在训练深度学习模型,尤其是大模型微调时,Warmup 几乎是标配。本文带你搞懂 Warmup 的作用、常见方式、公式推导、PyTorch 实现,以及如何设置预热步数。
前言
如果你训练过 BERT、LLaMA 这类模型,一定在配置里见过 warmup_steps 或 num_warmup_steps。它到底在做什么?为什么少了它训练就容易崩?今天就来详细聊聊学习率预热(Warmup)。
一、什么是 Warmup?
Warmup 是一种学习率预热策略:
训练初期不用大学习率,而是从很小的学习率逐步升到设定的初始学习率,再开始正常训练。
一句话概括:
先小步慢跑热身,再加速跑,避免一上来就大步扯着蛋。
二、为什么需要 Warmup?
Warmup 的存在,主要是为了解决训练初期的几个不稳定因素:
-
训练初期模型不稳定:参数随机初始化,梯度可能很大,直接上大学习率容易震荡甚至发散。
-
保护预训练权重:微调大模型时,如果一开始学习率太大,可能把预训练学到的知识冲垮。
-
Adam 等优化器初期方差估计不准:早期更新量可能异常大,Warmup 可以平滑过渡。
-
大 batch 训练更常见:大 batch 通常配大学习率,更需要 Warmup。
所以 Warmup 的本质是:给模型一个适应过程,别一开始就猛冲。
三、常见 Warmup 方式
| 方式 | 做法 |
|---|---|
| 线性 Warmup | 学习率从 0 线性升到初始值 |
| 常数 Warmup | 先固定一个很小的学习率,再切到正常 |
| 指数 Warmup | 按指数增长 |
| 余弦 Warmup | 用余弦曲线上升 |
最常用的是 线性 Warmup + 余弦退火:
前 N 步:学习率从 0 线性升到 lr_max
之后:按余弦退火慢慢降到 lr_min
四、公式(线性 Warmup)
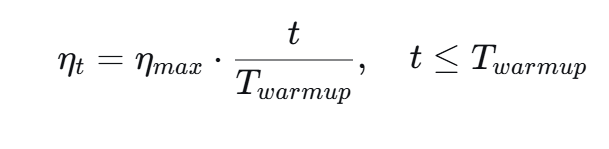
-
TwarmupTwarmup:预热步数
-
tt:当前步数
-
t>Twarmupt>Twarmup 后,切换到正常调度,比如余弦退火。
五、PyTorch 实现
PyTorch 没有单独的 WarmupLR,常用 LambdaLR 自定义:
python
import math
from torch.optim.lr_scheduler import LambdaLR

warmup_steps = 1000
total_steps = 10000

def lr_lambda(current_step):
    if current_step < warmup_steps:
        return float(current_step) / float(max(1, warmup_steps))
    # 之后接余弦退火
    progress = float(current_step - warmup_steps) / float(max(1, total_steps - warmup_steps))
    return max(0.0, 0.5 * (1.0 + math.cos(math.pi * progress)))

scheduler = LambdaLR(optimizer, lr_lambda)
Hugging Face transformers 里直接有现成的:
python
from transformers import get_cosine_schedule_with_warmup

scheduler = get_cosine_schedule_with_warmup(
    optimizer,
    num_warmup_steps=1000,
    num_training_steps=10000
)
训练循环里每个 step 调用 scheduler.step() 即可。
六、Warmup 设多少?
-
常见:总步数的 1% ~ 10%
-
大模型微调:几百到几千步
-
小数据集:几十到几百步
-
太大:浪费训练时间;太小:起不到稳定作用
经验:先设总步数的 5% 左右,再根据 loss 曲线调。
七、面试口头版
Warmup 就是学习率预热。训练初期不用大学习率,而是从很小的值逐步升到设定值,再正常训练。
目的是避免初期梯度不稳定、保护预训练权重、让 Adam 的方差估计更准。
最常见的是线性 Warmup 接余弦退火。
PyTorch 里可以用
LambdaLR自定义,Hugging Face 有get_cosine_schedule_with_warmup。一句话:先热身再加速,训练更稳。
总结
Warmup 虽然简单,但作用很大,尤其是大模型微调和大 batch 训练场景。核心就是"先小后大",让模型平稳度过训练初期。配合余弦退火,能兼顾收敛速度和稳定性。如果你还没用 Warmup,建议下次训练时加上试试。