前面几篇讲了 Flink Watermark 的基础原理、乱序问题处理、周期性 Watermark 和断点式 Watermark,都是从原理和 API 的角度展开。这篇换个角度,从企业级生产环境的真实案例出发,讲清楚生产环境中 Watermark 到底怎么配、怎么调、出了问题怎么排查。
很多同学学完 Watermark 原理后,到了生产环境还是一脸懵:乱序容忍设多少?WM 生成间隔设多少?withIdleness 要不要设?窗口不触发怎么办?结果偏小怎么办?大促期间 WM 异常怎么办?这些问题教科书上没有标准答案,因为每个业务场景的答案都不一样。
这篇把我在生产环境中踩过的坑、总结的经验整理出来,覆盖四大典型企业级场景(实时数仓 ETL、金融实时风控、IoT 设备监控、电商实时大盘)、六大核心配置参数、六大调优策略、监控告警体系、六大常见生产事故、五步排查流程、十二条最佳实践。看完这篇,生产环境 Watermark 相关的问题基本都能覆盖。
一、企业级 Watermark 四大生产挑战
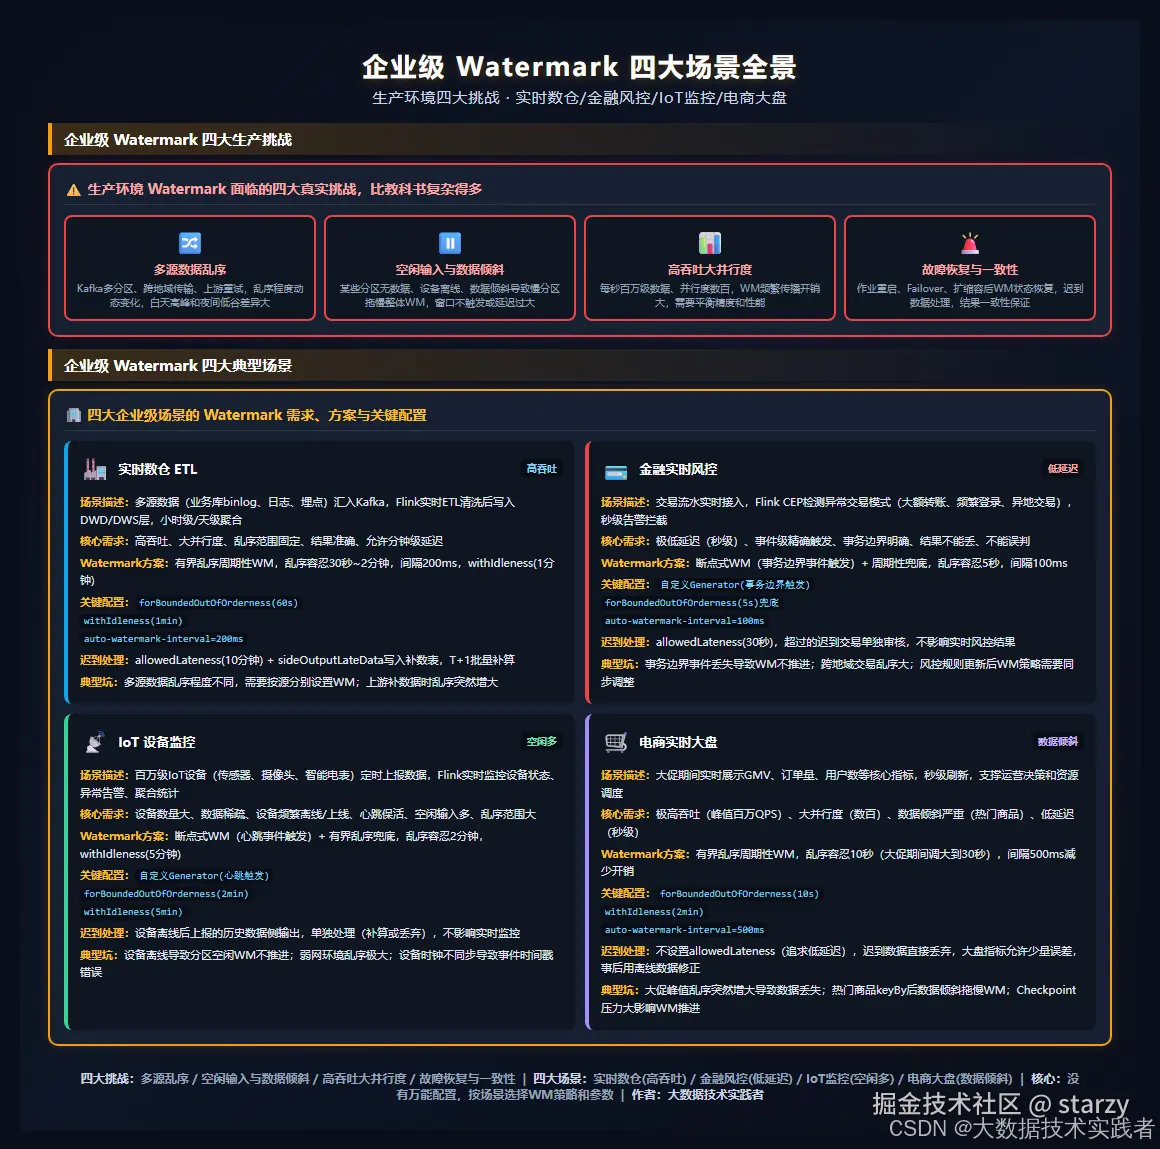
生产环境的 Watermark 比教科书复杂得多,主要面临四大挑战:
下面这张图把四大生产挑战和四大典型场景放在一起展示。
1.1 挑战一:多源数据乱序
生产环境的数据来源通常不止一个:业务库 binlog、应用日志、用户埋点、第三方数据,每个数据源的乱序程度都不一样。Kafka 多分区消费时,分区之间的数据本身就是乱序的;跨地域传输时网络延迟波动大;上游系统故障恢复后会重试补发数据,导致乱序突然增大。
更麻烦的是,乱序程度不是固定的:白天业务高峰时乱序大,夜间低谷时乱序小;大促期间乱序可能是平时的 3~5 倍。固定的乱序容忍时间很难适配所有场景。
1.2 挑战二:空闲输入与数据倾斜
生产环境中,某些 Kafka 分区可能长时间没有数据(如冷门 topic、低流量分区),某些设备可能离线(IoT 场景),导致对应的 Source 子任务没有数据,Watermark 不推进。下游算子取所有输入 Watermark 的最小值,空闲分区会拖慢整体 Watermark,导致窗口不触发或延迟过大。
数据倾斜是另一个常见问题:热门商品、热门用户的 key 数据量特别大,对应的子任务处理慢,Watermark 推进慢,同样拖慢整体。
1.3 挑战三:高吞吐大并行度
企业级 Flink 作业通常是高吞吐大并行度:每秒百万级数据、并行度数百。Watermark 生成间隔如果设得太小(如 10ms),每个子任务频繁发出 Watermark,Watermark 在算子链中频繁传播,CPU 和网络开销很大。
但间隔设得太大(如 5 秒),Watermark 推进不精确,窗口触发延迟高。需要在精度和性能之间找到平衡。
1.4 挑战四:故障恢复与一致性
生产环境作业不可避免会遇到故障:TaskManager 宕机、网络抖动、OOM、扩缩容、版本升级。作业从 Checkpoint/Savepoint 重启后,Watermark 状态能否正确恢复?迟到数据如何处理?结果一致性如何保证?
自定义 WatermarkGenerator 的内部状态(如 maxTimestamp)如果没有纳入 Checkpoint,重启后状态丢失,Watermark 回退,导致数据重复处理或丢失。
二、案例一:实时数仓 ETL 场景
2.1 场景描述
某互联网公司的实时数仓,数据来源包括:MySQL binlog(订单、用户、商品表)、Nginx 访问日志、App 埋点数据,全部汇入 Kafka。Flink 实时 ETL 作业负责数据清洗、维度关联、格式转换,写入 DWD 层;然后经过聚合写入 DWS 层,支撑小时级和天级的报表统计。
作业并行度 200,日均处理数据量 500 亿条,峰值 QPS 80 万。
2.2 核心需求
- 高吞吐:峰值 80 万 QPS,需要稳定处理不积压
- 大并行度:200 并行度,Watermark 传播开销需要控制
- 乱序范围固定:binlog 和日志的乱序范围相对固定,P99 乱序约 45 秒
- 结果准确:统计结果不能丢数据,允许分钟级延迟
- 多源数据:binlog、日志、埋点三个数据源,乱序程度不同
2.3 Watermark 方案
采用有界乱序周期性 Watermark,这是最稳定可靠的方案:
java
// 实时数仓 ETL Watermark 策略
WatermarkStrategy<JsonNode> binlogStrategy = WatermarkStrategy
    .<JsonNode>forBoundedOutOfOrderness(Duration.ofSeconds(60))  // 乱序容忍60秒
    .withIdleness(Duration.ofMinutes(1))  // 空闲输入1分钟
    .withTimestampAssigner((event, ts) -> event.get("ts").asLong() * 1000);  // 秒级转毫秒

WatermarkStrategy<JsonNode> logStrategy = WatermarkStrategy
    .<JsonNode>forBoundedOutOfOrderness(Duration.ofSeconds(30))  // 日志乱序小,容忍30秒
    .withIdleness(Duration.ofMinutes(1))
    .withTimestampAssigner((event, ts) -> event.get("@timestamp").asLong());

// 多源分别设置WM策略
DataStream<JsonNode> binlogStream = env.fromSource(binlogSource, binlogStrategy, "binlog");
DataStream<JsonNode> logStream = env.fromSource(logSource, logStrategy, "log");
关键配置:
- 乱序容忍 60 秒(binlog)/ 30 秒(日志),按 P99 乱序 × 1.3 设置
- withIdleness(1 分钟),处理空闲分区
- WM 生成间隔保持默认 200ms(高吞吐场景可以调大到 500ms 减少开销)
- 多源数据分别设置 WM 策略,不共用同一个
2.4 迟到数据处理
java
// 窗口聚合,允许迟到数据重新触发
OutputTag<OrderEvent> lateTag = new OutputTag<OrderEvent>("late-order") {};

SingleOutputStreamOperator<OrderStat> result = orderStream
    .keyBy(OrderEvent::getUserId)
    .window(TumblingEventTimeWindows.of(Time.minutes(5)))
    .allowedLateness(Time.minutes(10))  // 允许10分钟迟到
    .sideOutputLateData(lateTag)  // 超过10分钟的迟到数据侧输出
    .aggregate(new OrderAggregate(), new OrderWindowFunction());

// 迟到数据写入补数表,T+1批量补算
result.getSideOutput(lateTag).addSink(lateOrderSink);
2.5 踩过的坑
坑一:上游补数据导致乱序突然增大。 有一次上游系统故障恢复后,补发了 2 小时的历史数据,乱序突然增大到 30 分钟,大量数据被当作迟到丢弃。解决方案:补数据期间临时调大乱序容忍到 30 分钟,补完后恢复。后续建立了补数据流程规范,补数据前必须通知下游调整 WM 配置。
坑二:多源数据用同一个 WM 策略。 早期 binlog 和日志用同一个 WM 策略(乱序容忍 60 秒),日志数据的窗口延迟了 60 秒才触发,但日志实际乱序只有 10 秒。后来改成每个 Source 分别设置 WM 策略,日志的延迟降到 30 秒以内。
坑三:忘记设置 withIdleness。 有一个冷门 topic 的某个分区长期没有数据,导致整体 WM 不推进,窗口不触发。排查了半天才发现是空闲分区的问题。加上 withIdleness(1 分钟) 后问题解决。从那以后,所有事件时间作业都必须设置 withIdleness,这是上线检查的必选项。
三、案例二:金融实时风控场景
3.1 场景描述
某银行的实时风控系统,交易流水实时接入 Kafka,Flink CEP 作业检测异常交易模式:大额转账(单笔超过 5 万)、频繁登录(5 分钟内登录超过 3 次)、异地交易(10 分钟内两个城市交易)、凌晨高频交易等。检测到异常后秒级告警,触发人工审核或自动拦截。
作业并行度 64,峰值 QPS 5 万,要求端到端延迟 < 3 秒。
3.2 核心需求
- 极低延迟:端到端延迟 < 3 秒,异常交易必须秒级告警
- 事件级精确触发:交易完成后立即触发窗口,不能等固定时间间隔
- 事务边界明确:每笔交易有明确的开始和结束事件
- 结果不能丢:异常交易不能漏检,漏检就是资金损失
- 不能误判:正常交易不能误报,误报率高会影响用户体验
3.3 Watermark 方案
采用断点式 Watermark(事务边界事件触发)+ 周期性兜底:
java
// 金融风控断点式 WatermarkGenerator
public class TransactionPunctuatedGenerator
    implements WatermarkGenerator<TransactionEvent>, CheckpointedFunction {

    private long maxTimestamp = Long.MIN_VALUE;
    private long lastEmittedWatermark = Long.MIN_VALUE;
    private final long periodicFallbackMs;  // 周期性兜底间隔对应的乱序容忍

    public TransactionPunctuatedGenerator(long periodicFallbackMs) {
        this.periodicFallbackMs = periodicFallbackMs;
    }

    @Override
    public void onEvent(TransactionEvent event, long eventTimestamp, WatermarkOutput output) {
        maxTimestamp = Math.max(maxTimestamp, eventTimestamp);

        // 事务结束事件触发 Watermark
        if (event.isTransactionEnd()) {
            emitWatermarkIfNeeded(output, maxTimestamp);
        }
    }

    @Override
    public void onPeriodicEmit(WatermarkOutput output) {
        // 周期性兜底:即使事务结束事件丢失,也定期推进 WM
        if (maxTimestamp != Long.MIN_VALUE) {
            long fallbackWatermark = maxTimestamp - periodicFallbackMs;
            emitWatermarkIfNeeded(output, fallbackWatermark);
        }
    }

    private void emitWatermarkIfNeeded(WatermarkOutput output, long watermark) {
        if (watermark > lastEmittedWatermark) {
            output.emitWatermark(new Watermark(watermark));
            lastEmittedWatermark = watermark;
        }
    }

    // 自定义状态纳入 Checkpoint,保证重启后恢复
    @Override
    public void snapshotState(FunctionSnapshotContext context) throws Exception {
        // 用 ListState 保存 maxTimestamp 和 lastEmittedWatermark
    }

    @Override
    public void initializeState(FunctionInitializationContext context) throws Exception {
        // 从 Checkpoint 恢复状态
    }
}

// 使用方式
WatermarkStrategy<TransactionEvent> strategy = WatermarkStrategy
    .<TransactionEvent>forGenerator(ctx -> new TransactionPunctuatedGenerator(5000))  // 5秒兜底
    .withIdleness(Duration.ofMinutes(1))
    .withTimestampAssigner((event, ts) -> event.getTransactionTime());
关键设计:
- 断点式:事务结束事件到达时立即发出 WM,事件级精确触发,延迟最小
- 周期性兜底:即使事务结束事件丢失,也定期推进 WM(maxTimestamp - 5 秒),避免 WM 不推进
- 单调递增保证:记录 lastEmittedWatermark,只发出更大的值
- 自定义状态纳入 Checkpoint:maxTimestamp 和 lastEmittedWatermark 持久化,重启后恢复
3.4 踩过的坑
坑一:事务结束事件丢失导致 WM 不推进。 早期只用断点式,没有周期性兜底。有一次上游系统的事务结束事件因为 bug 没有发出,导致 WM 完全不推进,所有窗口不触发,风控系统停摆。后来加上周期性兜底,即使标记事件丢失也能定期推进 WM,问题解决。
坑二:自定义 WM 状态没有纳入 Checkpoint。 作业重启后 maxTimestamp 丢失,WM 回退到 Long.MIN_VALUE,导致历史数据被重新处理,大量重复告警。后来实现 CheckpointedFunction 接口,把 maxTimestamp 和 lastEmittedWatermark 纳入 Checkpoint,重启后恢复,问题解决。
坑三:跨地域交易乱序大。 有用户在异地交易,交易时间戳乱序较大(最多 30 秒),导致部分交易被当作迟到丢弃。解决方案:周期性兜底的乱序容忍从 5 秒调大到 30 秒,同时监控迟到数据量,确认没有异常交易被丢弃。
四、案例三:IoT 设备监控场景
4.1 场景描述
某智能电表公司的 IoT 监控平台,百万级智能电表每 15 分钟上报一次用电数据(电压、电流、功率、电量),Flink 作业实时监控设备状态:离线检测(超过 30 分钟未上报)、异常用电检测(功率突变、电量异常)、按时段聚合统计(小时级/天级用电量)。
作业并行度 128,设备数量 150 万,日均上报数据 140 亿条。
4.2 核心需求
- 设备数量大:150 万设备,keyBy 后数据分散
- 数据稀疏:每 15 分钟上报一次,大部分时间没有数据
- 设备频繁离线/上线:设备断电、网络故障导致离线,恢复后重新上线
- 心跳保活:设备定期发送心跳包,表示设备在线
- 空闲输入多:很多分区大部分时间没有数据
- 乱序范围大:弱网环境下数据延迟大,乱序最多 5 分钟
4.3 Watermark 方案
采用断点式 Watermark(心跳事件触发)+ 有界乱序兜底:
java
// IoT 心跳触发 WatermarkGenerator
public class IoTPunctuatedGenerator implements WatermarkGenerator<DeviceEvent> {
    private long maxTimestamp = Long.MIN_VALUE;
    private long lastEmittedWatermark = Long.MIN_VALUE;
    private static final long OUT_OF_ORDERNESS_MS = 120000;  // 2分钟乱序容忍

    @Override
    public void onEvent(DeviceEvent event, long eventTimestamp, WatermarkOutput output) {
        maxTimestamp = Math.max(maxTimestamp, eventTimestamp);

        // 心跳事件触发 Watermark
        if (event.isHeartbeat()) {
            emitWatermarkIfNeeded(output, maxTimestamp);
        }
    }

    @Override
    public void onPeriodicEmit(WatermarkOutput output) {
        // 有界乱序兜底:即使心跳事件丢失,也定期推进 WM
        if (maxTimestamp != Long.MIN_VALUE) {
            long fallbackWatermark = maxTimestamp - OUT_OF_ORDERNESS_MS;
            emitWatermarkIfNeeded(output, fallbackWatermark);
        }
    }

    private void emitWatermarkIfNeeded(WatermarkOutput output, long watermark) {
        if (watermark > lastEmittedWatermark) {
            output.emitWatermark(new Watermark(watermark));
            lastEmittedWatermark = watermark;
        }
    }
}

// 使用方式,withIdleness 设置 5 分钟(设备离线超时)
WatermarkStrategy<DeviceEvent> strategy = WatermarkStrategy
    .<DeviceEvent>forGenerator(ctx -> new IoTPunctuatedGenerator())
    .withIdleness(Duration.ofMinutes(5))  // 5分钟空闲超时
    .withTimestampAssigner((event, ts) -> event.getReportTime());
关键设计:
- 心跳事件触发:设备每 15 分钟上报一次心跳,心跳到达时立即发出 WM
- 有界乱序兜底:2 分钟乱序容忍,即使心跳丢失也能定期推进 WM
- withIdleness(5 分钟):设备离线 5 分钟后暂时忽略该输入的 WM,避免离线设备拖慢整体
- 设备时钟同步:要求设备上报的时间戳是同步后的 NTP 时间,避免设备时钟不同步导致 WM 错误
4.4 踩过的坑
坑一:设备离线导致 WM 不推进。 早期 withIdleness 设置 1 分钟,设备因为网络波动短暂离线(2 分钟)就被标记为空闲,WM 被忽略,设备恢复后 WM 突然跳变,导致窗口触发异常。后来把 withIdleness 调大到 5 分钟(设备离线检测阈值),短暂离线不会被忽略,问题解决。
坑二:设备时钟不同步。 有一批设备的时钟没有同步 NTP,时间戳比实际时间慢了 10 分钟,导致这些设备的数据永远被当作迟到丢弃。解决方案:在数据接入层增加时间戳校验,异常时间戳的数据侧输出单独处理;同时推动设备端强制 NTP 同步。
坑三:弱网环境乱序极大。 部分偏远地区的设备通过 2G/3G 网络上报,数据延迟大,乱序最多 10 分钟。早期乱序容忍设置 2 分钟,大量数据被丢弃。后来对这些地区的设备单独配置 WM 策略(乱序容忍 10 分钟),问题解决。这也验证了"多源数据分别设置 WM"的重要性。
五、案例四:电商实时大盘场景
5.1 场景描述
某电商平台的实时大盘,大促期间实时展示核心指标:GMV、订单量、支付用户数、客单价、各品类占比、各地区占比,秒级刷新,支撑运营决策和资源调度。大促峰值 QPS 120 万,作业并行度 500。
5.2 核心需求
- 极高吞吐:峰值 120 万 QPS,不能积压
- 大并行度:500 并行度,WM 传播开销需要控制
- 数据倾斜严重:热门商品、热门品类的 key 数据量特别大
- 低延迟:大盘指标秒级刷新,延迟不能超过 10 秒
- 允许少量误差:大盘指标是趋势参考,允许 1% 以内的误差,事后用离线数据修正
5.3 Watermark 方案
采用有界乱序周期性 Watermark + 本地预聚合解决数据倾斜:
java
// 电商大盘 Watermark 策略
WatermarkStrategy<OrderEvent> strategy = WatermarkStrategy
    .<OrderEvent>forBoundedOutOfOrderness(Duration.ofSeconds(10))  // 乱序容忍10秒
    .withIdleness(Duration.ofMinutes(2))  // 空闲输入2分钟
    .withTimestampAssigner((event, ts) -> event.getPayTime());

// 本地预聚合解决数据倾斜:先在每个并行子任务内预聚合,再 keyBy 全局聚合
DataStream<OrderStat> result = orderStream
    .assignTimestampsAndWatermarks(strategy)
    .map(new LocalPreAggregator())  // 本地预聚合,减少数据量
    .keyBy(OrderStat::getCategory)
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))  // 10秒滚动窗口
    .sum("gmv");
关键配置:
- 乱序容忍 10 秒(大促期间临时调大到 30 秒)
- WM 生成间隔调大到 500ms(高吞吐大并行度,减少 WM 传播开销)
- withIdleness(2 分钟)
- 不设置 allowedLateness(追求低延迟,迟到数据直接丢弃,大盘允许少量误差)
- 本地预聚合解决数据倾斜,减少下游 keyBy 的数据量
5.4 踩过的坑
坑一:大促峰值乱序突然增大。 第一次大促时,乱序容忍设置 10 秒,但峰值期间上游支付系统压力大,重试增多,乱序突然增大到 40 秒,大量订单数据被丢弃,大盘 GMV 比实际值低了 8%。解决方案:大促前压测评估峰值乱序,大促期间临时调大乱序容忍到 30 秒,同时增加本地预聚合减少下游压力。后续每次大促前都做压测和 WM 配置调整。
坑二:热门商品数据倾斜拖慢 WM。 某爆款商品的订单量占总订单量的 20%,keyBy 后对应的子任务处理慢,WM 推进慢,拖慢整体大盘。解决方案:增加本地预聚合(在 map 阶段先按商品聚合),减少下游 keyBy 的数据量;同时对热门商品单独处理(两阶段聚合:先随机 key 预聚合,再按商品 key 聚合)。
坑三:Checkpoint 压力大影响 WM 推进。 大促期间状态大(500 并行度 × 每个 key 的聚合状态),Checkpoint 同步阶段阻塞 TaskManager 线程,导致 WM 推进慢,大盘延迟增大。解决方案:开启增量 Checkpoint 和异步 Checkpoint,增大 Checkpoint 间隔(从 30 秒调大到 2 分钟),使用 RocksDB StateBackend(支持增量 Checkpoint)。
六、企业级 Watermark 配置与调优体系
四大场景讲完了,下面总结企业级 Watermark 的配置与调优体系。
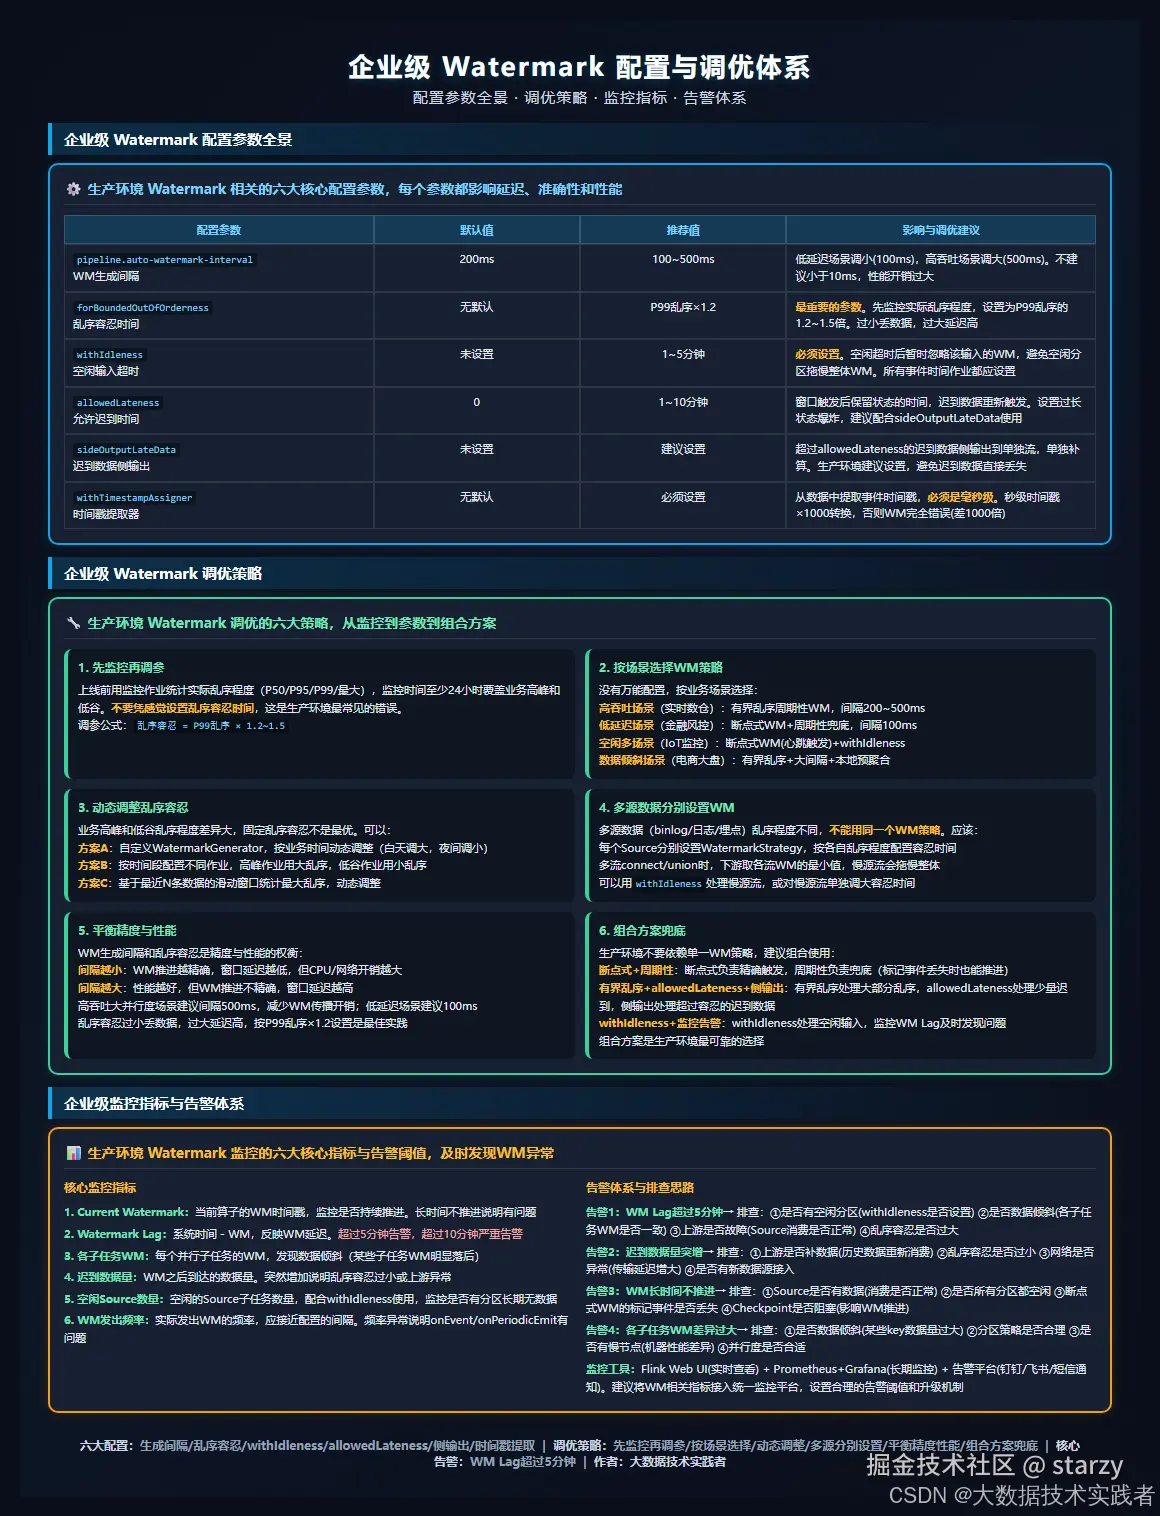
下面这张图把六大核心配置参数、六大调优策略、监控指标与告警体系放在一起展示。
6.1 六大核心配置参数
| 配置参数 | 默认值 | 推荐值 | 影响与调优建议 |
|---|---|---|---|
| pipeline.auto-watermark-interval | 200ms | 100~500ms | 低延迟场景调小(100ms),高吞吐场景调大(500ms)。不建议小于10ms |
| forBoundedOutOfOrderness | 无默认 | P99乱序×1.2 | 最重要的参数。先监控实际乱序,设置为P99的1.2~1.5倍。过小丢数据,过大延迟高 |
| withIdleness | 未设置 | 1~5分钟 | 必须设置。空闲超时后暂时忽略该输入的WM,避免空闲分区拖慢整体 |
| allowedLateness | 0 | 1~10分钟 | 窗口触发后保留状态的时间,迟到数据重新触发。设置过长状态爆炸 |
| sideOutputLateData | 未设置 | 建议设置 | 超过allowedLateness的迟到数据侧输出,单独补算。生产环境建议设置 |
| withTimestampAssigner | 无默认 | 必须设置 | 从数据中提取事件时间戳,必须是毫秒级。秒级×1000转换 |
6.2 六大调优策略
策略一:先监控再调参。 上线前用监控作业统计实际乱序程度(P50/P95/P99/最大),监控时间至少 24 小时覆盖业务高峰和低谷。不要凭感觉设置乱序容忍时间,这是生产环境最常见的错误。调参公式:乱序容忍 = P99 乱序 × 1.2~1.5。
策略二:按场景选择 WM 策略。 没有万能配置:高吞吐场景(实时数仓)用有界乱序周期性 WM,间隔 200~500ms;低延迟场景(金融风控)用断点式 WM + 周期性兜底,间隔 100ms;空闲多场景(IoT 监控)用断点式 WM(心跳触发)+ withIdleness;数据倾斜场景(电商大盘)用有界乱序 + 大间隔 + 本地预聚合。
策略三:动态调整乱序容忍。 业务高峰和低谷乱序程度差异大,固定乱序容忍不是最优。可以自定义 WatermarkGenerator 按业务时间动态调整(白天调大,夜间调小),或按时间段配置不同作业。
策略四:多源数据分别设置 WM。 多源数据(binlog/日志/埋点)乱序程度不同,不能用同一个 WM 策略。每个 Source 分别设置 WatermarkStrategy,按各自乱序程度配置。多流 connect/union 时下游取最小值,慢源流会拖慢整体,可以用 withIdleness 处理。
策略五:平衡精度与性能。 WM 生成间隔和乱序容忍是精度与性能的权衡:间隔越小精度越高但开销越大,间隔越大性能越好但延迟越高。高吞吐大并行度场景建议间隔 500ms,低延迟场景建议 100ms。
策略六:组合方案兜底。 生产环境不要依赖单一 WM 策略:断点式 + 周期性(断点式精确触发,周期性兜底);有界乱序 + allowedLateness + 侧输出(三层处理迟到数据);withIdleness + 监控告警(及时发现问题)。
6.3 监控指标与告警体系
六大核心监控指标:
- Current Watermark:当前算子的 WM 时间戳,监控是否持续推进。长时间不推进说明有问题。
- Watermark Lag:系统时间 - WM,反映 WM 延迟。超过 5 分钟告警,超过 10 分钟严重告警。
- 各子任务 WM:每个并行子任务的 WM,发现数据倾斜(某些子任务 WM 明显落后)。
- 迟到数据量:WM 之后到达的数据量。突然增加说明乱序容忍过小或上游异常。
- 空闲 Source 数量:空闲的 Source 子任务数量,配合 withIdleness 使用。
- WM 发出频率:实际发出 WM 的频率,应接近配置的间隔。
告警体系: WM Lag 超过 5 分钟告警,超过 10 分钟严重告警;迟到数据量突增告警;WM 长时间不推进告警;各子任务 WM 差异过大告警。监控工具:Flink Web UI(实时查看)+ Prometheus + Grafana(长期监控)+ 告警平台(钉钉/飞书/短信通知)。
七、企业级生产事故排查与最佳实践
最后讲生产环境最常见的事故和排查方法。
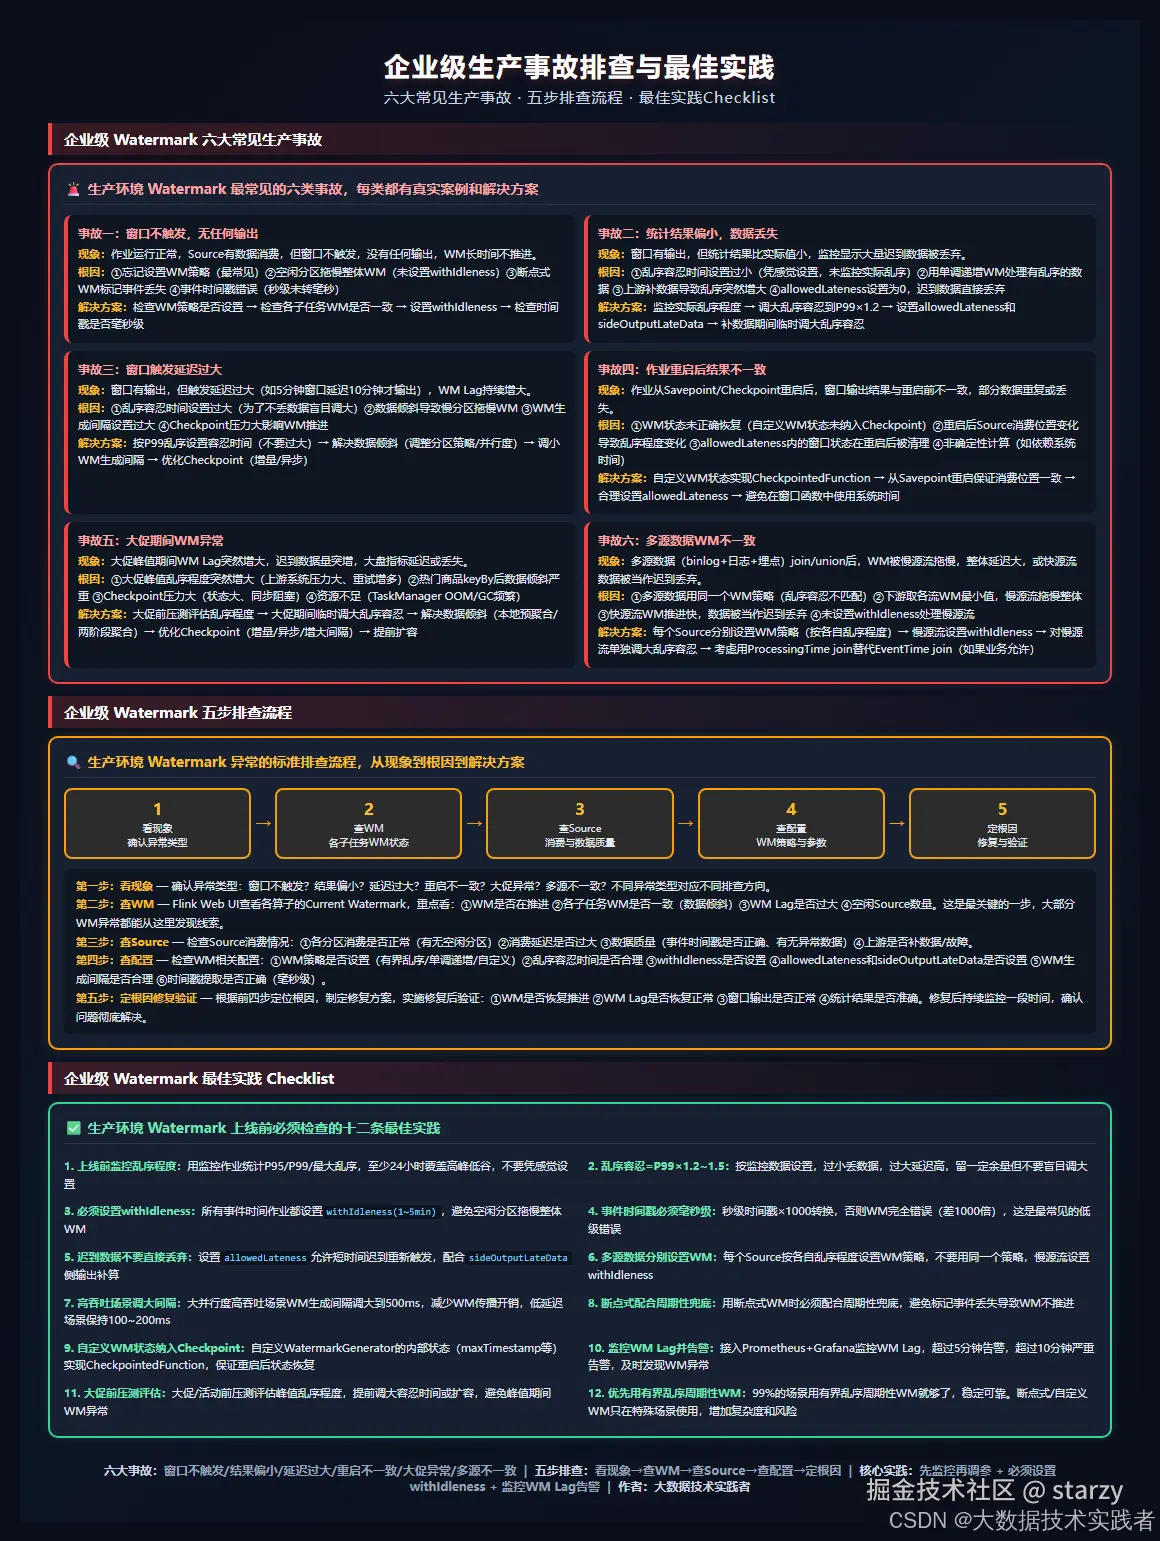
下面这张图把六大常见生产事故、五步排查流程、十二条最佳实践 Checklist 放在一起展示。
7.1 六大常见生产事故
事故一:窗口不触发,无任何输出。 现象:作业运行正常,Source 有数据消费,但窗口不触发,没有任何输出,WM 长时间不推进。根因:①忘记设置 WM 策略(最常见)②空闲分区拖慢整体 WM(未设置 withIdleness)③断点式 WM 标记事件丢失 ④事件时间戳错误(秒级未转毫秒)。解决方案:检查 WM 策略是否设置 → 检查各子任务 WM 是否一致 → 设置 withIdleness → 检查时间戳是否毫秒级。
事故二:统计结果偏小,数据丢失。 现象:窗口有输出,但统计结果比实际值小,监控显示大量迟到数据被丢弃。根因:①乱序容忍时间设置过小(凭感觉设置)②用单调递增 WM 处理有乱序的数据 ③上游补数据导致乱序突然增大 ④allowedLateness 设置为 0。解决方案:监控实际乱序程度 → 调大乱序容忍到 P99×1.2 → 设置 allowedLateness 和 sideOutputLateData → 补数据期间临时调大乱序容忍。
事故三:窗口触发延迟过大。 现象:窗口有输出,但触发延迟过大(如 5 分钟窗口延迟 10 分钟才输出),WM Lag 持续增大。根因:①乱序容忍时间设置过大(盲目调大)②数据倾斜导致慢分区拖慢 WM ③WM 生成间隔设置过大 ④Checkpoint 压力大影响 WM 推进。解决方案:按 P99 乱序设置容忍时间 → 解决数据倾斜 → 调小 WM 生成间隔 → 优化 Checkpoint(增量/异步)。
事故四:作业重启后结果不一致。 现象:作业从 Savepoint/Checkpoint 重启后,窗口输出结果与重启前不一致,部分数据重复或丢失。根因:①WM 状态未正确恢复(自定义 WM 状态未纳入 Checkpoint)②重启后 Source 消费位置变化 ③allowedLateness 内的窗口状态在重启后被清理 ④非确定性计算。解决方案:自定义 WM 状态实现 CheckpointedFunction → 从 Savepoint 重启保证消费位置一致 → 合理设置 allowedLateness → 避免在窗口函数中使用系统时间。
事故五:大促期间 WM 异常。 现象:大促峰值期间 WM Lag 突然增大,迟到数据量突增,大盘指标延迟或丢失。根因:①大促峰值乱序程度突然增大 ②热门商品 keyBy 后数据倾斜严重 ③Checkpoint 压力大 ④资源不足(OOM/GC 频繁)。解决方案:大促前压测评估乱序 → 大促期间临时调大乱序容忍 → 解决数据倾斜(本地预聚合/两阶段聚合)→ 优化 Checkpoint → 提前扩容。
事故六:多源数据 WM 不一致。 现象:多源数据 join/union 后,WM 被慢源流拖慢,整体延迟大,或快源流数据被当作迟到丢弃。根因:①多源数据用同一个 WM 策略 ②下游取各流 WM 最小值,慢源流拖慢整体 ③快源流 WM 推进快,数据被当作迟到丢弃 ④未设置 withIdleness。解决方案:每个 Source 分别设置 WM 策略 → 慢源流设置 withIdleness → 对慢源流单独调大乱序容忍 → 考虑用 ProcessingTime join 替代。
7.2 五步排查流程
第一步:看现象。 确认异常类型:窗口不触发?结果偏小?延迟过大?重启不一致?大促异常?多源不一致?不同异常类型对应不同排查方向。
第二步:查 WM。 Flink Web UI 查看各算子的 Current Watermark,重点看:①WM 是否在推进 ②各子任务 WM 是否一致(数据倾斜)③WM Lag 是否过大 ④空闲 Source 数量。这是最关键的一步,大部分 WM 异常都能从这里发现线索。
第三步:查 Source。 检查 Source 消费情况:①各分区消费是否正常(有无空闲分区)②消费延迟是否过大 ③数据质量(事件时间戳是否正确、有无异常数据)④上游是否补数据/故障。
第四步:查配置。 检查 WM 相关配置:①WM 策略是否设置 ②乱序容忍时间是否合理 ③withIdleness 是否设置 ④allowedLateness 和 sideOutputLateData 是否设置 ⑤WM 生成间隔是否合理 ⑥时间戳提取是否正确(毫秒级)。
第五步:定根因修复验证。 根据前四步定位根因,制定修复方案,实施修复后验证:①WM 是否恢复推进 ②WM Lag 是否恢复正常 ③窗口输出是否正常 ④统计结果是否准确。修复后持续监控一段时间。
7.3 十二条最佳实践 Checklist
上线前逐条检查:
- 上线前监控乱序程度:用监控作业统计 P95/P99/最大乱序,至少 24 小时覆盖高峰低谷
- 乱序容忍 = P99 × 1.2~1.5:按监控数据设置,过小丢数据,过大延迟高
- 必须设置 withIdleness:所有事件时间作业都设置 withIdleness(1~5min)
- 事件时间戳必须毫秒级:秒级时间戳 × 1000 转换,否则 WM 完全错误
- 迟到数据不要直接丢弃:设置 allowedLateness + sideOutputLateData
- 多源数据分别设置 WM:每个 Source 按各自乱序程度设置 WM 策略
- 高吞吐场景调大间隔:大并行度高吞吐场景 WM 生成间隔调大到 500ms
- 断点式配合周期性兜底:用断点式 WM 时必须配合周期性兜底
- 自定义 WM 状态纳入 Checkpoint:实现 CheckpointedFunction 接口,保证重启后恢复
- 监控 WM Lag 并告警:接入 Prometheus + Grafana,超过 5 分钟告警
- 大促前压测评估:大促/活动前压测评估峰值乱序,提前调大容忍时间或扩容
- 优先用有界乱序周期性 WM:99% 的场景用有界乱序周期性 WM 就够了,稳定可靠
八、总结与下一篇预告
企业级 Watermark 案例分析要点回顾:
第一,生产环境 Watermark 面临四大挑战:多源数据乱序(乱序程度动态变化)、空闲输入与数据倾斜(慢分区拖慢整体)、高吞吐大并行度(WM 传播开销大)、故障恢复与一致性(WM 状态恢复)。教科书上的固定配置在生产环境不够用。
第二,四大典型场景的 WM 方案各不相同:实时数仓 ETL 用有界乱序周期性 WM(乱序容忍 60 秒,多源分别设置,迟到数据侧输出补算);金融实时风控用断点式 WM(事务边界触发)+ 周期性兜底(低延迟,事件级精确);IoT 设备监控用断点式 WM(心跳触发)+ 有界乱序兜底 + withIdleness(5 分钟)(空闲多,设备离线);电商实时大盘用有界乱序周期性 WM + 大间隔(500ms) + 本地预聚合(高吞吐,数据倾斜,允许少量误差)。
第三,六大核心配置参数:WM 生成间隔(100500ms)、乱序容忍(P99×1.2 1.5,最重要)、withIdleness(必须设置 15 分钟)、allowedLateness(110 分钟)、sideOutputLateData(建议设置)、时间戳提取(必须毫秒级)。
第四,六大调优策略:先监控再调参、按场景选择 WM 策略、动态调整乱序容忍、多源数据分别设置 WM、平衡精度与性能、组合方案兜底。
第五,监控告警体系:六大核心指标(Current WM、WM Lag、各子任务 WM、迟到数据量、空闲 Source 数量、WM 发出频率),WM Lag 超过 5 分钟告警,超过 10 分钟严重告警。
第六,六大常见生产事故:窗口不触发(忘记设置 WM/空闲分区/标记丢失/时间戳错误)、结果偏小(乱序容忍过小/补数据乱序增大)、延迟过大(乱序容忍过大/数据倾斜/Checkpoint 压力)、重启不一致(WM 状态未恢复/消费位置变化)、大促异常(峰值乱序增大/数据倾斜/资源不足)、多源不一致(同一 WM 策略/慢源流拖慢)。
第七,五步排查流程:看现象 → 查 WM(最关键)→ 查 Source → 查配置 → 定根因修复验证。
第八,十二条最佳实践 Checklist:上线前监控乱序、乱序容忍=P99×1.2、必须设置 withIdleness、时间戳毫秒级、迟到数据不丢弃、多源分别设置 WM、高吞吐调大间隔、断点式配合兜底、自定义状态纳入 Checkpoint、监控 WM Lag 告警、大促前压测、优先有界乱序周期性 WM。
生产环境 Watermark 没有万能配置,核心原则是:先监控再调参,按场景选择策略,组合方案兜底,持续监控告警。把这十二条最佳实践落实到上线检查流程中,Watermark 相关的生产事故能减少 90%。