前两篇写了高频榜第一和第二,有一句话我一直想回应:这些题,是不是背个解法就行了。
数组中的第 K 个最大元素 是我最想拿来回答这道问的一个例子。它在面经数据里出现 606 次,排第 4。
它看起来只有一种标准解法,实际上面试官会拿它连问三件事,而且三件事的答案互相矛盾------你在第一问里写的最优解,到第二问就作废了,到第三问更是根本不能用。
这题真正的区分度不在算法,在于你有没有意识到:你答的到底是哪一个问。
摘要:本文以高频面试题「数组中的第 K 个最大元素」为例,拆解面试官围绕同一道题连问的三件事:静态数组、分布式批处理、在线数据流。文章先用一张表摆出全排序、小顶堆、快速选择三种路线的复杂度,再用实测数据说明快选为何快(同一份数据差 12 倍),并指出「快选 O(n)」的前提是 pivot 选得足够均匀,否则在有序数据上会退化为 O(n²)。随后分别给出 10 亿个数分布在 100 台机器上的分片 TopK 解法与值域二分优化,以及数据流场景下只能用堆的结论。核心观点:面试官考的不是三个算法,而是三种系统形态下的最优解选择。
目录
- 一、先把三种解法摆出来
- 二、快选为什么快:它不做你不需要的事
- [三、代价实测:同一份数据,差 12 倍](#三、代价实测:同一份数据,差 12 倍)
- [四、但"快选 O(n)"是有前提的](#四、但"快选 O(n)"是有前提的)
- [五、第二问:如果这 10 亿个数在 100 台机器上](#五、第二问:如果这 10 亿个数在 100 台机器上)
- 六、第三问:如果数据是持续到达的流
- 附:这题的追问清单
一、先把三种解法摆出来
题面很干净:给定无序数组,返回第 k 大的元素。要求线性时间。
三种常见路线:
| 路线 | 时间 | 空间 | 能不能处理数据流 |
|---|---|---|---|
全排序后取 a[n-k] |
O(n log n) | O(1)~O(n) | 否 |
| 大小为 k 的小顶堆 | O(n log k) | O(k) | 是 |
| 快速选择 | 平均 O(n),最坏 O(n²) | O(1) | 否 |
全排序是最多人第一反应的写法,也是最容易被追问的------面试官会问"你排了全部的序,但你只要一个数,剩下的排序成果你用到了一丝一毫吗"。
答案是没用到。这就是快速选择存在的全部理由。
二、快选为什么快:它不做你不需要的事
快速选择的思路一句话:借快排的划分,但每轮只递归一侧。
先说清楚一个转换。第 k 大,等价于升序排列下标 n - k 的那个元素。所以目标从"找第 k 大"变成"找升序第 target 位",其中 target = n - k。
然后每一轮:选一个 pivot,把区间划分成"不大于 pivot"和"不小于 pivot"两段。划分完成后 pivot 落在了它最终的排序位置上(或者一个全等于 pivot 的区段里)。这时候只需要比一下 target 在哪边,另一边整段永久丢掉。
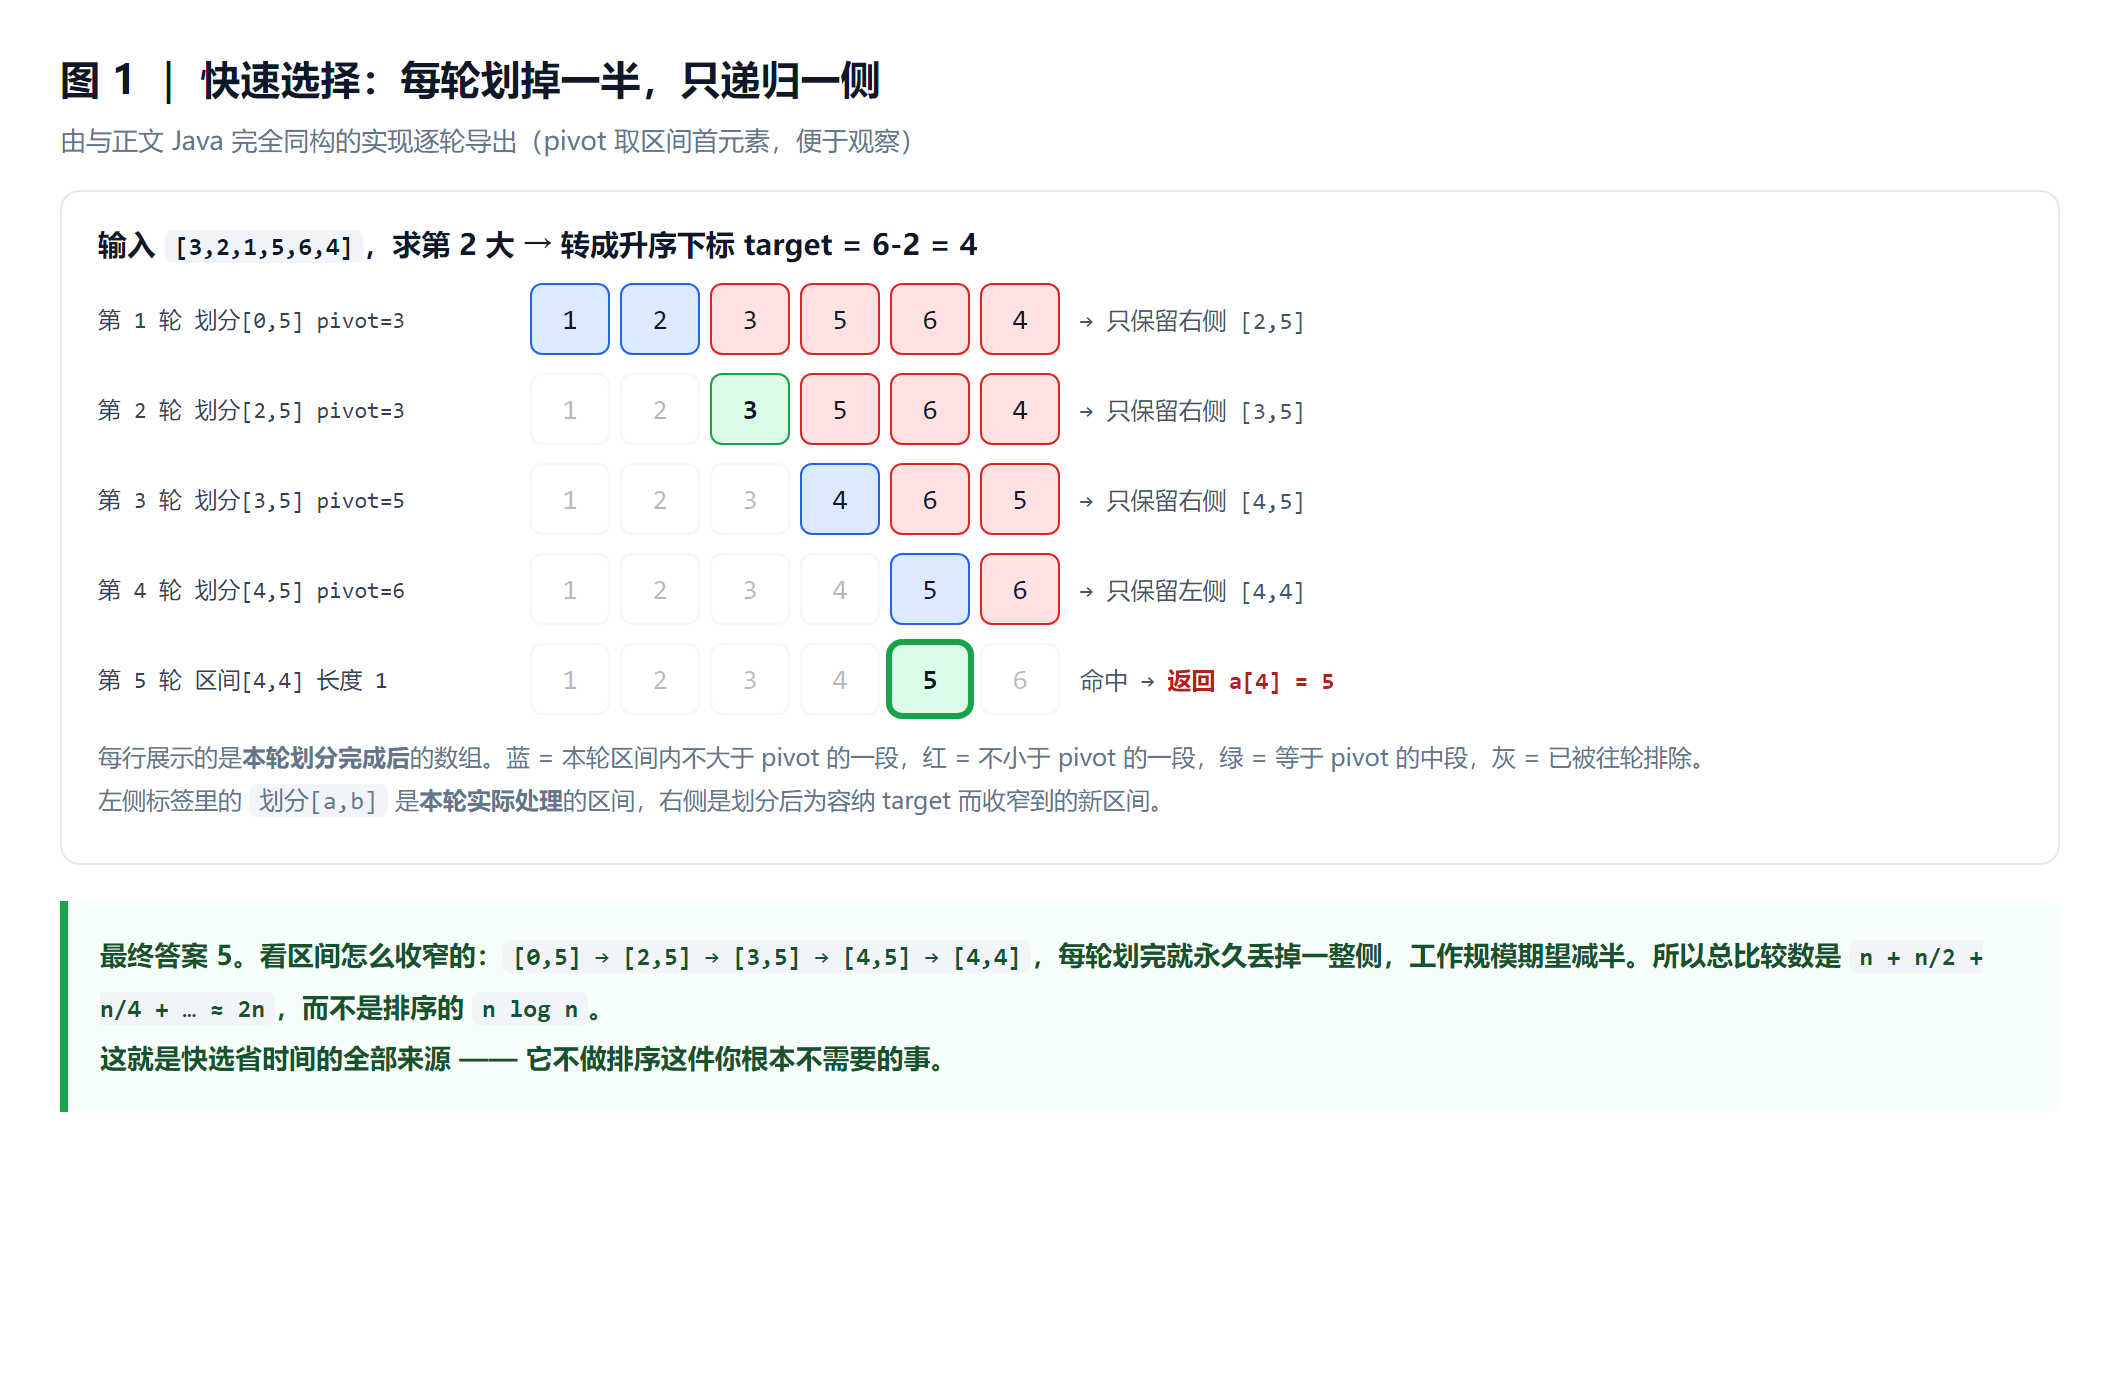
看图里区间是怎么收窄的:[0,5] → [2,5] → [3,5] → [4,5] → [4,4]。
第 1 轮 pivot=3,划分后 1 2 在左、3 5 6 4 在右。target=4 落在右半边,于是下标 0 和 1 这两个位置从此再也不会被看一眼。
每轮工作规模期望减半,所以总比较数是
n + n/2 + n/4 + ... ≈ 2n而不是排序的 n log n。
快选省时间的全部来源,是它拒绝做排序这件你根本不需要的事。
三、代价实测:同一份数据,差 12 倍
上面是理论。我把三种路线都自己实现了一遍(不能用库函数,否则统计不到比较次数),加了一个受控比较器,只统计元素两两比较的次数。
n = 100,000、k = 50,000,随机数据:
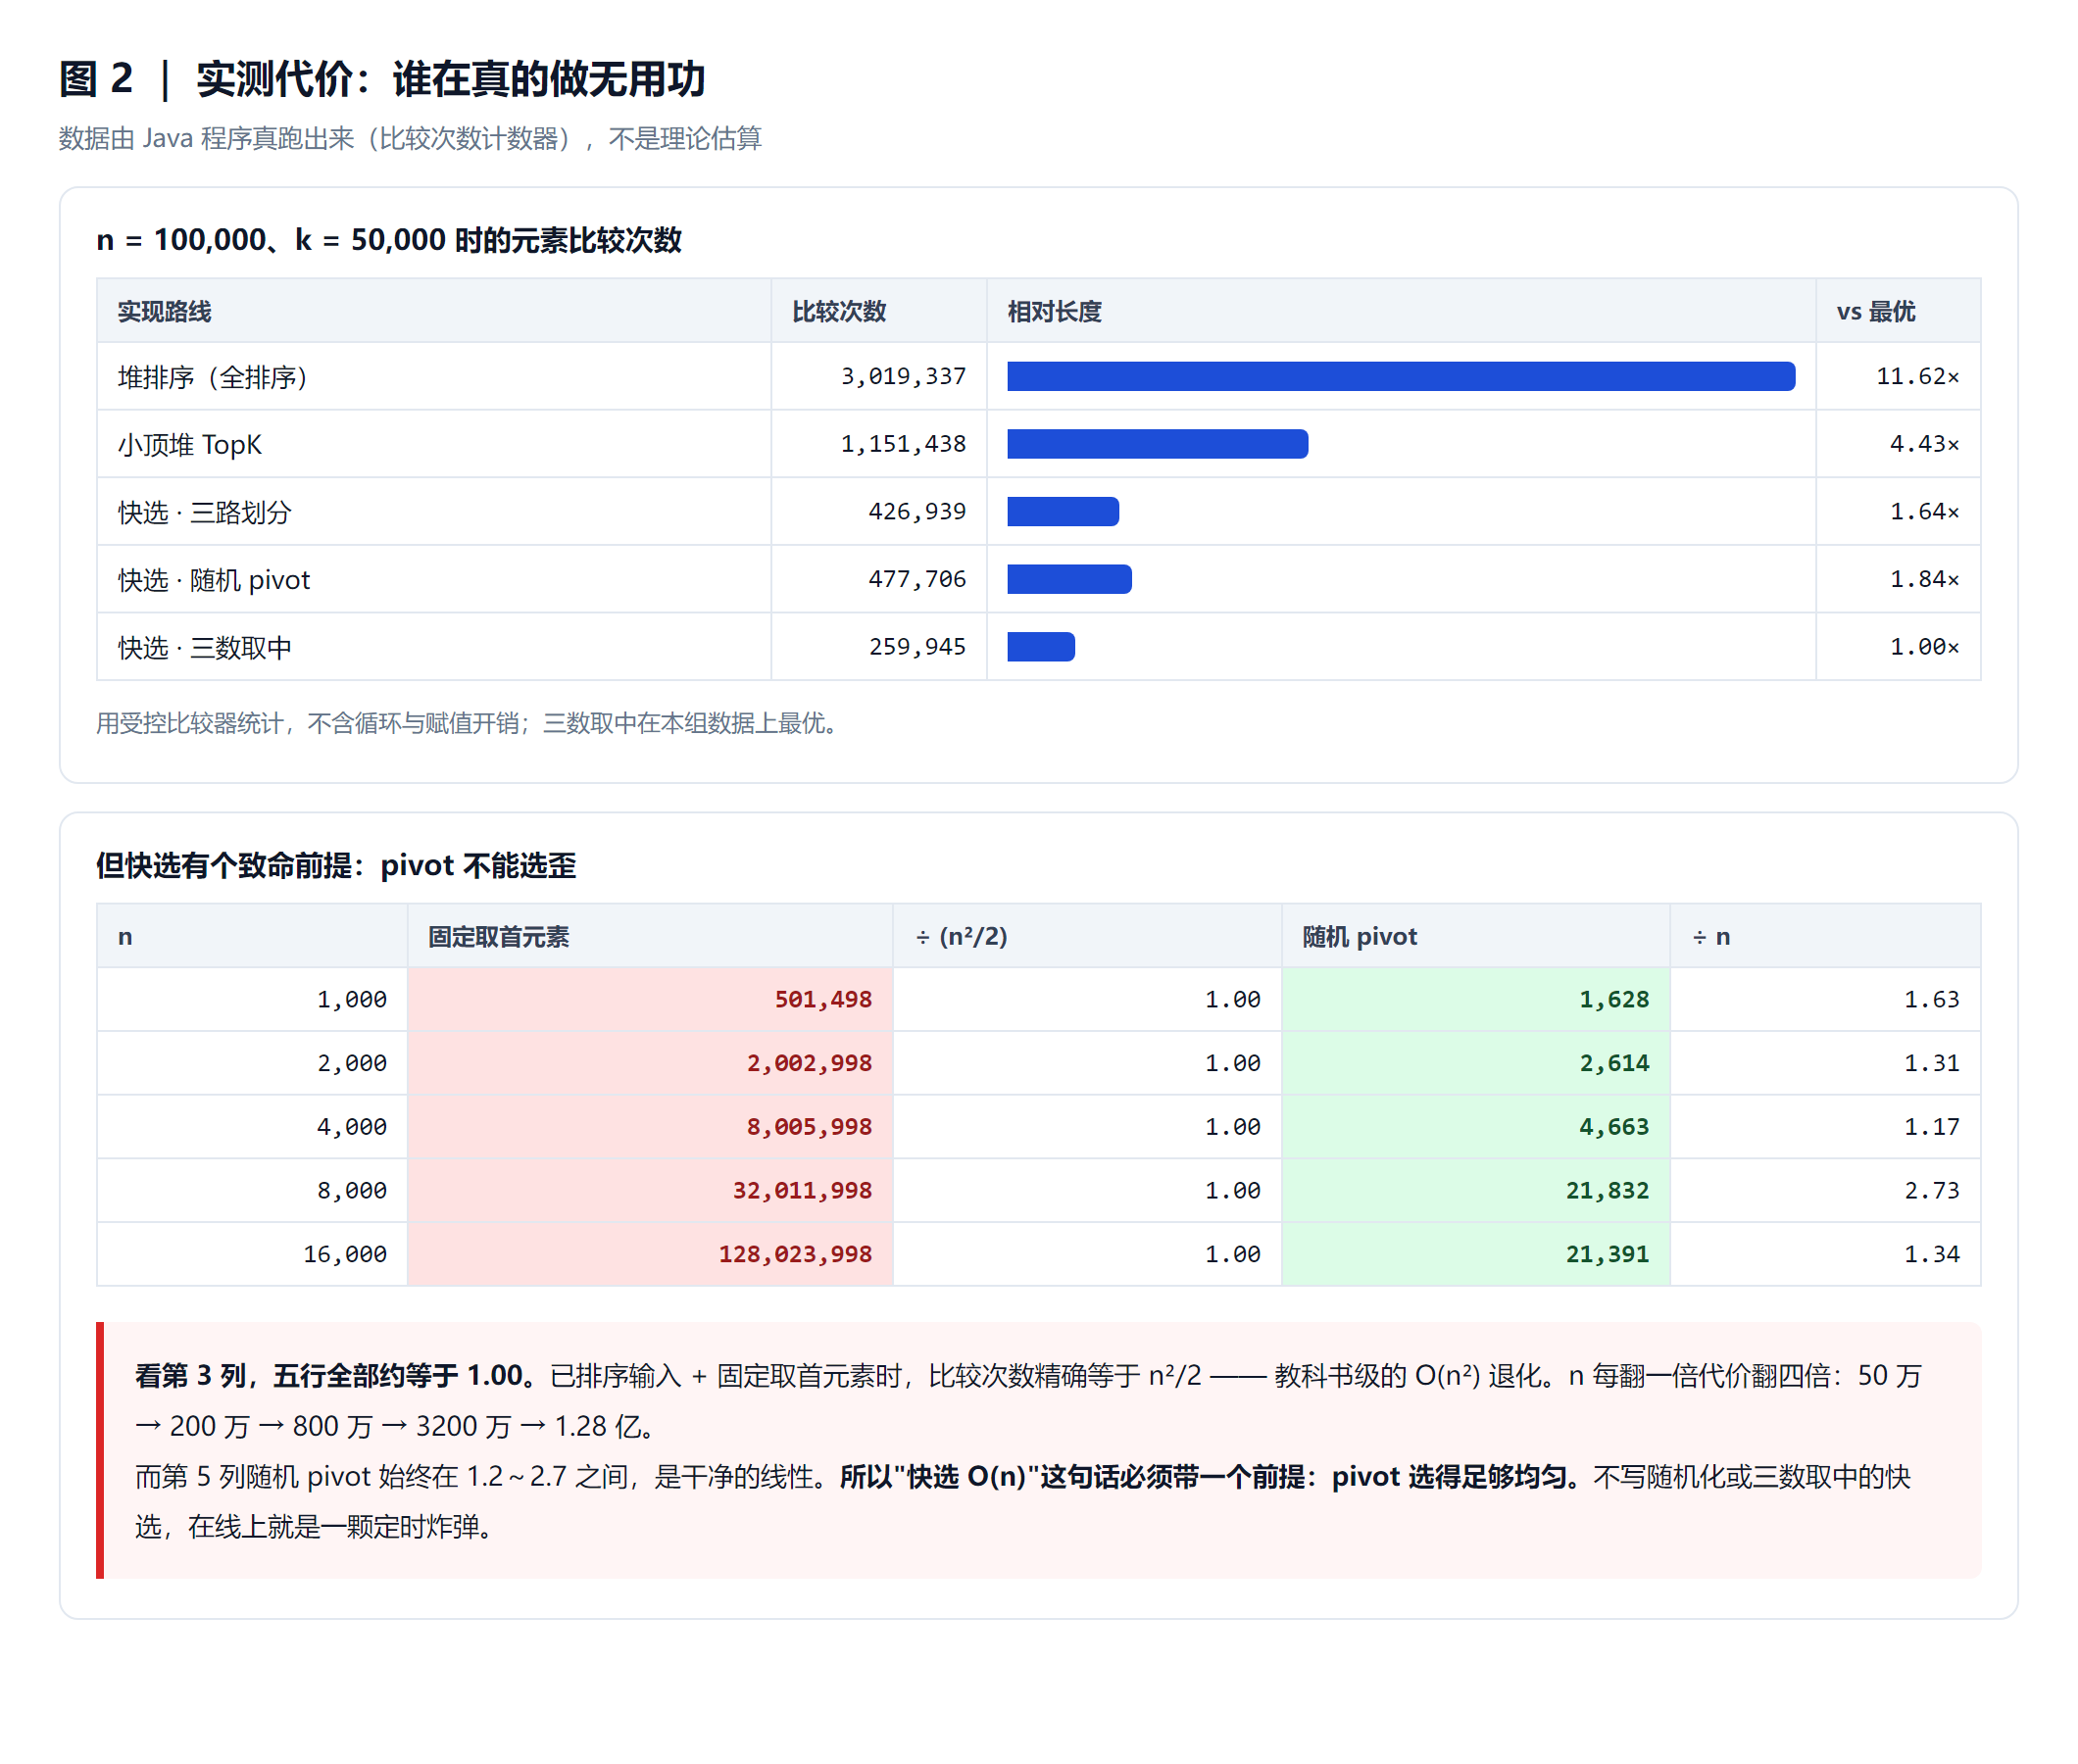
| 实现 | 比较次数 | vs 最优 |
|---|---|---|
| 堆排序(全排序) | 3,019,337 | 11.62× |
| 小顶堆 TopK | 1,151,438 | 4.43× |
| 快选 · 三路划分 | 426,939 | 1.64× |
| 快选 · 随机 pivot | 477,706 | 1.84× |
| 快选 · 三数取中 | 259,945 | 1.00× |
全排序比最优写法多花 11.62 倍。这 11.62 倍就是"顺手 sort 一下"的代价。
顺便解释一下为什么堆是 O(n log k) 而不是 O(n log n):堆里最多只存 k 个数,每次插入或替换的调整高度是 log k。所以 k 越小堆越有优势,k 接近 n 时它就退化成全排序的量级。
四、但"快选 O(n)"是有前提的
这是这题最容易翻车的地方,也是我实测里最意外的一组数。
我把 pivot 策略换成"固定取区间首元素",输入换成已排序数组(也就是最容易被忽略的一种真实场景------很多业务数据本来就是近似有序的),然后看比较次数怎么随 n 增长:
| n | 固定取首元素 | ÷ (n²/2) | 随机 pivot | ÷ n |
|---|---|---|---|---|
| 1,000 | 501,498 | 1.00 | 1,628 | 1.63 |
| 2,000 | 2,002,998 | 1.00 | 2,614 | 1.31 |
| 4,000 | 8,005,998 | 1.00 | 4,663 | 1.17 |
| 8,000 | 32,011,998 | 1.00 | 21,832 | 2.73 |
| 16,000 | 128,023,998 | 1.00 | 21,391 | 1.34 |
第三列五行全部约等于 1.00。
也就是说,退化后的比较次数精确等于 n²/2。n 每翻一倍代价翻四倍,从 50 万一路涨到 1.28 亿。而随机 pivot 那一列始终在 1.2~2.7 之间,是干净的线性。
所以"快选 O(n)"这句话必须带一个前提:pivot 选得足够均匀。不写随机化或三数取中的快选,在线上就是一颗定时炸弹------它在随机数据上表现完美,在某天遇到一批有序数据时突然把服务拖死。
正文推荐写法(也是我做实验用的那份):
java
// mode: 0=取区间首元素(用于演示退化) 1=随机 2=三数取中
static int pickPivot(int[] a, int lo, int hi, int mode) {
    if (mode == 1) {
        swap(a, lo, lo + rnd.nextInt(hi - lo + 1));
    } else if (mode == 2) {
        int m = (lo + hi) >>> 1;
        if (gt(a[m], a[lo])) swap(a, lo, m);
        if (gt(a[hi], a[m])) swap(a, m, hi);
        if (gt(a[m], a[lo])) swap(a, lo, m);
        swap(a, lo, m);                 // 中位数落到 lo
    }
    return a[lo];                       // pivot 值存在于待扫描区间,内层循环可终止
}

static int kthByQuickSelect(int[] src, int k, int mode) {
    int[] a = src.clone();
    int target = a.length - k;          // 第 k 大 = 升序下标 n-k
    int lo = 0, hi = a.length - 1;
    while (true) {
        if (lo >= hi) return a[lo];
        int pivot = pickPivot(a, lo, hi, mode);
        int i = lo, j = hi;
        while (i <= j) {
            while (lt(a[i], pivot)) i++;
            while (gt(a[j], pivot)) j--;
            if (i <= j) { swap(a, i, j); i++; j--; }
        }
        if (target <= j) hi = j;         // 只保留左半
        else if (target >= i) lo = i;    // 只保留右半
        else return a[target];           // 落在等于 pivot 的区段,直接命中
    }
}
最后那个 else 分支值得单独说:两路划分结束后,[j+1, i-1] 这一段全等于 pivot。如果 target 正好落在这段里,答案就是 pivot,不用再递归了。
这个性质在重复元素多的时候威力很大。我专门测了一组:n=60,000、值域只有 3 个数(模拟状态码、枚举值这类数据)。
两路划分 = 120,900 次
三路划分 =  99,924 次   (少 20,976 次,约 17%)
三路划分(把区间分成 < pivot / == pivot / > pivot 三段)遇到大量重复时,能一次把整个等于区段排除掉。数据重复度越高,优势越大。
五、第二问:如果这 10 亿个数在 100 台机器上
答到这儿,面试官会换个姿势问:现在数据不在一台机器上了。
每台机器各自算出本机的 TopK,把 100 份候选集汇总,再对这 100×k 个数取第 k 大。
关键是这一步的正确性证明,一句话就够:
全局 TopK 里的任何一个元素,一定也在它所在分片的 TopK 里。否则该分片内就存在 k 个比它更大的数,而这 k 个数同样大于全局第 k 大,矛盾。
所以候选集一定包含答案,第二步不会漏。总代价从"把 10 亿个数搬回一台机器"降到"搬 100×k 个数"------网络传输才是这类问题的真实瓶颈,不是 CPU。
这个等价性我也实测了:20 万个元素随机打散到 100 个分片,每片各取 TopK 再汇总,跑 200 组随机 k 值,与全局排序结果比对:
20 万元素 / 100 分片 / 200 组随机 k:一致 200/200而这一步真正的加分项,是主动说出它的适用边界。 如果 k = 100 万、100 台机器,候选集就是 1 亿,等于没优化。这时候要么改成二级聚合(先 10 台一组归并再汇总),要么干脆换思路:
值域二分。二分答案,每一片只统计"≤ mid 的元素个数"------这是个纯粹的计数,每台机器返回一个数字就行,通信量从 O(k) 降到 O(1)。TopK 问题被转换成了计数问题。
这一转换在真实系统里非常重要,因为"返回一个数"和"返回 k 个数"的带宽差距是数量级的。
六、第三问:如果数据是持续到达的流
前两问的解法在这问全部作废。
快选要求对一个静态数组做随机访问------数据还在一条一条到达,你连"区间"都定义不了。全排序同理。
唯一活下来的是堆。维护一个大小为 k 的小顶堆,每来一个数比较一次堆顶,比堆顶大就替换。这就是 LeetCode 703 的实现。
如果问的是"任意时刻的中位数",那就升级成对顶双堆(大顶堆放较小的一半、小顶堆放较大的一半),也就是 LeetCode 295。
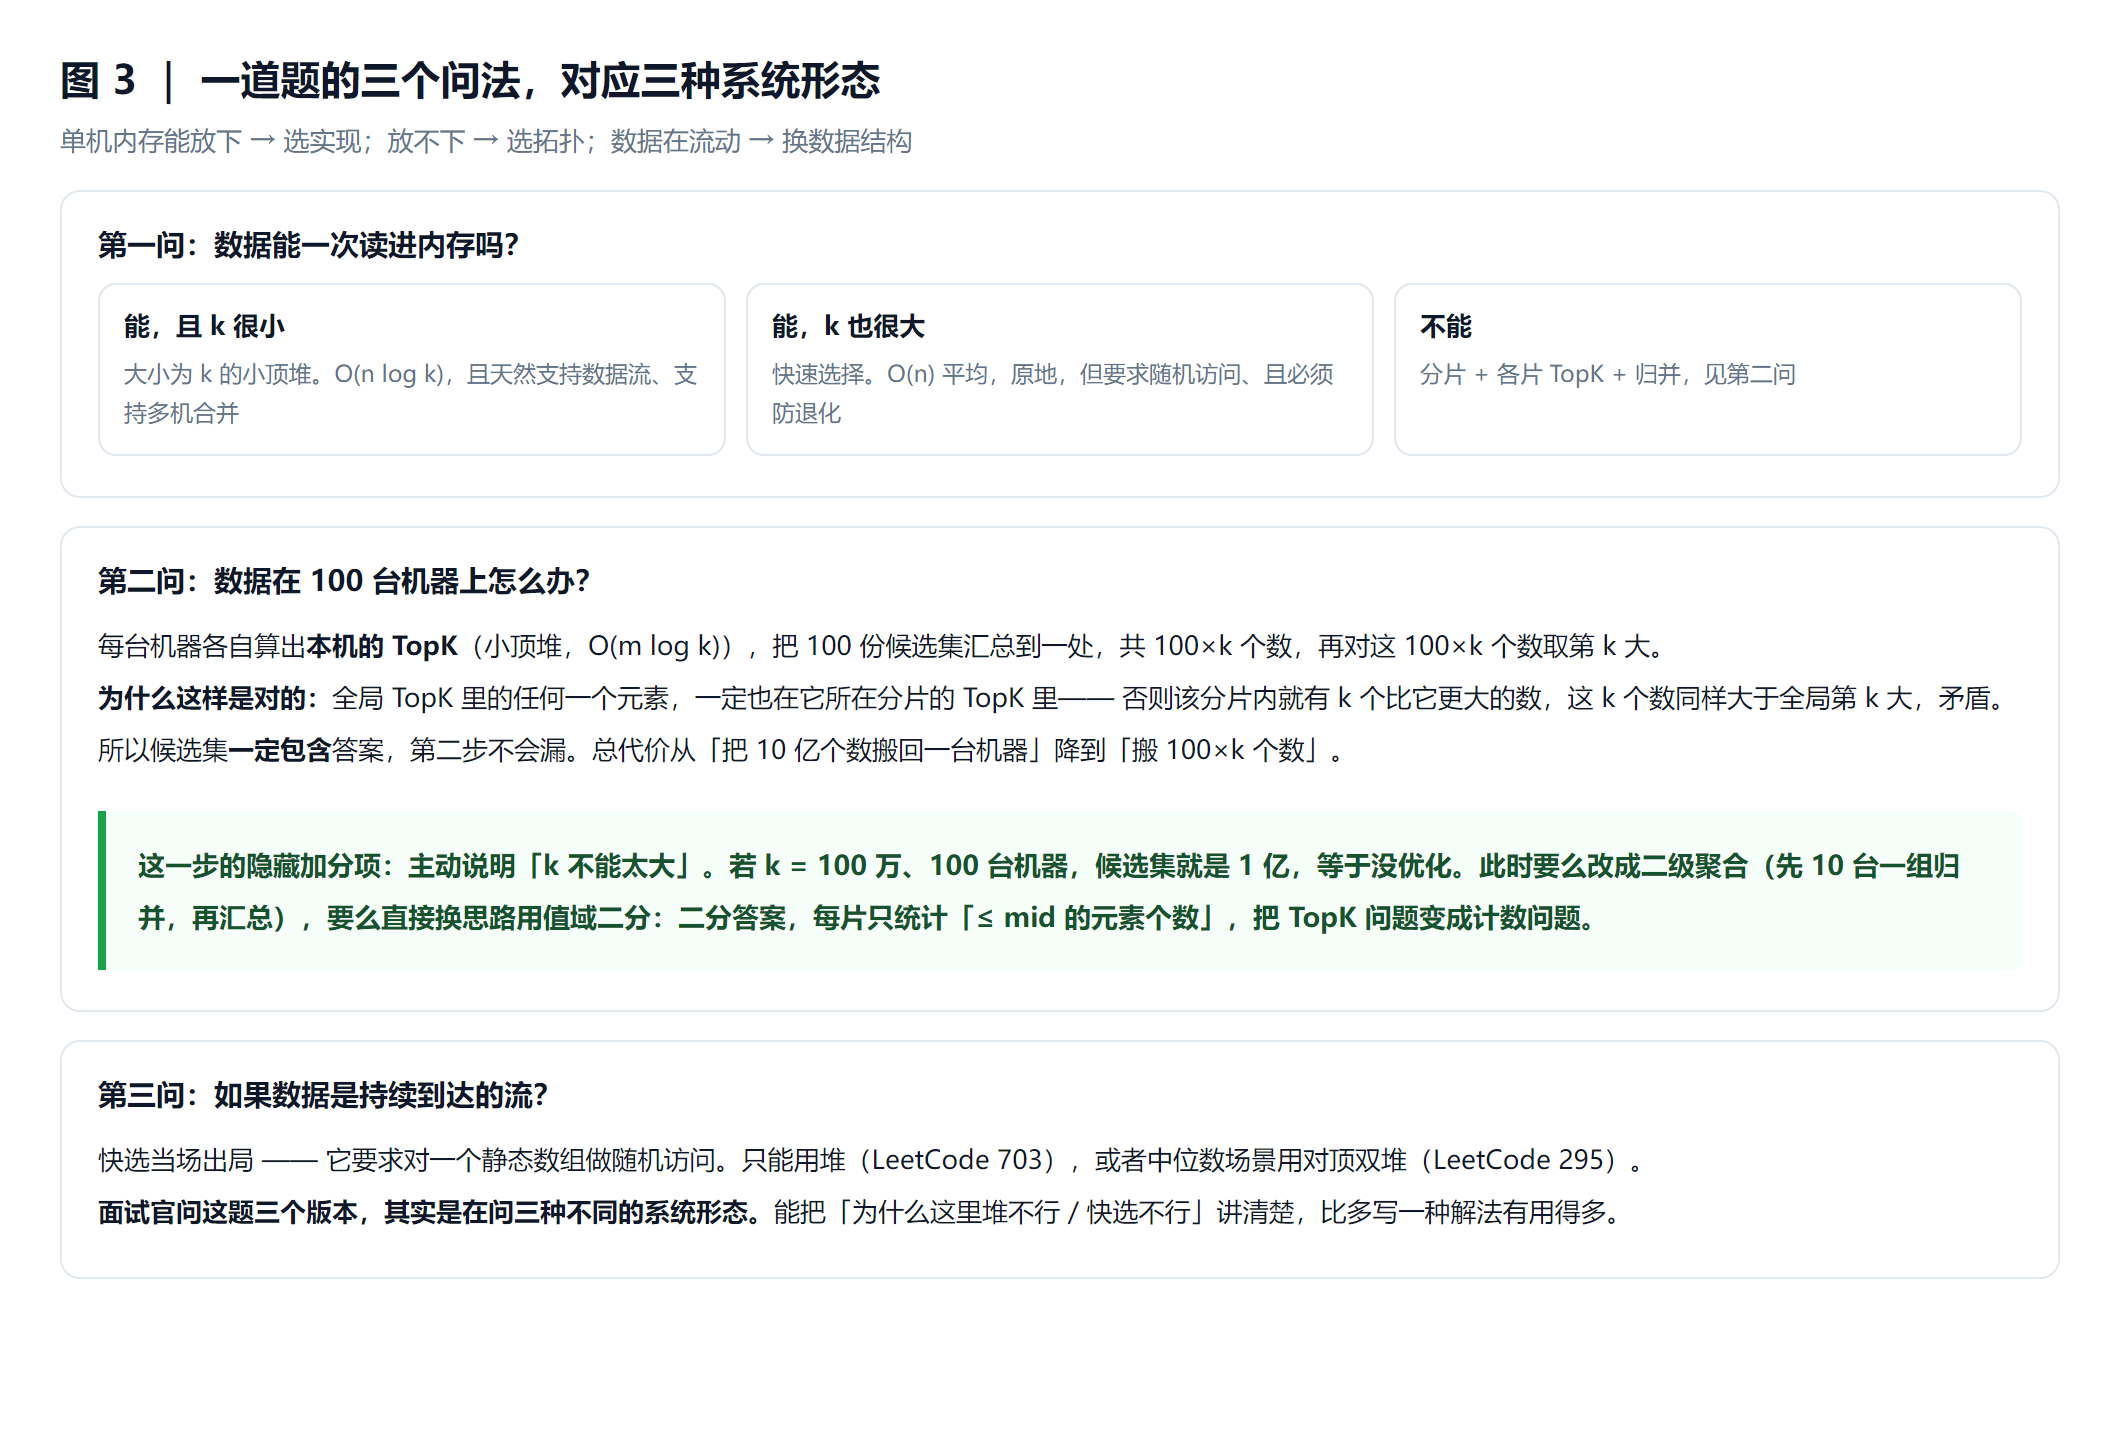
把三问串起来看,会发现一件事:面试官不是在考三个算法,是在考三种系统形态。 静态内存、分布式批处理、在线数据流。同一份"求第 k 大"的需求,在三种形态下的最优解完全不同,而且互相不可迁移。
能主动说出"这里快选不能用,因为它要求随机访问",比再写一种解法值钱得多。
附:这题的追问清单
| 追问 | 想确认什么 | 一句话答案 |
|---|---|---|
| 第 k 大怎么转成下标 | 会不会被题意绕住 | target = n - k,转成升序第 target 位 |
| 快选为什么平均 O(n) | 是否真理解划分 | 每轮丢弃一整侧,规模期望减半,n+n/2+...≈2n |
| 最坏情况怎么触发 | 有没有线上意识 | 已排序 + 固定 pivot,比较数精确等于 n²/2 |
| 怎么防 | 会不会写生产代码 | 随机 pivot 或三数取中;重复多时上三路划分 |
| 为什么是 O(n log k) 不是 O(n log n) | 堆的复杂度算清没有 | 堆里最多 k 个元素,调整高度是 log k |
| 10 亿数在 100 台机器上 | 有没有分布式直觉 | 各片 TopK 再汇总;正确性靠反证 |
| 候选集太大怎么办 | 会不会主动找边界 | 二级聚合,或改值域二分(通信量降到 O(1)) |
| 数据流怎么办 | 知不知道解法的适用前提 | 只能堆(703);中位数用对顶双堆(295) |
金句:快选的全部价值,在于它拒绝做你不需要的那部分工作。而它的全部风险,也在于它假设你给的数据不是有序的。
下一篇写排名第 5 的 K 个一组翻转链表,出现 537 次,是前十名里唯一的 Hard。那题的难点根本不在思路------思路一句话就能说完------而在于断链重连的那一瞬间,你会不会把整组丢掉。
本文代码与配图由作者用华为云码道(CodeArts 代码智能体)辅助完成,全部实现经穷举与随机对撞验证。