论文名片
| 项目 | 内容 |
|---|---|
| 论文名 | HoHoNet: 360 Indoor Holistic Understanding with Latent Horizontal Features |
| 作者 | Cheng Sun、Min Sun、Hwann-Tzong Chen ------ HorizonNet 的原班人马 |
| 发表 | CVPR 2021,pp. 2573--2582 |
| 一句话贡献 | 把 HorizonNet 那条"一维水平特征"的潜力彻底榨干 :不只用来画房间骨架,还能直接变出深度图和语义分割图 ,而且快到 110 FPS |
| 江湖地位 | 全景视觉从"一个模型干一件事"迈向"一个模型干所有事"的关键一步;它的 LHFeat + h2d 成了后续很多全景密集预测任务的基础套路 |
名字拆解:Ho listic(整体的)+ Horizontal(水平的)= HoHoNet。
一、动机:HorizonNet 留下了一个"未完成"
1.1 HorizonNet 的成功与遗憾
先回忆一下 HorizonNet(同一批作者的前作)干了什么:
把 512×1024 的全景图,压缩成 3 条长度 1024 的数字串------每一列记录天花板边界高度、地板边界高度、墙角概率。
效果拔群:精度高、参数少、快。
但它有一个天生的限制,论文原话点得很清楚:
HorizonNet 只适用于"逐列(per-column)"的任务------比如预测布局的角点或边界。这限制了它在需要"逐像素(per-pixel)"预测的场景中应用。
什么叫"逐列" vs "逐像素"?
| 类型 | 输出形状 | 能干的事 | 例子 |
|---|---|---|---|
| 逐列模态 | O(W),每列一个数或几个数 | 房间骨架(高度、边界、角点) | 布局重建 |
| 逐像素模态 | O(HW),每个像素一个值 | 密集深度图 、语义分割图 | 深度估计、分割 |
问题来了:**房间的深度图、语义分割图,是全景视觉里另外两个极其重要的任务。** 可 HorizonNet 那套"一维表示"根本输出不了------一列一个数,怎么可能表达一整列 512 个像素各自的深度?
类比:HorizonNet 发明了"用一行字总结一页书"的绝技,又快又准。但你现在需要"把这一页书重新画出来"------一行字显然不够。
1.2 一个关键观察:人造结构是"按重力排队"的
那怎么办?作者观察到了一个极其朴素、却极其有力的事实:
人造建筑的结构,与全景图中"重力对齐的 y 轴"之间存在强烈的规律性。
翻译成人话:
- 墙是竖直的;
- 地板、天花板是水平的;
- 门、窗、桌子、柜子......几乎所有人工物体,都沿着重力方向整齐排列。
既然如此,垂直方向(列方向)上的信息是高度结构化、高度冗余的------它不像水平方向那样需要 512 个独立自由度去描述。
底层规律
对齐好的全景图里,室内场景有一个非常强的几何规律: 所有墙面都是竖直的,地板、天花板都是水平的,沿着图像每一列的内容,高度方向的变化是平滑、有规律的。
比如在同一列上,从上到下基本就是:天花板 → 墙面 → 家具 → 地板,结构非常规整。
这意味着:
- 我们可以把每一列的高度维度 "压扁" 成一个特征向量,保留核心结构信息;
- 反过来,从这个压缩的向量里,也能根据规律恢复出每一行的细节。
这就是 HoHoNet 的立论基础 :既然垂直方向冗余,那就把它压扁;压扁之后,再用数学方法"解压"回来------只要解压方式得当,细节不会丢太多。
可以把整个思路理解成 "压缩包" 逻辑:
- LHFeat(潜态水平特征) :就是压缩包。把 2D 图像特征沿竖直方向打包压缩,变成高度只有 1 的长条形特征,体积大幅减小;
- EHC 模块 :打包工具。高效地把多层 2D 特征压缩成 LHFeat;
- H2D 模块 :解压工具。不用简单的拉伸插值,而是用频域重建的方式,从 LHFeat 里还原出高清的 2D 密集结果。
二、三大卖点(论文自己总结的)
| 卖点 | 具体数字 |
|---|---|
| **🚀 快(Fast)** | 在 512×1024 高分辨率全景图上,ResNet-50 跑 52 FPS ,ResNet-34 跑 110 FPS,还能输出密集模态 |
| **🧰 全能(Versatile)** | 把输出空间从 O(W) 放宽到 O(HW) ,一套框架同时干布局重建 + 深度估计 + 语义分割 |
| **🎯 准(Accurate)** | 布局、分割与当时 SOTA 持平;深度估计大幅超越所有前人 |
三、整体架构:三步走
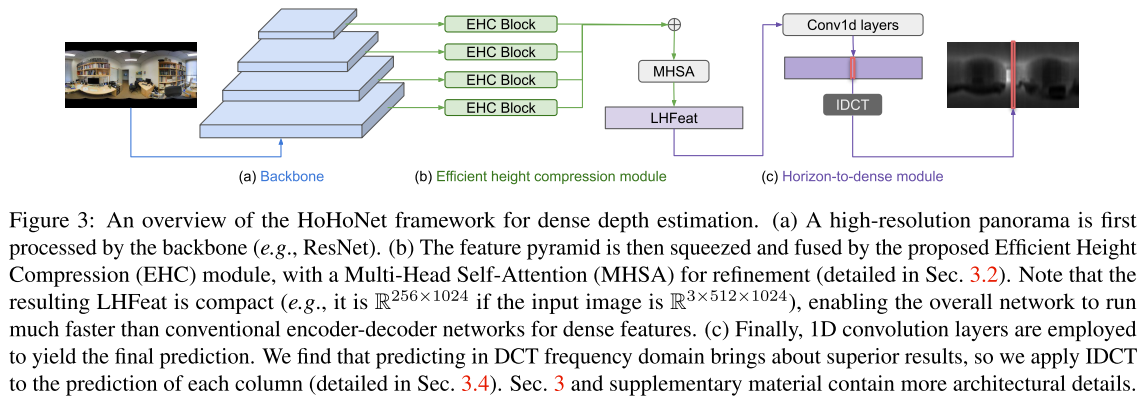
输入:512×1024 RGB 全景图(ERP)
   ↓
【第 1 步】ResNet 骨干网络 → 提取多尺度特征金字塔(4层)
   ↓
【第 2 步】EHC 模块(高效高度压缩)
        把每层 2D 特征"压扁",高度维压成 1
        → 得到 LHFeat(潜在水平特征),形状如 256×1024
   ↓
   MHSA(多头自注意力)精修 ------ 让每一列都知道全局
   ↓
【第 3 步】1D 卷积输出
   ├─ 逐列任务(布局)→ 直接出 3 条曲线,用 HorizonNet 的后处理
   └─ 逐像素任务(深度/分割)→ 过 H2D 模块,用 IDCT "解压"成 2D
   ↓
输出:布局 / 深度图 / 语义分割图
HoHoNet 整体是 "单骨干 + 单特征 + 多头输出" 的统一架构,所有任务共享同一个特征提取器,只换最后的输出头。
架构优势
- 多任务统一 :布局、深度、分割共用同一个骨干和 LHFeat,部署时只需要一个模型就能出多种结果;
- 极致轻量化 :高度维度被压缩,整个网络的计算量远小于常规的 2D 编解码网络;
- 高精度 :频域重建保证了密集任务的精度,不输甚至超过专门的 2D 网络。
四、核心创新 ①:LHFeat(潜在水平特征)
它是什么
Latent Horizontal Feature ------把 2D 特征图沿垂直方向压扁,只剩水平方向。
- 输入图像:3 × 512 × 1024
- LHFeat:256 × 1024(高度维被压成 1,通道 256)
压缩比 :高度从 512 → 1,等于砍掉了 512 倍的空间维度。
这就是为什么 HoHoNet 能跑到 110 FPS------它压根没有在 2D 特征图上做过任何昂贵的卷积运算,所有重活都在那 256×1024 的一维条带上完成。
和 HorizonNet 的关系
论文说得很坦诚:编码成 LHFeat 这个思路,是受 HorizonNet 启发的。
但 HoHoNet 做了两件 HorizonNet 没做的事:
- 重新设计架构,更快更准;
- 发明 h2d 模块,打破"只能逐列输出"的枷锁。
五、核心创新 ②:EHC 模块(高效高度压缩)
老办法(HorizonNet 的 HC block)有什么问题?
HorizonNet 用的是 HC block(Height Compression) :堆一串卷积层,逐步减少通道数和高度。
毛病:一层层卷积去压高度,太贵了。每一步都在 2D 特征图上做卷积,计算量居高不下。
EHC(Efficient Height Compression)怎么改?
三步走,招招省钱:
第 1 步:先用卷积给通道"瘦身"
把通道数降下来------这是最便宜的一步。
第 2 步:双线性上采样
把宽度统一到目标宽度 W(如果需要的话)。上采样比卷积便宜得多。
第 3 步:ConvSqueezeH------一击压扁(关键一招)
这是一个深度可分离卷积(depthwise convolution) ,它的卷积核大小被设成 (h, 1) ------正好等于输入特征的高度,且不加 padding。
结果:一次卷积,高度直接从 h 变成 1。
类比:老办法是拿剪刀一层层把纸剪短,剪 512 次;EHC 是拿一台压路机,一碾就把 512 层压成 1 层。
第 4 步:再用一个 Conv2D 块精修,把通道数转成 LHFeat 的隐维度 D,高度维直接丢弃(此时高度已经是 1 了)。
效果(消融实验铁证)
在深度估计任务上:
| 高度压缩模块 | 精修方式 | MAE ↓ | FPS ↑ |
|---|---|---|---|
| HC(HorizonNet) | 无 | 0.3090 | 49 |
| EHC | 无 | 0.3022 | 54 |
| HC | Bi-LSTM | 0.3002 | 38 |
| EHC | Bi-LSTM | 0.2928 | 41 |
| HC | MHSA | 0.2915 | 47 |
| EHC | MHSA | 0.2835 | 52 |
同一列对比,EHC 全面碾压 HC:误差更低,帧率更高。MHSA自注意力比Bi-LSTM的速度 - 精度tradeoff更优 。
六、核心创新 ③:用 MHSA 替代 Bi-LSTM
这是一个很典型的"时代更替"细节。
HorizonNet 用 Bi-LSTM 干什么?
让每一列知道"整张图发生了什么"------看到左边的墙,推断右边墙的走向。这是"全局视野"的来源。
HoHoNet 换成了什么?
MHSA(Multi-Head Self-Attention,多头自注意力)------就是 Transformer 的核心部件。
为什么换?
| Bi-LSTM | MHSA | |
|---|---|---|
| 计算方式 | 串行:一列一列扫,必须等前一列算完 | 并行:所有列同时算 |
| 速度 | 慢(是 HorizonNet 从 119 FPS 掉到 20 FPS 的元凶) | 快 |
| 长距离依赖 | 靠"记忆"传递,距离远了会衰减 | 直接两两相连,不受距离影响 |
消融实验的结果(上表最后两行):
- HC + Bi-LSTM:MAE 0.3002,38 FPS
- EHC + MHSA :MAE 0.2835,52 FPS
既更准,又快了 37%。
这是 2020---2021 年整个视觉领域的缩影:RNN 让位给 Attention。HoHoNet 是这个趋势在全景任务上的一次漂亮落地。
七、核心创新 ④:h2d 模块 + IDCT(最精彩的一招)
这是整篇论文最原创、最值得记住的部分。
7.1 问题:怎么从"一列一个数"变回"一列 512 个数"?
LHFeat 是 256×1024------每一列只有 256 个数。可深度图每一列需要 512 个像素值。
怎么办?
7.2 朴素做法:线性插值
最直接的思路:把输出的通道维当"高度"用,然后线性插值放大到 512。
**问题在哪?** 论文点得很准:
这要求浅层的 1D 卷积 去把"与行有关的信息"从"与行无关的 LHFeat"里硬拆出来。
而 LHFeat 的本质是**"行(row)被搅在一起"的** ------它在压缩时把整列的信息混成了一个向量。让几层浅浅的 Conv1D 去解开这个结,太难为它了。
7.3 HoHoNet 的解法:去频域做
既然空间域里"解不开",那就换到频率域。
作者的洞察:LHFeat 在垂直方向上是"混合"的------而混合信号最自然的分解方式,就是频率分解。于是他们请出了数据压缩领域的老将:
DCT(离散余弦变换)
DCT 你一定用过,只是不知道名字:JPEG 图片压缩、MP3 音频压缩,核心都是它。
DCT 的直觉 :任何一段信号(比如图像的一列),都可以拆成"缓慢变化的基础轮廓 + 一层层越来越细的波纹"。
- 低频分量 = 大轮廓(墙的大致形状、深度的整体趋势)
- 高频分量 = 细节(边缘、纹理、家具腿)
压缩的秘诀:丢掉高频,只留低频,肉眼几乎看不出来。
7.4 h2d 模块具体怎么做
关键反转 :不是"预测像素值再压缩",而是直接预测 DCT 系数。
设:
 :网络对某一列预测的 r 个值 (把它当成 DCT 频域里前 r 个低频系数,更高频的直接截断为 0)
 :由 r 个正交列向量组成的基矩阵(IDCT 的基)
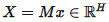 :还原出来的整列 H 个像素值
也就是说:
网络输出的 r 个数,被当作"基的线性组合权重";乘上基矩阵 M(做一次 IDCT),就还原出了整列 512 个值。
每一列都这么干一次,就把 1D 特征"解压"回了 2D 密集图。
7.5 为什么这样更好?
| 线性插值(空间域) | IDCT(频率域) | |
|---|---|---|
| 网络要学什么 | 直接学 512 个像素值 | 只学 r 个频率系数(如 64 个) |
| 难度 | 高:要凭空造出高频细节 | 低:低频系数平滑、好学 |
| 归纳偏置 | 无 | 内置:相当于告诉网络"垂直方向是平滑的、可压缩的" |
| 效果 | 较差 | 更好 |
一句话:与其让网络死记 512 个数,不如让它学 64 个"频率旋钮"------这 64 个旋钮天然对应着房间的结构节奏。
7.6 r 取多少?(消融实验)
r = 保留多少个 DCT 低频系数,是个超参数:
| r | 方法 | MAE ↓ | RMSE ↓ | δ¹ ↑ | FPS |
|---|---|---|---|---|---|
| 32 | 插值 | 0.2886 | 0.5013 | 0.8356 | 52 |
| 32 | IDCT | 0.2847 | 0.4935 | 0.8369 | 52 |
| 64 | 插值 | 0.2880 | 0.4996 | 0.8351 | 52 |
| 64 | IDCT | 0.2835 | 0.4916 | 0.8389 | 52 |
| 128 | 插值 | 0.2926 | 0.5043 | --- | --- |
| 128 | IDCT | 0.2850 | 0.4955 | --- | --- |
三条结论:
- IDCT 在所有 r 下都优于插值------无一例外;
- r = 64 是最佳值(太大反而变差:高频系数难学,还引入噪声);
- FPS 完全不变(52 FPS)------IDCT 是纯矩阵乘法,几乎不花钱。
最后这点太重要了:精度提升是白送的,速度一点没损失。
八、一套框架,三个任务
HoHoNet 的"全能"体现在:同一个 LHFeat,接不同的输出头,就能干不同的活。
| 任务 | 输出类型 | 走不走 h2d | 损失/后处理 |
|---|---|---|---|
| 布局重建 | 逐列(O(W)) | ❌ 不需要 | 直接出 3 条曲线,沿用 HorizonNet 的后处理 |
| 深度估计 | 逐像素(O(HW)) | ✅ 走 h2d | L1 损失 |
| 语义分割 | 逐像素(O(HW)) | ✅ 走 h2d | 交叉熵损失 |
注意这个设计的聪明之处 :布局本来就是逐列任务,不需要 h2d,那就别浪费计算 ;深度和分割必须逐像素,才动用 h2d。按需分配,各取所需。
九、实验结果
9.1 深度估计(最亮眼的成绩)
在 Matterport3D 上(数值越小越好):
| 方法 | MAE ↓ | RMSE ↓ | δ¹ ↑ |
|---|---|---|---|
| BiFuse(此前 SOTA) | 0.3470 | 0.6259 | 0.8452 |
| HoHoNet | 0.2862 | 0.5138 | 0.8786 |
在 Stanford2D3D 上:
|-----------------|------------|------------|------------|
| 方法 | MAE ↓ | RMSE ↓ | δ¹ ↑ |
| BiFuse(此前 SOTA) | 0.2343 | 0.4142 | 0.8660 |
| HoHoNet | 0.2027 | 0.3834 | 0.9054 |
MAE 从 0.347 降到 0.286,降幅超过 17%------论文称"大幅超越所有前人",毫不夸张。
更值得一提的是 :对手 BiFuse 用了两个骨干网络 (一个吃 ERP、一个吃 cubemap),而 HoHoNet 只用一个 ResNet-50 。更简单的架构,更好的结果。速度还快 3 倍多。
9.2 布局重建(与 SOTA 持平)
在 MatterportLayout 上:
| 方法 | 3D IoU ↑ | 2D IoU ↑ | FPS ↑ |
|---|---|---|---|
| LayoutNet v2 (ResNet-34) | 75.82 | 78.73 | 46 |
| DuLa-Net v2 (ResNet-50) | 75.05 | 78.82 | 34 |
| HorizonNet (ResNet-50) | 79.11 | 81.71 | 31 |
| AtlantaNet (ResNet-50) | 80.02 | --- | 慢 |
| **HoHoNet (ResNet-34)** | 79.88 | 82.32 | 110 |
按角点数拆开(3D IoU):
| 方法 | 整体 | 4 角 | 6 角 | 8 角 | 10+ 角 |
|---|---|---|---|---|---|
| HorizonNet | 79.11 | 81.88 | 82.26 | 71.78 | 68.32 |
| AtlantaNet | 80.02 | 82.09 | 82.08 | 75.19 | 71.61 |
| HoHoNet | 79.88 | 82.64 | 82.16 | 73.65 | 69.26 |
怎么读:
- 整体 3D IoU 79.88,略低于 AtlantaNet 的 80.02(差 0.14,基本持平);
- 但 2D IoU 82.32 是最高的(超过 AtlantaNet 的 82.09、HorizonNet 的 81.71);
- 在**简单房型(4 角)**上 HoHoNet 最强(82.64);
- 在最复杂的 8 角、10+ 角上,AtlantaNet 更强(因为它能处理斜墙)。
关键权衡 :HoHoNet 比 AtlantaNet 快 22 倍,精度只差一点点。
9.3 语义分割**(Stanford2D3D 数据集)**
|---------|-------------------|-----------|-----------|
| 分辨率 | 方法 | mIoU | mAcc |
| 低分辨率 | HexRUNet(球面专门优化) | 43.3% | 58.6% |
| 低分辨率 | HoHoNet | 40.8% | 52.1% |
| 高分辨率 | TangentImg(多透视投影) | 51.9% | 69.1% |
| 高分辨率 | HoHoNet | 56.3% | 68.9% |
核心结论:
- 低分辨率下略逊于专门做球面优化的方法,但依然有竞争力;
- 高分辨率下 mIoU 反超 4.4 个百分点,达到 SOTA 水平,证明高分辨率下 LHFeat 的信息优势更明显。
9.4 速度总览
| 骨干 | FPS(512×1024 密集模态) |
|---|---|
| ResNet-50 | 52 |
| ResNet-34 | 110 |
对比:HorizonNet 31 FPS、DuLa-Net v2 34 FPS、LayoutNet v2 46 FPS------而且这些都只干布局一件事 ,HoHoNet 是三件事一起干。
十、局限性(作者自己坦白的)
局限 1:必须"重力对齐"------这是最要命的
因为 LHFeat 是把垂直方向压扁的,它默认"垂直方向 = 重力方向"。一旦相机歪了,这个前提就破了。
论文给了明确数字:
引入 10° 的俯仰(pitch)或翻滚(roll)旋转,会把 MAE 从 28.45 厘米推高到 44 厘米以上。
而且误差随旋转角度近似线性上升。
**怎么办?** 可以用 IMU 传感器或消失点检测先做对齐------但这本身就是个额外步骤和误差源。
这正是所有"沿重力方向压缩"方法的共同原罪:用极致的效率,换来了对姿态的敏感。
局限 2:高频细节会糊
因为 h2d 模块只保留前 r=64 个低频 DCT 系数,高频被截断了。
表现:深度图的边界偏模糊,细长物体(比如落地灯的细杆、椅子的细腿)偶尔会重建失败。
这是"压缩"的必然代价,就像 JPEG 压狠了会有马赛克。
局限 3:复杂房型不如 AtlantaNet
在 8 角、10+ 角房型上略逊于 AtlantaNet------因为 HoHoNet 沿用了 HorizonNet 的曼哈顿后处理,不具备 AtlantaNet 处理斜墙、圆弧墙的能力。
局限 4:仍是"按比例"的深度
和同代方法一样,单张图测不出绝对尺度(需已知相机高度)。
和 HorizonNet 的关系
- HorizonNet 是专用布局方案:把布局任务做到了极致轻量化;
- HoHoNet 是通用全景框架:在 HorizonNet 思路的基础上,扩展到多任务,是 HorizonNet 的全面升级和泛化。
- 工业落地里,如果只需要布局,HorizonNet 足够;如果需要同时出布局、深度、分割多种结果,HoHoNet 是更优的选择。
十一、一句话总结 + 四条可迁移的思路
HoHoNet 的故事是一次"把好想法用到底"的典范:HorizonNet 发现"房间可以压成一行字",但只用它画了房间骨架;HoHoNet 追问了一句------"这一行字能不能还原出整页书?"答案是能,只要换用 IDCT 在频域里还原。结果:一个模型同时干布局、深度、分割三件事,还跑到了 110 FPS,深度估计更是大幅超越所有前人。代价是:它压得越狠,就越怕相机歪,也越容易糊掉细节。
四条可以带走的思路:
- 先问"这个表示还能干别的吗",再去做新模型。 HorizonNet 的一维表示本来只服务布局,HoHoNet 没急着造新架构,而是先问"它的边界在哪"。结果发现------补上一个解码模块,它的边界远比想象中远 。深挖一个好表示的潜力,常常比另起炉灶更划算。
- 当空间域解不开时,试试频域。 这是本篇最漂亮的思维跳跃。网络学不会"凭空造 512 个像素",但学得会"调 64 个频率旋钮"。换个坐标系,难题可能立刻变简单------这是信号处理给我们的免费礼物。
- 用"归纳偏置"替网络省力。 IDCT 基矩阵是固定的 ,不是学出来的。它等于提前告诉网络:"垂直方向是平滑、可压缩的。"能用公式写清楚的先验,直接焊进架构里,别让网络从零猜。
- 效率来自"压对地方"。 HoHoNet 快,不是因为网络小,而是因为它从不在 2D 特征图上做昂贵运算 ------先把高度压成 1,剩下的活全在一维条带上干。优化之前,先想清楚"哪里才是真正需要保留的维度"。
核心贡献总结
- 提出通用的 LHFeat 潜态水平特征框架 把 HorizonNet 针对布局任务的 1D 表示,升级成了通用的全景特征表示,从单一任务扩展到布局、深度、分割三大室内全景任务,证明了 "压缩竖直维度" 思路的普适价值。
- 发明 EHC 高效高度压缩模块 一步式高度压缩 + 多尺度融合 + 自注意力细化,比之前的 1D 特征提取方式更快、更准、并行度更高。
- 发明 Horizon-to-Dense 频域重建模块 用 IDCT 逆变换实现了从 1D 紧凑特征到 2D 密集预测的突破,解决了 1D 特征只能输出 1D 结果的瓶颈,打开了轻量化 1D 特征的应用场景。
- 速度与精度的双重突破 单骨干、单特征的轻量化架构,同时在三个核心任务上达到或超越 SOTA,速度远超同类方法,非常适合端侧、嵌入式设备的多任务部署。
📖 名词小抄
| 名词 | 大白话 |
|---|---|
| LHFeat | Latent Horizontal Feature:把 2D 特征沿垂直方向压扁后剩下的一维条带(如 256×1024) |
| EHC | Efficient Height Compression:高效高度压缩模块,一击把高度压成 1 |
| ConvSqueezeH | 核大小 = 输入高度、无 padding 的深度卷积,一次卷积把 h 压成 1 |
| MHSA | Multi-Head Self-Attention,多头自注意力(Transformer 的核心),替代 Bi-LSTM |
| h2d | horizon-to-dense:把一维水平特征还原成二维密集预测的模块 |
| DCT / IDCT | 离散余弦变换 / 反变换。JPEG 压缩的核心;把信号拆成"轮廓 + 层层细节" |
| r | 保留多少个 DCT 低频系数(论文最佳值 64);越大细节越多但越难学 |
| 基矩阵 M | IDCT 的基,形状 H×r;网络输出的 r 个数是"基的权重",乘上去就还原出整列 |
| 逐列模态 / 逐像素模态 | O(W)(每列几个数)/ O(HW)(每像素一个值) |
| ERP | Equirectangular Projection,等距柱状投影------全景图摊平后的样子 |
| MAE / RMSE / δ¹ | 深度误差指标:平均绝对误差 / 均方根误差 / 误差在 1.25 倍内的像素占比 |
| 重力对齐 | 全景图的垂直方向 = 真实重力方向;HoHoNet 的命门 |
| pitch / roll | 俯仰角 / 翻滚角,相机歪的两种方式 |
| FPS | 每秒处理多少张图(Frames Per Second) |