一、问题是怎么暴露出来的
前期在做语音情感识别时,尝试过使用 qwen-omini 方案,希望直接通过模型分析音频中的情绪信息,减少单独训练分类模型的工作量。
最开始的思路比较直接:将音频送入模型,获取情绪判断,再把结果接入后续业务流程。
真正开始验证后,发现事情没有预想的那么简单。有些音频的预测结果基本符合人工判断,但换一批录音后,结果就不够稳定。特别是一些语义相似、语气不同的语音,仅从输出结果来看,很难判断模型究竟有没有识别到声音本身的情绪变化。
继续调整原有方案之前,需要先回答一个问题:当前效果不好,到底是模型理解能力不足,还是输入音频、数据标注、情绪分类标准存在问题?
如果这个问题没有查清楚,即使换模型,也可能只是把问题转移到另一个环节。
因此,项目先暂缓原有路线,把精力转向识别流程重构。这里并不是直接认定 qwen-omini 不适合所有情感识别任务,而是现阶段的实测表现不足以支撑项目继续按原方案推进。
二、先排查流程,不急着换模型
这类问题不适合一上来就增加模型复杂度。我把排查工作拆成了几个步骤,先保证输入和评估过程没有明显问题,再决定后续采用什么模型。
1. 检查音频输入
首先统一音频格式、采样率、声道数和输入时长。
真实录音经常存在静音较长、说话声音偏小、背景噪声明显等情况。如果不同样本的输入条件不一致,最终结果就很难直接比较。
这一阶段主要检查:
-
音频是否能够正常解码,有没有空文件或异常文件。
-
是否存在大量静音,导致有效语音占比过低。
-
音频切分是否把一句话从中间截断。
-
同一批测试数据是否使用了相同的预处理规则。
如果发现部分音频异常,应先修正输入问题,而不是直接把误判归因于模型。
2. 把预测错误的样本单独整理出来
单看总体准确率,很难知道模型具体错在哪里。因此,建议把模型输出、人工标签和音频路径放到同一张表里。
例如,可以按照下面的结构记录测试结果:
| 音频编号 | 人工标签 | 预测标签 | 问题记录 |
|---|---|---|---|
| A001 | 中性 | 愤怒 | 检查音量变化及语气 |
| A002 | 愤怒 | 中性 | 检查语速、音高和背景噪声 |
| A003 | 悲伤 | 中性 | 检查有效语音长度 |
| A004 | 中性 | 中性 | 暂无明显问题 |
上表只是问题记录示例,不代表项目已经得到这些实测结果。
整理完成后,不要只挑几个明显错误的样本听一遍就结束。更合适的做法是按照错误类型分组,再抽取有代表性的音频进行复核。
例如,针对"愤怒被识别为中性"的情况,可以进一步查看:
-
人工标签是否有明确的判定依据。
-
录音中是否确实存在可辨别的情绪声学特征。
-
音频切分是否丢失了关键语气。
-
错误是否集中在某个说话人或某类录音环境。
这一步的价值在于把笼统的"模型效果差",转化为可以逐项排查的问题。
3. 统一情绪标签
情绪标注本身也容易出现分歧。
例如,一段语音听起来比较急,有人会标记为愤怒,也有人会标记为焦虑。如果没有明确的标注规则,训练数据就可能出现相同表达对应不同标签的情况。
因此,重新整理数据时,需要先确定各个情绪类别的判断标准,并对存在争议的样本进行复核。
对于仅凭声音难以判断的片段,不建议为了凑齐标签而强行分类。可以先标记为待复核,必要时排除出首轮基线测试集。
三、重构识别流程:先做声学特征基线
原方案暂缓后,新的技术路线不再把所有判断都交给一个通用模型,而是先建立独立的声学特征分类流程。
整体步骤如下:
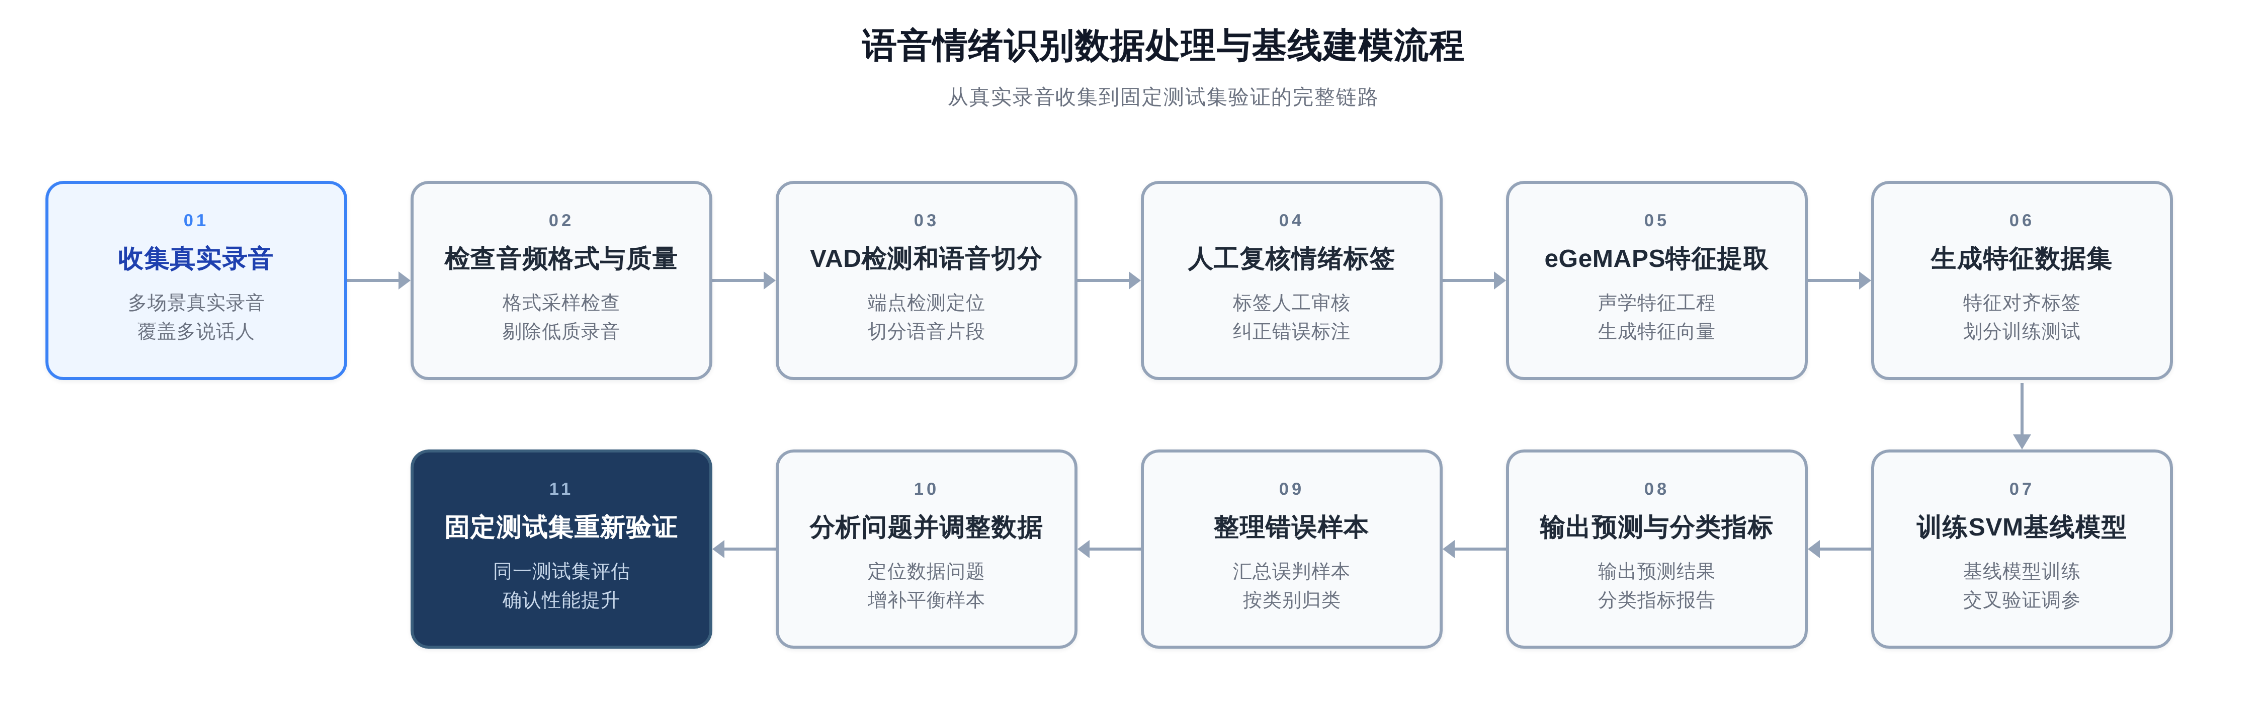
这样设计有一个实际好处:每个环节都能单独检查。即使最后分类效果不理想,也可以进一步判断是音频质量、特征表达还是分类器本身存在问题。
1. 使用 eGeMAPS 提取声音特征
eGeMAPS 是语音与情感计算中常用的一套声学特征配置,包含音高、响度、频谱和发声质量等信息。
这里先选择 eGeMAPS,不是因为它一定优于深度学习模型,而是它适合作为一个可解释的起点。特征提取后,可以直接检查数值、比较不同类别的分布,也便于与其他模型进行对照实验。
安装依赖:
pip install opensmile numpy pandas scikit-learn下面是一个可以直接改造的特征提取脚本:
from pathlib import Path

import numpy as np
import pandas as pd
import opensmile

smile = opensmile.Smile(
    feature_set=opensmile.FeatureSet.eGeMAPSv02,
    feature_level=opensmile.FeatureLevel.Functionals
)

def extract_audio_features(audio_path):
    audio_path = Path(audio_path)

    if not audio_path.exists():
        raise FileNotFoundError(audio_path)

    features = smile.process_file(str(audio_path))

    if features.empty:
        raise ValueError(f"没有提取到特征: {audio_path}")

    vector = features.iloc[0].to_numpy(dtype=np.float32)

    if not np.isfinite(vector).all():
        raise ValueError(f"特征中存在异常数值: {audio_path}")

    return vector
这里使用的是 eGeMAPSv02 的功能统计特征。实际处理长录音时,应先进行合理切分,再逐段提取,否则一个片段内混合多种情绪,可能影响后续分类。
2. 将特征和标签整理成固定数据集
建议维护一份独立的清单文件,至少记录音频路径、说话人编号、录音会话编号和情绪标签。
例如:
audio_path,speaker_id,session_id,label
data/a001.wav,S01,MEET01,neutral
data/a002.wav,S02,MEET02,angry
data/a003.wav,S03,MEET03,sad
实际标签应以人工复核结果为准,不能直接照搬示例。
整理特征时,还应保存提取失败的文件及错误原因。不要因为某些音频处理失败就直接忽略,否则不同实验之间的数据范围可能不一致。
四、建立第一版分类模型
在特征数据准备完成后,可以先用 SVM 做一个基线。它不需要特别复杂的训练流程,适合用来验证现有声学特征是否具有一定的分类能力。
以下代码假设已经准备好 X_train、X_test、y_train 和 y_test:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix

model = Pipeline([
    ("scaler", StandardScaler()),
    ("svm", SVC(
        kernel="rbf",
        C=1.0,
        class_weight="balanced",
        random_state=42
    ))
])

model.fit(X_train, y_train)

pred = model.predict(X_test)

print("分类报告:")
print(classification_report(
    y_test,
    pred,
    zero_division=0
))

print("混淆矩阵:")
print(confusion_matrix(
    y_test,
    pred,
    labels=model.classes_
))
这里有两个地方需要注意。
第一,标准化只应在训练数据上拟合,再应用到测试数据。使用 Pipeline 可以避免在数据预处理时意外泄漏测试集信息。
第二,语音数据不能简单地随机切分所有音频片段。同一个说话人可能有多段录音,如果这些片段同时出现在训练集和测试集中,模型可能学到说话人特征,而不是情绪特征。
更稳妥的做法是按照说话人或录音会话进行分组划分。样本量允许时,可以采用分组交叉验证,观察不同数据划分下结果是否稳定。
五、模型效果不好时,下一步怎么处理
完成首轮训练后,不能只看一个准确率就决定方案是否可用。
例如,总体准确率看起来不错,但如果悲伤、恐惧等类别几乎无法识别,那么对于需要细分情绪的业务,模型依然可能不合格。
建议每轮实验固定记录以下内容:
| 记录项 | 用途 |
|---|---|
| 数据版本 | 确认本轮使用了哪批音频和标签 |
| 特征配置 | 方便复现实验结果 |
| 模型参数 | 对照不同参数组合的影响 |
| Macro-F1 | 观察各类别整体表现 |
| 各类召回率 | 找出容易漏掉的情绪 |
| 误判样本清单 | 为下一轮数据修正提供依据 |
如果某个类别效果不好,可以先检查对应的样本数量、标签一致性和音频质量,再考虑增加数据或调整分类器。
后续也可以引入预训练语音模型提取 embedding,与 eGeMAPS 特征进行对照。但建议先分别测试两类特征,再测试融合方案。只有在相同测试集上取得稳定收益,融合才有意义。
另外,低置信度样本可以单独进入复核队列。需要注意,普通 SVM 的决策分数不能直接当成可靠概率;如果业务需要基于置信度设置阈值,应使用独立验证数据进行校准。
六、阶段性结论
这次方案调整的出发点,是原有 qwen-omini 情感识别方案的实测效果不足以支持项目继续推进。因此,项目暂缓原路线,转向更容易定位问题的声学特征分类流程。
新的流程先检查音频和标签,再提取 eGeMAPS 特征,使用 SVM 建立基线,最后通过分类报告、混淆矩阵和人工复核定位误判原因。
这套流程并不意味着传统模型一定比大模型准确,而是让每一轮实验都有明确的输入、输出和判断依据。后续是否重新引入大模型、预训练语音模型或特征融合,应以统一测试集上的结果为准。
对于熙瑾会悟这类涉及会议语音分析的应用,情感识别也不宜脱离语音转写、说话人信息和录音质量单独评价。只有先把数据和验证流程稳定下来,模型升级才有可靠的比较基础。