你有没有遇到过这种情况:Demo 跑得好好的语音助手,一上生产就被人吐槽"反应太慢";你翻遍模型规格表,每个都说自己"低延迟",但真到用户盯着屏幕等回复的时候,谁快谁慢你心里根本没底。
更麻烦的是,这种等待是没法靠猜的。你挑了三四个模型,文档都说自己快,但没人告诉你:在你实际用的提示词长度下,谁真的能一秒内开口?谁在你把文档从 500 字加到 10,000 字之后会突然变慢?谁平时看着正常,却偶尔卡上十几秒让用户以为你的产品挂了?
这些恰恰是选型时最该知道的事。但市面上没有一个简单、公开的答案。
所以这次我们直接把它测了出来:DigitalOcean 无服务器推理上的六个模型,包括 Gemma 4、GLM-5.3、Kimi K2.6、DeepSeek V3.2、DeepSeek V4.1 Flash 和 Llama 4 Maverick。每个模型分别测试三种提示词长度,总计进行了 380 次调用。所有请求都经过特殊处理,以确保不会命中提示缓存。此外,我们还针对其中一个模型进行了额外测试,专门观察它在最苛刻输入条件下的响应表现。
不管你是正准备选模型,还是已经上线但心里没底,或是正准备使用 DigitalOcean 无服务器推理但不知怎么选模型,下面这些测试数据与测试方法应该都能帮你少踩几个坑。
如果你看过之后还是不知道该怎么选模型,或不知是否该从自己部署大模型迁移到无服务器推理,也可直接与 DigitalOcean 中国区战略合作伙伴卓普云(aidroplet.com)的技术团队聊一聊。
TTFT 为什么才是关键
首 Token 延迟(Time to First Token,TTFT)并不等于总响应时间。
一个模型可能需要两秒才开始输出,但开始之后能迅速流式生成完整答案。在这项测试中,它不应该因此被判定为响应慢。反过来,如果一个模型开始输出后速度很快,却让用户等了五秒才看到第一个字,那么对用户而言,它的响应就是慢的。因为这五秒,才是用户实际感受到的等待时间。
对于聊天机器人、语音交互界面,以及需要给用户即时反馈的 AI Agent 等交互式应用,TTFT 是衡量响应体验的重要指标。它很大程度上决定了产品给人的感觉究竟是"反应灵敏",还是"卡住了"。
我们测了什么
我们选了六个模型,是为了覆盖不同规格,而不是图方便:Gemma 4(小体积,本应很快)、GLM-5.3(推理始终开启,关不掉)、Kimi K2.6(这组里最大的模型,一万亿参数)、DeepSeek V3.2、DeepSeek V4.1 Flash,以及 Llama 4 Maverick。
每个模型都接受三种长度的提示词测试:
- 短提示词:一个简单问题,约 20--50 Token。
- 中等长度提示词:约 500 Token,包含一段文本摘录和一个摘要请求。
- 长提示词:约 5,000--10,000 Token,包含更长的文本摘录和一个问题。
每种模型与提示词长度的组合重复测试 20 次。此外,我们还对 DeepSeek V3.2 进行了 20 次额外测试,将输入精确控制在 10,000 Token,并使用模型自己的 Tokenizer 计算 Token 数量,而不是根据字符数估算。由于这是整组测试中输入负载最大的场景,我们专门对它进行了更深入的观察。
全部测试共进行了 380 次调用。
这些测试跑在 DigitalOcean 的 Tier 1 定价档上,也就是任何新账户起步时的默认档位。
为了确保测试结果不受提示缓存影响,我们在每条提示词开头都添加了随机生成的唯一标记。原因在于,DigitalOcean 的提示缓存会根据完全一致的前缀进行匹配。缓存命中后,请求可能会非常快地返回,但这种速度并不能真实反映模型的推理服务性能。
如果不确保每次请求的文本都是全新的,重复发送的短问题最终可能命中缓存,让测得的 TTFT 看起来比实际情况更好。因此,这组数据中的每次调用都经过处理,确保请求不会命中提示缓存。
测量脚本里曾出现的一个 bug
第一次完整运行测试时,390 条记录中有 127 条没有记录到 TTFT。程序没有报错,只是没有留下任何延迟数据。
问题出在部分模型会输出两类文本:一类是模型的内部推理内容,另一类才是最终答案。Kimi K2.6 和 DeepSeek V4.1 Flash 总是先输出推理内容;GLM-5.3 在处理较长提示词时也会如此。但最初的测试脚本只监测最终答案,完全忽略了推理内容。
测试还将每次调用的输出限制在 50 个 Token,因为答案最终有多长,并不影响第一个 Token 出现的时间。问题恰恰出在这个限制上:有些模型把全部输出预算都用在了推理过程上,还没来得及生成最终答案,输出额度就已经耗尽了。由于脚本只监测答案文本,自然就没有记录到任何内容。
修复方法是同时检查推理内容和答案内容,并记录最先出现的 Token。修复后,受影响的 140 次调用重新运行,所有记录都成功获得了延迟数据。
这里有一个值得注意的细节:如果你测试的是带有显式推理输出的模型,却只监测最终答案流,就可能完全得不到 TTFT 数据;即使测到了,记录的也可能是"推理结束后到首个答案 Token 出现的时间",而不是通常所说的首 Token 延迟。这两个指标并不相同,后者也无法准确反映用户最初的等待体验。
测量背后的代码
这次测试中有三段关键代码,决定了测量结果是否可靠。直接展示它们很有必要,因为测试方法是否可信,最终取决于代码是否真正实现了它所声称的功能。
首先,要获得真实的、未命中缓存的 TTFT 数据,就必须确保每条提示词对模型而言都是新的,而不是重复请求导致缓存命中。解决方法是在每条提示词开头添加随机标记:
ini
import uuid

session_marker = str(uuid.uuid4())
full_prompt = f"[session:{session_marker}]\n{prompt_text}"
正确地为第一个 Token 计时,是拿到真实数据的另一半。下面的代码在请求发出前启动计时器,然后逐块流式接收响应,在第一段真实内容出现的精确时刻打上时间戳。第一个时间戳之后的一切对 TTFT 都不重要,重要的只是在任何东西出现之前等了多久:
ini
import time

start_time = time.perf_counter()
first_token_time = None

stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": full_prompt}],
    stream=True,
    max_tokens=50,
)

for chunk in stream:
    if chunk.choices:
        delta = chunk.choices[0].delta
        content_piece = getattr(delta, "content", None) or getattr(delta, "reasoning_content", None)
        if content_piece and first_token_time is None:
            first_token_time = time.perf_counter()

ttft = first_token_time - start_time其中,getattr(delta, "content", None) or getattr(delta, "reasoning_content", None) 这一行,正是前面提到的 Bug 的修复方案。
如果只检查 content,就会漏掉那些先通过独立字段输出推理内容的模型。同时检查这两个字段,并以最先出现的内容为准,才能更准确地测量首 Token 延迟。
最后一段代码解决的是一个更具体的问题:如何让 DeepSeek V3.2 的输入提示词精确达到 10,000 Token,而不是只得到一个大致的长度。
它会逐句截取原始文本,并在每次调整后使用模型自己的 Tokenizer 计算 Token 数量,通过不断缩小搜索范围,找到最接近 10,000 Token 的截断位置。
ini
low, high = 1, len(sentences)
best_text, best_count, best_diff = None, None, float("inf")

while low <= high:
    mid = (low + high) // 2
    candidate_text = " ".join(sentences[:mid]) + question_suffix
    tok_count = count_tokens(candidate_text, "deepseek-3.2")
    diff = abs(tok_count - 10000)

    if diff < best_diff:
        best_text, best_count, best_diff = candidate_text, tok_count, diff

    if tok_count < 10000:
        low = mid + 1
    elif tok_count > 10000:
        high = mid - 1
    else:
        break
这是一种标准的二分查找算法,只不过搜索对象不是排好序的列表,而是句子的数量。它可以在较少的步骤内找到合适的截断位置,不需要人工反复裁剪文本、估算长度,再逐次检查结果。
测试数据说明了什么
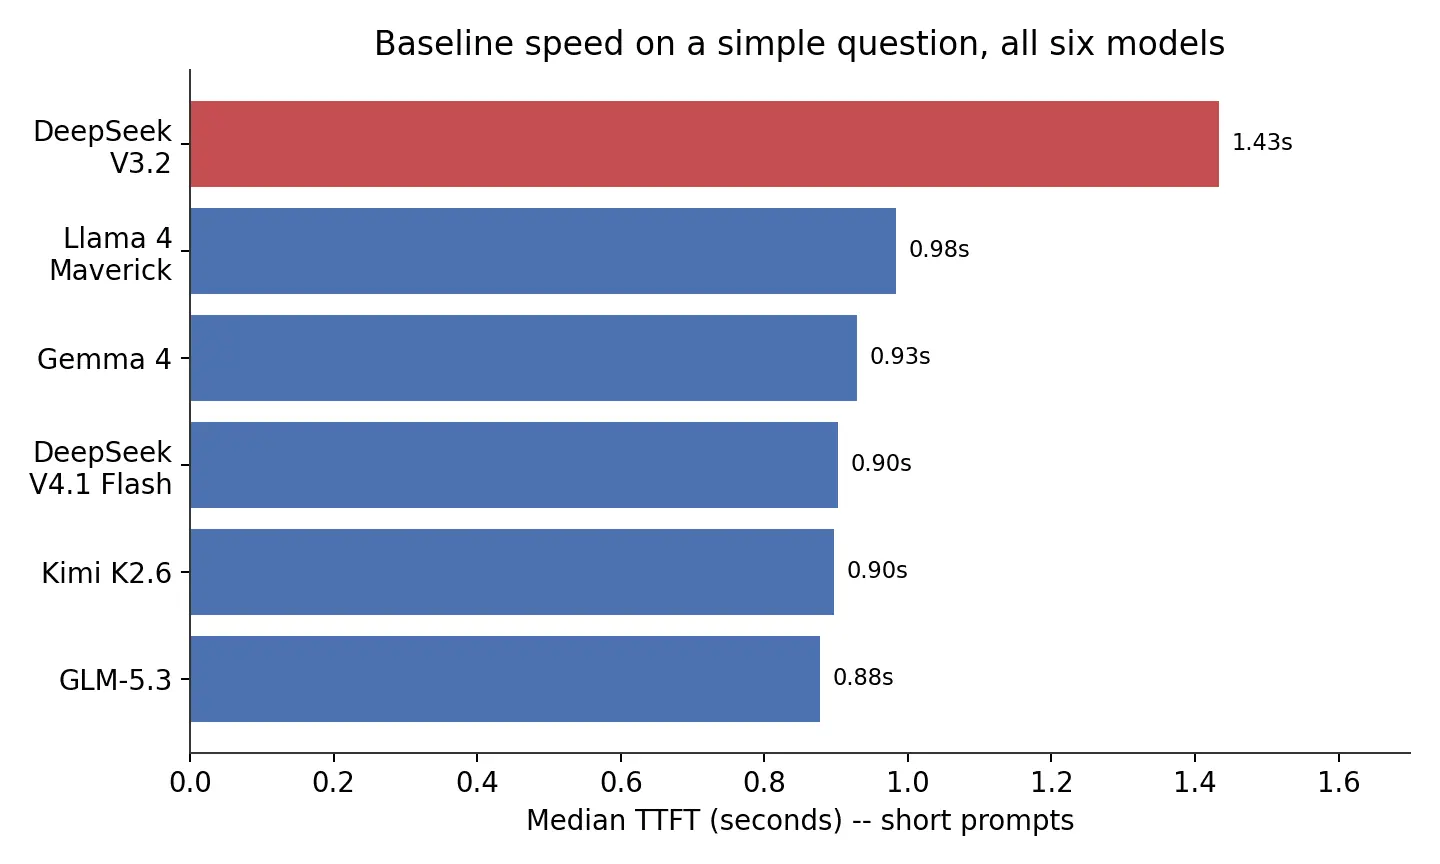
在短提示词上,六个模型里有五个靠得很近:GLM-5.3 中位数 0.88 秒,Kimi K2.6 是 0.90,DeepSeek V4.1 Flash 是 0.90,Gemma 4 是 0.93,Llama 4 Maverick 是 0.98。对于一个简单问题,这些模型大多能每次都在一秒内作答。
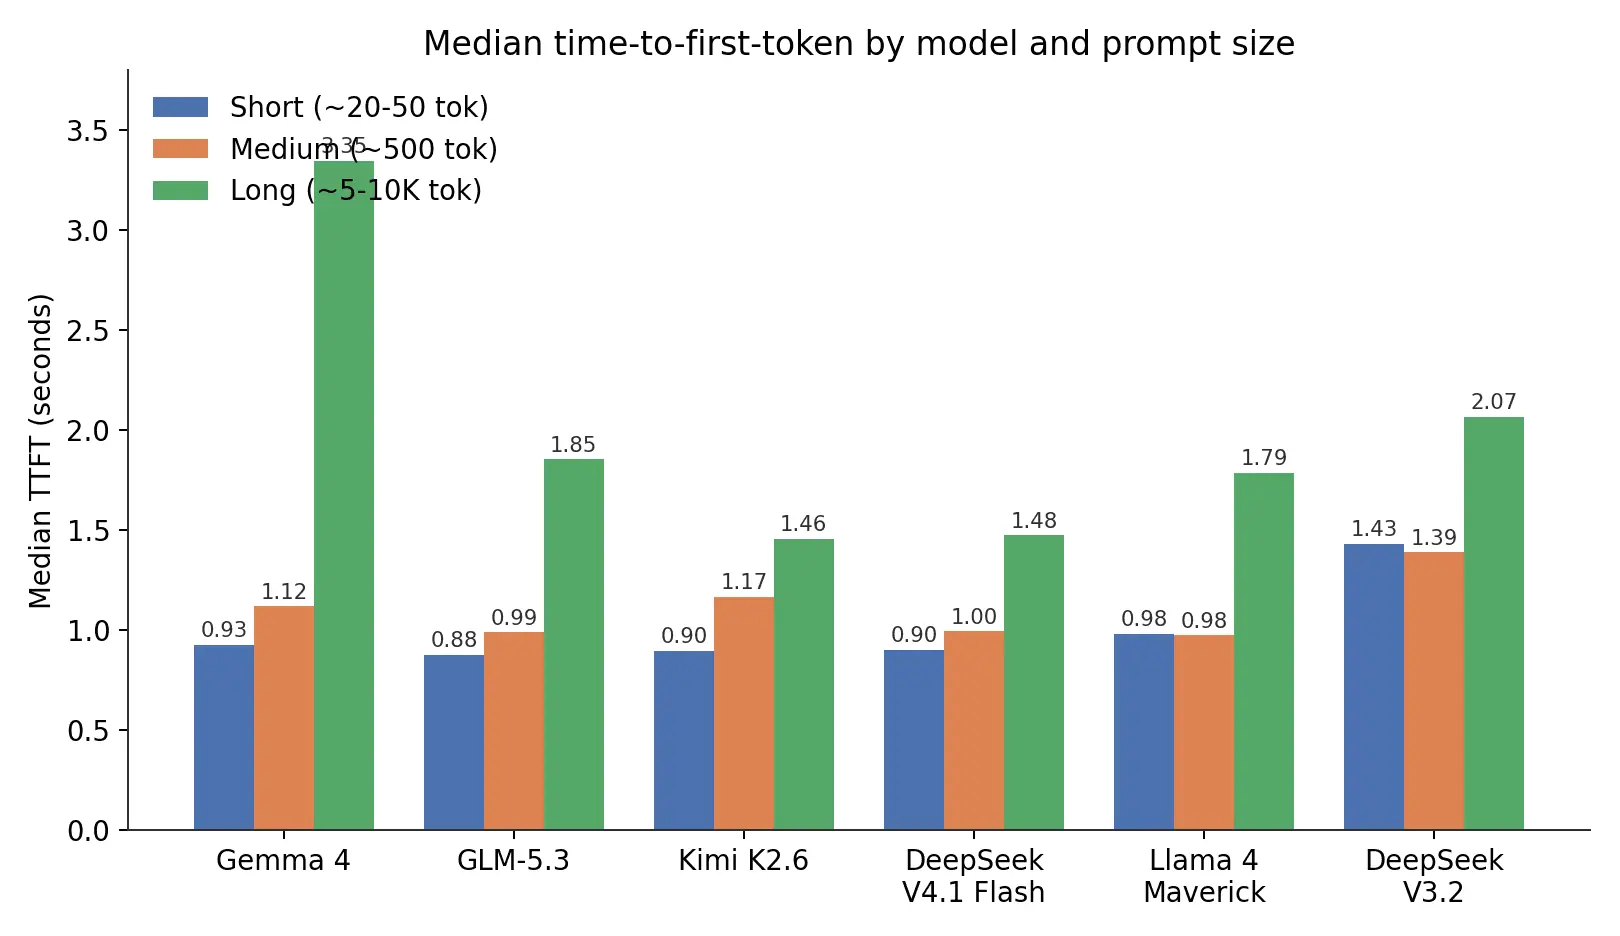
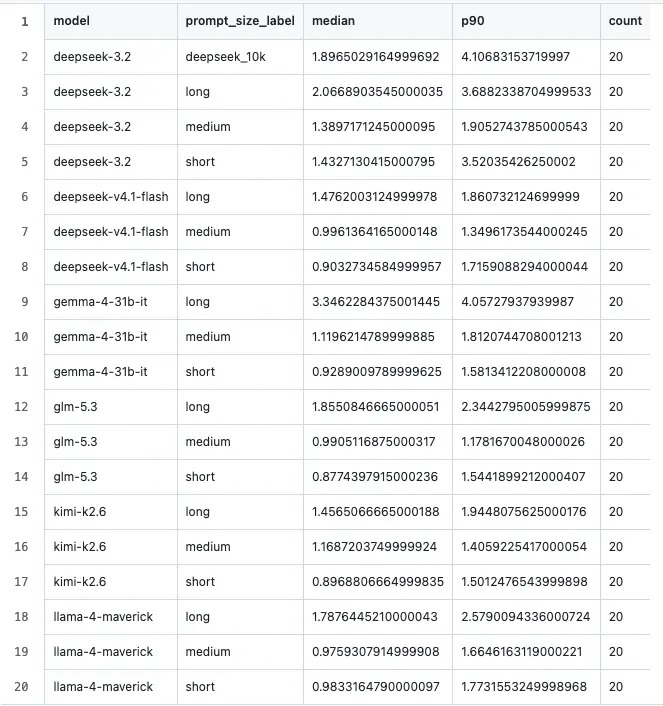
DeepSeek V3.2 的整体表现则稍慢一些。短提示词下,它的 TTFT 中位数为 1.43 秒;当输入增加到 10,000 Token 时,中位数上升至 1.9 秒,P90(第 90 百分位数)达到 4.1 秒。
对于大型模型处理长而密集的提示词来说,这样的延迟并非完全不可接受。但如果你的应用要求该模型在这类输入规模下也能稳定地实现亚秒级响应,就必须提前了解这一点。
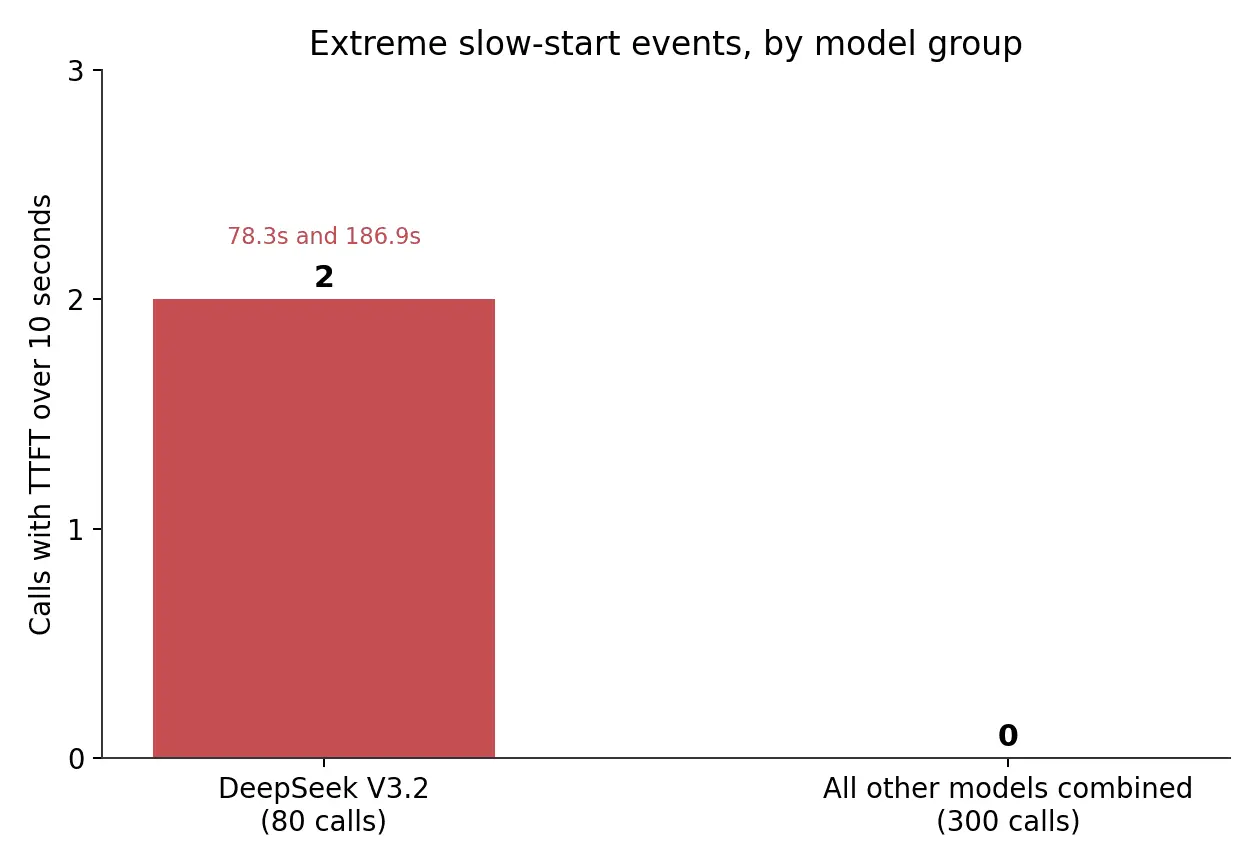
更值得关注的,是我们对 DeepSeek V3.2 的全部 80 次调用进行排查后发现的异常情况。
其中有两次请求明显偏慢:一次等待了 186.9 秒才收到第一个 Token,另一次则等待了 78.3 秒。值得注意的是,一旦开始输出,这两次请求都能正常生成答案;对于输出上限为 50 个 Token 的回复,生成过程大约只用了 4 秒。也就是说,主要延迟发生在模型开始输出之前,而不是生成答案的过程中。
我们还检查了相同时间段内其他模型的表现,没有发现类似情况。在另外五个模型的 300 次调用中,没有一次请求的 TTFT 接近 10 秒。
80 次调用中出现了两次异常漫长的等待,而且都发生在同一个模型上。这个结果不足以说明模型存在固定比例的故障,但在构建依赖快速响应的交互式应用之前,确实值得留意。
另一个值得关注的发现与 Gemma 4 有关。我们选择它作为体量较小、理论上响应较快的基线模型,但随着提示词变长,它的响应延迟反而出现了最大的增长。
Gemma 4 在短提示词下的 TTFT 中位数为 0.93 秒,长提示词下则升至 3.35 秒,是所有受测模型中增幅最大的。相比之下,其他模型在长提示词下的 TTFT 中位数都低于 2.1 秒。
这说明,模型参数规模并不能单独决定它处理长提示词时的响应表现。 如果你的应用经常需要输入大量上下文,仅凭模型大小或短提示词测试结果来判断响应速度,很可能得出错误的结论。
这组测试无法看出来的是?
首先,测试只使用了一个 DigitalOcean 账户,采用前面介绍的默认 Tier 1 配置,并在 2026 年 9 月某一天的约 10 分钟内完成。
DeepSeek V3.2 的 80 次调用中出现了两次异常漫长的等待,这是实际观察到的结果,但不能直接将其当作模型的故障率。由于样本数量有限,我们没有足够依据断言它会在固定比例的请求中出现问题。
更严谨的说法是:在这次测试中,DeepSeek V3.2 出现了两次长时间等待,而其他受测模型没有出现类似情况。
其次,这些数据只反映了特定时间点的表现。推理服务的容量和请求路由都可能发生变化,因此,即使使用相同的方法,下周重新测试也可能得到不同的结果。
本次测试使用的数据、脚本和完整提示词都是公开的。任何拥有 DigitalOcean 账户的人,都可以按照相同的方法重复测试,观察自己得到的结果。
对实际选型有什么参考价值?
在这组测试中,大多数模型处理短、中等长度提示词时,都能比较稳定地在一秒内返回首 Token。如果你正在使用这些模型构建对延迟敏感的应用,这是一个积极的信号。
不过,有两点值得纳入实际的系统设计。
第一,DeepSeek V3.2 偶尔可能出现远超典型水平的首 Token 延迟。如果你用它来处理聊天、语音交互等需要及时反馈的任务,就应该考虑设置超时机制和备用模型,避免个别请求长时间没有响应。
第二,不要想当然地认为小模型一定更快,或者一定能在长提示词下保持速度优势。Gemma 4 的测试结果就说明,模型在短提示词下的表现,并不能直接预测它处理长上下文时的表现。
如果你正在使用无服务器推理构建需要实时反馈的应用,选型时不应该只看模型宣传的性能指标。更可靠的做法是:在正式投入生产之前,使用真实业务中的提示词长度和请求模式,针对候选模型进行实际测试。
想在自己的模型和提示词长度下复现这次测试?你可以在 DigitalOcean 账户中运行相同的测试流程,并将结果与本文的数据进行比较。可以先参考无服务器推理快速入门指南,再使用本次测试公开的脚本和原始数据作为起点。
本文提到的全部脚本、提示词和原始测试结果,都可以在 GitHub 仓库中找到:github.com/smukherjee1do/ttft-audit