大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
上个月有个做企业知识库的朋友找我,说他的向量检索"能跑,但就是跑不对"。问答返回的结果,总差一口气,明明库里有正确的文档,它就是排不上来。我让他把整条链路从文档切分开始,一步步走一遍。他自己也承认,当时图快,切分那步直接按固定字数切了,检索效果也就没再测过。
向量检索,是把文本、图片这类内容转成高维向量,再用距离或夹角,找出与查询最接近的K条结果。它查的是"意思像不像",不是"字面对不对"。这篇不讲概念综述,只做一件事:用一个最小可运行的示例,把从文档切分到TopK的完整链路跑通,再把参数和评测补上。看完你能自己复现一遍。
一、先把整条链路摊开
很多人一上手就直奔"选哪个向量库""哪个索引快",其实向量检索落地,链路是这样的:
text
原始文档 → 文档切分(chunk) → 向量化(Embedding) → 写入并建索引
        → 查询向量化 → 相似度检索+标量过滤 → TopK →(可选)重排
每一步都能单独让结果变差。切分决定"一段向量里塞了多少意思",Embedding决定"意思有没有被表达对",索引和参数决定"该召回的被没被捞到"。链路里缺一步,后面怎么调都补不回来。
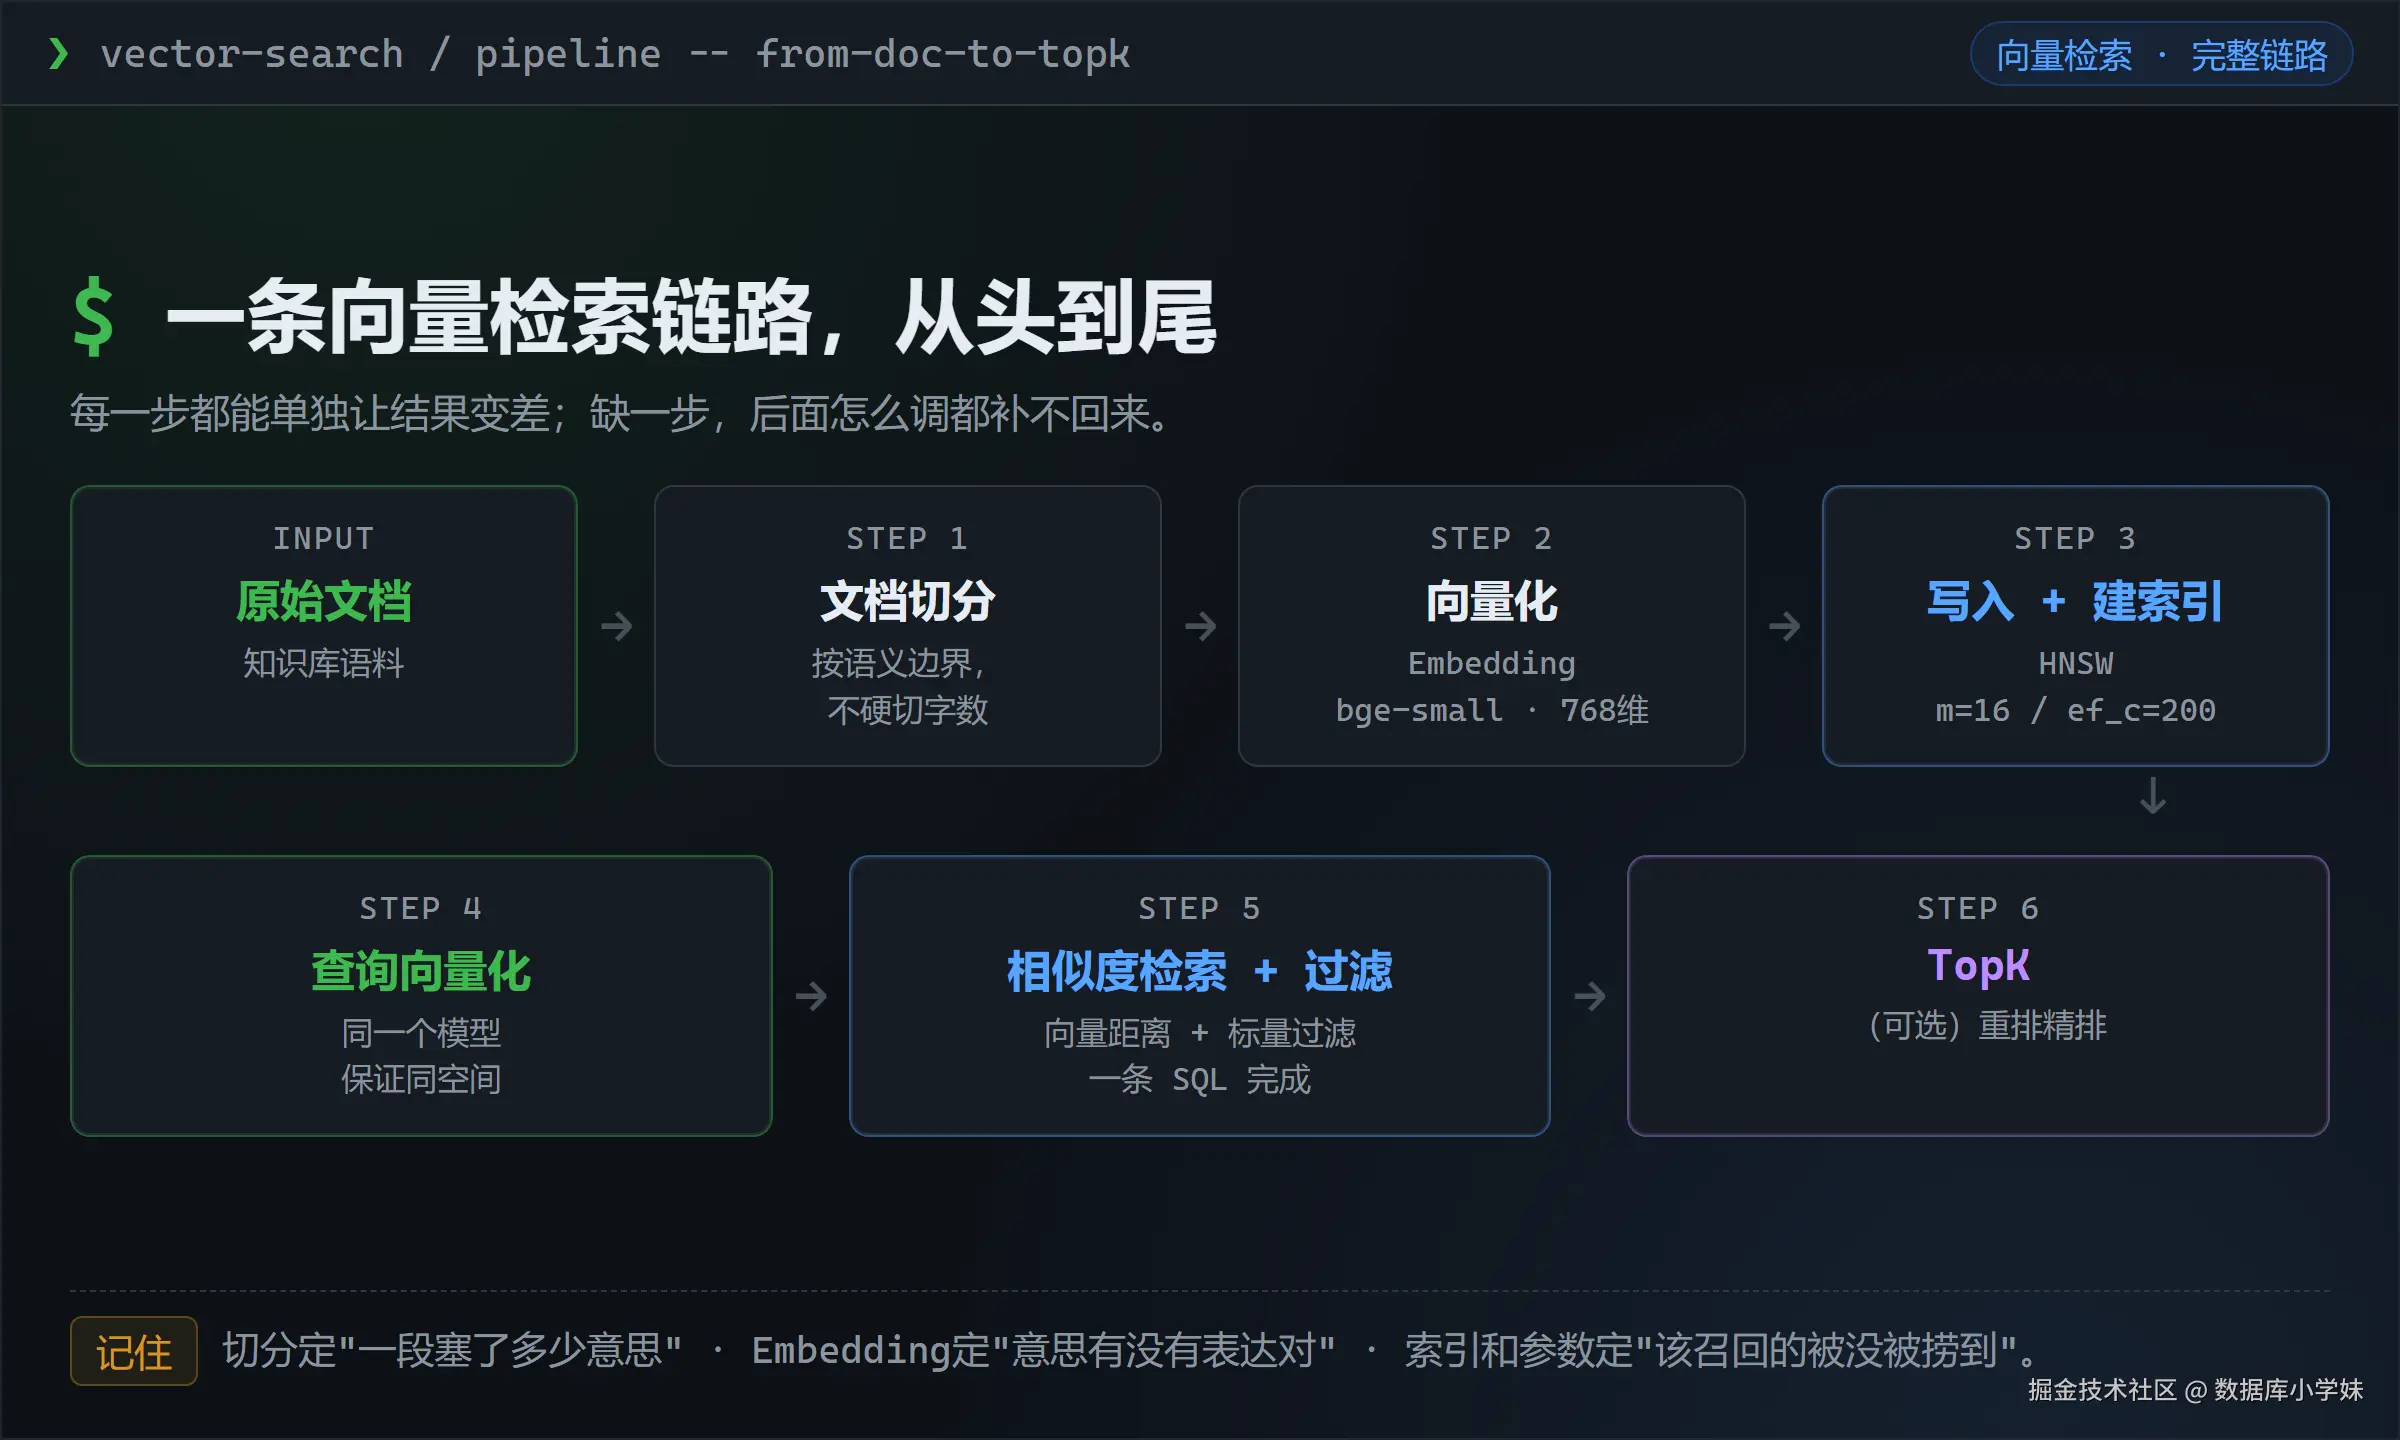 图1 一条向量检索链路的完整走向:从原始文档到 TopK
二、精确检索和近似检索,先分清
在动手之前,先分清一件事:你接下来要建的索引,是精确KNN还是近似ANN。这决定了后面所有参数的调法。很多人把这俩混着讲,参数就调歪了。
| 对比维度 | 精确检索(暴力KNN) | 近似检索(ANN) |
|---|---|---|
| 原理 | 逐个比对全部向量 | 用索引先缩小候选集再算距离 |
| 召回率 | 100% | 通常95%以上,可用参数调 |
| 时间复杂度 | 随数据量线性增长 | 亚线性,规模越大优势越明显 |
| 典型适用 | 十万级以内、精度基准 | 百万级以上生产检索 |
向量检索的生产环境,绝大多数走的是ANN这条路。原因很简单:百万条128维向量如果全量比对,一次查询就是上亿次浮点运算,延迟压不住。ANN用"牺牲一点点召回率,换大幅提速"的思路,把这件事变得可行。所以你后面看到的所有调参,本质都是在召回率和延迟之间找那个平衡点。
下面对应的最小示例,索引这一层用的就是ANN。
三、把示例跑起来:五段代码
环境说明:Python 3.10,Embedding用本地模型(示例用bge-small,768维),向量库以KES(KingbaseES V9)为例,它在关系引擎里直接带向量类型和向量索引,建表和查询走SQL就行,省掉一套独立向量库的运维。换其他向量库,SQL语法改一改,链路是一样的。
第1步,切分。 这一步别用固定字数硬切。
python
from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,          # 单块目标长度
    chunk_overlap=80,        # 相邻块重叠,避免语义被切断
    separators=["\n\n", "\n", "。", "!", "?", ";", " "]
)
chunks = splitter.split_text(open("kb.txt", encoding="utf-8").read())切分的关键不是chunk_size填多少,而是优先按语义边界(段落、句号)切,切不动了再退到字符。文档是问答对、是技术规范、还是政策文件,合理切法不一样。
第2步,生成向量。
python
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")

vectors = model.encode(chunks, normalize_embeddings=True) # 归一化后可用内积normalize_embeddings=True这行别省。向量归一化之后,余弦相似度和内积等价,后面索引选择会更灵活。
第3步,建表并建向量索引。 这是KES里的写法:
sql
CREATE TABLE kb_chunks (
    id         BIGSERIAL PRIMARY KEY,
    doc_id     BIGINT,
    category   VARCHAR(32),
    is_active  BOOLEAN DEFAULT TRUE,
    content    TEXT,
    embedding  VECTOR(768)
);

-- 建HNSW向量索引,指定距离度量
CREATE INDEX idx_kb_embedding ON kb_chunks
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 200);
维度提醒:这里用的768维模型没问题,但KES的向量索引维度受8K数据页限制,FP32向量最高支持2000维,FP16最高4000维。模型输出超过这个维度,索引建不起来(表里存储不受影响),选模型前先确认维度。
向量索引和普通B+树索引可以共存,标量字段(category、is_active)照样能建普通索引。
第4步,写入。
python
import psycopg2, numpy as np
conn = psycopg2.connect(dsn)   # 连接KES;dsn 形如 "host=xxx port=54321 dbname=xxx user=xxx password=xxx"
cur = conn.cursor()
for chunk, vec in zip(chunks, vectors):
    cur.execute(
        "INSERT INTO kb_chunks (doc_id, category, content, embedding) "
        "VALUES (%s, %s, %s, %s)",
        (doc_id, category, chunk, np.array(vec).tolist())
    )
conn.commit()
第5步,查询。 把向量检索和标量过滤放在一条SQL里。
sql
SELECT id, content,
       1 - (embedding <=> :query_vec) AS similarity
FROM kb_chunks
WHERE is_active = TRUE
  AND category = 'product'
ORDER BY embedding <=> :query_vec
LIMIT 10;注意WHERE里的标量过滤和ORDER BY里的向量距离,是在同一个执行计划里完成的。这就是关系库带向量能力的好处:过滤条件不必事后在应用层筛。如果向量和业务数据分在两个库里,你得先从向量库召回Top-K,再回业务库查有效性和分类,两次往返再加一次应用层拼装,过滤条件越苛刻,越容易凑不满K条。
四、参数不是拍脑袋:HNSW三个参数怎么调
示例里的m=16, ef_construction=200不是随手写的。HNSW有三个参数最影响效果,调之前得分清各自管什么。
| 参数 | 作用 | 调大 | 调小 |
|---|---|---|---|
| M | 每个节点的邻居数 | 召回率更高、内存占用更大 | 省内存、召回下降 |
| ef_construction | 建索引时的候选池 | 索引质量更好、建索引更慢 | 建得快、质量下降 |
| ef_search | 查询时的候选池 | 召回率高、延迟上升 | 快、可能漏召回 |
经验取值:M一般16到48,从16起,召回不够再加;ef_construction默认64,常用范围200到500,追求更高的索引质量可以调到400以上(示例里的200是偏质量优先的选择);ef_search最灵活,它可以在查询时临时调,想提召回就调大,对延迟敏感就调小,不用重建索引。这三个参数的取舍逻辑,和数据库里"索引建多密"是一回事,够用就行,堆满只是给自己加成本。
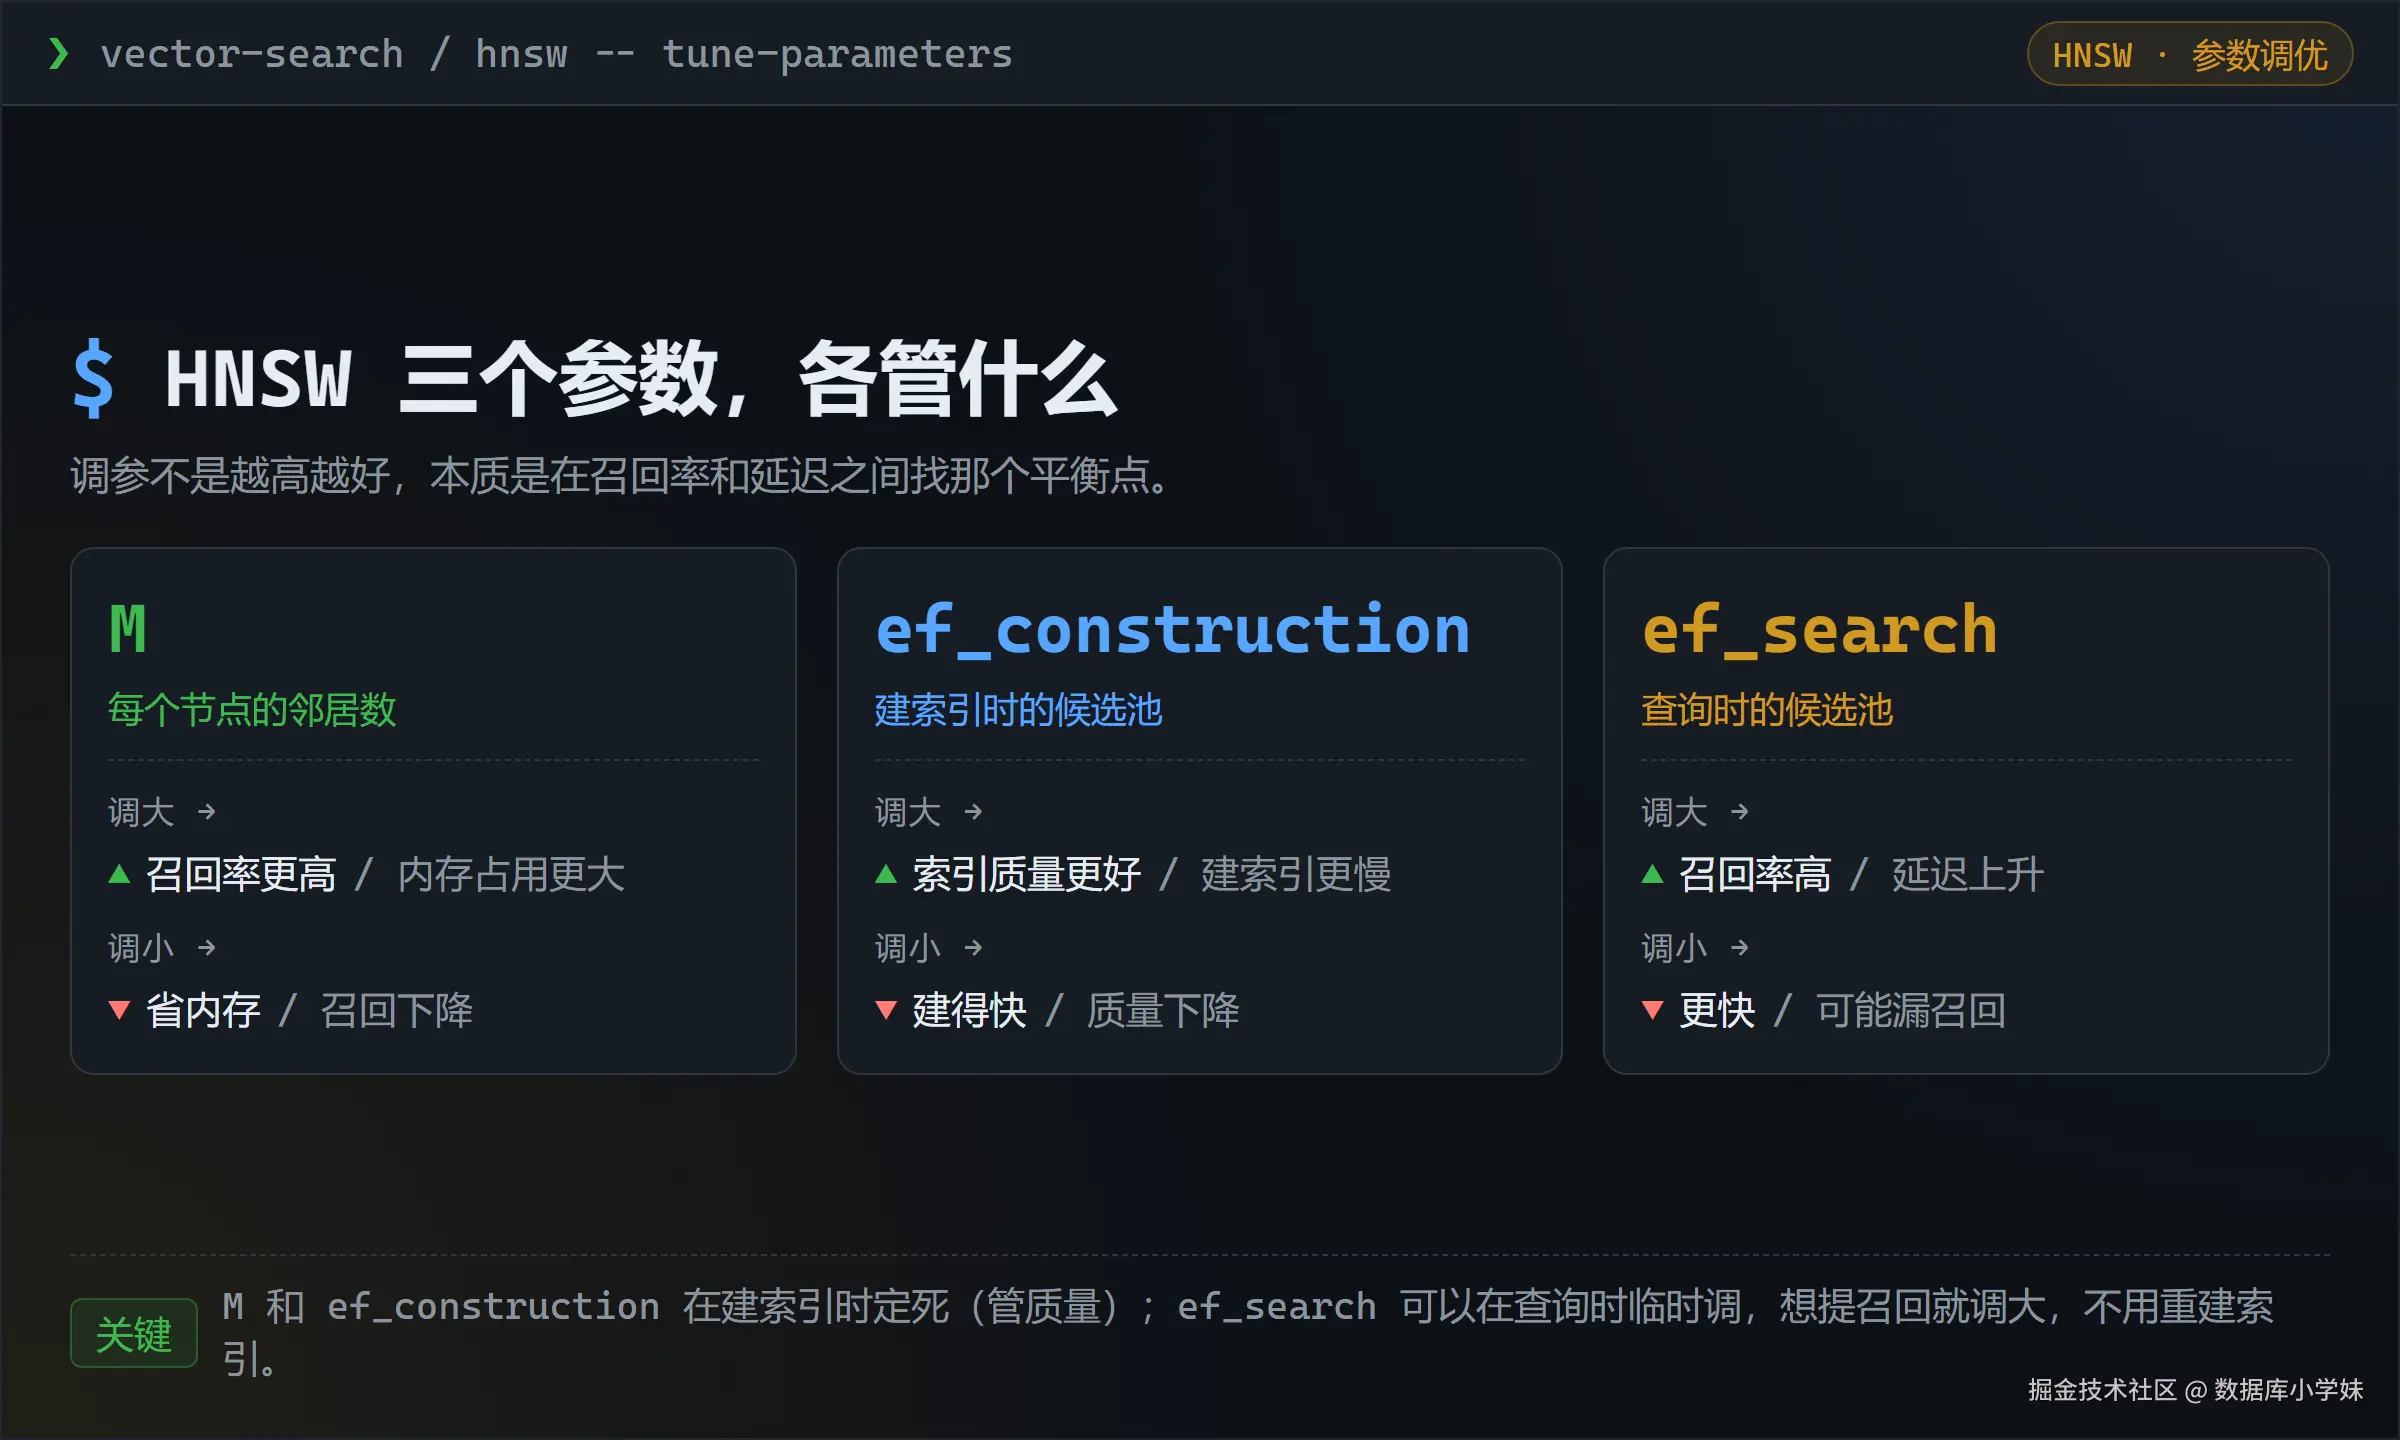 图2 HNSW 三个参数各管什么:M 和 ef_construction 定索引质量,ef_search 管查询
五、怎么证明"检索对了":召回率和延迟一起看
参数调完,得有个东西告诉你结果变好还是变差。固定一批测试集,用召回率和延迟两个指标,别靠感觉。
评测的做法:准备N条查询,先用精确KNN(暴力检索)跑一遍,把它的结果当成标准答案(ground truth),再拿ANN的结果跟它比对,看正确答案有没有落在返回的K条里,算出Recall@K;同时记录P50、P95延迟。
下面这组数据参考自金仓官方在固定环境下的测试,测试条件一并列出,方便你对照:
测试环境:4核8G服务器,SIFT-1M数据集(100万条128维向量),HNSW参数M=16、ef_construction=200。(来源:金仓官方技术博客)
补一句前提:SIFT-1M是图像特征数据集,用在这里只当作HNSW索引性能的基准参考。中文文本场景的实际召回率,得拿自己的语料重新评测。
| 指标 | 结果 |
|---|---|
| 召回率 | 95%以上 |
| 查询响应时间 | 稳定在50ms以内 |
| 索引与标量过滤组合查询 | 一条SQL完成 |
这里补一句:这组数字来自特定数据集和特定硬件,你换套数据、换个维度,结果未必一样。真要下结论,就用自己的数据、带上真实的过滤条件跑一遍。生产查询几乎都带部门、租户、时间这类条件,纯向量的干净测试说明不了问题,数字再漂亮也不作数。
知道了怎么评测,接下来聊几个动手前就容易踩的坑。
六、避坑清单
链路跑通了、指标也测过了,但这几处坑我见得太多次,趁热说清楚,省得你回头返工。
第一,别跳过切分评测。切太大,一段向量混了好几个意思,检索就模糊;切太小,一句话被拆开,语义也散了。切分策略要和你的文档类型绑着调,不是设一个固定值就完事。
第二,别拿干净数据集下结论。ANN-Benchmarks这类公开基准面向算法库对比,数据集偏旧、用例偏简单,能看趋势,不能当生产结论。要测就带真实过滤条件和并发模式测分位数延迟。
第三,这条是我自己踩的。我第一次建向量索引,为了追求召回率把ef_construction拉到了800,结果建索引等了快两个小时,事后才知道,这个参数只影响建索引阶段,和查询召回不直接挂钩,真正该调的是ef_search。建索引慢,白白占了我一个下午。
坑说完了,回头还是那个老问题:索引到底该怎么选。下面这张表,按你的数据规模和更新频率给个方向。
七、按规模选索引:一个简单的决策框架
| 数据规模 | 向量维度 | 更新频率 | 索引倾向 |
|---|---|---|---|
| 十万级以内 | 任意 | 任意 | 精确检索够用,先别上ANN |
| 百万到千万级 | 512-1024 | 较低 | HNSW,重召回率 |
| 百万到千万级 | 512-1024 | 很高 | IVF_Flat,重写入吞吐 |
| 亿级及以上 | 高维 | 低 | 图索引+量化正交 |
索引没有"更强的",只有"更合适的"。数据更新频繁就别死磕需要频繁重建的索引,查询对延迟敏感就别只盯召回率。
八、小结
向量检索落地,"能跑"和"跑得对"之间,隔着切分、参数、评测三件事。补上这三件,检索质量才站得住。
我跑完这一圈,最大的感受是:向量要和业务数据一起过滤、排序时,用关系库自带的向量能力(比如KES Vector)最省事,一条SQL就完事,不用在两个库之间倒数据。信创项目里,飞腾、鲲鹏、海光、龙芯这些芯片,统信、麒麟这些系统,适配也是现成的。
你在做向量检索的时候,卡在切分、参数还是评测?评论区聊聊,让后来的人少走一段。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋