(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/DZRng)!
论文标题:FastJEV: Understanding Redundancy for Compact JEV Inference
论文作者:厦门大学,Jie Ma、Xiaoshuai Sun等
发表时间:2026年10月8日
目录
本文要点
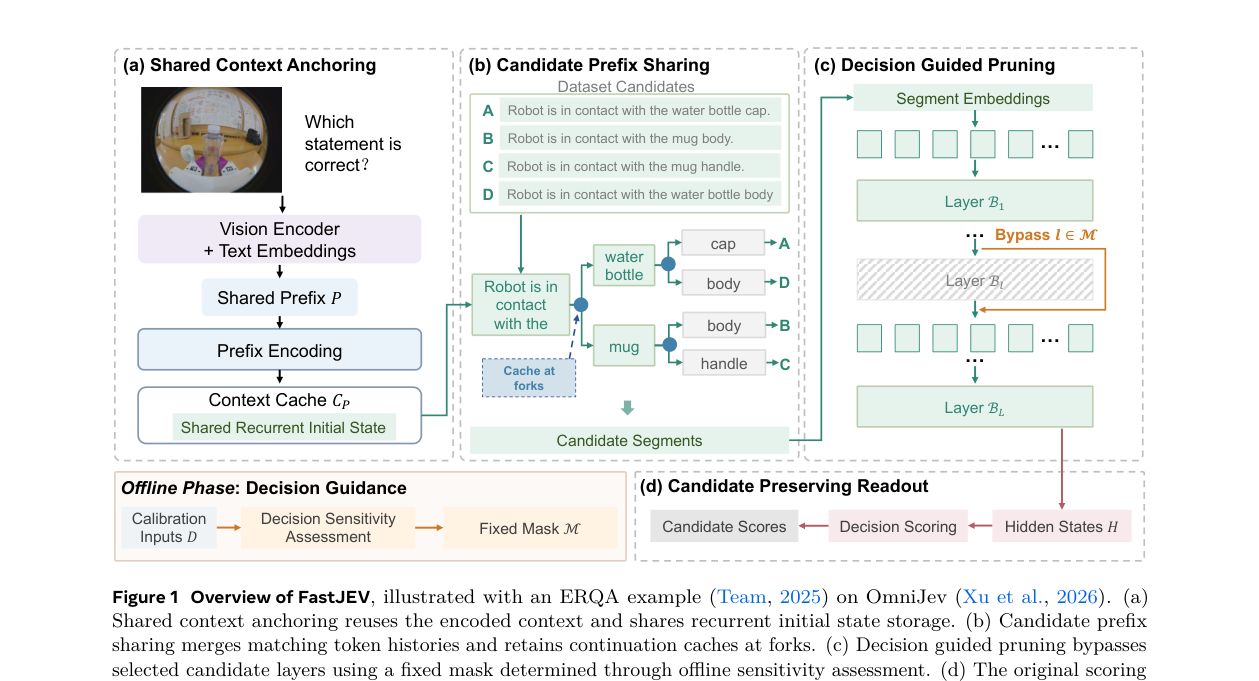
(1)FastJEV优化的是OmniJev v1.1这种多模态决策模型的候选打分。图像和公共上下文仍用完整骨干编码,候选路径上做三件事,锚定、共享前缀、剪层。
(2)不额外训练,候选和决策头都保留。0.8B剪掉45.83%的候选层,六项平均保留97.52%的原分数。2B同预算保留94.92%。4B剪掉43.75%保留93.66%。
(3)默认只跳六层时,0.8B、2B、4B的平均保留率是100.97%、98.98%、100.21%。4B的AI2D从84.33%到84.29%,BLINK停在64.33%,ERQA从44.75%到46.50%。
(4)分数留下来,墙钟时间不一定降。选出的大预算上,三个尺寸相对原版的几何平均加速比是0.938、0.939、0.953,小于1。
(5)文末按论文第4.1节列T、S、P三个开关和校准集做法。仓库地址在论文里,正文没有安装命令。
2026年10月8日,厦门大学的Jie Ma、Jie Gao、Yihang Liu、Zhike Qiu、Junle Li、Chongyi Zhuang、Jiayi Ji、Xiaoshuai Sun把FastJEV提交到arXiv,编号2610.11379。PDF的Date行写October 9, 2026。我读的是v1。通讯邮箱是jiema100@stu.xmu.edu.cn和xssun@xmu.edu.cn。
OmniJev是他们用来打分的多模态决策模型,v1.1,尺寸0.8B、2B、4B。图像和问题编码一次之后,每个候选还要走语言层。候选之间会重复同一段token历史,也会各存一份推理状态,并且默认跑完所有层。FastJEV盯的是这三处,不改权重。
一、上下文锚定和候选前缀树
发布版推理已经把公共的视觉和文本前缀算一次。FastJEV在这之上再动状态和深度。
共享上下文锚定把前缀在每一层产生的循环状态当成只读缓冲。每个候选分支读这份初始状态,再维护自己的工作状态。视觉、token历史、位置和mask一致时,这种共享在精确算术下和原来的递推相同。卷积状态和注意力的KV缓存仍然按分支分开存。一条候选路径结束、后面没有人依赖它时,最终的循环缓存不再分配和写回。中间还要分叉的缓存留着。
候选前缀共享把后缀收成一棵前缀树。两个token能并到同一个节点,条件是父节点、token本身、三个原始位置id都相同。位置id沿用合并前的输入,不在合并后再重编。树按路径段执行,段在分叉或候选边界结束。同一父节点的段可以组batch,继承父节点的缓存当初始锚。有后代的段留下最终缓存,叶子段可以省掉最终循环缓存。
决策头仍要每个候选一条记录。作者保留token到树节点的映射,按原路径把对数概率捡回来,以原来的候选顺序送进没改过的决策头。头输出各候选logit和一个弃权logit。共享了整条树路径的候选,在读出里仍然是分开的条目。
二、用无标签样本决定跳哪些层
前缀共享不减少路径深度。剪层只发生在候选分支,公共前缀仍跑全部层。
对校准集里的每个输入,比较完整logit和只跳过第ℓ层之后的logit。两者都包含弃权logit,并在概率后处理之前测量。先去掉全体logit的共同平移,因为softmax不看这个平移。敏感度是相对分数变化的均方根,再除以原logit的尺度,分母有一个1e-8的下限。一层的分数是校准集上的平均敏感度。预算为k时,取敏感度最小的k层,平局按层号。
这套排序每个模型算一次,之后所有输入共用,不用标签,也不更新权重。校准集是32条OK-VQA,每条64个来自训练答案词表的固定候选。评价集的标签不参与选层。
图2里,三个尺寸都是靠后的一些层敏感度低,最后一块反而最高。敏感度不是越深越低,所以不能按"跳掉最后几层"来剪。
跳过的层换成恒等映射,注意力或循环模块以及前馈网络都不跑。
三、六个评测集上的保留率
公开集是AI2D测试3,088题,ScienceQA图像测试2,017题,POPE 9,000题,BLINK验证1,901题,ERQA 400题。另有从LIBERO-10演示重建的离线问答,20条评测episode、十个任务、188帧,每帧八种题,共1,504题。标签来自仿真器状态和固定轨迹规则。原题库不可得,所以LIBERO只代表这套重建题,不代表官方题面。
多选看给定选项里的最高分。二值题用原来的sigmoid头,阈值0.5。LIBERO的argmax包含弃权,弃权算错。平均保留率是六项准确率之比的不加权均值,比值在四舍五入前计算,不截断到100%。
计时在一张NVIDIA L20上,BF16骨干,SDPA。公开集用64道固定题测三轮时间、16道题测显存。LIBERO用20帧测三轮时间、10帧测显存。延迟含读图、预处理、上下文编码、候选执行和打分,不含加载模型、预热和序列化结果。
T是前缀共享,S是上下文锚定,P是剪层。完整方法是T+S+P。下表只列原版,以及平均保留率至少90%的最大预算。默认六层那一档另列,因为它是论文的默认实验。
| 模型 | 方法 | 剪掉层数 | 剪枝比例 | AI2D | SQA | POPE | BLINK | ERQA | LIBERO | 平均保留 |
|---|---|---|---|---|---|---|---|---|---|---|
| 0.8B,24层 | 原版 | 0 | 0 | 62.27 | 69.01 | 84.76 | 43.98 | 28.75 | 55.45 | 100 |
| 0.8B | FastJEV | 6 | 25.00 | 62.37 | 69.31 | 87.79 | 43.40 | 29.50 | 55.65 | 100.97 |
| 0.8B | FastJEV | 11 | 45.83 | 58.19 | 66.63 | 88.50 | 41.45 | 28.00 | 54.92 | 97.52 |
| 2B,24层 | 原版 | 0 | 0 | 75.00 | 83.79 | 88.83 | 52.24 | 36.75 | 58.24 | 100 |
| 2B | FastJEV | 6 | 25.00 | 74.90 | 83.84 | 88.80 | 51.13 | 37.00 | 55.59 | 98.98 |
| 2B | FastJEV | 11 | 45.83 | 70.24 | 77.84 | 89.33 | 49.40 | 35.00 | 54.12 | 94.92 |
| 4B,32层 | 原版 | 0 | 0 | 84.33 | 94.30 | 90.77 | 64.33 | 44.75 | 65.23 | 100 |
| 4B | FastJEV | 6 | 18.75 | 84.29 | 94.10 | 90.64 | 64.33 | 46.50 | 63.76 | 100.21 |
| 4B | FastJEV | 14 | 43.75 | 81.96 | 92.56 | 90.46 | 64.70 | 40.00 | 50.20 | 93.66 |
再往上剪,0.8B剪14层、58.33%,平均保留掉到76.17%。2B同档73.81%。4B剪18层、56.25%,保留78.76%。论文把"至少90%"当成表里加粗的那一档边界。
默认六层时,18个对比里有13个绝对准确率变化不到1个百分点。2B和4B的LIBERO分别掉2.66和1.46个百分点。4B的ERQA从44.75升到46.50,这是少数变好的格子,不能当成剪层会涨点。
四、少算了,墙钟时间不一定短
默认六层预算下,完整FastJEV在18个对比里有6个总峰值显存更低。POPE上三个尺寸都比原版快,另外五个数据集更慢。LIBERO峰值显存分别降15.70%、8.43%、9.12%,每个尺寸的延迟都更高。
表1里那些保留率至少90%的较大预算,六集合上的几何平均加速比是0.938、0.939、0.953。小于1就是总体更慢。
4B的因子实验把T、S、P拆开,用同一个循环核,P启用时仍跳六层。S在T和P固定时,AI2D峰值显存降104.8MiB,LIBERO降224.6MiB,准确率不变。P在T和S固定时两边延迟都降,LIBERO准确率从64.89%到63.76%。T会改变分段方式和词表投影的调度。论文的实现结论写在摘要里。候选前缀共享可以减少重复计算,同时让延迟变高。共享粒度和执行顺序要一起设计,不能只看逻辑上少了多少token。
五、本地部署与推理实践
论文给出的代码地址是github.com/JieMaMagic/FastJEV。正文没有安装命令和命令行参数,下面按第4.1节整理开关,避免把没写过的flag当成官方接口。
text
models: OmniJev v1.1, 0.8B / 2B / 4B
T: candidate prefix sharing
S: shared context anchoring
P: decision guided pruning
full method: T+S+P
calibration: 32 OK-VQA inputs, 64 fixed candidates, no answer labels
default P: skip 6 candidate blocks
  0.8B and 2B: 25% of 24 layers
  4B: 18.75% of 32 layers
prefix: all layers, all weights stay loaded
binary threshold: 0.5
LIBERO: abstention counts as an error
device in the paper: one NVIDIA L20, BF16, SDPA
剪层掩码跟模型走,不跟任务走。换一批图之前不用重新标定,除非要换预算k。公共前缀不能跟着剪,否则共享的上下文缓存和原版对不上。
六、总结与思考
FastJEV说明多模态JEV的候选路径里有可剪的层。最后一层最敏感,中间偏后的一些层可以跳,0.8B在剪掉将近一半候选层时还留着97.52%的平均分。4B在43.75%的预算上留93.66%,LIBERO从65.23掉到50.20,这项比平均保留率难看。
它没有变成一次更快的服务。几何平均加速比小于1,前缀树在这份实现里还可能加延迟。若目标是降延迟,论文自己的POPE结果和其余五集是反的,不能只报准确率保留。若目标是少占状态,S那一百到两百MiB更直接。我会先看显存和LIBERO,再决定要不要上T。
参考链接
- 论文原文 arXiv 2610.11379 v1,2026年10月
- 代码地址 JieMaMagic/FastJEV,以论文给出的链接为准
- 被测模型OmniJev v1.1,论文引为Xu et al., 2026
- 重建问答所用环境LIBERO-10,论文第4.1节