TL;DR:这是一个从 0 到 1 的心理咨询师智能体实战项目,技术栈是 Vue3 + NestJS + LangGraph 1.x + PostgreSQL。核心思路是用状态图把"危机安全筛查"焊死在对话流程里,配合 SSE 流式输出和双套持久化,做到无 Key 无数据库也能完整跑通。
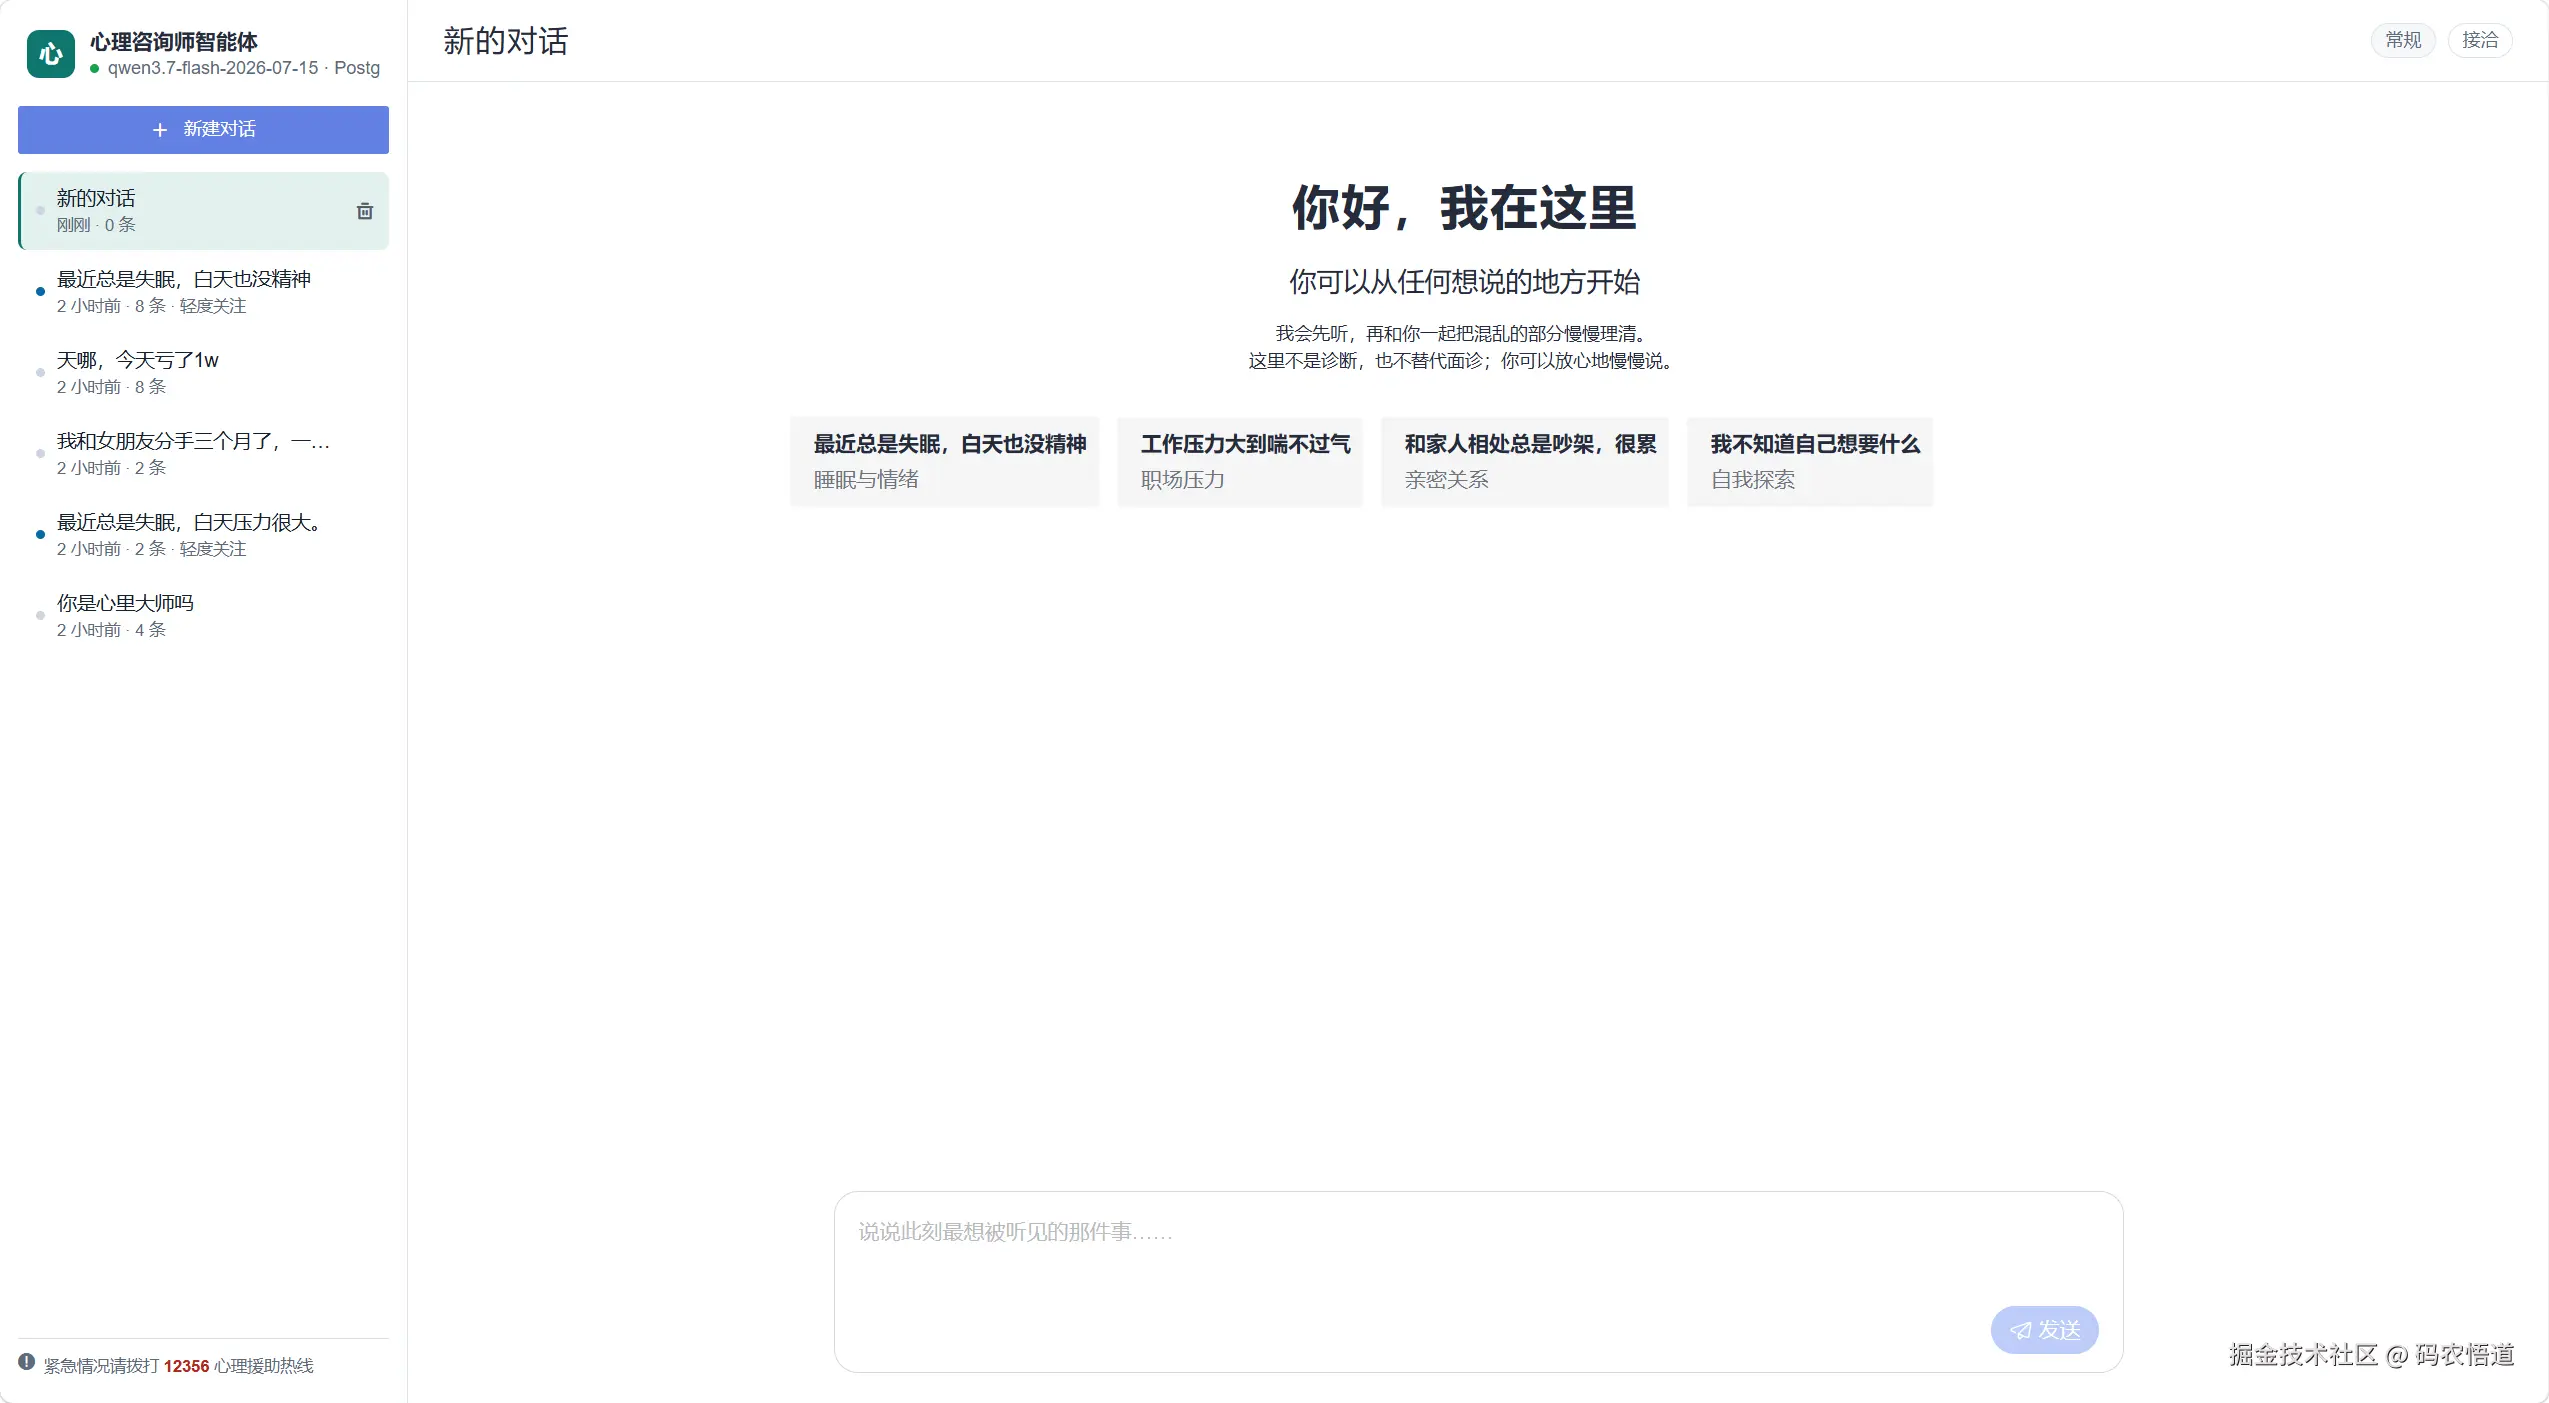
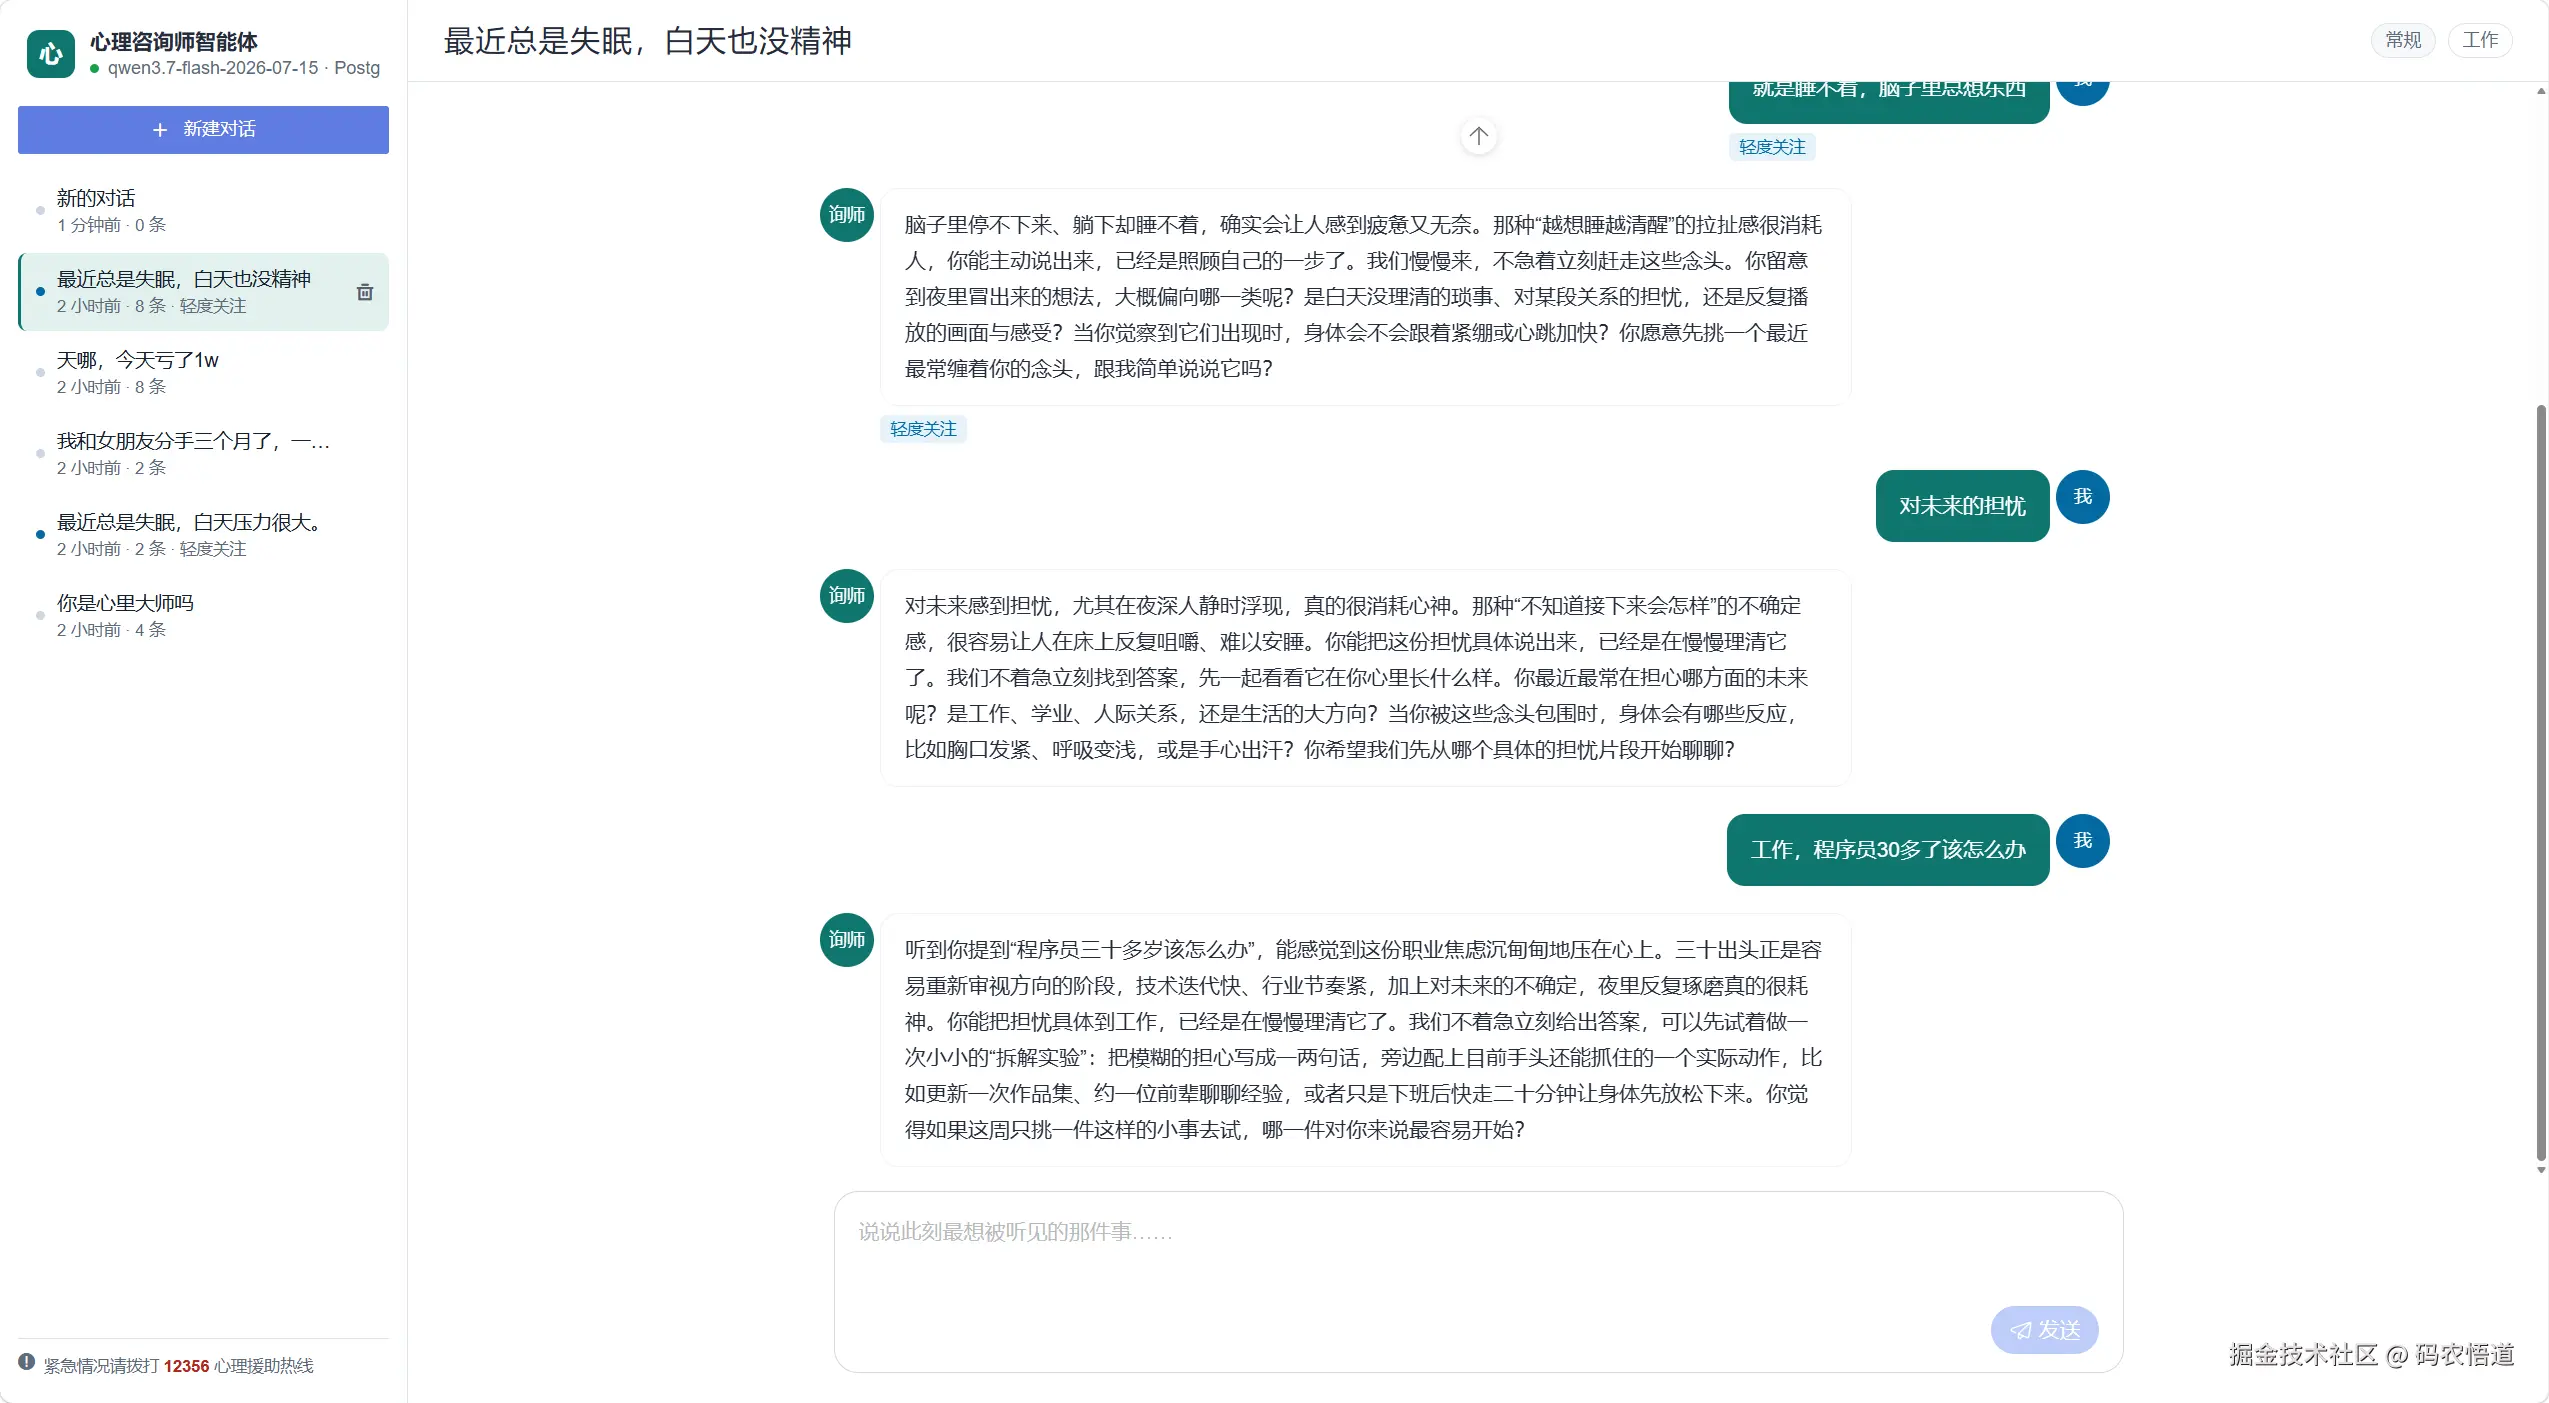
实现效果如下:
写在前面
大家好,这是我最近折腾的一个小项目------一个心理咨询陪伴类的 AI 助手。
之所以想做这个,是因为我发现心理咨询场景和普通聊天机器人有个本质区别:回复不好只是体验问题,漏掉一次高危信号就是安全问题。
所以从一开始我就定了条死规矩:安全这件事,不能全交给大模型,代码必须兜底。
这篇文章是我边踩坑边迭代出来的记录,肯定有很多不足,写出来主要是想跟大家交流学习,欢迎大佬们指点。
一、为什么要做"智能体",而不是简单调个 API?
最开始我也想偷懒------不就是调一下大模型接口嘛,传历史消息,拿回复返回去,完事。
但真动手写了个 demo 之后,发现根本不是那么回事:
-
对话状态:用户是刚进来随便聊聊,还是已经情绪崩溃了?不同阶段回复策略完全不同。
-
流程分支:同一句"我好累",可能只是加班吐槽,也可能是自杀前兆,要走完全不同的处理链路。
-
长记忆:多轮对话得记住前面聊过什么,不能用户上一句说"我三个月前失业了",下一句就忘了。
-
安全闸门:风险等级这种判断,必须由确定性代码执行,大模型说了不算。
这四个需求一摆出来,我就明白了:这不是一个"调 API"的活,这是一个智能体的活------得给它画一张流程图,规定好第一步干嘛、第二步干嘛、什么情况下走哪条路。
LangGraph 的状态图刚好能干这个。
二、技术选型与整体架构
技术栈一览
| 层级 | 技术选型 | 版本 | 选择理由 |
|---|---|---|---|
| 前端框架 | Vue3 + TypeScript + Vite | 3.5 / Vite 8 | 组合式 API 写流式状态很顺手 |
| 对话 UI | MateChat + DevUI | 1.14 / 1.6 | 自带聊天气泡、输入框,不用重复造轮子 |
| 服务端 | NestJS | 11.2 | 模块化 + 依赖注入,存储和模型都可替换 |
| 智能体编排 | LangGraph.js | 1.4 | 状态图 + 条件分支 + 检查点,天生适合多轮对话 |
| 模型接入 | LangChain.js | 1.2 / 1.6 | ChatOpenAI 同时覆盖 OpenAI 和阿里云百炼 |
| 数据库 | PostgreSQL + pg | 16 / 8.23 | 业务数据和智能体检查点共用一套库 |
| 参数校验 | zod | 4.6 | 请求校验 + 前后端共享类型 |
整体架构图
一次对话的完整流程
-
用户输入消息,前端先显示用户气泡,再放一个空的助手气泡在那 loading
-
POST 请求发到后端,后端立刻返回 SSE 流
-
后端先把用户说的话存下来------就算后面模型调用失败,用户的话也不会丢
-
进入 LangGraph 状态图,第一步永远是安全筛查
-
如果是高危,直接返回预设的危机话术,根本不调大模型;否则交给大模型生成回复
-
后端一边生成一边往前端推:先推风险等级和咨询阶段(meta 事件),再逐字推 token,最后推 done
-
前端收到 token 就往气泡里拼,done 了就关掉 loading,刷新侧边栏
三、核心实现:我是怎么把"安全"焊死在流程里的
3.1 状态图:安全筛查是绕不过去的第一步
LangGraph 1.x 的写法跟老版本差别挺大的(这个后面踩坑部分会说)。我用 Annotation.Root 定义了整个对话的状态,里面有几个关键字段:
-
riskLevel:风险等级------这个字段只能由代码写入,大模型改不了 -
riskEvidence:命中的原文片段,方便排查误判 -
phase:咨询阶段(刚进来 / 深入探索 / 危机干预等)
typescript
// src/counselor/agent/state.ts
import { Annotation, MessagesAnnotation } from "@langchain/langgraph";

const replace = <T>(_prev: T, next: T): T => next;

export const CounselorState = Annotation.Root({
  ...MessagesAnnotation.spec,  // 复用官方的消息管理
  sessionId: Annotation<string>({ reducer: replace, default: () => "" }),
  riskLevel: Annotation<RiskLevel>({ reducer: replace, default: () => "none" }),
  riskEvidence: Annotation<string[]>({ reducer: replace, default: () => [] }),
  phase: Annotation<CounselingPhase>({ reducer: replace, default: () => "intake" }),
});然后画图的时候,安全筛查节点是第一个节点,没有任何捷径可以绕过去:
typescript
// src/counselor/agent/graph.ts
const workflow = new StateGraph(CounselorState)
  .addNode("safetyScreen", safetyScreenNode)      // 第一步:确定性筛查
  .addNode("crisisResponse", crisisResponseNode) // 高危路径:固定脚本
  .addNode("counselor", createCounselorNode(model)) // 普通路径:调模型
  .addEdge(START, "safetyScreen")  // 从 START 进来,必须先过筛查
  .addConditionalEdges("safetyScreen", routeAfterScreening, {
    crisis: "crisisResponse",
    counselor: "counselor",
  })
  .addEdge("crisisResponse", END)
.addEdge("counselor", END);这里我觉得最大的好处是:"高危时必须给求助热线"这件事,可以直接写单元测试断言,不用靠大模型评测。 因为危机响应是个纯函数节点,输入什么、输出什么,完全确定。
3.2 风险筛查:正则规则是底线,还要处理否定句
我现在的实现是用正则规则做确定性筛查,覆盖自杀意念、准备行为、自伤、伤人、无望感这些场景。
这里踩过一个特别坑的问题:否定句误判。
比如用户说"我不会自杀的,我只是最近很累"------如果直接正则匹配"自杀"两个字,系统就会弹出危机热线,这反而会让用户觉得"你根本没听懂我在说什么"。
所以我加了否定句处理逻辑:命中关键词之前,如果有"不会""没有""从没""不再"这些否定词,就跳过这条规则。
typescript
const NEGATION_BEFORE = /(不会|没有|从没|不再|不想再|从未|没想过)s{0,4}(去)?s{0,4}$/;

function findEvidence(text: string, pattern: RegExp): string | undefined {
  // 先分句,再看命中位置前面有没有否定词
  for (const sentence of splitSentences(text)) {
    if (!pattern.test(sentence)) continue;
    const index = pattern.exec(sentence)?.index ?? 0;
    if (NEGATION_BEFORE.test(sentence.slice(0, index))) continue;
    return sentence;
  }
  return undefined;
}
我还写了一组单元测试,覆盖了各种情况:正常聊天、轻度情绪、有自杀想法、有准备行为、否定句......相当于把规则的预期行为"锁死"了。
3.3 SSE 流式:既要逐字出,又要知道状态
这个需求听起来简单,但实际写的时候挺头疼的:
-
前端需要逐字收到 token,才能做出那种"打字机"效果
-
同时前端还需要知道这一轮的风险等级和咨询阶段,好显示对应的标记
LangGraph 1.x 支持同时订阅两种模式:streamMode: ['messages', 'updates'],一次订阅两边都拿到。
typescript
const config = {
  configurable: { thread_id: input.sessionId },
  streamMode: ['messages', 'updates'],
  signal,  // 前端断开时能中断
};

const stream = await this.graph.stream(input, config);
for await (const chunk of stream) {
  const [mode, payload] = chunk;
  if (mode === 'updates') {
    // 拿到节点更新的状态(风险等级、阶段)
  }
  if (mode === 'messages') {
    // 拿到模型逐片产出的 token
  }
}
这里有个非常关键的坑:不是所有节点都会产生流式分片。
crisisResponse 节点直接返回一整段固定话术,它不经过大模型,所以不会逐字吐 token。如果不做处理,前端就会看到一个空空的助手气泡------用户点了发送,然后什么都没发生。
所以我加了兜底逻辑:如果一轮下来一个 token 都没收到,就从最终状态里把完整回复读出来,整段作为一个 token 事件推给前端。
typescript
// 兜底:没有流式分片时,直接读完整回复
if (!streamed) {
  const answer = await this.readLastReply(input.sessionId);
  if (answer) {
    yield { type: 'token', content: answer };
  }
}
3.4 两套存储:各干各的活,别互相将就
这是整个项目里我觉得收获最大的一个设计决策。
LangGraph 自带的 PostgresCheckpointer,会把对话状态序列化后存在二进制 blob 字段里。它特别适合做智能体的记忆恢复、断点续跑。但如果你想用它来做"会话列表分页""历史消息查询""风险统计",那会非常痛苦------blob 字段你怎么排序?怎么做检索?
所以我搞了两套存储,各司其职:
| 存储 | 干什么用 | 表 |
|---|---|---|
| checkpointer | 智能体运行状态、多轮记忆、断点续跑 | checkpoints 系列表 |
| 业务读模型 | 会话列表、历史消息、风险统计、审计 | counselor_session / counselor_message |
写的时候两边都写一份,读的时候各取所需:页面展示走读模型,智能体恢复记忆走 checkpointer。
3.5 没有 API Key 也能跑:三级降级策略
这个项目我做了一个特别开心的设计------三级降级:
-
有 PostgreSQL 就连 PostgreSQL,没有就用内存存储
-
有模型 API Key 就用真模型,没有就自动降级到离线演示模型
-
离线演示模型是我自己继承
BaseChatModel写的,模拟逐字流式输出
这样带来的好处是:就算你在一台没有网络、没有数据库的电脑上,这套系统也能完整跑通。 本地调试方便,CI 跑测试也方便------不用依赖外部环境。
typescript
export class DemoCounselorModel extends BaseChatModel {
  // 非流式调用走这里
  async _generate(messages) { ... }
  // 流式调用走这里:按 4 个字符一片吐出,模拟逐字效果
  async *_streamResponseChunks(messages) {
    for (const token of text.match(/[sS]{1,4}/g)) {
      await delay(8);
      yield new ChatGenerationChunk({ text: token });
    }
  }
}
3.6 前端:手动解析 SSE 流
浏览器原生的 EventSource 只支持 GET 请求,但我们对话需要 POST 带 JSON 体,所以只能用 fetch + ReadableStream 手动解析。
要点是:SSE 分片可能被 TCP 截断,不能每次收到数据就直接解析。得先放缓冲区里,按 nn 分割事件块,没拼完的留到下一轮。
Vue 这边还踩了一个响应式的坑:你 push 进数组的裸对象不是响应式代理,直接改它的属性不会触发视图更新。
typescript
messages.value.push({ content: '', streaming: true });
// 重点:从数组里重新取出来,拿到的才是响应式代理
const reply = messages.value[messages.value.length - 1];
// 之后改 reply.content,UI 才会正常更新
四、踩坑记录:这些都是我真金白银换回来的经验
坑 1:网上教程全是老版本 API,照抄就报错
LangChain / LangGraph 1.x 跟 0.x 的 API 变化非常大。modelName 改成了 model,MessageGraph 整个废弃了,streamEvents 也换成了 streamMode......
经验:动手前先去 node_modules 里翻 .d.ts 文件,别相信网上的博客。
| 0.x 写法(已废弃) | 1.x 正确写法 |
|---|---|
new ChatOpenAI({ modelName }) |
new ChatOpenAI({ model }) |
MessageGraph |
StateGraph + MessagesAnnotation |
graph.streamEvents(...) |
graph.stream(input, { streamMode: [...] }) |
坑 2:@nestjs/config 升级成纯 ESM 了,跟 CJS 构建冲突
不想为了读个 .env 引入一个 ESM-only 依赖,我干脆手写了一个简单的 .env 解析逻辑,用 Node 内置能力搞定。反而少了一个依赖,而且系统环境变量优先级高于 .env 文件,语义更正确。
坑 3:DevUI 的老样式把 LightningCSS 搞崩了
DevUI 里保留了一些 IE 时代的 CSS hack 语法,LightningCSS 严格模式直接构建失败。解决办法是开 errorRecovery: true,让它跳过异常规则。
坑 4:按需引入组件,但图标没注册
我为了压包体积,没有全量引入 DevUI,只注册了用到的组件。结果控制台一直报 d-icon 找不到------因为 d-button 内部是用 resolveComponent('d-icon') 字符串解析的,按需引入 button 不会自动带上 icon 模块。
手动注册 icon 模块之后,首屏主包从 4.57 MB 降到了 1.53 MB。
坑 5:流式的"最后一公里"------不是所有节点都会分片
这个前面说过了:危机路径是整段返回的,没有逐字分片,必须做兜底,否则前端空气泡。
坑 6:Vue 响应式------push 进去的裸对象不是代理
这个也前面说过了,push 完要从数组里取回来才是响应式的。
坑 7:同一接口两套实现,行为悄悄跑偏
Postgres 存储和内存存储实现了同一个接口,但我写着写着,两边的逻辑就不一样了------Postgres 版在 SQL 里加了"只有默认标题时才用首句命名"的判断,内存版却漏了。
经验:同一接口的多实现是"行为漂移"的高发区,一定要写契约测试锁住行为。
坑 8:配置静默失败,运行时才报错
.env 里明明写了 DashScope 的 Key,但 LLM_PROVIDER 还是模板里默认的 openai,程序静默不报错,直到第一次请求才抛出 401。
所以我现在的做法是:启动时就把最终生效的配置打印出来,而且如果指定的供应商没 Key,自动回退到另一个有 Key 的供应商并打警告日志。
坑 9:pnpm 每次执行脚本都想重装依赖
项目里的 node_modules 与当前解析出的 pnpm store 位置不一致,在 pnpm-workspace.yaml 里显式声明 storeDir 就解决了。
五、我觉得这个项目还不错的几个设计点
-
安全不可绕过:风险筛查是状态图第一个必跑节点,高风险直接固定脚本接管,模型插不上手
-
双层持久化:智能体记忆和业务查询各用各的存储,互不将就
-
三级降级:无库无 Key 也能跑通全链路,本地调试和 CI 测试都方便
-
咨询阶段可推导:根据对话轮次推导阶段,不额外消耗模型调用
-
可观测:启动打印配置,SSE 带元信息,运行时状态接口暴露
-
前端体验完整:流式打字、风险标记、危机横幅、移动端适配
六、怎么验证它真的能用?
bash
# 后端:lint + 类型检查 + 单元测试 + e2e + 编译
cd psychologist-agent-api
pnpm lint && pnpm exec tsc -p tsconfig.json --noEmit
pnpm test          # 风险规则、会话存储、graph 逻辑
pnpm run test:e2e  # e2e 用演示模型+内存存储,不需要数据库和网络
pnpm run build

# 前端
cd ../psychologist-agent-web
pnpm build
e2e 测试会离线验证几个关键行为:普通对话能流式输出、高危输入强制返回危机脚本不走模型、消息按顺序落库。
七、后续还想继续折腾的方向
这个项目更多是个技术原型,离生产级产品还差得远。我后面想继续完善的方向:
-
风险检测升级:规则兜底 + 模型辅助,但模型只能提高风险等级,不能降低
-
规则表外置:把危机词表从代码里挪到配置或数据库,让心理专业人员也能维护
-
黄金测试对话集:收集典型咨询场景,自动化断言"有没有共情""有没有给热线",防止改 prompt 后行为退化
-
前端包体积优化:MateChat 自带的 mermaid、katex 做动态 import 懒加载
-
生产化补齐:鉴权多租户、数据脱敏、审计日志、接 LangSmith 监控
写在最后
做完这个项目最大的感受是:做 AI 应用,调用大模型其实只占很小一部分工作量。
更多时间是花在画清楚边界上------哪些判断必须由确定性代码做、哪些状态存在哪里、失败了怎么优雅降级。
把这些边界想清楚,再配上充分的测试,整个系统才会比较稳。
以上都是我个人边踩坑边摸索出来的,肯定有很多考虑不周的地方,欢迎大家在评论区一起交流指正 👇