那些在各类榜单上表现出色的大模型,如果真正进入企业、接手一项具体销售工作,还能不能保持同样的表现?
网易智企做了一次测试。
我们把** 12 款国产大模型**放进真实销售任务中,让它们完成从评估线索、准备拜访,到整理纪要、判断商机、应对异议、跟进客户,再到输出方案和报价的一整套工作。
不是再做几道知识、推理或代码题,而是让模型面对客户资料、沟通记录、业务规则、产品能力和交付要求,真正完成一项销售工作。
基于这次测试,我们把过程、结果和观察沉淀成了一份完整报告。
今天,网易智企正式发布 《2026 销售场景 AI 实战评测报告》 。
(点击"阅读原文"即可下载)
这是「企业 AI 实战评测」系列的第一期,也是国内首份聚焦企业真实销售场景、以任务交付为验收标准的大模型深度评测。
这一次,我们站在企业实际使用者的视角,把模型放进真实工作,用真实任务验证能力,希望为企业 AI 选型、组合与落地找到更优解。
01
12 款模型
参加同一场"销售实战考试"
过去的大模型评测,大多围绕知识、推理、代码、指令遵循等通用能力展开。
这些能力可以反映模型的基础水平,但真正进入企业之后,任务往往会复杂得多。
一项销售工作,可能同时涉及客户资料、历史沟通、产品信息、价格规则、销售流程和交付边界。
模型不仅要读懂材料,还要判断哪些信息已经确认、哪些仍待核实,遵循既定业务规则,并最终交付可供后续业务继续使用的成果。
因此,这次评测没有另外设计一套脱离业务的"考试题",而是直接从真实的销售工作中提炼任务。
首期共设置 7 项高频销售工作:线索评估、拜访准备、沟通纪要、商机评估、异议处理、客户跟进、方案与报价。
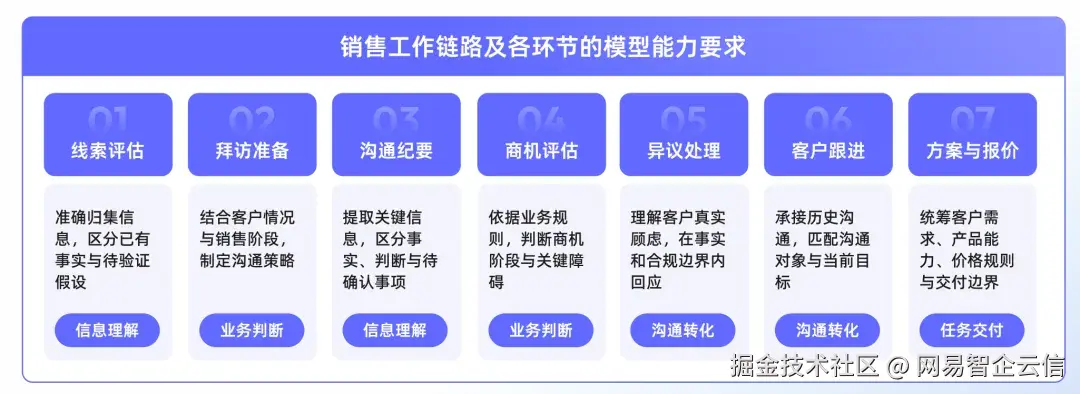
评测覆盖 DeepSeek、MiniMax、豆包、千问、Kimi、GLM 六个模型品牌,共 12 款国产大模型。
每项任务设置 5 个测试样例,共计 35 个样例。12 款模型完成相同任务,最终形成:7 项销售任务 × 5 个样例 × 12 款模型=420 份实际任务成果。
这些成果不是简单问答,而是客户研究报告、拜访作战卡、售前方案、产品报价等一项项真实销售工作的交付结果。
为了尽量保证比较条件一致,在同一个测试样例下,不同模型获得相同的业务材料、任务要求、输出规范和业务规则,并统一在网易智企企业级 AI Agent 平台帝王蟹(ClawHive) 提供的 Agent 环境中完成任务。
这次评测,我们把模型在真实销售任务里的表现概括为"销售场景 AI 胜任力"。相比"会不会生成内容",我们更关心它能不能真正理解任务、遵循规则,并按照企业要求交付可用结果。
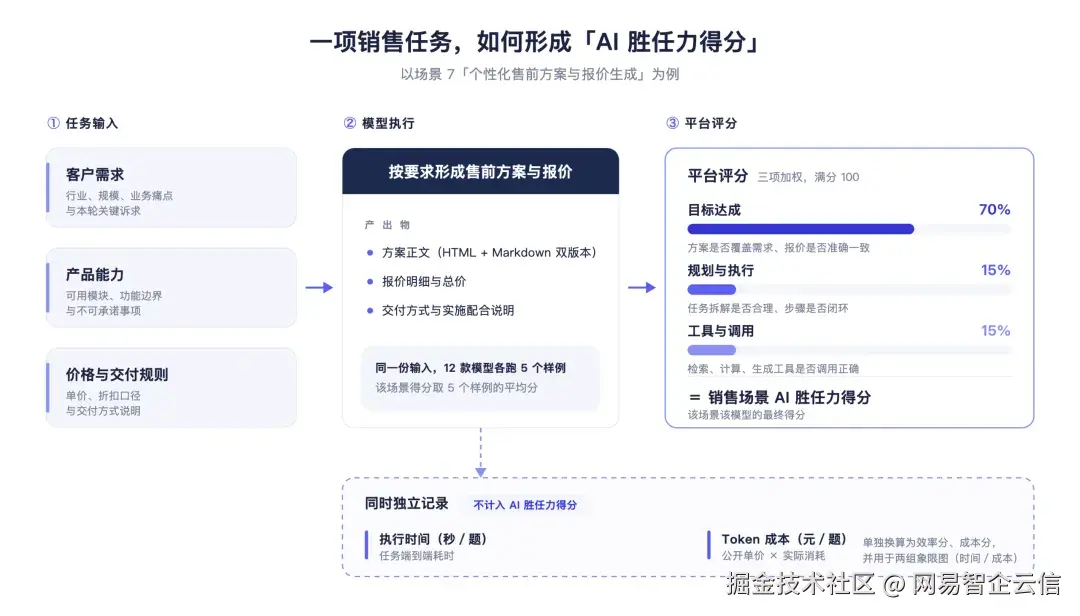
在此基础上,我们也同步记录执行时间和 Token 成本,用来观察不同模型完成同一项工作时的效率与成本表现。
02
35 道"实战题"考完
我们看到三个值得注意的结果
1头部模型开始出现明显的"任务分工"
本轮评测中,7 项销售任务的第一名全部由 Qwen3.8-Flash 和 DeepSeek-V4.1-Flash 获得,但两款模型领先的任务并不相同。
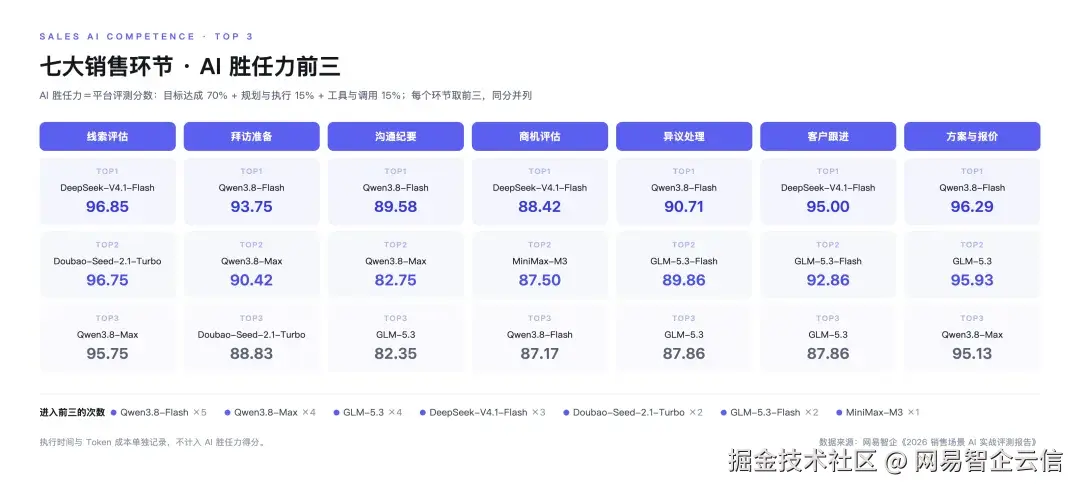
其中,Qwen3.8-Flash 在拜访准备、沟通纪要、异议处理、方案与报价 4 项任务中位列第一;DeepSeek-V4.1-Flash 在**线索评估、商机评估、客户跟进 **3 项任务中位列第一。
这说明,即使都是本轮表现领先的模型,擅长的任务类型也并不相同。
销售工作本身就包含多种不同性质的任务:有的更依赖信息理解和整理,有的更强调判断与分析,有的则需要结合上下文完成连续推进。模型在这些任务中的优势,也会有所不同。
也正因为如此,这次评测没有把 7 项任务进一步加权成统一总分,也没有评出一个"销售总冠军"。
相比得到一个简单排名,我们更希望看清:不同类型的任务,分别更适合由什么模型来完成。
2质量、速度和成本,不存在简单的对应关系
只看任务得分,还不是全部。把执行时间和 Token 成本一起放进来看,同一个任务的选择也可能发生变化。
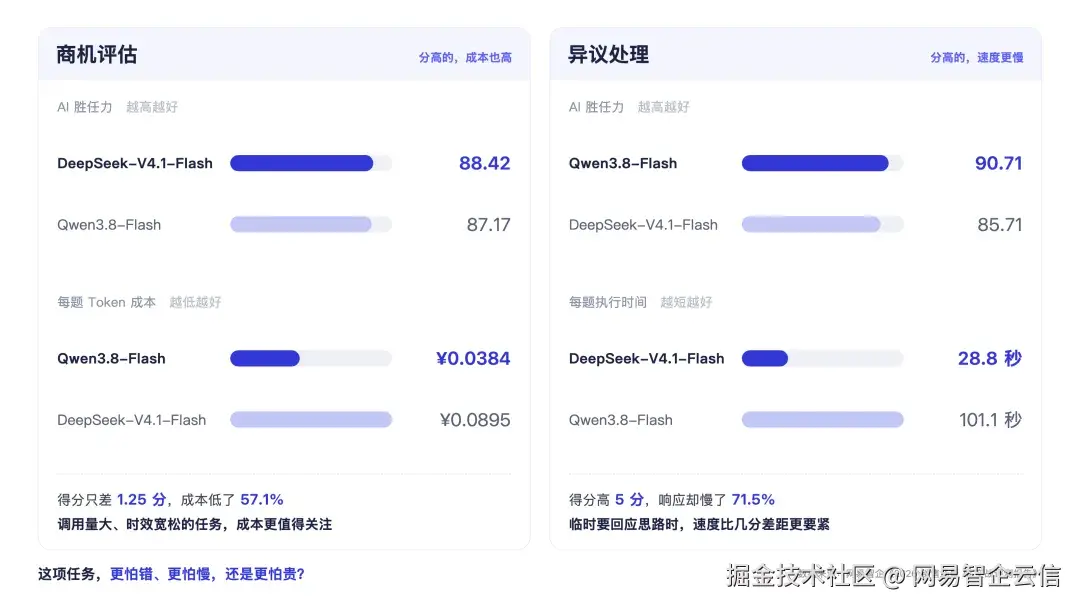
以商机评估为例,DeepSeek-V4.1-Flash 的 AI 胜任力得分比 Qwen3.8-Flash 高 1.25 分,但 Qwen3.8-Flash 的平均 Token 成本低约 57.1%。
如果企业面对的是调用规模较大、时效要求宽松 的周期性分析任务,成本优势就可能变得更重要。
异议处理则是另一种情况。
Qwen3.8-Flash 得分比 DeepSeek-V4.1-Flash 高 5 分,但 DeepSeek-V4.1-Flash 的平均执行时间比 Qwen3.8-Flash 短约 71.5%。
如果销售正在和客户沟通,需要临时获得回应思路 ,响应速度可能就比几分的差距更影响实际体验。
所以到了真实业务里,企业选模型不能只问"谁分最高",还要进一步判断:这项任务,更怕错、更怕慢,还是更怕贵?
3真正拉开差距的,不是"会不会写",而是"懂不懂业务"
沟通纪要就是一个很典型的例子。
本轮测试中,Qwen3.8-Flash 在沟通纪要场景中获得 89.58 分,排名第一;Qwen3.8-Max 以 82.75 分位列第二,两者相差 6.83 分,是七项任务中第一、第二名分差最大的场景。
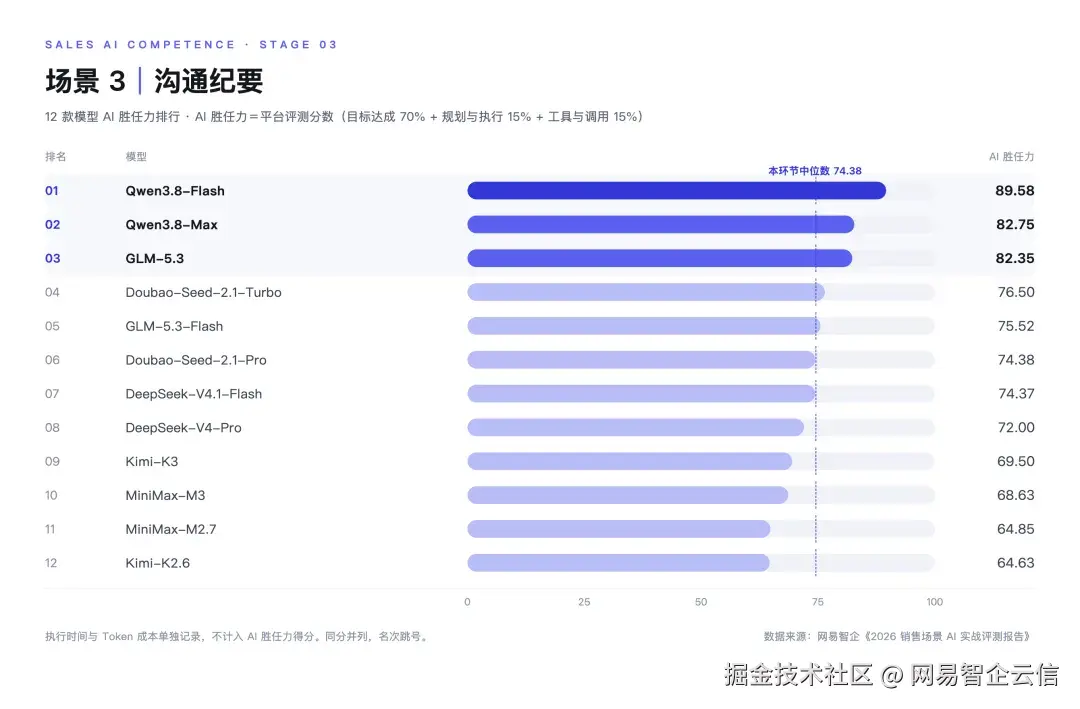
差距并不主要来自文字是否流畅、结构是否完整,而在于模型能不能理解沟通背后的业务含义,并准确区分已确认事实、销售侧说明和待确认信息。
在一个测试样例中,客户提出"内部已立项""七月底要定下来""没有具体预算"等信息。看起来都不复杂,但真正写进 CRM 时,每一句都需要判断。
"内部已立项"不等于预算已审批;"七月底要定下来"也没有明确指向选型、定供应商还是签约;仍需技术验证的能力,也不能直接写成已确认的产品承诺。
表现更好的模型,会把已确认事实、销售侧说明和待确认信息区分开来;表现较弱的输出,则可能把销售方案写成客户需求,把待确认信息写成确定事实,甚至遗漏下一步行动的责任人和时间。
这些问题单独看只是纪要里的几个细节,但一旦进入 CRM,并被后续商机判断、客户跟进甚至方案报价继续引用,误差就可能沿着业务流程传递。
所以,一份纪要"写得完整",并不意味着这项工作已经做对。真正重要的是:记录是否准确、边界是否清楚、结果能不能继续被下一环节使用。
03
比"选模型"更重要的
是怎么让 AI 真正跑进业务
这次评测让我们看到,不同模型在不同销售任务中的优势并不相同。
这意味着,企业选模型时,已经不能只看谁整体更强,而要根据不同任务,选择和配置更合适的模型能力。
但当 AI 真正进入企业,模型选择只是其中一部分。
客户资料会更新,产品知识有版本,报价和交付有规则;一次沟通形成的信息,会进入商机判断,商机判断又会影响下一次跟进和最终方案。
这些数据、知识、规则和上下文,不能在每次模型调用时重新建立。
AI 懂业务,才算真落地。
真正进入企业,AI 还要理解行业和企业的业务背景,调用企业自己的知识和规则,知道当前任务要完成什么,并让结果能够继续进入下一环节。
帝王蟹(ClawHive)是网易智企面向企业打造的企业级 AI Agent 平台,负责接入和管理不同模型,并将企业知识、业务工具和工作流程组织进 Agent 运行环境,让 AI 能够在真实业务上下文中持续完成任务。
在销售场景中,销售宝作为基于帝王蟹构建的销售 AI 员工,承接线索评估、拜访准备、沟通纪要、商机判断、异议处理、客户跟进和方案报价等具体工作。本次评测中的 7 项任务,也正是从这些真实销售工作中提炼而来。
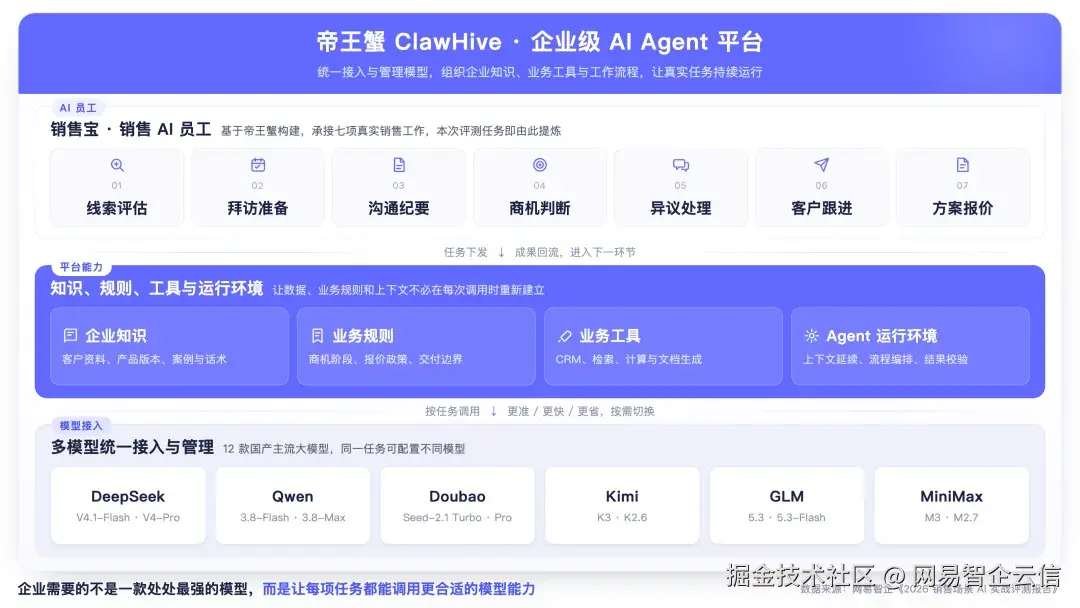
在这套运行方式中,大模型不是固定不变的"唯一答案" ,而是可以根据不同任务灵活配置的底层能力。
比如,某项工作更强调准确性,可以优先选择任务表现更好的模型;需要实时辅助时,响应速度更重要;面对大规模批量处理,调用成本又可能成为关键变量。
于是,模型选择也从"哪款模型整体最强",变成了一个更具体的业务问题:这项工作,什么模型更适合?质量、速度和成本,又该如何取舍?
完整报告中,我们进一步拆解了 7 项销售任务的评测结果、模型表现和真实案例,为不同任务下的模型选择和配置提供更具体的参考。
如果你也在思考 AI 到底怎么进入真实业务,欢迎点击**「阅读原文」**下载完整报告,看看这 420 份"销售作业"里,藏着哪些值得参考的答案。
销售只是第一站。后续,**「企业 AI 实战评测」**还将继续进入更多企业岗位,以及金融、制造等行业场景,把不同模型放回真实业务中检验,为企业 AI 选型与落地提供更贴近业务的参考。
👉 点击**「链接」**,获取完整报告