原文链接:AI 智能体实战速成指南:从零到企业级落地 | ai-agents-from-zero
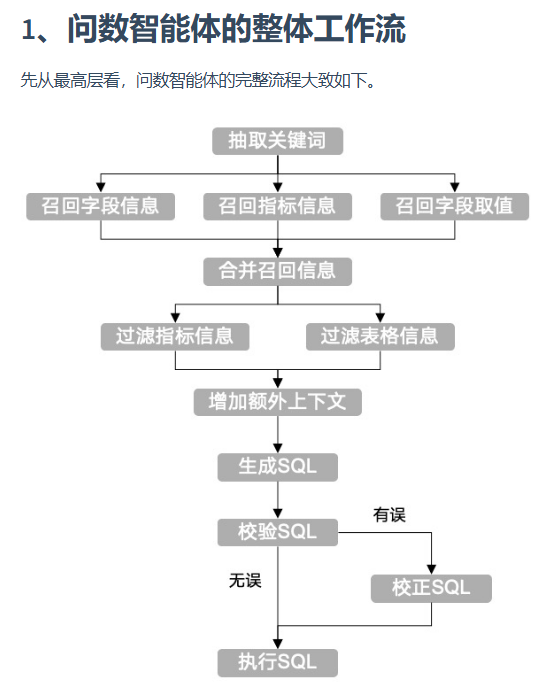
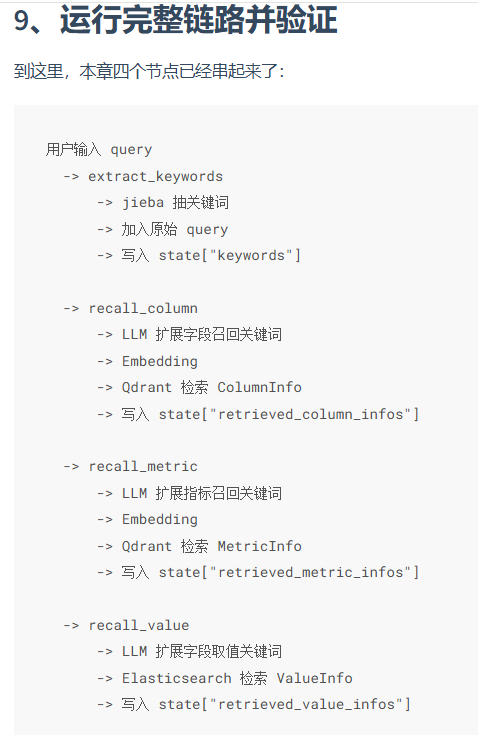
这里有三处设计需要先看懂。
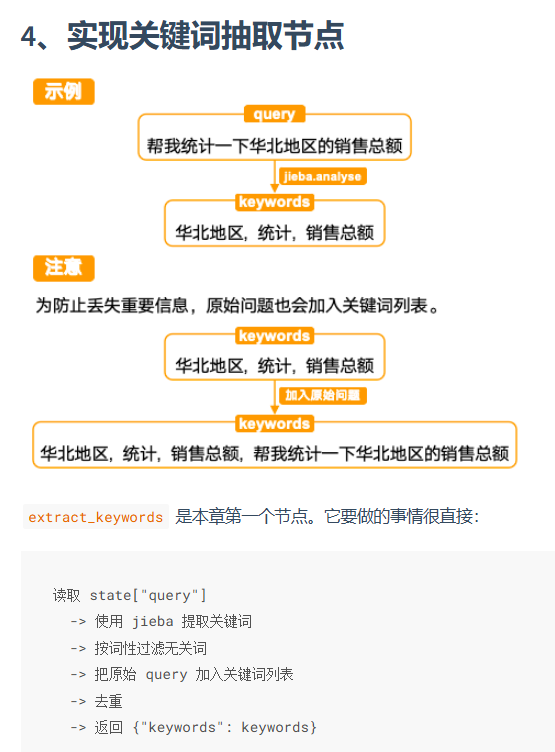
第一,关键词抽取之后,字段信息、指标信息、字段取值可以并行召回。它们都依赖用户问题和关键词,但彼此之间没有强制先后顺序。
第二,召回结果不能直接交给大模型生成 SQL。召回阶段通常宁可多召回一些,避免漏掉关键信息;但生成 SQL 阶段需要尽量干净、准确的上下文。因此中间还需要合并和过滤。
第三 ,生成 SQL 后不能直接执行。大模型生成的 SQL 可能字段名写错、表名写错、join 条件不完整,或者不符合当前数据库方言。所以后面还要校验 SQL;校验失败时,再进入校正流程。
这套流程看起来比"直接生成 SQL"麻烦,但它更接近企业级问数系统的真实做法:每一步都让模型少猜一点,让系统多提供一点确定信息。
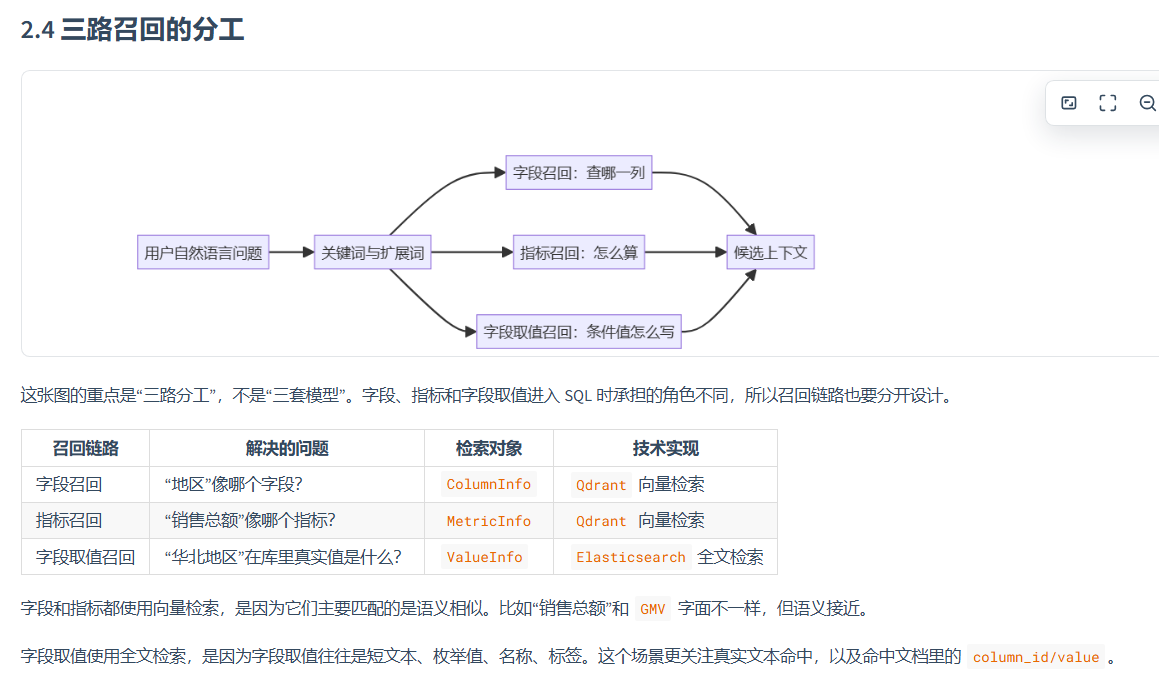
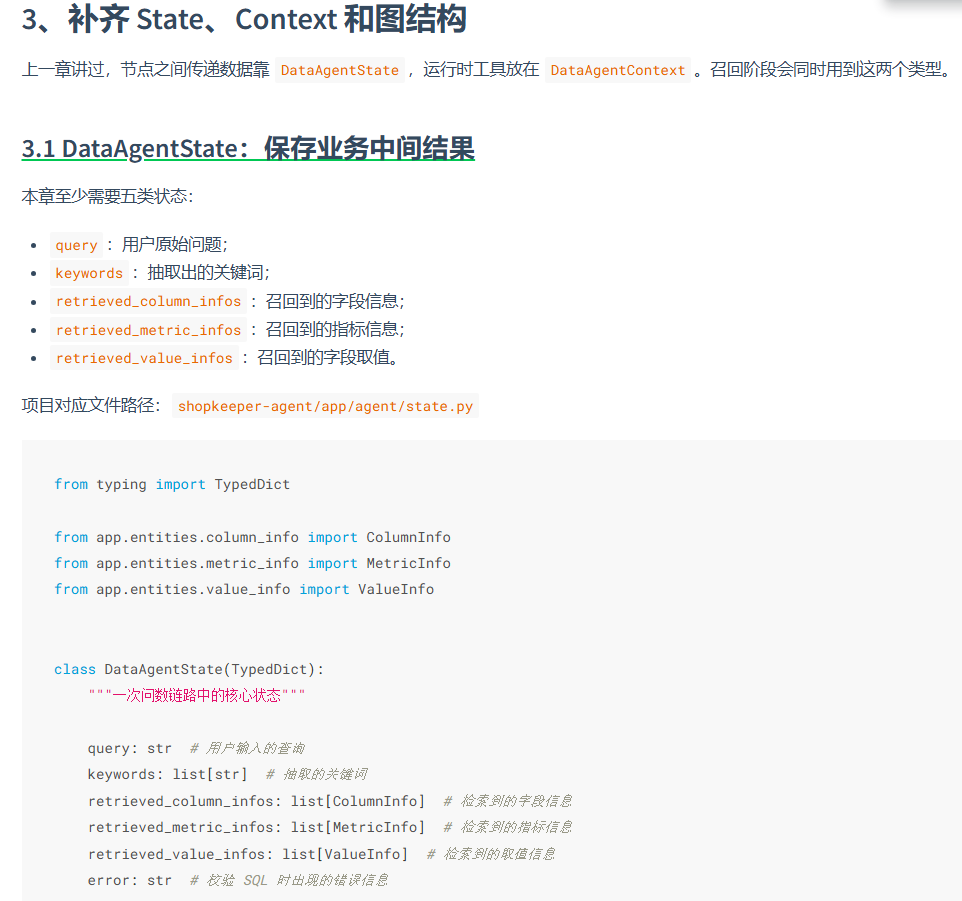
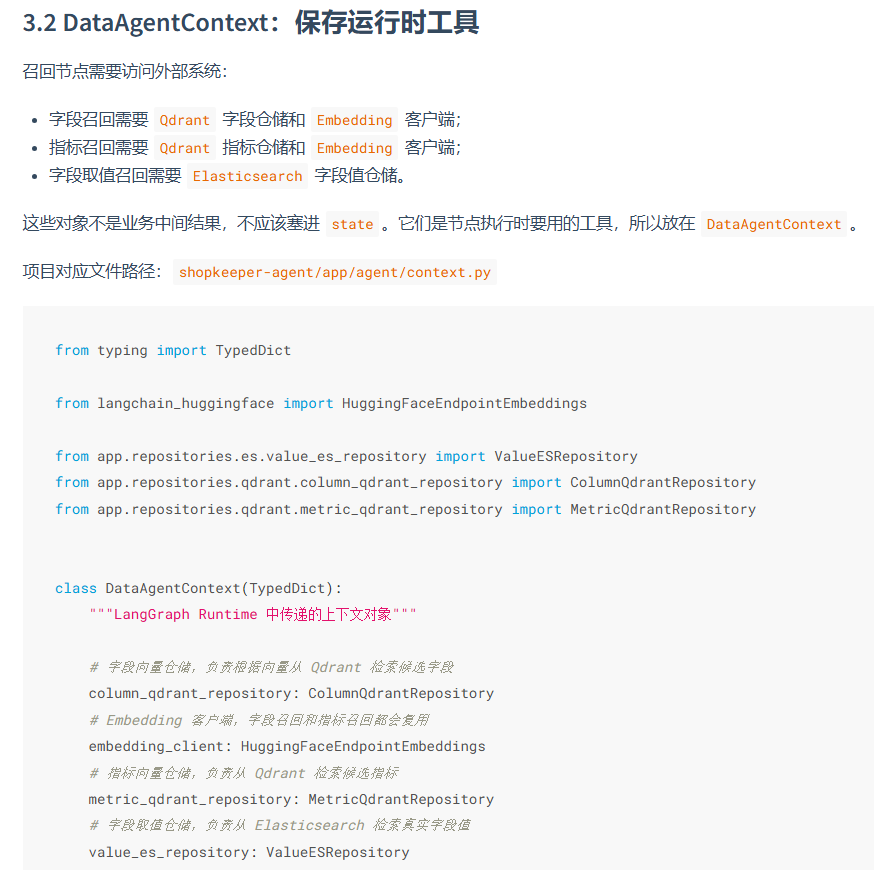
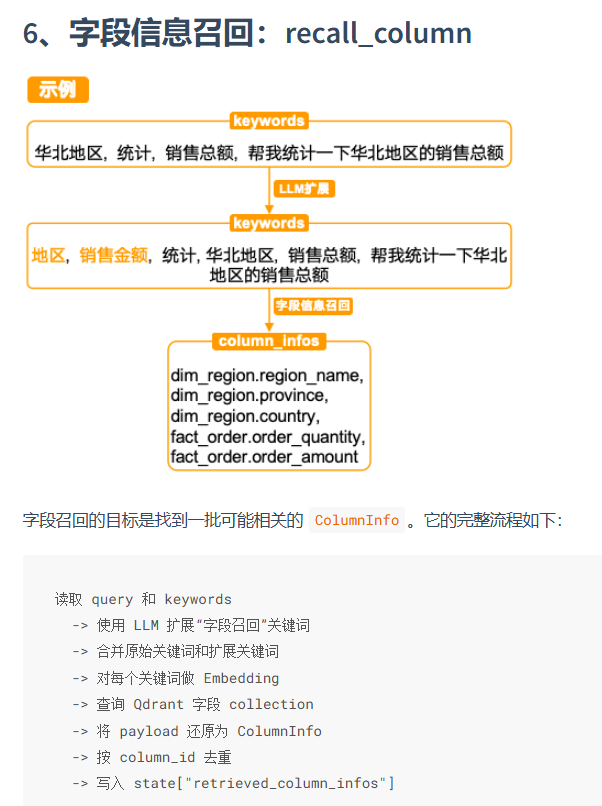
字段召回
python
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import PromptTemplate
from langgraph.runtime import Runtime

from app.agent.context import DataAgentContext
from app.agent.llm import llm
from app.agent.state import DataAgentState
from app.core.log import logger
from app.entities.column_info import ColumnInfo
from app.prompt.prompt_loader import load_prompt


async def recall_column(state: DataAgentState, runtime: Runtime[DataAgentContext]):
    writer = runtime.stream_writer
    writer("召回字段信息")

    # state 保存图内业务中间结果:原始问题和上游抽取出的关键词
    keywords = state["keywords"]
    query = state["query"]
    # context 保存外部运行时工具:向量仓储和 Embedding 客户端
    column_qdrant_repository = runtime.context["column_qdrant_repository"]
    embedding_client = runtime.context["embedding_client"]

    # 用 LLM 把用户问法扩展成"字段语义"列表,例如"销售总额"可扩展出"销售金额"
    prompt = PromptTemplate(
        template=load_prompt("extend_keywords_for_column_recall"),
        input_variables=["query"],
    )
    output_parser = JsonOutputParser()
    chain = prompt | llm | output_parser

    result = await chain.ainvoke({"query": query})

    # 原始关键词和 LLM 扩展词一起参与召回;set 去重,避免重复请求同一关键词
    keywords = set(keywords + result)

    # 用字段 id 做唯一键,因为多个关键词、同一字段的多个向量点都可能命中同一个字段
    column_info_map: dict[str, ColumnInfo] = {}
    for keyword in keywords:
        # 查询词必须先转成向量,才能和第 9 章写入 Qdrant 的字段向量做相似度检索
        embedding = await embedding_client.aembed_query(keyword)
        current_column_infos: list[ColumnInfo] = await column_qdrant_repository.search(
            embedding
        )
        for column_info in current_column_infos:
            if column_info.id not in column_info_map:
                column_info_map[column_info.id] = column_info

    # 写回 state 的是去重后的 ColumnInfo 列表,不暴露 Qdrant 原始 point 结构
    retrieved_column_infos: list[ColumnInfo] = list(column_info_map.values())

    logger.info(f"检索到字段信息:{list(column_info_map.keys())}")
    return {"retrieved_column_infos": retrieved_column_infos}
指标召回
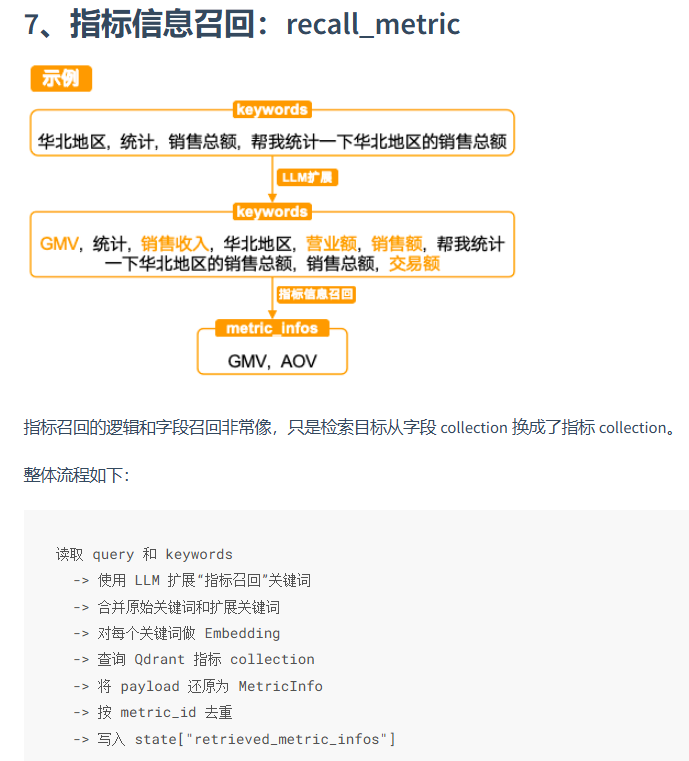
代码略,和召回字段的几乎一致。
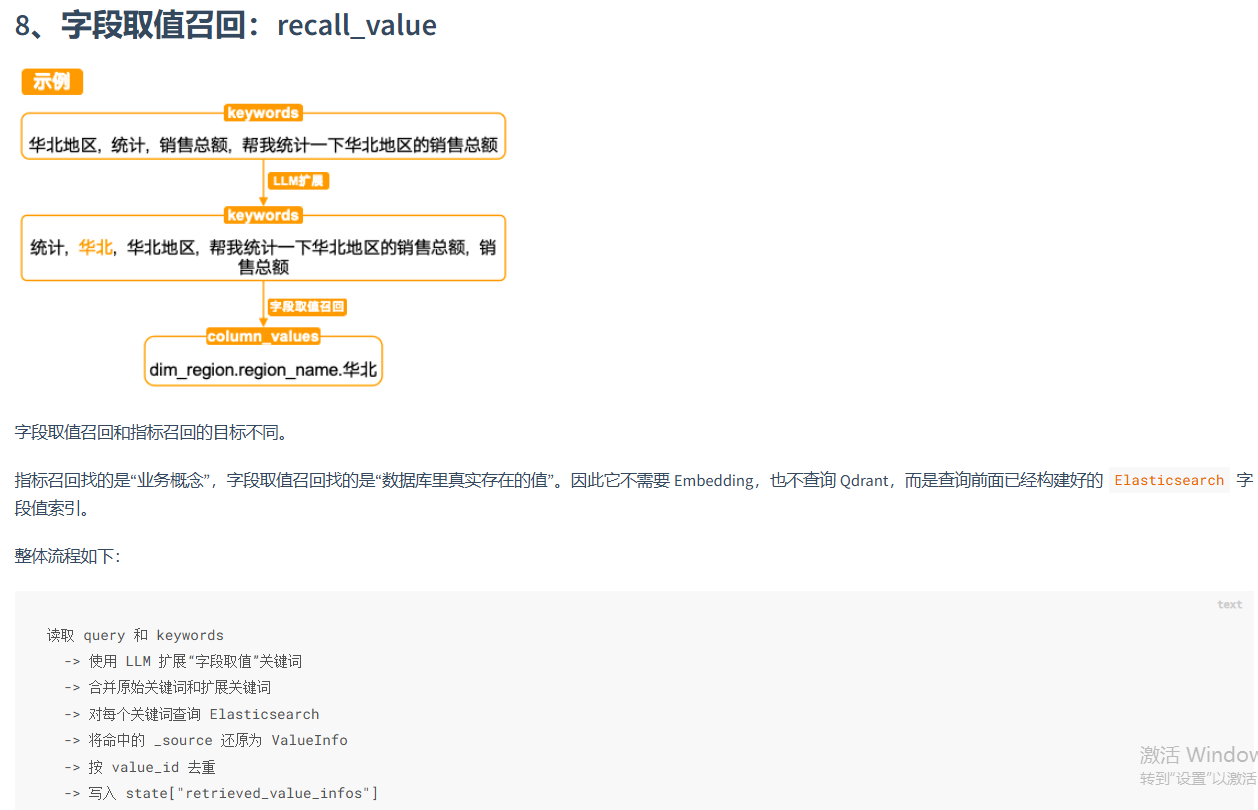
字段取值召回代码也差不多,略。
12 - 电商问数:召回信息合并与上下文构建
首先看下这个代码:
python
return [ColumnInfo(**point.payload) for point in result.points]这是很常见的字典解包,比如
python
payload = {
    "id": "orders.order_amount",
    "name": "order_amount",
    "description": "订单金额",
    "alias": ["销售额", "成交金额"],
}
那么:
column_info = ColumnInfo(**payload)
等价于:
python
column_info = ColumnInfo(
    id="orders.order_amount",
    name="order_amount",
    description="订单金额",
    alias=["销售额", "成交金额"],
)
就是把字典转为对象。
召回信息合并和上下文构建完整代码:
python
from langgraph.runtime import Runtime

from app.agent.context import DataAgentContext
from app.agent.state import (
    ColumnInfoState,
    DataAgentState,
    MetricInfoState,
    TableInfoState,
)
from app.core.log import logger
from app.entities.column_info import ColumnInfo
from app.entities.metric_info import MetricInfo
from app.entities.table_info import TableInfo
from app.entities.value_info import ValueInfo


async def merge_retrieved_info(
    state: DataAgentState, runtime: Runtime[DataAgentContext]
):
    """合并召回结果,并输出 SQL 生成前的候选表信息和指标信息"""

    writer = runtime.stream_writer
    writer("合并召回信息")

    retrieved_column_infos: list[ColumnInfo] = state["retrieved_column_infos"]
    retrieved_metric_infos: list[MetricInfo] = state["retrieved_metric_infos"]
    retrieved_value_infos: list[ValueInfo] = state["retrieved_value_infos"]

    meta_mysql_repository = runtime.context["meta_mysql_repository"]

    # 本节点的主线是:
    # 字段召回 + 指标依赖字段 + 字段真实取值 + 主外键补齐
    # -> table_infos / metric_infos,交给后续过滤和 SQL 生成节点继续使用。

    # 1. 以 column_id 为 key 合并字段信息
    # 三路召回可能命中同一个字段,用 dict 可以自然去重;
    # 后续指标依赖字段和字段取值也都通过 column_id 合并进来。
    retrieved_column_infos_map: dict[str, ColumnInfo] = {
        retrieved_column_info.id: retrieved_column_info
        for retrieved_column_info in retrieved_column_infos
    }

    # 2. 补齐指标依赖字段
    # 指标告诉模型"怎么算",但生成 SQL 还需要知道指标依赖哪些真实字段。
    # 如果相关字段没有被字段召回命中,就从 Meta MySQL 里按 id 查出来补进上下文。
    for retrieved_metric_info in retrieved_metric_infos:
        for relevant_column in retrieved_metric_info.relevant_columns:
            if relevant_column not in retrieved_column_infos_map:
                column_info: ColumnInfo = (
                    await meta_mysql_repository.get_column_info_by_id(relevant_column)
                )
                retrieved_column_infos_map[relevant_column] = column_info

    # 3. 把字段取值合并回字段 examples
    # 字段取值召回命中的是 column_id + value,例如 dim_region.region_name.华北。
    # 把真实 value 放进字段 examples,可以帮助模型写出更接近真实数据的 where 条件。
    for retrieved_value_info in retrieved_value_infos:
        value = retrieved_value_info.value
        column_id = retrieved_value_info.column_id
        if column_id not in retrieved_column_infos_map:
            column_info: ColumnInfo = await meta_mysql_repository.get_column_info_by_id(
                column_id
            )
            retrieved_column_infos_map[column_id] = column_info
        if value not in retrieved_column_infos_map[column_id].examples:
            retrieved_column_infos_map[column_id].examples.append(value)

    # 4. 按表组织字段上下文
    # SQL 生成提示词通常按"表 -> 字段列表"的方式描述结构,
    # 所以这里先把分散的字段按 table_id 归到各自所属表下面。
    table_to_columns_map: dict[str, list[ColumnInfo]] = {}
    for column_info in retrieved_column_infos_map.values():
        table_id = column_info.table_id
        if table_id not in table_to_columns_map:
            table_to_columns_map[table_id] = []
        table_to_columns_map[table_id].append(column_info)

    # 5. 补齐主外键字段
    # 主外键通常不会出现在用户问题里,单靠向量召回容易漏掉;
    # 但多表查询的 Join 路径必须依赖它们,所以每张候选表都要兜底补齐。
    for table_id in table_to_columns_map.keys():
        key_columns: list[
            ColumnInfo
        ] = await meta_mysql_repository.get_key_columns_by_table_id(table_id)
        column_ids = [column_info.id for column_info in table_to_columns_map[table_id]]
        for key_column in key_columns:
            if key_column.id not in column_ids:
                table_to_columns_map[table_id].append(key_column)

    # 6. 生成表结构上下文
    # 数据库实体里可能包含入库和索引用字段,传给模型前只保留必要信息,
    # 让后续过滤和 SQL 生成节点面对的是更稳定的 TableInfoState 结构。
    table_infos: list[TableInfoState] = []
    for table_id, column_infos in table_to_columns_map.items():
        table_info: TableInfo = await meta_mysql_repository.get_table_info_by_id(
            table_id
        )
        columns = [
            ColumnInfoState(
                name=column_info.name,
                type=column_info.type,
                role=column_info.role,
                examples=column_info.examples,
                description=column_info.description,
                alias=column_info.alias,
            )
            for column_info in column_infos
        ]
        table_info_state = TableInfoState(
            name=table_info.name,
            role=table_info.role,
            description=table_info.description,
            columns=columns,
        )
        table_infos.append(table_info_state)

    # 7. 生成指标上下文
    # 指标上下文保留名称 描述 别名和依赖字段,足够让模型理解业务口径。
    metric_infos: list[MetricInfoState] = [
        MetricInfoState(
            name=retrieved_metric_info.name,
            description=retrieved_metric_info.description,
            relevant_columns=retrieved_metric_info.relevant_columns,
            alias=retrieved_metric_info.alias,
        )
        for retrieved_metric_info in retrieved_metric_infos
    ]

    logger.info(f"合并后的表信息:{[table_info['name'] for table_info in table_infos]}")
    logger.info(
        f"合并后的指标信息:{[metric_info['name'] for metric_info in metric_infos]}"
    )

    return {"table_infos": table_infos, "metric_infos": metric_infos}
这段代码看起来长,但主线只有两条:
python
表信息:字段 Map -> 补指标字段 -> 补字段值 -> 按表分组 -> 补主外键 -> TableInfoState
指标信息:MetricInfo -> MetricInfoState
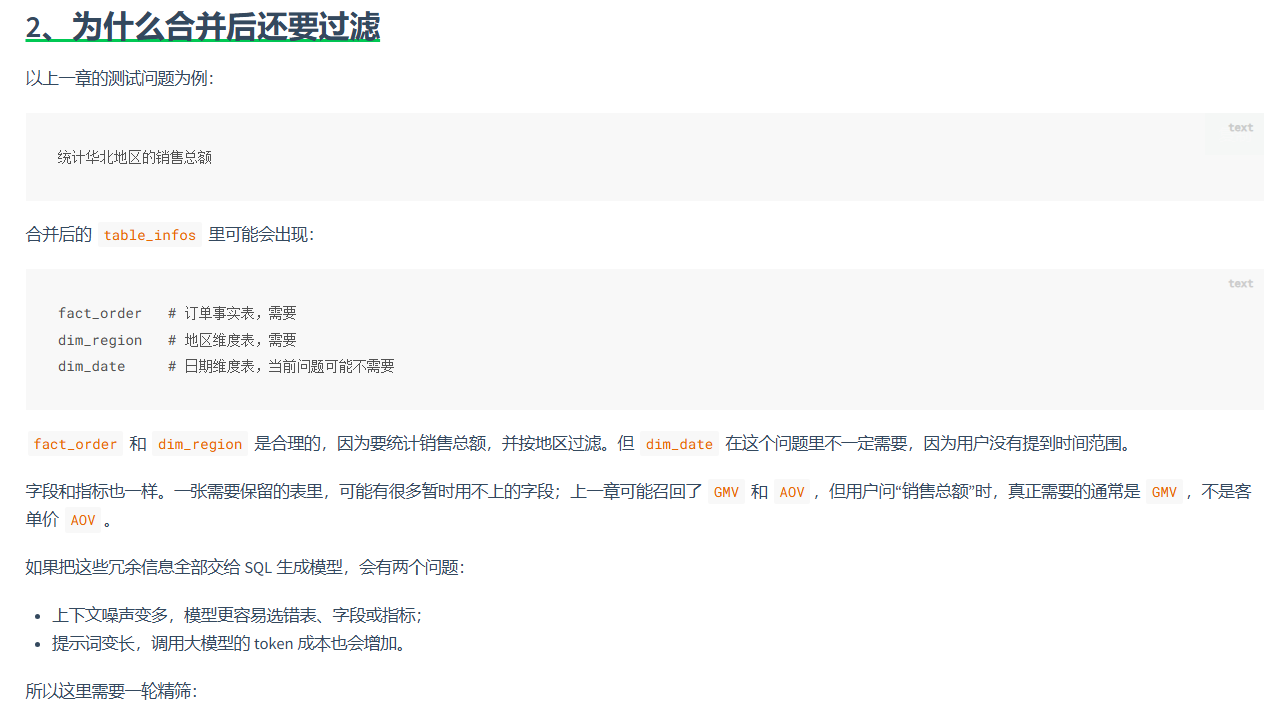
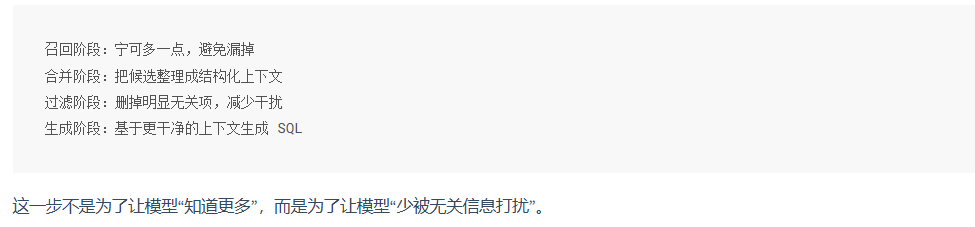
13 - 电商问数:SQL 生成前的信息过滤与补全
5.2 filter_table 核心代码
filter_metric的代码差不多,就略, 本质上都是掉用大模型。
python
import yaml
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import PromptTemplate
from langgraph.runtime import Runtime

from app.agent.context import DataAgentContext
from app.agent.llm import llm
from app.agent.state import DataAgentState, TableInfoState
from app.core.log import logger
from app.prompt.prompt_loader import load_prompt


async def filter_table(state: DataAgentState, runtime: Runtime[DataAgentContext]):
    """根据用户问题裁剪候选表结构上下文"""

    writer = runtime.stream_writer
    writer("过滤表信息")

    query = state["query"]
    table_infos: list[TableInfoState] = state["table_infos"]

    # table_infos 是嵌套结构,转成 YAML 后更适合放进提示词,也保留中文字段说明
    prompt = PromptTemplate(
        template=load_prompt("filter_table_info"),
        input_variables=["query", "table_infos"],
    )
    # filter_table_info prompt 要求模型只输出 JSON 对象:表名 -> 字段名列表
    output_parser = JsonOutputParser()
    # LCEL 管道:填充提示词 -> 调用模型 -> 解析 JSON
    chain = prompt | llm | output_parser

    result = await chain.ainvoke(
        {
            "query": query,
            "table_infos": yaml.dump(table_infos, allow_unicode=True, sort_keys=False),
        }
    )
    # 模型只负责选择,程序根据选择结果从原始 TableInfoState 中裁剪,避免模型重写复杂结构出错
    filtered_table_infos: list[TableInfoState] = []
    for table_info in table_infos:
        if table_info["name"] in result:
            table_info["columns"] = [
                column_info
                for column_info in table_info["columns"]
                if column_info["name"] in result[table_info["name"]]
            ]
            filtered_table_infos.append(table_info)

    logger.info(
        f"过滤后的表信息:{[filtered_table_info['name'] for filtered_table_info in filtered_table_infos]}"
    )
    return {"table_infos": filtered_table_infos}
8.2 add_extra_context 核心代码
python
from datetime import date

from langgraph.runtime import Runtime

from app.agent.context import DataAgentContext
from app.agent.state import DataAgentState, DateInfoState, DBInfoState
from app.core.log import logger


async def add_extra_context(state: DataAgentState, runtime: Runtime[DataAgentContext]):
    """补齐 SQL 生成所需的日期和数据库环境信息"""

    dw_mysql_repository = runtime.context["dw_mysql_repository"]

    # 当前日期信息会帮助模型处理"今天 本月 本季度 最近 N 天"等相对时间表达
    today = date.today()
    date_str = today.strftime("%Y-%m-%d")
    weekday = today.strftime("%A")
    quarter = f"Q{(today.month - 1) // 3 + 1}"
    date_info = DateInfoState(date=date_str, weekday=weekday, quarter=quarter)

    # 数据库方言和版本会影响函数名 日期运算 limit 语法等 SQL 细节
    db = await dw_mysql_repository.get_db_info()
    db_info = DBInfoState(**db)
    logger.info(f"数据库信息:{db_info}")
    logger.info(f"日期信息:{date_info}")
    return {"date_info": date_info, "db_info": db_info}
15 - 电商问数:API 接口基础与 FastAPI 入门
7、FastAPI 三件套:lifespan、middleware、Depends
前面已经把最小查询接口和流式协议跑通了。接下来再补三个 FastAPI 工程基础。
它们分别解决不同问题:
| 工程问题 | FastAPI 能力 | 本项目中的用途 |
|---|---|---|
| 应用启动和关闭时如何管理资源 | lifespan |
初始化和关闭外部客户端 |
| 每个请求前后如何统一执行逻辑 | middleware | 生成 request_id,辅助日志追踪 |
| 路由函数依赖的对象如何创建 | Depends |
组装 QueryService、Repository、Session |
这三个概念本章先理解到"各自管什么"就够了,具体代码会在后面两章展开。
7.1 lifespan:应用级资源什么时候初始化
FastAPI 的生命周期事件用于在应用开始接收请求前执行初始化逻辑,并在应用关闭时执行清理逻辑。现在推荐的写法是通过 FastAPI(lifespan=...) 传入一个异步上下文管理器。
为什么本项目需要它?因为问数接口依赖很多外部资源:
- Embedding 客户端;
- Qdrant 客户端;
- Elasticsearch 客户端;
- 元数据库 MySQL 连接;
- 数仓 MySQL 连接。
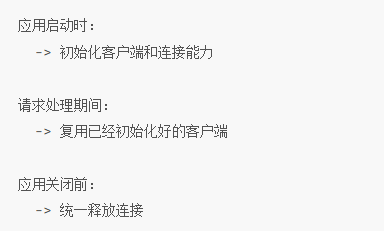
这些资源不应该每来一个请求就重新初始化一次。更合理的方式是:
FastAPI 中的 lifespan 写法类似下面这样:
python
from contextlib import asynccontextmanager

from fastapi import FastAPI


@asynccontextmanager
async def lifespan(app: FastAPI):
    # yield 之前:应用启动时执行,适合初始化客户端、连接池等应用级资源
    init_clients()

    # yield 处:FastAPI 应用进入运行状态,开始接收和处理请求
    yield

    # yield 之后:应用关闭前执行,适合释放连接、关闭客户端
    await close_clients()


# 把生命周期函数交给 FastAPI,框架会在启动和关闭时自动调用
app = FastAPI(lifespan=lifespan)
可以先把 yield 理解成分界线:
yield 前:应用启动时执行
yield 后:应用关闭时执行
下一章会把真实代码写成:
python
@asynccontextmanager
async def lifespan(app: FastAPI):
    # 应用启动时初始化外部客户端,后续请求可以直接复用这些客户端
    qdrant_client_manager.init()
    embedding_client_manager.init()
    es_client_manager.init()
    meta_mysql_client_manager.init()
    dw_mysql_client_manager.init()

    # 应用运行期间停在这里,开始处理请求
    yield

    # 应用关闭前释放外部连接,避免连接泄漏
    await qdrant_client_manager.close()
    await es_client_manager.close()
    await meta_mysql_client_manager.close()
    await dw_mysql_client_manager.close()
7.2 middleware:所有请求都经过的统一逻辑
这里的中间件不是 Kafka、RabbitMQ 那类消息中间件,而是 Web 框架中的请求中间件。它可以理解成包在所有接口外层的一段逻辑。
一次请求大致会经过:
客户端请求
  -> 中间件前半段
  -> 路由处理函数
  -> 中间件后半段
  -> 客户端响应
FastAPI 中定义 HTTP 中间件的基本写法是:
python
from fastapi import Request


@app.middleware("http")
async def add_process_time_header(request: Request, call_next):
    # call_next 之前:请求还没有进入具体路由,适合做鉴权、打 request_id 等统一处理
    response = await call_next(request)

    # call_next 之后:路由已经生成响应,适合补充响应头、记录耗时等
    return response
这里两个参数很重要:
| 参数 | 含义 |
|---|---|
request |
当前请求对象,可以读取路径、方法、请求头等 |
call_next |
把请求继续交给后续路由处理函数 |
中间件适合放所有接口都需要的横切逻辑,例如:
- 统一鉴权;
- 统计请求耗时;
- 添加响应头;
- 记录访问日志;
- 为每个请求生成
request_id。
本项目第 17 章会用中间件为每次请求生成唯一 request_id,让并发日志可以按请求维度追踪。
7.3 Depends:声明"我需要什么"
依赖注入(Depends)可以先按字面理解:接口函数只声明自己需要什么对象,FastAPI 负责在请求到来时调用依赖函数,把对象创建好并传进来。
官方示例的简化写法如下:
python
from typing import Annotated

from fastapi import Depends, FastAPI

app = FastAPI()


async def common_parameters(skip: int = 0, limit: int = 100):
    # 依赖函数可以像普通函数一样接收参数、组织数据,并返回给接口使用
    return {"skip": skip, "limit": limit}


@app.get("/items/")
async def read_items(
    # Annotated[真实类型, Depends(依赖函数)]
    # 表示 commons 的类型是 dict,获取方式是调用 common_parameters
    commons: Annotated[dict, Depends(common_parameters)],
):
return commons这段代码里,read_items() 没有手动调用 common_parameters(),它只是声明:
我需要一个 commons
commons 的获取方式是 Depends(common_parameters)
请求进来时,FastAPI 会自动调用依赖函数。
放回本项目,查询接口最终会这样写:
python
@query_router.post("/api/query")
async def query_handler(
    # 请求体参数:FastAPI 会把 JSON 请求体解析成 QuerySchema
    query: QuerySchema,
    # 业务服务参数:FastAPI 会调用 get_query_service 来创建 QueryService
    query_service: Annotated[QueryService, Depends(get_query_service)],
):
    return StreamingResponse(
        # 下一章会把真实问数工作流封装到 query_service.query(...) 中
        query_service.query(query.query),
        media_type="text/event-stream",
    )
这表示:
query 来自请求体
query_service 来自 get_query_service 这个依赖函数
路由层不需要关心 QueryService 里面又依赖哪些 Repository、Session、Client。这些对象会交给下一章的 dependencies.py 分层组装。