用户输入一句话:"帮我看看订单 O-1001 为什么还没到。"
背后可能有订单 Agent、物流 Agent、客服 Agent,还可能有不同机房里的多个容器。问题随之而来:客户端怎么选?Agent 之间怎么传信息?扩容以后,上一次对话和正在执行的任务又去哪里找?
把这条请求走完,A2A、Nacos、AgentScope、Agent Harness、MCP 和记忆库之间的关系就清楚了。
先给出分工:客户端决定把任务交给哪个 Agent 服务;注册中心提供能力描述和实例信息;A2A 传递消息、任务状态与产物;服务内的 Harness 组织执行;工具和状态存储由业务应用接入。
下面用一个订单诊断应用说明设计。域名、订单号、返回内容和部署拓扑均为示例。协议报文按 A2A 1.0 编写,参考 v1.0.1 文档,线上协议版本字段写 1.0。框架接入另行说明兼容边界。
1. 先把应用、Harness 和 Agent 放对位置
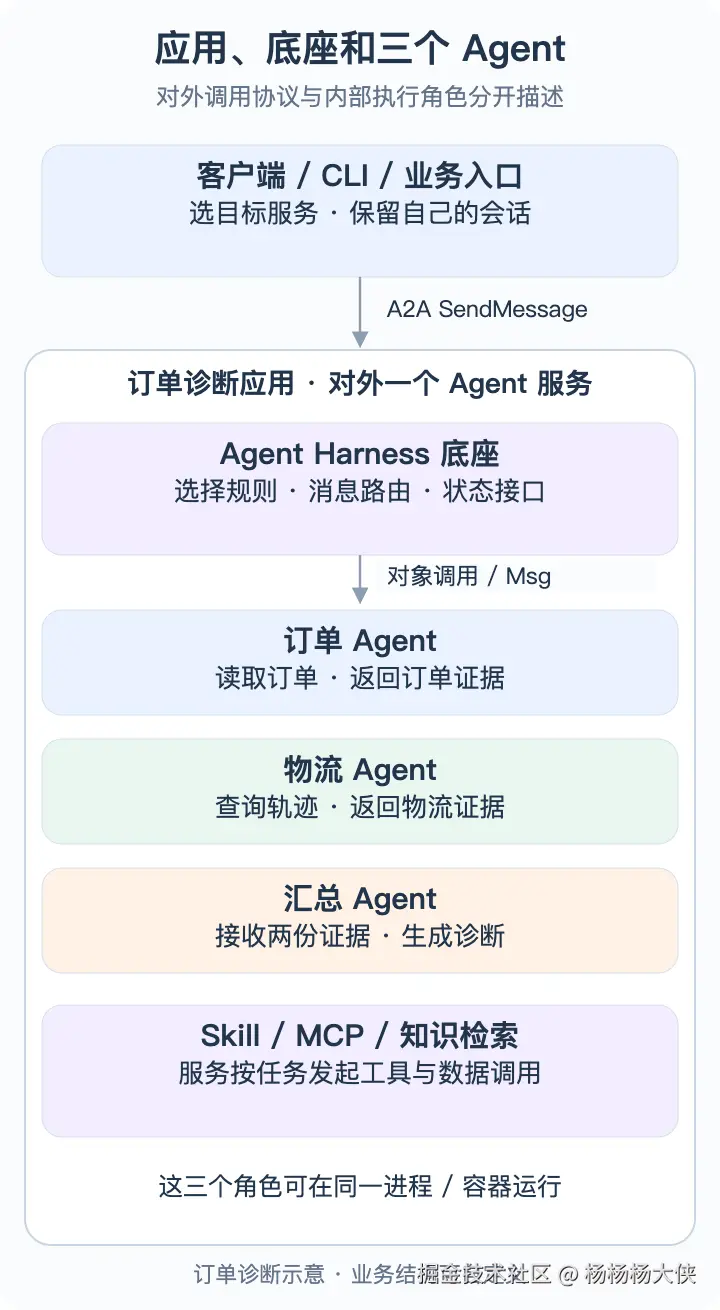
图里的"订单诊断应用"对外提供一个 A2A Agent 服务,内部有三个角色:
- 订单 Agent:读取订单状态,判断支付、出库等环节。
- 物流 Agent:查询运单轨迹,判断运输是否异常。
- 汇总 Agent:把证据合成结论,说明不确定项和下一步建议。
这里的 Agent Harness 指运行底座:管理模型调用、工具执行、消息、选择规则、执行循环以及状态接口。Agent 是它运行的任务角色。本文不把"单个 Agent"叫作 Harness,也不把这个通用概念等同于某个框架的同名类。
AgentScope 是开发框架;用它构建的应用,可以组织多个 Agent。 一个应用也可以组合多个 Harness,但"应用、Harness、Agent、Docker 容器"之间没有协议规定的一对一关系。
本例可以先把三个 Agent 放在同一个 Python 进程、同一个容器里。它们是运行对象,不要求每个角色独占一个 Docker。需要独立扩缩容或隔离依赖时,再拆成服务,通过 A2A 等网络接口协作。
客户端也不限于终端 CLI。业务系统后端、网页入口、工作流服务,甚至另一个 Agent,都可以成为 A2A 客户端。A2A 核心概念
2. 先选 Agent 服务,再选运行实例
假设系统暴露了两个服务:order-assistant 和 refund-assistant。客户端输入"查物流",怎么知道该读前者的 Card?
先有候选服务,再读能力描述,最后做业务选择。 候选名单可以来自业务配置、注册目录或受控的搜索接口;协议不会凭空替客户端认识所有 Agent。
Agent Card 是服务说明书:名字、能力描述、业务 skills、协议接口、版本及认证要求。skills 帮客户端理解"这个服务能做什么",并不是远端工具的完整实现目录。Agent 发现机制
一张最小 Card 长什么样
下面是 1.0 的最小业务示例。生产服务还应按实际认证方案补充 Card 声明与服务端校验。
json
{
  "name": "order-assistant",
  "description": "诊断订单与物流异常,输出证据和建议",
  "version": "1.0.0",
  "supportedInterfaces": [
    {
      "url": "https://agent.example.com/a2a",
      "protocolBinding": "JSONRPC",
      "protocolVersion": "1.0"
    }
  ],
  "capabilities": {},
  "defaultInputModes": ["text/plain"],
  "defaultOutputModes": ["application/json"],
  "skills": [
    {
      "id": "order-diagnosis",
      "name": "订单诊断",
      "description": "结合订单状态和物流轨迹诊断延迟",
      "tags": ["order", "logistics"]
    }
  ]
}
version 是这个 Agent 服务自己的版本;protocolVersion 是接口使用的 A2A 版本。不能混为一谈。官方数据模型
两个 Agent 暴露相同 skill,谁来选
同样声明"订单诊断",不代表两者能力、数据权限或成本完全一样。客户端可以先按租户授权、环境、协议兼容性和业务范围过滤,再按确定规则或 LLM 判断。
固定业务适合明确映射,例如"物流问题 → order-assistant"。开放任务可把经过过滤的候选 Card 摘要交给 LLM,让模型返回候选中的服务名。Harness 校验这个名字,再实际发请求。模型不能绕过候选名单随意拼接 URL。
规则由应用开发者或平台配置制定;选择由客户端代码执行,也可以由代码调用 LLM 辅助决定。 把 Card 放进一个文件只是配置方式,放进数据库或注册中心也可以。
选定 order-assistant 后,才进入第二层:同一服务的三个实例里,选哪个地址?这层按客户端 SDK、网关或负载均衡策略处理健康状态、地域、权重、会话亲和等因素。通常不需要让 LLM 选择 IP。
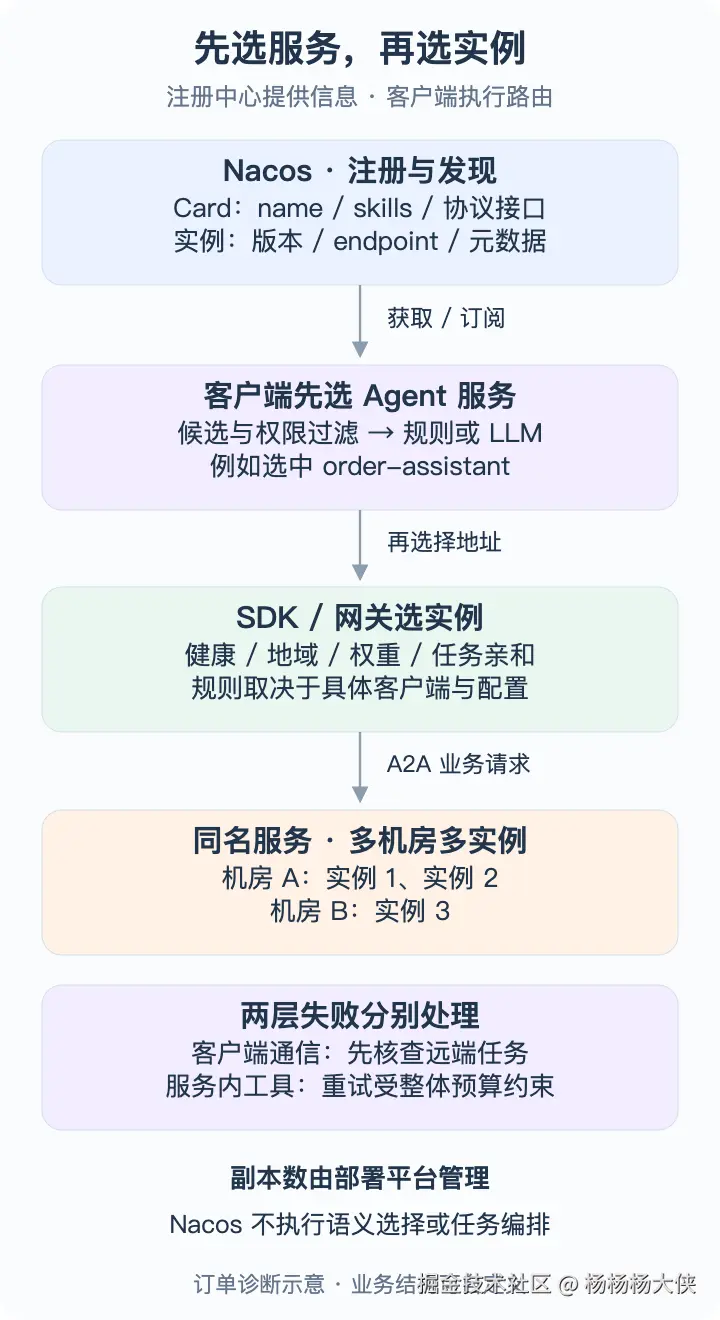
Nacos 负责哪一段
Nacos 的 Agent 管理支持 Card 发布、查询和订阅,以及 endpoint 注册。公开逻辑身份以 namespaceId + AgentCard.name 区分;Card 版本与实例地址分别管理。同一个名称和版本可登记多个 endpoint。Nacos Agent 管理
例如两个机房的三份容器,都可以登记为 order-assistant 的实例。客户端获取更新后的描述和地址,再按自己的路由策略调用。
因此,多机房部署和传统服务发现有相似之处:Nacos 提供目录与变化通知,客户端或网关执行实例选择,请求进入目标服务。 容器副本数由部署平台管理;跨机房容灾顺序、业务 Agent 的语义选择和任务恢复,则需要相应应用策略。
还有一个容易踩的边界:当前官方 Agent 管理文档说明,按 skill、tag、description 等做模糊发现仍在开发中。不能直接假设"注册进去后,Nacos 就能按一句自然语言自动找 Agent"。可以先配置候选服务名,再读取它们的 Card。
3. Card 读完,实际发什么请求
Card 给出怎么连接;实际消息按 A2A 的请求模型发送。 客户端不会把整张 Card 当任务发送,也没有一个通用的"远程调用 skillId"操作。
本例选择 Card 中的 JSON-RPC 接口,发出:
http
POST /a2a HTTP/1.1
Host: agent.example.com
Content-Type: application/json
A2A-Version: 1.0
如果服务要求认证,HTTP 层还要携带与声明匹配的凭据。下面展示业务消息体:
json
{
  "jsonrpc": "2.0",
  "id": "req-001",
  "method": "SendMessage",
  "params": {
    "message": {
      "messageId": "msg-001",
      "role": "ROLE_USER",
      "parts": [
        {"text": "请诊断订单 O-1001 为什么还没到"}
      ]
    }
  }
}
请求里说的是业务任务。服务接收后决定由哪些内部 Agent、工具或流程完成;客户端无需知道这些实现细节。JSON-RPC 绑定与迁移说明
一次完成的示例返回:
json
{
  "jsonrpc": "2.0",
  "id": "req-001",
  "result": {
    "task": {
      "id": "task-001",
      "contextId": "ctx-001",
      "status": {"state": "TASK_STATE_COMPLETED"},
      "artifacts": [
        {
          "artifactId": "diagnosis-001",
          "parts": [
            {
              "mediaType": "application/json",
              "data": {
                "orderId": "O-1001",
                "conclusion": "运输延迟",
                "evidence": ["订单已出库", "转运节点超过预期时长"],
                "nextAction": "联系物流核实预计送达时间"
              }
            }
          ]
        }
      ]
    }
  }
}这里的证据内容是演示数据。SendMessage 也可以返回 result.message;长任务可以先返回仍在处理的 Task,再通过查询、流或订阅接收更新。上面只演示一种完成路径。任务生命周期
三个 ID 各自管什么
jsonrpc.id:把一次 RPC 请求与对应响应匹配起来。messageId:标识一条消息,由发送方提供。task.id:标识远端任务,由服务端产生;contextId关联相关消息和任务。
首次请求不需要自己编一个 taskId。本例由服务端返回 contextId。下一轮可按服务契约带上已返回的 contextId;继续一个尚可交互的任务时,再按状态带上相应 taskId。
contextId 是关联标识,不等于把完整历史、记忆或授权一起传给了对方。 更不能把一个服务返回的 ID 原样送给另一个服务,就期待两边自动共享上下文。
4. 请求进入应用,三个 Agent 怎么协作
客户端交给的是 order-assistant。内部的订单、物流、汇总三个 Agent 不必各自注册 Nacos,也不必为每一次本地调用走 A2A。
一种简单流程是:Harness 校验请求和访问范围,提取订单号,给订单 Agent 和物流 Agent 分发任务,两者完成后把结果交给汇总 Agent。
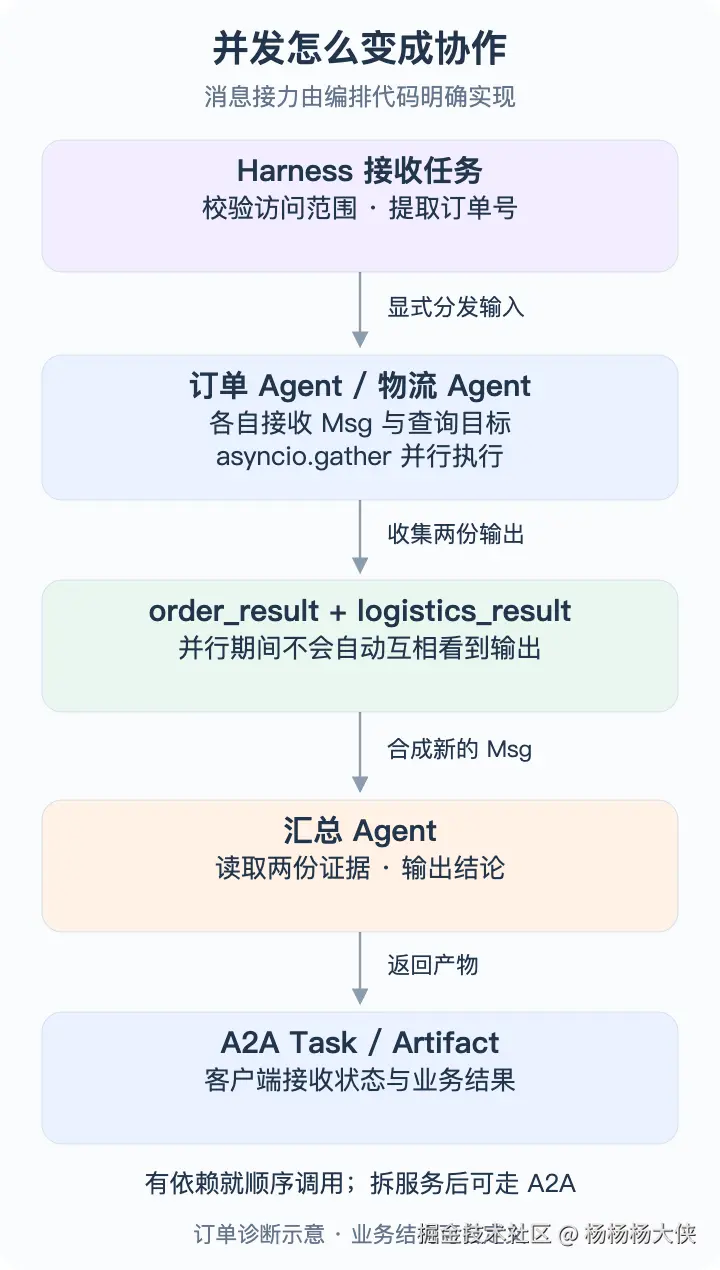
asyncio.gather 只是并发,协作靠消息接力
下面用 AgentScope 的 Msg 表达输入输出。假设 order_agent、logistics_agent 和 summary_agent 已创建,数据工具已注册。代码是编排示意,不包含服务启动和模型配置。
python
import asyncio
from agentscope.message import Msg

async def diagnose_order(order_id: str):
    # 将调用目标和业务范围明确传给订单角色。
    order_input = Msg("orchestrator", f"查询订单 {order_id} 的订单状态", "user")
    # 物流角色只接收本任务所需的订单号与查询目标。
    logistics_input = Msg("orchestrator", f"查询订单 {order_id} 的物流异常", "user")

    # 并行执行;结果在两个调用都完成后交回编排代码。
    order_result, logistics_result = await asyncio.gather(
        order_agent(order_input),
        logistics_agent(logistics_input),
    )

    # 显式转发两份结果,汇总角色才会看到双方提供的证据。
    summary_input = Msg("orchestrator", [
        {"type": "text", "text": f"诊断订单 {order_id},保留证据与不确定项。"},
        {"type": "text", "text": str(order_result.content)},
        {"type": "text", "text": str(logistics_result.content)},
    ], "user")

    # 最后一跳负责形成对外产物。
    return await summary_agent(summary_input)
gather 不会让正在运行的订单 Agent 自动看到物流 Agent 的结果。信息在哪里传递,代码必须有对应的数据通路。 本例就是"两份输入 → 两份输出 → 一份汇总输入"。
如果物流查询必须先从订单结果取到运单号,就改成顺序调用。如果后续需要双方讨论,可显式轮流投递消息,或使用 AgentScope 的 MsgHub 让参与者观察消息;退出条件、发言顺序和最大轮数仍要由应用规定。AgentScope Pipeline 与 MsgHub
同一进程里,主要通过对象调用和 Msg 传数据。拆成独立服务后,可以把下一跳实现成 A2A 客户端调用。多 Agent 协作既可以发生在一个应用内,也可以跨服务;并不要求 CLI 同时调用所有 Agent。
Harness 怎么知道角色和工具
开发者注册角色的名称、描述、入口,以及它允许使用的工具。固定流程直接调用目标对象;动态编排可把允许调用的角色包装成工具,把名称、描述、参数类型等交给 LLM。模型提出选择,Harness 校验参数并执行。AgentScope Routing
因此,"其他 Agent 写在一个文件里,由编排 Agent 读取后调用 LLM"是一种可行做法,但不是唯一做法。关键在于:候选角色来自哪里,选择规则是什么,执行入口是什么,结果如何回传。 自定义 Harness 可以自己定义这些规则。
还要区分两个常被同名叫作 skill 的东西:Card 的 skills 是对外业务能力描述;本地 Skill 可以是工作步骤、提示和操作规范。服务可以依据任务使用某个本地 Skill,也可以调用 MCP 工具。MCP 工具的具体操作由工具服务器执行,业务 Agent/Harness 负责发起调用并处理结果。A2A 与 MCP 的关系
5. AgentScope 和 Nacos 怎么接,CLI 有哪些现成选择
AgentScope 的官方教程提供了按名称从 Nacos 解析远端 Card 的接法。结构如下:
python
from agentscope.agent import A2AAgent
from agentscope.a2a import NacosAgentCardResolver
from v2.nacos import ClientConfig

# 用明确的远端服务名定位注册记录。
resolver = NacosAgentCardResolver(
    remote_agent_name="order-assistant",
    nacos_client_config=ClientConfig(
        server_addresses="http://localhost:8848"
    ),
)

# 获取描述后,将远端服务包装为 AgentScope 可调用对象。
card = await resolver.get_agent_card()
remote_agent = A2AAgent(agent_card=card)
localhost 是本地开发地址,真实环境按网络与认证配置。上面展示官方 API 的接入顺序;具体版本的构造参数与依赖,以安装版本文档为准。AgentScope A2A 教程
这里必须提醒一个版本边界。 当前 AgentScope 在线教程仍有旧式 Card 顶层 url 等示例,A2A 功能也标为实验性;Nacos 3.1 的教程示例使用 0.3 协议。不能把教程代码与前面的 1.0 报文拼起来,就说已完成互通。
接入前需要核对解析出来的 Card、实际客户端和服务端支持的版本。只得到 0.3 Card 时,两端固定使用 0.3,或通过明确支持版本转换的兼容层接入。前面的 1.0 示例中,方法名、枚举值与 Part 结构都按 1.0 编写。Nacos 3.1 示例
Nacos Java SDK 的官方注册模式是先发布 Card,再登记服务实例,例如 releaseAgentCard(card) 与 registerAgentEndpoint(agentName, agentVersion, host, port, "JSONRPC")。Spring AI Alibaba 则有由 Nacos registry starter 注入的 AgentCardProvider,配合 A2aRemoteAgent 接入,Java 业务系统不一定需要另造一个终端入口。以上是官方接入模式,本例的订单诊断部署未做真实互操作测试。
开源客户端可以先看这三个方向
- 官方 a2a-cli:适合查看 Card、发消息、调试任务和流式返回。
- 官方 Python SDK:适合在业务后端或自定义编排器里集成客户端。
- Spring AI Alibaba:适合 Java Agent 应用,结合 Nacos 做服务发现与远端 Agent 接入。
官方 CLI 的简单用法是:
bash
a2a card get https://agent.example.com
a2a send -a https://agent.example.com "诊断订单 O-1001"
这两条命令指定了目标服务。业务候选筛选、Nacos 接入、同 skill 选择和完整失败恢复,还需要在应用层组合实现,不能默认把这些能力算到 CLI 里。
6. 多个 Docker 副本和两层重试,最容易漏什么
给 order-assistant 部署三个副本,就可能有三份运行相同应用的容器,每份内部都能创建订单、物流、汇总 Agent。也可以多个进程共处一个容器;副本与 Agent 对象不是同一个维度。
扩容后有两个独立问题:新请求路由到哪台机器,已有任务在哪台机器继续。
第一层失败发生在客户端到 Agent 服务之间,例如连接断开、响应超时。重试策略由客户端 SDK、网关或业务代码定义。超时只说明客户端没拿到结果,并不能证明远端没执行。
如果已经拿到 task-001,先按同一服务和任务路由查询:
json
{
  "jsonrpc": "2.0",
  "id": "req-002",
  "method": "GetTask",
  "params": {
    "id": "task-001",
    "historyLength": 0
  }
}
GetTask 成功时的 result 直接是 Task 对象,与 SendMessage 的 result.task 包装不同。查询、订阅或取消需要服务端具备对应能力及访问权限。A2A 操作定义
还没拿到任务 ID 就断开时,应用需要约定可核查的业务请求标识和幂等机制。相同 messageId 不自动保证"恰好执行一次";规范允许发送消息实现幂等,但不能替每个服务保证具体行为。
第二层失败发生在 Agent 服务内部,例如物流 MCP 超时。应由业务 Agent、Harness 或工具适配器决定重试,设置次数、退避和整体截止时间。外层三次、内层三次,可能放大成九次实际调用;需要共享整体预算,避免层层重复。
读订单通常较容易安全重试;退款、发券、下单等写操作,要先查询执行结果,并使用业务幂等键与服务端约束。
换一个容器后,任务能否继续也有条件:要么路由保持任务亲和,要么副本共享任务状态并具备恢复流程。共享数据库不会让原进程里的协程在新容器自动接着跑;恢复需要检查点、执行归属、租约或并发控制,以及对外部操作结果的核查。
7. 上下文、记忆和知识库,分别放在哪里
"上下文在 CLI,还是先查数据库?"没有二选一答案。完整状态在哪里持久化,与这一次发给模型或远端服务的内容,是两件事。
客户端可以保留用户会话、任务拆分和各远端服务返回的 ID;业务 Agent 服务保留自己的执行历史和业务记忆。每一层在调用前加载需要的状态,选择与当前任务相关的内容,再发送必要的消息或资料。
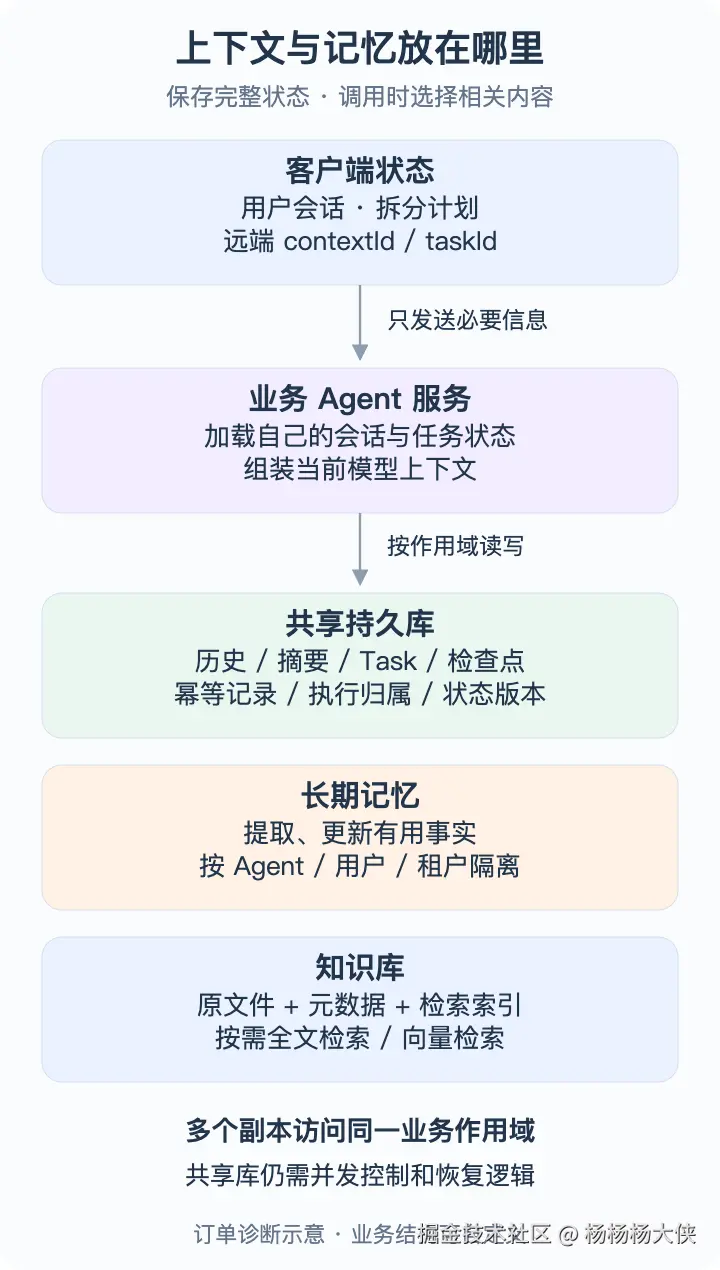
可以先按五类数据管理
| 数据 | 主要用途 | 本例可用的存储 |
|---|---|---|
| 当前模型上下文 | 本轮送入模型的消息、工具结果与检索片段 | 从状态中选取,临时组装在内存 |
| 会话历史与摘要 | 延续同一个用户会话 | PostgreSQL、MySQL 等持久库 |
| 任务状态与检查点 | 记录进度、结果、幂等信息与恢复位置 | 有事务与并发控制的持久库 |
| 长期记忆 | 跨会话保存有用事实、偏好或经验 | 事实记录,可加向量索引 |
| 知识库 | 检索业务文档、规则和历史材料 | 原文存储、元数据、全文或向量索引 |
"放在数据库"只是存储介质的回答。不同数据的生命周期、作用域和一致性要求还要分别定义。知识库原文件也可能放在对象存储中;向量库通常保存可检索的片段和索引,并不等于整个知识库。
主流框架给了哪些实现
AgentScope 提供 InMemoryMemory、AsyncSQLAlchemyMemory、RedisMemory 等记忆实现;持久化记忆可以按 user_id、session_id 区分。Session 负责保存、加载应用状态,长期记忆还有 Mem0 等接入。短期记忆、Session、长期记忆
LangGraph 用 checkpointer 保存线程执行状态,用 Store 表达跨会话数据。生产示例使用数据库后端,进一步说明"当前会话"和"跨会话记忆"可以采用不同接口与作用域。LangGraph Memory
对于检索,PostgreSQL 加 pgvector 可以在现有数据库中保存向量,也能结合全文检索。知识库一般先做解析、分块和索引,查询时召回、过滤并按需重排,再把片段交给模型。pgvector、Dify RAG
Mem0 等记忆组件会从交互中提取和更新有用事实。长期记忆不宜简单等同于"所有聊天原文都向量化":什么时候写入、如何去重或更新、哪些事实允许跨会话使用,都属于业务策略。Mem0 开源说明
多副本共享的是同一业务作用域
本例可先采用这样的设计:客户端把自己的会话存入所属应用的数据库;订单诊断服务把会话、任务和幂等记录放入共享 PostgreSQL;业务文档需要语义检索时再加 pgvector;原文件放对象存储。
每份容器按已验证的身份、租户、Agent、用户和会话范围读写。相同类型的副本可以访问同一作用域的数据;不同用户和租户不能因为"共享记忆库"就共用一份无边界历史。
同一个会话同时来两条消息时,还需要串行队列、事务、版本校验或等效控制。把上下文搬进共享库解决了"换机器可读取",并没有同时解决并发覆盖、任务恢复和重复执行。
8. 沿这条订单请求,再走一遍
用户说"订单还没到",客户端先恢复自己的会话,拿到允许使用的候选服务描述。选择规则或 LLM 判断交给 order-assistant;SDK 或网关根据地址与路由策略选择实例。
客户端向目标接口发送 A2A SendMessage。服务校验请求后,由 Harness 分配订单与物流任务,收齐证据,交给汇总 Agent;所需本地 Skill、MCP 与知识检索由服务内部接入。
服务保存执行状态,返回 Task 和 Artifact。客户端记录远端 contextId、任务 ID 与结果,形成自己的用户回复。下一轮分别加载两边的相关状态;发生失败时,按外层通信和内层工具两种责任处理,遇到未知执行结果先核查。
这就是可以逐步落地的多 Agent 系统:先把候选、选择、消息、工具、状态、恢复六条通路写清楚,再决定哪些角色合在一个应用里,哪些值得独立部署。A2A 为跨服务交互建立共同协议,其余工程职责依然有明确的主人。