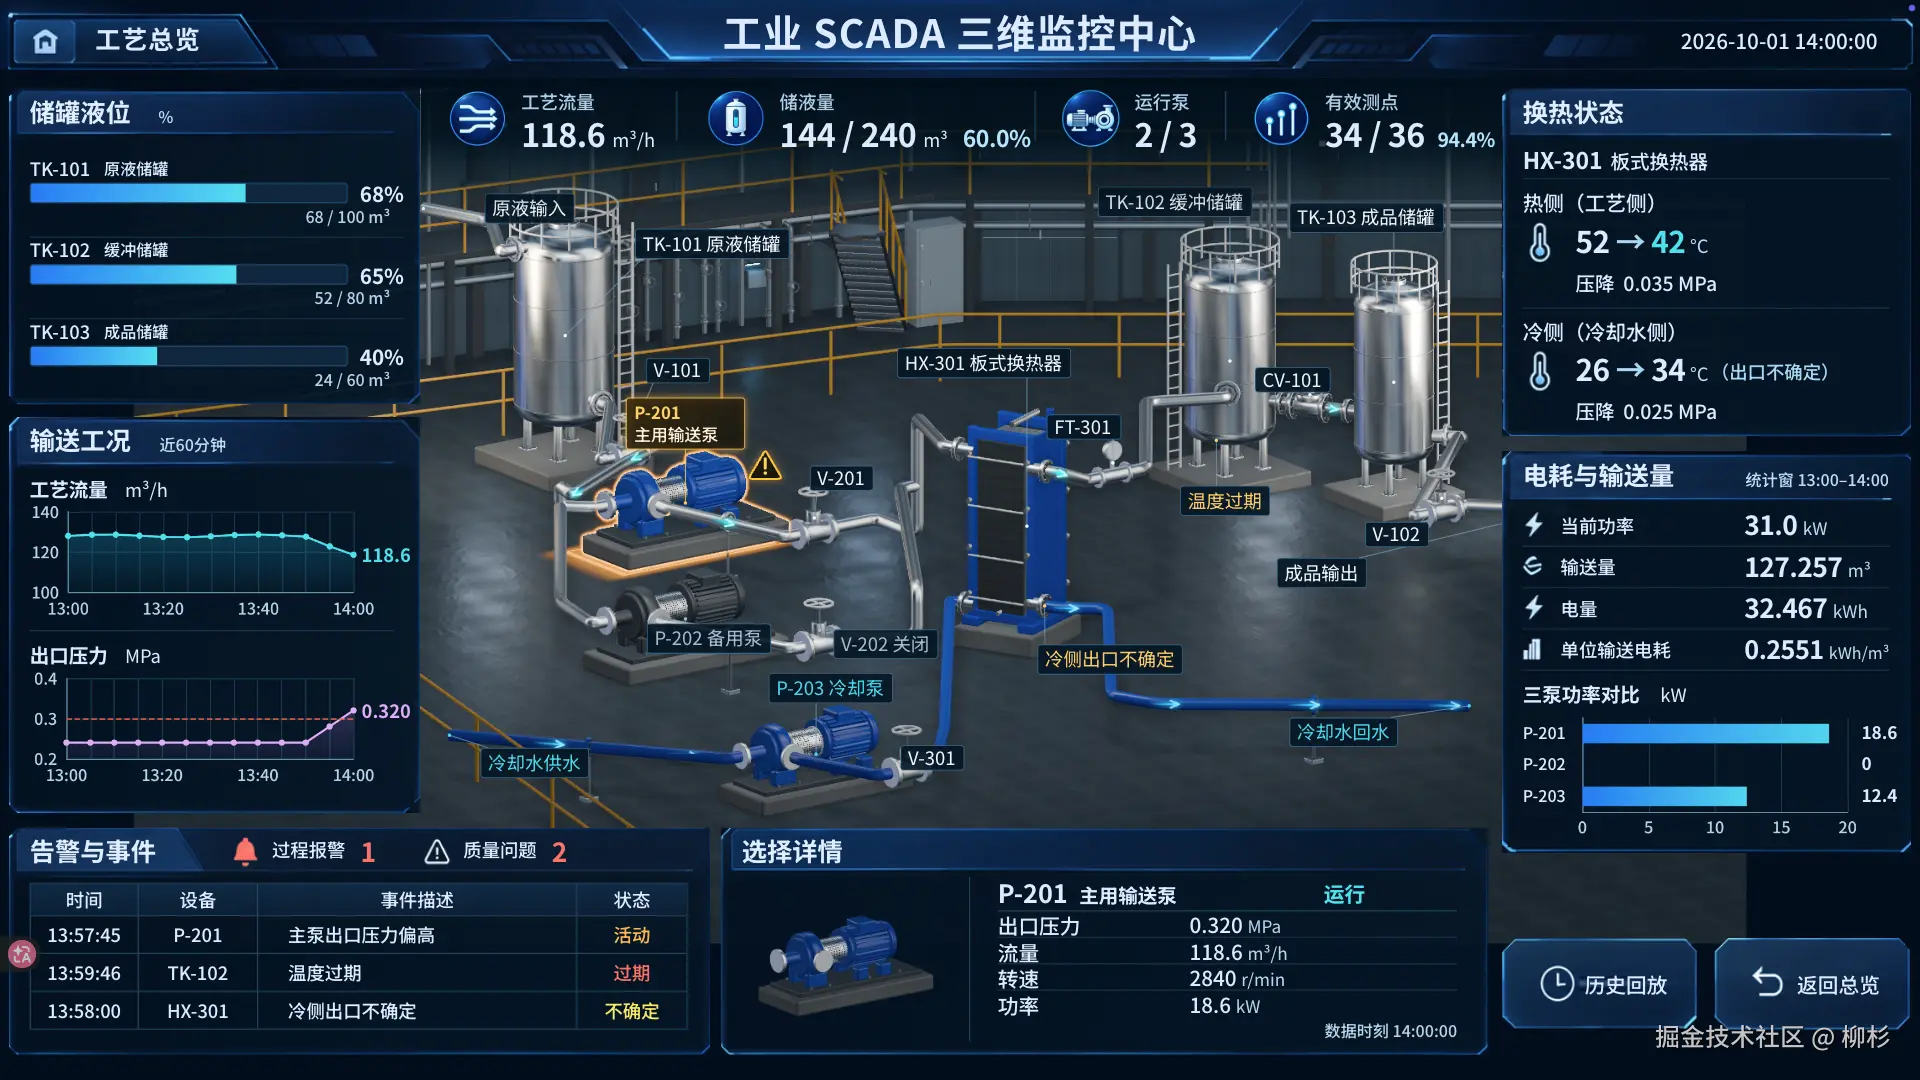
在不断完善这个可视化大屏工作流的过程中,我发现能做出来的效果也在不断变化------从最初的"可交互",逐渐做到了"可动效"。
以前对着一张可视化设计稿,经常要感慨"这个场景大概率实现不了":三维模型太理想化、交互逻辑说不清楚、数据和画面对不上,最后只能打折交付。但这套工作流跑过几个项目之后,情况变了------现在拿到一份完整的大屏设计稿,基本能确认90% 的设计可以实现,其中 95% 能做到和原稿基本一致。
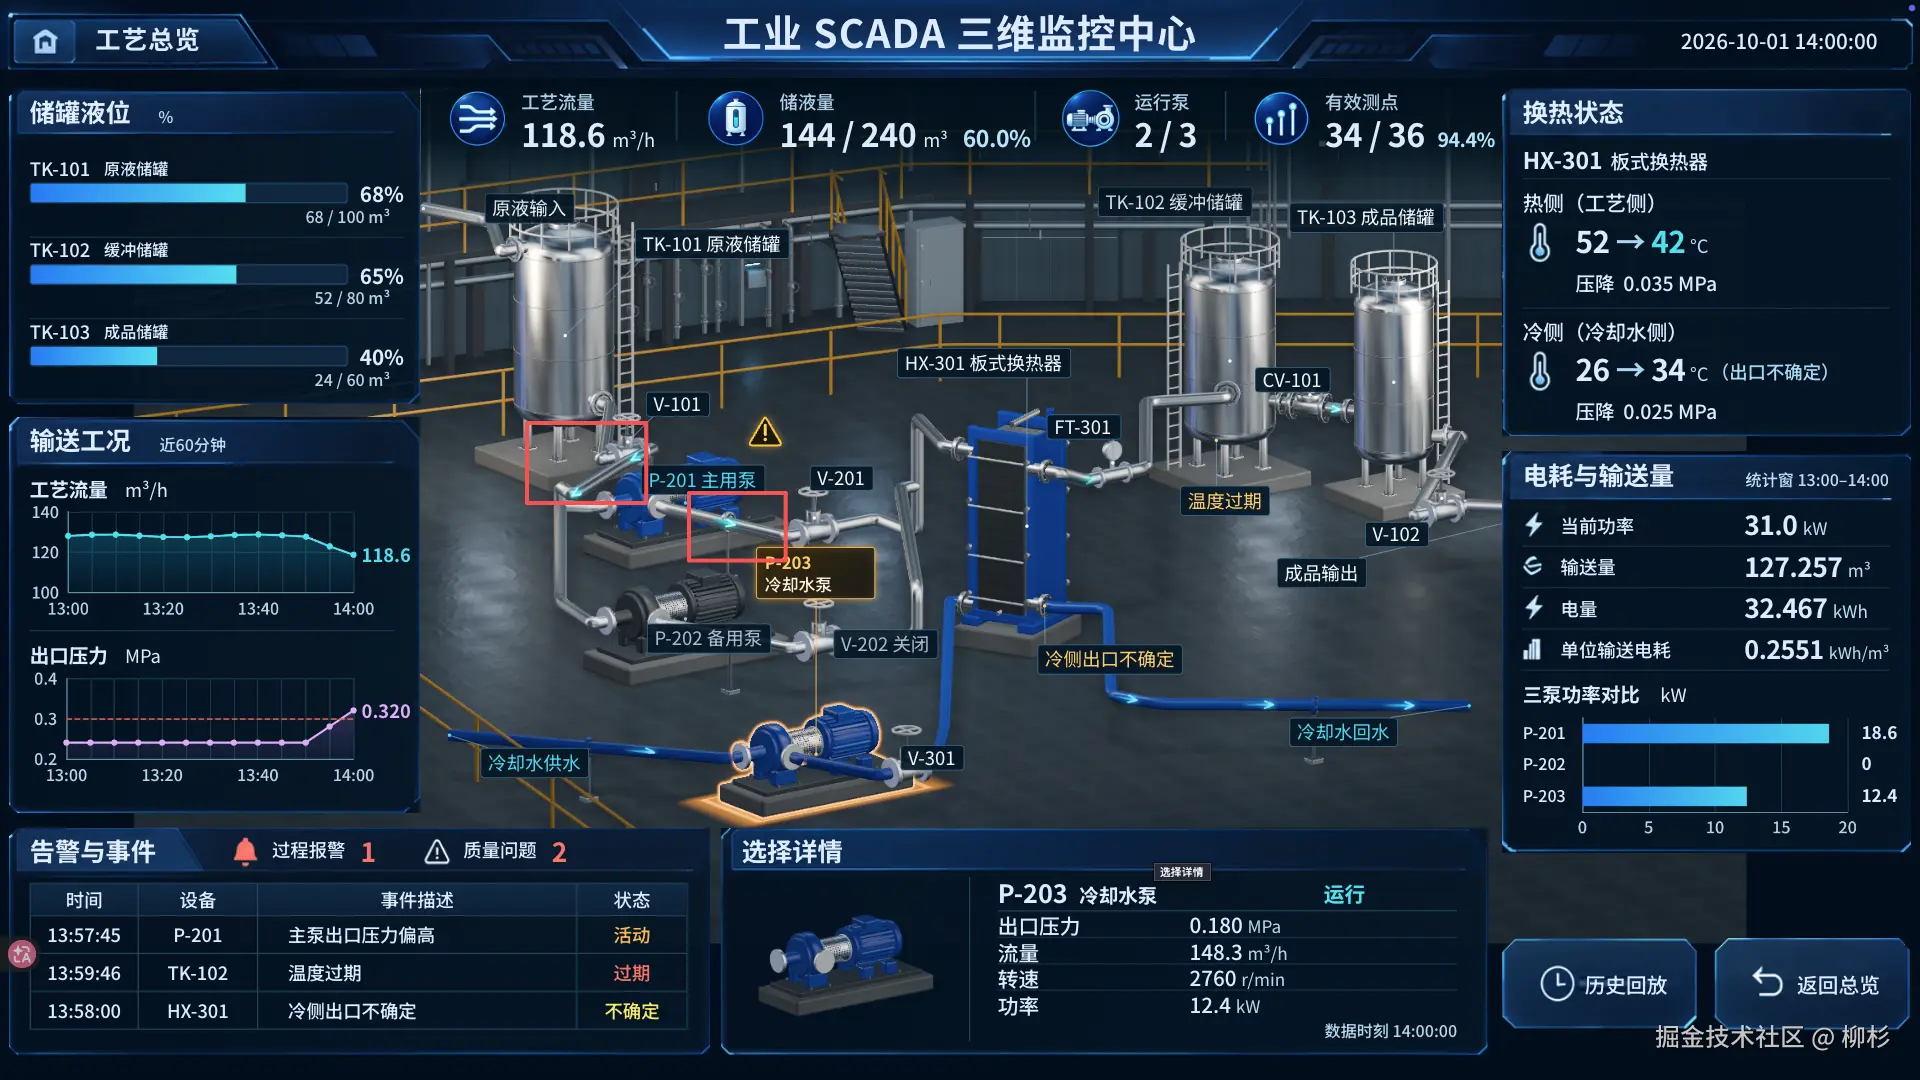
这次做的,是一个工业 SCADA 三维监控大屏。
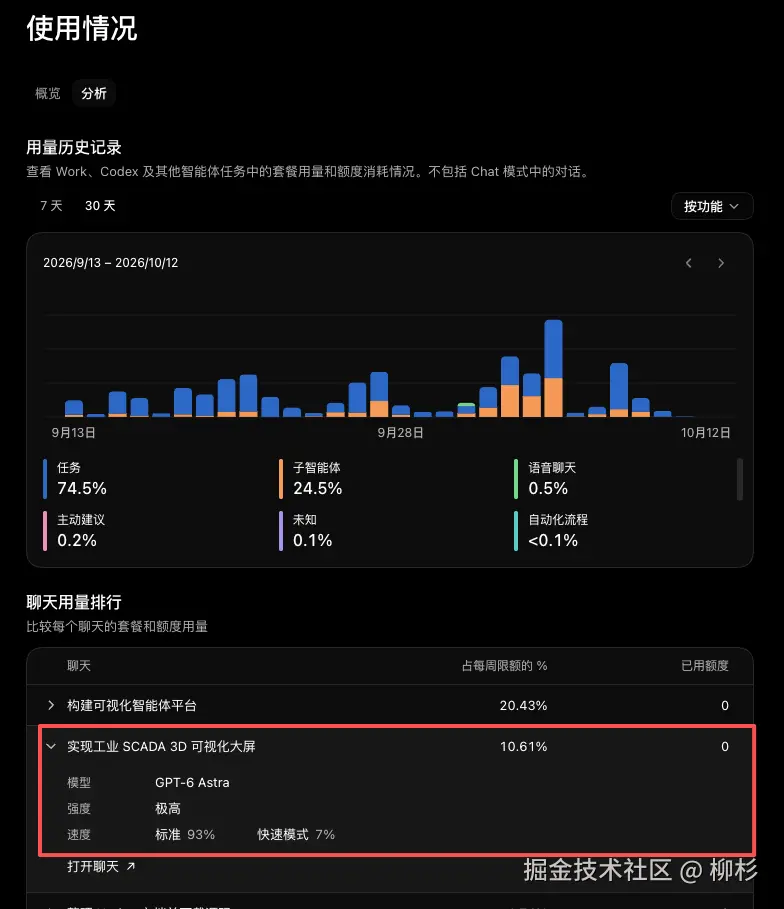
给 Codex (使用Gpt6 astra 模型)的需求依然只有一句:
使用 build-3d-visual-dashboard 工作流,实现一个工业 SCADA 三维监控大屏。Codex会自己去核对真实的业务------这块屏幕给谁看,要监控哪些设备,哪些数据值得放在首页,以及三维场景能够帮助使用者判断什么。
这些问题确定下来,界面、模型和交互才有具体的制作依据。
下面就按照实际操作顺序,介绍这个项目怎样从 SCADA 调研,一步步走到完整的网页效果。文中的提示词是按各阶段任务整理的示例,可以结合自己的项目调整。
第一步,让 Codex 建立 SCADA 调研
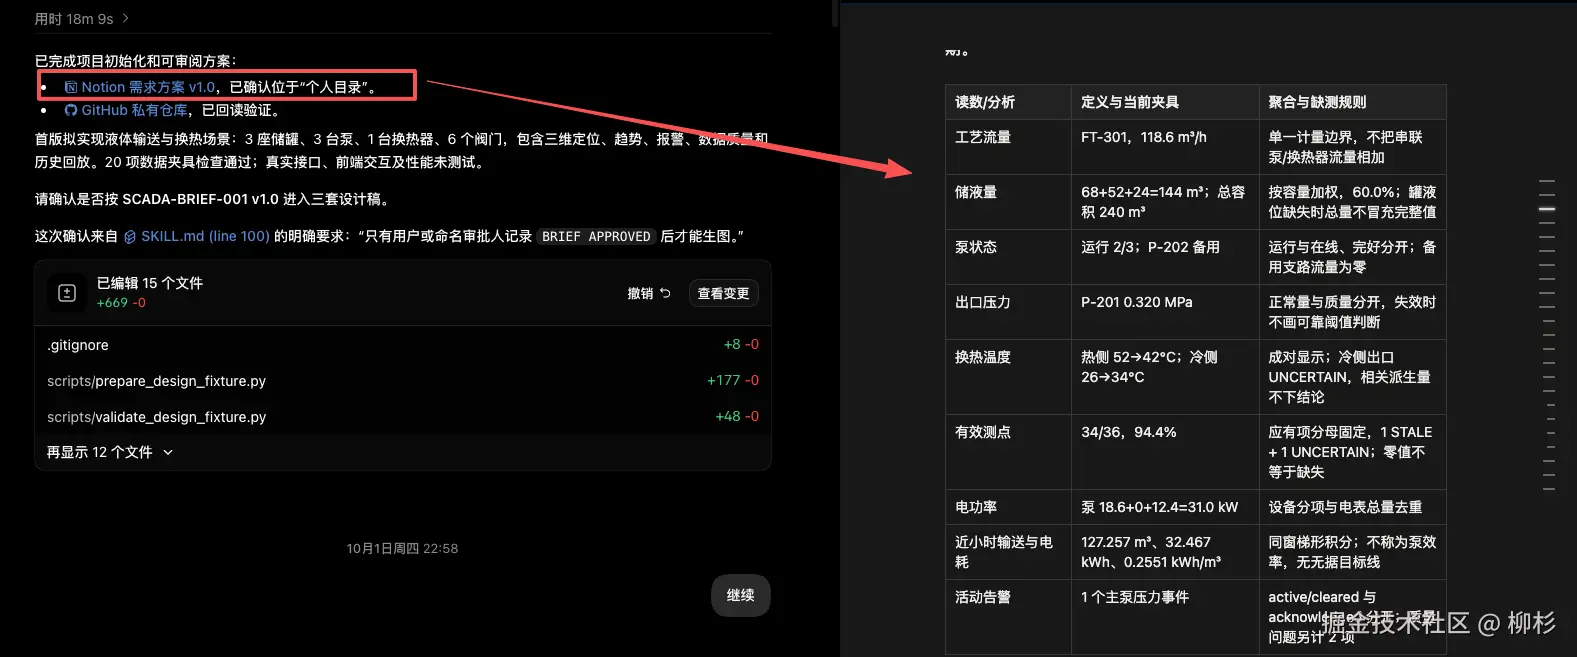
SCADA 通常指数据采集与监视控制系统。对于这个大屏项目,我们先关注设备状态、工艺数据、趋势和告警的监控展示。
开始时,可以向 Codex 提出这样的任务:
使用 build-3d-visual-dashboard 工作流,先开展工业 SCADA 三维监控大屏调研。梳理主要使用者、典型操作场景、设备对象、监控指标、历史趋势、告警和数据质量。同时研究完整大屏的视觉参考,整理适合本项目的内容与布局方向。先输出调研和需求方案,再进入设计。这里需要把业务调研和视觉调研一起开展。
业务调研回答"屏幕上应该有什么"。例如,值班人员关注当前工况和异常位置,运维人员还需要进一步查看设备参数与历史变化。
视觉调研回答"这些内容怎样放在一起"。三维设备占据多大的空间,趋势图放在哪里,告警怎样吸引注意,标签又怎样靠近对应设备,都需要结合完整画面观察。
项目的调研记录中,Codex 查阅了数据值与时间戳、告警、历史数据、泵工况和换热器监测等资料,也查看了工厂、换热站和运营中心的界面参考。
这些资料的用途各不相同。设备资料帮助理解监控对象,数据文档帮助确定字段和状态,完整大屏参考则帮助安排画面。
例如,调研中有一个直接影响实现的问题:一个数值长时间没有变化,是否就代表数据失效?
阀门可能一直保持同一个开度,但系统仍在持续验证这个值。因此,后面需要区分数值发生变化的时间和最后被验证的时间。
这类问题在设计图里不显眼,却会决定网页中的"正常"和"过期"是否显示正确。
完成这一阶段后,应得到一份可以继续使用的调研结果:有哪些业务对象,需要哪些数据,能够做什么判断,还有哪些现场资料缺失。
第二步,把调研范围收敛到一套具体工艺
"工业 SCADA"覆盖的场景很多。为了继续设计,需要选择一套具体的工艺。
这个项目最终围绕液体输送与换热处理单元展开。
主工艺从原液储罐出发,经过输送泵和板式换热器,再进入缓冲储罐与成品储罐。同时,换热器连接独立的冷却水回路。
原液储罐 ↓主用泵 / 备用泵 ↓换热器热侧 ↓缓冲储罐 ↓成品储罐冷却水供水 → 冷却水泵 → 换热器冷侧 → 回水确定这条过程之后,再让 Codex 逐段整理监控内容:
以液体输送与换热处理单元为场景,整理设备清单和工艺连接关系。按储液、输送、换热、输出几个环节,说明每个环节需要查看哪些数据,出现异常时需要定位到哪个设备。这样,模块名称就能对应到实际问题。
| 工艺环节 | 需要查看的内容 | 帮助使用者判断 |
|---|---|---|
| 储液 | 液位、容量、储量、温度 | 哪座罐的储量发生变化 |
| 输送 | 泵状态、流量、压力、转速 | 运行状态与输送表现是否一致 |
| 换热 | 两侧进出温度、压降 | 工况怎样变化,读数是否可信 |
| 电耗 | 各泵功率、区间电量 | 用电分布与单位输送电耗 |
| 事件 | 时间、设备、内容、状态 | 问题发生在哪里、何时发生 |
设备也在这一步获得稳定编号。例如,主用输送泵是 P-201,备用泵是 P-202,板式换热器是 HX-301。
后面的模型、测点、图表和事件都使用这些编号。点中场景中的主用泵,程序才能准确找到它的压力、流量和告警。
第三步,准备数据,把调研整理成需求方案
有了设备和指标,还要确认数据从哪里来。
这个项目没有现场点表、历史库接口和设备尺寸资料,因此先使用固定的模拟数据完成设计与软件验证。
可以继续交给 Codex:
根据设备清单建立可重复使用的模拟数据。明确每个测点的设备编号、名称、单位、数值、数据质量和时间,并准备同一时间范围的历史快照。核对库存、流量、电耗等汇总口径,将数据与界面需求整理成正式方案。模拟数据也需要保持内部一致。
以储罐为例,三个罐的容量不同,不能把液位百分比直接平均:
erlang
原液罐:100 m³ × 68% = 68 m³缓冲罐: 80 m³ × 65% = 52 m³成品罐: 60 m³ × 40% = 24 m³总储量:144 m³总容量:240 m³总体占比:60%同样,工艺中的多个串联测点可能测量同一股流体,不能把它们的流量加起来作为总流量。
项目最终准备了三十六项测点,以及覆盖一小时的六十一份分钟快照。它们供设计稿、图表、设备详情和历史回放共同使用。
还安排了压力告警、温度过期和测点不确定等情况,让设计阶段就能考虑异常如何呈现。
随后,Codex 将这些内容整理成需求方案:目标画布为 1920 × 1080,首页展示工艺总览、储罐液位、输送工况、换热状态、电耗与事件,支持设备选择和历史回放。
到这里,才具备进入设计的条件。 画面里要放哪些对象、显示什么数值、允许哪些操作,都已有明确依据。
第四步,让 Codex 生成完整设计稿
接下来,把需求方案交给设计阶段。
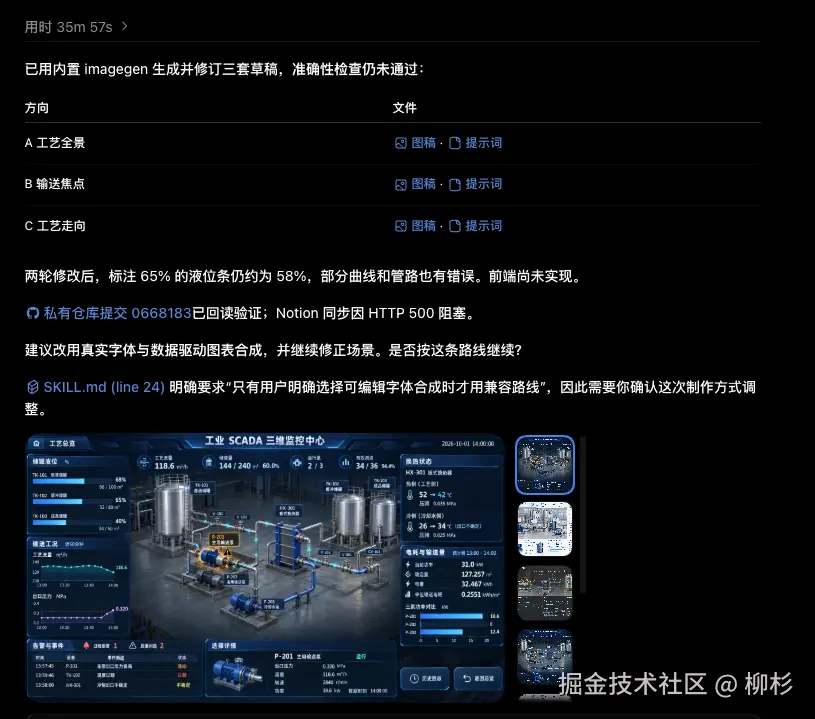
根据已确定的需求和数据制作三套完整大屏设计。分别探索工艺全景、输送设备重点、沿工艺走向组织信息的表达方式。每套都需要完整呈现标题、指标、图表、三维场景、设备标签、事件和详情区域。这个项目比较了三种方向,最终选择"工艺全景":中央展示完整处理单元,周围的数据区域分别解释储液、输送、换热和电耗。
看设计稿时,可以按实际阅读过程检查。
先看顶部,能否快速知道当前流量、库存和运行泵数量;再看中央,能否辨认主用泵、备用泵及管路关系;最后查看趋势与事件,能否找到异常对象。
细节也需要一起核对。液位条是否对应数值,单位是否正确,主备泵是否连接合理,冷却水是否保持独立回路,都属于这一阶段的检查内容。
选定方向以后,继续调整到一份完整、明确的设计稿,再保存为后续实现的视觉基准。
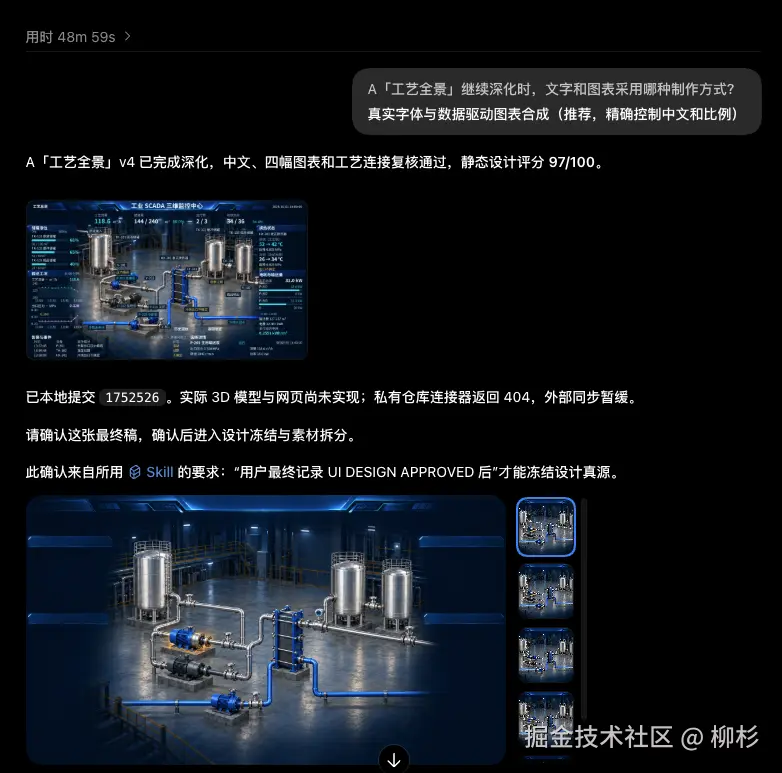
这一做法让 Codex 在写网页时有具体目标:标题在哪、容器多大、图表怎样排列,都可以直接对照。
第五步,拆分设计稿,准备素材与建模参考
设计稿是一张完整画面,实现时则需要把其中的内容分别交给图片、代码和三维模型。
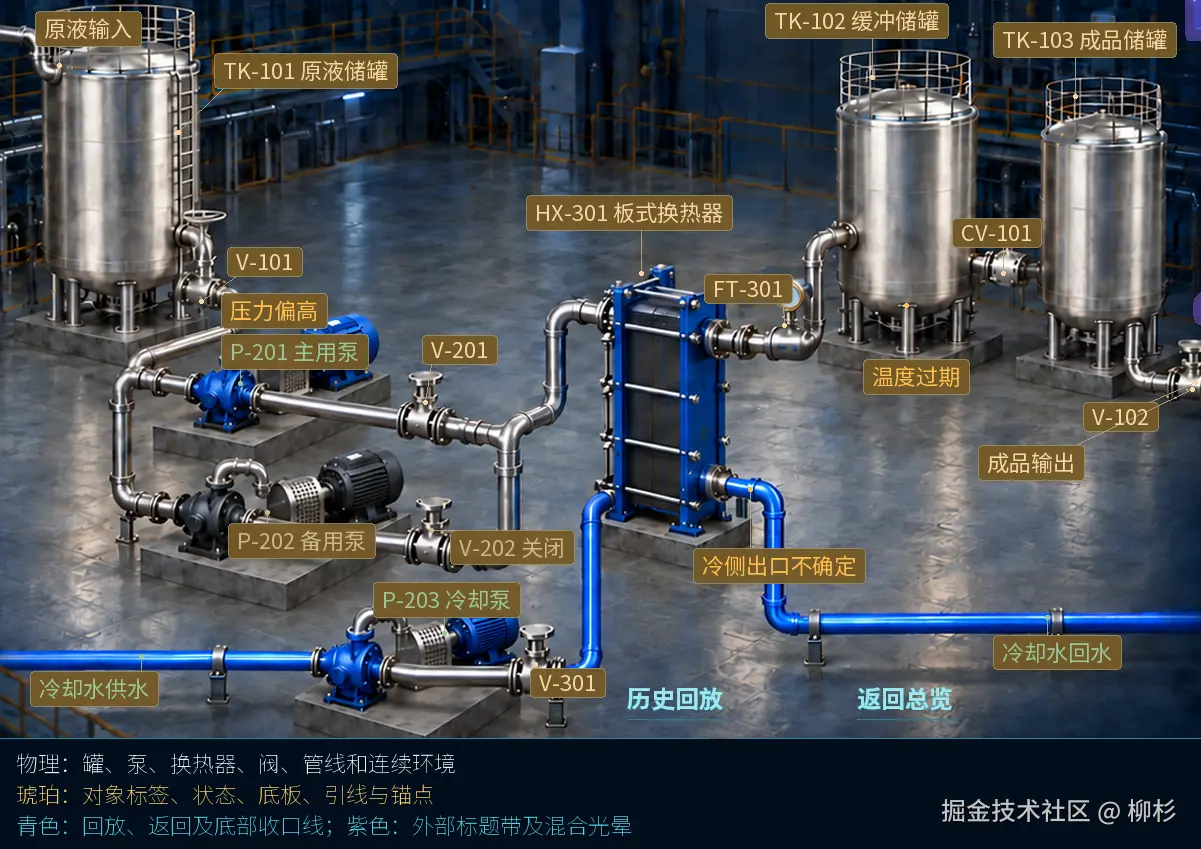
可以让 Codex 继续:
盘点设计稿中的全部可见元素,区分物理模型、场景标签、业务组件和装饰素材。提取界面素材,整理模型参考与材质局部,记录位置、尺寸和使用方式,再按原尺寸重组检查。例如,储罐和管道需要进入三维模型;设备名称和测点数字需要绑定空间位置;趋势图由 ECharts 绘制;装饰边框和图标则作为独立素材使用。
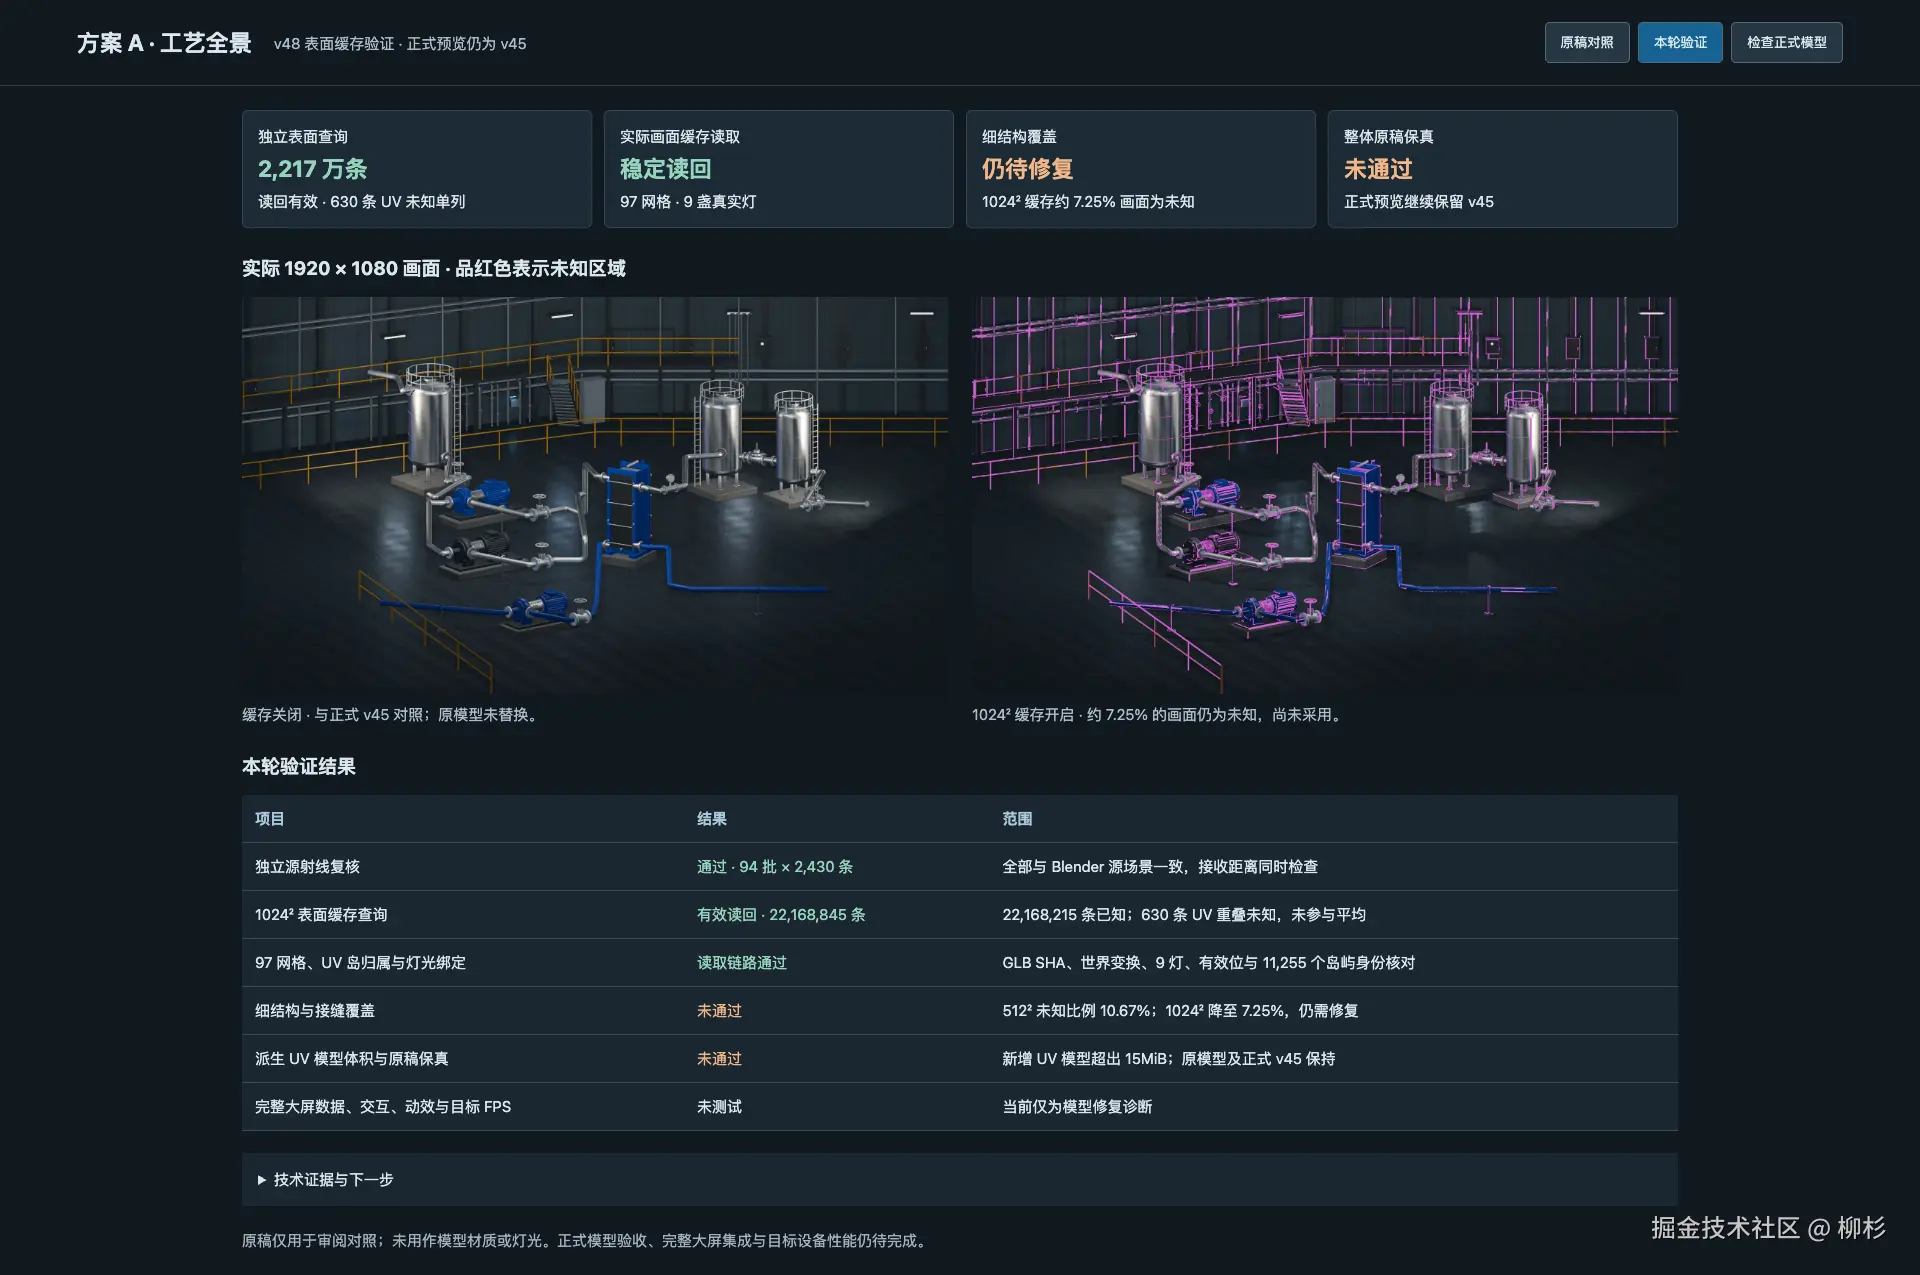
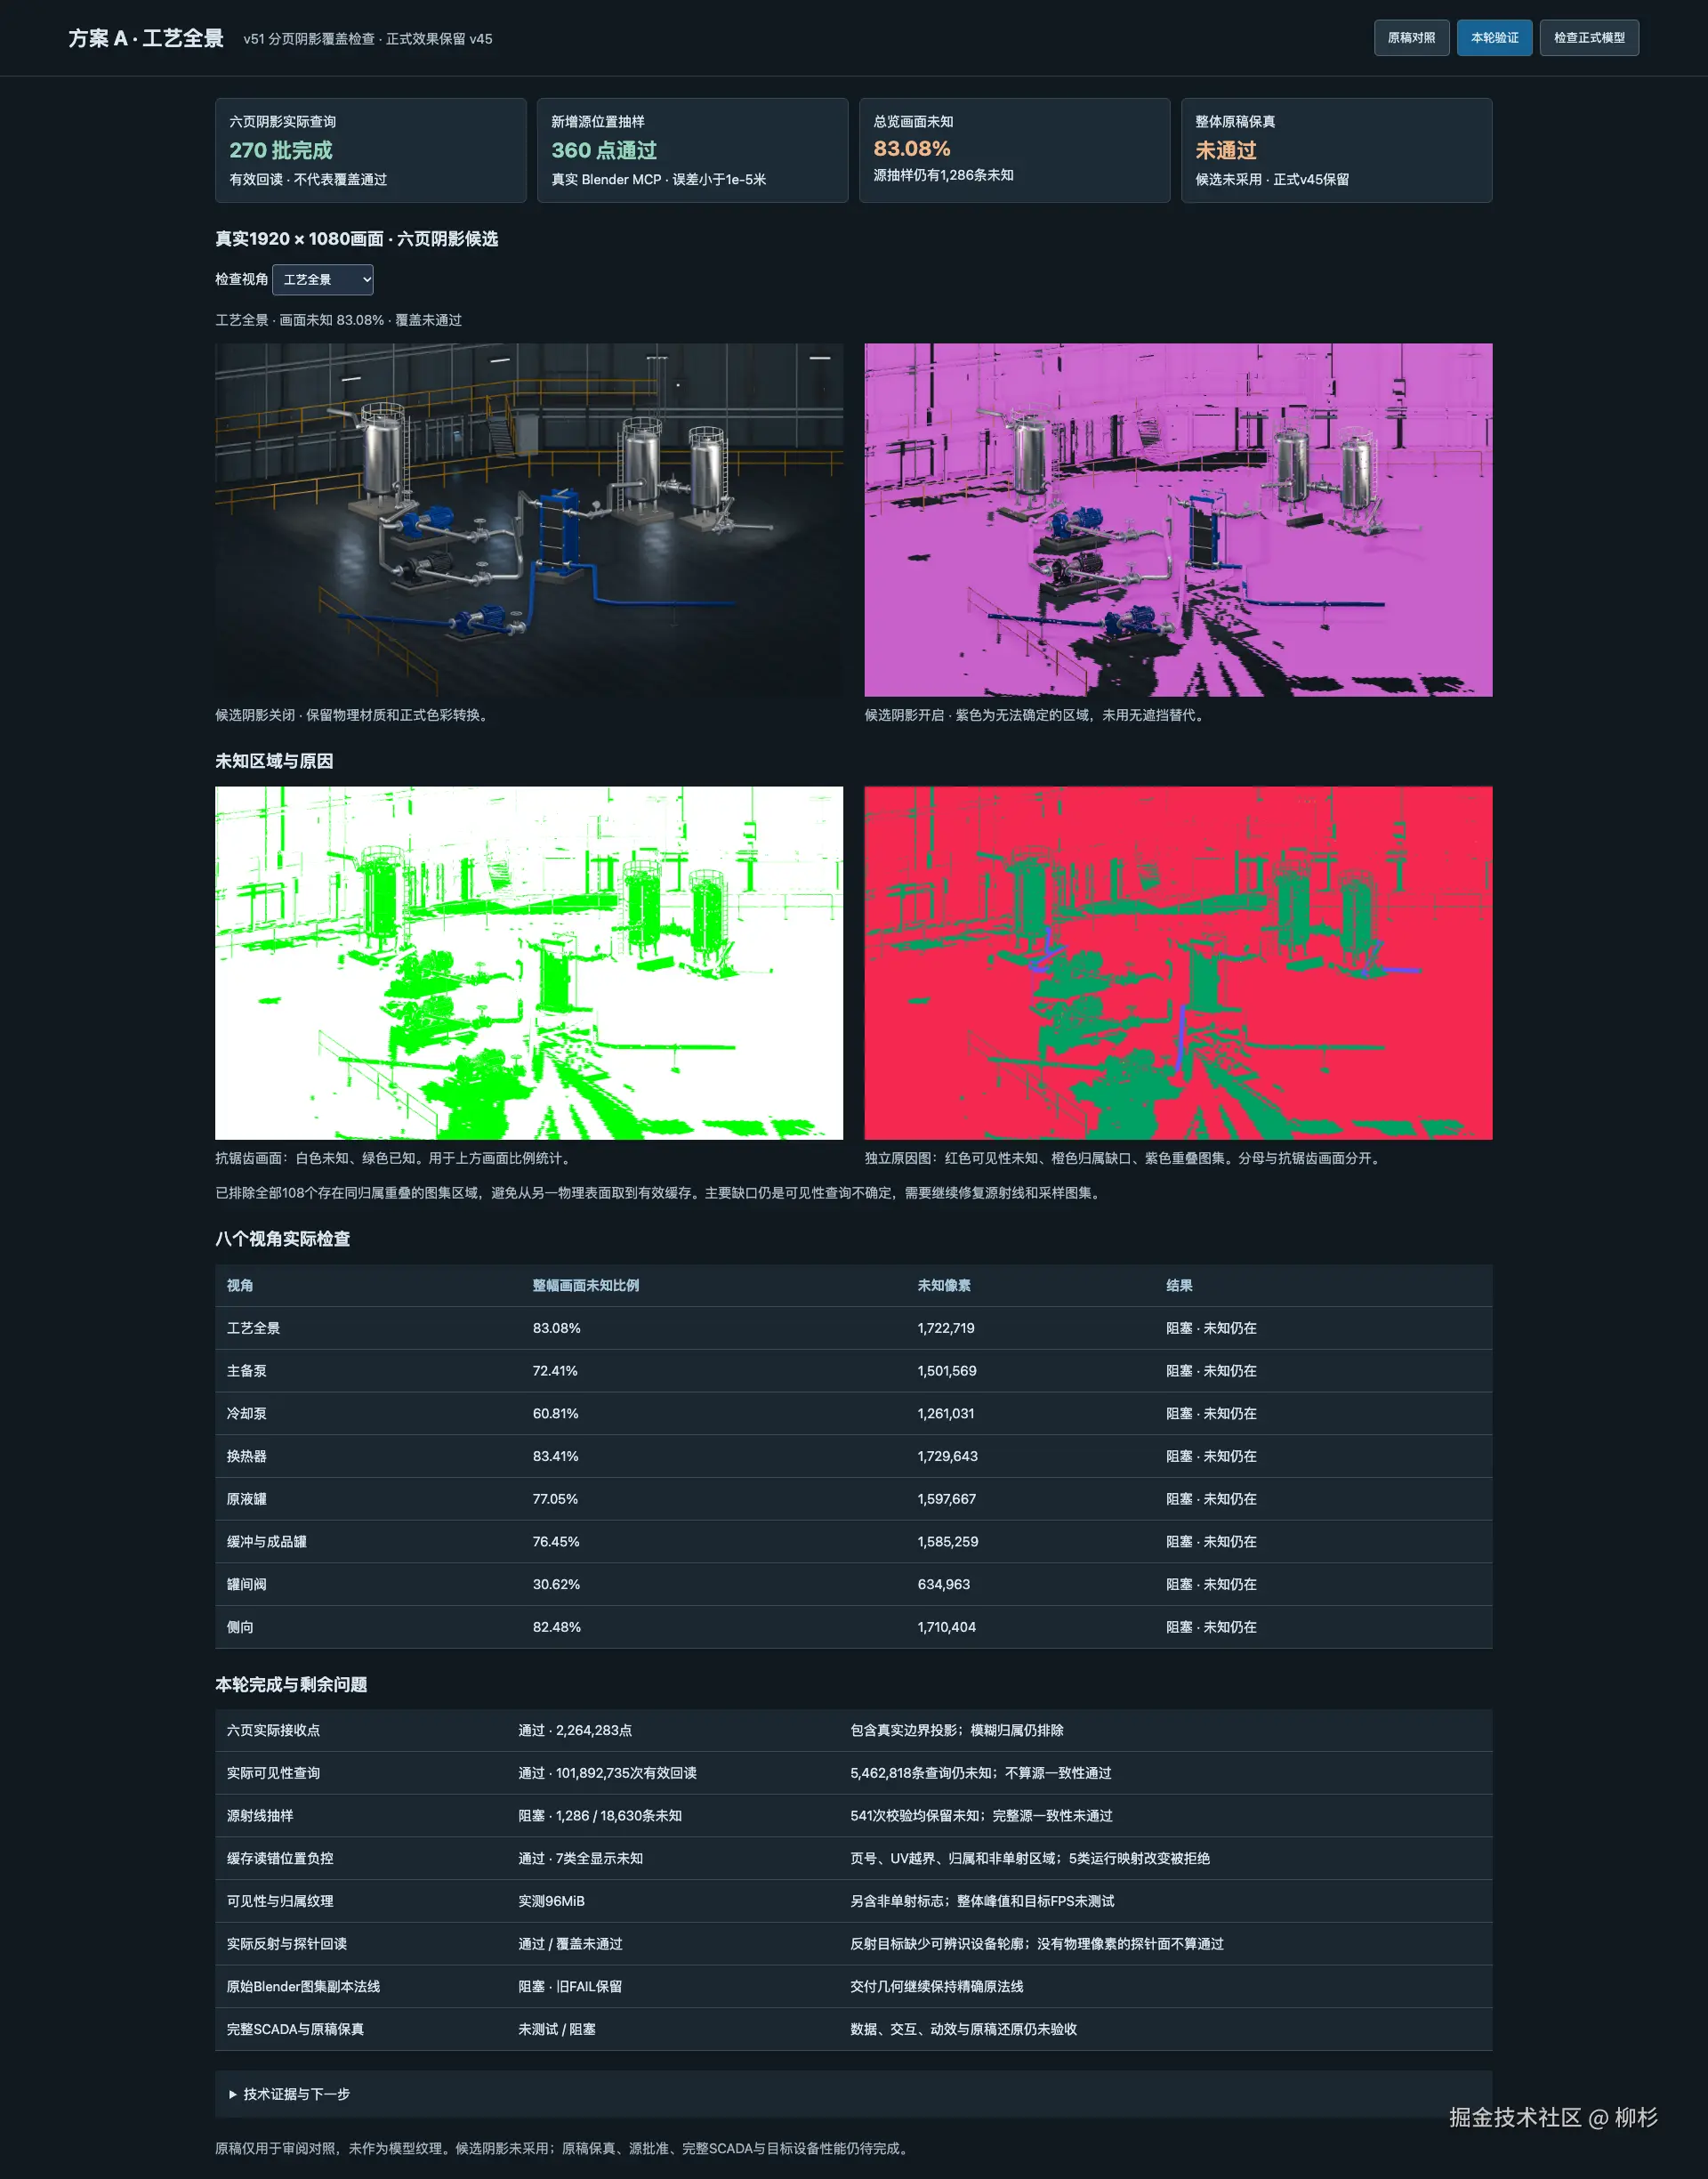
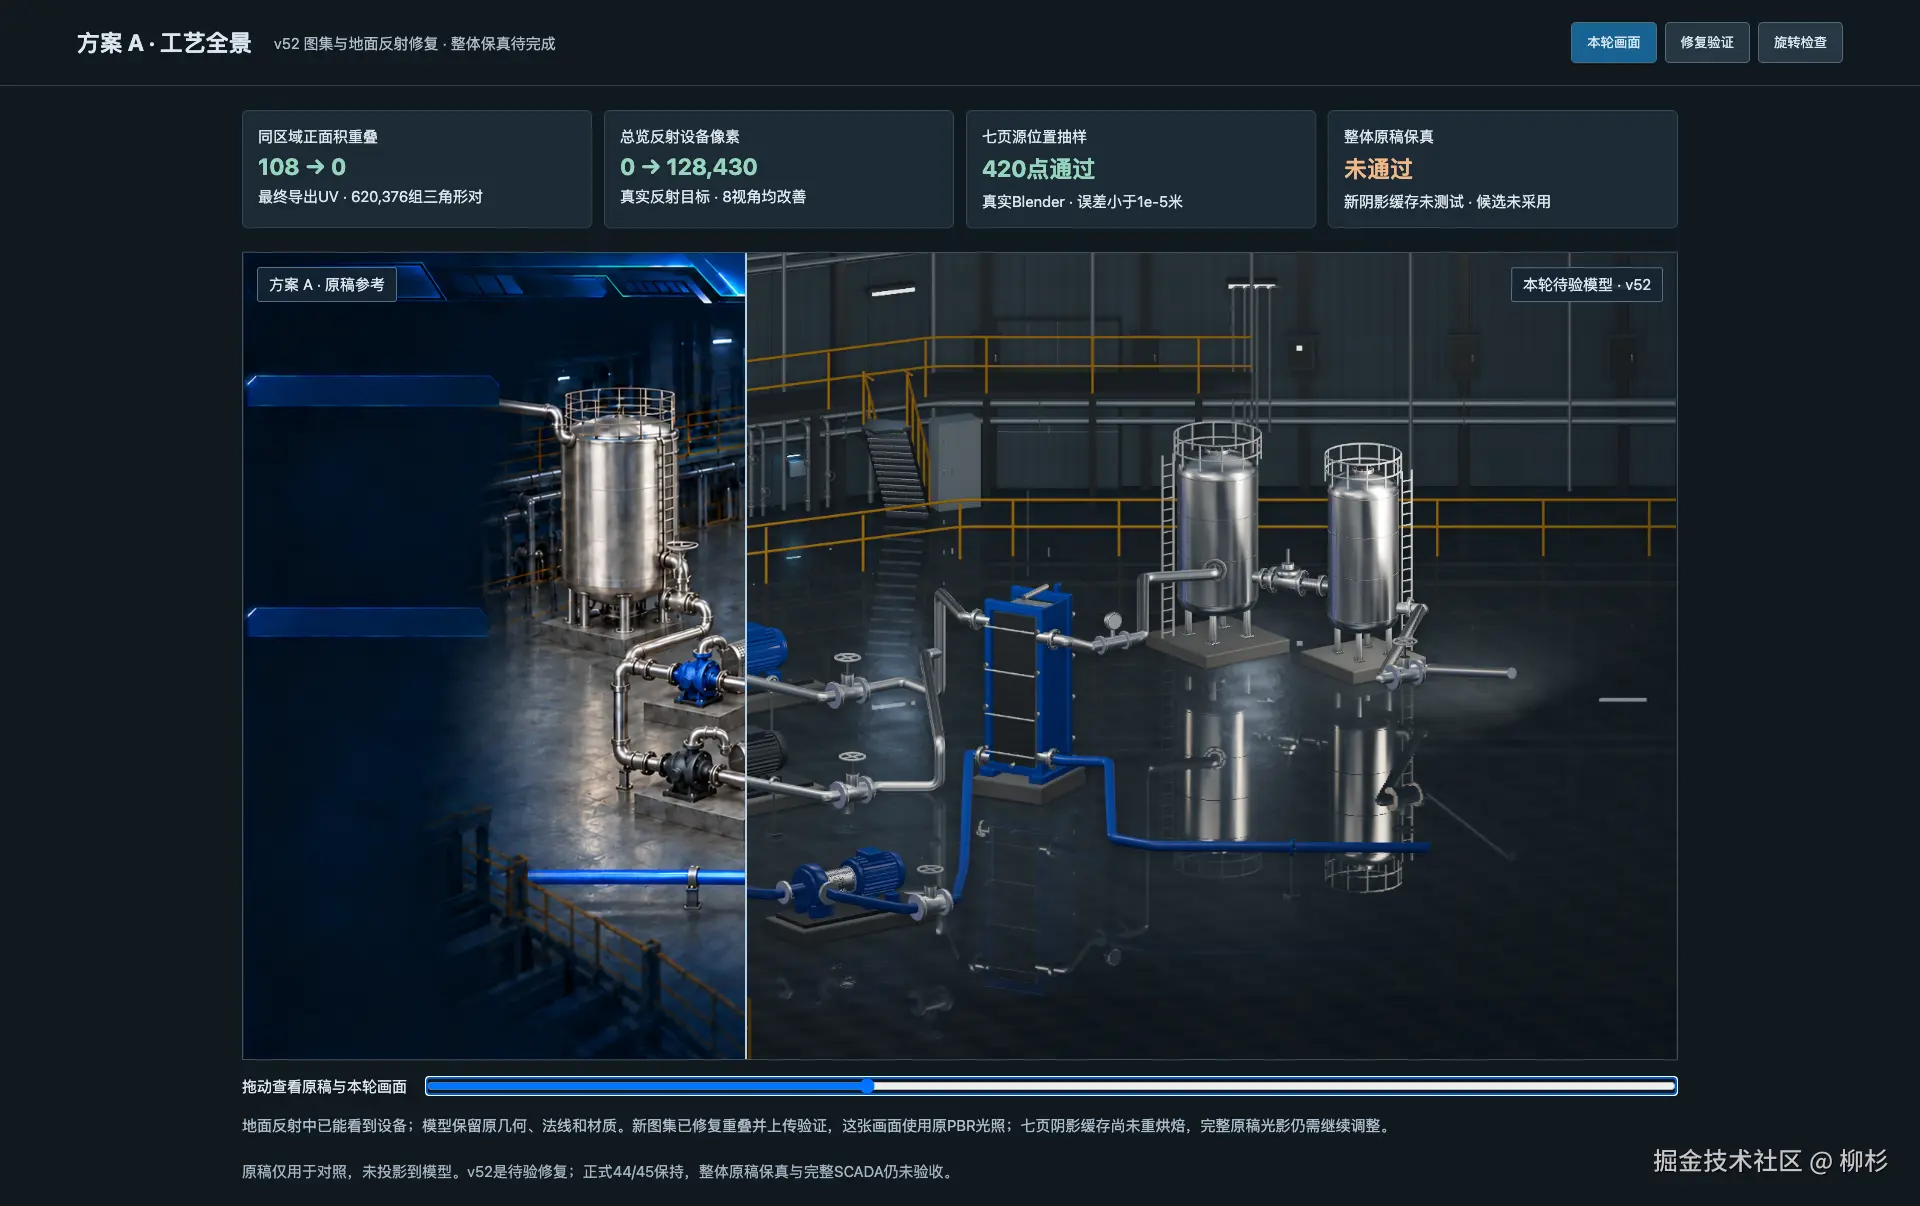
这里最容易出问题的是图层边界。
标题框不能顺带裁入后面的厂房,设备名称不能烘焙进储罐材质,图表曲线也不能留在背景图片里。
否则,模型转动或数据变化时,就会露出静态内容和动态内容不一致的问题。
这次项目还遇到了容器背景和文字排布需要重新调整的情况。只有边框、缺少阅读底板时,场景纹理会透到文字后面;标题的位置没有与框体对应时,界面也会显得松散。
因此,素材完成后要放回原位置重组,检查边框、底色、透明区域和接缝。同时,把设备局部、材质和场景轮廓整理出来,供下一步建模使用。
第六步,制作 Blender 模型,再放进网页检查
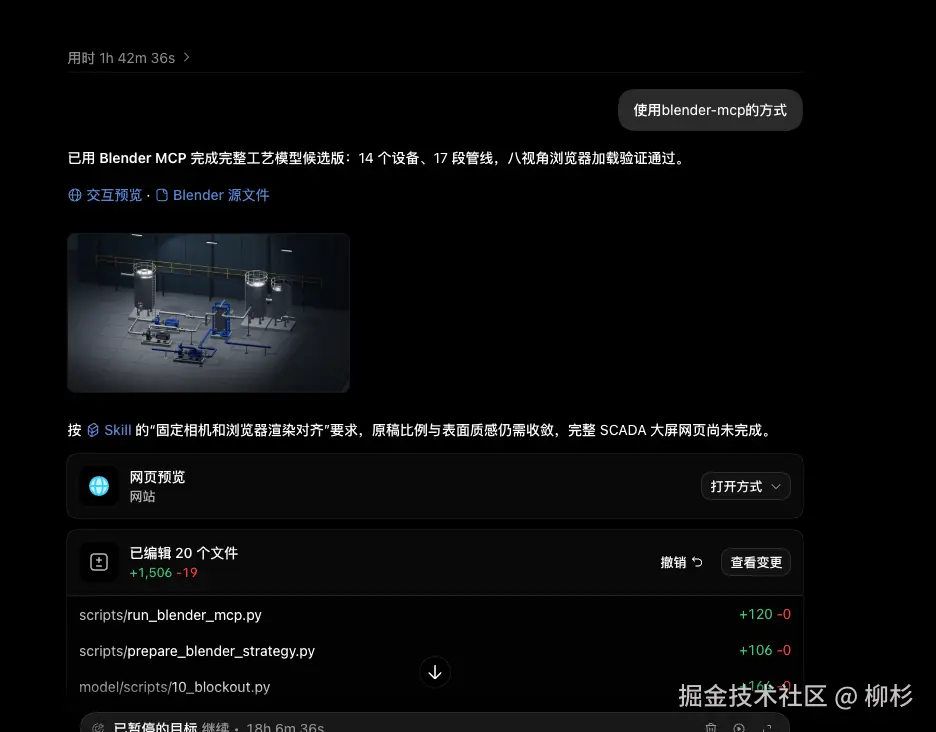
三维阶段沿用已经确定的构图和设备关系。
操作顺序可以从大到小:
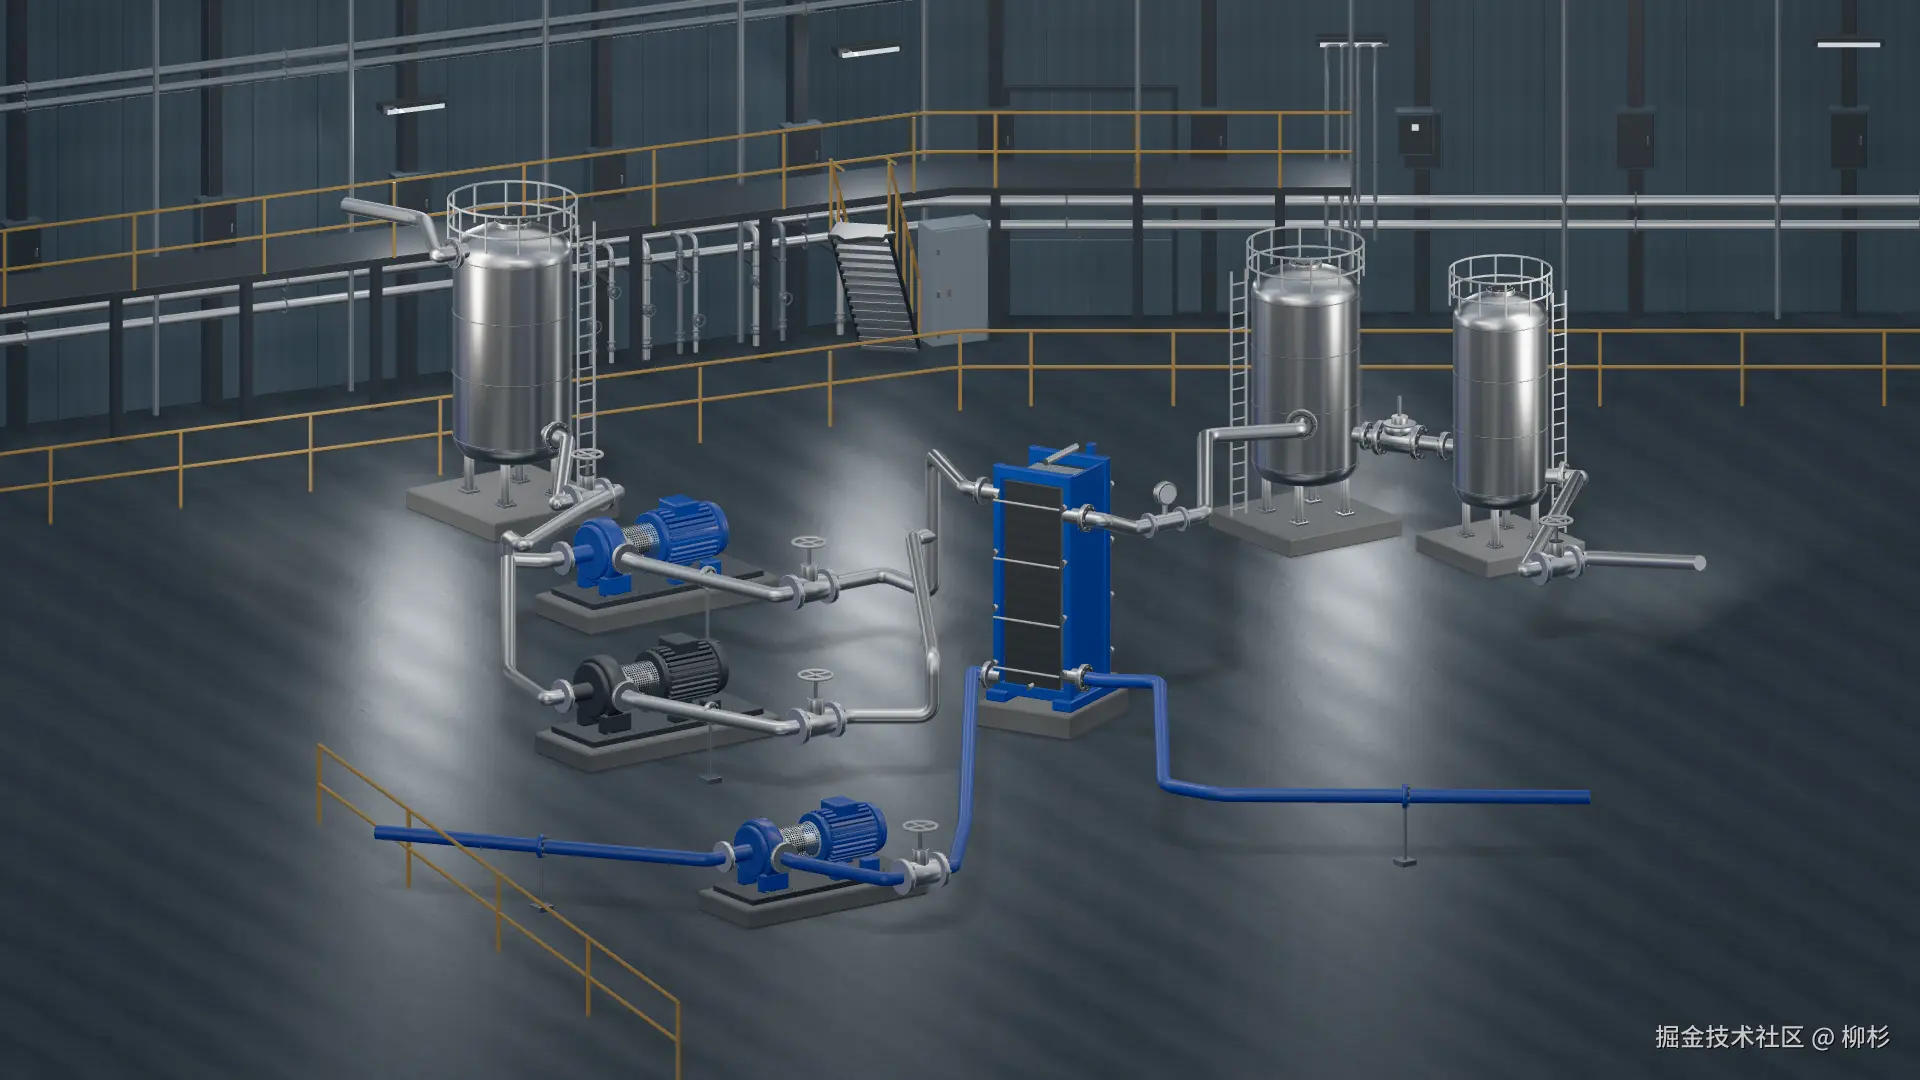
先摆出储罐、泵和换热器的位置,检查比例;再连接主工艺与冷却水管路;随后补齐底座、法兰、支架和护栏;最后处理金属、地面和管道材质。
每台设备的零件归到一个根节点下面,为后面的选择交互保留结构。
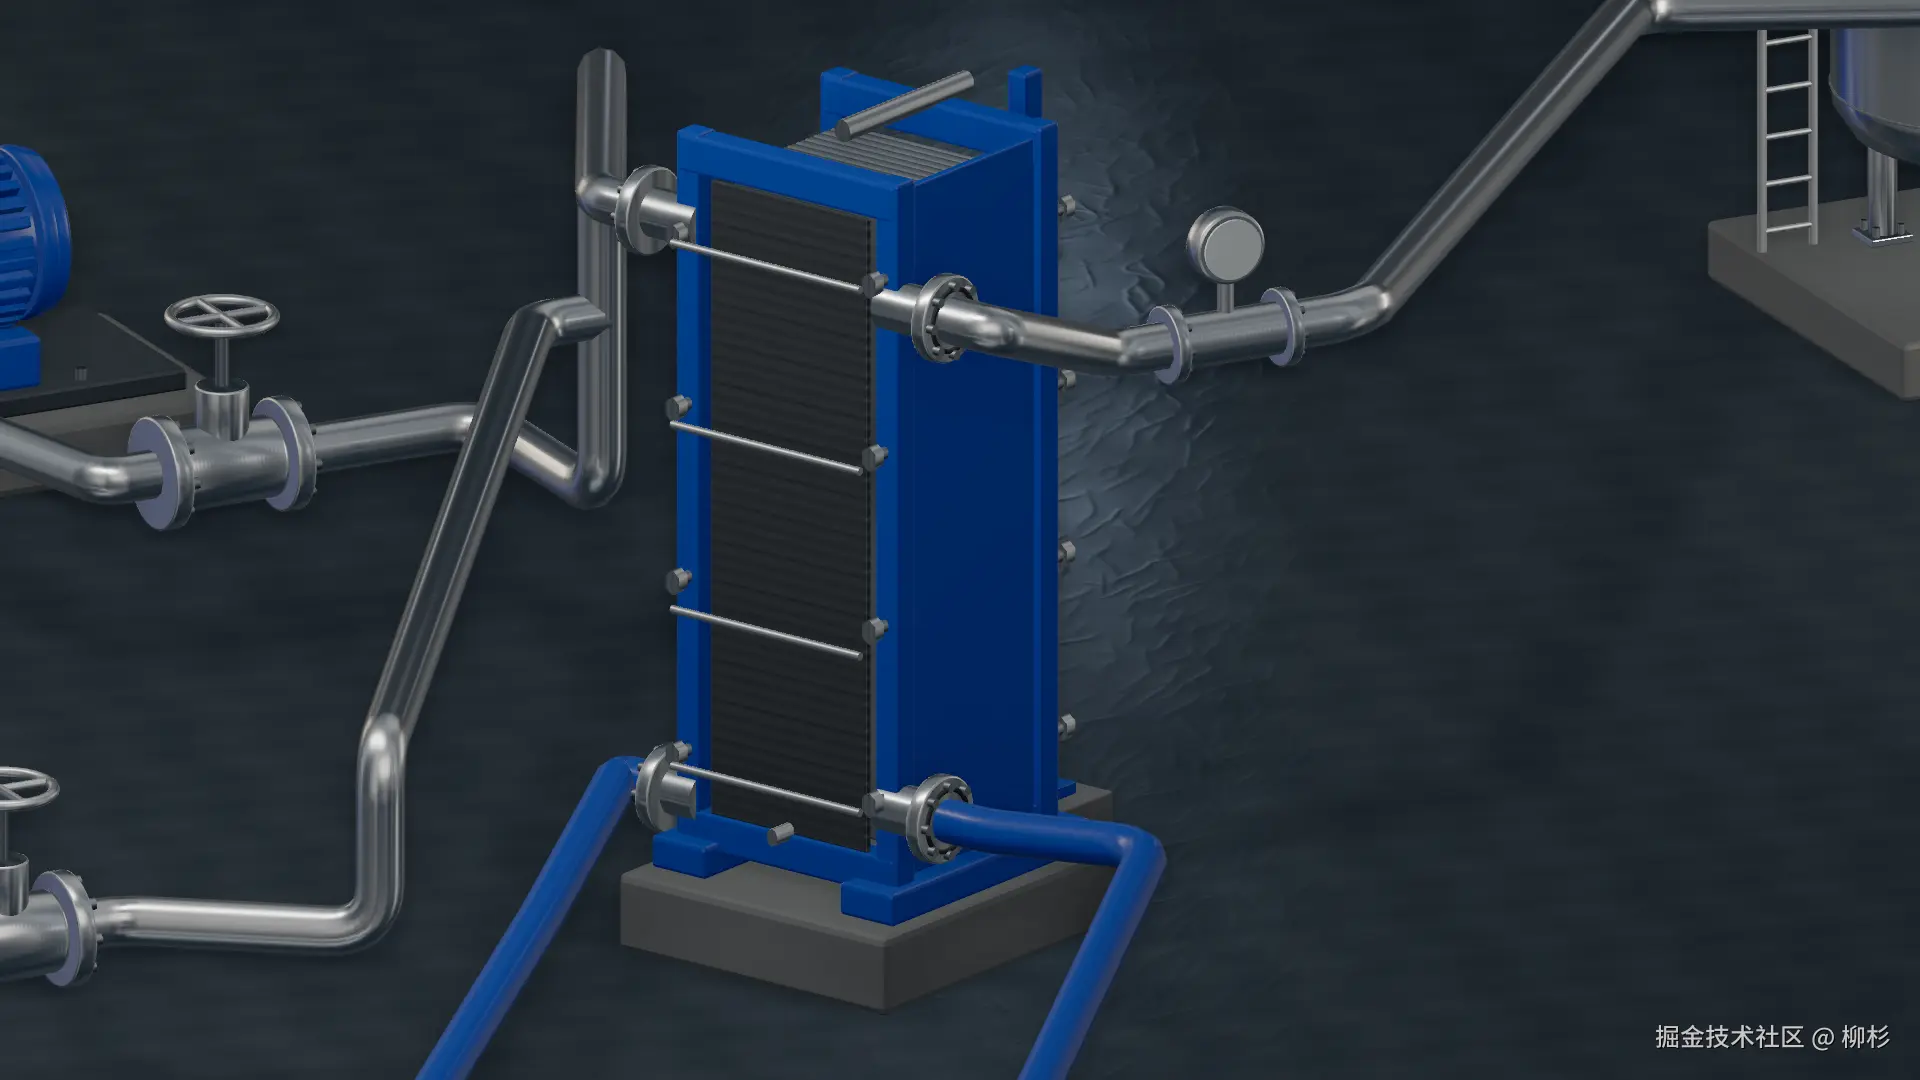
网页加载模型以后,通过映射查找设备:
javascript
const root = model.getObjectByName(roots[id]);if (!root) { throw new Error("缺失设备 " + id);}id 是业务编号,roots[id] 是它在模型中的节点名称。这样,场景中的设备就与前面的数据清单连起来了。
模型交付包含 Blender 源文件和网页使用的 GLB。浏览器端使用 Three.js,当前压缩模型通过 Meshopt 解码:
csharp
const gltf = await new GLTFLoader() .setMeshoptDecoder(MeshoptDecoder) .parseAsync(glb, "");scene.add(gltf.scene);接着让 Codex 在浏览器中固定相机,逐项对照构图、材质、光照和阴影。
Blender 中已经好看的模型,进入网页后仍可能出现颜色、反射和亮度差异。这一阶段需要看真实渲染结果,继续校准,直到设备占位和场景表现能够融入整屏。
第七步,组装前端,先完成一台设备的完整联动
模型与素材准备好后,开始组织页面。
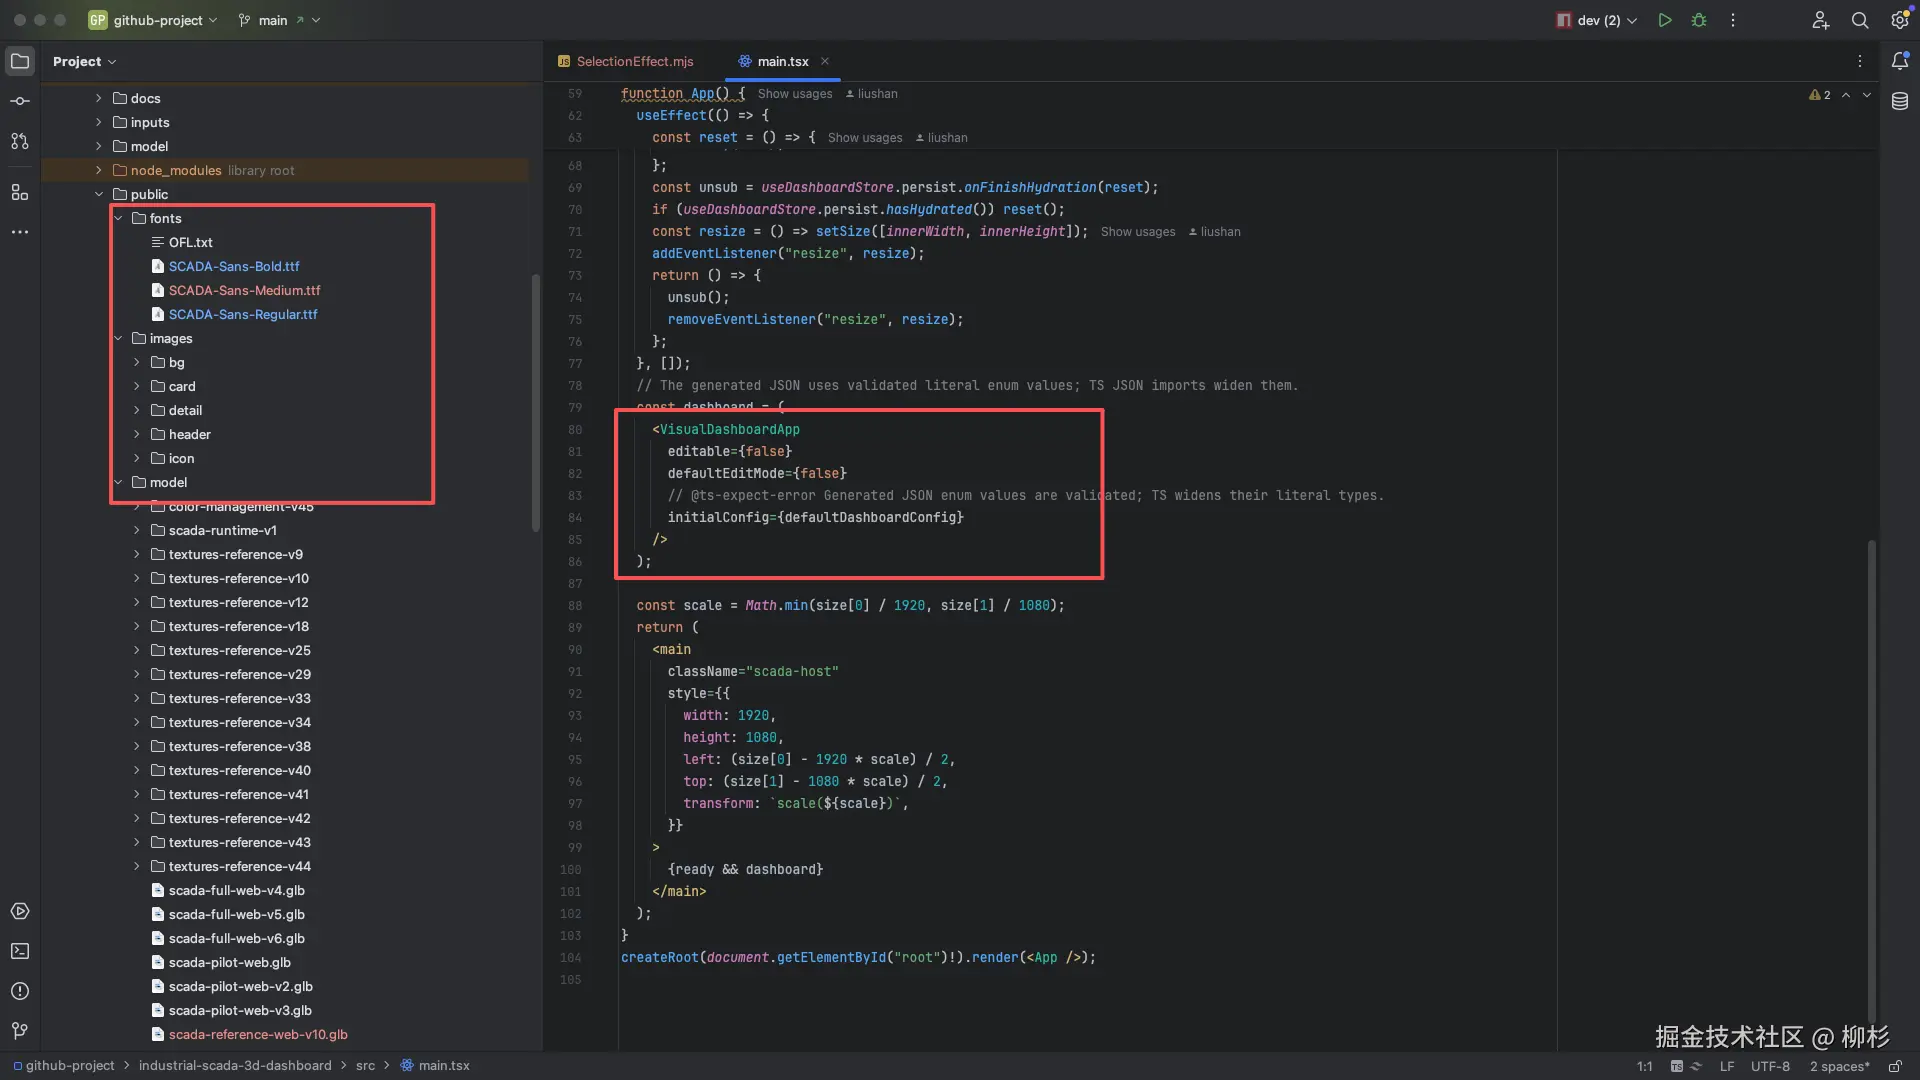
项目通过 @lius1314/visual-dashboard-scaffold 管理布局,各业务区域注册为独立组件:
scss
registerBlock("summary", Summary);registerBlock("tanks", Tanks);registerBlock("scene", Scene);registerBlock("detail", Detail);布局配置负责区域位置与容器,组件负责内部内容,Three.js 负责场景,ECharts 负责图表。
这时可以给 Codex 一个较小、但完整的实现任务:
css
先实现主用泵 P-201 的完整选择链路。点击模型或设备名称后,同步更新选中轮廓、名称牌和详情面板。详情显示对应模型,以及压力、流量、转速和功率。完成后在浏览器中验证,再扩展其他设备。先完成一台设备,可以尽早发现模型节点、业务编号和界面状态之间的问题。
链路通过后,再覆盖储罐、其他泵、换热器和阀门。详情缩略图从当前 GLB 中生成,确保显示的是实际选中的设备。
随后接入统一的时间状态:
arduino
export function useScada() { const state = useSyncExternalStore( store.subscribe, store.get ); return { ...state, data: derive(state.cursor, state.dataState), };}cursor 指向当前查看的历史快照。指标、趋势、事件和设备详情都由它派生,拖动回放时便能同步变化。
这也让前面准备的模拟数据真正发挥作用:同一套数据贯穿设计、实现和验证。
第八步,补齐流动效果,再逐区还原完整界面
最后,继续实现管道流动和页面细节。
可以把动效任务写成具体行为:
根据泵状态、阀位、流量和数据质量,控制主用支路、备用支路和冷却水回路的流动。箭头沿管道方向移动,并遵循设备遮挡。检查停泵、回放暂停、相机旋转和后台返回。项目分别计算主用、备用和共用管段的状态。主用泵停止后,对应支路停流;备用泵运行时,共用管段仍可继续流动。
箭头沿管线路径推进,三维侧提供投影与遮挡信息,独立 Canvas 绘制箭头和光尾。相机变化时更新投影,避免光效穿过设备显示。
动效完成后,再让 Codex 对照设计稿逐区检查完整页面:顶部图标与数值、标题和容器、图表坐标轴、表格行列、设备标签,以及底部详情和操作按钮。
每发现一处差异,就修改对应资源、配置或组件,然后重新截图检查。
这个项目后续的多轮调整,正是在补齐这些细节:恢复容器底色,统一字号与字重,调整图表布局,重新制作指标图标,补充选中效果,再完善管道的方向与遮挡。
最终得到的是一个可以选择设备、查看测点、定位事件和回放历史的三维监控页面。当前数据仍是模拟快照,现场接口与目标硬件表现需要在部署阶段继续验证。
从调研开始走一遍,会发现前面的每一步都能在最终界面中找到对应结果。
调研确定了需要关注的工况,设备清单成为模型身份,数据定义进入图表和指标,设计稿决定整屏关系,素材与建模负责视觉表达,最后再通过代码把它们连接起来。
有了这条连续的制作过程,Codex 每次继续工作时,都能知道当前要完成什么,以及应该拿什么结果来检查。
最后
想说的是,在反复跑这套工作流的过程中,真正起决定作用的,还是模型本身 和多轮试错这两件事。
即使用的是目前最强的模型(GPT-6 Astra),在细节层面依然需要反复修复------材质差一点、交互卡一下、数据对不齐,都得靠一轮轮对照、调整、再验证才能收敛。这也是整个流程里最耗时间、也最考验耐心的部分。
很多人会关心一个具体问题:做一个这样的三维监控大屏,大概要花多少 token?我用的是 Pro 20x 套餐,下面是这次项目的实际使用情况:
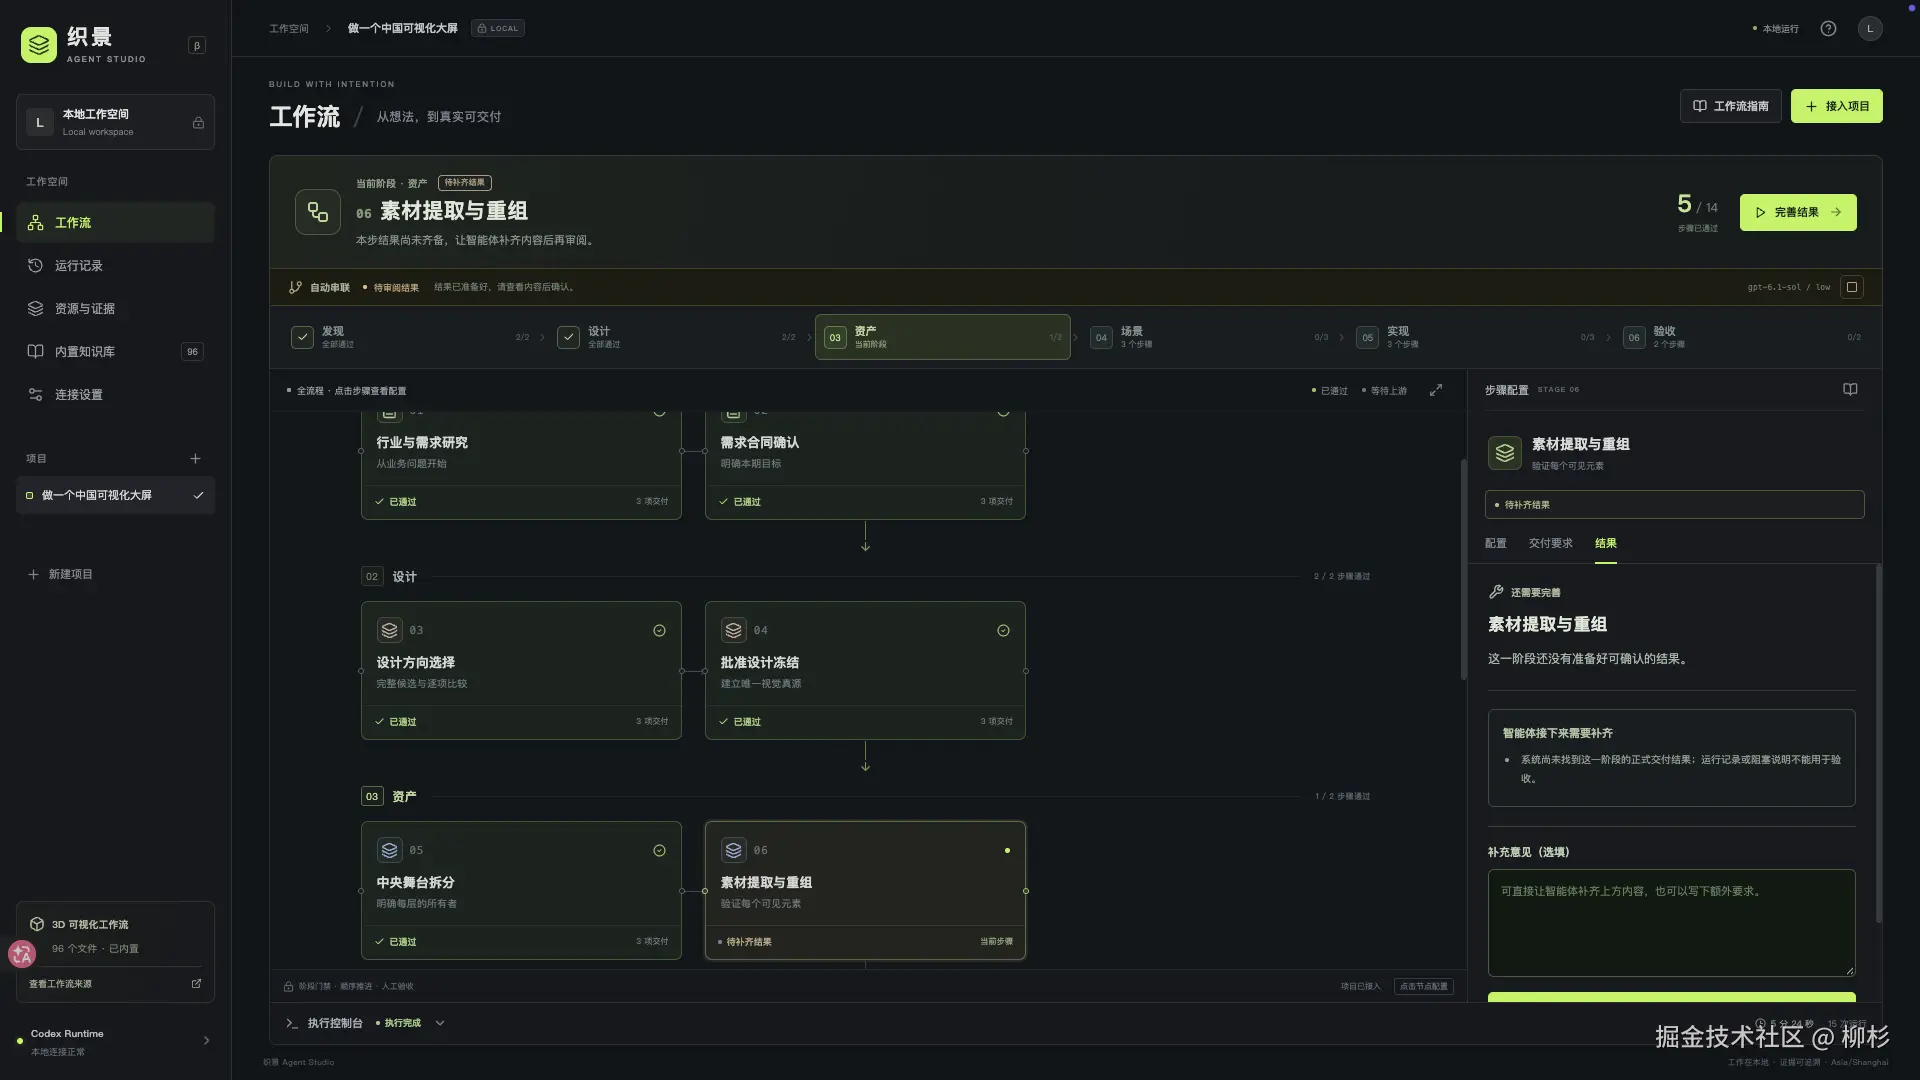
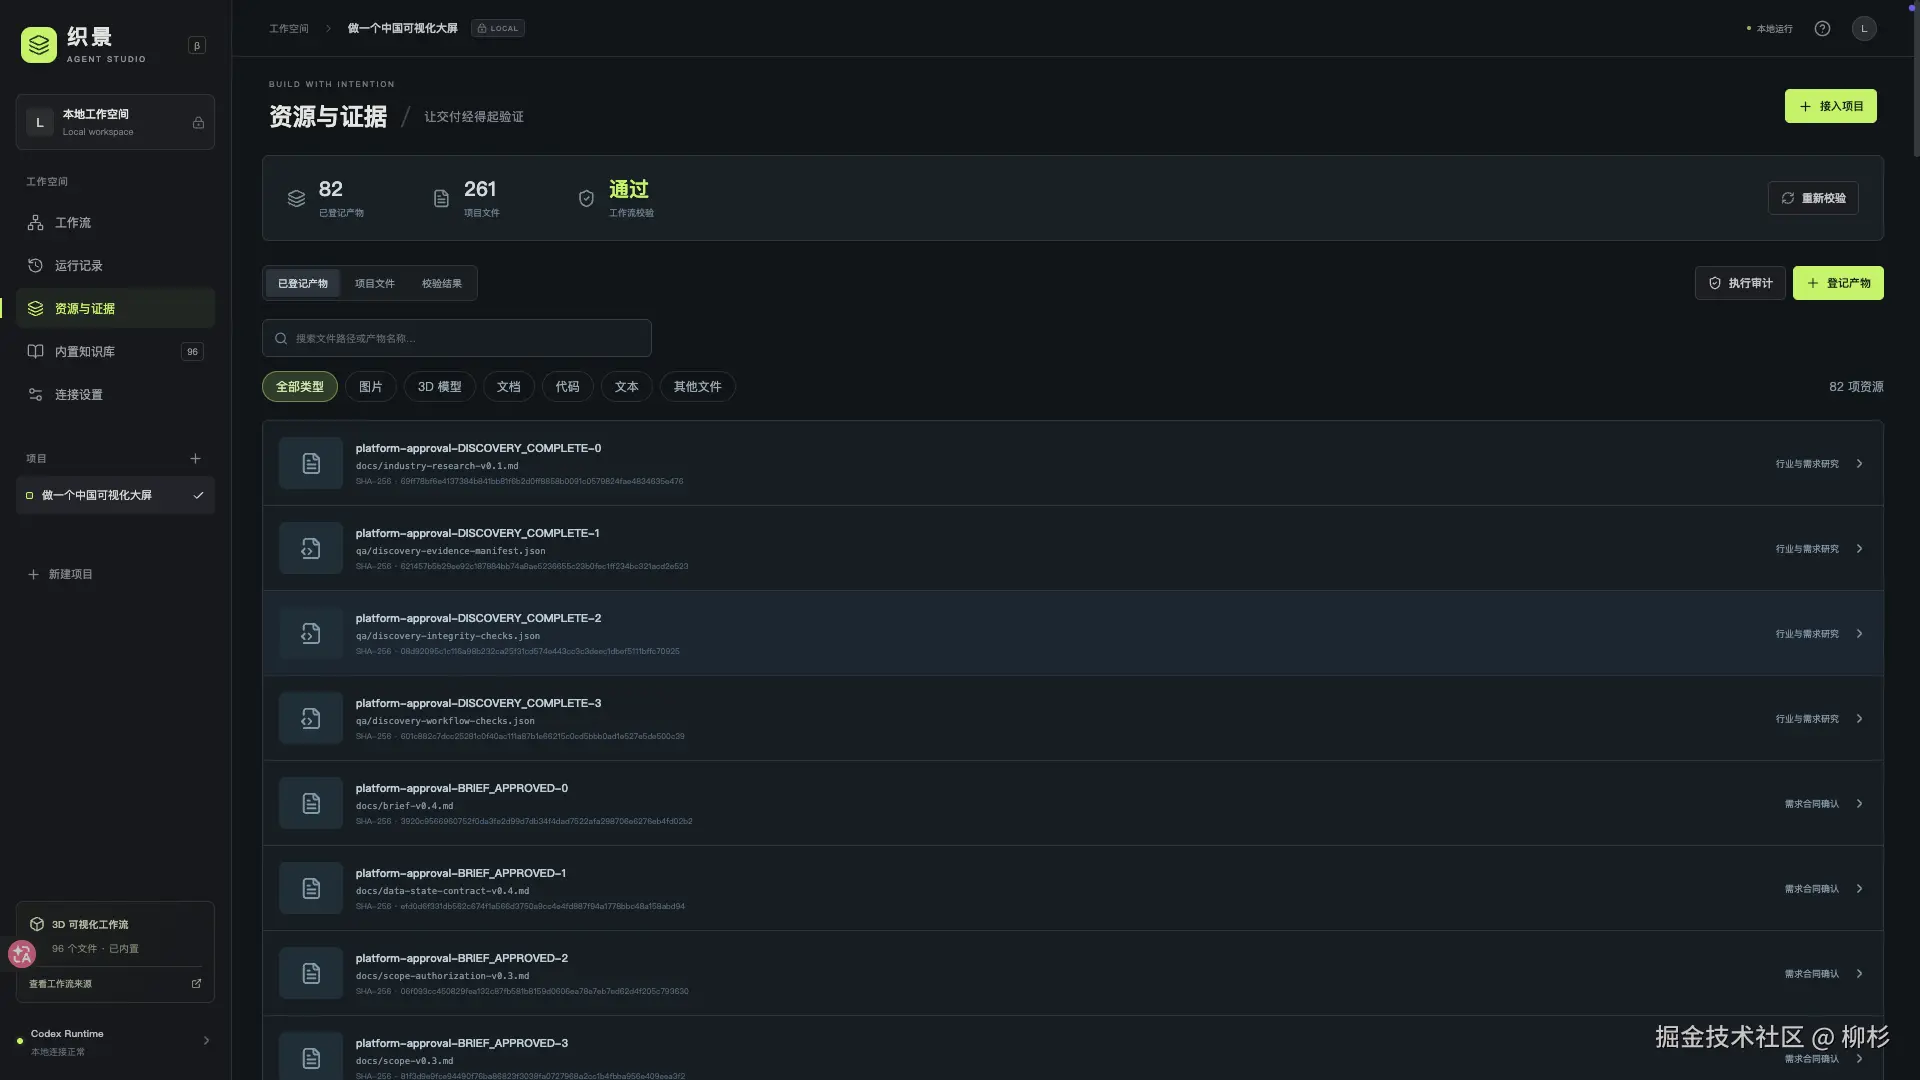
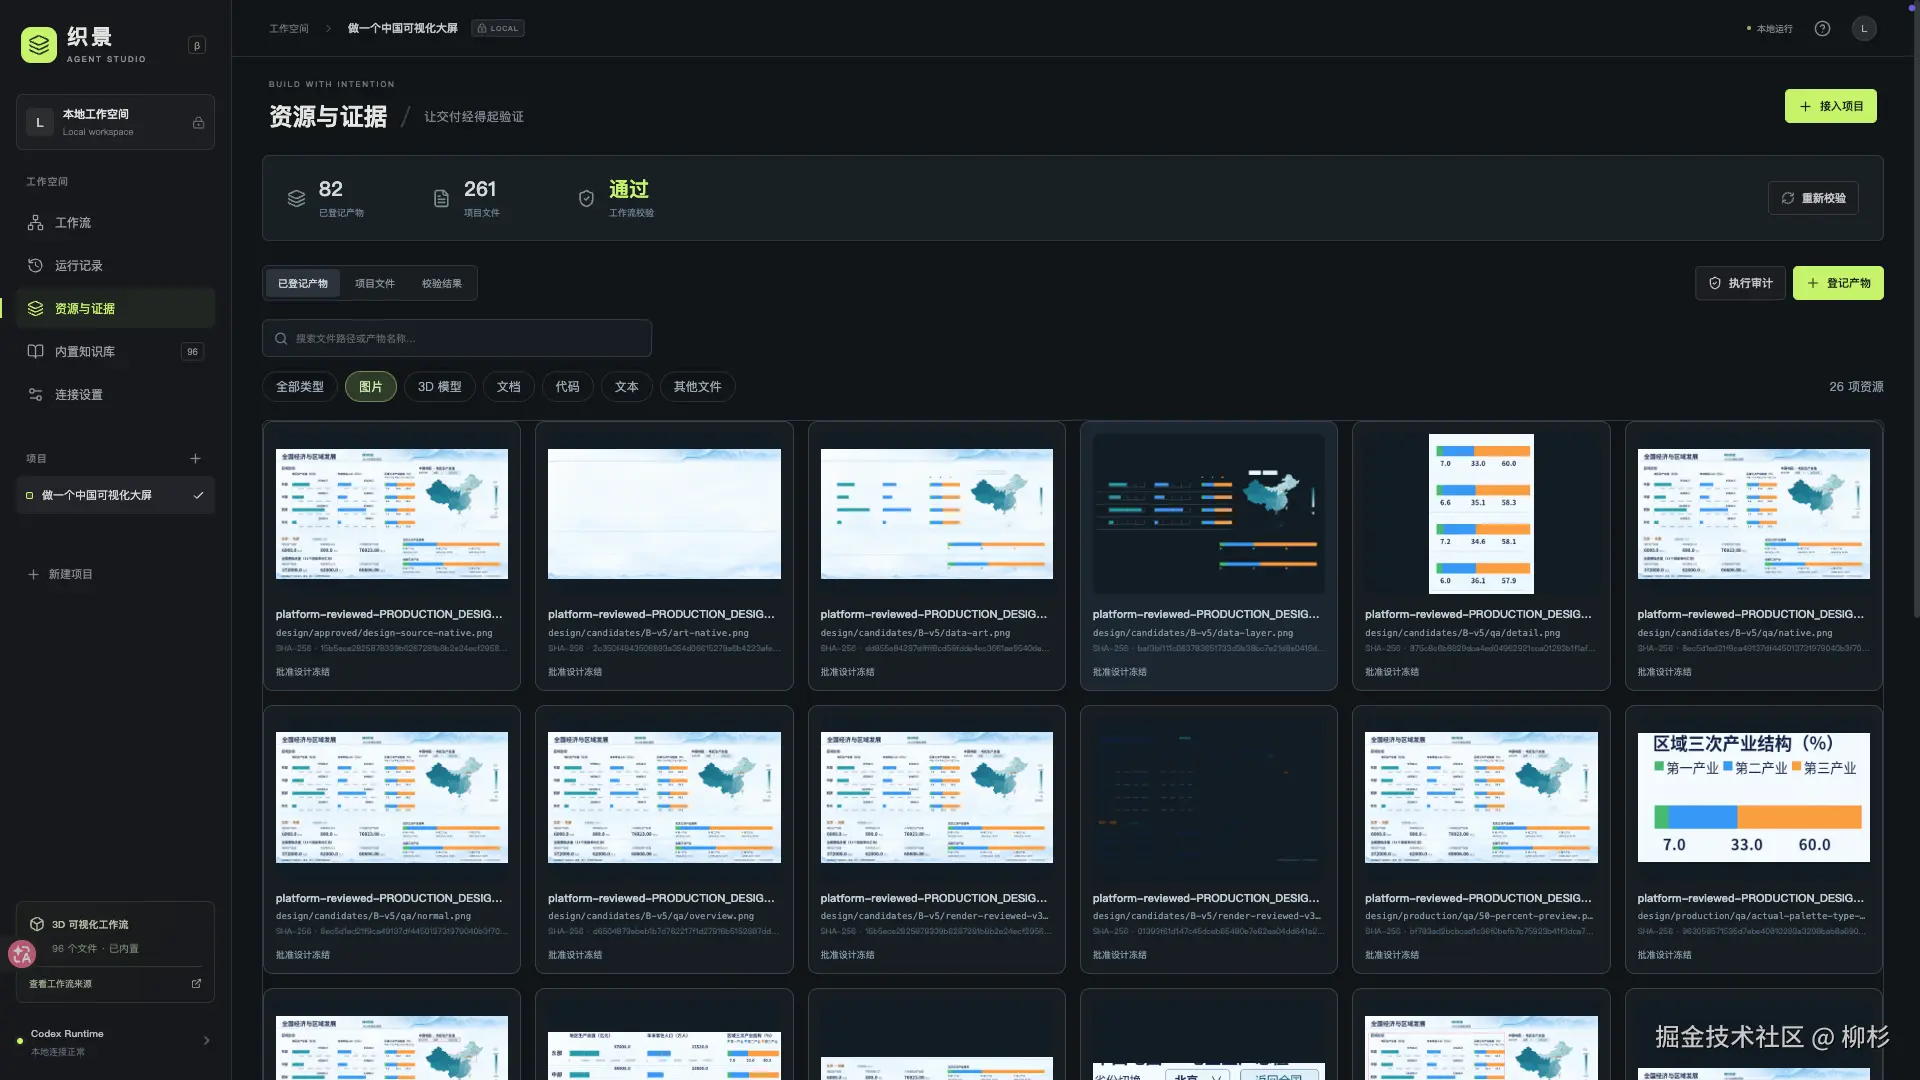
顺便提一句,在打磨这套工作流的同时,我也在想办法更快地展示它的运行效果、优化整个操作流程的呈现方式------比如清楚地看到每一步在做什么、跑了多久、历史记录如何。
所以我顺手做了一个可视化智能体平台,用来追踪和展示工作流的运行情况与执行历史,目前还在持续完善和测试中,后面做到阶段性可用,会开放公测给大家体验。
 感兴趣的小伙伴可以留意一下哈!!
想要源码的小伙伴,可以来 柳杉前端 公众号 同名文章自取哈。