上一章讲原理,这一章动手。面试官问到最后,往往会来一句:
"你自己搭过向量检索吗?"
这时候,能从头说清楚"我起了什么库、表怎么建、索引什么时候建、查询 SQL 长什么样、哪些参数调过"的人,和只会说"我用了向量数据库"的人,是两种候选人。
这篇我用 pgvector 从头走一遍,理由上一章说过:你是 Java 后端,pgvector 靠 SQL 就能玩,零额外组件,生产里也真常见。全程给可复制的命令和代码。走完你就能说一句底气十足的话------这条链路,我自己搭过。
一、先把库跑起来
最省事的办法是 Docker,官方有带 pgvector 的镜像。
bash
docker run -d --name pgvector-demo \
  -e POSTGRES_PASSWORD=secret \
  -e POSTGRES_DB=kb \
  -p 5432:5432 \
  pgvector/pgvector:pg16
连进去:
bash
docker exec -it pgvector-demo psql -U postgres -d kb装扩展:
sql
CREATE EXTENSION IF NOT EXISTS vector;验证一下:
sql
SELECT '[1,2,3]'::vector;能打印出 [1,2,3],说明向量类型已经可用。这几步看着简单,但面试时你能脱口说出"pgvector 是 PG 的一个扩展,装一个扩展就能用",就已经比空谈选型强------它说明你见过真实环境,不是只看过对比文章。
二、建表:向量只是一个特殊的列
sql
CREATE TABLE kb_chunk (
    id          bigserial PRIMARY KEY,
    doc_id      text        NOT NULL,
    title       text,
    category    text,
    content     text        NOT NULL,
    embedding   vector(1536),
    created_at  timestamptz DEFAULT now()
);
几个点要能讲。
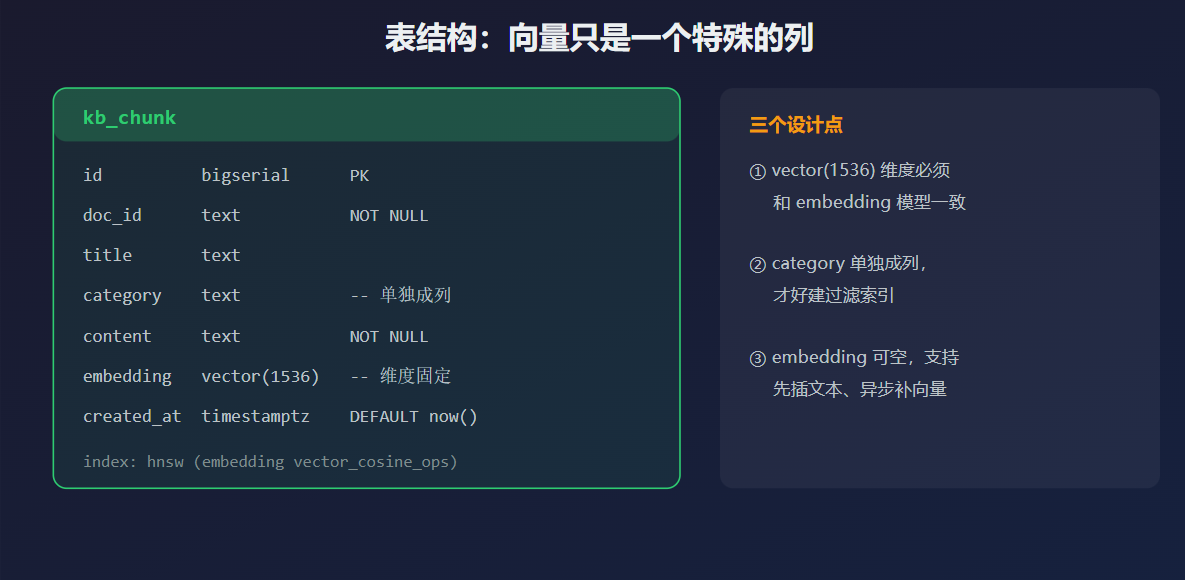
vector(1536):维度必须和你用的 embedding 模型完全一致。 你换了模型,维度变了,这张表就对不上,要么改列、要么重建表。这是最常见的报错来源,后面踩坑清单还会提。
我特意把 category 单独拆成一列,而不是塞进一个 jsonb 里。因为过滤字段单独成列,才好建索引 。如果元数据五花八门、也没打算按它过滤,用 jsonb 更灵活------这是一个真实的取舍,面试时能说出"我为什么这么拆",就是加分项。
embedding 是可空的。为什么?因为入库流程常常是先插文本、异步再补向量------解析、切分、调模型算 embedding 这几步很慢,不能卡在用户请求里同步做完。
三、灌数据:向量是应用算出来的,不是数据库算的
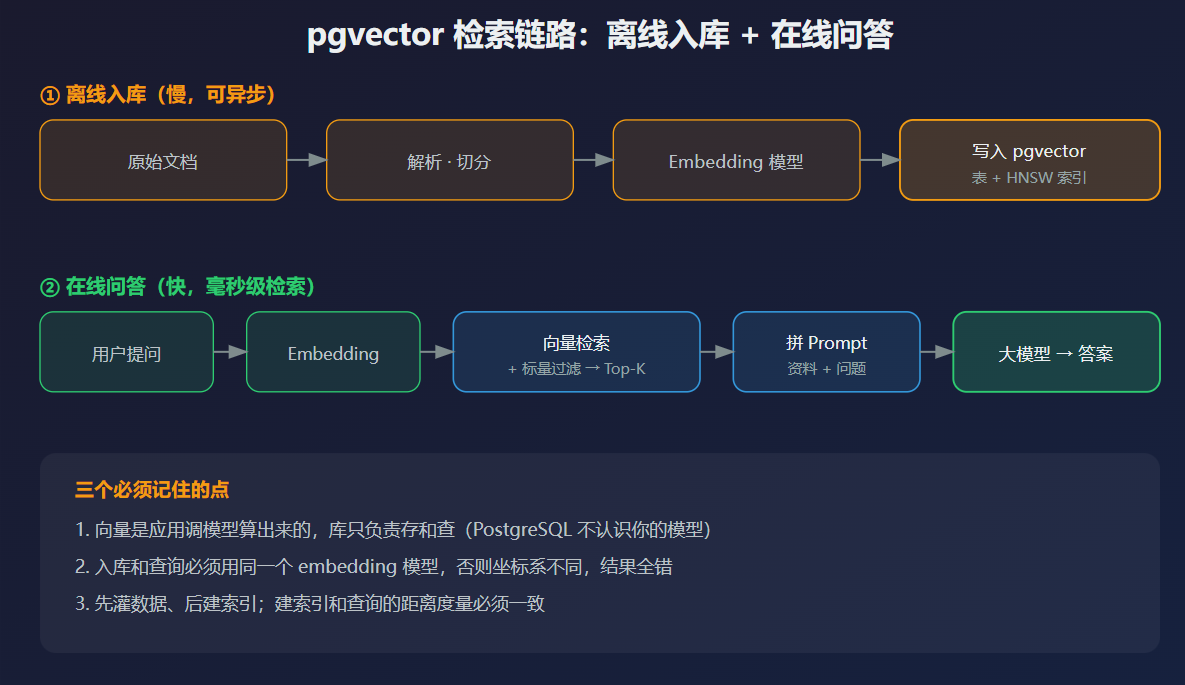
关键认知先立住:PostgreSQL 不认识你的 embedding 模型。 那串 1536 维的数,是你在 Java 侧调用模型算好,再当普通数组写进去的。库只负责存和查。
单条插入:
sql
INSERT INTO kb_chunk (doc_id, title, category, content, embedding)
VALUES (
    'faq-001',
    '退货政策',
    'refund',
    '签收后七天内可无理由退货......',
    '[0.012, -0.034, 0.087, /* ... 共 1536 个数 ... */]'
);
真实项目里当然不会一条条手写。批量入库的常见做法是把向量拼成文本,用 COPY 或者批量 INSERT 一次性写进去,几千条一批,比逐条快得多。
再提醒一句:入库用的 embedding 模型,和查询时用的必须是同一个。 入库用 A 模型、查询用 B 模型,两边的向量空间根本不是一套坐标系,检索结果会离谱到没法看。这个错误不报错,只会静静地给你垃圾结果,是排查起来最难受的那类。
四、建索引:什么时候建,比怎么建更重要
这是全文最该记住的一句:先灌数据,后建索引。
为什么?HNSW 建图是一个非常重的活,数据越多越慢。你要是先建索引再往表里灌几百万行,每插一批都要维护索引,慢到怀疑人生。正确顺序是------把数据批量灌完,最后一把建索引。
HNSW 索引:
sql
CREATE INDEX idx_kb_hnsw ON kb_chunk
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
拆开看:
-
USING hnsw:索引类型是 HNSW。 -
vectorcosineops:这是关键,它声明"这张索引服务于余弦距离的查询"。 上一章说的"度量和算子必须对得上",在这里落地------你用余弦建索引,查询就得用余弦的算子。 -
m = 16:每个节点连的边数,默认 16,越大召回越高、内存越大。 -
ef_construction = 64:建图搜索宽度,默认 64,越大图越准、建得越慢。
如果数据量大、内存紧张,也可以考虑 IVFFlat:
sql
CREATE INDEX idx_kb_ivf ON kb_chunk
    USING ivfflat (embedding vector_cosine_ops)
    WITH (lists = 100);
lists 的经典经验值是"行数除以 1000(一百万行以内)"。HNSW 召回更稳、但内存更高;IVFFlat 省内存、但边界点容易漏。选型逻辑跟上一章一致。
建索引前顺手把
maintenanceworkmem调大(比如SET maintenanceworkmem = '1GB';),否则 HNSW 建图可能慢得离谱,甚至因为内存不够报错。这是个实打实的运维细节,面试说出来很加分。
五、查询:三个算子,一条 ORDER BY
pgvector 的查询,核心就一个写法------按距离升序排,取前 K。
余弦距离:
sql
SELECT id, title, content,
       1 - (embedding <=> $1) AS cosine_sim
FROM kb_chunk
ORDER BY embedding <=> $1
LIMIT 5;
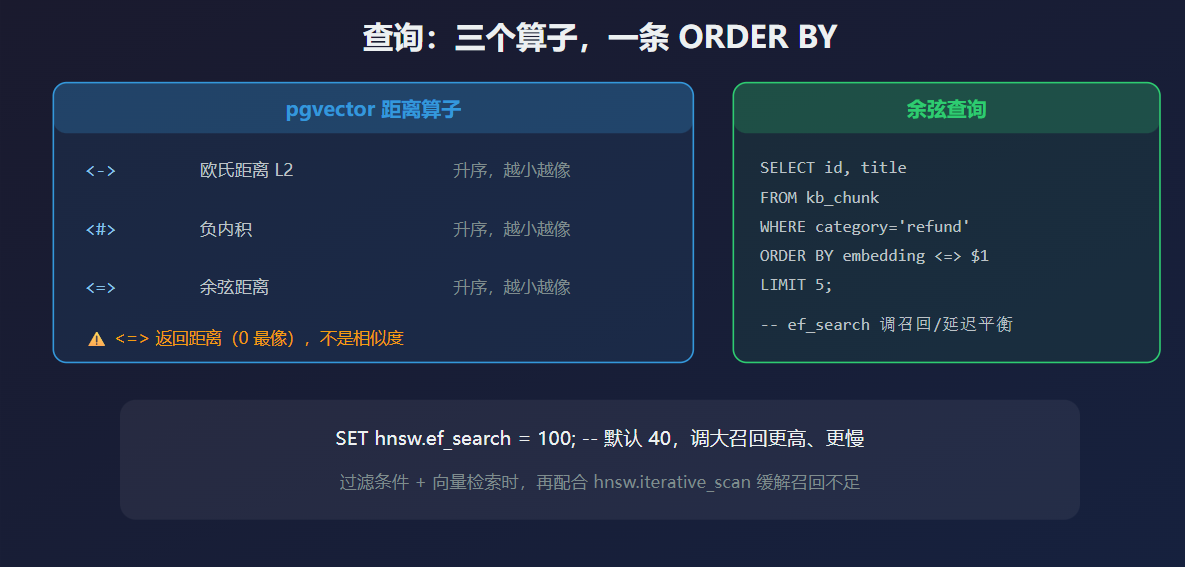
$1 是你的查询向量。三个距离算子各对应一种度量:
| 算子 | 含义 | 排序方向 |
|---|---|---|
<-> |
欧氏距离(L2) | 升序,越小越像 |
<#> |
负内积 | 升序,越小(即内积越大)越像 |
<=> |
余弦距离 | 升序,越小越像 |
几个容易踩的点。
cosine_sim 那一列是我顺手算出来给人看的,1 - 余弦距离 就是余弦相似度。真正排序用的是 <=>,别拿相似度去 ORDER BY,方向正好反过来。
<=> 返回的是距离(0 最像,2 最不像),不是相似度。很多人第一眼会搞混,写出来结果反了还以为是模型的问题。
想调召回和延迟的平衡,动这个旋钮:
sql
SET hnsw.ef_search = 100; -- 默认 40,调大召回更高、更慢六、带过滤条件的查询:生产里最常遇到的形态
纯相似检索只是入门。真实业务一定带条件:
sql
SELECT id, title, content
FROM kb_chunk
WHERE category = 'refund'
ORDER BY embedding <=> $1
LIMIT 5;
上一章讲的过滤难题,这里给你两条实操对策。
对策一,用迭代索引扫描(pgvector 0.8+):
sql
SET hnsw.iterative_scan = relaxed_order;它让引擎一边按 HNSW 游走、一边套 WHERE,不够 Top K 就继续找,缓解"过滤太狠导致召回不足"的问题。
对策二,给高频过滤字段建普通索引。
sql
CREATE INDEX idx_kb_category ON kb_chunk (category);或者对特别固定的过滤组合,直接建部分索引(partial index),让索引本身就只覆盖符合条件的行。
面试时你能说出"过滤和向量索引是耦合的,我一般先用迭代扫描兜底,再针对高频字段建索引",说明你是真部署过,不是纸上谈兵。
七、接进 Spring AI:生产里你不会手写这些 SQL
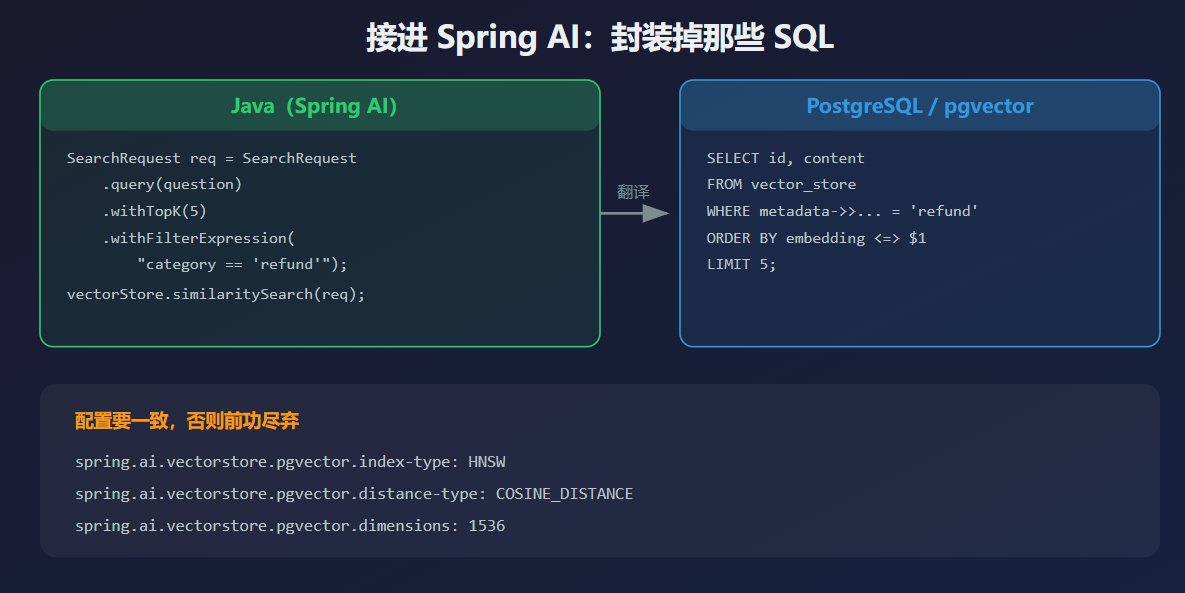
前面手写 SQL 是为了让你知道底下在发生什么。真到了工程里,Java 侧一般用 Spring AI 的 VectorStore 接口封装,少写一堆样板代码。
配置(application.yml):
yaml
spring:
  ai:
    vectorstore:
      pgvector:
        index-type: HNSW
        distance-type: COSINE_DISTANCE
        dimensions: 1536
        initialize-schema: true
说明:Spring AI 的 PgVectorStore 会在启动时自动建一张表(默认叫 vectorstore*),index-type 和 distance-type 决定它用哪种索引、哪种距离------一定要和你实际查询的算子一致,否则就会踩上一章说的那个坑。 它也能通过 table-name 指向你自己的表,如果你想复用前面手写的 kb* chunk。
写入:
java
List<Document> docs = List.of(
    new Document("签收后七天内可无理由退货......",
                 Map.of("doc_id", "faq-001", "category", "refund")),
    new Document("生鲜类商品不支持七天无理由退货......",
                 Map.of("doc_id", "faq-002", "category", "refund"))
);
vectorStore.add(docs);
Document 的第二个参数就是元数据,会被存成可过滤的字段。
检索:
java
SearchRequest request = SearchRequest.query(question)
        .withTopK(5)
        .withSimilarityThreshold(0.6)
        .withFilterExpression("category == 'refund'");

List<Document> docs = vectorStore.similaritySearch(request);
withFilterExpression 是 Spring AI 自带的一套过滤表达式 DSL,写起来接近自然语言,底层会翻译成 SQL 的 WHERE。withTopK(5) 是要 5 条,withSimilarityThreshold(0.6) 是"相似度低于 0.6 的直接不要"。
提示一个常见的组合坑:
topK和similarityThreshold一起用,阈值设太高,可能一条都不返回。 别一上来就设 0.9,先用默认值观察,再按实际数据回调。
把它接进一个完整的 RAG 问答:
java
@Service
public class KbQaService {

    @Autowired private VectorStore vectorStore;
    @Autowired private ChatClient chatClient;

    public String ask(String question) {
        // 1. 检索:按语义相似 + 分类过滤,取前 5 段
        List<Document> docs = vectorStore.similaritySearch(
                SearchRequest.query(question)
                        .withTopK(5)
                        .withFilterExpression("category == 'refund'"));

        // 2. 拼上下文
        String context = docs.stream()
                .map(Document::getText)
                .collect(Collectors.joining("\n---\n"));

        // 3. 组 Prompt,交给模型
        String prompt = """
                只依据下面的资料回答问题,资料里没有就说不知道:
                %s

                问题:%s
                """.formatted(context, question);

        return chatClient.prompt().user(prompt).call().content();
    }
}
这段代码不长,但把"检索 → 拼上下文 → 生成"这条主线串完了。面试官问"你怎么用的向量库",你把这段讲一遍,就落地了。
八、踩坑清单:都是我或身边人真踩过的
1. 维度对不上。 表声明 vector(1536),却塞进去 1024 维的向量,直接报维度不符。换模型时最容易翻车。
2. 度量不一致。 索引用 vectorcosineops 建,查询却按 <->(欧氏)排序,结果全乱。这个错误不报错,最阴。
3. 该归一化没归一化。 打算用内积,却没把向量归一化,于是长文本的向量靠"模长大"占便宜,语义反而不准。
4. 索引建太早。 数据还很少就建了 HNSW,规划器扭头不用它,走了全表扫描------你还以为索引没生效。
5. 参数没调。 ef_search、lists、probes 全是默认值,召回上不去,就抱怨"向量检索不准"。
6. 阈值设太高。 similarityThreshold 一上手就设 0.9,返回空列表,还以为是模型不行。
7. 千万级数据才想起来建索引。 建 HNSW 锁着表跑半天,线上直接告警。要么提前规划,要么挑低峰窗口建。
🎯 面试官视角的标准回答
如果面试官问:"你自己搭过向量检索吗?具体怎么做的?"
搭过,我用 pgvector 走的全流程。库是 Docker 起的
pgvector/pgvector:pg16,进来先CREATE EXTENSION vector装上扩展。<br><br>表里向量就是一个普通的列,声明成vector(1536),维度必须和 embedding 模型一致。入库时我先批量插文本,向量是 Java 侧调模型算好再写进去的,顺序上是先灌完数据、最后一把建索引,因为 HNSW 建图很重,边插边维护索引会很慢。索引我用的是 HNSW,配vectorcosineops,保证索引和查询的度量一致。<br><br>查询就是按距离升序取前 K,余弦用<=>算子。带权限、分类这类过滤条件时,我先用迭代索引扫描兜底,再对高频过滤字段单独建索引,避免先过滤把图退化成暴力。<br><br>工程里这些 SQL 我用 Spring AI 的 VectorStore 封装了,配置里指定索引类型和距离类型,检索时用withFilterExpression传过滤条件。踩过的坑主要是两个:一是换 embedding 模型忘了改维度,二是索引的度量和查询算子不一致,结果错得还特别隐蔽。
26 篇,这次是真的收官了
回头看,第 04 篇讲了"向量库选哪个",这两篇把"它内部怎么快、我手上怎么搭"补齐了。到这儿,这套「面 Java 岗,问我 AIGC?」从概念到落地、从原理到源码,一条线走完了。
写这两篇的起因,是有读者追问:"向量数据库到底是不是必学?"我的答案是:语法背不背无所谓,但"它凭什么快"和"我怎么把它跑起来",是一个想拿 AIGC 岗的 Java 后端绕不开的。
面试官招的从来不是背了多少名词的人,是能把东西讲清楚、还能动手做出来的人。愿这里面的每一段代码、每一条 SQL,都变成你面试桌上能拿得出手的底气。
唠点键盘之外的,谢谢看到这里。面试顺利。