前言
- 我们在入门强化学习已经有一阵子了,今天我们来讲讲强化学习中的另一个分支,即离策略强化学习
- 本文将从这个分支的概念讲起,再从算法原理一路讲到
SB3(Stable-Baselines3)的源码实现,依次讲清DDPG(Deep Deterministic Policy Gradient,深度确定性策略梯度)、TD3(Twin Delayed DDPG,双延迟深度确定性策略梯度)、SAC(Soft Actor-Critic,软演员评论家)三代离策略算法 - 最后用一个小实验,把这三代算法与在策略基线
PPO(Proximal Policy Optimization,近端策略优化)放在同一个环境、同一个交互预算下对比,看离策略算法的样本效率优势能不能转换成更短的训练耗时
文章目录
-
- 前言
- [0 强化框架](#0 强化框架)
-
-
- [0-1 Stable-Baselines3](#0-1 Stable-Baselines3)
- [0-2 安装](#0-2 安装)
-
- [1 off-policy](#1 off-policy)
-
-
- [1-1 介绍](#1-1 介绍)
- [1-2 off-policy 常见算法](#1-2 off-policy 常见算法)
- [1-3 off-policy 为什么能生效](#1-3 off-policy 为什么能生效)
- [1-4 off-policy 优势与缺点](#1-4 off-policy 优势与缺点)
- [1-5 Deadly Triad](#1-5 Deadly Triad)
-
- [2 DDPG](#2 DDPG)
-
-
- [2-1 介绍](#2-1 介绍)
- [2-2 整体架构](#2-2 整体架构)
- [2-3 核心思想](#2-3 核心思想)
-
- [2-3-1 确定性策略梯度(Deterministic Policy Gradient)](#2-3-1 确定性策略梯度(Deterministic Policy Gradient))
- [2-3-2 经验回放(Experience Replay)](#2-3-2 经验回放(Experience Replay))
- [2-3-3 目标网络(Target Networks)](#2-3-3 目标网络(Target Networks))
-
- [2-3-3-1 问题描述](#2-3-3-1 问题描述)
- [2-3-3-2 目标网络引入的真正原因](#2-3-3-2 目标网络引入的真正原因)
- [2-3-3-3 软更新](#2-3-3-3 软更新)
- [2-3-4 探索噪声(Exploration Noise)](#2-3-4 探索噪声(Exploration Noise))
- [2-4 损失计算](#2-4 损失计算)
-
- [2-4-1 Critic 损失(Critic Loss)](#2-4-1 Critic 损失(Critic Loss))
- [2-4-2 Actor 损失(Actor Loss)](#2-4-2 Actor 损失(Actor Loss))
- [2-5 训练流程](#2-5 训练流程)
-
- [2-5-1 全流程](#2-5-1 全流程)
- [2-5-2 采样动作:预热与探索噪声](#2-5-2 采样动作:预热与探索噪声)
- [2-5-3 存池](#2-5-3 存池)
- [2-5-4 随机抽取 Batch](#2-5-4 随机抽取 Batch)
- [2-5-5 更新 Critic](#2-5-5 更新 Critic)
- [2-5-6 更新 Actor](#2-5-6 更新 Actor)
- [2-5-7 软更新目标网络](#2-5-7 软更新目标网络)
- [2-6 缺陷与不足](#2-6 缺陷与不足)
-
- [3 TD3](#3 TD3)
-
-
- [3-1 介绍](#3-1 介绍)
- [3-2 整体架构](#3-2 整体架构)
- [3-3 核心思想](#3-3 核心思想)
-
- [3-3-1 Clipped Double Q-Learning(截断双 Q 学习)](#3-3-1 Clipped Double Q-Learning(截断双 Q 学习))
- [3-3-2 Target Policy Smoothing(目标策略平滑)](#3-3-2 Target Policy Smoothing(目标策略平滑))
- [3-3-3 Delayed Policy Updates(延迟策略更新)](#3-3-3 Delayed Policy Updates(延迟策略更新))
- [3-4 损失计算](#3-4 损失计算)
-
- [3-4-1 Critic 损失(Critic Loss)](#3-4-1 Critic 损失(Critic Loss))
- [3-4-2 Actor 损失(Actor Loss)](#3-4-2 Actor 损失(Actor Loss))
- [3-5 训练流程](#3-5 训练流程)
- [3-6 缺陷与不足](#3-6 缺陷与不足)
-
- [4 SAC](#4 SAC)
-
-
- [4-1 介绍](#4-1 介绍)
- [4-2 整体架构](#4-2 整体架构)
- [4-3 核心思想](#4-3 核心思想)
-
- [4-3-1 最大熵强化学习(Maximum Entropy Reinforcement Learning)](#4-3-1 最大熵强化学习(Maximum Entropy Reinforcement Learning))
- [4-3-2 随机策略(Stochastic Policy)](#4-3-2 随机策略(Stochastic Policy))
- [4-3-3 双 Q 网络与目标网络(Twin Q Networks)](#4-3-3 双 Q 网络与目标网络(Twin Q Networks))
- [4-3-4 自动熵调节(Automatic Entropy Tuning)](#4-3-4 自动熵调节(Automatic Entropy Tuning))
- [4-4 损失计算](#4-4 损失计算)
-
- [4-4-1 Critic 损失(Critic Loss)](#4-4-1 Critic 损失(Critic Loss))
- [4-4-2 Actor 损失(Actor Loss)](#4-4-2 Actor 损失(Actor Loss))
- [4-4-3 熵系数损失(Entropy Coefficient Loss)](#4-4-3 熵系数损失(Entropy Coefficient Loss))
- [4-5 训练流程](#4-5 训练流程)
-
- [5 实验](#5 实验)
-
-
- [5-1 实验说明](#5-1 实验说明)
-
- [5-1-1 环境与任务的选取](#5-1-1 环境与任务的选取)
- [5-1-2 四个臂与网络量级的统一](#5-1-2 四个臂与网络量级的统一)
- [5-2 结果分析](#5-2 结果分析)
-
- [5-2-1 探索效率](#5-2-1 探索效率)
- [5-2-2 样本效率](#5-2-2 样本效率)
- [5-2-3 训练墙钟耗时](#5-2-3 训练墙钟耗时)
-
- 总结
0 强化框架
0-1 Stable-Baselines3
Stable-Baselines3(简称 SB3)是一个基于 PyTorch 的强化学习算法库,提供了多种经典强化学习算法的实现,帮助开发者快速训练、评估和部署强化学习智能体,而不必从零开始实现神经网络、损失函数、梯度更新和训练循环。- 官方项目:Stable-Baselines3 GitHub 仓库
- 本文所有算法的实现都取自
SB3,用它做这件事的理由有三个- 接口统一:所有算法都是"构造模型、调用
learn"两步,算法之间的差异只落在超参与策略网络上,做多算法对照时才不会混进实现风格的影响 - 实现规范:它是被大量论文与工程引用的参考实现,本文给出的每一段代码都取自它被真正执行的那一份,不是伪代码
- 可复现:随机种子、计算设备、评估方式都是显式参数,同一份配置可以逐位复现
- 接口统一:所有算法都是"构造模型、调用
- 本文涉及的四个算法在 SB3 里对应的类与规格如下
| 算法 | 类 | 策略类型 | 是否离策略 |
|---|---|---|---|
| DDPG | stable_baselines3.DDPG |
确定性 | 是 |
| TD3 | stable_baselines3.TD3 |
确定性 | 是 |
| SAC | stable_baselines3.SAC |
随机 | 是 |
| PPO | stable_baselines3.PPO |
随机 | 否 |
- 用起来只有三步,以本文实验里的
TD3为例
python
import gymnasium as gym
from stable_baselines3 import TD3

env = gym.make("Pendulum-v1")                          # 连续动作环境,第 5 章说明为什么选它
model = TD3("MlpPolicy", env, seed=0, device="cuda")   # 策略网络与环境都由 SB3 接管
model.learn(total_timesteps=50_000) # 唯一的训练入口- 注意第二行的
"MlpPolicy":它只表示"用全连接网络分别搭出 Actor 与 Critic",至于网络几层、每层多宽,由policy_kwargs里的net_arch决定,这一点在实验一章会用到
0-2 安装
- SB3 的主要依赖只有
PyTorch与Gymnasium(一个标准化的强化学习环境接口库,提供 CartPole、Pendulum 等经典环境,并统一了环境创建、状态观测、动作执行、奖励反馈与环境重置等操作),一条命令装完
bash
pip install stable-baselines3- 装完用三行确认版本与后端是否就绪
python
import torch
import stable_baselines3 as sb3

print(sb3.__version__, torch.__version__, torch.cuda.is_available())- 注意:本文的源码对照基于
SB3 2.8.0。SB3 在小版本之间调整过超参默认值(离策略算法的batch_size就是其中之一),如果你装的版本不同,行号与默认值可能有出入,判断以本地那份源码为准
1 off-policy
1-1 介绍
#mermaid-svg-3jLUHMitrRLDO2l8{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-3jLUHMitrRLDO2l8 .error-icon{fill:#552222;}#mermaid-svg-3jLUHMitrRLDO2l8 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-3jLUHMitrRLDO2l8 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-3jLUHMitrRLDO2l8 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-3jLUHMitrRLDO2l8 .marker.cross{stroke:#333333;}#mermaid-svg-3jLUHMitrRLDO2l8 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-3jLUHMitrRLDO2l8 p{margin:0;}#mermaid-svg-3jLUHMitrRLDO2l8 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster-label text{fill:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster-label span{color:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster-label span p{background-color:transparent;}#mermaid-svg-3jLUHMitrRLDO2l8 .label text,#mermaid-svg-3jLUHMitrRLDO2l8 span{fill:#333;color:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 .node rect,#mermaid-svg-3jLUHMitrRLDO2l8 .node circle,#mermaid-svg-3jLUHMitrRLDO2l8 .node ellipse,#mermaid-svg-3jLUHMitrRLDO2l8 .node polygon,#mermaid-svg-3jLUHMitrRLDO2l8 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-3jLUHMitrRLDO2l8 .rough-node .label text,#mermaid-svg-3jLUHMitrRLDO2l8 .node .label text,#mermaid-svg-3jLUHMitrRLDO2l8 .image-shape .label,#mermaid-svg-3jLUHMitrRLDO2l8 .icon-shape .label{text-anchor:middle;}#mermaid-svg-3jLUHMitrRLDO2l8 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-3jLUHMitrRLDO2l8 .rough-node .label,#mermaid-svg-3jLUHMitrRLDO2l8 .node .label,#mermaid-svg-3jLUHMitrRLDO2l8 .image-shape .label,#mermaid-svg-3jLUHMitrRLDO2l8 .icon-shape .label{text-align:center;}#mermaid-svg-3jLUHMitrRLDO2l8 .node.clickable{cursor:pointer;}#mermaid-svg-3jLUHMitrRLDO2l8 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-3jLUHMitrRLDO2l8 .arrowheadPath{fill:#333333;}#mermaid-svg-3jLUHMitrRLDO2l8 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-3jLUHMitrRLDO2l8 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-3jLUHMitrRLDO2l8 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-3jLUHMitrRLDO2l8 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-3jLUHMitrRLDO2l8 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-3jLUHMitrRLDO2l8 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster text{fill:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 .cluster span{color:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-3jLUHMitrRLDO2l8 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-3jLUHMitrRLDO2l8 rect.text{fill:none;stroke-width:0;}#mermaid-svg-3jLUHMitrRLDO2l8 .icon-shape,#mermaid-svg-3jLUHMitrRLDO2l8 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-3jLUHMitrRLDO2l8 .icon-shape p,#mermaid-svg-3jLUHMitrRLDO2l8 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-3jLUHMitrRLDO2l8 .icon-shape .label rect,#mermaid-svg-3jLUHMitrRLDO2l8 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-3jLUHMitrRLDO2l8 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-3jLUHMitrRLDO2l8 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-3jLUHMitrRLDO2l8 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 强化学习算法
On-policy
Off-policy
PPO
A2C
TRPO
DQN
DDPG
TD3
SAC
- 强化学习的算法可以按"训练数据从哪来"分成两类,也就是常说的在策略与离策略
- 在策略(on-policy):使用当前策略(或与其对应的采样策略)产生的数据进行学习,通常在完成有限轮更新后丢弃这批数据,重新采样。
- 离策略(off-policy):允许使用不同于当前目标策略的行为策略产生的数据进行学习,通常可以通过经验回放等机制重复利用历史数据。
- 更形式化的说法是:在策略方法要求行为策略 与目标策略 是同一个,离策略方法允许两者不同
- 行为策略(behavior policy):实际与环境交互、产生数据的那个策略
- 目标策略(target policy):我们真正想学好的那个策略
- 这个区分之所以重要,是因为它直接决定了一件事:一条数据能被利用多少次
说人话:在策略是"边做边学、做完就忘",离策略是"先记在本子上,回头反复翻"
- 举个具体的例子:环境走一步、拿到一个奖励
- 在策略方法里这份经验参与一次梯度更新就被丢进历史的垃圾桶;
- 离策略方法把它存进经验池,之后每一轮训练都可能再抽到它
- 本文要讲的三代算法全部属于离策略,它们的差别不在"用不用经验池"上,而在怎么把这个池子里的数据用稳
1-2 off-policy 常见算法
- 离策略这条线上值得记住的代表算法如下
| 算法 | 年份 | 策略类型 | 相对前一代的关键改动 |
|---|---|---|---|
| DQN | 2015 | 离散、确定性 | 经验回放加目标网络,让"值函数加神经网络"第一次稳定下来 |
| DDPG | 2016 | 连续、确定性 | 把 DQN 的两个技巧搬到 Actor-Critic 上,扩展到连续动作 |
| TD3 | 2018 | 连续、确定性 | 修正 DDPG 的价值高估与更新过频,是本文的主线算法之一 |
| SAC | 2018 | 连续、随机 | 把最大熵目标写进优化目标,用随机策略兼做探索 |
- 需要注意 DQN 与后面三者的关系:DQN 只能处理离散动作(要对每个动作求最大值),DDPG 用"Actor 直接输出动作"绕开了这个限制,这也是它一定要引入确定性策略梯度的原因,2-3-1 小节会展开
1-3 off-policy 为什么能生效
- Off-policy(离策略学习)之所以能够生效,核心在于:学习目标与数据的产生方式可以相互独立,训练数据不一定必须由当前策略产生。
- 行为策略(Behavior Policy)负责与环境交互并收集数据,目标策略(Target Policy)是希望学习或评估的策略。On-policy 使用当前策略产生的数据,而 Off-policy 允许利用其他策略产生的数据。
- 那么,为什么历史数据仍然有效?
- 学习价值信息: 交互数据包含状态、动作、奖励和状态转移等信息,可用于估计价值函数或改进策略,而不只是模仿历史动作。
- 提高样本利用率: 不同策略可能访问相同或相似的状态,历史经验可以重复用于学习,无须每次更新策略后都重新采集数据。
- 当然,历史数据并非总是有效。如果数据无法充分覆盖目标策略可能访问的重要状态和动作,价值估计与策略改进就可能受到影响。
- 因此,Off-policy 能够利用其他策略产生的数据学习目标策略,但其效果取决于数据覆盖程度、学习方法及其适用条件。
1-4 off-policy 优势与缺点
-
off-policy与之带来的优势显而易见:
- 样本效率高: 离策略方法可以复用历史数据进行多次梯度更新,在相同环境交互预算下通常能获得更多学习机会。
- 数据可复用: 旧策略产生的数据、历史经验甚至人工示范都可能用于训练,尤其适合交互成本高的机器人等真实系统。
- 探索与学习相对解耦: 行为策略负责探索并收集数据,目标策略负责学习改进,两者可以不同,但仍需保证数据具有足够的覆盖性。
-
但是,Off-policy 也存在相应的代价:
- 分布不匹配: 历史数据的分布可能与目标策略的访问分布不同,导致部分状态或动作缺乏足够的数据支持,影响价值估计与策略改进。
- 训练稳定性挑战: 当函数逼近、自举和离策略学习同时存在时,可能出现 Deadly Triad 所描述的不稳定性,甚至导致价值估计发散。
- 算法设计与调参更复杂: 经验回放、目标网络等机制引入了额外的设计选择和超参数,需要根据具体算法进行调整。
1-5 Deadly Triad
- Deadly Triad(致命三元组) 由 Sutton 和 Barto 在 2018 年出版的《Reinforcement Learning: An Introduction》第二版第 11.3 节中系统讨论。尽管这一概念并不意味着函数逼近、自举和离策略学习同时存在时算法必然发散,但它仍为理解强化学习中的训练不稳定性提供了重要的理论视角,具有参考价值。
- 函数逼近(Function Approximation): 使用神经网络等参数化函数近似价值函数,一次参数更新可能影响多个状态的价值估计。
- 自举(Bootstrapping): 利用已有的价值估计构造学习目标,例如 TD 学习使用下一状态的价值估计更新当前状态的价值。
- 离策略学习(Off-policy Learning): 使用行为策略产生的数据学习目标策略,训练数据的分布可能与目标策略的访问分布不一致。
- 三者结合可能使价值估计误差相互影响,破坏学习过程的稳定性,甚至导致发散。但这并不意味着三者同时存在就必然发散,也不意味着所有离策略算法都会出现这一问题。
- 为缓解相关风险,算法可以采用目标网络、改进梯度更新规则或修正价值估计等方法。其中,目标网络通过减缓 TD 目标的变化来改善训练稳定性,但不能保证彻底消除发散风险。
2 DDPG
2-1 介绍
#mermaid-svg-2FX1qZaPKOhJNbw2{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-2FX1qZaPKOhJNbw2 .error-icon{fill:#552222;}#mermaid-svg-2FX1qZaPKOhJNbw2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-2FX1qZaPKOhJNbw2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .marker.cross{stroke:#333333;}#mermaid-svg-2FX1qZaPKOhJNbw2 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-2FX1qZaPKOhJNbw2 p{margin:0;}#mermaid-svg-2FX1qZaPKOhJNbw2 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster-label text{fill:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster-label span{color:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster-label span p{background-color:transparent;}#mermaid-svg-2FX1qZaPKOhJNbw2 .label text,#mermaid-svg-2FX1qZaPKOhJNbw2 span{fill:#333;color:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .node rect,#mermaid-svg-2FX1qZaPKOhJNbw2 .node circle,#mermaid-svg-2FX1qZaPKOhJNbw2 .node ellipse,#mermaid-svg-2FX1qZaPKOhJNbw2 .node polygon,#mermaid-svg-2FX1qZaPKOhJNbw2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .rough-node .label text,#mermaid-svg-2FX1qZaPKOhJNbw2 .node .label text,#mermaid-svg-2FX1qZaPKOhJNbw2 .image-shape .label,#mermaid-svg-2FX1qZaPKOhJNbw2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-2FX1qZaPKOhJNbw2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .rough-node .label,#mermaid-svg-2FX1qZaPKOhJNbw2 .node .label,#mermaid-svg-2FX1qZaPKOhJNbw2 .image-shape .label,#mermaid-svg-2FX1qZaPKOhJNbw2 .icon-shape .label{text-align:center;}#mermaid-svg-2FX1qZaPKOhJNbw2 .node.clickable{cursor:pointer;}#mermaid-svg-2FX1qZaPKOhJNbw2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .arrowheadPath{fill:#333333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-2FX1qZaPKOhJNbw2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-2FX1qZaPKOhJNbw2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-2FX1qZaPKOhJNbw2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster text{fill:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 .cluster span{color:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-2FX1qZaPKOhJNbw2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-2FX1qZaPKOhJNbw2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-2FX1qZaPKOhJNbw2 .icon-shape,#mermaid-svg-2FX1qZaPKOhJNbw2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-2FX1qZaPKOhJNbw2 .icon-shape p,#mermaid-svg-2FX1qZaPKOhJNbw2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-2FX1qZaPKOhJNbw2 .icon-shape .label rect,#mermaid-svg-2FX1qZaPKOhJNbw2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-2FX1qZaPKOhJNbw2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-2FX1qZaPKOhJNbw2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-2FX1qZaPKOhJNbw2 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 梯度更新
策略梯度
软更新
软更新
状态 s
Actor 在线网络
动作 a
Critic 在线网络
下一状态 s'
Actor 目标网络
目标动作 a'
Critic 目标网络
奖励 r
TD 目标值 y
终止标志 d
Critic 损失
- DDPG(Deep Deterministic Policy Gradient,深度确定性策略梯度)出自 2016 年的论文 "Continuous control with deep reinforcement learning",作者是 Lillicrap 等人
- 它要解决的问题很具体:DQN 那一套(经验回放加目标网络)在离散动作上已经能稳定训练,但搬到连续动作上直接就用不了
- DQN 学的是动作价值 Q ( s , a ) Q(s,a) Q(s,a),选动作时需要对全部动作取最大值,动作连续时这个最大值没法枚举
- 一个直接的想法是把动作离散化,可是动作维度一高,离散网格就指数增长,而且把控制量量化成台阶,在控制任务里往往直接表现成抖动
- DDPG 的思路是把"取最大值"这一步换掉,不再去搜动作,而是学一个函数直接给出让 Q Q Q 最大的那个动作
- 单独学一个 Actor μ ( s ) \mu(s) μ(s),它的输出就是动作本身,也就是那个最大值的解
- Critic 仍然学 Q ( s , a ) Q(s,a) Q(s,a),它的职责变成评价 Actor 给出的动作有多好
- 于是离散动作上的"枚举取最大值"被换成了连续动作上的"沿 Q Q Q 的梯度改进动作",后者可微,能直接用梯度下降来做
- 这个思路能成立靠的是确定性策略梯度定理,2-3-1 小节给出它的结论
说人话:DQN 是在一堆候选动作里挑最好的,候选一多就挑不过来,DDPG 干脆训练一个"替我们挑动作的人",让他直接给出答案
2-2 整体架构
- DDPG 将目标网络机制扩展到了 Actor 和 Critic 两部分,同时采用软更新
- 也就是说它有四个网络,分成两组
| 组别 | 在线网络 | 目标网络 | 分工 |
|---|---|---|---|
| Actor | μ ( s ∣ θ μ ) \mu(s\mid\theta^\mu) μ(s∣θμ) | μ ′ ( s ∣ θ μ ′ ) \mu'(s\mid\theta^{\mu'}) μ′(s∣θμ′) | 在线网络输出动作,目标网络用于构造学习目标 |
| Critic | Q ( s , a ∣ θ Q ) Q(s,a\mid\theta^Q) Q(s,a∣θQ) | Q ′ ( s , a ∣ θ Q ′ ) Q'(s,a\mid\theta^{Q'}) Q′(s,a∣θQ′) | 在线网络被训练,目标网络用于算 TD 目标 |
- 四个网络的更新关系是:在线网络被优化器更新,目标网络只跟着在线网络走,从不直接接收梯度
- 数据流可以概括成一条链
- 行为策略与环境交互,把转移样本 ( s t , a t , r t , s t + 1 , d t ) (s_t,a_t,r_t,s_{t+1},d_t) (st,at,rt,st+1,dt) 存进经验池
- 从池里随机抽一个 mini-batch,用目标 Critic 与目标 Actor 算出 TD 目标 y y y
- 用 y y y 与在线 Critic 的输出做均方误差,更新在线 Critic
- 在线 Critic 稍微稳定之后,用它的梯度去改进在线 Actor
- 最后把在线网络的参数按比例软更新到目标网络上
- 这条链里有一处循环依赖值得留意:Critic 学的目标 y y y 里含有 Actor 的输出,而 Actor 又是照着 Critic 的梯度改的,两者互相追赶。这正是 DDPG 不稳定的根源,也是 2-6 小节四条不足的共同出处
2-3 核心思想
2-3-1 确定性策略梯度(Deterministic Policy Gradient)
-
Actor 不再输出离散动作的概率分布,而是直接输出一个确定性动作 a = μ ( s ∣ θ μ ) a=\mu(s\mid\theta^\mu) a=μ(s∣θμ)意思就是:把当前状态 s s s 输入 Actor 网络 μ \mu μ,网络根据已经学到的参数 θ μ \theta^\mu θμ,计算并输出动作 a a a。
-
Critic 评价当前状态与动作的价值 Q ( s , a ∣ θ Q ) Q(s,a\mid\theta^Q) Q(s,a∣θQ)同理 θ Q \theta^Q θQ是价值网络参数
-
Actor 的优化目标是让 Critic 认为自己选择的动作具有更高的 Q 值
J ( θ μ ) = E s ∼ ρ β Q ( s , μ ( s ∣ θ μ ) ) J(\theta^\mu)=\mathbb{E}_{s\sim\rho^\beta} \leftQ(s,\\mu(s\\mid\\theta\^\\mu))\\right J(θμ)=Es∼ρβQ(s,μ(s∣θμ))
- 期望是对状态分布 ρ β \rho^\beta ρβ 取的,其中 β \beta β 是行为策略。注意期望里只有状态、没有动作,因为动作已经被 Actor 唯一确定了,这正是"确定性"三个字落到公式上的样子
- 对上式求梯度就得到确定性策略梯度
∇ θ μ J ≈ E s ∼ ρ β ∇ a Q ( s , a ∣ θ Q ) ∣ a = μ ( s ) ⋅ ∇ θ μ μ ( s ∣ θ μ ) \nabla_{\theta^\mu}J\approx\mathbb{E}_{s\sim\rho^\beta}\left\\nabla_a Q(s,a\\mid\\theta\^Q)\\big\|_{a=\\mu(s)}\\cdot\\nabla_{\\theta\^\\mu}\\mu(s\\mid\\theta\^\\mu)\\right ∇θμJ≈Es∼ρβ∇aQ(s,a∣θQ) a=μ(s)⋅∇θμμ(s∣θμ)
- 这个式子的结构值得记住:它由两项相乘组成,前一项是 Critic 告诉 Actor"动作往哪个方向变能让价值更大",后一项是 Actor 自己"能不能朝那个方向变",链式法则把两者接在一起
- 对照 SB3 的实现,Actor 就是一个输出维数等于动作维数的全连接网络,末端用
tanh把输出压到合法区间
python
# stable_baselines3/td3/policies.py
class Actor(BasePolicy):
    def __init__(self, observation_space, action_space, net_arch, features_extractor,
                 features_dim, activation_fn=nn.ReLU, normalize_images=True):
        ...
        action_dim = get_action_dim(self.action_space)
        # squash_output=True 会在网络末端接一个 tanh,把输出限在 [-1, 1]
        actor_net = create_mlp(features_dim, action_dim, net_arch, activation_fn, squash_output=True)
        # Deterministic action
        self.mu = nn.Sequential(*actor_net)      # 对应 a = mu(s|theta),没有分布、没有采样

    def forward(self, obs: th.Tensor) -> th.Tensor:
        features = self.extract_features(obs, self.features_extractor)
return self.mu(features) # 输入状态,直接输出动作- Actor 的损失函数就是把优化目标取负号,把最大化换成最小化
python
# stable_baselines3/td3/td3.py
# Compute actor loss
actor_loss = -self.critic.q1_forward(
    replay_data.observations, self.actor(replay_data.observations)
).mean()- 注意这里用的是
q1_forward而不是 Critic 的全部输出,取的是第一个 Critic 给出的打分。DDPG 只有一个 Critic,两者在这里是同一件事 - 另外
q1_forward内部把特征提取这一步放在th.no_grad()里,梯度只流到 Actor 的输出上,不会顺着 Critic 的权重往回改,避免 Actor 的更新反过来把 Critic 带偏
说人话:Critic 是裁判,Actor 是选手。裁判告诉选手"你刚才那个动作往左一点分数更高",选手照着改,改完裁判再评一次,如此往复
2-3-2 经验回放(Experience Replay)
- DDPG 继承了 DQN 的经验回放机制,将与环境交互得到的转移样本存入经验池 ( s t , a t , r t , s t + 1 , d t ) (s_t,a_t,r_t,s_{t+1},d_t) (st,at,rt,st+1,dt)其中: d t d_t dt 表示终止标志(done / terminal flag),用于表示当前时刻的交互是否导致一个 episode 结束。
- 从经验池中随机采样一个 mini-batch 训练网络
- 这样做打破连续交互样本之间的强相关性,提高样本利用率
- 为什么必须打散:连续几步的样本来自同一条轨迹,状态之间高度相关,直接拿它们做梯度下降,相当于在一个很窄的分布上反复更新。梯度的方差虽然小了,但方向是偏的,网络容易记住这一段轨迹,而不是学到策略
- SB3 里的经验池是一个环形缓冲,写满之后从最旧的那条开始覆盖
python
# stable_baselines3/common/buffers.py
class ReplayBuffer(BaseBuffer):
    def add(self, obs, next_obs, action, reward, done, infos) -> None:
        action = action.reshape((self.n_envs, self.action_dim))
        # Copy to avoid modification by reference
        self.observations[self.pos] = np.array(obs)
        self.next_observations[self.pos] = np.array(next_obs)
        self.actions[self.pos] = np.array(action)
        self.rewards[self.pos] = np.array(reward)
        self.dones[self.pos] = np.array(done)
        self.pos += 1
        if self.pos == self.buffer_size:
            self.full = True
            self.pos = 0        # 环形:写满后回到起点,覆盖最旧的样本

    def sample(self, batch_size: int, env=None):
        upper_bound = self.buffer_size if self.full else self.pos
        batch_inds = np.random.randint(0, upper_bound, size=batch_size)
return self._get_samples(batch_inds, env=env) # 均匀随机抽,与样本新旧无关- 两点值得留意
- 采样是均匀的,新旧样本被抽到的概率一样,这是原始 DDPG 的做法,优先经验回放属于后来的改进
- 池子里混着不同时期的策略产生的数据,这正是 1-3 小节说的"离策略"在代码上的落点:数据不必与当前策略同源
说人话:经验池是一本错题本,每做一道题就记一笔,训练时随机翻几页出来复习,而不是只盯着刚做的那几道
2-3-3 目标网络(Target Networks)
2-3-3-1 问题描述
- DDPG 使用两组网络
| 在线网络 | 目标网络 |
|---|---|
| Actor: μ ( s ) \mu(s) μ(s) | Target Actor: μ ′ ( s ) \mu'(s) μ′(s) |
| Critic: Q ( s , a ) Q(s,a) Q(s,a) | Target Critic: Q ′ ( s , a ) Q'(s,a) Q′(s,a) |
- 训练 Critic 时,利用目标网络计算 TD 目标即当前动作的目标价值 = 即时奖励 + 折扣后的未来价值 y = r + γ ( 1 − d ) Q ′ ( s ′ , μ ′ ( s ′ ) ) y=r+\gamma(1-d)Q' \left(s',\mu'(s')\right) y=r+γ(1−d)Q′(s′,μ′(s′))其中:
- γ \gamma γ:折扣因子,控制未来奖励的重要程度。
- d d d:终止标志,当回合终止时, d = 1 d=1 d=1,未来价值项归零
- 然后最小化在线 Critic 的损失 L ( θ Q ) = E ( Q ( s , a ) − y ) 2 L(\theta^Q)=\mathbb{E}\left(Q(s,a)-y)\^2\\right L(θQ)=E(Q(s,a)−y)2
- 这引出了一个问题:神经网络在预测价值的同时,又利用已有的价值估计构造学习目标。这就是 TD 自举(Temporal-Difference Bootstrapping)的核心思想。
- TD 自举是指:利用后续状态的价值估计来构造当前的学习目标,从而更新当前状态或状态---动作对的价值估计,而不必等待整个回合结束后再获得完整回报。
- 在 DDPG 中,如果直接使用在线 Critic 计算 TD 目标,那么 Critic 的参数更新不仅会改变当前的价值预测,也会影响后续用于构造学习目标的价值估计,使学习目标随训练过程不断变化。
说人话:就像你一边写卷子,一边修改参考答案。你刚根据参考答案改好一道题,参考答案本身却又变了,导致你很难按照一个稳定的标准检查和纠正自己的错误。
- 为了缓解这种目标变化带来的不稳定性,DDPG 引入目标网络,使用更新较为缓慢的目标 Critic 计算 TD 目标,从而降低学习目标的变化速度。
2-3-3-2 目标网络引入的真正原因
- 这里需要尤其注意的一点是,目标网络的不是因为"有 TD 自举"才必然需要,而是特定算法为了稳定价值学习而采用的设计。DDPG 的离策略数据复用、函数逼近与自举共同增加了稳定性挑战,因此采用目标网络来减缓 TD 目标的变化。
- 我们结合我们正确学习过的几个在策略的网络来类比一下:
- PPO: 同样可以使用 TD 自举,例如通过 GAE 计算优势函数。但 PPO 通常使用当前策略采集一批数据,再基于这批数据进行有限轮更新,之后重新采样。它通常不需要为 Critic 额外维护一套独立的目标网络。
- A2C: 同样可以使用 TD 自举,但通常直接利用采样数据和当前价值网络计算学习目标,不依赖经验回放池反复复用历史数据,因此标准实现通常也不需要独立的目标 Critic。
- 这并不意味着在策略算法不存在训练不稳定性,而是它们的数据使用方式和学习目标构造方式有所不同。相比之下,DDPG 可以反复使用由不同历史策略产生的数据,且 Critic 的价值估计又参与构造后续的 TD 目标,因此需要特别关注目标值随网络更新而变化的问题。
2-3-3-3 软更新
- 目标网络采用软更新,而不是像 DQN 的经典实现那样每隔一段时间硬更新 θ ′ ← τ θ + ( 1 − τ ) θ ′ \theta' \leftarrow \tau\theta+(1-\tau)\theta' θ′←τθ+(1−τ)θ′其中:
- θ \theta θ:在线网络的参数。
- θ ′ \theta' θ′:目标网络的参数。
- τ \tau τ:软更新系数,用于控制软更新的幅度, τ \tau τ 越小,目标网络跟随在线网络的速度越慢,滞后越明显; τ \tau τ 越大,跟随速度越快。通常取较小的值,例如 0.005 0.005 0.005。
- 软更新与硬更新的主要区别在于目标网络参数的更新频率和变化幅度 :
- 硬更新(Hard Update): 每隔固定步数,将在线网络的参数完整复制给目标网络。在两次更新之间,目标网络参数保持不变,因此参数变化呈阶梯式。
- 软更新(Soft Update): 每次更新时,都会更新目标网络的全部对应参数,但每个参数只向在线网络对应参数靠近一小步。目标网络因此能够缓慢跟随在线网络的变化。
- 注意,是在线网络全部参数的 τ \tau τ 倍,不是只挑一部分参数来更新。
说人话:硬更新是隔一段时间把在线网络的全部参数直接复制过去;软更新则是每次都调整全部对应参数,但每个参数只靠近在线参数的一小步,让目标网络慢慢跟上在线网络。
- SB3 里软更新就是一次不做自动求导的原地位移
python
# stable_baselines3/common/utils.py
def polyak_update(params, target_params, tau: float) -> None:
    with th.no_grad():        # 不建计算图:目标网络永远不接收梯度
        for param, target_param in zip(params, target_params, strict=True):
            target_param.data.mul_(1 - tau)                                  # 目标参数乘以 (1 - tau)
th.add(target_param.data, param.data, alpha=tau, out=target_param.data) # 再加上 tau 倍的在线参数- 这段实现全部是原地位运算,既不建图也不产生中间张量,所以开销很小,可以每一步都做
- 目标网络的调用点与 Actor 更新写在训练循环的同一个位置,两者同时发生,相对顺序在 2-5 小节的更新代码里能直接看到
2-3-4 探索噪声(Exploration Noise)
- 由于 Actor 输出的是确定性动作,如果不额外添加探索机制,同一个状态通常会得到相同动作,难以主动探索其他可能性
- 因此,DDPG 在训练阶段给 Actor 输出的动作添加噪声
a t = μ ( s t ∣ θ μ ) + ϵ t a_t=\mu(s_t\mid\theta^\mu)+\epsilon_t at=μ(st∣θμ)+ϵt
- 其中, ϵ t \epsilon_t ϵt 是探索噪声,可以使用高斯噪声,也可以使用原始 DDPG 论文中采用的 Ornstein-Uhlenbeck(OU)噪声
- Ornstein--Uhlenbeck(OU)噪声,中文通常称为奥恩斯坦--乌伦贝克噪声,是一种具有时间相关性的随机噪声。
- 需要注意:噪声主要用于与环境交互时探索,不是 Actor 本身输出随机策略
- 这句话很容易被忽略,落到代码上却是两件完全不同的事
- 加噪发生在与环境交互这一步,带噪动作进了经验池,但 Actor 网络本身没有任何改动
- 评估的时候把噪声关掉,Actor 输出的仍然是那个确定性动作
- 换句话说,随机性只存在于行为策略里,目标策略始终是确定的。这与 SAC 把随机性写进策略本身是两条路
- SB3 里噪声是构造模型时传入的一个对象,交互时叠加到动作上
python
from stable_baselines3 import DDPG
from stable_baselines3.common.noise import OrnsteinUhlenbeckActionNoise
import numpy as np

# 论文用的 OU 噪声:在随机游走之外加了一项向均值回归的拉力
action_noise = OrnsteinUhlenbeckActionNoise(mean=np.zeros(1), sigma=0.1 * np.ones(1))
model = DDPG("MlpPolicy", env, action_noise=action_noise)- 噪声施加的位置在交互函数里:动作先被缩放到 − 1 , 1 -1,1 −1,1,再叠噪声,最后一起裁剪
python
# stable_baselines3/common/off_policy_algorithm.py
scaled_action = self.policy.scale_action(unscaled_action)

# Add noise to the action (improve exploration)
if action_noise is not None:
scaled_action = np.clip(scaled_action + action_noise(), -1, 1)- 注意
action_noise的默认值是None。不加噪声的 DDPG 只靠随机初始化和池子里的历史样本探索,在简单环境上仍能训起来,但在探索困难的任务上会明显吃力
2-4 损失计算
- 2-3 讲了四块积木各自解决什么问题,但要让网络真正动起来,还得把这些说法翻译成可求导的目标函数,这一步就是损失
- DDPG 需要更新的网络有两个:Critic 与 Actor,两者的损失性质不同:前者是有标签的回归,后者没有标签可用。下面把两条损失分开看
2-4-1 Critic 损失(Critic Loss)
- Critic 要估计动作价值,学习目标就是把 2-3-3 小节算出的那个值当成标签去拟合
y = r + γ ( 1 − d ) Q ′ ( s ′ , μ ′ ( s ′ ∣ θ μ ′ ) ∣ θ Q ′ ) y = r + \gamma (1-d)\, Q'\left(s', \mu'(s'|\theta^{\mu'}) \mid \theta^{Q'}\right) y=r+γ(1−d)Q′(s′,μ′(s′∣θμ′)∣θQ′)
- 损失就是预测值与这个标签之间的均方误差
L ( θ Q ) = E ( s , a , r , s ′ , d ) ∼ D ( Q ( s , a ∣ θ Q ) − y ) 2 L(\theta^{Q}) = \mathbb E_{(s,a,r,s',d)\sim \mathcal D} \left \\left( Q(s,a\|\\theta\^{Q}) - y \\right)\^2 \\right L(θQ)=E(s,a,r,s′,d)∼D(Q(s,a∣θQ)−y)2
- 这个损失里有三点值得说明
- 标签 y y y 里的 μ ′ \mu' μ′ 与 Q ′ Q' Q′ 都取自目标网络,不是在线网络自己的输出。这是 2-3-3 小节引入目标网络的落点:标签在一次更新之内是固定的
- ( 1 − d ) (1-d) (1−d) 让回合结束时标签只剩即时奖励,不再往后看, d d d 就是存池时写进去的
dones - 期望由经验池里随机抽出的一个 batch 做无偏估计,不必遍历状态空间,这是 2-3-2 小节经验回放带来的便利
说人话:Critic 的损失就是一个普通的回归,标签是"这一步实际拿到多少奖励,再按目标网络估一下之后还能拿多少"
- 把这段更新完整写出来是下面这样,从抽 batch 一直走到优化器更新完参数
python
# DDPG 训练循环里的 Critic 更新
replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)
discounts = replay_data.discounts if replay_data.discounts is not None else self.gamma

with th.no_grad():                       # 标签的计算不建计算图
    next_actions = self.actor_target(replay_data.next_observations)
    next_q_values = self.critic_target(replay_data.next_observations, next_actions)[0]
    target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values

current_q_values = self.critic(replay_data.observations, replay_data.actions)[0]
critic_loss = F.mse_loss(current_q_values, target_q_values)

self.critic.optimizer.zero_grad()
critic_loss.backward()
self.critic.optimizer.step()- 逐行对照
- 前两行从经验池里随机抽一个 batch,顺便取出折扣因子。
discounts在多数设置下取不到,于是回落到self.gamma with th.no_grad()罩住的是标签的整段计算:目标 Actor 给出下一状态的动作,目标 Critic 给它打分,再叠上即时奖励,得到上面的 y y yself.critic_target(...)返回的是元组,DDPG 里这个元组只有一项,取下标[0]就是对动作价值的估计current_q_values是在线 Critic 对池子里那些真实动作的估计,F.mse_loss算出它与标签之间的均方误差- 末尾三行是标准的三件套:清梯度、反向传播、更新参数。被更新的只有在线的那个 Critic
- 前两行从经验池里随机抽一个 batch,顺便取出折扣因子。
2-4-2 Actor 损失(Actor Loss)
- Actor 这边没有标签可用。它的目标是让自己输出的动作在 Critic 眼里尽量值钱,所以直接把 Critic 当成目标函数
J ( θ μ ) = E s ∼ D Q ( s , μ ( s ∣ θ μ ) ∣ θ Q ) J(\theta^{\mu}) = \mathbb E_{s\sim\mathcal D}\left Q\\left(s, \\mu(s\|\\theta\^{\\mu}) \\mid \\theta\^{Q}\\right) \\right J(θμ)=Es∼DQ(s,μ(s∣θμ)∣θQ)
- 优化器只会最小化,实际写进代码的是它的相反数
L ( θ μ ) = − E s ∼ D Q ( s , μ ( s ∣ θ μ ) ∣ θ Q ) L(\theta^{\mu}) = -\, \mathbb E_{s\sim\mathcal D}\left Q\\left(s, \\mu(s\|\\theta\^{\\mu}) \\mid \\theta\^{Q}\\right) \\right L(θμ)=−Es∼DQ(s,μ(s∣θμ)∣θQ)
- 把它对参数求导,用链式法则展开,得到的就是 2-3-1 小节那条确定性策略梯度
∇ θ μ J ≈ E s ∼ D ∇ a Q ( s , a ∣ θ Q ) ∣ a = μ ( s ) ⋅ ∇ θ μ μ ( s ∣ θ μ ) \nabla_{\theta^{\mu}} J \approx \mathbb E_{s\sim\mathcal D}\left \\nabla_a Q(s,a\|\\theta\^{Q})\\big\|_{a=\\mu(s)} \\cdot \\nabla_{\\theta\^{\\mu}} \\mu(s\|\\theta\^{\\mu}) \\right ∇θμJ≈Es∼D∇aQ(s,a∣θQ) a=μ(s)⋅∇θμμ(s∣θμ)
- 这条式子把两个网络的分工写清楚了
- ∇ a Q \nabla_a Q ∇aQ 由 Critic 提供,回答"动作往哪个方向改会更值钱"
- ∇ θ μ μ \nabla_{\theta^{\mu}}\mu ∇θμμ 由 Actor 自己提供,回答"参数往哪个方向改才能让动作朝那个方向走"
- Actor 只负责第二项,第一项对它来说是外部信号,它没有办法自己判断哪个动作好
- 一个容易忽略的细节:这份梯度必须穿过 Critic 的网络才能到达 Actor,但这一步被更新的只有 Actor 的参数。Critic 在这里的角色是给出梯度,不是被训练
- 把这段更新完整写出来是下面这样
python
# DDPG 训练循环里的 Actor 更新
replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)

actor_loss = -self.critic.q1_forward(
    replay_data.observations, self.actor(replay_data.observations)
).mean()

self.actor.optimizer.zero_grad()
actor_loss.backward()
self.actor.optimizer.step()- 逐个部分对照
self.actor(...)给出 Actor 当前的动作,q1_forward让 Critic 给它打分,得到的就是上面那个 Q ( s , μ ( s ) ) Q(s,\mu(s)) Q(s,μ(s))- 前面的负号把"最大化打分"换成"最小化负打分",
.mean()对应式子里的期望 - 末尾三行只更新 Actor 的参数。梯度虽然要穿过 Critic 才能到达 Actor,但 Critic 的权重在这一步不动
- 两条损失不能合并成一次反向传播,它们的优化对象与输入都不同:Critic 用真实发生过的动作当输入,Actor 用自己的输出当输入,在 2-5 小节的流程里各自走一遍独立的梯度更新
核心观点:两条损失对应两种学习方式,Critic 用目标值做监督回归,Actor 用 Critic 的梯度做没有标签的爬山。前者决定价值估得准不准,后者决定动作改得对不对
2-5 训练流程
2-5-1 全流程
#mermaid-svg-lm0Q5zroh6N5GmE2{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-lm0Q5zroh6N5GmE2 .error-icon{fill:#552222;}#mermaid-svg-lm0Q5zroh6N5GmE2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-lm0Q5zroh6N5GmE2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .marker.cross{stroke:#333333;}#mermaid-svg-lm0Q5zroh6N5GmE2 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-lm0Q5zroh6N5GmE2 p{margin:0;}#mermaid-svg-lm0Q5zroh6N5GmE2 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster-label text{fill:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster-label span{color:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster-label span p{background-color:transparent;}#mermaid-svg-lm0Q5zroh6N5GmE2 .label text,#mermaid-svg-lm0Q5zroh6N5GmE2 span{fill:#333;color:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .node rect,#mermaid-svg-lm0Q5zroh6N5GmE2 .node circle,#mermaid-svg-lm0Q5zroh6N5GmE2 .node ellipse,#mermaid-svg-lm0Q5zroh6N5GmE2 .node polygon,#mermaid-svg-lm0Q5zroh6N5GmE2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .rough-node .label text,#mermaid-svg-lm0Q5zroh6N5GmE2 .node .label text,#mermaid-svg-lm0Q5zroh6N5GmE2 .image-shape .label,#mermaid-svg-lm0Q5zroh6N5GmE2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-lm0Q5zroh6N5GmE2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .rough-node .label,#mermaid-svg-lm0Q5zroh6N5GmE2 .node .label,#mermaid-svg-lm0Q5zroh6N5GmE2 .image-shape .label,#mermaid-svg-lm0Q5zroh6N5GmE2 .icon-shape .label{text-align:center;}#mermaid-svg-lm0Q5zroh6N5GmE2 .node.clickable{cursor:pointer;}#mermaid-svg-lm0Q5zroh6N5GmE2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .arrowheadPath{fill:#333333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-lm0Q5zroh6N5GmE2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-lm0Q5zroh6N5GmE2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-lm0Q5zroh6N5GmE2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster text{fill:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 .cluster span{color:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-lm0Q5zroh6N5GmE2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-lm0Q5zroh6N5GmE2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-lm0Q5zroh6N5GmE2 .icon-shape,#mermaid-svg-lm0Q5zroh6N5GmE2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-lm0Q5zroh6N5GmE2 .icon-shape p,#mermaid-svg-lm0Q5zroh6N5GmE2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-lm0Q5zroh6N5GmE2 .icon-shape .label rect,#mermaid-svg-lm0Q5zroh6N5GmE2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-lm0Q5zroh6N5GmE2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-lm0Q5zroh6N5GmE2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-lm0Q5zroh6N5GmE2 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 1. 交互采样
Actor 根据当前状态选择动作
2. 存入经验池
保存 (s, a, r, s')
3. 随机抽取 Batch
从经验回放池采样一批经验
4. 更新 Critic
计算 TD 目标与 Critic Loss,更新 Critic 参数
5. 更新 Actor
利用 Critic 提供的梯度更新 Actor 参数
6. 软更新目标网络
缓慢更新目标 Actor 和目标 Critic 参数
- 把 2-3 的四块拼起来,DDPG 的一轮训练就是六步:交互采样、存入经验池、随机抽 batch、更新 Critic、更新 Actor、软更新目标网络
- 这六步的源码分在两个地方,先把这个分界说清楚,后面读起来会顺很多
- 采样与存池是前两步,所有离策略算法共用,SB3 把它们放在公共基类
OffPolicyAlgorithm里,换成别的算法也是同一段代码 - 更新是后四步,属于算法自身的实现,也是三代算法之间真正不同的那部分。这两块本章都会给出来
- 采样与存池是前两步,所有离策略算法共用,SB3 把它们放在公共基类
2-5-2 采样动作:预热与探索噪声
- 先看采样这一步。训练初期通常会有一段预热期(Warm-up),随后才主要使用 Actor 产生动作,并叠加探索噪声。
python
# stable_baselines3/common/off_policy_algorithm.py
def _sample_action(self, learning_starts, action_noise=None, n_envs=1):
    # 预热期:前 learning_starts 步均匀随机采样,先把经验池铺开再开始学
    if self.num_timesteps < learning_starts:
        unscaled_action = np.array([self.action_space.sample() for _ in range(n_envs)])
    else:
        # 之后走 Actor 的输出,deterministic=False 表示保留策略自身的随机性
        unscaled_action, _ = self.predict(self._last_obs, deterministic=False)

    if isinstance(self.action_space, spaces.Box):
        scaled_action = self.policy.scale_action(unscaled_action)
        # 探索噪声加在这一步,2-3-4 小节讲的 OU 噪声就是传进来的这个 action_noise
        if action_noise is not None:
            scaled_action = np.clip(scaled_action + action_noise(), -1, 1)
        buffer_action = scaled_action                 # 池子里存的是缩放后的动作
        action = self.policy.unscale_action(scaled_action)
return action, buffer_action- 预热是指在训练初期,暂时不使用当前 Actor 生成动作,而是从动作空间中随机采样,让智能体先与环境交互,并积累一批初始经验。
- 这是因为训练刚开始时,Actor 和 Critic 的参数通常还没有经过有效学习。如果一开始就完全依赖当前策略采样,初始数据可能集中在有限的状态和动作范围内,不利于后续学习。
- 通过预热,经验池可以先积累一些相对多样化的样本,为后续的 Critic 和 Actor 更新提供数据基础。
- 预热结束后,算法使用 Actor 产生动作,并在动作缩放到 (-1,1) 的范围后叠加探索噪声。前面介绍的 OU 噪声就是一种可选的
action_noise。
python
scaled_action = np.clip(
    scaled_action + action_noise(), -1, 1
)
2-5-3 存池
- 采样交互后就是存池
- 存池本身只有一行,但它要处理回合边界:环境重置是自动发生的,
new_obs已经是下一回合的第一个观测,终止状态得从infos里单独取回来再存
python
# stable_baselines3/common/off_policy_algorithm.py
replay_buffer.add(
    self._last_original_obs,   # 状态 s
    next_obs,                  # 后继状态 s',回合边界已处理
    buffer_action,             # 动作 a,与池子里其余样本的存法一致
    reward_,                   # 奖励 r
    dones,                     # 终止标志 d
    infos,
)
2-5-4 随机抽取 Batch
-
完成环境交互和经验存储后,接下来从经验回放池中随机抽取一批历史经验,用于本轮梯度更新。
replay_buffer.sample():从经验回放池中随机抽取一批经验,包含状态、动作、奖励、下一状态等信息。
batch_size:本次梯度更新使用的样本数量。discounts:优先使用经验数据携带的折扣因子;如果没有,则使用默认折扣因子self.gamma。
python
# 第 3 步:随机抽取 Batch
replay_data = self.replay_buffer.sample(
    batch_size,
    env=self._vec_normalize_env
)

discounts = (
    replay_data.discounts
    if replay_data.discounts is not None
    else self.gamma
)- 需要注意,随机抽样并不能保证样本完全独立,也不意味着经验池中的每条样本在所有情况下都具有相同的被抽取概率;这里讨论的是 SB3 常规均匀经验回放的情况。
2-5-5 更新 Critic
- 抽取 Batch 后,首先更新 Critic。回顾 2-4-1 小节,Critic 通过最小化当前 Q 值与 TD 目标之间的均方误差来更新参数。这里重点看 SB3 如何将这一过程落实到代码中。
python
# 计算 TD 目标
with th.no_grad():
    next_actions = self.actor_target(
        replay_data.next_observations
    )
    next_q_values = self.critic_target(
        replay_data.next_observations,
        next_actions
    )[0]

    target_q_values = (
        replay_data.rewards
        + (1 - replay_data.dones)
        * discounts
        * next_q_values
    )

# 计算在线 Critic 的 Q 值与损失
current_q_values = self.critic(
    replay_data.observations,
    replay_data.actions
)[0]

critic_loss = F.mse_loss(
    current_q_values,
    target_q_values
)

# 更新在线 Critic
self.critic.optimizer.zero_grad()
critic_loss.backward()
self.critic.optimizer.step()- 逐行对照:
actor_target根据下一状态生成动作,critic_target对其进行价值估计,两者共同计算 TD 目标。th.no_grad()使目标值计算不记录梯度,目标网络不会通过这条计算路径被更新。current_q_values是在线 Critic 对经验池中状态和实际执行动作的价值估计。F.mse_loss()对应 2-4-1 小节介绍的 Critic Loss。
- 最后三行依次完成梯度清零、反向传播和优化器更新;本段更新的是在线 Critic。
2-5-6 更新 Actor
- Critic 更新完成后,接下来更新 Actor。回顾 2-4-2 小节,Actor 的目标是最大化当前策略所产生动作的 Q 值,因此源码使用负 Q 值作为需要最小化的损失。
python
actor_loss = -self.critic.q1_forward(
    replay_data.observations,
    self.actor(replay_data.observations)
).mean()

self.actor.optimizer.zero_grad()
actor_loss.backward()
self.actor.optimizer.step()- 逐行对照:
self.actor(replay_data.observations)根据经验池中的状态生成当前策略动作。self.critic.q1_forward(...)使用在线 Critic 评价这些动作,得到 (Q(s,\mu(s)))。- 负号将最大化 Q 值转换成最小化 Loss,
.mean()则对 Batch 中的 Q 值取平均。 actor_loss.backward()通过 Critic 的计算路径获得 Actor 的梯度,最终由 Actor 的优化器更新策略参数。
- 注意,这一步虽然需要经过 Critic 计算梯度,但更新的仍然是 Actor 参数,而不是 Critic 参数。
2-5-7 软更新目标网络
- 完成在线 Critic 和在线 Actor 的更新后,最后更新两个目标网络,让它们缓慢跟随对应的在线网络。
python
# 第 6 步:软更新目标网络
polyak_update(
    self.critic.parameters(),
    self.critic_target.parameters(),
    self.tau
)

polyak_update(
    self.actor.parameters(),
    self.actor_target.parameters(),
    self.tau
)- 这里分别更新目标 Critic 和目标 Actor。核心计算为 θ target ← ( 1 − τ ) θ target + τ θ online \theta_{\text{target}} \leftarrow(1-\tau)\theta_{\text{target}}+\tau\theta_{\text{online}} θtarget←(1−τ)θtarget+τθonline每次软更新都会调整目标网络的全部对应参数,但每个参数只向在线网络对应参数靠近一小步。
2-6 缺陷与不足
- 单个 Critic 容易高估
- Critic 通过自举(Bootstrapping)构造学习目标,目标值中又包含自身的估计,估计误差可能不断累积。
- Actor 根据 Critic 的梯度更新,会主动选择那些被高估的动作,导致价值看似很高,实际策略却没有变好。
- Critic 容易产生虚假的高价值
- Critic 是函数逼近器,而训练数据只覆盖状态---动作空间的一小部分,因此在未充分探索的动作附近,可能产生不合理的高值尖峰。
- Actor 会把这些尖峰当成真实的高价值,主动向其靠近,导致策略退化。
- Actor 更新过于频繁
- DDPG 每次更新 Critic 后都会更新 Actor,但训练早期 Critic 的估计往往还不稳定。
- Actor 不断追逐 Critic 波动的估计,两个网络容易相互追赶,导致训练不稳定,也使算法对学习率和软更新系数较为敏感。
- 探索依赖人工设置的噪声
- 噪声难以控制:噪声太小可能探索不足,太大又可能导致动作偏离有效策略。
- 随机性来自外部噪声,而不是策略本身:DDPG 的 Actor 输出确定性动作,OU 噪声只是额外叠加的扰动,Actor 并没有直接学习一个随机动作分布。
- 前三点分别引出了 TD3 的三项核心改进,第四点则是 DDPG 探索机制的局限。下一章将重点介绍 TD3 如何解决前三类问题。
3 TD3
3-1 介绍
#mermaid-svg-7GJHo4twZ3eLR7Er{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-7GJHo4twZ3eLR7Er .error-icon{fill:#552222;}#mermaid-svg-7GJHo4twZ3eLR7Er .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-7GJHo4twZ3eLR7Er .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-7GJHo4twZ3eLR7Er .marker{fill:#333333;stroke:#333333;}#mermaid-svg-7GJHo4twZ3eLR7Er .marker.cross{stroke:#333333;}#mermaid-svg-7GJHo4twZ3eLR7Er svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-7GJHo4twZ3eLR7Er p{margin:0;}#mermaid-svg-7GJHo4twZ3eLR7Er .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster-label text{fill:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster-label span{color:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster-label span p{background-color:transparent;}#mermaid-svg-7GJHo4twZ3eLR7Er .label text,#mermaid-svg-7GJHo4twZ3eLR7Er span{fill:#333;color:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er .node rect,#mermaid-svg-7GJHo4twZ3eLR7Er .node circle,#mermaid-svg-7GJHo4twZ3eLR7Er .node ellipse,#mermaid-svg-7GJHo4twZ3eLR7Er .node polygon,#mermaid-svg-7GJHo4twZ3eLR7Er .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-7GJHo4twZ3eLR7Er .rough-node .label text,#mermaid-svg-7GJHo4twZ3eLR7Er .node .label text,#mermaid-svg-7GJHo4twZ3eLR7Er .image-shape .label,#mermaid-svg-7GJHo4twZ3eLR7Er .icon-shape .label{text-anchor:middle;}#mermaid-svg-7GJHo4twZ3eLR7Er .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-7GJHo4twZ3eLR7Er .rough-node .label,#mermaid-svg-7GJHo4twZ3eLR7Er .node .label,#mermaid-svg-7GJHo4twZ3eLR7Er .image-shape .label,#mermaid-svg-7GJHo4twZ3eLR7Er .icon-shape .label{text-align:center;}#mermaid-svg-7GJHo4twZ3eLR7Er .node.clickable{cursor:pointer;}#mermaid-svg-7GJHo4twZ3eLR7Er .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-7GJHo4twZ3eLR7Er .arrowheadPath{fill:#333333;}#mermaid-svg-7GJHo4twZ3eLR7Er .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-7GJHo4twZ3eLR7Er .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-7GJHo4twZ3eLR7Er .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-7GJHo4twZ3eLR7Er .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-7GJHo4twZ3eLR7Er .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-7GJHo4twZ3eLR7Er .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster text{fill:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er .cluster span{color:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-7GJHo4twZ3eLR7Er .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-7GJHo4twZ3eLR7Er rect.text{fill:none;stroke-width:0;}#mermaid-svg-7GJHo4twZ3eLR7Er .icon-shape,#mermaid-svg-7GJHo4twZ3eLR7Er .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-7GJHo4twZ3eLR7Er .icon-shape p,#mermaid-svg-7GJHo4twZ3eLR7Er .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-7GJHo4twZ3eLR7Er .icon-shape .label rect,#mermaid-svg-7GJHo4twZ3eLR7Er .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-7GJHo4twZ3eLR7Er .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-7GJHo4twZ3eLR7Er .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-7GJHo4twZ3eLR7Er :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 梯度更新
梯度更新
延迟提供策略梯度
延迟软更新
软更新
软更新
状态 s
Actor 在线网络
动作 a
Critic 1 在线网络
Critic 2 在线网络
下一状态 s'
Actor 目标网络
添加平滑噪声并裁剪
目标动作 a'
Critic 1 目标网络
Critic 2 目标网络
取两个 Q 值的最小值
奖励 r
TD 目标值 y
终止标志 d
Critic 1 损失
Critic 2 损失
- TD3(Twin Delayed DDPG,双延迟深度确定性策略梯度)出自 2018 年的论文 "Addressing Function Approximation Error in Actor-Critic Methods",作者是 Fujimoto 等人
- 它的定位非常明确:不推翻 DDPG,而是针对 2-6 小节列出的三条不足各给一个修正
- 论文的对比实验是刻意设计过的:TD3 与 DDPG 使用完全相同的网络结构、相同的超参、相同的评估方式,唯一的差别就是那三项改动。这样实验里出现的性能差才能干净地归因到算法本身,而不是归因到网络更大或者调参更细
- 三项改动分别对应
- 截断双 Q 学习:给价值估计的高估加一个上界
- 目标策略平滑:把 Critic 在动作方向上的尖峰抹平
- 延迟策略更新:让 Critic 先学好,Actor 再跟上
- 需要注意,TD3 仍然是确定性策略算法,它没有改 Actor 的输出形式,三项改动全部作用在 Critic 的估计方式与更新节奏上
说人话:TD3 没有换零件,只是在 DDPG 的引擎上装了三道保险,分别针对价值高估、动作尖峰、更新过频
3-2 整体架构
- 与 DDPG 相比,网络数量从四个增加到六个
| 网络 | DDPG | TD3 |
|---|---|---|
| Actor | 1 个在线 + 1 个目标 | 1 个在线 + 1 个目标 |
| Critic | 1 个在线 + 1 个目标 | 2 个在线 + 2 个目标 |
- 多出来的两个网络就是截断双 Q 的载体,两个 Critic 独立初始化、独立训练,只在算目标值时被合并成一项
- 更新节奏也变了:Critic 每一步都更新,Actor 与目标网络每两步才更新一次,这就是延迟
- 在 SB3 的类结构里,这两处差异都落在
TD3Policy上:Critic 的个数由n_critics决定,延迟由policy_delay决定
python
# stable_baselines3/common/policies.py
class ContinuousCritic(BaseModel):
    """Critic network(s) for DDPG/SAC/TD3."""
    def __init__(self, observation_space, action_space, net_arch, features_extractor,
                 features_dim, activation_fn=nn.ReLU, normalize_images=True,
                 n_critics: int = 2, share_features_extractor: bool = True):
        ...
        self.n_critics = n_critics
        self.q_networks: list[nn.Module] = []
        for idx in range(n_critics):        # 独立初始化若干个 Q 网络
            q_net_list = create_mlp(features_dim + action_dim, 1, net_arch, activation_fn)
            q_net = nn.Sequential(*q_net_list)
            self.add_module(f"qf{idx}", q_net)
            self.q_networks.append(q_net)

    def forward(self, obs, actions) -> tuple[th.Tensor, ...]:
        features = self.extract_features(obs, self.features_extractor)
        qvalue_input = th.cat([features, actions], dim=1)      # 状态与动作拼接后送进网络
return tuple(q_net(qvalue_input) for q_net in self.q_networks) # 每个网络各给一个 Q- 有两个细节值得留意
n_critics的默认值就是 2,所以 TD3 什么都不用传已经是双 Q,而 DDPG 是在构造函数里显式把它改成 1 的,见 3-5 小节- Critic 的输入是状态与动作的拼接,这一点与只吃状态的 V 网络不同,Q 网络必须同时看到动作,才知道这个动作值多少分
说人话:DDPG 只请了一个裁判,他说多少就是多少,TD3 请了两个裁判,算分时取低的那个,宁可少给也不多给
3-3 核心思想
3-3-1 Clipped Double Q-Learning(截断双 Q 学习)
-
解决的问题:Critic 对 Q 值的过高估计
- DDPG 只有一个 Critic,如果它高估了某些动作的价值,Actor 就会倾向于选择这些被高估的动作。随着 Actor 不断优化策略,这种误差可能进一步累积
-
TD3 使用两个独立的 Critic,分别估计动作价值 Q θ 1 ( s , a ) , Q θ 2 ( s , a ) Q_{\theta_1}(s,a),\qquad Q_{\theta_2}(s,a) Qθ1(s,a),Qθ2(s,a)
-
计算 TD 目标时,取两个目标 Critic 估计值中的较小值 y = r + γ ( 1 − d ) min i = 1 , 2 Q θ i ′ ( s ′ , a ′ ) y=r+\gamma(1-d) \min_{i=1,2}Q_{\theta_i'}(s',a') y=r+γ(1−d)i=1,2minQθi′(s′,a′)其中 a ′ = μ ϕ ′ ( s ′ ) + ϵ a'=\mu_{\phi'}(s')+\epsilon a′=μϕ′(s′)+ϵ这里的 ϵ \epsilon ϵ 来自目标策略平滑机制,下一小节会解释
-
取最小值能够抑制过高估计,但也可能引入一定的低估偏差。它的目的不是让 Q 值永远准确,而是降低过估计对策略学习造成的负面影响
- 这份取舍是有意为之的:
- 高估会让 Actor 主动去追那些虚高的动作,属于正反馈,会直接毁掉策略;
- 低估只是让 Actor 变得保守,在时序差分学习里通常还能自己修正回来。两害相权取其轻
- 这份取舍是有意为之的:
-
一个容易问的问题是:为什么不用 min \min min 的结果去更新 Actor,而要单独用第一个 Critic。
- 答案是如果 Actor 追的是两个 Critic 的最小值,那么只要其中一个低估,Actor 就会被它拖住,动作的改进方向会被无谓地削掉。
- TD3 论文里保留第一个 Critic 给 Actor 提供梯度,正是为了不把这个保守偏差带进策略梯度
说人话:取两个 Critic 的最小值计算 TD 目标,是为了降低 Q 值高估的风险;而更新 Actor 时固定使用第一个 Critic,是为了避免较小的 Q 值直接主导策略梯度,减少 Critic 低估对动作优化方向的干扰。
- 落到代码上,截断双 Q 就是一行取最小值
python
# stable_baselines3/td3/td3.py
# Compute the next Q-values: min over all critics targets
next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_valuesself.critic_target(...)返回的是一个元组,每个元素形如(batch, 1),th.cat把它们拼成(batch, n_critics),th.min再沿这一维取最小值,得到(batch, 1)。取最小值之后接的是keepdim=True,形状与后面的奖励张量对齐,广播时才不会出错
说人话:两个裁判各自打分,取低的那一份当成绩。分数被压低了,Actor 就不会为了虚高的分数去冒险
3-3-2 Target Policy Smoothing(目标策略平滑)
-
解决的问题:Critic 对动作价值的估计过于尖锐
- 假设 Critic 错误地认为某个特定动作具有特别高的 Q 值,Actor 就可能不断朝这个局部高值优化,即使这个高值只是估计误差
-
TD3 在计算目标 Q 值时,对目标 Actor 输出的动作添加截断噪声 a ~ ′ = clip ( μ ϕ ′ ( s ′ ) + clip ( ϵ , − c , c ) , a min , a max ) \tilde a'= \operatorname{clip} \left( \mu_{\phi'}(s')+ \operatorname{clip}(\epsilon,-c,c), a_{\min},a_{\max} \right) a~′=clip(μϕ′(s′)+clip(ϵ,−c,c),amin,amax)其中:
- a ~ ′ \tilde a' a~′:添加噪声并裁剪后得到的目标动作。
- μ ϕ ′ \mu_{\phi'} μϕ′:Actor 目标网络。
- ϕ ′ \phi' ϕ′:Actor 目标网络的参数。
- s ′ s' s′:下一状态。
- ϵ \epsilon ϵ:从高斯分布中采样的随机噪声。 ϵ ∼ N ( 0 , σ 2 ) \epsilon\sim\mathcal N(0,\sigma^2) ϵ∼N(0,σ2)
- c c c:噪声裁剪阈值,用于限制噪声的幅度。
- clip ( ϵ , − c , c ) \operatorname{clip}(\epsilon,-c,c) clip(ϵ,−c,c):将噪声限制在 − c , c -c,c −c,c 范围内。
- a min a_{\min} amin:动作空间允许的最小值。
- a max a_{\max} amax:动作空间允许的最大值。
-
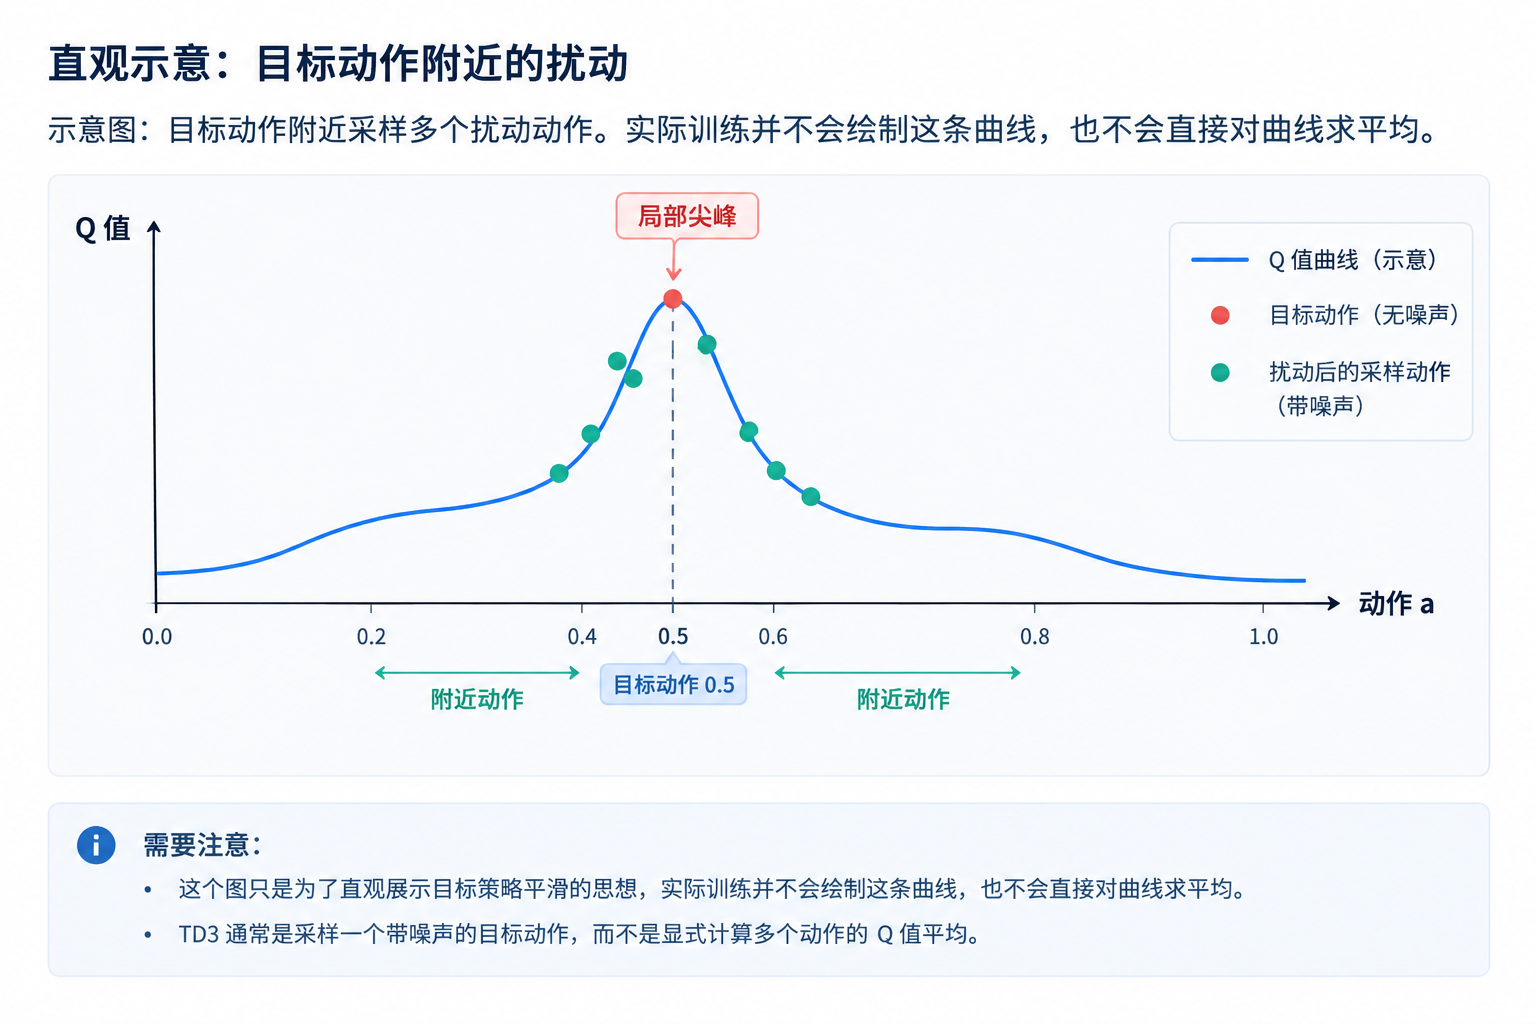
这样做可以让目标价值不再过度依赖某个精确动作点,而是对附近动作具有一定的鲁棒性
-
注意,这里的噪声与 DDPG 的探索噪声不同
- DDPG 探索噪声:用于和环境交互,探索不同动作
- TD3 目标策略平滑噪声:用于构造 Critic 的 TD 学习目标,缓解价值估计中的尖锐峰值
也就是说TD3 的 Target Policy Smoothing 噪声只用于计算 TD 目标(进而计算 TD Error),不用于与环境交互。
- 两层
clip干的不是同一件事,代码里能看得很清楚
python
# stable_baselines3/td3/td3.py
# Select action according to policy and add clipped noise
noise = replay_data.actions.clone().data.normal_(0, self.target_policy_noise)
noise = noise.clamp(-self.target_noise_clip, self.target_noise_clip)
next_actions = (self.actor_target(replay_data.next_observations) + noise).clamp(-1, 1)- 内层
clamp(-c, c):将噪声限制在 − c , c -c,c −c,c 内,c对应target_noise_clip,默认值为 0.5。
- 外层
clamp(-1, 1):将加噪后的动作限制在合法的缩放动作范围内。 - 噪声生成 :
replay_data.actions.clone().normal_()借用已有张量的形状生成噪声,原有动作值会被覆盖,不参与计算。 - 两个参数的区别 :
target_policy_noise默认值为 0.2,决定高斯噪声的标准差 σ \sigma σ;target_noise_clip默认值为 0.5,限制噪声的最大幅度。
说人话:原来只盯着"这个精确动作值多少分",现在改成问"这个动作附近一小圈大概值多少分",一个孤立的假高分就被邻居拉平了
3-3-3 Delayed Policy Updates(延迟策略更新)
-
解决的问题:Actor 更新过于频繁,容易受到 Critic 估计误差的影响
- DDPG 通常在每次 Critic 更新时,也更新 Actor。可是,Critic 本身还没有充分学好,Actor 就频繁追逐当前估计出的高价值动作,容易导致训练不稳定
-
TD3 采取延迟更新策略
- 每次训练迭代都更新两个 Critic
- 每隔 d d d 次 Critic 更新,才更新一次 Actor
- Actor 更新时,再同步软更新对应的目标网络
-
Actor 的优化目标仍然是最大化 Critic 估计的 Q 值 J ( ϕ ) = E s Q θ 1 ( s , μ ϕ ( s ) ) J(\phi)= \mathbb E_s \left Q_{\\theta_1}(s,\\mu_\\phi(s)) \\right J(ϕ)=EsQθ1(s,μϕ(s))
-
实际实现通常使用第一个在线 Critic 来计算 Actor 的策略梯度,而不是对两个 Critic 的输出取最小值后再更新 Actor
- 这样 Critic 就有更多机会修正自身的估计误差,Actor 也不必对每一次价值波动都做出响应
-
代码上就是那个取模判断
python
# stable_baselines3/td3/td3.py
# Delayed policy updates
if self._n_updates % self.policy_delay == 0:
    # Compute actor loss
    actor_loss = -self.critic.q1_forward(
        replay_data.observations, self.actor(replay_data.observations)
    ).mean()

    # Optimize the actor
    self.actor.optimizer.zero_grad()
    actor_loss.backward()
    self.actor.optimizer.step()

    polyak_update(self.critic.parameters(), self.critic_target.parameters(), self.tau)
polyak_update(self.actor.parameters(), self.actor_target.parameters(), self.tau)self._n_updates统计的是 Critic 已经更新过多少次,policy_delay的默认值是 2,所以这个分支每两次迭代进入一次- 注意最后两行
polyak_update也在这个分支内部,也就是说目标网络的更新与 Actor 绑在一起,一起被延迟。这是设计的一部分:Critic 每一步都在变,但它的目标网络慢一拍,Actor 与 Actor 的目标网络更是慢两拍,三层参数的变化速度形成一个梯度,最不稳定的那一环被压得最慢
核心观点:延迟更新不是为了让训练更快,而是为了让 Actor 追赶的目标先稳定下来。Critic 每步都学,Actor 隔一步再学,追上的是一个已经收敛了一点的信号
3-4 损失计算
- 3-3 的三项改动分别落在学习目标的三个位置上,合起来就是 TD3 的两条损失。与 2-4 小节相比,Critic 那条的标签换了算法,Actor 那条的式子一字未改
3-4-1 Critic 损失(Critic Loss)
-
Critic 的标签比 DDPG 多了两步加工:目标动作先加截断噪声,再由两个目标 Critic 分别打分取较小值 a ~ ′ = clip ( μ ϕ ′ ( s ′ ) + clip ( ϵ , − c , c ) , a min , a max ) \tilde a' = \operatorname{clip}\left( \mu_{\phi'}(s') + \operatorname{clip}(\epsilon,-c,c),\ a_{\min}, a_{\max} \right) a~′=clip(μϕ′(s′)+clip(ϵ,−c,c), amin,amax) y = r + γ ( 1 − d ) min i = 1 , 2 Q θ i ′ ( s ′ , a ~ ′ ) y = r + \gamma(1-d) \min_{i=1,2} Q_{\theta_i'}(s', \tilde a') y=r+γ(1−d)i=1,2minQθi′(s′,a~′)
-
损失形式仍是均方误差,只是要对两个在线 Critic 各算一份,再相加 L ( θ i ) = E ( s , a , r , s ′ , d ) ∼ D ( Q θ i ( s , a ) − y ) 2 L(\theta_i) = \mathbb E_{(s,a,r,s',d)\sim\mathcal D}\left \\left( Q_{\\theta_i}(s,a) - y \\right)\^2 \\right L(θi)=E(s,a,r,s′,d)∼D(Qθi(s,a)−y)2 L critic = L ( θ 1 ) + L ( θ 2 ) L_{\text{critic}} = L(\theta_1) + L(\theta_2) Lcritic=L(θ1)+L(θ2)
-
这里有三点值得说明
- 两个网络被同一个 y y y 监督,这是截断双 Q 能起作用的前提:两份估计从不同的初始权重出发,见过的 batch 也不同,误差方向并不一致,取最小值才是在两者之间挑更保守的那一个
- 相加而不是取平均,回传到共享特征提取层的梯度是两份之和,尺度比单网络大了一倍
- y y y 里的 θ i ′ \theta_i' θi′ 与 ϕ ′ \phi' ϕ′ 仍然来自目标网络,2-3-3 小节的做法没有变,只是从一份变成了两份
-
这段更新完整写出来是下面这样,三项改动的位置在注释里标出
python
# stable_baselines3/td3/td3.py
replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)
discounts = replay_data.discounts if replay_data.discounts is not None else self.gamma

with th.no_grad():
    # 改动二:目标策略平滑,目标动作先加截断噪声
    noise = replay_data.actions.clone().data.normal_(0, self.target_policy_noise)
    noise = noise.clamp(-self.target_noise_clip, self.target_noise_clip)
    next_actions = (self.actor_target(replay_data.next_observations) + noise).clamp(-1, 1)

    # 改动一:截断双 Q,两份目标估计取最小值
    next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
    next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
    target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values

current_q_values = self.critic(replay_data.observations, replay_data.actions)
critic_loss = sum(F.mse_loss(current_q, target_q_values) for current_q in current_q_values)

self.critic.optimizer.zero_grad()
critic_loss.backward()
self.critic.optimizer.step()- 逐行对照
- 标签那一整段比 DDPG 多两步:先给目标动作加噪再夹回合法区间,再把两份目标估计取最小值
sum(...)在这里不再是退化形式,self.critic返回的是两份估计,求和号下面确实是两项- 两个网络共用同一个标签 y y y,所以 y y y 只算一次。这也要求 y y y 的全部计算都在无梯度状态下完成,否则标签会跟着网络一起动
- 末尾三行只更新两个在线 Critic,两个目标 Critic 只参与标签的计算,不接收梯度
3-4-2 Actor 损失(Actor Loss)
- Actor 的损失与 2-4-2 小节是同一个式子:它同样没有标签可用,直接把第一个 Critic 对 Actor 输出的打分当成目标函数,取负号后交给优化器最小化
L ( ϕ ) = − E s ∼ D Q θ 1 ( s , μ ϕ ( s ) ) L(\phi) = -\, \mathbb E_{s\sim\mathcal D}\left Q_{\\theta_1}\\left(s, \\mu_\\phi(s)\\right) \\right L(ϕ)=−Es∼DQθ1(s,μϕ(s))
- 式子没变,但式子外面多了三道限制,这正是三项改动的效果所在
- 标签 y y y 被取了最小值,Actor 爬的是一座被压低过的山,不容易被单个 Critic 的虚高值骗走
- 标签里的动作加了平滑噪声,山面被抹平,Actor 不会一头扎进某个孤立尖峰
- 参数每
policy_delay步才更新一次,追的是已经稳定了一点的信号
- 有一处对照容易看漏:Actor 的损失里只出现 Q θ 1 Q_{\theta_1} Qθ1,而 Critic 的损失里两个网络都出现。取最小值只用在了构造标签上,如果也用到 Actor 身上,等于把保守偏差直接写进策略的改进方向,这一点 3-3-1 小节解释过
- 这段更新完整写出来是下面这样,改动三的位置在注释里标出
python
# stable_baselines3/td3/td3.py
# 改动三:延迟策略更新,每 policy_delay 次 Critic 更新才更新一次 Actor
if self._n_updates % self.policy_delay == 0:
    actor_loss = -self.critic.q1_forward(
        replay_data.observations, self.actor(replay_data.observations)
    ).mean()

    self.actor.optimizer.zero_grad()
    actor_loss.backward()
    self.actor.optimizer.step()

    # 两个目标网络的软更新也在这个分支里,与 Actor 一起被延迟
    polyak_update(self.critic.parameters(), self.critic_target.parameters(), self.tau)
polyak_update(self.actor.parameters(), self.actor_target.parameters(), self.tau)self._n_updates统计的是 Critic 已经更新过多少次,policy_delay的默认值是 2,所以这个分支每两次迭代才进入一次- 整个分支被包在
if里,所以 Actor 的反向传播并不每步都发生,而 Critic 的损失每步都算。DDPG 与 TD3 在每步优化器调用次数上的差异就来自这里
核心观点:三项改动没有让损失变得更多,而是把同一条损失周围的约束加密了。标签更保守也更平滑,更新节奏更慢,Actor 因此拿到一个更钝但更可信的信号
3-5 训练流程
#mermaid-svg-qSFZXtp3Ng5CI3eP{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-qSFZXtp3Ng5CI3eP .error-icon{fill:#552222;}#mermaid-svg-qSFZXtp3Ng5CI3eP .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-qSFZXtp3Ng5CI3eP .marker{fill:#333333;stroke:#333333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .marker.cross{stroke:#333333;}#mermaid-svg-qSFZXtp3Ng5CI3eP svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-qSFZXtp3Ng5CI3eP p{margin:0;}#mermaid-svg-qSFZXtp3Ng5CI3eP .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster-label text{fill:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster-label span{color:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster-label span p{background-color:transparent;}#mermaid-svg-qSFZXtp3Ng5CI3eP .label text,#mermaid-svg-qSFZXtp3Ng5CI3eP span{fill:#333;color:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .node rect,#mermaid-svg-qSFZXtp3Ng5CI3eP .node circle,#mermaid-svg-qSFZXtp3Ng5CI3eP .node ellipse,#mermaid-svg-qSFZXtp3Ng5CI3eP .node polygon,#mermaid-svg-qSFZXtp3Ng5CI3eP .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .rough-node .label text,#mermaid-svg-qSFZXtp3Ng5CI3eP .node .label text,#mermaid-svg-qSFZXtp3Ng5CI3eP .image-shape .label,#mermaid-svg-qSFZXtp3Ng5CI3eP .icon-shape .label{text-anchor:middle;}#mermaid-svg-qSFZXtp3Ng5CI3eP .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .rough-node .label,#mermaid-svg-qSFZXtp3Ng5CI3eP .node .label,#mermaid-svg-qSFZXtp3Ng5CI3eP .image-shape .label,#mermaid-svg-qSFZXtp3Ng5CI3eP .icon-shape .label{text-align:center;}#mermaid-svg-qSFZXtp3Ng5CI3eP .node.clickable{cursor:pointer;}#mermaid-svg-qSFZXtp3Ng5CI3eP .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .arrowheadPath{fill:#333333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-qSFZXtp3Ng5CI3eP .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-qSFZXtp3Ng5CI3eP .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-qSFZXtp3Ng5CI3eP .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster text{fill:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP .cluster span{color:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-qSFZXtp3Ng5CI3eP .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-qSFZXtp3Ng5CI3eP rect.text{fill:none;stroke-width:0;}#mermaid-svg-qSFZXtp3Ng5CI3eP .icon-shape,#mermaid-svg-qSFZXtp3Ng5CI3eP .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-qSFZXtp3Ng5CI3eP .icon-shape p,#mermaid-svg-qSFZXtp3Ng5CI3eP .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-qSFZXtp3Ng5CI3eP .icon-shape .label rect,#mermaid-svg-qSFZXtp3Ng5CI3eP .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-qSFZXtp3Ng5CI3eP .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-qSFZXtp3Ng5CI3eP .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-qSFZXtp3Ng5CI3eP :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 是
否
采样 Batch
目标动作加噪
双 Critic 取最小 Q
计算 TD 目标
更新双 Critic
延迟更新?
更新 Actor
软更新目标网络
- 把三项改动放回 2-5 小节讲的那六步,TD3 的完整训练循环如下,三处标注就是它相对 DDPG 的全部差异
python
# stable_baselines3/td3/td3.py
def train(self, gradient_steps: int, batch_size: int = 100) -> None:
    self._update_learning_rate([self.actor.optimizer, self.critic.optimizer])

    for _ in range(gradient_steps):
        self._n_updates += 1
        replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)
        discounts = replay_data.discounts if replay_data.discounts is not None else self.gamma

        with th.no_grad():
            # 改动二:目标策略平滑。对目标动作加截断噪声后再构造 TD 目标
            noise = replay_data.actions.clone().data.normal_(0, self.target_policy_noise)
            noise = noise.clamp(-self.target_noise_clip, self.target_noise_clip)
            next_actions = (self.actor_target(replay_data.next_observations) + noise).clamp(-1, 1)

            # 改动一:截断双 Q。两个目标 Critic 的输出取最小值
            next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
            next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
            target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values

        # 两个在线 Critic 的损失相加后一起回传
        current_q_values = self.critic(replay_data.observations, replay_data.actions)
        critic_loss = sum(F.mse_loss(current_q, target_q_values) for current_q in current_q_values)

        self.critic.optimizer.zero_grad()
        critic_loss.backward()
        self.critic.optimizer.step()

        # 改动三:延迟策略更新。每 policy_delay 次 Critic 更新才更新一次 Actor
        if self._n_updates % self.policy_delay == 0:
            actor_loss = -self.critic.q1_forward(
                replay_data.observations, self.actor(replay_data.observations)
            ).mean()

            self.actor.optimizer.zero_grad()
            actor_loss.backward()
            self.actor.optimizer.step()

            polyak_update(self.critic.parameters(), self.critic_target.parameters(), self.tau)
polyak_update(self.actor.parameters(), self.actor_target.parameters(), self.tau)- 同一份循环里的三次差异可以并排读
| 位置 | DDPG | TD3 |
|---|---|---|
| 目标动作 | 直接用目标 Actor 的输出 | 加截断噪声后再用 |
| 目标 Q 值 | 单个目标 Critic 的输出 | 两个目标 Critic 输出的最小值 |
| Critic 损失 | 单个网络的均方误差 | 两个网络均方误差之和 |
| Actor 更新 | 每一步都更新 | 每 policy_delay 步更新一次 |
| 目标网络软更新 | 每一步都做 | 与 Actor 同步,被延迟 |
- 这张表也解释了为什么 TD3 每步的梯度更新次数比 DDPG 少:Actor 与目标网络的更新被摊薄到一半,而 Critic 的更新次数不变
- 需要注意
critic_loss是两个网络的损失直接相加,而不是取平均。这意味着回传到共享的特征提取器上的梯度是两份之和,尺度比单网络大了一倍。SB3 保持与论文一致,没有额外做缩放,调节学习率时要把这一点考虑进去
- 需要注意
- 到这里可以补一句 SB3 是怎么处理这两代算法的关系的:它没有为 DDPG 另写一份训练循环,而是把 DDPG 直接写成 TD3 的子类,把三项改动逐个关掉
python
# stable_baselines3/ddpg/ddpg.py
class DDPG(TD3):
    """
    Note: we treat DDPG as a special case of its successor TD3.
    """
    def __init__(self, policy, env, ..., action_noise=None, ...):
        super().__init__(
            ...,
            # Remove all tricks from TD3 to obtain DDPG:
            # we still need to specify target_policy_noise > 0 to avoid errors
            policy_delay=1,             # 改动三关掉:策略不再延迟更新
            target_noise_clip=0.0,      # 改动二关掉:目标动作上的噪声被削平
            target_policy_noise=0.1,
            _init_setup_model=False,
        )
        # 改动一关掉:只建一个 Critic
        if "n_critics" not in self.policy_kwargs:
self.policy_kwargs["n_critics"] = 1- 这三个参数与上表一一对应,那张并排表之所以能成立也是因为这个:三项改动在实现上就是三个开关,打开是 TD3,关掉就是 DDPG
- 顺序要说清楚:论文上是 DDPG 在前、TD3 是对它的修正,SB3 反过来用 TD3 的实现来表达 DDPG,docstring 里
successor这个词说的就是这件事。第 5 章的同种子对照正是建立在这个实现关系上
- 顺序要说清楚:论文上是 DDPG 在前、TD3 是对它的修正,SB3 反过来用 TD3 的实现来表达 DDPG,docstring 里
- 还有一个容易忽略的细节:
target_policy_noise仍然要传一个大于 0 的值,尽管噪声最终会被target_noise_clip=0.0削平,源码注释说明这是为了避免报错
核心观点:TD3 的三项改动全部围绕"让 Critic 的信号更可信"这一个目的,三者作用在同一个学习目标的三个不同环节上,缺一项都会在实验里掉分
3-6 缺陷与不足
- 确定性策略,探索能力仍然有限
- 三项改动都没有触及 Actor 的输出形式,Actor 依然只给一个动作,探索仍然靠外挂噪声
- 这意味着 TD3 在需要大范围探索的任务上,仍然要依赖噪声尺度调得合适,而这件事没有通用的做法
- 探索与利用之间的平衡依赖噪声设计
- 噪声的尺度、类型(高斯还是 OU)、以及探索发生在哪些维度上,都会影响最终能学到什么
- TD3 自己的论文把噪声放在超参表里当一个普通参数处理,并没有给出选择准则
- 对探索程度的控制仍有调参成本
- 噪声只在训练时起作用,训练结束后策略是确定的,探索强度无法随训练进度自适应
- 想让探索随训练逐步收敛,得自己写噪声衰减,而衰减曲线又是新的超参
- 顺着这三条往下看,下一步要解决的问题就很清楚了:能不能让策略本身带上随机性,让探索不再需要外挂噪声
核心观点:TD3 让确定性的那一支做到了极致,但它始终没有回答"探索强度该由谁决定"这个问题,这正好是 SAC 的切入点
4 SAC
4-1 介绍
#mermaid-svg-VsoYUBJCzEfXZVEE{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-VsoYUBJCzEfXZVEE .error-icon{fill:#552222;}#mermaid-svg-VsoYUBJCzEfXZVEE .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-VsoYUBJCzEfXZVEE .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-VsoYUBJCzEfXZVEE .marker{fill:#333333;stroke:#333333;}#mermaid-svg-VsoYUBJCzEfXZVEE .marker.cross{stroke:#333333;}#mermaid-svg-VsoYUBJCzEfXZVEE svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-VsoYUBJCzEfXZVEE p{margin:0;}#mermaid-svg-VsoYUBJCzEfXZVEE .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster-label text{fill:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster-label span{color:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster-label span p{background-color:transparent;}#mermaid-svg-VsoYUBJCzEfXZVEE .label text,#mermaid-svg-VsoYUBJCzEfXZVEE span{fill:#333;color:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE .node rect,#mermaid-svg-VsoYUBJCzEfXZVEE .node circle,#mermaid-svg-VsoYUBJCzEfXZVEE .node ellipse,#mermaid-svg-VsoYUBJCzEfXZVEE .node polygon,#mermaid-svg-VsoYUBJCzEfXZVEE .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-VsoYUBJCzEfXZVEE .rough-node .label text,#mermaid-svg-VsoYUBJCzEfXZVEE .node .label text,#mermaid-svg-VsoYUBJCzEfXZVEE .image-shape .label,#mermaid-svg-VsoYUBJCzEfXZVEE .icon-shape .label{text-anchor:middle;}#mermaid-svg-VsoYUBJCzEfXZVEE .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-VsoYUBJCzEfXZVEE .rough-node .label,#mermaid-svg-VsoYUBJCzEfXZVEE .node .label,#mermaid-svg-VsoYUBJCzEfXZVEE .image-shape .label,#mermaid-svg-VsoYUBJCzEfXZVEE .icon-shape .label{text-align:center;}#mermaid-svg-VsoYUBJCzEfXZVEE .node.clickable{cursor:pointer;}#mermaid-svg-VsoYUBJCzEfXZVEE .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-VsoYUBJCzEfXZVEE .arrowheadPath{fill:#333333;}#mermaid-svg-VsoYUBJCzEfXZVEE .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-VsoYUBJCzEfXZVEE .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-VsoYUBJCzEfXZVEE .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-VsoYUBJCzEfXZVEE .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-VsoYUBJCzEfXZVEE .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-VsoYUBJCzEfXZVEE .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster text{fill:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE .cluster span{color:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-VsoYUBJCzEfXZVEE .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-VsoYUBJCzEfXZVEE rect.text{fill:none;stroke-width:0;}#mermaid-svg-VsoYUBJCzEfXZVEE .icon-shape,#mermaid-svg-VsoYUBJCzEfXZVEE .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-VsoYUBJCzEfXZVEE .icon-shape p,#mermaid-svg-VsoYUBJCzEfXZVEE .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-VsoYUBJCzEfXZVEE .icon-shape .label rect,#mermaid-svg-VsoYUBJCzEfXZVEE .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-VsoYUBJCzEfXZVEE .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-VsoYUBJCzEfXZVEE .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-VsoYUBJCzEfXZVEE :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 更新双 Critic
更新双 Critic
策略梯度
软更新
软更新
状态 s
Actor 策略网络
动作分布 π(a|s)
采样动作 a
Critic 1:Q₁(s,a)
Critic 2:Q₂(s,a)
下一状态 s'
Actor 生成下一动作 a'
目标 Critic 1
目标 Critic 2
取较小 Q 值
熵项 -α log π(a'|s')
软 Bellman 目标 y
奖励 r
终止标志 d
Critic 损失
Actor 损失
- SAC(Soft Actor-Critic,软演员评论家)出自 2018 年的论文 "Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor",作者是 Haarnoja 等人,同年稍后的续作 "Soft Actor-Critic Algorithms and Applications" 做了两处工程简化
- 它在两条线上同时和前面两代分道扬镳
- 目标换了:不再只最大化累积奖励,而是最大化"累积奖励加策略熵",也就是最大熵目标
- Actor 换了:不再输出一个确定性动作,而是输出一个动作分布,每次采样出一个动作
- 这两处改动是一体的:熵要能被优化,前提是策略本身有分布可算熵;而有了分布,探索就不再需要外挂噪声
- 前两代把"确定性"这一支做到了极致,SAC 回头去补的是 3-6 小节留下的那个问题,探索强度该由谁决定
- 顺带说明版本差异:初版 SAC 里还有一个单独学状态价值的 V 网络,续作把它去掉,用两个 Q 网络的较小值来算价值目标,并加入自动熵调节。SB3 实现的是续作那一版,本文按 SB3 的版本来讲
说人话:DDPG 与 TD3 是"把动作定死、另外加噪声去试",SAC 是"干脆让策略自己去摇骰子",而骰子的随机程度由熵这一项自动调节
4-2 整体架构
- 网络清单如下
| 网络 | 数量 | 说明 |
|---|---|---|
| Actor | 1 个在线 + 1 个目标 | 输出动作分布的均值与对数标准差,再采样出动作 |
| Critic | 2 个在线 + 2 个目标 | 与 TD3 相同,取最小值抑制高估 |
| 熵系数 | 1 个可学习标量 | 只存 log α \log\alpha logα,不占网络,但同样由优化器更新 |
- 与 TD3 相比,两处结构变化值得点出
- Actor 的输出从一个动作变成一个分布的两组参数,网络末端不再接
tanh做挤压,而是接两个并行的线性层 - 多出一个标量 α \alpha α,它没有前向计算,只作为损失里的系数参与梯度更新
- Actor 的输出从一个动作变成一个分布的两组参数,网络末端不再接
- Actor 的内部结构在代码里是这样搭的
python
# stable_baselines3/sac/policies.py
LOG_STD_MAX = 2
LOG_STD_MIN = -20

class Actor(BasePolicy):
    def __init__(self, observation_space, action_space, net_arch, features_extractor,
                 features_dim, use_sde=False, log_std_init=-3, ...):
        ...
        action_dim = get_action_dim(self.action_space)
        latent_pi_net = create_mlp(features_dim, -1, net_arch, activation_fn)
        self.latent_pi = nn.Sequential(*latent_pi_net)
        last_layer_dim = net_arch[-1] if len(net_arch) > 0 else features_dim

        # 非 gSDE 模式(默认):对角高斯,用两个并行线性层分别给出均值与对数标准差
        self.action_dist = SquashedDiagGaussianDistribution(action_dim)
        self.mu = nn.Linear(last_layer_dim, action_dim)
self.log_std = nn.Linear(last_layer_dim, action_dim)- 共享主干加两个头,这是 SAC 与 TD3 在网络层面最直观的差别:TD3 的 Actor 末层直接给动作,SAC 的 Actor 末层给的是两个统计量
- 注意
log_std也走线性层,也就是标准差同样是被学出来的 ,而不是一个固定常数。它随后会被夹在 LOG_STD_MIN , LOG_STD_MAX \\text{LOG\\_STD\\_MIN},\\ \\text{LOG\\_STD\\_MAX} LOG_STD_MIN, LOG_STD_MAX 即 − 20 , 2 -20,\\ 2 −20, 2 之间,对应标准差约 2 × 10 − 9 , 7.4 2\\times10\^{-9},\\ 7.4 2×10⁻⁹, 7.4,前者防止数值下溢,后者防止探索尺度失控
说人话:TD3 的 Actor 是一个只会给答案的选手,SAC 的 Actor 除了给答案,还报一个"我有多大把握",训练过程会把这份把握也一起调好
4-3 核心思想
- 这一节按"先立目标、再给手段"的顺序展开:4-3-1 讲清最大熵这个目标是什么,4-3-2 讲怎么用随机策略实现它,4-3-3 讲价值估计怎么做,4-3-4 讲熵系数怎么自动定
4-3-1 最大熵强化学习(Maximum Entropy Reinforcement Learning)
-
这是 SAC 最核心的思想,也是最应该优先介绍的部分
-
传统强化学习主要追求最大化累积奖励 J ( π ) = E π ∑ t = 0 T r ( s t , a t ) J(\pi)=\mathbb E_{\pi} \left\\sum_{t=0}\^{T}r(s_t,a_t)\\right J(π)=Eπt=0∑Tr(st,at)
-
而 SAC 不仅希望智能体获得更高的奖励,还希望策略保留一定的随机性,因此将策略熵加入优化目标 J ( π ) = E π ∑ t = 0 T γ t ( r ( s t , a t ) + α H ( π ( ⋅ ∣ s t ) ) ) J(\pi)=\mathbb E_{\pi} \left \\sum_{t=0}\^{T} \\gamma\^t \\left( r(s_t,a_t)+\\alpha\\mathcal H(\\pi(\\cdot\|s_t)) \\right) \\right J(π)=Eπt=0∑Tγt(r(st,at)+αH(π(⋅∣st)))其中
- r ( s t , a t ) r(s_t,a_t) r(st,at):环境奖励,鼓励智能体完成任务
- H ( π ( ⋅ ∣ s t ) ) \mathcal H(\pi(\cdot|s_t)) H(π(⋅∣st)):策略熵,衡量策略的随机程度
- α \alpha α:熵温度系数,控制奖励与熵之间的权衡
说人话:传统强化学习更关心"哪个动作的回报最高",SAC 除了追求高回报,还鼓励策略保留合理的探索空间,避免过早地只选择某一个动作
- 需要注意,最大熵并不意味着随机性越大越好。熵过高会影响任务执行,因此需要在探索与利用之间取得平衡
- 这个目标之所以能写进同一条期望里,是因为熵本身就是一个可以求梯度的量:
- 策略输出的高斯分布有解析的微分熵, tanh \tanh tanh 挤压后的分布也有对应的修正项,所以"多拿一点熵"可以和"多拿一点奖励"一样,作为一项直接加进损失
- 这个目标之所以能写进同一条期望里,是因为熵本身就是一个可以求梯度的量:
- 它带来一个不太显眼但很重要的副作用:多峰任务上的稳健性。如果两个动作的回报相近,只最大化奖励的方法会任意挑一个,而最大熵目标会把概率同时分给两者。当高回报区域只是估计偏差时,这份保留就避免了过早收敛到错的解
4-3-2 随机策略(Stochastic Policy)
- DDPG 和 TD3 的 Actor 通常输出确定性动作
a = μ ϕ ( s ) a=\mu_\phi(s) a=μϕ(s)
- 而 SAC 的 Actor 学习的是一个动作概率分布
a ∼ π ϕ ( a ∣ s ) a\sim\pi_\phi(a|s) a∼πϕ(a∣s)
-
在常见的连续动作 SAC 实现中,Actor 通常输出高斯分布的均值和标准差,再通过重参数化技巧采样动作 u = μ ϕ ( s ) + σ ϕ ( s ) ⊙ ϵ , ϵ ∼ N ( 0 , I ) u=\mu_\phi(s)+\sigma_\phi(s)\odot\epsilon, \qquad \epsilon\sim\mathcal N(0,I) u=μϕ(s)+σϕ(s)⊙ϵ,ϵ∼N(0,I)
-
如果动作范围有限,通常还会使用 tanh \tanh tanh 将动作映射到指定区间 a = tanh ( u ) a=\tanh(u) a=tanh(u)
-
这意味着相同状态下,策略可以采样不同动作,而不是始终输出同一个动作
-
它与最大熵目标相互配合:随机策略提供探索能力,熵目标则鼓励策略在训练过程中保留适当的随机性
- 重参数化:把随机性写成 ϵ \epsilon ϵ 的形式之后,采样结果对 μ ϕ \mu_\phi μϕ 与 σ ϕ \sigma_\phi σϕ 是可导的,梯度能穿过采样这一步回传到网络。
- 如果直接写 a ∼ N ( μ , σ 2 ) a\sim\mathcal N(\mu,\sigma^2) a∼N(μ,σ2) 再采样,采样操作本身不可导,就没法用反向传播优化
-
采样与对数概率的实现如下
python
# stable_baselines3/common/distributions.py
class SquashedDiagGaussianDistribution(DiagGaussianDistribution):
    def sample(self) -> th.Tensor:
        # Reparametrization trick to pass gradients
        self.gaussian_actions = super().sample()      # 内部是 self.distribution.rsample()
        return th.tanh(self.gaussian_actions)         # 对应 a = tanh(u)

    def log_prob(self, actions, gaussian_actions=None) -> th.Tensor:
        if gaussian_actions is None:
            gaussian_actions = TanhBijector.inverse(actions)   # 先反解出 tanh 之前的 u
        log_prob = super().log_prob(gaussian_actions)          # 高斯分布的对数概率
        # Squash correction (from original SAC implementation)
        log_prob -= th.sum(th.log(1 - actions**2 + self.epsilon), dim=1)
return log_probsuper().sample()走的是self.distribution.rsample(),rsample与sample的区别正在于它保留了对分布参数的梯度,这就是重参数化在代码里的落点log_prob里那一行减法是 tanh \tanh tanh 挤压带来的雅可比修正。变量替换会改变概率密度,不做这个修正,算出来的熵就是错的,而熵是 SAC 的核心项,这一项漏了算法就不成立- 到这里也能看到评估与训练的区别:训练时按上面的方式采样,评估时取分布的中心,也就是
mode(),它同样过一遍tanh,给出确定性的动作
说人话:重参数化的要点是把"随机"单独拿出来当一个外部输入 ϵ \epsilon ϵ,网络只负责决定这个随机量怎么被平移和缩放,这样一来整条链都可导
4-3-3 双 Q 网络与目标网络(Twin Q Networks)
- SAC 延续了 TD3 的双 Critic 思想,使用两个独立的 Q 网络
Q θ 1 ( s , a ) , Q θ 2 ( s , a ) Q_{\theta_1}(s,a),\qquad Q_{\theta_2}(s,a) Qθ1(s,a),Qθ2(s,a)
- 计算目标价值时,取两个目标 Critic 估计值中的较小者,以减轻 Q 值过高估计的问题
- 现代常见 SAC 实现中的 TD 目标为 a ′ ∼ π ϕ ( ⋅ ∣ s ′ ) y = r + γ ( 1 − d ) min i = 1 , 2 Q θ ˉ i ( s ′ , a ′ ) − α log π ϕ ( a ′ ∣ s ′ ) \begin{aligned} a'&\sim\pi_\phi(\cdot|s')\\ y&=r+\gamma(1-d)\big \\min_{i=1,2}Q_{\\bar\\theta_i}(s',a')\\\\ \&\\qquad\\qquad-\\alpha\\log\\pi_\\phi(a'\|s') \\big \end{aligned} a′y∼πϕ(⋅∣s′)=r+γ(1−d)i=1,2minQθˉi(s′,a′)−αlogπϕ(a′∣s′)其中, log π ϕ ( a ′ ∣ s ′ ) \log\pi_\phi(a'|s') logπϕ(a′∣s′) 对应采样动作的对数概率,负号体现了熵正则化对价值目标的影响
- 也就是说,SAC 并非只估计未来奖励,还会考虑未来策略的熵
- 展开读这个负号: − α log π -\alpha\log\pi −αlogπ 在 π \pi π 越小时越大,也就是"越出人意料的动作,价值越高"。把它加进目标价值,等于给未来留了一份探索补贴,这正是 4-3-1 的熵项在时序差分形式下的样子
- 代码与公式逐行对应
python
# stable_baselines3/sac/sac.py
with th.no_grad():
    # Select action according to policy
    next_actions, next_log_prob = self.actor.action_log_prob(replay_data.next_observations)
    # Compute the next Q values: min over all critics targets
    next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
    next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
    # add entropy term
    next_q_values = next_q_values - ent_coef * next_log_prob.reshape(-1, 1)
    # td error + entropy term
target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values- 与 TD3 的两处差别:这里的 a ′ a' a′ 是从策略分布里采样 出来的,不是目标 Actor 的确定性输出,也不需要目标策略平滑噪声,因为随机策略本身就是平滑的来源;另外多减了一项
ent_coef * next_log_prob - 一个实现细节:
next_log_prob.reshape(-1, 1)是为了形状对齐,log_prob返回的是一维张量,而 Q 值是(batch, 1),不 reshape 会在广播时出错
说人话:TD3 的双 Q 是"两个裁判取低分",SAC 在低分的基础上再补一句"如果你选的动作足够意外,我额外给你一点奖励",逼着策略别太早变确定
4-3-4 自动熵调节(Automatic Entropy Tuning)
J ( π ) = E π ∑ t = 0 T γ t ( r ( s t , a t ) + α H ( π ( ⋅ ∣ s t ) ) ) J(\pi)=\mathbb E_{\pi} \left \\sum_{t=0}\^{T} \\gamma\^t \\left( r(s_t,a_t)+\\alpha\\mathcal H(\\pi(\\cdot\|s_t)) \\right) \\right J(π)=Eπt=0∑Tγt(r(st,at)+αH(π(⋅∣st)))
- 4-3-1 的最大熵目标里,回报与熵是加权相加的,那个权重就是 α \alpha α,它代表"每一单位熵值多少奖励",量纲上与回报直接挂钩
- α \alpha α 太小:熵的权重低,策略会很快收缩成一个确定动作,探索停得太早
- α \alpha α 太大:策略为了拿熵奖励而乱动,任务回报被拖下去
- 固定一个 α \alpha α 反复试是最常见的做法,但任务一换,合适的位置就得重新找一遍。自动熵调节要处理的就是这件事:把 α \alpha α 从超参变成跟着训练过程自己走的变量
- 换一个角度提问,这件事会好写得多。不规定熵的价格,而是要求策略的平均熵不低于某个水平,在这个条件下最大化回报
max π E π ∑ t γ t r ( s t , a t ) s.t. E π H ( π ( ⋅ ∣ s t ) ) ≥ H ˉ \begin{aligned} \max_\pi \quad & \mathbb E_\pi\left \\sum_t \\gamma\^t r(s_t,a_t) \\right \\ \text{s.t.} \quad & \mathbb E_\pi\left \\mathcal H\\left( \\pi(\\cdot\|s_t) \\right) \\right \geq \bar{\mathcal H} \end{aligned} πmaxs.t.Eπt∑γtr(st,at)EπH(π(⋅∣st))≥Hˉ
- 其中 H ˉ \bar{\mathcal H} Hˉ 是目标熵,也就是允许策略降到的最低随机程度
- 用拉格朗日乘子把这个约束并进目标,乘子正是 α \alpha α。对偶问题里乘子那一侧求极小,含义是"在满足约束的前提下把价格压到最低"。把熵的定义 H ( π ( ⋅ ∣ s ) ) = − E a ∼ π log π ( a ∣ s ) \mathcal H(\pi(\cdot|s)) = -\,\mathbb E_{a\sim\pi}\\log\\pi(a\|s) H(π(⋅∣s))=−Ea∼πlogπ(a∣s) 代进去,约束项写成
− α E π log π ( a t ∣ s t ) + H ˉ -\,\alpha\, \mathbb E_\pi\left \\log\\pi(a_t\|s_t) + \\bar{\\mathcal H} \\right −αEπlogπ(at∣st)+Hˉ
- 这一项读起来很直白:括号里是当前对数概率与目标熵之和。它为正,说明策略比目标水平更确定,此时乘子会往大的方向走,熵的权重随之加大
- 令这一项的梯度为零,得到的是 E log π + H ˉ = 0 \mathbb E\\log\\pi + \\bar{\\mathcal H} = 0 Elogπ+Hˉ=0,也就是 H ( π ) = H ˉ \mathcal H(\pi) = \bar{\mathcal H} H(π)=Hˉ。熵系数的最优值恰好落在"当前熵等于目标熵"这一点上,这就是它能自动对齐目标的原因
- 源码与上面只差一处:SB3 把式子里的 α \alpha α 直接换成了 log α \log\alpha logα,源码注释里也标了这一点。换成对数之后参数可以取遍实数, α = e log α \alpha = e^{\log\alpha} α=elogα 恒为正,不需要再额外加一条正性约束
L ( α ) = − E log α ⋅ ( log π ϕ ( a ∣ s ) + H ˉ ) L(\alpha) = -\, \mathbb E\left \\log\\alpha \\cdot \\left( \\log\\pi_\\phi(a\|s) + \\bar{\\mathcal H} \\right) \\right L(α)=−Elogα⋅(logπϕ(a∣s)+Hˉ)
- 对 log α \log\alpha logα 求导,负号与对数概率的期望正好凑成熵的定义
∂ L ( α ) ∂ log α = − E log π ϕ ( a ∣ s ) + H ˉ = H ( π ϕ ) − H ˉ \frac{\partial L(\alpha)}{\partial \log\alpha} = -\, \mathbb E\left \\log\\pi_\\phi(a\|s) + \\bar{\\mathcal H} \\right = \mathcal H(\pi_\phi) - \bar{\mathcal H} ∂logα∂L(α)=−Elogπϕ(a∣s)+Hˉ=H(πϕ)−Hˉ
- 这个导数就是更新方向,两种情况分别读
- 当前熵低于目标熵时导数为负,梯度下降把 log α \log\alpha logα 往上推, α \alpha α 变大,熵的权重加大,策略被推向更随机
- 当前熵高于目标熵时导数为正,方向反过来,权重被调小
- 所以 α \alpha α 不需要人来定,每一批数据都会把它往"让当前熵回到目标熵"的方向挪一步
- 目标熵这个标量的取法也有依据:续作论文把它设成动作维数的相反数,即 H ˉ = − dim ( A ) \bar{\mathcal H} = -\dim(\mathcal A) Hˉ=−dim(A)。Pendulum 的动作维数是 1,目标熵就是 − 1 -1 −1,平衡点是让 E − log π ϕ ( a ∣ s ) \mathbb E-\\log\\pi_\\phi(a\|s) E−logπϕ(a∣s) 收敛到 − 1 -1 −1
- 代码里先把待优化的标量建出来,初始值取 1,对应 log α = 0 \log\alpha = 0 logα=0,也就是 α = 1 \alpha = 1 α=1
python
# stable_baselines3/sac/sac.py
# Target entropy is used when learning the entropy coefficient
if self.target_entropy == "auto":
    # automatically set target entropy if needed
    self.target_entropy = float(-np.prod(self.env.action_space.shape).astype(np.float32))

if isinstance(self.ent_coef, str) and self.ent_coef.startswith("auto"):
    init_value = 1.0
    ...
    # Note: we optimize the log of the entropy coeff which is slightly different from the paper
    # as discussed in https://github.com/rail-berkeley/softlearning/issues/37
    self.log_ent_coef = th.log(th.ones(1, device=self.device) * init_value).requires_grad_(True)
self.ent_coef_optimizer = th.optim.Adam([self.log_ent_coef], lr=self.lr_schedule(1))- 被优化的对象是
self.log_ent_coef,一个只有一个元素的张量,也是三个被优化的对象里唯一不绑定网络的 - 熵系数的损失长这样
python
# stable_baselines3/sac/sac.py
ent_coef = th.exp(self.log_ent_coef.detach())
ent_coef_loss = -(self.log_ent_coef * (log_prob + self.target_entropy).detach()).mean()
...
self.ent_coef_optimizer.zero_grad()
ent_coef_loss.backward()
self.ent_coef_optimizer.step()- 式子里那个
log_prob是这一批状态下、从当前策略分布里采样动作时带回的对数概率,与 4-3-2 小节的重参数化采样是同一个来源 - 两处
detach()各有用处:ent_coef那一处是为了让熵系数不被 Critic 与 Actor 的损失带着走,只由自己的优化器负责;括号内那一处是为了让 α \alpha α 的梯度只反映熵的偏差,不反向影响策略网络 - 到这里 SAC 的三层自动性就齐了:熵系数自动调、标准差自动学、双 Q 自动取小值,留给人工的只剩目标熵这一个标量
说人话: α \alpha α 原本是一个要靠人试出来的旋钮,自动熵调节把这个旋钮接到了策略自己的熵上,熵偏低就把权重调大,偏高就调小,让随机程度一直维持在一个预设水平附近
4-4 损失计算
- 前两代都是两条损失,SAC 有三条:Critic 一条、Actor 一条、熵系数一条。三个被优化的对象也正好对应这三条,前两个是网络,第三个是一个标量。下面按这三条分别看
4-4-1 Critic 损失(Critic Loss)
- Critic 的损失形式没有变,仍然是预测值与标签之间的均方误差。变的只有标签:它先由两个目标 Critic 取最小值,再从里面减去一项熵
y = r + γ ( 1 − d ) min i = 1 , 2 Q θ ˉ i ( s ′ , a ′ ) − α log π ϕ ( a ′ ∣ s ′ ) y = r + \gamma(1-d)\left \\min_{i=1,2} Q_{\\bar\\theta_i}(s', a') - \\alpha \\log \\pi_\\phi(a'\|s') \\right y=r+γ(1−d)i=1,2minQθˉi(s′,a′)−αlogπϕ(a′∣s′)
- 标签里的 a ′ a' a′ 与前一章不同:它不再是目标 Actor 的确定性输出,而是从当前策略的输出分布里采样出来的动作,同时带回这个动作的对数概率,供后面那一项熵使用
a ′ ∼ π ϕ ( ⋅ ∣ s ′ ) a'\sim\pi_\phi(\cdot|s') a′∼πϕ(⋅∣s′)
- 两个在线 Critic 各自回归同一个标签,损失是两份均方误差之和的一半
L ( θ i ) = E ( s , a , r , s ′ , d ) ∼ D ( Q θ i ( s , a ) − y ) 2 L(\theta_i) = \mathbb E_{(s,a,r,s',d)\sim\mathcal D}\left \\left( Q_{\\theta_i}(s,a) - y \\right)\^2 \\right L(θi)=E(s,a,r,s′,d)∼D(Qθi(s,a)−y)2
L critic = 1 2 ( L ( θ 1 ) + L ( θ 2 ) ) L_{\text{critic}} = \tfrac{1}{2}\left( L(\theta_1) + L(\theta_2) \right) Lcritic=21(L(θ1)+L(θ2))
- 这里有两个容易看混的地方
- 输入的动作 a a a 取自经验池,是真实发生过的动作。Critic 学的是"给定这个动作值多少分",所以必须用历史动作,这与下一条损失正好相反
- 1 2 \tfrac{1}{2} 21 是为了抵消平方求导后多出来的因子 2,让梯度尺度与 Actor 那边更接近,TD3 没有这个系数
- 这段更新完整写出来是下面这样
python
# stable_baselines3/sac/sac.py
replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)
discounts = replay_data.discounts if replay_data.discounts is not None else self.gamma

with th.no_grad():
    # 目标动作从策略分布里采样,同时拿到它的对数概率
    next_actions, next_log_prob = self.actor.action_log_prob(replay_data.next_observations)
    next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
    next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
    # 减去熵项之后再算标签
    next_q_values = next_q_values - ent_coef * next_log_prob.reshape(-1, 1)
    target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values

current_q_values = self.critic(replay_data.observations, replay_data.actions)
critic_loss = 0.5 * sum(F.mse_loss(current_q, target_q_values) for current_q in current_q_values)

self.critic.optimizer.zero_grad()
critic_loss.backward()
self.critic.optimizer.step()- 逐行对照
next_log_prob就是标签里那一项熵的来源,reshape(-1, 1)是为了与(batch, 1)的 Q 值对齐,不 reshape 会在广播时出错critic_loss的输入是replay_data.actions,也就是池子里真实发生过的动作,与上面那条"必须用历史动作"在代码里是一致的current_q_values是self.critic返回的元组,SAC 里有两项,sum(...)把两份均方误差加起来,前面的0.5就是式子里的 1 2 \tfrac{1}{2} 21target_q_values就是上面的 y y y,它在无梯度状态下算好,只有current_q_values带梯度
4-4-2 Actor 损失(Actor Loss)
-
4-3-1 的目标是最大化"价值减熵",把它取反写进代码就是 Actor 的损失 L ( ϕ ) = E s ∼ D , a ∼ π ϕ ( ⋅ ∣ s ) α log π ϕ ( a ∣ s ) − min i = 1 , 2 Q θ i ( s , a ) L(\phi) = \mathbb E_{s\sim\mathcal D,\ a\sim\pi_\phi(\cdot|s)}\left \\alpha \\log \\pi_\\phi(a\|s) - \\min_{i=1,2} Q_{\\theta_i}(s,a) \\right L(ϕ)=Es∼D, a∼πϕ(⋅∣s)αlogπϕ(a∣s)−i=1,2minQθi(s,a)其中:
- Q ( s , a ) Q(s,a) Q(s,a):鼓励选择 Q 值更高的动作。
- α log π ( a ∣ s ) \alpha\log\pi(a|s) αlogπ(a∣s):结合概率密度,鼓励策略保留一定的熵。
-
注意,连续动作空间里的 π ( a ∣ s ) \pi(a|s) π(a∣s) 是概率密度,不是单个动作的离散概率。
-
这条损失与前面两代有几个明显不同
- 输入的动作由当前策略现场采样,而不是从池子里取。Actor 要改的是自己的输出,所以必须用自己当前采样的动作,梯度才能穿过采样这一步
- 里面没有标签,只有两项:一项是 Critic 的打分,一项是策略自己的对数概率。前者负责把动作往高分处推,后者负责给策略留出随机性
- 两个 Critic 在这里取的是最小值,与 TD3 只用一个 Critic 的做法相反。原因在 4-3-3 小节提过:SAC 的策略自带随机性,取最小值带来的保守偏差不会像在确定性策略上那样直接卡住改进方向
-
这段更新完整写出来是下面这样
python
# stable_baselines3/sac/sac.py
actions_pi, log_prob = self.actor.action_log_prob(replay_data.observations)   # 从当前策略采样动作
q_values_pi = th.cat(self.critic(replay_data.observations, actions_pi), dim=1)
min_qf_pi, _ = th.min(q_values_pi, dim=1, keepdim=True)
actor_loss = (ent_coef * log_prob - min_qf_pi).mean()

self.actor.optimizer.zero_grad()
actor_loss.backward()
self.actor.optimizer.step()- 逐行对照
- 第一行从当前策略里采样出动作,同时拿到它的对数概率,对应式子里的 a ∼ π ϕ ( ⋅ ∣ s ) a\sim\pi_\phi(\cdot|s) a∼πϕ(⋅∣s)
- 第二行把两个 Critic 的两份打分拼成
(batch, 2),第三行沿这一维取最小值得到(batch, 1),对应式子里的 min i = 1 , 2 Q θ i ( s , a ) \min_{i=1,2}Q_{\theta_i}(s,a) mini=1,2Qθi(s,a) - 第四行用
ent_coef乘对数概率再减去打分,最后按 batch 取平均。减号落在打分前面,写出来的顺序与式子里的 α log π − Q \alpha\log\pi - Q αlogπ−Q 一致 - 末尾三行只更新 Actor 的参数,Critic 在这里只提供梯度
4-4-3 熵系数损失(Entropy Coefficient Loss)
- 最后一条损失优化的是一个标量,目标是让策略的熵逼近 4-3-4 小节那个预设水平
L ( α ) = − E s ∼ D log α ⋅ ( log π ϕ ( a ∣ s ) + H ˉ ) L(\alpha) = -\, \mathbb E_{s\sim\mathcal D}\left \\log\\alpha \\cdot \\left( \\log \\pi_\\phi(a\|s) + \\bar{\\mathcal H} \\right) \\right L(α)=−Es∼Dlogα⋅(logπϕ(a∣s)+Hˉ)
- 这条式子读起来要小心符号
- 括号里是当前对数概率与目标熵之和。目标熵取负值,Pendulum 的动作维数是 1,它就是 − 1 -1 −1,对应的平衡点是让 E − log π ϕ ( a ∣ s ) \mathbb E-\\log\\pi_\\phi(a\|s) E−logπϕ(a∣s) 收敛到 − 1 -1 −1
- 括号内为正,说明当前策略比目标水平更确定,此时对 log α \log\alpha logα 求导得到的梯度方向是把它往上推,也就是加大熵的权重;策略过于随机时方向反过来
- 优化的是 log α \log\alpha logα 而不是 α \alpha α,这样 α = e log α \alpha=e^{\log\alpha} α=elogα 恒为正,省掉一个不等式约束
- 这段更新完整写出来是下面这样
python
# stable_baselines3/sac/sac.py
ent_coef = th.exp(self.log_ent_coef.detach())
ent_coef_loss = -(self.log_ent_coef * (log_prob + self.target_entropy).detach()).mean()

self.ent_coef_optimizer.zero_grad()
ent_coef_loss.backward()
self.ent_coef_optimizer.step()- 逐行对照
- 第一行取的是指数的值,但
.detach()挡住了梯度,熵系数只由它自己的优化器负责更新,不会被另外两条损失带着走 - 第二行里括号内的量也被
.detach()了, α \alpha α 的梯度只反映熵的偏差,不会反过来影响策略网络 - 末尾三行更新的是
self.log_ent_coef这个标量,它是三个被优化的对象里唯一不绑定网络的 - 这里的
log_prob与 4-4-2 小节用的是同一个量,所以这一步只采样一次就可以供两条损失使用
- 第一行取的是指数的值,但
- 把三代算法并排看,损失的演化路径很清楚
| 算法 | Critic 的标签 | Actor 损失 |
|---|---|---|
| DDPG | 单个目标 Critic 的输出 | − Q θ 1 ( s , μ ( s ) ) -Q_{\theta_1}(s,\mu(s)) −Qθ1(s,μ(s)) |
| TD3 | 双 Q 取小值,动作加平滑噪声 | − Q θ 1 ( s , μ ( s ) ) -Q_{\theta_1}(s,\mu(s)) −Qθ1(s,μ(s)) |
| SAC | 双 Q 取小值,再减熵项 | α log π ϕ ( a ∣ s ) − min i Q θ i ( s , a ) \alpha\log\pi_\phi(a \mid s) - \min_i Q_{\theta_i}(s,a) αlogπϕ(a∣s)−miniQθi(s,a) |
- 前两代改的始终是 Critic 的标签,Actor 那条损失一动不动,到 SAC 才第一次动 Actor 那一侧:从"最大化 Critic 的打分"变成"最大化打分与熵的加权差",也多出了第三条损失
核心观点:SAC 多出来的那条损失不是补丁,而是最大熵目标的直接产物。两条老损失分别管"价值估得准不准"与"动作改得对不对",新加的一条管"该保留多少随机性",三者各有一个优化器,互不代劳
4-5 训练流程
#mermaid-svg-dk9T4LzM7sxRZUgF{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-dk9T4LzM7sxRZUgF .error-icon{fill:#552222;}#mermaid-svg-dk9T4LzM7sxRZUgF .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-dk9T4LzM7sxRZUgF .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-dk9T4LzM7sxRZUgF .marker{fill:#333333;stroke:#333333;}#mermaid-svg-dk9T4LzM7sxRZUgF .marker.cross{stroke:#333333;}#mermaid-svg-dk9T4LzM7sxRZUgF svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-dk9T4LzM7sxRZUgF p{margin:0;}#mermaid-svg-dk9T4LzM7sxRZUgF .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster-label text{fill:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster-label span{color:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster-label span p{background-color:transparent;}#mermaid-svg-dk9T4LzM7sxRZUgF .label text,#mermaid-svg-dk9T4LzM7sxRZUgF span{fill:#333;color:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF .node rect,#mermaid-svg-dk9T4LzM7sxRZUgF .node circle,#mermaid-svg-dk9T4LzM7sxRZUgF .node ellipse,#mermaid-svg-dk9T4LzM7sxRZUgF .node polygon,#mermaid-svg-dk9T4LzM7sxRZUgF .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-dk9T4LzM7sxRZUgF .rough-node .label text,#mermaid-svg-dk9T4LzM7sxRZUgF .node .label text,#mermaid-svg-dk9T4LzM7sxRZUgF .image-shape .label,#mermaid-svg-dk9T4LzM7sxRZUgF .icon-shape .label{text-anchor:middle;}#mermaid-svg-dk9T4LzM7sxRZUgF .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-dk9T4LzM7sxRZUgF .rough-node .label,#mermaid-svg-dk9T4LzM7sxRZUgF .node .label,#mermaid-svg-dk9T4LzM7sxRZUgF .image-shape .label,#mermaid-svg-dk9T4LzM7sxRZUgF .icon-shape .label{text-align:center;}#mermaid-svg-dk9T4LzM7sxRZUgF .node.clickable{cursor:pointer;}#mermaid-svg-dk9T4LzM7sxRZUgF .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-dk9T4LzM7sxRZUgF .arrowheadPath{fill:#333333;}#mermaid-svg-dk9T4LzM7sxRZUgF .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-dk9T4LzM7sxRZUgF .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-dk9T4LzM7sxRZUgF .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-dk9T4LzM7sxRZUgF .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-dk9T4LzM7sxRZUgF .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-dk9T4LzM7sxRZUgF .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster text{fill:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF .cluster span{color:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-dk9T4LzM7sxRZUgF .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-dk9T4LzM7sxRZUgF rect.text{fill:none;stroke-width:0;}#mermaid-svg-dk9T4LzM7sxRZUgF .icon-shape,#mermaid-svg-dk9T4LzM7sxRZUgF .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-dk9T4LzM7sxRZUgF .icon-shape p,#mermaid-svg-dk9T4LzM7sxRZUgF .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-dk9T4LzM7sxRZUgF .icon-shape .label rect,#mermaid-svg-dk9T4LzM7sxRZUgF .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-dk9T4LzM7sxRZUgF .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-dk9T4LzM7sxRZUgF .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-dk9T4LzM7sxRZUgF :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 采样 Batch
Actor 采样动作与 log_prob
更新熵系数 α
计算 TD 目标
更新双 Critic
更新 Actor
软更新目标 Critic
- SAC 的完整循环如下,一轮里更新三个对象:两个 Critic、Actor、以及对数熵系数
python
# stable_baselines3/sac/sac.py
def train(self, gradient_steps: int, batch_size: int = 64) -> None:
    for gradient_step in range(gradient_steps):
        replay_data = self.replay_buffer.sample(batch_size, env=self._vec_normalize_env)
        discounts = replay_data.discounts if replay_data.discounts is not None else self.gamma

        # 1. 用当前 Actor 采样动作,同时拿到它的对数概率
        actions_pi, log_prob = self.actor.action_log_prob(replay_data.observations)
        log_prob = log_prob.reshape(-1, 1)

        # 2. 更新熵系数:让策略的熵向 target_entropy 靠拢
        if self.ent_coef_optimizer is not None and self.log_ent_coef is not None:
            ent_coef = th.exp(self.log_ent_coef.detach())
            ent_coef_loss = -(self.log_ent_coef * (log_prob + self.target_entropy).detach()).mean()
        else:
            ent_coef = self.ent_coef_tensor

        if ent_coef_loss is not None and self.ent_coef_optimizer is not None:
            self.ent_coef_optimizer.zero_grad()
            ent_coef_loss.backward()
            self.ent_coef_optimizer.step()

        with th.no_grad():
            # 3. 目标价值:双 Q 取最小值,再减去熵项
            next_actions, next_log_prob = self.actor.action_log_prob(replay_data.next_observations)
            next_q_values = th.cat(self.critic_target(replay_data.next_observations, next_actions), dim=1)
            next_q_values, _ = th.min(next_q_values, dim=1, keepdim=True)
            next_q_values = next_q_values - ent_coef * next_log_prob.reshape(-1, 1)
            target_q_values = replay_data.rewards + (1 - replay_data.dones) * discounts * next_q_values

        # 4. 更新两个 Critic:注意这里的动作来自经验池,不是来自当前 Actor
        current_q_values = self.critic(replay_data.observations, replay_data.actions)
        critic_loss = 0.5 * sum(F.mse_loss(current_q, target_q_values) for current_q in current_q_values)
        self.critic.optimizer.zero_grad()
        critic_loss.backward()
        self.critic.optimizer.step()

        # 5. 更新 Actor:最小化"熵项减 Q 值",Q 取两个 Critic 的最小值
        q_values_pi = th.cat(self.critic(replay_data.observations, actions_pi), dim=1)
        min_qf_pi, _ = th.min(q_values_pi, dim=1, keepdim=True)
        actor_loss = (ent_coef * log_prob - min_qf_pi).mean()
        self.actor.optimizer.zero_grad()
        actor_loss.backward()
        self.actor.optimizer.step()

        # 6. 软更新目标 Critic
        if gradient_step % self.target_update_interval == 0:
polyak_update(self.critic.parameters(), self.critic_target.parameters(), self.tau)- 这段代码里有几处与 TD3 的对照值得单独拎出来
- 三条损失对应三次独立的
backward,第 2 步更新熵系数、第 4 步更新 Critic、第 5 步更新 Actor,每一步只动自己的优化器 - SAC 没有 Actor 的目标网络,只有 Critic 的目标网络。Actor 的目标值不需要单独算,因为它的目标已经体现在 Critic 的 TD 目标里了
- 熵系数的更新排在最前面,它用到的
log_prob是这一步开始时对当前 Actor 采样得到的,与第 5 步更新 Actor 时用的是同一个参数版本
- 三条损失对应三次独立的
- 还有一个容易忽略的细节:
train的默认batch_size是 64,但调用方传入的是模型级的batch_size,SB3 里 SAC 的默认值是 256,与 TD3、DDPG 相同。三个算法在这一个超参上是对齐的
核心观点:SAC 把"探索"从外挂的噪声变成了目标函数的一部分,随机策略负责提供随机性,熵项负责决定保留多少,熵系数负责把这份保留量调到合适的位置,三者构成一个自动的闭环
5 实验
5-1 实验说明
- 前四章把三代离策略算法的原理与源码实现都过了一遍,剩下的问题是它们在真实训练里的表现
- 本章用一个受控实验回答两个问题
- 离策略算法相对在策略基线省下来的样本,能不能换算成省下来的时间
- 后一代相对前一代多出来的机制,在这个任务上的代价是多少
- 四个算法臂全部跑在同一块 GPU 上,用的是同一份
SB3 2.8.0
5-1-1 环境与任务的选取
- 环境取
Pendulum-v1,也就是倒立摆 - 选它的理由有三条
- 动作连续:动作是 − 2 , 2 -2, 2 −2,2 区间内的一个力矩,满足离策略算法对连续动作空间的要求,也让确定性策略与随机策略可以直接对比
- 状态维度低:状态是 ( cos θ , sin θ , θ ˙ ) (\cos\theta, \sin\theta, \dot\theta) (cosθ,sinθ,θ˙) 三个量,单集固定 200 步。任务小意味着单次训练足够快,可以在多个算法、多个种子上重复,而不是把全部预算花在一个配置上
- 回报有明确上界:力矩越小越好,最优策略的回报落在 − 130 -130 −130 到 − 120 -120 −120 之间,不需要为了对比人为设定一条及格线
- 这里要交代一句边界:倒立摆适合做算法之间的横向对照,不适合用来说明某个算法更强。它的状态维度只有 3,很多在高维任务上才会暴露的问题在这个规模下不会出现,5-2 的最后一小节会用到这一点
说人话:倒立摆的任务是"把摆杆从下垂位置摆到竖直并稳住",状态少、动作连续、回报有天花板,是拿来做对照实验的合适对象
5-1-2 四个臂与网络量级的统一
- 四个臂是
PPO、DDPG、TD3、SAC,其中PPO(Proximal Policy Optimization,近端策略优化)是在策略基线,另外三个是本章要对照的离策略三代 SB3给这四个算法配的默认网络来自互不相干的历史约定,按本任务的输入维度实际算出的单网络参数量差了一个半数量级
| 算法 | 默认网络 | 单网络参数量 | 出处 |
|---|---|---|---|
| PPO | [64, 64] |
4,547 | PPO 论文的 MuJoCo 设置 |
| SAC | [256, 256] |
67,331 | SAC 与 rlkit 一脉 |
| DDPG | [400, 300] |
122,503 | DDPG 论文正文 |
| TD3 | [400, 300] |
122,503 | 直接继承 DDPG,未做改动 |
- 为减少网络规模对单步耗时比较的干扰,统一网络量级:PPO、SAC 使用
[256, 256],DDPG、TD3 使用[400, 300],最大规模差约 1.8 倍,较原先的 27 倍明显缩小。- DDPG 与 TD3 使用完全相同的网络结构及离策略训练超参(
batch_size=256、learning_rate=1e-3、gamma=0.99、tau=0.005、learning_starts=100、train_freq=1、gradient_steps=1),确保 TD3 改动的对照公平。 - PPO 保留自身默认训练配置:
batch_size=64、学习率3e-4、每次收集 2048 步、更新 10 轮,避免破坏其独特的更新机制。
- DDPG 与 TD3 使用完全相同的网络结构及离策略训练超参(
- 每种算法运行 3 个随机种子(0、1、2),每个种子与环境交互 50,000 步。
5-2 结果分析
5-2-1 探索效率
- 评估回报 是衡量强化学习算法探索效率的一项指标,通过定期评估当前策略在环境中的平均回报,观察算法能否更快找到高回报行为。评估回报上升越快,通常说明算法越早学会获得较高回报的策略。
- 在此任务中,我们每 2,500 个环境步评估一次,每次使用当前策略运行 10 个回合并取平均回报,评估时关闭探索噪声。
- 评估环境统一使用相同随机种子,确保四种算法面对一致的初始状态条件。
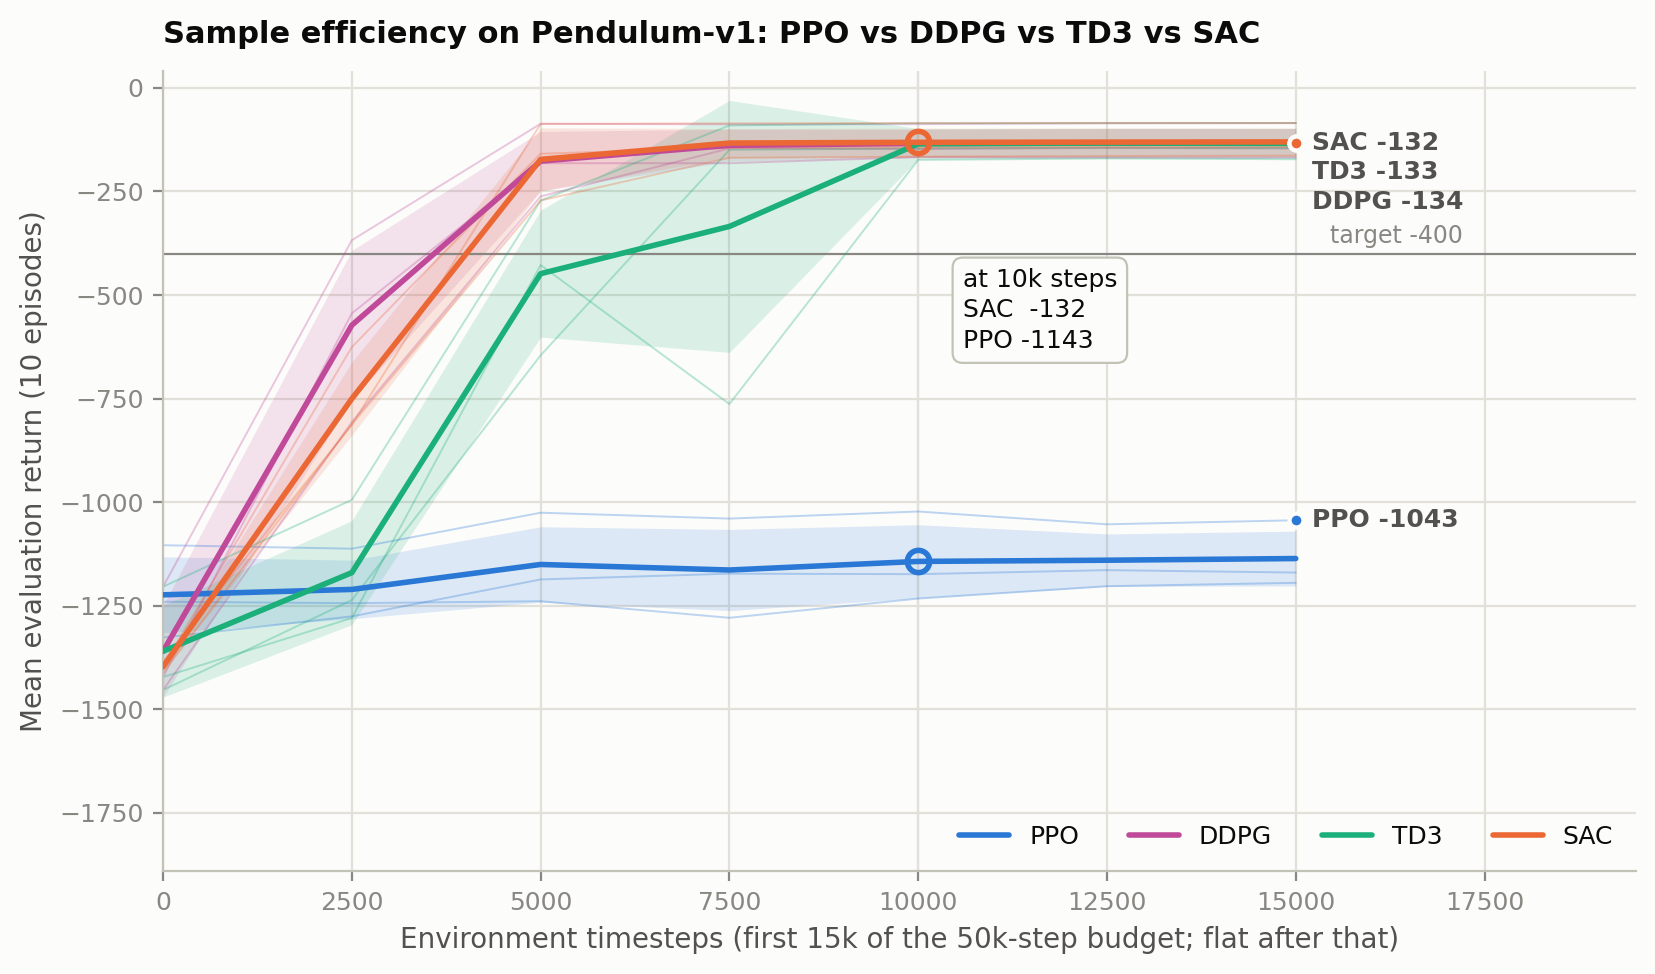
- 可以看出,DDPG、TD3 和 SAC 在约 10,000 步时已收敛至相近回报,PPO 则始终未明显提升。
- 同时在此任务中,由于状态简单,DDPG 的收敛速度快于 SAC,但三个离策略臂的收尾回报几乎并列,差异远小于种子间的波动,所以后面能比较的只有到达同一个目标的快慢。
- 另外,PPO 这一条不能直接读成"它不行":它的每步只做极少量梯度更新,全程更新次数比 SAC 少一个量级,这是更新预算的差距。
5-2-2 样本效率
-
到达目标的步数是衡量样本效率的一项指标,通过统计策略第一次稳定到达某个回报水平所消耗的环境步数,观察算法需要多少交互才能学会任务。步数越少,通常说明样本效率越高。
- 在此任务中,我们先把回报阈值设为 − 400 -400 −400,再取第一次连续 k = 2 k=2 k=2 个评估点都不低于该阈值的步数。用"连续达标"而不是"曾经碰到过",因为要的是一个到手的策略,而不是偶然路过好成绩的策略。
-
同时把阈值从 − 1000 -1000 −1000 扫到 − 200 -200 −200、把 k k k 从 2 加到 3,用来确认排序不依赖这两个选择。
-
可以看出,每一档里
DDPG的柱子最短、TD3最长、SAC居中,PPO只在最低那一档有柱子。 -
每一档的顺序都一致,说明这个排序来自三条学习曲线的相对位置,不依赖阈值与连续点数怎么挑。
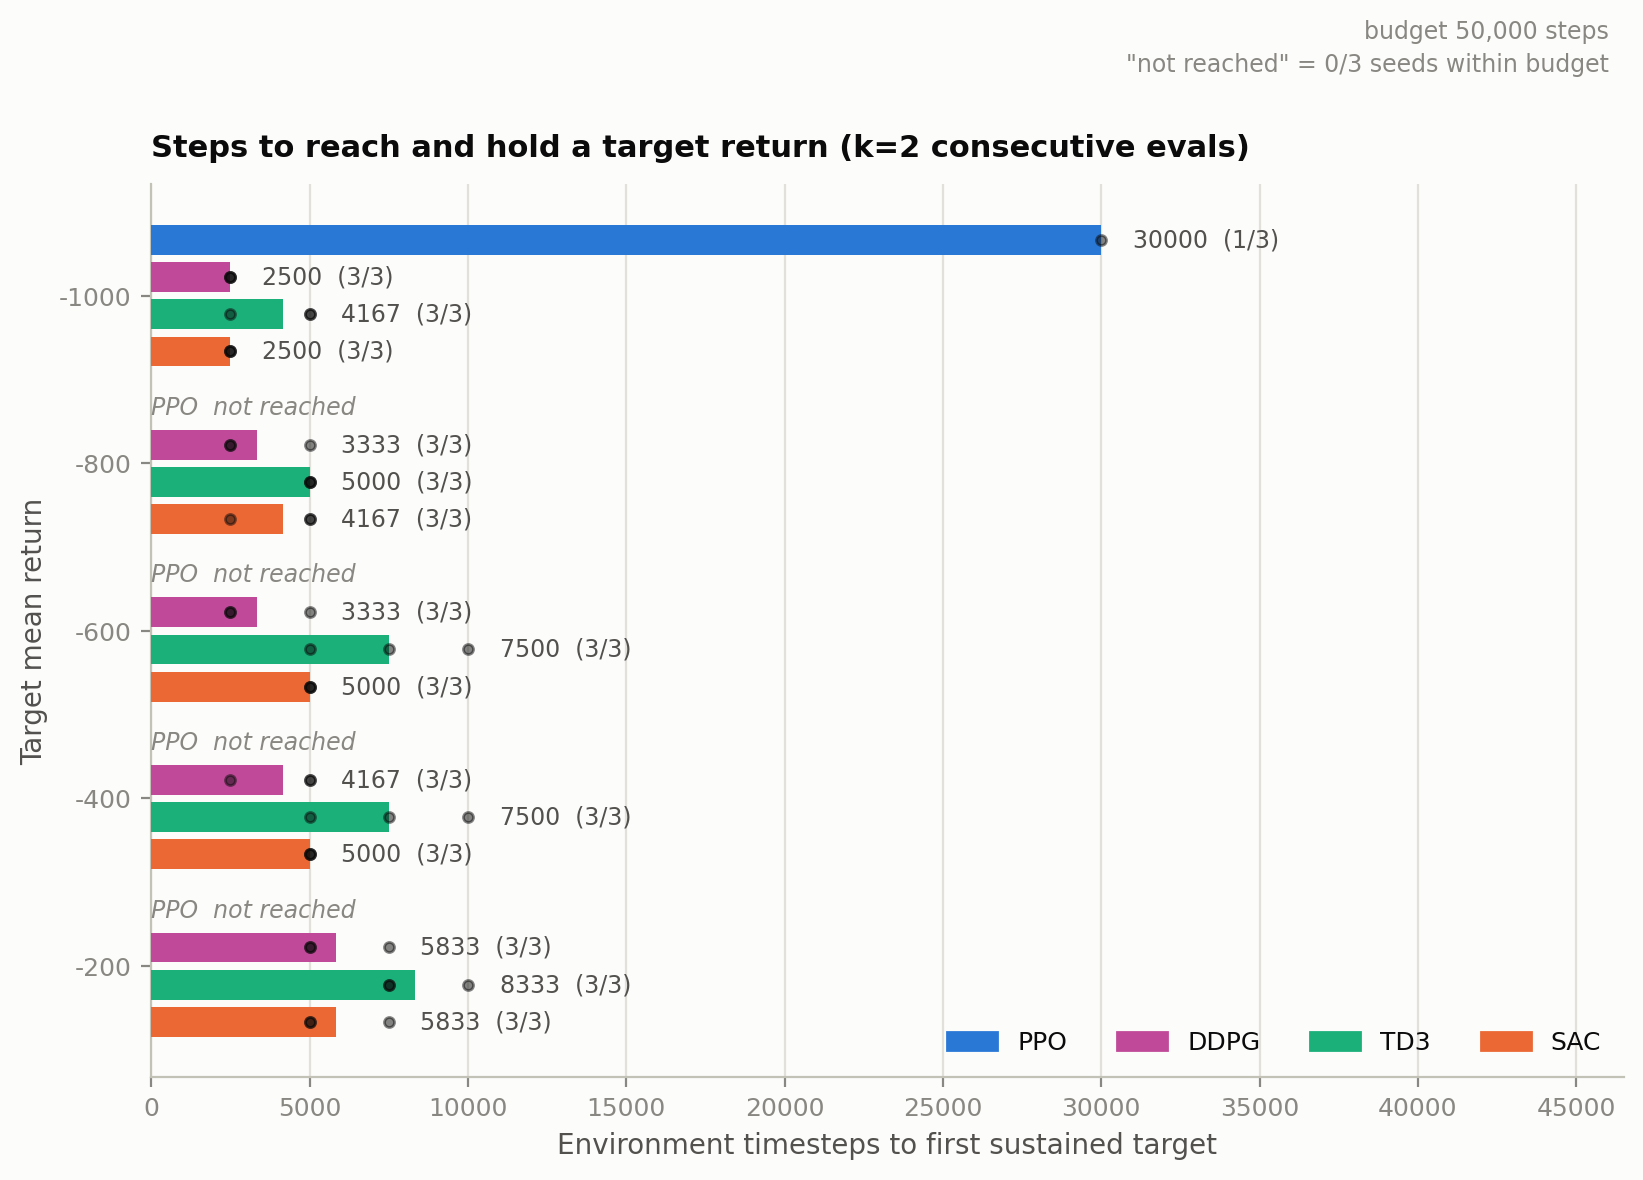
5-2-3 训练墙钟耗时
-
训练墙钟耗时是衡量时间效率的一项指标,通过记录从开始训练到达成目标所花的真实时间,观察省下来的样本有没有变成省下来的时间。耗时越短,通常说明算法在实际使用中越划算。
-
在此任务中,我们记录训练入口的真实墙钟时间,并把评估本身的开销单独扣掉,因为评估是测量行为,不该算进训练成本。
-
左面板四条线的斜率就是每步耗时,
SAC最陡、PPO最平;右面板是到达目标回报的秒数。
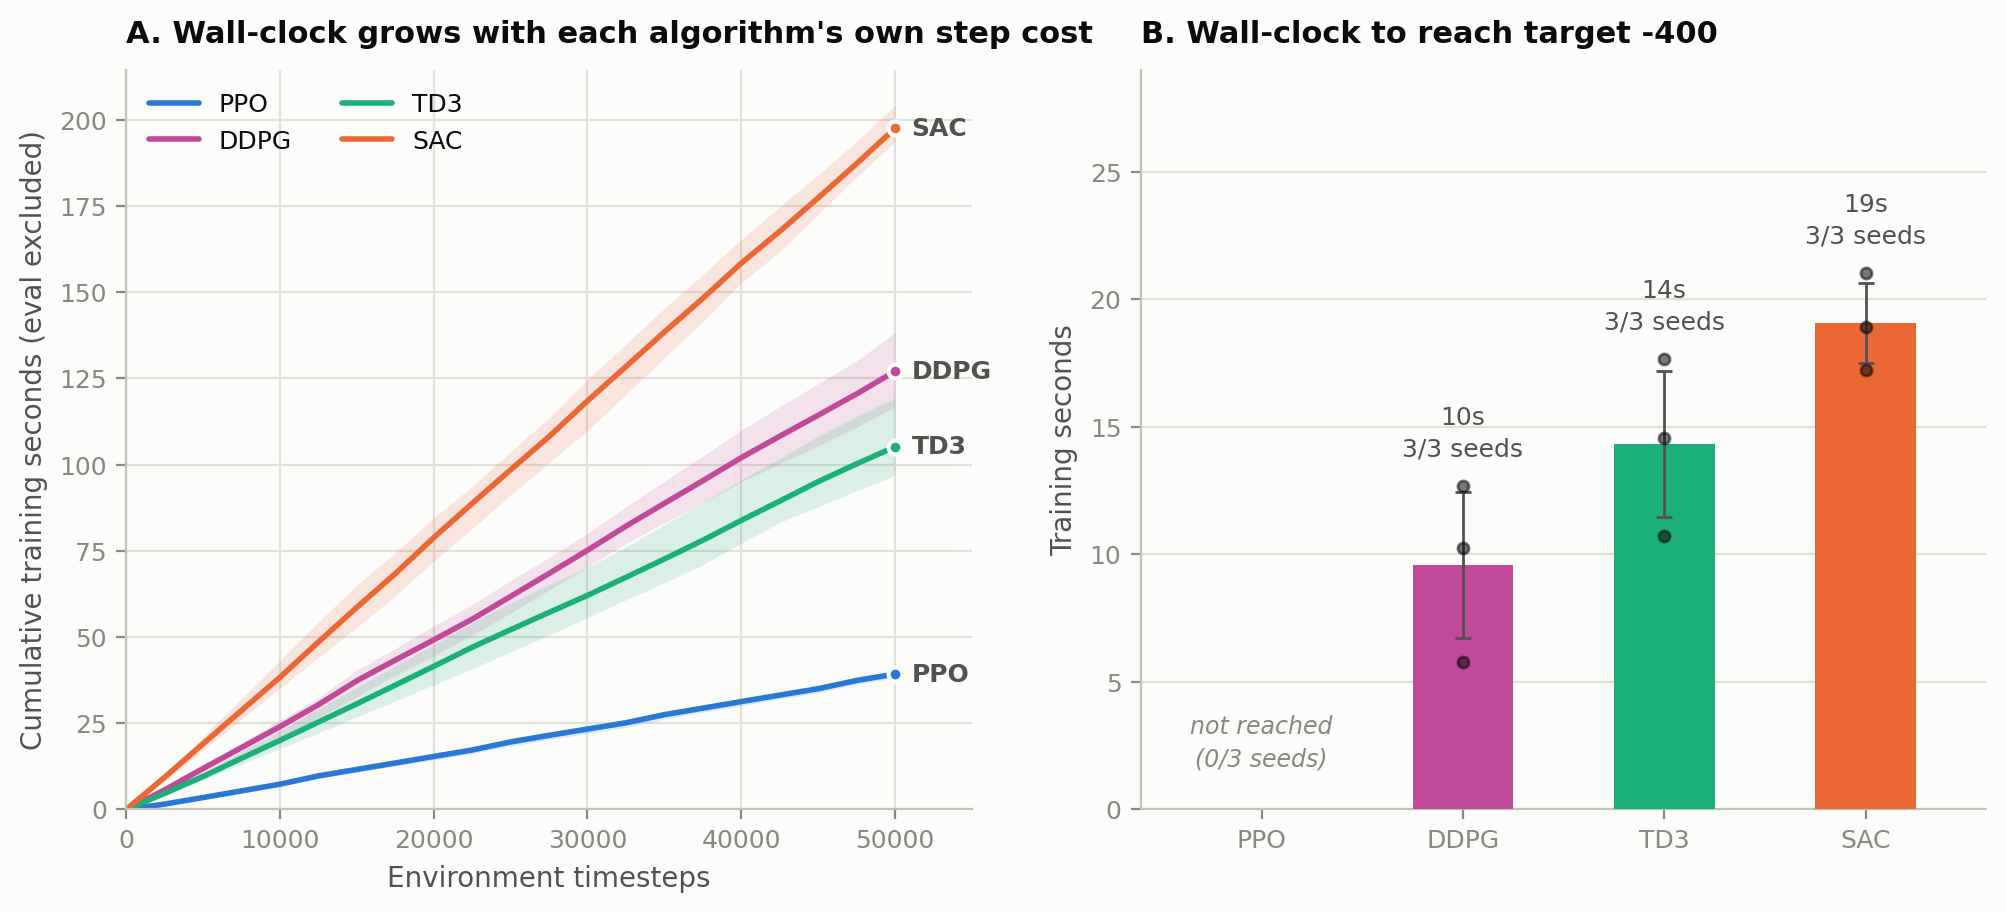
- 可以看出,左右两个排序并不一致:步数上
DDPG领先、TD3垫底,秒数上DDPG仍然领先,但TD3与SAC换了位置。
总结
- 本文从在策略与离策略的区别讲起,逐代拆解了
DDPG、TD3、SAC的原理与SB3源码实现,最后用一个受控实验把三代算法与在策略基线PPO放在同一个环境、同一个交互预算下对照 - 如有错误,欢迎指出!
- 感谢观看!