作者:来自 Elastic Jeffrey Rengifo
被驱逐的容器组往往并不是内存占用增长的那个。本演示从一条针对单个节点的 异常检测 告警出发,一路追踪到工作集发生变化的容器组。
在 EKS、 GKE、 AKS 和 OpenShift 中,结合完整的应用上下文监控集群、容器组和节点。
观看我们的点播网络研讨会:使用 Elastic 和智能体人工智能管理 Kubernetes,提升你的技能。你也可以开始免费云试用,或在本地运行 Elasticsearch。
在一次分阶段加载的负载测试中,一个 Elastic 异常检测作业触发了告警,比 kubelet 设置 MemoryPressure(内存压力)早2分31秒,比首次 HTTP 请求失败早7分29秒。当 MemoryPressure 变为真时, kubelet 已经开始选择要驱逐哪些容器组,而且它选择的并不是消耗了那些内存的容器组。在本次测试中,它驱逐了一个内存占用不足9 MiB 的 NGINX 容器组,导致服务随之 中断 。
当节点上的可用内存或磁盘空间越过 kubelet 的驱逐阈值时, Kubernetes 节点压力就会出现,而针对该状态的告警触发时,留给你采取行动的时间已经很少。异常检测会学习每个节点正常的可用内存水平,在节点仍有余量时标记内存下降,但并非每次下降都能被标记。在第二次测试中,相同的总负载一次性到达,异常得分为4.2,完全没有触发告警。因此,本演示将 low_mean 作业与余量规则以及 Kubernetes OTel 压力规则模板配合使用。节点指标来自 Elastic 的 OpenTelemetry 发行版( EDOT )收集器,排查流程则从实际触发的告警出发,追踪到发生变化的容器组。
前提条件: Elastic、 Kubernetes 和 EDOT 版本
- 启用了机器学习( ML )的 Elastic 部署,并具备异常检测所需的权限和订阅。本演示使用 Elastic 托管云9.5.4。
- 一个允许你安装 Helm 图表的 Kubernetes 集群。示例使用 EDOT 收集器9.5.4和 kube-stack 图表0.16.0。
- Kubernetes OpenTelemetry 资产集成(本例为2.6.0),用于提供下文使用的仪表板和告警规则模板。
你可以在这里找到配套笔记本。它复现了本文的整个实验,包括异常检测作业、驱逐检查以及中间的各个步骤,并在最后执行清理。
Kubernetes 节点压力如何触发驱逐
kubelet 会将 memory.available(可用内存)和 nodefs.available(节点文件系统可用空间)等驱逐信号与阈值进行比较。在 Linux 上,默认硬阈值为 memory.available<100Mi 和 nodefs.available<10%。达到硬阈值会立即驱逐容器组,而达到软阈值则会先启动宽限期。一旦越过其中任一阈值, kubelet 就会设置节点的 MemoryPressure(内存压力)或 DiskPressure(磁盘压力)状态。
kubelet 确定容器组驱逐顺序时,首先考虑其资源用量是否超过请求量,其次考虑容器组优先级,最后考虑用量超出请求量的程度。被驱逐的容器组可能并不是消耗了那些内存的容器组。
下表按从早到晚的顺序列出了本演示使用的三个信号、各自说明的情况,以及触发后应采取的行动:
| 信号 | 说明的情况 | 下一步行动 |
|---|---|---|
| 可用内存偏低异常 | 节点的余量低于其自身基线所预测的水平 | 查找发生了什么变化 |
| 可用内存低于你设置的预警水平 | 剩余容量已接近驱逐阈值 | 与工作负载负责人商定缓解措施 |
MemoryPressure(内存压力)或 DiskPressure(磁盘压力) |
kubelet 已越过驱逐阈值 | 检查驱逐情况并升级处理 |
在一个工作节点上分阶段增加内存占用
测试集群是一个双节点的 kind 集群,运行在内存约为8 GiB 的 Docker 虚拟机上。工作节点的 kubelet 使用适合该虚拟机容量的软驱逐阈值,通过 kind 集群配置中的 kubeadm 配置补丁设置:
markdown
`

1.  kubeletExtraArgs:
2.    eviction-soft: "memory.available<6Gi"
3.    eviction-soft-grace-period: "memory.avai

`AI代码解释
工作节点上运行三个工作负载:
- 一个单副本的 NGINX 部署,没有设置内存请求量,且容器组优先级较低。 k6 探针约每秒向其发起一次请求,并通过 OpenTelemetry( OTel )导出结果。
- 一个压力测试容器组,在两小时的正常基线运行后分配256 MiB 内存。
- 第二个压力测试容器组,约四分半钟后分配1 GiB 内存。
这些内存阈值适用于笔记本电脑规模的实验环境。请根据节点容量和你的 kubelet 配置设置自己的阈值。
第1步:使用 EDOT 收集器收集 Kubernetes 节点指标
按照 Kubernetes 快速入门指南,通过托管 OpenTelemetry 协议( mOTLP )端点安装 EDOT 收集器。在文档中的 Helm 安装配置中添加以下覆盖配置:
yaml
`
1. clusterName: node-pressure-v2
2. collectors:
3. cluster:
4. config:
5. receivers:
6. k8s_cluster:
7. collection_interval: 10s
8. node_conditions_to_report: [Ready, MemoryPressure, DiskPressure]
9. daemon:
10. config:
11. receivers:
12. kubeletstats:
13. collection_interval: 10s
`AI代码解释该覆盖配置将 DiskPressure(磁盘压力)添加到上报的节点状态中,并每10秒采样一次。在此处及后续所有示例中,将 node-pressure-v2 替换为你的集群名称。
在发现页面中,确认以下两个数据流:
metrics-kubeletstatsreceiver.otel-*中,每个k8s.node.name都有最新的k8s.node.memory.available值。metrics-k8sclusterreceiver.otel-*中包含k8s.node.condition_memory_pressure和k8s.node.condition_disk_pressure,其中0表示假,1表示真。
在发现页面中运行以下 Elasticsearch 查询语言( ES|QL )查询,查看所选时间范围内每个节点两种状态的最新值:
less
`

1.  FROM metrics-k8sclusterreceiver.otel-*
2.  | WHERE k8s.cluster.name == "node-pressure-v2"
3.  | STATS memory_pressure = MAX(k8s.node.condition_memory_pressure),
4.      disk_pressure = MAX(k8s.node.condition_disk_pressure),
5.      latest_sample = MAX(@timestamp)
6.  BY k8s.cluster.name, k8s.node.name
7.  | LIMIT 1000

`AI代码解释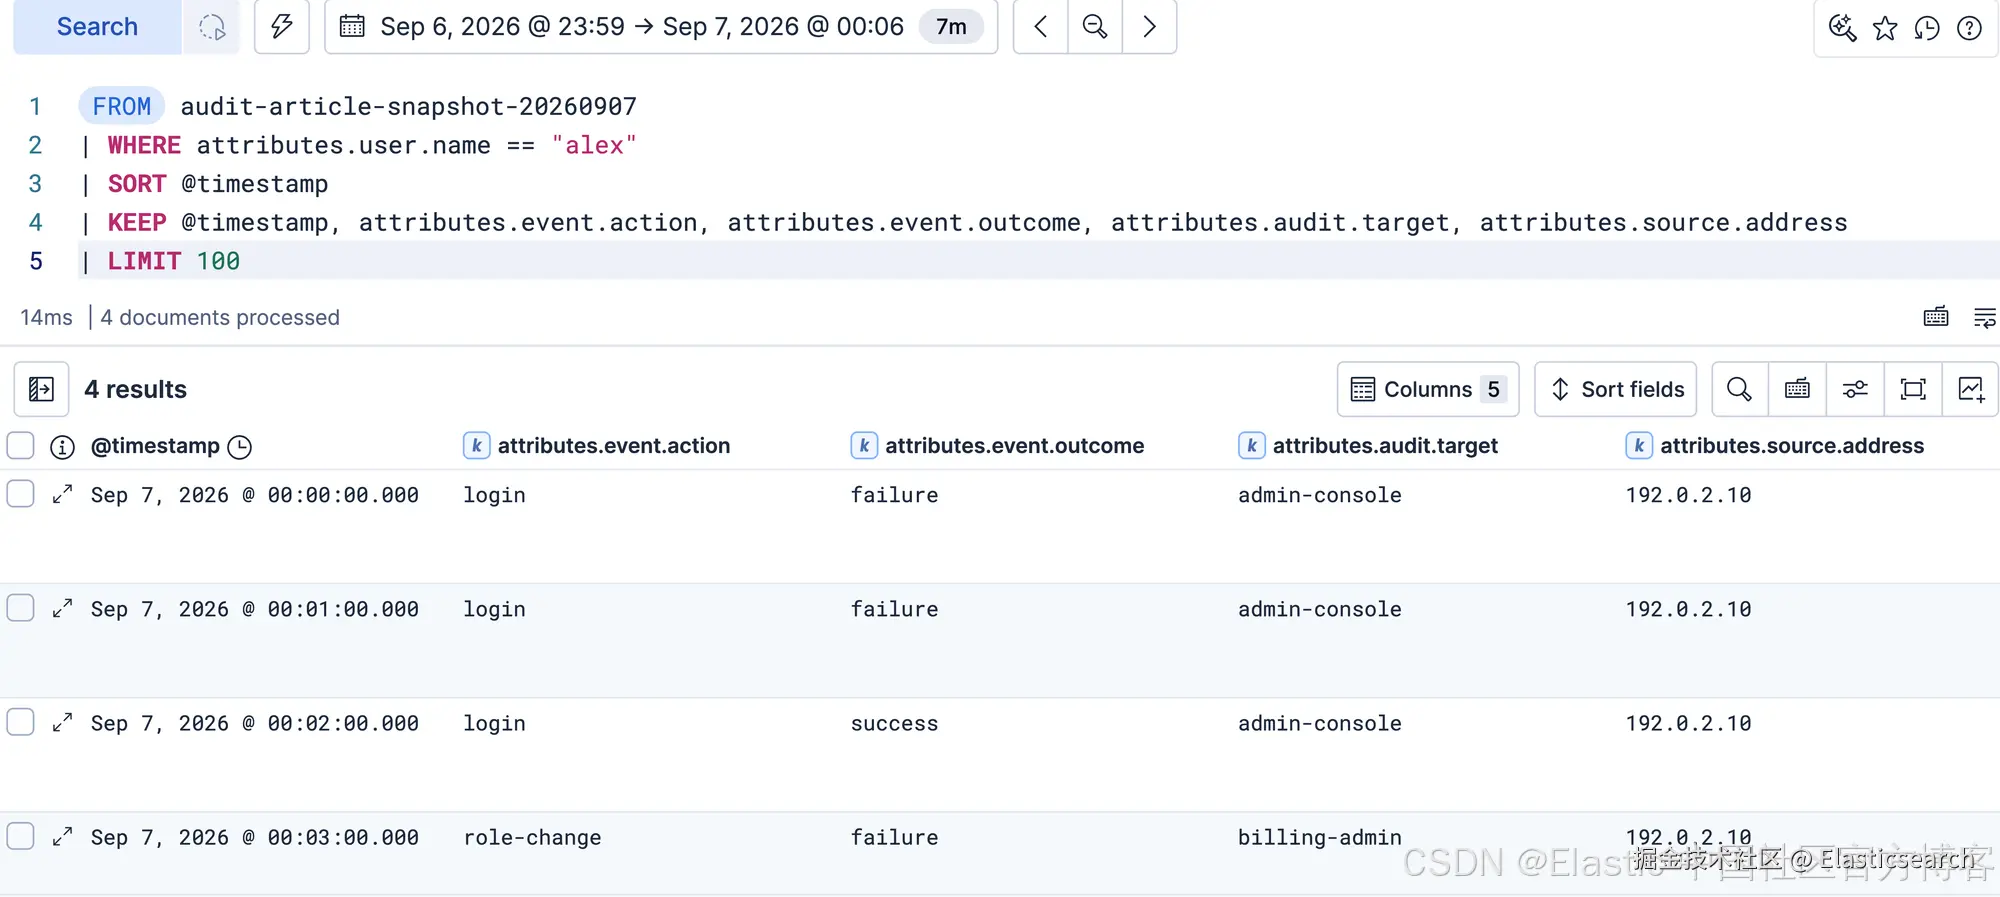
k8s.node.memory.available 跟踪 kubelet 据以采取行动的数值。在测试中,该指标读数为6,093,116 KiB,一秒后 kubelet 记录了一次驱逐,其中包含 available: 6092844Ki。
第2步:为节点内存创建按节点进行异常检测的作业
在开发工具 > 控制台中创建作业及其数据馈送:
bash
`
1. PUT _ml/anomaly_detectors/node-pressure-memory-v2
2. {
3. "analysis_config": {
4. "bucket_span": "1m",
5. "detectors": [{
6. "function": "low_mean",
7. "field_name": "k8s.node.memory.available",
8. "partition_field_name": "k8s.node.name"
9. }],
10. "influencers": ["k8s.node.name"]
11. },
12. "analysis_limits": {"model_memory_limit": "32mb"},
13. "data_description": {"time_field": "@timestamp"},
14. "model_plot_config": {"enabled": true},
15. "datafeed_config": {
16. "datafeed_id": "datafeed-node-pressure-memory-v2",
17. "indices": ["metrics-kubeletstatsreceiver.otel-*"],
18. "query_delay": "20s",
19. "frequency": "10s",
20. "query": {"bool": {"filter": [
21. {"term": {"k8s.cluster.name": "node-pressure-v2"}},
22. {"exists": {"field": "k8s.node.memory.available"}}
23. ]}}
24. }
25. }
`AI代码解释以下设置最为关键:
low_mean仅对平均值异常偏低的时间桶评分,因此节点释放内存不会触发异常。partition_field_name为每个节点建立独立的基线。64 GiB 的节点和8 GiB 的节点不会共用模型。- 1分钟的
bucket_span(时间桶跨度)适合小型集群中每10秒一次的采样。5分钟或15分钟的跨度成本更低,也能平滑节点指标中的噪声,但告警会更晚触发。 - 20秒的
query_delay(查询延迟)为指标到达留出时间,然后再分析时间桶。 model_plot_config存储模型边界,单指标查看器会将其绘制为预期范围。
打开作业,并从节点历史数据的起点启动数据馈送。将起始值替换为第一条 kubeletstats 文档的时间戳:
bash
`

1.  POST _ml/anomaly_detectors/node-pressure-memory-v2/_open
2.  POST _ml/datafeeds/datafeed-node-pressure-memory-v2/_start
3.  {"start":"2026-09-19T18:53:00Z"}

`AI代码解释在机器学习 > 管理作业 中,确认已处理记录数持续增加。如果通过 API 创建的作业未出现在列表中,请选择同步已保存对象。
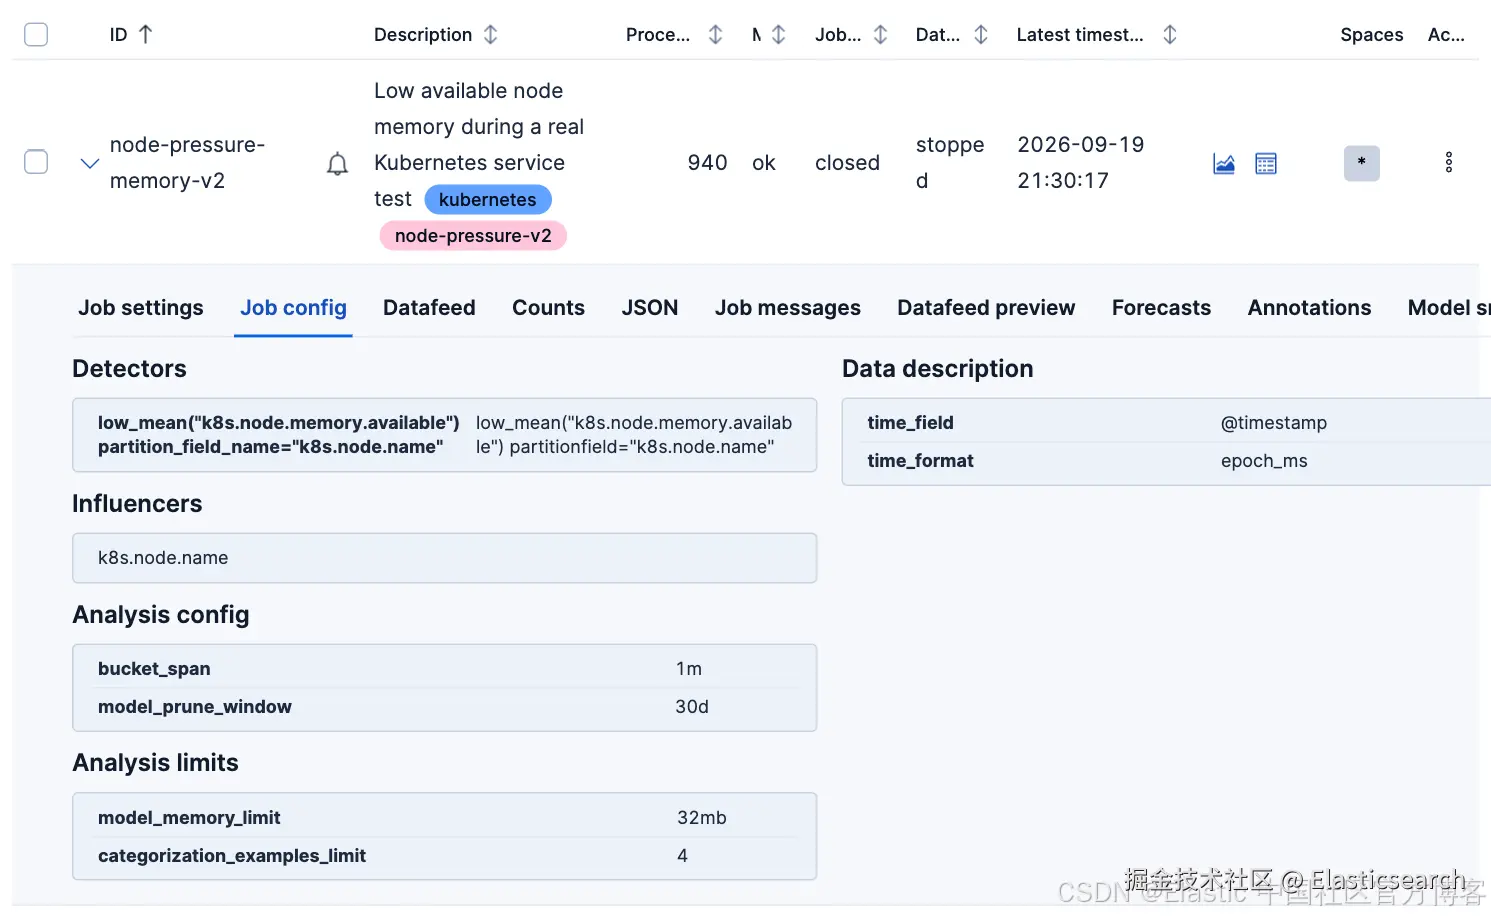
均值检测器至少需要八个非空时间桶或两小时的数据,以要求更高者为准。在生产环境中,应让模型学习完整的工作负载周期,包括预期的繁忙时段。
第3步:基于异常得分创建告警规则
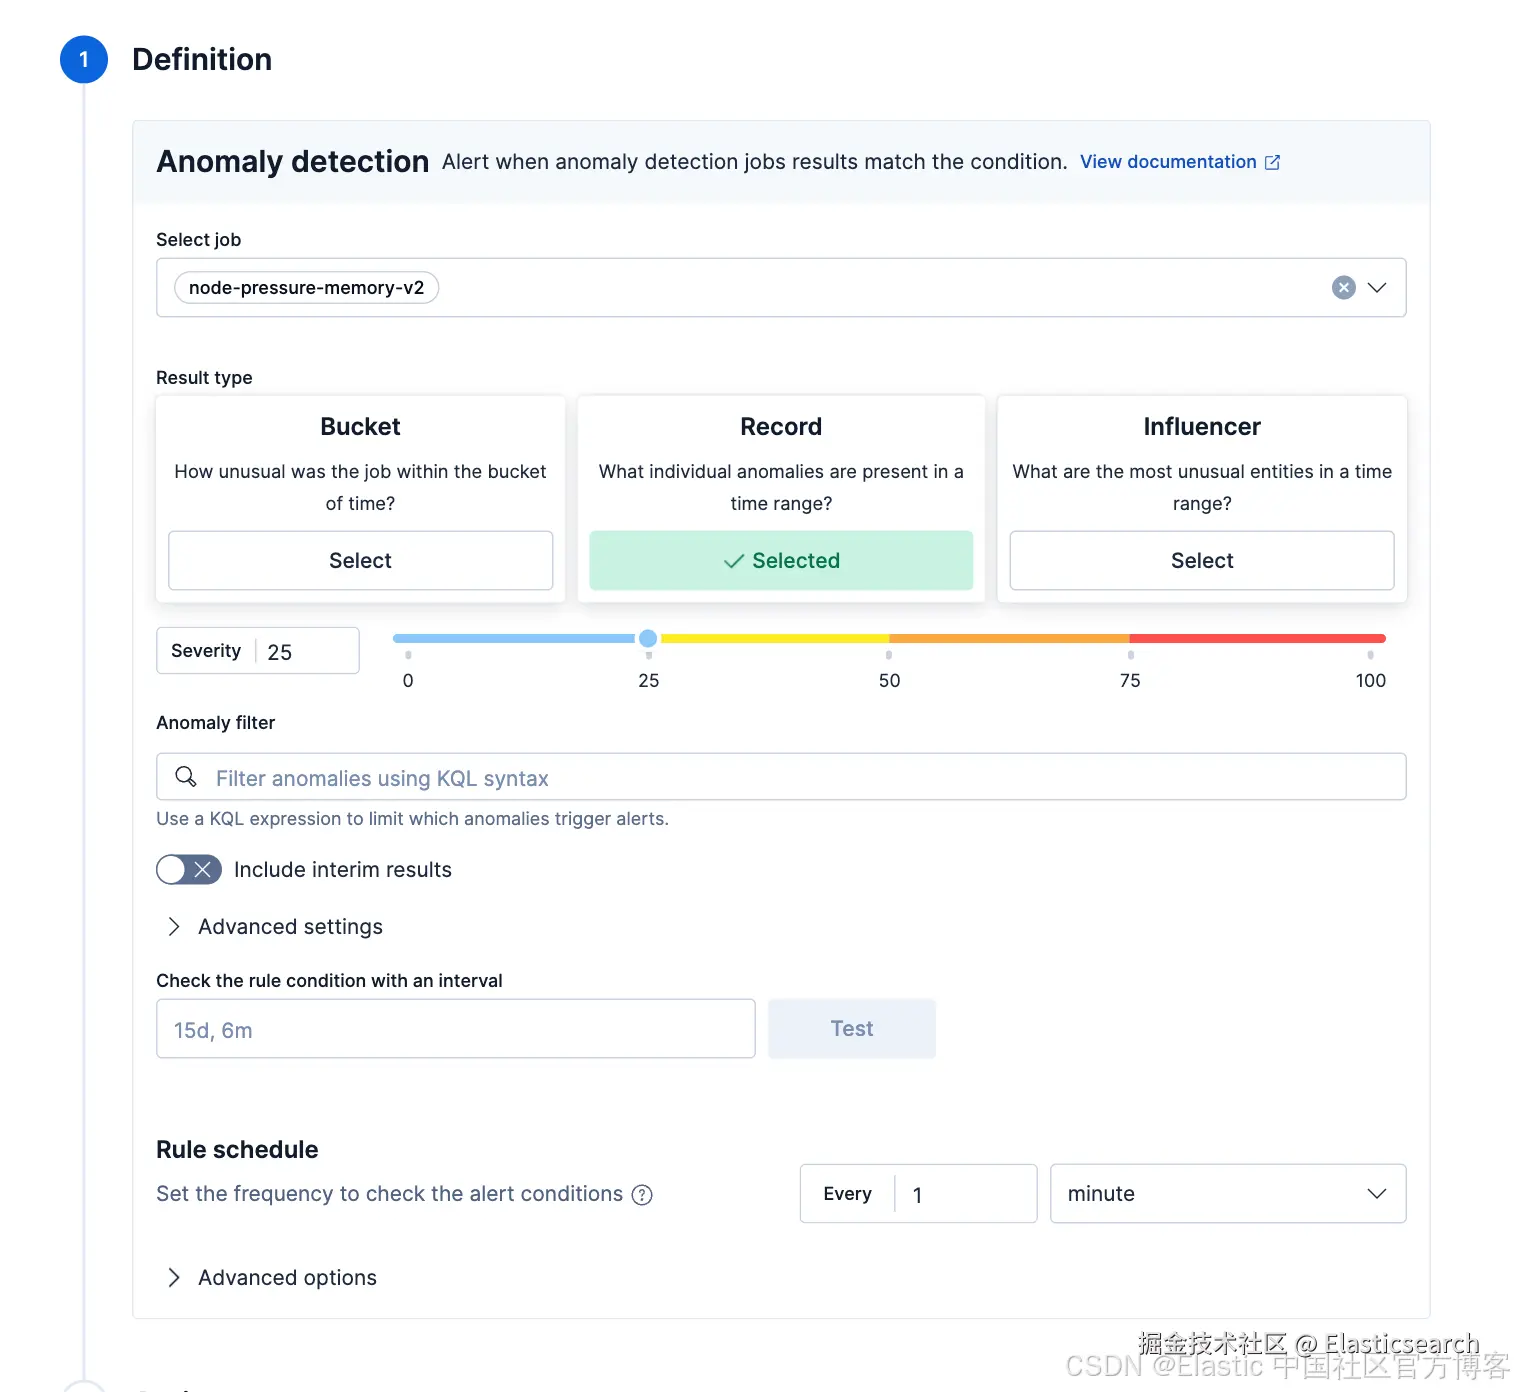
打开堆栈管理 > 规则 > 创建规则 ,选择异常检测,将节点压力第2版规则命名为"内存余量异常",并选择作业。使用以下设置:
| 设置 | 值 | 原因 |
|---|---|---|
| 结果类型 | 记录 | 评估每个节点自身的异常 |
| 严重程度阈值 | 25 | 异常浏览器中25--50区间的下限 |
| 包含临时结果 | 关闭 | 仅评估已最终确定的时间桶 |
| 检查间隔 | 1分钟 | 与作业的时间桶跨度一致 |
异常得分介于0到100之间,用于衡量某个时间桶对该节点而言有多异常。请根据集群中的日常变化调整阈值。
添加一个连接器和一个操作,让告警发送到 Slack、电子邮件或 PagerDuty。在消息中包含异常检测操作变量中的 {{context.anomalyExplorerUrl}} 和 {{context.topRecords}},使通知能够直接链接到受影响的节点。
第4步:添加针对 Kubernetes 余量和压力状态的告警规则
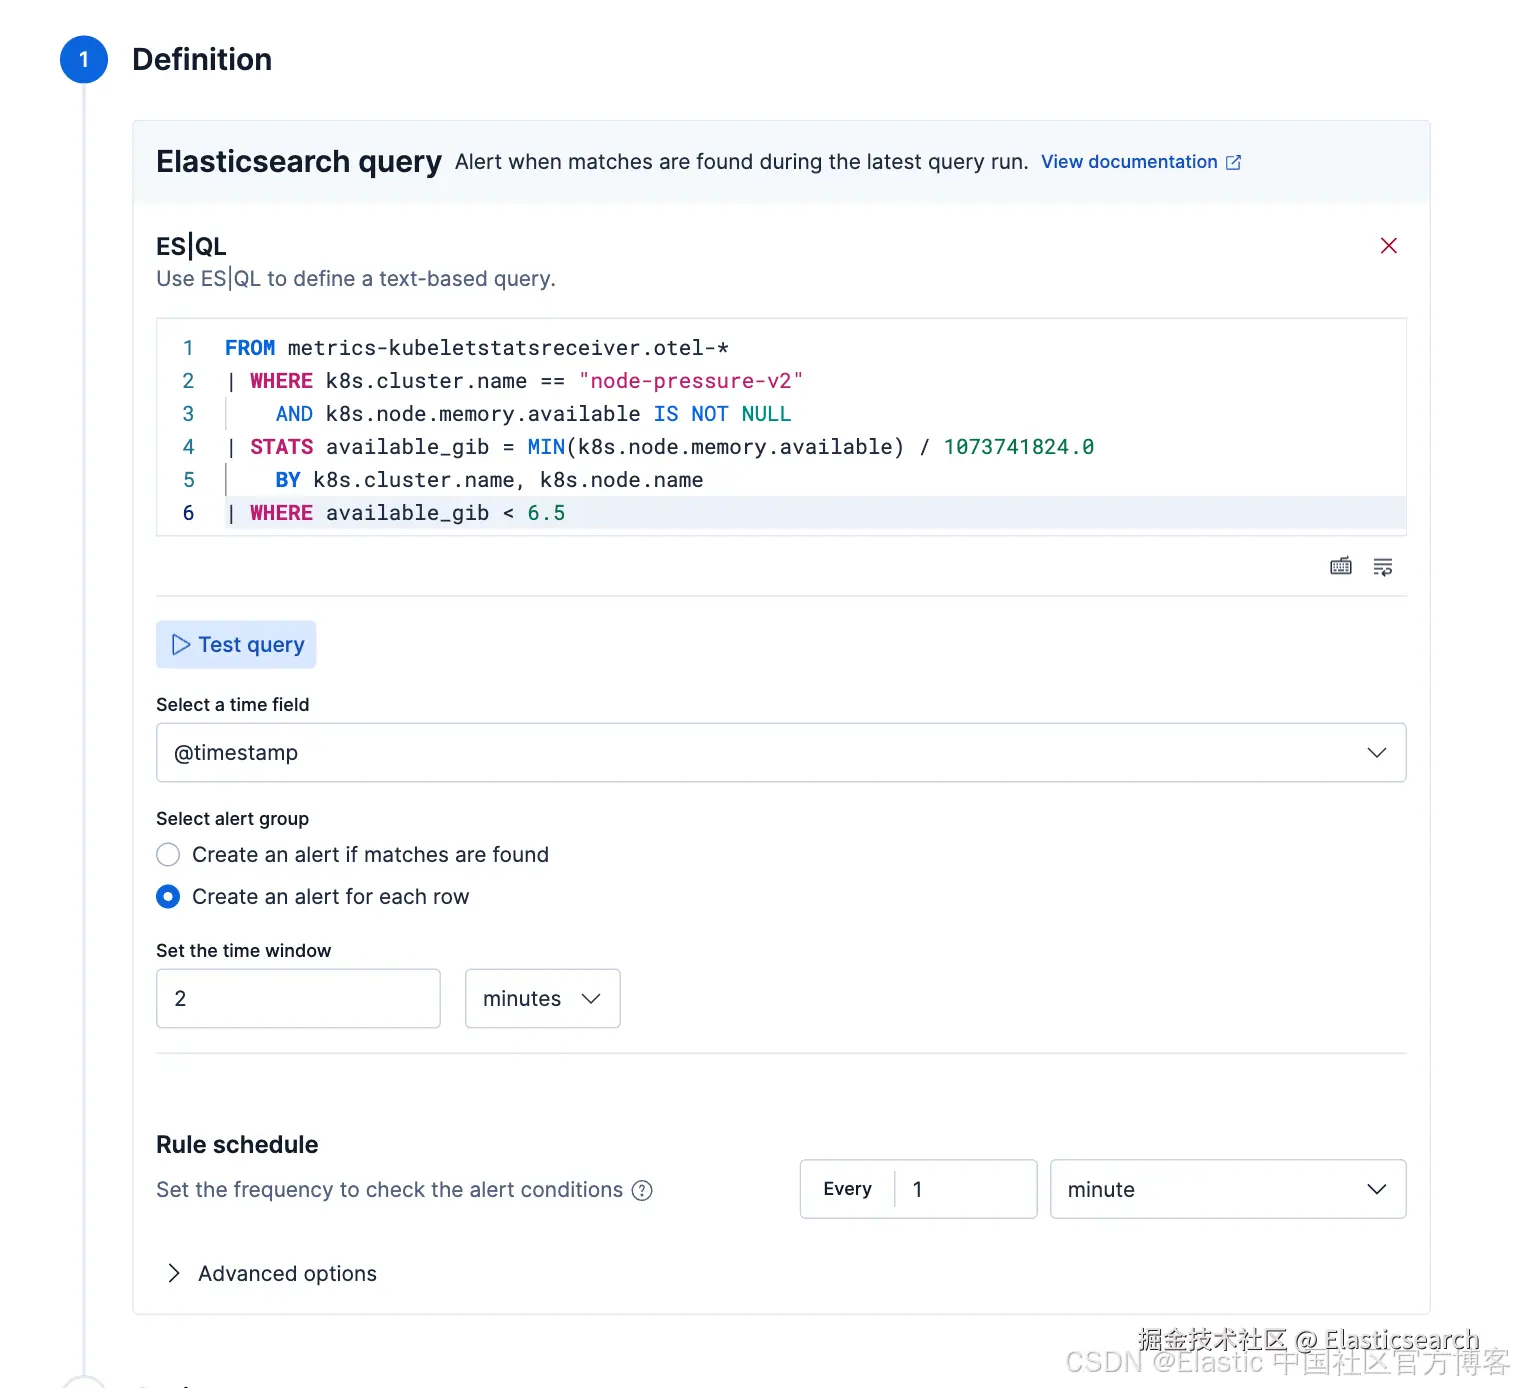
以正常速度增长的工作负载也可能耗尽节点资源,而不会产生较高的异常得分。使用采用以下 ES|QL 查询的 Elasticsearch 查询规则来覆盖这种情况:
sql
`

1.  FROM metrics-kubeletstatsreceiver.otel-*
2.  | WHERE k8s.cluster.name == "node-pressure-v2"
3.  AND k8s.node.memory.available IS NOT NULL
4.  | STATS available_gib = MIN(k8s.node.memory.available) / 1073741824.0
5.  BY k8s.cluster.name, k8s.node.name
6.  | WHERE available_gib < 6.5

`AI代码解释
将规则命名为"节点压力第2版:内存余量预警",将时间字段设为 @timestamp,选择为每一行创建告警,并使用两分钟的时间窗口,每分钟检查一次。6.5 GiB 的预警水平比该场景的软驱逐阈值高0.5 GiB。请根据两次规则运行之间内存可能下降的速度,设置自己的余量。
然后在创建规则 > 模板中创建状态规则:Kubernetes OTel 节点内存压力和 Kubernetes OTel 节点磁盘压力。在每个模板的 TS 数据源行之后添加以下行,使规则仅评估你的集群:
ini
`| WHERE k8s.cluster.name == "node-pressure-v2"`AI代码解释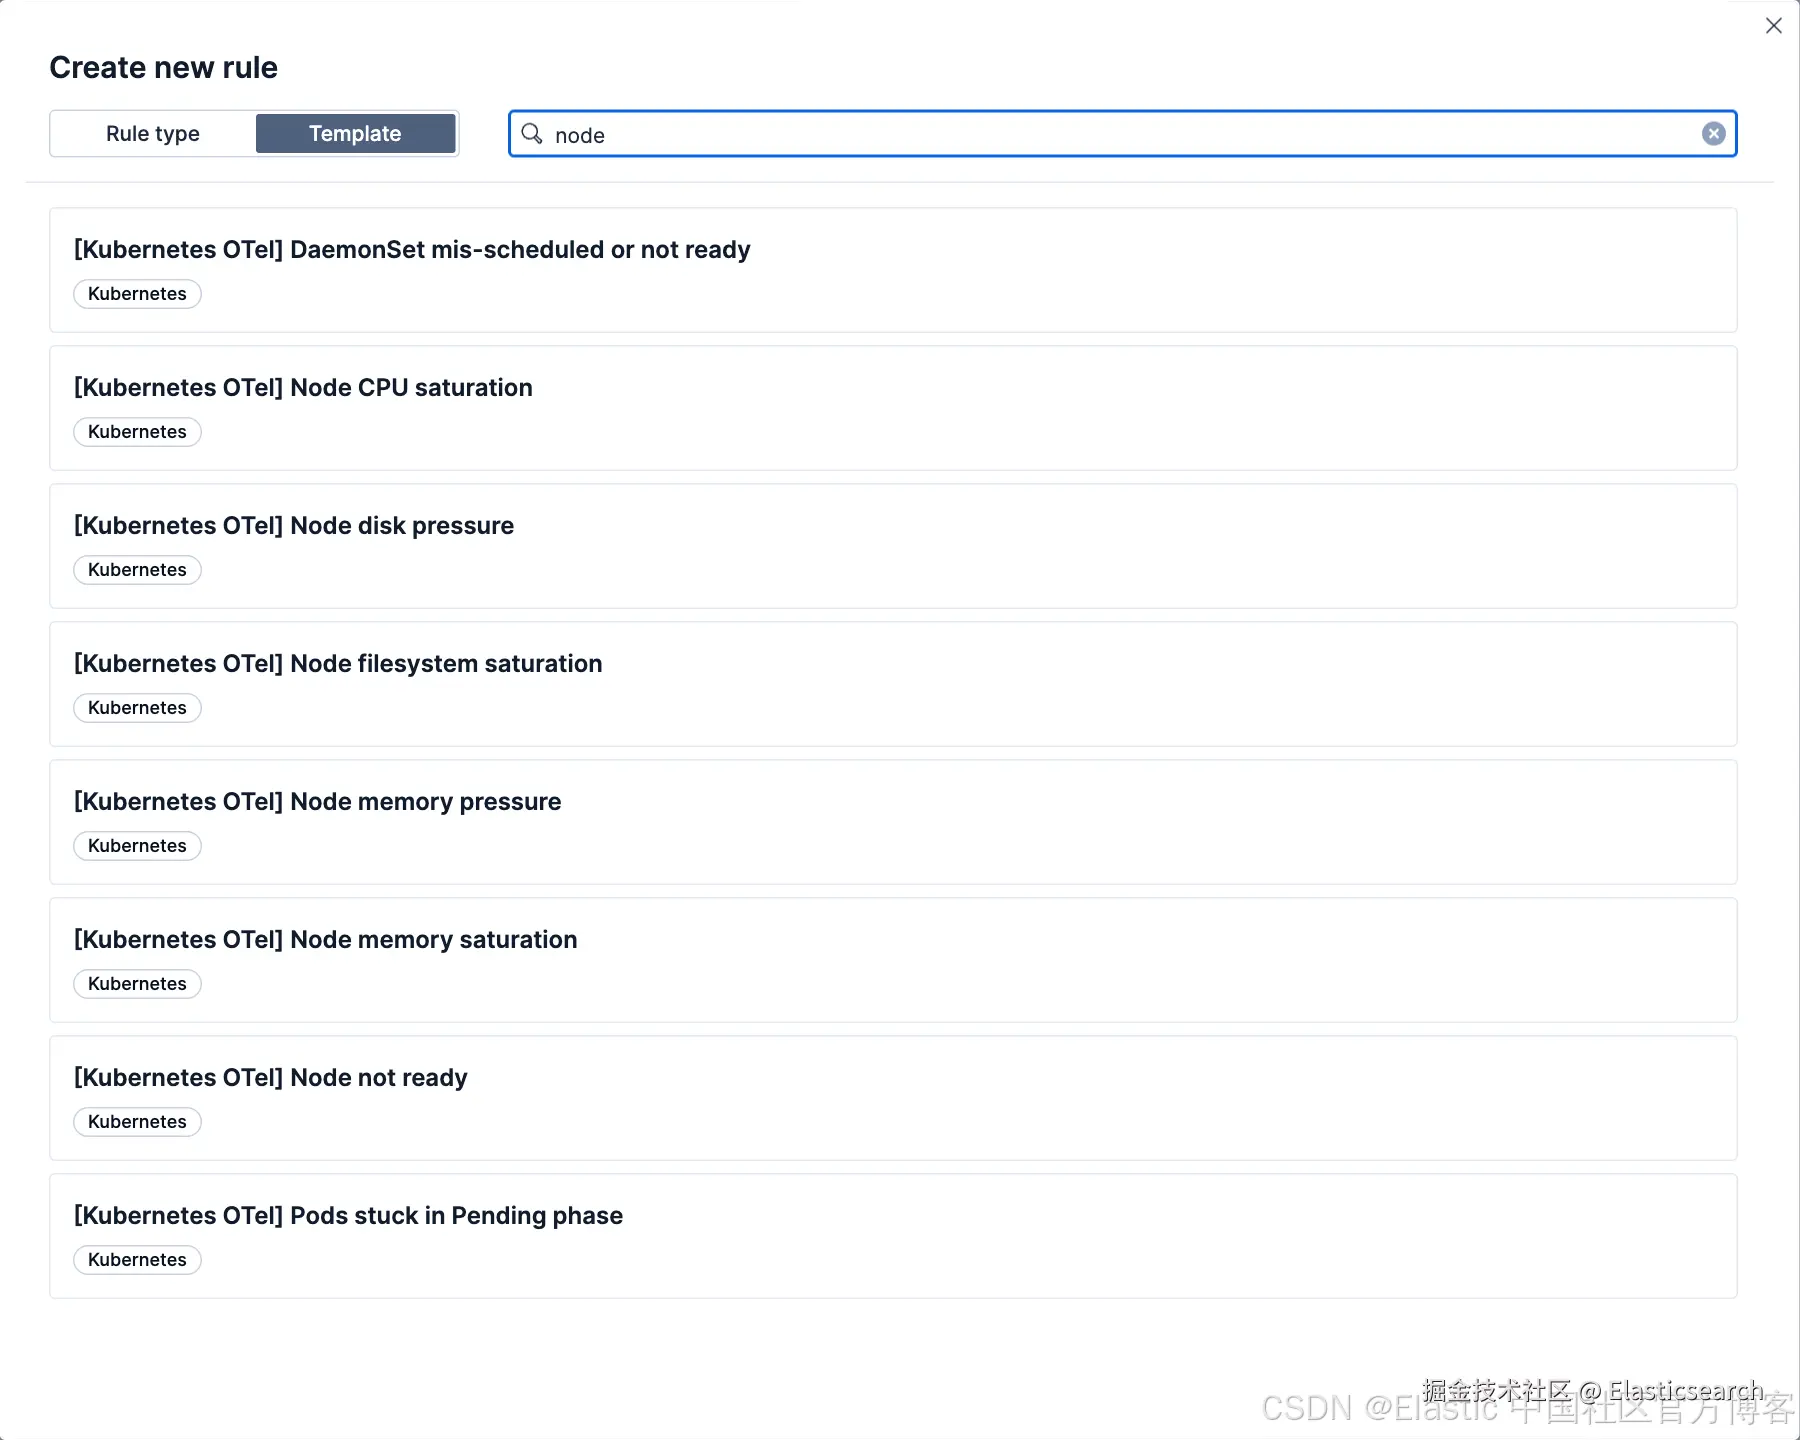
模板默认等待连续三次匹配后才触发告警。本演示将告警延迟设为一次匹配,因为软驱逐宽限期可能短于三次规则运行所需的时间。Elastic 集成中的告警规则模板更详细地介绍了时间窗口、运行计划和告警延迟设置。
第5步:在驱逐发生前排查 Kubernetes 节点压力预警
当异常告警或余量告警触发时,按以下流程处理:
- 查看异常,确定节点和内存下降幅度。
- 找出内存发生变化的容器组。
- 检查 kubelet 会优先驱逐哪些容器组。
- 与工作负载负责人一起采取缓解措施。
- 从节点和服务两方面验证是否恢复。
查看异常记录,找出受影响的节点
打开机器学习 > 异常浏览器 ,选择作业和告警的时间范围。然后在异常记录中找到 k8s.node.name。比较实际值 和典型值 列。将表格时间间隔设为显示全部,以便每个时间桶显示一行。
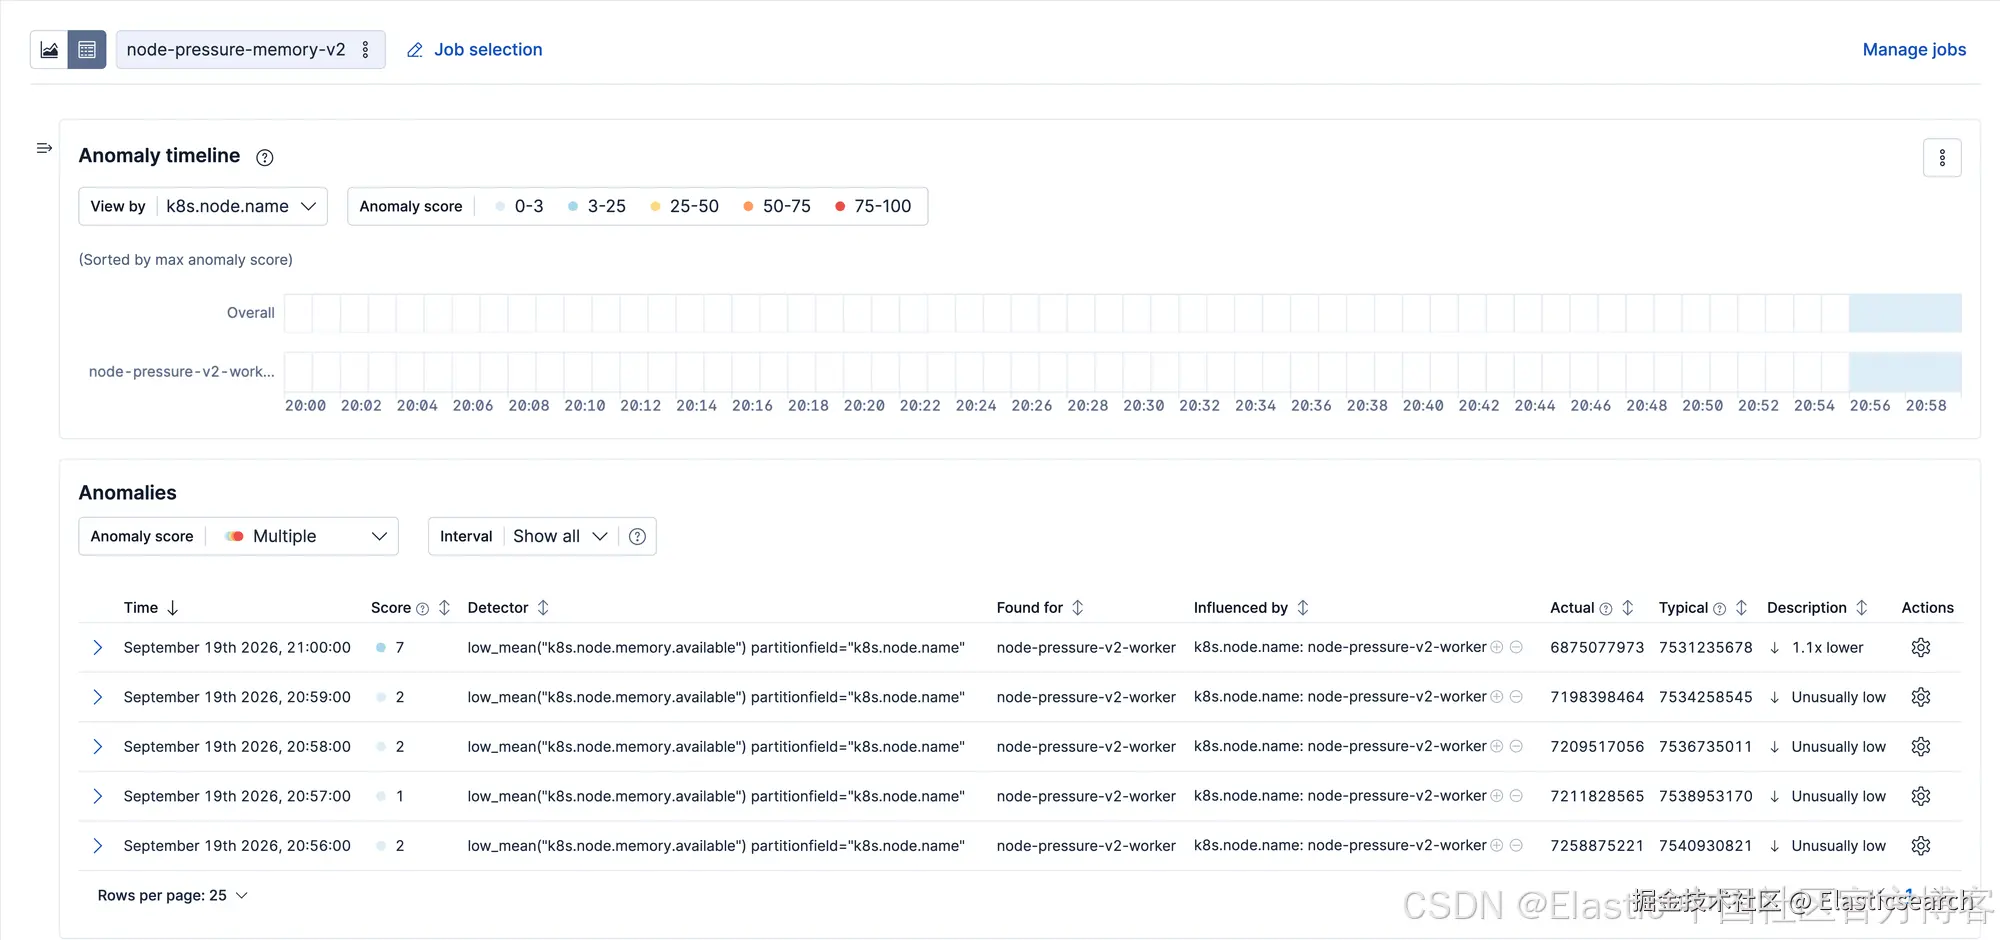
在该场景中,20:56时间桶的平均可用内存为6.76 GiB,典型值为7.02 GiB,规则评估出的异常得分为30。此时,内存压力状态仍为假,节点可用内存也高于6.5 GiB 的余量预警水平。所有 HTTP 请求均成功。
这张运行结束后截取的截图中,同一时间桶的得分 列显示为2。随着模型接收更多数据,异常得分会重新归一化,结果部分将对此进行说明。
哪个容器组导致了 Kubernetes 节点压力?
打开 Kubernetes OTel 节点详情仪表板,按告警对应的集群和节点进行筛选。然后按平均内存工作集对容器组表格排序。
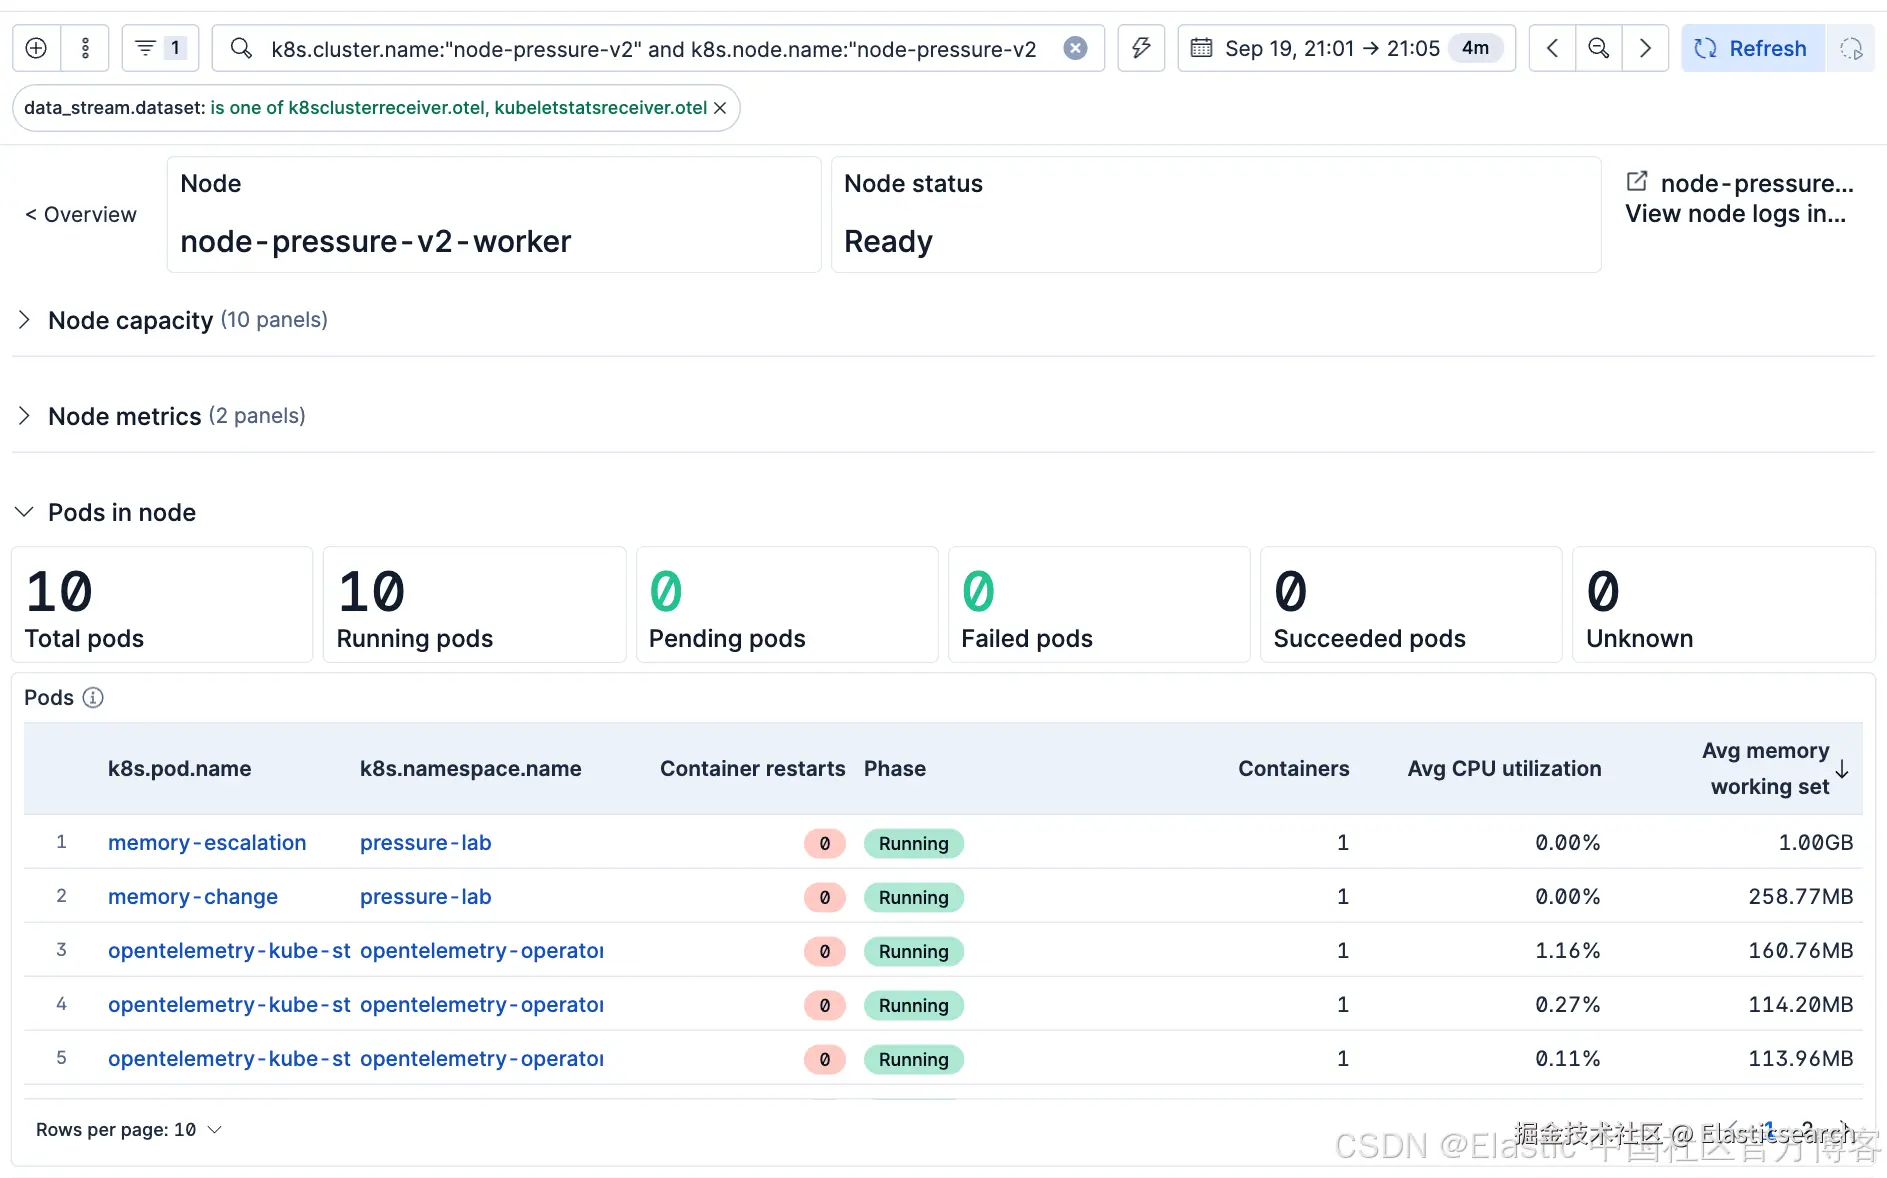
内存占用最大的容器组和内存发生变化的容器组可能并不是同一个。以下查询将每个容器组最近五分钟的数据与其先前的基线进行比较:
sql
`
1. FROM metrics-kubeletstatsreceiver.otel-*
2. | WHERE k8s.cluster.name == "node-pressure-v2"
3. AND k8s.node.name == "node-pressure-v2-worker"
4. AND k8s.pod.memory.working_set IS NOT NULL
5. AND @timestamp >= NOW() - 1 hour
6. | STATS
7. recent = AVG(k8s.pod.memory.working_set) WHERE @timestamp >= NOW() - 5 minutes,
8. baseline = AVG(k8s.pod.memory.working_set) WHERE @timestamp < NOW() - 15 minutes
9. BY k8s.namespace.name, k8s.pod.name
10. | EVAL recent_mib = ROUND(recent / 1048576, 1),
11. baseline_mib = ROUND(COALESCE(baseline, 0) / 1048576, 1)
12. | EVAL change_mib = ROUND(recent_mib - baseline_mib, 1)
13. | WHERE recent_mib IS NOT NULL
14. | SORT change_mib DESC
15. | LIMIT 5
`AI代码解释两个时间窗口之间留出10分钟的间隔,可以避免将新容器组最初几分钟的数据纳入其基线。在该场景的告警触发两分钟后,查询返回 memory-change,其 change_mib 为246.8,而节点上其他所有容器组与各自基线的差值都在1 MiB 以内。
接下来,列出节点上的容器组及其服务质量( QoS )类别和优先级:
ini
`

1.  kubectl get pods -A --field-selector spec.nodeName=node-pressure-v2-worker \
2.    -o custom-columns=NS:.metadata.namespace,NAME:.metadata.name,QOS:.status.qosClass,PRIORITY:.spec.priority

`AI代码解释BestEffort(尽力而为)容器组,以及资源用量超过请求量的低优先级容器组,会被优先驱逐。如果其中某个容器组承载的是单副本服务,宽限期结束时,该服务就会中断。
与工作负载负责人一起采取缓解措施,并验证恢复情况
如果余量稳定,且变化符合预期,请继续观察节点,并审查告警阈值。如果可用内存持续下降、逼近驱逐阈值,请与工作负载负责人商定以下措施之一:
- 停止可选工作负载或缩减其规模。
- 回滚导致内存用量增加的部署变更。
- 增加节点容量,并以受控方式迁移工作负载。
然后从两方面确认恢复情况:可用内存回到典型范围,服务请求成功。此外,还应确认响应过程中没有容器组被驱逐。以下查询读取由 k8s_events 接收器收集的驱逐事件:
vbnet
`

1.  FROM logs-k8seventsreceiver.otel-*
2.  | WHERE k8s.cluster.name == "node-pressure-v2"
3.      AND k8s.event.reason == "Evicted"
4.  | KEEP @timestamp, k8s.object.name, k8s.event.reason, body.text
5.  | SORT @timestamp
6.  | LIMIT 1000

`AI代码解释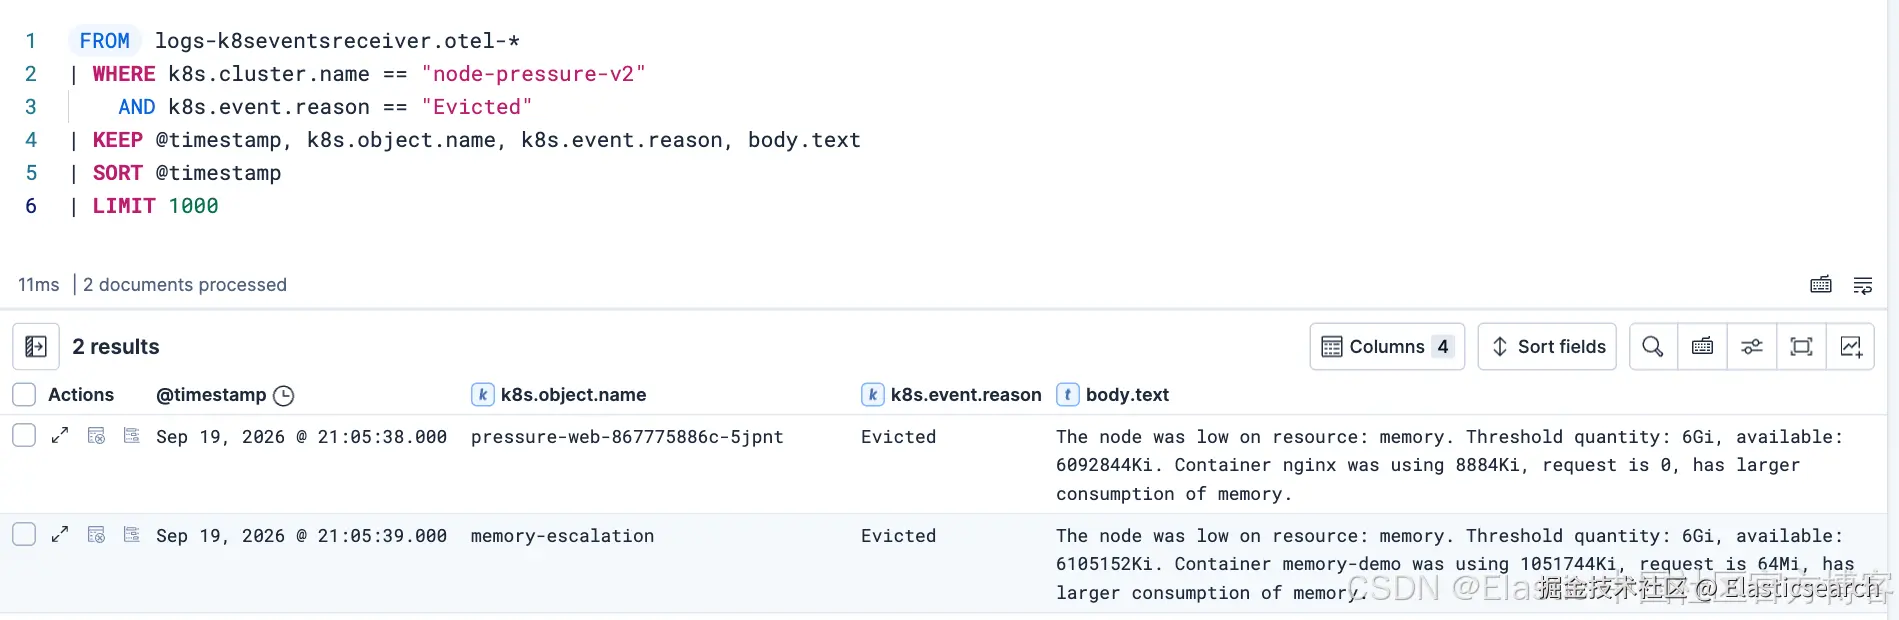
在不采取干预措施的情况下运行该场景时, kubelet 首先驱逐 NGINX 容器组,消息为"容器 nginx 使用了8884 Ki,请求量为0"。一秒后,分配了1 GiB 内存的 memory-escalation 容器组也被驱逐。被驱逐的 NGINX 容器组内存占用不足9 MiB,但其驱逐导致了服务中断。
压力状态的解除晚于内存恢复。在信号回升至阈值以上后, kubelet 仍会维持 MemoryPressure(内存压力)状态,持续时间由 eviction-pressure-transition-period(驱逐压力状态转换期)决定,默认为五分钟。
异常检测能在容器组驱逐前多久发出预警?
异常告警比 MemoryPressure(内存压力)出现早2分31秒,比首次请求失败早7分29秒,但只有在内存占用逐步增长时才会如此。该场景运行了两次。第一次运行中,负载持续存在,直到 kubelet 驱逐容器组。第二次运行中,两次内存分配同时开始,由于没有触发异常告警,因此在余量告警触发后移除了负载。
| 事件 | 第一次运行:负载持续 | 第二次运行:移除负载 |
|---|---|---|
| 负载开始 | 20:56:03(256 MiB ),21:00:29(1 GiB ) | 21:12:35(两者同时) |
| 首个最终确定的异常得分 | 30.1 | 4.2 |
| 异常告警 | 20:58:09 | 无 |
| 内存压力状态变为真 | 21:00:40 | 21:12:45 |
| 余量告警 | 21:01:21 | 21:13:21 |
| 首次驱逐和请求失败 | 21:05:38 | 无 |
| 移除负载 | 21:06:54 | 21:15:52 |
| 内存压力状态解除 | 21:10:53 | 21:20:45 |
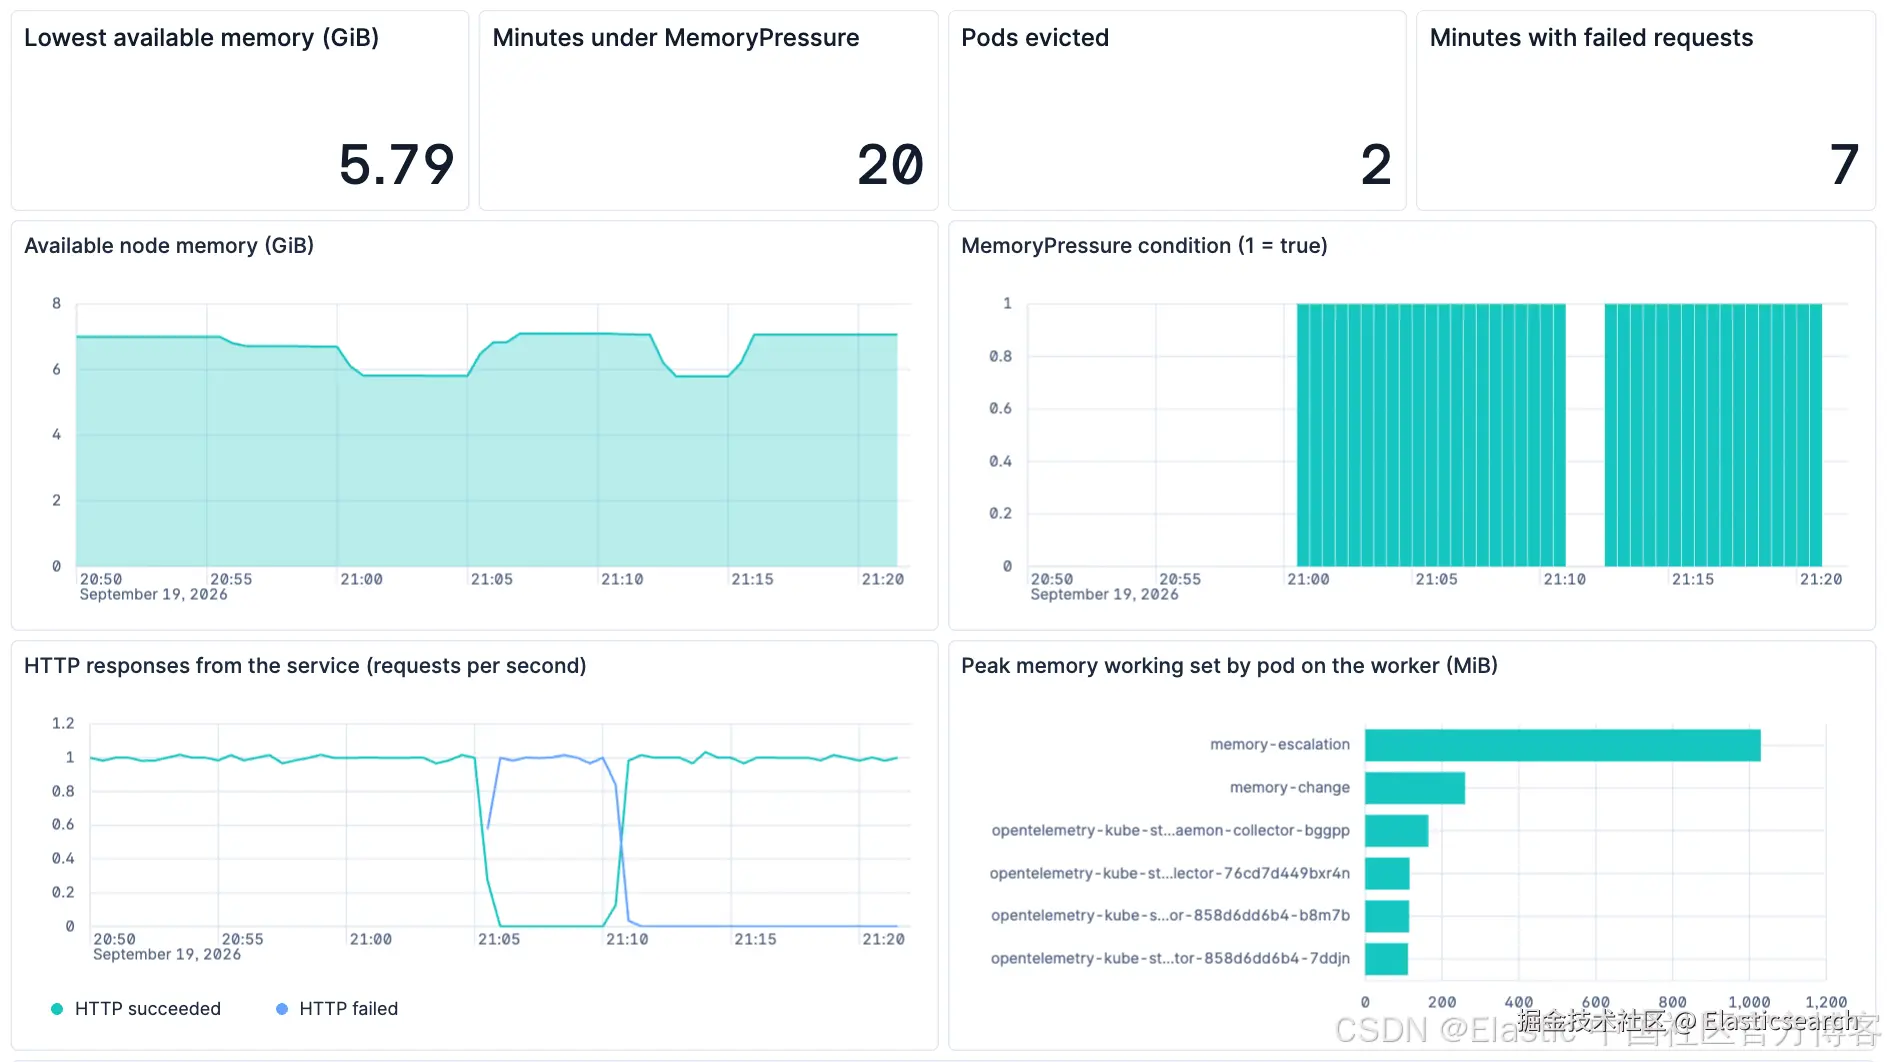
同一个仪表板还嵌入了异常检测作业的单指标查看器,显示两次运行的模型边界和异常标记。配套笔记本会导入此仪表板,因此你可以用同样的方式查看自己的运行结果。
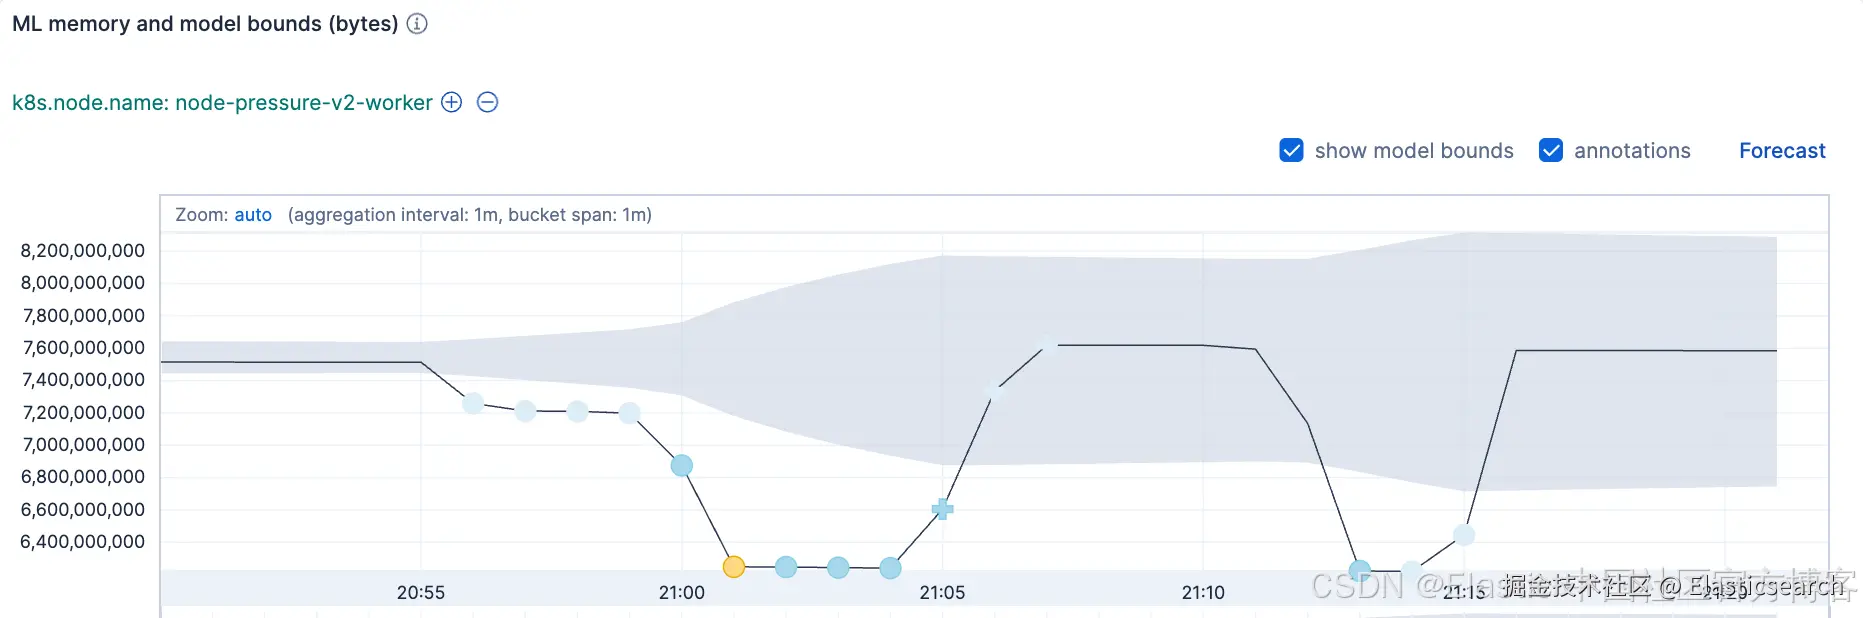
有三个结果值得关注:
- 异常告警比
MemoryPressure(内存压力)早2分31秒。它标记了256 MiB 的变化,早于使节点越过阈值的1 GiB 内存分配。首次请求失败前的7分29秒中,有五分钟来自配置的软驱逐宽限期。 - 两次运行中,余量告警都晚于
MemoryPressure(内存压力),分别晚41秒和36秒。1 GiB 的突增会在同一个规则检查间隔内越过0.5 GiB 的余量和驱逐阈值。在第二次运行中,宽限期提供了采取行动的时间。 - 异常得分取决于内存如何变化。相同的总负载一次性到达时,得分为4.2,没有触发异常告警。
随着模型接收更多数据,异常得分会重新归一化。1 GiB 的突增发生后,第一次运行的记录在异常浏览器中的得分从30降至2.7,而其 initial_record_score(初始记录得分)保留了规则评估时的值。平稳的两小时基线使3.7%的下降显得突出。对于具有数天波动历史数据的节点,相同变化的得分预计会更低。
三种信号共同覆盖哪些情况
本演示使用 low_mean 异常检测作业,为每个节点的可用内存建模,并以25分的记录得分作为告警阈值。余量规则和 Kubernetes OTel 压力模板覆盖了模型评分较低的变化。排查流程从异常记录出发,追踪到工作集发生变化的容器组、最先被驱逐的容器组,再进行包含服务在内的恢复检查。
在分阶段测试中,异常告警最先到达,但仅在变化逐步发生时如此。保持三种信号全部启用,并根据团队响应所需的时间设置软驱逐宽限期。
接下来如何扩展 Kubernetes 监控配置
以下资源可用于扩展实验,并提供各个部分的背景信息:
- 在同一个作业中,为
k8s.node.filesystem.available添加第二个low_mean检测器,以便为每个节点的磁盘余量建模。 - 用于 Kubernetes 监控的常见 ES|QL 查询,包括因内存不足而终止前的容器内存利用率
- Elastic 集成中的告警规则模板
- Kubernetes 文档中的节点压力驱逐
- 为异常检测作业生成告警
- EDOT Kubernetes 指南
原文:Kubernetes node pressure alerts with Elastic anomaly detection | Elastic Observability Labs