文章目录
- 概述
- [1 axi-full-slave IP](#1 axi-full-slave IP)
-
- [1.1 IP 概述](#1.1 IP 概述)
- [1.2 创建 axi4-full-slave 总线接口 IP](#1.2 创建 axi4-full-slave 总线接口 IP)
- [1.3 代码分析](#1.3 代码分析)
-
- [1.3.1 axi-full-slave 的 axi_awready](#1.3.1 axi-full-slave 的 axi_awready)
- [1.3.2 axi-full-slave 的 axi_awaddr](#1.3.2 axi-full-slave 的 axi_awaddr)
- [1.3.3 axi-full-slave 的 axi_wready](#1.3.3 axi-full-slave 的 axi_wready)
- [1.3.4 axi-full-slave 的 axi_bvalid 信号](#1.3.4 axi-full-slave 的 axi_bvalid 信号)
- [1.3.5 axi-full-slave 的 axi_arready 信号](#1.3.5 axi-full-slave 的 axi_arready 信号)
- [1.3.6 axi-full-slave 的 axi_araddr 信号](#1.3.6 axi-full-slave 的 axi_araddr 信号)
- [1.3.7 axi-full-slave 的 axi_rvalid 信号](#1.3.7 axi-full-slave 的 axi_rvalid 信号)
- [1.3.8 数据保存到 block ram](#1.3.8 数据保存到 block ram)
- [1.4 仿真结果](#1.4 仿真结果)
- [2 saxi_full_mem IP 介绍](#2 saxi_full_mem IP 介绍)
- [3 创建 FPGA 逻辑工程](#3 创建 FPGA 逻辑工程)
- [4 添加 FDMA 接口控制代码](#4 添加 FDMA 接口控制代码)
- [5 仿真文件](#5 仿真文件)
- [6 实验结果](#6 实验结果)
概述
本文试验中对上一篇: FPGA应用技巧之AXI4-FULL-MASTER IP FDMA(Fast Direct Memory)详细介绍描写的 FDMA IP 进行仿真验证。
1 axi-full-slave IP
这里为什么要先给大家梳理axi-full-slave IP的相关内容呢,是因为关于AXI4-FULL-uiFDMA IP的应用其实都是基于VIVADO 工具产生 AXI 协议模板进行拓展的。因此这一部分主要目的在于:
1:掌握基于 VIVADO 工具产生 AXI 协议模板
2:掌握通过 VIVADO 工具产生 AXI-full-slave 代码
3:理解 AXI-full-slave 中自定义寄存器的地址分配
4:掌握通过 VIVADO 封装 AXI-full-slave 图形化 IP
1.1 IP 概述
使用 XILINX 的软件工具 VIVADO 以及 XILINX 的 7 代以上的 FPGA 或者 SOC 掌握 AXI-4 总线结束, 并且可以灵活使用 AXI-4 总线技术完成数据的交换,可以让我们在构建强大的 FPGA 内部总线数据互联通信方面取得高效、高速、 标准化的优势。
1.2 创建 axi4-full-slave 总线接口 IP
新建工程我们不再赘述。
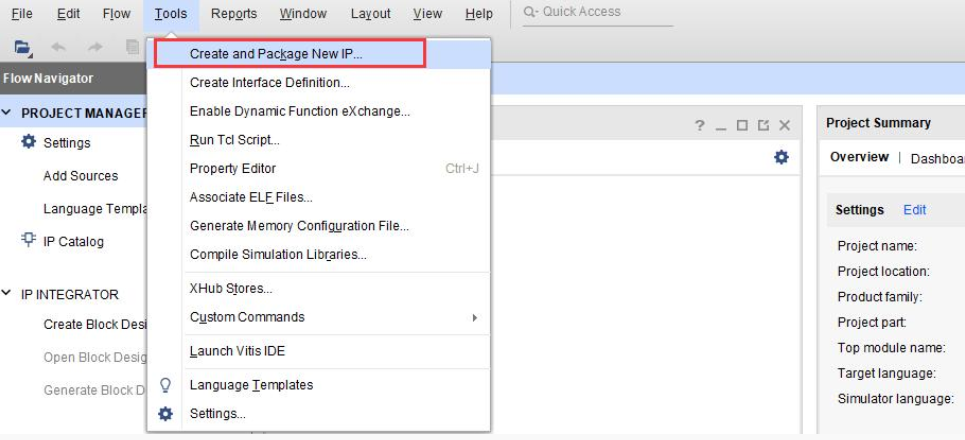
新建完成工程后, 单击菜单栏 Tools->Create and Package New IP, 开始创建一个 AXI4-Full 接口总线 IP
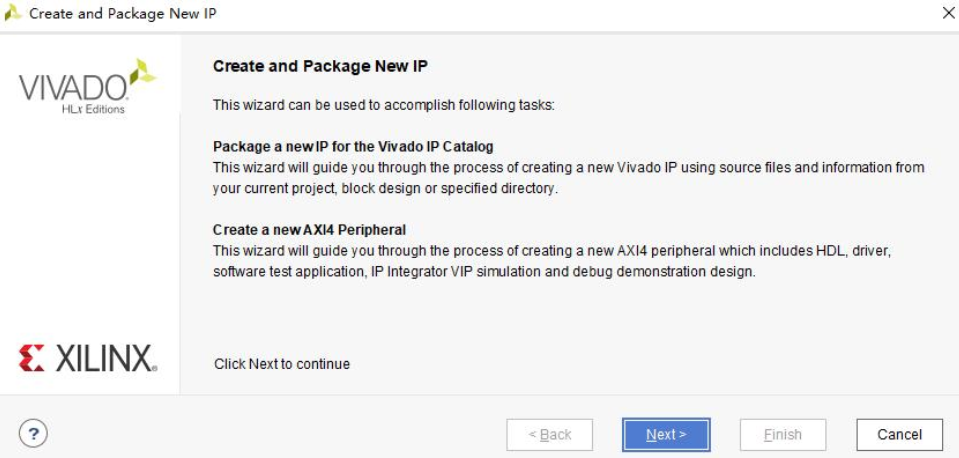
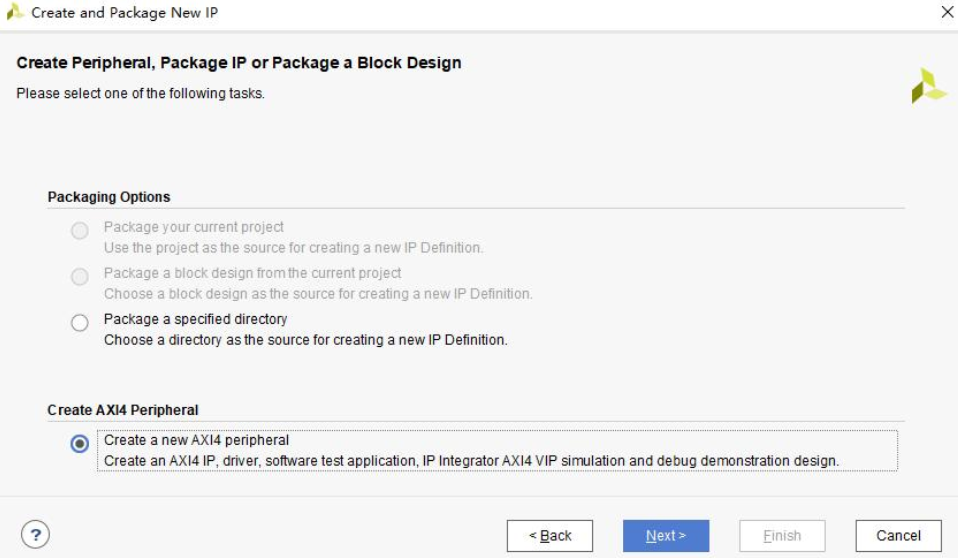
选择使用 vivado 自带的 AXI 总线模板创建一个 AXI4-FULL 接口 IP。
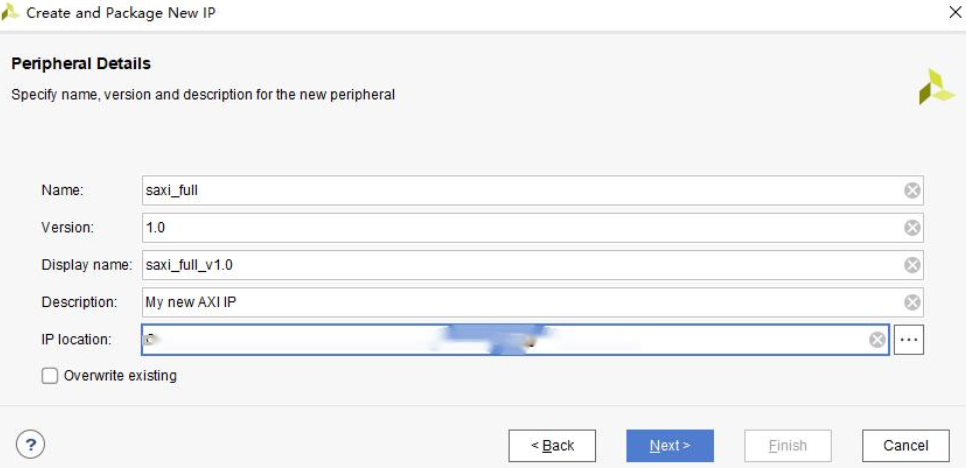
设置 IP 的名字为 saxi_full。
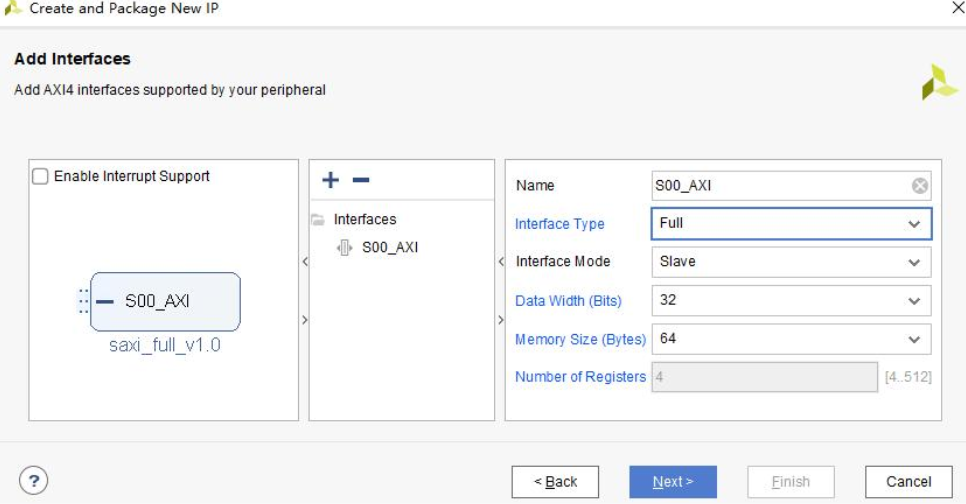
模板支持 3 种协议, 分别是 AXI4-Full , AXI4-Lite , AXI4-Stream, 这里选择 full;总线包括 Master 和 Slave 两种模式, 这里选择 Slave 模式。
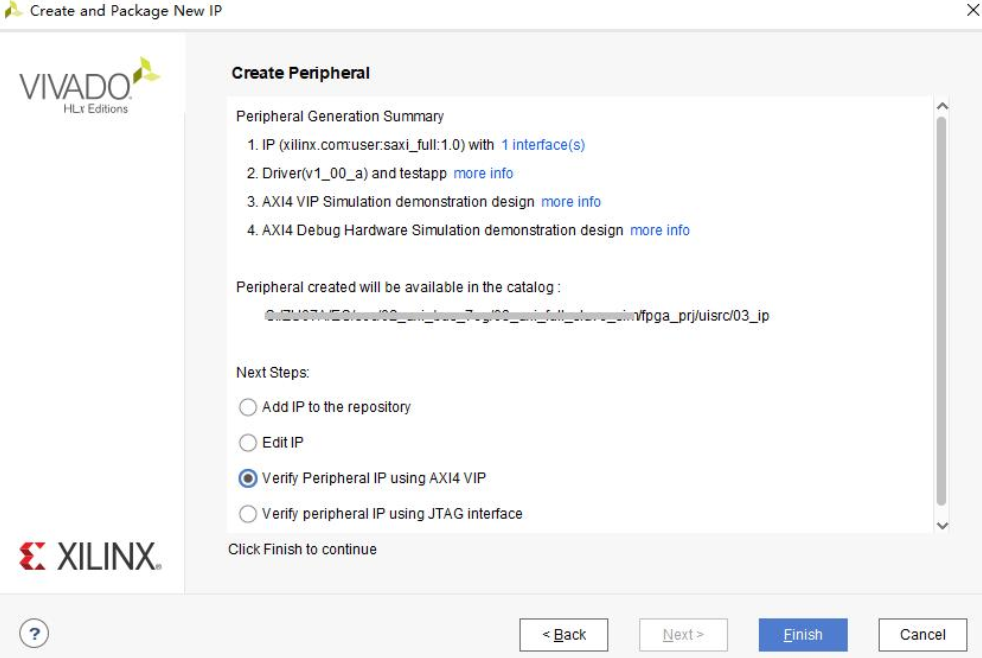
这里选择 Verify Peripheral IP using AXI4 VIP 可以对 AXI4-FULL 快速验证。
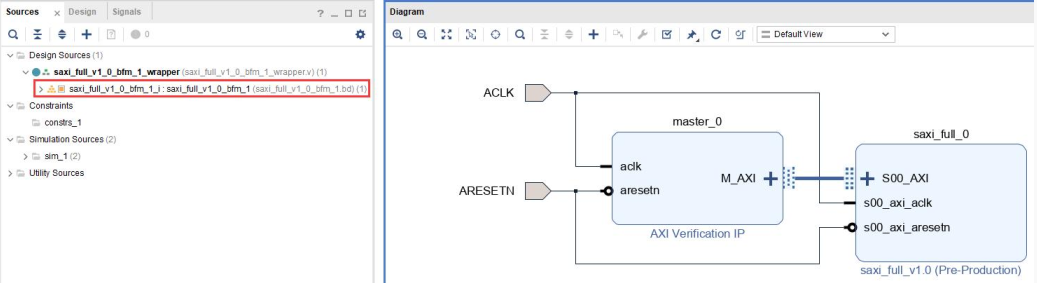
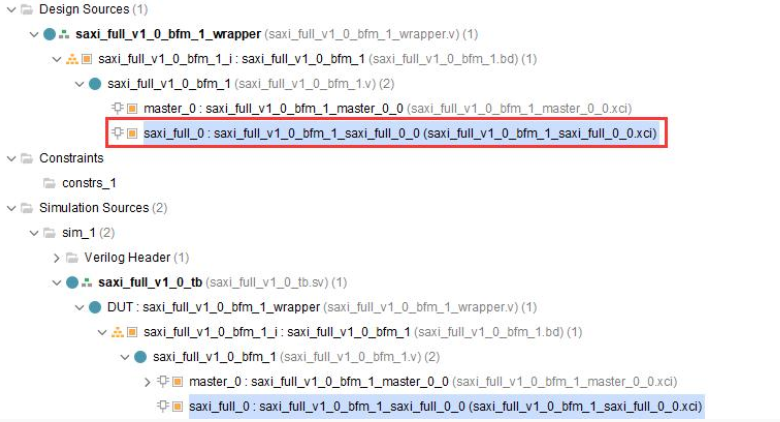
单击 Finish 后展开 VIVADO 自动产生的 demo, 单击 Block Design 的工程, 可以看到如下 2 个 IP。 其中 saxi_full_0 就是我们自定义的 IP, 另外一个 master_0 是用来读写我们自定义的 saxi_full_0, 以此验证我们的 IP 正确性。
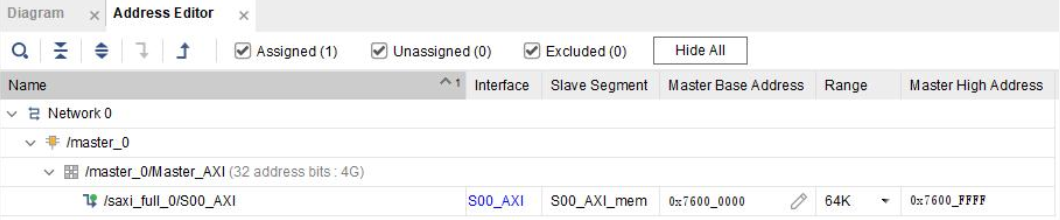
采用默认地址分配即可。
继续再看代码看看里面有什么东西。
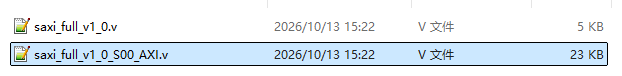
文件夹saxi_full_1.0/hdl 路径下的 saxi_full_v1_0_S00_AXI.v 就是我们的源码。 另外一个 saxi_full_v1_0.v是软件产生了一个接口文件, 如果我们自己定义 IP 可有可无。
1.3 代码分析
1.3.1 axi-full-slave 的 axi_awready
当满足条件(~axi_awready && S_AXI_AWVALID && ~axi_awv_awr_flag &&~axi_arv_arr_flag)=1 的时候表示可以进行一次 AXI-FULL 的 burst 写操作了, 这个时候 AXI-FULL-SLAVE 设置 axi_awready <= 1'b1 和 axi_awv_awr_flag<= 1'b1。
c
	// Implement axi_awready generation

	// axi_awready is asserted for one S_AXI_ACLK clock cycle when both
	// S_AXI_AWVALID and S_AXI_WVALID are asserted. axi_awready is
	// de-asserted when reset is low.

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_awready <= 1'b0;
	      axi_awv_awr_flag <= 1'b0;
	    end
	  else
	    begin
	      if (~axi_awready && S_AXI_AWVALID && ~axi_awv_awr_flag && ~axi_arv_arr_flag)
	        begin
	          // slave is ready to accept an address and
	          // associated control signals
	          axi_awready <= 1'b1;
	          axi_awv_awr_flag  <= 1'b1;
	          // used for generation of bresp() and bvalid
	        end
	      else if (S_AXI_WLAST && axi_wready)
	      // preparing to accept next address after current write burst tx completion
	        begin
	          axi_awv_awr_flag  <= 1'b0;
	        end
	      else
	        begin
	          axi_awready <= 1'b0;
	        end
	    end
	end
1.3.2 axi-full-slave 的 axi_awaddr
AXI 的 burst 模式包括 3 种:
1:fixed burst 这种模式下地址都是相同的
2: incremental burst 这种模式下地址递增
3: Wrapping burst 这只模式下地址达到设置的最大地址边界后返回原来的地址。
本文 demo 中以下三种模式的具体代码如下:
c
	// Implement axi_awaddr latching

	// This process is used to latch the address when both
	// S_AXI_AWVALID and S_AXI_WVALID are valid.

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_awaddr <= 0;
	      axi_awlen_cntr <= 0;
	      axi_awburst <= 0;
	      axi_awlen <= 0;
	    end
	  else
	    begin
	      if (~axi_awready && S_AXI_AWVALID && ~axi_awv_awr_flag)
	        begin
	          // address latching
	          axi_awaddr <= S_AXI_AWADDR[C_S_AXI_ADDR_WIDTH - 1:0];
	           axi_awburst <= S_AXI_AWBURST;
	           axi_awlen <= S_AXI_AWLEN;
	          // start address of transfer
	          axi_awlen_cntr <= 0;
	        end
	      else if((axi_awlen_cntr <= axi_awlen) && axi_wready && S_AXI_WVALID)
	        begin

	          axi_awlen_cntr <= axi_awlen_cntr + 1;

	          case (axi_awburst)
	            2'b00: // fixed burst
	            // The write address for all the beats in the transaction are fixed
	              begin
	                axi_awaddr <= axi_awaddr;
	                //for awsize = 4 bytes (010)
	              end
	            2'b01: //incremental burst
	            // The write address for all the beats in the transaction are increments by awsize
	              begin
	                axi_awaddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] <= axi_awaddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] + 1;
	                //awaddr aligned to 4 byte boundary
	                axi_awaddr[ADDR_LSB-1:0]  <= {ADDR_LSB{1'b0}};
	                //for awsize = 4 bytes (010)
	              end
	            2'b10: //Wrapping burst
	            // The write address wraps when the address reaches wrap boundary
	              if (aw_wrap_en)
	                begin
	                  axi_awaddr <= (axi_awaddr - aw_wrap_size);
	                end
	              else
	                begin
	                  axi_awaddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] <= axi_awaddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] + 1;
	                  axi_awaddr[ADDR_LSB-1:0]  <= {ADDR_LSB{1'b0}};
	                end
	            default: //reserved (incremental burst for example)
	              begin
	                axi_awaddr <= axi_awaddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] + 1;
	                //for awsize = 4 bytes (010)
	              end
	          endcase
	        end
	    end
	end
1.3.3 axi-full-slave 的 axi_wready
当满足条件( ~axi_wready && S_AXI_WVALID && axi_awv_awr_flag)==1 设置 axi_wready 为 1.这里可以看出,S_AXI_WVALID 必须在一次 burst 中持续有效,直到满足条件 (S_AXI_WLAST && axi_wready) ,否则AXI-FULL-SLAVE会出错, 这一点有别于 AXI-LITE-SLAVE 每次只读写一个数据。
c
	// Implement axi_wready generation

	// axi_wready is asserted for one S_AXI_ACLK clock cycle when both
	// S_AXI_AWVALID and S_AXI_WVALID are asserted. axi_wready is
	// de-asserted when reset is low.

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_wready <= 1'b0;
	    end
	  else
	    begin
	      if ( ~axi_wready && S_AXI_WVALID && axi_awv_awr_flag)
	        begin
	          // slave can accept the write data
	          axi_wready <= 1'b1;
	        end
	      //else if (~axi_awv_awr_flag)
	      else if (S_AXI_WLAST && axi_wready)
	        begin
	          axi_wready <= 1'b0;
	        end
	    end
	end
1.3.4 axi-full-slave 的 axi_bvalid 信号
axi_bvalid 用于告知 axi master axi-slave 端已经完成数据接收了。
给出 ACK, 写操作 LAST 信号的下一个时钟, AXI-SLAVE 给出 ACK 信号。
c
	// Implement write response logic generation

	// The write response and response valid signals are asserted by the slave
	// when axi_wready, S_AXI_WVALID, axi_wready and S_AXI_WVALID are asserted.
	// This marks the acceptance of address and indicates the status of
	// write transaction.

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_bvalid <= 0;
	      axi_bresp <= 2'b0;
	      axi_buser <= 0;
	    end
	  else
	    begin
	      if (axi_awv_awr_flag && axi_wready && S_AXI_WVALID && ~axi_bvalid && S_AXI_WLAST )
	        begin
	          axi_bvalid <= 1'b1;
	          axi_bresp  <= 2'b0;
	          // 'OKAY' response
	        end
	      else
	        begin
	          if (S_AXI_BREADY && axi_bvalid)
	          //check if bready is asserted while bvalid is high)
	          //(there is a possibility that bready is always asserted high)
	            begin
	              axi_bvalid <= 1'b0;
	            end
	        end
	    end
	 end
1.3.5 axi-full-slave 的 axi_arready 信号
当满足条件(~axi_arready && S_AXI_ARVALID && ~axi_awv_awr_flag &&~axi_arv_arr_flag)=1 的时候表示可以进行一次 AXI-FULL 的 burst 读操作了, 这个时候 AXI -FULL-SLAVE 设置 axi_arready <= 1'b1 和 axi_arv_arr_flag <=1'b1。
c
	// Implement axi_arready generation

	// axi_arready is asserted for one S_AXI_ACLK clock cycle when
	// S_AXI_ARVALID is asserted. axi_awready is
	// de-asserted when reset (active low) is asserted.
	// The read address is also latched when S_AXI_ARVALID is
	// asserted. axi_araddr is reset to zero on reset assertion.

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_arready <= 1'b0;
	      axi_arv_arr_flag <= 1'b0;
	    end
	  else
	    begin
	      if (~axi_arready && S_AXI_ARVALID && ~axi_awv_awr_flag && ~axi_arv_arr_flag)
	        begin
	          axi_arready <= 1'b1;
	          axi_arv_arr_flag <= 1'b1;
	        end
	      else if (axi_rvalid && S_AXI_RREADY && axi_arlen_cntr == axi_arlen)
	      // preparing to accept next address after current read completion
	        begin
	          axi_arv_arr_flag  <= 1'b0;
	        end
	      else
	        begin
	          axi_arready <= 1'b0;
	        end
	    end
	end
1.3.6 axi-full-slave 的 axi_araddr 信号
AXI-的读写操作几乎是相对的代码, AXI 的 burst 模式包括 3 种:
1:fixed burst 这种模式下地址都是相同的
2: incremental burst 这种模式下地址递增
3: Wrapping burst 这只模式下地址达到设置的最大地址边界后返回原来的地址。
本文 demo 种以下三种模式的具体代码如下:
c
	// Implement axi_araddr latching

	//This process is used to latch the address when both
	//S_AXI_ARVALID and S_AXI_RVALID are valid.
	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_araddr <= 0;
	      axi_arlen_cntr <= 0;
	      axi_arburst <= 0;
	      axi_arlen <= 0;
	      axi_rlast <= 1'b0;
	      axi_ruser <= 0;
	    end
	  else
	    begin
	      if (~axi_arready && S_AXI_ARVALID && ~axi_arv_arr_flag)
	        begin
	          // address latching
	          axi_araddr <= S_AXI_ARADDR[C_S_AXI_ADDR_WIDTH - 1:0];
	          axi_arburst <= S_AXI_ARBURST;
	          axi_arlen <= S_AXI_ARLEN;
	          // start address of transfer
	          axi_arlen_cntr <= 0;
	          axi_rlast <= 1'b0;
	        end
	      else if((axi_arlen_cntr <= axi_arlen) && axi_rvalid && S_AXI_RREADY)
	        begin

	          axi_arlen_cntr <= axi_arlen_cntr + 1;
	          axi_rlast <= 1'b0;

	          case (axi_arburst)
	            2'b00: // fixed burst
	             // The read address for all the beats in the transaction are fixed
	              begin
	                axi_araddr       <= axi_araddr;
	                //for arsize = 4 bytes (010)
	              end
	            2'b01: //incremental burst
	            // The read address for all the beats in the transaction are increments by awsize
	              begin
	                axi_araddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] <= axi_araddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] + 1;
	                //araddr aligned to 4 byte boundary
	                axi_araddr[ADDR_LSB-1:0]  <= {ADDR_LSB{1'b0}};
	                //for awsize = 4 bytes (010)
	              end
	            2'b10: //Wrapping burst
	            // The read address wraps when the address reaches wrap boundary
	              if (ar_wrap_en)
	                begin
	                  axi_araddr <= (axi_araddr - ar_wrap_size);
	                end
	              else
	                begin
	                axi_araddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] <= axi_araddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB] + 1;
	                //araddr aligned to 4 byte boundary
	                axi_araddr[ADDR_LSB-1:0]  <= {ADDR_LSB{1'b0}};
	                end
	            default: //reserved (incremental burst for example)
	              begin
	                axi_araddr <= axi_araddr[C_S_AXI_ADDR_WIDTH - 1:ADDR_LSB]+1;
	                //for arsize = 4 bytes (010)
	              end
	          endcase
	        end
	      else if((axi_arlen_cntr == axi_arlen) && ~axi_rlast && axi_arv_arr_flag )
	        begin
	          axi_rlast <= 1'b1;
	        end
	      else if (S_AXI_RREADY)
	        begin
	          axi_rlast <= 1'b0;
	        end
	    end
	end
1.3.7 axi-full-slave 的 axi_rvalid 信号
在用 VIVADO 模板产生的 demo 中, 读操作数据不是连续读的, 通过 axi_rvalid 设置 AXI-SLAVE FULL 读数据有效。
c
	// Implement axi_arvalid generation

	// axi_rvalid is asserted for one S_AXI_ACLK clock cycle when both
	// S_AXI_ARVALID and axi_arready are asserted. The slave registers
	// data are available on the axi_rdata bus at this instance. The
	// assertion of axi_rvalid marks the validity of read data on the
	// bus and axi_rresp indicates the status of read transaction.axi_rvalid
	// is deasserted on reset (active low). axi_rresp and axi_rdata are
	// cleared to zero on reset (active low).

	always @( posedge S_AXI_ACLK )
	begin
	  if ( S_AXI_ARESETN == 1'b0 )
	    begin
	      axi_rvalid <= 0;
	      axi_rresp  <= 0;
	    end
	  else
	    begin
	      if (axi_arv_arr_flag && ~axi_rvalid)
	        begin
	          axi_rvalid <= 1'b1;
	          axi_rresp  <= 2'b0;
	          // 'OKAY' response
	        end
	      else if (axi_rvalid && S_AXI_RREADY)
	        begin
	          axi_rvalid <= 1'b0;
	        end
	    end
	end

	//Output register or memory read data

	always @( mem_data_out, axi_rvalid)
	begin
	  if (axi_rvalid)
	    begin
	      // Read address mux
	      axi_rdata <= mem_data_out[0];
	    end
	  else
	    begin
	      axi_rdata <= 32'h00000000;
	    end
	end
1.3.8 数据保存到 block ram
以下是利用 block ram 完成数据的保存和回读
c
	// implement Block RAM(s)
	generate
	  for(i=0; i<= USER_NUM_MEM-1; i=i+1)
	    begin:BRAM_GEN
	      wire mem_rden;
	      wire mem_wren;

	      assign mem_wren = axi_wready && S_AXI_WVALID ;

	      assign mem_rden = axi_arv_arr_flag ; //& ~axi_rvalid

	      for(mem_byte_index=0; mem_byte_index<= (C_S_AXI_DATA_WIDTH/8-1); mem_byte_index=mem_byte_index+1)
	      begin:BYTE_BRAM_GEN
	        wire [8-1:0] data_in ;
	        wire [8-1:0] data_out;
	        reg  [8-1:0] byte_ram [0 : 15];
	        integer  j;

	        //assigning 8 bit data
	        assign data_in  = S_AXI_WDATA[(mem_byte_index*8+7) -: 8];
	        assign data_out = byte_ram[mem_address];

	        always @( posedge S_AXI_ACLK )
	        begin
	          if (mem_wren && S_AXI_WSTRB[mem_byte_index])
	            begin
	              byte_ram[mem_address] <= data_in;
	            end
	        end

	        always @( posedge S_AXI_ACLK )
	        begin
	          if (mem_rden)
	            begin
	              mem_data_out[i][(mem_byte_index*8+7) -: 8] <= data_out;
	            end
	        end

	    end
	  end
	endgenerate
1.4 仿真结果
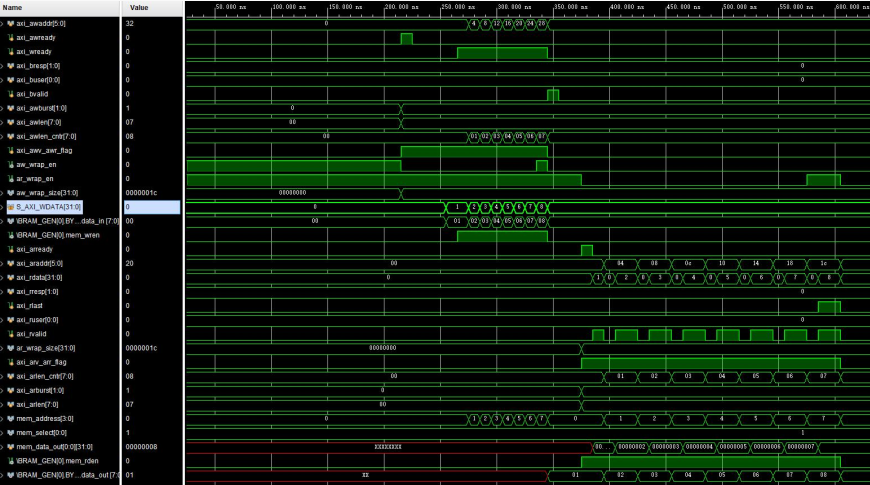
2 saxi_full_mem IP 介绍
这个 IP 的源码可以基于 axi-full-slave 的模板简单修改就可以实现。 找到以下路径, 中 saxi_full_v1_0_S00_AXI.v文件, 并且对齐修改。
我们把修改后的代码命名为 saxi_full_mem.v 修改其中的部分代码, 关键部分是 memory 部分定义。
c
	// ------------------------------------------
	// -- Example code to access user logic memory region
	// ------------------------------------------
	localparam MEM_LEN		= clogb2(USER_NUM_MEM)-1;

	reg  [C_S_AXI_DATA_WIDTH-1:0] byte_ram [0 : USER_NUM_MEM -1];

	assign axi_rdata = axi_rvalid ? byte_ram[axi_araddr[ADDR_LSB+MEM_LEN:ADDR_LSB]] : 0;

	always @( posedge S_AXI_ACLK )begin
	    if (axi_wready && S_AXI_WVALID)begin
	            byte_ram[axi_awaddr[ADDR_LSB+MEM_LEN:ADDR_LSB]] <= S_AXI_WDATA;
	    end
	end
修改的这部分代码支持 Memory 的任意长度设置(FPGA 内部 RAM 会消耗资源), 其中参数 USER_NUM_MEM用于定义 RAM 的长度, 我们一次 FDMA 的 burst 长度应该小于等于 USER_NUM_MEM 这个参数。
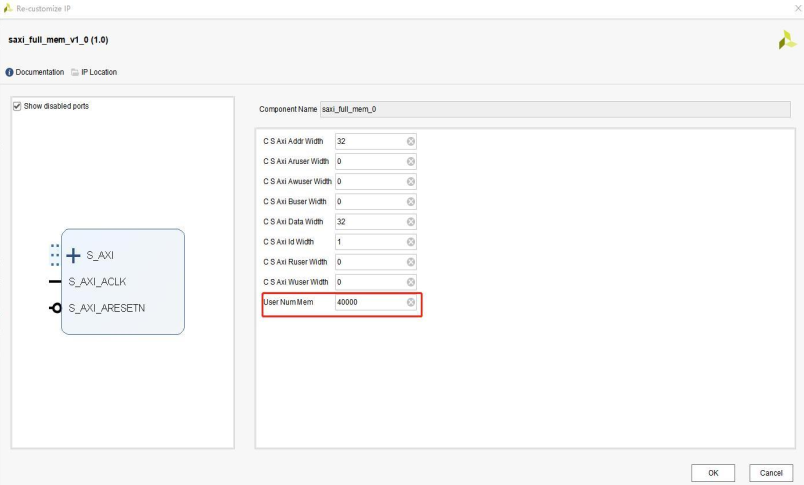
这个 IP 后面可以用于 AXI4 总线的仿真验证。
3 创建 FPGA 逻辑工程
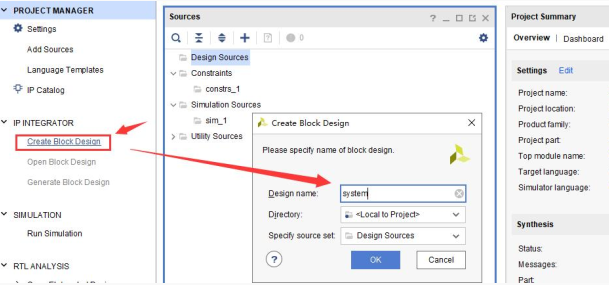
设置 IP 路径。
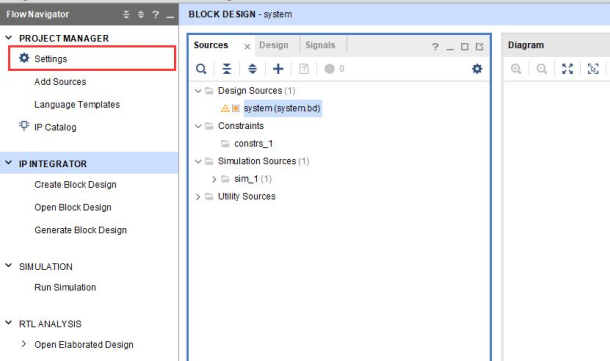
添加已经创建好的 IP。
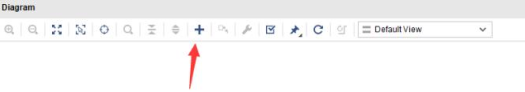
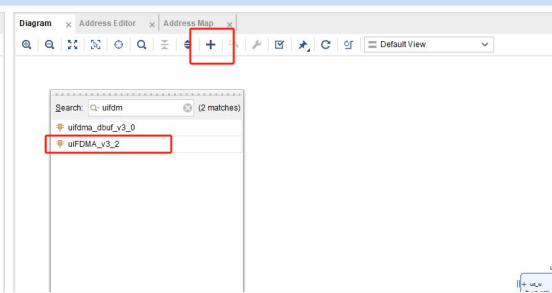
输入关键词 fdma, 在最后可以看到, 双击添加 Ip。
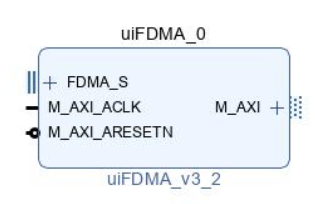
继续添加剩余 IP。
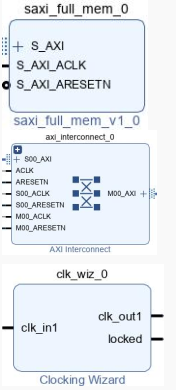
设置 IP 参数。
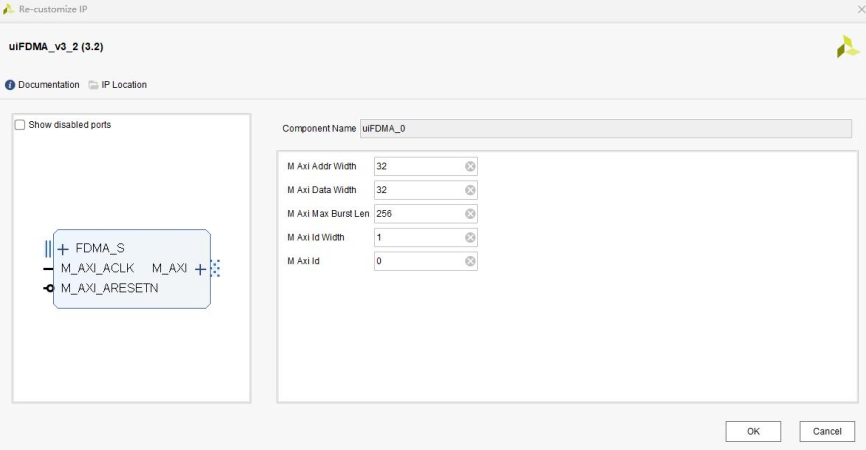
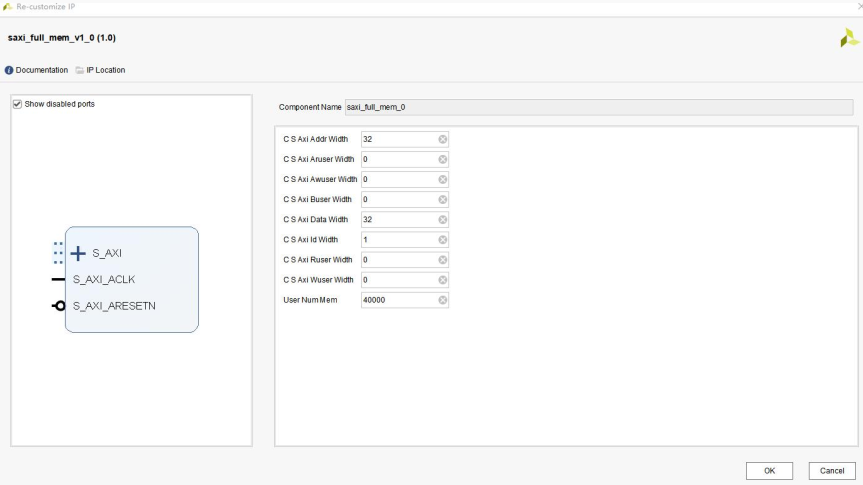
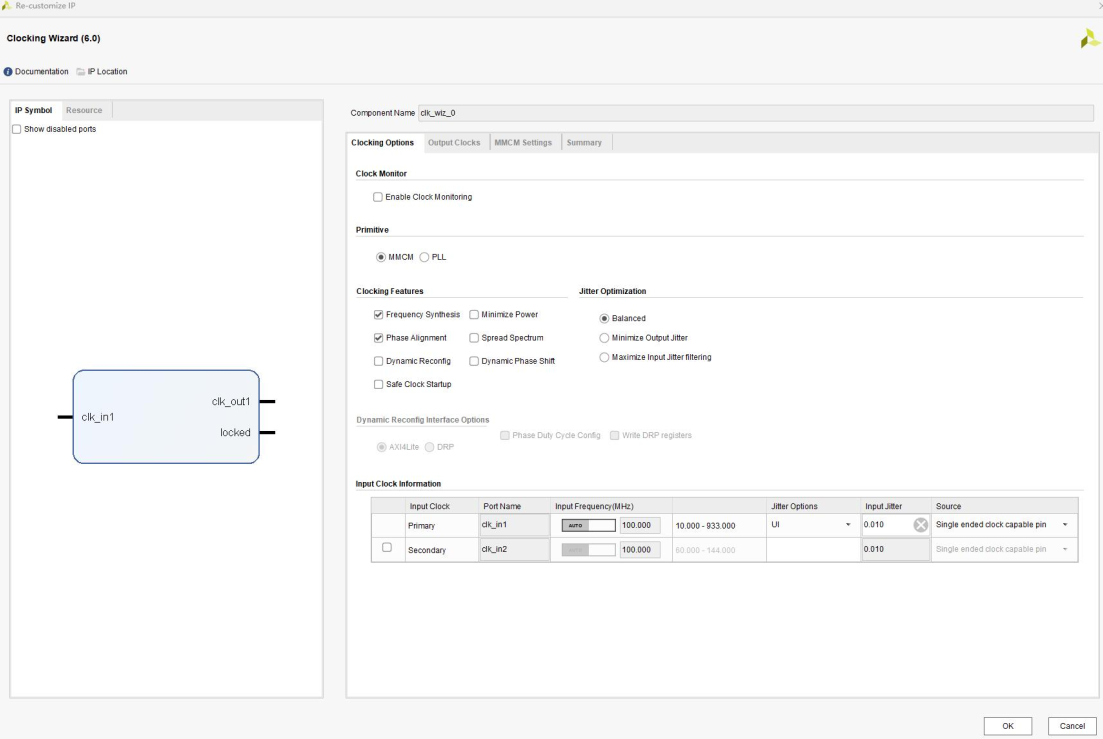
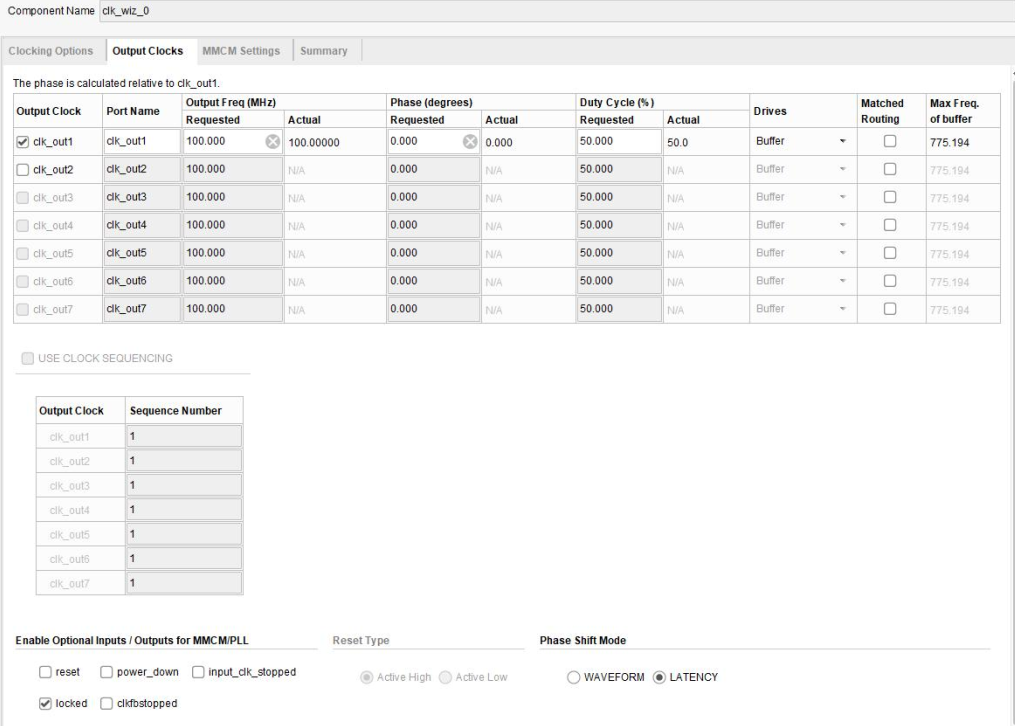
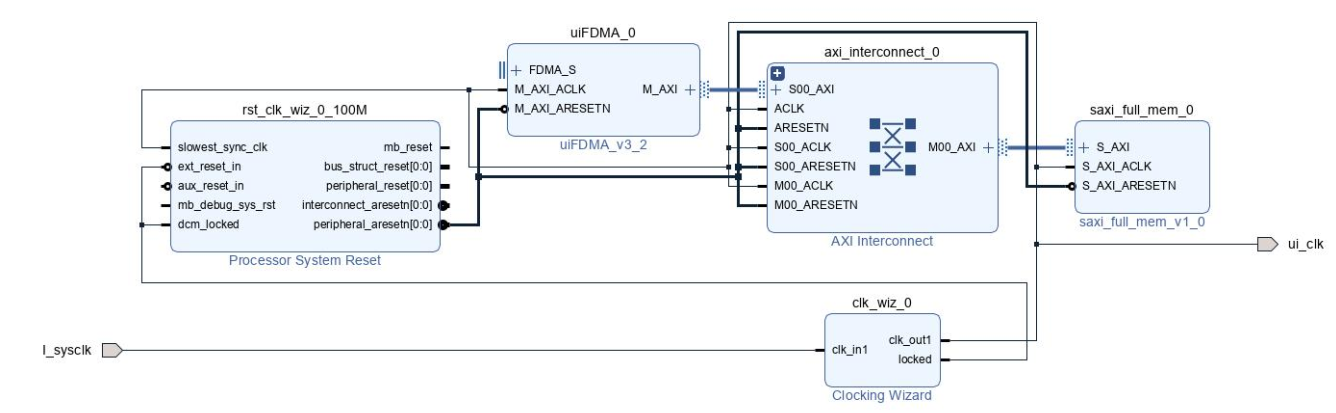
完成连线。
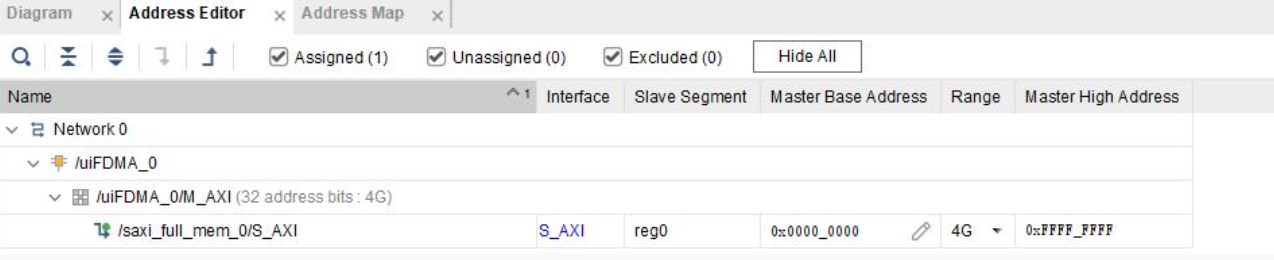
设置地址分配:
4 添加 FDMA 接口控制代码
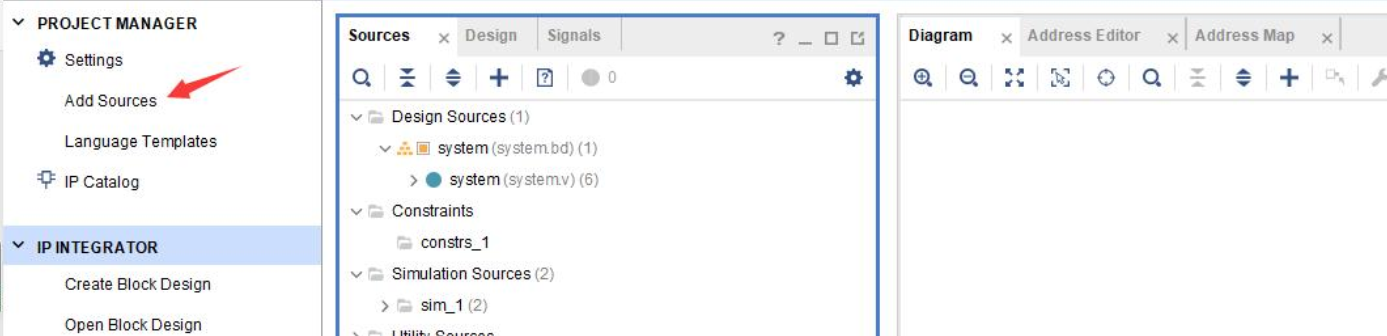
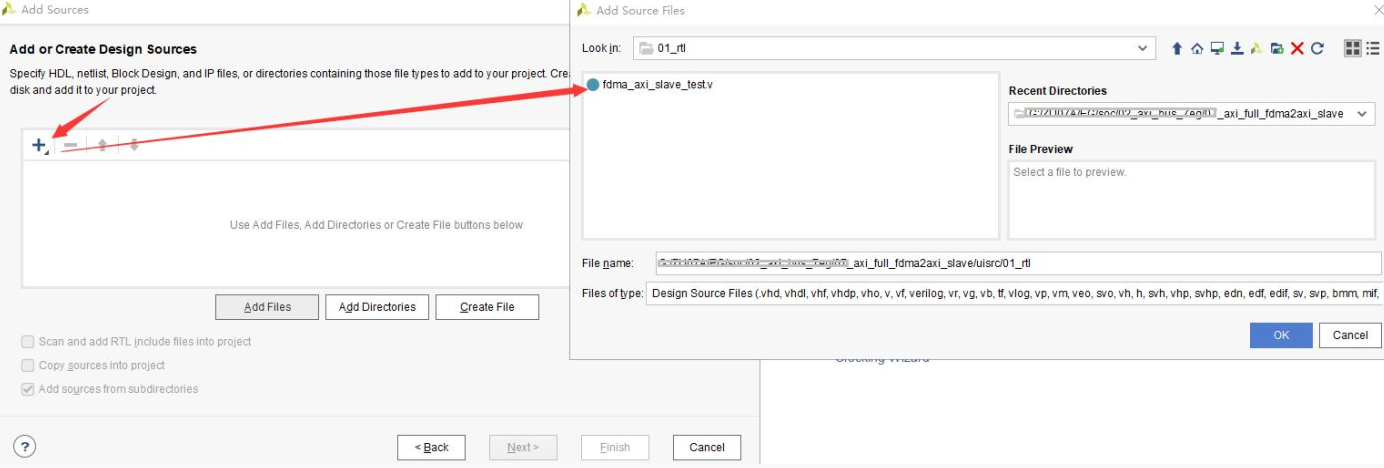
添加完成后如下图:
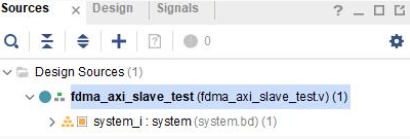
fdma_axi_slave_test.v源码如下:
c
`timescale 1ns / 1ps
module fdma_axi_slave_test(
  input I_sysclk
);

wire [31:0]   fdma_raddr;
reg           fdma_rareq;
wire          fdma_rbusy;
wire [31:0]   fdma_rdata;
wire [15:0]   fdma_rsize;
wire          fdma_rvalid;
wire [31:0]   fdma_waddr;
reg           fdma_wareq;
wire          fdma_wbusy;
wire [31:0]   fdma_wdata;
wire [15:0]   fdma_wsize;
wire          fdma_wvalid;
wire          ui_clk;

parameter TEST_MEM_SIZE   = 32'd20000;
parameter FDMA_BURST_LEN  = 16'd500;
parameter ADDR_MEM_OFFSET = 0;
parameter ADDR_INC = FDMA_BURST_LEN*4;

parameter WRITE1 = 0;
parameter WRITE2 = 1;
parameter WAIT   = 2;
parameter READ1  = 3;
parameter READ2  = 4;

reg [31: 0] t_data;
reg [31: 0] fdma_waddr_r;
reg [2  :0] T_S = 0;

assign fdma_waddr = fdma_waddr_r + ADDR_MEM_OFFSET;
assign fdma_raddr = fdma_waddr;

assign fdma_wsize = FDMA_BURST_LEN;
assign fdma_rsize = FDMA_BURST_LEN;
assign fdma_wdata ={t_data,t_data,t_data,t_data};


//delay reset
reg [8:0] rst_cnt = 0;
always @(posedge ui_clk)
    if(rst_cnt[8] == 1'b0)
         rst_cnt <= rst_cnt + 1'b1;
     else
         rst_cnt <= rst_cnt;

always @(posedge ui_clk)begin
    if(rst_cnt[8] == 1'b0)begin
        T_S <=0;
        fdma_wareq  <= 1'b0;
        fdma_rareq  <= 1'b0;
        t_data<=0;
        fdma_waddr_r <=0;
    end
    else begin
        case(T_S)
        WRITE1:begin
            if(fdma_waddr_r==TEST_MEM_SIZE) fdma_waddr_r<=0;
                if(!fdma_wbusy)begin
                    fdma_wareq  <= 1'b1;
                    t_data  <= 0;
                end
                if(fdma_wareq&&fdma_wbusy)begin
                    fdma_wareq  <= 1'b0;
                    T_S         <= WRITE2;
                end
        end
        WRITE2:begin
            if(!fdma_wbusy) begin
                 T_S <= WAIT;
                 t_data  <= 32'd0;
            end
            else if(fdma_wvalid) begin
                t_data <= t_data + 1'b1;
            end
        end
        WAIT:begin//not needed
            T_S <= READ1;
        end
        READ1:begin
            if(!fdma_rbusy)begin
                fdma_rareq  <= 1'b1;
                t_data   <= 0;
            end
            if(fdma_rareq&&fdma_rbusy)begin
                 fdma_rareq  <= 1'b0;
                 T_S         <= READ2;
            end
        end
        READ2:begin
            if(!fdma_rbusy) begin
                 T_S <= WRITE1;
                 t_data  <= 32'd0;
                 fdma_waddr_r  <= fdma_waddr_r + ADDR_INC;//128/8=16
            end
            else if(fdma_rvalid) begin
                t_data <= t_data + 1'b1;
            end
        end
        default:
            T_S <= WRITE1;
        endcase
    end
  end

wire test_error = (fdma_rvalid && (t_data[15:0] != fdma_rdata[15:0]));

//ila_0 ila_dbg (
//	.clk(ui_clk),
//	.probe0({fdma_wdata[15:0],fdma_wareq,fdma_wvalid,fdma_wbusy}),
//	.probe1({fdma_rdata[15:0],t_data[15:0],fdma_rvalid,fdma_rbusy,T_S,test_error})
//);

  system system_i
       (.FDMA_S_0_fdma_raddr(fdma_raddr),
        .FDMA_S_0_fdma_rareq(fdma_rareq),
        .FDMA_S_0_fdma_rbusy(fdma_rbusy),
        .FDMA_S_0_fdma_rdata(fdma_rdata),
        .FDMA_S_0_fdma_rready(1'b1),
        .FDMA_S_0_fdma_rsize(fdma_rsize),
        .FDMA_S_0_fdma_rvalid(fdma_rvalid),
        .FDMA_S_0_fdma_waddr(fdma_waddr),
        .FDMA_S_0_fdma_wareq(fdma_wareq),
        .FDMA_S_0_fdma_wbusy(fdma_wbusy),
        .FDMA_S_0_fdma_wdata(fdma_wdata),
        .FDMA_S_0_fdma_wready(1'b1),
        .FDMA_S_0_fdma_wsize(fdma_wsize),
        .FDMA_S_0_fdma_wvalid(fdma_wvalid),
        .sysclk(sysclk),
        .ui_clk(ui_clk)
        );

endmodule
以上代码中调用的 system.bd 的图形代码接口。 在状态机中, 每次写 500 个长度 32bit 的数据, 再读出来判断数据是否正确,因此传输 20000 字节的数据需要传输 10 次,每次FDMA 传输的地址递增 2000。
5 仿真文件
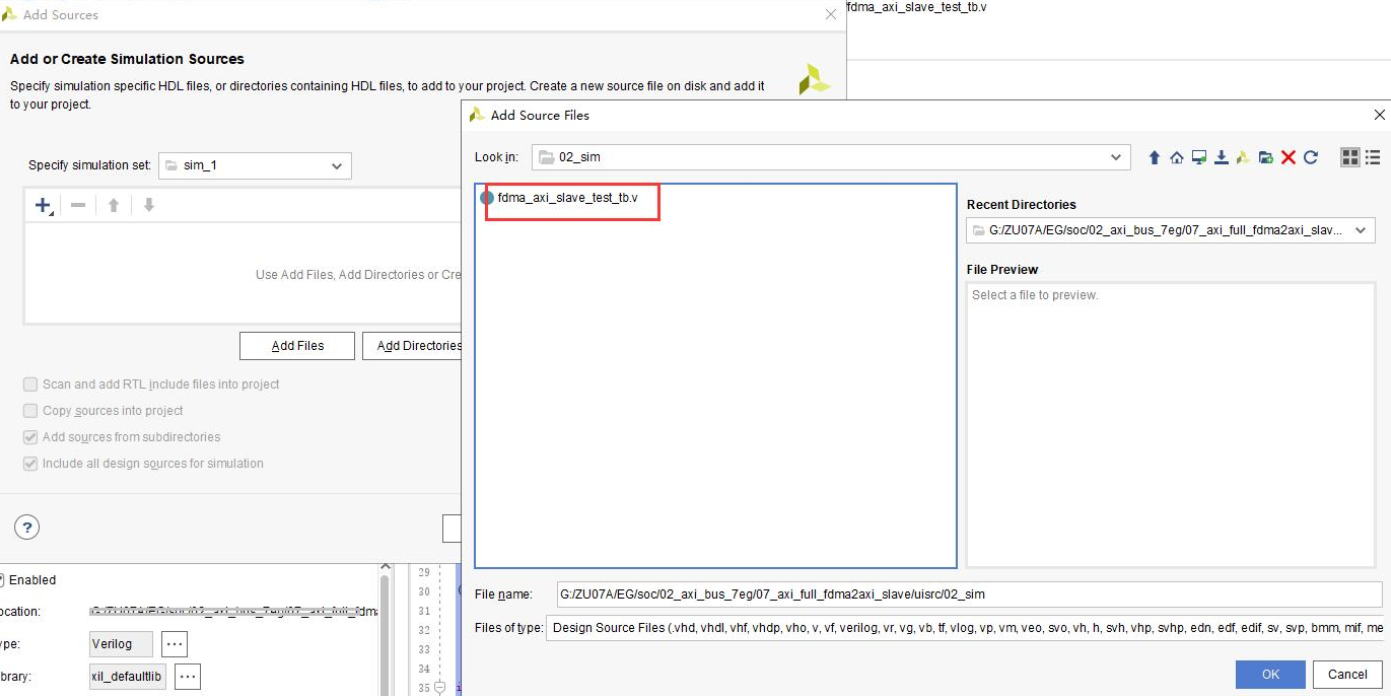
添加仿真文件。
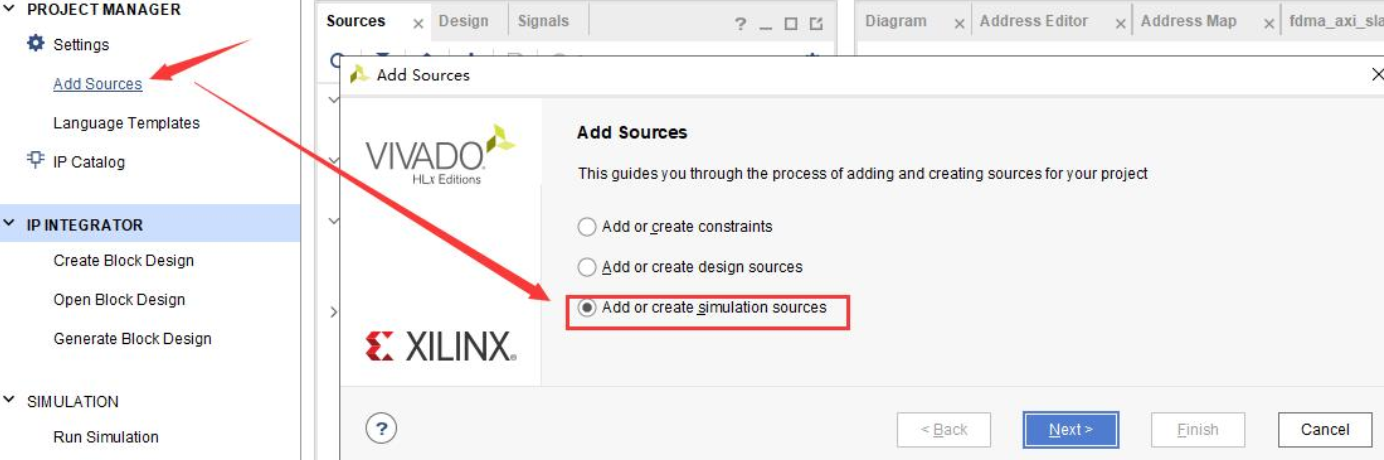
添加完成后:
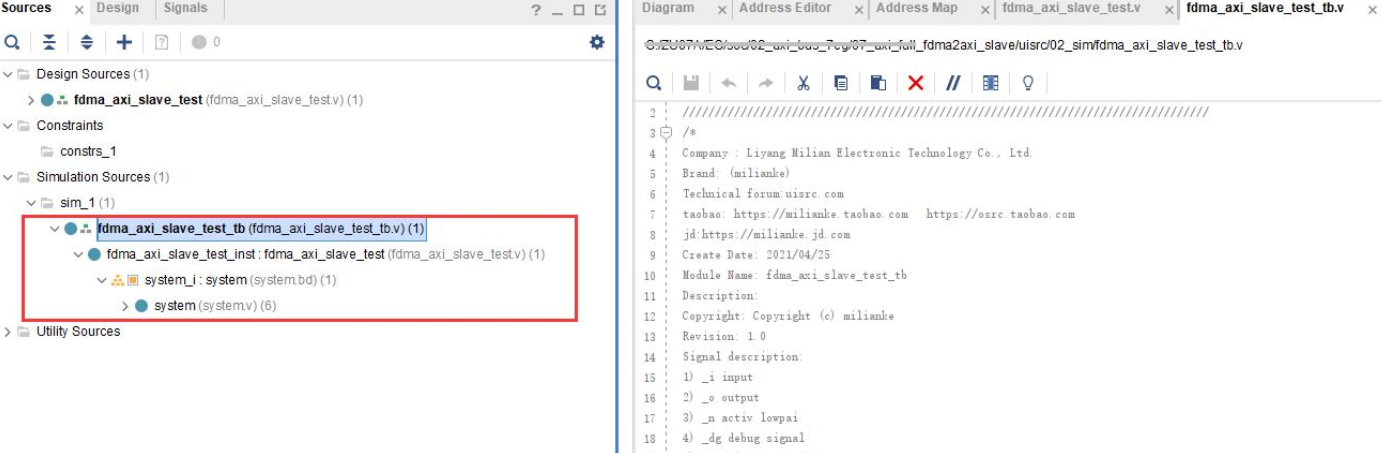
仿真文件非常简单, 只要提供时钟激励就可以。
c
module fdma_axi_slave_test_tb();

 reg I_sysclk;

 fdma_axi_slave_test fdma_axi_slave_test_inst
(
    .I_sysclk(I_sysclk)

 );

initial begin
     I_sysclk  = 0;
     #100;
end
    always #10 I_sysclk = ~I_sysclk;

endmodule
6 实验结果
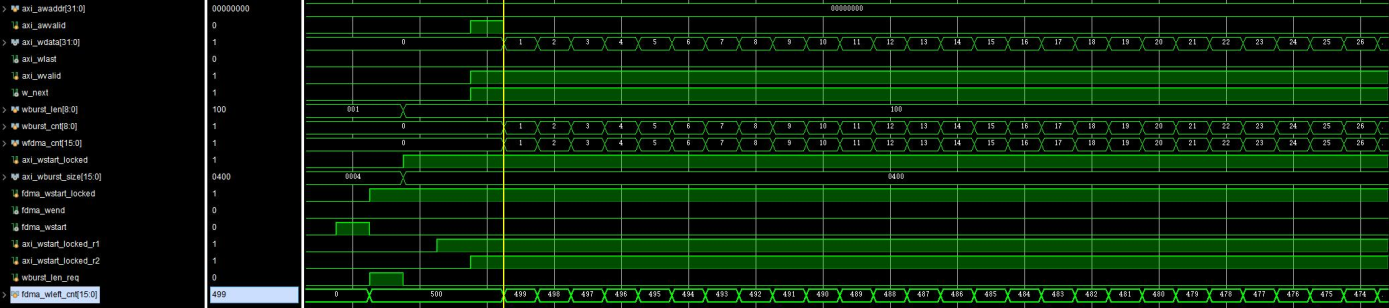
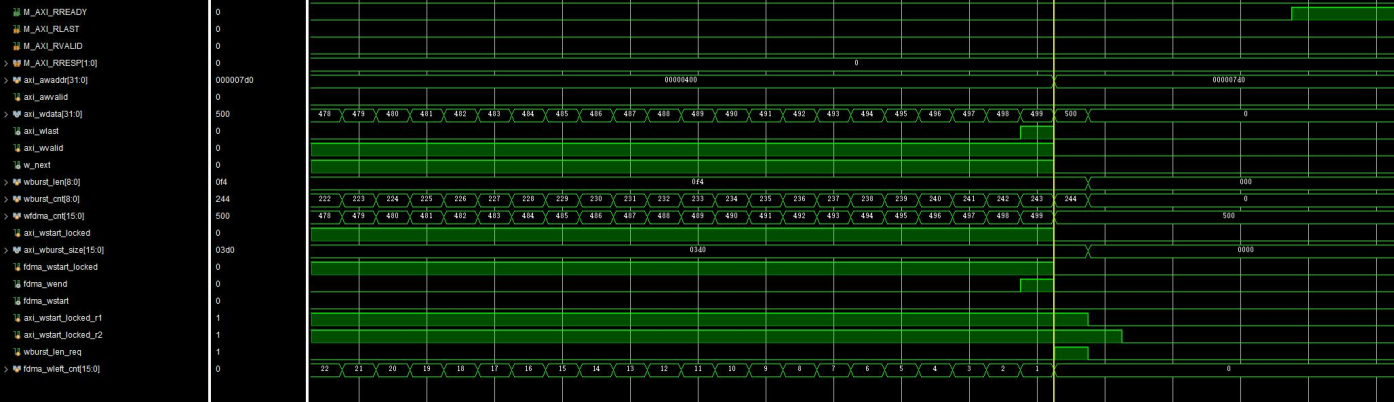
下图中红色框内分别代表了 FDMA 一次 burst 的写操作和一次 burst 的读操作。 FDMA 控制器会根据用户代码设置的 fdma_wsize 和 fdma_rsize 以及设置的 FDMA IP 参数中, AXI4 总线支持的最大 burst 长度, 来决定进行多少次的 AXI4 burst。
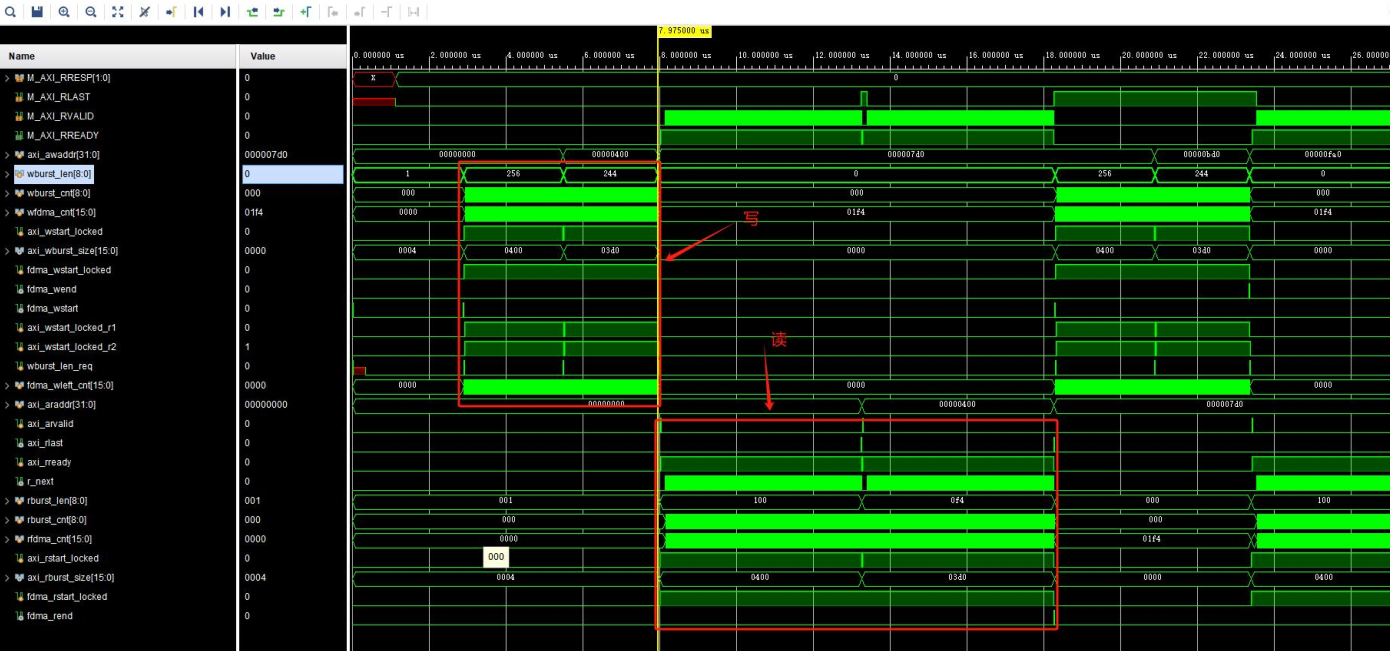
本次写传输中, wburst_len_req 自动发起计算 AXI4 总线需要发起的传输长度, 本次传输中, FDMA 的用户代码每次发起传输长度为 500, 因此 FDMA 部分会自动控制 AXI 部分的传输长度, 第一次 axi burst 长度为 256, 第二次 axi burst 长度为 244。
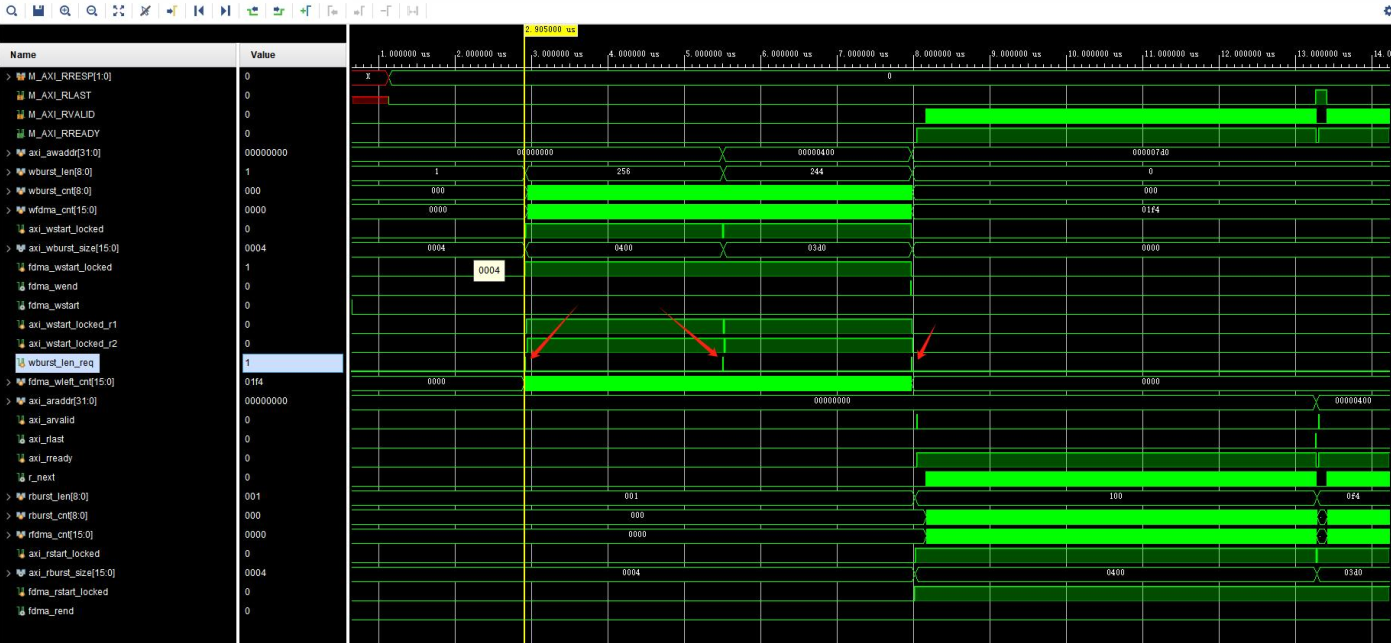
一次 FDMA 写传输的起始时序。
连续 burst,自动管理 burst 长度, 以及一次 FDMA 写传输结束时序。
本次读传输中, rburst_len_req 自动发起计算 AXI4 总线需要发起的传输长度, 本次传输中, FDMA 的用户代码每次发起传输长度为 500, 因此 FDMA 部分会自动控制 AXI 部分的传输长度, 第一次 axi burst 长度为 256, 第二次axi burst 长度为 244。
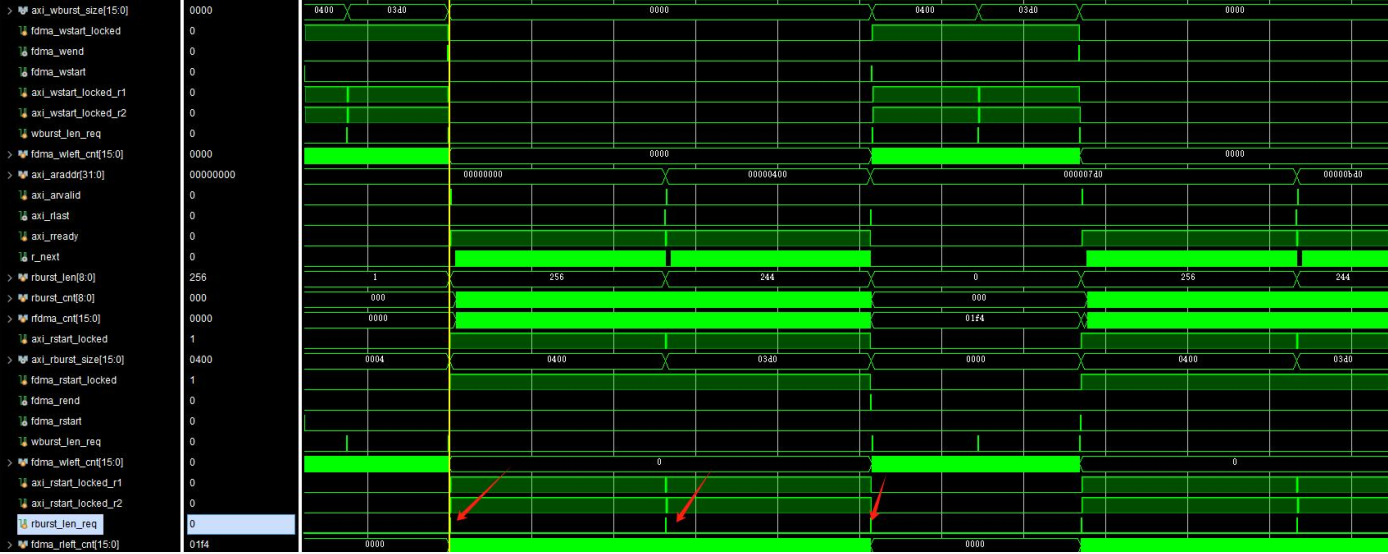
一次 FDMA 读传输的起始时序。
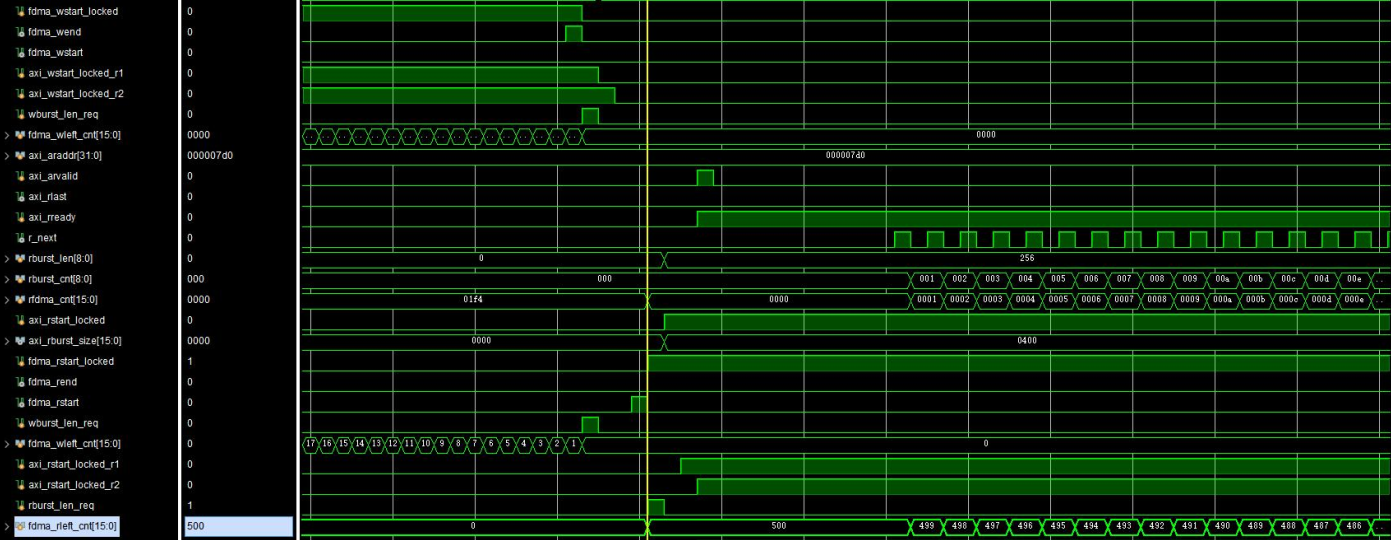
连续 burst,自动管理 burst 长度, 以及一次 FDMA 读传输结束时序。
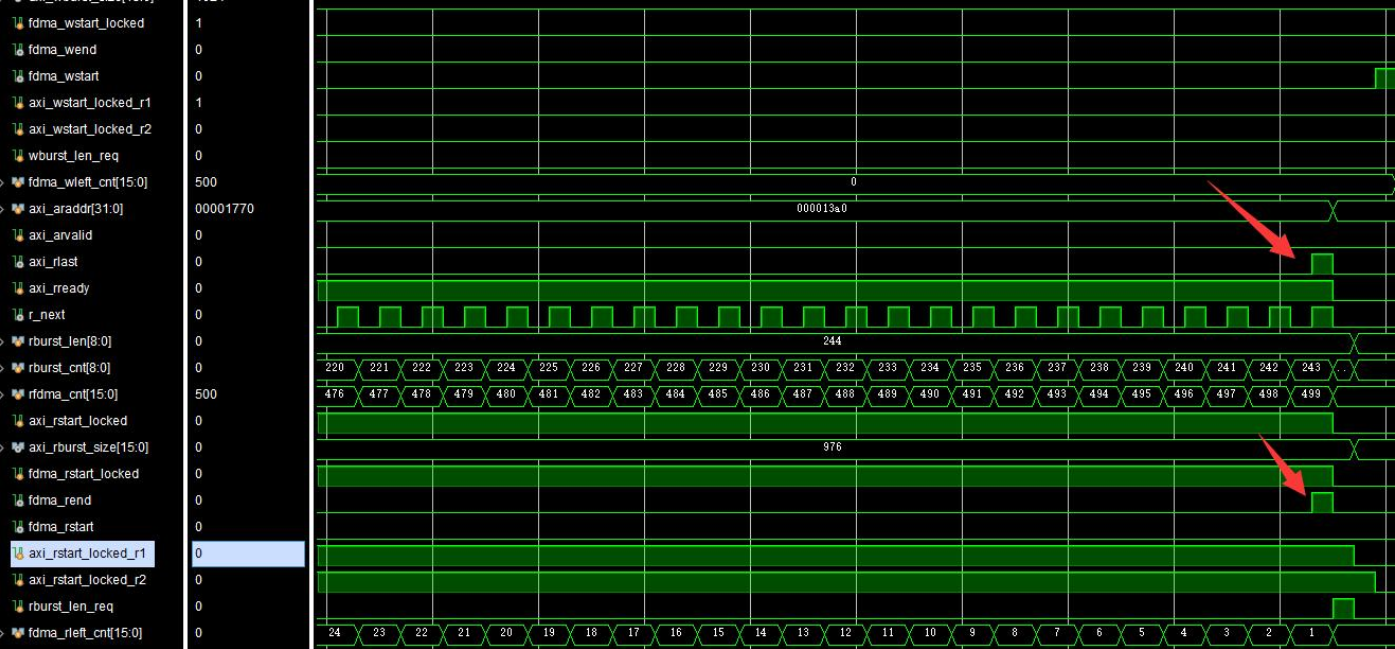
另外放大后可以看到 rvalid 不是连续的, 这个读者也可以自己去优化 saxi_ful_mem ip 让这 IP 支持连续的 rvalid。
不要忘记关注我,点赞收藏,我会为你带来更多优质内容!