上一篇,我们把复杂度这个概念彻底拆了一遍。时间复杂度和空间复杂度,各自是什么、怎么算,结合一个个经典例子和图像,掰开揉碎地讲了个透。我们还把常见的复杂度拉出来做了对比,看了各种排序算法的复杂度表格。最后,用轮转数组这道力扣题,把"算法思路有很多种"这句话落到了实处,三种不同的思路,从超时到通过,再到把时间压到O(n)、空间守到O(1),一趟走下来,算法和复杂度的关系算是看明白了。
而这一篇,我们就要翻开顺序表和链表的新篇章了。初阶的数据结构与算法,我们把知识点分成三块。第一块,复杂度。第二块,顺序表、链表、栈和队列、二叉树。第三块,排序。第一块的复杂度,已经讲完了。从这篇开始,我们正式进入第二块顺序表和链表。
目录
[2.1 顺序表的基本概念](#2.1 顺序表的基本概念)
[2.2 顺序表的两种实现方式](#2.2 顺序表的两种实现方式)
[2.2.1 静态顺序表](#2.2.1 静态顺序表)
[2.2.2 动态顺序表](#2.2.2 动态顺序表)
[2.3 顺序表的结构设计](#2.3 顺序表的结构设计)
[2.3.1 静态顺序表的结构定义](#2.3.1 静态顺序表的结构定义)
[2.3.2 动态顺序表的结构定义](#2.3.2 动态顺序表的结构定义)
[2.4 动手实现动态顺序表:从尾插入手](#2.4 动手实现动态顺序表:从尾插入手)
[2.4.1 动态顺序表的基本实现](#2.4.1 动态顺序表的基本实现)
[2.5 静态与动态顺序表的完整代码实现](#2.5 静态与动态顺序表的完整代码实现)
[2.5.1 静态顺序表的实现](#2.5.1 静态顺序表的实现)
[2.5.2 动态顺序表的实现](#2.5.2 动态顺序表的实现)
一、认识线性表
线性表(Linear List),说的是n个具有相同特性的数据元素,排成的一个有限序列。这东西在实际开发里太常见了,顺序表、链表、栈、队列、字符串,全都是线性表家族的成员。
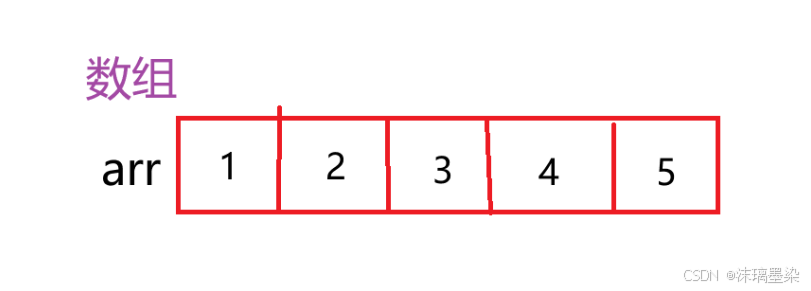
线性表在逻辑上是一条连续的直线,元素一个挨着一个,次序清清楚楚。可到了物理层面,就不一定了。它在内存里通常有两种落脚方式:一种是数组,元素挤在连续的空间里;另一种是链式结构,元素各住各的,靠指针牵线搭桥。
所以,线性表可以从两个维度来看:逻辑结构 和物理结构。逻辑结构是人为抽象出来的模型,物理结构才是它在内存里的真实存储形态。
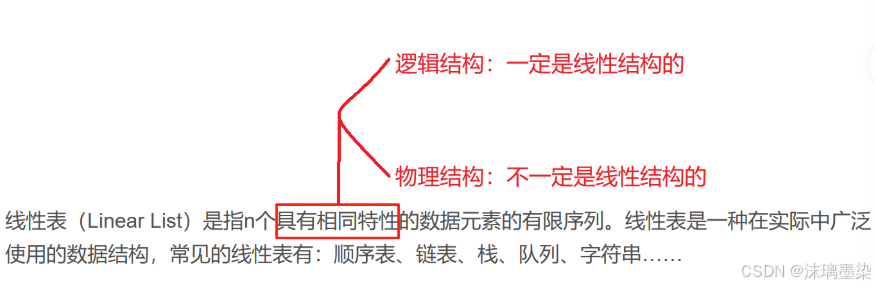
所谓逻辑结构,说白了就是人想象出来的那套秩序;而物理结构,是数据实打实躺在内存里的样子。
二、顺序表:线性表的顺序存储结构
2.1 顺序表的基本概念
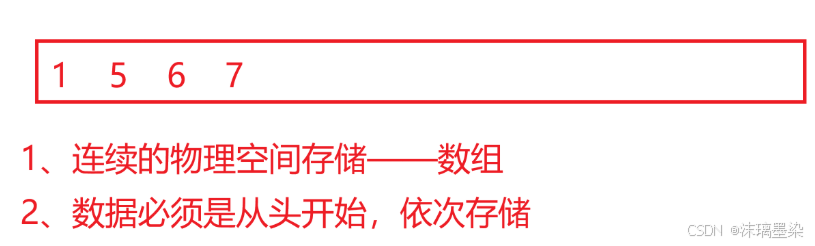
顺序表,是一段用物理地址连续的存储单元,依次把数据元素排进去的线性结构。平时,它一般就用数组来存储。那问题来了:数组就是顺序表吗?顺序表就是数组吗?能这么直接划等号吗?
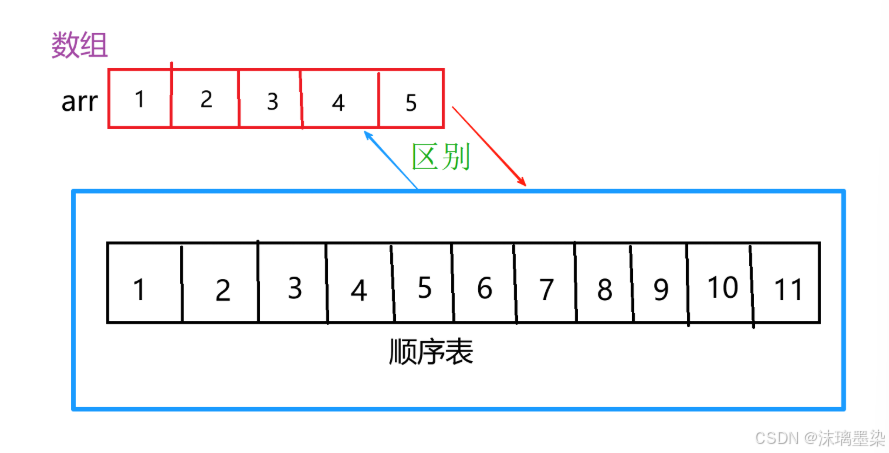
不能。真要说清楚,得这么看:顺序表的底层结构是数组,它是在数组之上做了一层封装,实现了常见的增删查改等接口。
换句话说,数据结构要干的活儿,就是把顺序表那套增删查改的接口函数,一个一个实现出来。
那数组和顺序表,到底啥关系?打个比方吧。
数组就像街边的苍蝇小馆,几口大锅、几张桌子,能填饱肚子,但没什么讲究。顺序表呢,更像米其林五星级餐厅,同样的食材,人家后厨有一套精细的流程,摆盘、上菜、服务,样样都有章法。底层都是"吃饭"这件事,可一个粗放,一个精细,体验天差地别。
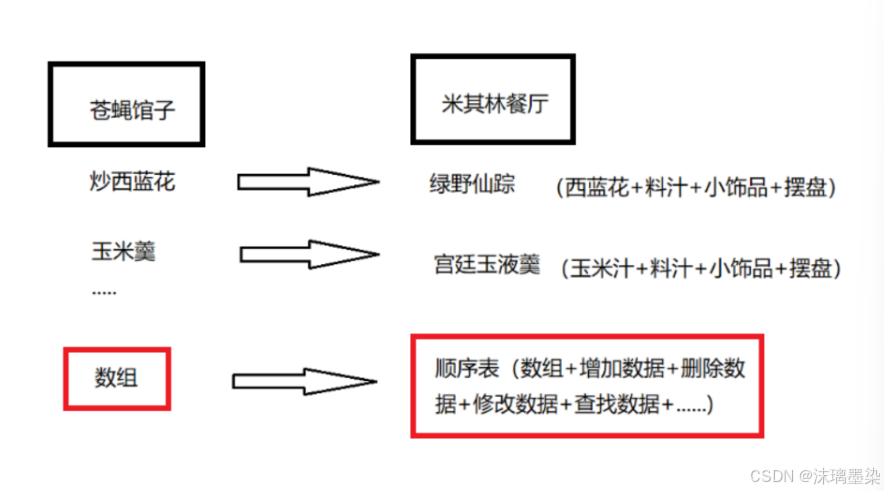
数组给你的是最原始的存储能力,而顺序表在它之上,把插入、删除、查找、修改这些操作,做成了规范、好用的接口。用起来顺手,管起来也省心。
2.2 顺序表的两种实现方式
顺序表分两种:静态顺序表 和动态顺序表。
2.2.1 静态顺序表
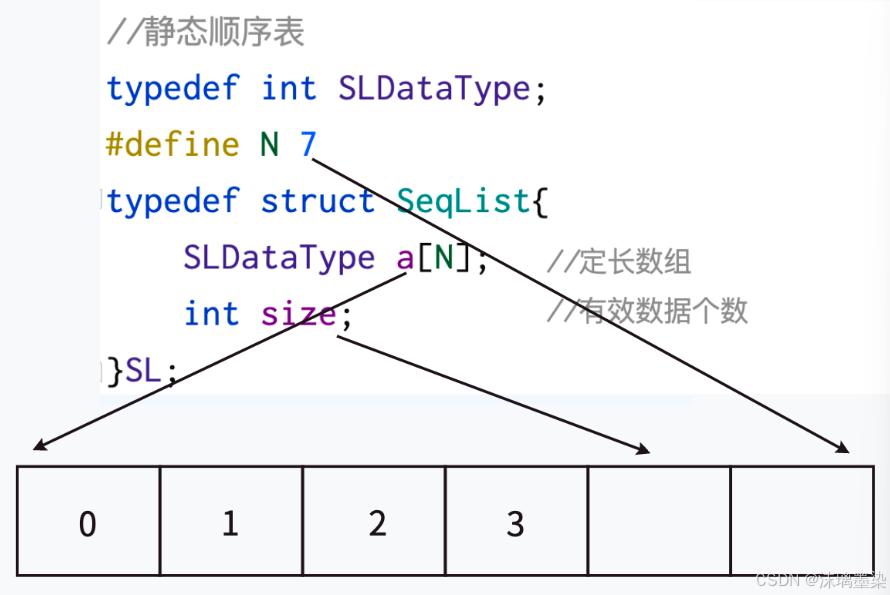
静态顺序表,就是用定长数组来存元素。开篇就定死,多大就是多大。
它的毛病也很直白:空间给少了,不够用,程序直接趴窝;给多了,用不完,白白浪费。两头不讨好,尺寸全靠拍脑袋估。估准了算运气,估不准是常态。
2.2.2 动态顺序表
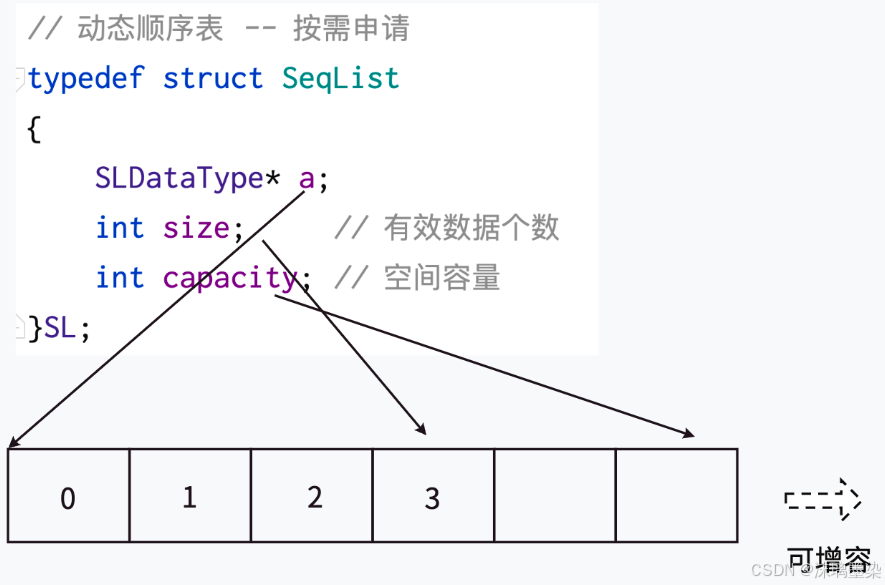
动态顺序表就不一样了,按需申请空间。要多少,给多少;不够了,再扩。空间利用率上去了,也不用再为"到底开多大"纠结半天。
静态和动态,一个把尺寸焊死,一个随用随调。各有各的适用场景,但真要灵活,还得看动态的。
2.3 顺序表的结构设计
我们分别来看静态顺序表和动态顺序表,各自长什么样。
2.3.1 静态顺序表的结构定义
静态顺序表,结构简单到不能再简单,一个定长数组,加一个记录当前元素个数的变量。
2.3.2 动态顺序表的结构定义
动态顺序表,把定长数组换成了一个指针,再配上容量和元素个数两个变量。
2.4 动手实现动态顺序表:从尾插入手
静态顺序表和动态顺序表,我们这里只实现动态顺序表。但这并不意味着静态顺序表就没有学习的必要了,这一点得先说明白。
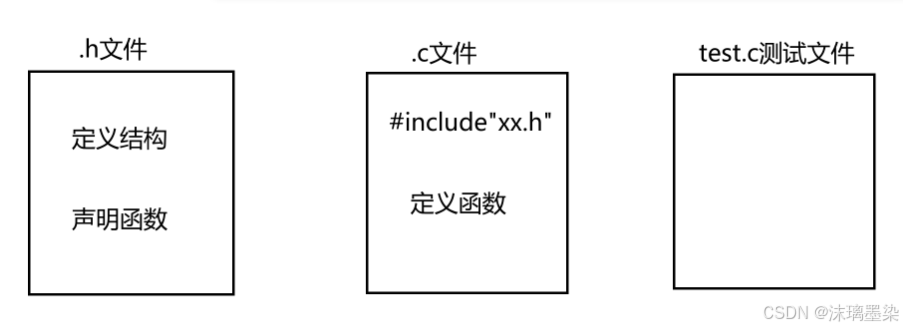
实现要分成三个文件来做。因为是顺序表,名字就叫"SeqList"。用三个文件实现一个功能,这套路我们在扫雷游戏那儿就打过交道了。简单捋一下三个文件各自的分工:
分别创建三个文件SeqList.h头文件、SeqList.c源文件、test.c测试文件。
下面会逐一介绍三个文件怎么写。每个小标题下面的第一段代码,就是动态顺序表的代码实现;代码后面,再抽丝剥茧地展开详解。
2.4.1 动态顺序表的基本实现
先看三个文件的原貌,再一个个拆开讲。代码里藏着几个要命的坑,我们边看边说。
①SeqList.h:声明顺序表结构与相关接口
cpp
#pragma once
#include <stdio.h>

typedef int SLDataType;

typedef struct SeqList
{
    SLDataType* arr;
    int size;
    int capacity;
} SL;

void SLInit(SL* ps);
void SLPushBack(SL* ps, SLDataType x);
头文件里,SLDataType是类型别名,方便以后换成别的数据类型。结构体三个成员,arr指向动态数组,size记有效数据个数,capacity记总容量。
②SeqList.c:实现顺序表功能
cpp
#define _CRT_SECURE_NO_WARNINGS 1

#include "SeqList.h"
#include <stdlib.h>

void SLInit(SL* ps)
{
    ps->arr = NULL;
    ps->size = ps->capacity = 0;
}

void SLPushBack(SL* ps, SLDataType x)
{
    if (ps->size == ps->capacity)
    {
        int newCapacity = ps->capacity == 0 ? 4 : 2 * ps->capacity;
        SLDataType* tmp = (SLDataType*)realloc(ps->arr, newCapacity * sizeof(SLDataType));
        if (tmp == NULL)
        {
            perror("realloc fail!");
            exit(1);
        }
        ps->arr = tmp;
        ps->capacity = newCapacity;
    }
    ps->arr[ps->size++] = x;
}
③test.c:编写测试代码,验证尾插功能
cpp
#define _CRT_SECURE_NO_WARNINGS 1

#include "SeqList.h"

void test01()
{
    SL sl;
    SLInit(&sl);

    SLPushBack(&sl, 1);
    SLPushBack(&sl, 2);
    SLPushBack(&sl, 3);
    SLPushBack(&sl, 4);
}

int main()
{
    test01();
    return 0;
}
2.5 静态与动态顺序表的完整代码实现
这块内容牵扯到结构体的知识。学数据结构,对结构体得有足够的认识,不然后面全是空中楼阁。
先看一段代码:
cpp
#pragma once

#define N 100
typedef int SQDataType;

struct SeqList
{
    SQDataType a[N];
    int size;
}

// 增删查改等接口函数
先说#pragma once
这行代码,博主在C语言专栏那篇文章里介绍过,截图就不重复了。它的功能很单纯:避免头文件被重复包含。
如果你不想用它,也可以写成这样,效果完全等价:
cpp
#ifdef __TEST_H__
#define __TEST_H__

#define N 100
typedef int SQDataType;

struct SeqList
{
    SQDataType a[N];
    int size;
}

// 增删查改等接口函数
#endif // __TEST_H__
一个用编译器的扩展指令,一个用预处理宏,两条路,同一个终点。
为什么类型用typedef,常量用#define?
这里有个容易犯迷糊的点。定义数据类型,我们一般用typedef;定义普通常量,才用#define。比如N是个常量100,用#define 没问题。
这么做的意义在哪?假设顺序表的数组长度写死成10:
cpp
struct SeqList
{
    int a[10];
    int size;
}
哪天想改成100,或者1000,你就得满代码翻,一个地方一个地方地改。但换成这样:
cpp
#define N 100

struct SeqList
{
    SQDataType a[N];
    int size;
}
a\[\]里直接放N,想改的时候,就在定义处把N动一下,其他地方纹丝不动。
存储的数据类型也一样。typedef int SLDataType;一写,以后想存char,就改成char;想存double,就改成double:
cpp
typedef char SLDataType;
typedef float SLDataType;
typedef double SLDataType;
只动一行,全局生效。这就是typedef的好处,把类型抽象出来,改一处,通全盘。
初始化怎么做?
初始化可以用循环,也可以直接用memset。memset是按字节来初始化的,用起来利索。
cpp
#pragma once

#define N 100
typedef int SQDataType;

struct SeqList
{
    SQDataType a[N];
    int size;
}

// 增删查改等接口函数
void SeqListInit(struct SeqList sl);
我们C语言里写结构体,不能直接用结构体名,得带上struct关键字。uu们是不是觉得这样太长了?那就简写嘛。
cpp
#ifdef __TEST_H__
#define __TEST_H__

#define N 100
typedef int SQDataType;

struct SeqList
{
    SQDataType a[N];
    int size;
}
typedef struct SeqList SL;

void SeqListInit(struct SeqList sl);
// 增删查改等接口函数
#endif // __TEST_H__
当然,还有另一种写法,很多书、很多老师都这么写:
cpp
#ifdef __TEST_H__
#define __TEST_H__

#define N 100
typedef int SQDataType;

typedef struct SeqList
{
    SQDataType a[N];
    int size;
} SL;

void SeqListInit(struct SeqList sl);
// 增删查改等接口函数
#endif // __TEST_H__
这样就不用再写长长的一截struct SeqList了,直接写简写SL:
cpp
#ifdef __TEST_H__
#define __TEST_H__

#define N 100
typedef int SQDataType;

typedef struct SeqList
{
    SQDataType a[N];
    int size;
} SL;

void SeqListInit(SL sl);
// 增删查改等接口函数
#endif // __TEST_H__
是不是简单多了?
这里再提醒一下uu们:敲代码,别一股脑全写完再测试。写一个,测一个。
代码一长,一口气写完再运行,唰地蹦出几十个错误,你盯着屏幕反复调,调了一两个小时,再一运行,又炸出几十个错误,人当场就崩了。
写一个测一个,有问题也只在这几行代码里,好找、好改,犯不着自己吓自己。
顺序表嘛,本质就是个数组。uu们可能觉得N这个变量名不好理解,那我们就把它写明白:
cpp
#ifdef __TEST_H__
#define __TEST_H__

#define MAX_SIZE 100
typedef int SQDataType;

typedef struct SeqList
{
    SQDataType a[MAX_SIZE];
    int size;
} SL;

void SeqListInit(SL s);
// 增删查改等接口函数
#endif // __TEST_H__
这下是不是一眼就懂MAX_SIZE,数组最大容量,清清楚楚。初始化写起来也顺:
cpp
#include "SeqList.h"

void SeqListInit(SL s)
{
    memset(sl.a, 0, sizeof(SQDataType) * MAX_SIZE);
    sl.size = 0;
    // sl.a 说明是按字节初始化
    // 初始化多少个字节呢?MAX_SIZE 个
    // 每个有多大呢?sizeof(SQDataType)------SQDataType 这个类型每一个的大小
}
到这里,定义数组大小为MAX_SIZE的好处就更明显了。想改数组大小?只在.h文件里动一下MAX_SIZE,所有包含这个头文件的地方,全都跟着变。方便得不像话。
定义数据类型也一样,本质上都是增强程序的可维护性------不用满世界找着改。
那我们现在开始,写一点,测一点。程序要输入输出,得包含头文件。不知道memset在哪个头文件?查一下嘛,<cstring>或者<string.h>,这俩是一样的。
cpp
#ifdef __TEST_H__
#define __TEST_H__

#include <stdio.h>
#include <string.h>

// 增强程序可维护性
#define MAX_SIZE 100
typedef int SQDataType;

typedef struct SeqList
{
    SQDataType a[MAX_SIZE];
    int size;
} SL;

void SeqListInit(SL s);
// 增删查改等接口函数
#endif // __TEST_H__
然后来到test.c,先写个简单的:
cpp
#include "SeqList.h"

void TestSeqList1()
{
    SL sl;
    SeqListInit(SL s1);
    // 调接口进行初始化
}

int main()
{
    return 0;
}
定义完了,先跑一跑看看。调试的时候,可以结合VS调试技巧F9打断点,F5调试,程序就停在断点处。
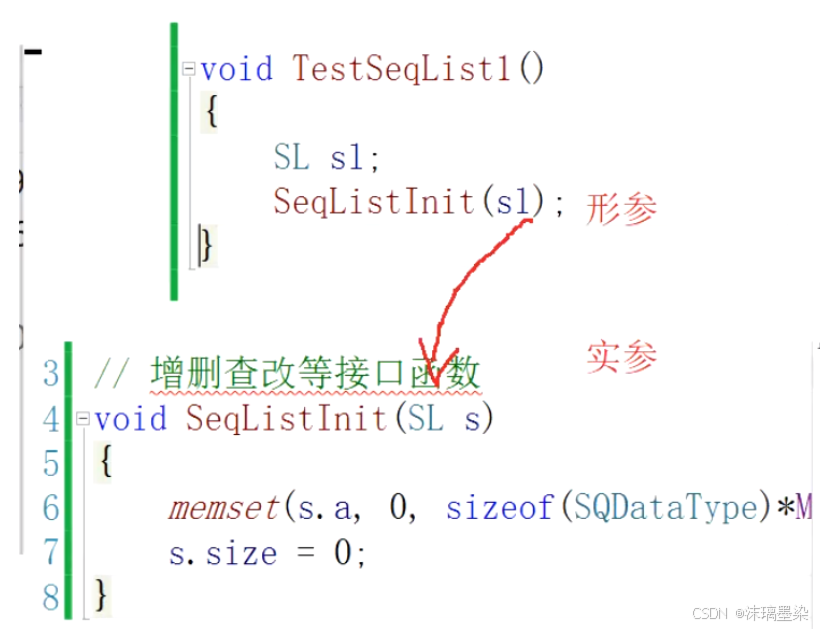
不过这里我们就不能这么写了,前面那几处得改一改。
2.5.1 静态顺序表的实现
我们C语言里学过通讯录,那个结构,跟静态顺序表一个路子,定义一个宏,尺寸就写死了。
①SeqList.h:定义静态顺序表结构与接口
cpp
#ifndef __TEST_H__
#define __TEST_H__

#include <stdio.h>
#include <string.h>

// 增强程序可维护性
#define MAX_SIZE 10   // 100 个、500 个有点太大了,先来 10 个
typedef int SQDataType;

typedef struct SeqList
{
    SQDataType a[MAX_SIZE];
    int size;
} SL;

// 增删查改等接口函数
void SeqListInit(SL* ps);
void SeqListPushBack(SL* ps, SQDataType x);   // 尾插
void SeqListPushFront(SL* ps, SQDataType x);  // 头插
void SeqListPopBack(SL* ps);                  // 尾删
void SeqListPopFront(SL* ps);                 // 头删

#endif
这里的命名,uu们如果自己有别的习惯,也完全可以。博主这里是跟着C++ STL标准库的命名走的,算是比较规范的写法:
cpp
void SeqListPushBack(SL* ps, SQDataType x);   // 尾插
void SeqListPushFront(SL* ps, SQDataType x);  // 头插
void SeqListPopBack(SL* ps);                  // 尾删
void SeqListPopFront(SL* ps);                 // 头删
当然,接口不止这些。还是老原则,写一个,测一个。
②SeqList.c:实现静态顺序表相关操作
cpp
#include "SeqList.h"

void SeqListInit(SL* ps)
{
    memset(ps->a, 0, sizeof(SQDataType) * MAX_SIZE);
    ps->size = 0;
}

// 头插、尾插、头删、尾删
void SeqListPushBack(SL* ps, SQDataType x)
{
    if (ps->size >= MAX_SIZE)
    {
        printf("SeqList is Full\n");
        return;
    }
    ps->a[ps->size] = x;
    ps->size++;
}

// 下面几个大致也是这个套路,就不一一展开了
void SeqListPushFront(SL* ps, SQDataType x);
void SeqListPopBack(SL* ps);
void SeqListPopFront(SL* ps);
从这里就能看出,静态顺序表不是一块好料。你想存1001个数据,就得把MAX_SIZE定义成10000,白白空着一大片。总结一下它的毛病:
给少了不够用,给多了用不完,浪费空间,控制不灵活。
正因如此,我们才转向更灵活的动态顺序表。静态顺序表,就介绍到这儿。
③test.c:测试静态顺序表
cpp
#include "SeqList.h"

void TestSeqList1()
{
    SL sl;
    SeqListInit(&sl);
    // 调接口进行初始化
}

int main()
{
    TestSeqList1();
    return 0;
}
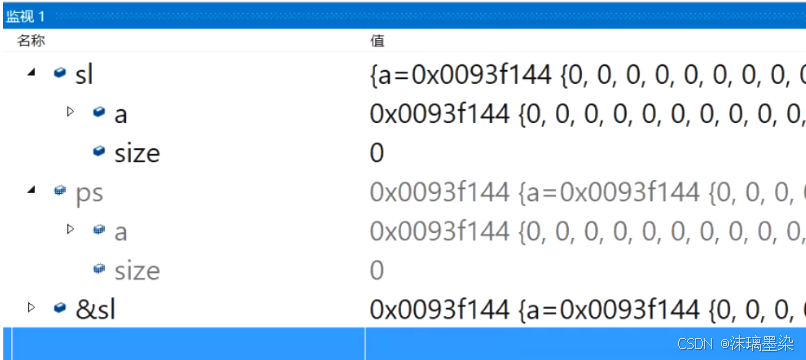
这里为什么要传指针呢?
因为形参只是实参的一份临时拷贝,形参和实参各有各的空间,彼此独立。你在函数里改形参,外面那个实参根本不知道。所以,得把地址传进去。传了地址,函数就能顺着地址找到实参本尊,改的就是它了。
那为什么传地址就能影响到实参?
因为地址指向的就是实参所在的那块内存。函数拿到地址后,通过指针解引用,直接操作的就是实参本身。拷贝的是地址,可地址指向的,是同一块地方。所以,形参改的,就是实参。
2.5.2 动态顺序表的实现
①SeqList.h:定义动态顺序表结构与接口
cpp
#ifdef __SEQLIST__H__
#define __SEQLIST__H__

#include <stdio.h>
#include <string.h>

// 增强程序可维护性
typedef int SLTDataType;

typedef struct SeqList
{
    SLTDataType* a;
    int size;      // 有效数据的个数
    int capacity;  // 容量
} SL;

// 增删查改等接口函数
void SeqListInit(SL* ps);
void SeqListPrint(SL* ps);
void SeqListPushBack(SL* ps, SLTDataType x);   // 尾插
void SeqListPushFront(SL* ps, SLTDataType x);  // 头插
void SeqListPopBack(SL* ps);                   // 尾删
void SeqListPopFront(SL* ps);                  // 头删

#endif
②SeqList.c:实现动态顺序表及尾插操作
cpp
#include "SeqList.h"

void SeqListInit(SL* ps)
{
    // 粗暴一点,先置为空,再改成 0,然后 capacity 也改为 0
    ps->a = NULL;
    ps->size = 0;
    ps->capacity = 0;
    // 当然,我们也可以直接 malloc
}

// 头插、尾插、头删、尾删
void SeqListPushBack(SL* ps, SLTDataType x)
{
    // 满了就要扩容
    if (ps->size == ps->capacity)
    {
        // 扩容一般扩两倍。一个一个太慢了,三倍又太多了,C++ 标准库一般是扩两倍
        // 我们有两种思路:一种是新开辟一个两倍的空间,然后把原来的内容复制过去;
        // 另一种是 realloc
        int newcapacity = ps->capacity == 0 ? 4 : ps->capacity * 2;
        // 第一次给多少没什么讲究,给个 10 也可以,只是一开始不要给太大,给太大就浪费了
        // 动态管理,就是开始给小一点,不够了慢慢增加
        // 最小给个 1
        SLTDataType* tmp = realloc(ps->a, newcapacity * sizeof(SLTDataType));
        // realloc 有可能失败
        if (tmp == NULL)
        {
            printf("realloc fail\n");
            exit(-1);
        }
        else
        {
            ps->a = tmp;
            // ps->capacity *= 2;  // 这里就不是乘两倍了,直接等于 newcapacity
            ps->capacity = newcapacity;
        }
    }
    ps->a[ps->size] = x;
    ps->size++;
}

void SeqListPushFront(SL* ps, SLTDataType x);
void SeqListPopBack(SL* ps);
void SeqListPopFront(SL* ps);

void SeqListPrint(SL* ps)
{
    for (int i = 0; i < ps->size; ++i)
    {
        printf("%d ", ps->a[i]);
    }
    printf("\n");
}③test.c:测试动态顺序表
cpp
#include "SeqList.h"

void TestSeqList1()
{
    SL sl;
    SeqListInit(&sl);

    SeqListPushBack(&sl, 1);
    SeqListPushBack(&sl, 2);
    SeqListPushBack(&sl, 3);
    SeqListPushBack(&sl, 4);
    SeqListPushBack(&sl, 5);
    SeqListPushBack(&sl, 6);
    SeqListPushBack(&sl, 7);
    SeqListPushBack(&sl, 8);
    SeqListPushBack(&sl, 9);
    SeqListPushBack(&sl, 10);
    SeqListPushBack(&sl, 11);

    SeqListPrint(&sl);
}

int main()
{
    TestSeqList1();
    return 0;
}
这就是尾插。只要内存够,就能一直插下去。它不像静态顺序表那样,得提前定死存多少个,不够了就扩容,可以一直尾插。这就是动态顺序表相较于静态顺序表的优越性。
那么uu们可能要问了:realloc不是在原来空间的基础上扩容吗?如果原来空间是0呢?
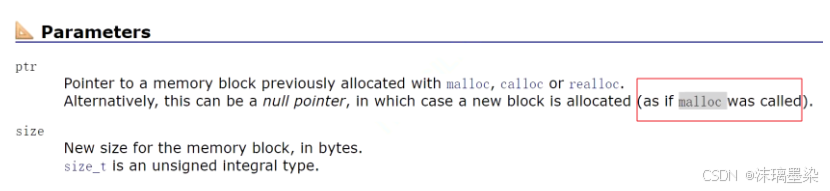
realloc的文档里有一句说明:原来空间可以为空。只不过这样一来,realloc就等同于malloc,如果原来空间为空,它直接申请一块新空间,跟malloc一模一样。
像头插、指定插入、指定删除这些知识点,博主会专门整理一篇博客。当然,一篇肯定讲不完,给主包一点时间整理。或者,铸币主包把它们融进顺序表和链表的博客里,也是可行的。
如果这篇文章对你有帮助,别忘了点赞、收藏、关注三连支持。你的每一次反馈,都是我继续硬核输出的最大动力。