目录
-
- 前言
- [1. Course Introduction](#1. Course Introduction)
- [2. About the Instructor](#2. About the Instructor)
- [3. Why Efficient AI: The Compute Gap](#3. Why Efficient AI: The Compute Gap)
- [4. Efficient AI for Computer Vision](#4. Efficient AI for Computer Vision)
-
- [4.1 Image Classification: Accuracy vs. Compute](#4.1 Image Classification: Accuracy vs. Compute)
- [4.2 On-Device Inference and Training](#4.2 On-Device Inference and Training)
- [4.3 Promptable Image Segmentation](#4.3 Promptable Image Segmentation)
- [4.4 Efficient Image, Video and 3D Generation](#4.4 Efficient Image, Video and 3D Generation)
- [4.5 3D Perception](#4.5 3D Perception)
- [5. Efficient AI for Language Models](#5. Efficient AI for Language Models)
-
- [5.1 LLM Capabilities and Their Cost](#5.1 LLM Capabilities and Their Cost)
- [5.2 Efficient LLM Techniques](#5.2 Efficient LLM Techniques)
- [6. Multimodal and Embodied AI](#6. Multimodal and Embodied AI)
-
- [6.1 Vision-Language Models](#6.1 Vision-Language Models)
- [7. Hardware Foundations: Three Pillars](#7. Hardware Foundations: Three Pillars)
- [8. Course Overview and Takeaways](#8. Course Overview and Takeaways)
- 结语
- 参考
前言
学习 MIT 韩松教授讲授的 MIT 6.5940: Tiny ML and Efficient AI Computing 课程,本篇文章记录 第一讲:概述 的学习内容,和大家一起分享交流😄
1. Course Introduction
这门课由 MIT 的 Song Han 教授讲授,侧重于 高效的机器学习训练、推理技术。学生需要有一定的深度学习方面的知识基础。
课程主要分为 三个部分 。第一部分讲授让神经网络轻量化的各种关键技术,例如 剪枝、量化、蒸馏、网络架构搜索 等等。有了这些基础之后,第二部分会介绍面向特定领域场景的各种高效优化技术,内容覆盖当前深度学习最前沿、最热门的各个方向,例如 大语言模型的推理、长上下文支持、后训练加速、多模态大语言模型、GAN、扩散模型 等等。第三部分则聚焦各类 高效训练技术 ,例如 大规模分布式并行、自动并行优化、梯度压缩、边缘训练 等等。Song Han 教授的讲解深入浅出,覆盖的知识面很广,且都是当前热门的领域方向;如果你只是想对大语言模型有一个初步了解,也可以重点关注第二、第三部分的内容。
课程作业一共有 5 个 ,前三个分别考察 GPU 基础、剪枝和 NAS ,后两个聚焦 大语言模型的压缩与高效部署,总体难度不算高,但能很好地巩固核心知识。
另外想说一下,博主之所以对这门课感兴趣,主要是因为它涉及 高性能计算与优化 ,正好是博主喜欢的方向。此前在学习 CUDA与TensorRT部署实战课程 的 CUDA-BEVFusion 时,韩君老师提到过 BEVFusion 的原始仓库 mit-han-lab,里面有不少出色的项目,而且 这些项目都很关注模型效率 。这一点也是 mit-han-lab 比较特别、比较有优势的地方。而这个仓库正是 Song Han 教授实验室的仓库,所以也一直想听听韩松老师的课程。
2. About the Instructor
以下为老师自述:
我叫韩松(Song Han),八年前加入 MIT,此前在清华大学获得学士学位,在斯坦福大学获得博士学位。我在 模型压缩和高效 AI 计算 领域已经做了十多年,我读研究生时正好赶上 AlexNet 刚刚出现的 2012 年,那时的模型只有 600 万个参数 。而现在我们在谈论的是 数千亿参数,甚至三万亿参数。过去十年的这种增长令人惊叹,能亲眼见证这个趋势,并和你们分享这段历程,真的非常激动。
我发表过一篇叫 Deep Compression(深度压缩) 的论文,能在保持精度的前提下 把神经网络压缩一个数量级 ,从而节省大量内存;我还设计了高效的推理引擎,为稀疏化、压缩后的模型加速。后来稀疏性被采纳,从 Ampere GPU 架构开始得到支持。之后我做了一家创业公司把这些技术商业化,公司被 XILINX 收购,后来 XILINX 又被 AMD 收购;随后我加入了 MIT,做了几个与高效 AI 计算相关的项目,比如 AWQ(activation-aware weight quantization,激活感知权重量化) ,这个项目的 下载量已经超过 6000 万次。如果你想在本地设备上部署这些大语言模型,很可能就会从这个项目中受益。
这门课里的很多技术都已经被商业化了,所以这是一门非常有用的课:被收购的不只是我的创业公司---我学生 Henry Wong 做的 Token Factory 今年也被收购了;另外还有两个学生在创业,可见机会很多。
3. Why Efficient AI: The Compute Gap
为什么我们需要高效 AI?
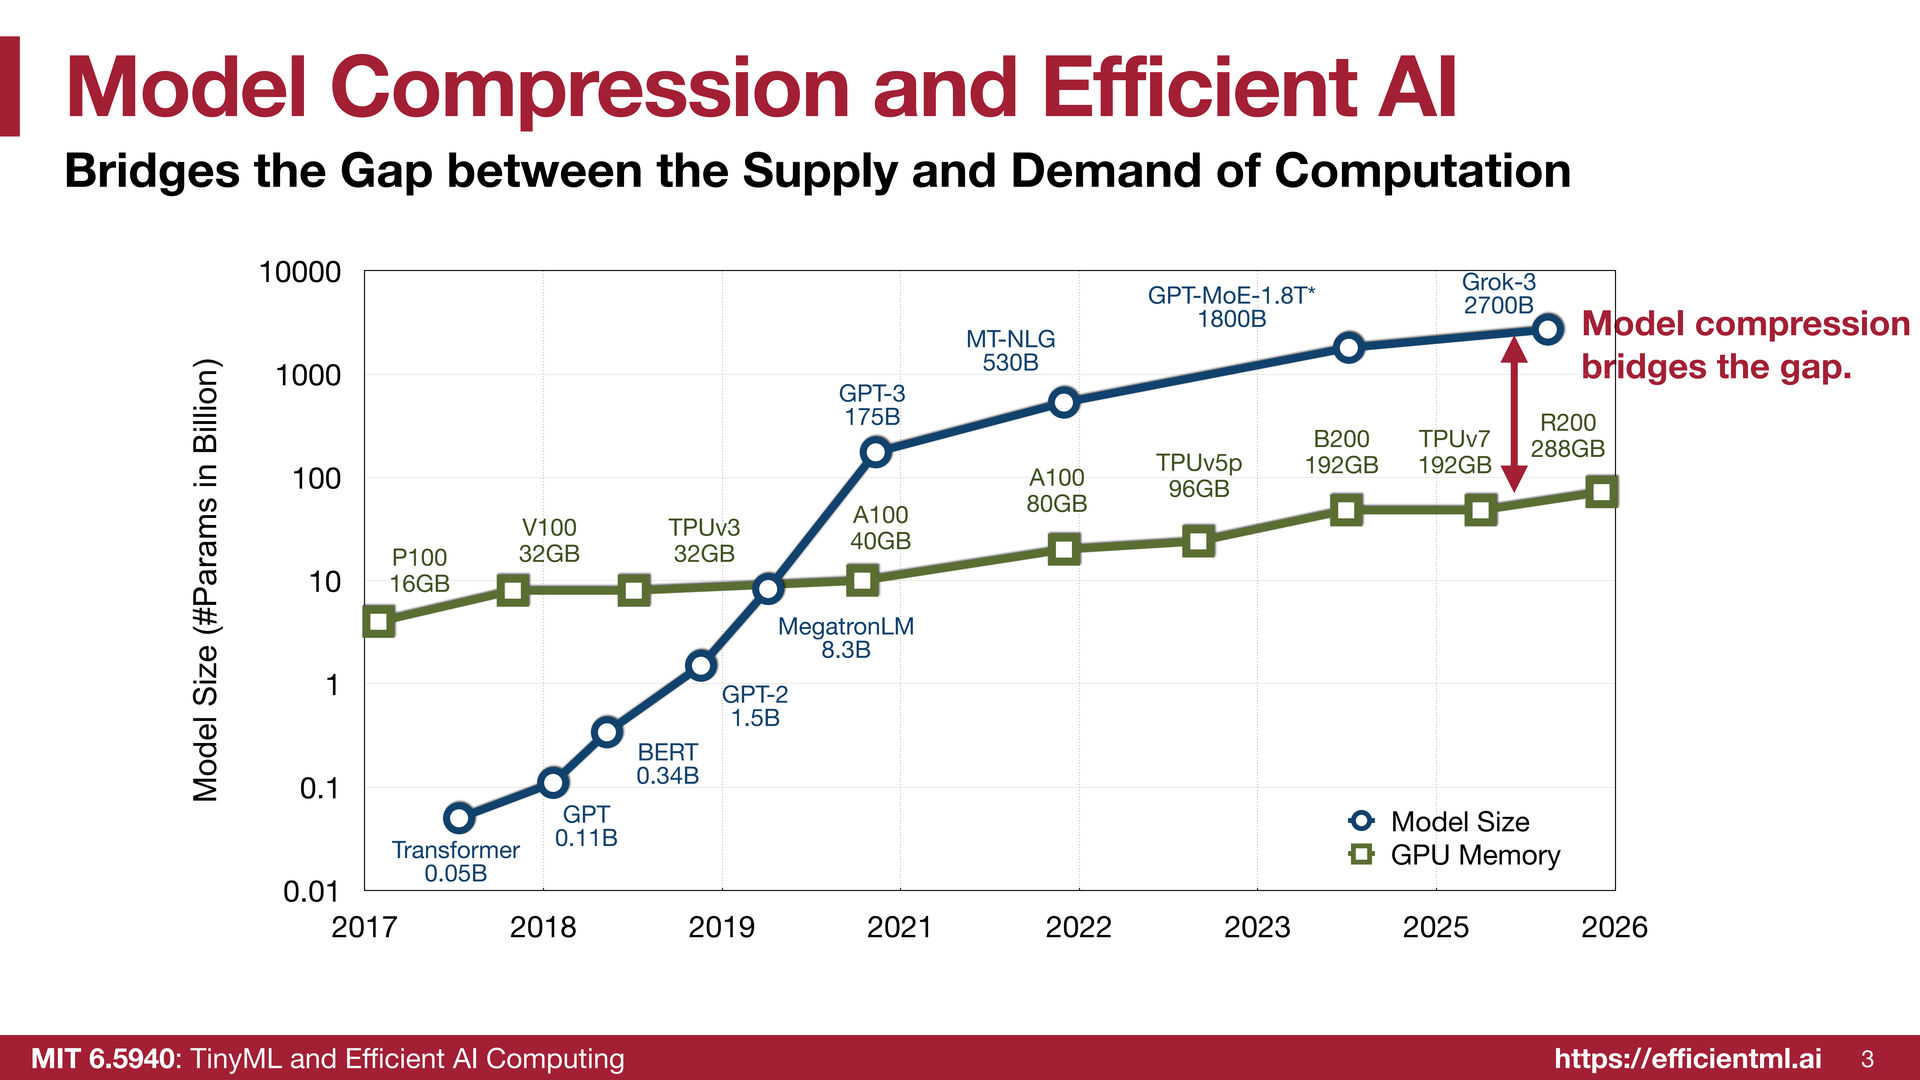
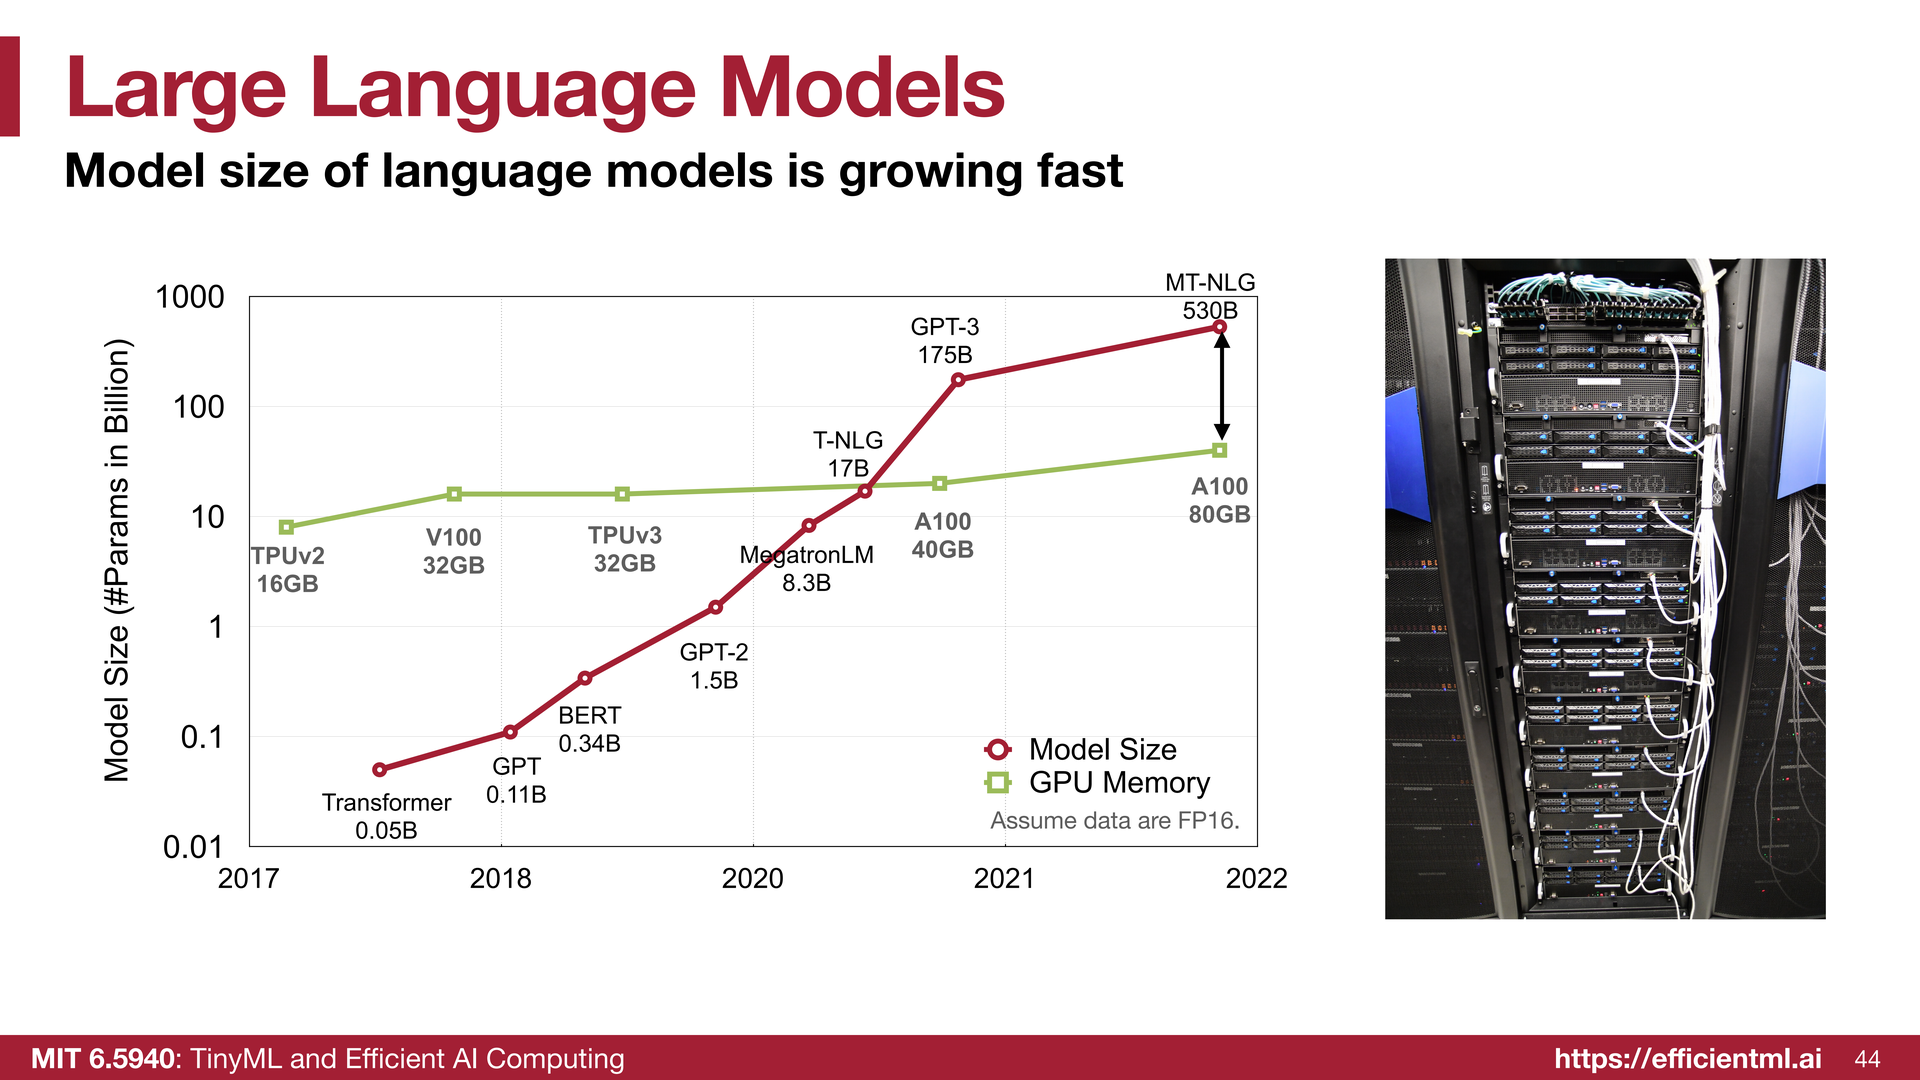
这张图展示了从 2017 年一直到 2026 年模型规模的演变,蓝色部分代表模型规模,与之对比的是可用的 GPU 显存---如今内存变得非常昂贵。可以看到,模型的增长速度远远快于 GPU 显存容量的增长,所以从供给的角度看,我们这边供给的是那条绿线:比如 2017 年的 P100 大约 16 GB,那正是我毕业的那一年,那时的 GPU 只有 16 GB 显存;然后是 V100 的 32 GB,A100 的 40 GB,然后 B200 一下涨到 192 GB,而 Rubin 架构的显存则超过 200 GB。
显存的增长很稳定,但 相对于模型规模的需求来说还是慢得多 。举个例子,2017、2018 年前后的 Transformer 大约 5000 万参数;GPT 第一个模型只有 1 亿参数;然后是 GPT-2 的 15 亿,Megatron 的 80 亿;后来的 GPT-3 1750 亿;现在人们在谈论 2.7 万亿参数,甚至 10 万亿参数 的模型。所以它增长得非常快,而且别忘了,这张图的纵轴是对数坐标,实际增长比图上看起来还要惊人。
算力的供需缺口正在变得越来越大。 我们想弥合这个缺口,因此需要 效率、需要模型压缩:把模型变小,就能用更少的算力填平供给与需求之间的鸿沟。
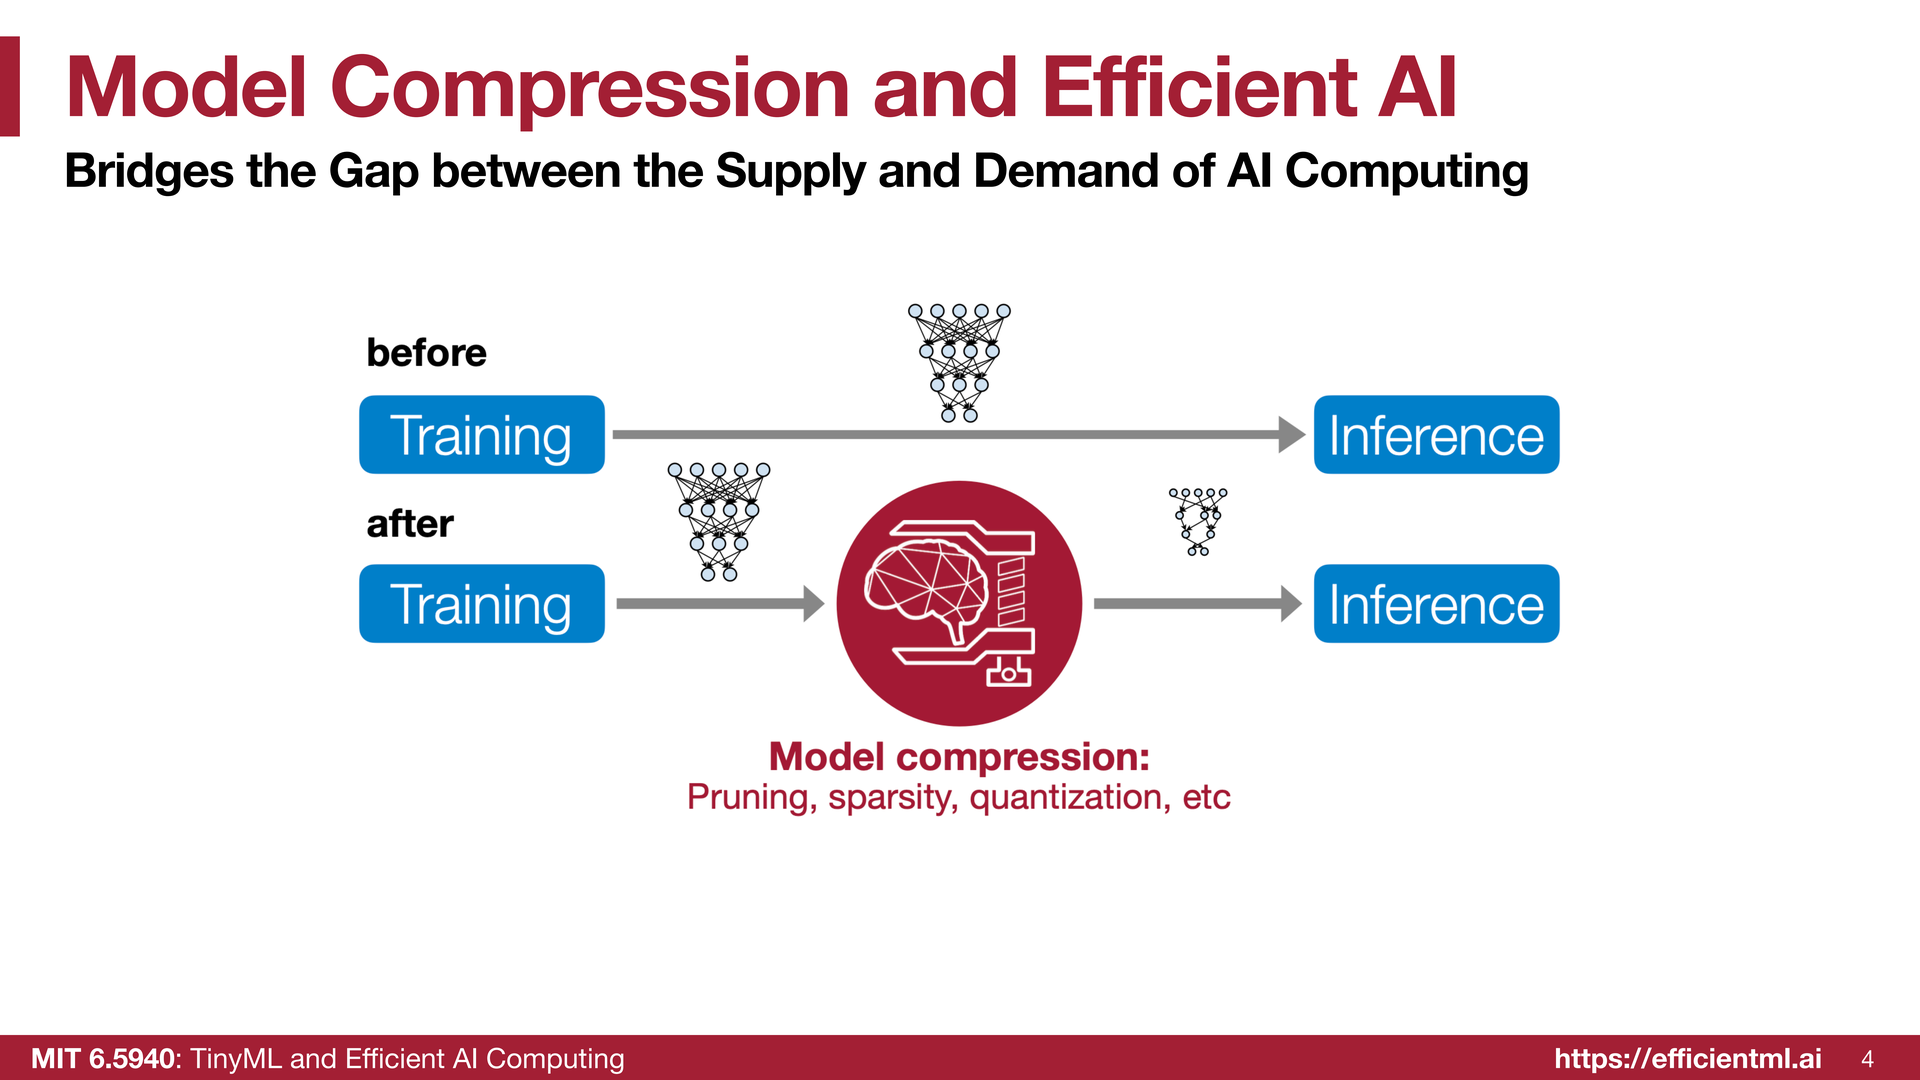
常规做法是训练一个模型然后直接部署,但那样非常耗电,也需要大量内存。而我们在这门课里要学的正是 模型压缩和效率技术 :把模型变得更小,再通过剪枝、量化、稀疏化来保持精度---其中很多技术会在学期后面讲到。这样在完成所有实验之后,你就能 把一个大语言模型塞进自己的笔记本电脑,本地跑起来。
我先快速概览一下我们将要详细介绍的两种技术,让大家对我们讲的内容有个概念。
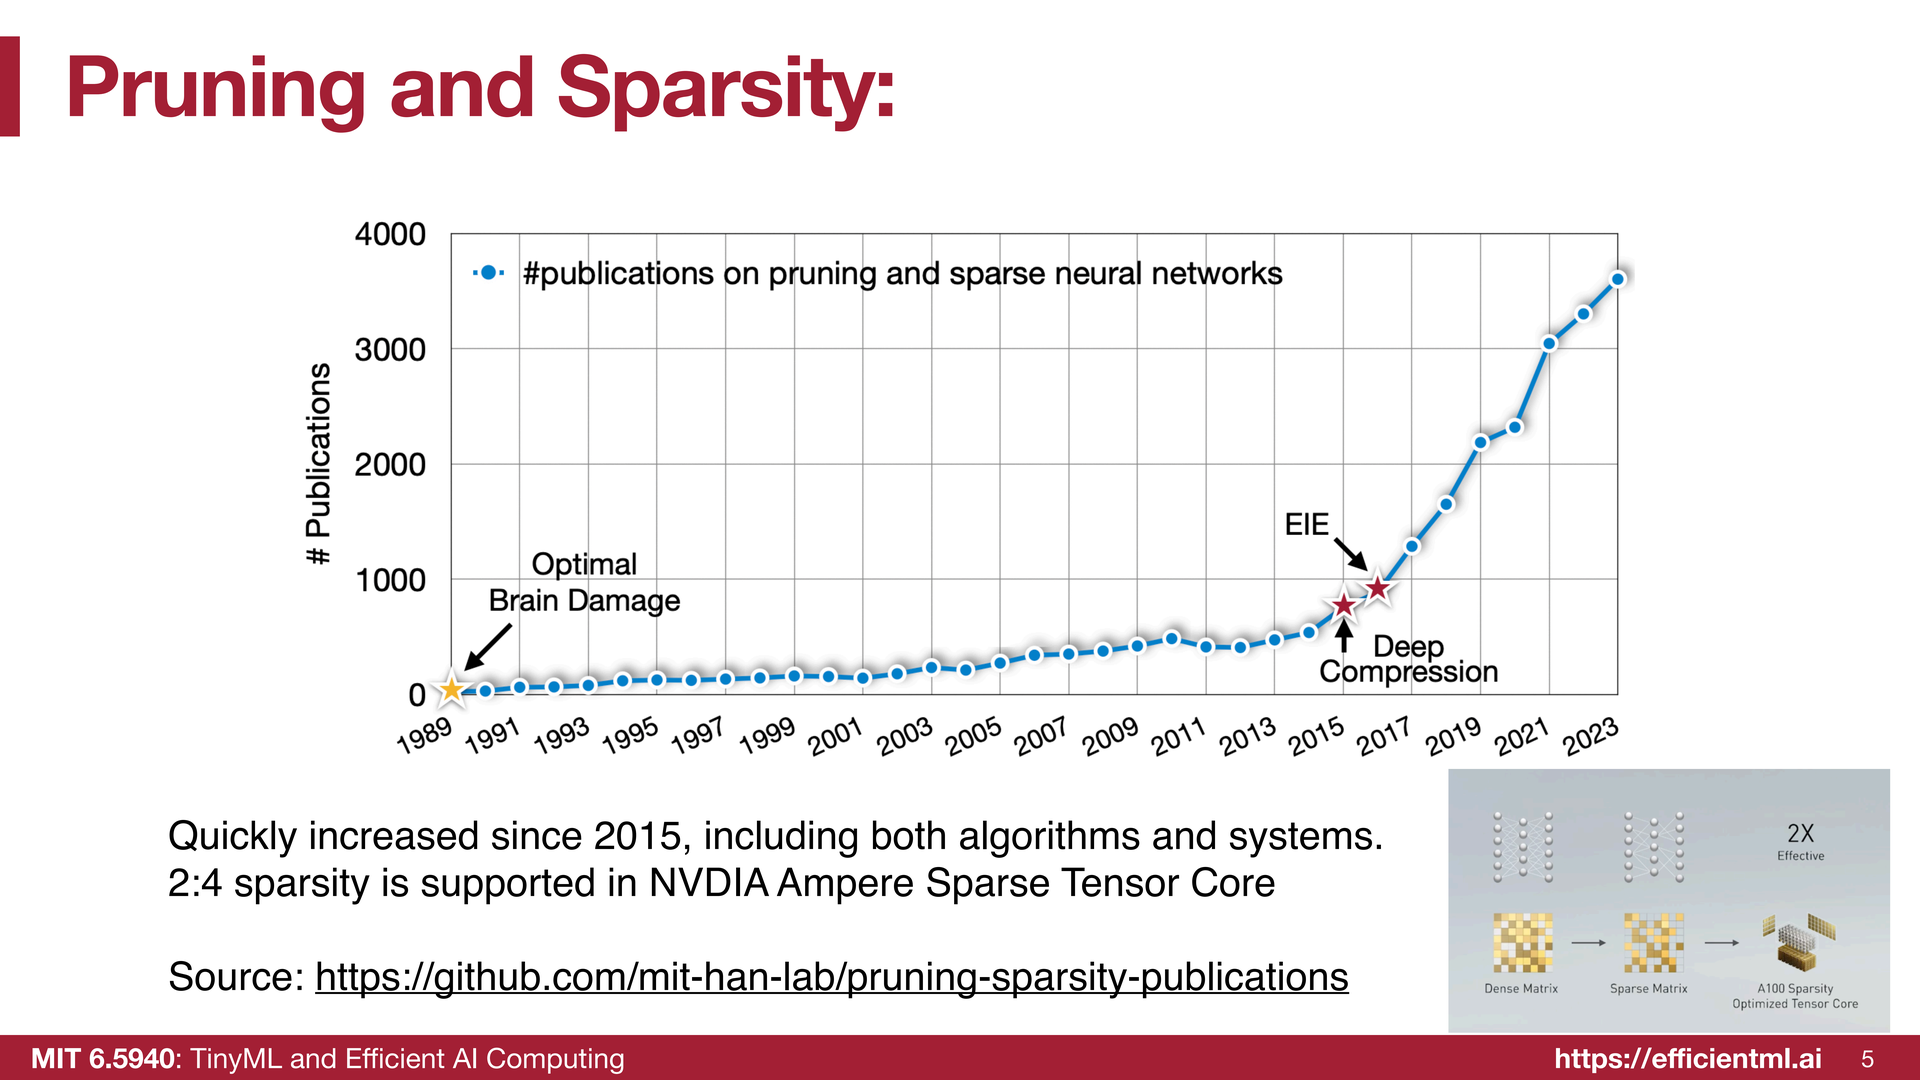
我们会讲 剪枝和稀疏化 :如何 去掉大量冗余连接,让原本稠密的网络变得稀疏。这项技术从 2015、2017 年前后开始变得非常流行,相关论文数量激增,并被工业界广泛采用,从而把模型做得更小。
4. Efficient AI for Computer Vision
先来概览一下深度学习为什么如此了不起。我们会从三个方面来讲:从视觉到语言再到多模态。
4.1 Image Classification: Accuracy vs. Compute
先从视觉模型开始,我们会过一遍相关的技术和应用,看看如何让它们 既轻量又快速。
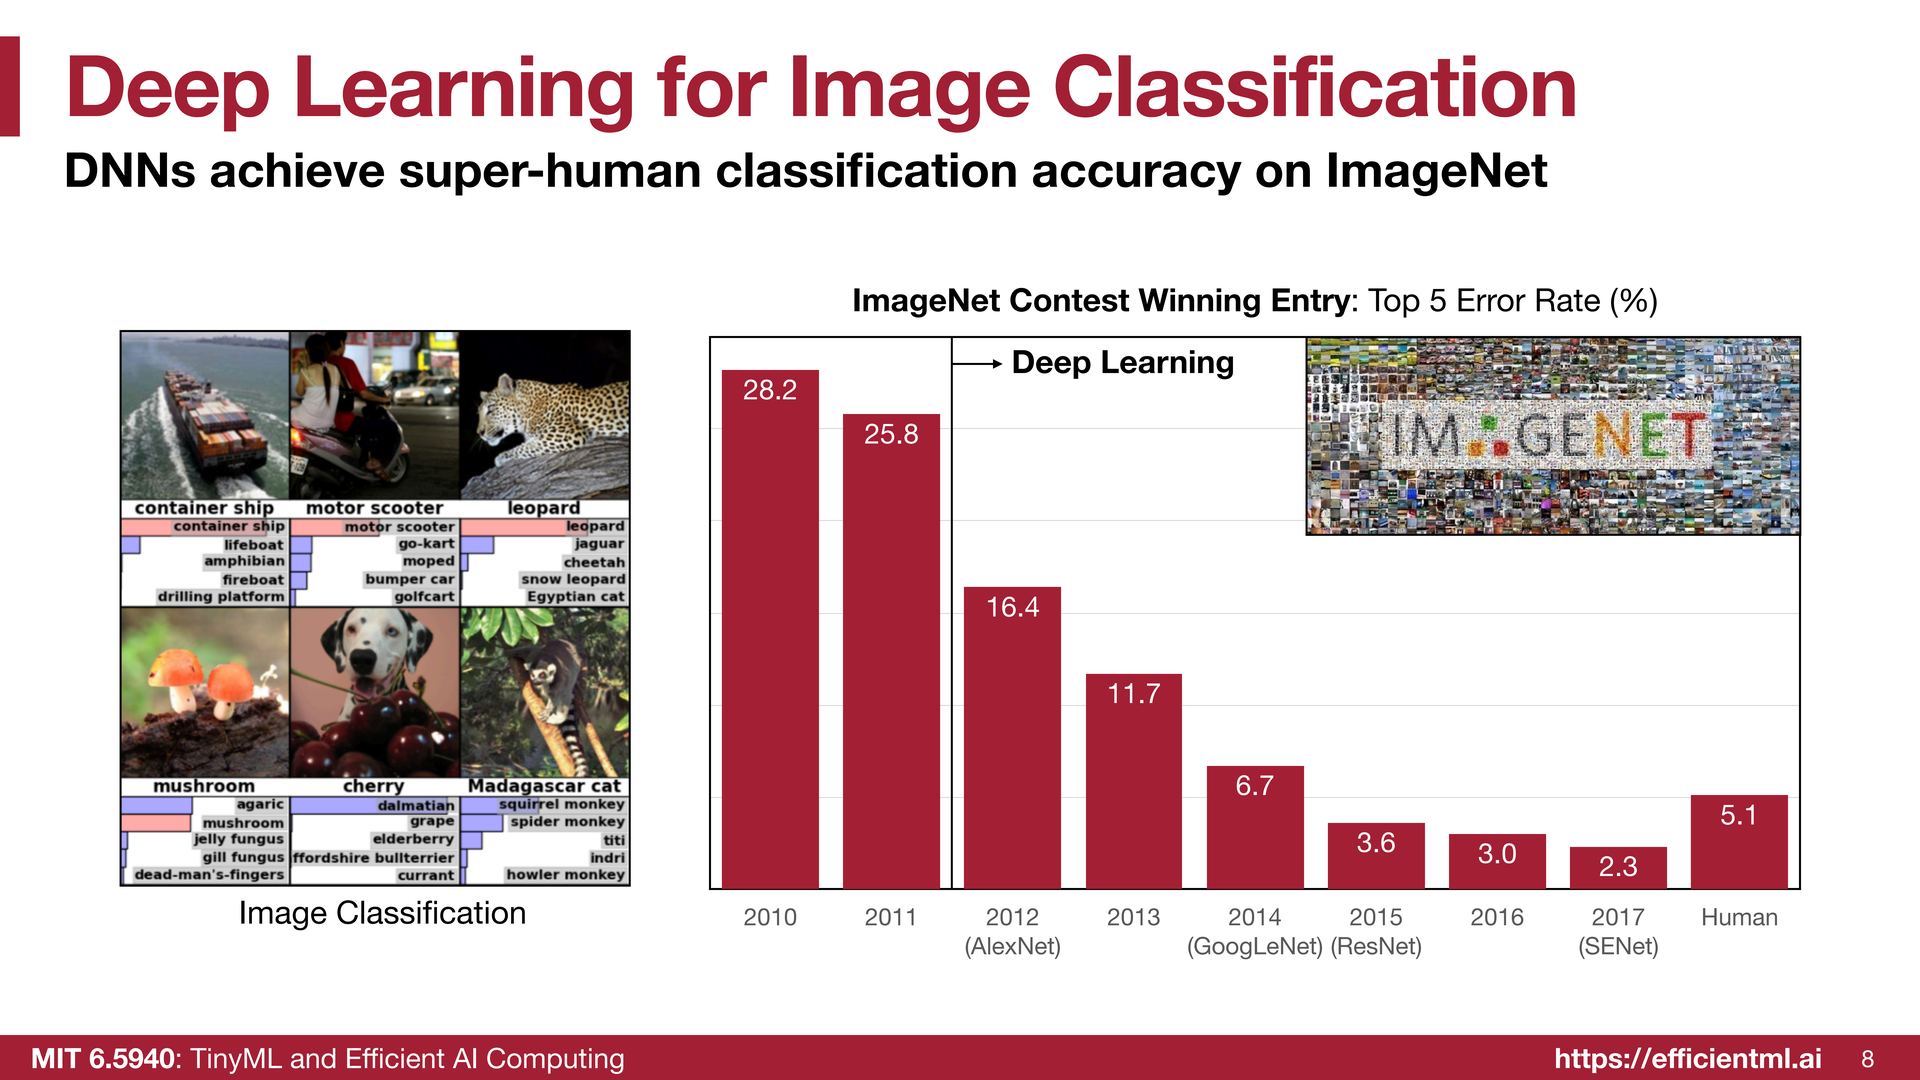
自 2012 年 AlexNet 出现以来,神经网络在 ImageNet 上已经达到了 超越人类的分类精度 。上图展示了历年的情况,右侧是 ImageNet 上的错误率(数据来自斯坦福):2010 年是 28%,2012 年有了很大改进,AlexNet 把错误率降到 16%,随后 GoogLeNet 降到 6%,ResNet 只有 3%,而人类的基线大约是 5%。
自 AlexNet 发明以来,精度有了很大的提升。在当时这是了不起的进步,但 天下没有免费的午餐,高精度是以高昂的计算代价换来的:
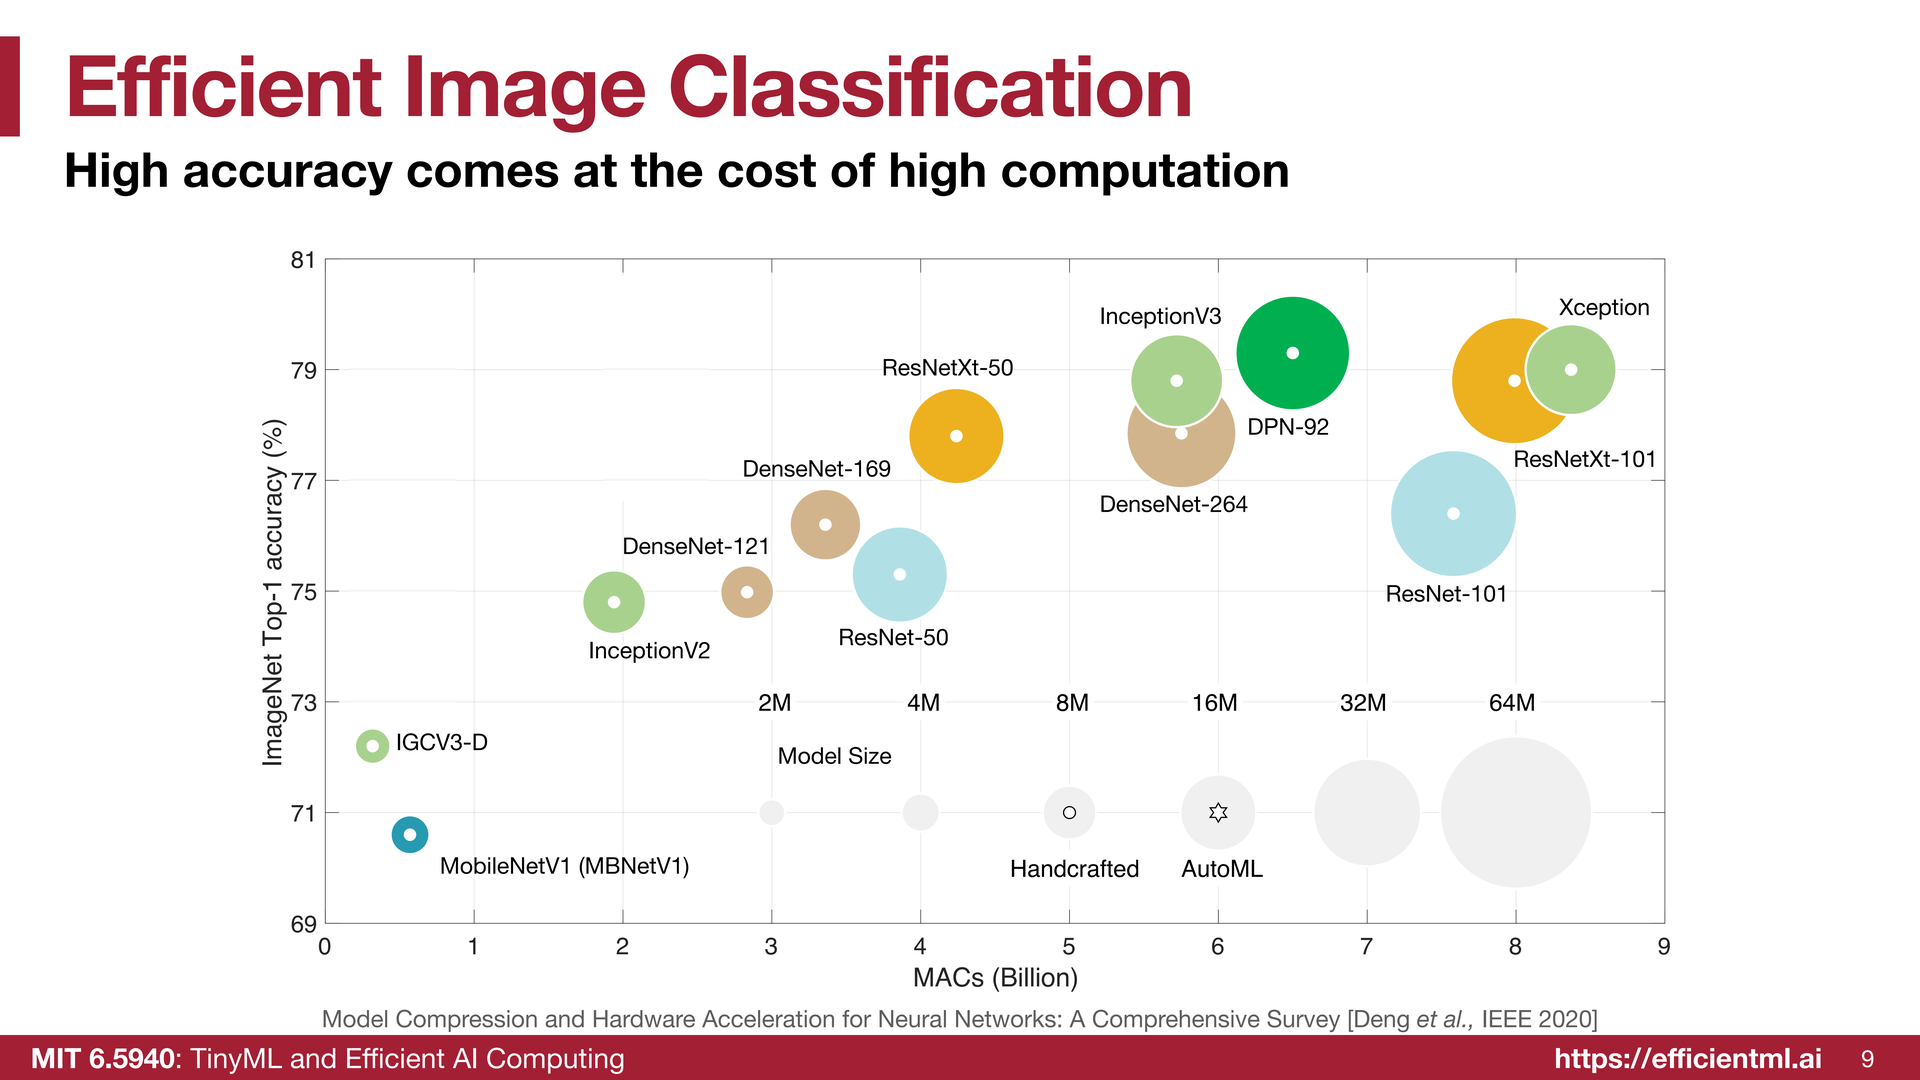
图中横轴是 MAC,MAC 就是乘加运算(multiply-accumulate) ,也就是一次乘法和一次加法。横轴越往右,计算量越大;纵轴是精度。所以一般来说,想达到更高的精度,就得投入大量的计算。那么哪个角落最好呢?我们想要更少的计算、更高的精度,那正好是左上角。那我们怎么做到呢?
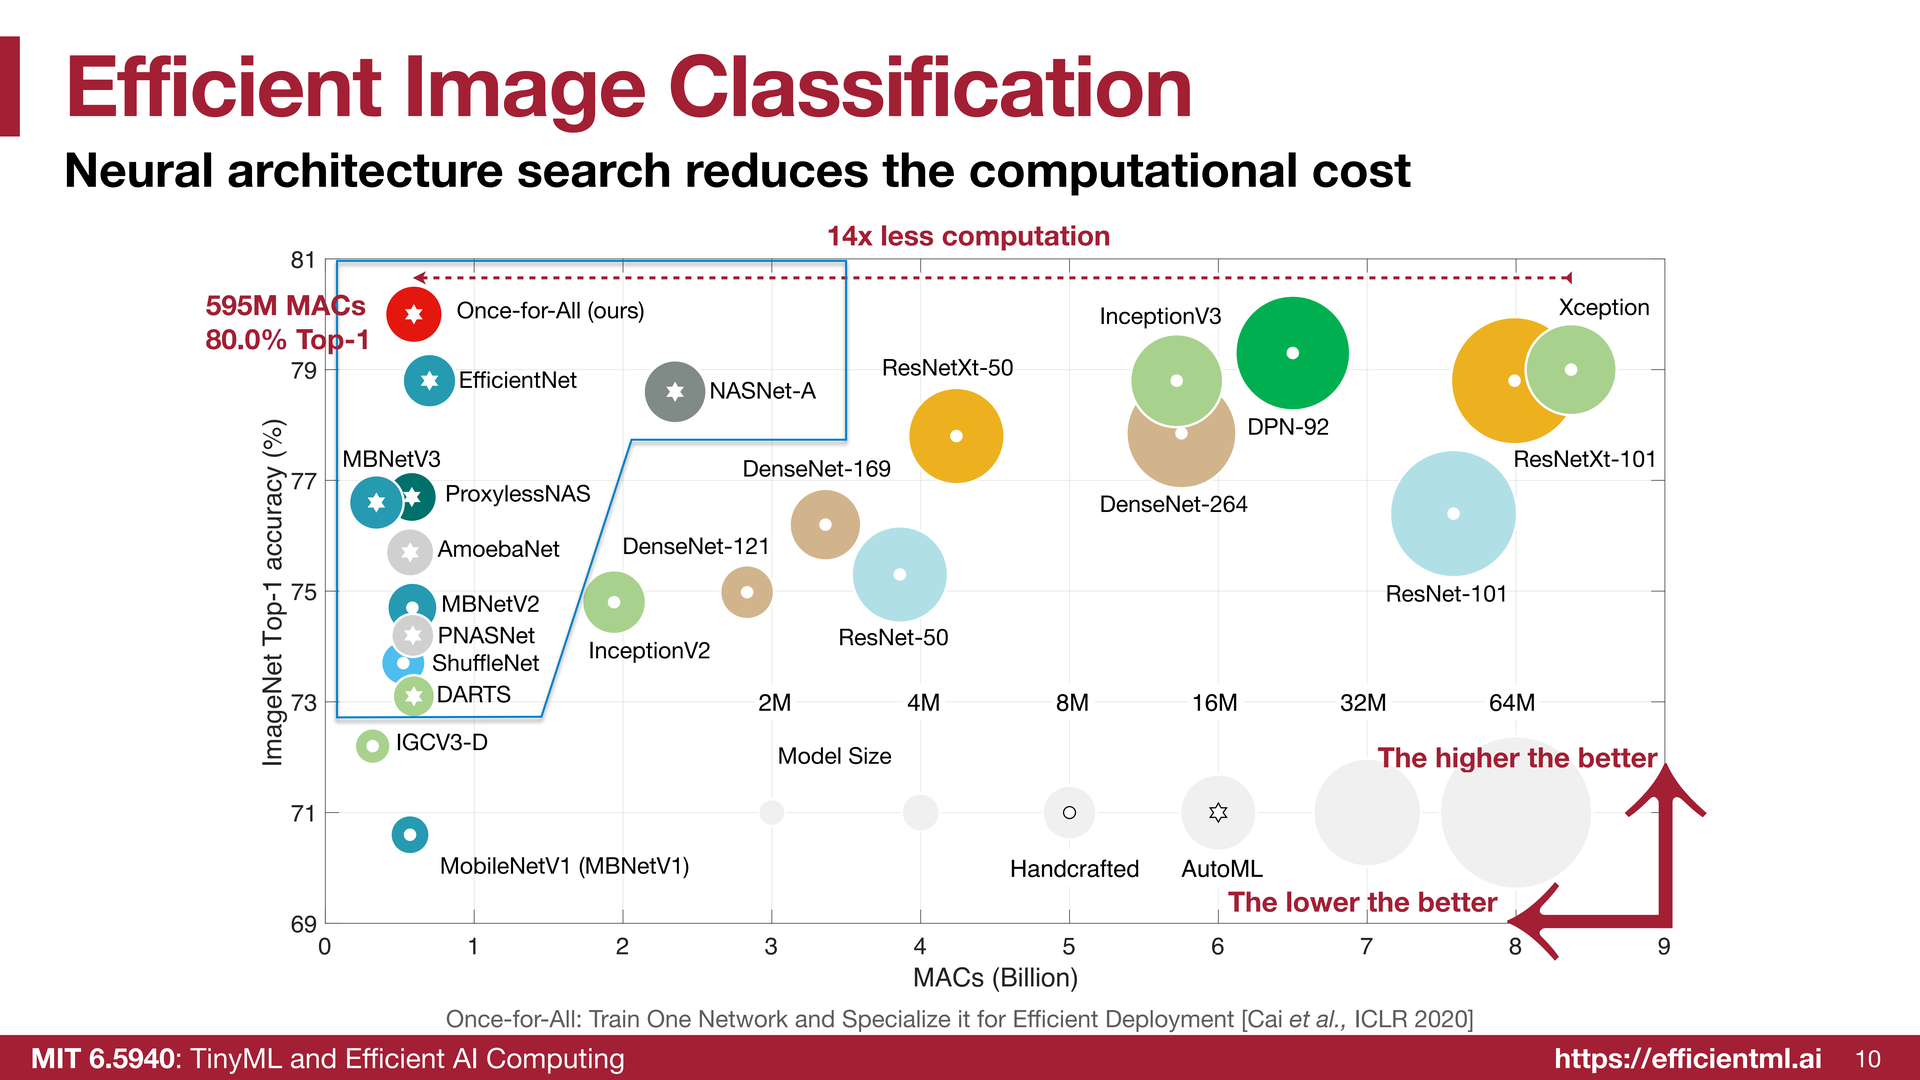
我们会讲到这些技术:用 神经架构搜索、用硬件感知的神经网络设计 来推动这条前沿曲线向左上方移动---减少计算量、提升精度,最终做到 计算量只有原来的 1/14 ,却能达到相同甚至更高的精度。这条权衡曲线,我们会一次又一次回到它。我们介绍的每一项技术,都会看到这样的图:我们能降低计算量、提升精度,以及它们各自对应的应用场景。
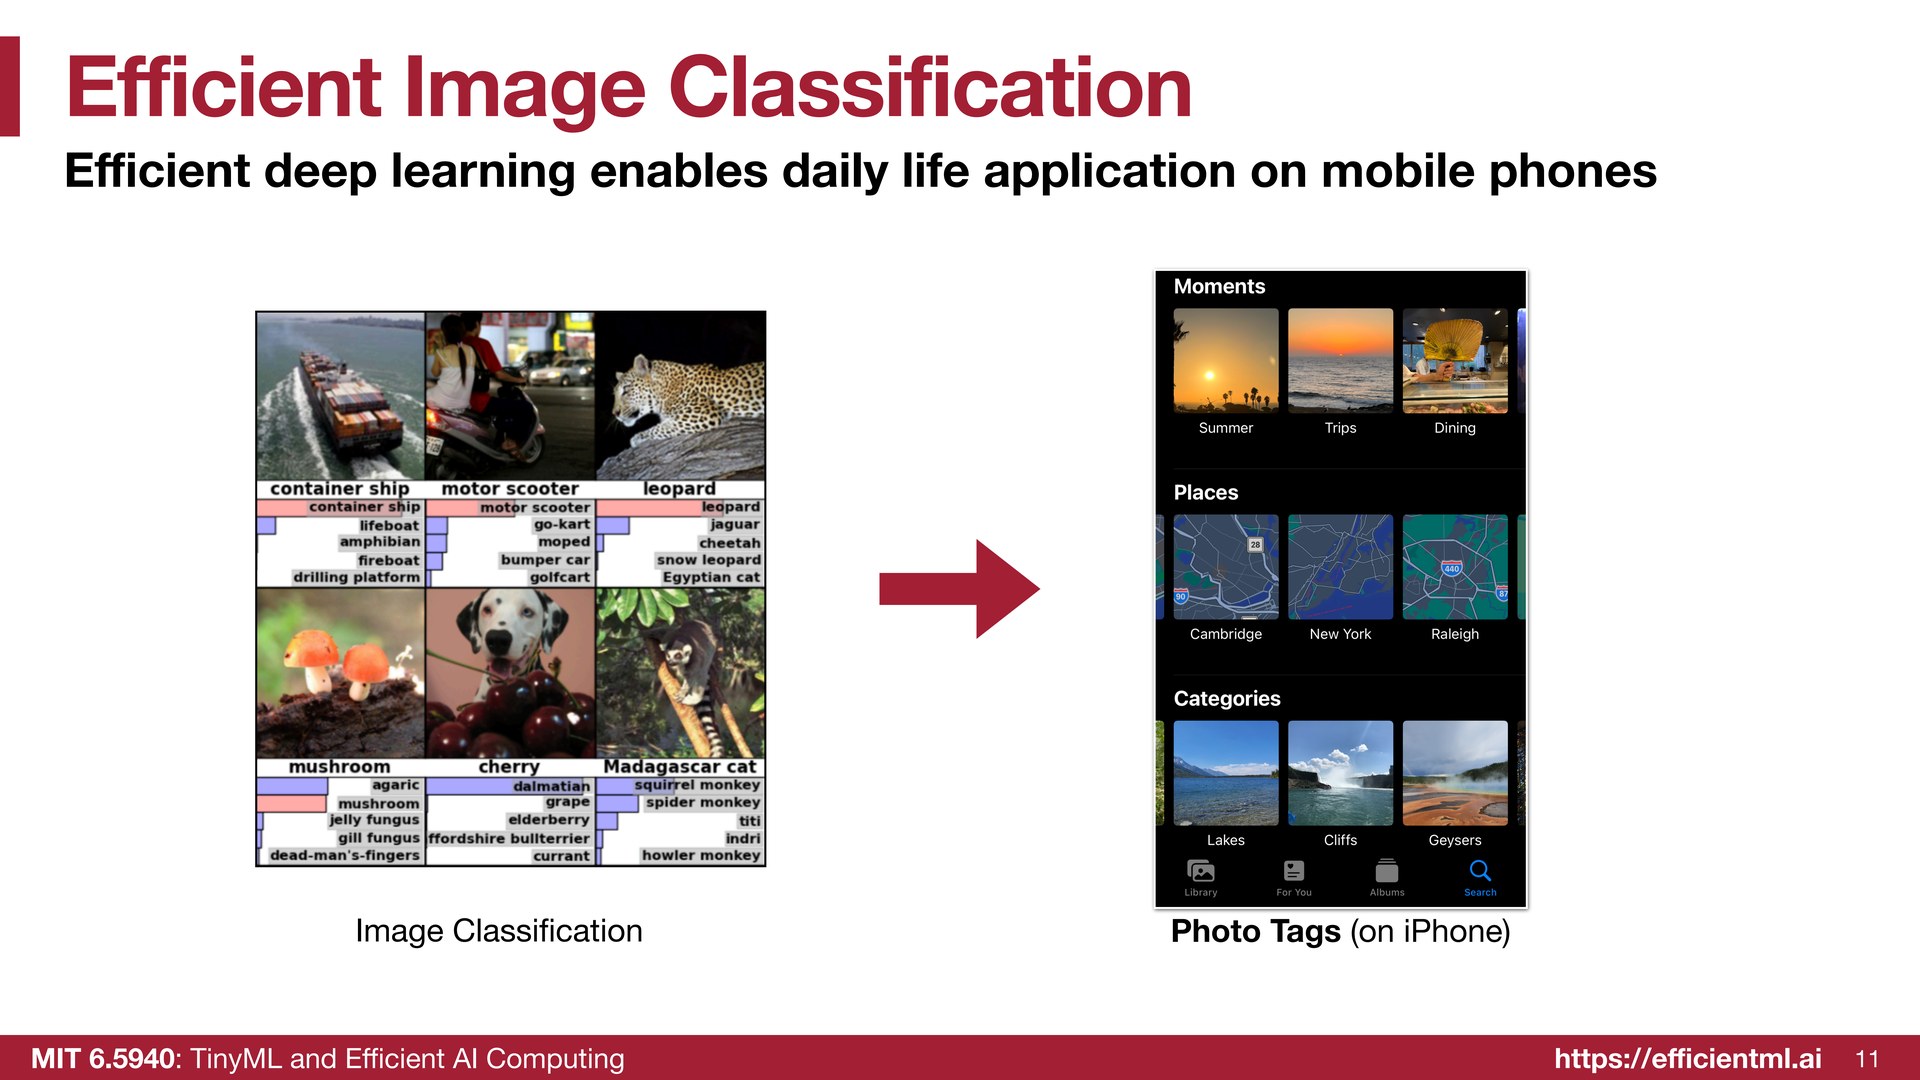
如果我们能把它做得足够小、塞进手机里,它就能有很多现实世界的用途,比如给照片打标签。在手机上本地运行机器学习模型还能保护隐私:你可以对夏天、旅行、聚餐的照片,或者不同的地点、不同的类别(比如湖泊、悬崖、间歇泉)进行分类。
4.2 On-Device Inference and Training
在手机上本地运行模型还可以分类不同的面孔,甚至可以做端上的骨架预测,比如姿态预测、识别不同的关节。
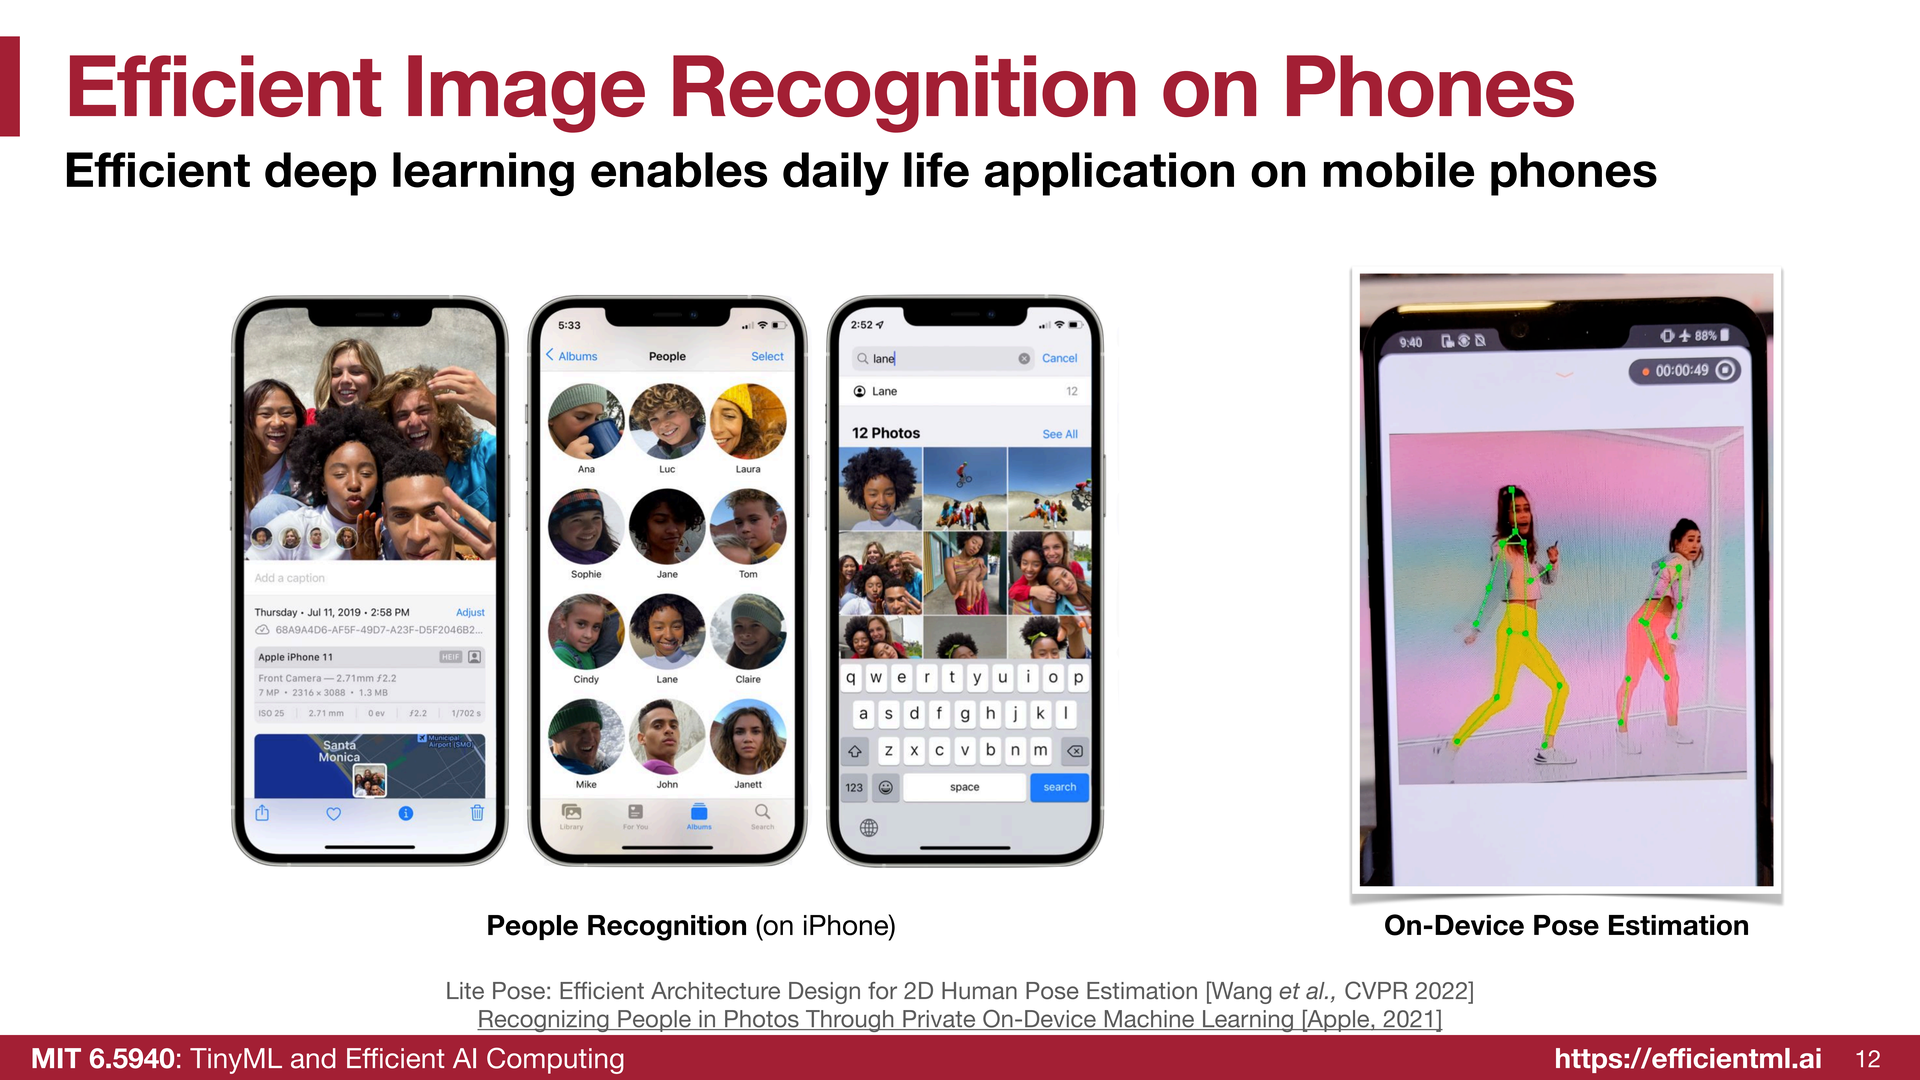
这是我们在几年前做过的一个演示,在搭载高通骁龙芯片的三星手机上本地运行。
那我们能不能做得更小呢?不仅能跑在手机上,还能塞进 只有几百 KB 内存的微控制器(MCU) 里做推理和检测。
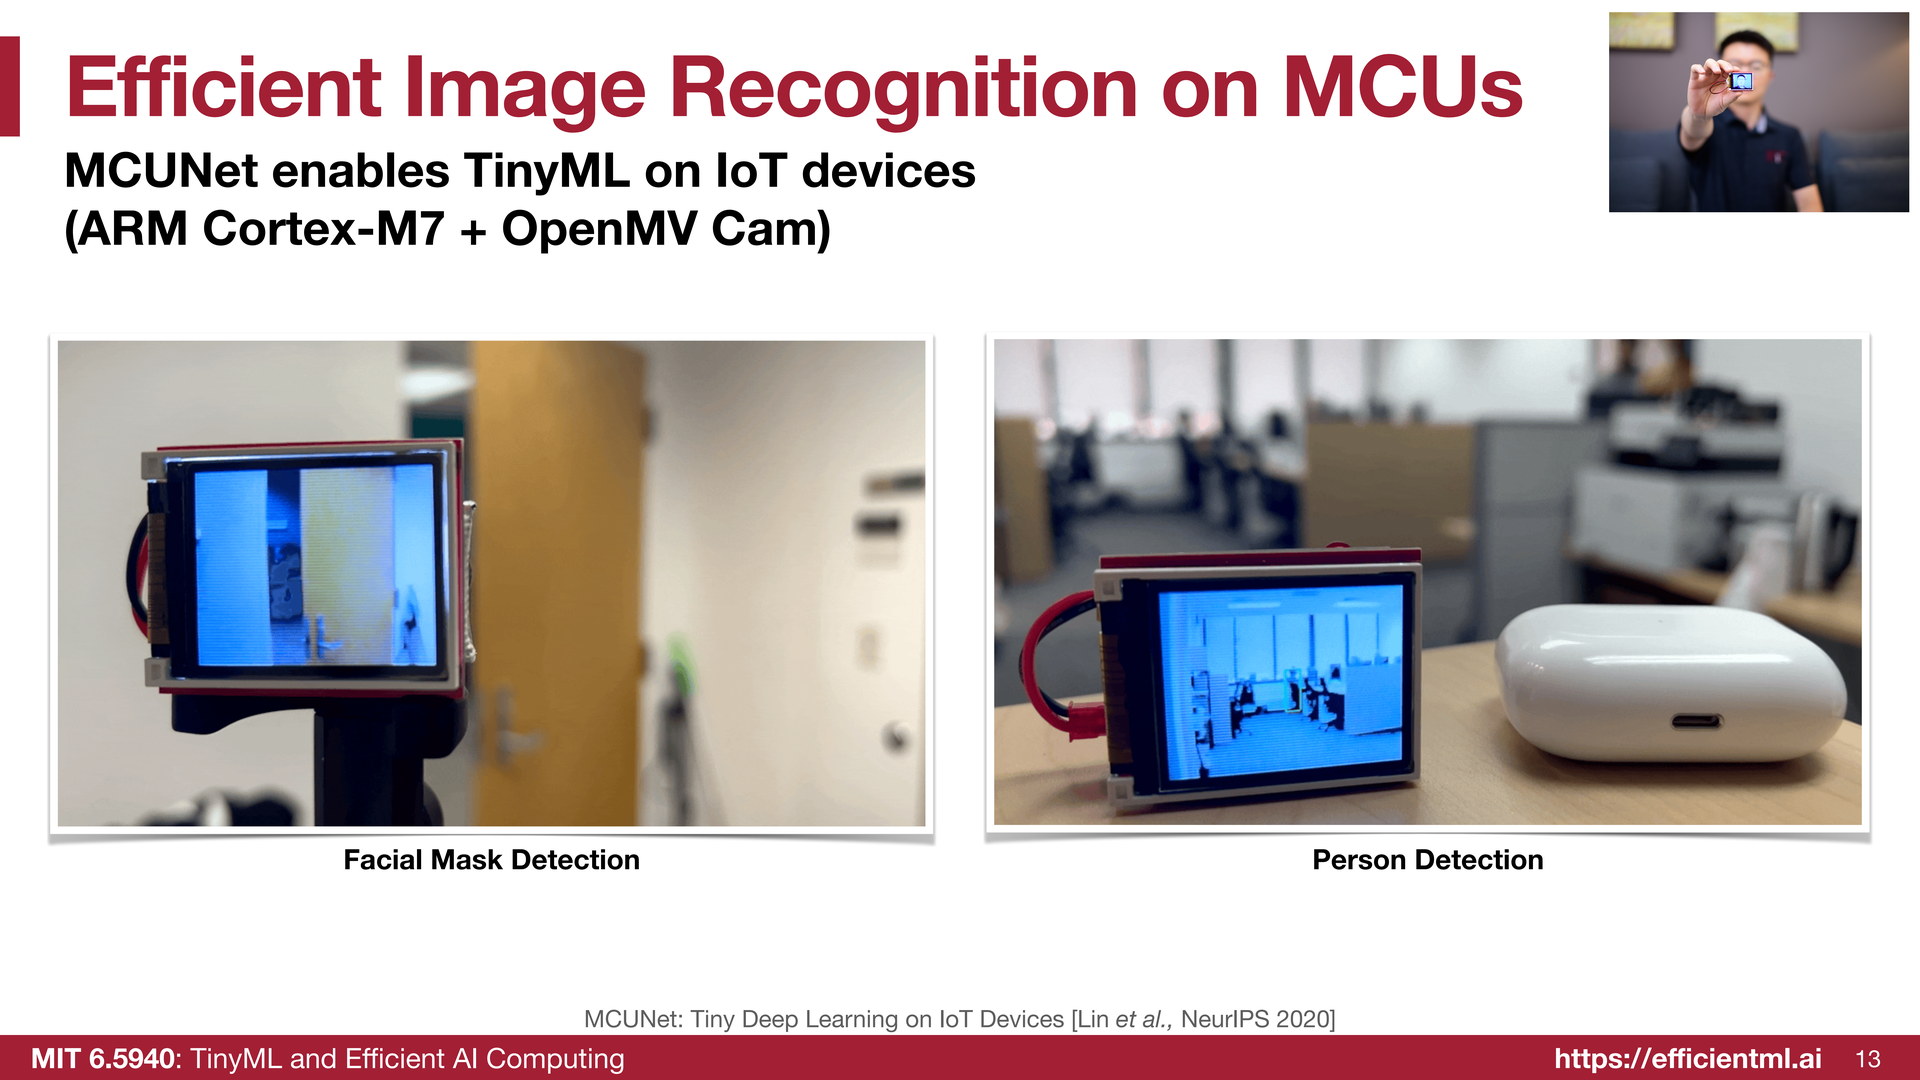
比如左边这个在做口罩检测,这是 Ji 和 Jiaming,我们实验室的毕业生,现在一个在英伟达,一个在 OpenAI;他设计了一个叫 MCUNet 的神经网络,非常非常小,可以 塞进只有几百 KB SRAM 的微控制器(ARM Cortex-M7),在当时我们还处于新冠疫情期间,用来检测人脸和口罩。在右边,同一个微控制器在检测是否有人,不仅做分类,还在上面画出边界框。
我们又向前迈进了一步:不仅能做推理,能不能 在边缘设备上本地做训练和微调 呢?
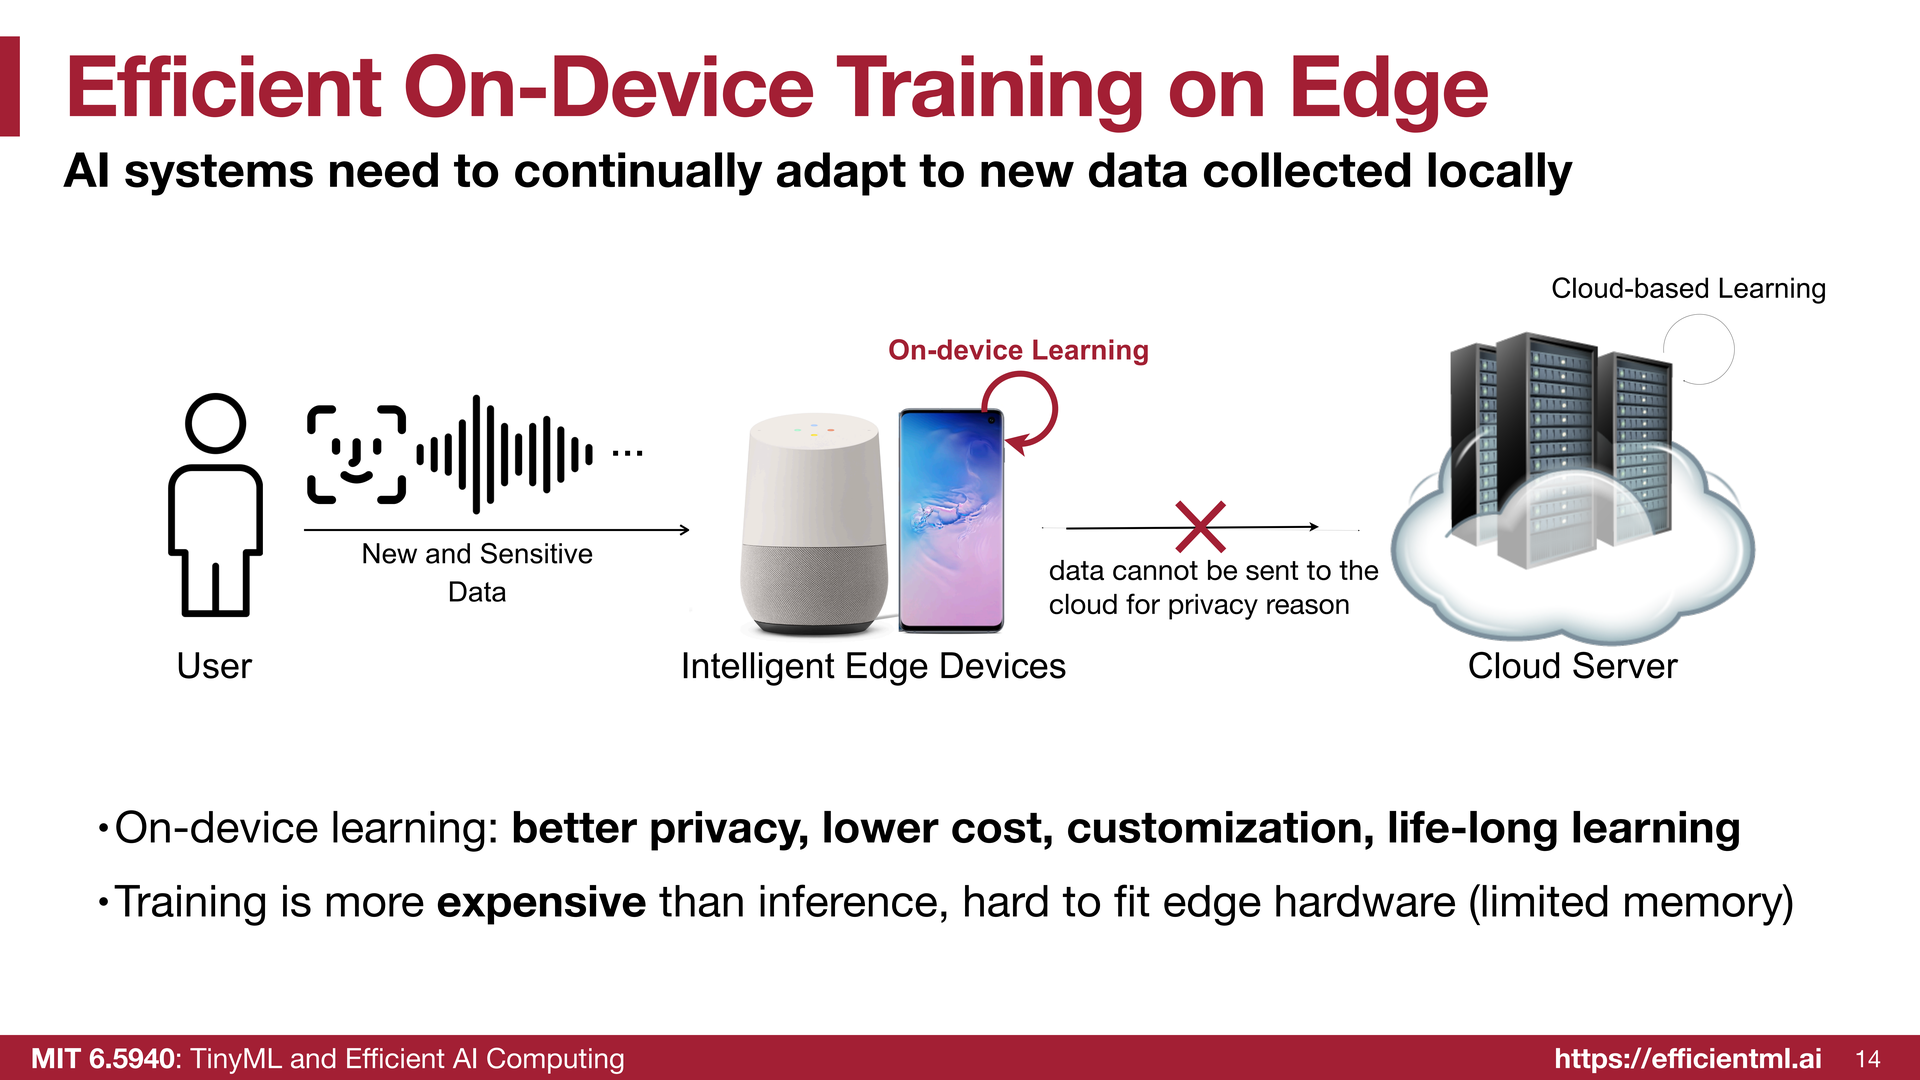
因为模型可以不断定制,持续适应本地传感器采集到的新数据---无论是音频、图像还是文本。这正是我们需要 端上训练、定制化和持续学习 的原因。它的优势是 更好的隐私、更低的成本、更强的定制化能力,甚至终身学习的能力---因为所有数据都留在本地设备上,不需要上传云端。
然而,训练比推理要昂贵得多 。训练不仅要做前向,还要反向传播,计算量约为推理的三倍 ,同时还要缓存大量中间激活,内存压力更大。后面在课程中我们会讲怎么做端上训练,把训练内存从 600 多 MB 一路降到 141 KB。
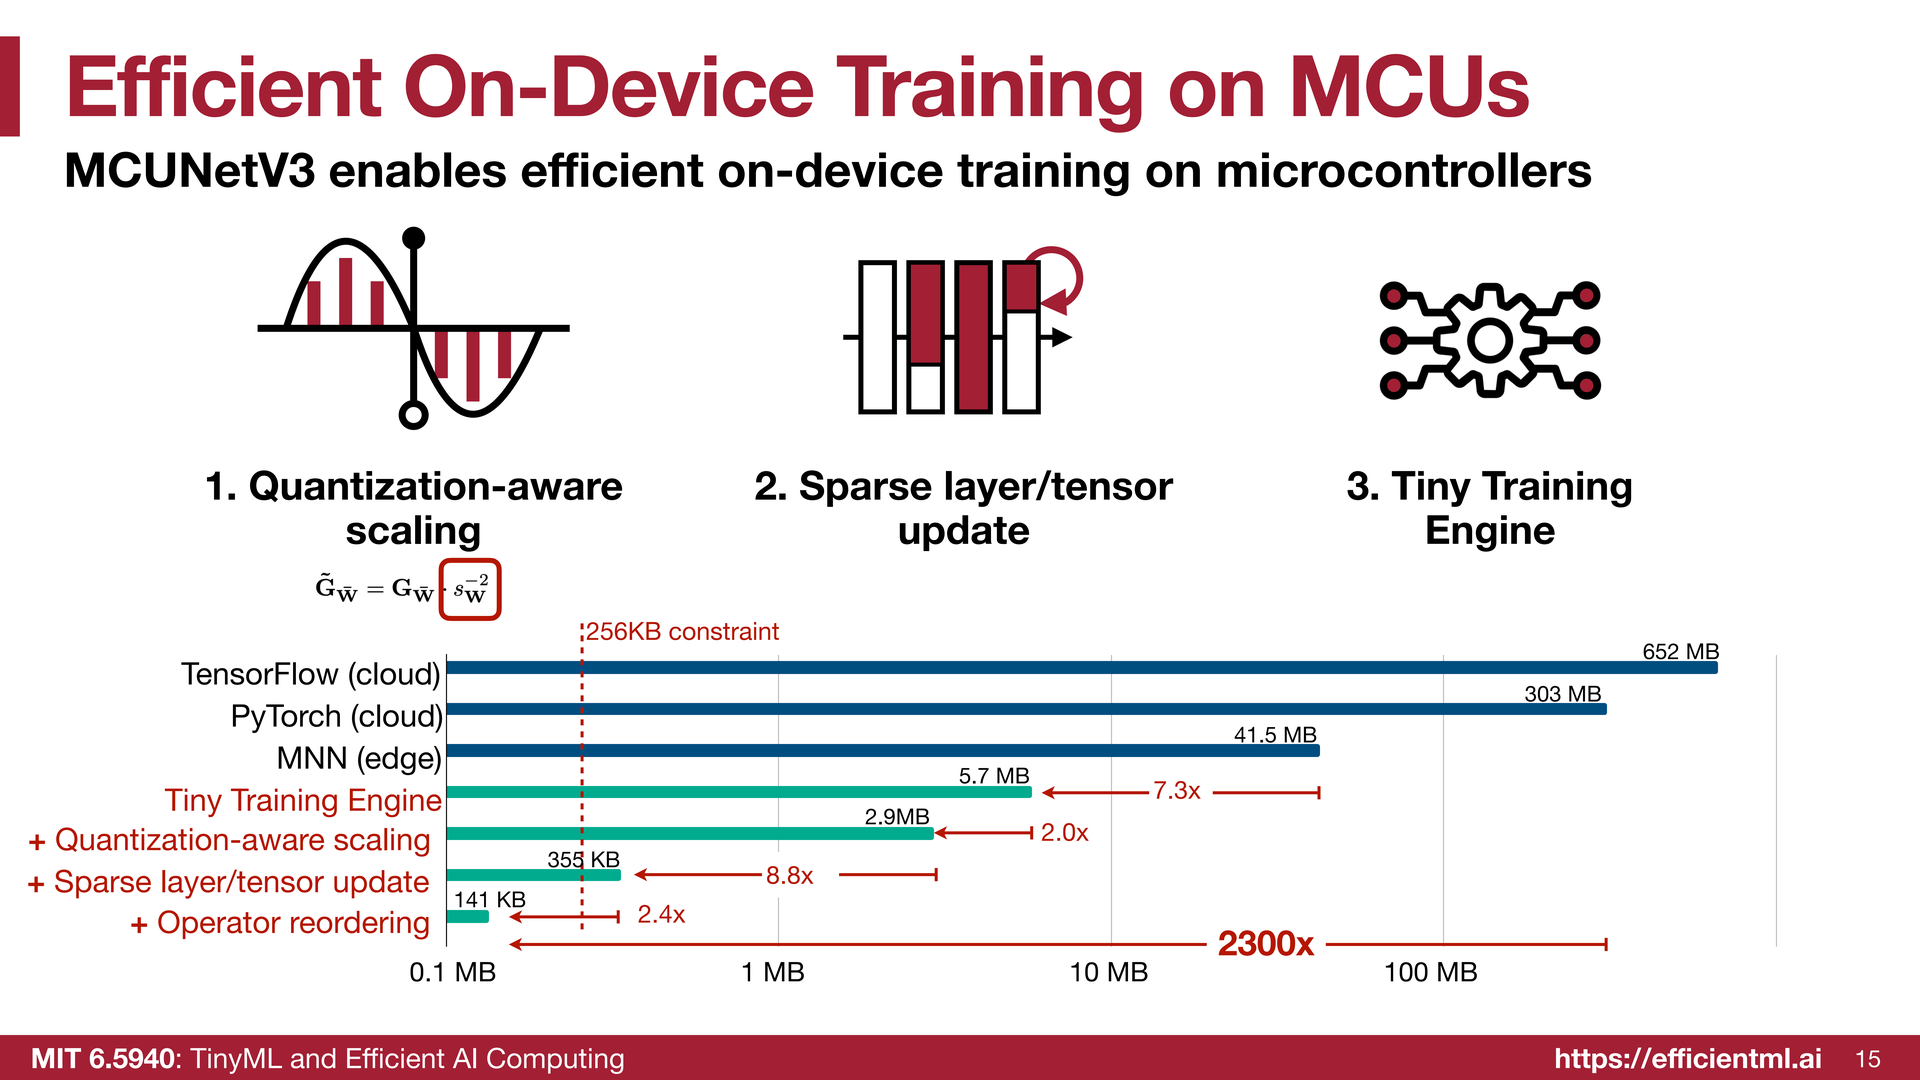
这是 三个数量级的缩减 ,靠的是若干技术:Quantization-aware scaling(量化感知缩放) ,通过缩放参数让模型装得进内存;稀疏层和稀疏张量更新 ,不需要更新所有权重,只更新需要的那部分;最后是 微型训练引擎(tiny training engine) ,通过 算法与系统的协同设计,把算法上的理论收益变成实测的加速。所以就算只有几百 KB 的内存,也能做很多事情。
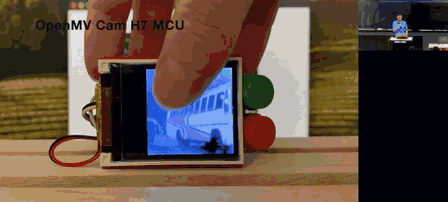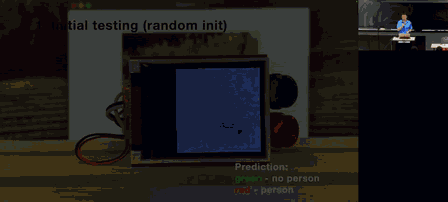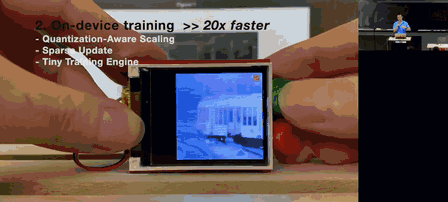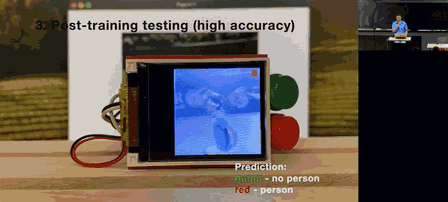
这是一个视频演示,展示了如何 在仅有 256 KB 内存的设备上做端上训练,我们会在后面的课程里深入讲。演示用的这块 Cortex-M7 微控制器上有一块屏幕和两个按钮。绿色按钮表示没有人,红色按钮表示有人。
在最开始的测试中,我们随机初始化权重,它判断不出有没有人,输出的都是随机标签。我们想通过端上训练来改进它:有人就按红色按钮,没有人就按绿色按钮。这样就能收集一些数据、做反向传播---没有互联网,一切都发生在本地 。只用了几个样本,训练就已经在设备上发生了。
再测试一下:绿色表示没有人,红色表示有人,它已经能以相当高的准确率区分有没有人了。所有的反向传播、整个学习过程,都只在设备上本地发生。
4.3 Promptable Image Segmentation
除了分类和检测,我们还能做更复杂的事情,比如图像分割。这是那篇非常有影响力的 Segment Anything 论文。
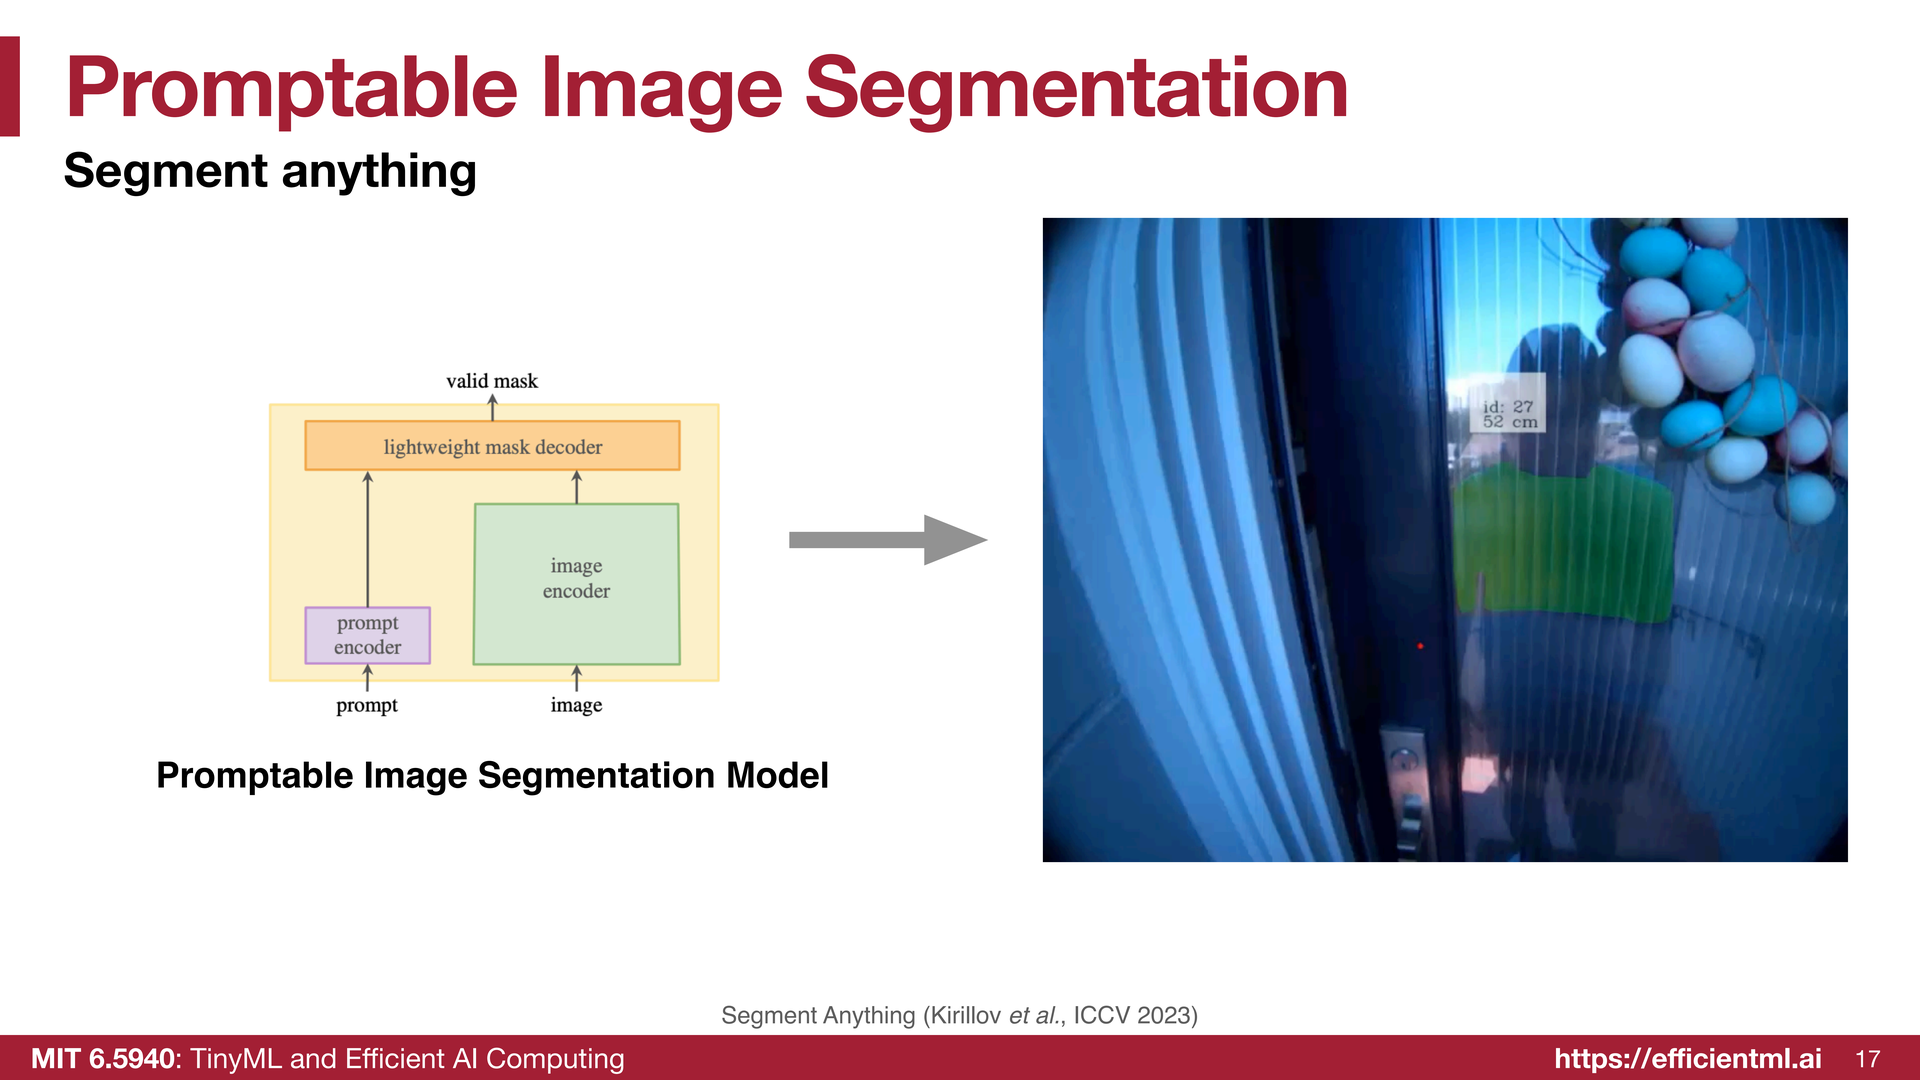
图中右侧有一个点,代表你正在看的位置,模型会把你正在看的东西分割出来。这在 AR 和 VR 应用中有很多用途。但怎么才能让它更快,以便跑在本地---比如跑在你的眼镜里?所以我们设计了 高效版 ViT 的 Segment Anything---EfficientViT-SAM。
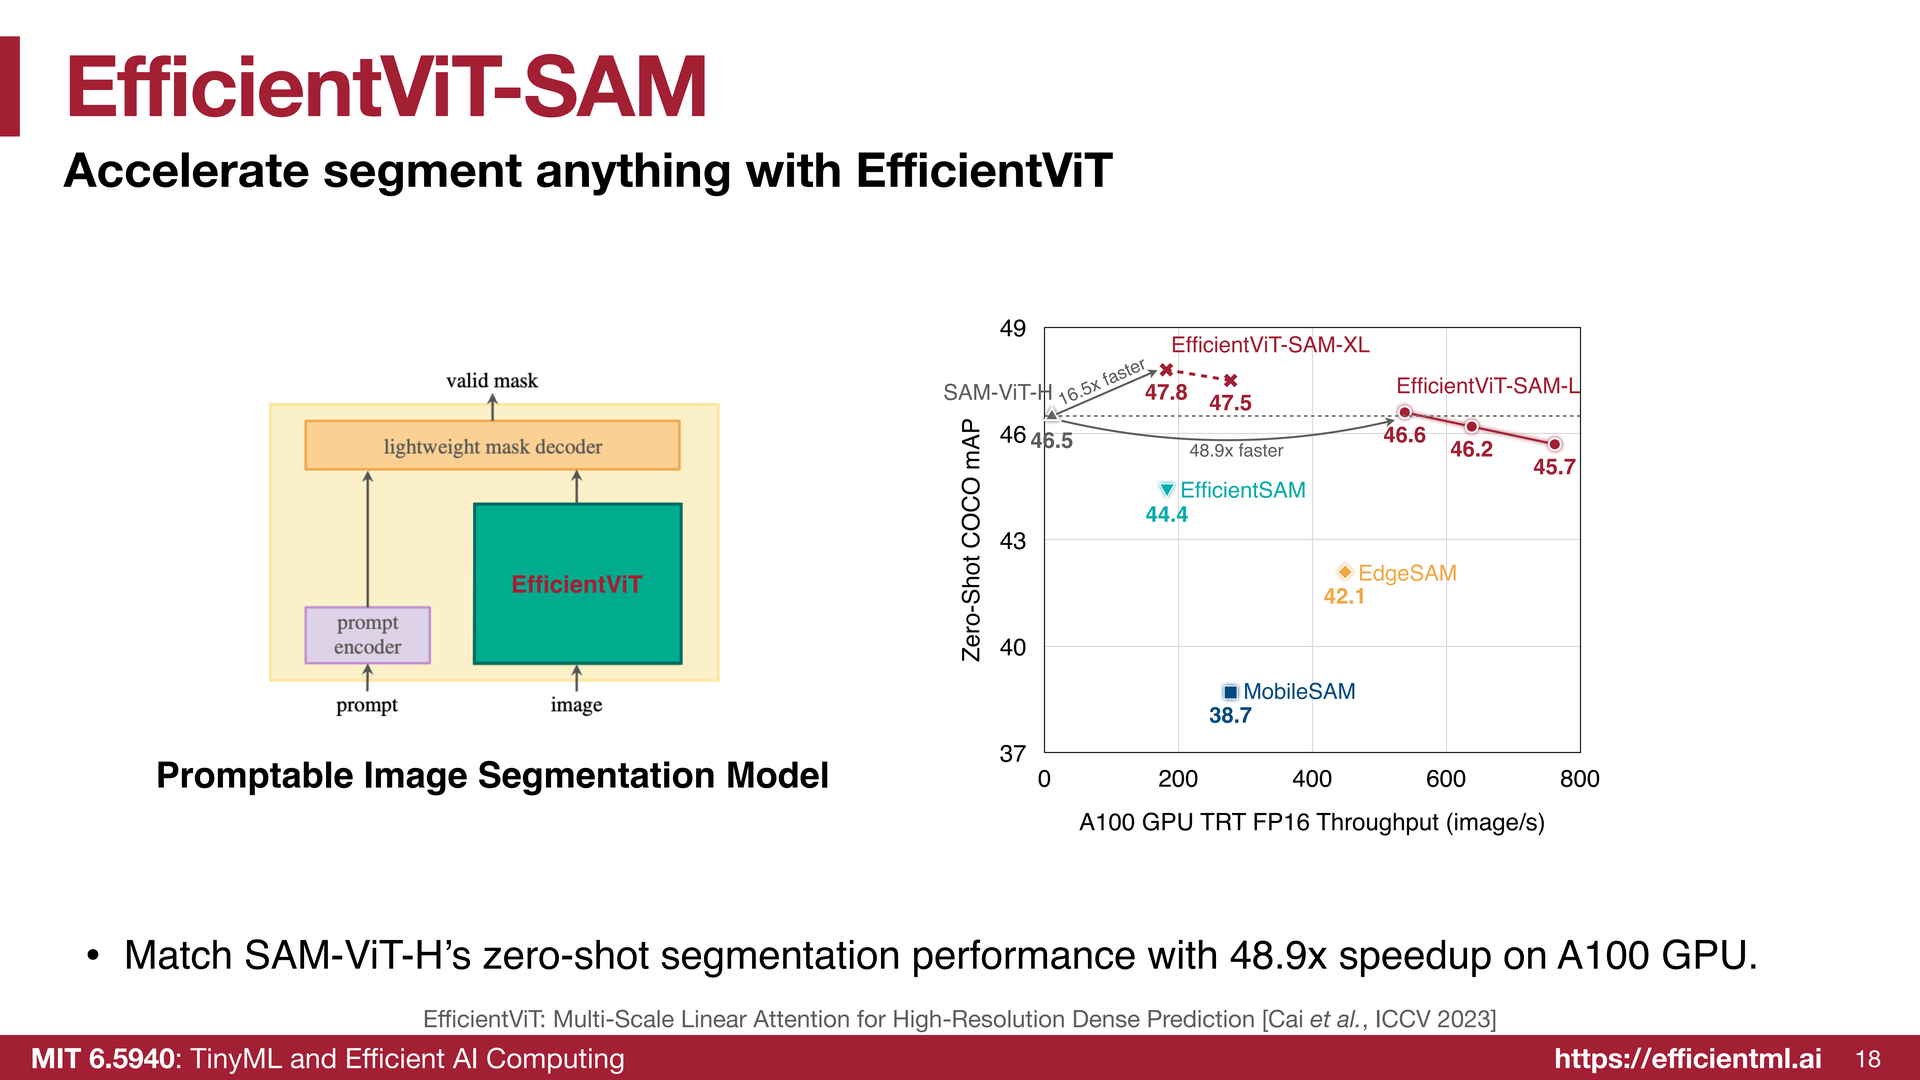
之前 GPU 上的吞吐量只有每秒十几帧,现在能跑到每秒数百帧,精度不变,速度大约快了 48 倍。
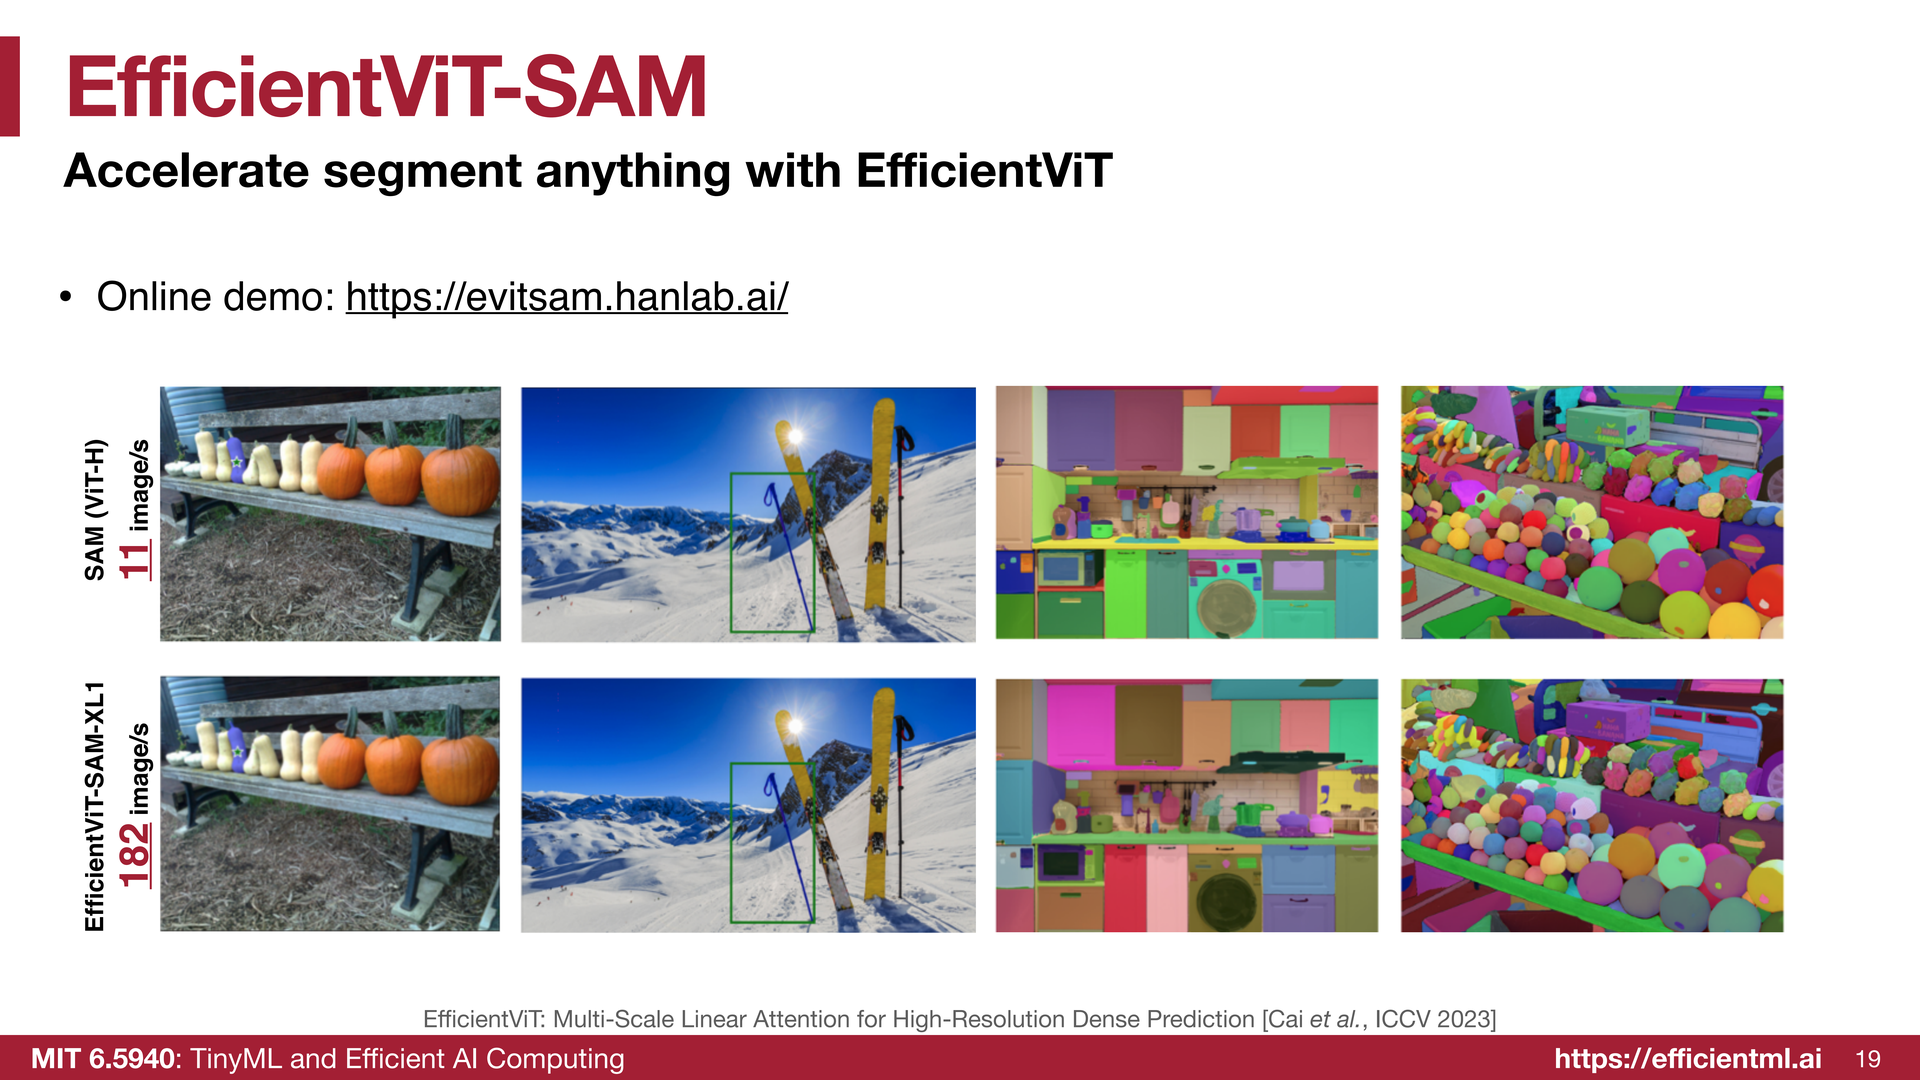
这里有一些演示,比如分割那根杆子---它非常细,是个相当困难的任务;右边则把图像里的所有东西都分割出来。最初的 SAM 每秒只能处理 11 张图,而现在可以加速到每秒 182 张图---同样的 GPU、同样的精度。这类技术我们后面会在课程中深入讲。
到目前为止,我们讲的是图像理解,也就是 判别式模型,对吧?那我们能不能也生成图像呢?图像生成、视频生成现在非常流行。你可能听说过 MiniMax H3,一个很受欢迎的开源视频生成模型。
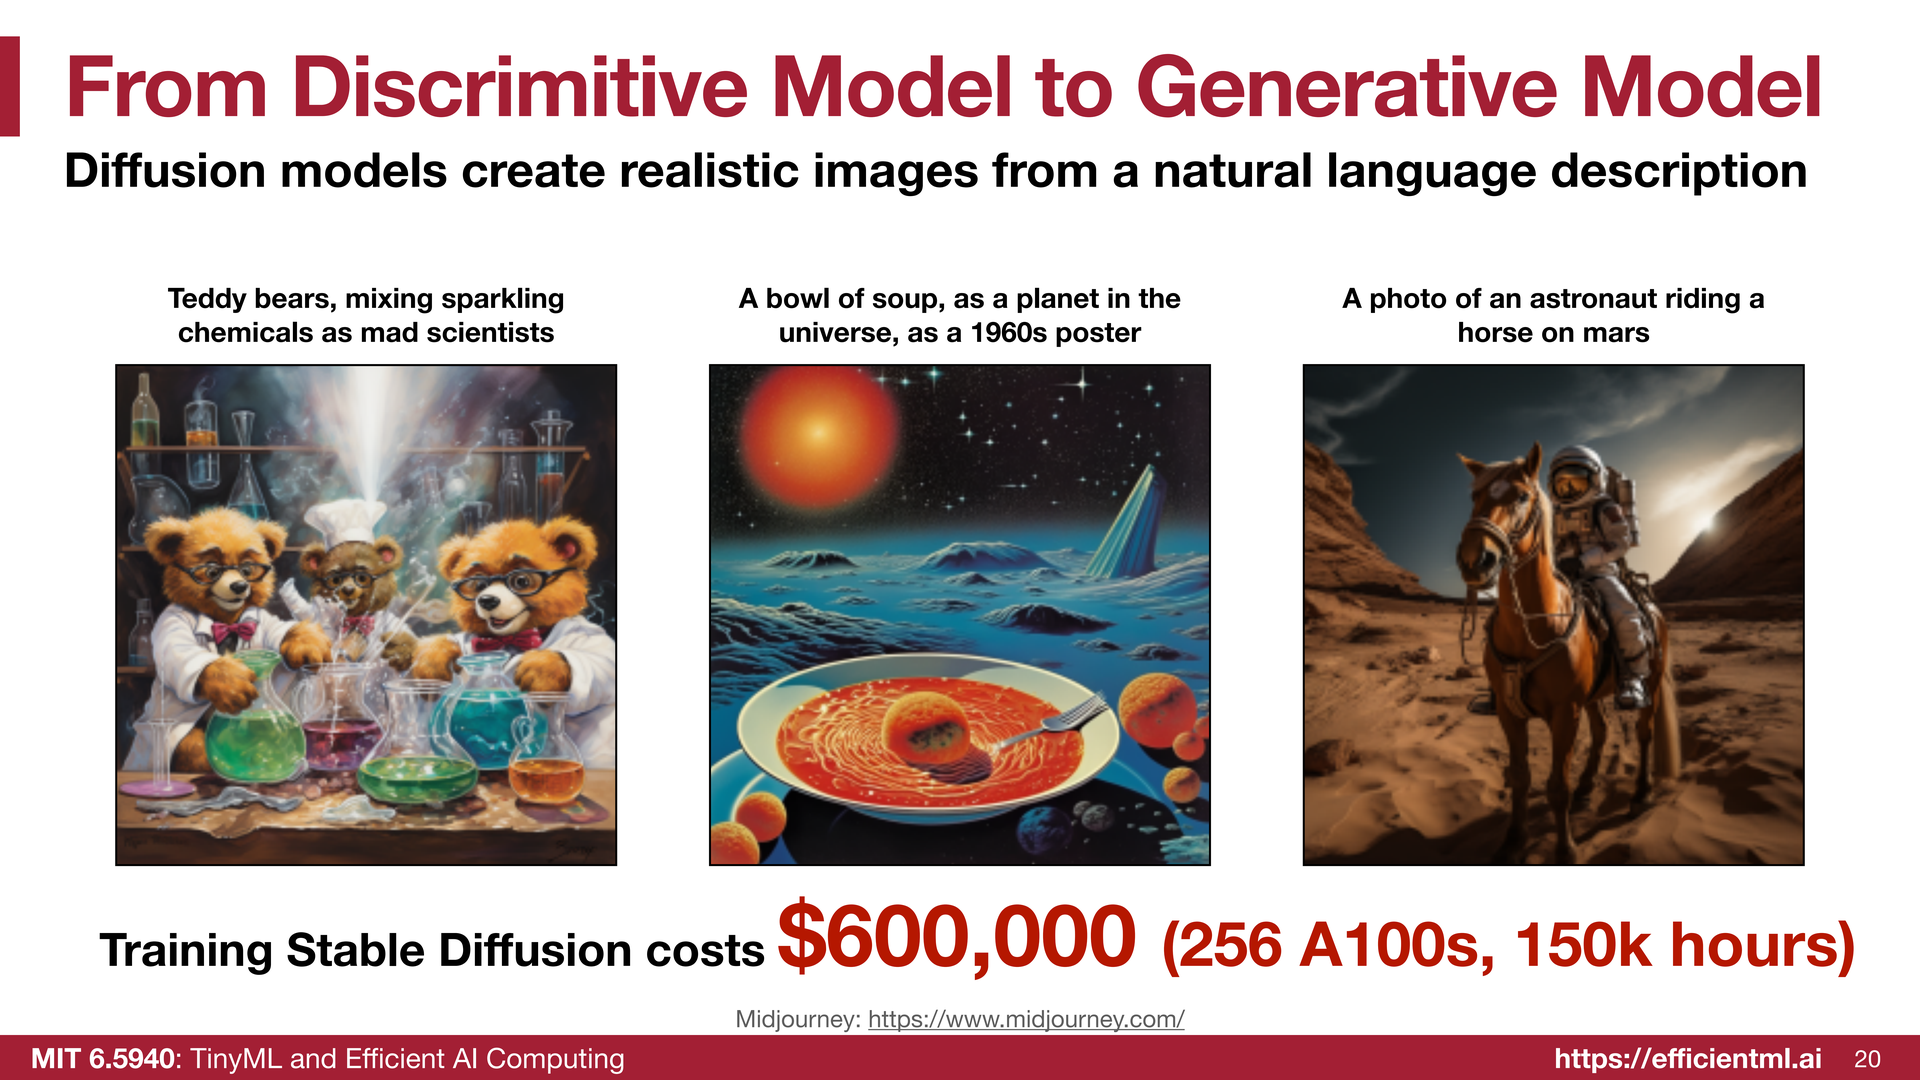
但它们的 计算成本非常高 :最早的 Stable Diffusion 训练花了 60 万美元,用了 256 块 A100 GPU---而这还只是图像生成,更别说视频了。
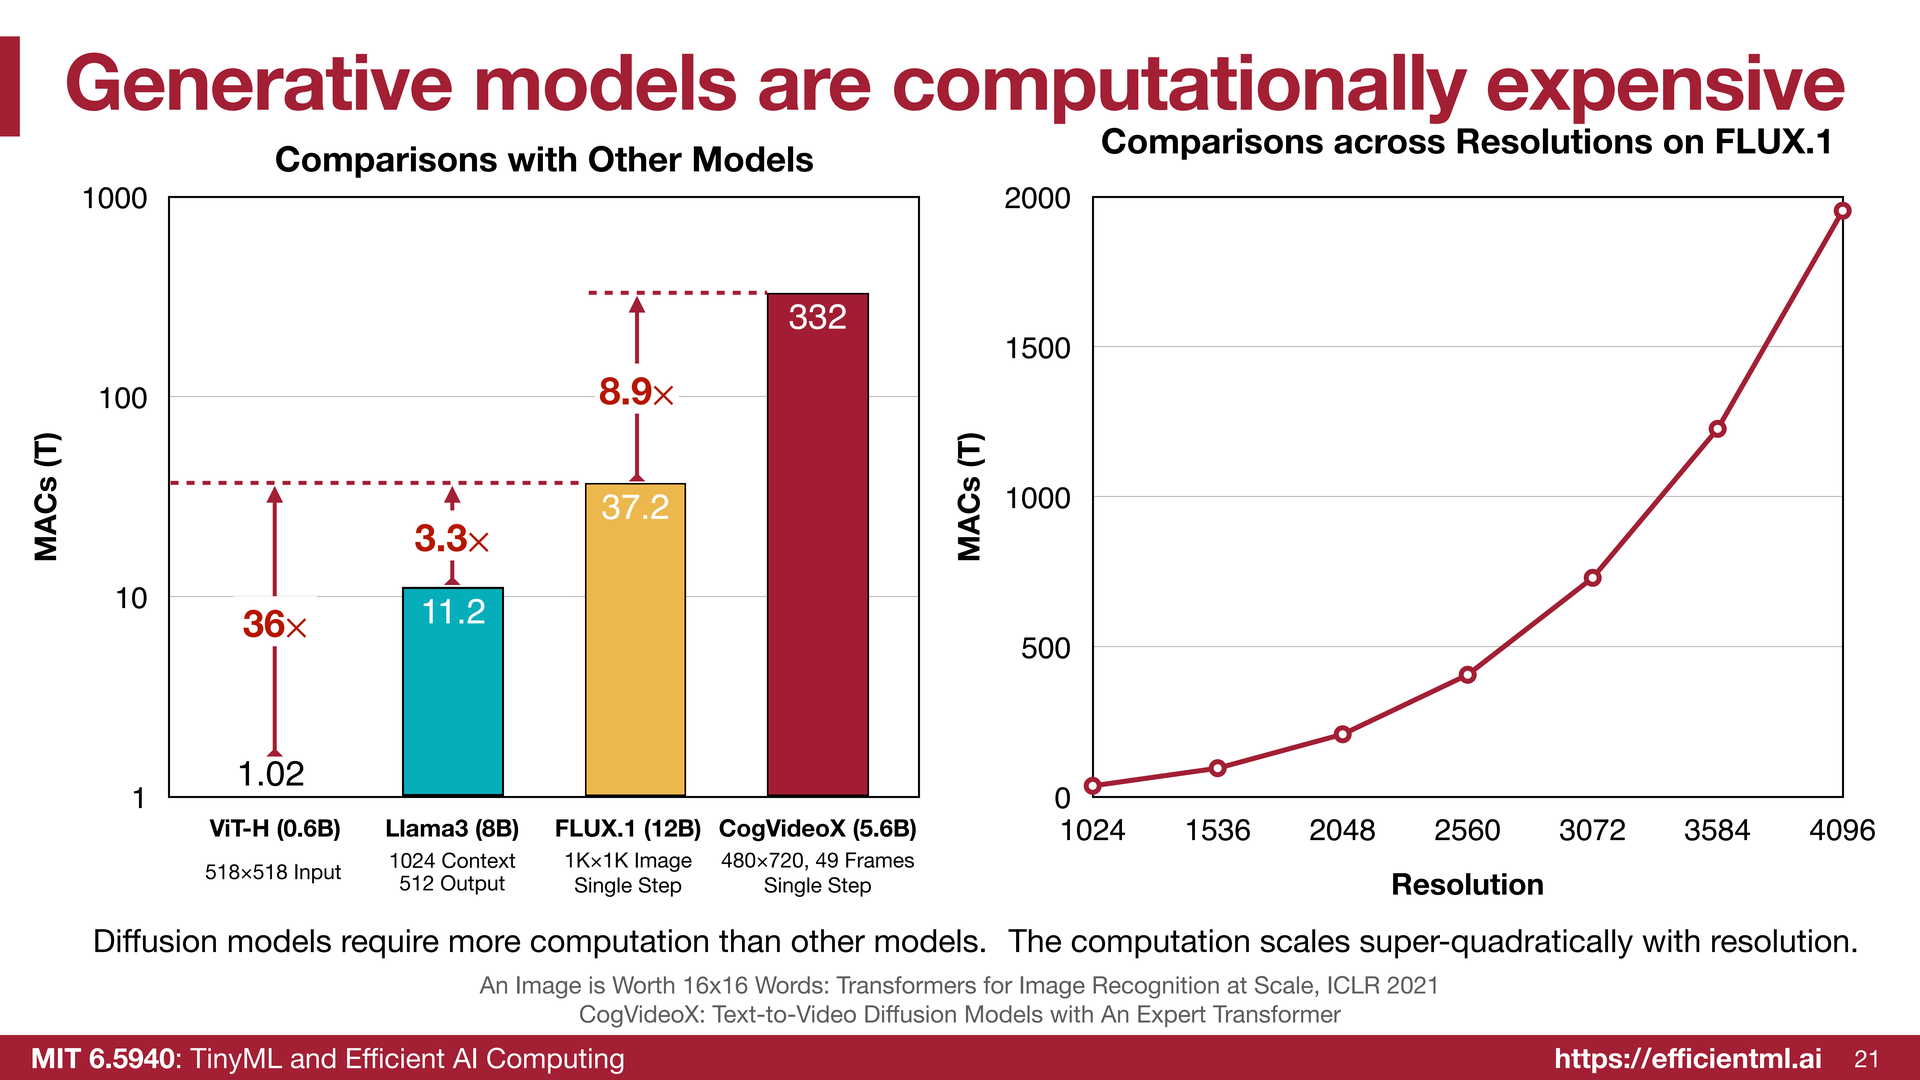
上图对比了不同的模型:ViT(图像识别)、80 亿参数的 LLaMA(语言模型)和 FLUX(图像生成)。FLUX 的开销是 ViT 的 36 倍,是语言模型的 3 倍多 ,而 视频生成还要更贵---比如 CogVideoX 大约 60 亿参数,开销几乎是图像生成的 9 倍。
对于 Transformer 来说,生成的内容越长,需要的 token 就越多,而 注意力机制的计算复杂度随 token 数量呈二次增长 。那要怎么省 token 呢?能不能用 线性 Transformer、线性注意力、块稀疏注意力?这些话题我们会在课里深入讲。右边这张图显示,随着分辨率提高,MAC 也在飞速增长。所以我们会介绍高效的图像生成技术来降低计算成本。
4.4 Efficient Image, Video and 3D Generation
比如我们组 Muyang 的早期工作 GAN Compression,是与 CMU 的 Jun-Yan Zhu 教授合作完成的,可以 通过剪枝把计算量降低一个数量级。
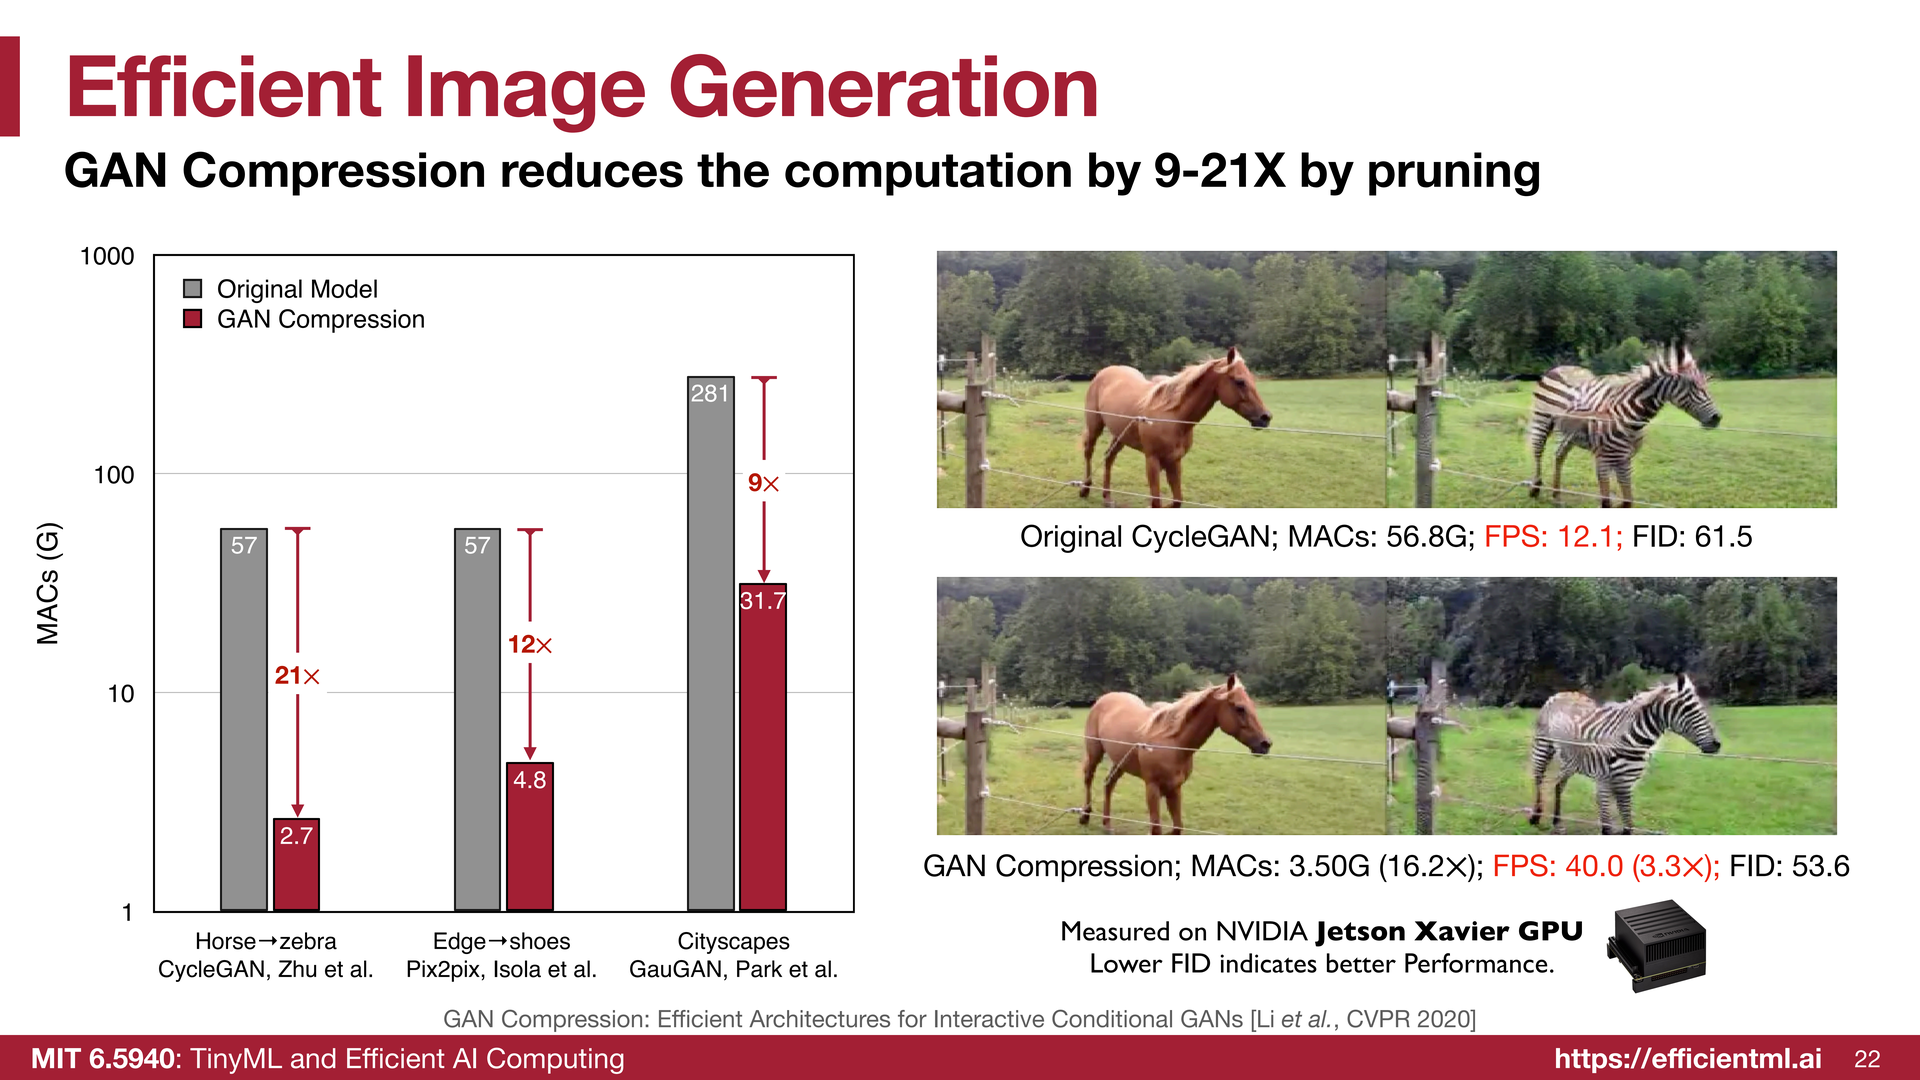
右图展示了原始版 CycleGAN 和 GAN Compression 的对比。这个任务是把马变成斑马,基线每秒只有 12 帧;加速后能跑到每秒 40 帧。
另一项工作是实时图像编辑。我们叫它 Anycost GAN,是 Ji 和 Richard 2021 年的工作。
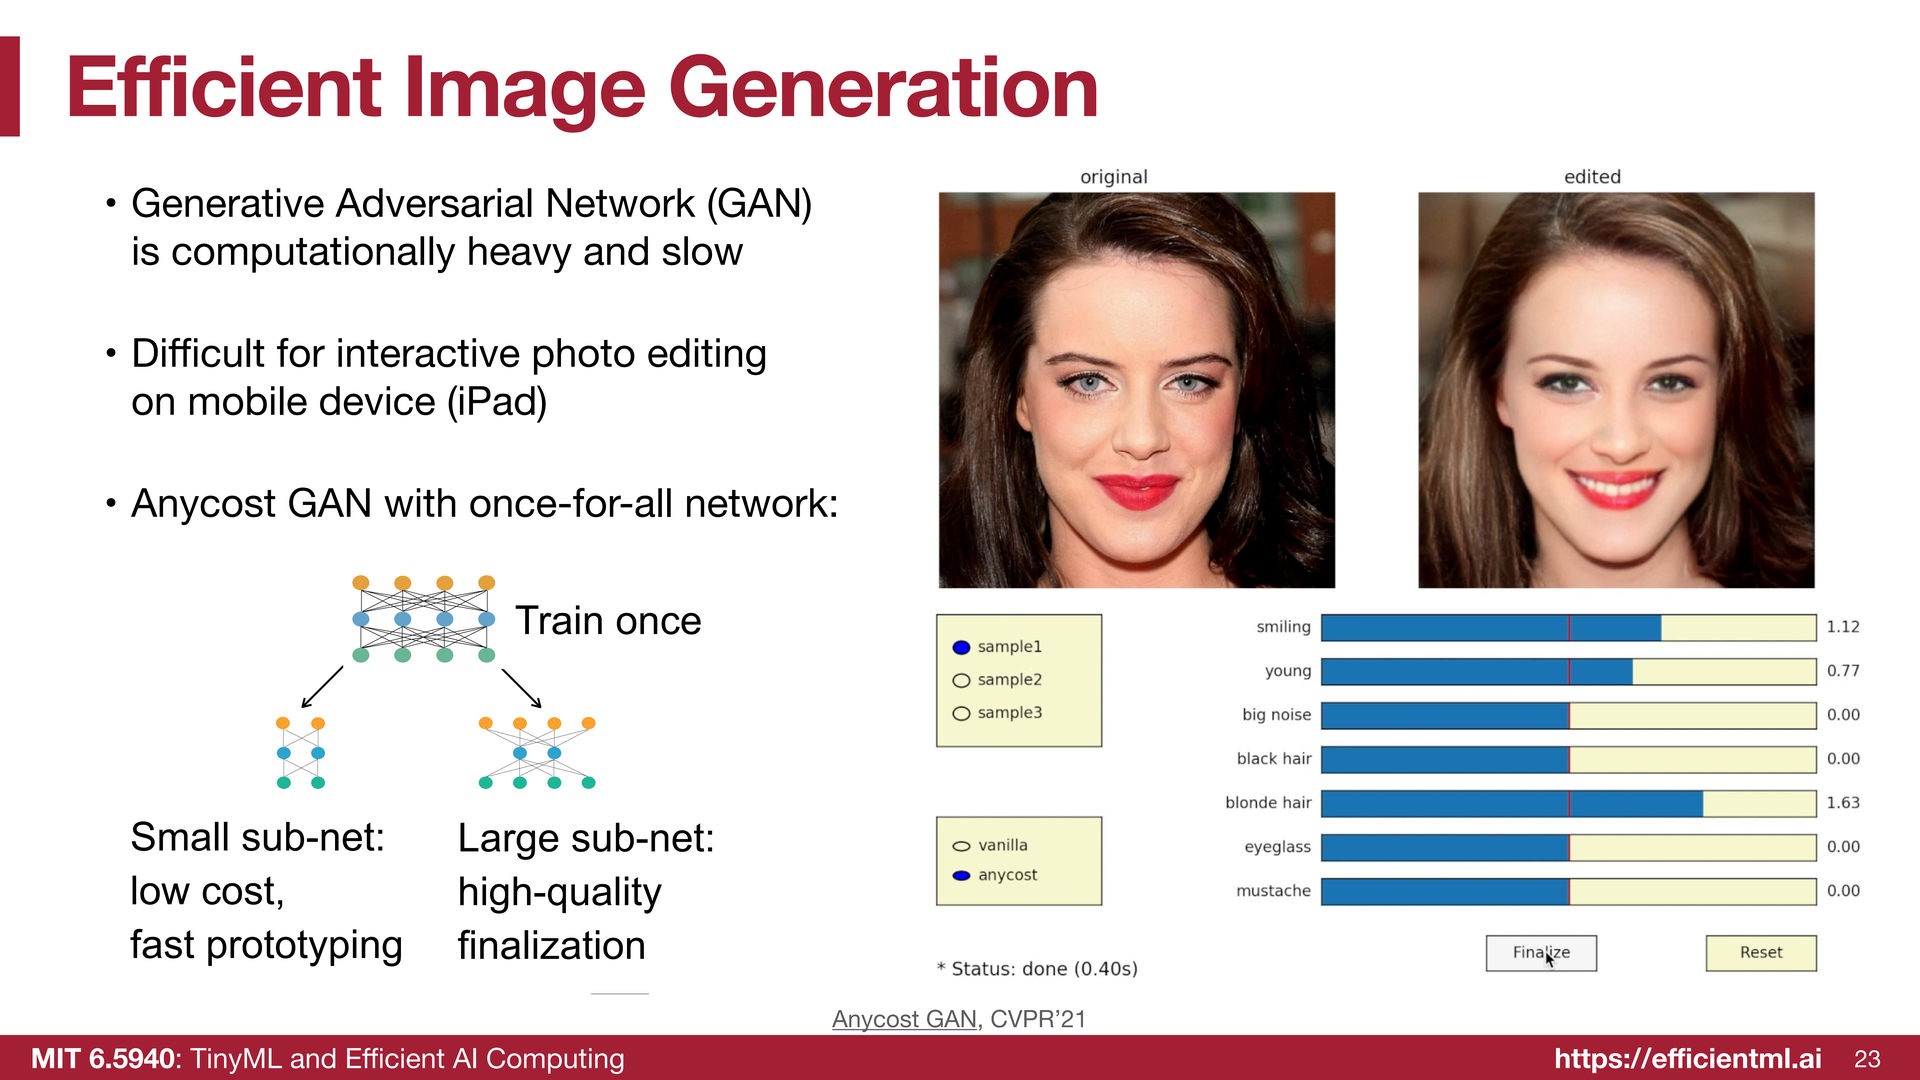
这些生成对抗网络计算量很大、很慢,对图像编辑来说很难用。但我们意识到,人们修图时通常 先从一个粗略的版本开始 ---先用低分辨率、低画质看看效果,然后再跑完整模型。于是我们设计了这样一个 Once-for-All 网络:它有不同大小的子组件,其中有一个非常小、跑得飞快的子模型。这样就能快速做原型:比如把滑块往右拉,让她笑起来;拉得越多,她就笑得越开心。
你也可以把第二个滑块往右拉,让她看起来更年轻。而且速度非常快,可以实时完成,比如像这里一样改变头发颜色。最后,当你满意的时候点击 finalize,它就会跑完整模型,而 权重是共享的 。所以你可以 用小模型快速做原型,最后再跑完整模型拿到最终结果。这就是 Anycost GAN 的工作原理。
它既能跑完整模型,也能跑小得多的子模型,画质几乎没有损失。
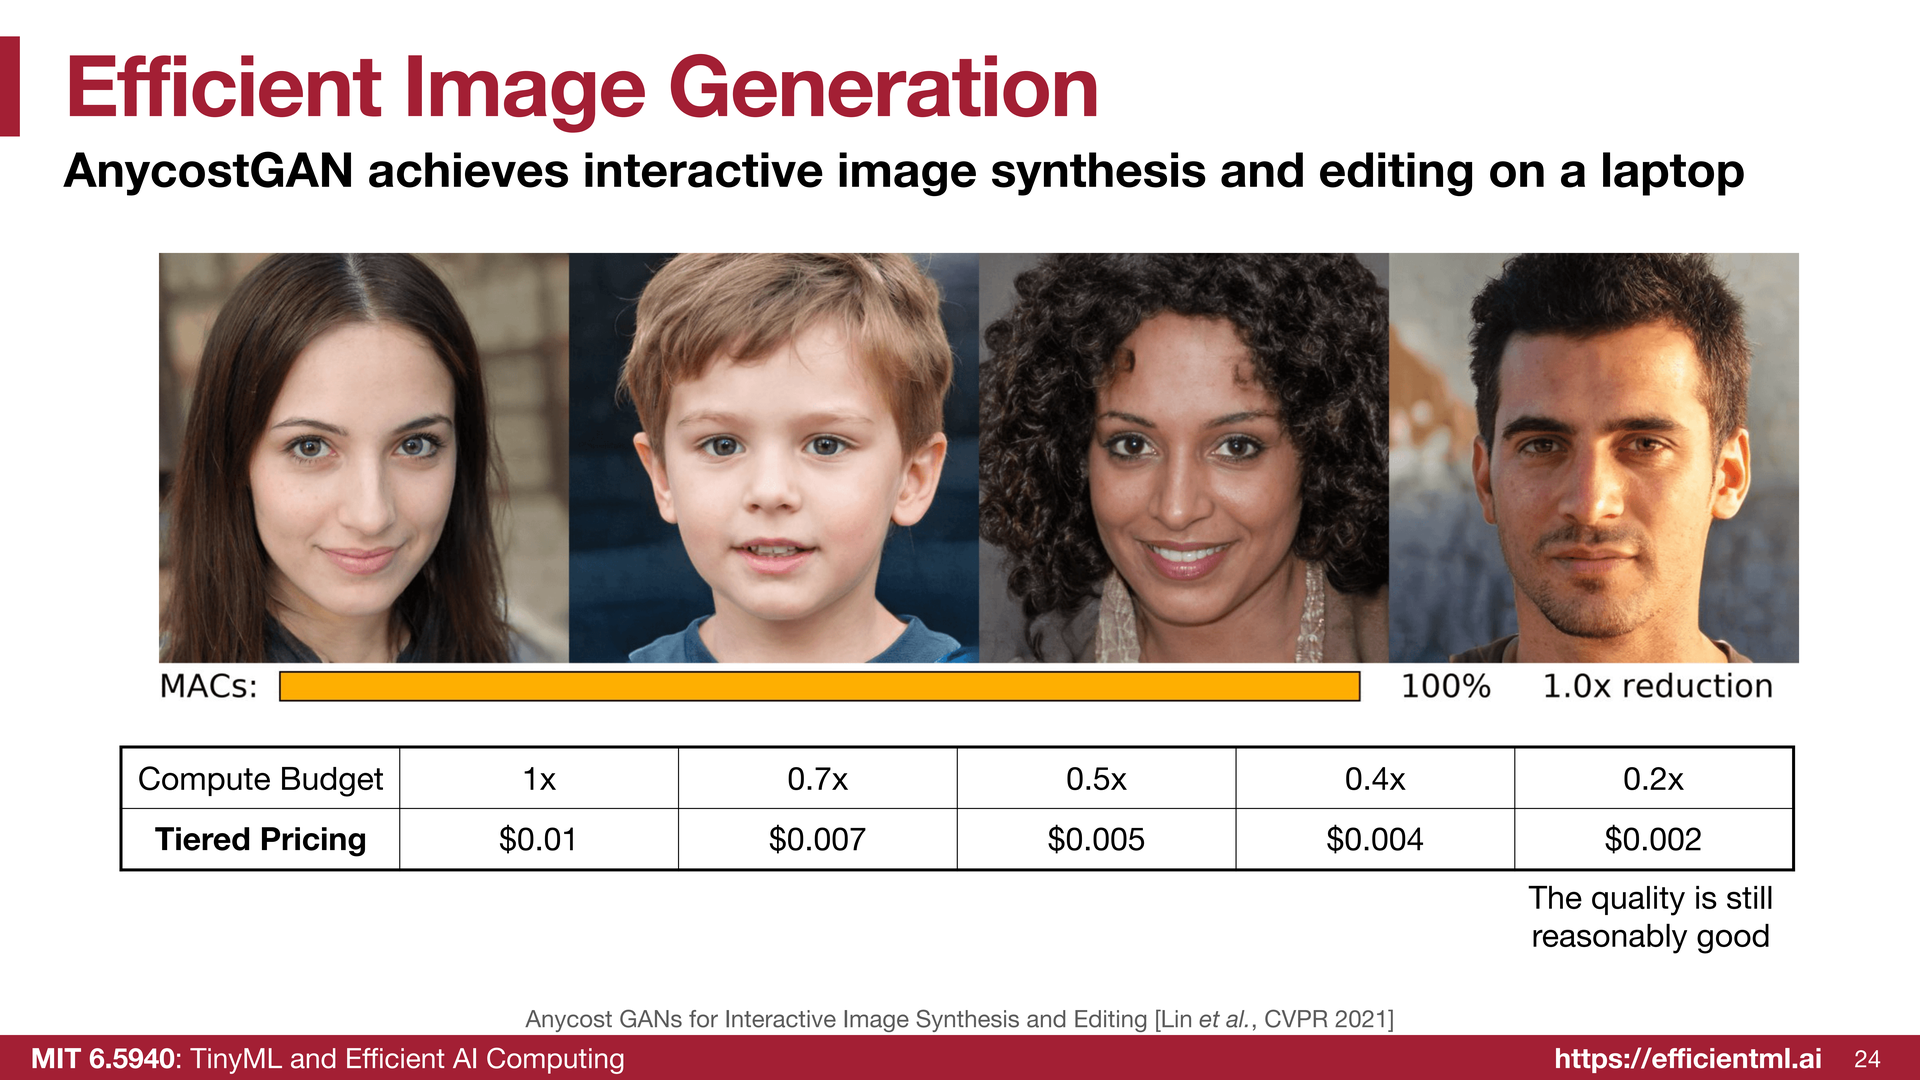
看最左边这个最极端的例子,计算量降到约 1/5.2,图像质量依然很好。
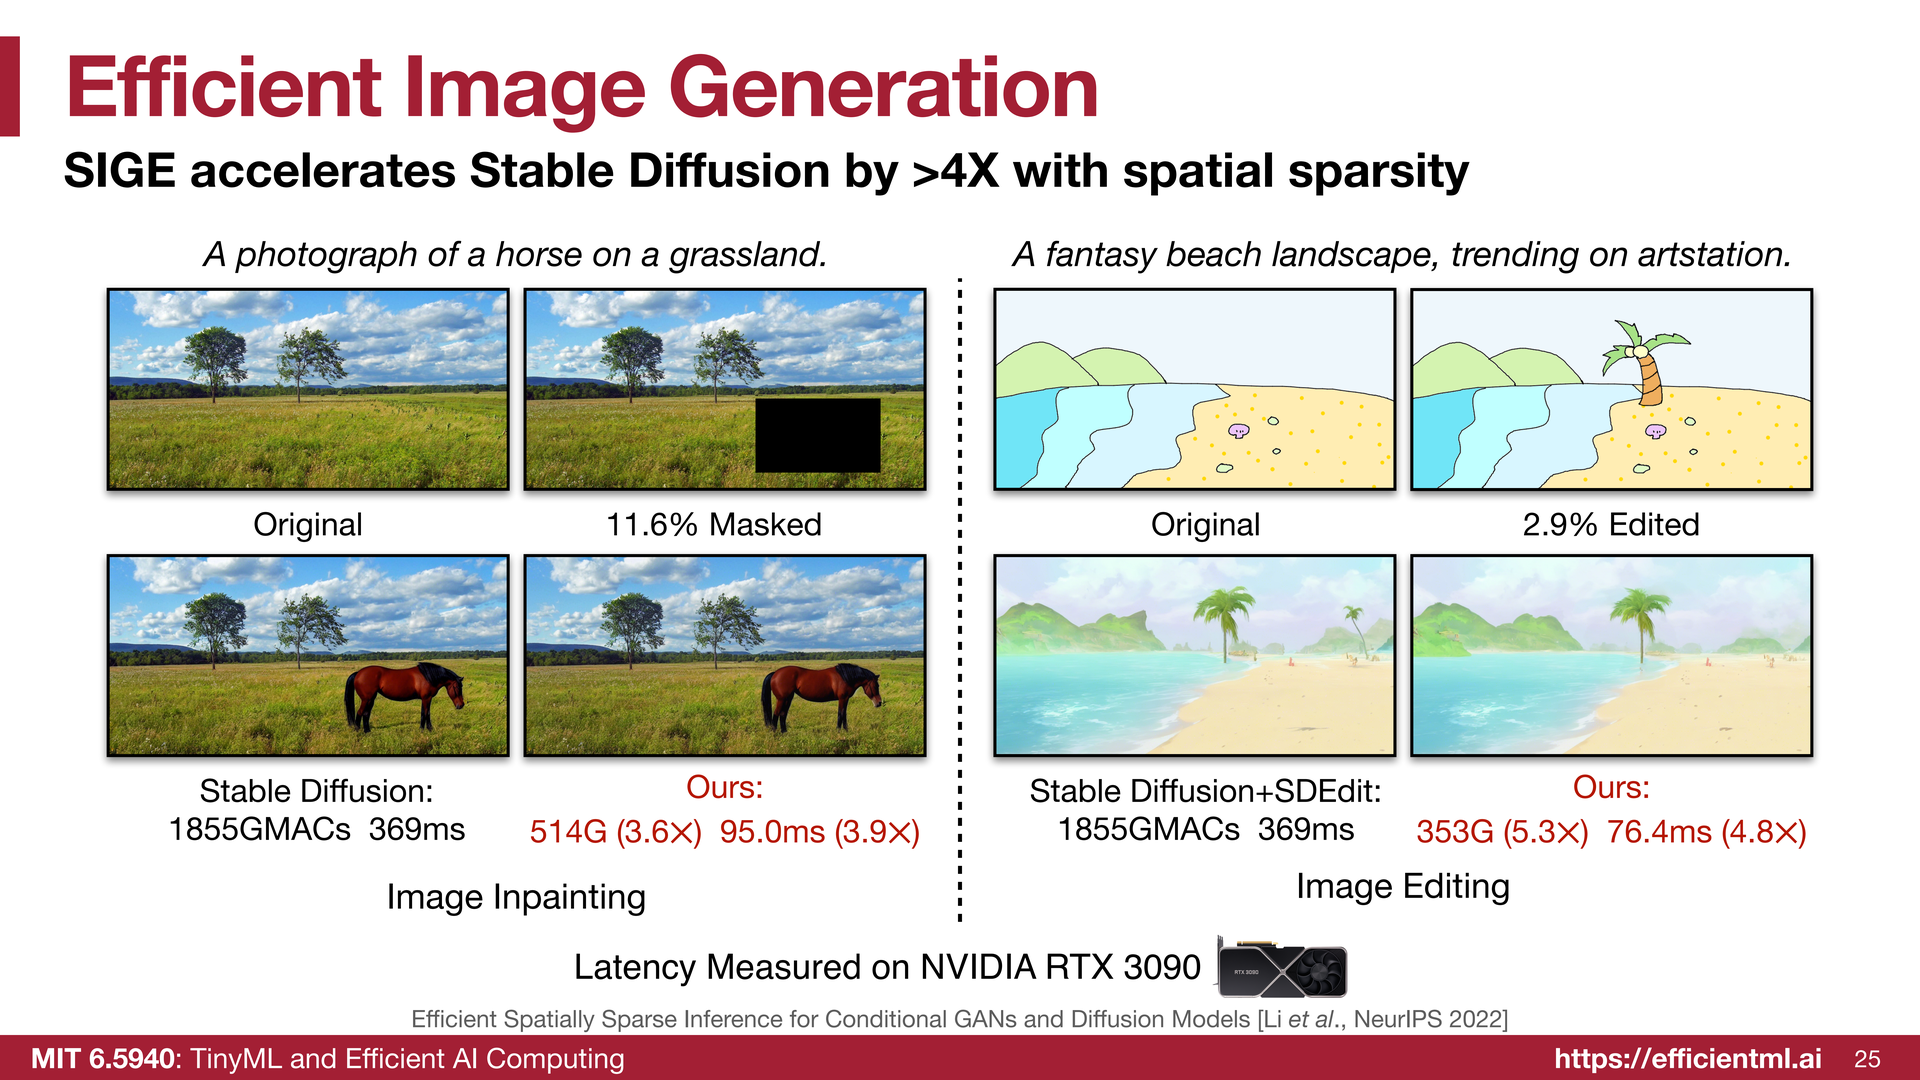
另一项高效图像生成工作是 图像修复(inpainting) 。什么是图像修复呢?也就是 在指定的掩码区域内生成新内容 。比如这里我们想在掩码区域里加一匹马,提示词是 "a photograph of a horse on a grassland"(草地上的一匹马的照片)。Stable Diffusion 原始模型需要 1700 GMACs,耗时 369 毫秒 。而用我们加速后的模型,只需要 500 GMACs,耗时不到 100 毫秒,快得多。
类似地,右图这里我们想在这个位置加一棵椰子树,提示词是 "the fantasy beach landscape trending on art station"。原始版和我们的版本看起来几乎一样,但我们能实现大约 4.8 倍的加速。
后面在课程中我们还会介绍并行、多 GPU 推理、多 GPU 训练。
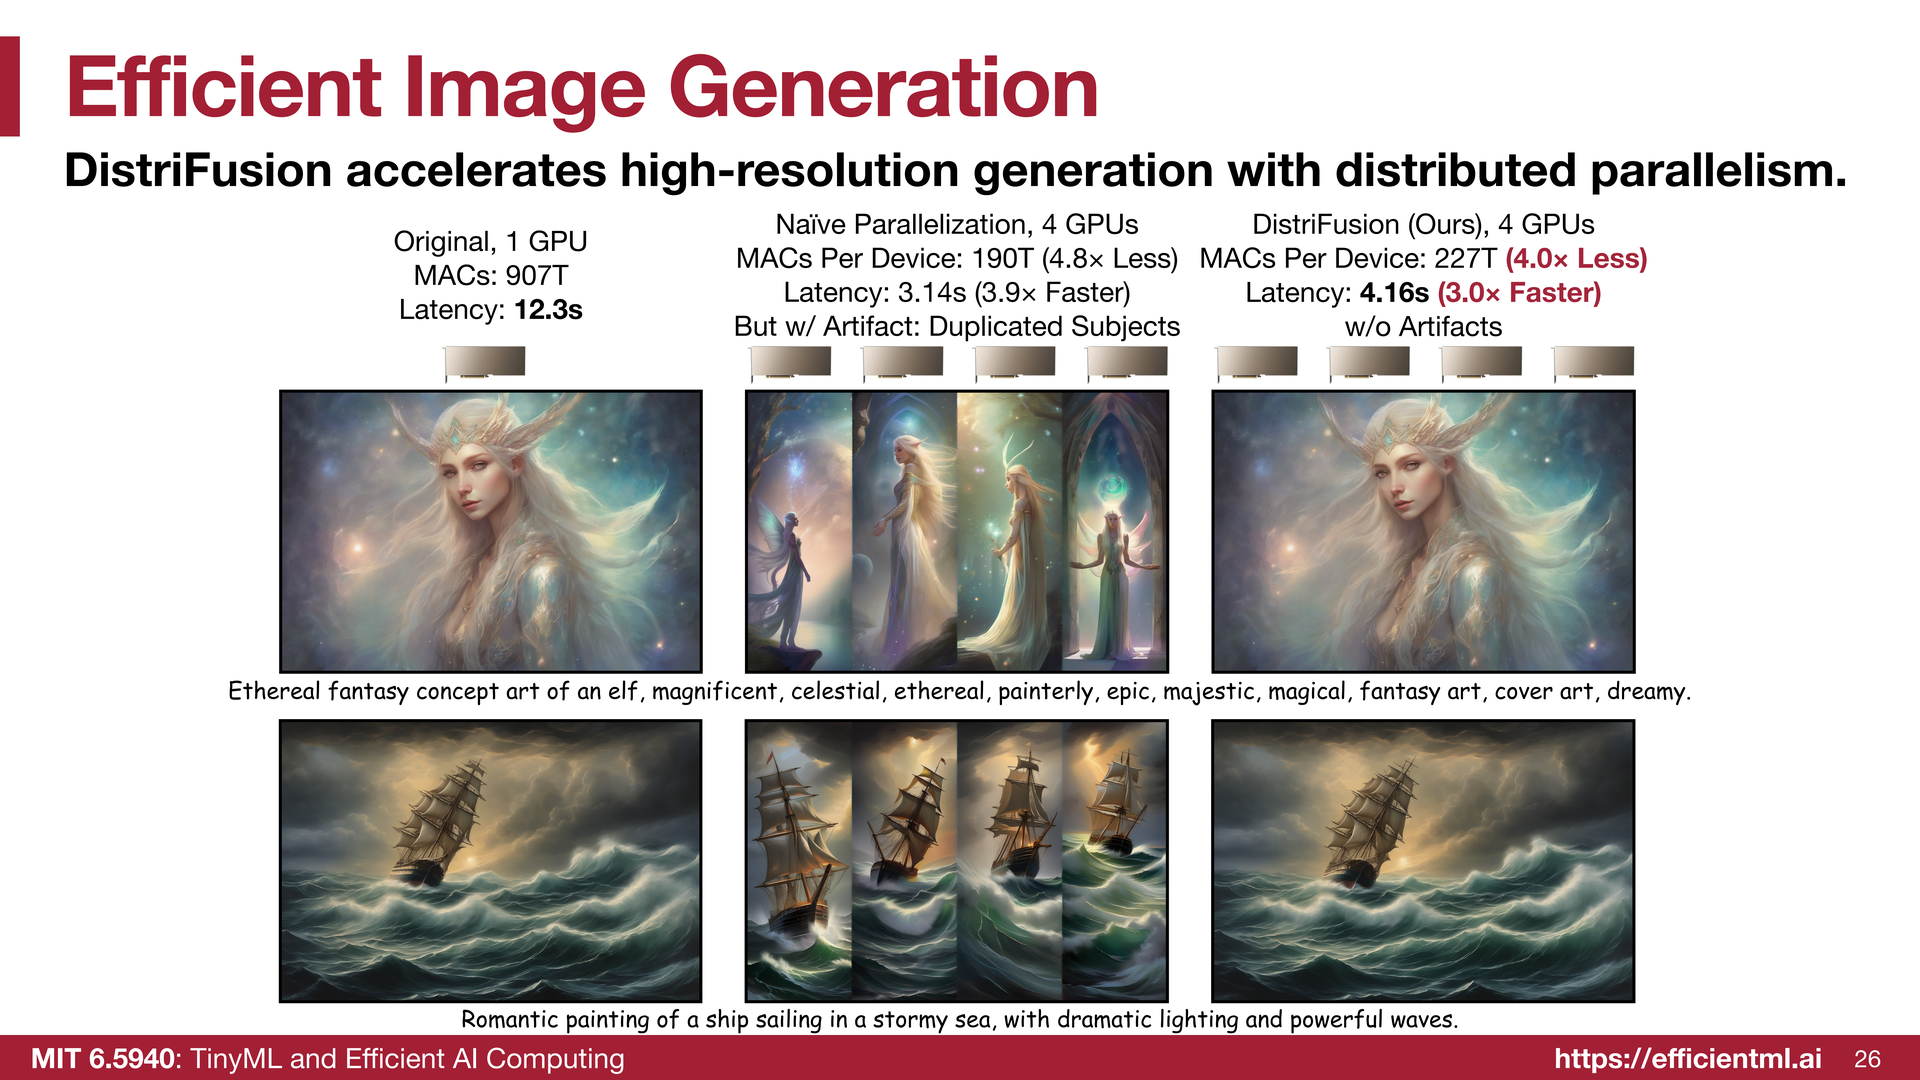
这里展示了一个例子:用一块 GPU 跑推理需要 12 秒,四块 GPU 直接并行只要 3 秒,但拼出来的图有 接缝伪影 ;加上 GPU 间的通信与同步后,伪影消除 ,耗时略增到 4 秒,换来一张连贯的大图。这就是 分布式推理与并行的价值。
并行在如今的大语言模型服务中非常重要:模型动辄数万亿参数,单块 GPU 装不下,甚至单个节点都未必有足够的内存同时放下所有权重和 KV cache,因此必须依赖 GPU 之间的通信。而 数据搬运非常昂贵 ---这就像做饭:计算本身很便宜,贵的是把食材从超市搬进冰箱,再从冰箱搬到厨师手里。内存访问和网络访问,就属于这样昂贵的数据搬运。
那怎么压缩搬运过程中的数据呢?我们会学 梯度压缩、梯度量化 这类技术,它们可以降低通信开销。
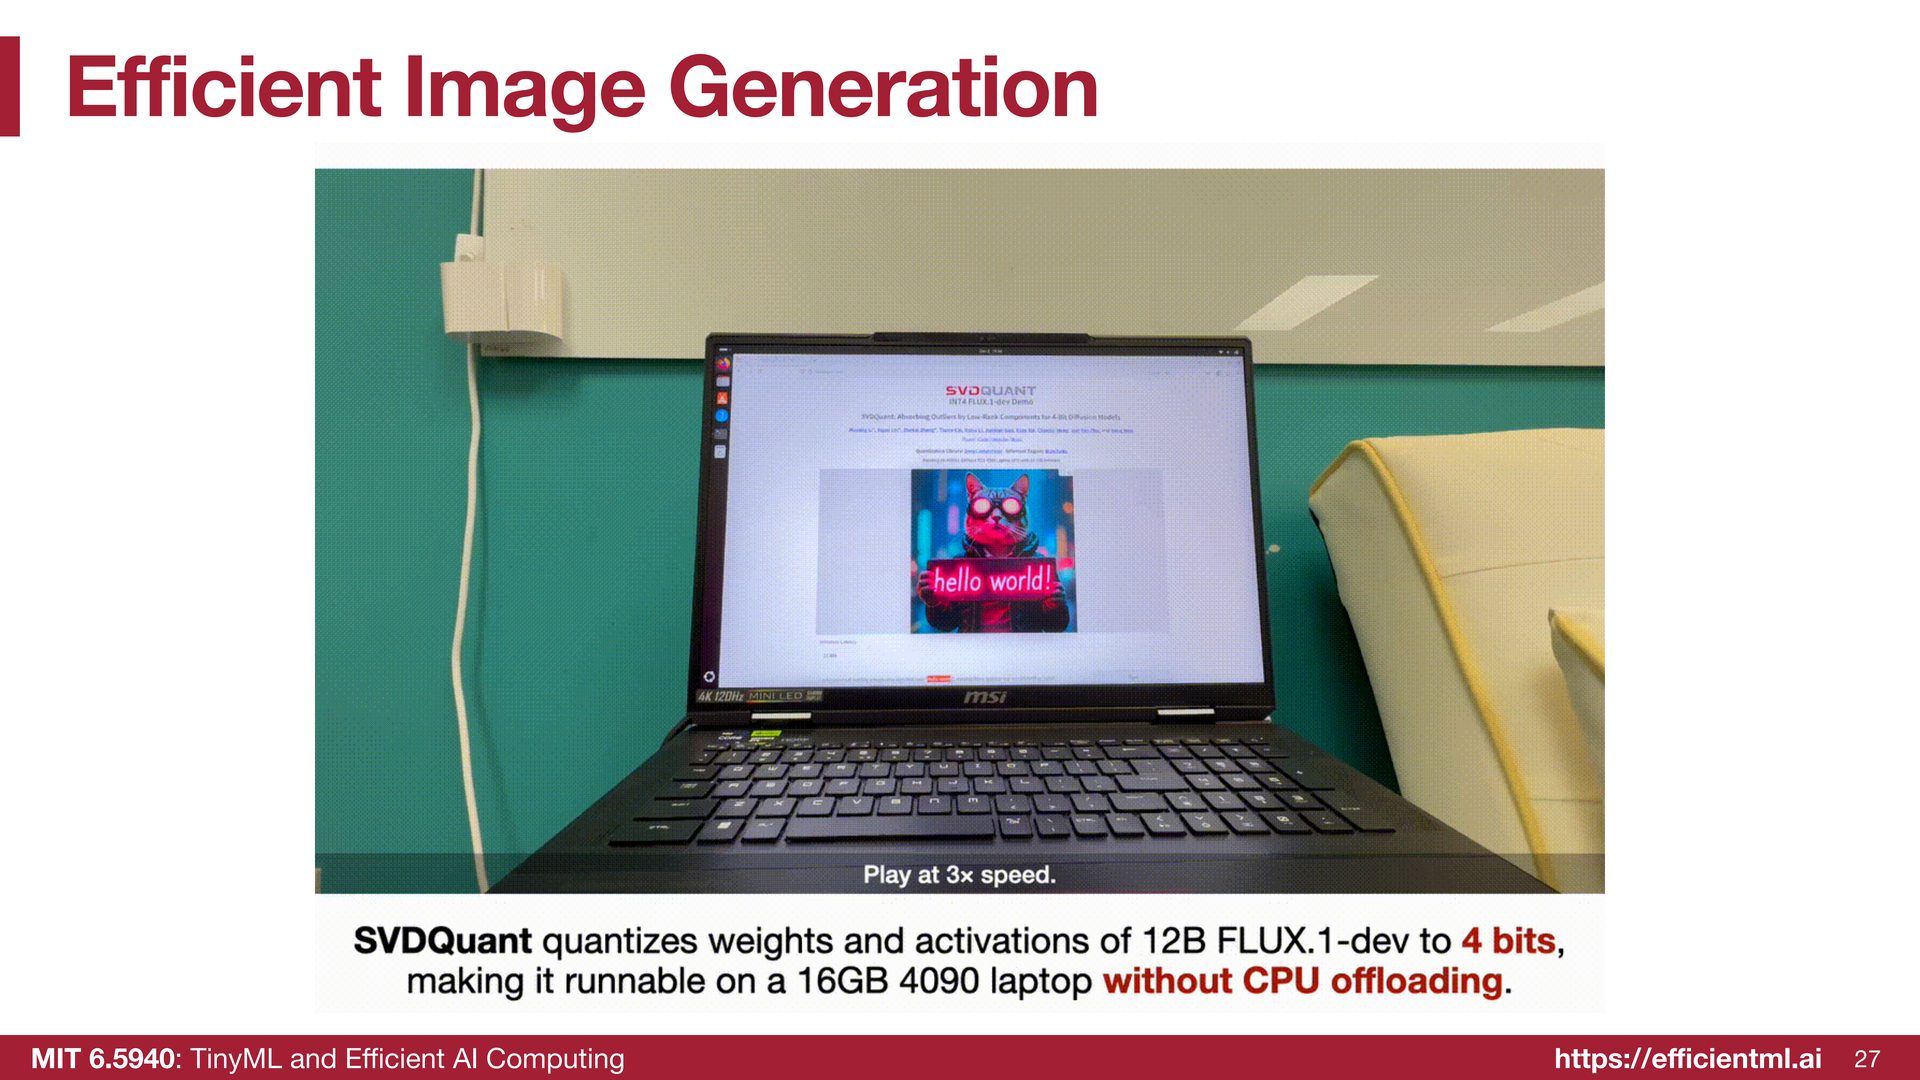
加速之后,这些扩散模型其实已经能在设备本地跑起来。这是 120 亿参数的 FLUX 在笔记本上本地运行 :最左边是加速前,右边是加速后。你还可以直接 套用现成的 LoRA 来获得不同的风格,比如动画风格、绘画风格,甚至可以做局部编辑,比如画一栋房子,然后在上面加几扇窗户。
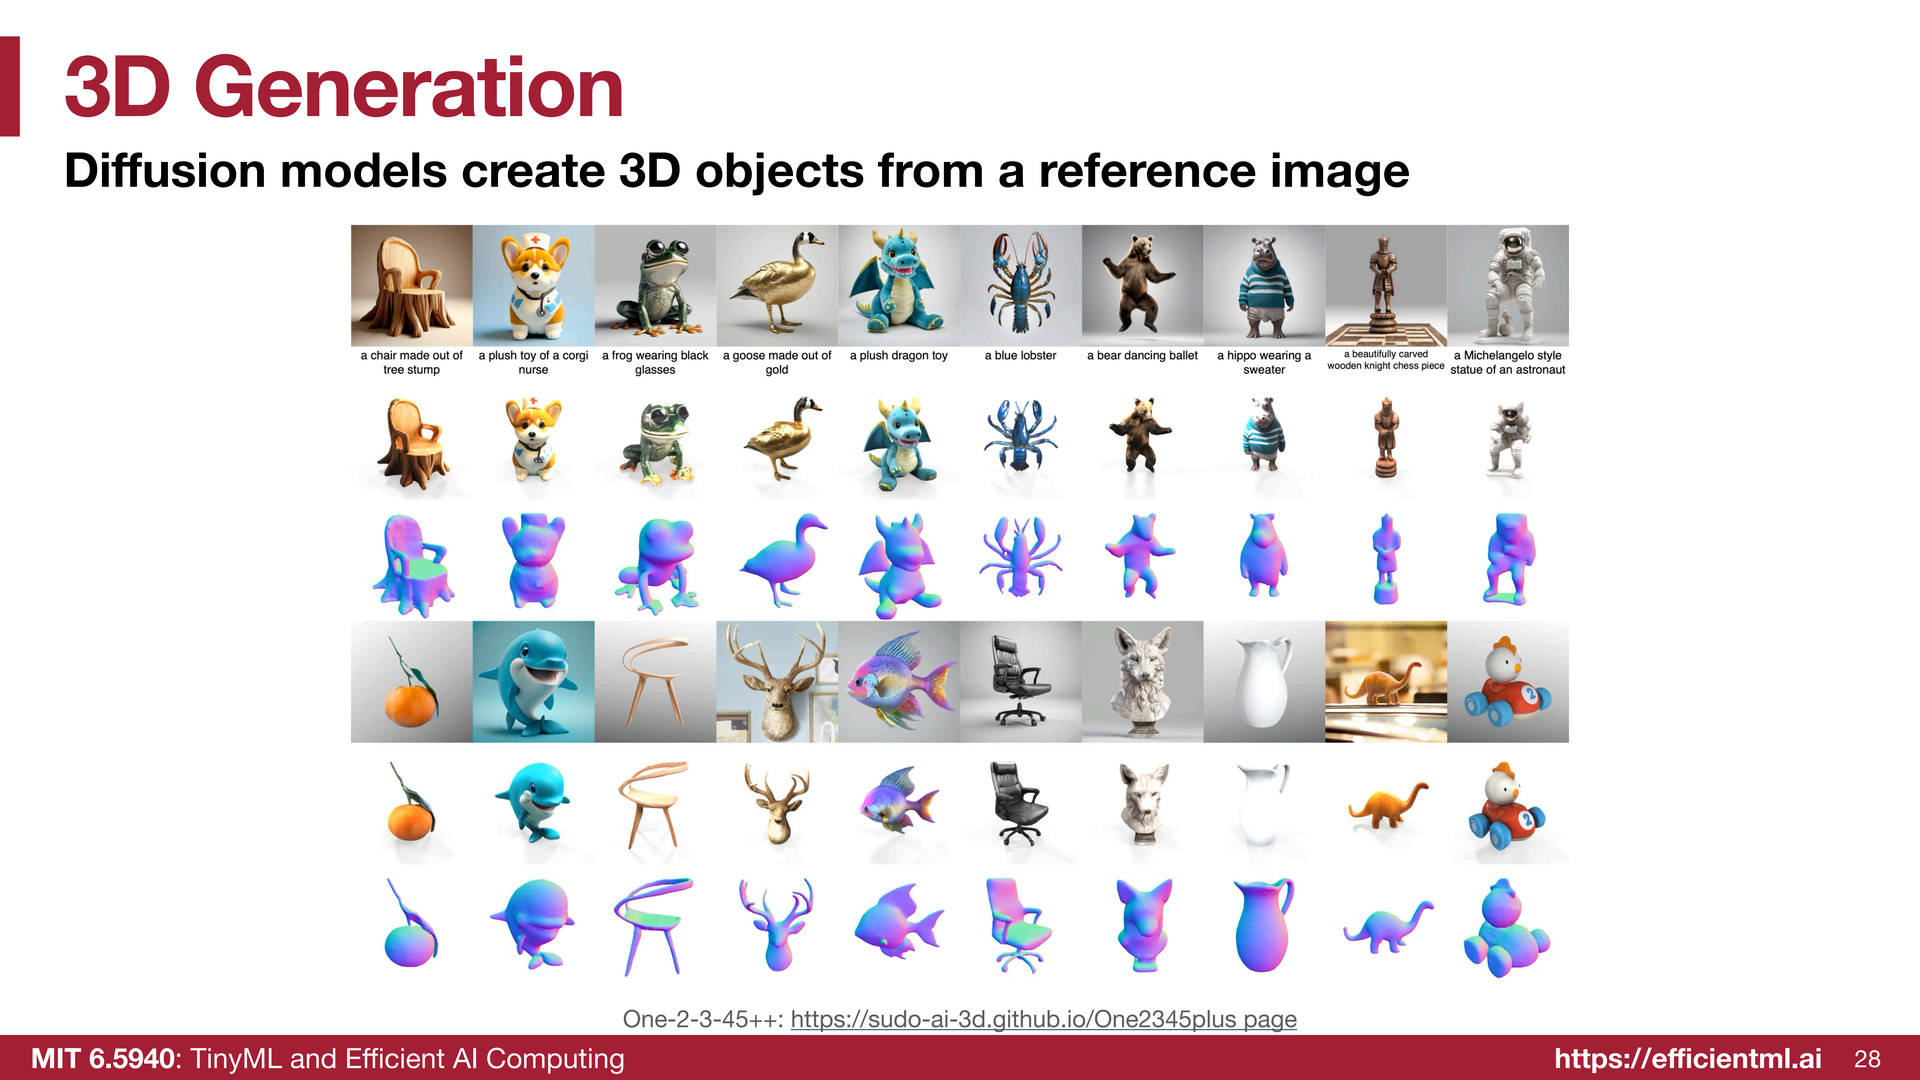
到目前为止我们看到的很多都是 2D 生成任务,而现在人们也能做 3D 生成---用扩散模型从一张参考图创建 3D 物体。
还有视频生成,从零开始生成照片级真实的视频。这是难得多的一项任务---必须保持前后一致,而且模型也非常大。
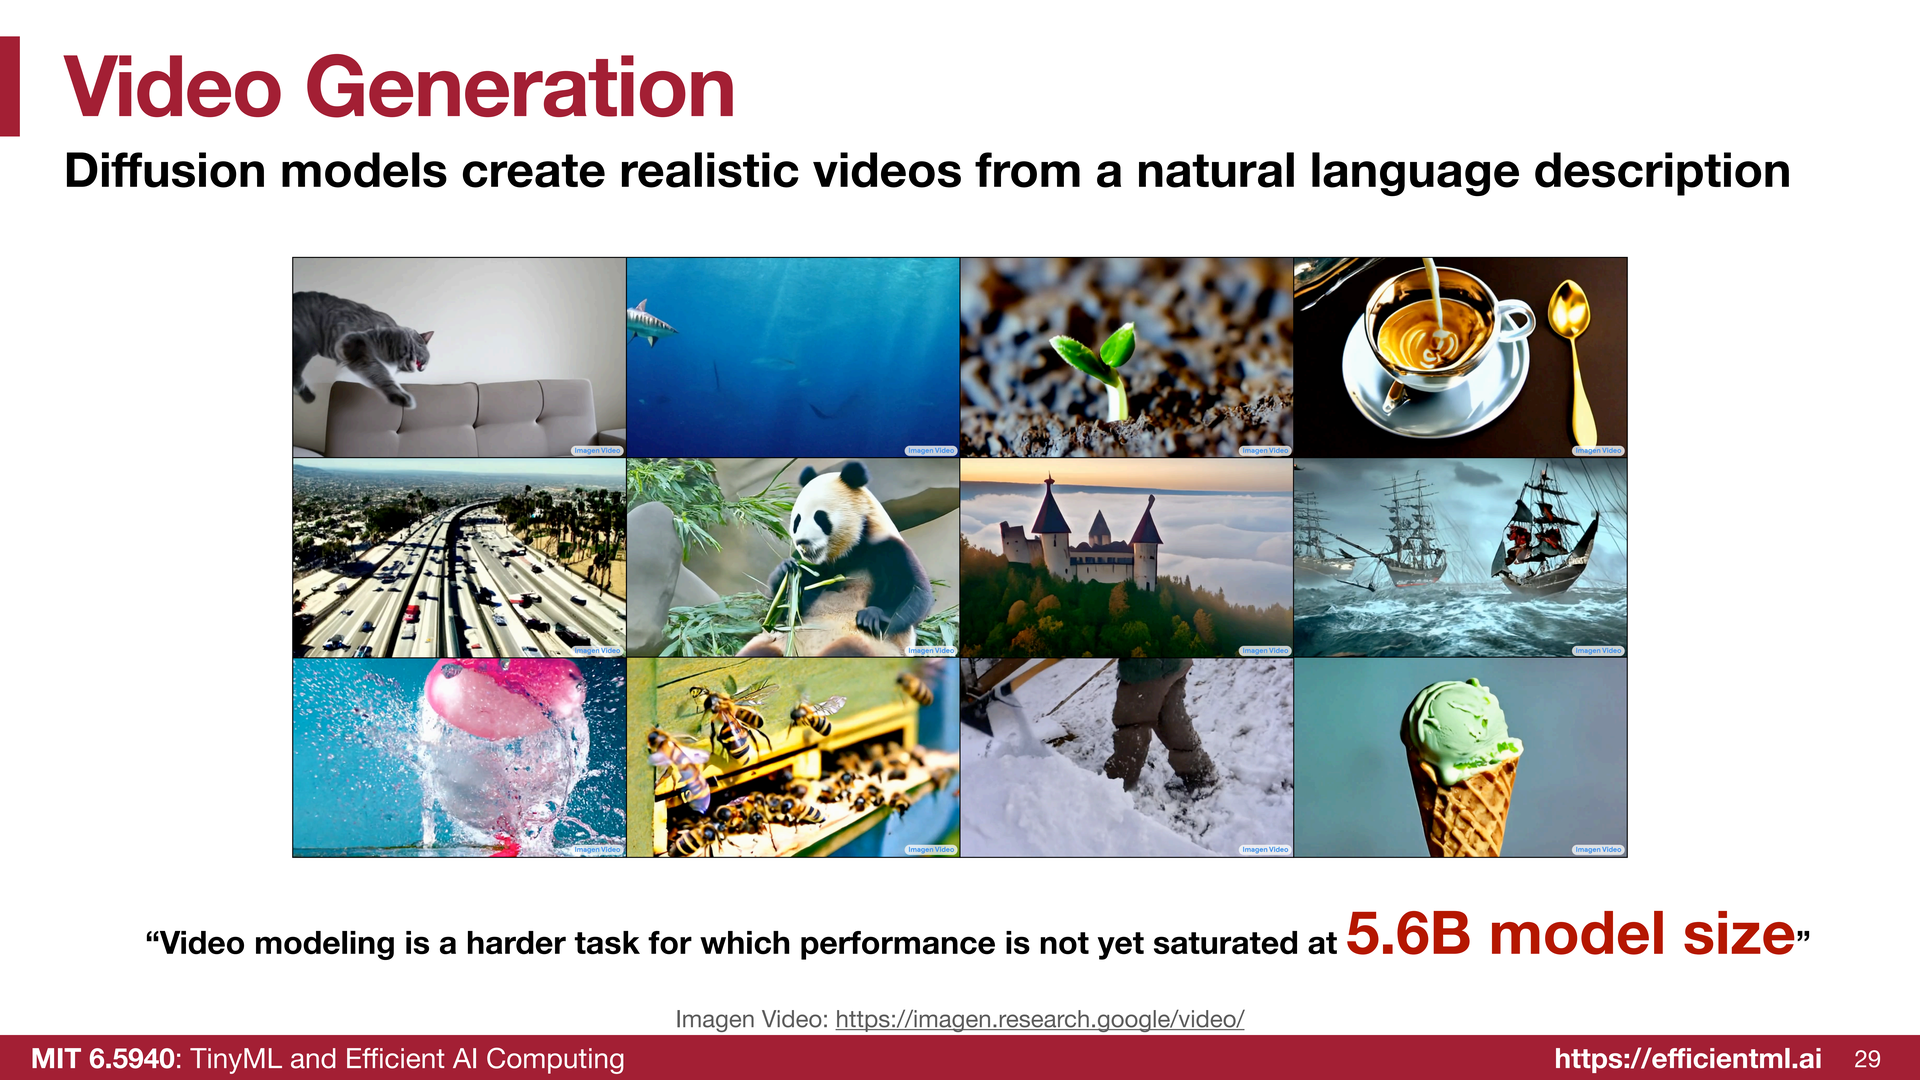
这个例子展示的是一个 56 亿参数的模型,但现在我们已经有更大的模型可用了。
这段视频是我自己生成的,但 仅仅生成这一段就花了好几分钟,目前还做不到实时---通过加速,我们有望做得更快。
4.5 3D Perception
从 2D 视觉到 3D 视觉,如今激光雷达(LiDAR)非常流行,自动驾驶是特斯拉和许多公司正在攻克的问题。深度学习帮助机器感知周围环境,但 没人希望后备箱里塞着一整个工作站,所以效率很重要,端上计算也很重要。
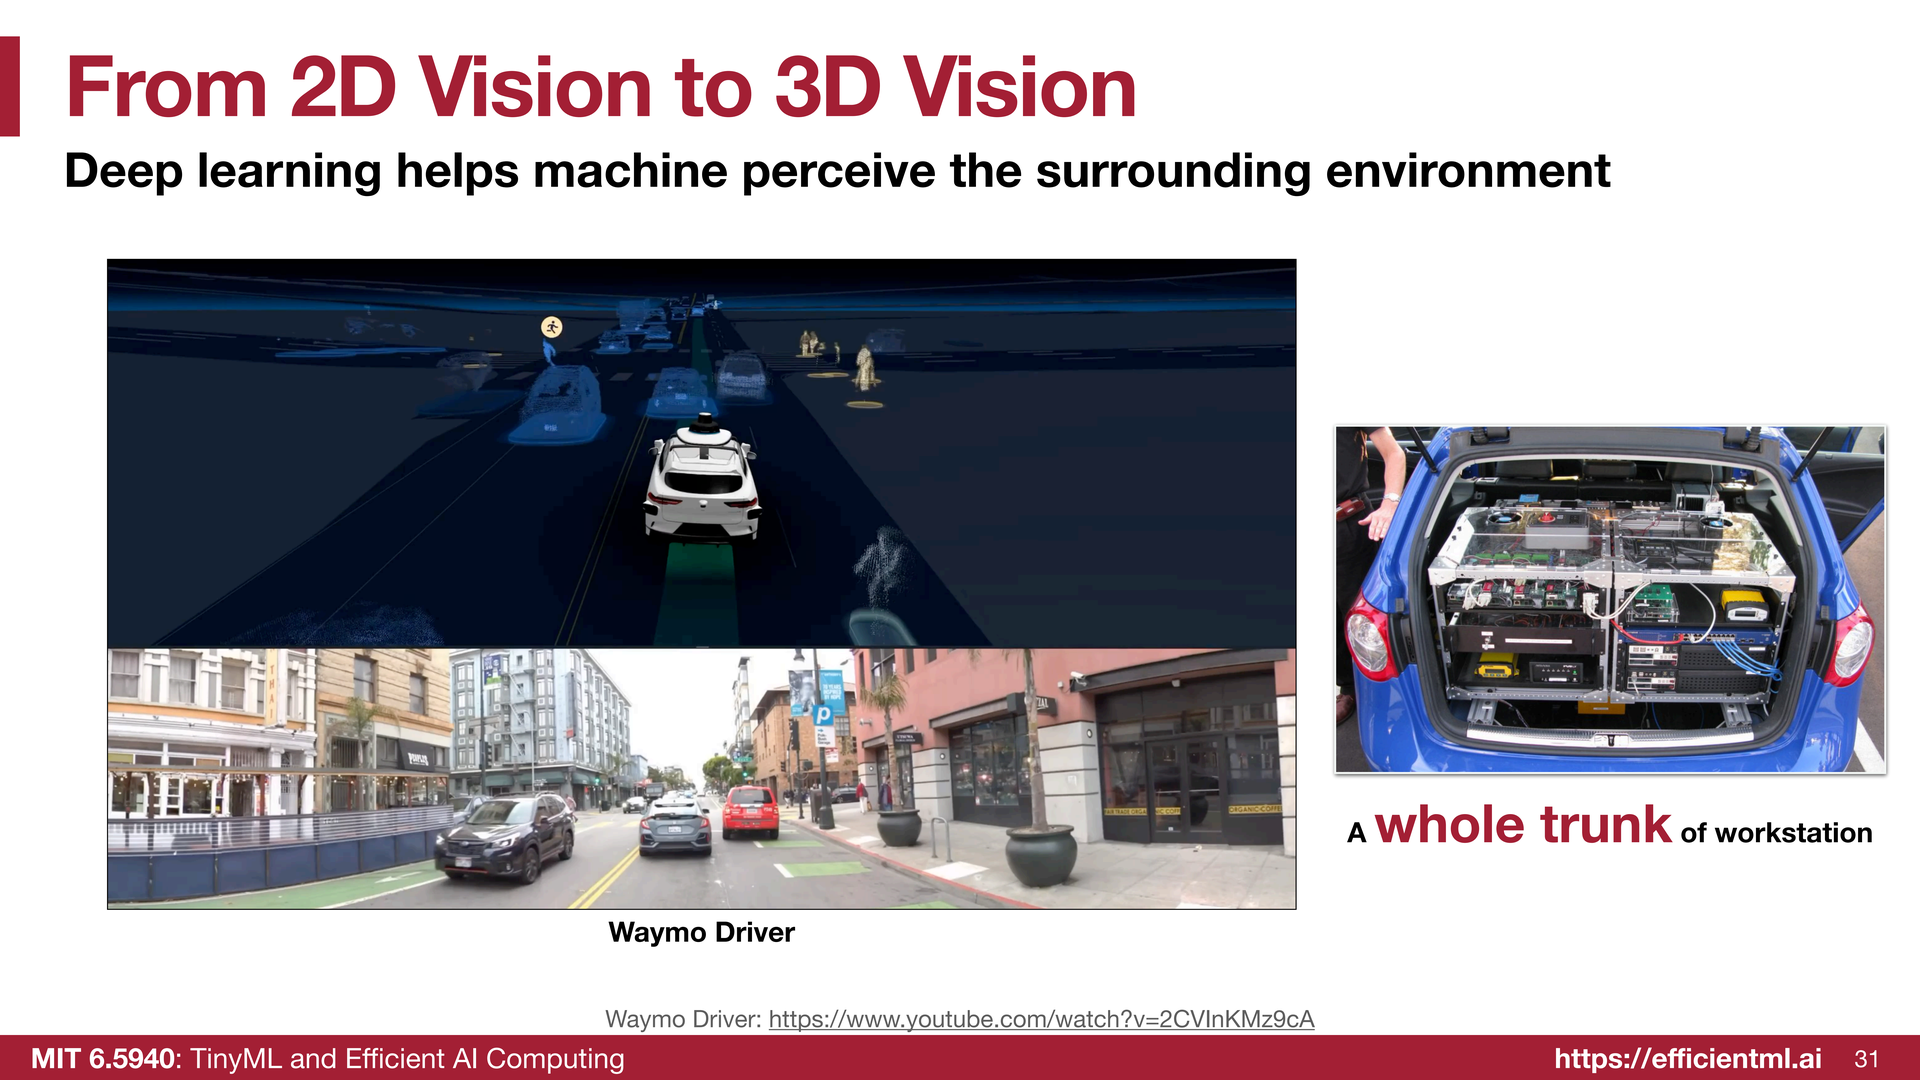
下面是我们做的演示:通过 算法与系统的协同设计 来加速 Pseudo-LiDARNet,实现 3D 感知。
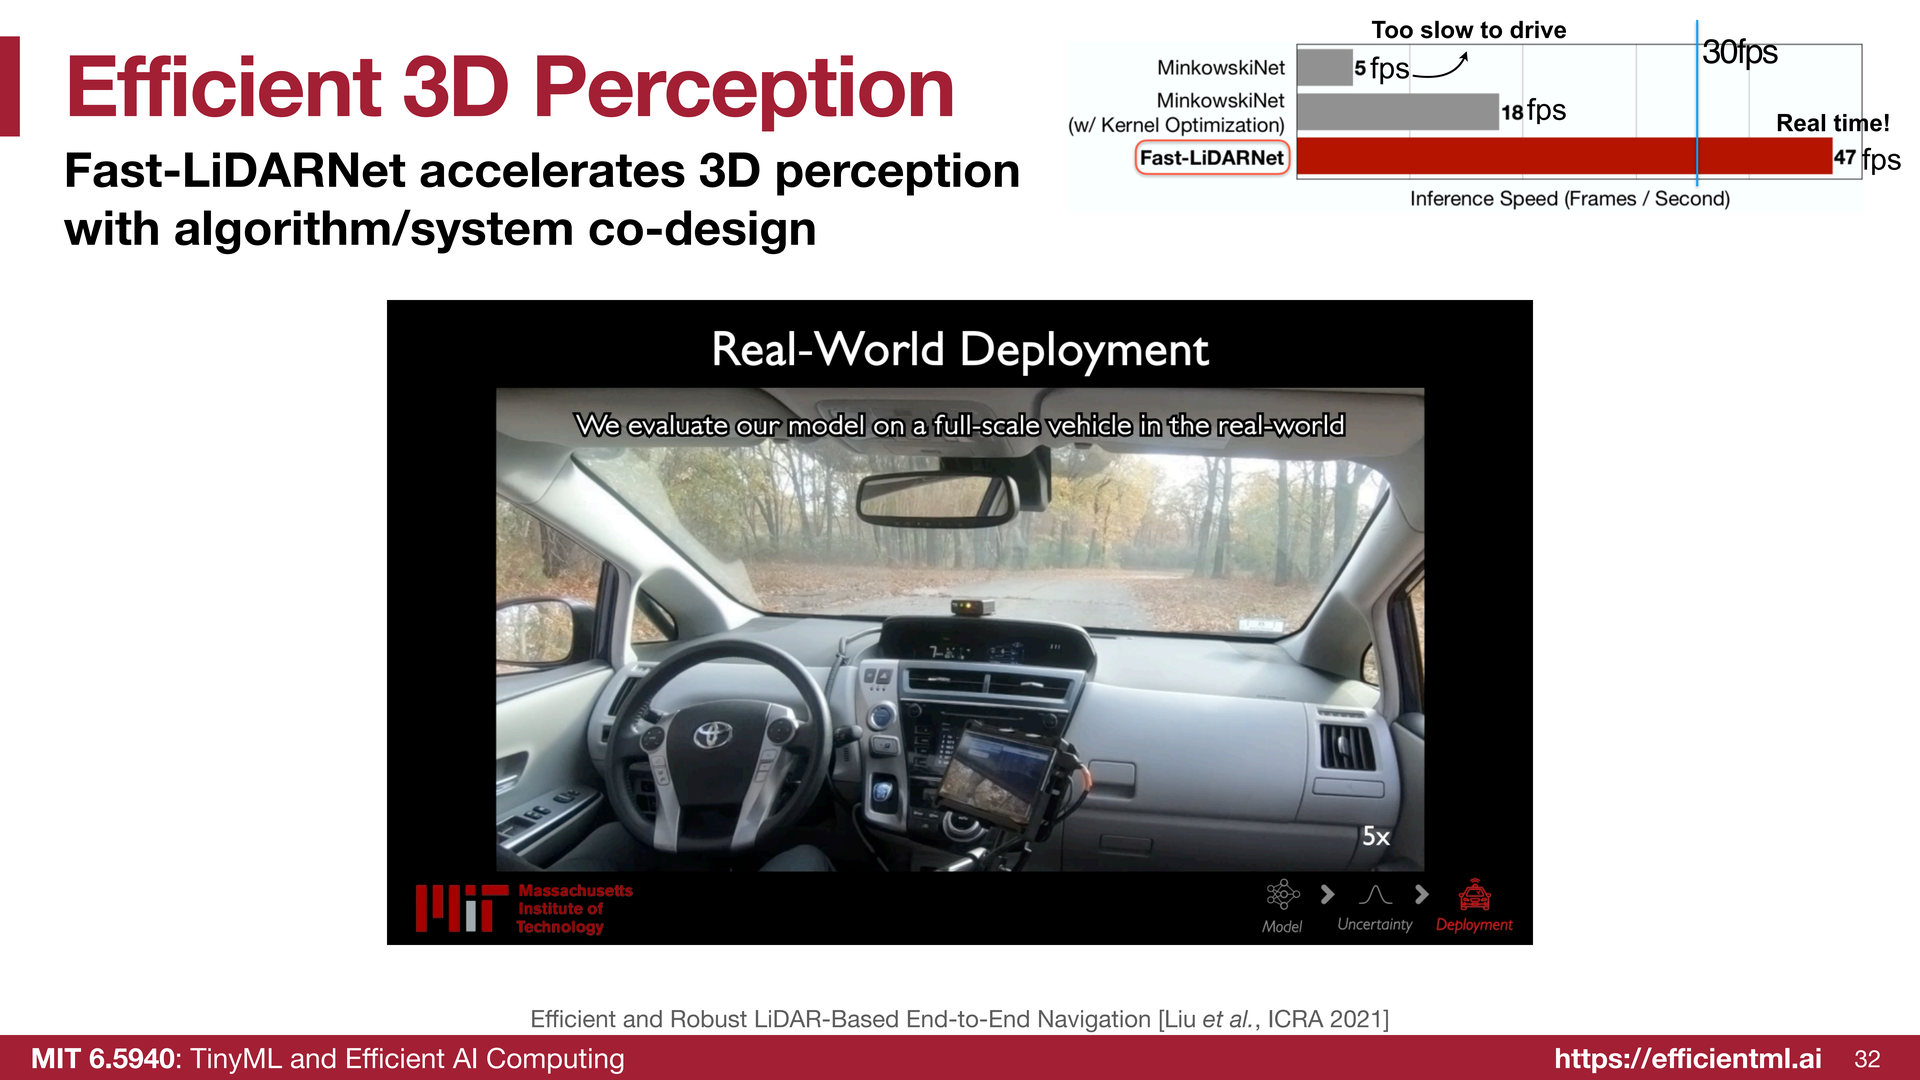
一开始它只能跑到每秒 5 帧。经过我们的加速,用激光雷达开车时能跑到每秒 47 帧。
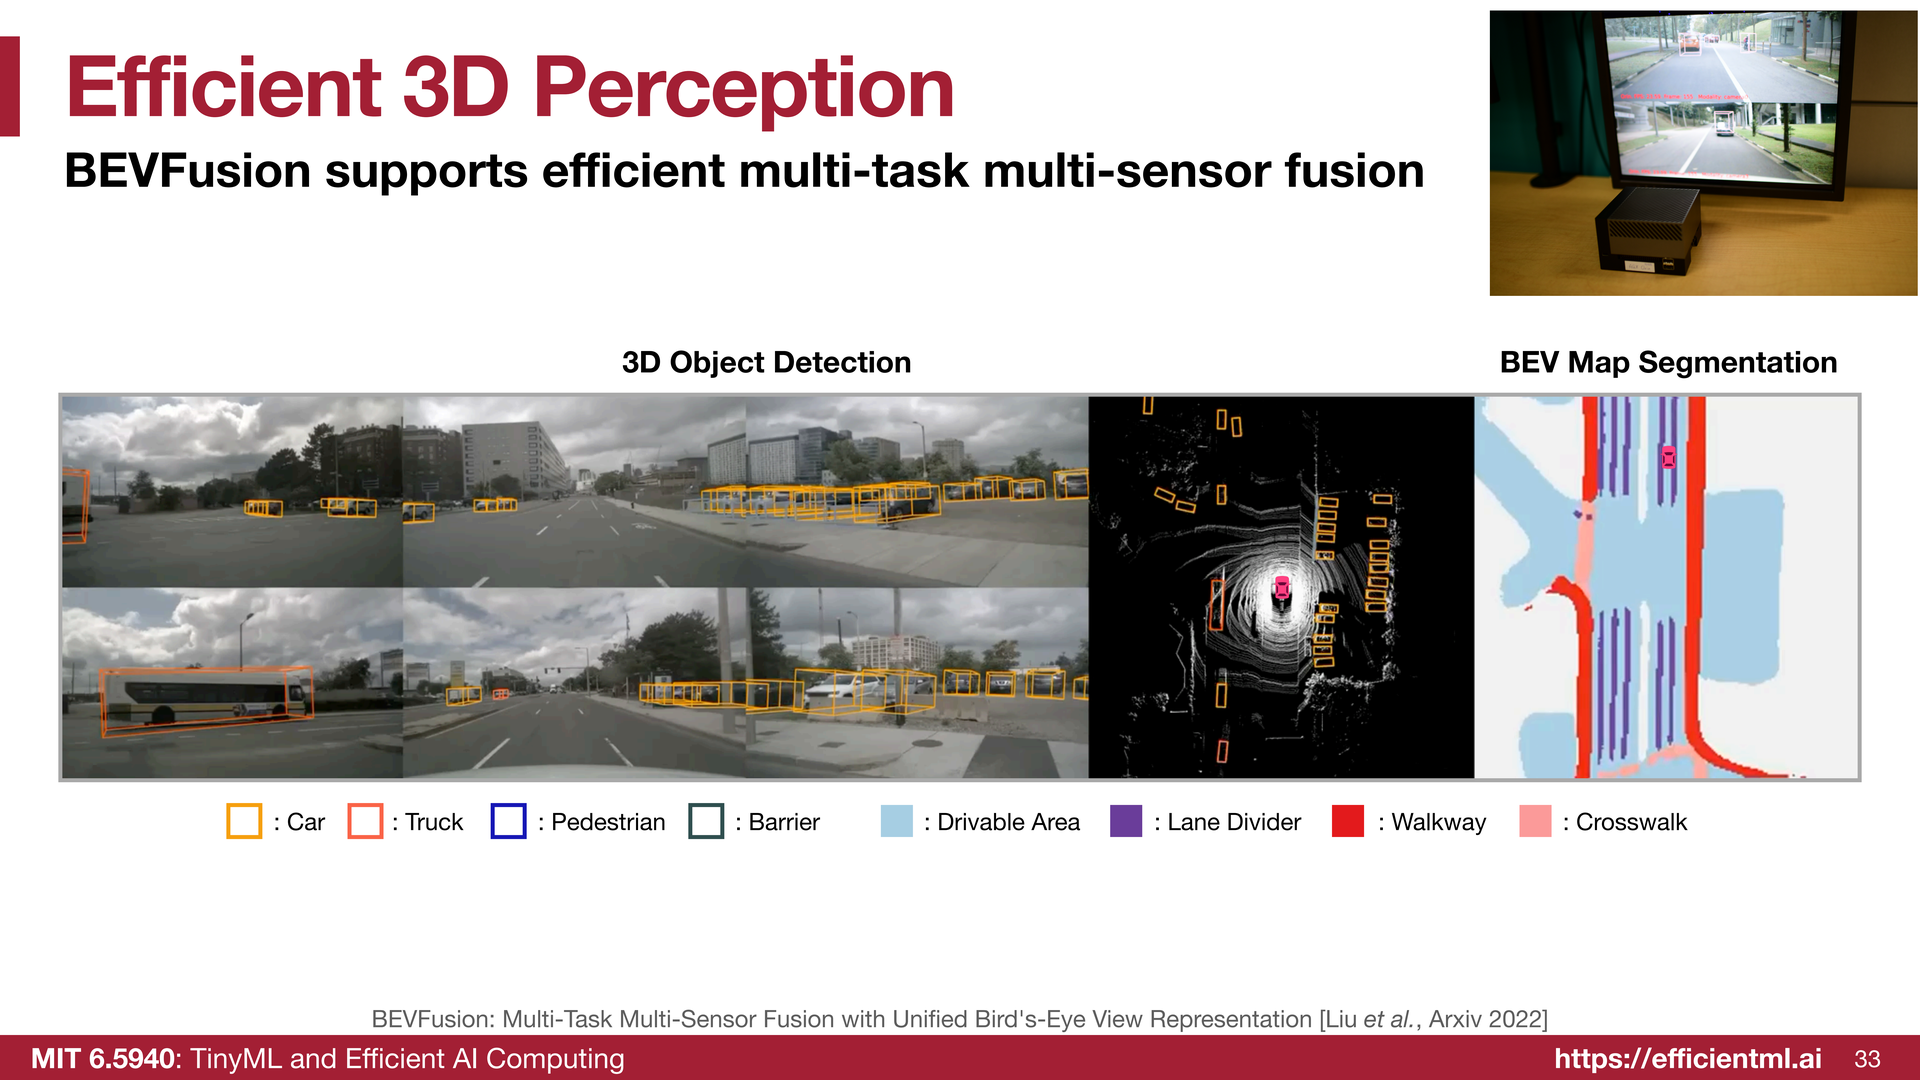
上面是我们组的另一项工作 BEVFusion ,做的是 3D 感知中的传感器融合。一辆车通常有多个传感器---前、左、右、后,这里正好是六个摄像头加一个激光雷达。这是激光雷达传感器生成的点云,右边提供的是鸟瞰图地图分割:红色是人行道、人行横道,蓝色是可行驶区域,紫色是车道线。
它做的事情就是把所有传感器融合在一起。摄像头是稠密的,激光雷达是稀疏的,朝向也不一样,但两者可以融合,给出鸟瞰图,并对每一辆车做检测。这计算量很大,但我们还是 把它塞进了一块移动端 GPU(见右上角),这样你就不需要一整个后备箱的电脑了。
5. Efficient AI for Language Models
5.1 LLM Capabilities and Their Cost
现在让我们换个话题,从视觉转到语言模型。
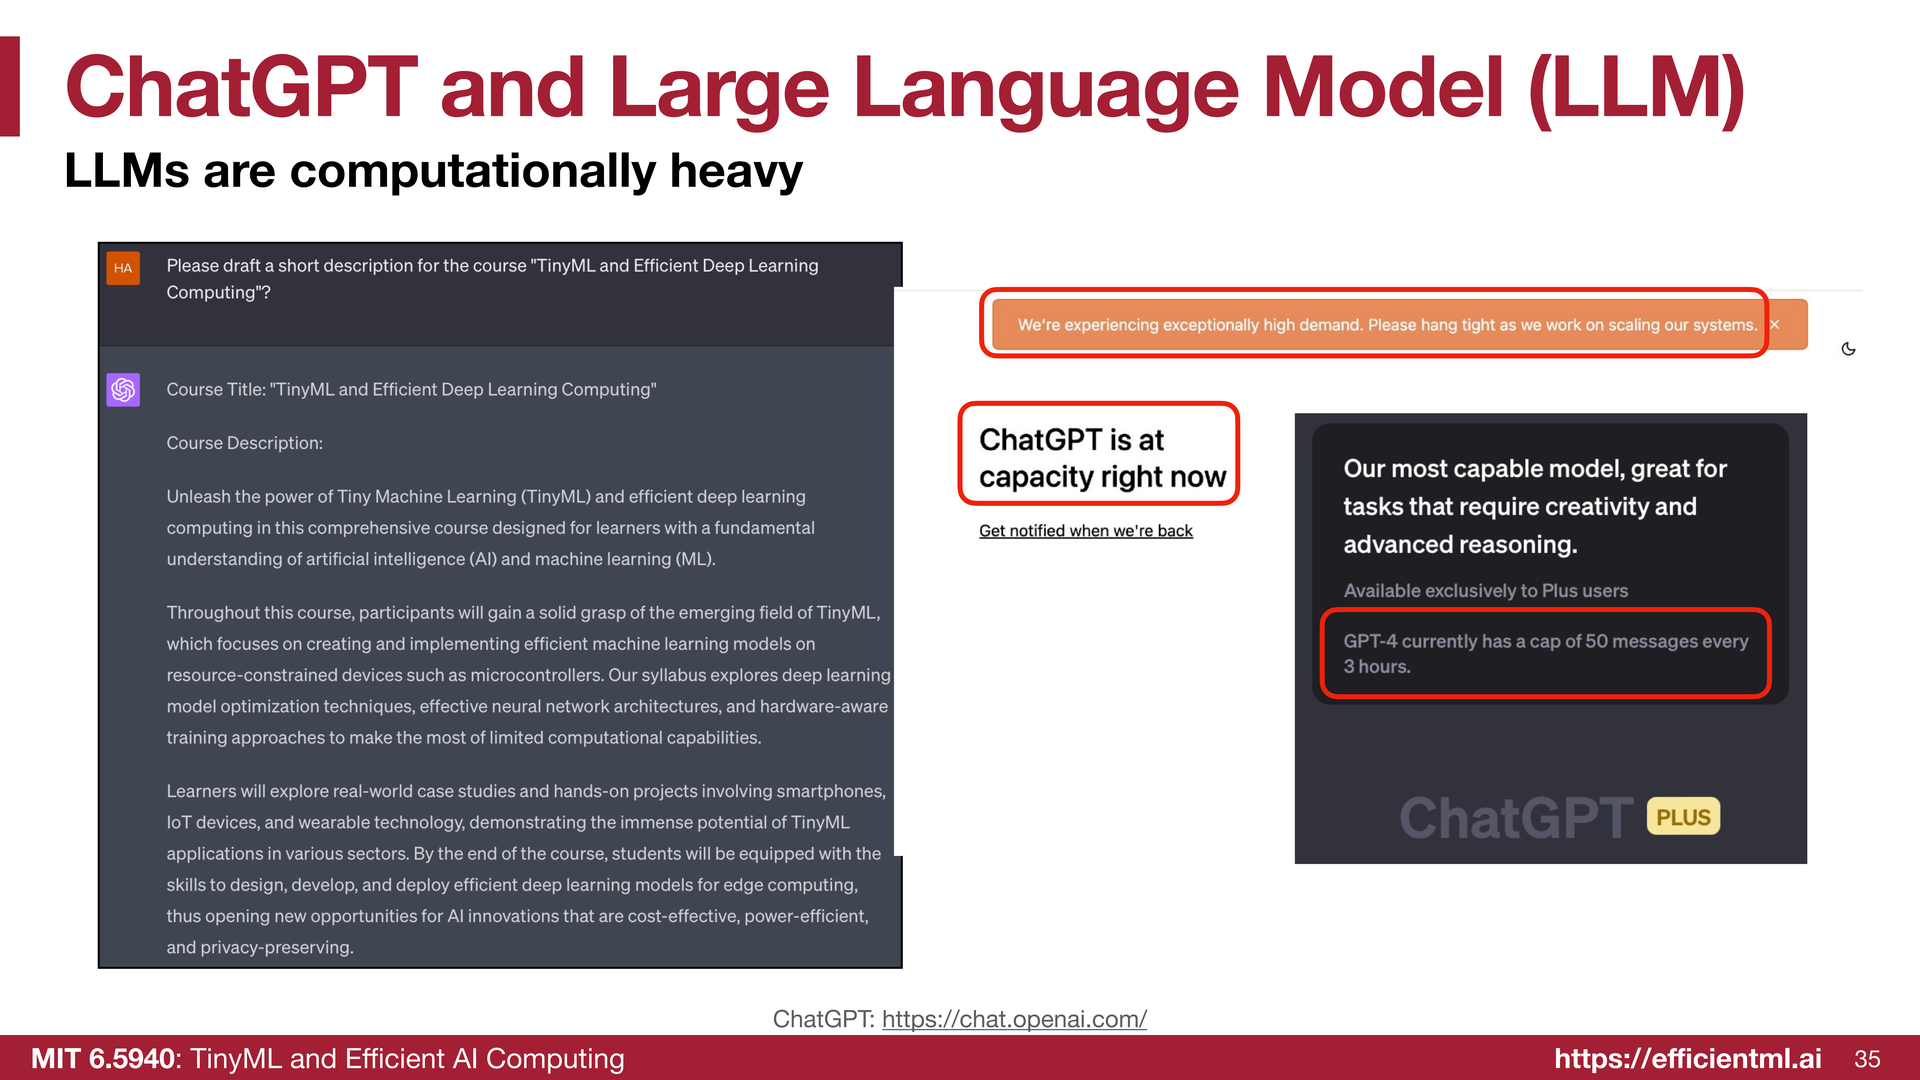
ChatGPT 在 2022 年出现。这些年它有了巨大的进步,但 计算量也非常大 。如今最让人头疼的事大概就是订阅里的 token 用完了---毕竟 token 很贵;最开心的时刻,则是 token 重置的时候。那我们怎么才能 让它更便宜,让大家都能用上更多 token、提高生产力 呢?
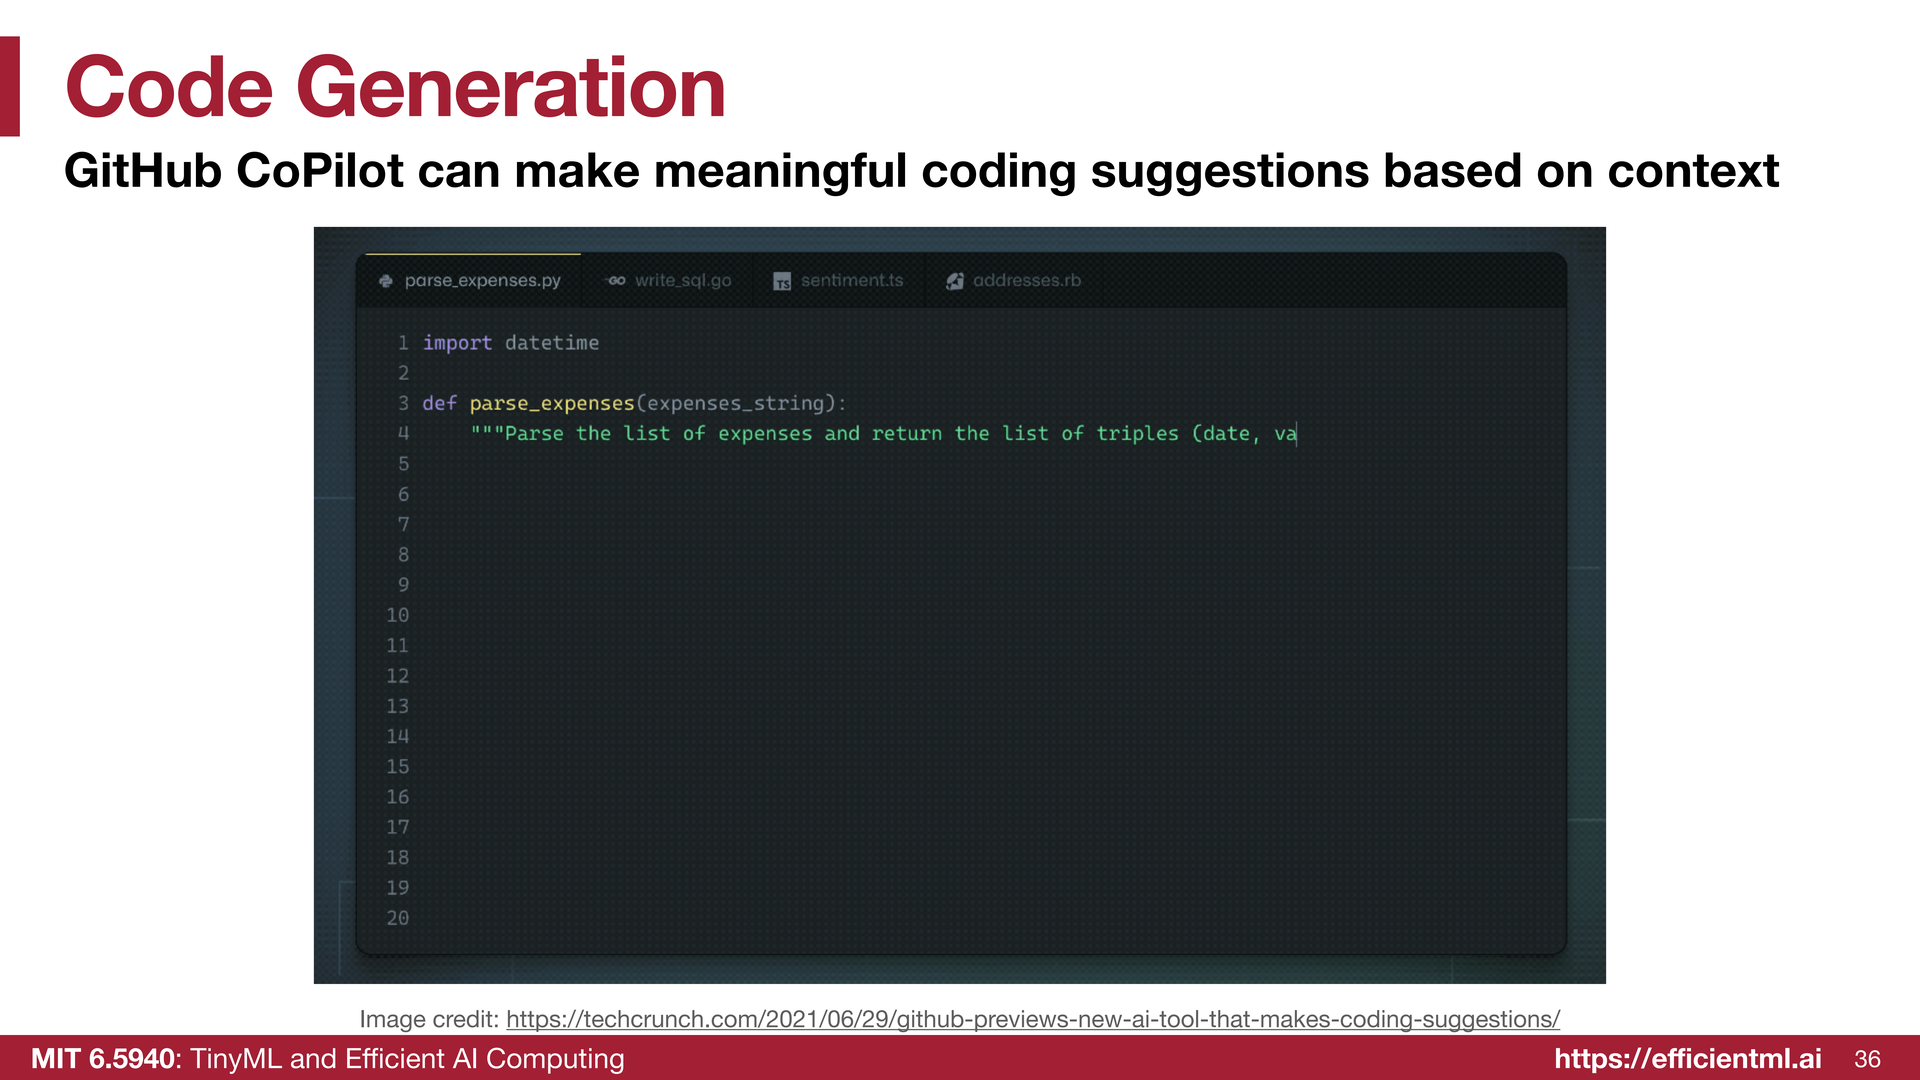
比如代码生成方面的 Copilot,最近几年有大量惊人的进展;
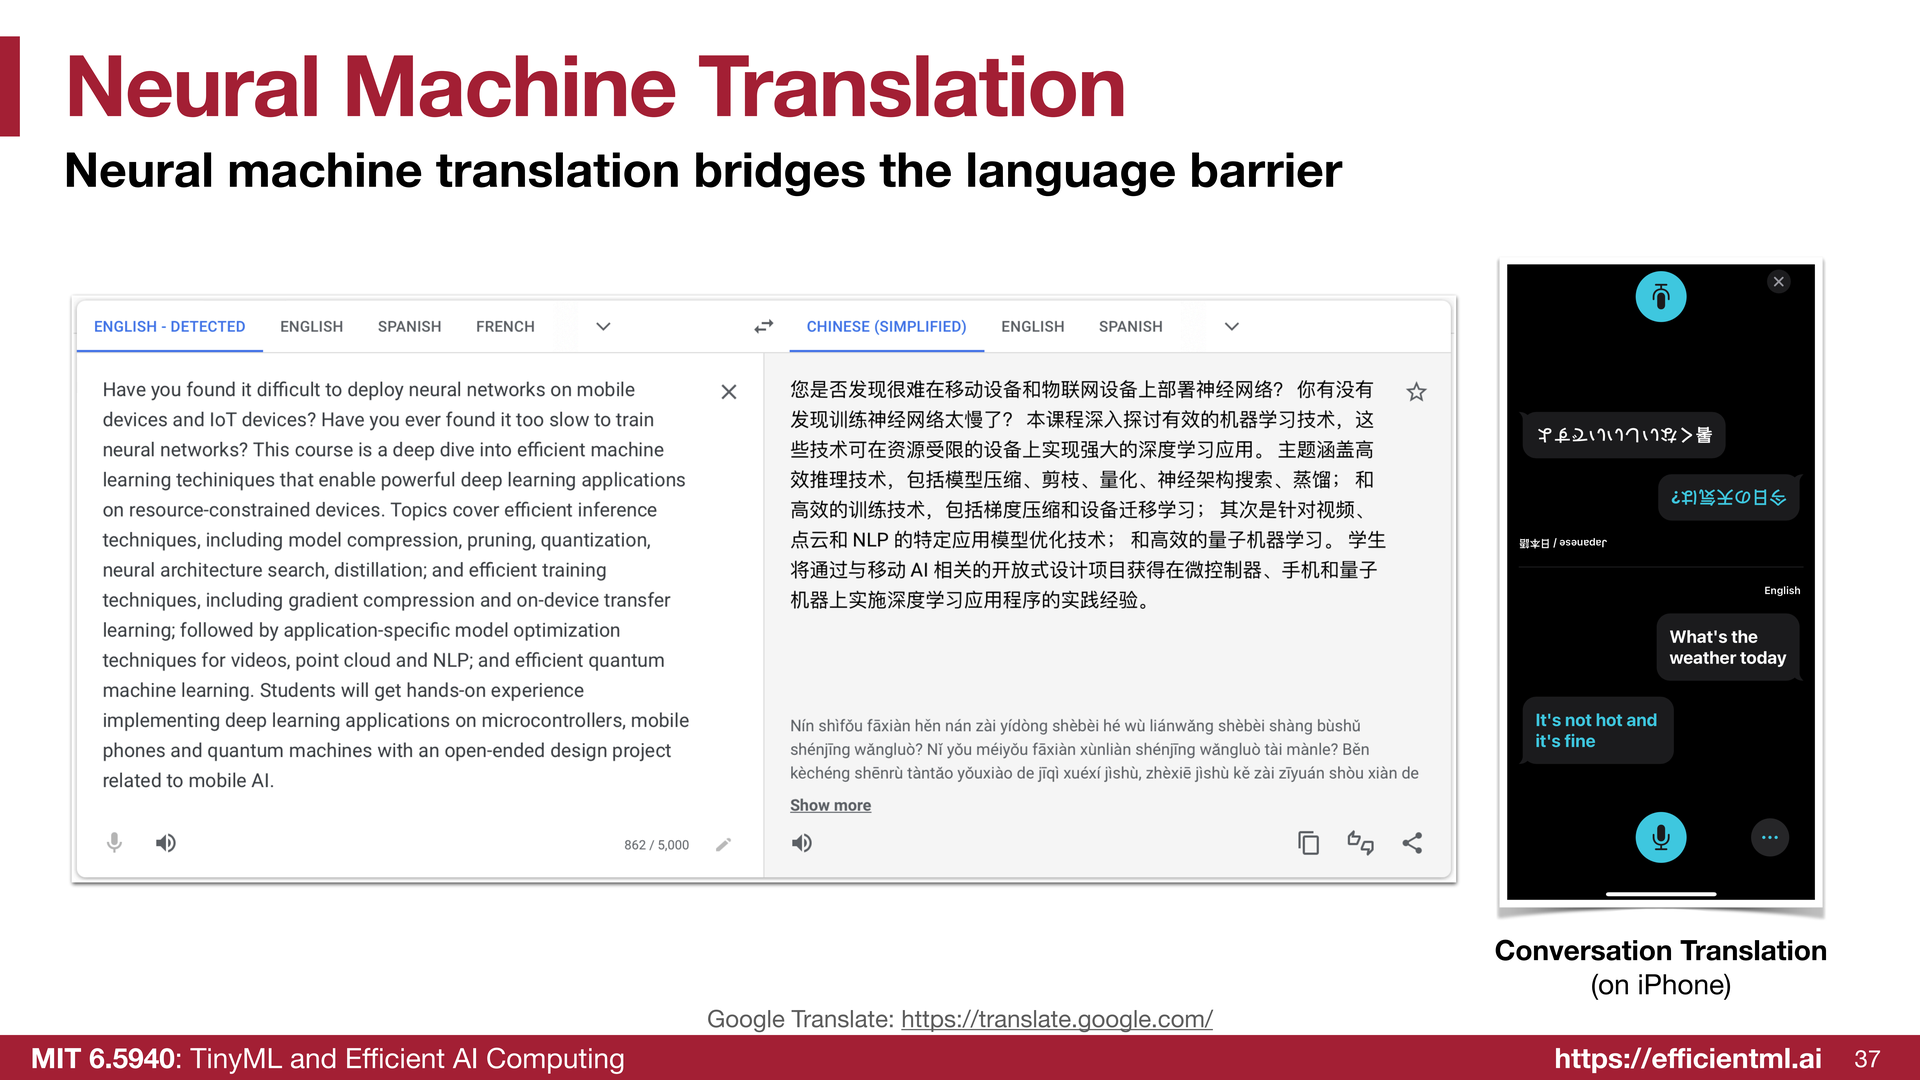
神经机器翻译可以把不同语言翻译得很好,甚至可以在你的手机上本地完成。
在这个方向上,我们做了一个高效的神经机器翻译工作,叫 Lite Transformer,通过剪枝和量化来减小模型大小。
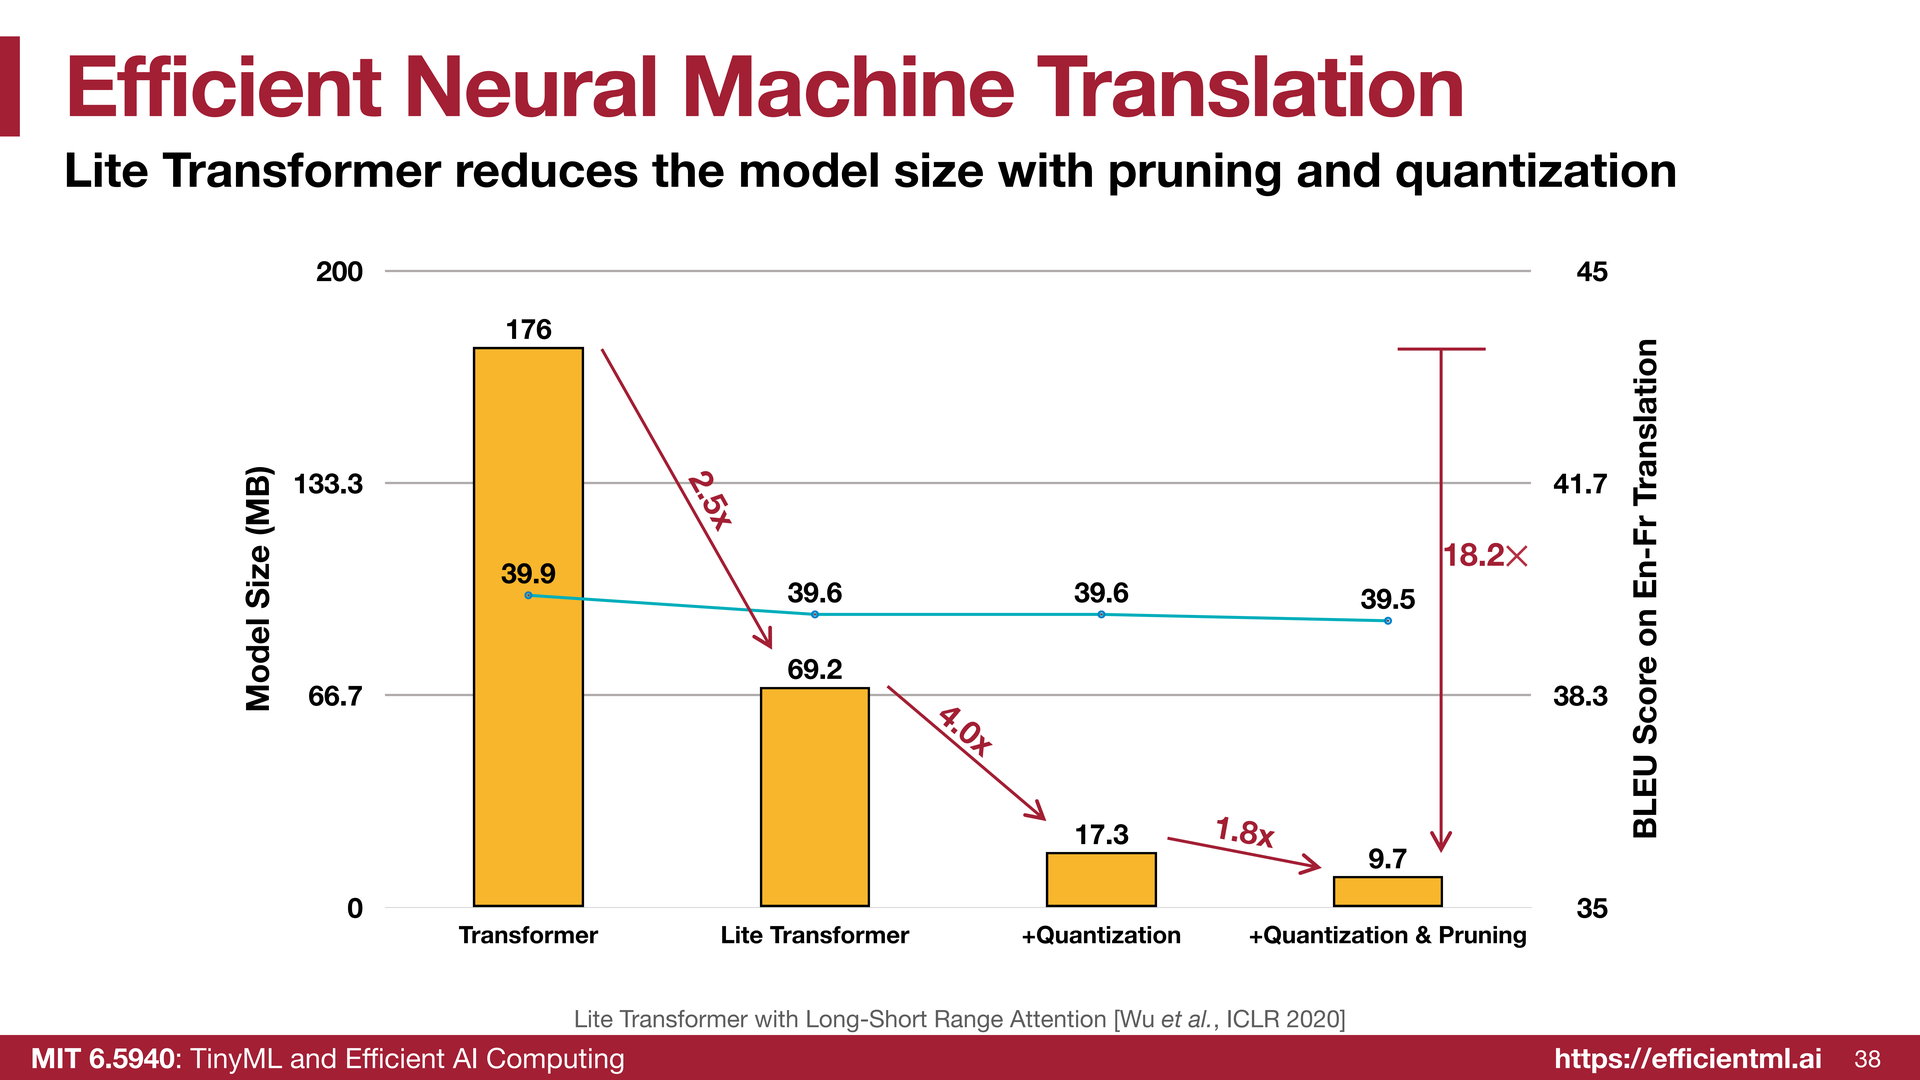
通过新架构加上量化、剪枝,它实现了 18 倍加速,同时保持精度。
另外大语言模型展现出非常有趣的现象,比如 零样本学习和少样本学习。
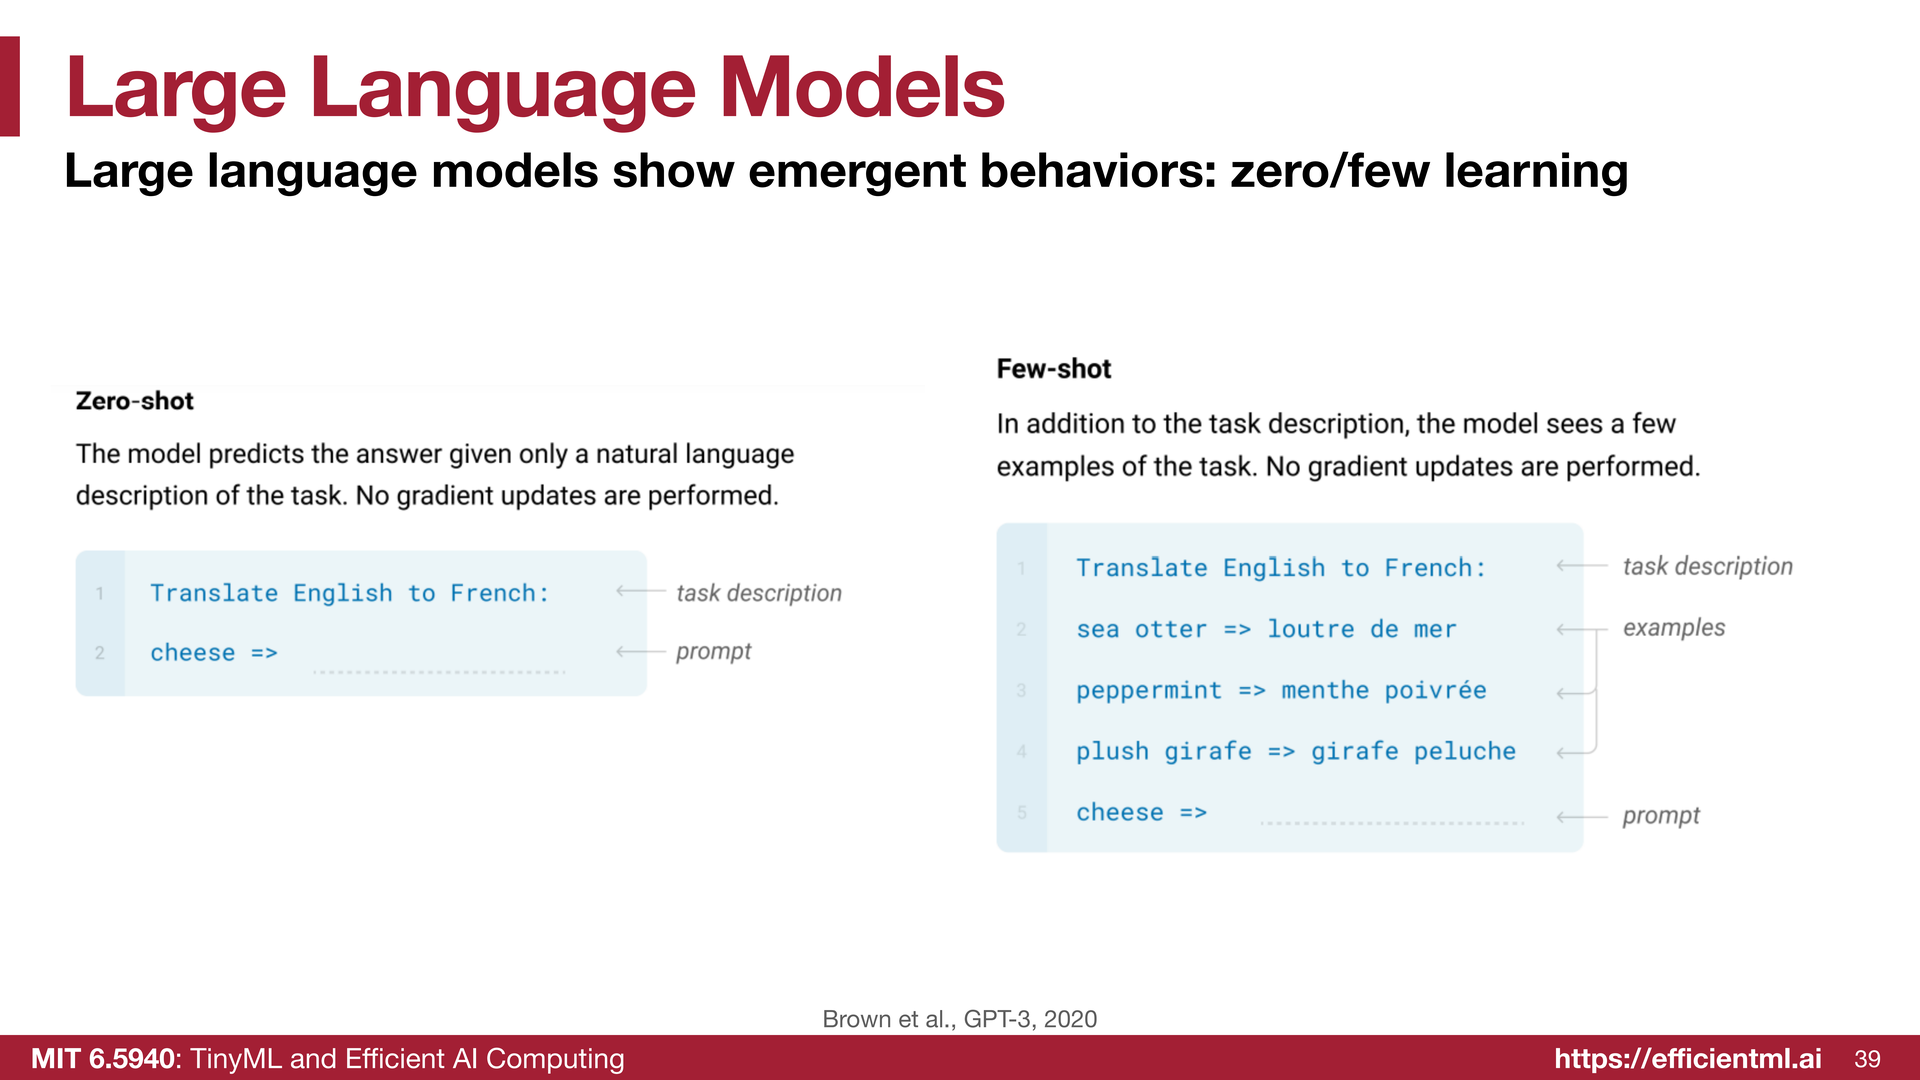
你可以描述任务,比如从英语翻译成法语---你从来不需要专门为机器翻译任务训练一个模型,它就能帮你翻译。你也可以做少样本学习:给它几个例子---这是英语,这是法语,英语、法语、英语、法语---然后再给一个英语单词,它就能理解任务是什么。
但这种现象 是以大模型规模为代价的。
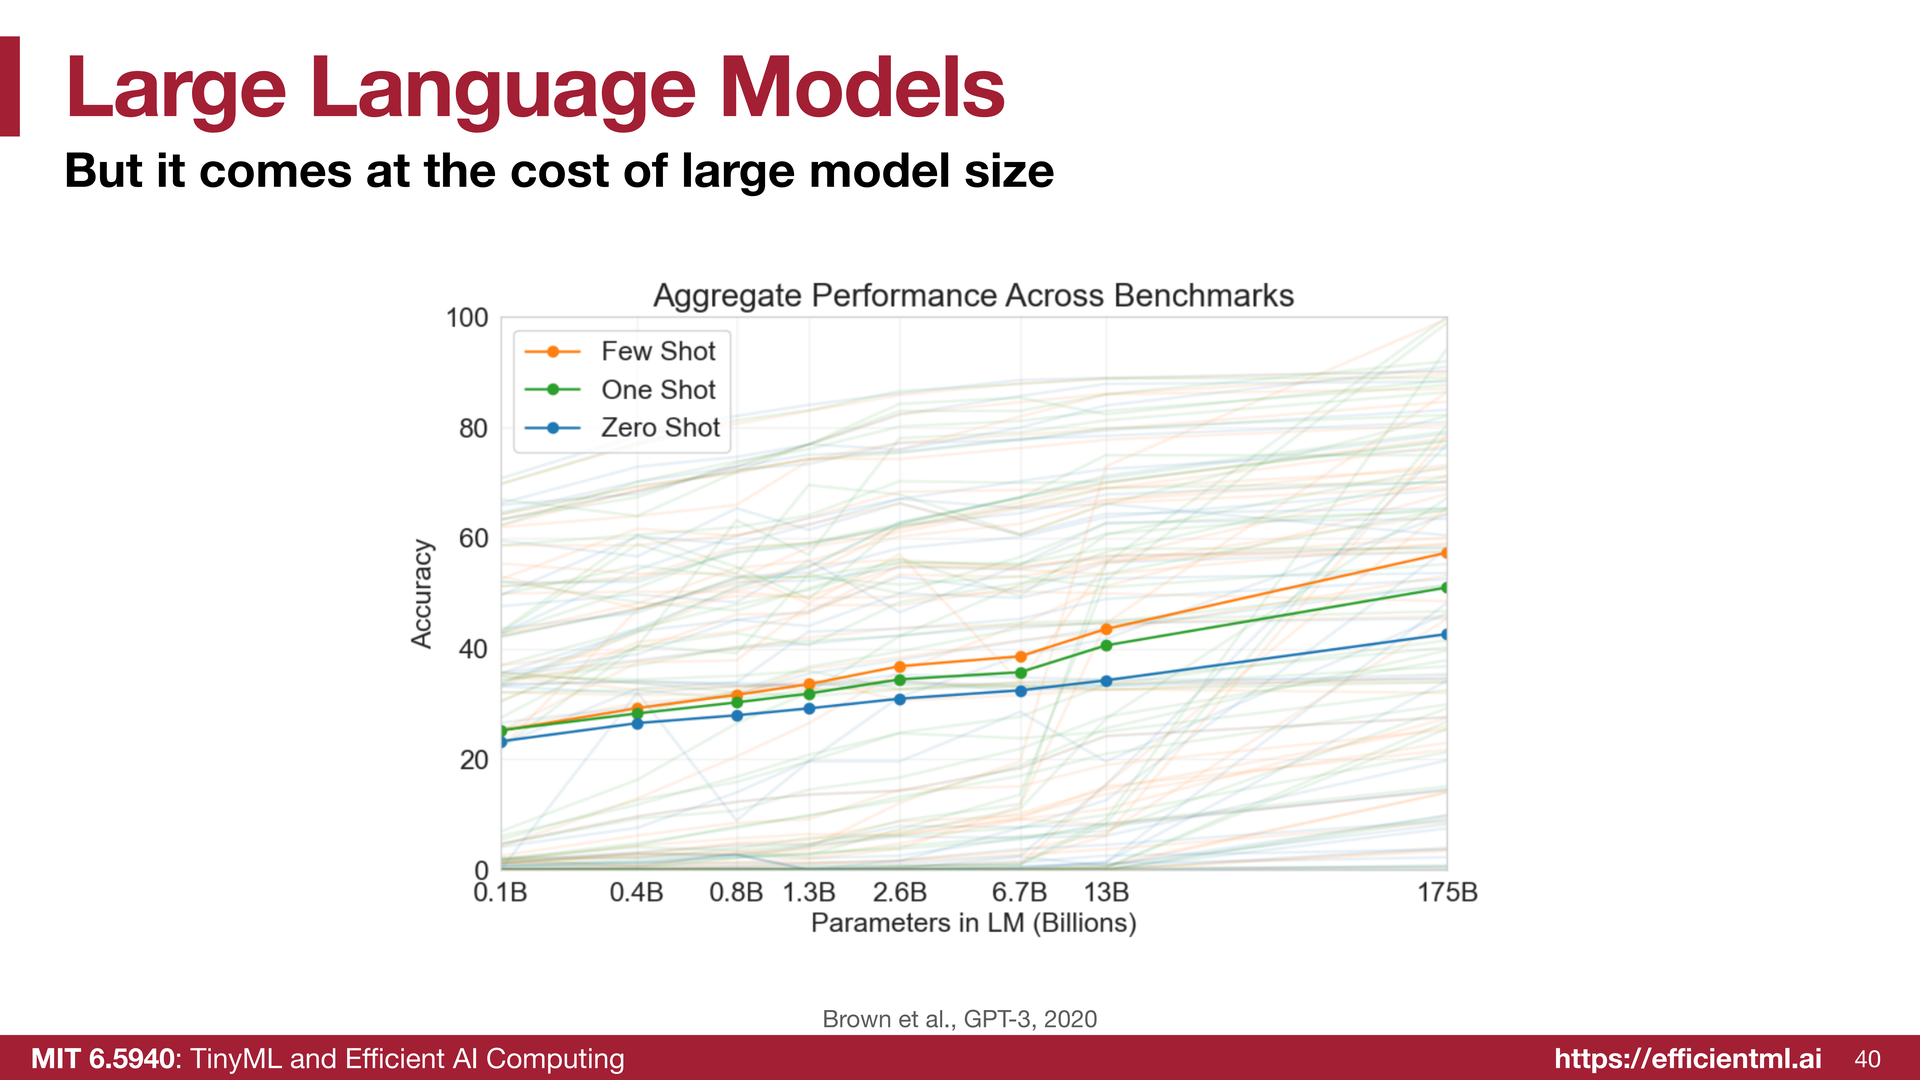
比如零样本能力、单样本能力、少样本能力,它们随参数数量增长。参数越多精度越高,但这条曲线存在 明显的递减回报 :哪怕只想提升一点点精度,也要付出大幅增加参数量的代价。这就是我们需要解决的问题。
另外大语言模型有一个很棒的时刻,叫做 思维链(chain of thought) ,大概是在 GPT-3 之后出现的。我觉得这是 过去几年最了不起的发明之一。
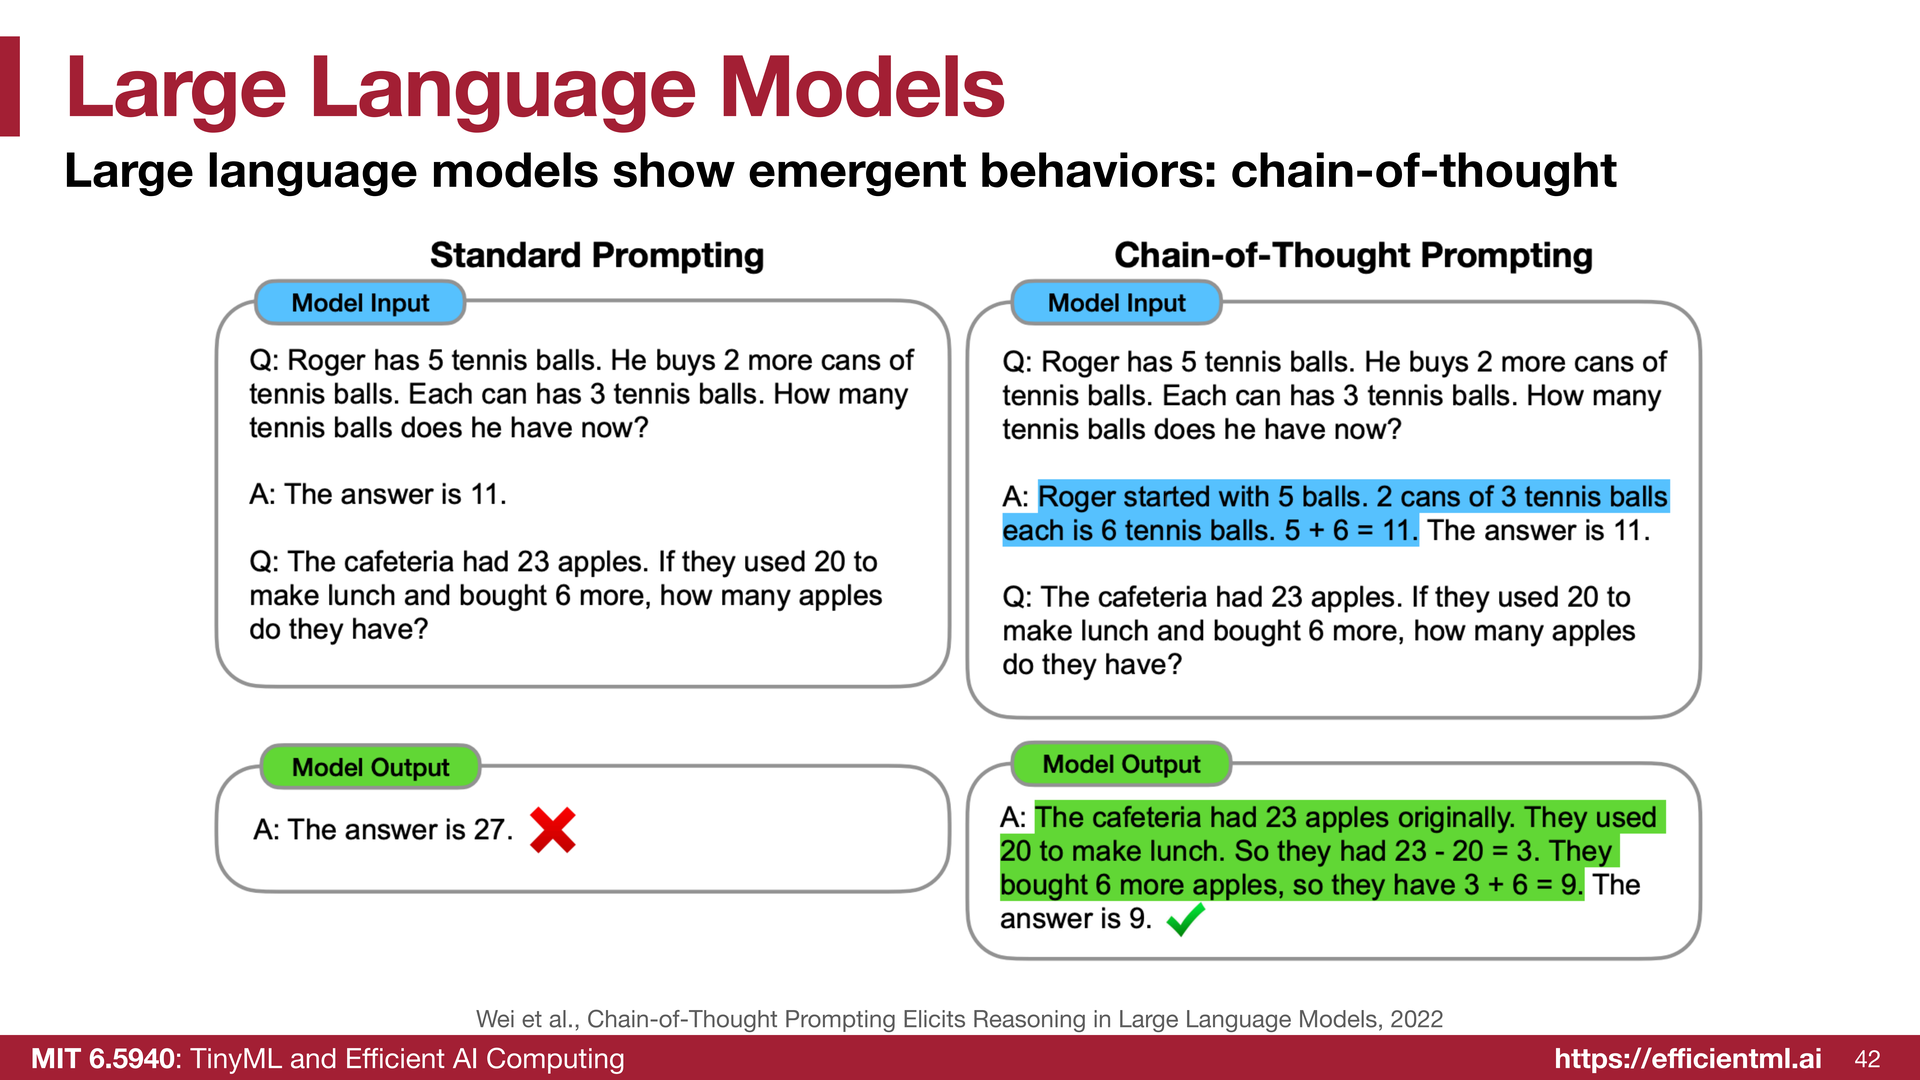
比如这个例子:Roger 有五个网球,他又买了两罐网球,每罐有三个网球,他现在有多少个网球?答案是 11---但 示例里并没有给出这个数字是怎么算出来的,只是直接给了答案 。然后:食堂有 23 个苹果。如果他们用 20 个做午餐,又买了六个,他们还有多少苹果?示例里同样只给答案,模型自然会答错。
那怎么让它答对呢?这就是 思维链提示 :不再只给出答案 11,而是像最简单的这个例子一样,把过程写出来:Roger 一开始有五个球,两罐、每罐三个网球,就是六个,五加六等于 11,所以答案是 11。那么对于食堂这个新例子---食堂有 23 个苹果---它就能用类似的方式做思维链:食堂原本有 23 个苹果,他们用了 20 个,好,那就是 23 减 20 等于 3;他们又买了 6 个,所以有 3 加 6 等于 9。答案是 9。
只要在提示里让模型看到你是怎么解题的,它就能答对,并自然地迁移到新的问题上 ,这就是思维链。那它不好的地方在哪呢?以前你只需要生成几个 token,比如 "答案是 11";现在需要生成一串 token,比之前多得多。所以 它变得更贵了,这又进一步凸显了高效 AI 计算的价值。
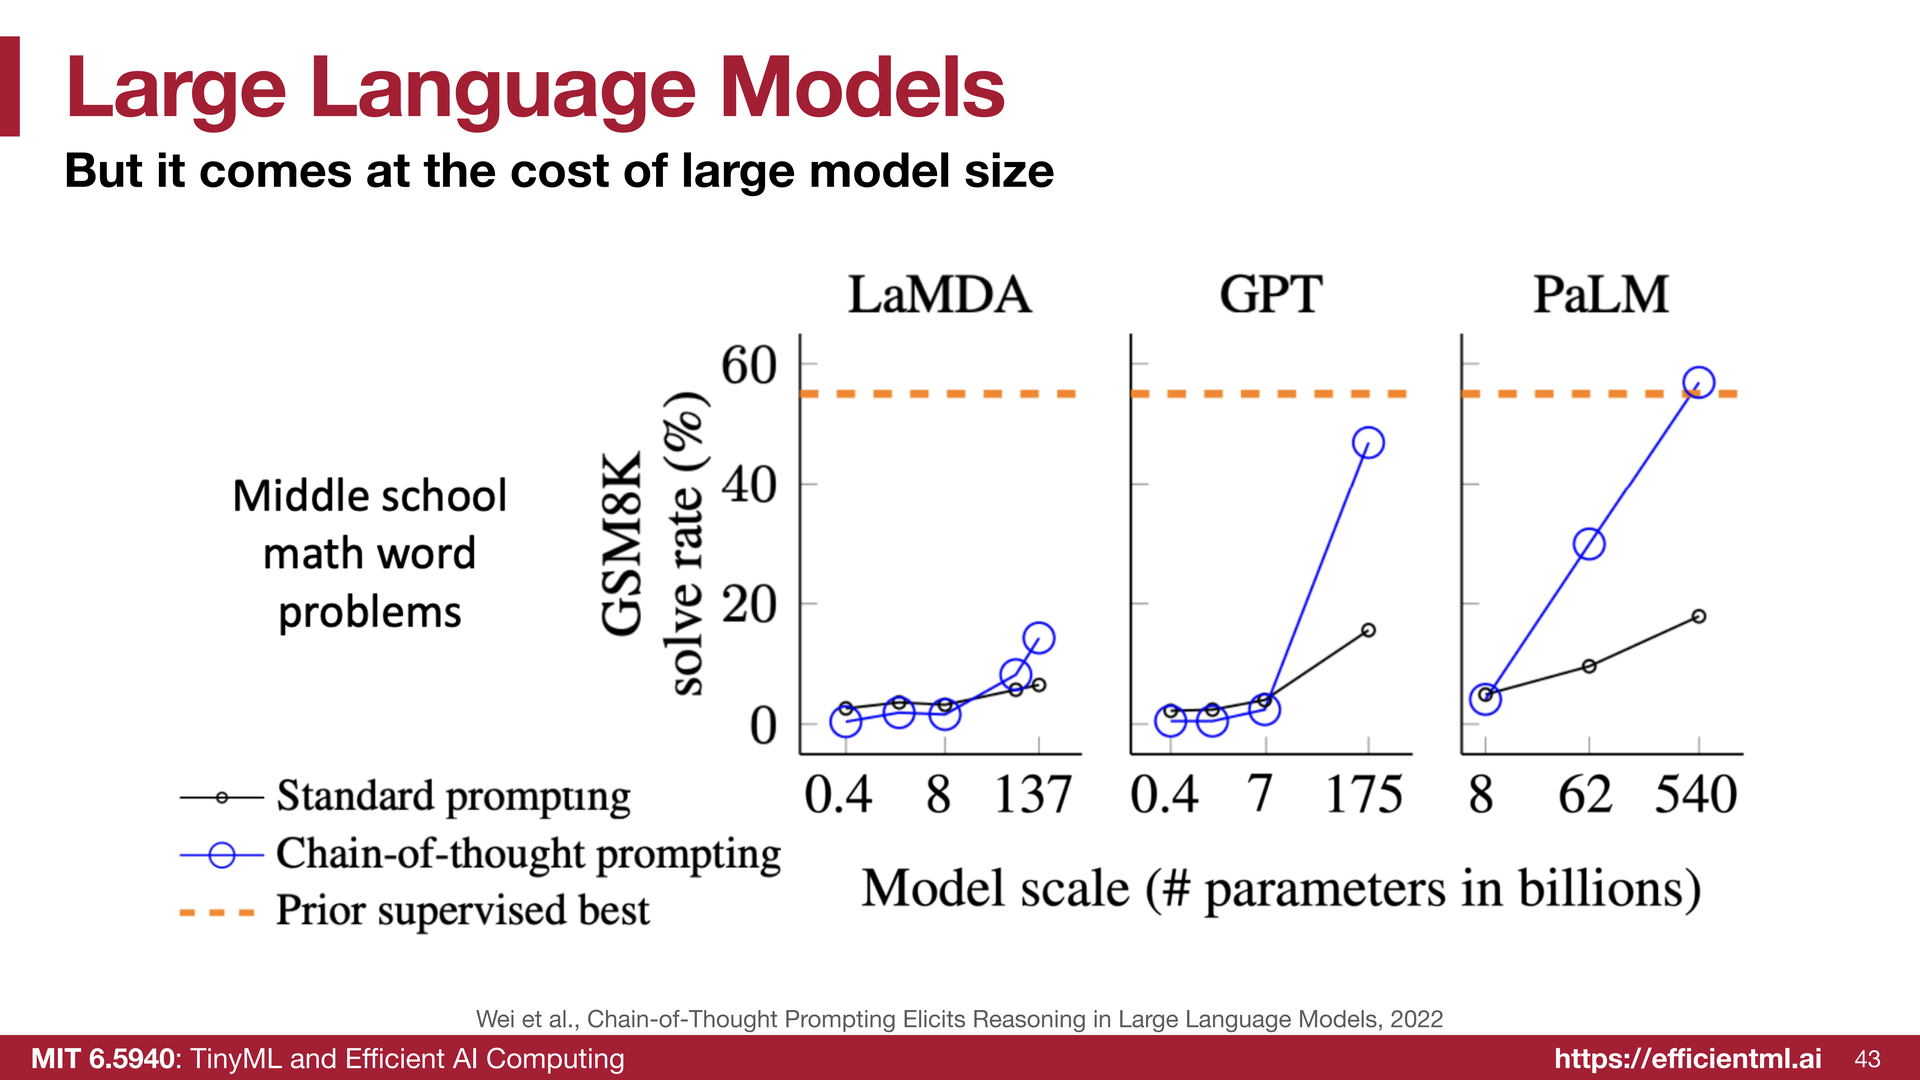
这里是模型规模与 GSM8K 解题正确率(百分比)的关系:思维链提示带来的精度提升,只有在模型规模超过某个阈值之后才会出现并急剧上升,而那个规模需要一整机架的 GPU 才撑得起。
这是在我们实验室 EE 大楼(36 号楼)的地下室。可以看到很多 GPU 节点互相连接,相当昂贵;而且如今散热也是一个大麻烦,需要水冷,空间不够、电也不够。所以 我们真的需要降低成本。
5.2 Efficient LLM Techniques
为了做到这一点,我们要学一些技术---先给大家概览一下,比如 稀疏注意力(sparse attention):
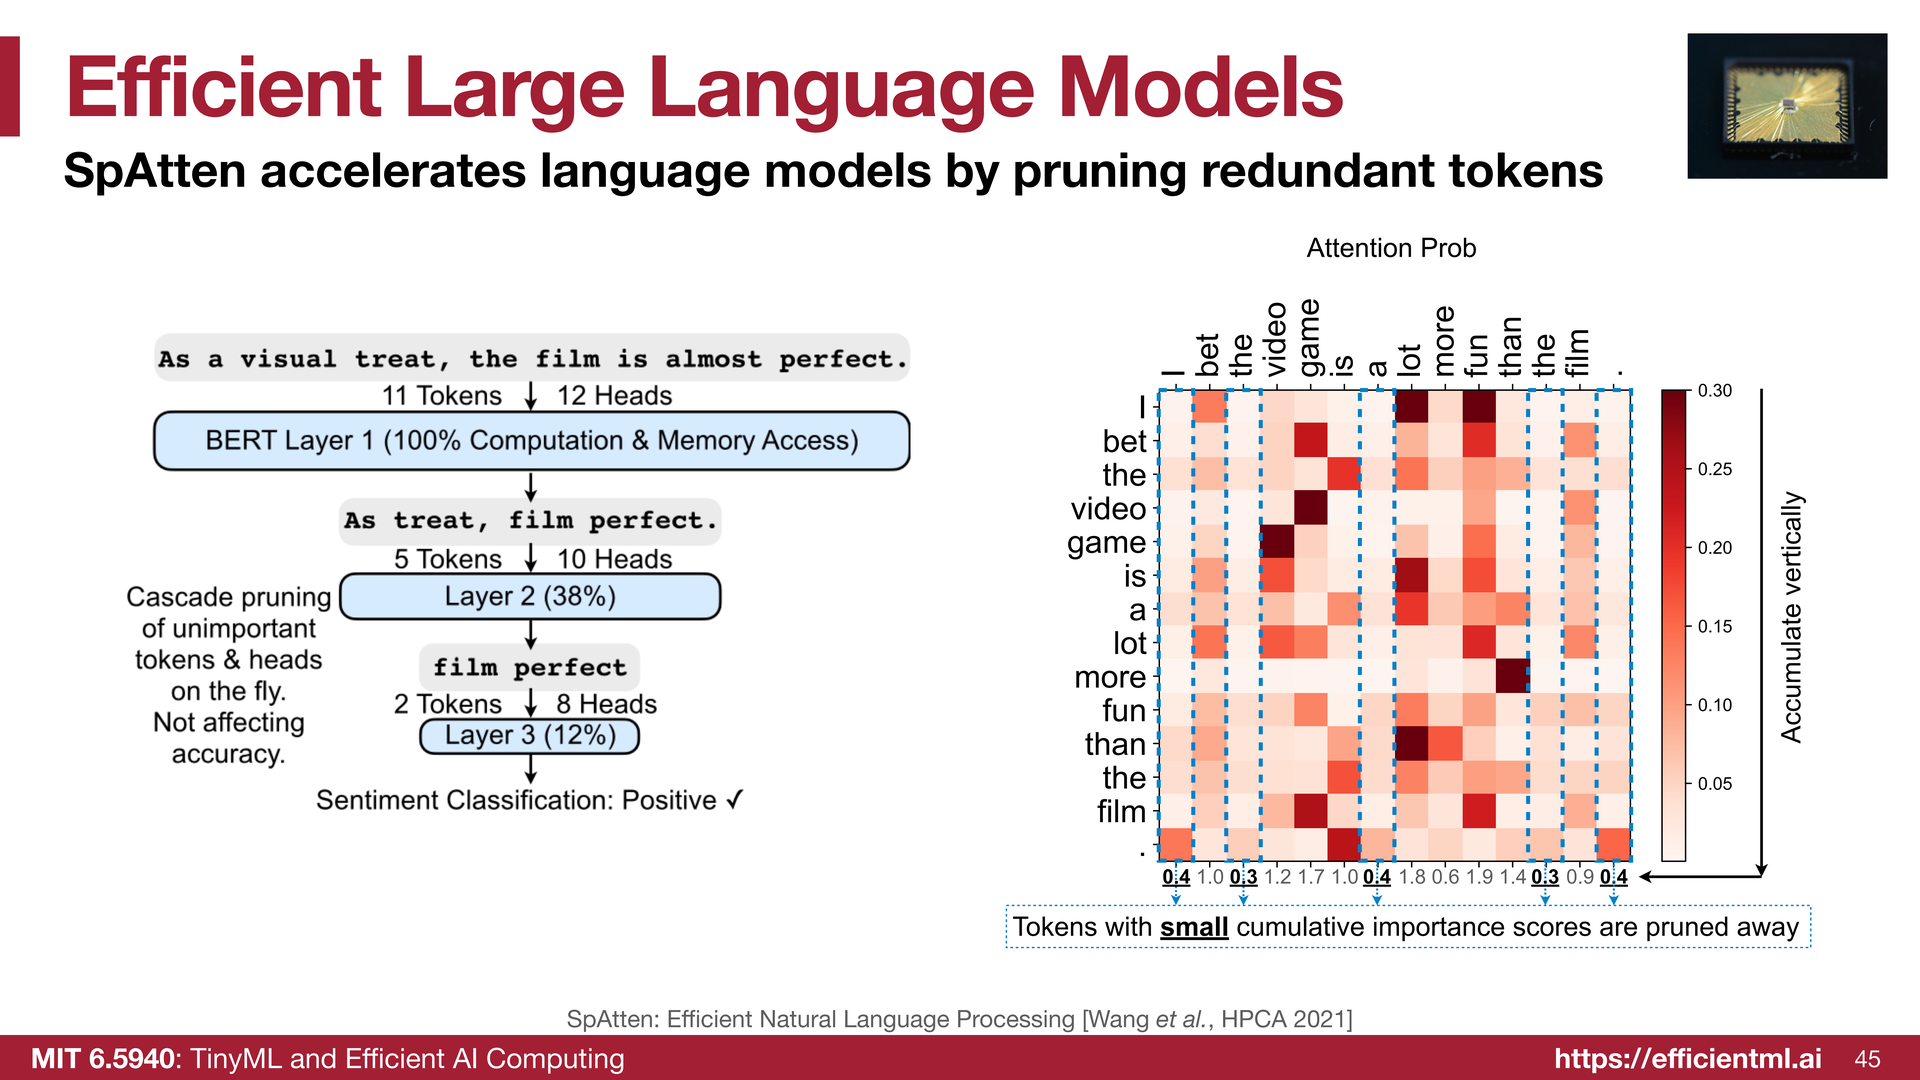
SpAtten 可以通过剪掉冗余 token 来加速语言模型 :在一个句子里,并不是每个词都重要。比如要对这句话做情感分类:"as a visual treat, the film is almost perfect",它有 11 个 token,我们可以把它剪到 5 个 token:"as treat, film perfect",再进一步剪到只剩两个 token:"film perfect"。我们仍然能把它分类为正面情感。所以 token 冗余是我们可以解决的问题。
我们可以观察注意力图:Attention is all you need,但 你并不需要把注意力平均分配给每个 token,只需要有选择地关注少数真正需要的 token。比如在这个例子里,"bat"、"a lot" 互相注意,"video" 和 "game" 互相注意。但不是所有 token 都这样---有些 token 几乎没有任何东西注意它们,那我们就可以把它们完全去掉。
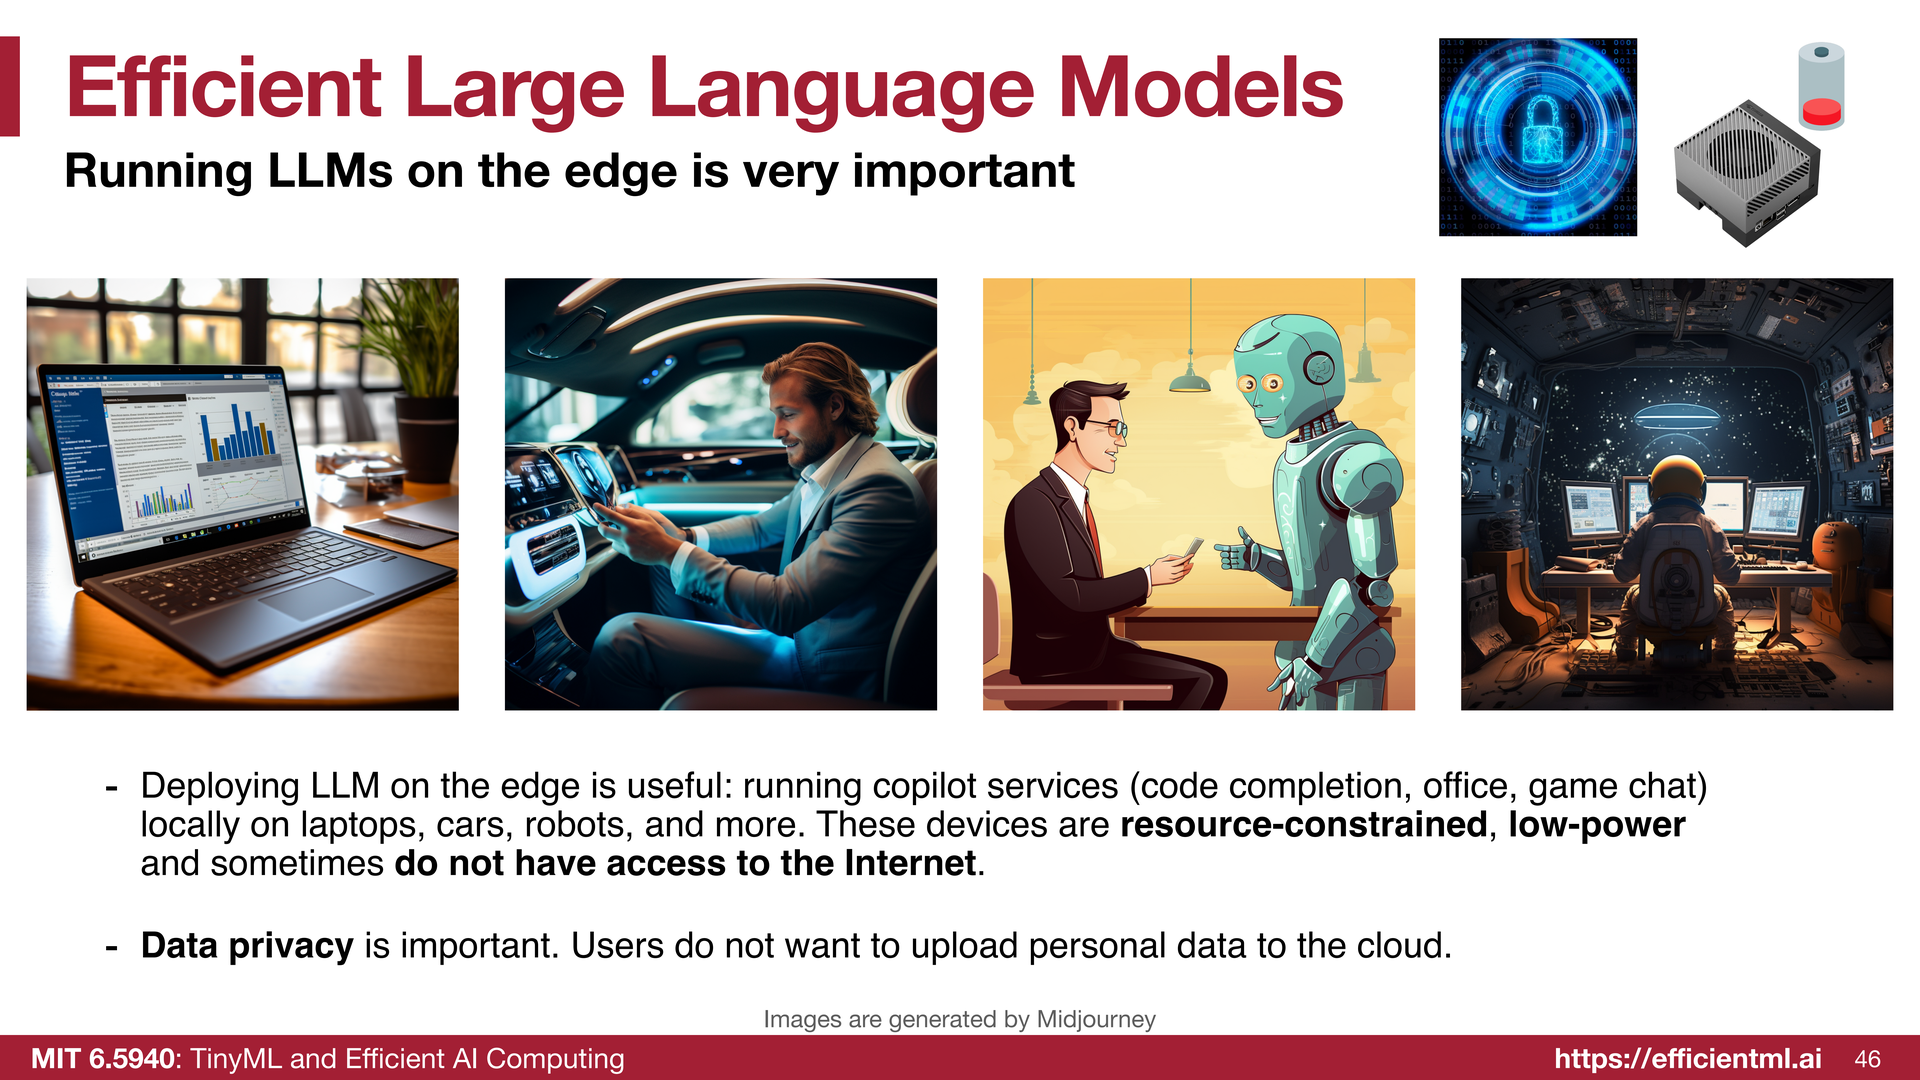
这些模型相当大,目前大多跑在云端,但如果能把它们跑在边缘设备上,那就非常有用了---你可以在笔记本里、车里本地跑代码补全,用于办公、游戏和聊天。这样既能保护隐私,也能在没有网络的时候使用。但 在边缘部署大语言模型相当有挑战性。
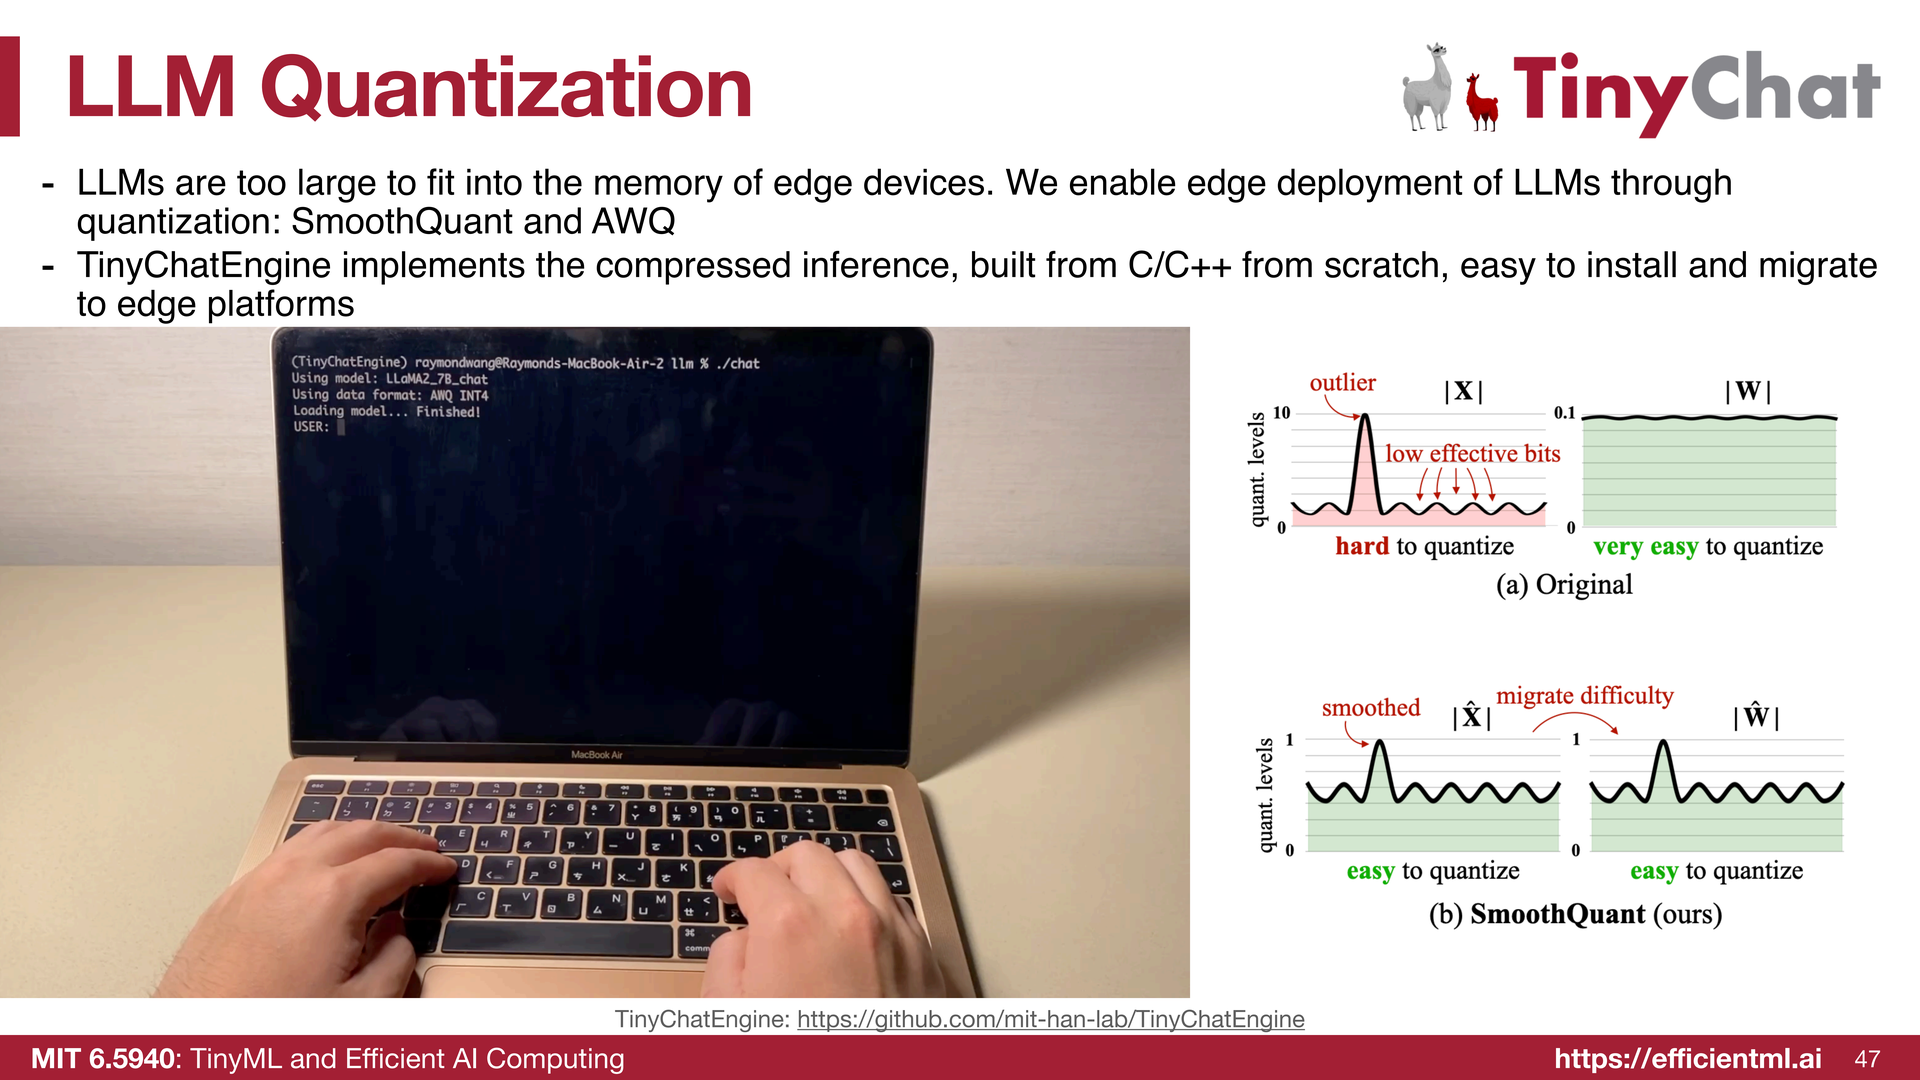
我们通过量化解决了这个问题:用更少的比特表示权重和激活,只用 4 位 。我们要学的技术之一是 SmoothQuant ,它把离群值平滑掉,这样就能把大语言模型部署到本地---手机上、笔记本上。这是一台三年多以前的笔记本了,如今还会更快。在这项技术之前,激活里有很多离群值,非常难量化:这就像用同一把尺子去量长颈鹿,再量蚂蚁 。而用 SmoothQuant,你可以让长颈鹿变矮、让蚂蚁变高,整体更平滑,也就更容易量化了。这也是我们的实验之一:你将亲手实现这样的量化技术。
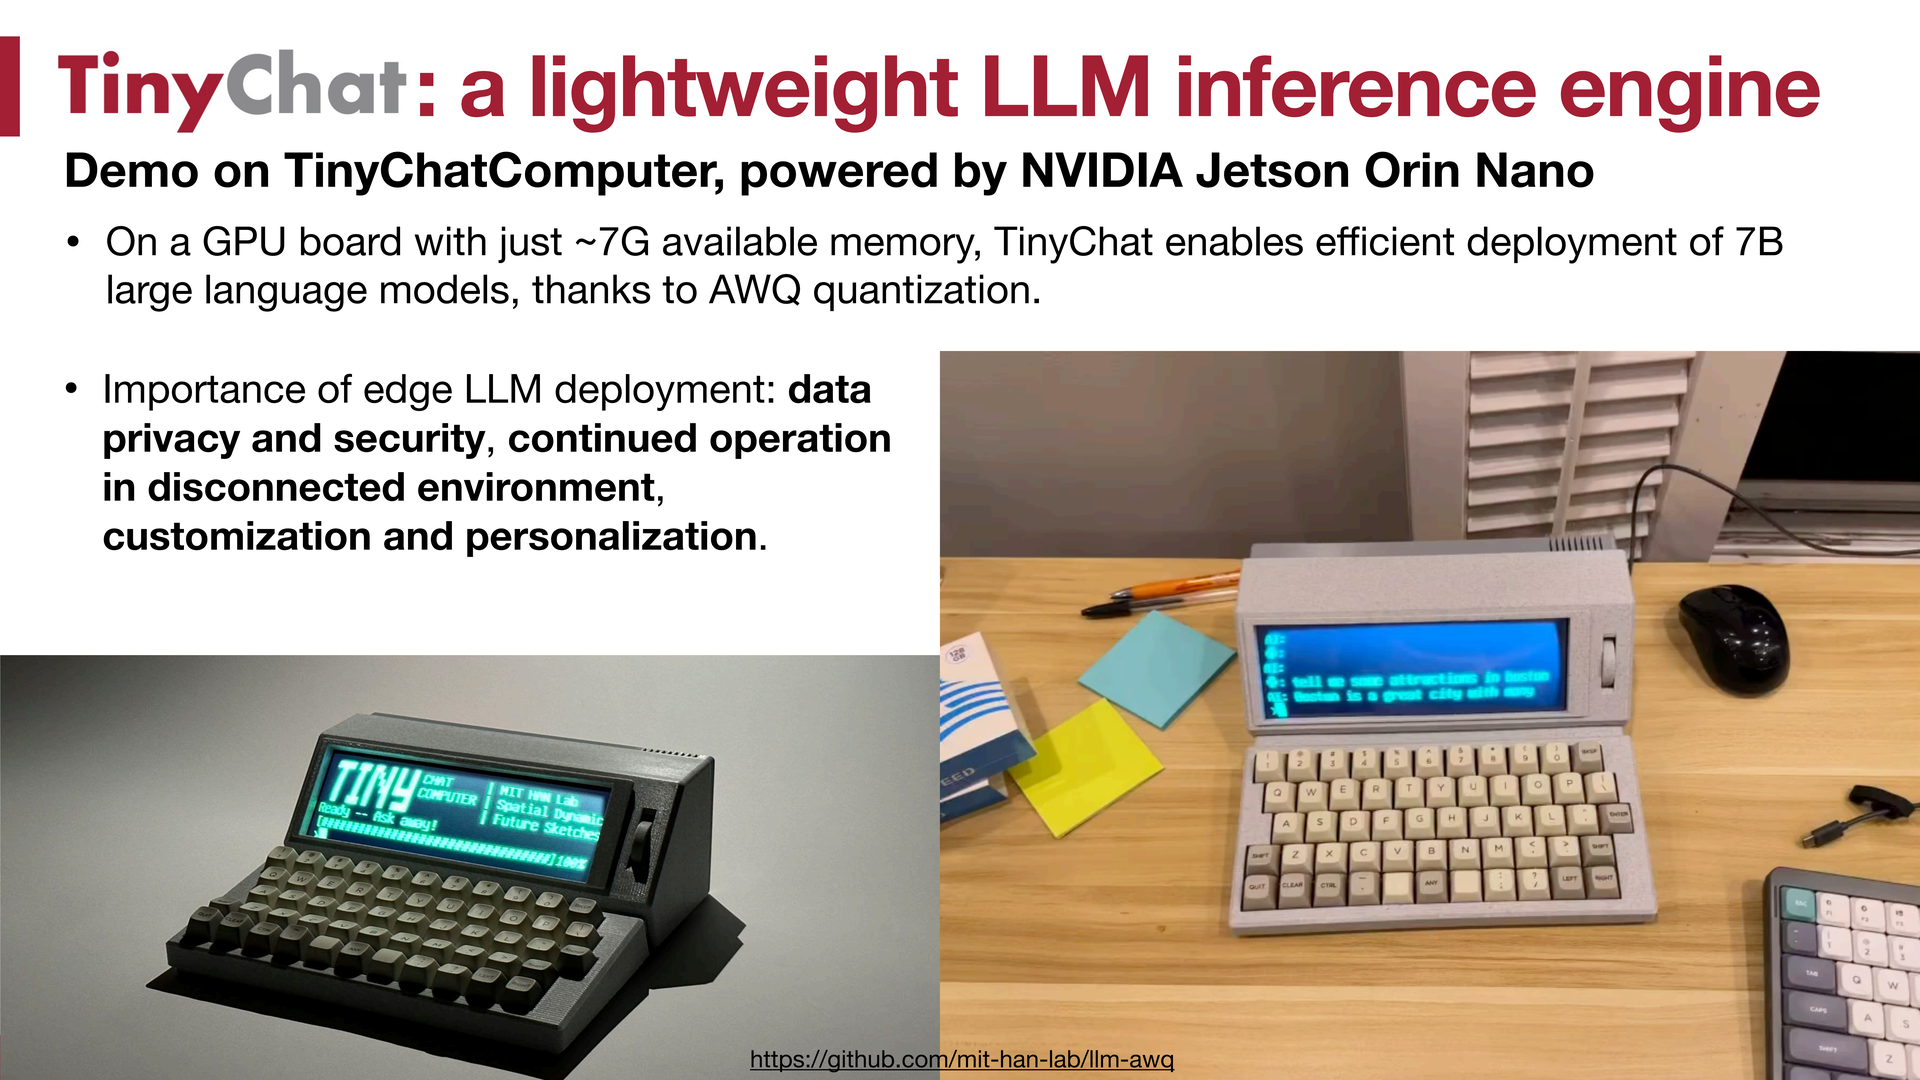
我还设计了推理引擎。计算机是按字节对齐的 :如果你上过计算机体系结构课,就知道最小的处理单位是 8 位,也就是一个字节。但我们把所有东西量化到 4 位,那是半个字节---怎么在这种 4 位权重上跑推理呢?所以我们会实现 TinyChat Engine(微型聊天引擎) ,它能在设备本地跑 40 亿参数的模型。完成全部五个实验之后,你会带回家一个类似这样的微型聊天引擎,可以在笔记本上本地运行。
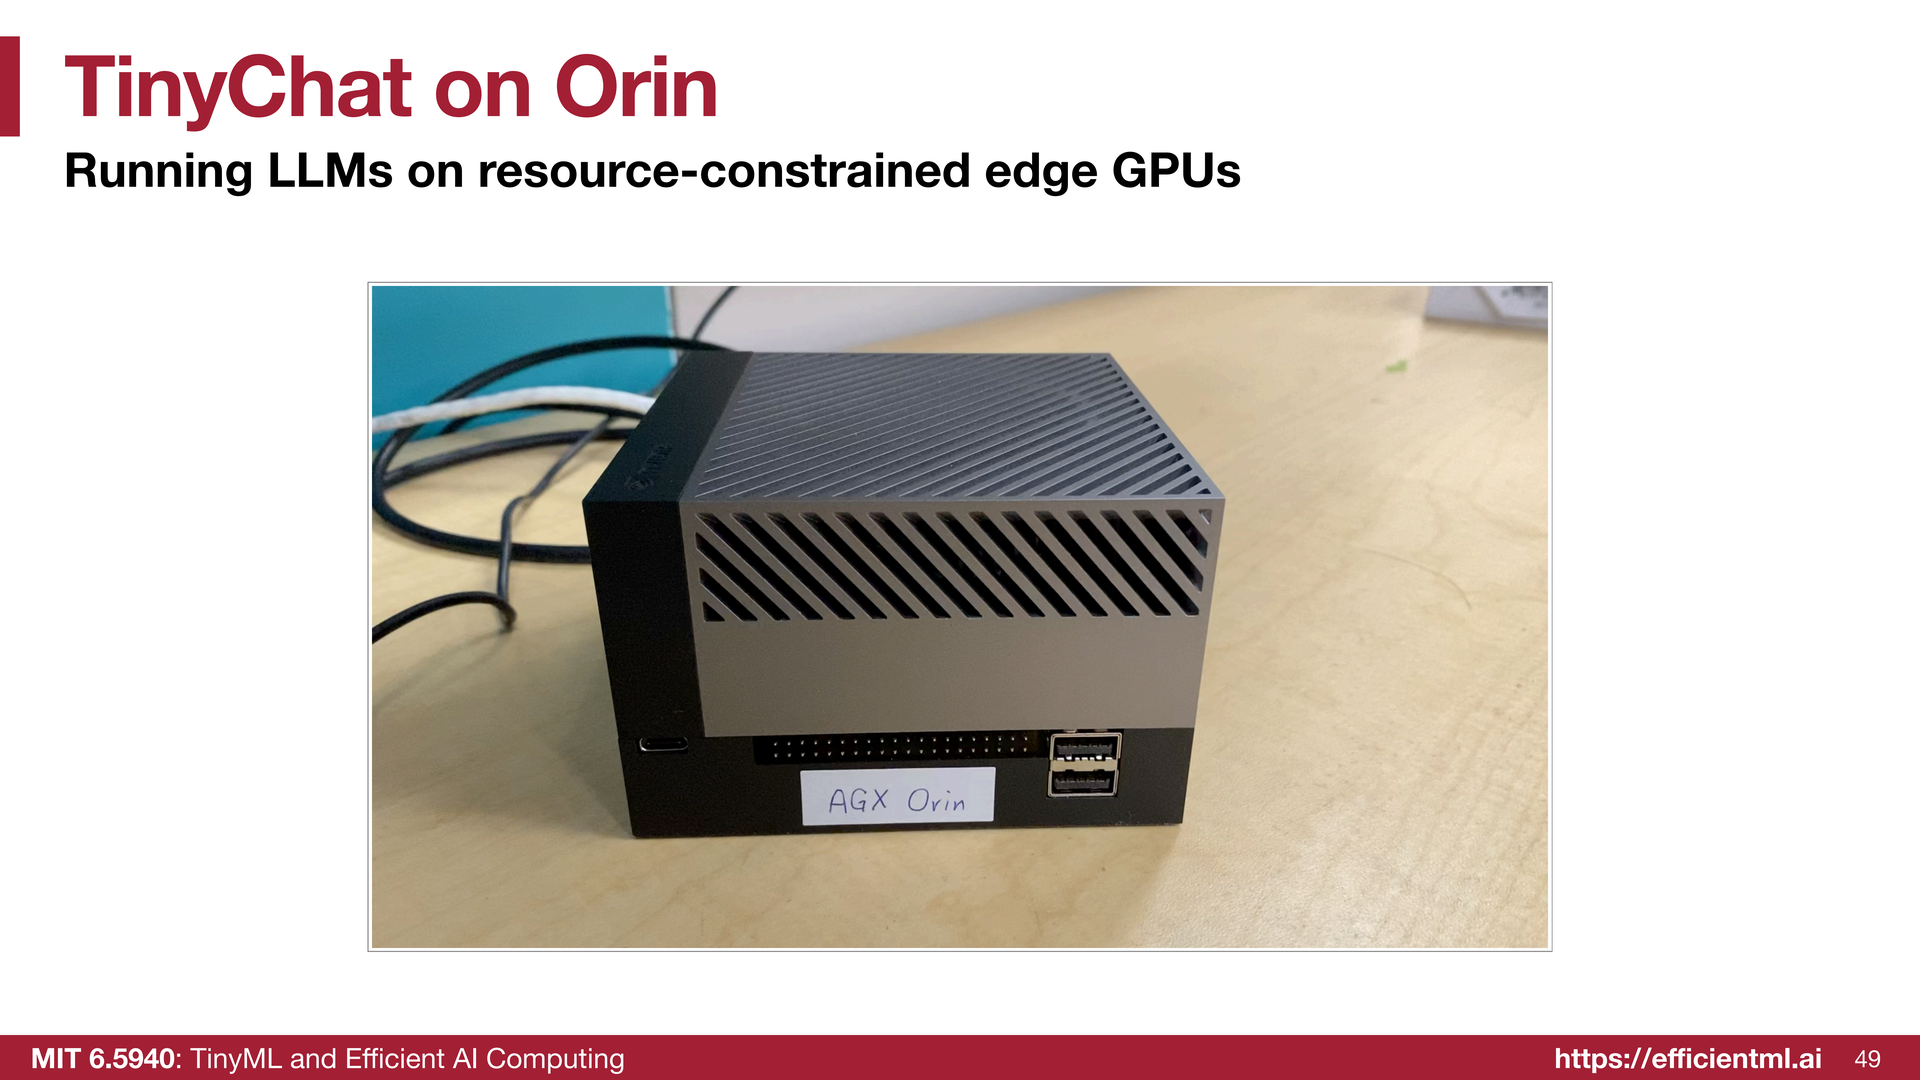
后来我们还 3D 打印了一台微型电脑,在 Jetson Orin Nano 上本地跑 70 亿参数的模型。这台微型电脑的背面相当小巧,我们也可以用一个稍大一点的 Jetson。
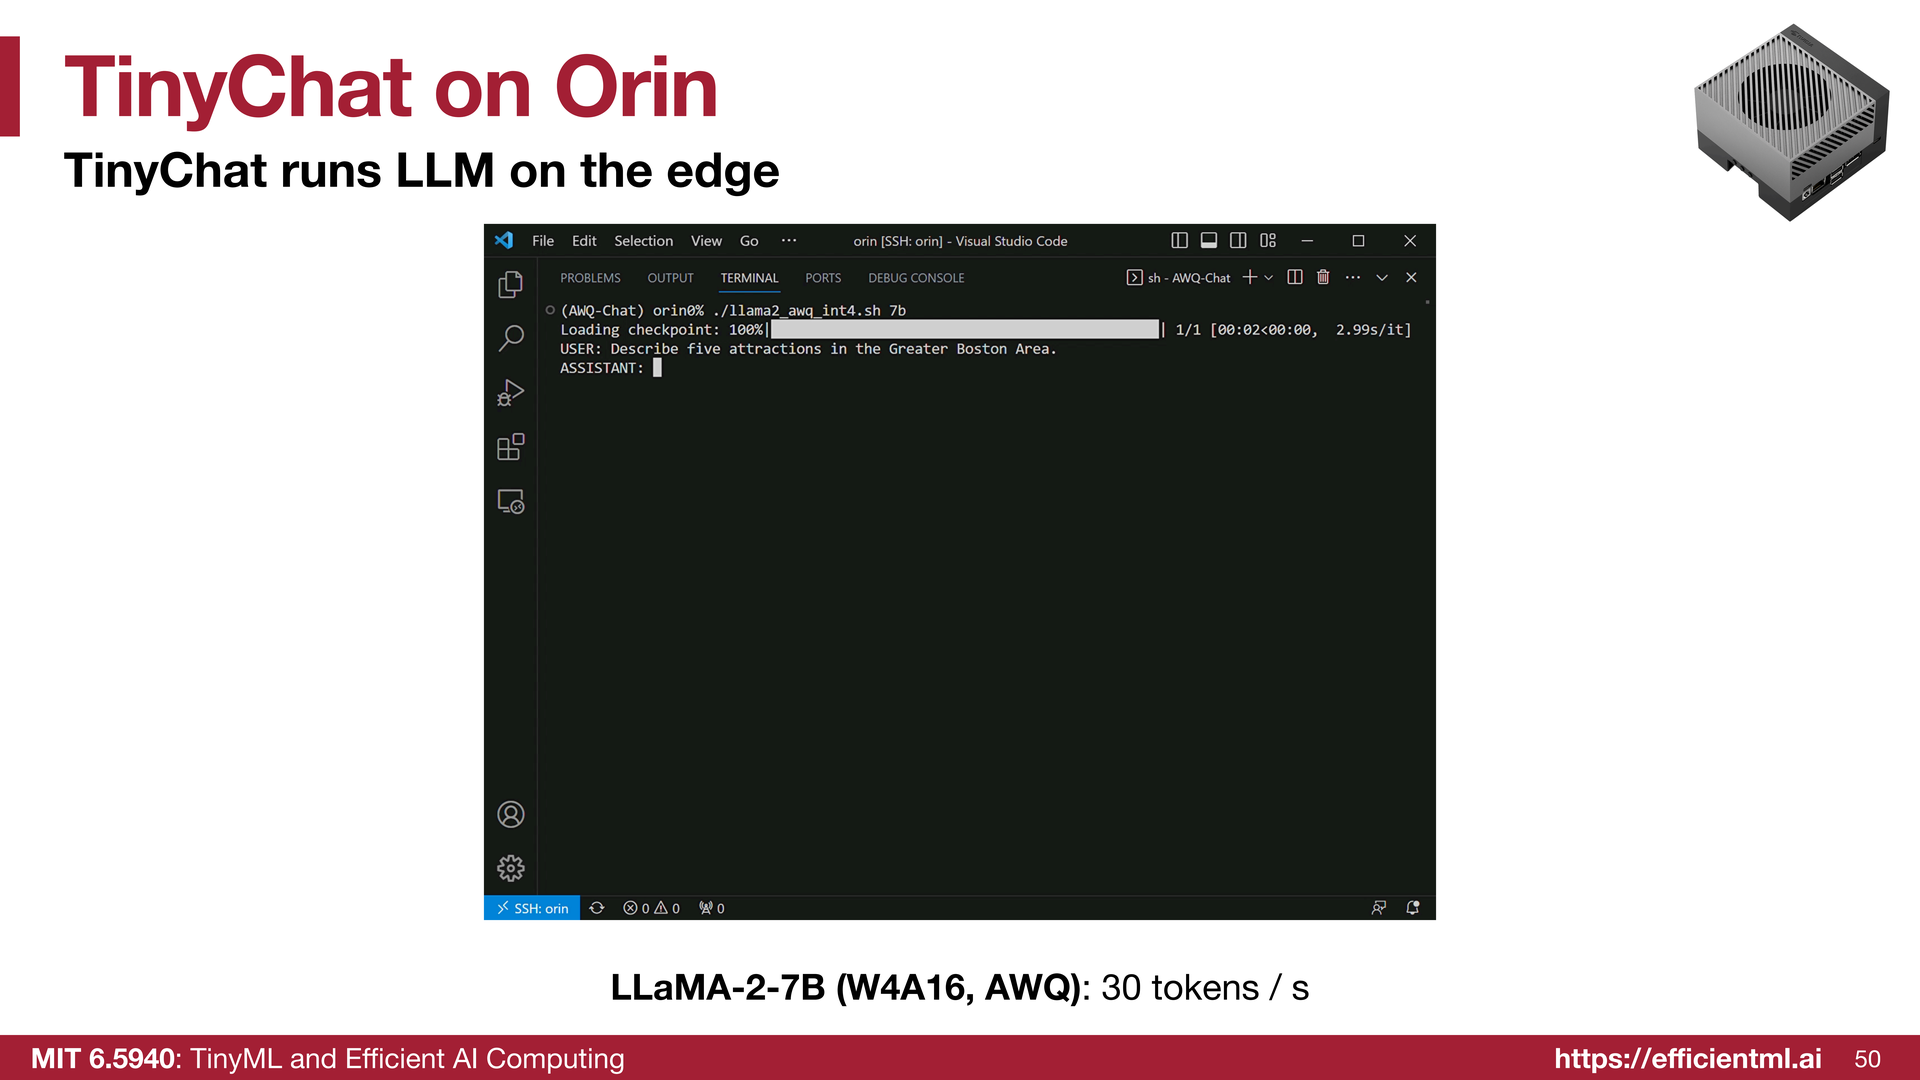
这里有一个用 AWQ 在这台设备上跑 7B 模型的演示,是我们联合授课老师 Sean 大约三年前做的,输出速度相当快---运行 70 亿参数的 LLaMA,大约每秒能出 30 个 token。
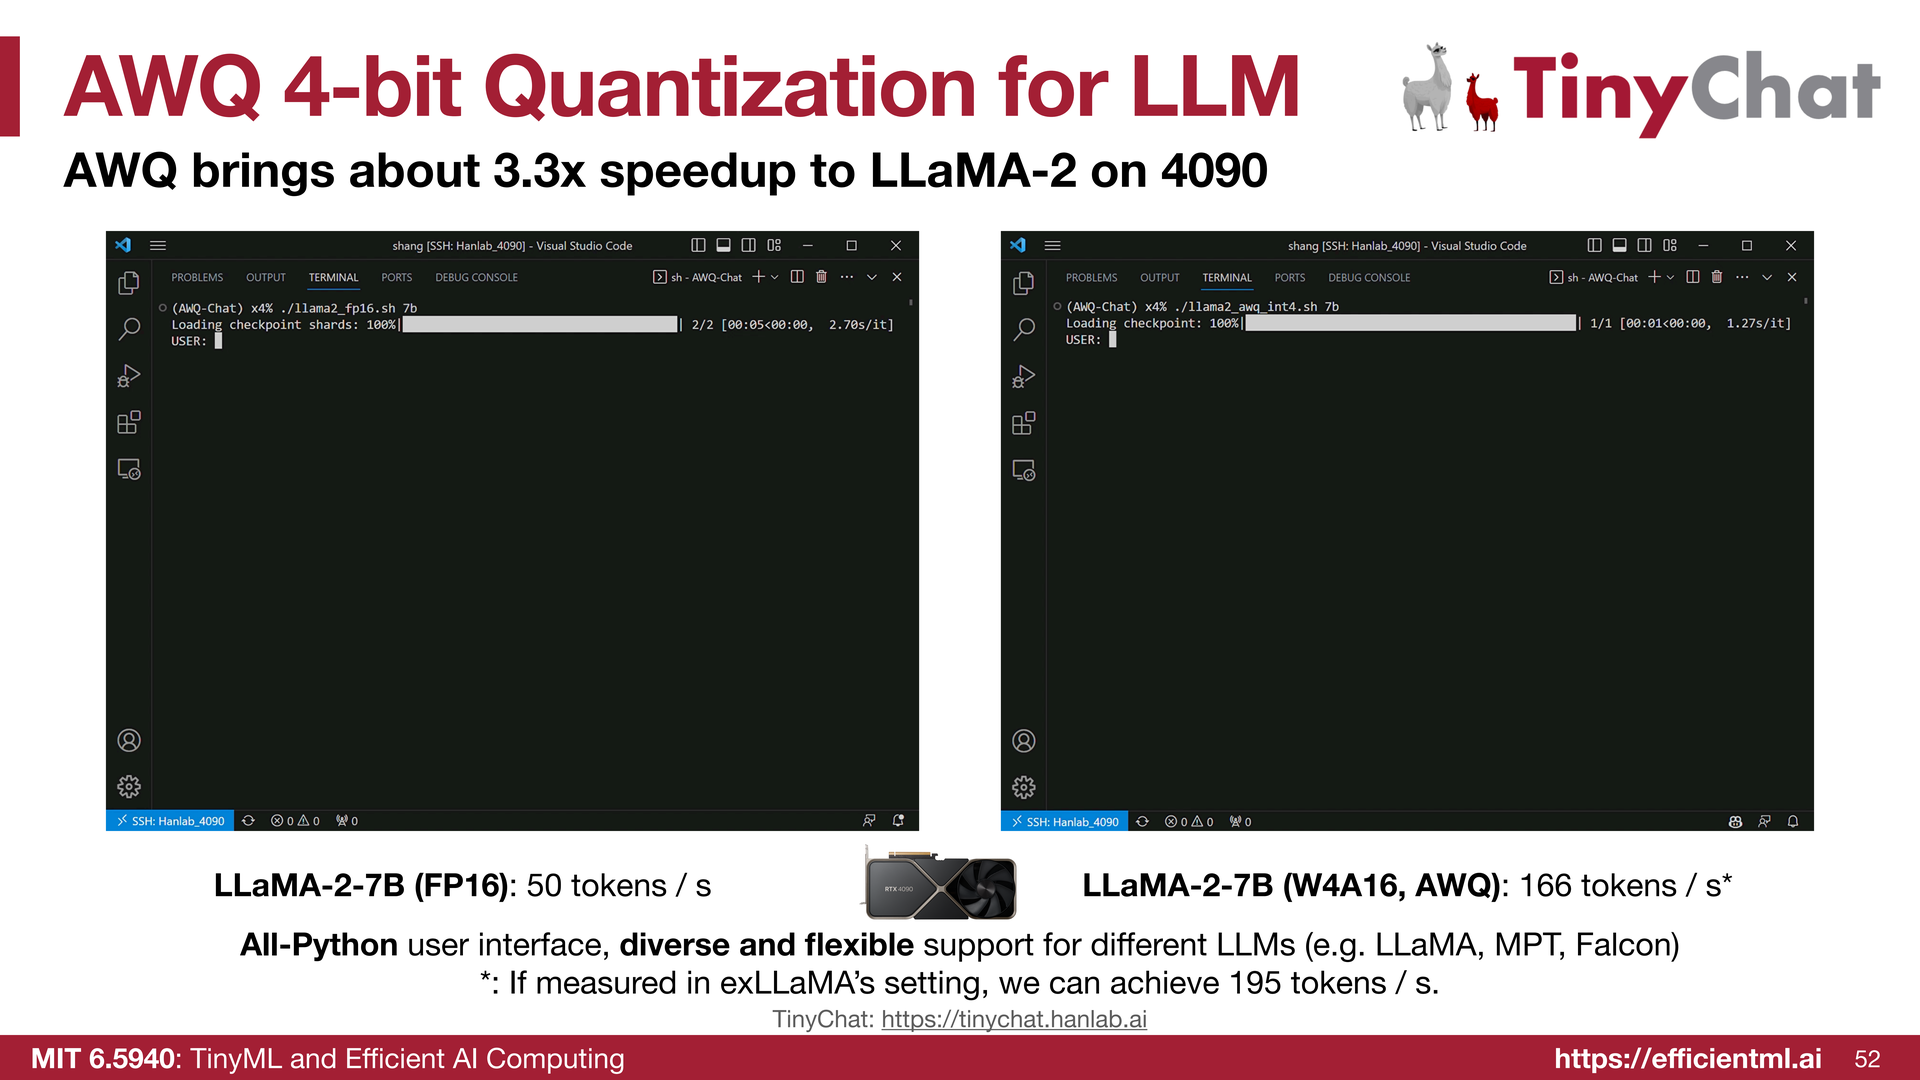
这里对比的是在 4090 GPU 上运行的速度:不用这项技术大约每秒 50 个 token,用了能跑到每秒 166 个 token 。在这门课里,我们会带你走完每一步加速的细节,而 你们要自己动手实现每一项技术,亲眼看到实测的加速比。
6. Multimodal and Embodied AI
6.1 Vision-Language Models
我们已经讲了视觉和语言,接下来我们把两者结合起来,看看多模态模型:怎么支持不同的模态?比如,能不能把图像理解和语言放在一起?那就是 视觉语言模型。
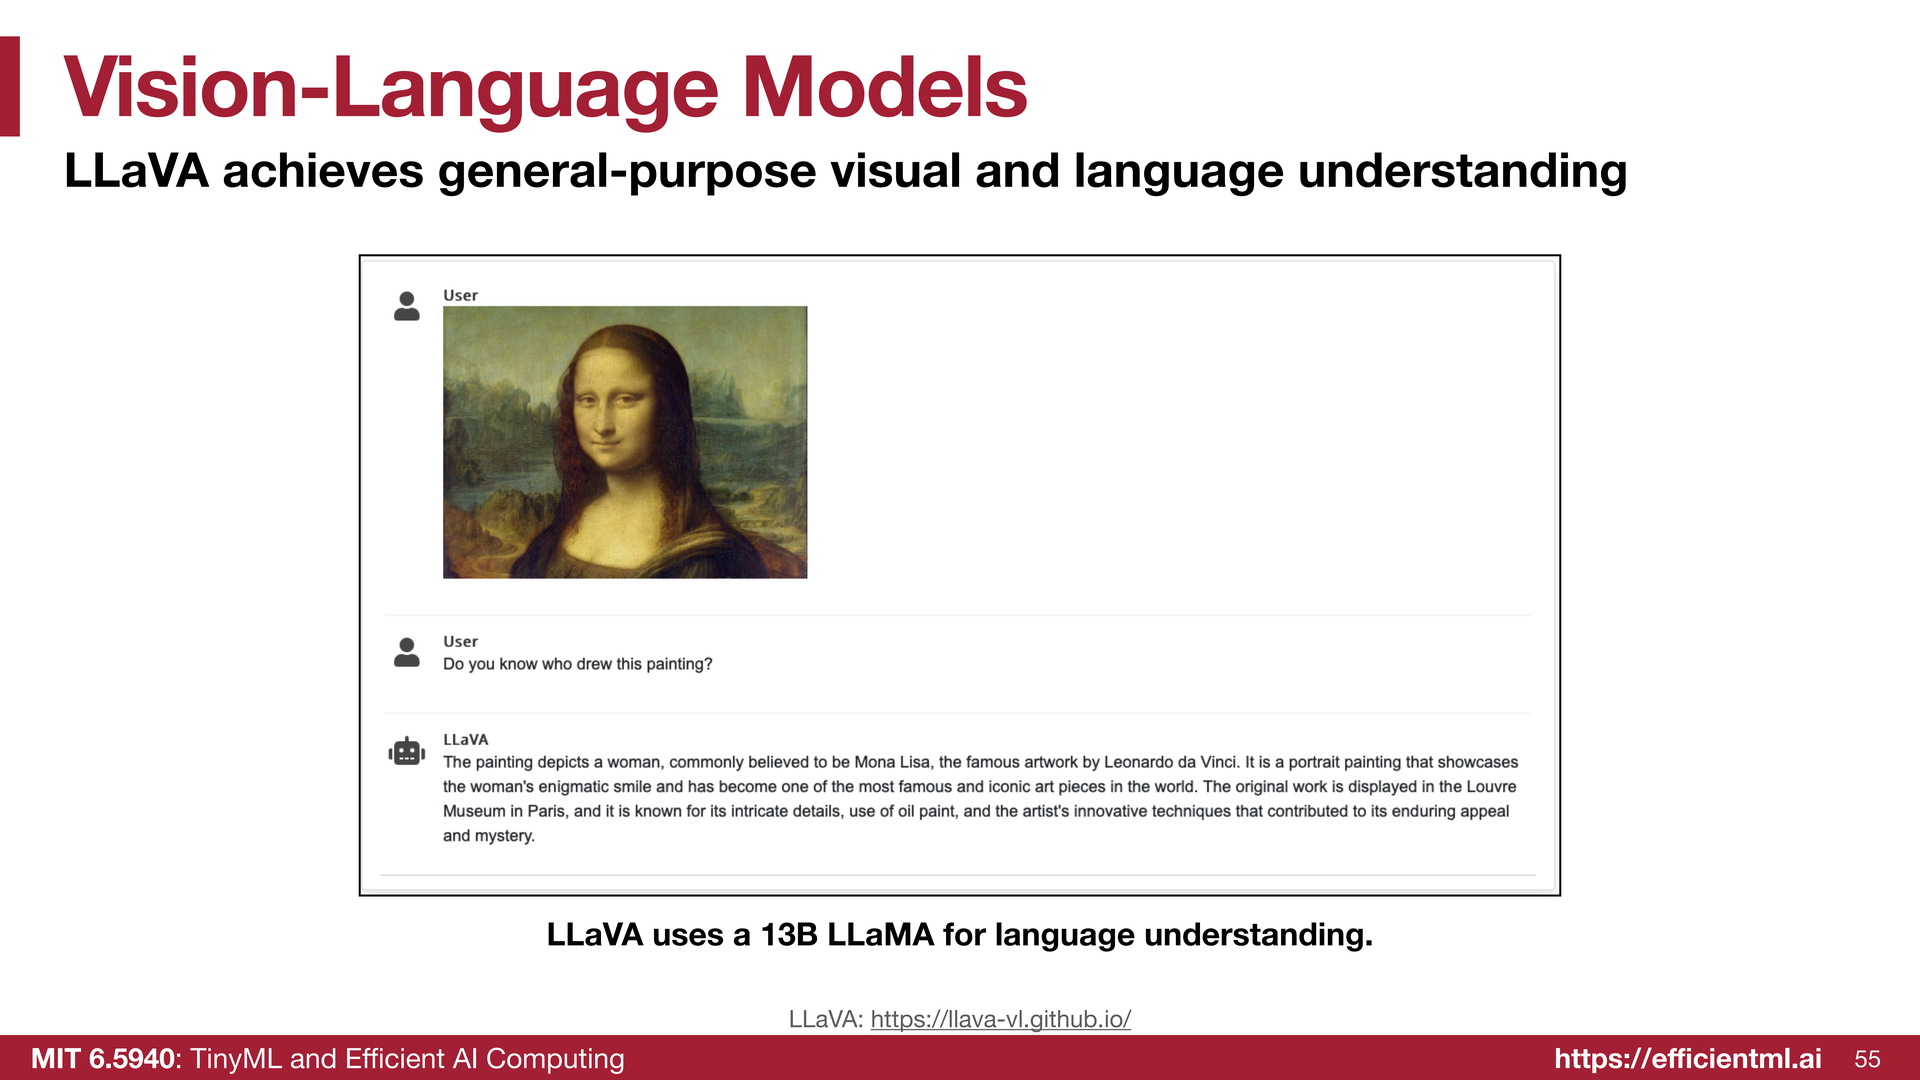
你希望模型理解并描述图像里有什么。比如这里,我们问"你知道这幅画是谁画的吗",基线模型会说:嗯,这只是《蒙娜丽莎》。
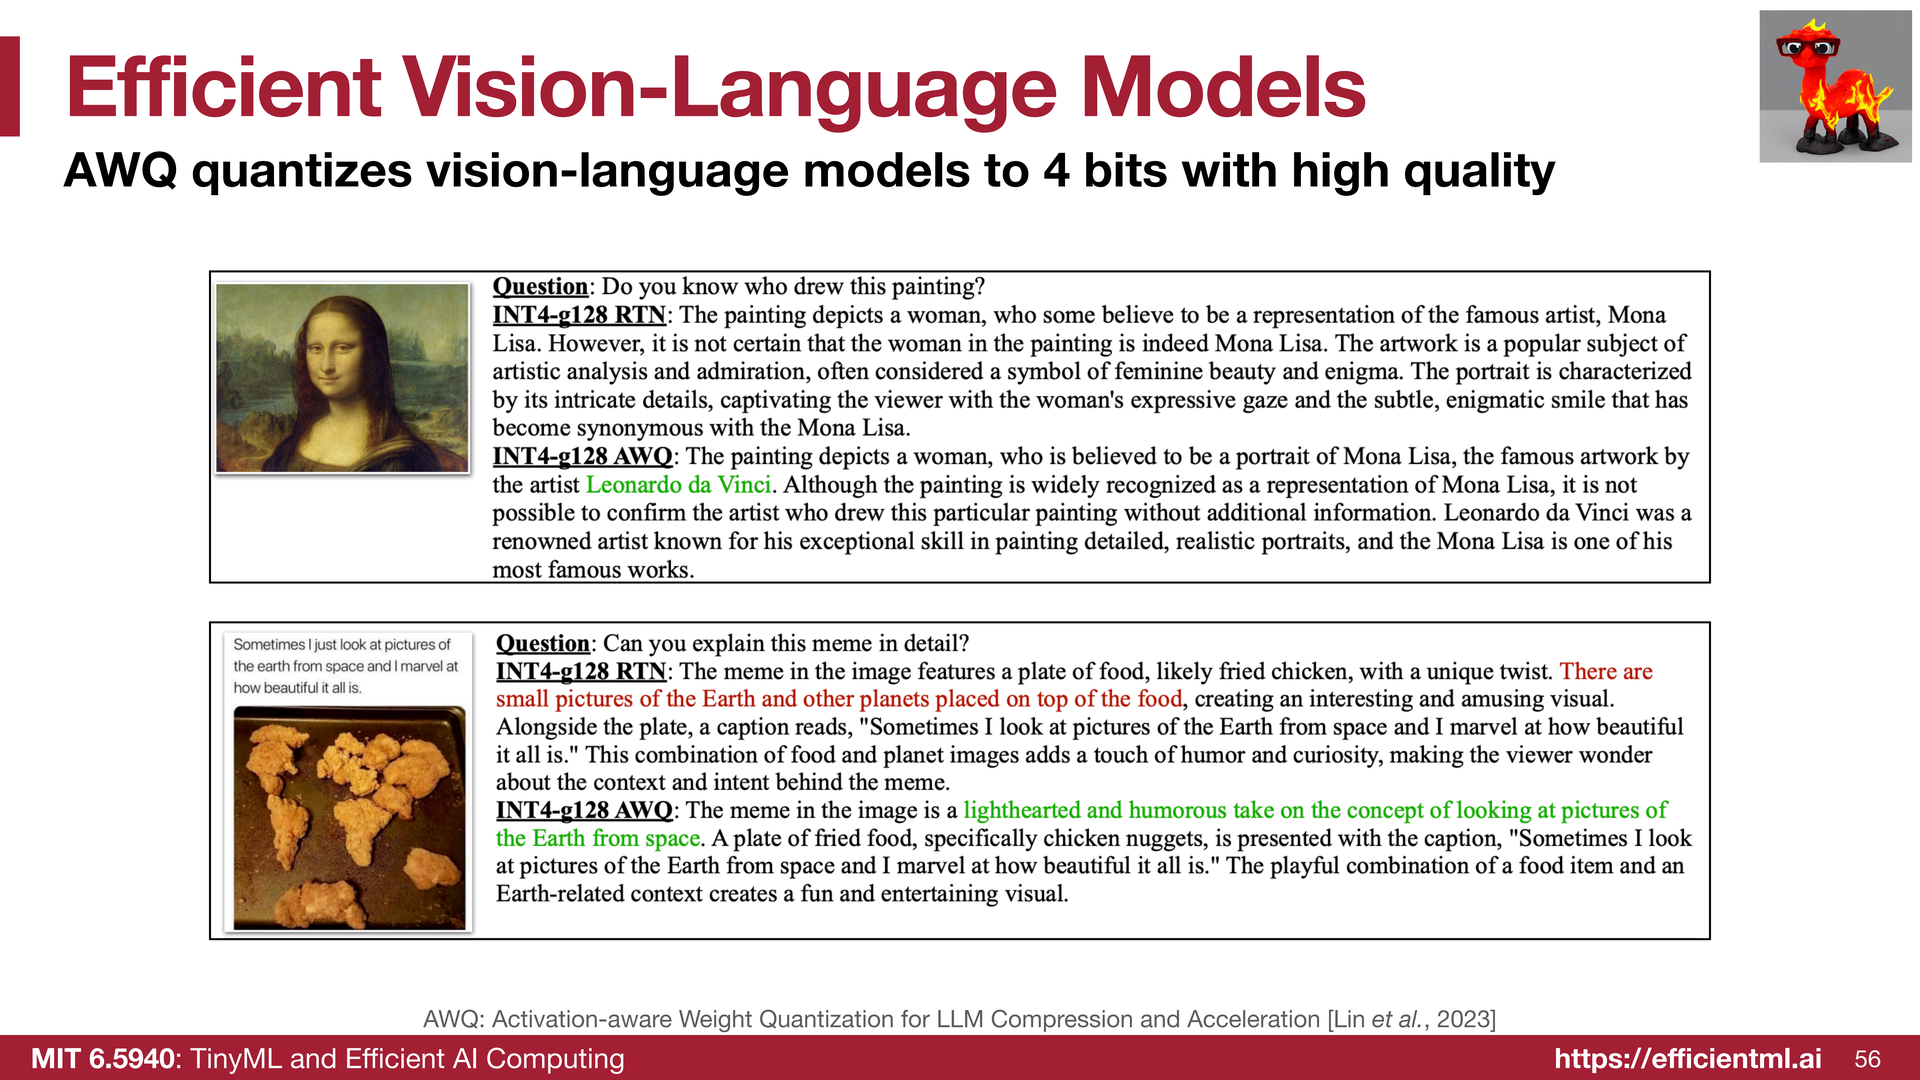
我们可以用 4 位的 AWQ 技术来压缩它,它就能说:哦,这是列奥纳多·达·芬奇。再问"你能详细解释一下这个梗图吗",如果只是简单地做量化、把它压到 4 位,效果并不好,它会说:食物上面放着一些地球和其他星球的小图片;但用了 AWQ 之后,它会说:这是对从太空看地球照片这一概念的一种轻松、幽默的演绎。这说明很多压缩技术不仅能用在语言模型上,也能用在视觉语言模型上。
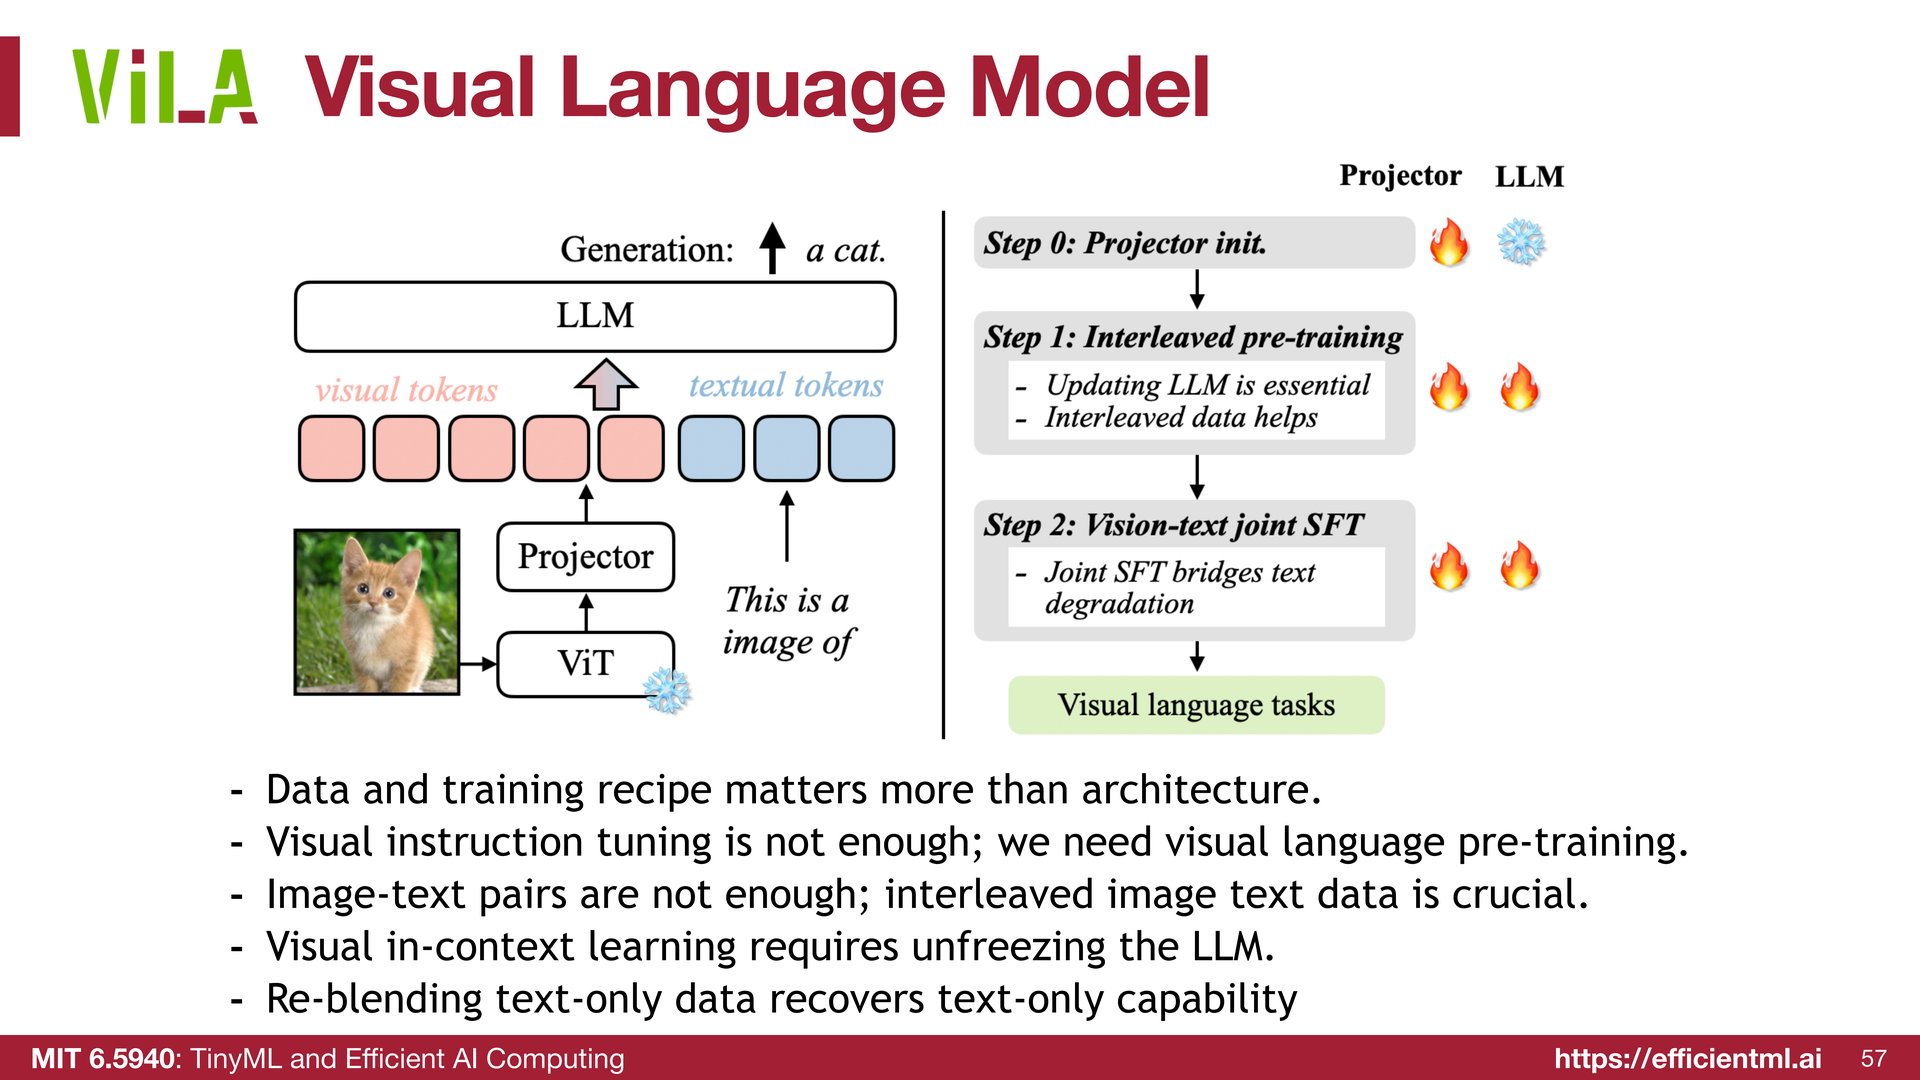
视觉语言模型本质上就是 把视觉 token 拼接起来 。一切都 token 化了---一张图会被切分成许多个 token,一段视频则是更多的 token,它们都可以和文本 token 拼接在一起。同时还要 让图像和文本对齐到同一个空间:图像先经过一个视觉 Transformer 和一个投影器(projector)完成 token 化,这样就能用交错的图像和文本数据来训练这个视觉语言模型。
光是图像-文本对还不够,你需要交错排列的图像和文本。下面用几个例子看看视觉语言模型是怎么工作的。
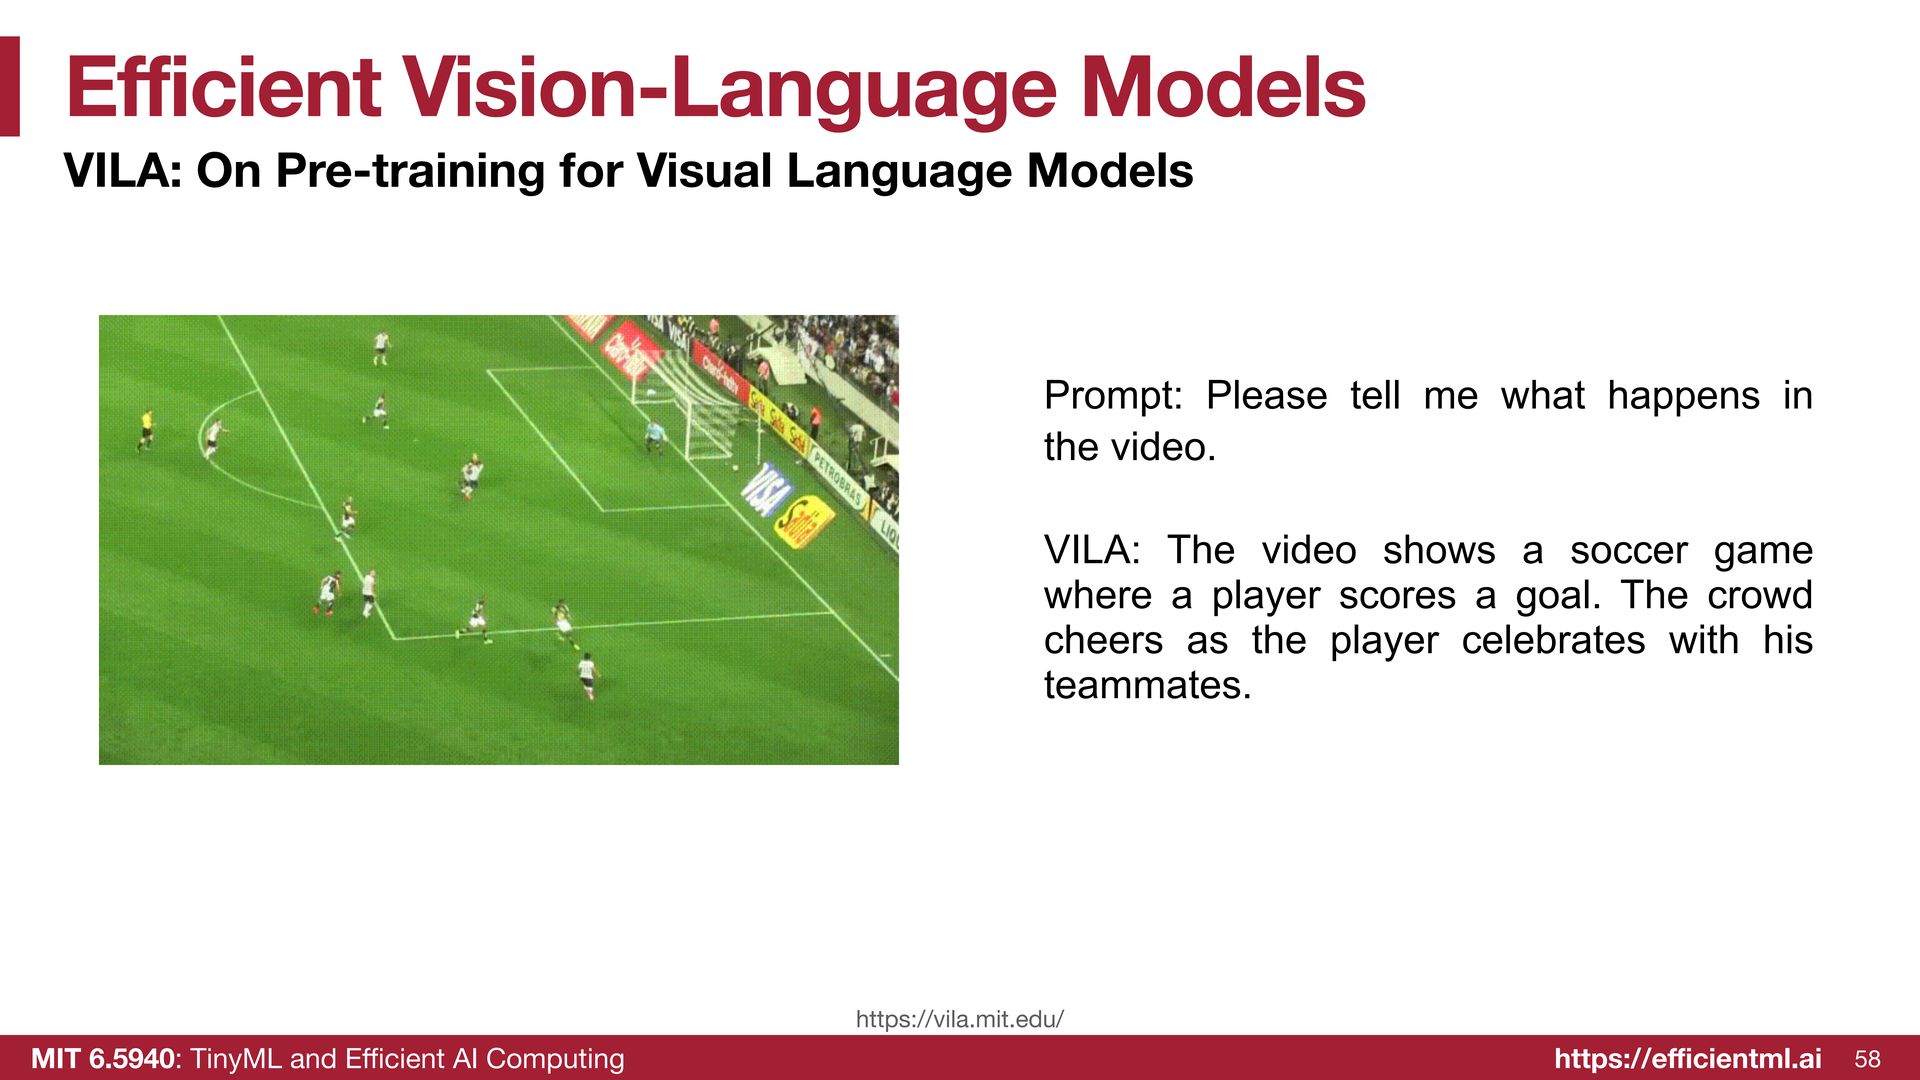
"请告诉我视频里发生了什么",视觉语言模型会说:视频显示一场足球比赛,一名球员进球了,球员庆祝时观众欢呼。
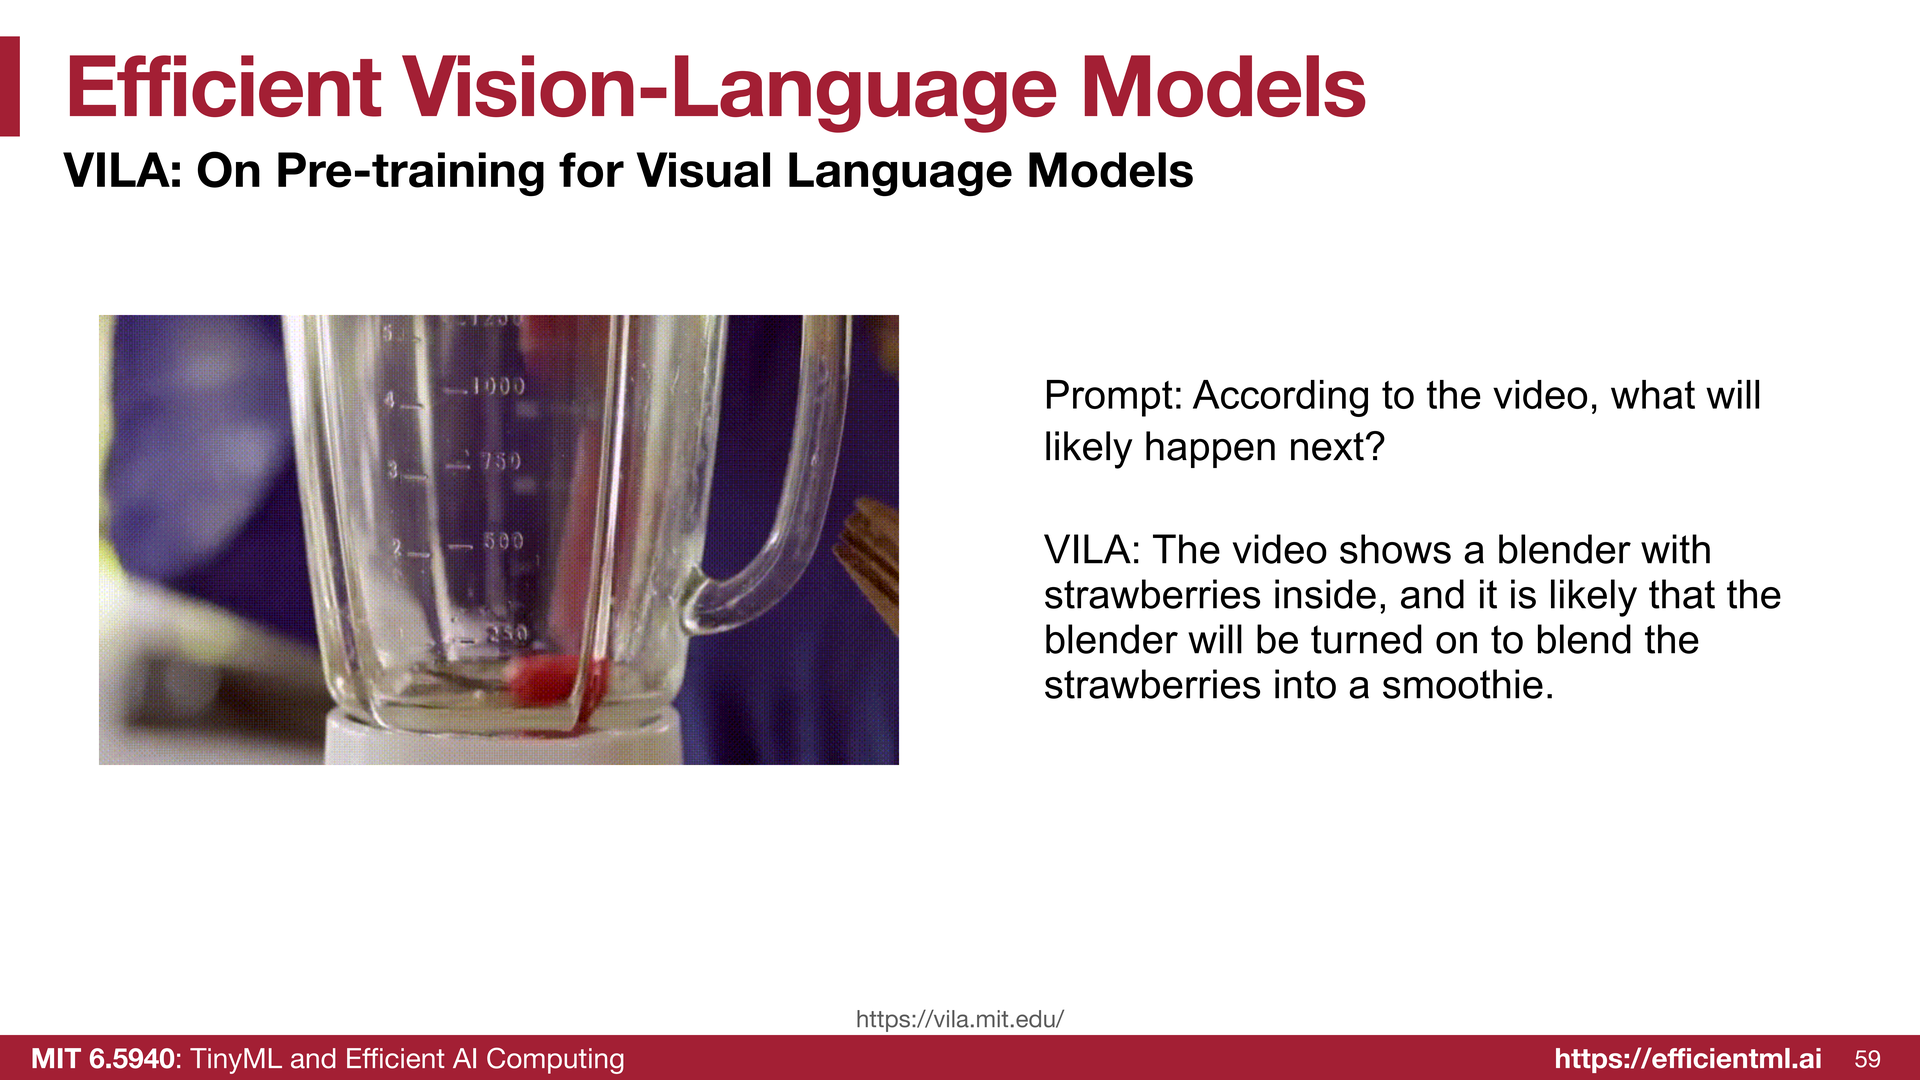
或者给定这段视频:"根据视频,接下来可能会发生什么?"它会说:视频显示一个装着草莓的搅拌机,接下来很可能打开搅拌机,把草莓打成冰沙。
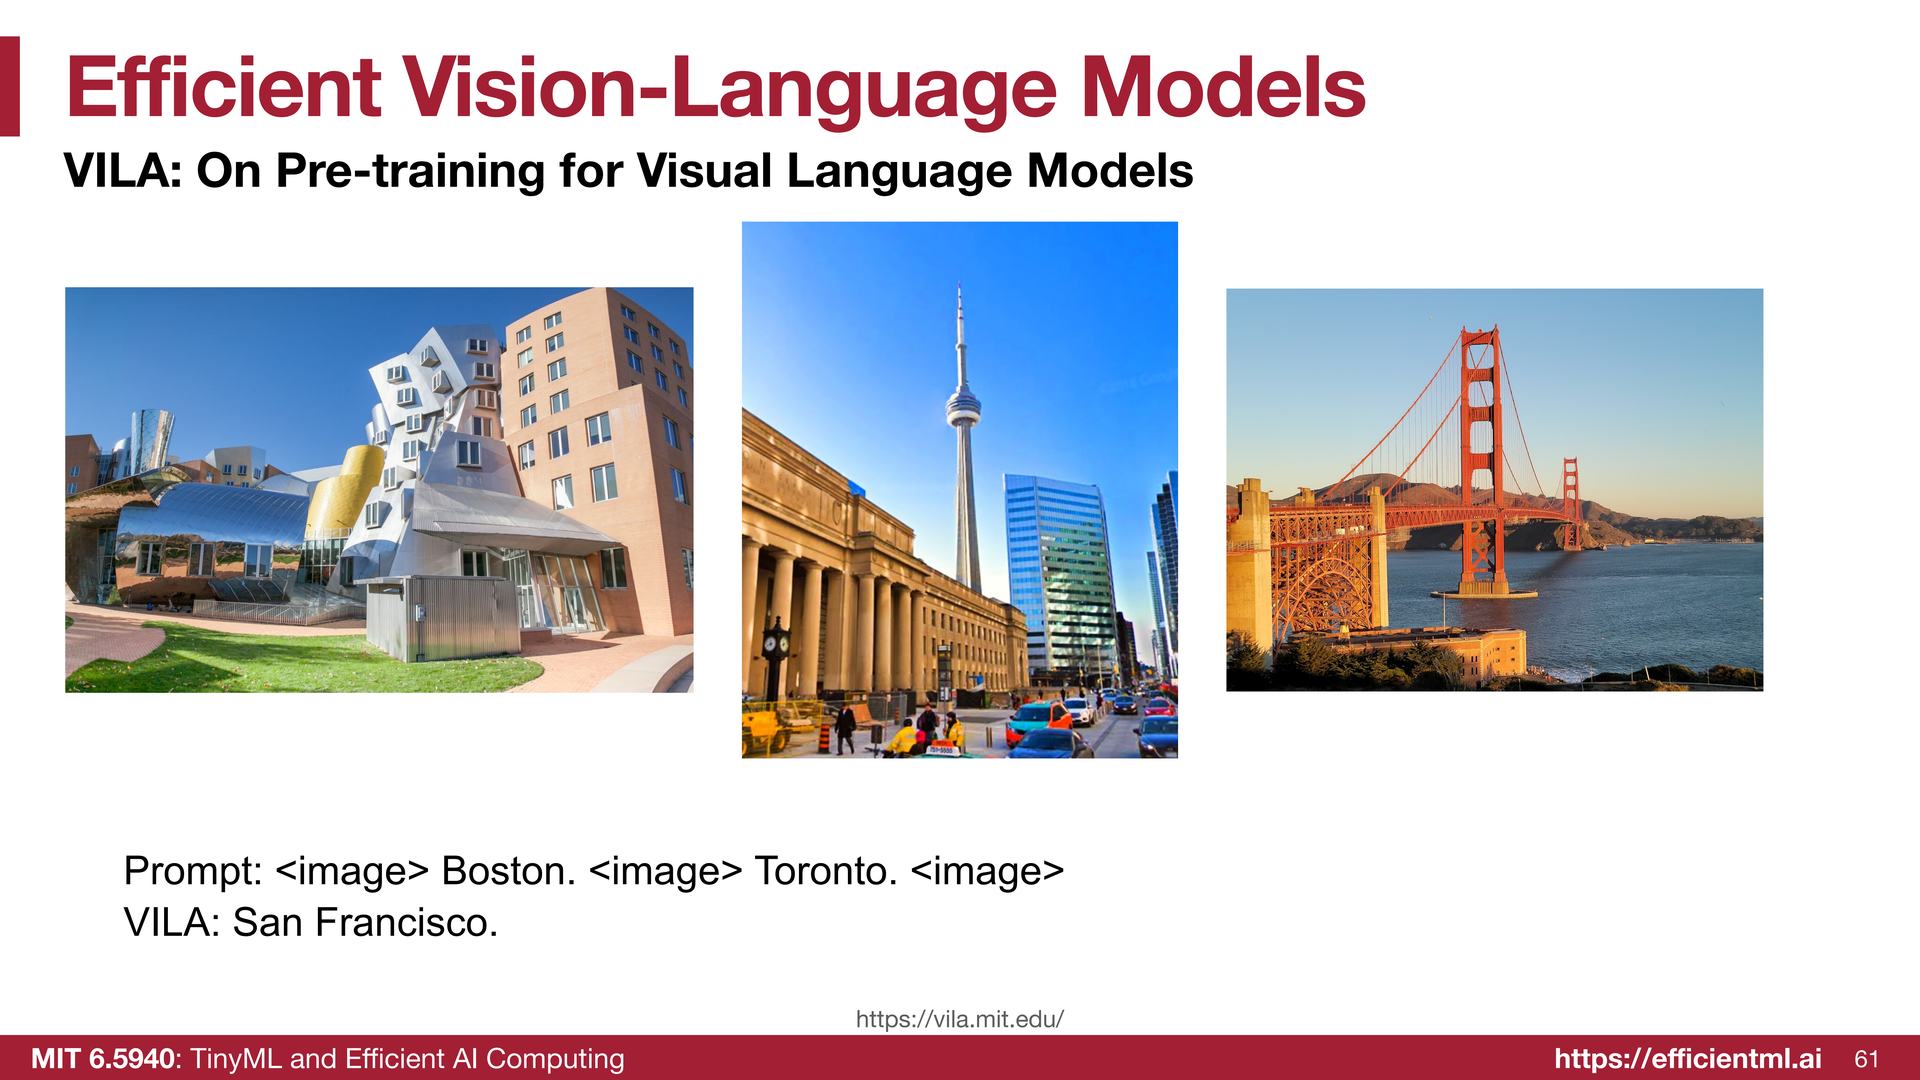
它还能做上下文学习:比如第一张图是波士顿,第二张是多伦多,最后一张图是......,视觉语言模型会说:哦,这是旧金山。这就是 视觉上下文学习,而且它掌握很多世界知识。
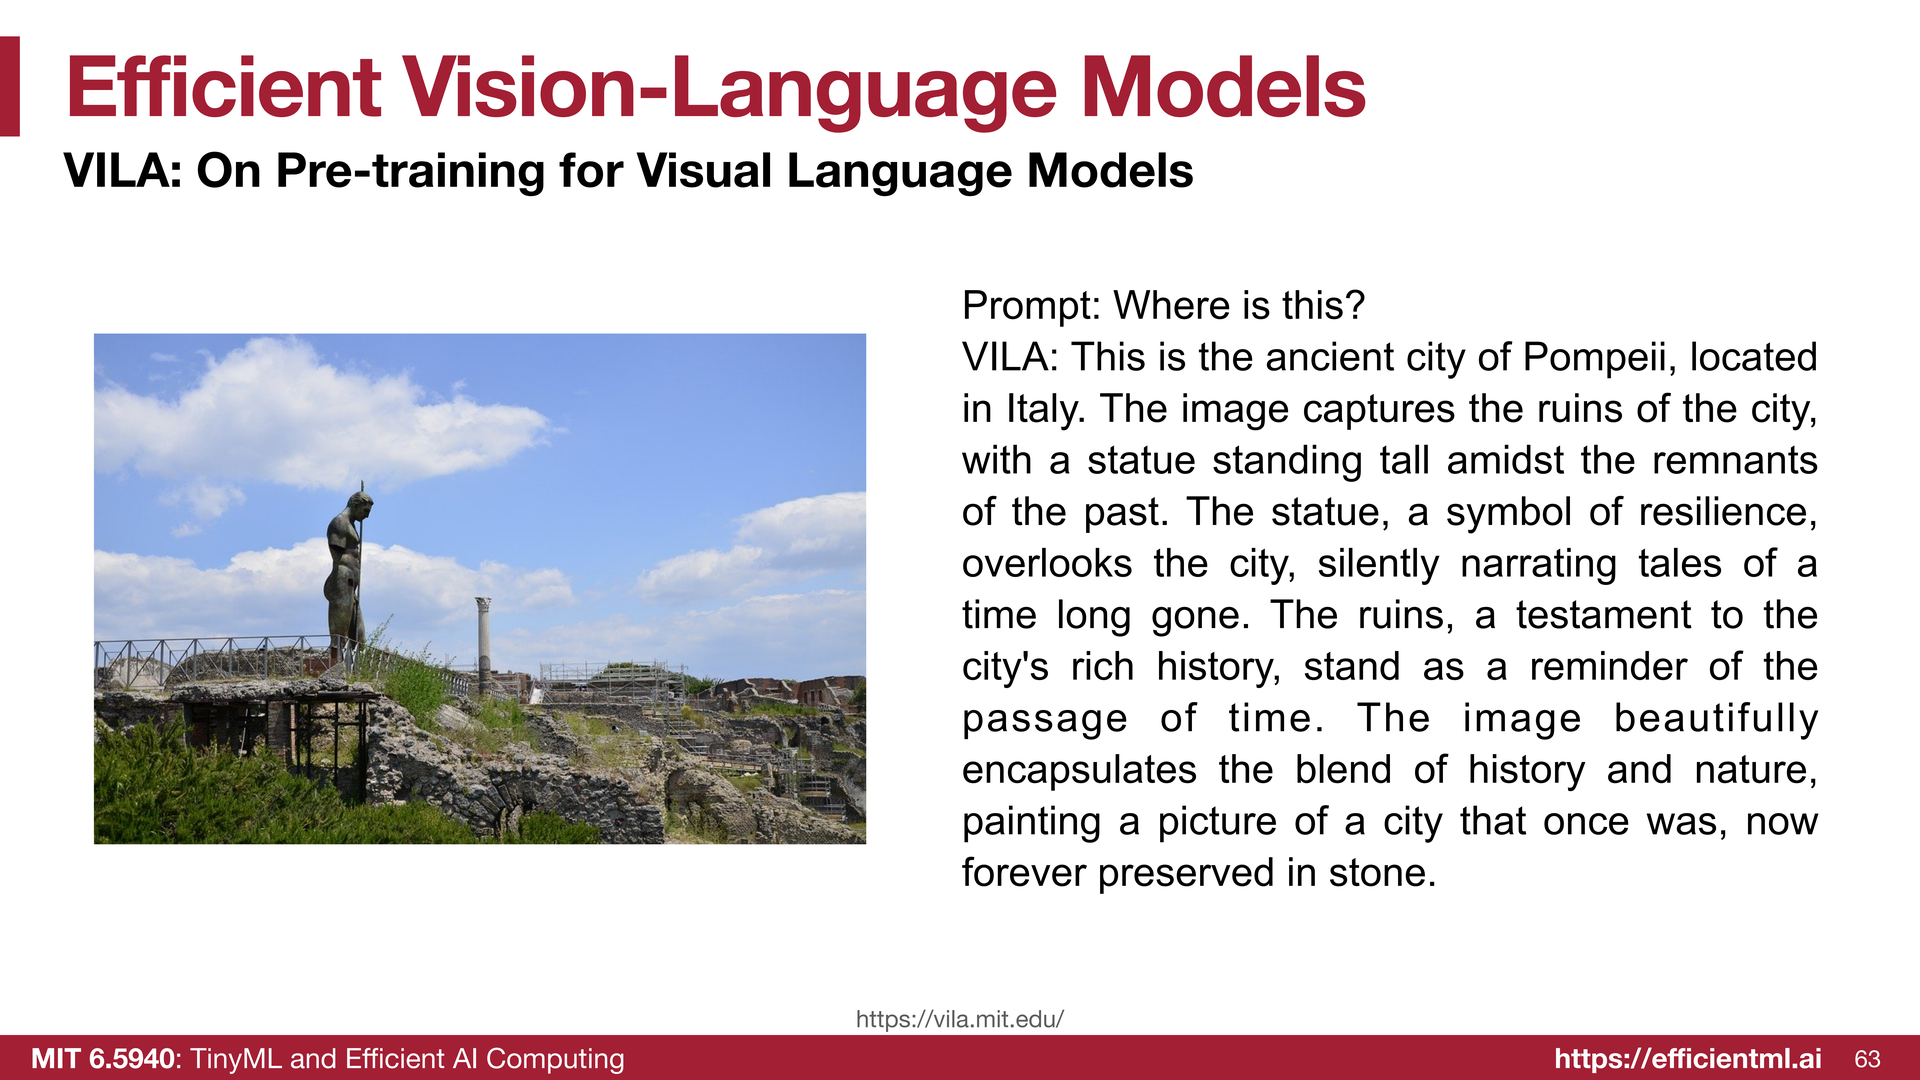
比如:这是哪里?这是庞贝城。
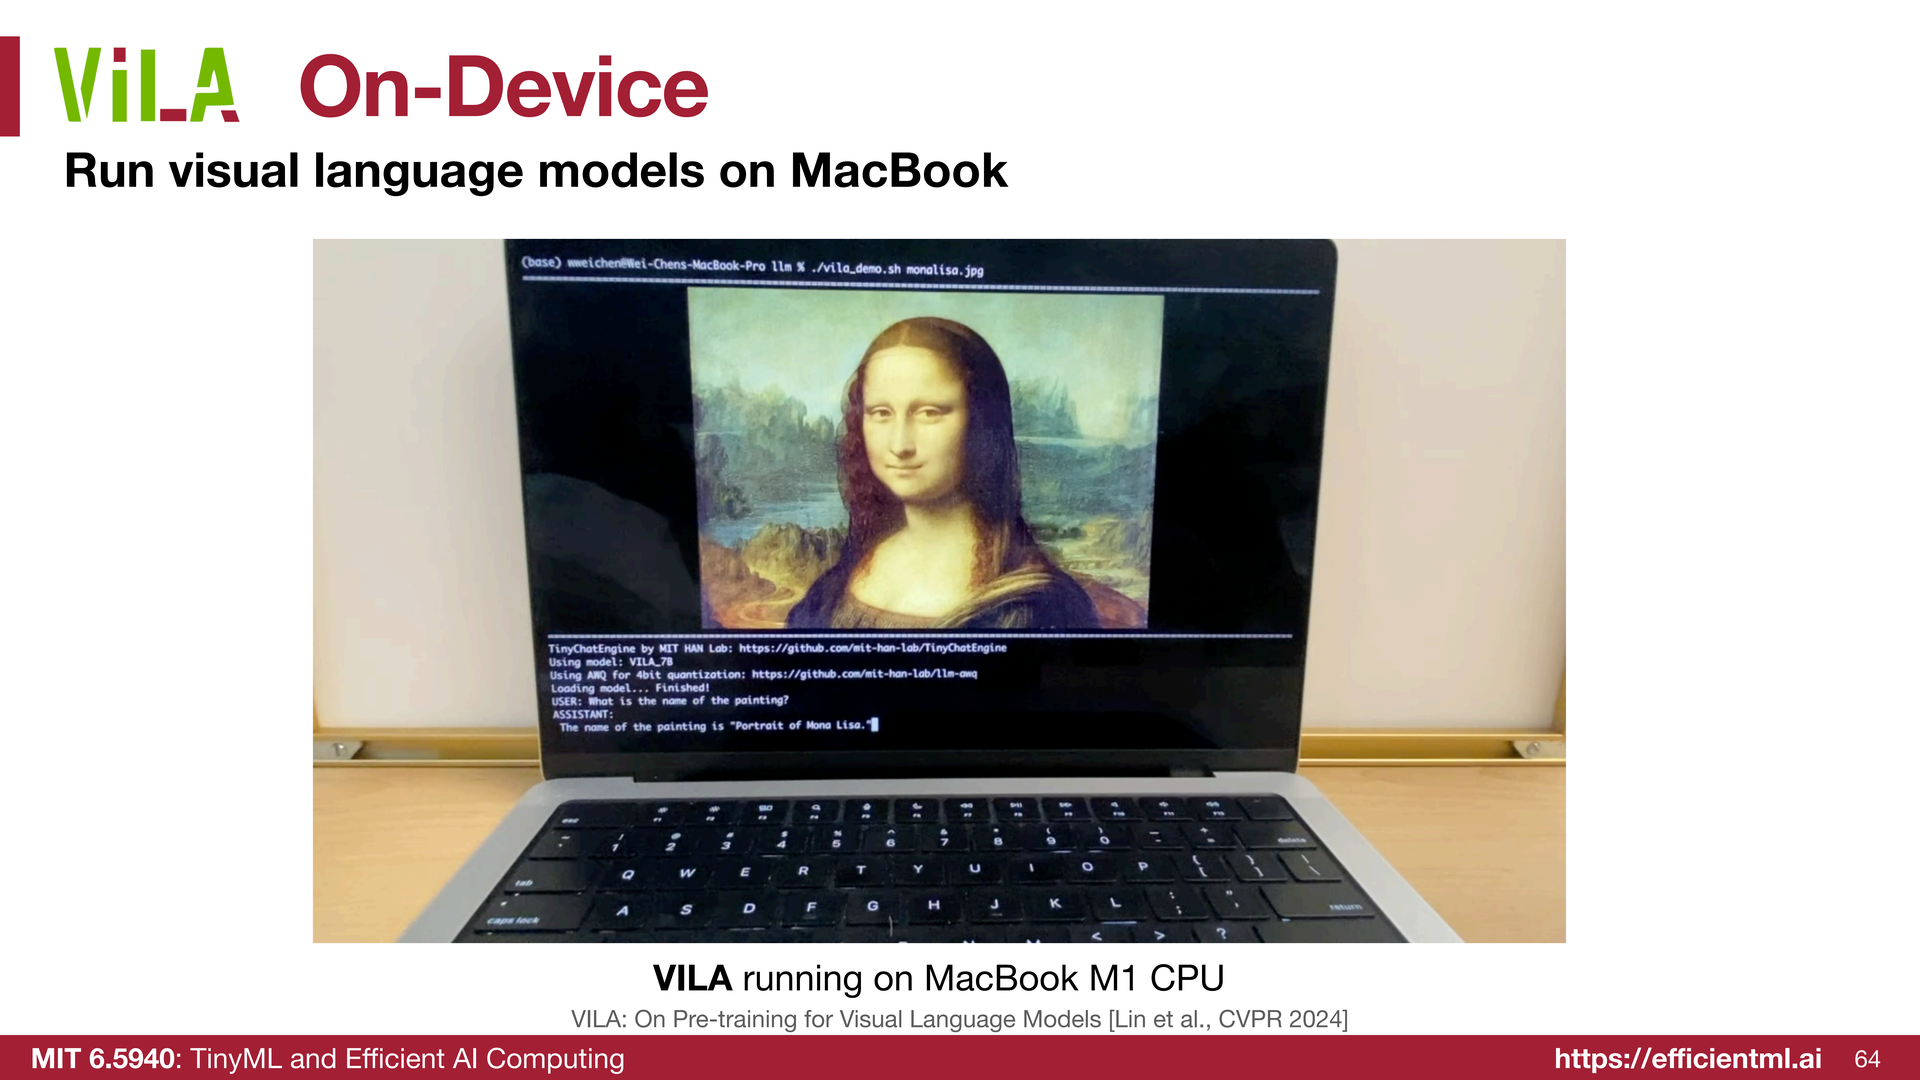
所有这些了不起的技术,能不能也跑在边缘设备上呢?我们可以应用 AWQ 技术和 TinyChat Engine---这些我们这学期后面会实现。这就是 在 MacBook 上本地运行 的效果:"这幅画叫什么名字?"现在这幅画的名字是《蒙娜丽莎》。所以在我们的作业里,我们只要求你实现语言模型,但如果你也能实现视觉语言模型---就像这样在笔记本上本地做图像识别---我们会给加分。
最近 AI 技术极大地推动了 机器人和具身智能 的发展。
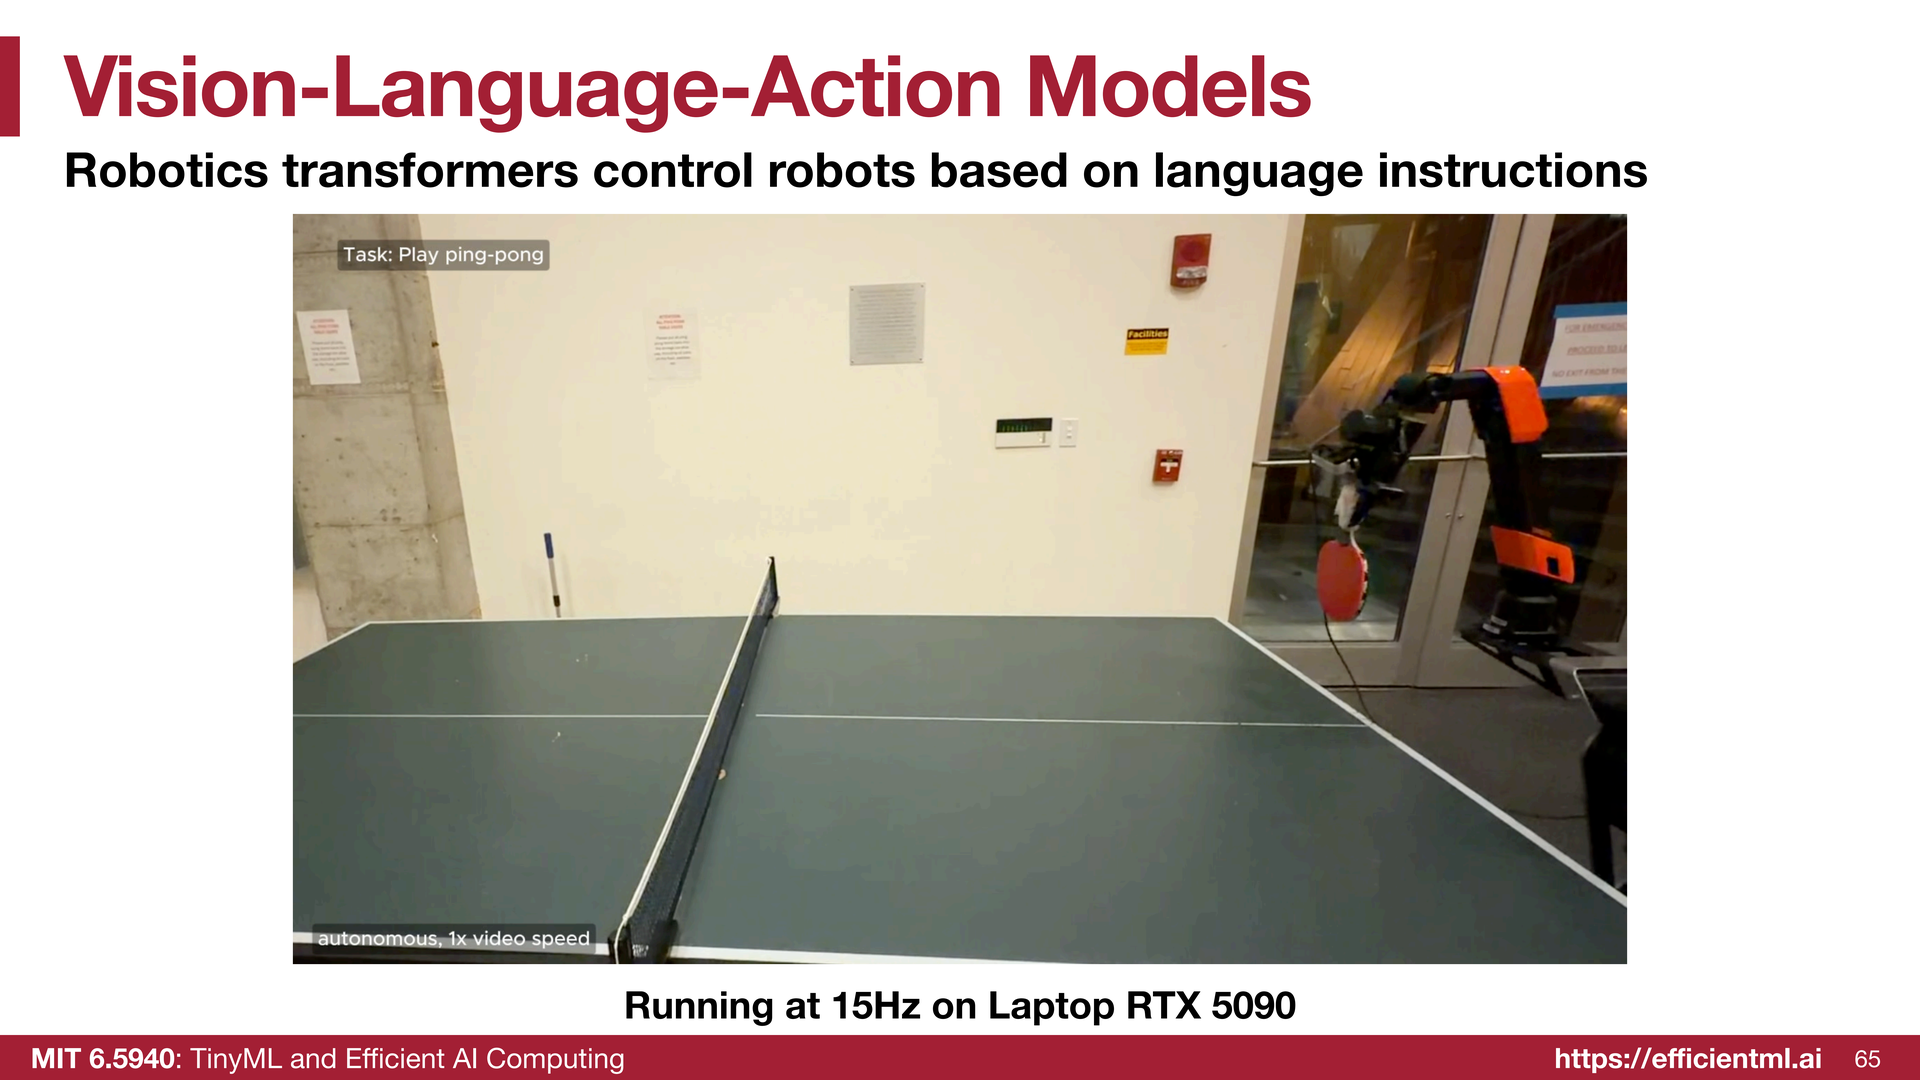
这是我们助教 Jiaming 做的打乒乓球机器人,大概能连续对打三个回合。它跑在一台 RTX 5090 笔记本上,实时性达到 15 Hz。所以 在压缩和效率技术的加持下,它能做出接近实时的交互和决策。
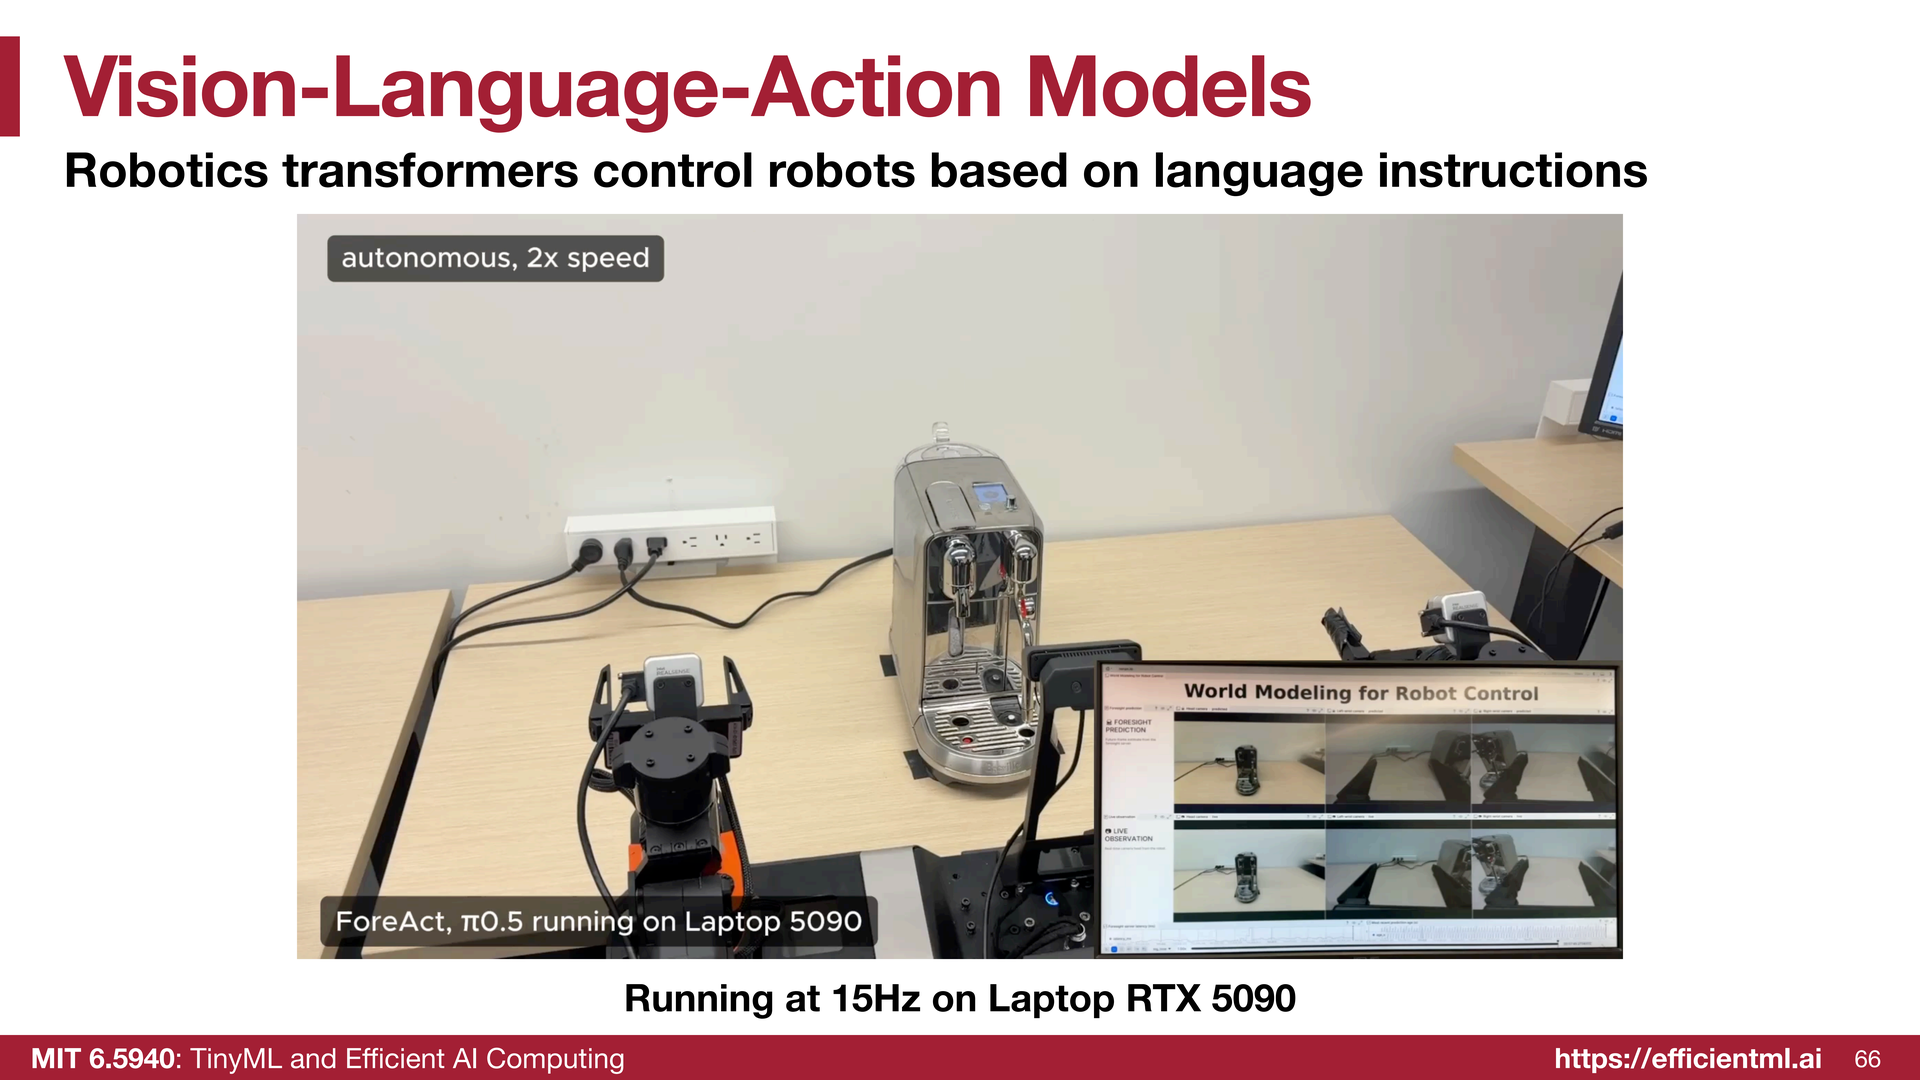
这是 Jiaming 和 Joy 的另一项工作:用 世界动作模型(world action model) 煮咖啡。机器人有两条手臂:拿起胶囊,左臂打开门,右臂把胶囊放进咖啡机,关上门,然后移动咖啡杯。这里有六个视频:最下面是摄像头观察到的东西,最上面是模型在预测接下来会发生什么---它在设想未来,并努力达成那个目标 。但实时生成图像相当昂贵,因为需要逐个像素地预测。所以这又一次说明 我们需要效率技术,让你能在机器人上实时、本地地完成这类工作。
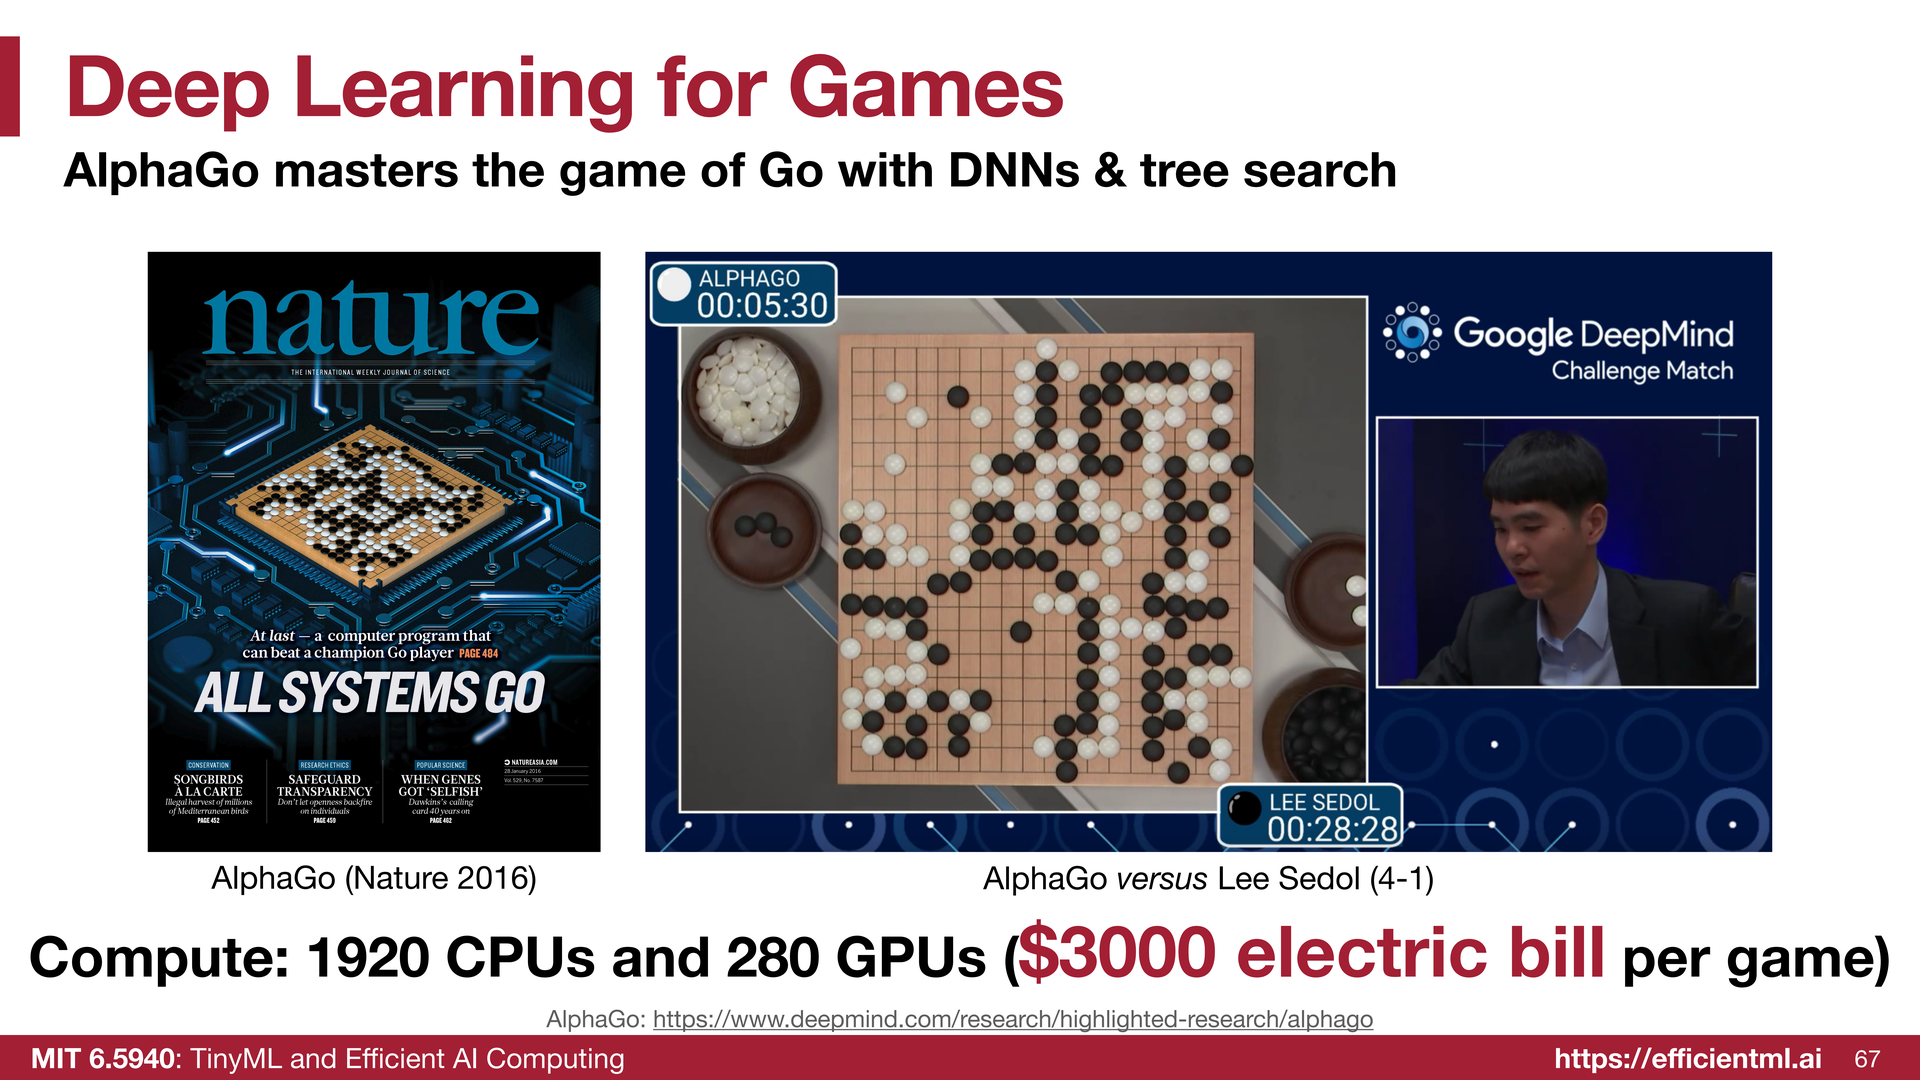
大约十年前,深度学习在围棋上击败了李世石,那 需要 1200 个 CPU 和将近 300 块 GPU,每盘棋的电费要 3000 美元,相当昂贵。
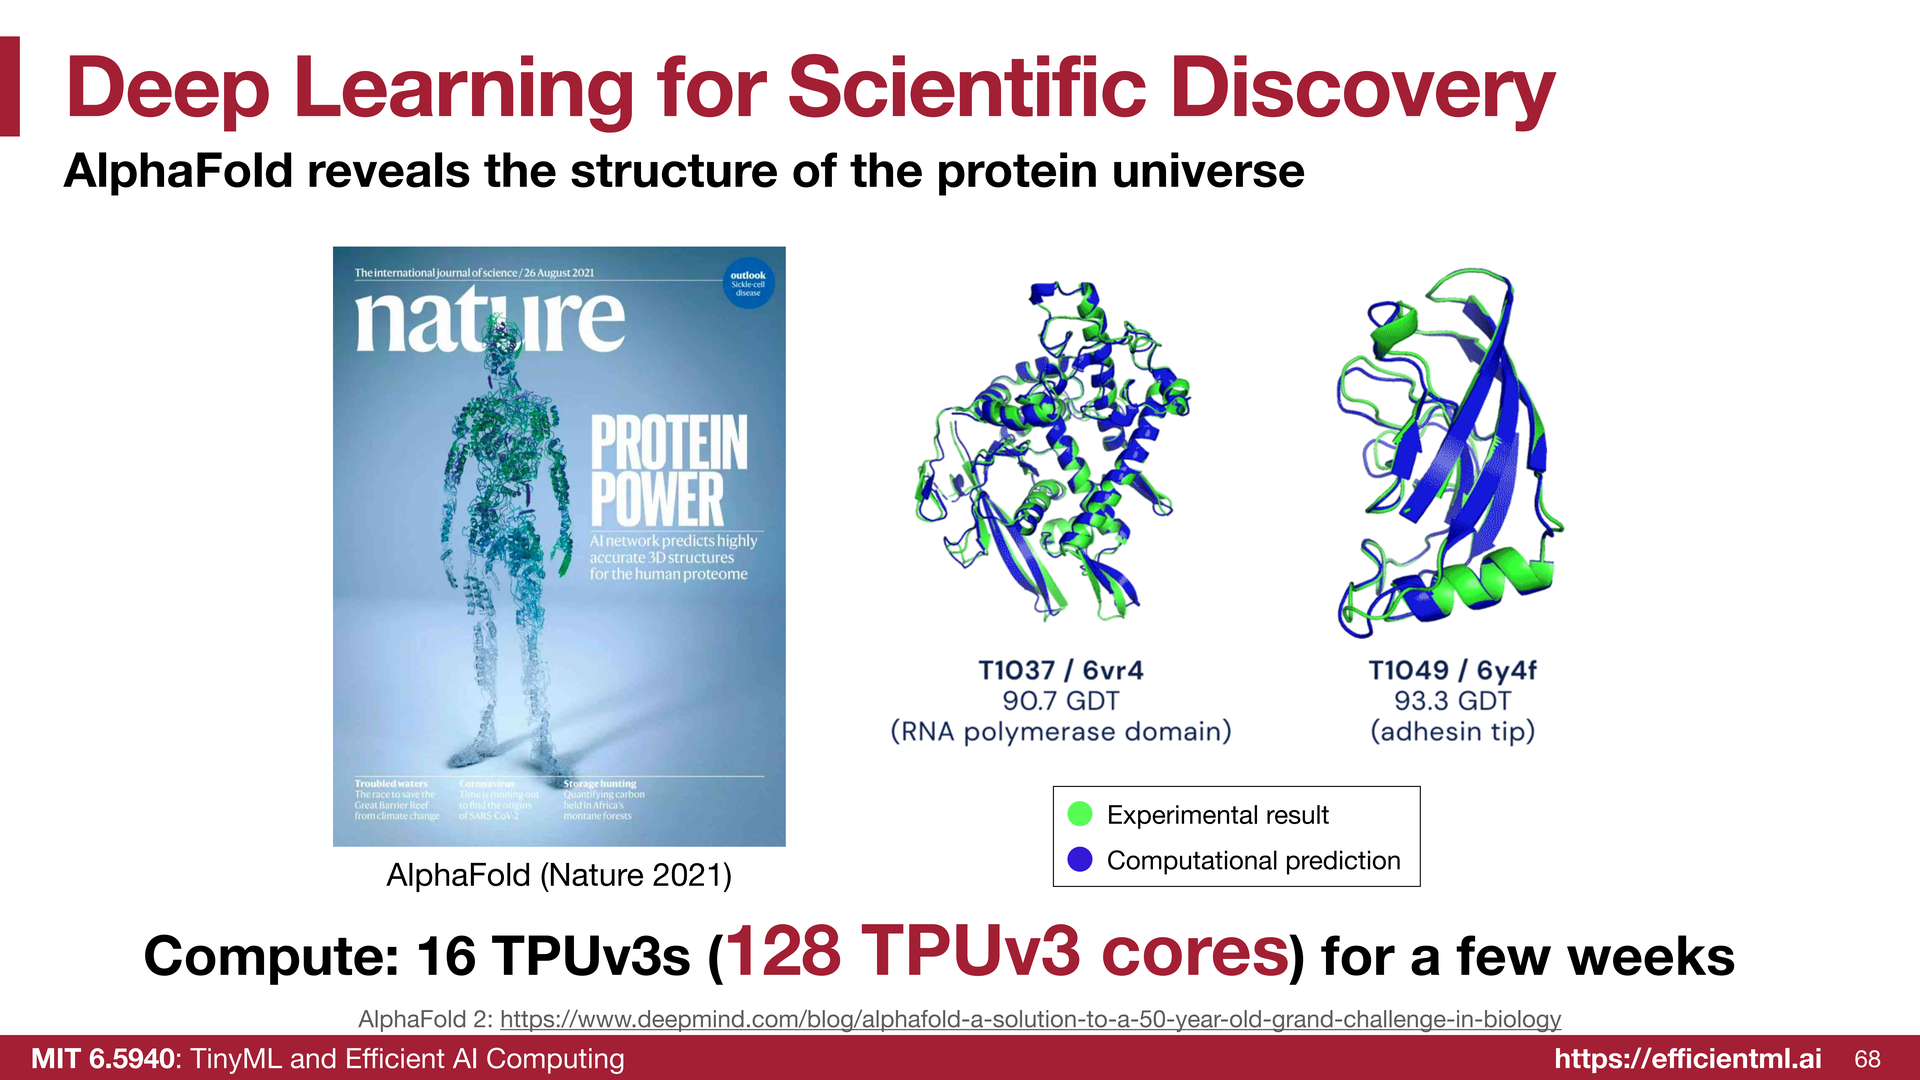
还有 AlphaFold---用深度学习做科学发现 ,大约 128 块 TPUv3 的算力,成本非常高昂。这也促使我们去了解硬件。
7. Hardware Foundations: Three Pillars
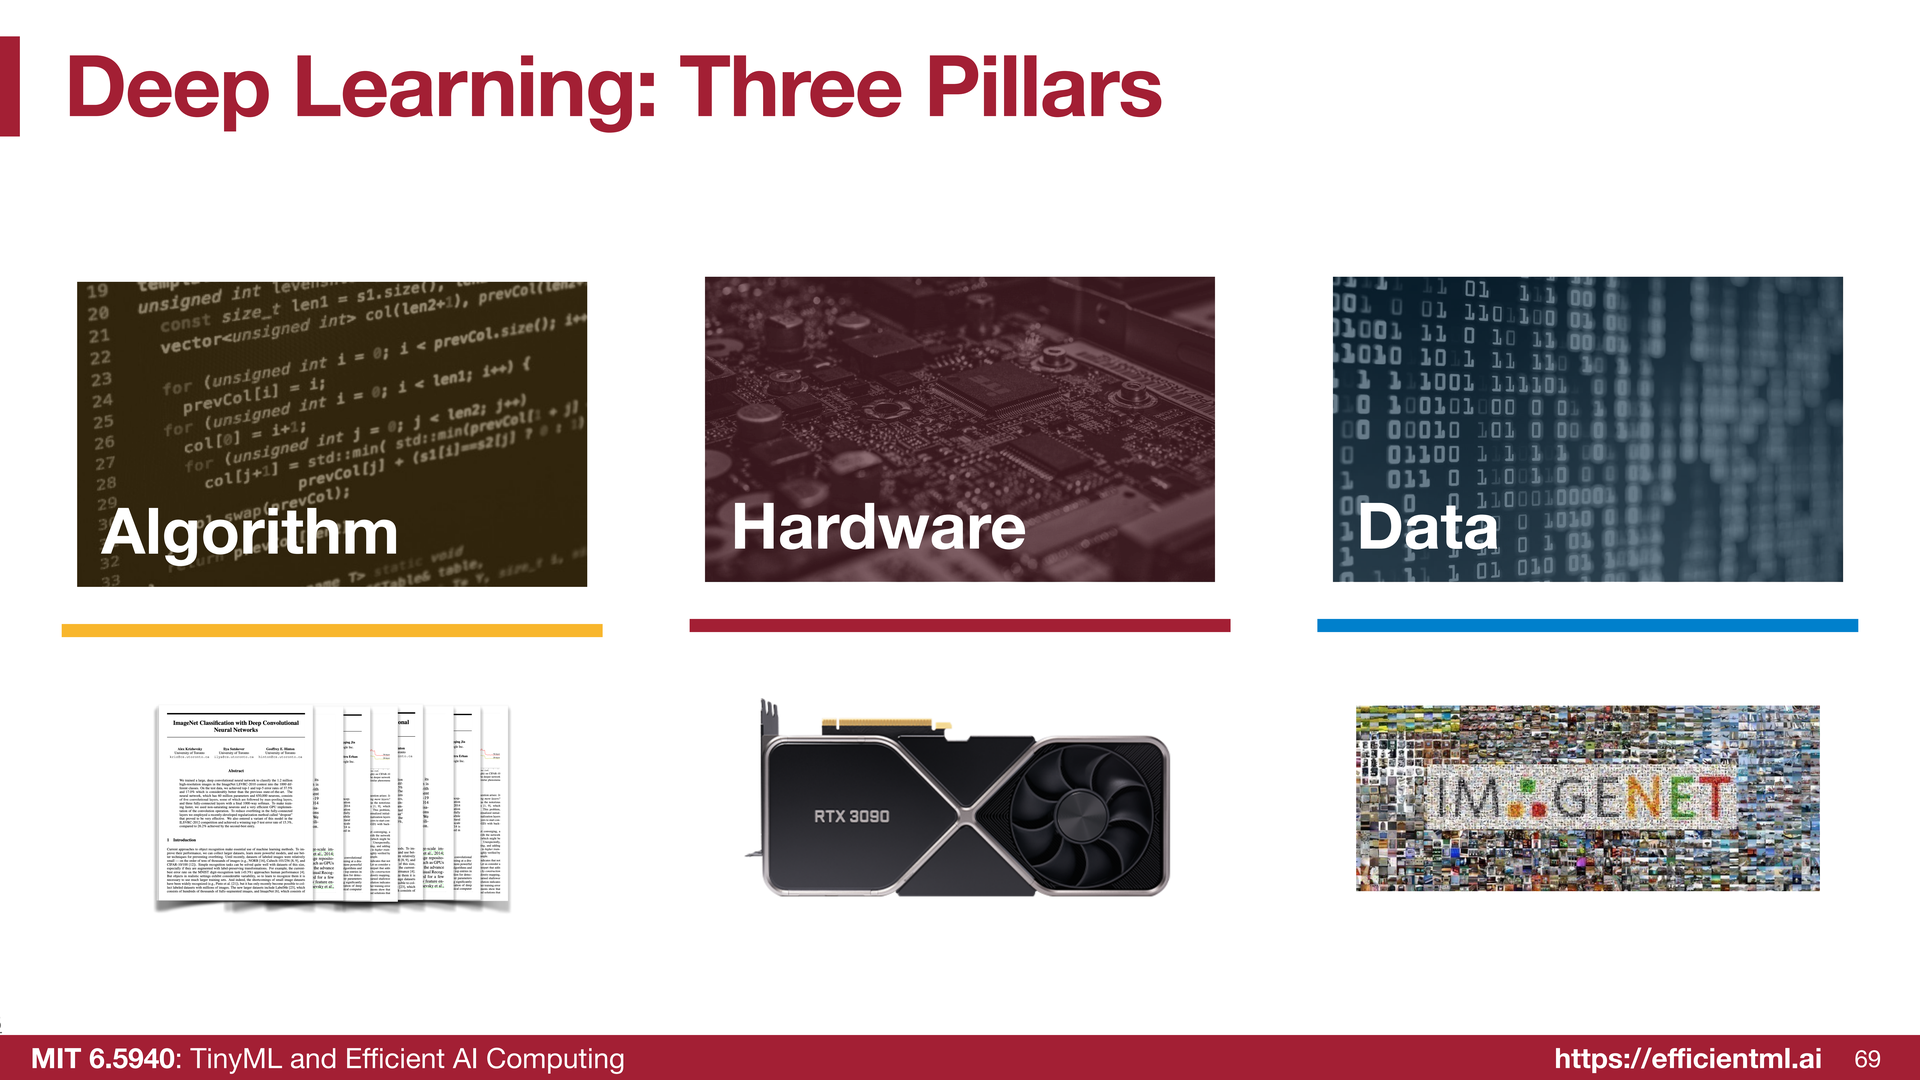
算法、硬件和数据,这是高效深度学习计算的三大支柱。
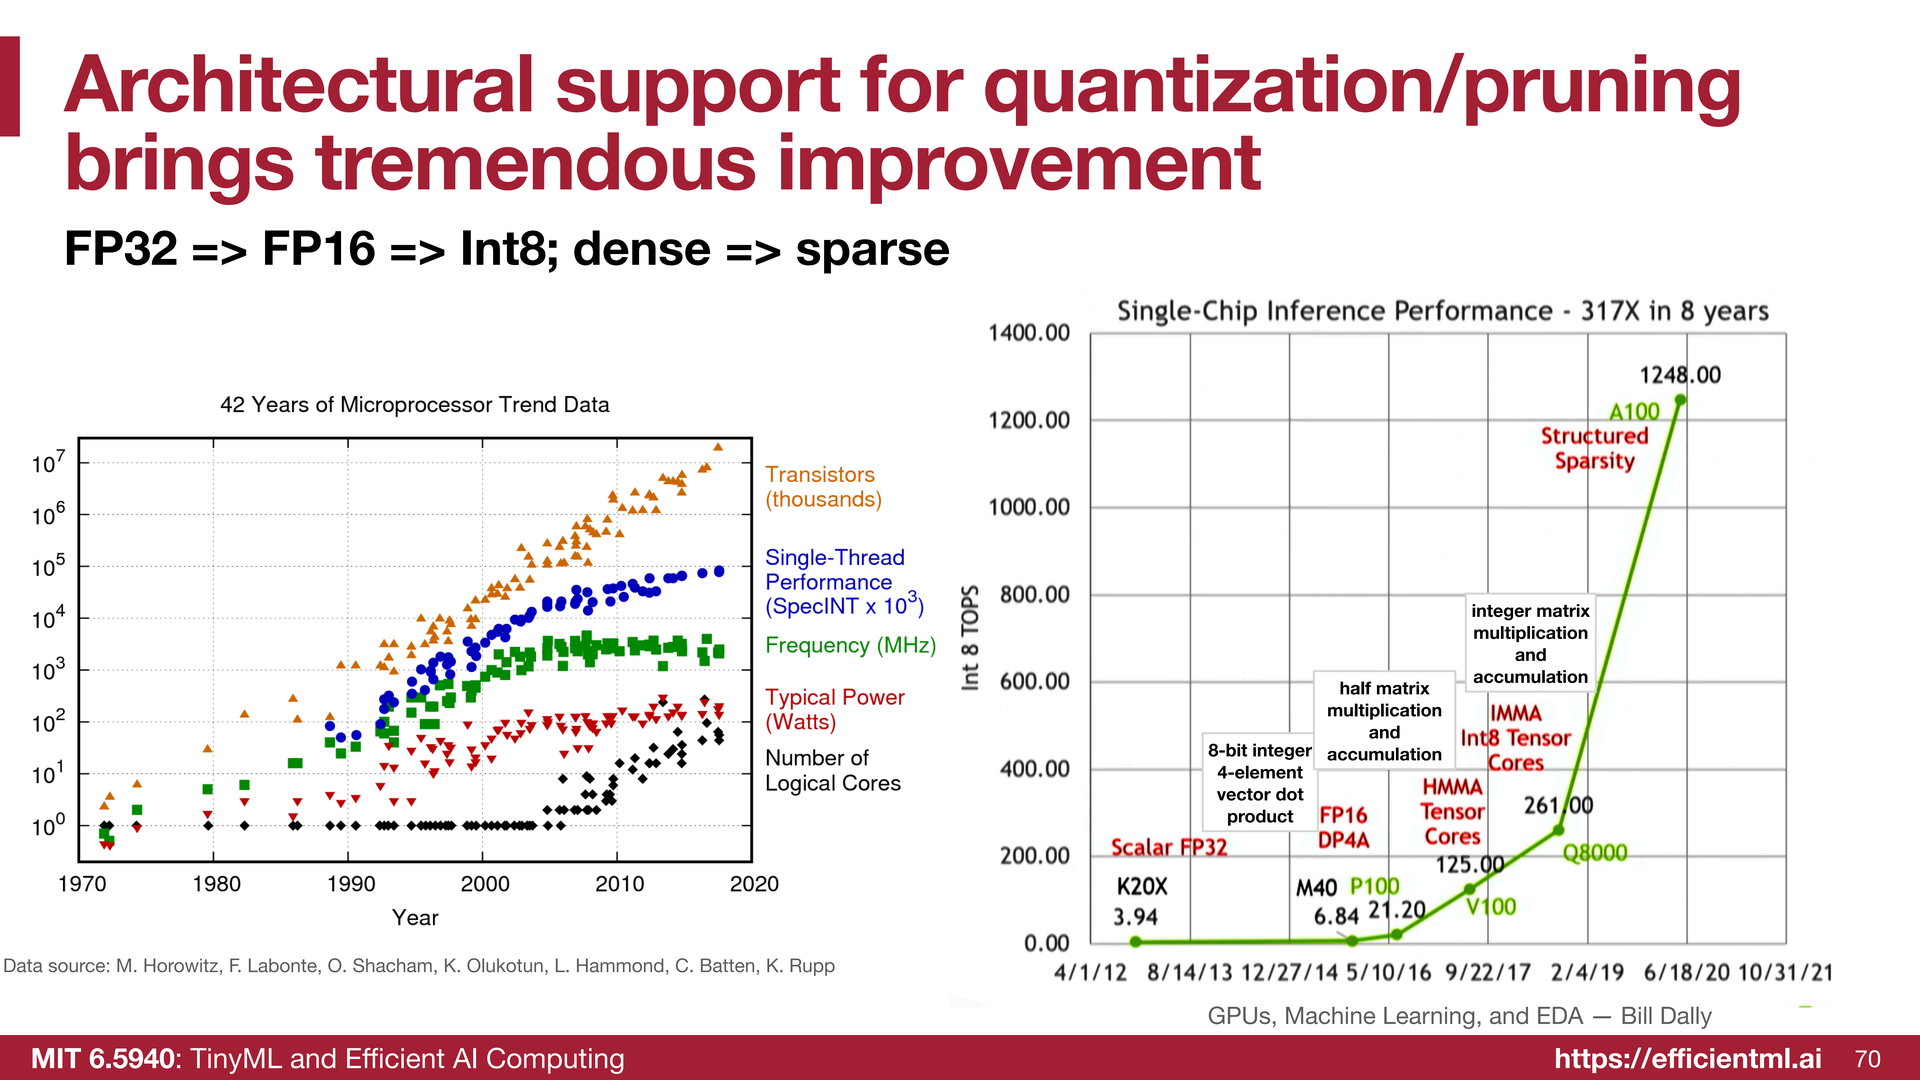
这是在 GPU 和高效硬件平台上运行这些模型所需的架构支持概览,也是从 1970 年到 2020 年共 50 年的微处理器趋势数据。微处理器在不断演进:近年来核心数量持续增加,晶体管数量也在增加,但 单线程性能几乎停滞,典型功耗也停滞了 。所以并行处理变得非常重要 。算法、系统与代码的协同设计也变得重要,因为 单靠摩尔定律、单靠晶体管微缩,不再能提供更多算力,你需要大量软件和算法技术。
比如右图,这是英伟达 GPU 上单芯片的推理性能,八年里相比 P100 提升了 300 多倍 。从 Volta 开始引入了 DP4A 指令和 HMMA Tensor Core :一条指令就能完成一个小矩阵块的乘加,节省了大量指令开销;还有 INT8 以及结构化稀疏,它们持续提升着 GPU 的性能。
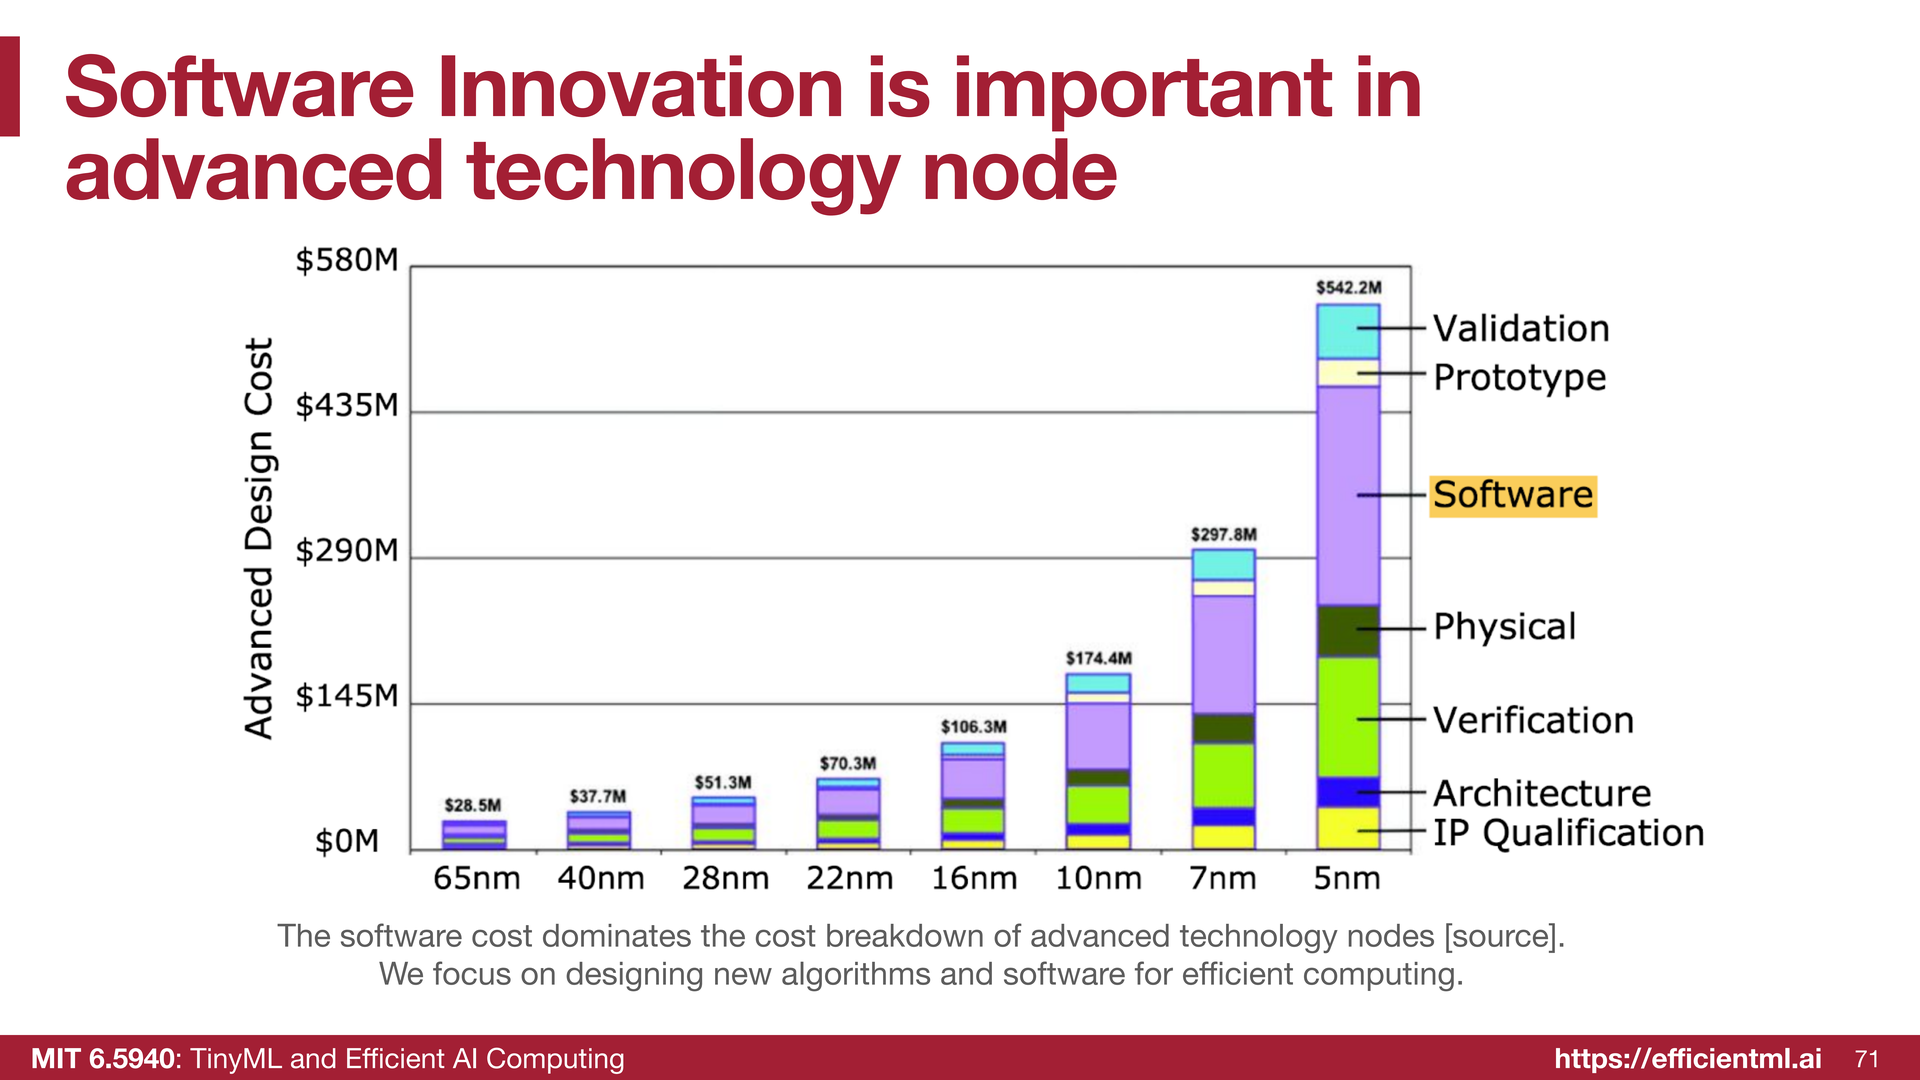
如果你看先进制程节点成本的构成,会发现 紫色部分(软件)占比最大 ---从左边 65 纳米到右边 5 纳米。软件变得越来越重要 。所以 这门课讲的全是软件。我们会用到硬件,但不会在这门课里设计新硬件。我们要学的是纯软件技术:如何提高硬件的利用率,以及如何提升模型的效率---让模型更小,需要更少的内存、更少的计算。
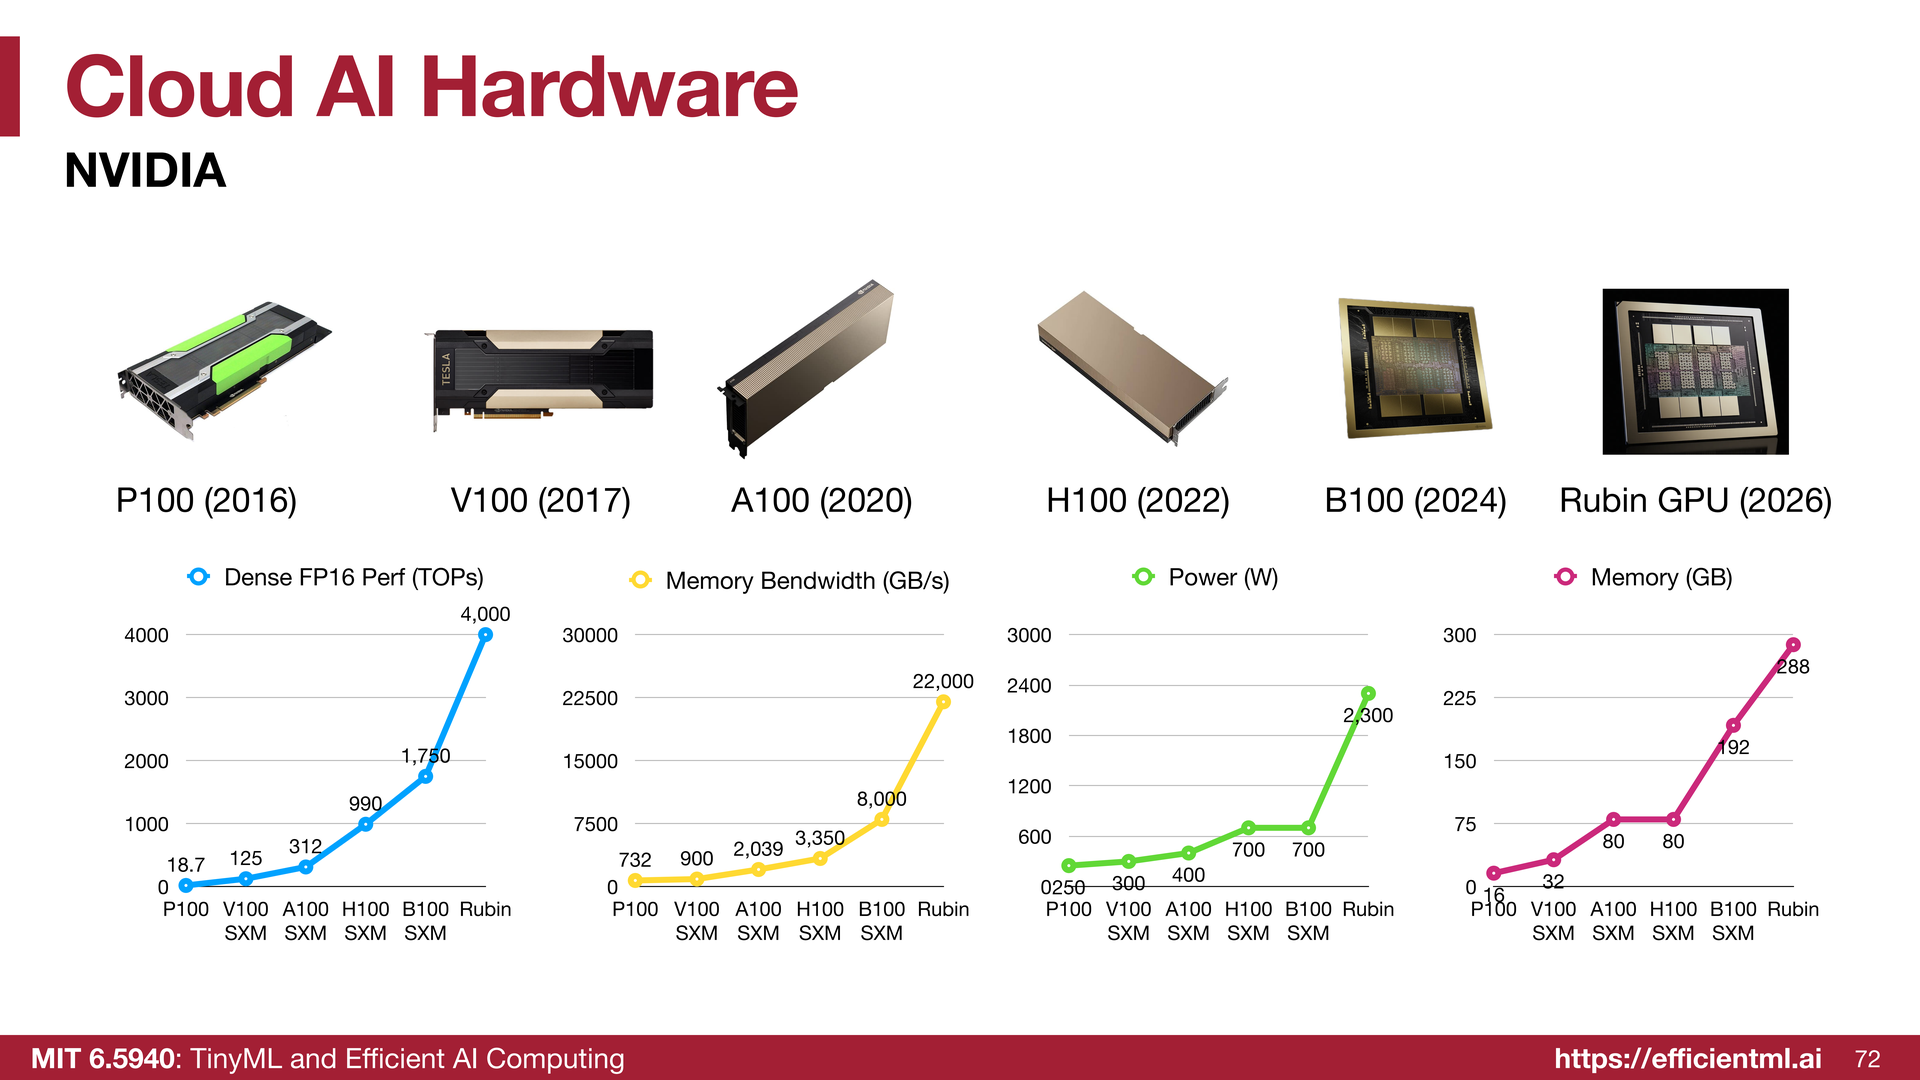
这里是云端 AI 硬件的发展历史:从 P100(Pascal)到 V100(Volta)、A100(Ampere)、H100(Hopper)、B200(Blackwell),再到如今的 Rubin 架构 。这里展示了 FP16 性能,单位是 TOPS:A100 大约 300 TOPS,现在已经到 4000 TOPS。内存带宽也提升了很多,从 A100 的每秒 2 TB 提升到每秒 22 TB。功耗和内存容量也大幅增加。
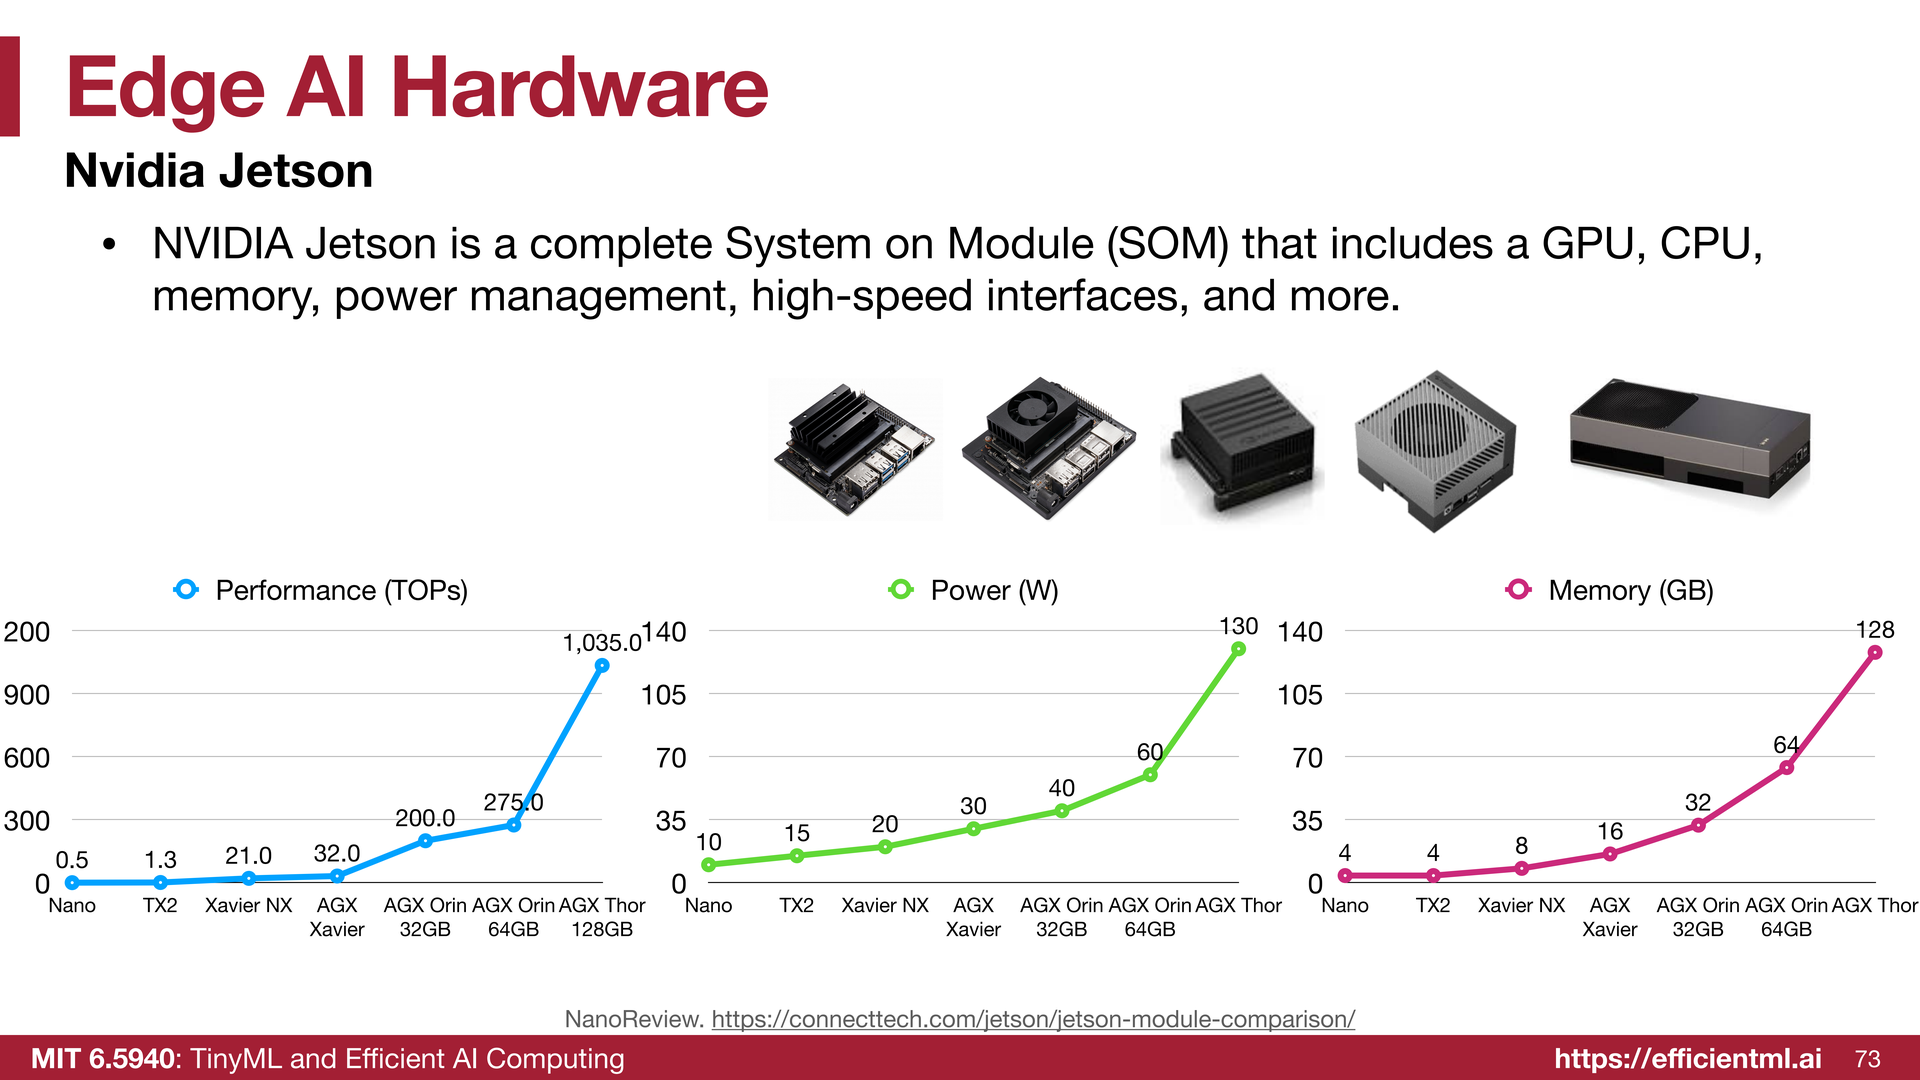
这里是常见的边缘 AI 硬件平台---Jetson 系列 。过去几年它们的性能提升得相当快:功耗从几十瓦一路涨到如今超过 100 瓦,应用也从机器人覆盖到自动驾驶汽车。内存也增加了,Orin 大约有 64 GB,而 Thor 已经有 128 GB 了。
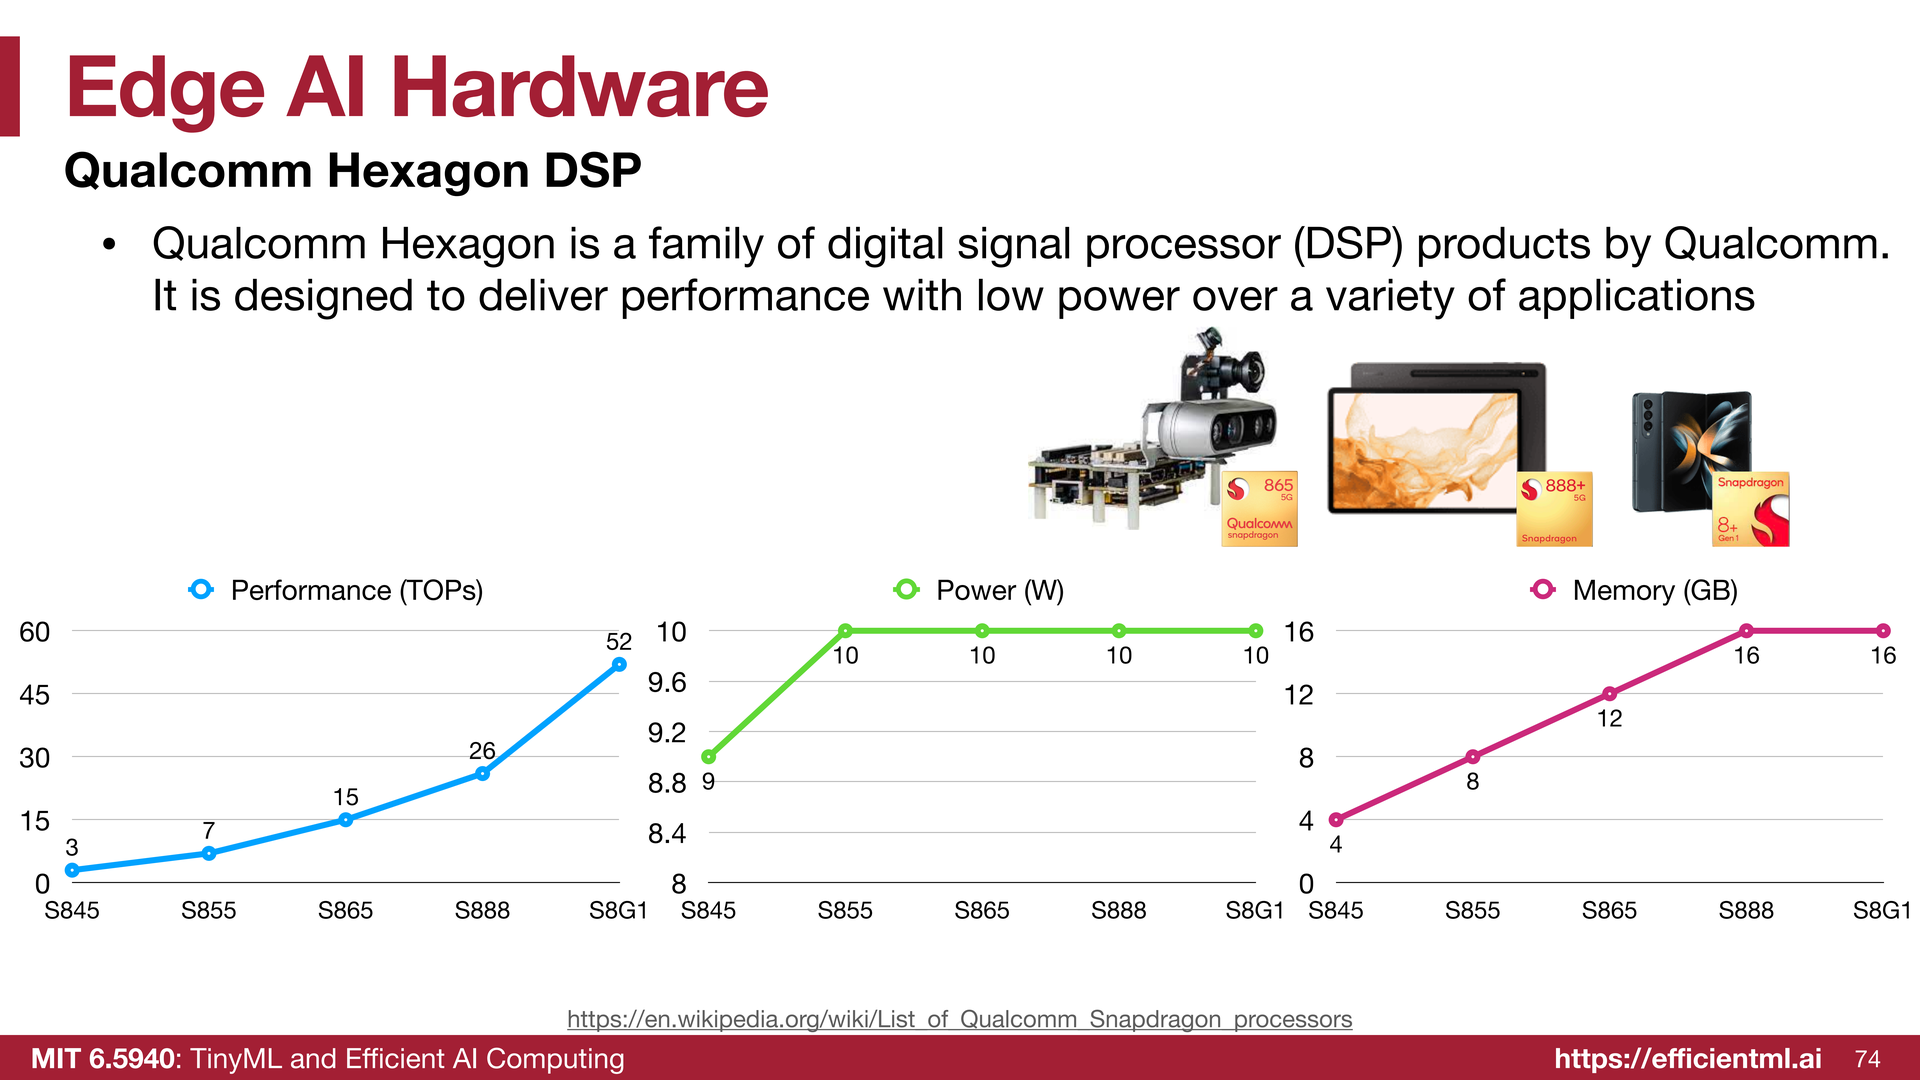
边缘 AI 硬件里我们还有 DSP,尤其是高通的。这是过去几年的骁龙芯片,功耗很低,只有 10 瓦 ,内存大约 16 GB,但 算力相当高。
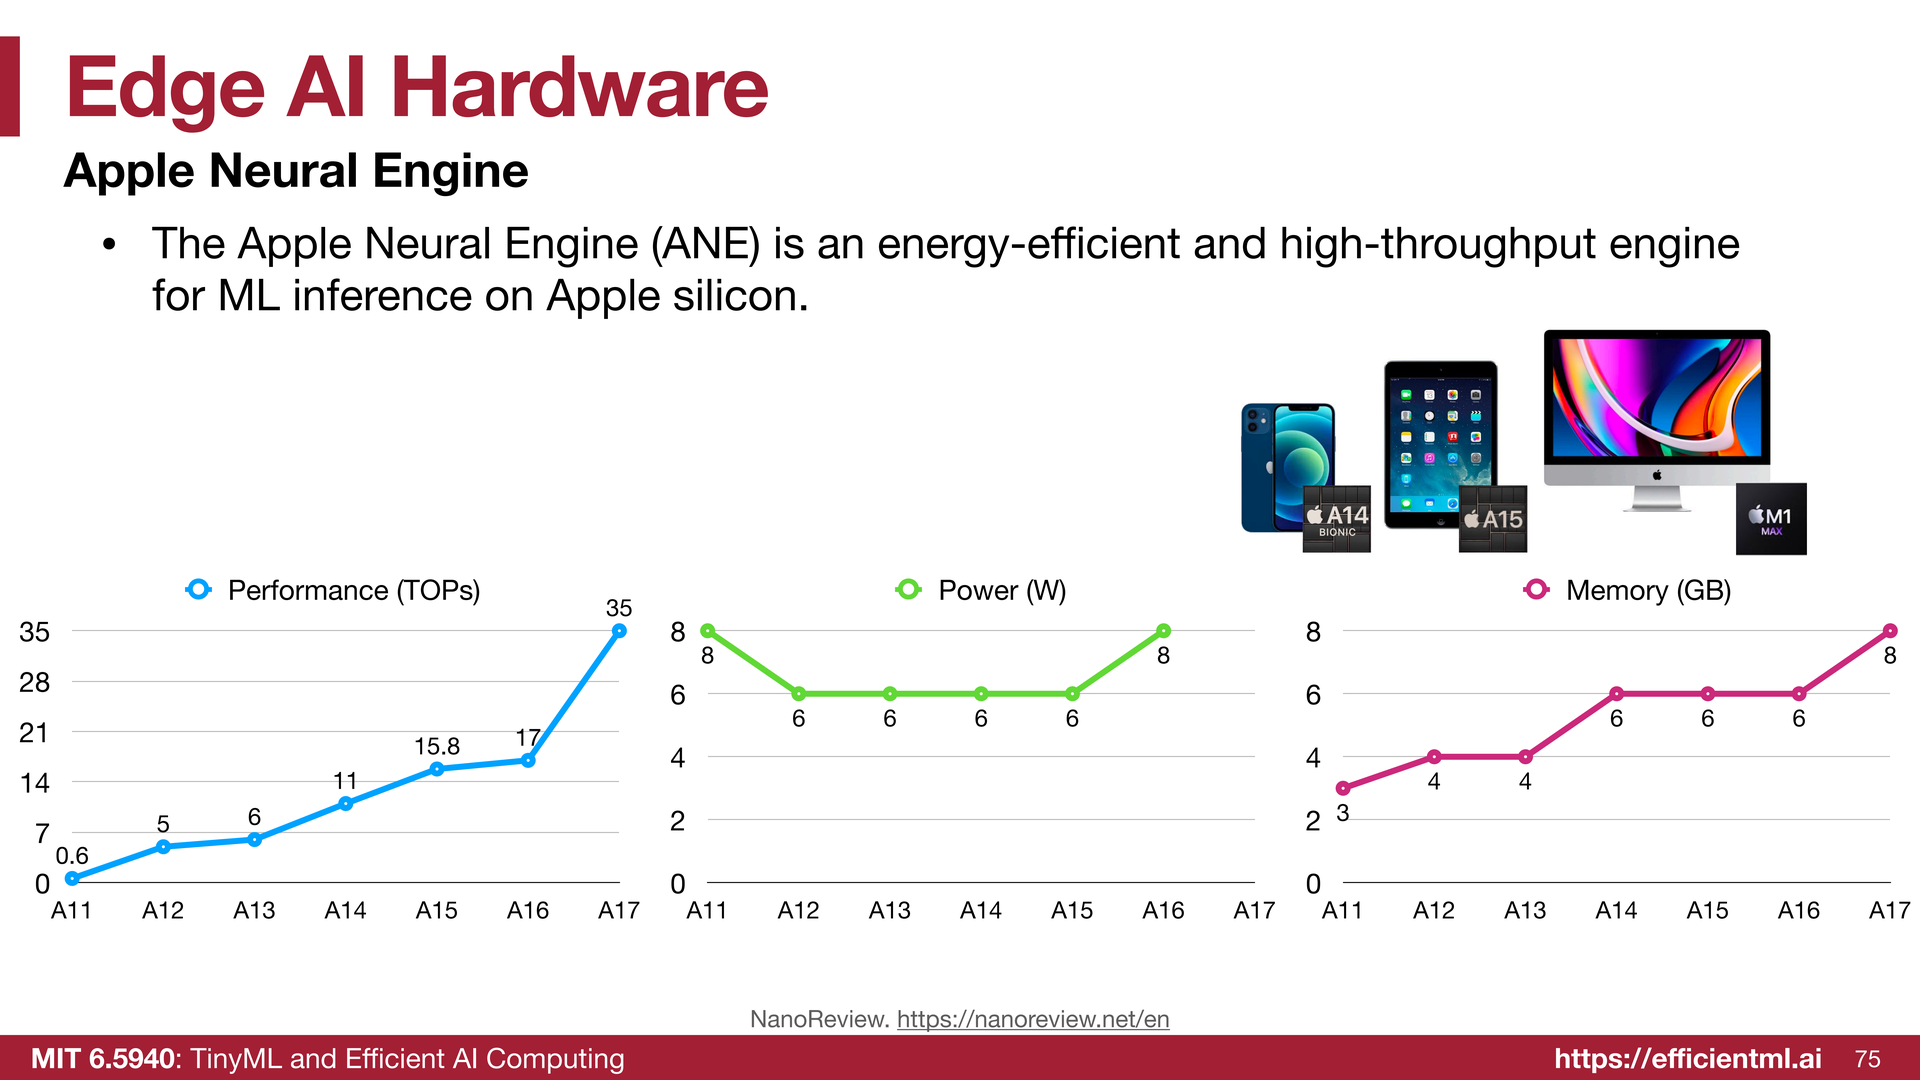
还有 NPU、神经引擎,是 能效非常高的方案,只要 6 到 8 瓦,却能提供 30 多 TOPS。
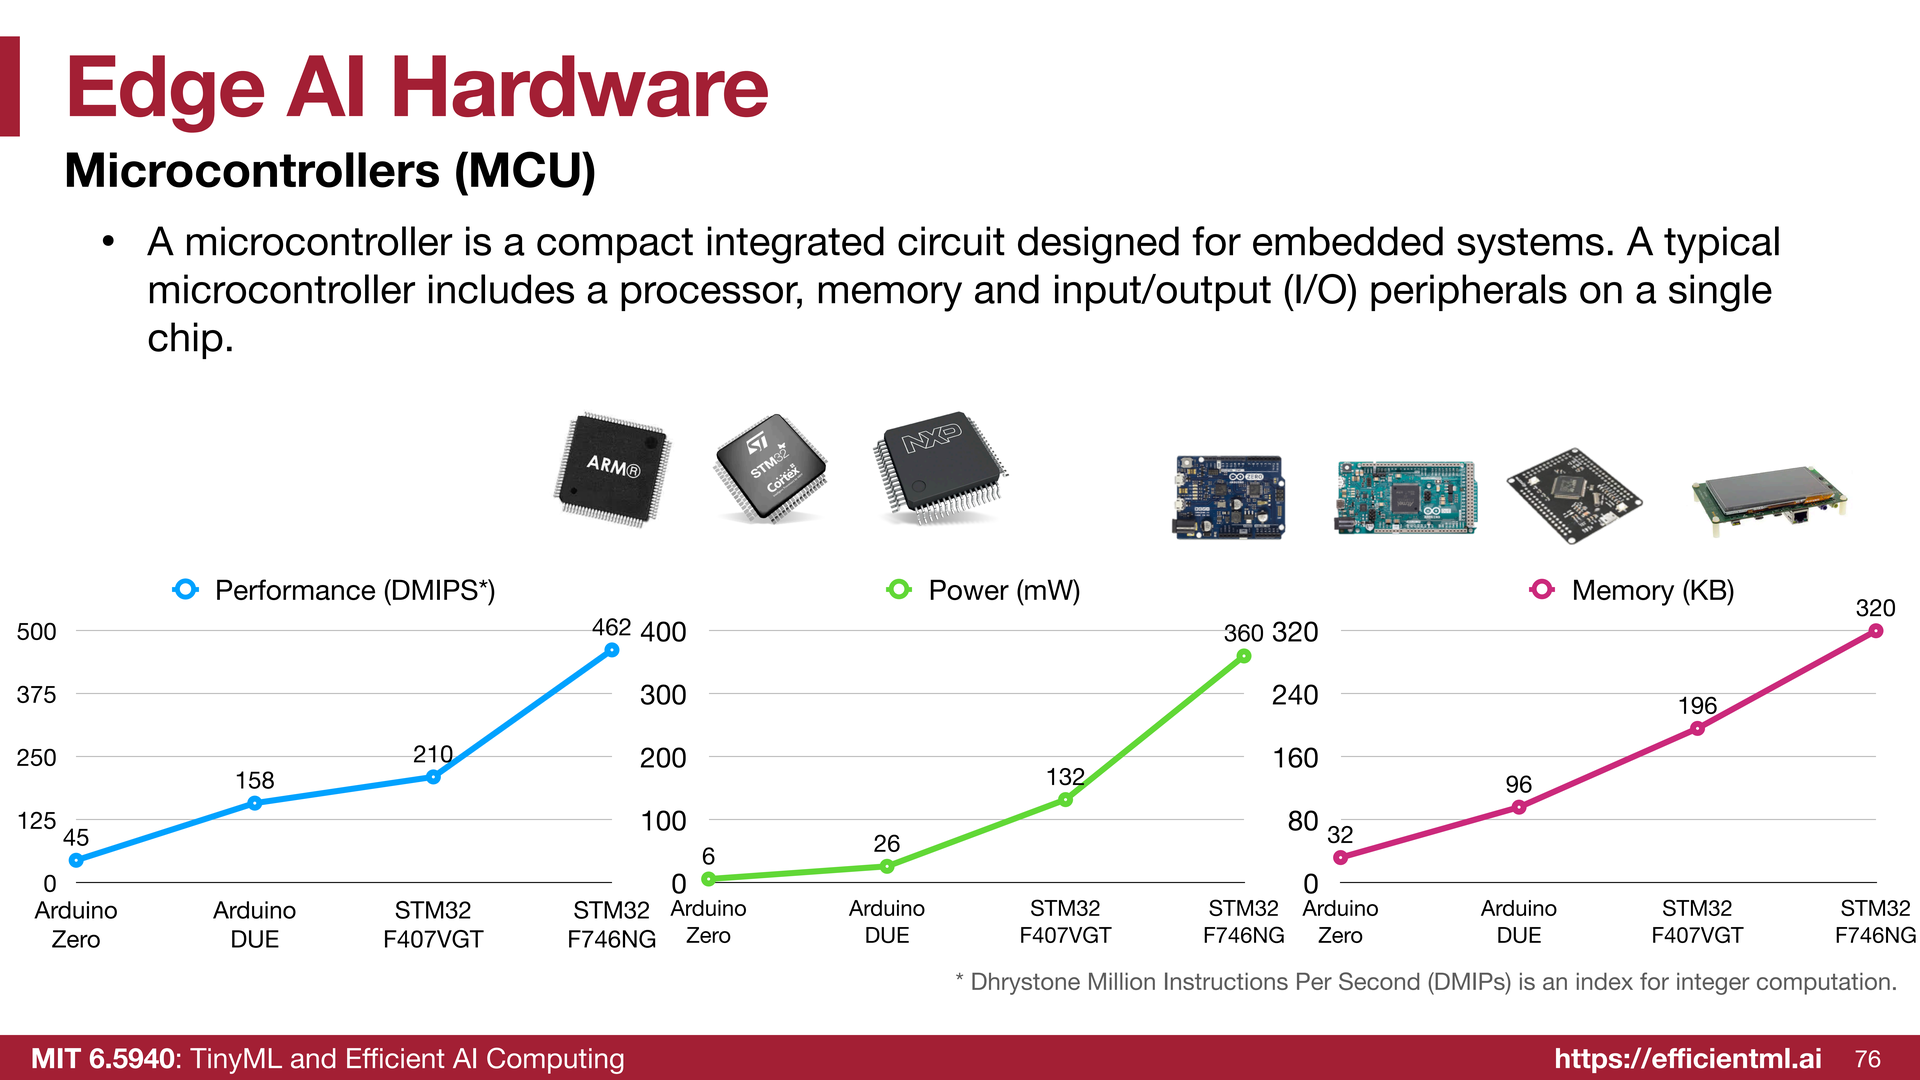
我们还有微控制器,用于这种极端廉价的场景。功耗只有几百毫瓦。我们会介绍 MCUNet 和端上训练技术 ,它们 只用几百 KB 内存就能同时承载推理和训练,这对嵌入式场景意义很大。
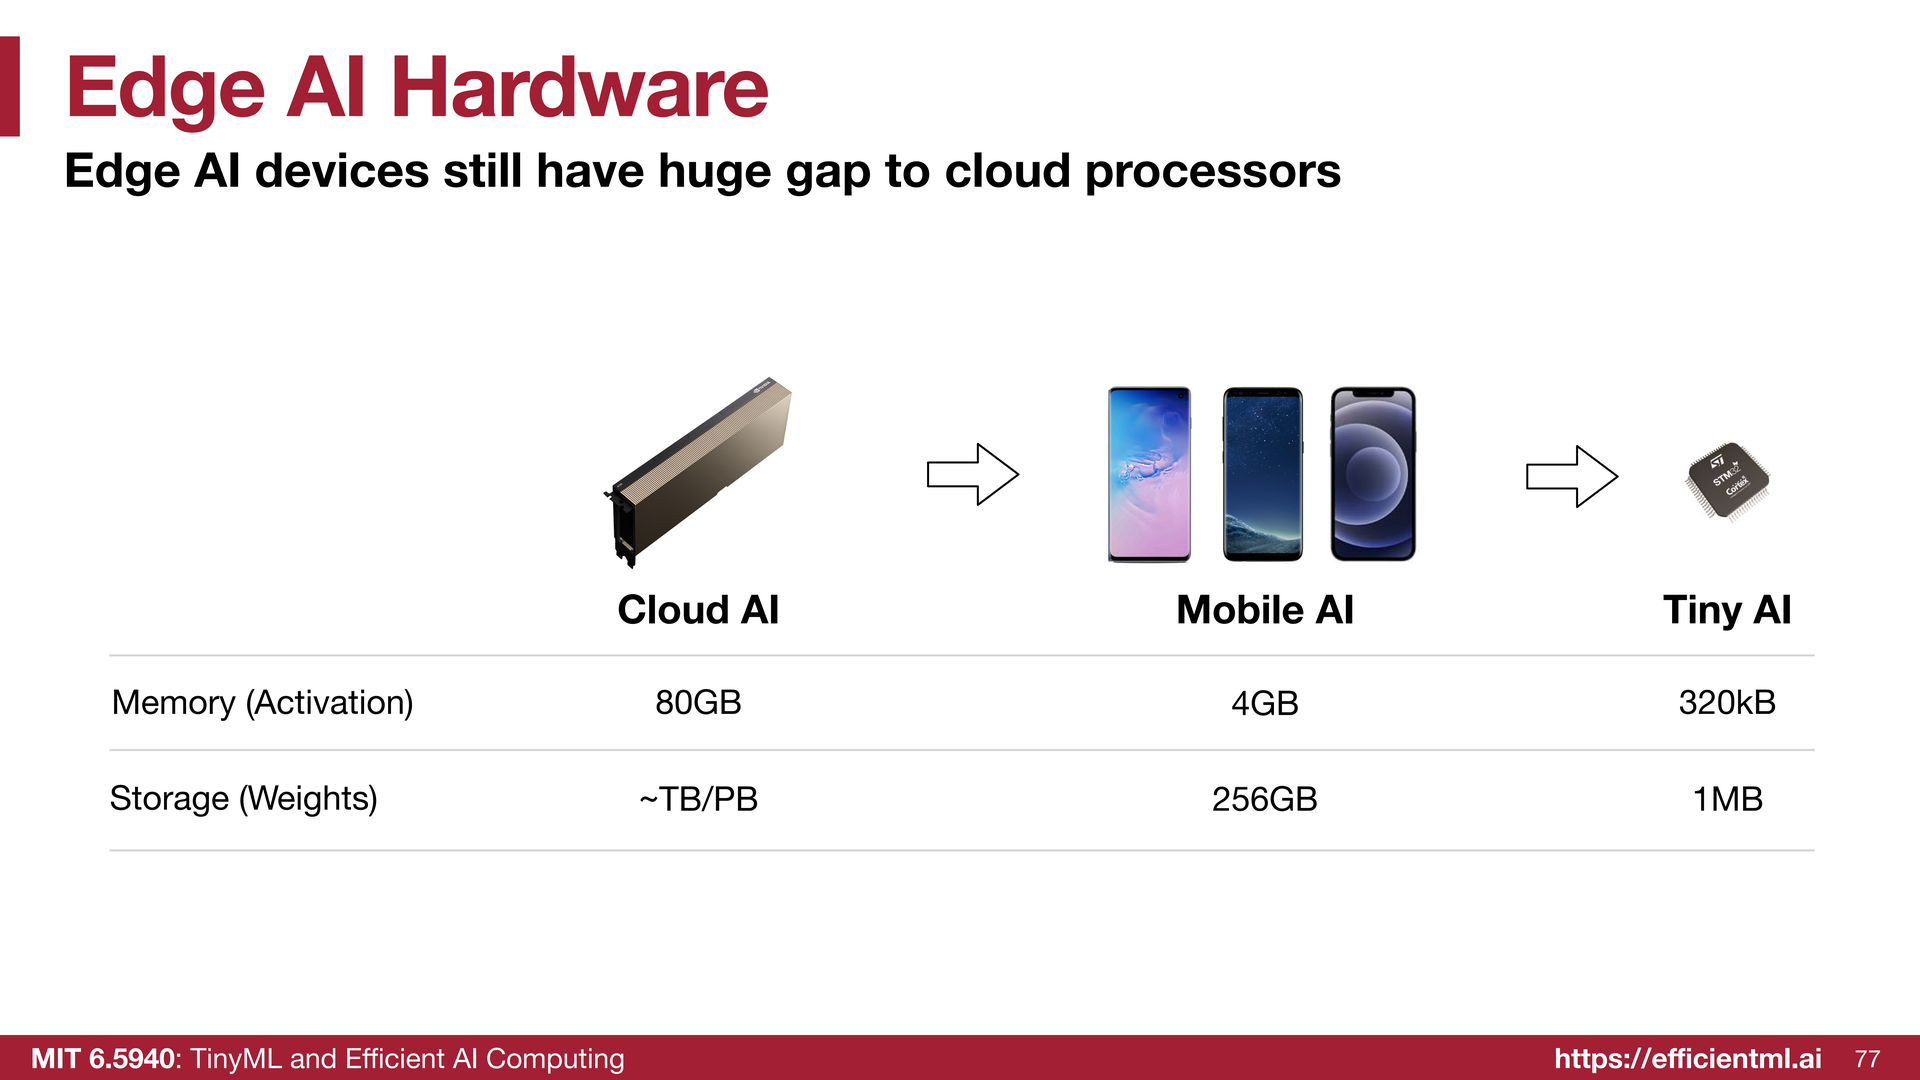
这是一个把云端 AI、移动端 AI 和微型 AI 做对比的概览:云端是几十到几百 GB 内存、TB 甚至 PB 级存储;移动端是 4 到 10 GB 内存、几百 GB 存储;而 微型 AI 跑在微控制器上,只有几百 KB 内存、也许 1 MB flash。
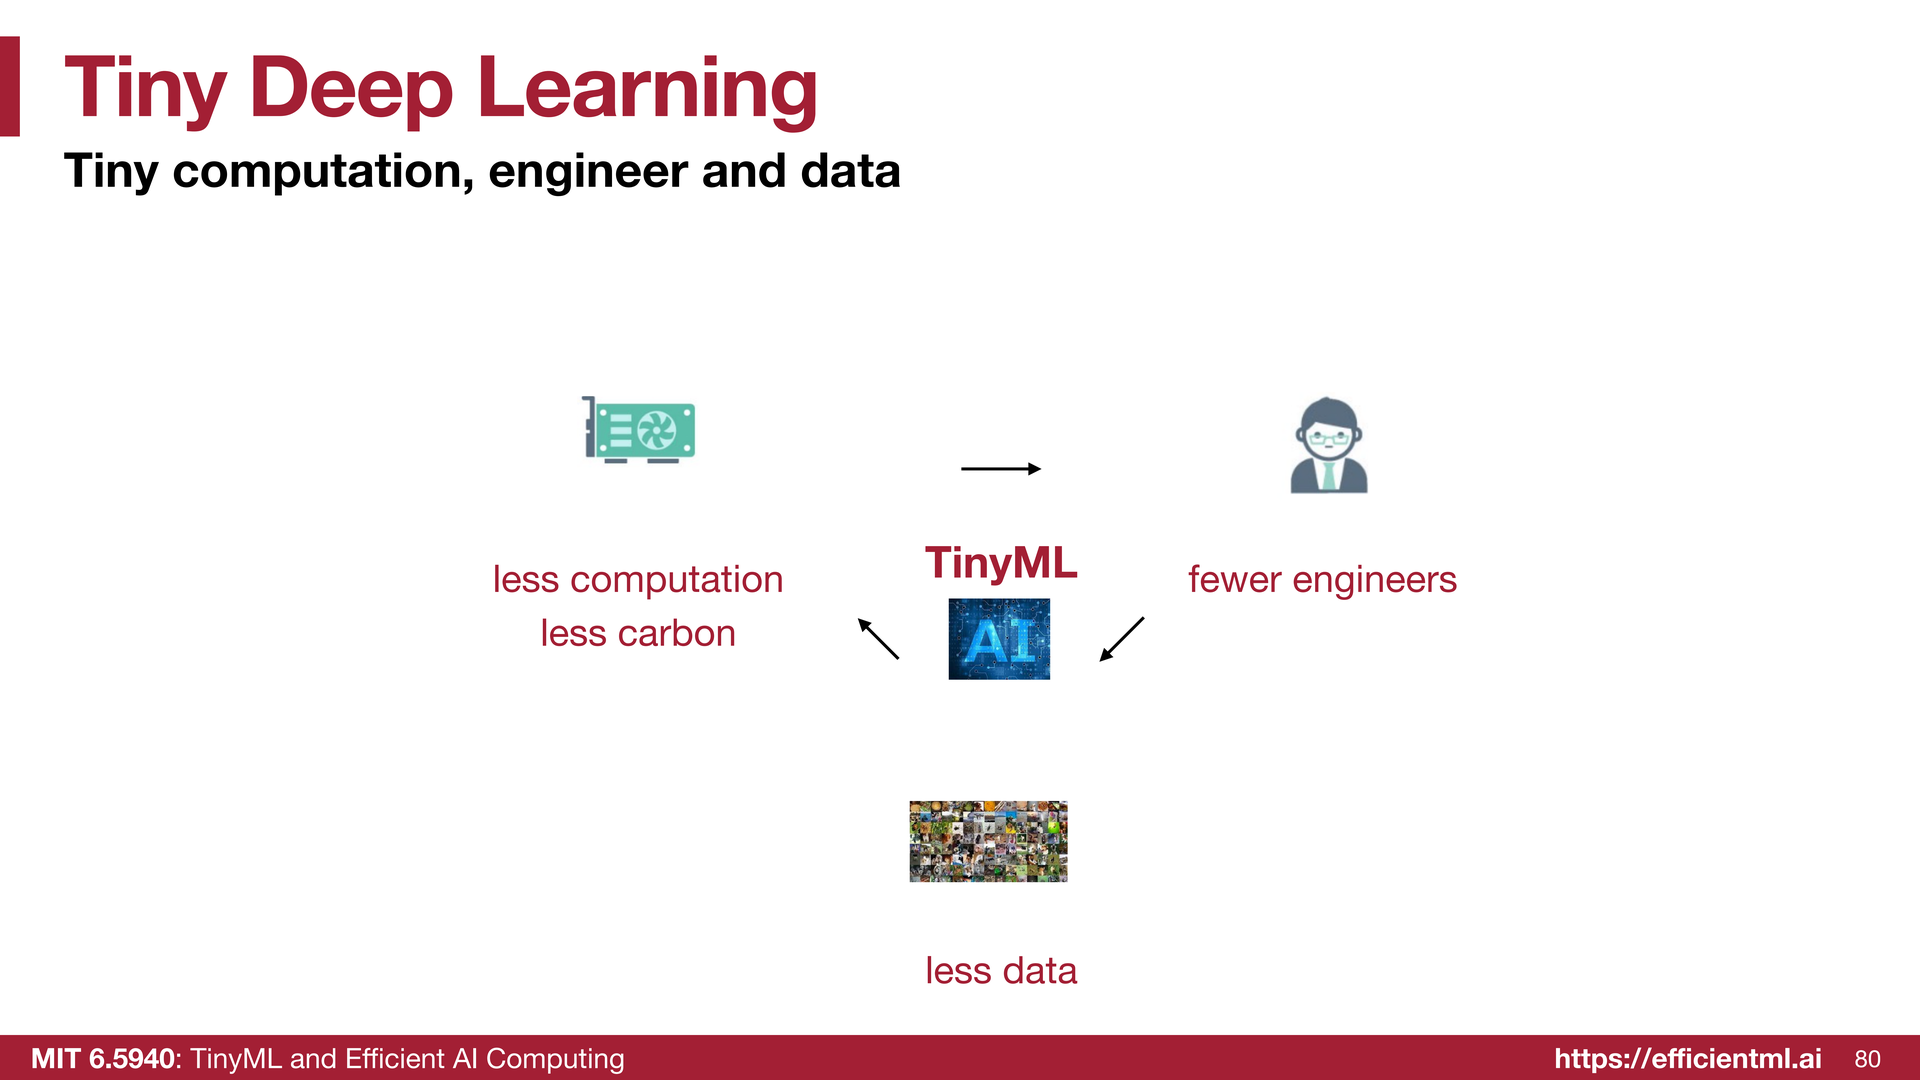
所以支撑现代深度学习计算的是三大支柱:新的算法、硬件支持和海量数据 。过去,要达到同样的精度需要大量计算、很多工程师和很多数据;而学完这门课,到学期后半程,你就能 用更少的计算、更少的工程师(因为很多流程可以自动化)以及更少的数据,达到相同的精度。
8. Course Overview and Takeaways
为了学习这些,我先快速概览一下课程安排。
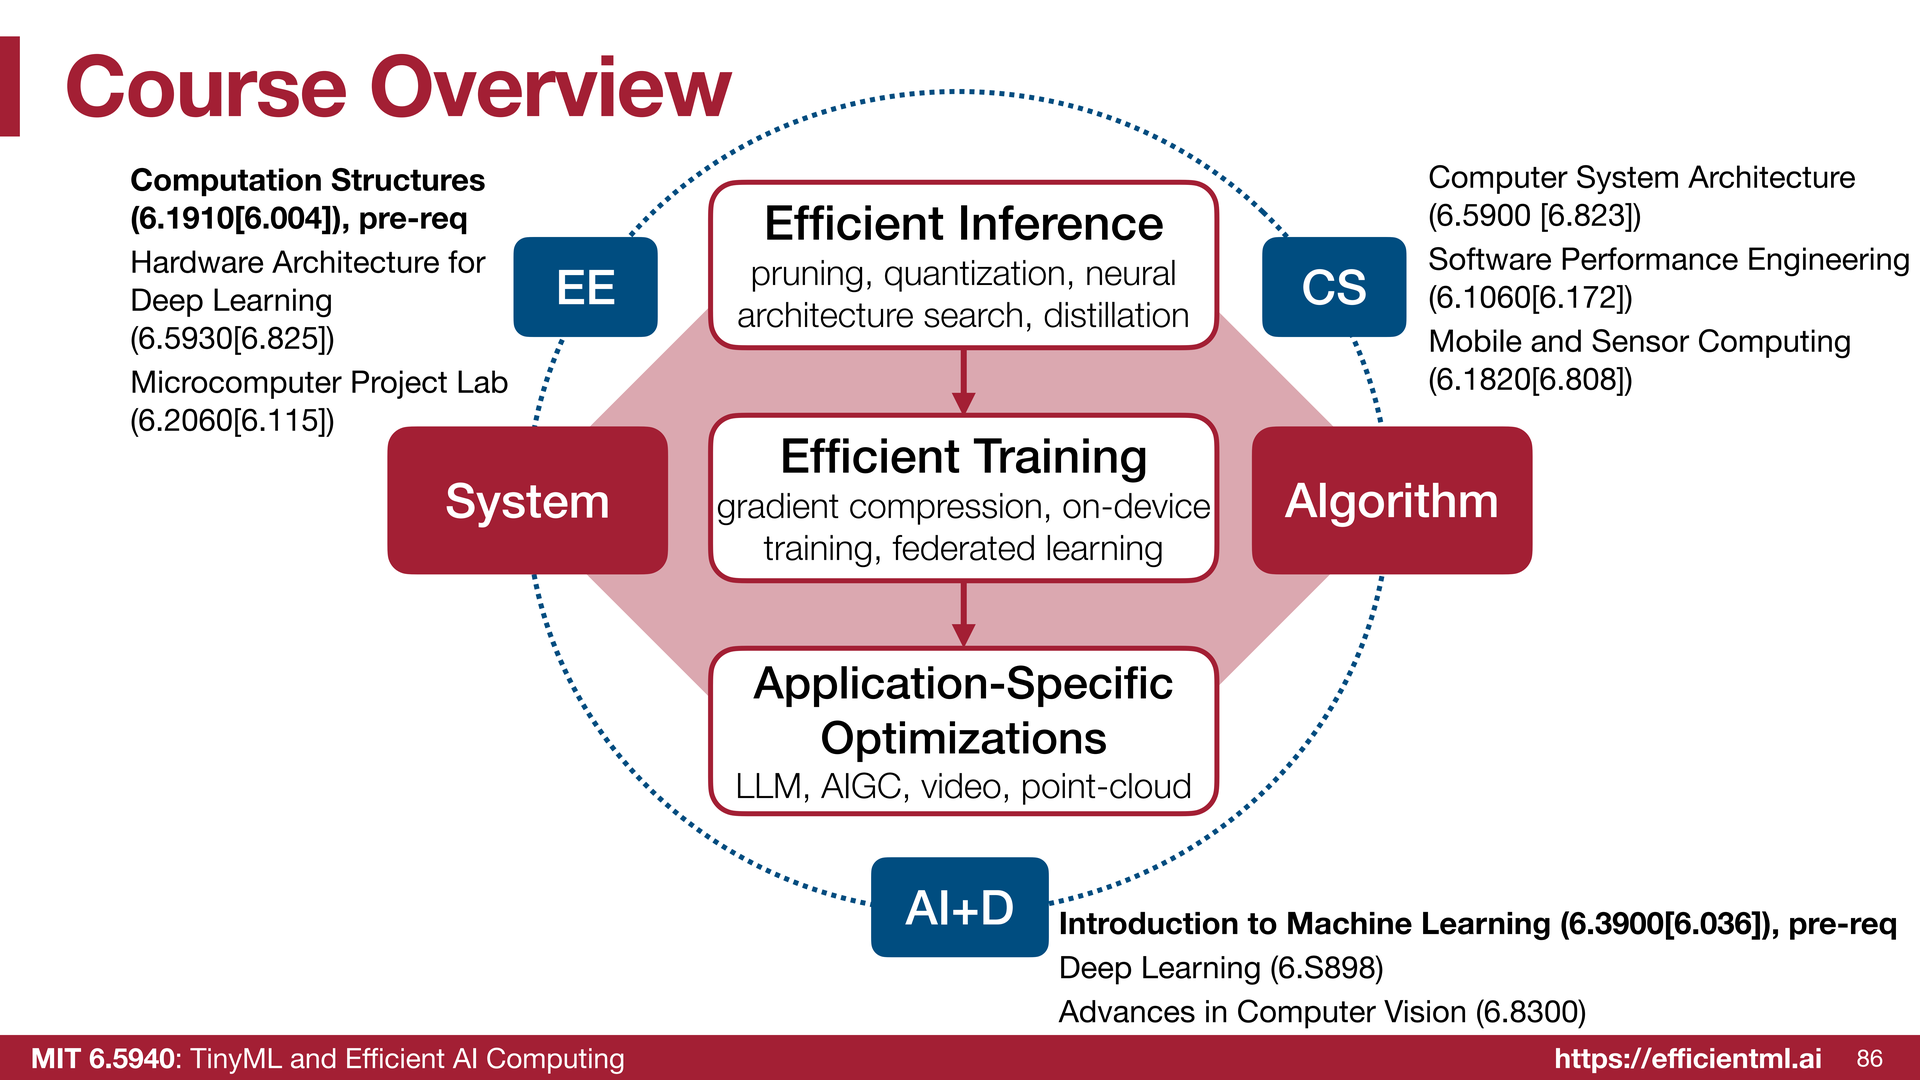
整门课大致分为三个模块:第一个是 高效推理 ,第二个是 高效训练 ,然后是 面向特定应用的优化。
推理部分我们会讲 剪枝 来减少参数数量,量化 来降低每个参数的精度,以及 神经架构搜索 来设计硬件感知、硬件友好的架构,还有 蒸馏 ---从教师模型学到一个更小的学生模型。高效训练方面,我们会讲 压缩梯度的技术、端上训练技术和联邦学习技术 。面向应用的优化方面,我们会讲 大语言模型、图像和视频生成以及点云。
在整个课程中,我们会做 系统与算法的协同设计 。这就是为什么我们要求先修课:包括机器学习的先修课和计算机体系结构的先修课。所以这就是 EE 与 CS 的交叉,也就是 EECS 的范畴。相关的 EE 课程是计算结构 6.1910,以前叫 6.004。它也和 Vivienne Sze 的《深度学习硬件架构》以及微计算机项目实验室相关。在 CS 方面,计算机系统体系结构、软件性能工程、移动与传感器计算等都高度相关;机器学习导论、高级计算机视觉、深度学习和自然语言处理也都是相关的 AI 课程。
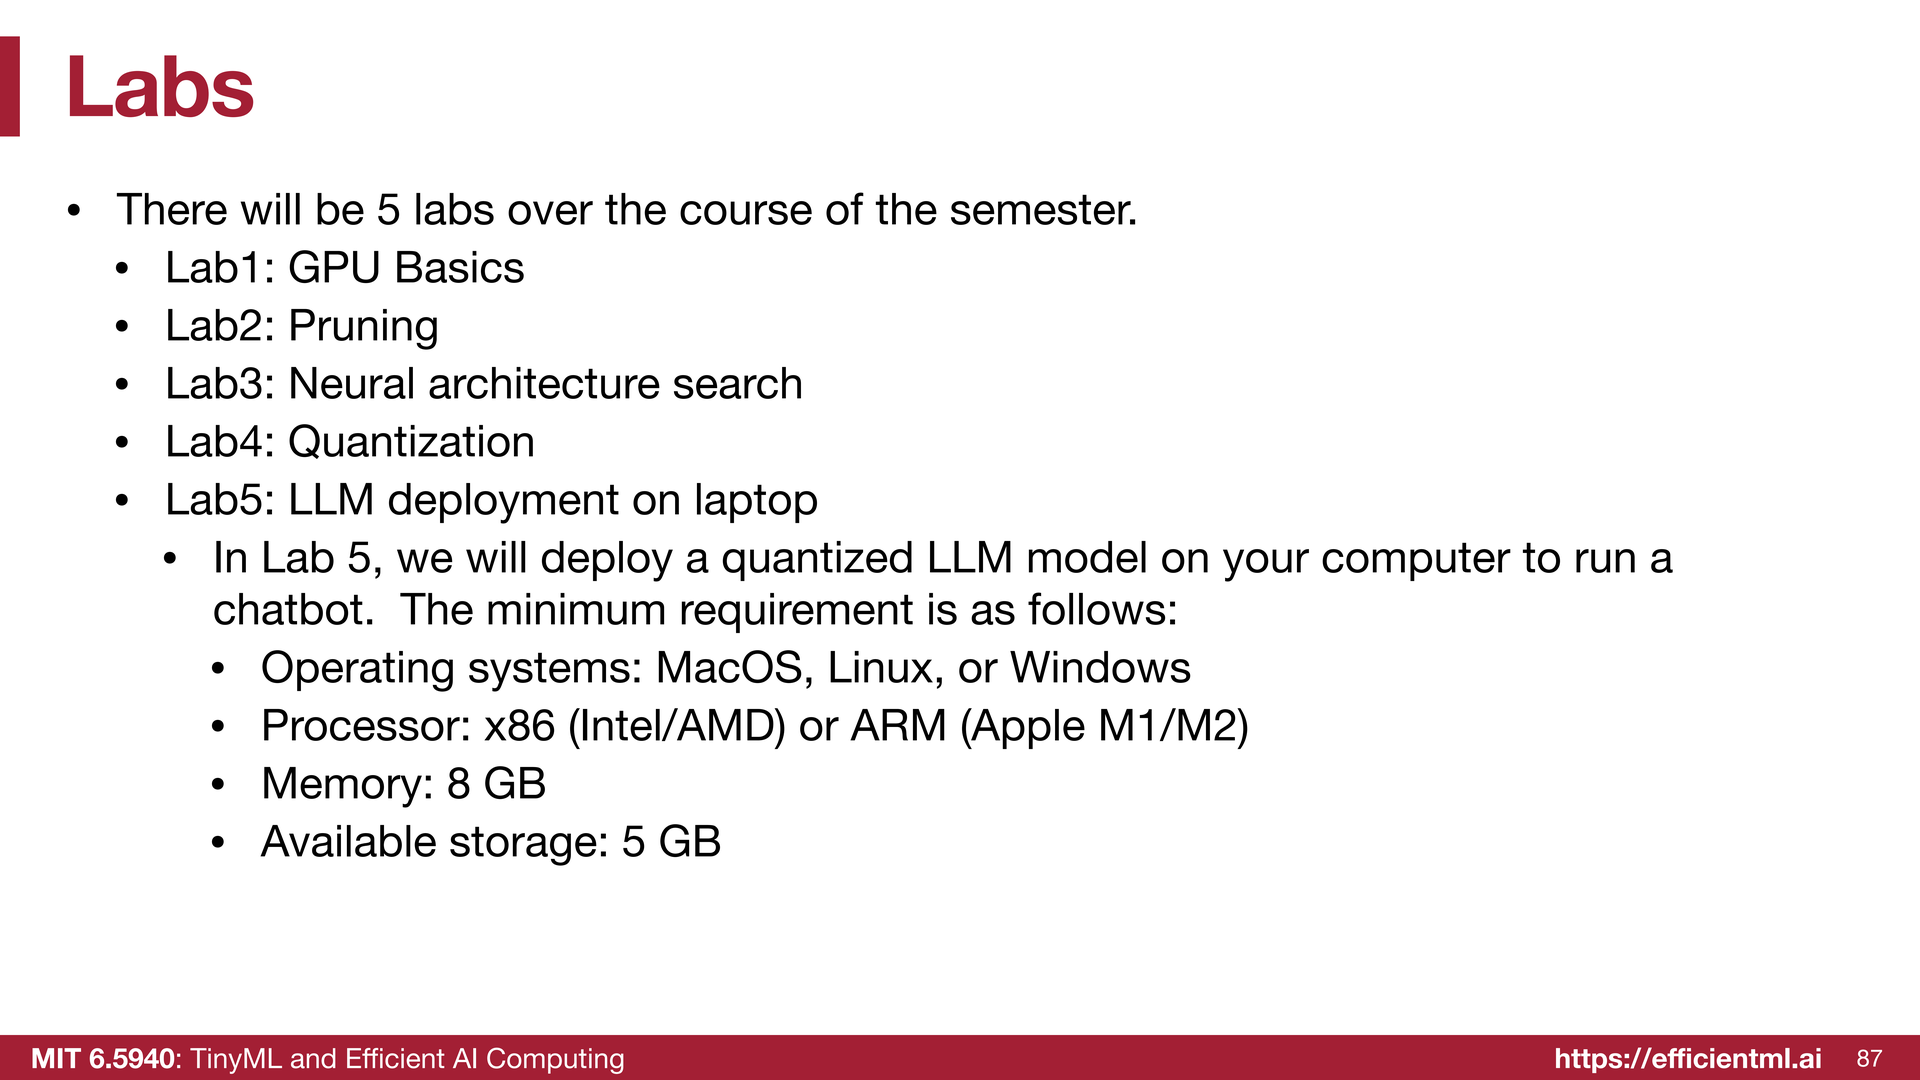
这学期我们会有五个实验,另外还有一个不计分的 lab zero,所以一共六个,其中五个计分。实验一是 GPU 基础,以及如何计数---比如如何数 FLOPs,这会非常有用:数 FLOPs 可以估计模型的计算量和推理耗时,数参数量则能估算内存占用 。实验二是剪枝,实验三是神经架构搜索,实验四是量化,实验五是笔记本电脑上的大语言模型部署。特别建议你把实验四和实验五放在一起做 :实验五做的是系统部分,实验四做的是算法部分,把它们结合起来,你就能在自己的笔记本上部署并运行一个聊天机器人。
我们的助教做了很多工作来同时支持 macOS、Linux 和 Windows 操作系统,同时支持 AMD、Intel CPU 以及苹果的 ARM CPU。你需要一台 至少 8 GB 内存、5 GB 以上可用存储空间 的笔记本,才能完成实验。
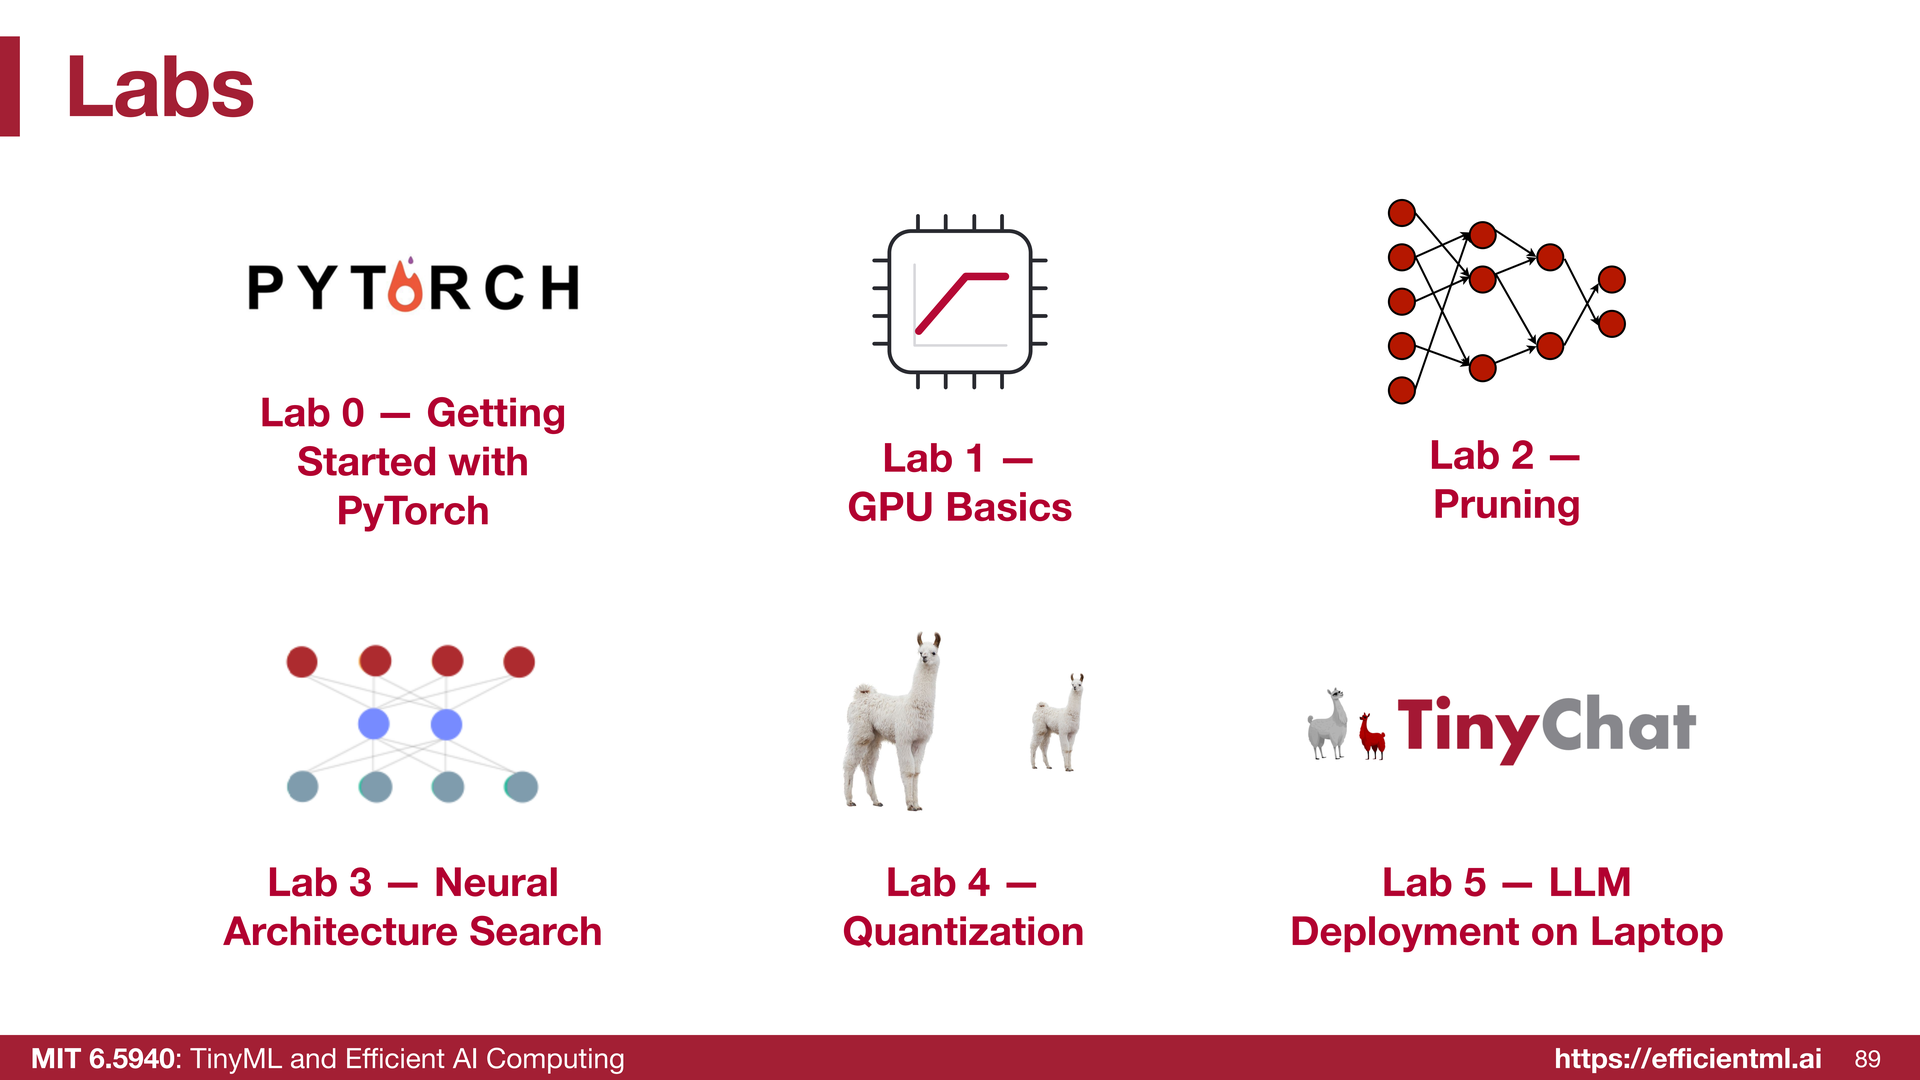
这里是全部六个实验:先是 lab zero,PyTorch 入门。我们的联合授课老师 Sean 会在下一讲教我们 PyTorch 的基础知识。接下来实验一是 GPU 基础,实验二是剪枝,实验三是神经架构搜索,实验四是量化,实验五是大语言模型部署和 TinyChat Engine。
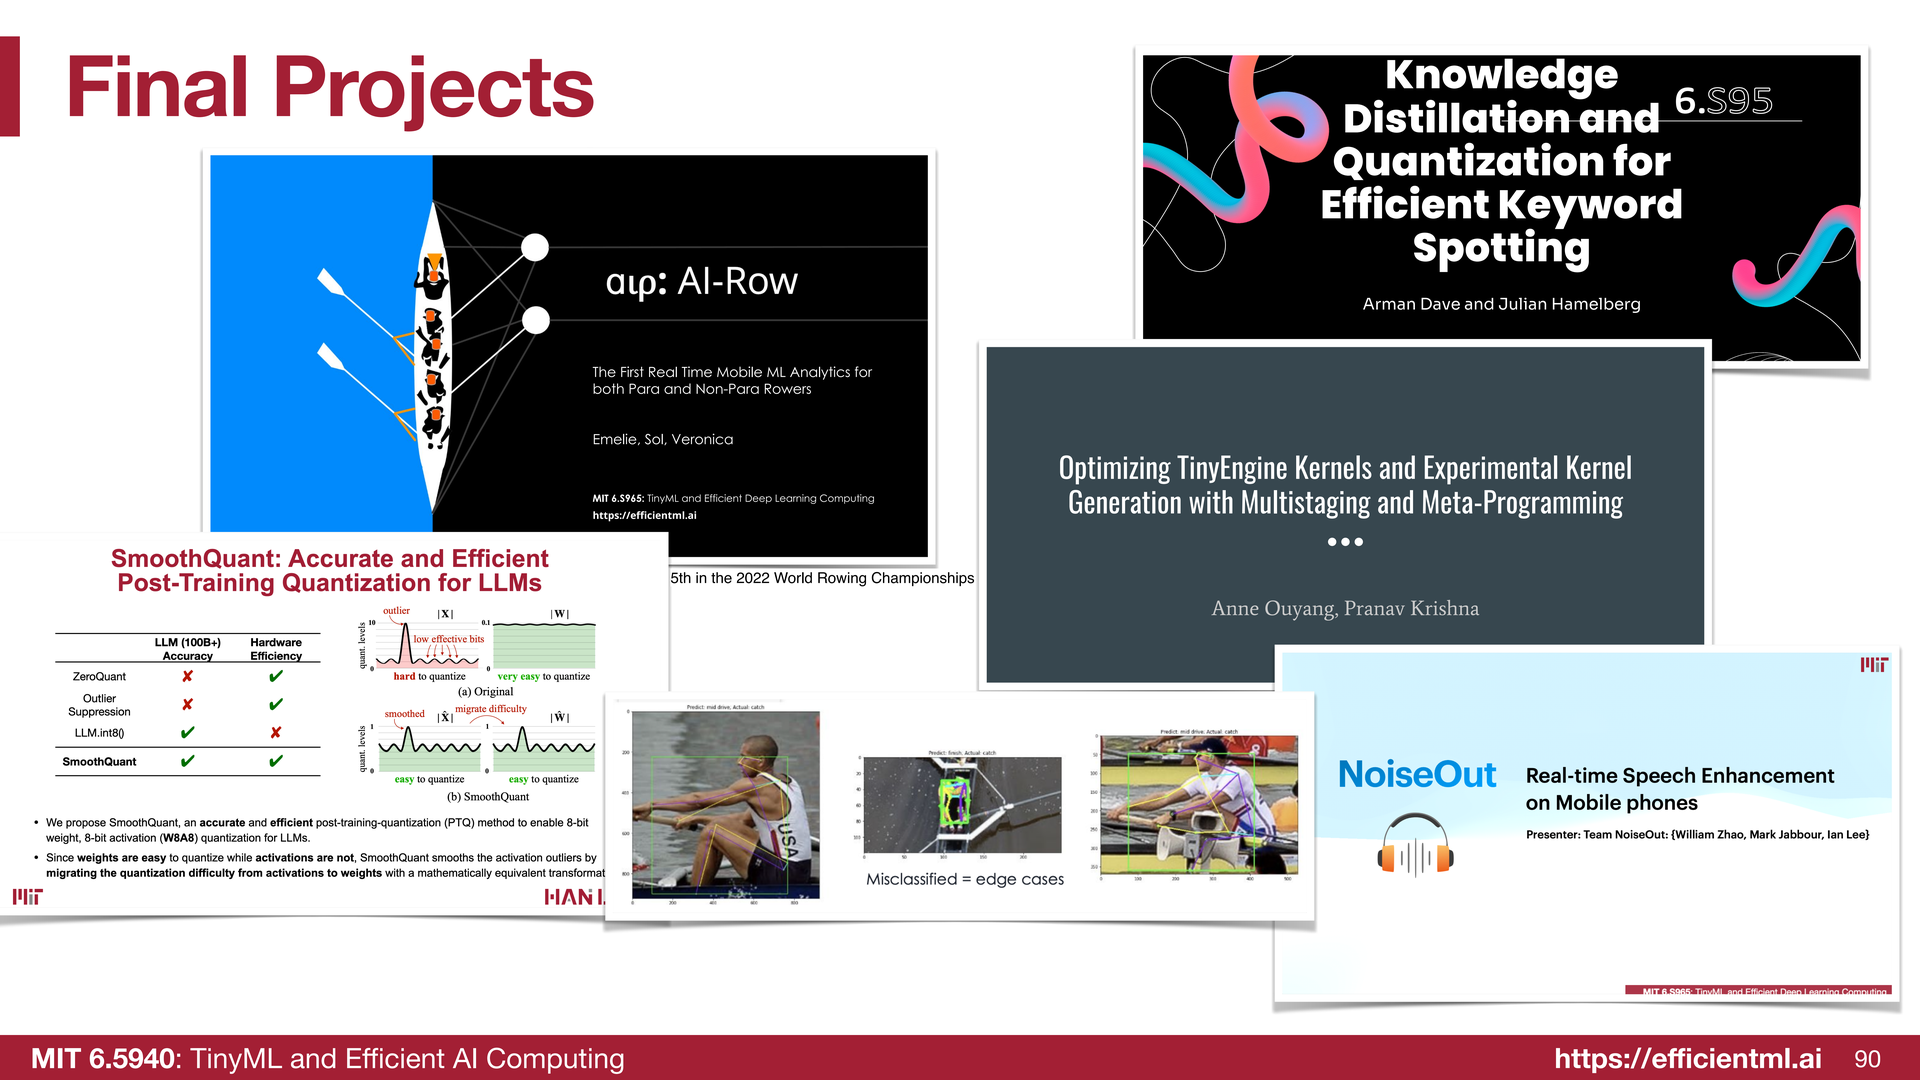
这里是一些上学期的期末项目。比如其中一个是 SmoothQuant,最早可以追溯到 2022 年,它已经成为大语言模型中广泛使用的量化技术,被英伟达的 TensorRT-LLM 采用了 ,这位学生(Guangxuan)现在在 Thinking Machine Lab。其实 很多作业和项目都可能非常有价值,SmoothQuant 只是其中一个例子,我希望几年后你们的某些项目也能产生很大的影响。
下面是本讲的要点。
我们了解了深度学习计算的效率指标。这门课结束后,你会熟悉如何加速推理和训练,理解不同优化技术之间的取舍,并且跟上最新的研究趋势 。我们会读很多论文,非常贴近工业实践,最后 获得亲手压缩和部署大语言模型的实战经验。
OK,以上就是本次讲座的全部内容了。
结语
第一讲与其说在讲技术,不如说是在立论:为什么我们需要高效 AI。韩松老师用一组贯穿全场的曲线给出了答案---模型规模在对数坐标上一路突飞猛进,从 AlexNet 的 600 万参数涨到今天的数万亿,而 GPU 显存只是从 P100 的 16 GB 缓慢爬到 Rubin 的 200 GB 出头,供需之间那道越拉越大的缺口,正是这门课要解决的问题。而 "高精度从来不是免费的午餐" 这句话在这一讲里出现了不止一次:视觉模型超越人类的精度是用成倍的计算量换来的,零样本、少样本能力随参数量增长却明显递减回报,思维链让模型答对了题、也让输出 token 成倍变长。于是效率技术---剪枝、量化、蒸馏、神经架构搜索---就成了必由之路。
更让人印象深刻的是,这些技术在这堂课里全都是 "活的"。视觉方向上,MCUNet 把神经网络塞进只有几百 KB SRAM 的微控制器做口罩检测,端上训练靠量化感知缩放、稀疏张量更新和微型训练引擎,把训练内存从 600 多 MB 压到 141 KB,整整三个数量级,EfficientViT-SAM 在同等精度下快 48 倍,12B 的 FLUX 也能在笔记本上本地跑起来。语言方向上,SpAtten 通过剪掉冗余 token 来加速注意力,SmoothQuant 用 "让长颈鹿变矮、让蚂蚁变高" 的思路抹平激活离群值、把大模型压到 4 bit,而 TinyChat Engine 解决了半个字节跑不进按字节对齐的体系结构的问题---配合 AWQ,7B 模型能在 Jetson 上跑到每秒 30 个 token,在 4090 上从 50 提到 166。再往后是多模态与具身智能:视觉语言模型把图像 token 与文本 token 对齐到同一空间,同样吃到了 AWQ 的红利;而打乒乓球的机器人和煮咖啡的世界动作模型,把 "实时、本地、低延迟" 这几个词变得非常具体。
讲到最后,韩松老师把镜头拉回硬件。算法、硬件、数据是支撑深度学习的三大支柱,但 40 年的微处理器趋势显示,核心数和晶体管数还在涨,单线程性能和典型功耗却早已停滞,靠摩尔定律白拿算力这条路走不通了,并行与软硬件协同设计成了唯一的出口---软件在先进制程成本中的占比越来越高,这正是这门课全程只讲软件的原因。整门课会分成高效推理、高效训练和面向应用的优化三个模块,配上 lab zero 在内的六个实验,从数 FLOPs 开始,一路走到把剪枝的算法和量化的系统结合起来,在自己笔记本上跑起一个聊天机器人。就像前言里说的,希望这一系列笔记能和大家一起,把这条路一讲一讲地走完🤗。