目录
[SSE,webSocket 和HTTP chunked 这三种流式协议](#SSE,webSocket 和HTTP chunked 这三种流式协议)
[JSON Mode、JSON Schema 和 Structured Output 的区别](#JSON Mode、JSON Schema 和 Structured Output 的区别)
一次生产级LLM调用
用户请求------>业务服务------>Prompt 组装------>模型网关------>供应商 API------>流式事件------>增量解析------>前端/落库/观测
一次请求通常包含8个阶段:
-
业务请求进入:校验用户身份、租户、套餐、功能权限、请求大小。
-
上下文组装:拼 System Prompt、用户输入、历史消息、RAG 证据、工具 Schema、输出格式约束。
-
Token 预算预估:估算输入 Token,预留输出 Token,决定是否裁剪历史、压缩上下文或换小模型。
-
模型网关路由:选择模型、供应商、区域、超时参数、重试策略、限流桶。
-
供应商 API 调用:同步返回或流式返回,可能经过 SSE、WebSocket 或普通 HTTP 响应体。
-
响应解析:处理 delta、finish reason、tool call、usage、拒答、结构化 JSON、异常中断。
-
状态回写:保存完整回答、增量片段、Token 用量、调用成本、失败原因和业务状态。
-
观测与告警:记录 traceId、providerRequestId、TTFT、总耗时、重试次数、429 次数、解析失败率。
同步返回和流式返回
- 同步调用要等模型生成完全部内容,再一次性返回完整结果。
- 流式输出则是边生成边返回。
为什么Streaming能降低TTFT?
TTFT(Time To First Token)指从请求发出到收到第一个可展示 Token 的时间。
- 同步返回时,用户要等模型生成完整答案。
- 流式返回只需等到第一个片段,用户就能看到内容逐步出现。流式输出没有让模型少算 Token,它缩短的是首字等待时间。
注:面向用户展示的长文本通常优先流式返回;后台批处理和必须拿到完整对象才能提交的任务更适合同步返回。
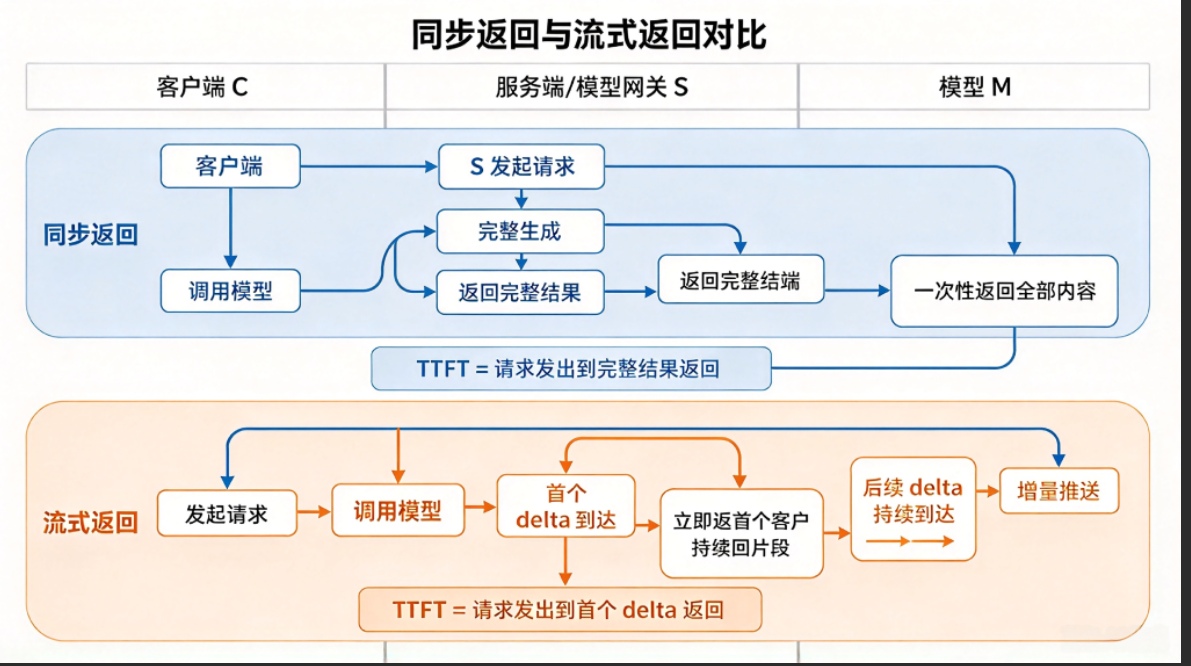
从时间轴上看,同步返回要等模型完整生成后才返回首个 Token,TTFT 覆盖整个生成过程;流式返回在首个 delta 到达时即返回,TTFT 大幅缩短。流式输出并没有减少模型计算量,只是把"首字等待时间"提前到了第一个片段,让用户更快看到内容开始出现。
SSE,webSocket 和HTTP chunked 这三种流式协议
流式输出有几种常见承载方式,如:
| 方式 | 核心特点 | 适合场景 | 边界 |
|---|---|---|---|
| SSE | 浏览器原生 EventSource,服务端到客户端单向推送,格式是 text/event-stream |
文本聊天、模型增量输出、状态通知 | 单向通信;复杂双向控制需要额外 HTTP 请求 |
| WebSocket | 双向长连接,客户端和服务端都能随时发消息 | 实时语音、多人协作、需要频繁取消或插话 | 连接管理更复杂,网关、鉴权、心跳都要自己管好 |
| HTTP chunked | HTTP/1.1 的分块传输机制,响应体分块发送 | 后端到后端流式代理、低层传输 | 它是传输机制,不是应用事件协议;HTTP/2 之后有自己的流式机制 |
- SSE 的优势是简单。浏览器端几行代码就能接收事件,服务端按
data:一段段写出去即可。MDN 对 EventSource 的描述也强调了它和 WebSocket 的区别:SSE 是服务端到客户端的单向数据流。 - WebSocket 适合更实时、更复杂的交互。比如语音 Agent 里,客户端要不断上传音频,服务端要不断返回 ASR、LLM、TTS 状态,还要支持用户中途打断。这种场景用 WebSocket 更自然。
- HTTP chunked 更底层。很多服务端框架在没有
Content-Length的情况下会用分块响应,它能实现"边写边发",但不会帮你定义事件类型、重连语义、消息边界。业务层仍然要自己设计协议。
SSE的协议的事件边界
SSE 通常通过 HTTP 响应承载,媒体类型是 text/event-stream,消息格式是一份 UTF-8 文本事件流。每个事件由若干行字段组成**,事件之间用空行分隔;** 实际换行可以是 \n 或 \r\n,所以事件分隔常见写法是 \n\n 或 \r\n\r\n。
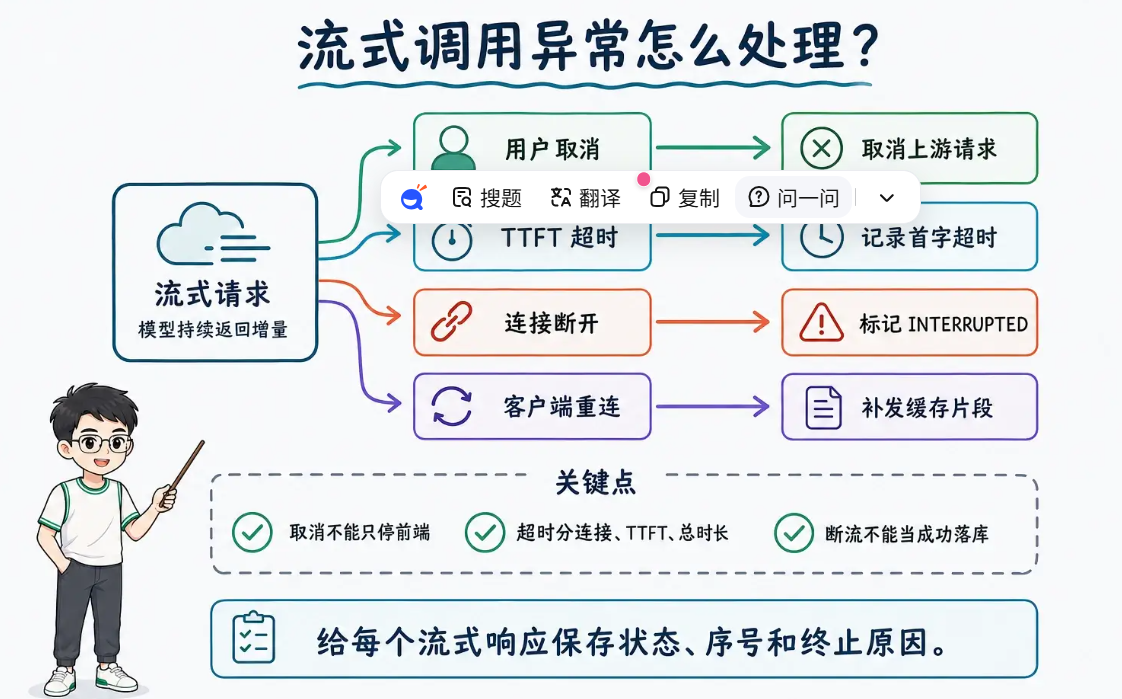
流式异常的四类场景
1.用户取消
用户关闭页面,点击停止生成,切换会话,都应该取消。后端也同时取消:
- 到供应商 API 的请求。
- 正在解析的响应流。
- 后续 TTS、工具调用、落库任务。
- 还没提交的增量缓存。
2.超时
超时至少分三层:
- 连接超时:连不上供应商。
- TTFT 超时:连接上了,但迟迟没有第一个事件。
- 总时长超时:一直有输出,但超过业务可接受时间。
注:TTFT 超时通常指向模型排队、上下文过长或供应商抖动;总时长超时可能只是用户让模型写太长。
3.断流
断流的时候不要把生成一半的内容当作成功,应该要记录 finish_reason 或最后事件状态,如果没有正常结束标记,就把本次调用标记为 INTERRUPTED,前端展示"已中断,可重新生成",而不是悄悄落成完整答案。
4.重连
SSE 的 EventSource 有自动重连能力,但大模型输出不是普通新闻推送。重连后是否能从断点续传,取决于你的服务端是否保存了事件序号、增量片段和供应商调用状态。
更好的做法是:
- 服务端为每个流式响应生成
messageId和递增sequence。 - 已发送片段写入短期缓存。
- 前端重连时先补发已缓存片段。
- 如果供应商流已结束或失效,提示用户重新生成,而不是假装无缝续写。
哪些错误能重试?
大模型 API 的重试有两个特殊点:
- 请求贵:失败请求也可能消耗配额,甚至已经消耗了部分 Token。
- 输出非确定:即使 Prompt 一样,第二次返回也可能和第一次不同。
错误类型对照表
| 类型 | 示例 | 是否建议重试 | 处理方式 |
|---|---|---|---|
| 网络瞬断 | 连接重置、DNS 抖动、读超时 | 可以 | 指数退避 + 抖动,限制最大次数 |
| 供应商 5xx | 500、502、503、504 | 可以 | 短暂重试,超过阈值切换模型或降级 |
| 供应商过载 | Anthropic 529、类似 overloaded 错误 | 可以 | 慢重试,必要时熔断该供应商 |
| 429 限流 | RPM、TPM、RPD、并发限制超出 | 谨慎 | 优先看 Retry-After 和限流头,排队或降级 |
| 流式中断 | 未收到正常结束事件 | 视场景 | 用户可见任务不自动重试,后台任务可幂等重试 |
| 400 参数错误 | Schema 不合法、字段缺失、上下文超限 | 不建议 | 修请求,不要重试同一 payload |
| 401/403 鉴权错误 | API Key 无效、权限不足 | 不建议 | 告警并停用对应 Key |
| 安全拒答 | 内容策略拒绝 | 不建议 | 进入业务拒答流程 |
| 解析失败 | JSON 不完整、字段类型错误 | 可有限重试 | 带失败原因二次修复,最多 1-2 次 |
指数退避会随着失败次数增加等待时间,直到达到最大等待时间或最大重试次数。
**抖动(Jitter)**再给等待时间加一段随机量,避免所有请求同时重试,把刚恢复的系统再次打进限流。
注:
- 最大重试次数:通常 2-3 次足够,别无限重试。
- 总体截止时间:用户请求有整体 SLA,例如 15 秒,到点就失败,不要因为重试拖成 1 分钟
**幂等 Key:**避免重试
服务端拿到请求后,先查这个 Key 是否已经存在:
-
如果已经成功,直接返回历史结果。
-
如果正在生成,返回同一个流式任务的订阅地址。
-
如果失败且允许重试,创建新的 attempt,但仍然挂在同一个业务消息下。
-
如果失败但不可重试,直接返回失败原因。
响应重复的处理
重试后的响应可能重复,冲突或部分重叠。
对聊天类应用,建议把一次用户消息下的多次模型调用区分为:
-
message_id:业务消息 ID,对用户可见。 -
attempt_id:模型调用尝试 ID,对系统可见。 -
provider_request_id:供应商请求 ID,用于排查。 -
stream_sequence:增量片段序号,用于去重和补发。
注:落库时,只保留一个 attempt 作为结果,其他的 attempt 保留为记录,不参与用户上下文。
为什么要限流?
限流的四层架构
| 层级 | 限制对象 | 核心目的 | 常见策略 |
|---|---|---|---|
| 用户级 | 单个用户或账号 | 防止滥用、误操作、脚本刷接口 | 每分钟请求数、每日 Token 上限 |
| 租户级 | 企业、团队、项目 | 控制套餐成本和公平性 | 月度配额、并发上限、优先级队列 |
| 模型级 | 某个模型或模型族 | 避免热门模型被打满 | 模型维度令牌桶、降级到备用模型 |
| 供应商级 | OpenAI、Anthropic、Gemini 等 | 保护外部依赖和 API Key | 全局 RPM、TPM、并发、熔断 |
token预算
常见的 API 限流按 QPS。大模型 API 不能只看 QPS,例如:
- 请求 A:输入 500 Token,输出 100 Token。
- 请求 B:输入 80K Token,输出 8K Token。
它们都是一次请求,但对模型推理、供应商配额和账单的压力完全不是一个量级。
所以限流至少要看
- RPM:每分钟请求数。
- TPM:每分钟 Token 数。
- 并发数:正在生成的请求数量。
- 上下文大小:单请求输入 Token。
- 最大输出 :
max_tokens或类似参数。 - 日/月预算:租户或用户总成本。
请求应先扣预算,在发给供应商。
常见的限流策略
| 策略 | 适合场景 | 优点 | 缺点 |
|---|---|---|---|
| 固定窗口 | 简单后台任务、管理接口 | 实现简单,容易统计 | 窗口边界容易突刺 |
| 滑动窗口 | 用户级请求限制 | 边界更平滑 | 实现和存储成本更高 |
| 令牌桶 | 模型调用、Token 预算 | 支持一定突发,工程上常用 | 参数需要调优 |
| 漏桶 | 严格平滑出流量 | 输出稳定,适合保护供应商 | 突发体验差 |
| 并发信号量 | 流式生成、长任务 | 能限制同时占用连接 | 不控制单个请求 Token 成本 |
| 优先级队列 | 多租户、多套餐 | 能保护高优先级请求 | 需要处理饥饿和超时 |
下面是一个基于令牌桶算法的 Java 实现示例,用于对模型调用进行限流:
java
import java.util.concurrent.TimeUnit;
import java.util.concurrent.locks.ReentrantLock;
/**
令牌桶限流器:控制模型调用的速率。
*/
public class TokenBucket {
private final int capacity; // 桶容量,即允许的最大突发请求数
private final double refillRate; // 每秒向桶中补充的令牌数,即平均请求速率
private double tokens; // 当前令牌数,初始为满桶
private long lastRefillNanos; // 上次补充令牌的时间戳(纳秒)
private final ReentrantLock lock = new ReentrantLock(); // 保证多线程安全
/**
初始化令牌桶。
@param capacity 桶的最大容量,即允许的最大突发请求数
@param refillRate 每秒向桶中补充的令牌数,即平均请求速率
*/
public TokenBucket(int capacity, double refillRate) {
this.capacity = capacity;
this.refillRate = refillRate;
this.tokens = capacity; // 初始为满桶
this.lastRefillNanos = System.nanoTime();
}
/**
按时间间隔补充令牌,补充量不超过桶容量。
*/
private void refill() {
long now = System.nanoTime();
double elapsedSeconds = (now - lastRefillNanos) / 1_000_000_000.0;
// 补充的令牌数 = 经过的时间 * 补充速率,且不能超过桶容量
tokens = Math.min(capacity, tokens + elapsedSeconds * refillRate);
lastRefillNanos = now;
}
/**
获取令牌,成功返回 true,超时或拒绝返回 false。
@param tokens 本次调用需要的令牌数,通常为 1
@param timeout 最多等待秒数;0 表示不等待,立即拒绝
@return 是否成功获取令牌
*/
public boolean acquire(int tokens, long timeout) {
lock.lock();
try {
refill();
if (this.tokens >= tokens) {
// 令牌充足,直接扣减并放行
this.tokens -= tokens;
return true;
}
if (timeout <= 0) {
// 令牌不足且不等待,直接拒绝
return false;
}
// 计算需要等待的时间,让令牌补充到足够数量
double waitSeconds = (tokens - this.tokens) / refillRate;
if (waitSeconds > timeout) {
// 等待时间超过允许的上限,拒绝本次请求
return false;
}
try {
// 释放锁并等待,避免阻塞其他线程获取令牌
lock.unlock();
TimeUnit.NANOSECONDS.sleep((long) (waitSeconds * 1_000_000_000L));
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
return false;
} finally {
lock.lock();
}
refill();
if (this.tokens >= tokens) {
this.tokens -= tokens;
return true;
}
return false;
} finally {
lock.unlock();
}
}
// 示例:容量 5,每秒补充 2 个令牌
public static void main(String[] args) throws InterruptedException {
TokenBucket bucket = new TokenBucket(5, 2);
// 模拟模型调用:每次消耗 1 个令牌,最多等待 1 秒
for (int i = 0; i < 8; i++) {
if (bucket.acquire(1, 1)) {
System.out.println("请求 " + (i + 1) + ":放行,调用模型");
} else {
System.out.println("请求 " + (i + 1) + ":拒绝,稍后重试");
}
Thread.sleep(300);
}
}
}上述实现包含三个核心部分:初始化 时设置桶容量和补充速率;获取令牌 时先按时间补充令牌再判断是否足够;等待和拒绝 逻辑则根据剩余令牌数和允许的超时时间决定是阻塞等待还是直接拒绝。实际接入模型网关时,可以把每次模型调用包装在 acquire() 之后,从而在请求层统一控制并发和速率。
收到429如何处理
TTP 429 表示请求过多。后端处理 429 时,建议按这个顺序:
-
读取
Retry-After或供应商 rate limit header:有明确恢复时间就尊重它。 -
标记限流维度:是请求数打满,还是 Token 打满,还是日配额耗尽。
-
短请求可排队:例如后台摘要任务可以进延迟队列。
-
用户交互请求少重试:用户等不起时,直接提示稍后再试或切换轻量模型。
-
供应商连续 429 时熔断:不要让所有请求继续撞墙。
一个典型降级链路:
优先模型可用 -> 正常调用
优先模型 429 -> 切备用同级模型
备用模型也限流 -> 切轻量模型并缩短输出
仍不可用 -> 排队或返回"当前请求繁忙"
结构化返回
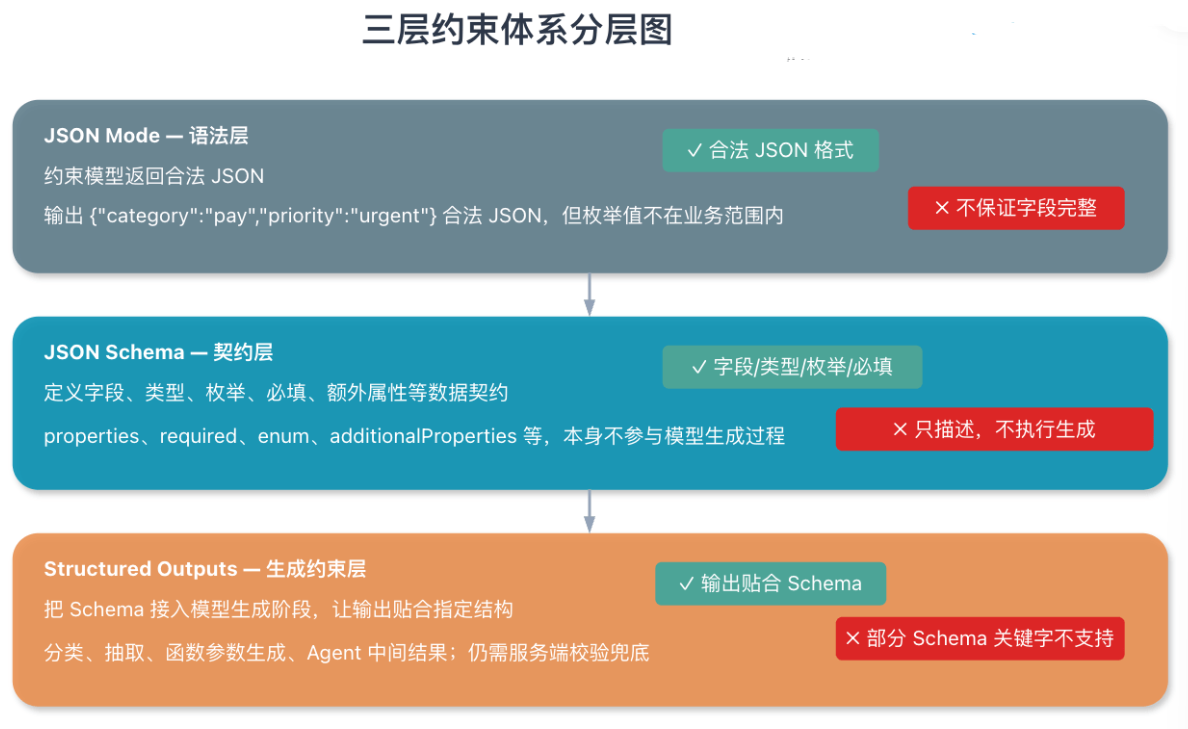
JSON Mode、JSON Schema 和 Structured Output 的区别
| 方式 | 约束强度 | 工程价值 | 风险 |
|---|---|---|---|
| 普通自然语言 | 几乎没有 | 适合展示型回答 | 不适合程序解析 |
| Prompt 要求 JSON | 弱 | 简单、跨模型 | 容易混入解释文本或缺字段 |
| JSON Mode | 中 | 通常能保证语法是 JSON | 不一定符合业务字段 Schema |
| JSON Schema | 强 | 明确字段、类型、必填、枚举 | 不同供应商支持子集不同 |
| Structured Outputs | 更强 | 供应商在解码或 SDK 层增强约束 | 受模型、SDK、Schema 子集限制 |
| Function Calling / Tool Use | 面向动作 | 适合让模型选择工具和参数 | 不是最终自然语言答案的万能替代 |
结构化输出失败后如何兜底
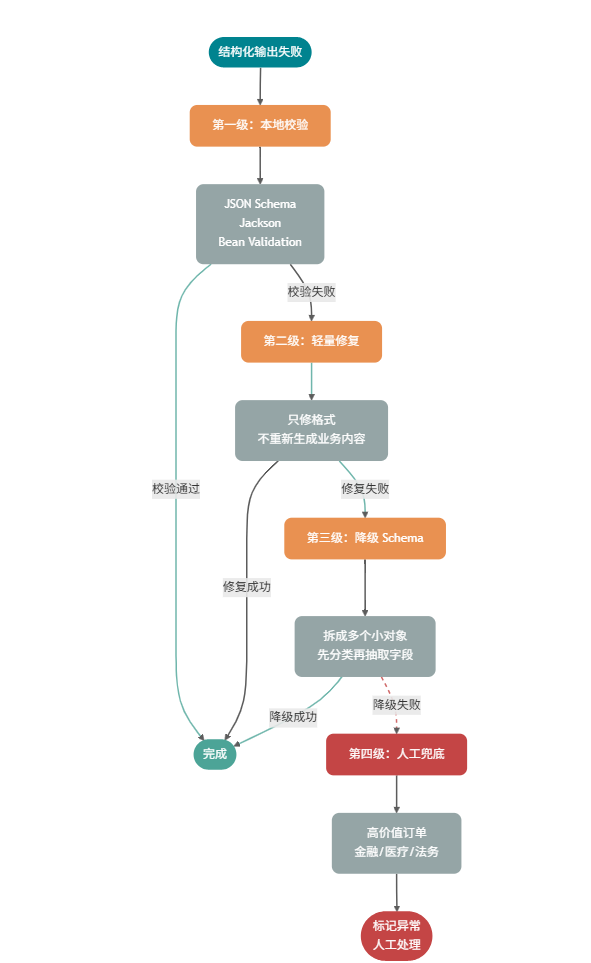
建议兜底分四级:
- 本地校验:用 JSON Schema、Jackson、Bean Validation 校验字段和类型。
- 轻量修复:只让模型修复格式,不重新生成业务内容。
- 降级 Schema:复杂对象拆成多个小对象,或先分类再抽取字段。
- 人工或规则兜底:高价值订单、金融、医疗、法务场景不要完全依赖自动修复。