编者按: 最近圈子里总有个声音,说现在大模型的 API 定价根本不可持续,全靠风投在背后烧钱补贴,等哪天资本撤了,价格马上就得暴涨。但事实真的如此吗?Token 的真实成本,到底有没有被严重低估?
我们今天为大家带来的文章,作者的观点是:当前按 Token 计费的 API 价格其实相当准确地反映了其背后的底层运行成本,真正的"补贴"更多是发生在面向个人的订阅套餐上,而非 API 调用本身。
为了验证这个判断,作者没停留在理论层面,而是拿 Kimi K3 做了个具体的拆解。他先是横向对比了 OpenRouter 上十几家供应商的 API 报价,接着又算了一笔"自托管"的账------从购买 8 张 GB300 GPU 的 55 万美元硬件成本,到机房托管、电费带宽,再到每月的 Token 吞吐量。算下来,只要产能跑满,自建服务器的运行成本其实明显低于服务商的收费。当然,这里我得补充一句,作者自己也坦言,这个粗略的分析忽略了高达数亿美元的模型训练成本,这部分确实算是投资者在承担。但无论如何,他通过这笔账把一个核心逻辑讲透了,这也是我想反复强调的:激烈的市场竞争确实在把价格往下压,但从底层算力成本来看,API 定价依然留有可观的利润空间,并没有大家想象的那么"赔本赚吆喝"。
作者 | Hadley Wickham
编译 | 岳扬
我经常听到一种质疑的声音,认为 AI token 的定价根本不可持续,那些前沿实验室是在拿 VC 的钱替我们大幅贴补。先低价让人上瘾,等哪天想狠狠赚一笔了,随时可以撤走补贴。真是这样吗?我的感觉是,大体上不是。但我能用一些数据来支撑这个判断吗?这篇文章要做的就是这件事。
现在有很多开放模型(open models)可用,但在这里我想重点谈谈 Kimi K3。过去几个月我一直在大量使用它,有趣的是,即使在 Opus 5.5 发布之后,我依然继续使用它。体感上 Opus 5.5 确实比 Kimi K3 聪明一点,可到头来我还是更愿意回到 Kimi K3------图的就是划算。这个话题我想留到以后单独写一篇,因为它正好牵出 Posit Assistant1 里我最喜欢的功能之一:cost display。这是一个强大的工具,可以帮助你建立一种直觉------模型的钱花在了哪里,以及某个特定任务大概应该花多少钱。
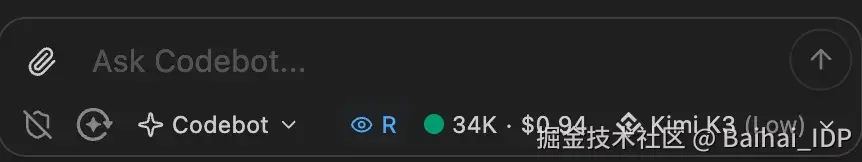
Posit Assistant 的聊天框显示了当前对话的累计费用(34K tokens,$0.94),旁边的模型选择器设为 Kimi K3。
因此,Kimi K3 可以作为一个"扎实的顶尖模型"的合理代表:也许它没那么强,但已经非常接近了。那它的成本是多少呢?
01 OpenRouter 上的报价
因为是开放模型,Kimi K3 在好几家供应商那儿都买得到。下面是 OpenRouter 当前的定价。我加了一个 blended 列,采用的是智能体编程(agentic coding)场景下的典型比例:输入输出比为 20:1,且 95% 的输入来自缓存。后面我们在对比 API 调用和自建部署的成本时会用到这个数据。
#> Provider Input /M Output /M Cache /M Blended /M
#> Wafer 0.28 9.60 0.13 0.59
#> Sail Research 0.22 10.72 0.11 0.62
#> Relace 0.21 9.33 0.21 0.64
#> Makora 0.36 12.00 0.12 0.70
#> Chutes 1.85 9.50 0.18 0.71
#> Decart 1.95 9.75 0.20 0.73
#> ParetoAlpha 1.00 11.25 0.23 0.79
#> Fireworks 2.10 10.50 0.21 0.79
#> Phala 2.55 12.75 0.26 0.96
#> DigitalOcean 2.55 12.95 0.26 0.97
#> InferenceNet 0.23 16.50 0.20 0.97
#> Morph 1.42 12.00 0.40 1.00
#> DeepInfra 2.85 14.25 0.28 1.07
#> Amazon Bedrock 3.00 15.00 0.30 1.13
#> Parasail 3.00 15.00 0.30 1.13
#> Modal 3.00 15.00 0.30 1.13
#> Together 3.00 15.00 0.30 1.13
#> BaseTen 3.00 15.00 0.30 1.13
#> Moonshot AI 3.00 15.00 0.30 1.13
#> Alibaba 3.45 17.25 0.34 1.30
#> AkashML 1.20 14.00 1.20 1.81
你会注意到这里有很多选择!而且我敢打赌,大多数购买决策都是由价格驱动的,这意味着这些供应商在价格上面临着巨大的竞争压力。
有什么能阻止各种补贴把价格压低到不可持续的地步呢?这么说吧,我猜最便宜的那几家供应商确实在烧风投的钱来拉拢客户。但与此同时,处于价格高位区间的也有六家供应商,它们的报价基本都在同一水平。其中一家是 BaseTen2,我们正与他们合作,为 Posit AI Pass3 提供模型服务。这家的服务质量我敢以个人名义打包票:虽然不是最便宜的,但我们的合作体验非常棒。
以上是直接"买现成"的 Kimi K3。那如果我们尝试自己部署托管呢?
02 自托管的成本
本地部署大模型这方面我不是行家,所以拉了 Claude 一起算这笔账4。写的时候,但凡落到具体事实我都一条条核实过。可也保不齐 Claude 从一开始就把我带进了完全错的方向,底下还埋着个我没看出来的更深的坑。不过,先算一版试试。
先得买一台能跑得动 Kimi K3 的机器。这得花多少钱?Moonshot AI(Kimi K3 的作者)给了一份 vLLM 部署方案5,推荐"至少 8x GB300"。照这个配置能选的,比如 Supermicro 8U GPU SuperServer6,一台标价足足 550,000!我手边可没摆着五十万美元闲钱,所以这笔钱得靠借。按年息 8%(这大概还算往乐观里估算)借 3 年,摊到每月就是 17,000 上下。
换个办法,也可以按每张 4/hour 上下去租这 8 张 GPU。把那笔机房托管费(下面会讲)算进来,总数跟买机子差不多。借钱买下来的好处是,三年到期还能把机器转手,说不定净回笼 150,000。租的好处则是,想收手随时能收手。
接下来我们需要把这台服务器放在某个地方。这类场所叫做服务器托管机房(colocation facility),虽然互联网上一般查不到定价信息,但 Claude 声称每月大约需要 3,750,外加600 的带宽费和约 $700 的电费。你也许会考虑把服务器放在自己家里,但它会产生巨量的热量,你还得为它专门买一台空调。
还有一些其他零碎开销,加起来每月总成本约为 $23,000。
那么我们一个月能处理多少 token 呢?SemiAnalysis7 给的数大约是每张 GPU ~6000 tokens/s,8 张便是 48,000 tokens/second,合 124 billion tokens/month。假设利用率达到 75%(对 API 服务商来说挺合理),那么成本约为 0.25 / million tokens。再按智能体编程这一使用场景的常见比例(输入:输出 20:1,输入里 95% 走缓存)来算,对应的 API 服务成本(BaseTen 和同档那几家)是 1.13 per million tokens。只要产能真能跑满,看起来自建服务器的运行成本明显低于服务商的收费。
显然,这只是一个粗略的分析,但它为 token 服务成本设定了一个合理的上限。真做成生意,规模效应、跟供应商砍价的余地都还能再压一截,可另一头也得给人发工资。
03 补贴
所以,我想我现在相信:token 的价格相当准确地反映了其背后的成本。激烈的竞争正在把成本往下压,但从底层成本来看,似乎仍然留有相当可观的利润空间。
这并不是说补贴就不存在了!我只是觉得,补贴并不发生在按 token 计费的 API 价格上,而是发生在订阅套餐上。SemiAnalysis 最近的一篇文章指出,一个每月 200 美元的套餐,能让你用到价值 2,000 到 10,000 美元不等的 token。这类套餐只面向个人和小型企业开放,企业客户则必须按 token 单价付费。
还有一点值得注意:我的分析忽略了模型训练的成本,而这项成本可能高达数亿美元8。目前,这笔费用由 Moonshot AI 的投资者承担。你可以认为这也是一种补贴,这个说法不无道理。我希望能有更多的政府意识到,训练开放模型是一件有益于社会的事(总好过让前沿模型只攥在私营企业手里),并决定直接为其提供资金支持。
你怎么看?你觉得本文这个分析能够说服你吗?你还有其他证据,能够说明 token 的真实成本到底是多少吗?
END
本期互动内容 🍻
作者在文末很诚实地补充了一点:这笔自托管的账,其实忽略了高达数亿美元的模型训练成本。读到这儿时,我其实犹豫了一下:如果把训练成本也强行摊薄到每一次推理里,现在的 API 定价逻辑可能瞬间就会被推翻。 我想听听大家的看法:你认为"训练成本"应该由推理阶段的 Token 价格来承担吗?还是说,在成熟的商业模式里,推理和训练本来就该是两笔分开算的账?
文中链接
5recipes.vllm.ai/moonshotai/...
6store.supermicro.com/us_en/8u-gp...
7inferencex.semianalysis.com/run/kimi-k3...
8yaroslavvb.github.io/training-nu...
原文链接: