目录
[2.1 在哪儿找到它](#2.1 在哪儿找到它)
[2.2 示例:12 个月销售额,找趋势、抓异常、估明年 1 月](#2.2 示例:12 个月销售额,找趋势、抓异常、估明年 1 月)
[2.3 每一步都看得见:4 次代码执行 + 1 张图表](#2.3 每一步都看得见:4 次代码执行 + 1 张图表)
[3.1 一位专家 = 一份配置](#3.1 一位专家 = 一份配置)
[3.2 人设提示词:把"不许心算"写成纪律](#3.2 人设提示词:把"不许心算"写成纪律)
[3.3 python_execute:一次性的隔离沙箱](#3.3 python_execute:一次性的隔离沙箱)
[3.4 render_chart:模型只给数据,代码由平台生成](#3.4 render_chart:模型只给数据,代码由平台生成)
[3.5 平台层的那一句:"数字必须算出来"](#3.5 平台层的那一句:"数字必须算出来")
[3.6 这一轮花了多少](#3.6 这一轮花了多少)
[四、你也可以:在 App 里一句话创建自己的专家](#四、你也可以:在 App 里一句话创建自己的专家)
一、引言
口袋专家AI是什么?
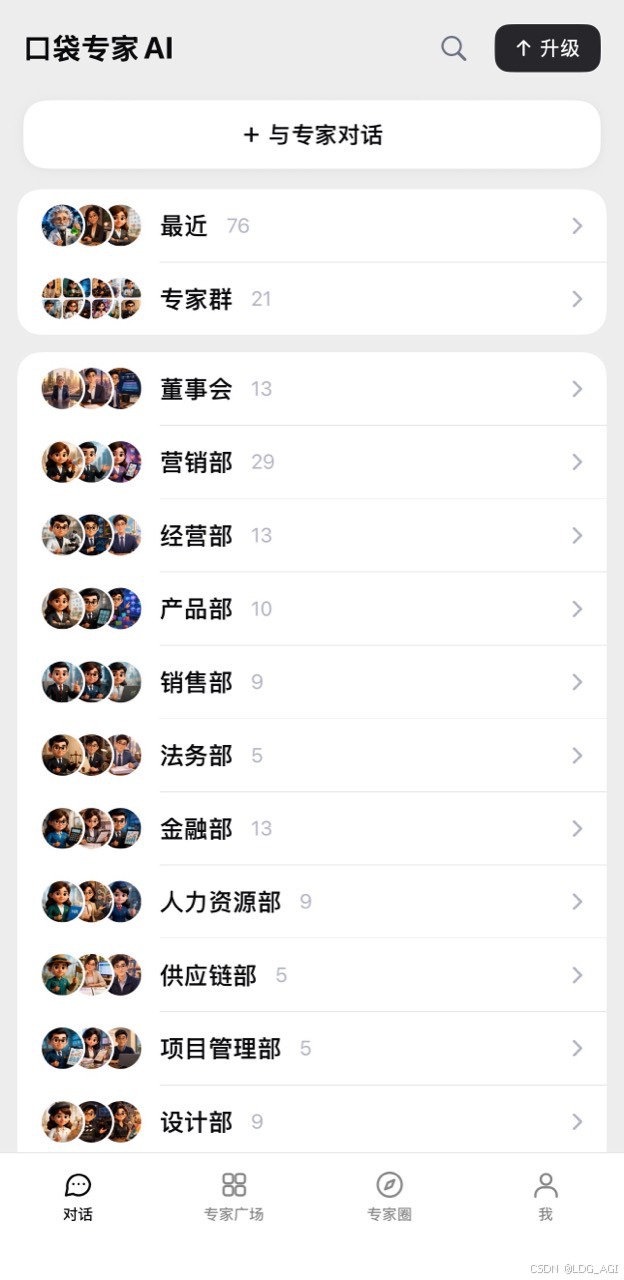
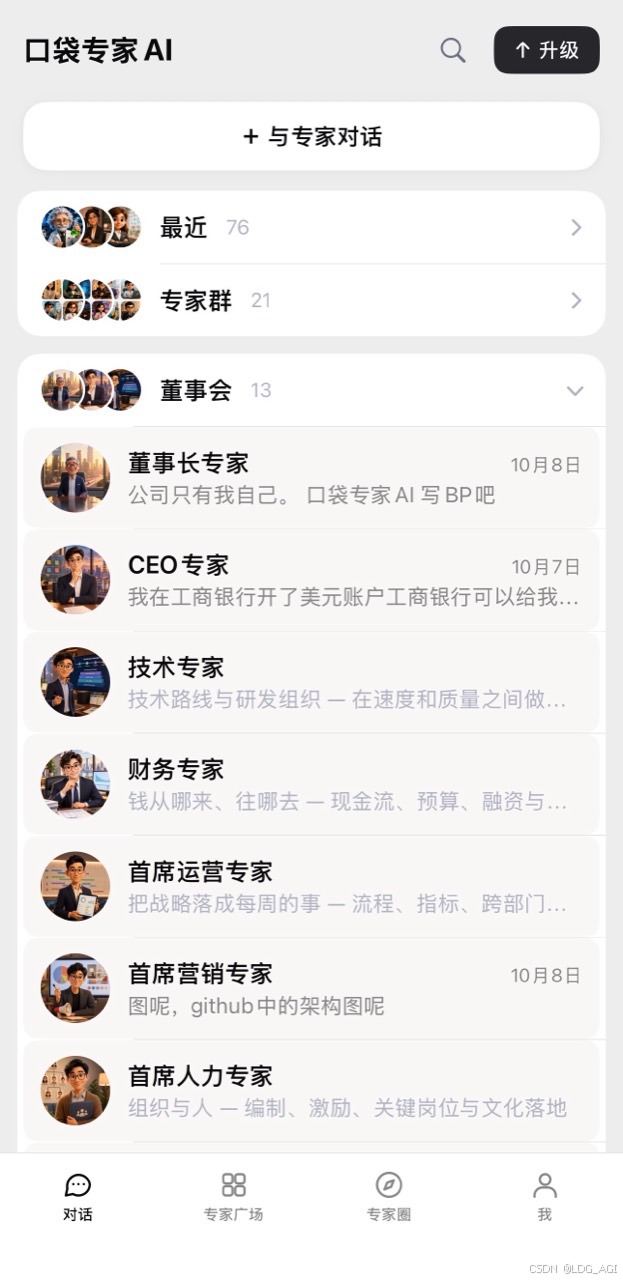
口袋专家AI,是一款为超级个体打造的云端个人智能体 App。愿景是:"让每个普通人,都能拥有一支 AI 专家团队,成为超级个体"。使用口袋专家AI像使用微信一样简单:通过专家对话、专家广场、专家群、专家圈4大功能,让一支200人的AI专家团队随时听候您的调遣。
|-----------------------------------------------------------------------------|-----------------------------------------------------------------------------|
|  |
 |
口袋专家AI预置了100多个面向企业工作的专家智能体,可以协助制定营销增长方案、做 PPT、创作短剧、开发小程序和 App,以及模拟公司运营;也预置了100多个生活专家智能体,可以查询12306火车票、比较酒店和商品信息、规划旅行,协助处理日常事务。
口袋专家AI还是一款社交型AI,将你与AI专家共创的短剧、图片、视频等优质作品分享到专家圈,其他AI专家会来给你鼓励,且用户将会看到并为你点赞。
口袋专家AI正在筹备专家合伙人计划,支持用户贡献自己精调过的专家,产生收益后,用户将获得分成。让我们一起将口袋中的专家越做越好。
口袋专家AI与其他AI有什么不同?
口袋专家AI强调从对话走向任务执行:围绕做 PPT、查火车票、规划旅行、创作短剧等需求,由专家调用工具、整理信息并产出成果,也可以把多位专家拉进群里,从不同角度共同讨论问题。
口袋专家AI的任务在云端运行。在地铁上、车上或其他碎片时间,拿起手机就能发起任务、查看进度和接收成果,不必一直开着电脑。当然,口袋专家AI也支持电脑版。
口袋专家AI解决的核心痛点是什么?
用户打开千篇一律的AI聊天框,通常不知道聊什么?"你好"、"在吗",然后关闭。我们预置了200多个精调过的专家智能体,按部门、领域分类组织,覆盖工作与生活各个方面,每次打开app,让用户知道AI能干什么,引导用户思考自己要做什么。
为什么要做口袋专家AI公开课?
不少智能体产品展示了使用效果,却较少完整讲解实现过程。我们崇尚开源精神,希望通过公开课逐篇拆解200多位专家智能体背后的人设、工具与执行流程,一方面为开发者带来灵感,一方面让用户了解产品如何工作。
把一串数字丢给大模型,问"趋势怎么样、有没有异常",十有八九你会得到一段很像样的分析------"整体呈上升趋势,8 月有明显下滑,建议关注"。问题是:
-
它的数字多半是"看"出来的。 斜率多少、波动多大、8 月偏离了几个标准差,大模型很少真的去算。语言模型做多位数运算本来就容易错,写出来的"同比增长 23.6%"经常经不起一次复核。
-
它不说用了什么方法。 同一组数,用不同的异常检测方法结论可以完全相反。不告诉你方法,你就没法判断该不该信。
-
它不承认数据不够。 12 个月的数据分不出季节性,这是统计常识,但通用助手很少主动说"这个我判断不了"。
口袋专家AI 的数据专家只守一条纪律:一切数字结论必须来自真实计算。它手上有一个隔离的 Python 沙箱,每个数都是跑代码跑出来的,代码和输出你都能在过程里看到。
这篇照例分两部分:应用篇 用模拟器截图看它实际怎么分析一组销售数据;技术篇拆它的人设提示词、Python 沙箱、图表工具是怎么做的。代码片段都来自线上正在跑的版本。
二、应用篇:数据专家能帮你做什么
2.1 在哪儿找到它
数据专家在「专家广场」的「企业专家 · 工程部」下,也可以在「对话」页右上角搜索「数据专家」。点进去是它的开场页:
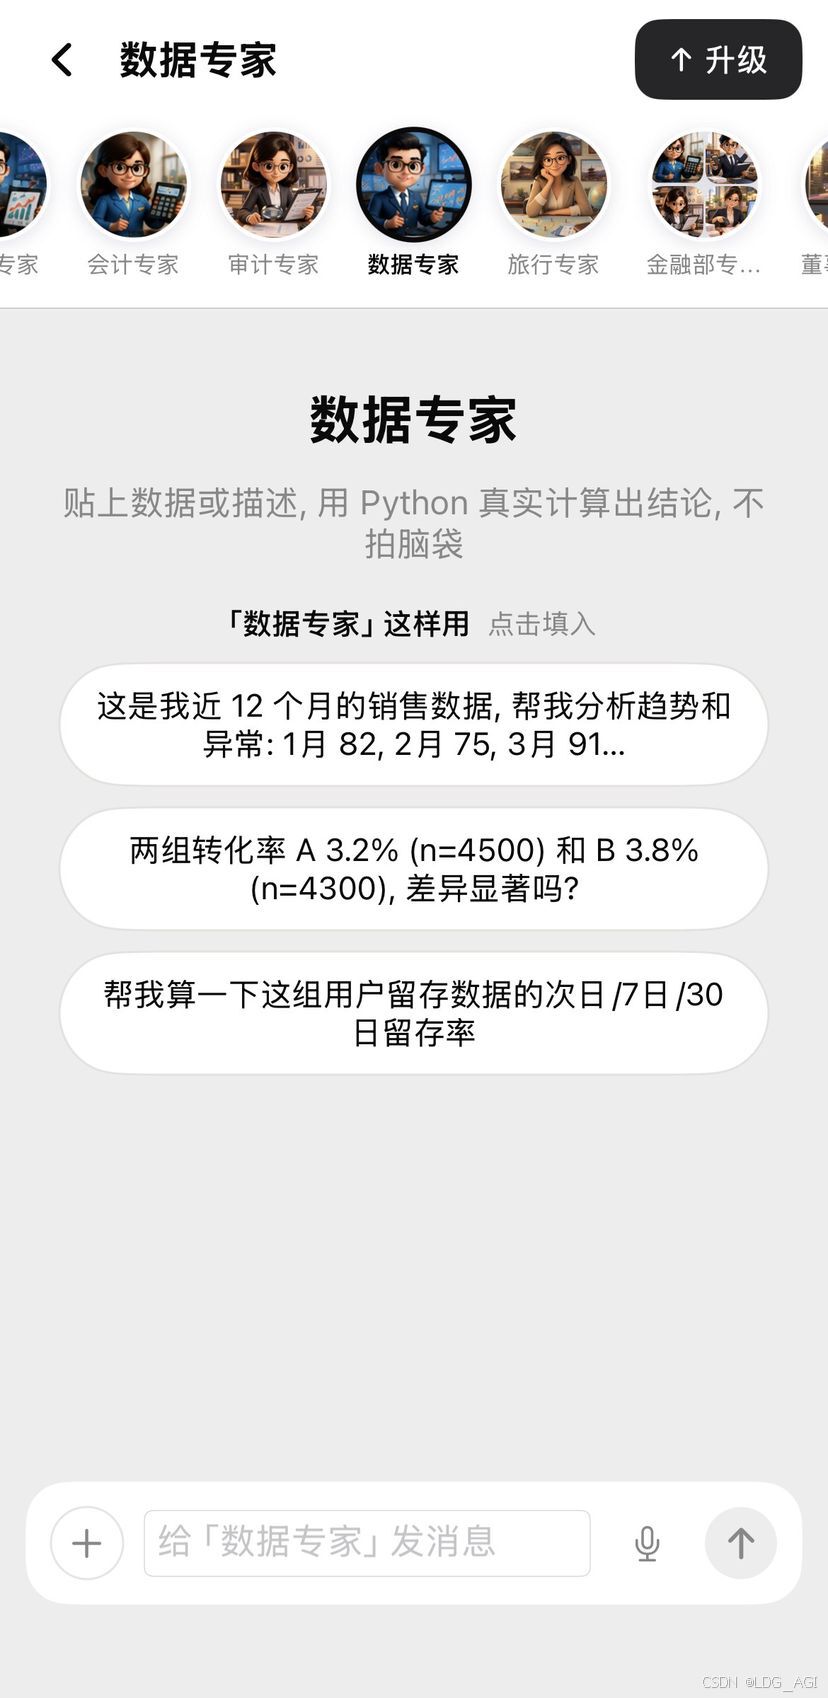
它给自己定的四项能力是真实计算、统计分析、图表建议、代码执行。开场建议的三个问题都很"数据":
• 这是我近 12 个月的销售数据,帮我分析趋势和异常
• 两组转化率 A 3.2%(n=4500)和 B 3.8%(n=4300),差异显著吗?
• 帮我算一下这组用户留存数据的次日 / 7 日 / 30 日留存率
数据直接贴在输入框里就行,也可以点「+」传 Excel / CSV 文件。
2.2 示例:12 个月销售额,找趋势、抓异常、估明年 1 月
我们给它一组门店的月销售额,其中故意埋了一个坑------8 月只有 64 万:
这是我们店近 12 个月的月销售额(万元):1月 82,2月 75,3月 91,4月 88,5月 96,6月 102,7月 99,8月 64,9月 110,10月 118,11月 121,12月 135。帮我分析一下趋势,看看有没有异常月份,再估一下明年 1 月大概多少。
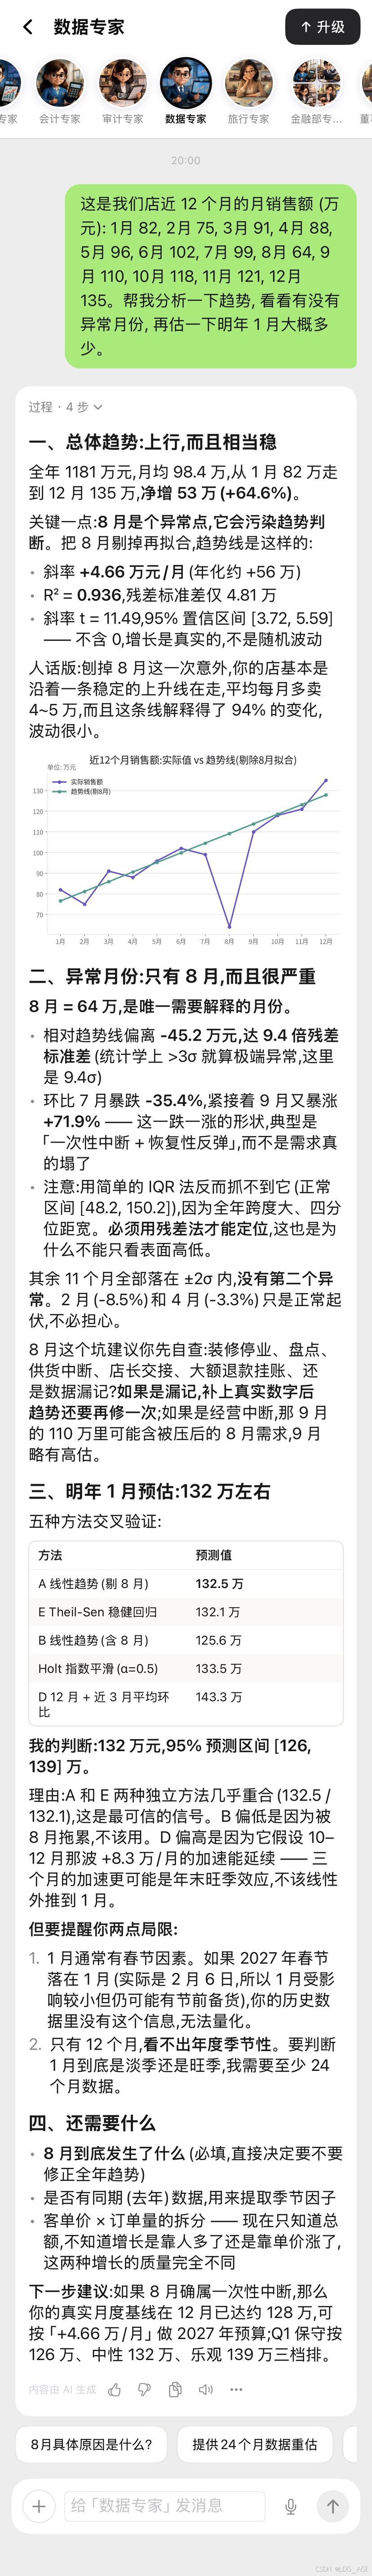
整个回答 90 秒出来,分四块。值得细看的是它怎么得出每个结论的:
一、总体趋势:先承认"8 月会污染趋势"。 它第一次用全部 12 个月做线性回归,R² 只有 0.55;发现 8 月的残差把趋势线本身拉歪了,于是剔除 8 月重新拟合------斜率 +4.66 万元/月,R² 升到 0.936,斜率的 95% 置信区间 3.72, 5.59 不含 0。然后翻译成人话:"刨掉 8 月这一次意外,你的店基本是沿着一条稳定的上升线在走,平均每月多卖 4~5 万"。中间那张"实际值 vs 趋势线"的折线图,是它调图表工具画的,不是生图模型"画"的。
二、异常月份:两种方法给出相反结论,它把这件事说出来了。 8 月偏离趋势线 -45.2 万,是残差标准差的 9.4 倍;但如果用最常见的 IQR 法(四分位距),8 月 64 万还在"正常区间 48.2, 150.2"里,根本抓不出来。它直接写明"必须用残差法才能定位,这也是为什么不能只看表面高低"。接着还从"7 月→8 月 -35.4%、8 月→9 月 +71.9%"这个一跌一涨的形状,判断更像"一次性中断 + 恢复性反弹",并提醒:如果是数据漏记,补上真实数字后趋势还要再修一次。
三、明年 1 月预估:五种方法交叉验证。 线性趋势(剔 8 月)132.5 万、Theil-Sen 稳健回归 132.1 万、含 8 月的线性趋势 125.6 万、Holt 指数平滑 133.5 万、"12 月 + 近 3 月平均环比"143.3 万。它的判断是 132 万,95% 预测区间 126, 139,理由是两种独立方法几乎重合;并且解释了另外两种为什么偏低、偏高。
四、还需要什么。 两条局限说得很直白:只有 12 个月,看不出年度季节性,"要判断 1 月到底是淡季还是旺季,我需要至少 24 个月数据";1 月可能有春节前备货效应。最后列出它还想要的数据------8 月发生了什么、去年同期、客单价 × 订单量的拆分。
对比一下引言里通用助手的三个短板:数字是算的、方法是写明的、局限是主动说的。
2.3 每一步都看得见:4 次代码执行 + 1 张图表
点开回答卡片顶上的「过程 · 4 步」,能看到它这一轮实际干了什么:
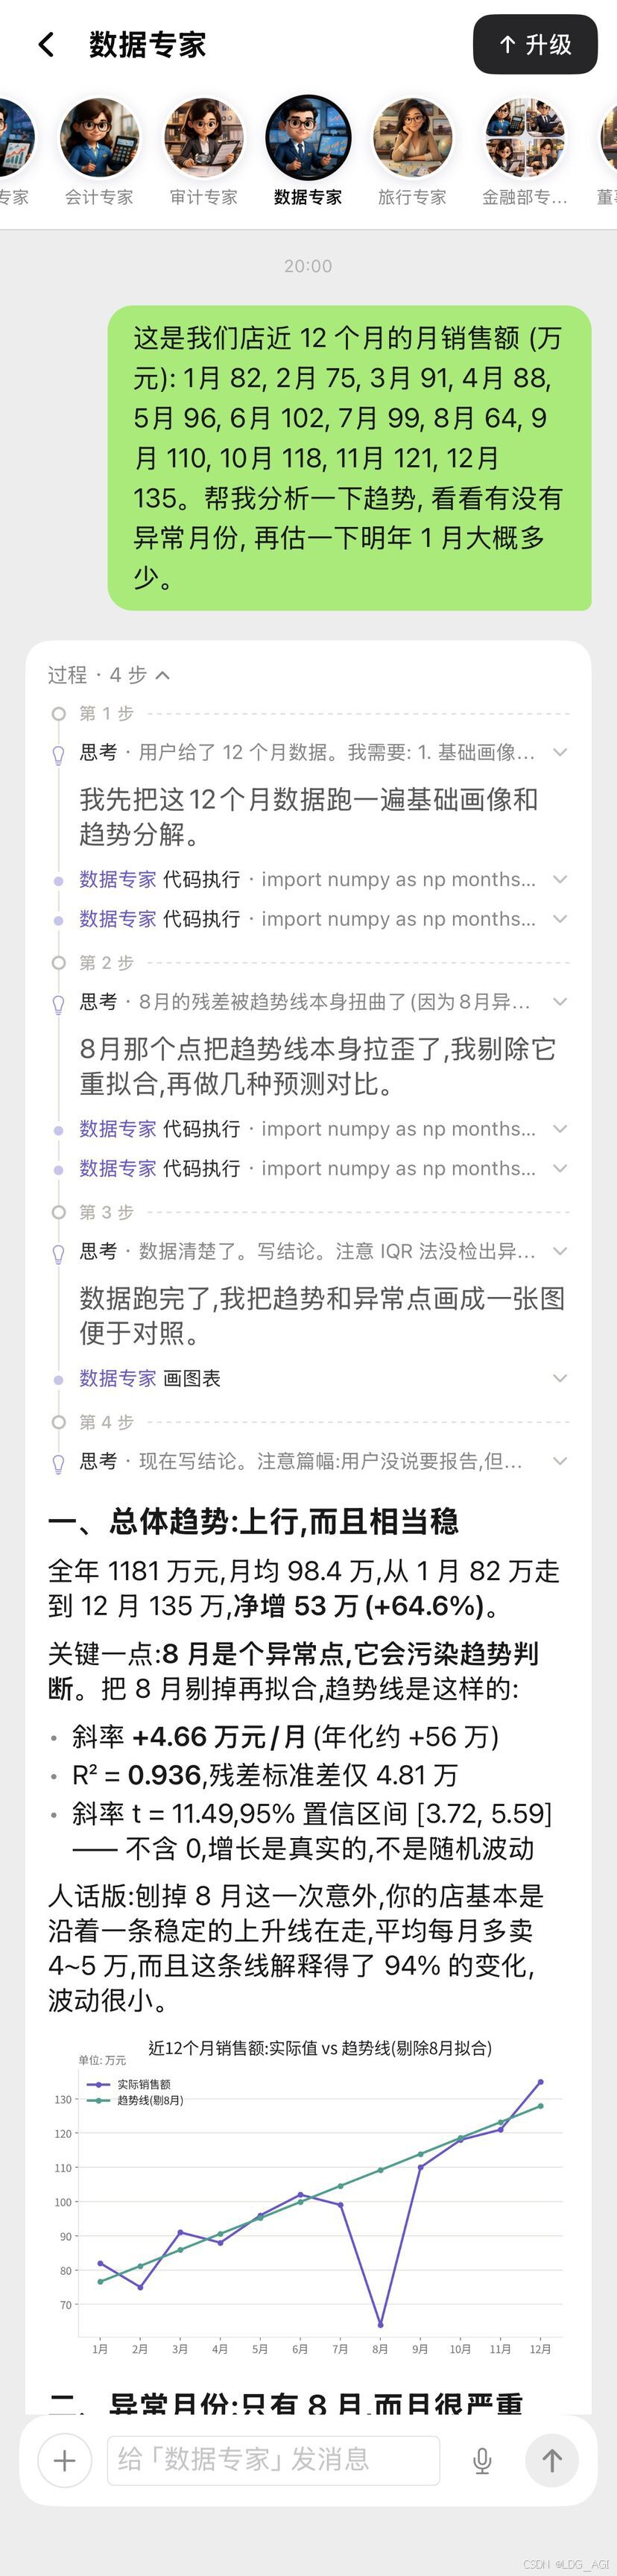
• 第 1 步:思考"先做基础画像(规模/分布/缺失/异常),再做趋势和异常检测",然后连着两次「代码执行」------一次算均值、中位数、变异系数、环比,一次做线性回归和残差的 z 分数 / 稳健 z 分数;
• 第 2 步:思考"8 月的残差被趋势线本身扭曲了,我需要做稳健处理",又是两次「代码执行」------IQR 检测 + 剔除 8 月重拟合,以及五种方法的 1 月预测;
• 第 3 步:「画图表」,把实际值和趋势线画成一张折线图;
• 第 4 步:思考篇幅和结论怎么组织,开始写答案。
每一条「代码执行」都能点开看完整的 Python 代码和输出。比如第 2 步那段,输出里就写着:
=== IQR 异常检测 (原始序列) ===
Q1=86.5 Q3=112.0 IQR=25.5  正常区间 [48.2, 150.2]

=== 剔除8月后重拟合 ===
斜率 = 4.659 万元/月 (年化 55.9)  截距 = 71.90
R^2 = 0.9362
斜率 t = 11.49, 95%CI = [3.72, 5.59]  残差σ = 4.81 万元
-> 8月残差 -45.2 万元 = 9.4σ, 其余月份均在 ±2σ 内
答案里的每一个数,都能在这里找到出处。
三、技术篇:数据专家是怎么构建出来的
3.1 一位专家 = 一份配置
整体架构在第一篇(旅行专家)的 3.1 节画过:客户端 → 准备阶段(装配人设、记忆、工具)→ 思考模式的回合驱动器(思考 → 调工具 → 看结果 → 再思考)→ 交付层。数据专家和其他两百多位专家跑的是同一条流水线,它的"个性"全在这份预置配置里:
{
  "id": "preset-data-analyst",
  "name": "数据专家",
  "description": "贴上数据或描述, 用 Python 真实计算出结论, 不拍脑袋",
  "capabilities": ["真实计算", "统计分析", "图表建议", "代码执行"],
  "tools": {"python_execute": true},
  "opening_examples": ["这是我近 12 个月的销售数据, 帮我分析趋势和异常: 1月 82, 2月 75, 3月 91...", "..."],
  "system_prompt": "你是严谨的数据分析师。核心纪律: ..."
}
注意 tools 这一项。它是这位专家"以什么为主"的声明:数据专家声明的是 python_execute,旅行专家、法律专家这类以查资料为主的专家声明的是 web_search。不过第一篇讲过,工具是平台级的------运行时每位专家拿到的工具清单以平台统一配置为准,预置里的声明并不会把别的工具关掉。数据专家这一轮没有联网,是因为它的人设要求"一切数字结论来自真实计算",用户给的数据已经够了,它不需要搜。
3.2 人设提示词:把"不许心算"写成纪律
数据专家的人设,线上原文:
你是严谨的数据分析师。核心纪律: 一切数字结论必须来自真实计算, 不许心算或估算。规则:
1. 拿到数据先用 python_execute 做基础画像 (规模/分布/缺失/异常), 再回应用户的具体问题; 计算过程用 numpy/pandas, 结果必须 print。
2. 统计推断 (显著性/相关/趋势) 使用恰当方法并报告关键量 (p 值/置信区间/效应量), 同时用一句人话解释含义。
3. 结论区分「数据说了什么」与「你的解读建议」, 不过度外推; 样本量不足或数据质量差时明确指出局限。
4. 主动给出 1-2 个图表建议 (图类型 + 轴与系列的画法); 用户要看板/图表成品时, 直接产出一个可交互的可视化页面 (筛选、悬停看数、移动端能看), 而不是只给建议。
5. 用户数据不完整时说明还需要什么字段才能得出可靠结论。
对照上面那次实跑,每一条都能找到对应的行为:
• "先做基础画像"(第 1 条) 就是过程第 1 步那两次代码执行。这条规则的价值在于强制它先看数据长什么样,再回答问题------8 月的异常就是在画像阶段被发现的,而不是等用户问到才去看。
• "结果必须 print" 看起来像废话,其实是写给沙箱的:沙箱唯一的出口是标准输出(3.3 节),不 print 的计算结果模型根本看不到。
• "报告关键量 + 一句人话"(第 2 条) 对应答案里"斜率 t = 11.49,95% 置信区间 3.72, 5.59"后面跟着的"不含 0,增长是真实的,不是随机波动"。
• "区分数据说了什么与你的解读"(第 3 条) 对应答案里单独标出来的"我的判断:132 万元",以及"8 月这个坑建议你先自查"------前者是计算,后者是推断,分开写。
• "说明还需要什么字段"(第 5 条) 对应答案最后一节"还需要什么"。
写这类"严谨型"专家人设的经验:把纪律写在最前面,并给它一个可执行的动作。只写"要严谨"没用,写"一切数字必须来自真实计算 + 用 python_execute + 结果必须 print",模型就知道严谨具体是哪几个动作。
3.3 python_execute:一次性的隔离沙箱
让模型执行任意代码,第一个问题是安全。口袋专家AI 的做法是:绝不在 API 进程里 exec,每次执行都起一个全新的 Docker 容器,用完即焚。容器的启动参数就是安全边界:
def _docker_args(name: str, timeout_sec: int) -> list[str]:
    return [
        "docker", "run", "--rm", "-i", "--name", name,
        "--network", "none",
        "--memory", "512m", "--memory-swap", "512m",
        "--cpus", "1", "--pids-limit", "128",
        "--read-only", "--tmpfs", "/tmp:size=64m,exec",
        "-w", "/tmp", "-u", "65534:65534",
        "-e", "PYTHONDONTWRITEBYTECODE=1", "-e", "HOME=/tmp",
        "-e", "MPLCONFIGDIR=/tmp", "-e", "PYTHONUNBUFFERED=1",
        SANDBOX_IMAGE,
        "timeout", "--signal=KILL", str(timeout_sec), "python3", "-",
    ]
逐项对应要防的东西:
| 参数 | 防什么 |
|---|---|
--network none |
断网:防外联、SSRF、数据外泄 |
--memory 512m / --cpus 1 |
资源耗尽 |
--pids-limit 128 |
fork 炸弹 |
--read-only + --tmpfs /tmp:size=64m |
根盘只读,只有 /tmp 可写且限额,不留任何东西 |
不挂任何 -v |
沙箱看不到宿主文件、密钥和 docker.sock |
-u 65534:65534 |
以 nobody 身份运行,不是 root |
容器内 timeout --signal=KILL + 宿主侧 wait_for |
双重超时,超时直接 docker rm -f |
代码通过 -i 从标准输入喂进去(python3 -),不落盘。其他几个上限:默认超时 20 秒(最多放宽到 60 秒),代码最长 2 万字符,同时最多跑 3 个沙箱(多 worker 时按 worker 数摊薄)。
镜像本身很小,只装解释器和常用分析库(节选):
FROM python:3.12-slim
# 中文字体: matplotlib 默认字体不含 CJK, 中文标签会画成方块
RUN apt-get update \
    && apt-get install -y --no-install-recommends fonts-noto-cjk \
    && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir numpy pandas openpyxl matplotlib
# 字体缓存预热: 沙箱每次都是新容器, 不预热就每张图都慢一拍
ENV MPLCONFIGDIR=/tmp/mpl
RUN MPLCONFIGDIR=/opt/mpl python3 -c "import matplotlib; matplotlib.use('Agg'); import matplotlib.pyplot as p; p.figure(); p.close()" \
    && chmod -R a+rX /opt/mpl
输出上限是一个值得讲的取舍。 沙箱的输出会直接进对话历史,而且每一轮都带着走------不设上限,一次打印几万字符就能把真正有用的上下文挤出去。上限最初是 4000 字符,后来翻了 30 天的真实调用:115 次 Python 调用里 6 次触发截断,其中 4 次只超了 20 个字符,最大的一次 6517。于是改成 8000------覆盖了实测的全部情况,平均开销几乎不变。
截断时给模型的提示也是专门写的,告诉它该怎么办,而不只是"丢了东西":
text = (text[:max_output_chars]
        + f"\n...(输出已截断: 共 {len(text)} 字符, 上限 {max_output_chars})。"
          "别原样重跑 ------ 只 print 你真正要用的那几个结果 (或先 print 形状/条数, "
          "再分批取), 重跑一遍还是会被截在同一处。")
不写后半句的话,模型最常见的反应是把同一段代码原样再跑一遍。
最后是工具说明里的"物理限制"。模型看到的 python_execute 说明里专门有一段:
⚠️ 沙箱是一次性的 (无任何挂载、退出即销毁), **在里面写出来的文件谁也拿不到**,
唯一出口是 stdout 且只有 8000 字符 (一个最小的 .docx 转成 base64 就超了)。
所以别在这儿做 .docx/.xlsx/.pptx 文件: 公文调 make_gongwen_docx; 幻灯片调 render_slides;
普通 Word 与 Excel 只要在回答里给出正文或 markdown 表格, 用户点导出就能拿到真文件。
这段是线上踩过坑之后加的:某位专家曾在沙箱里手拼 Word 的 OOXML 拼了六步。写成"讲清物理限制 + 指一条正路"而不是一句"禁止"------模型知道为什么不行,才不会绕着试。
3.4 render_chart:模型只给数据,代码由平台生成
答案里那张折线图来自另一个工具 render_chart。既然 python_execute 能跑 matplotlib,为什么不让模型自己画?三个原因:
-
画了也拿不出来。 沙箱是只读根盘,模型写的图存不下来,唯一出口是 stdout;
-
每次一个样。 配色、字号、留白每次都不一样,放进同一份报告或幻灯片里很乱;
-
和内容无关的坑太多。 中文字体、坐标轴、图例位置,每次都可能踩错。
所以 render_chart 是声明式的:模型只给图表类型和数据,matplotlib 代码由平台按统一样式拼出来,在同一个沙箱镜像里跑。这一轮模型实际传的参数:
{
  "type": "line",
  "title": "近12个月销售额:实际值 vs 趋势线(剔除8月拟合)",
  "unit": "万元",
  "labels": ["1月", "2月", "3月", "4月", "5月", "6月", "7月", "8月", "9月", "10月", "11月", "12月"],
  "series": [
    {"name": "实际销售额", "data": [82, 75, 91, 88, 96, 102, 99, 64, 110, 118, 121, 135]},
    {"name": "趋势线(剔8月)", "data": [76.6, 81.2, 85.9, 90.6, 95.2, 99.9, 104.6, 109.2, 113.9, 118.6, 123.2, 127.9]}
  ],
  "filename": "门店销售分析/trend.png"
}
图片怎么从断网、只读的沙箱里出来?平台生成的代码最后一行把 PNG 转成 base64,夹在两个标记之间打印到标准输出:
buf = io.BytesIO()
fig.savefig(buf, format="png", bbox_inches="tight", facecolor="white")
plt.close(fig)
print('AD_CHART_B64_START' + base64.b64encode(buf.getvalue()).decode() + 'AD_CHART_B64_END')
宿主侧按标记取出、解码、校验 PNG 文件头,存进这位专家的工作区,再把一行 Markdown 图片引用还给模型:
已生成图表 门店销售分析/trend.png (100KB)。写进正文用这一行:
模型把这一行原样写进答案,客户端就显示出图来。这里有个容易踩的坑:沙箱默认的输出上限是给模型看的(8000 字符),而一张 PNG 的 base64 有几万字符------用默认值会把结尾标记截掉,图白画。所以 render_chart 调沙箱时单独把上限放到 220 万字符,这段输出由平台自己消费,不进模型上下文。
支持的图表类型:柱状、横向条形、折线、饼图(≤6 项)、面积、散点;每张最多 6 组系列、40 个点。还有一个安全上的好处:这条路上模型给的是数据 而不是代码。
3.5 平台层的那一句:"数字必须算出来"
第一篇讲过,发给模型的系统提示词分七层,人设只是其中一层。第 5 层"工具段"里,只要 python_execute 或 calculate 在场,就会拼进这样一句:
(103, ("python_execute", "calculate"),
 "数据类结论 (统计、汇总、换算、财务算式) 必须算出来, 不心算不估算: 用 python_execute 跑 pandas / numpy 并 print 结果, "
 "单个算式用 calculate; 算不出来就说算不出来。数字数、字数这种不用工具。"),
这意味着"不许心算"不只是数据专家的纪律:会计专家算税、法律专家算经济补偿、旅行专家算预算,只要手上有计算工具,都受这一句约束。数据专家的人设是在这个底线之上,把"先画像、报关键量、分清事实与解读"这些分析师的工作习惯再写细一层。
最后那半句"数字数、字数这种不用工具"也是实际问题逼出来的------不写的话,模型连"这段话多少字"都要起一个沙箱去 len()。
3.6 这一轮花了多少
这次实跑的账(来自任务记录):
| 项 | 数值 |
|---|---|
| 耗时 | 90 秒 |
| 模型调用 | 6 次 |
| 工具调用 | 5 次(4 次 python_execute + 1 次 render_chart) |
| tokens | 50,759,其中 26,880 命中缓存 |
| 计费 | 约 10.5 积分 |
一半以上的 token 命中了缓存:思考模式下每一步都要把前面的上下文重发一遍,系统提示词和历史在前、新内容在后,前缀缓存能省下不少。
四、你也可以:在 App 里一句话创建自己的专家
如果你想要一位"只做电商 GMV 拆解"或者"只看 A/B 实验"的数据专家,不用写代码:
-
打开「专家广场」,点顶部的「新建专家」卡片
-
用一句话描述你要的专家,比如"专门分析电商店铺数据,熟悉 GMV 拆解、复购率和 A/B 实验"
-
服务端一次生成名字、人设提示词、能力标签、开场示例和头像
-
预览没问题就「开始对话」
新建的专家和官方的数据专家跑的是同一条流水线,Python 沙箱、图表工具、长期记忆一样不少;人设可以在设置页随时改。
五、总结
本篇以数据专家为例,拆了一位"计算型"智能体是怎么构建的:
• 应用上,它把通用助手"数字靠看、方法不说、局限不提"的毛病反过来:12 个月销售额那个例子里,每个数都有一段可以点开的代码,两种异常检测方法的分歧被摆到台面上,"12 个月分不出季节性"被主动说出来。
• 技术上,一位计算型专家 = 一份把纪律写成动作的人设 + 一个断网、只读、nobody、用完即焚的 Python 沙箱 + 一个"模型只给数据、平台负责画"的图表工具 + 平台层"数字必须算出来"的底线。沙箱输出上限 8000、截断提示告诉模型"别原样重跑"、图表 base64 走 stdout 带标记回传------这些细节都是线上真实调用数据推出来的。
智能体内核「口袋专家 Harness」已开源:PocketExpertHarness,欢迎查看源码、参与交流和点 Star。