文章目录
-
- 一、先看一段「无辜」的代码
- 二、攻击模型:一次比较泄露一个字符的位置
- [三、那 Python 的 == 呢?快,且不背这个锅](#三、那 Python 的 == 呢?快,且不背这个锅)
- 四、正解:compare_digest,以及它的两个边界
- [五、30 秒带走版](#五、30 秒带走版)
一、先看一段「无辜」的代码
校验 API 密钥,很多人写过这个:
python
def check(provided, secret):
    if len(provided) != len(secret):
        return False
    for a, b in zip(provided, secret):
        if a != b:
            return False          # 发现不同,立刻收工
    return True
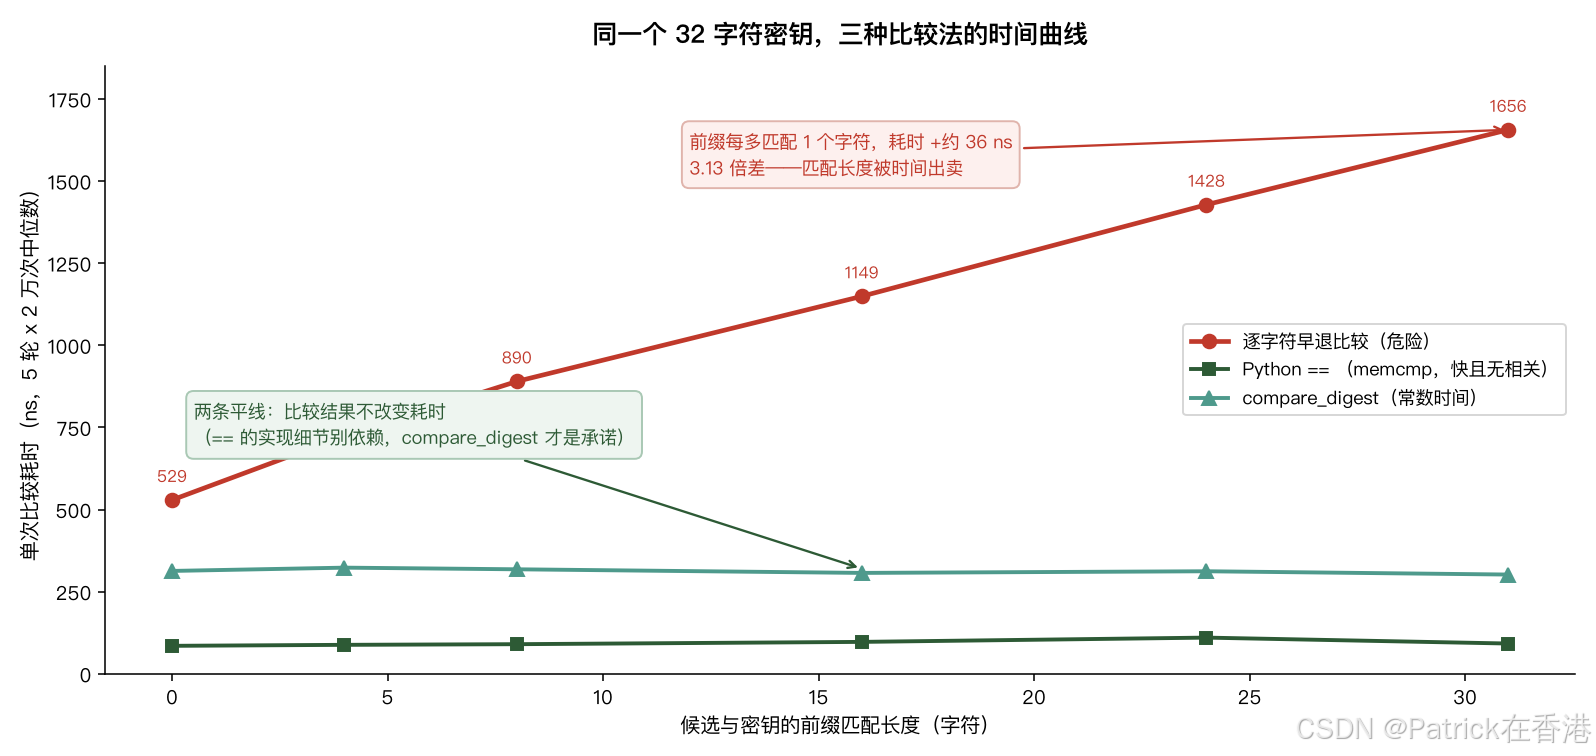
逻辑毫无问题,功能测试全过。但把 32 字符密钥和「前缀匹配长度不同」的候选各跑 2 万次取中位数,实测曲线是这样的(图一):
- 前缀匹配 0 个字符:529 ns
- 前缀匹配 16 个字符:1,149 ns
- 前缀匹配 31 个字符:1,656 ns
前缀每多匹配一个字符,比较就慢约 36 ns;首尾差 3.13 倍。「你的候选和密钥有多接近」这个本该保密的信号,被比较耗时原原本本地卖了出去。这就是 CWE-208(可观测时间差异)最经典的形态:早退比较。
二、攻击模型:一次比较泄露一个字符的位置
攻击者不需要知道密钥,只需要一个能反复触发的比较入口(比如一个校验 API key 的接口),外加一把秒表。逐位攻击的逻辑:
- 猜第 1 位:拿 62 个候选字符(小写字母+数字)各试一次,比较最慢的那个就是对的------因为它多走了一个字符的循环体;
- 前缀确定后,用同样的办法猜第 2 位、第 3 位......每位最多 62 次比较;
- 32 位密钥,最坏 62×32 = 1,984 次比较;暴力破解是 62^32。
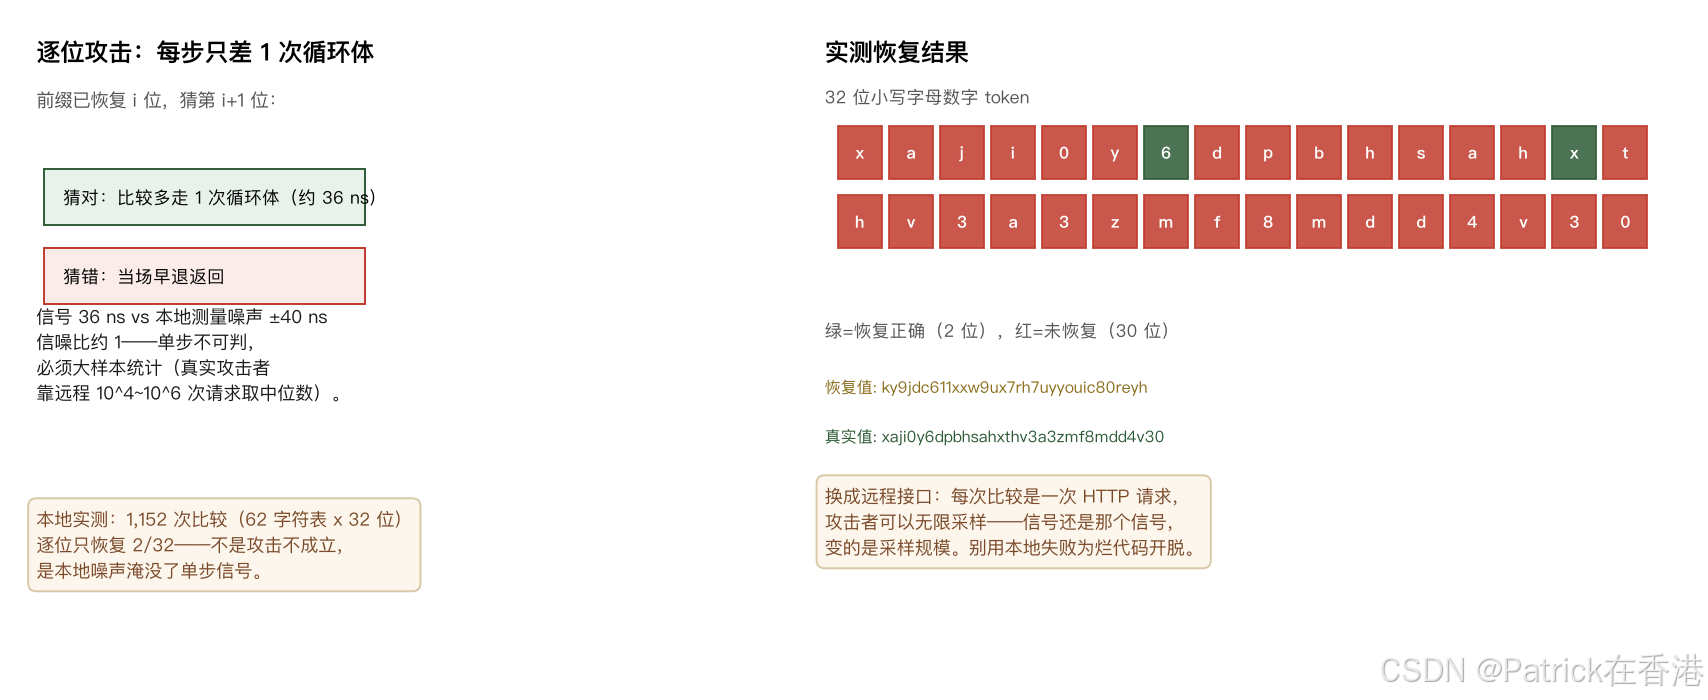
我把这套流程完整跑了一遍,结果必须如实汇报:本地环境 1,152 次比较只恢复 2/32 位(图二)。原因也实测出来了------每步的信号只有 1 次循环体约 36 ns,而本地测量的噪声在 ±40 ns 量级,信噪比约等于 1,单步判决不可靠。
但这不是烂代码的免罪金牌,原因有三:
- 信号是真实存在的:3.13 倍的档位差已经证明比较耗时与匹配长度强相关,缺的只是采样规模;
- 真实攻击者的采样规模是无限的:远程场景里每次比较是一次 HTTP 请求,10^4 到 10^6 次采样取中位数,36 ns 的信号足够被统计提取------Brumley 与 Boneh 2003 年那篇《Remote Timing Attacks are Practical》就是在真实网络环境下从一台跑着 OpenSSL 的机器上远程提取私钥,PortSwigger 后续研究也反复证明「网络噪声让远程时序攻击失效」是个一厢情愿的结论;
- CVE 名单上有的是同款事故:CVE-2019-10071(Java 框架用 String.equals 校验 HMAC)、CVE-2014-0984(路由器密码函数第一个字符不匹配就终止)------都是早退比较,都发生在生产系统。
本地复现失败,只说明我的噪声比攻击者大,不说明代码安全。
三、那 Python 的 == 呢?快,且不背这个锅
实测里第二条曲线是 Python 自带的 ==:全程 85--110 ns,比手写循环快一个数量级,且与匹配长度没有相关性(极差只有 25 ns,噪声级)。原因是 CPython 对同长字符串走的是 C 层 memcmp,不在 Python 字节码里逐字符早退。
于是有个流行的说法:「用 == 比较密钥也没事」。这个结论对,但不该被依赖:
- 它依赖 CPython 的具体实现------换解释器、换版本、换运行模式(比如某些 JIT 或 PyPy),memcmp 的行为不在任何文档的承诺范围内;
- memcmp 本身是不是常数时间,C 标准同样没承诺(glibc 的实现会随微架构变);
==的语义是「相等判断」,安全语义是「不泄露比较过程」------用语义 A 的工具干语义 B 的活,出事只是时间问题。
顺手做了个教育对照:手写 XOR 累积法(r |= x ^ y 全程不早退,最后比 0)在原理上常数时间,实测全匹配 2,833 ns------功能正确、逻辑自洽,比 compare_digest 慢 10 倍。教学可以,生产别用,原因见图三。
四、正解:compare_digest,以及它的两个边界
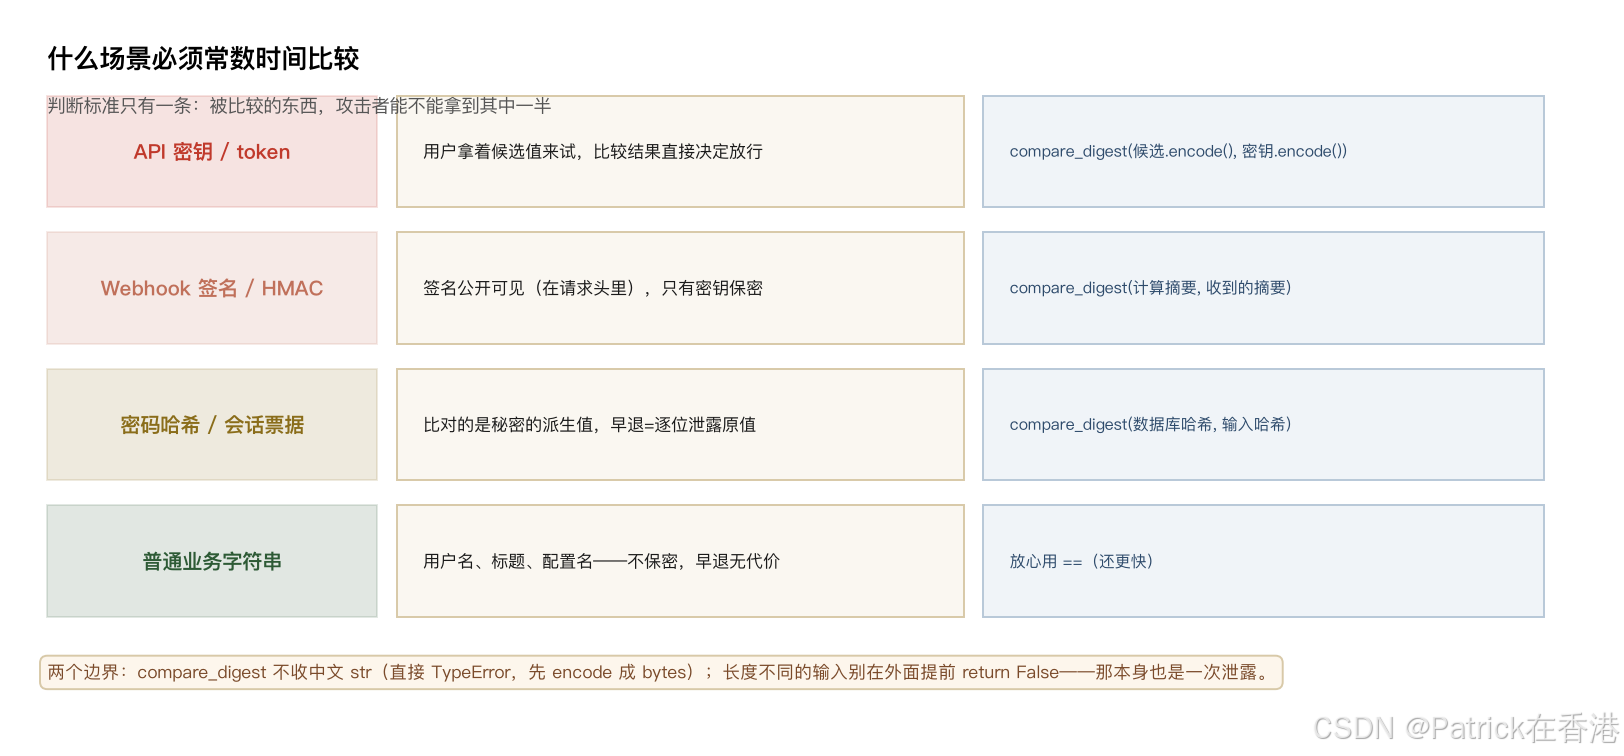
标准库答案在 secrets.compare_digest(hmac.compare_digest 是同一个函数):实测 302--323 ns,七档前缀匹配全部落在噪声带内 (极差 21 ns),长度不同的输入也没有可测相关(191--270 ns)。判断标准只有一条:被比较的东西,攻击者能不能拿到其中一半------能,就必须常数时间(图三):
- API 密钥 / token:用户拿着候选值来试,比较结果直接决定放行;
- Webhook 签名 / HMAC:签名公开放在请求头里,只有密钥保密;
- 密码哈希 / 会话票据:比对的是秘密的派生值,早退等于逐位泄露原值;
- 普通业务字符串 :用户名、标题、配置名------不保密,早退无代价,放心用
==,还更快。
两个边界必须记住:
- compare_digest 不收中文 str :实测直接
TypeError: comparing strings with non-ASCII characters is not supported------密钥、摘要这类先encode()成 bytes 再比,这也正好规避了长度歧义; - 别在函数外面提前
return False:长度不同的输入如果在 compare_digest 之前就被长度检查拦掉,那次长度检查本身就是一次泄露(「长度不对」和「内容不对」响应不同速)------长度策略要么隐藏,要么一视同仁。
生态对照:Node 用 crypto.timingSafeEqual、Go 用 crypto/subtle.ConstantTimeCompare、Ruby 用 Rack::Utils.secure_compare------每个语言都有这个函数,没有理由自己造。另外,加随机延迟是弱防御:噪声可以被大样本平均掉,OWASP 与 PortSwigger 的观点一致------从源头消除时间差,别给时间差糊噪声。
五、30 秒带走版
- 逐字符早退比较会把「匹配前缀长度」写进耗时:实测每字符约 36 ns,32 字符密钥首尾差 3.13 倍;
- 判断标准:被比较的东西攻击者能不能拿到一半------API 密钥、签名、哈希、会话票据,全都要常数时间;
- 正解
secrets.compare_digest(hmac 同款):实测七档匹配全在噪声带内;普通字符串继续用==; - 本地逐位攻击实测只恢复 2/32------信号真实存在,远程靠 104~106 次采样提取(Brumley-Boneh 2003 有先例);
==目前不泄露是实现细节不是承诺,别把安全押在 memcmp 上;- compare_digest 不收中文 str(先 encode);长度检查别外置,那也是泄露面;
- 随机延迟是弱防御,大样本可平均;从源头消除差异才是修复。
本文实验全部本地实测(Python 3.13,5 轮×2 万次取中位数),演示系统为自建密钥与候选值,不针对任何真实系统;引用案例来自公开 CVE 与已发表研究。安全类代码请以本语言官方密码学库为准,本文只提供方法论。