在 SAP HANA 实时同步中,有时会出现这样的情况,一笔历史订单的批量更新还没提交,新订单和库存变更却已经陆续提交。业务系统能查到后两笔数据,依赖同步数据的报表却迟迟没有变化。
同步链路没有报错,目标端也能正常写入。问题出在前面那笔尚未结束的长事务。
长事务为什么会拖慢后续数据?碰上长事务时如何提高数据同步的实时性,同时保证完整性呢?数据迁移与同步工具 CloudCanal 最近针对 SAP HANA 实时同步中的这一问题做了优化。
一个长事务,为什么会影响后面的数据?
举个简单的例子:
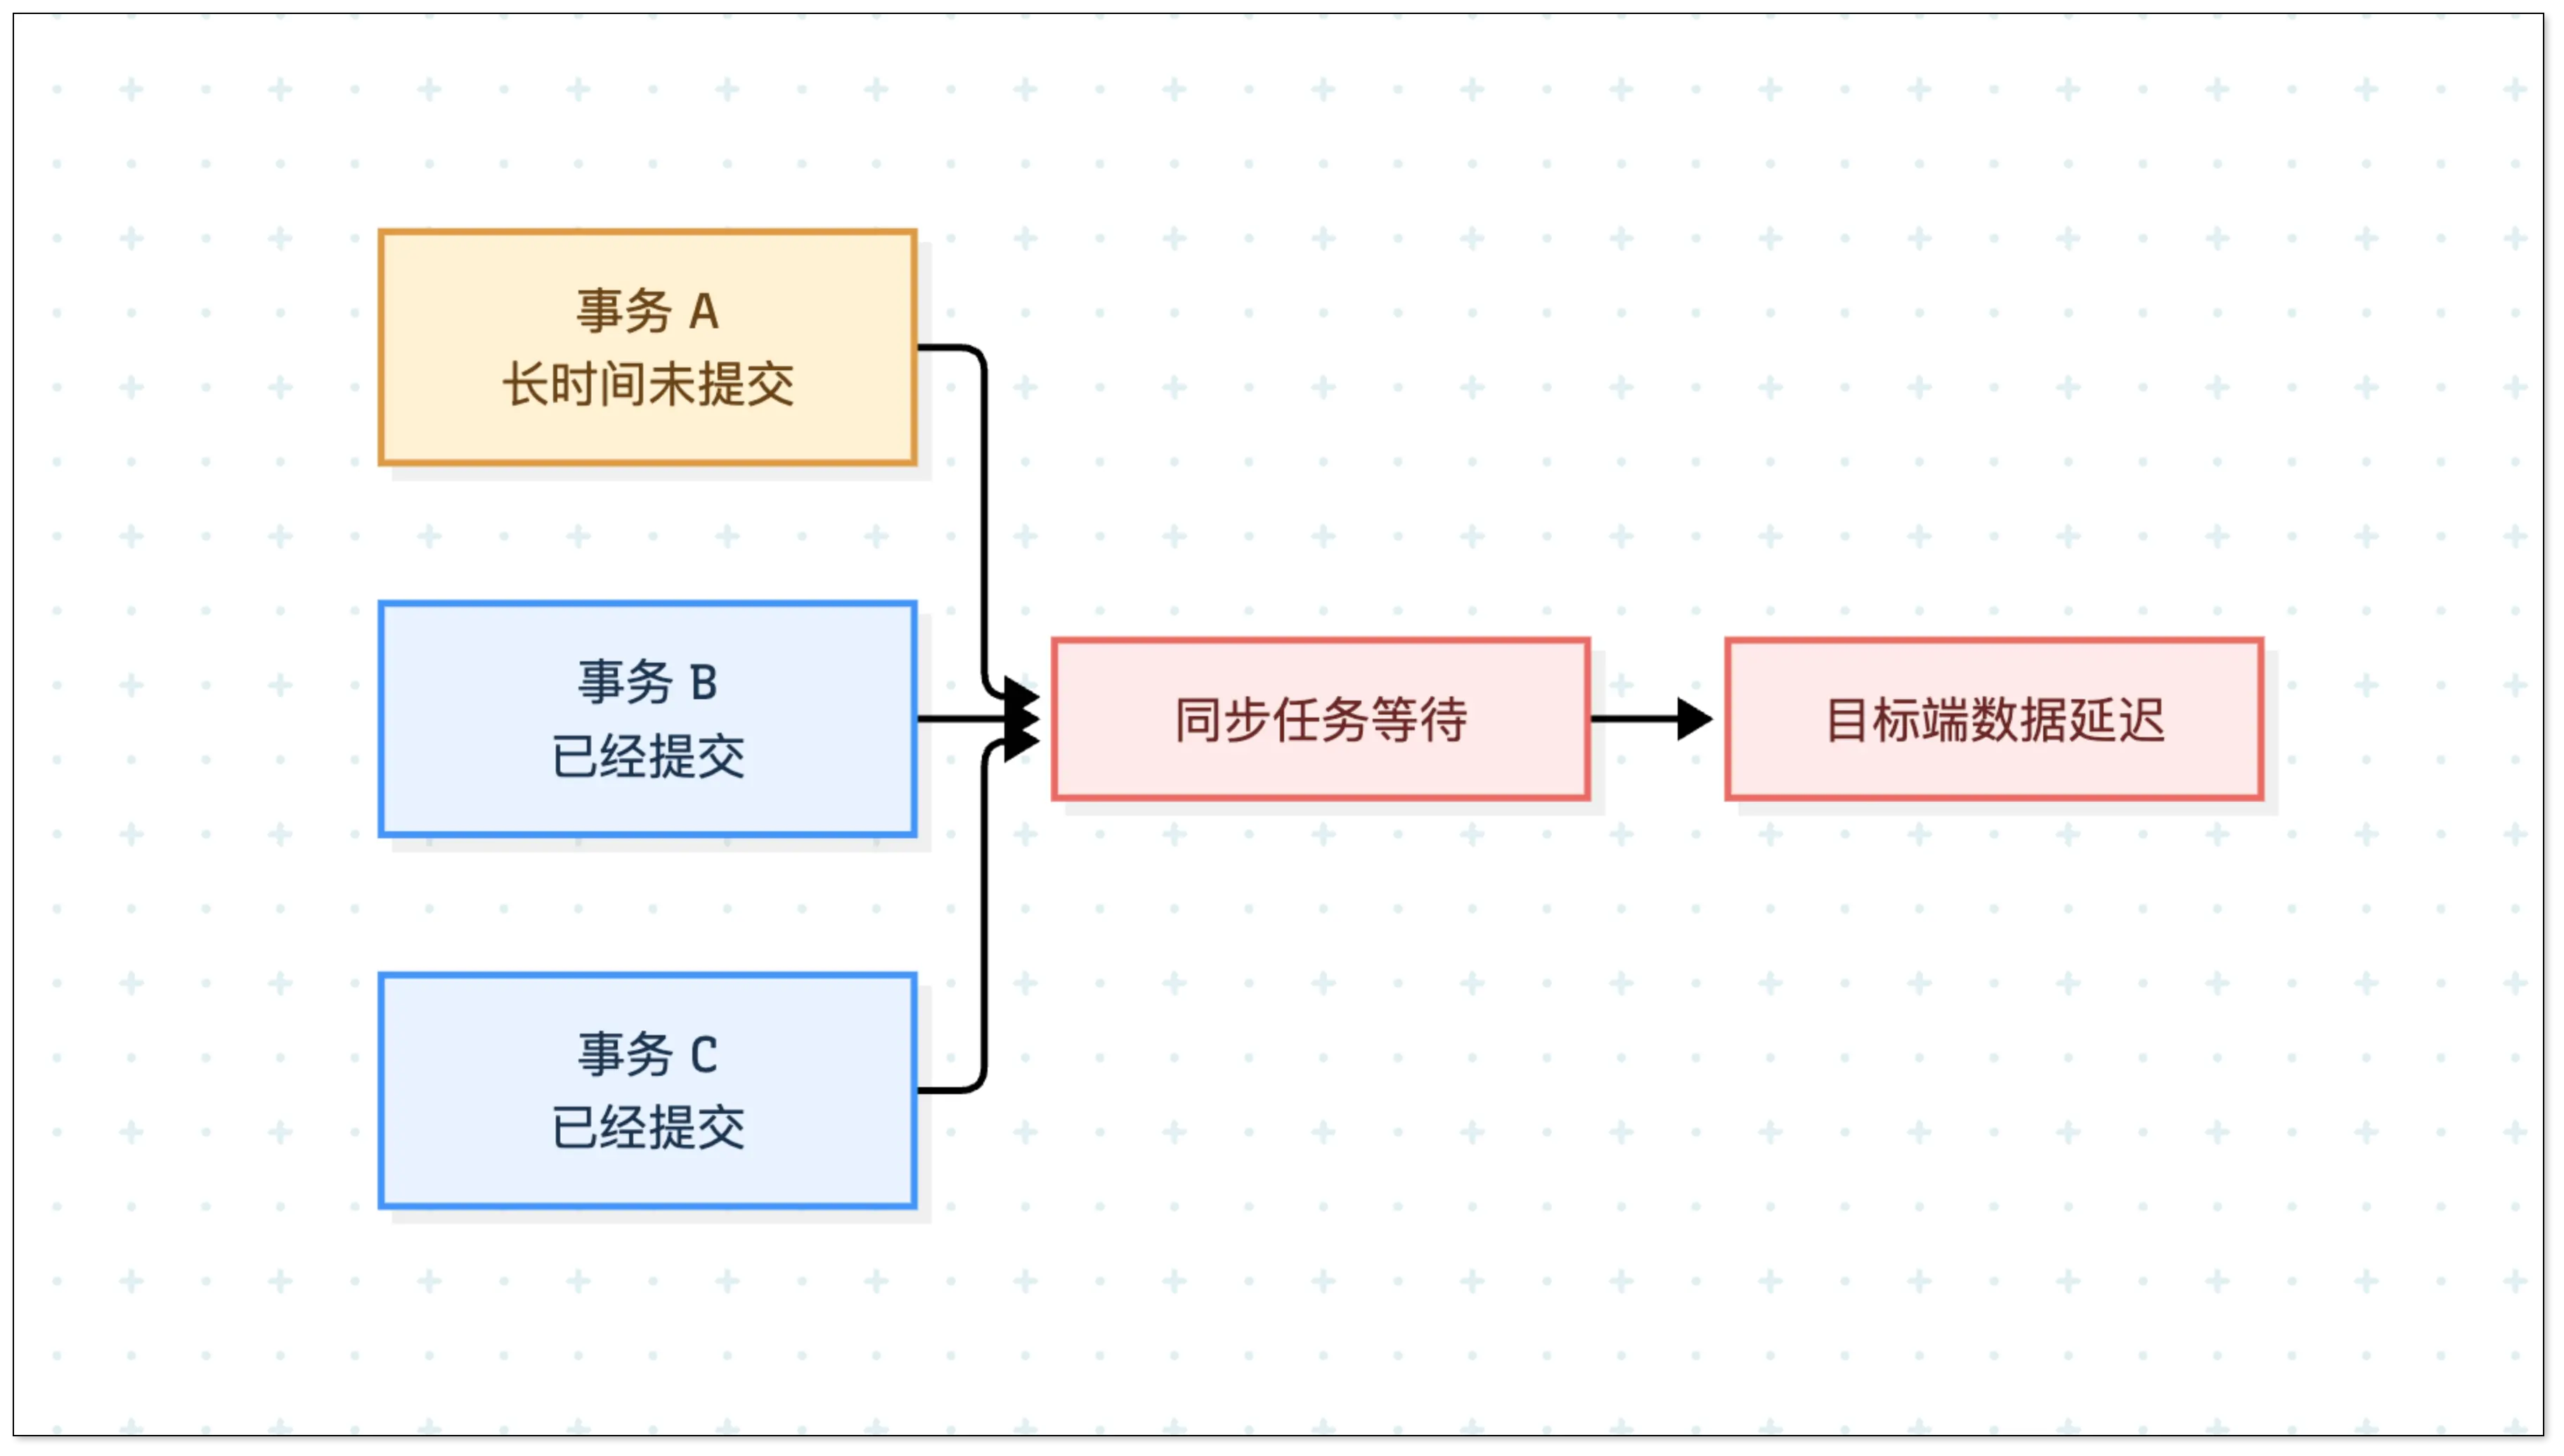
- 事务 A 正在批量更新历史订单,几分钟后仍未提交
- 事务 B 新增了一笔订单,已经提交
- 事务 C 更新了库存,也已经提交
长事务 A 没结束时,任务还不知道它最终会提交还是回滚。如果先处理后面的 B、C,并继续推进进度,就必须留下足够的信息,保证将来仍能回来处理 A。做不到这一点,就可能漏掉数据。
所以,等待 A 是一种合理的选择。CloudCanal 原有的 BLOCK 模式采用这种方式,等前面的未提交事务结束后,再继续处理后续数据。这种方法比较直接,也更能保证数据完整性。但也有代价,A 等得越久,B、C 到达下游的时间也越晚。
对长事务很少的业务,这种等待可能几乎没有影响。但如果 HANA 中经常运行批量处理、人工操作或大范围更新,单个长事务就可能持续拉高整条同步链路的延迟。
新模式:先同步已提交的事务
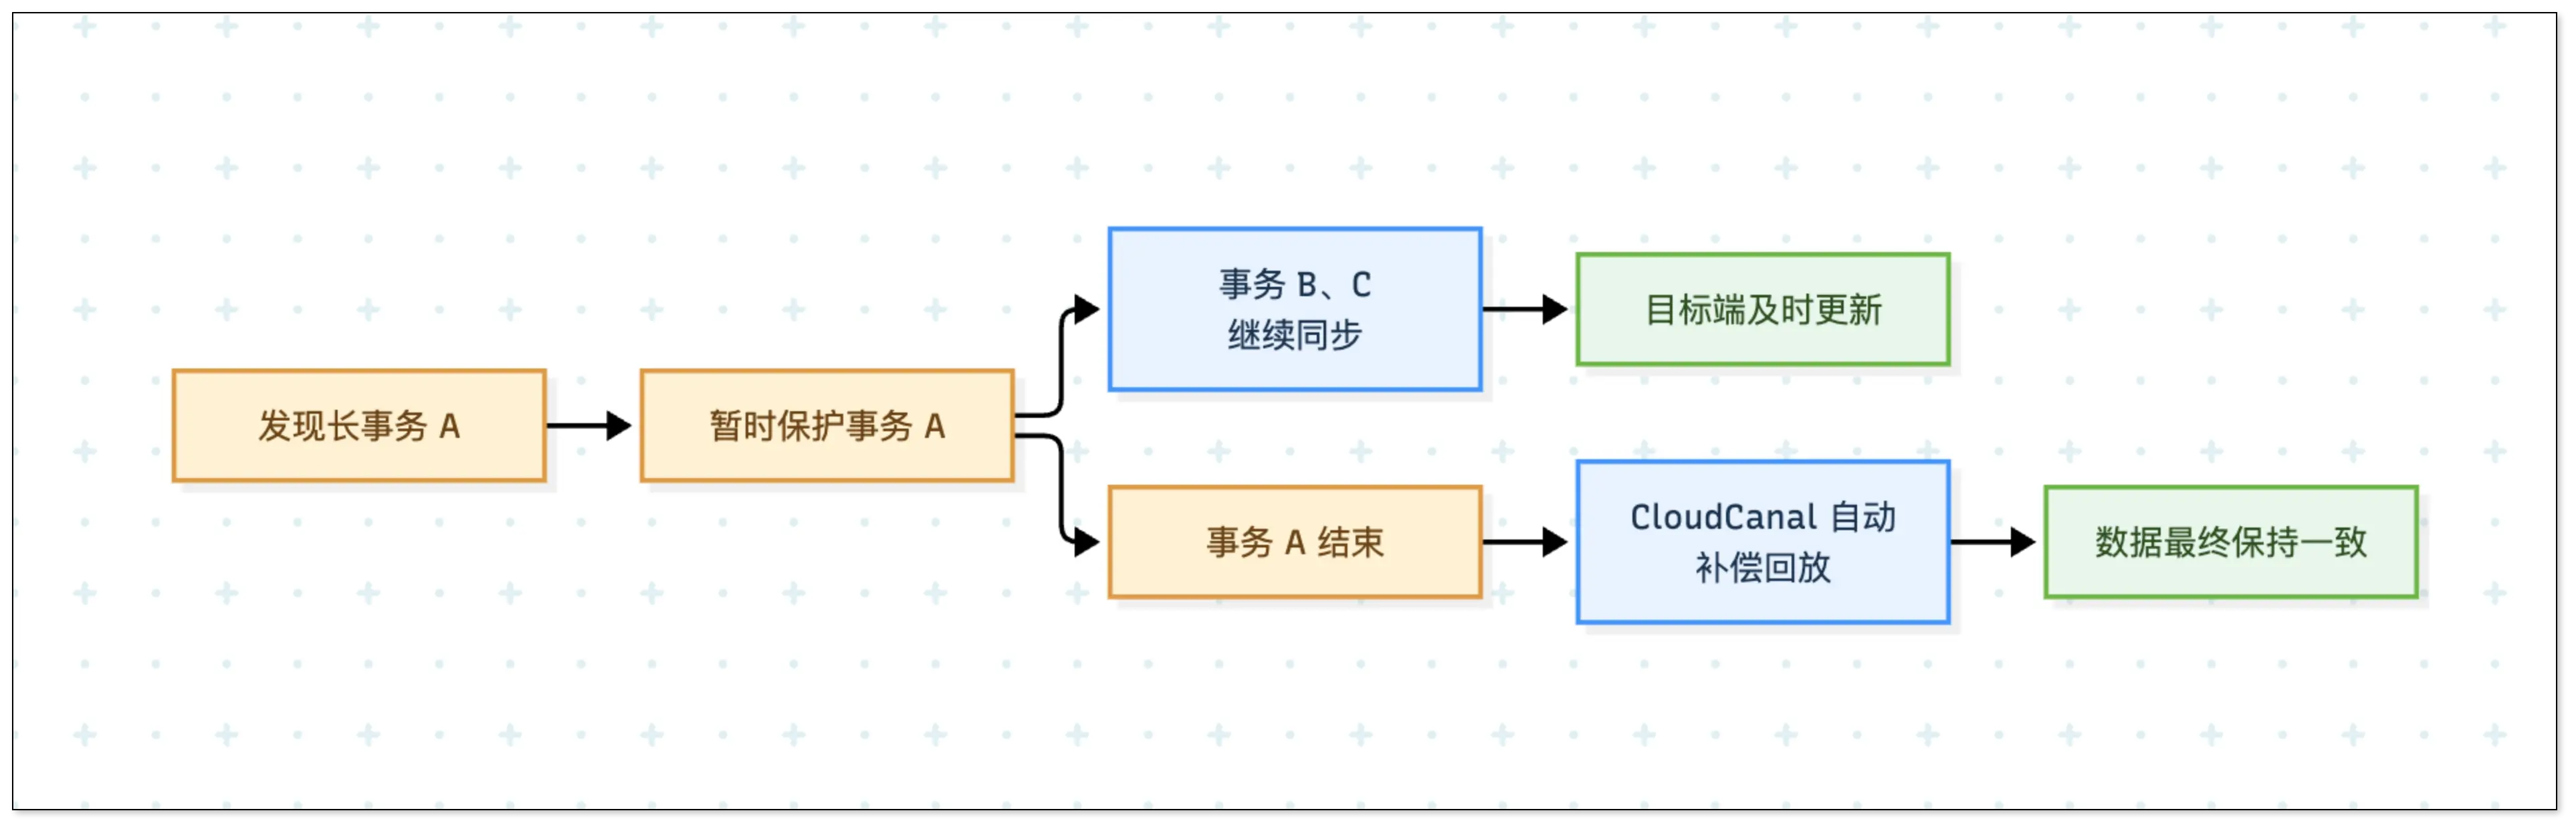
另一种处理思路是,先同步已经提交的事务 B、C,同时记住尚未结束的事务 A。
CloudCanal 近期为 SAP HANA 表级增量同步增加了 PENDING_REPLAY 模式,采用的就是这一方法。遇到未结束的事务时,任务会暂时保存相关数据,让后续已提交的变更继续同步。等长事务结束,再自动回看并补齐相关数据,无需用户手动调整同步进度或重新同步。
这样一来,长事务仍要等到结束才能得到最终处理,但它不会让后面已提交的数据被阻塞住,从而大大降低了链路延迟。
两种模式怎么选?
以上两种模式并没有优劣之分,而是由业务的具体需求决定。
CloudCanal 仍保留原有 BLOCK 模式,并将它作为默认选项。有更高实时性要求的用户,可以按业务场景选择 PENDING_REPLAY。
| 对比项 | BLOCK 模式 |
PENDING_REPLAY 模式 |
|---|---|---|
| 遇到长事务 | 等待事务结束 | 暂时保护,继续处理后续数据 |
| 后续已提交数据 | 安全等待 | 可以先到达目标端 |
| 同步延迟 | 可能受长事务影响 | 长事务期间仍可持续同步 |
| 长事务结束后 | 恢复正常同步 | 自动补偿相关数据 |
| 更适合 | 长事务少、关注处理顺序 | 长事务较多、关注实时性 |
切换模式前,可以先从一个延迟较高的任务入手。看延迟升高的时间,是否与 HANA 中的长事务重合,再看事务结束后,任务延迟是否随之回落。如果两者没有明显关系,还需要继续排查目标端写入、网络和任务资源。
确认是长事务造成等待后,再用业务数据验证新模式。重点看后续已提交的数据能否按预期到达,以及长事务提交或回滚后,目标端的数据是否符合预期。目标表的主键设计和重复数据处理策略,也需要一并检查。
如何切换模式?
该能力已随 CloudCanal 6.4.0.0 发布。
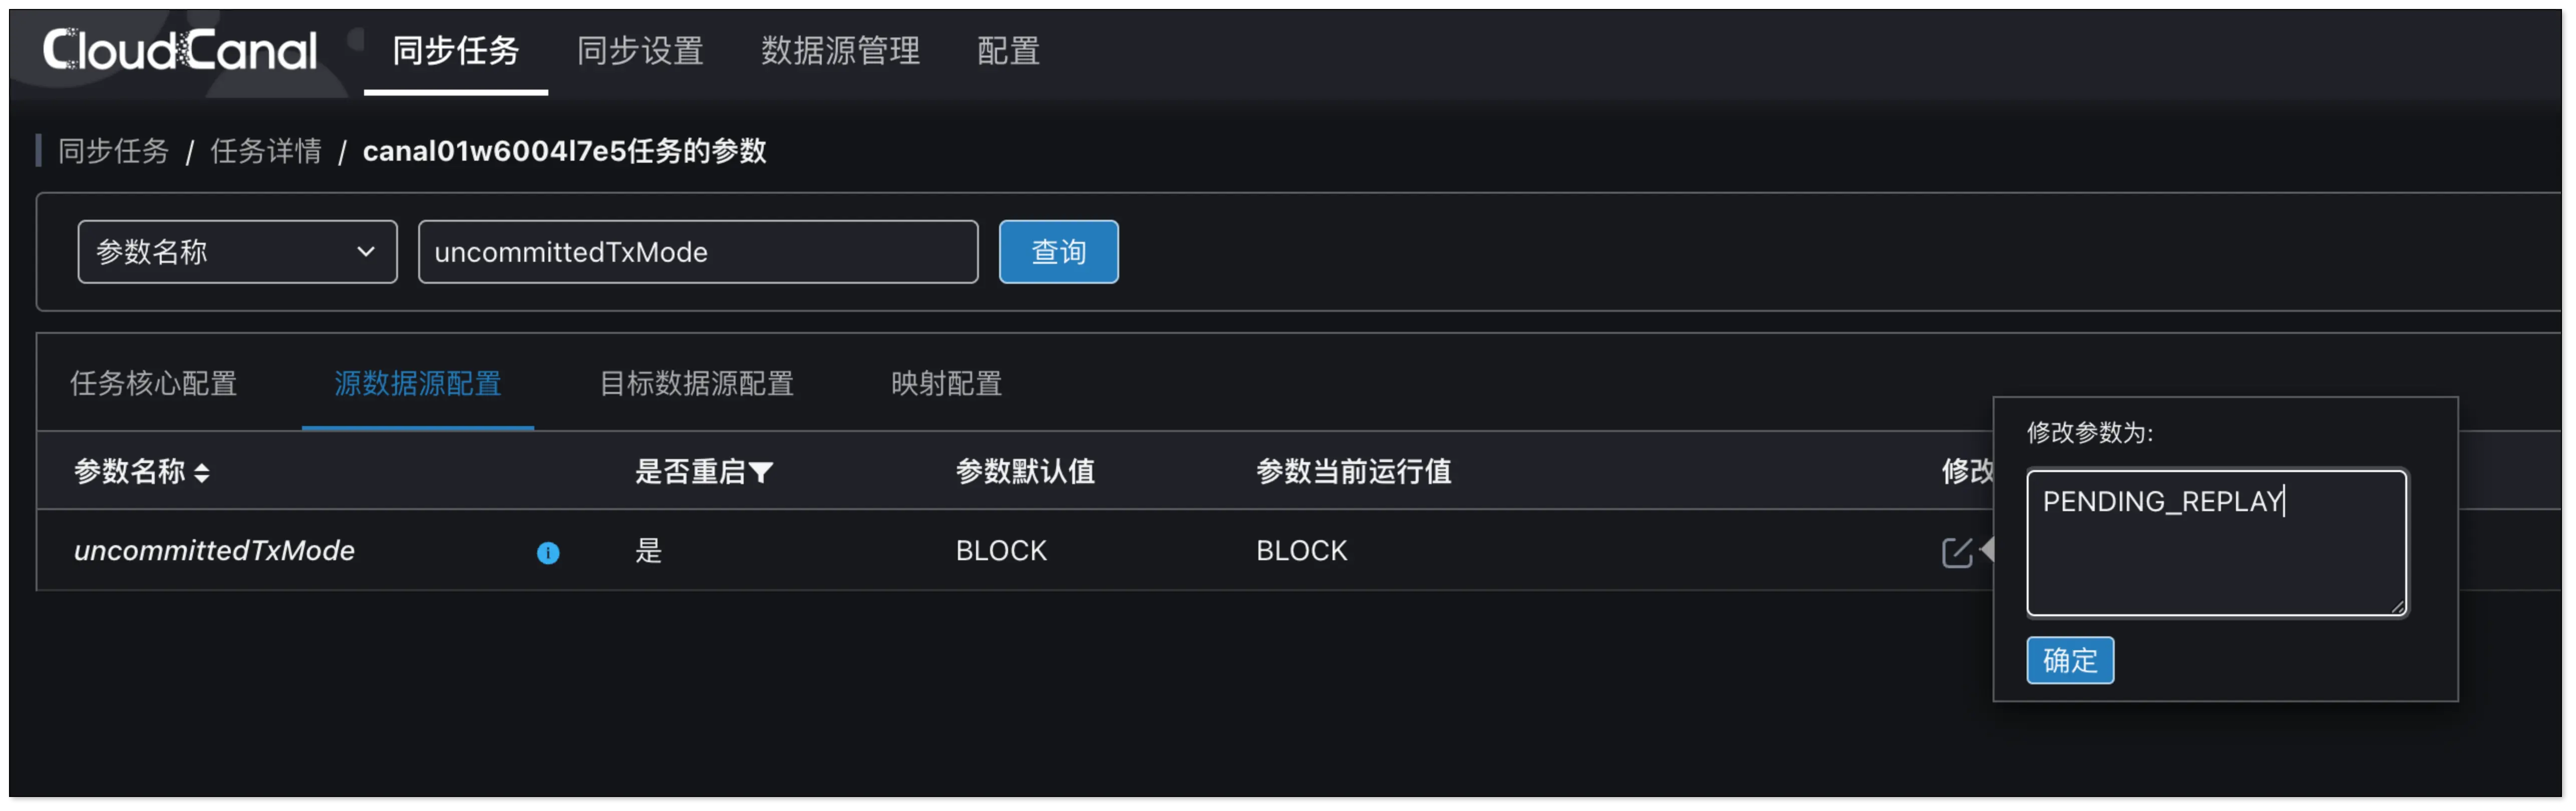
创建或配置 SAP HANA 源端任务时:
- 使用表级 CDC 模式;
- 在源端高级参数中,将
uncommittedTxMode从默认的BLOCK调整为PENDING_REPLAY; - 确认目标端主键设计和重复数据处理策略符合业务要求。
未修改配置的历史任务仍保持原有行为,不会因为版本升级自动改变同步方式。
总结
CloudCanal 对 SAP HANA 的支持,始终围绕生产环境中的实际需求持续完善。从多种目标端的迁移与同步,到数据校验、版本兼容和表级 CDC,改进都指向同一个目标,让 HANA 数据链路更稳定,也更适合长期运行。
此次新增的未提交事务非阻塞模式,解决的同样是生产中会遇到的问题。批量业务、财务结算或库存调整形成长事务时,后续已提交的数据仍能及时服务下游。
你在同步 SAP HANA 数据时是否碰到过什么问题?欢迎在评论区交流。