目录
[下面是一个用 C++ 实现的查找(Find)代码:](#下面是一个用 C++ 实现的查找(Find)代码:)
[七. 二叉搜索树的实现代码](#七. 二叉搜索树的实现代码)
[八. 二叉搜索树 key 和 key/value 使用场景](#八. 二叉搜索树 key 和 key/value 使用场景)
一,前言
二叉搜索树(Binary Search Tree,简称 BST)是计算机科学中最基础也最重要的数据结构之一。它在有序数据的存储、查找、插入和删除操作中扮演着核心角色,是理解更高级数据结构(如平衡二叉树、红黑树、B 树等)的基石。本文将从二叉搜索树的定义出发,深入剖析其核心原理、基本操作、复杂度分析、遍历方式、应用场景以及进阶话题,力求为读者呈现一份全面而深入的万字详解。
无论你是刚接触数据结构的初学者,还是希望系统梳理知识体系的进阶开发者,本文都将为你提供清晰、实用的指导。我们将通过大量的图示、代码示例和实战案例,帮助你真正理解二叉搜索树,而不仅仅是记住它的定义。
二,二叉搜索树的概念
什么是二叉搜索树
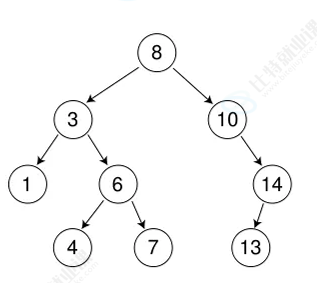
二叉搜索树是一棵二叉树,它满足以下性质:对于树中的任意节点,其左子树中所有节点的值都小于该节点的值,其右子树中所有节点的值都大于该节点的值。这一性质使得二叉搜索树在有序数据的管理上具有天然的优势。
更正式地,二叉搜索树(或称为二叉排序树、二叉查找树)要么是一棵空树,要么具有下列性质:
- 若左子树不为空,则左子树上所有节点的值均小于根节点的值。
- 若右子树不为空,则右子树上所有节点的值均大于根节点的值。
- 左、右子树也分别为二叉搜索树。
需要注意的是,⼆叉搜索树中可以⽀持插⼊相等的值,也可以不⽀持插⼊相等的值,具体看使⽤场景定义,后续我 们学习map/set/multimap/multiset系列容器底层就是⼆叉搜索树,其中map/set不⽀持插⼊相等 值,multimap/multiset⽀持插⼊相等值
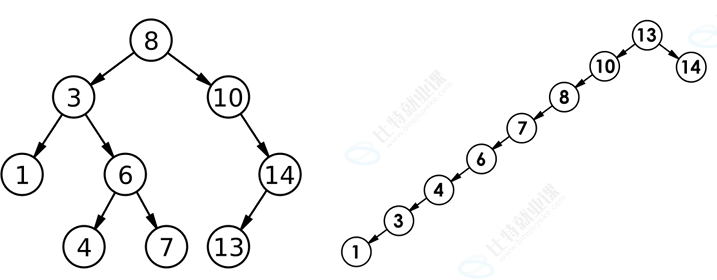
下图为二叉搜索树:
二叉搜索树的结构特点
二叉搜索树的结构特点决定了它的查找效率。由于每个节点都满足"左小右大"的约束,我们在查找一个值时,可以像二分查找一样,每次比较后排除一半的搜索空间。这种特性使得二叉搜索树在理想情况下(即树保持平衡时)的查找、插入和删除操作的时间复杂度均为 O(log n)。
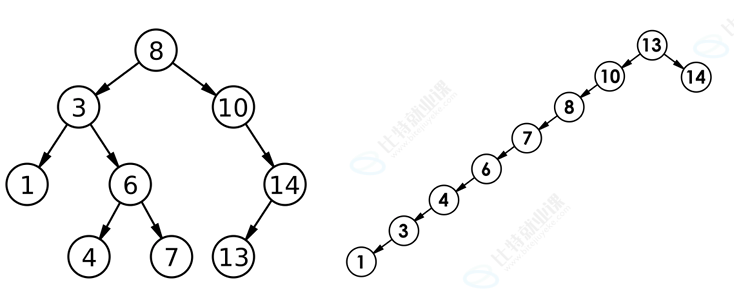
然而,如果插入的数据是有序的(例如从小到大依次插入) ,二叉搜索树会退化成一条链表,此时所有操作的时间复杂度都会退化为 O(n)。这是二叉搜索树最需要警惕的问题,也是后续引入平衡二叉树(如 AVL 树、红黑树)的根本原因。
下面的图片可以看出其问题:
另外需要说明的是,⼆分查找也可以实现O(logN) 级别的查找效率,但是⼆分查找有两⼤缺陷:
需要存储在⽀持下标随机访问的结构中,并且有序。
插⼊和删除数据效率很低,因为存储在下标随机访问的结构中,插⼊和删除数据⼀般需要挪动数 据。 这⾥也就体现出了平衡⼆叉搜索树的价值。
二叉搜索树的结构代码
cpp
#pragma once
#include<iostream>


template<class K>
class BSTNode
{
public:
	BSTNode(const K& _key)
		:_val(_key)
		, _left(nullptr)
		, _right(nullptr)
	{}

	K _val = 0;
	BSTNode<K>* _left = nullptr;
	BSTNode<K>* _right = nullptr;
};

template<class K>
class BSTree
{
	using Node = BSTNode<K>;
public:


private:
	Node* _root = nullptr;
};
三,二叉搜索树的性能分析
时间复杂度
二叉搜索树的各项操作(查找、插入、删除)的时间复杂度都取决于树的高度 h。在理想情况下,树是平衡的,高度 h = O(log n),因此各项操作的时间复杂度为 O(log n)。但在最坏情况下,如果插入的数据是有序的,树会退化为一条链表,高度 h = O(n),此时各项操作的时间复杂度退化为 O(n)。
下表总结了二叉搜索树在不同情况下的时间复杂度:
| 操作 | 平均情况(平衡树) | 最坏情况(退化链表) |
|---|---|---|
| 查找 | O(log n) | O(n) |
| 插入 | O(log n) | O(n) |
| 删除 | O(log n) | O(n) |
| 中序遍历 | O(n) | O(n) |
空间复杂度
二叉搜索树的空间复杂度为 O(n),因为每个节点需要存储值、左子节点指针和右子节点指针。递归操作(如递归查找、递归插入)还需要额外的栈空间,其空间复杂度为 O(h),即 O(log n)(平衡情况下)或 O(n)(最坏情况下)。
四,二叉搜索树的查找
查找是二叉搜索树最核心的操作。给定一个目标值,我们从根节点开始,将目标值与当前节点的值进行比较:
- 如果目标值等于当前节点的值,则查找成功。
- 如果目标值小于当前节点的值,则递归地在左子树中查找。
- 如果目标值大于当前节点的值,则递归地在右子树中查找。
- 如果当前节点为空,则查找失败。
下面是一个用 C++ 实现的查找(Find)代码:
cpp
bool Find(const K& x)
{
	Node* cur = _root;
	while (cur)
	{
		if (cur->_val > x)
		{
			cur =cur->_left;
		}
		else if (cur->_val < x)
		{
			cur = cur->_right;
		}
		else
		{
			return true;
		}
	}
	return false;
}
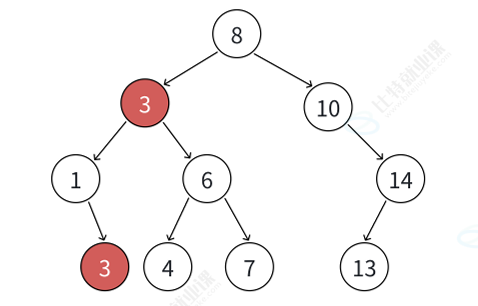
注意:如果⽀持插⼊相等的值,意味着有多个x存在,⼀般要求查找中序的第⼀个x。如下图,查找3,要 找到1的右孩⼦的那个3返回。
查找操作的时间复杂度取决于树的高度。在平衡的情况下,树的高度约为 log₂n,因此查找的时间复杂度为 O(log n)。在最坏情况下(树退化为链表),查找的时间复杂度为 O(n)。
五,二叉搜索树的插入
插⼊的具体过程如下:
树为空,则直接新增结点,赋值给root指针。
树不空,按⼆叉搜索树性质,插⼊值⽐当前结点⼤往右⾛,插⼊值⽐当前结点⼩往左⾛,找到空位 置,插⼊新结点。
如果⽀持插⼊相等的值,插⼊值跟当前结点相等的值可以往右⾛,也可以往左⾛,找到空位置,插 ⼊新结点。(要注意的是要保持逻辑⼀致性,插⼊相等的值不要⼀会往右⾛,⼀会往左⾛)
插入操作同样遵循二叉搜索树的性质。我们从根节点开始,比较待插入值与当前节点的值:如果待插入值小于当前节点值,则向左子树移动;如果大于,则向右子树移动。直到找到一个空位置,将新节点插入其中。
插入操作的关键在于:新节点总是作为叶子节点插入,不会破坏树中已有节点的相对位置。
int a\[\] = {8, 3, 1, 10, 6, 4, 7, 14, 13};
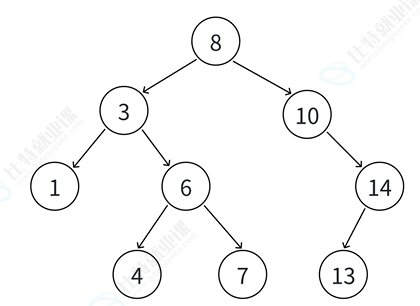
分别插入16与3如下图;
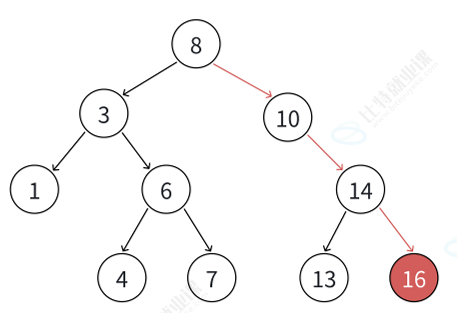
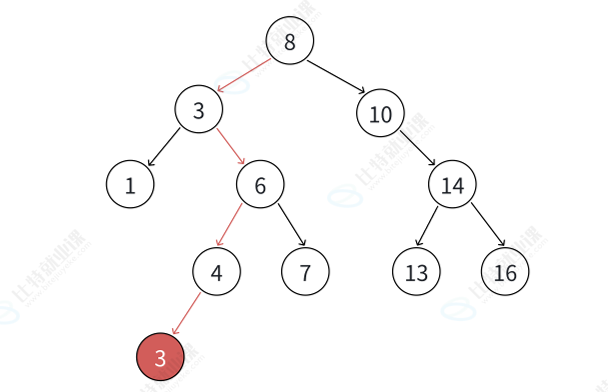
插入操作的时间复杂度与查找相同,在平衡情况下为 O(log n),在最坏情况下为 O(n)。
插入(Insert)的代码实现
cpp
bool insert(const K& x)
{
	if (_root == nullptr)
	{
		_root = new Node(x);
		return true;
	}
	Node* parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_val > x)
		{
			parent = cur;
			cur = parent->_left;
		}
		else if (cur->_val < x)
		{
			parent = cur;
			cur = parent->_right;
		}
		else
		{
			return false;
		}
	}

	cur = new Node(x);

	if (parent->_val > x)
		parent->_left = cur;
	else
		parent->_right = cur;

	return true;

}
六,二叉搜索树的删除
删除操作是二叉搜索树中最复杂的操作,因为删除一个节点后,需要保持树仍然满足二叉搜索树的性质。
⾸先查找元素是否在⼆叉搜索树中,如果不存在,则返回false。 如果查找元素存在则分以下四种情况分别处理:(假设要删除的结点为N)
-
要删除结点N左右孩⼦均为空
-
要删除的结点N左孩⼦位空,右孩⼦结点不为空
-
要删除的结点N右孩⼦位空,左孩⼦结点不为空
-
要删除的结点N左右孩⼦结点均不为空
对应以上四种情况的解决⽅案:
-
把N结点的⽗亲对应孩⼦指针指向空,直接删除N结点(情况1可以当成2或者3处理,效果是⼀样 的)
-
把N结点的⽗亲对应孩⼦指针指向N的右孩⼦,直接删除N结点
-
把N结点的⽗亲对应孩⼦指针指向N的左孩⼦,直接删除N结点
-
⽆法直接删除N结点,因为N的两个孩⼦⽆处安放,只能⽤替换法删除 。找N左⼦树的值最⼤结点 R(最右结点)或者N右⼦树的值最⼩结点R(最左结点)替代N,因为这两个结点中任意⼀个,放到N的 位置,都满⾜⼆叉搜索树的规则。替代N的意思就是N和R的两个结点的值交换,转⽽变成删除R结 点,R结点符合情况2或情况3,可以直接删除。
parent:为cur的父亲
cur:为需要删除的结点
root:整棵二叉搜索树的根
样例1:
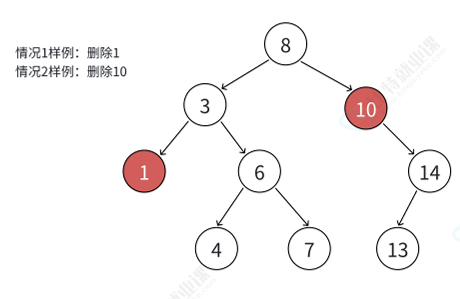
结点1没有左右孩子,所以可以直接删除。
结点10有右孩子没有左孩子,所以我们只用将parent的right接到cur的right结点。
样例2:
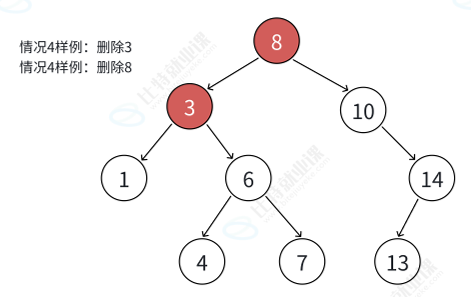
结点3有左右孩子,但是不是root,所以我们可以使用左子树的最大值或者右子树的最小值进行替换,然后将其结点3删除。
结点8有左右孩子,且为root,删除是一样的,但是需要将root变为新的root。
删除(Erase)的代码
cpp
bool Erase(const K& x)
{
	Node* parent = nullptr;
	Node* cur = _root;
	while (cur)
	{
		if (cur->_val > x)
		{
			parent = cur;
			cur = parent->_left;
		}
		else if (cur->_val < x)
		{
			parent = cur;
			cur = parent->_right;
		}
		else
		{
			if (cur->_left == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_right;
					delete cur;
				}
				else
				{
					if (parent->_left == cur)
					{
						parent->_left = cur->_right;
						delete cur;
					}
					else
					{
						parent->_right = cur->_right;
						delete cur;
					}
				}
			}
			else if (cur->_right == nullptr)
			{
				if (cur == _root)
				{
					_root = cur->_left;
					delete cur;
				}
				else
				{
					if (parent->_left == cur)
					{
						parent->_left = cur->_left;
						delete cur;
					}
					else
					{
						parent->_right = cur->_left;
						delete cur;
					}
				}
			}
			else
			{
				Node* ans = cur;
				Node* ansSon = cur->_left;
				while (ansSon->_right)
				{
					ans = ansSon;
					ansSon = ans->_right;
				}
				cur->_val = ansSon->_val;
				if (ans->_left == ansSon)
				{
					ans->_left = ansSon->_left;
				}
				else
				{
					ans->_right = ansSon->_left;
				}
				delete ansSon;

			}
			return true;
		}
	}
	return false;

}
删除操作的s时间复杂度同样为 O(log n)(平衡情况下)或 O(n)(最坏情况下)。
七. 二叉搜索树的实现代码
下面给出一个完整的 C++ 二叉搜索树实现,包含查找、插入、删除、遍历等核心操作,并提供了内存清理的析构函数:
cpp
#include <iostream>
#include <queue>

struct Node {
    int value;
    Node* left;
    Node* right;
    Node(int val) : value(val), left(nullptr), right(nullptr) {}
};

class BinarySearchTree {
private:
    Node* root;

    Node* insert(Node* node, int value) {
        if (node == nullptr) {
            return new Node(value);
        }
        if (value < node->value) {
            node->left = insert(node->left, value);
        } else if (value > node->value) {
            node->right = insert(node->right, value);
        }
        return node;
    }

    bool contains(Node* node, int target) {
        if (node == nullptr) {
            return false;
        }
        if (target == node->value) {
            return true;
        } else if (target < node->value) {
            return contains(node->left, target);
        } else {
            return contains(node->right, target);
        }
    }

    Node* findMin(Node* node) {
        while (node->left != nullptr) {
            node = node->left;
        }
        return node;
    }

    Node* deleteNode(Node* node, int value) {
        if (node == nullptr) {
            return nullptr;
        }
        if (value < node->value) {
            node->left = deleteNode(node->left, value);
        } else if (value > node->value) {
            node->right = deleteNode(node->right, value);
        } else {
            if (node->left == nullptr && node->right == nullptr) {
                delete node;
                return nullptr;
            }
            if (node->left == nullptr) {
                Node* temp = node->right;
                delete node;
                return temp;
            }
            if (node->right == nullptr) {
                Node* temp = node->left;
                delete node;
                return temp;
            }
            Node* successor = findMin(node->right);
            node->value = successor->value;
            node->right = deleteNode(node->right, successor->value);
        }
        return node;
    }

    void inorder(Node* node) {
        if (node == nullptr) {
            return;
        }
        inorder(node->left);
        std::cout << node->value << " ";
        inorder(node->right);
    }

    void destroy(Node* node) {
        if (node == nullptr) {
            return;
        }
        destroy(node->left);
        destroy(node->right);
        delete node;
    }

public:
    BinarySearchTree() : root(nullptr) {}

    ~BinarySearchTree() {
        destroy(root);
    }

    void insert(int value) {
        root = insert(root, value);
    }

    bool contains(int target) {
        return contains(root, target);
    }

    void deleteNode(int value) {
        root = deleteNode(root, value);
    }

    void inorderTraversal() {
        inorder(root);
        std::cout << std::endl;
    }
};
八. 二叉搜索树 key 和 key/value 使用场景
key搜索场景:
只有key作为关键码,结构中只需要存储key即可,关键码即为需要搜索到的值,搜索场景只需要判断 key在不在。key的搜索场景实现的⼆叉树搜索树⽀持增删查,但是不⽀持修改,修改key破坏搜索树结 构了。
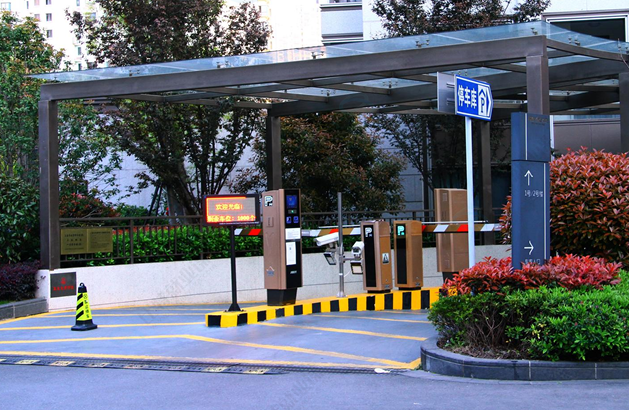
场景1:⼩区⽆⼈值守⻋库,⼩区⻋库买了⻋位的业主⻋才能进⼩区,那么物业会把买了⻋位的业主的 ⻋牌号录⼊后台系统,⻋辆进⼊时扫描⻋牌在不在系统中,在则抬杆,不在则提⽰⾮本⼩区⻋辆,⽆ 法进⼊。
场景2:检查⼀篇英⽂⽂章单词拼写是否正确,将词库中所有单词放⼊⼆叉搜索树,读取⽂章中的单 词,查找是否在⼆叉搜索树中,不在则波浪线标红提⽰。
key/value搜索场景:
每⼀个关键码key,都有与之对应的值value,value可以任意类型对象。树的结构中(结点)除了需要存 储key还要存储对应的value,增/删/查还是以key为关键字⾛⼆叉搜索树的规则进⾏⽐较,可以快速查找到key对应的value。key/value的搜索场景实现的⼆叉树搜索树⽀持修改,但是不⽀持修改key,修 改key破坏搜索树性质了,可以修改value。
场景1:简单中英互译字典,树的结构中(结点)存储key(英⽂)和vlaue(中⽂),搜索时输⼊英⽂,则同时 查找到了英⽂对应的中⽂。
场景2:商场⽆⼈值守⻋库,⼊⼝进场时扫描⻋牌,记录⻋牌和⼊场时间,出⼝离场时,扫描⻋牌,查 找⼊场时间,⽤当前时间-⼊场时间计算出停⻋时⻓,计算出停⻋费⽤,缴费后抬杆,⻋辆离场。
场景3:统计⼀篇⽂章中单词出现的次数,读取⼀个单词,查找单词是否存在,不存在这个说明第⼀次 出现,(单词,1),单词存在,则++单词对应的次数。
代码实现:
cpp
#pragma once
#include<iostream>
using namespace std;

namespace key_value
{
	template<class K, class V>
	struct BSTNode
	{
		K _key;
		V _value;

		BSTNode<K, V>* _left;
		BSTNode<K, V>* _right;

		BSTNode(const K& key, const V& value)
			:_key(key)
			, _value(value)
			, _left(nullptr)
			, _right(nullptr)
		{}
	};

	// Binary Search Tree
	// Key/value
	template<class K, class V>
	class BSTree
	{
		//typedef BSTNode<K> Node;
		using Node = BSTNode<K, V>;
	public:
		// 强制生成构造
		BSTree() = default;

		BSTree(const BSTree& t)
		{
			_root = Copy(t._root);
		}

		BSTree& operator=(BSTree tmp)
		{
			swap(_root, tmp._root);
			return *this;
		}

		~BSTree()
		{
			Destroy(_root);
			_root = nullptr;
		}

		bool Insert(const K& key, const V& value)
		{
			if (_root == nullptr)
			{
				_root = new Node(key, value);
				return true;
			}

			Node* parent = nullptr;
			Node* cur = _root;

			while (cur)
			{
				if (cur->_key < key)
				{
					parent = cur;
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					parent = cur;
					cur = cur->_left;
				}
				else
				{
					return false;
				}
			}

			cur = new Node(key, value);
			if (parent->_key < key)
			{
				parent->_right = cur;
			}
			else
			{
				parent->_left = cur;
			}

			return true;
		}

		Node* Find(const K& key)
		{
			Node* cur = _root;
			while (cur)
			{
				if (cur->_key < key)
				{
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					cur = cur->_left;
				}
				else
				{
					return cur;
				}
			}

			return nullptr;
		}

		bool Erase(const K& key)
		{
			Node* parent = nullptr;
			Node* cur = _root;

			while (cur)
			{
				if (cur->_key < key)
				{
					parent = cur;
					cur = cur->_right;
				}
				else if (cur->_key > key)
				{
					parent = cur;
					cur = cur->_left;
				}
				else
				{
					// 删除
					// 左为空
					if (cur->_left == nullptr)
					{
						if (cur == _root)
						{
							_root = cur->_right;
						}
						else
						{
							if (parent->_left == cur)
							{
								parent->_left = cur->_right;
							}
							else
							{
								parent->_right = cur->_right;
							}
						}
						delete cur;

					}
					else if (cur->_right == nullptr)
					{
						if (cur == _root)
						{
							_root = cur->_left;
						}
						else
						{
							// 右为空
							if (parent->_left == cur)
							{
								parent->_left = cur->_left;
							}
							else
							{
								parent->_right = cur->_left;
							}
						}

						delete cur;

					}
					else
					{
						// 左右都不为空
						// 右子树最左节点
						Node* replaceParent = cur;
						Node* replace = cur->_right;
						while (replace->_left)
						{
							replaceParent = replace;
							replace = replace->_left;
						}

						cur->_key = replace->_key;

						if (replaceParent->_left == replace)
							replaceParent->_left = replace->_right;
						else
							replaceParent->_right = replace->_right;

						delete replace;
					}

					return true;
				}
			}

			return false;
		}

		void InOrder()
		{
			_InOrder(_root);
			cout << endl;
		}
	private:
		void _InOrder(Node* root)
		{
			if (root == nullptr)
			{
				return;
			}

			_InOrder(root->_left);
			cout << root->_key << ":" << root->_value << endl;
			_InOrder(root->_right);
		}

		void Destroy(Node* root)
		{
			if (root == nullptr)
				return;

			Destroy(root->_left);
			Destroy(root->_right);
			delete root;
		}

		Node* Copy(Node* root)
		{
			if (root == nullptr)
				return nullptr;

			Node* newRoot = new Node(root->_key, root->_value);
			newRoot->_left = Copy(root->_left);
			newRoot->_right = Copy(root->_right);
			return newRoot;
		}
	private:
		Node* _root = nullptr;
	};
}
结语:
二叉搜索树是数据结构中重要的基础工具,具备良好的动态性和有序性支持。虽然原始形态存在退化风险,但结合自平衡机制后,成为现代编程语言和系统中不可或缺的组件。理解其原理与实现,有助于深入掌握高级数据结构与算法设计思想。
希望可以给你提供帮助,谢谢观看!!!