过去两年,神经语音合成(TTS)的自然度突飞猛进,但绝大多数开源方案都共享一个前置步骤:先用一个神经音频编解码器,把语音"切碎、量化"成一个个离散 token,再让语言模型像写文章一样逐 token 预测。这个步骤顺手、好用,却也在源头丢掉了呼吸、停顿、语气转折等大量细节。OpenBMB(面壁智能与清华团队,MiniCPM 系列的作者)开源的VoxCPM 反其道而行:它不使用离散语音分词器,直接在连续潜空间里端到端生成语音。最新的VoxCPM2 以2B 参数支持30 种语言、9 种汉语方言、48kHz 录音棚音质、文字描述凭空创造音色与零样本声音克隆,在一张消费级显卡上即可实时运行。本文把它的原理、架构、部署、效果与边界一次讲清。
一、先厘清概念: " 无需分词器 " 到底砍掉了什么
1.1 主流神经 TTS 的标准流水线
当前主流的大模型式 TTS,无论闭源 API 还是多数开源项目,基本遵循这样一条链路:文本 → 音素 / 文本 token → 离散语音 token → 声码器还原波形。其中第二步的"离散语音 token",由 VQ-VAE、EnCodec、DAC 等神经音频编解码器产生:它们把连续的语音波形压缩、量化为码本(codebook)里的一个个离散编号。这样做的最大好处是------语音被变成了"文字一样的符号",可以直接套用成熟的大语言模型自回归范式,工程上非常顺手。
1.2 关键澄清:砍掉的是 " 音频分词器 " ,不是文本分词
"Tokenizer-Free / 无需分词器"这个名字很容易被误解为"连文本都不分词"。这是必须先纠正的一点。VoxCPM 仍然读取文本 token,它的语言模型仍然按 token 序列工作;它真正去掉的,是把目标语音预先量化成离散音频 token 的那个神经编解码分词器 。取而代之的,是一个可微的"半离散瓶颈"(FSQ,有限标量量化)加上连续潜空间里的扩散---自回归生成。换句话说:输入端文本照常分词,被省略的是输出端对语音的离散化压缩。
1.3 离散语音 token 的四个固有代价
把连续语音硬塞进有限码本,本质是一种有损压缩,工程上会带来四类典型问题:
· 量化信息损失 :码本编号只能近似原信号,齿音、气声、微弱的情绪纹理在量化中被磨平。· 边界韵律伪影 :token是有边界的离散单元,拼接处容易出现不自然的停顿、咔哒声与韵律断层。· 表现力受码本容量限制 :能表达的音色与情感上限,受限于码本覆盖度,跨语言、跨情绪时尤其吃力。· 高采样率与多语种成本高:要提升采样率或覆盖更多语言,往往需要重建编解码器、重训码本,链路冗长。
|----------|---------------------------------------------------|------------------------------------|
| 对比维度 | 离散 token 路线( VQ/EnCodec/DAC ) | VoxCPM 连续潜空间路线 |
| 语音表示 | 码本中的离散编号 | AudioVAE 连续潜变量 + FSQ 半离散约束 |
| 生成方式 | 自回归预测离散 token,再解码 | 自回归规划 + 流匹配扩散逐 patch 生成连续潜变量 |
| 细粒度细节 | 受量化损失影响 | 连续建模保留呼吸、停顿、情绪转折 |
| 高采样率 | 常需外部上采样/重建编解码器 | AudioVAE V2 非对称 16k 编码→48k 解码,内置超分 |
| 工程范式 | 直接复用 LLM 预测符号,成熟 | 融合语言模型与扩散模型,更新但更复杂 |
1.4 一句话定义 VoxCPM
用三句话给它下定义:其一,VoxCPM 是一个无离散音频分词器的端到端 TTS 系统 ;其二,它不是简单的声码器或 TTS 前端,而是一套包含语义规划、声学建模、扩散解码与声音克隆的完整语音生成模型;其三,它与开发者的关系在于------以 Apache-2.0 开源、可商用、能在消费级显卡本地运行,让高质量多语种语音合成与声音克隆不再被闭源API 垄断。
二、 VoxCPM 是什么:团队、版本与关键事实
2.1 出身与定位
VoxCPM 来自 OpenBMB 社区,背后是面壁智能与清华大学的研究团队------也就是端侧小模型 MiniCPM、MiniCPM-V 多模态系列的同一支队伍。它延续了"小而强、能上端、彻底开源"的路线:模型权重与代码均以Apache-2.0协议开放,允许免费商用。项目托管在 GitHub 的 OpenBMB/VoxCPM,并同步发布到 HuggingFace 与 ModelScope,目前已收获数万 GitHub star(不同第三方统计站点与时点口径不一,具体以官方仓库为准)。
2.2 三代演进:从 0.5B 中英模型到 2B 多语种语音基础模型
|-------------------|--------------------------|---------------|----------------------|
| 对比项 | VoxCPM-0.5B (首发) | VoxCPM1.5 | VoxCPM2 (最新) |
| 状态 | 历史版本 Legacy | 稳定版 Stable | 最新推荐 Latest |
| 骨干参数量 | 0.5B | 0.6B | 2B |
| 采样率 | 16kHz | 44.1kHz | 48kHz |
| 语言 | 中、英 2 种 | 中、英 2 种 | 30 种语言 + 9 种汉语方言 |
| 克隆方式 | 提示音频续写 | 仅续写式 | 独立参考通道 + 续写 |
| 音色设计 Voice Design | 不支持 | 不支持 | 支持 |
| 可控声音克隆 | 不支持 | 不支持 | 支持 |
| RTF(RTX 4090) | 约 0.17 | 约 0.15 | 约 0.30 |
| RTF(Nano-vLLM 加速) | 约 0.10 | 约 0.08 | 约 0.13 |
| 显存占用 | 约 5GB | 约 6GB | 约 8GB |
| 全参/LoRA 微调 | 支持 | 支持 | 支持 |
说明:RTF 即实时率(Real-Time Factor),合成 1 秒音频耗时 RTF 秒,小于 1 即快于实时。VoxCPM2 因参数量与采样率提升,标准 PyTorch 实现 RTF 约 0.30,经专用推理引擎 Nano-vLLM 加速后可低至约 0.13。上表参数量、采样率、显存、RTF 均以官方 PyPI(voxcpm 2.0.2)版本对照表为准。
2.3 VoxCPM2 关键事实速览
|----------|---------------------------------------------------|
| 项目 | 内容 |
| 参数量 / 骨干 | 2B,基于 MiniCPM-4 语言模型骨干 |
| 训练数据 | 超过 200 万小时多语种语音(官方口径) |
| 音频规格 | 接收 16kHz 参考音频,原生输出 48kHz,内置超分 |
| 语言覆盖 | 30 种语言,多数无需语言标签;另含 9 种汉语方言 |
| 核心能力 | 上下文感知 TTS、Voice Design、可控克隆、Ultimate 高保真续写克隆、实时流式 |
| 硬件门槛 | 约 8GB 显存;Python≥3.10、PyTorch≥2.5、CUDA≥12.0 |
| 开源协议 | Apache-2.0,权重与代码均可商用 |
9 种汉语方言分别为四川话、粤语、吴语、东北话、河南话、陕西话、山东话、天津话、闽南话------方言覆盖密度在开源 TTS 中相当少见,也是它在国内消费级应用与无障碍场景走红的原因之一。
2.4 发布时间线
2025 年 9 月,VoxCPM 首发并公开技术报告(arXiv:2509.24650,后被 ICLR 2026 接收),确立"无分词器 + 分层语义---声学建模 + 半离散残差表示"路线;2025 年 12 月推出 VoxCPM1.5,采样率提升至 44.1kHz;2026 年 4 月发布 VoxCPM2,参数扩到 2B、原生 48kHz、新增音色设计与可控克隆、覆盖 30 语言与 9 方言,并在 2026 年中放出 VoxCPM2 技术报告(arXiv:2606.06928)。理解这条演进线,就能理解它的能力跃迁主要来自"采样率、语言广度与可控性",而无分词器的核心架构是一脉相承的。
三、为什么说离散语音 token 是一种 " 有损的妥协 "
3.1 神经音频分词器是怎么工作的
要理解 VoxCPM 的取舍,先要明白被它省略的那一步在做什么。以 VQ-VAE 为代表、并被 EnCodec、DAC 等沿用的神经音频编解码器,通常用一个编码器把波形压成连续隐向量,再通过矢量量化( VQ ) 把每个隐向量映射到一张"码本"里最近的离散编号;为了在低码率下保住音质,还常使用残差矢量量化( RVQ )------用多级码本逐级逼近原始信号。解码时再把这些编号查表还原、经声码器重建波形。语言模型看到的,就是这样一串离散编号。
3.2 它的真正吸引力:语音被 " 文字化 " , LLM 范式直接复用
这套设计在工程上极具诱惑:一旦语音变成离散符号,过去几年在文本大模型上积累的全部能力------自回归 Transformer、KV Cache、指令微调、上下文学习------都可以原样搬到语音上。VALL-E 一类"语言模型式 TTS"由此诞生,声音克隆也简化为"给一段 token 前缀让模型续写"。这也是为什么离散 token 路线在 2023--2025 年成为主流。
3.3 但代价在 " 听感 " 和 " 表现力 " 上集中爆发
问题在于,语音不是文字。文字本身就是离散符号,而语音是连续、充满副语言信息的信号。把它压进有限码本,会在四个层面付出代价:
· 码率与音质的两难 :码本越小、码率越低,量化越粗糙,齿音、气声、空间感丢失越明显;要提音质就得堆多级 RVQ,token 序列变长、建模变贵。· 韵律被 token 边界切割 >:自然语言里的呼吸、犹豫、句中情绪渐变是连续的,离散单元拼接容易产生机械停顿、重音错位和"机器味"。· 码本冲突与音色平均化 :大量声学细节共享有限编号,稀有音色、强情绪、方言口音容易被"平均"掉,克隆的相似度上限受限。· 跨语种与高采样率不经济:新增语言或把 16kHz 提到 48kHz,往往要重训编解码器与码本,链路长、迁移难。
3.4 VoxCPM 的绕开方式:连续潜空间 + 半离散瓶颈 + 扩散解码
VoxCPM 的思路是,不再追求把语音彻底符号化,而是让语言模型与扩散模型在连续潜空间里分工协作:语言模型负责高层的语义与韵律规划,扩散模型负责把连续的声学细节"画"出来;中间用一个可微的半离散瓶颈(FSQ)诱导两者自然分工,既保留连续表示的细腻,又获得类似离散token 的结构规整与训练稳定性。这正是论文标题中"Tokenizer-Free"与"分层语义---声学建模"的含义,也是它在呼吸、停顿、句中情绪转换上更自然的根本原因。
四、技术架构:四阶段流水线如何工作
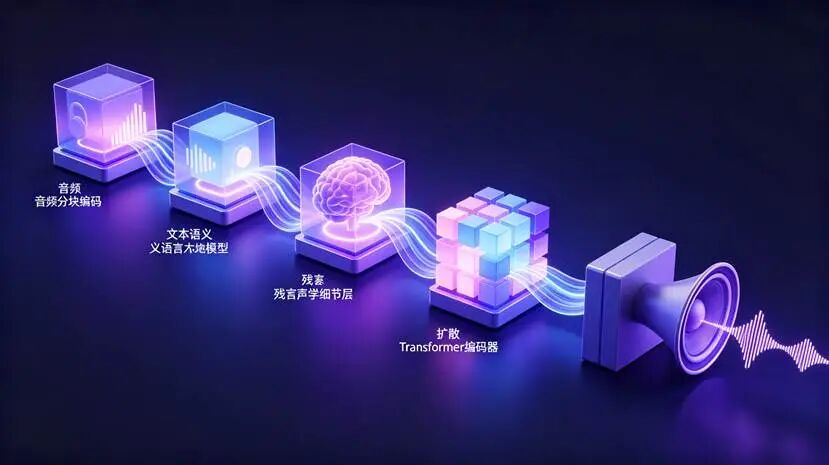
VoxCPM 系列共享同一条高层生成路径:文本 → 四阶段生成流水线 → AudioVAE 解码器 → 波形。它以 MiniCPM-4 为语言模型骨干,结合分层语言建模与 FSQ 约束的连续潜变量,把"高层语义规划"与"低层声学渲染"解耦。下面逐个模块拆解。
4.1 Local Encoder ( LocEnc ,局部编码器):先把音频 " 切块 "
LocEnc 把连续音频帧组织成 patch(块),编码为紧凑的局部表示。这一步的动机很实际:原始音频帧率极高(每秒上万采样点),即使降到隐空间帧率,序列长度仍然可观。把相邻帧打成patch,能显著缩短语言模型需要处理的有效序列长度,为长文本合成和更快推理铺路------这与视觉 Transformer 把图像切成 patch 是同一思想。
4.2 Text-Semantic LM ( TSLM ,文本 --- 语义语言模型):决定 " 怎么说 "
TSLM 是基于 MiniCPM-4 的因果语言模型,联合处理文本 token 与音频嵌入,捕捉高层语义意图。它负责"说什么、用什么语气说"------根据文本内容规划韵律、节奏、停顿与重音。VoxCPM 主打的"上下文感知合成"(自动从文本推断情绪与语气)主要发生在这一层。
4.3 FSQ 半离散瓶颈:让分层 " 自发特化 " 的关键
在语义与声学之间,VoxCPM 没有使用传统 VQ 的码本查表,而是引入FSQ ( Finite Scalar Quantization ,有限标量量化) 构成的可微半离散瓶颈:它把连续表示投影到若干有界标量上并做隐式的标量舍入,无需维护庞大码本,也避免了码本崩溃、利用率低等问题,同时保持可微、可端到端训练。论文指出,正是这个瓶颈诱导出自然的功能分工------TSLM 倾向于产出语义 --- 韵律计划,而 RALM 专注恢复细粒度声学细节。可以把它理解为一道"软闸门":既不像纯连续那样难以规整,也不像硬码本那样把信息一刀量化死。
4.4 Residual Acoustic LM ( RALM ,残差声学语言模型):补回声音的质感
RALM 与语义路径协同,专门建模 TSLM 不负责的细粒度声学信息------音色、齿音、气息、空间反射等。它在"抽象语义计划"与"最终高保真音频"之间起衔接作用,本质上是用残差思路把语义模型"顾不上"的声学细节补回来。
4.5 Local DiT ( LocDiT ,局部扩散 Transformer ):把声音 " 画 " 出来
LocDiT 是一个以语言模型输出为条件的条件流匹配( CFM , Conditional Flow Matching )扩散 Transformer,在每个自回归步内对一个音频patch 做连续潜变量的扩散生成。流匹配是近年比传统扩散更简洁、采样更快的一类生成范式(VoxCPM的LocDiT 实现参考了CosyVoice 的Flow Matching 与DiTAR 的扩散---自回归骨干)。语义/声学条件决定"内容与走向",扩散过程负责生成连续、丰富、不被码本量化的声学纹理。
4.6 AudioVAE 与非对称超分:从潜变量到 48kHz 波形
生成的连续潜变量最后由 AudioVAE 解码为波形:训练时它提供潜表示,推理时把预测的潜变量还原成采样点。VoxCPM2 升级为AudioVAE V2 ,采用非对称设计 ------ 以 16kHz 编码、却以 48kHz 解码,并带采样率条件。这意味着语言模型侧仍工作在较短、较高效的序列上,输出端却能直接得到 48kHz 录音棚音质,相当于把超分能力内置进解码器,无需再外挂一个上采样器;参考音频即使只有16kHz,也能输出48kHz。
4.7 VoxCPM2 的四项内部改进
|-------------|----------------|-------------------------|-------------------|
| 方面 | VoxCPM 1.x | VoxCPM2 | 带来的收益 |
| RALM 融合方式 | 逐元素相加 | 先拼接再经可学习投影 | 语义与声学可更自由交互,细节更丰富 |
| LocDiT 条件输入 | 单一融合条件 token | 多 token 条件前缀 | 缓解过早融合的信息坍缩,更可控 |
| 参考音频通路 | 仅提示音频续写 | 结构隔离的独立参考通道 | "仅参考"克隆更强,音色身份更稳 |
| AudioVAE | 对称编解码 | AudioVAE V2 非对称 16k→48k | 不拉长序列即原生输出 48kHz |
把这些模块串起来看,VoxCPM 的工程美学很清晰:用 patch 化压缩序列长度,用语言模型规划语义韵律,用 FSQ 软瓶颈做分层,用残差声学模型补细节,用扩散 Transformer 生成连续声学,再用非对称 VAE 超分到高采样率。它没有一处依赖离散音频码本,却同样获得了自回归语言模型的可控性与可克隆性。
五、四大核心能力与调用方式
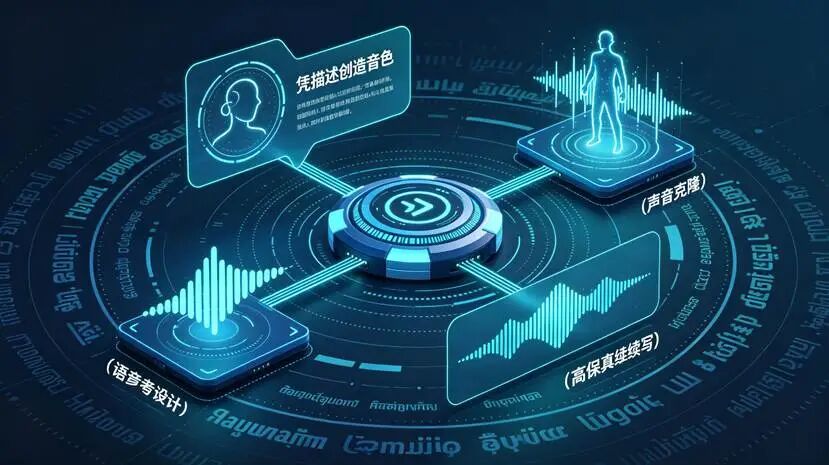
5.1 上下文感知的基础合成
最基础的文本转语音不只是"念字",模型会根据文本内容自动推断合适的语气、停顿与情感(Context-Aware Synthesis)。调用时两个关键参数是cfg_value (classifier-free guidance 强度,官方示例取 2.0,值越高越贴合条件)与inference_timesteps(扩散步数,示例取 10,步数越多通常越精细但越慢)。最简调用如下:
from voxcpm import VoxCPM
import soundfile as sf
model = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)
wav = model.generate(text="要合成的文本", cfg_value=2.0, inference_timesteps=10)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
5.2 Voice Design :用一句话 " 凭空设计 " 音色
这是 VoxCPM2 最具想象力的能力:不需要任何参考音频,只要在文本开头用括号描述想要的声音(性别、年龄、音色、情绪、语速),模型就会生成一个全新的说话人。约定格式是把描述放在text 开头的英文括号内,例如:
wav = model.generate(text="(A young woman, gentle and sweet voice)Hello, welcome to VoxCPM2!")
中文场景可写"(一位中年男性,低沉磁性、播音腔、语速平稳)......"。它本质上是把自然语言当作音色的控制条件,适合有声书角色音、虚拟人、快速试音等没有现成参考声的场景。
5.3 Controllable Cloning :短样本克隆,还能二次控制
给一段几秒到十几秒的参考音频(reference_wav_path),模型即可克隆其音色;与许多"克隆即固定"的方案不同,你还能再用控制指令调整情感、语速与风格,同时保留原始音色:
wav = model.generate(text="(slightly faster, cheerful tone)合成内容", reference_wav_path="voice.wav")
这让"同一个声音、不同情绪/语速"的批量生产成为可能,适合需要品牌统一音色但表达多样的客服、数字人与短视频配音。
5.4 Ultimate Cloning :续写式高保真克隆
追求极致相似度时使用终极克隆:同时提供参考音频及其准确转写文本(prompt_wav_path + prompt_text),模型以"音频续写"的方式无缝接续,忠实保留参考声音的音色、节奏、情感与风格;官方还建议把同一段参考同时传给reference_wav_path 与prompt_wav_path 以获得最高相似度。该模式自VoxCPM1.5 延续而来,适合对还原度要求极高的配音场景。
5.5 实时流式与多语种
通过 generate_streaming 接口可分块产出音频,配合约 0.13--0.30 的 RTF,足以支撑边生成边播放的实时对话。语言方面,VoxCPM2 覆盖阿拉伯、缅、中、丹麦、荷、英、芬兰、法、德、希腊、希伯来、印地、印尼、意、日、高棉、韩、老挝、马来、挪威、波兰、葡、俄、西班牙、斯瓦希里、瑞典、他加禄、泰、土耳其、越南共30 种语言,多数情况下无需显式语言标签直接输入即可;外加 9种汉语方言。
六、本地部署与生产实战
6.1 环境与安装
官方要求 Python ≥ 3.10、PyTorch ≥ 2.5.0、CUDA ≥ 12.0。安装与获取模型都很直接:
pip install voxcpm# 安装依赖包
模型默认从 HuggingFace 拉取 openbmb/VoxCPM2;国内网络可用 ModelScope:先 pip install modelscope,再用snapshot_download("OpenBMB/VoxCPM2") 得到本地目录,传给 from_pretrained。命令行也提供 voxcpm design(音色设计)、voxcpm clone(克隆)、voxcpm batch(按文本清单批量合成)等子命令;运行 python app.py --model-dir 本地模型目录 --port 8808 可起一个网页 Demo。
6.2 三版本怎么选:按显存与音质取舍
|--------------------------|-------------|-----------------------------|
| 部署条件 / 需求 | 建议版本 | 理由 |
| 显存 5GB 左右、只需中英、追求最低延迟 | VoxCPM-0.5B | 16kHz、RTF 约 0.17,轻量够用 |
| 显存 6GB、要更高音质的中英合成 | VoxCPM1.5 | 44.1kHz、RTF 约 0.15,性价比高 |
| 显存 8GB 起、多语种/方言/音色设计/48k | VoxCPM2 | 能力最全,Nano-vLLM 下 RTF 约 0.13 |
需要说明,VoxCPM2 标准 PyTorch 实现 RTF 约 0.30(仍远快于实时),换上专用推理引擎后吞吐大幅提升。
6.3 高并发生产部署: Nano-vLLM-VoxCPM
单机试玩用 PyTorch 即可;要做高并发服务,官方提供专用引擎 Nano-vLLM-VoxCPM(pip install nano-vllm-voxcpm),在 RTX 4090 上 RTF 可低至约 0.13,支持批量并发请求与异步 API,并自带 FastAPI HTTP 服务,便于封装成企业内部 TTS 接口。典型用法是VoxCPM.from_pretrained(model=本地路径, devices=0) 启动服务端,再以 generate(target_text=...) 流式取音频。
6.4 端侧与异构生态:不只有 NVIDIA 一条路
社区围绕 VoxCPM 已形成较完整的部署生态,覆盖不同硬件:
|------------------|---------------------------------|
| 项目 | 能力 |
| VoxCPM.cpp | GGML/GGUF 推理,支持 CPU、CUDA、Vulkan |
| VoxCPM-ONNX | 导出 ONNX,用于 CPU 推理与跨平台集成 |
| VoxCPMANE | Apple Neural Engine(苹果端侧神经引擎)后端 |
| voxcpm_rs | Rust 重实现,适合高性能服务嵌入 |
| ComfyUI-VoxCPM 等 | ComfyUI 节点 / 浏览器 TTS 扩展,接入创作工作流 |
这意味着它既能跑在数据中心 GPU,也在向个人电脑、苹果设备、甚至无独显的 CPU 环境下沉------与 MiniCPM 家族"端侧优先"的定位一致。需要注意的是,这些第三方后端的成熟度、支持的版本与功能完整度各不相同,生产使用前应实测验证。
6.5 用 5--10 分钟音频做专属音色微调
除了零样本克隆,VoxCPM 还支持全参微调( SFT )与 LoRA 微调。官方给出的门槛相当低:仅需约 5--10 分钟的音频,即可适配特定说话人、语言或垂直领域(如某地方言、品牌专属嗓音、特定术语发音)。LoRA 方式参数高效、便于热插拔多个音色,官方推荐优先使用:
python scripts/train_voxcpm_finetune.py --config_path conf/voxcpm_v2/voxcpm_finetune_lora.yaml
并提供 lora_ft_webui.py 训练/推理网页界面。配合"零样本克隆应对长尾、LoRA 沉淀高频音色"的组合,企业可以低成本搭建自己的音色资产库。
6.6 克隆效果调优与参考音频准备(实战)
同样的模型,参考音频质量与参数设置不同,克隆效果可能差一个档次。结合官方建议与工程实践,可从以下几方面调优。
第一,参考音频 " 干净 " 比 " 高清 " **更重要。**优先选择单人说话、底噪低、无背景音乐、无混响、无他人插话的片段;音量适中、不削波。VoxCPM2 接收 16kHz 参考即可经 AudioVAE V2 超分到 48kHz,因此不必强求高采样率源文件,清晰度与干净度才是关键;参考音频本身噪声较大时,可在加载时启用降噪器(from_pretrained的load_denoiser 设为True)。
第二,时长与内容覆盖要够。 零样本克隆几秒到十几秒即可,但参考片段最好覆盖较完整的音素与自然语调,避免只用一个短促语气词。做Ultimate 续写克隆时,prompt_text必须与参考音频里实际说出的内容逐字一致,转写错字、漏字会明显拉低相似度;官方还建议把同一段参考同时传给reference_wav_path 与prompt_wav_path,以获得最高一致性。
**第三,理解并调节两个核心推理参数。**cfg_value 是无分类器引导强度,官方示例取 2.0:调大更贴合文本/风格条件但可能发硬,调小更自然但可能"不听话";inference_timesteps 是扩散步数,示例取 10,加大通常更精细但更慢,追求实时可适当下调。二者建议在自己的语料上做小网格对比,而不是直接照搬默认值。
第四,接受并利用 " 可控生成的随机性 " **。**Voice Design 与可控克隆每次结果会有差异,官方建议生成 1--3 次择优;批量生产时可固定随机种子、对满意结果留档。长文本建议按句切分后再合成拼接,或直接走流式接口,以降低长序列的漂移与失败重试成本。
**第五,建立自己的验收闭环。**不要只凭单条试听下结论:准备 20--50 条覆盖目标语种、句式与情感的固定文本,用 ASR 回测 WER/CER 衡量清晰度、用说话人嵌入或人工盲听衡量相似度,并在目标硬件上实测RTF 与显存,再决定选哪个版本、是否上Nano-vLLM 或端侧后端。
七、效果到底如何:看懂指标与横向对比
7.1 先建立看 TTS 榜单的基本框架
TTS 评测主要看三类指标:WER/CER (词错率 / 字错率,越低越好) 用ASR 转写合成语音再比对文本,衡量"念得准不准、清不清晰";SIM (说话人相似度,越高越好) 衡量克隆声音与参考声音像不像;指令式音色设计则看APS/DSD/RP 等对"音频质量、与描述的相似度、韵律"的评分。需要强调:这些数字都来自特定测试集与评测模型,只能反映公开基准上的相对水平,不能等同于你的真实业务听感,最终仍应以自有语料试听为准。
7.2 Seed-TTS-eval :三代模型的清晰度与相似度
|-------------|--------|-----------------|-----------------|-----------------|-----------------|------------------|------------------|
| 模型 | 参数 | 英文 WER↓ | 英文 SIM↑ | 中文 WER↓ | 中文 SIM↑ | 困难集 WER↓ | 困难集 SIM↑ |
| VoxCPM-0.5B | 0.5B | 1.85 | 72.9 | 0.93 | 77.2 | 8.87 | 73.0 |
| VoxCPM1.5 | 0.6B | 2.12 | 71.4 | 1.18 | 77.0 | 7.74 | 73.1 |
| VoxCPM2 | 2B | 1.84 | 75.3 | 0.97 | 79.5 | 8.13 | 75.3 |
数据来自官方 PyPI 公布的 Seed-TTS-eval 结果。可见 VoxCPM2 主要把相似度( SIM **)**整体抬升,中文相似度达到 79.5;清晰度(WER)三代都已处在 1% 上下的高水平,差异不大。这与"无分词器保留更多声学细节、克隆更像"的设计目标一致。
7.3 多语种与低资源语言:它的真正长板
在 Minimax-MLS 多语种测试的相似度(SIM)上,VoxCPM2 在阿拉伯语(79.1)、粤语(83.5)、韩语(83.3)、葡萄牙语(83.7)、西班牙语(83.1)、泰语(84.0)、土耳其语(87.1)、越南语(80.6)等多个语种上超过 Minimax、ElevenLabs、Qwen3-TTS、FishAudio 等对照模型。更能说明问题的是官方一项"30 语言 × 每语言 500 条"的内部可懂度评测(用 Gemini 3.1 Flash Lite 转写打分),在低资源语言上对 Fish S2-Pro 形成碾压式优势:
|----------|--------|-------------|-----------------|
| 语言 | 指标 | VoxCPM2 | Fish S2-Pro |
| 高棉语(km) | CER | 2.05% | 75.15% |
| 老挝语(lo) | CER | 1.90% | 87.40% |
| 希伯来语(he) | CER | 2.98% | 15.27% |
| 中文(zh) | CER | 0.92% | 1.02% |
在指令式音色设计 InstructTTSEval 上,VoxCPM2 中文 APS 为 85.2(与 Qwen3TTS 并列最高),英文 APS/DSD/RP 为 84.2/83.2/71.4,英文三项均居前。这组结果共同指向一个定位:VoxCPM2 的差异化优势在多语种广度、低资源语言可用性与 " 按描述造音色 " 的可控性。
7.4 也要客观看到短板
官方榜单同时披露了它并不占优的语种:例如 Minimax-MLS 测试中,印地语 WER 为 19.699(ElevenLabs 5.827)、罗马尼亚语 21.577(ElevenLabs 1.347)、越南语 3.307(Minimax 0.88)。这说明 30 种语言是"广覆盖"而非"样样顶尖",主流中英与多数语种表现强,个别低资源或特定语种的清晰度仍有差距,落地前务必针对目标语种实测。
7.5 开源 TTS 选型对比(定性)
|---------------------------|--------------------|----------------------|----------|-------------|----------------------|
| 方案 | 技术路线 | 多语种 / 方言 | 音色设计 | 克隆方式 | 端侧 / 协议 |
| VoxCPM2 | 无分词器,连续潜空间扩散---自回归 | 30 语 + 9 汉语方言 | 支持(文字描述) | 可控克隆 + 续写克隆 | 约 8GB,多后端,Apache-2.0 |
| CosyVoice 2 | 语义 token + 流匹配 | 多语种、含方言与指令 | 部分版本支持 | 零样本克隆 | 开源,中文生态成熟 |
| XTTS-v2 | 离散 token 自回归 | 多语种 | 不支持 | 短样本克隆 | 开源,协议有商用限制 |
| F5-TTS | 流匹配扩散(非自回归) | 中英为主 | 不支持 | 零样本克隆 | 开源、推理快 |
| IndexTTS / ChatTTS | 离散/隐变量自回归 | 以中英为主 | 较弱 | 零样本/对话式 | 开源,中文场景活跃 |
| Fish Speech / Fish Audio | 自回归 + 声码器 | 多语种 | 部分支持 | 克隆 | 开源 + 商业云 |
| ElevenLabs / Minimax(闭源云) | 未公开 | 语种广、成熟度高 | 支持 | 克隆能力强 | 仅 API,按量付费、数据经云端 |
说明:上表为基于公开资料的定性对比,各开源项目迭代很快,具体能力、协议条款与性能以其官方最新版本为准。一句话选型建议:要可自托管、可商用、多语种与方言广、还要 " 文字造音色 " 和端侧下沉, VoxCPM2 是当前开源里少有的全能选项;只做单一语种、追求极致成熟度或不想自建运维,商业 API 仍是稳妥选择。
八、适用场景与落地建议
8.1 高匹配场景
· 有声书、播客与短视频配音 :Voice Design 批量造角色音、可控克隆统一旁白音色,48kHz 满足成片音质。· 智能硬件与车机 :约8GB 显存即可运行,配合cpp/ONNX/ANE 后端可向边缘设备下沉,离线合成、不依赖云。· 客服与数字人 :实时流式 +品牌专属音色(LoRA沉淀),自托管使客户语音数据不出域。· 方言保护与多语种出海 :9 种汉语方言与 30 种语言,尤其适合面向东南亚、中东、拉美市场的本地化语音,以及方言无障碍应用。· 游戏 NPC 、教育与无障碍:为大量角色快速生成差异化嗓音,或为阅读障碍、视障群体做高自然度朗读。
8.2 什么时候仍应选商业 API 或其他方案
若团队没有 GPU 运维能力、只服务单一主流语种且对稳定性/SLA 要求极高、或需要完整的录音棚级后期与合规兜底,成熟商业 API 更省心;若只需中英、且团队已在 CosyVoice/F5等栈上深度集成,也未必需要迁移。技术选型的本质是"自托管带来的数据主权、成本与可控性"与"自建带来的运维与调优负担"之间的权衡。
8.3 合规与伦理:声音克隆的红线
VoxCPM 官方在协议中明确:严禁用于冒充他人、电信诈骗、制造虚假信息,并强烈建议对AI 生成语音做显著标注。企业落地时应至少做到三点:克隆音色前取得本人授权、对生成内容保留审计与水印/标识、建立滥用检测与撤回机制。Apache-2.0 解决的是版权与商用授权问题,并不免除使用者在《生成式人工智能服务管理暂行办法》、个人信息与声音权保护等方面的责任。对于需要把"视觉 + 语音 + 3D 点云"打包成交付的项目(例如数字人、智能终端、行业语音终端),建议选择有完整AI 落地经验、能同时承担算法集成与合规交付的团队合作,避免只拿到模型却跑不通业务闭环。
九、局限与风险:避免把 " 无分词器 " 神化
9.1 可控生成仍有随机性
官方明确提示,Voice Design 与可控声音克隆的结果在不同运行之间会有波动,可能需要生成1--3 次才能挑到满意的音色或风格,团队也在持续改进可控一致性。因此它适合"可挑选、可重生成"的内容生产,而对"每次必须严格一致"的确定性播报,仍建议用固定音色 LoRA 或传统方案兜底。
9.2 语言广覆盖不等于处处顶尖
如第七章数据所示,30 种语言里主流中英与多数语种表现优秀,但印地语、罗马尼亚语等个别语种 WER 仍明显偏高;列表之外的语言官方建议自行测试或用自有数据微调。把它当成"开箱即用的万能多语种模型"是危险的,正确姿势是按目标语种建立自己的试听与ASR 回测集。
9.3 硬件与后端成熟度
VoxCPM2 完整能力建议约 8GB 显存,且官方推理路径对 NVIDIA + CUDA 优化最充分;CPU、Vulkan、Apple ANE、ONNX 等多由社区后端提供,支持的版本、功能(如音色设计、流式)与速度参差,落地前必须实测。它也不是音乐生成模型,主要面向人声语音;超长文本、极端情感、强噪声参考音频下的稳定性同样需要验证。
9.4 " 无分词器 " 是路线选择,不是没有量化
需要再次强调一个技术事实:VoxCPM 并非完全没有量化、也不是没有 token。它仍读取文本 token、仍以语言模型处理序列,中间还保留了 FSQ 这一半离散的可微量化瓶颈。它去掉的是"硬码本式的离散音频分词器",用连续潜空间 + 软量化 + 扩散解码换取更细腻的声学表达。这是与离散 token 路线并行的一条技术路线,有其收益(细节、韵律、高采样率),也有代价(融合扩散模型、推理与训练更复杂),不宜简单断言"连续一定全面优于离散"。
9.5 伦理与合规风险
高保真声音克隆天然伴随深度伪造风险:未经授权克隆名人、亲友、企业客服声音用于诈骗或造谣,已在多地触及法律红线。开源可商用(Apache-2.0)只授权了技术本身,使用者仍需自行承担声音授权、内容标识、数据合规与安全评估责任。官方也要求生产部署前做充分的场景化测试与安全评估。
十、总结与趋势判断
10.1 三句话总结 VoxCPM
第一,它用连续潜空间 + FSQ 半离散瓶颈 + 扩散 --- 自回归,绕开了离散音频分词器的量化损失,让呼吸、停顿、情绪等副语言信息得以保留。第二,VoxCPM2以2B 参数、约8GB 显存,把48kHz、30语言、9 方言、文字造音色、可控/续写克隆和实时流式整合进一个 Apache-2.0 可商用的开源模型,并具备 cpp/ONNX/ANE等端侧后端。第三,它的长板在多语种广度、低资源语言、音色可控与自托管主权,短板在个别语种清晰度、可控一致性与第三方后端成熟度。
10.2 趋势判断:语音生成正在 " 从离散符号回归连续信号 "
把 VoxCPM 放在更大的技术脉络里,能看到三个方向:其一,表示方式上 ,业界开始反思"万物皆离散 token"的路径依赖,连续/半离散表示 + 扩散/流匹配正在语音、图像、视频生成中回潮,以换取更高保真度。其二,部署形态上 ,语音模型正快速端侧化、轻量化,8GB显存甚至CPU/手机NPU 可跑、数据不出域的本地TTS,会成为隐私敏感与成本敏感场景的默认选项。其三,能力边界上,TTS 正从"把字念出来"走向"可设计、可克隆、可对话、懂语境"的语音基础模型,并与视觉、3D、数字人结合,成为多模态交互的出口。
10.3 给开发者的行动建议
如果你准备上手,建议按三步走:先用 pip install voxcpm 在一张 8GB 显存的卡上跑通官方 Python/CLI Demo,用自有文本对比 0.5B、1.5、2 三个版本的听感与速度;再针对目标语种/音色建立小规模评测集(ASR 回测 WER/CER + 人工相似度打分),决定用零样本克隆还是 LoRA 沉淀专属音色;最后在需要并发时切换 Nano-vLLM 引擎或评估 cpp/ONNX 端侧后端,并同步落实声音授权与 AI 内容标识。不必追逐每一个新模型,但"无分词器连续语音生成"这条路线,值得每一个做语音产品的团队认真测一次。