目录
Advisor对话拦截
Spring AI 利用面向切面的思想提供 Advisors API,它提供了灵活而强大的方法来拦截、修改和增强 Spring 应用程序中的 AI 驱动交互。
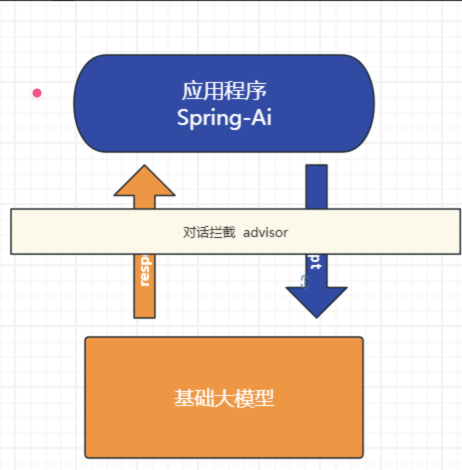
Advisor接口提供了CallAdvisor和组成CallAdvisorChain(适用于非流式场景),以及StreamAdvisor和StreamAdvisorChain(适用于流式场景)。它还包括ChatClientRequest,用于表示未密封的 Prompt 请求,以及ChatClientResponse用于表示聊天完成响应。
日志拦截:
由于 AI 对话过程是一个"黑盒",不利于我们调试,可以利用 SimpleLoggerAdvisor 拦截对话记录,帮助观察我们发了什么信息给大模型,便于调试。
java
    @Test
    public void testAdvisor(@Autowired ChatClient.Builder chatClientBuilder){
        ChatClient chatClient = chatClientBuilder
                .defaultAdvisors(new SimpleLoggerAdvisor()// SimpleLoggerAdvisor() 系统自带的日志拦截器
             )
                .build();
        String content=chatClient.prompt()
                .user("你好!")
                //.advisors()
                .call()
                .content();
        System.out.println(content);
    }
敏感词拦截:
java
 @Test
    public void testAdvisor(@Autowired ChatClient.Builder chatClientBuilder){
        ChatClient chatClient = chatClientBuilder
                .defaultAdvisors(new SimpleLoggerAdvisor(), // SimpleLoggerAdvisor() 系统自带的日志拦截器
                        new SafeGuardAdvisor(List.of("大家")))  //SafeGuardAdvisor()敏感词拦截器
                .build();
        String content=chatClient.prompt()
                .user("你好!大家")
                //.advisors()
                .call()
                .content();
        System.out.println(content);
    }
注:当用户提及与系统存入的敏感词相似,就会被 SafeGuardAdvisor() 拦截。
自定义拦截:
重读拦截器:
重读让 LLMs 重新审视输入问题,通过这种方式让 LLMs 理解问题,发现更复杂的模式。
ReReadingAdvisor:
java
public class ReReadingAdvisor implements BaseAdvisor {
    private  static  final  String DEFAULT_USER_TEXT_ADVISE= """
            {re2_input_query}
            Read the question again: {re2_input_query}
            """;

    @Override
    public ChatClientRequest before(ChatClientRequest chatClientRequest, AdvisorChain advisorChain) {
        // todo.. 请求之前  重写提示词
        String contents = chatClientRequest.prompt().getContents();
        String re2InputQuery = PromptTemplate.builder().template(DEFAULT_USER_TEXT_ADVISE).build()
                .render(Map.of("re2_input_query", contents));

        ChatClientRequest clientRequest = chatClientRequest.mutate()
                .prompt(Prompt.builder().content(re2InputQuery).build())
                .build();
        return clientRequest;
    }

    @Override
    public ChatClientResponse after(ChatClientResponse chatClientResponse, AdvisorChain advisorChain) {
        return null;
    }


     @Override
    public int getOrder() {
        return 0;
    }
}
测试:
java
 @Test
    public void testReAdvisor(@Autowired ChatClient.Builder chatClientBuilder){
        ChatClient chatClient = chatClientBuilder
                .defaultAdvisors(new SimpleLoggerAdvisor(), // SimpleLoggerAdvisor() 系统自带的日志拦截器
                       new ReReadingAdvisor())  //ReReadingAdvisor()自定义重读拦截器
                .build();
        String content=chatClient.prompt()
                .user("王维帅不帅")
                //.advisors()
                .call()
                .content();
        System.out.println(content);
    }
原理:
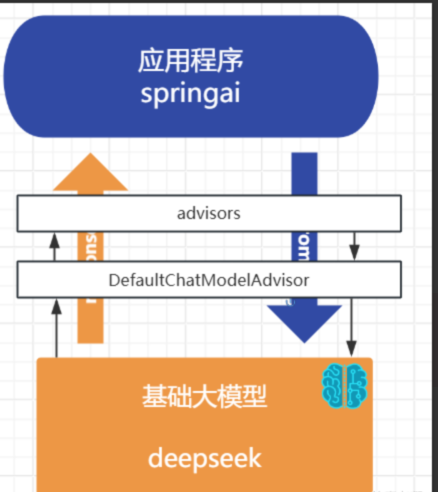
Advisor 只有结合 ChatClient 才能用!是 Spring AI 上层提供的
对话记忆
大语言模型是无状态的,这就意味着它们不会保留之前交互的信息。
如何让大模型记住我们的对话呢?实际上,每次对话都需要将之前的对话发送给大模型,这种方式称作多轮对话。
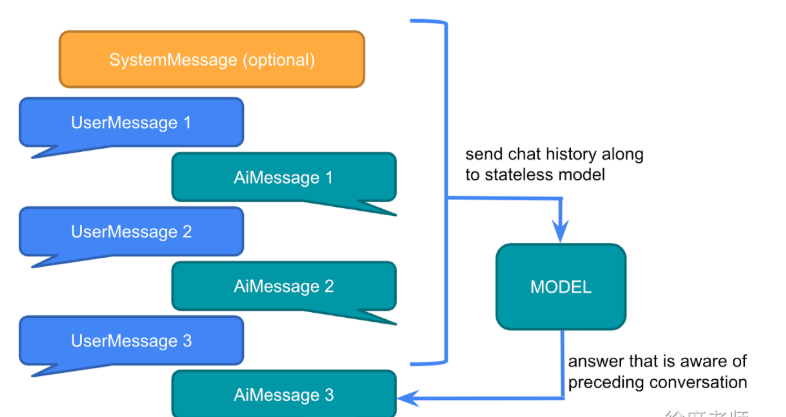
Spring AI 提供了一个 ChatMemory 的组件用于存储聊天记录,允许 LLM 跨多个交互存储和检索信息。并且可以为不同用户的多个交互之间维护上下文或状态。
也可以通过 Advisor 对话拦截,Spring AI 为我们提供了ChatMemoryAutoConfiguration自动配置类。
依赖:
java
   <!--对话记忆-->
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-autoconfigure-model-chat-memory</artifactId>
        </dependency>
测试:
java
@SpringBootTest
public class TestChatMemory {
    ChatClient chatClient;
    @BeforeEach
    public  void init(@Autowired
                      DeepSeekChatModel chatModel,
                      @Autowired
                      ChatMemory chatMemory) {
        chatClient = ChatClient
                .builder(chatModel)
                .defaultAdvisors(
                        PromptChatMemoryAdvisor.builder(chatMemory).build()
                )
                .build();
    }
    @Test
    public void testChatOptions() {
        String content = chatClient.prompt()
                .user("我叫王维 ?")
                .advisors(advisorSpec->advisorSpec.param(ChatMemory.CONVERSATION_ID, "1"))//设置对话唯一标识
                .call()
                .content();
        System.out.println(content);
        System.out.println("--------------------------------------------------------------------------");
        //对话记忆
        content = chatClient.prompt()
                .user("我叫什么 ?")
                .advisors(advisorSpec->advisorSpec.param(ChatMemory.CONVERSATION_ID, "2"))
                .call()
                .content();
        System.out.println(content);

        System.out.println("--------------------------------------------------------------------------");

        content = chatClient.prompt()
                .user("我叫什么 ?")
                .advisors(advisorSpec->advisorSpec.param(ChatMemory.CONVERSATION_ID, "1"))
                .call()
                .content();
        System.out.println(content);
    }

}
注:若有多个用户在进行对话,将需要进行对话隔离,利用 ChatMemory.CONVERSATION_ID 可以将用户对话隔离。
配置聊天记录最大存储数量:
大模型的 Token 是有上限的,如果你发送过多的聊天记录,可能就会导致 Token 过长。DEFAULT_MAX_MESSAGES 默认 20 即 10 次对话。
java
    @Bean
        ChatMemory chatMemory(ChatMemoryRepository chatMemoryRepository){
            return MessageWindowChatMemory.builder()
                    .maxMessages(10)
                    .build();
        }
数据库存储对话
默认情况下,对话内容会存在 JVM 内存会导致:
-
一直存最终只会撑爆 JVM 导致 OOM。
-
重启就会丢,可以存储到第三方进行持久化。
Spring AI 提供了几种方式(Cassandra、JDBC、Neo4j、Redis),我们以 JDBC 为例:
a. 依赖:
XML
 <!--存储方式-->

        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-starter-model-chat-memory-repository-jdbc</artifactId>
        </dependency>

        <!--jdbc-->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-jdbc</artifactId>
        </dependency>


        <!--mysql驱动-->
        <dependency>
            <groupId>com.mysql</groupId>
            <artifactId>mysql-connector-j</artifactId>
            <scope>runtime</scope>
        </dependency>
b. 配置
java
spring.ai.chat.memory.repository.jdbc.initialize-schema=always
spring.ai.chat.memory.repository.jdbc.schema=classpath:/sql/schema-mysql.sql
XML
spring:
  datasource:
    username: root
    password: root
    url: jdbc:mysql://localhost:3306/springai?characterEncoding=UTF-8&serverTimezone=Asia/Shanghai
    driver-class-name: com.mysql.cj.jdbc.Driver
c. SQL:
sql
CREATE TABLE IF NOT EXISTS SPRING_AI_CHAT_MEMORY (
                                                     `conversation_id` VARCHAR(36) NOT NULL,
    `content` TEXT NOT NULL,
    `type` VARCHAR(10) NOT NULL,
    `timestamp` TIMESTAMP NOT NULL,

    INDEX `SPRING_AI_CHAT_MEMORY_CONVERSATION_ID_TIMESTAMP_IDX` (`conversation_id`, `timestamp`)
    );
注:测试类用对话记忆的测试类,最终发现在配置类中设置的最大对话为几,数据库中就会存储几条该用户的消息,会更新数据库中的信息。
多层次记忆架构
对话记忆是基于对话上下文的存储,但记忆一旦多了,就会触发 Token 上限,这时候就需要多层次记忆架构,它是模仿人类的记忆类型。
- 近期记忆:保留在上下文窗口中的最近几轮对话,每轮对话完成后立即存储(可通过ChatMemory); 10 条
- 中期记忆:通过RAG检索的相关历史对话(每轮对话完成后,异步将对话内容转换为向量并存入向量数据库) 5条
- 长期记忆:关键信息的固化总结
方式一:定时批处理
- 通过定时任务(如每天或每周)对积累的对话进行总结和提炼
- 提取关键信息、用户偏好、重要事实等
- 批处理方式降低计算成本,适合大规模处理
方式二:关键点实时处理
- 在对话中识别出关键信息点时立即提取并存储
- 例如,当用户明确表达偏好、提供个人信息或设置持久性指令时
- 采用"写入触发器"机制,在特定条件下自动更新长期记忆
结构化输出
类型
基础类型
在agent中可以用于判断内容的两个分支,不同分支走不同的逻辑:
java
    @Test
    public void testBoolOut(){
        Boolean isComplain = chatClient
                .prompt()
                .system("""
                        请判断用户是否表达了投诉意图?
                        只能用 true  或 false回答,不做其他输出
                        """)
                .user("你们的水果运过来的时候烂了,我要投诉")
                .call()
                .entity(Boolean.class);

        if (Boolean.TRUE.equals(isComplain)){
            System.out.println("用户是投诉,转人工服务");
        }else {
            System.out.println("用户不是投诉,自动转客服机器人");

        }
    }
pojo类型
让大模型从一段话中提取信息,例如用购物app复制一个地址,会自动为你填入对应的输入框。
java
    ChatClient chatClient;
    @BeforeEach
    public void  init(@Autowired DashScopeChatModel chatModel){
        chatClient = ChatClient.builder(chatModel).build();

    }
    public record Address(
            String name,        // 收件人姓名
            String phone,       // 联系电话
            String province,    // 省
            String city,        // 市
            String district,    // 区/县
            String detail       // 详细地址
    ) {}

    @Test
    public void  testEntityOut(){
         Address address = chatClient.prompt()
                 .system("""
                          请从下面这条文本中提取收货信息""")
                 .user("收货人:张三,电话13588888888,地址:浙江省杭州市西湖区文一西路100号8幢202室")
                 .call()
                 .entity(Address.class);
        System.out.println(address);
    }
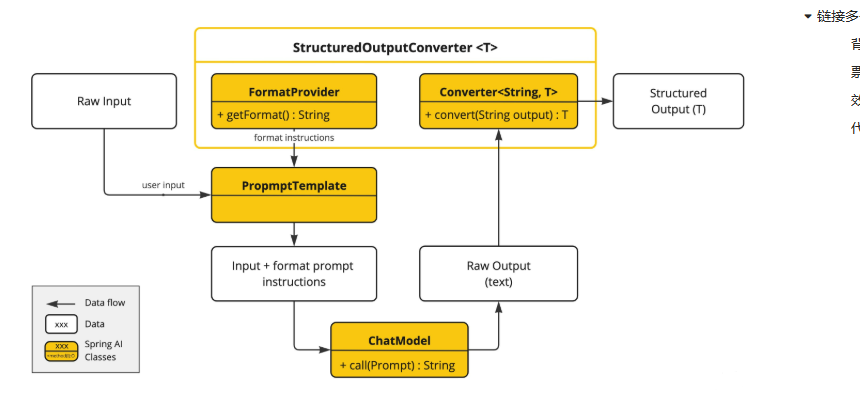
原理:spring ai底层写了一个FormatProvider的类,为大模型举例子如何填入对应的对象。