千笔-AIWritePaper · https://www.aiwritepaper.com
生成式 AI 能很快吐出一段「看起来很专业」的 Ovid/PubMed 策略串:PICO 齐、同义词多、布尔也像那么回事。把它直接写进协议附录,风险在于假 MeSH、漏关键同义词、过宽灌水、与注册协议不一致 ,以及未做召回测查就宣称「比馆员更好」。选型若停在「省时间」,就会把草稿加速 误当成策略终裁。
本文依据 Health Technology Assessment international - HTAi 频道信息检索兴趣组 webinar The Role of Generative AI in Search Strategy Development (讲者 Lisa Tjosvold,University of Alberta,2024-11-07,约 66 分钟)整理。讲者关于模型能力、提示演示与 MeSH 幻觉等经验均为视频口述,未经第三方核实 。实验部分用 12 条虚构 迷你检索策略任务,对照「人工策略清单」与「伪 GenAI 输出」,不是讲者课堂原始日志(_w/search-strategy-gate/)。
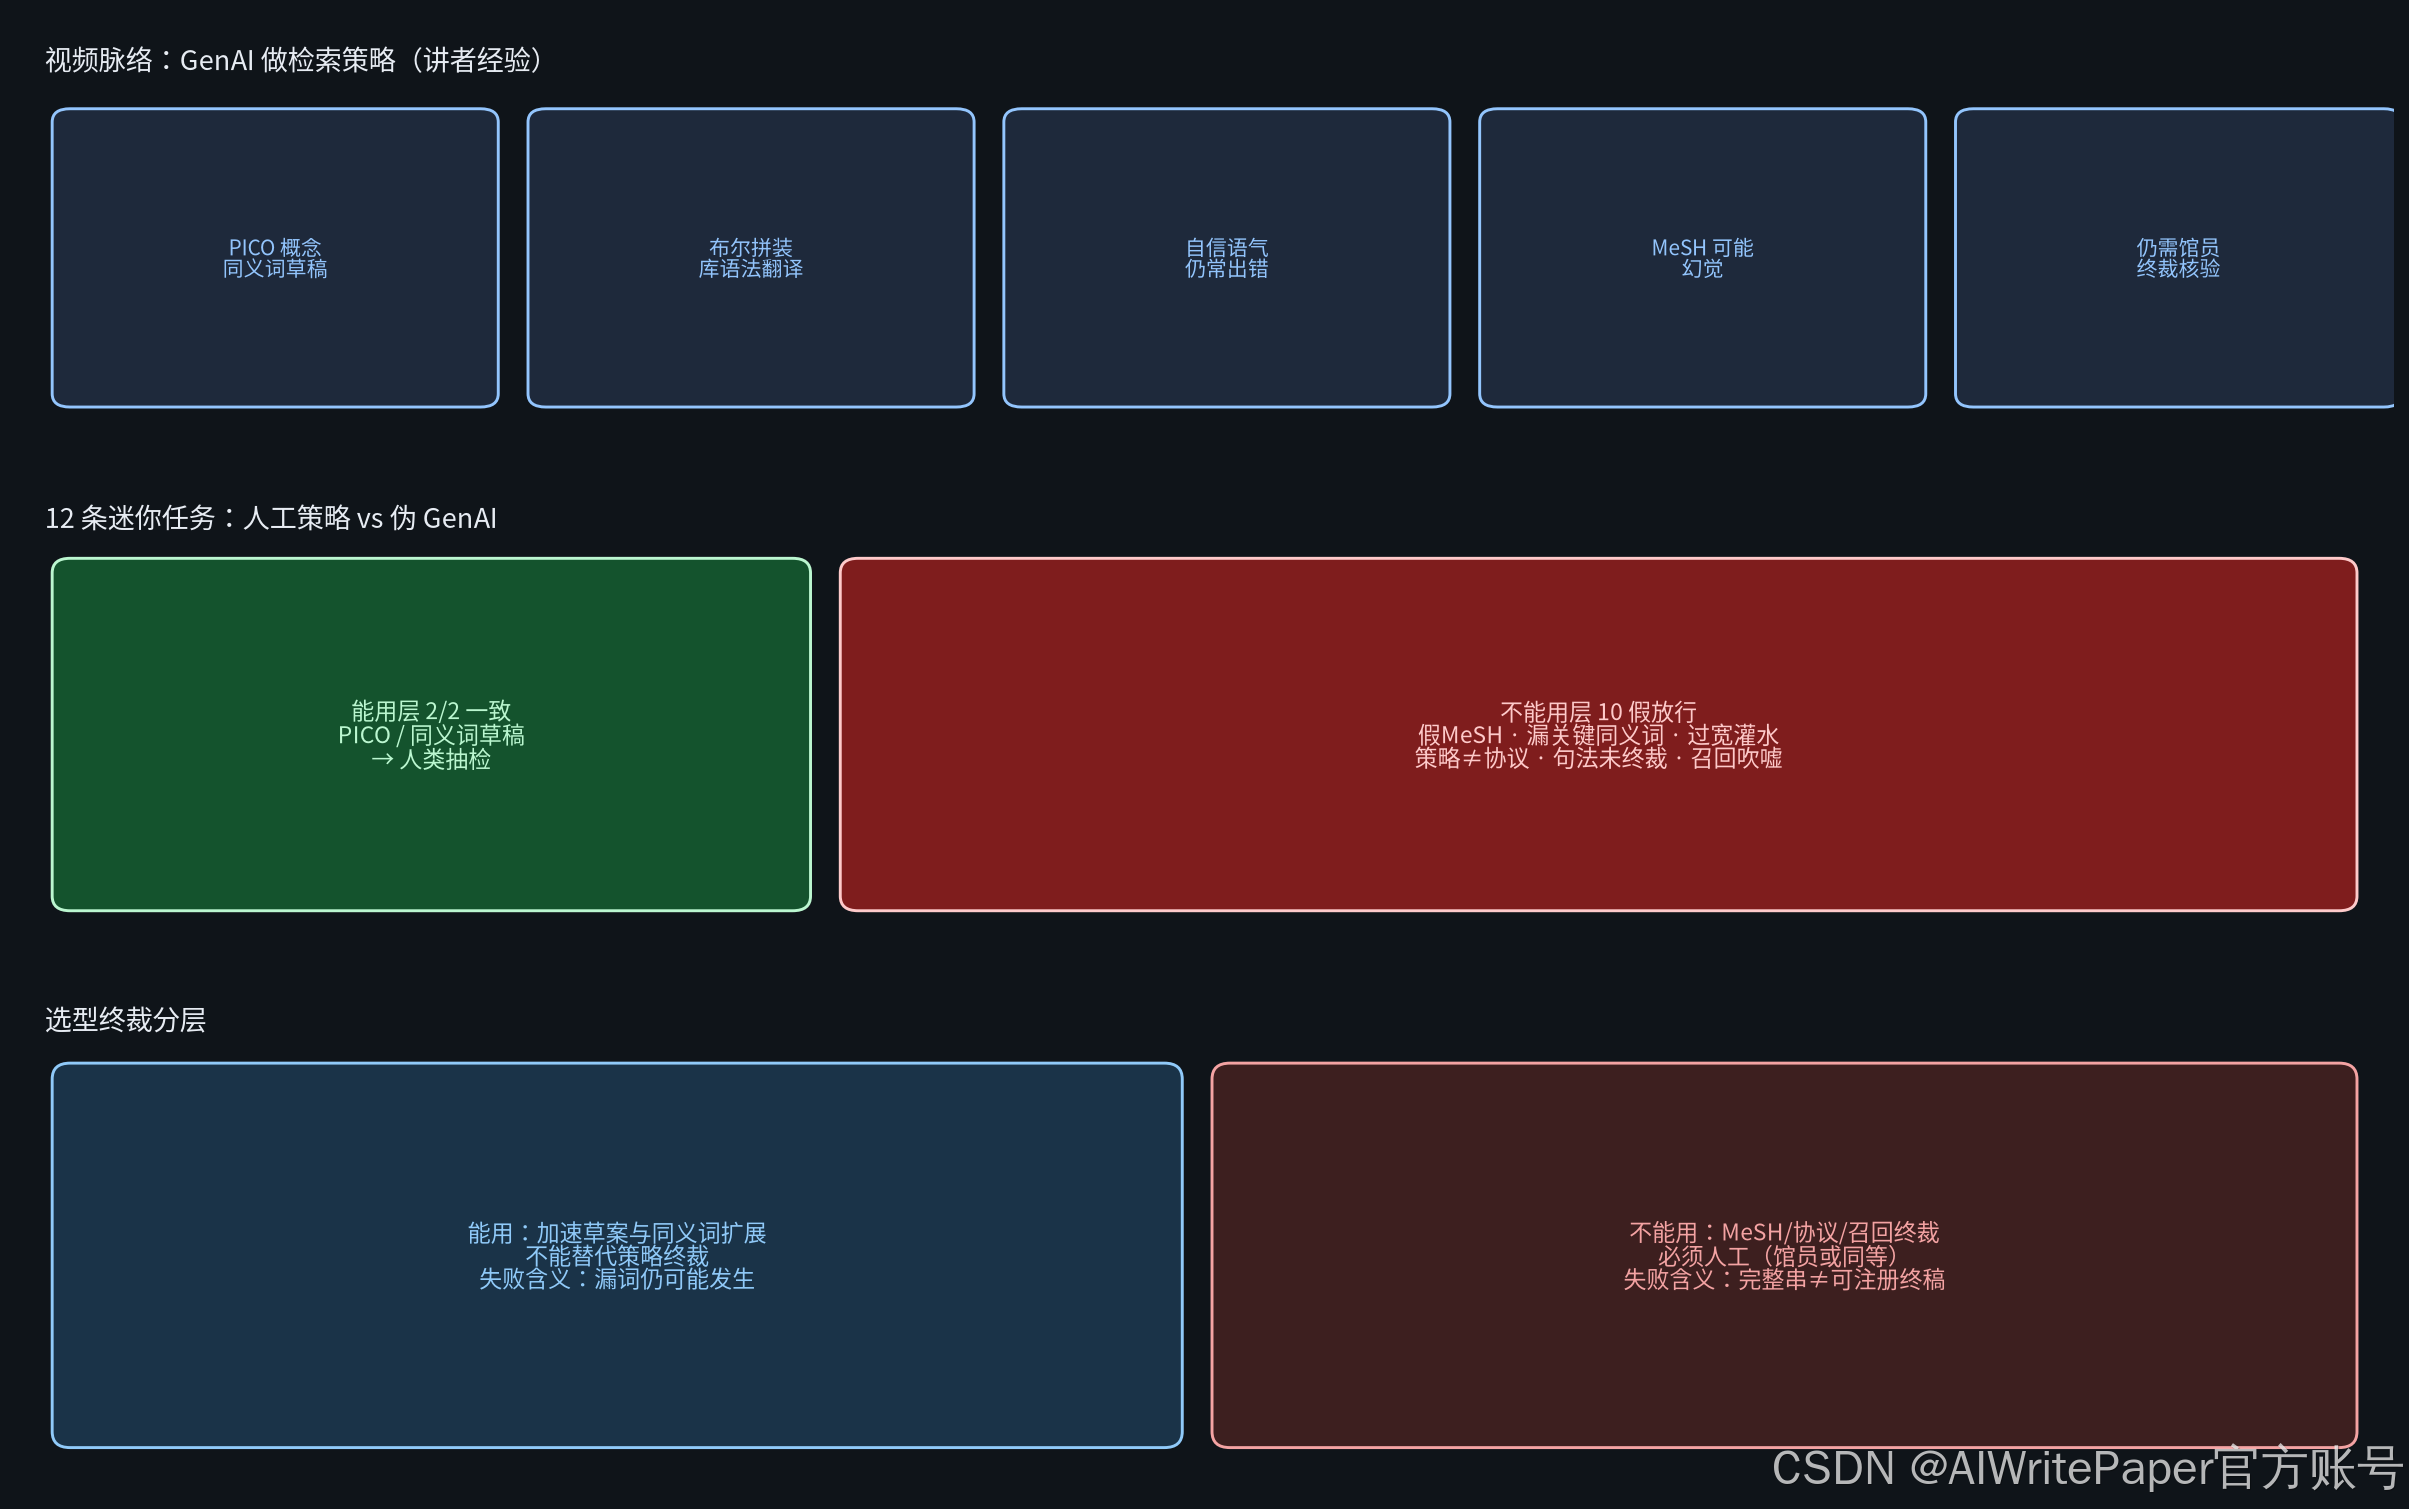
图:上排为讲者经验脉络;中排为 12 条任务的能用一致与假放行;底部为选型终裁分层。
目标说明
读完你应能独立完成四件事。
- 说清 GenAI 在检索策略开发里常能加速什么、必须人工终裁什么。
- 把能力拆成「能用草稿层」与「不能用终裁层」。
- 在 12 条迷你任务上复跑,看清假 MeSH、漏同义词、过宽、违约、错句法与召回吹嘘。
- 产出选型终裁表与验收 CSV,终裁列写清人类必做与失败含义。
视频要点:讲者原话(经验未经第三方核实)
讲者定位为卫生科学馆员,主题是生成式 AI(以 ChatGPT 能力为主)在系统检索策略开发中的潜力与局限。她强调模型常以权威语气输出,应默认响应不正确直至被核验 ;知识截止、幻觉、偏见与环境成本都是背景限制。课堂演示围绕「成人褪黑素治疗睡眠障碍」一类问题:PICO 概念化、同义词扩展、布尔拼装、翻译到 Ovid Medline / Embase 语法等。她观察到概念识别与同义词、基本布尔常有帮助,但邻接运算与括号仍会错;主题词是否正确必须另查。问答中她明确同意:ChatGPT 会幻觉 MeSH,主题词必须始终人工核对。对信息专员的含义:效率可提升,但工作不会被取代;仍需馆员或同等专长检查错误;准确率与召回相对人类策略的系统比较她本人尚未完成。
| 环节 | 视频描述 | 边界 |
|---|---|---|
| 能加速 | 概念化、同义词、布尔草稿、库语法初译 | 草稿,非终稿 |
| 常出错 | 邻接/括号、主题词、自我「查错」不可靠 | 必须在目标库试跑 |
| MeSH | 听众与讲者均确认存在幻觉主题词 | 浏览器核验,不可盲信 |
| 召回/精确 | 缺系统头对头测试 | 不得凭自信宣称更优 |
| 治理 | 仍需人类监督;注意偏见与能耗 | 终裁权在人 |
失败含义:完整策略串不等于可注册终稿;「已检查无误」的模型自述不能代替金标准测查与主题词核验。
实验:12 条迷你任务上的人工策略 vs 伪 GenAI
每条任务种植一类策略终裁缺陷(假 MeSH、漏关键同义词、过宽灌水、策略≠协议、句法未终裁、无金标准却吹嘘召回),并保留 2 条「PICO/同义词草稿」作为能用层对照。输出原样:
text
T01 缺陷=假MeSH          一致=MISMATCH 层=不能用-主题词终裁 → 人类必做
T02 缺陷=假MeSH          一致=MISMATCH 层=不能用-主题词终裁 → 人类必做
T03 缺陷=漏关键同义词         一致=MISMATCH 层=不能用-词表完备终裁 → 人类必做
T04 缺陷=漏关键同义词         一致=MISMATCH 层=不能用-词表完备终裁 → 人类必做
T05 缺陷=过宽式灌水          一致=MISMATCH 层=不能用-精确率/工作量终裁 → 人类必做
T06 缺陷=过宽式灌水          一致=MISMATCH 层=不能用-精确率/工作量终裁 → 人类必做
T07 缺陷=策略≠协议          一致=MISMATCH 层=不能用-协议一致性终裁 → 人类必做
T08 缺陷=策略≠协议          一致=MISMATCH 层=不能用-协议一致性终裁 → 人类必做
T09 缺陷=正常可加速          一致=ok       层=能用-概念/同义词草稿 → 人类抽检
T10 缺陷=正常可加速          一致=ok       层=能用-概念/同义词草稿 → 人类抽检
T11 缺陷=句法错误未终裁        一致=MISMATCH 层=不能用-句法终裁 → 人类必做
T12 缺陷=召回未核验          一致=MISMATCH 层=不能用-召回验证终裁 → 人类必做
合计=12 能用层一致=2/2 假放行(MISMATCH)=10 能用层任务=2 人类必做层=10
选型终裁: PICO概念与同义词草稿可加速 | 假MeSH·漏关键同义词·过宽灌水·策略≠协议·句法错误·无金标准召回吹嘘 必须人工终裁 | 讲者经验(含 MeSH 幻觉)未经本脚本核实
读法:
- 能用层 2/2:概念标签与「待核」同义词草稿可以和人工清单对齐,适合加速,仍要抽检。
- 假放行 10/10 种植缺陷:伪输出都能生成完整串,但塞进假 MeSH、漏 aged/elderly、OR 进 human/people 灌水、把儿童或光疗打进与协议冲突的块、邻接括号错误还自称无误、无测试集却宣称召回更高。
- 人类必做 10/12:选型若宣传「自动完成系统综述检索策略终裁」,会被这 10 条打脸。
- 与讲者边界同向:同义词与结构可起步;主题词、句法与召回必须人审。
能用 / 不能用:分层验收
| 层 | 环节 | 判定 | 依据 | 失败含义 |
|---|---|---|---|---|
| 能用 | PICO 概念标签、已审词表的 OR 草稿 | 加速,需抽检 | T09/T10 | 仍可能漏关键同义词(见 T03/T04) |
| 能用 | 布尔拼装初稿 | 加速起草 | 讲者演示 | 把草稿当终稿→错词进协议 |
| 不能用 | MeSH/Emtree 是否真实 | 人工终裁 | T01/T02;讲者确认幻觉 | 假主题词进入策略 |
| 不能用 | 关键同义词是否覆盖协议/种子文献 | 人工终裁 | T03/T04 | 召回缺口 |
| 不能用 | 过宽 OR / 库选择灌水 | 人工终裁 | T05/T06 | 筛查不可负担 |
| 不能用 | 与注册协议纳排一致 | 人工终裁 | T07/T08 | 策略与问题漂移 |
| 不能用 | 目标库句法试跑 | 人工终裁 | T11 | 语法错导致空跑或错跑 |
| 不能用 | 召回优于人类的宣称 | 人工终裁 | T12 | 无金标准的营销话术 |
选型终裁表(可抄走)
| 能力宣传 | 是否采纳 | 人类必做 | 失败含义 |
|---|---|---|---|
| 从问题生成 PICO 与同义词草稿 | 可作加速 | 对照协议与种子文献抽核 | 漏关键同义词 |
| 自动生成可注册的最终策略 | 不采纳为终裁 | 馆员/同等终裁 + 库内试跑 | 假 MeSH/错句法 |
| 自动保证与协议一致 | 不采纳 | 逐条对照注册文件 | 人群/干预漂移 |
| 宣称召回优于馆员策略 | 不采纳 | 金标准病例集测查 | 无证据吹嘘 |
| 模型说「已检查无误」 | 不当证据 | 独立查错清单 | 自检不可靠 |
伪 GenAI 输出怎么对照人工清单
对照时先固定「金标准」:人工侧只认协议里写死的人群/干预/对照/结局、已核验的 MeSH/Emtree,以及种子文献里真实出现过的自由词。伪 GenAI 侧故意混入完整但不可信的策略串:主题词看起来像正式编码、同义词列表很长、布尔括号「美观」。验收脚本只做字符串级一致判定:它不调用真实大模型,也不替你测召回。这样设计是为了让选型讨论可复现:换模型时换伪输出列即可,人类必做列不变。
实践上建议把终裁拆成三道门。第一道:主题词是否在浏览器里真实存在且语义匹配。第二道:协议纳排是否被策略块偷换。第三道:目标库试跑是否报错,以及是否出现不可负担的过宽命中。三道都过,才谈「可写入附录」。任何一道失败,输出退回草稿区,禁止用「模型已自检」作结案理由。
与「筛选工具选型」「Deep Research 广搜」分开记账:本文只验收检索策略串本身。筛选阶段假阴性、广搜阶段信源捏造,各自用各自的探针,避免一篇文章塞满所有 AI 写作场景。
常见误判
- 「布尔都对了就等于策略完成」:T01/T02 显示假 MeSH 可以藏在正确布尔里。
- 「模型自己查过错」:讲者演示与 T11 说明自查仍漏关键句法问题。
- 「比馆员快就是比馆员好」:T12 专拦无金标准的召回吹嘘。
- 「和 Deep Research / 筛选工具选型同一篇」:本文专管检索策略 GenAI,不展开全文筛选或 Deep Research 广搜。
验收清单
- GenAI 输出只进「草稿」区,终稿有人签。
- 所有主题词经 MeSH/Emtree 浏览器核对。
- 协议纳排与策略块逐条一致。
- 目标数据库试跑;邻接/括号/字段错误清零。
- 有金标准病例集才允许谈召回;否则禁止比较优势话术。
- CI 跑
search_strategy_gate.py,能用层保持一致,假放行可复现。
当天 30 分钟落地
- 5 分钟:选定一个 GenAI 入口,保存原始策略串与提示。
- 10 分钟:用
tasks.csv思路列本学科探针(假主题词、协议冲突、过宽 OR)。 - 10 分钟:对真实草稿抽核主题词与协议一致性,记下假放行类型。
- 5 分钟:更新选型终裁表:哪些步骤可加速,哪些写死「人类必做」。
踩坑
- 把课堂漂亮长串直接贴进 PROSPERO/协议附录。
- 只核对英文自由词,不核对 MeSH。
- 用「全面检索」作方法句,却拿不出测查病例集。
- 看见同义词多就采纳,不做种子文献逆查。
- 翻译到另一数据库后不再试跑句法。
与馆员终裁如何分工
建议把 GenAI 输出钉在「起草助手」角色:它负责把问题拆成概念块、列出候选同义词、生成可粘贴的布尔草稿。馆员或同等专长负责:主题词浏览器核对、协议逐条对读、目标库试跑、种子文献逆查,以及是否允许写入注册附录。分工写进 SOP 后,换模型不必重写终裁权。若团队无人能做 MeSH 核验,则不应宣称「已具备系统综述检索策略 GenAI 终裁能力」。
总结
检索策略 GenAI 适合加速 PICO 与同义词草稿,以及布尔/语法初译。它不能自动完成主题词真伪、协议一致性、过宽控制、句法终裁与召回证明。12 条虚构任务里,能用层 2 条可对齐人工清单,10 条种植缺陷全部假放行。选型终裁表应写清人类必做与失败含义,并在换模型时复跑同一份 CSV。讲者关于 MeSH 幻觉与「仍需人类监督」的判断,与本实验假放行方向一致,但其具体演示效果未经本脚本核实。
检索策略验收表与禁区归档可用千笔-AIWritePaper 整理;分层骨架与脚本不依赖产品名。