0.1 概述&序言
这里是白杨。上一篇 stack/queue 篇里,priority_queue 只讲到"用法 + 堆的两个调整"就收尾了。我自己复盘的时候越看越不对劲:构造函数没讲、仿函数没讲、自定义类型只有一个句号、指针陷阱完全没提------对复习党来说,这一块是整篇最"骨架"的。
所以这篇专门补完。而且越写越觉得值:仿函数不只是 priority_queue 的配件,它是整个 STL 的通用基础设施------sort 的升降序、find_if 的筛选条件、关联容器的比较规则,都靠它。
这篇要过五件事:
- 仿函数是什么:
f(1, 2)和f.operator()(1, 2)的关系 - 完整模拟实现:构造函数 + 区间建堆(上篇缺的那块)
- 自定义类型与指针陷阱 :
priority_queue<Date*>为什么会排错 - Top-K 实战:前 K 大 / 第 K 大 / 前 K 小
- 附:顺手做了个 deque 排序效率实验
老规矩,跑得通的结果才写进来(环境见下);完整代码文末自取,也可以直接去仓库:gitee.com/BaiYang_SQ/priority-queue-sim。
实测环境:w64devkit g++ 15.2.0(
-std=c++11 -O2 -Wall -Wextra)+ VS2022;教学简化版,生产请直接使用std::priority_queue。文中代码均为本人手写并实测;官方文档:cppreference·priority_queue。
让我们开始吧。
一、priority_queue 快速回顾
priority_queue 的本质:底层用堆算法维护优先级,堆顶永远是"优先级最高"的元素 。默认大堆(最大元素在堆顶),想变小堆就把比较器换成 greater。
| 接口 | 说明 | 复杂度 |
|---|---|---|
push(x) |
插入,自动上浮 | O(log N) |
pop() |
删除堆顶,自动下沉 | O(log N) |
top() |
只看堆顶 | O(1) |
empty() / size() |
判空 / 个数 | O(1) |
cpp
priority_queue<int> q1;                                    // 默认大堆
priority_queue<int, vector<int>, greater<int>> q2; // 小堆用法上篇讲过,这里不展开。真正值得挖的是第三个模板参数------greater<int> 这个括号背后的东西:仿函数。
二、仿函数:对象为什么能当函数用
priority_queue 的模板签名里,第三个参数是这样解的:
cpp
template <class T, class Container = std::vector<T>, class Compare = std::less<T> >
class priority_queue;
Compare 这个位置最终传的是一个类,不是函数。为什么类能拿来"比较"?看仿函数长什么样:
cpp
template <class T>
struct Less
{
    bool operator()(const T& x, const T& y) { return x < y; }
};

template <class T>
struct Greater
{
    bool operator()(const T& x, const T& y) { return x > y; }
};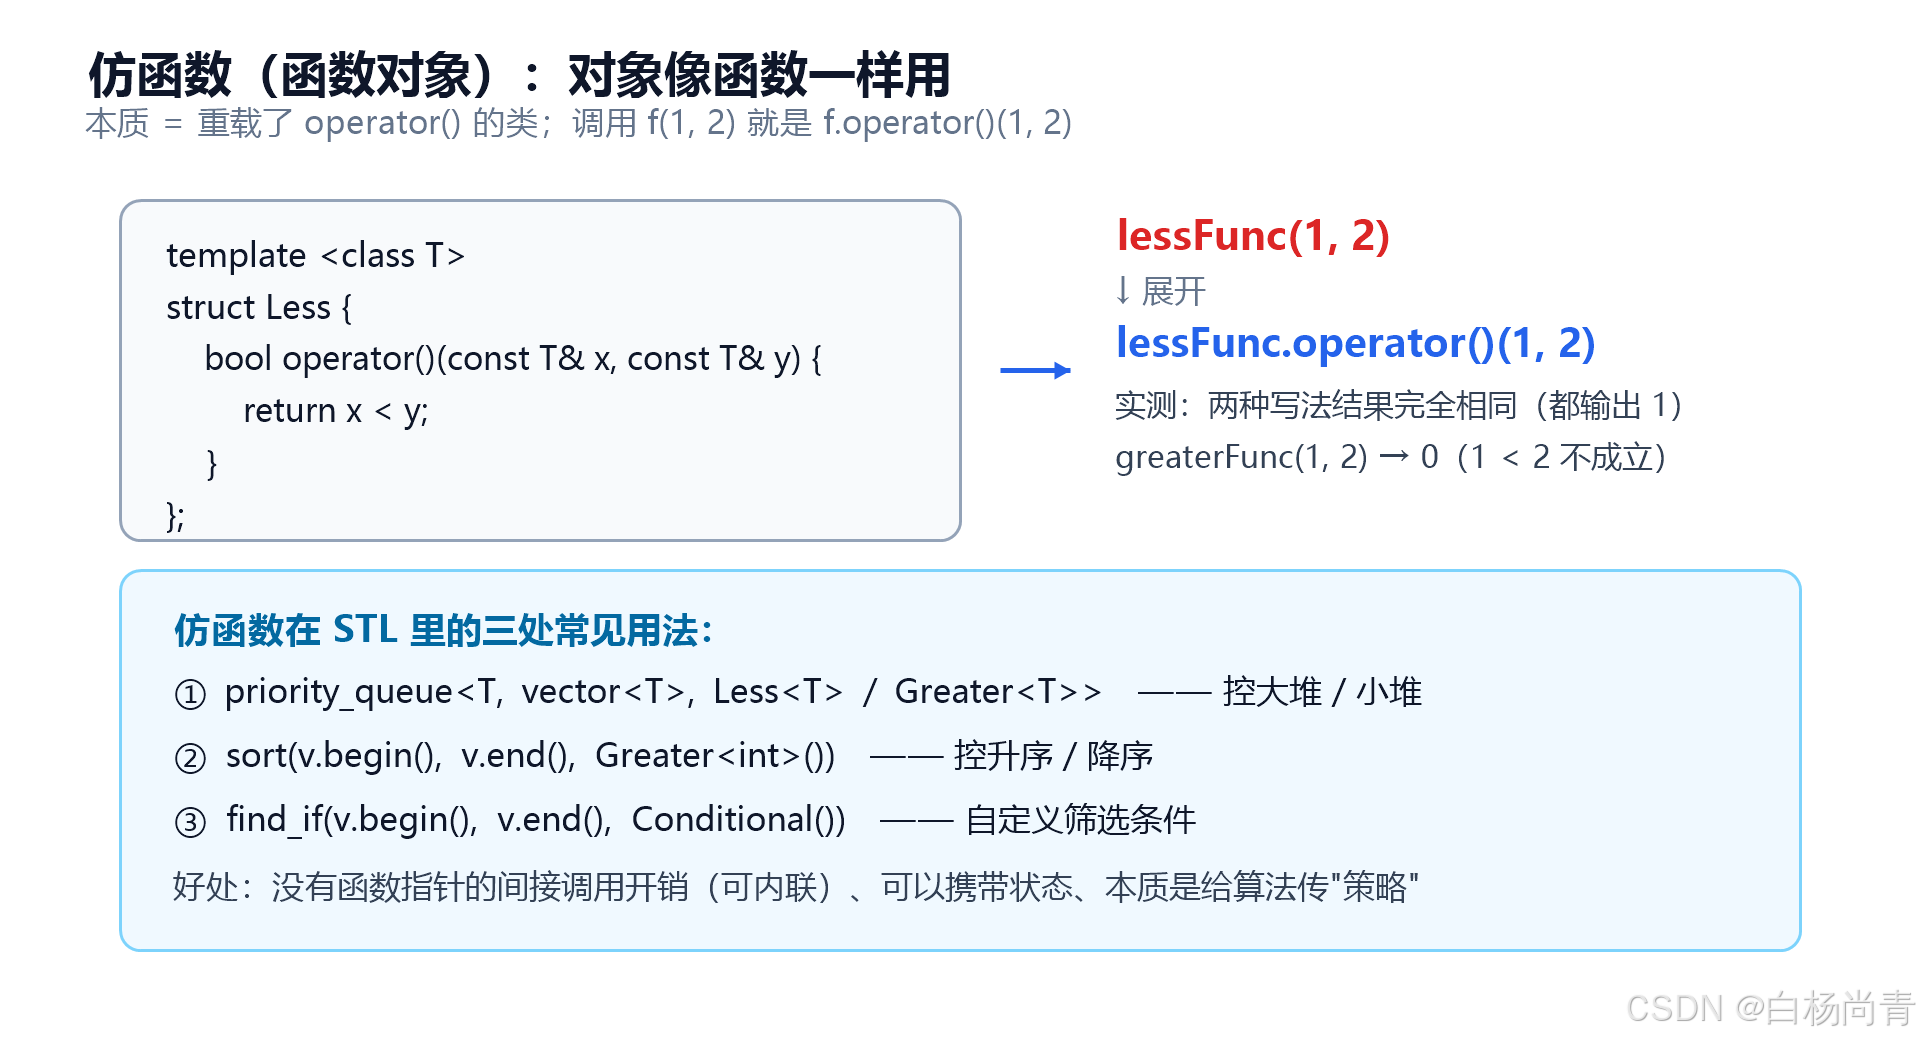
仿函数(函数对象)的本质:重载了 operator() 的类,它的对象可以像函数一样被"调用"。
cpp
Less<int> lessFunc;
Greater<int> greaterFunc;
cout << lessFunc(1, 2) << endl;              // 1
cout << lessFunc.operator()(1, 2) << endl;   // 1(等价写法)
cout << greaterFunc(1, 2) << endl; // 0(1 < 2 不成立)【一句话记】lessFunc(1, 2) 就是 lessFunc.operator()(1, 2) 的简写------对象像函数一样用,所以叫"仿函数"。
实测输出:
text
lessFunc(1, 2) = 1,lessFunc.operator()(1, 2) = 1
greaterFunc(1, 2) = 0
sort 降序: 9 8 7 6 5 4 3 3 2 2 2 1 0
find_if 找到第一个奇数且 11 的倍数: 55
后两行是仿函数的另两个用法:给 sort 传 Greater<int>() 排降序、给 find_if 传一个自定义"条件对象"(既是奇数、又是 11 的倍数):
cpp
class Conditional
{
public:
    bool operator()(int x) { return x % 2 && x % 11 == 0; }
};

vector<int> v{3, 2, 7, 6, 0, 4, 1, 9, 8, 5, 2, 2, 3};
sort(v.begin(), v.end(), Greater<int>());          // 降序
auto it = find_if(v.begin(), v.end(), Conditional());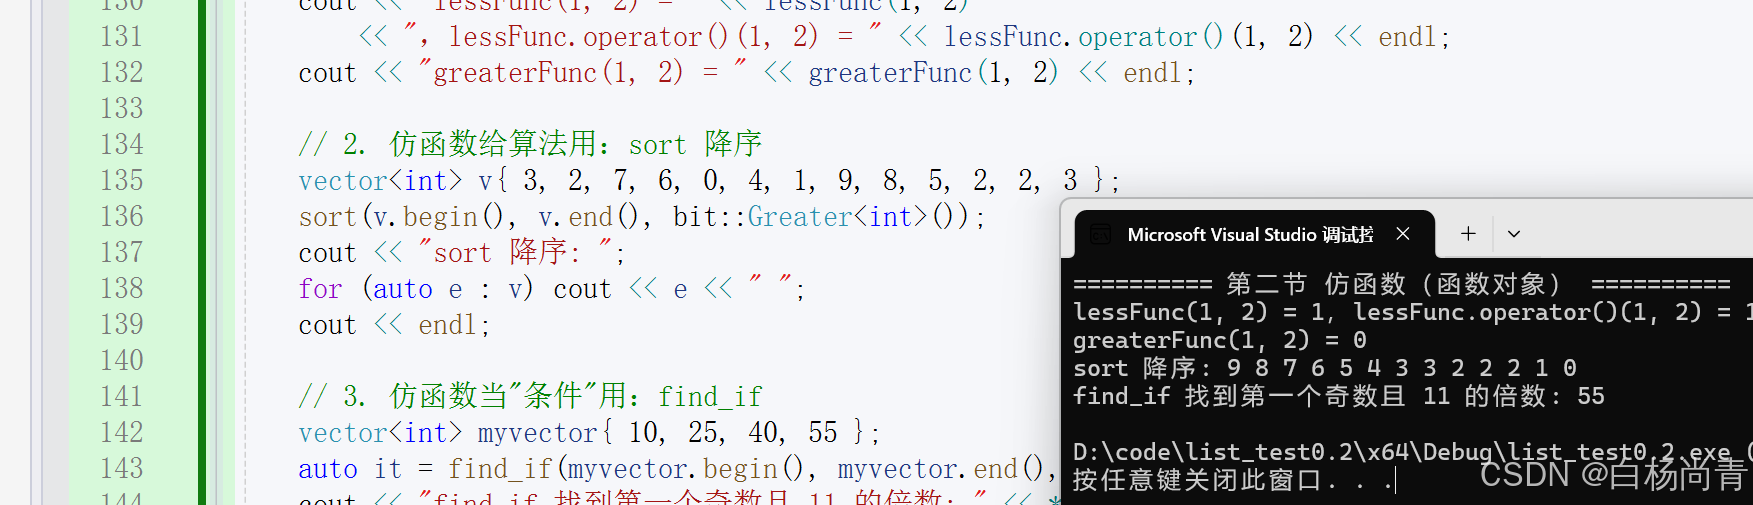
【面试】STL 为什么大量用仿函数,而不是用函数指针?
- 没有间接调用开销 :仿函数的
operator()是普通成员函数,编译器可以直接内联;函数指针调用往往要经过一次间接跳转; - 可以携带状态:类可以有成员变量(比如"带容差的比较器"),函数指针做不到;
- 给算法传"策略" :同一个
sort,换个比较器就换一套排序规则------策略模式。
三、完整模拟实现:构造函数与建堆
3.1 先理解"堆"长在数组里
堆是一棵完全二叉树,而完全二叉树可以按下标连续存在数组里,这就是它能 O(log N) 调整的秘密:
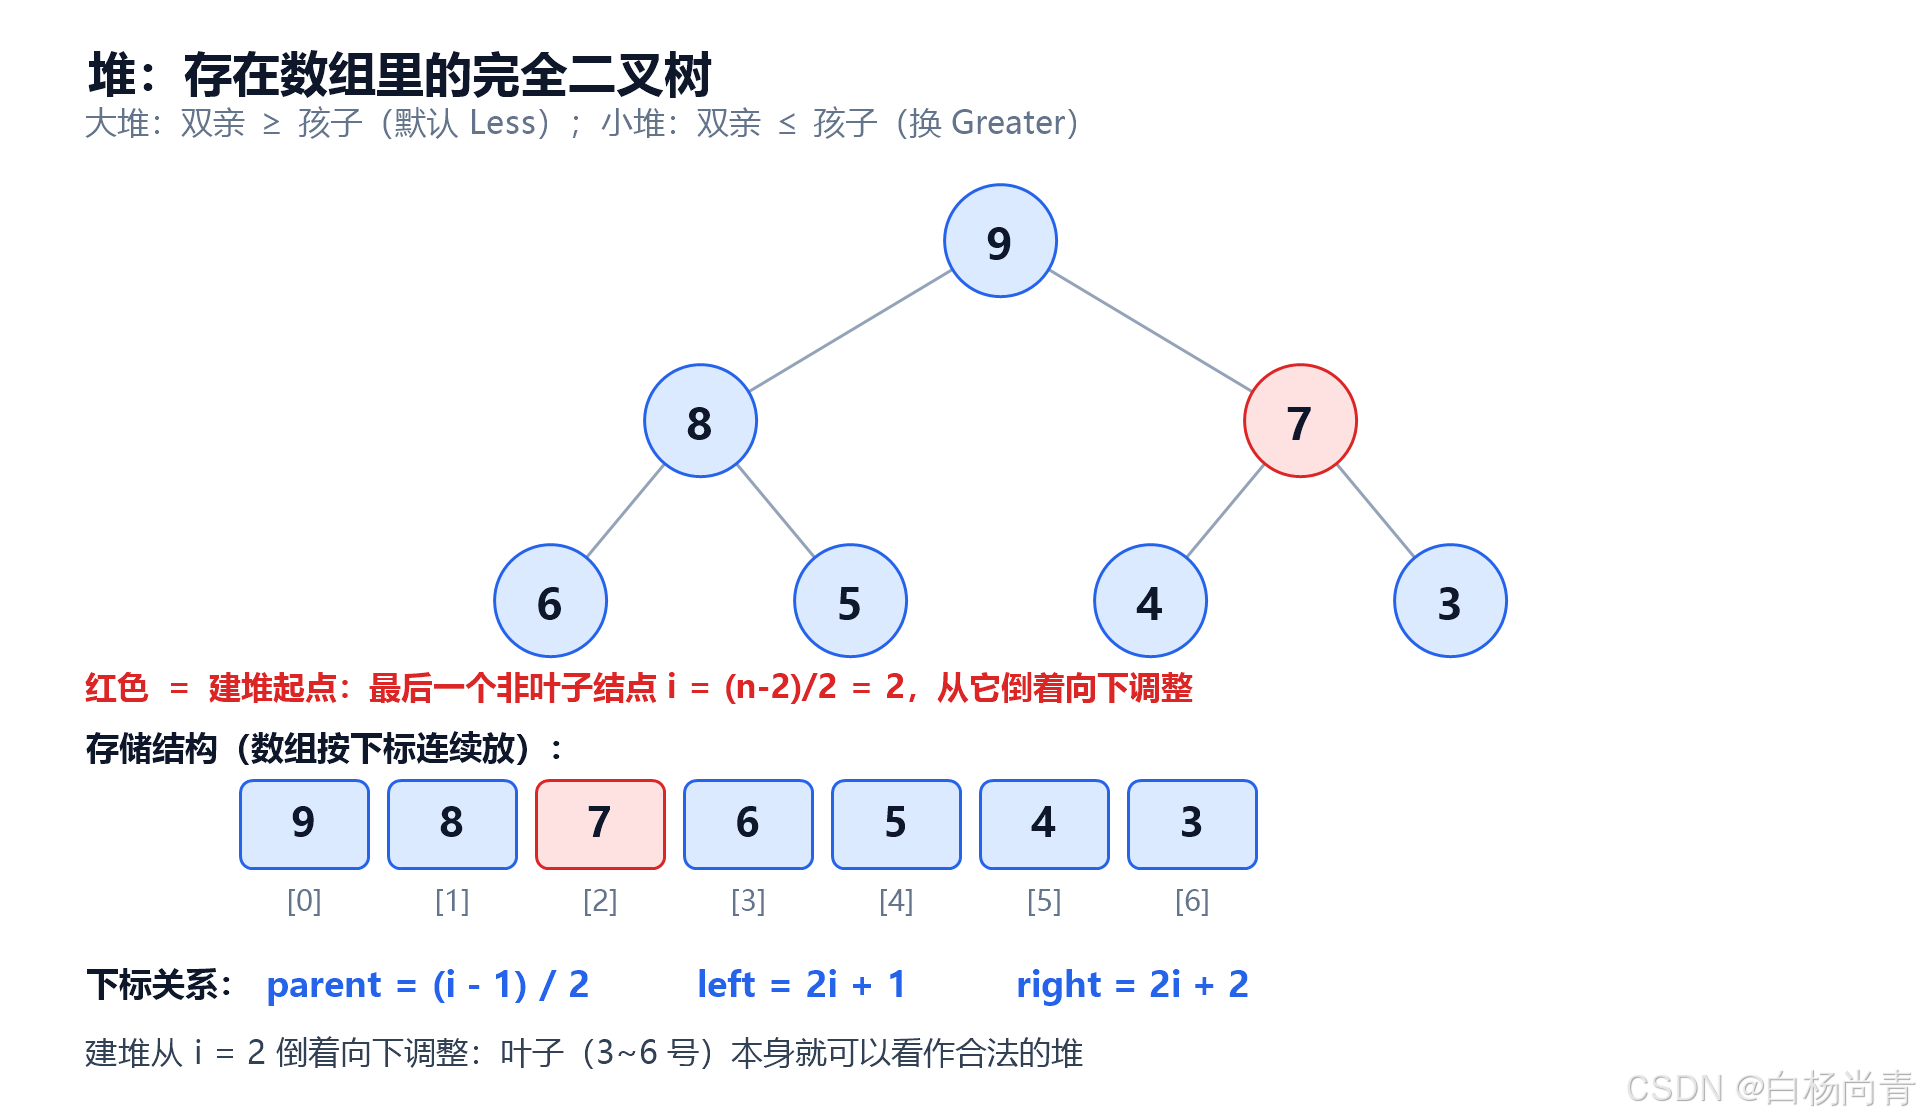
parent = (i - 1) / 2;left = 2i + 1;right = 2i + 2- 大堆 :每个双亲 ≥ 孩子(
Compare = Less时);小堆 反之(换Greater)
3.2 完整版实现
上篇只贴了 adjust_up / adjust_down 两个函数(还省略了构造函数),这次直接给完整不省略的版本:
cpp
namespace bit
{
template <class T, class Container = vector<T>, class Compare = Less<T>>
class priority_queue
{
public:
    priority_queue() {}

    // 迭代器区间构造:先装进底层容器,再自底向上建堆
    template <class InputIterator>
    priority_queue(InputIterator first, InputIterator last)
        : _con(first, last)
    {
        // 建堆:从最后一个非叶子结点倒着向下调整
        for (int i = ((int)_con.size() - 2) / 2; i >= 0; --i)
            adjust_down((size_t)i);
    }

    void push(const T& x)
    {
        _con.push_back(x);
        adjust_up(_con.size() - 1);
    }

    void pop()
    {
        swap(_con[0], _con[_con.size() - 1]);   // 堆顶和末尾交换
        _con.pop_back();                        // 删掉原来的堆顶
        adjust_down(0);                         // 新堆顶向下调整
    }

    const T& top() const { return _con[0]; }
    bool empty() const   { return _con.empty(); }
    size_t size() const  { return _con.size(); }

private:
    void adjust_up(size_t child)
    {
        size_t parent = (child - 1) / 2;
        while (child > 0)
        {
            Compare compare;   // 仿函数对象:像函数一样调用
            if (compare(_con[parent], _con[child]))
            {
                swap(_con[child], _con[parent]);
                child = parent;
                parent = (child - 1) / 2;
            }
            else
                break;
        }
    }

    void adjust_down(size_t parent)
    {
        size_t child = parent * 2 + 1;
        Compare compare;
        while (child < _con.size())
        {
            if (child + 1 < _con.size() && compare(_con[child], _con[child + 1]))
                ++child;   // 挑"更该上去"的那个孩子

            if (compare(_con[parent], _con[child]))
            {
                swap(_con[child], _con[parent]);
                parent = child;
                child = parent * 2 + 1;
            }
            else
                break;
        }
    }

    Container _con;
};
}
三个设计点,挨个说:
① Compare 单独抽出来是"解耦" :容器只负责存数据(Container),比较逻辑(Compare)单独一个模板参数。想换大堆小堆,只动 Compare,容器和堆调整代码一行不用改。
② 区间构造 = 装进容器 + 建堆 :_con(first, last) 先把数据全塞进 vector,然后......
③ 建堆为什么从 (n-2)/2 开始? 这是全篇最值得押的一道题:
- 最后一个结点下标是
n-1,它的双亲是((n-1)-1)/2 = (n-2)/2; - 下标比
(n-2)/2更大的结点全是叶子------叶子连孩子都没有,"向下调整"无事可做(天然合法); - 所以从最后一个非叶子结点开始,倒着向前,每个结点做一次向下调整,整棵树就是堆了。
复杂度上的直觉:越靠近底部的子树越矮、数量越多;越靠上子树越高、数量指数级减少,两边一抵消,建堆整体是 O(N),比"逐个 push"(O(N log N))更快。
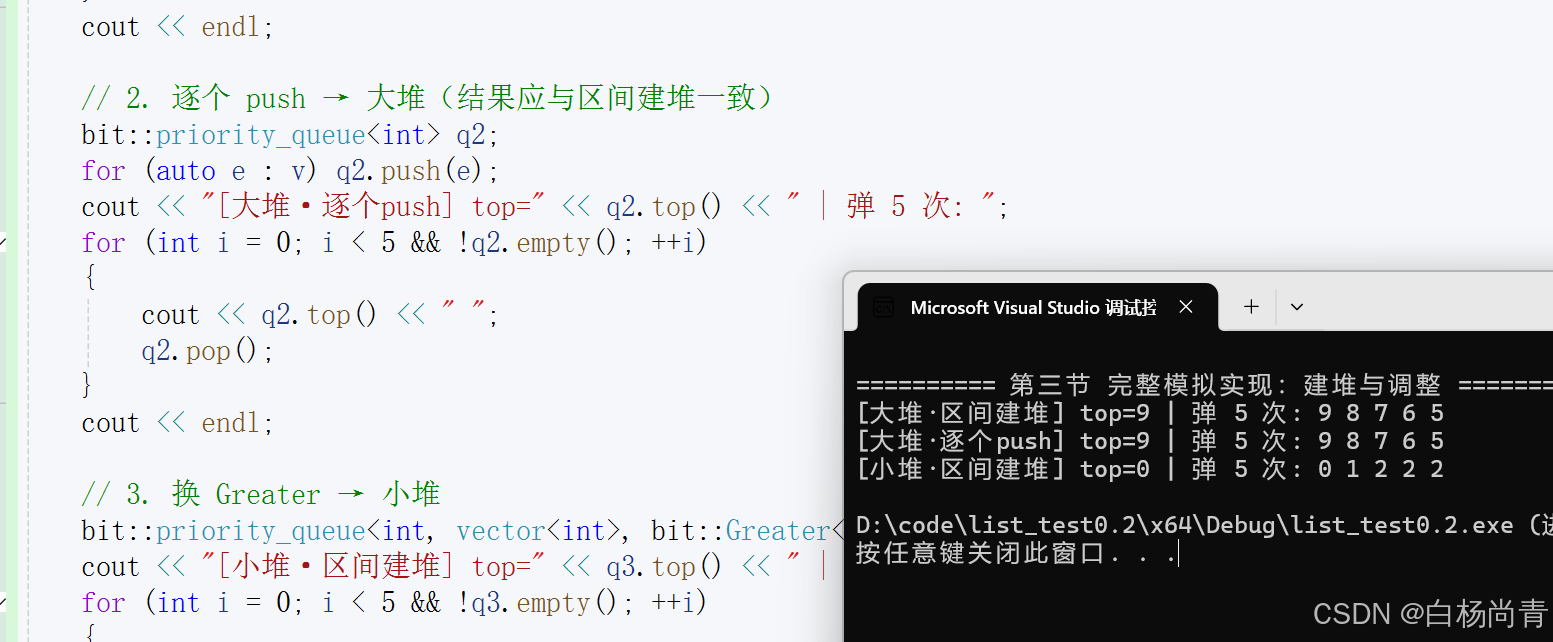
3.3 实测
text
[大堆·区间建堆] top=9 | 弹 5 次: 9 8 7 6 5
[大堆·逐个push] top=9 | 弹 5 次: 9 8 7 6 5
[小堆·区间建堆] top=0 | 弹 5 次: 0 1 2 2 2前两行结果完全一致:区间建堆和逐个 push 得到的是同一个堆 (只是效率不同)。第三行把 Compare 换成 Greater,同样一份代码立刻变成小堆。
【必背】push = 尾插 + 向上调整;pop = 堆顶与末尾交换、删尾、新堆顶向下调整;建堆从 (n-2)/2 倒着 adjust_down。
四、自定义类型与指针陷阱
4.1 自定义类型:要么给运算符,要么给仿函数
把 Date 放进 priority_queue,有两条路:
cpp
class Date
{
public:
    Date(int year = 1900, int month = 1, int day = 1)
        : _year(year), _month(month), _day(day)
    {}

    bool operator<(const Date& d) const   // 大堆需要:Date 支持 <
    {
        return (_year < d._year) ||
               (_year == d._year && _month < d._month) ||
               (_year == d._year && _month == d._month && _day < d._day);
    }

    bool operator>(const Date& d) const   // 小堆需要:Date 支持 >
    {
        return (_year > d._year) ||
               (_year == d._year && _month > d._month) ||
               (_year == d._year && _month == d._month && _day > d._day);
    }

    friend ostream& operator<<(ostream& _cout, const Date& d);
    // 教学方便起见成员公开;工程里建议 private + 提供接口
    int _year; int _month; int _day;
};

// 路线二:自定义仿函数,量身定做比较逻辑
class LessDate
{
public:
    bool operator()(const Date& x, const Date& y)
    {
        return (x._year < y._year) ||
               (x._year == y._year && x._month < y._month) ||
               (x._year == y._year && x._month == y._month && x._day < y._day);
    }
};实测(LessDate 大堆 + Greater<Date> 小堆):
text
[LessDate 大堆] top=2026-10-30 | 依次弹出: 2026-10-30 2026-10-29 2026-10-28 2021-3-30 2020-1-30
[Greater 小堆] top=2026-10-28 | 弹 3 次: 2026-10-28 2026-10-29 2026-10-30
【面试】自定义类型进 priority_queue 的条件:默认大堆要求类型支持 operator<;换 greater 变小堆要求 operator>。不想改类型?手写一个仿函数传进去即可------比较逻辑和数据类型解耦。
4.2 指针陷阱:priority_queue<Date*> 排的是什么?
重点来了。如果存的是指针:
cpp
bit::priority_queue<Date*> q; // Compare 默认是 Less<Date*>Less<Date*> 里的比较是 x < y------两个指针比大小,比的是地址!地址大小和日期大小毫无关系。用一个可控的实验暴露它:
cpp
Date arr[2] = {Date(2026, 10, 30), Date(2026, 10, 29)};
Date* p30 = &arr[0];   // 日期更大,地址更低(数组内地址随下标递增)
Date* p29 = &arr[1];

cout << std::less<Date*>()(p30, p29);   // 1:按地址比较,竟然认为"10-30 < 10-29"
cout << bit::Less<Date*>()(p30, p29);   // 0:按日期比较,正确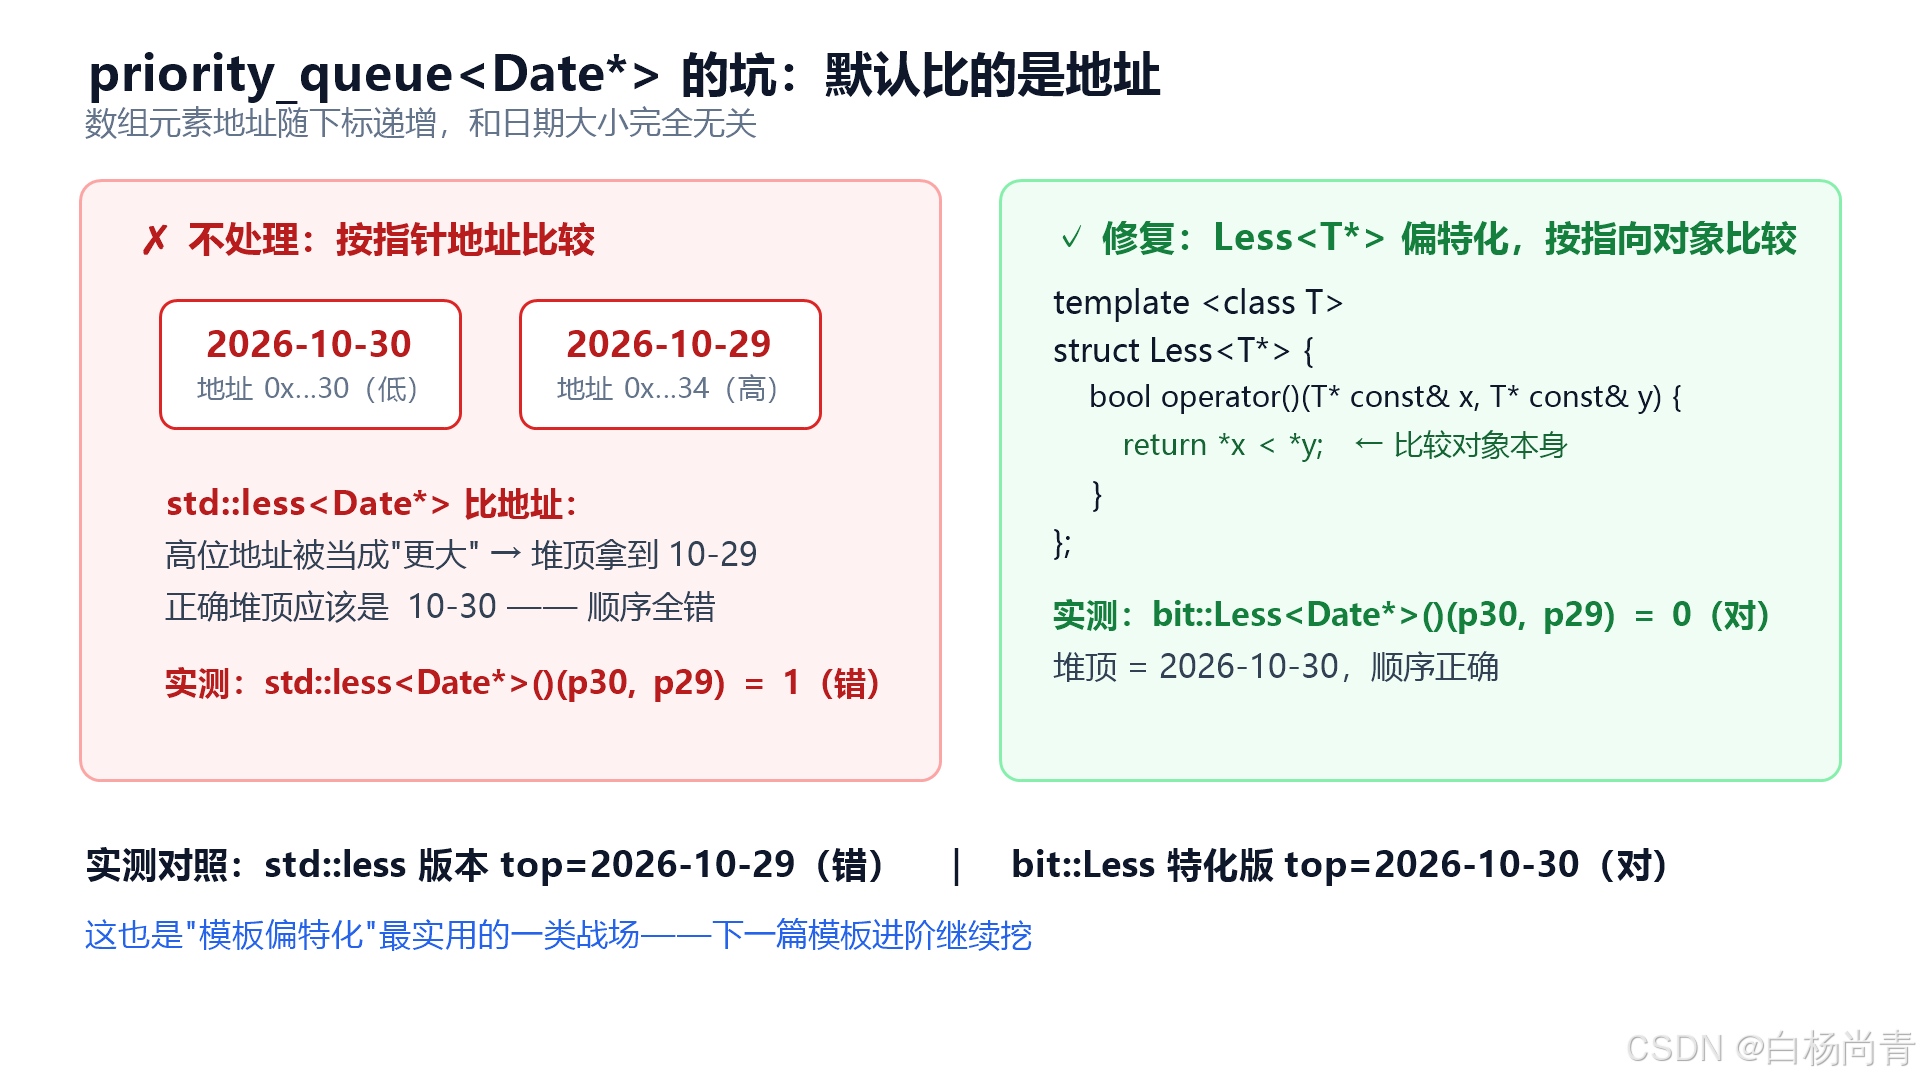
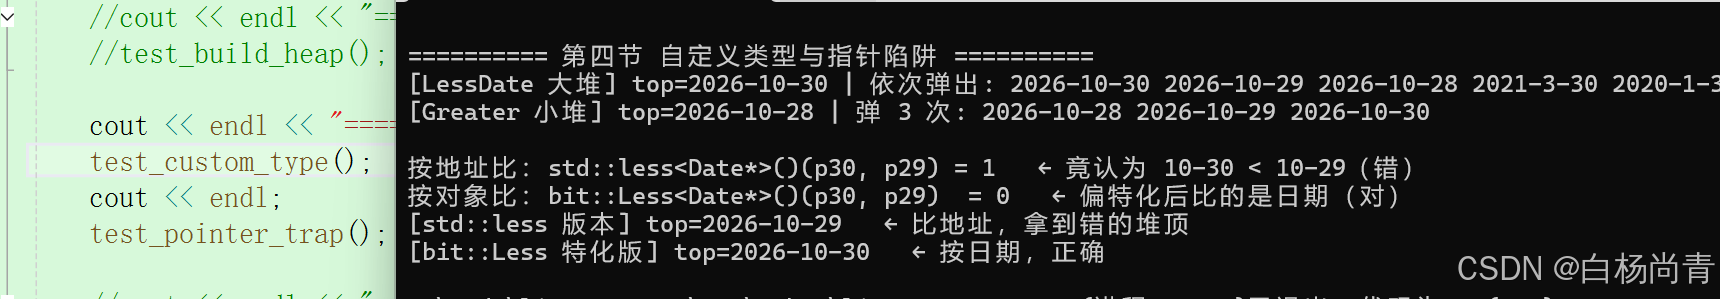
实测输出:
text
按地址比:std::less<Date*>()(p30, p29) = 1   ← 竟认为 10-30 < 10-29(错)
按对象比:bit::Less<Date*>()(p30, p29)  = 0   ← 偏特化后比的是日期(对)
[std::less 版本] top=2026-10-29   ← 比地址,拿到错的堆顶
[bit::Less 特化版] top=2026-10-30   ← 按日期,正确
后两行是真实的堆行为对照:用未特化的比较器,堆顶是错的 10-29;用偏特化后的 bit::Less,堆顶是 10-30。
修复方案:给 Less 加一个指针偏特化------所有指针类型一次性处理,比给每个类写仿函数优雅得多:
cpp
// 偏特化:所有"指针类型"都按指向的对象比较
template <class T>
struct Less<T*>
{
    bool operator()(T* const& x, T* const& y) { return *x < *y; }
};
【易错】指针 ≠ 对象。priority_queue<Date*> 不处理比较器,排的就是地址;这也是"模板偏特化"最实用的一类战场------下一篇《模板进阶》会专门展开全特化 / 偏特化的完整玩法,这里先混个脸熟。
五、Top-K 实战
priority_queue 最经典的 OJ 用法就是 Top-K。OJ 读数模式长这样(K 从输入读):
cpp
int k;
cin >> k;
while (k-- && !q.empty())
{
    cout << q.top() << " ";
    q.pop();
}
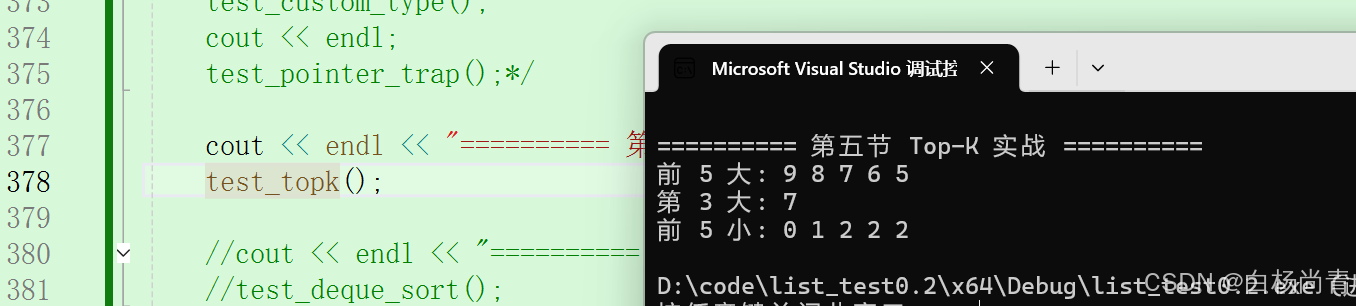
我们固定 K 实测(v = {3,2,7,6,0,4,1,9,8,5,2,2,3}):
text
前 5 大: 9 8 7 6 5
第 3 大: 7
前 5 小: 0 1 2 2 2
三种问法各对应一个套路:
- 前 K 大:大堆弹 K 次;
- 第 K 大:大堆弹 K-1 次,剩下的堆顶就是答案------建堆 O(N) + K 次调整 O(K log N);
- 前 K 小 :换
Greater小堆,弹 K 次。
【面试加一问】数据量 N 巨大、K 很小(比如 100 亿里找前 10)怎么办?------反过来维护一个大小为 K 的小堆:遍历时比堆顶大就替换,空间 O(K)、时间 O(N log K),不用把所有数据都装进来。这个思路常和"海量数据处理"一起考。
六、附:deque 排序效率实测
上一篇讲 deque 时说过"头尾 O(1)、遍历慢",那是理论。补一个实验兜底:100 万个数,一份直接在 deque 上 sort,一份拷到 vector 排完再拷回 deque(-O2):
text
N = 1000000(-O2 实测)
直接 sort(deque)              : 43 ms
拷贝到 vector 排序再拷回 deque : 30 ms
拷贝折腾了两趟,反而快 13ms。原因和之前 list 那篇是同一个:deque 的"分段连续"让迭代器频繁跨段检测、缓存命中率也低------排序和遍历都用不上它的长处,反而吃满它的短板。
【一句话记】deque 的用武之地是"两端进出",不是"排序和遍历"------这也解释了标准库为什么拿它给 stack/queue 当底层:那俩恰好只需要两端操作。
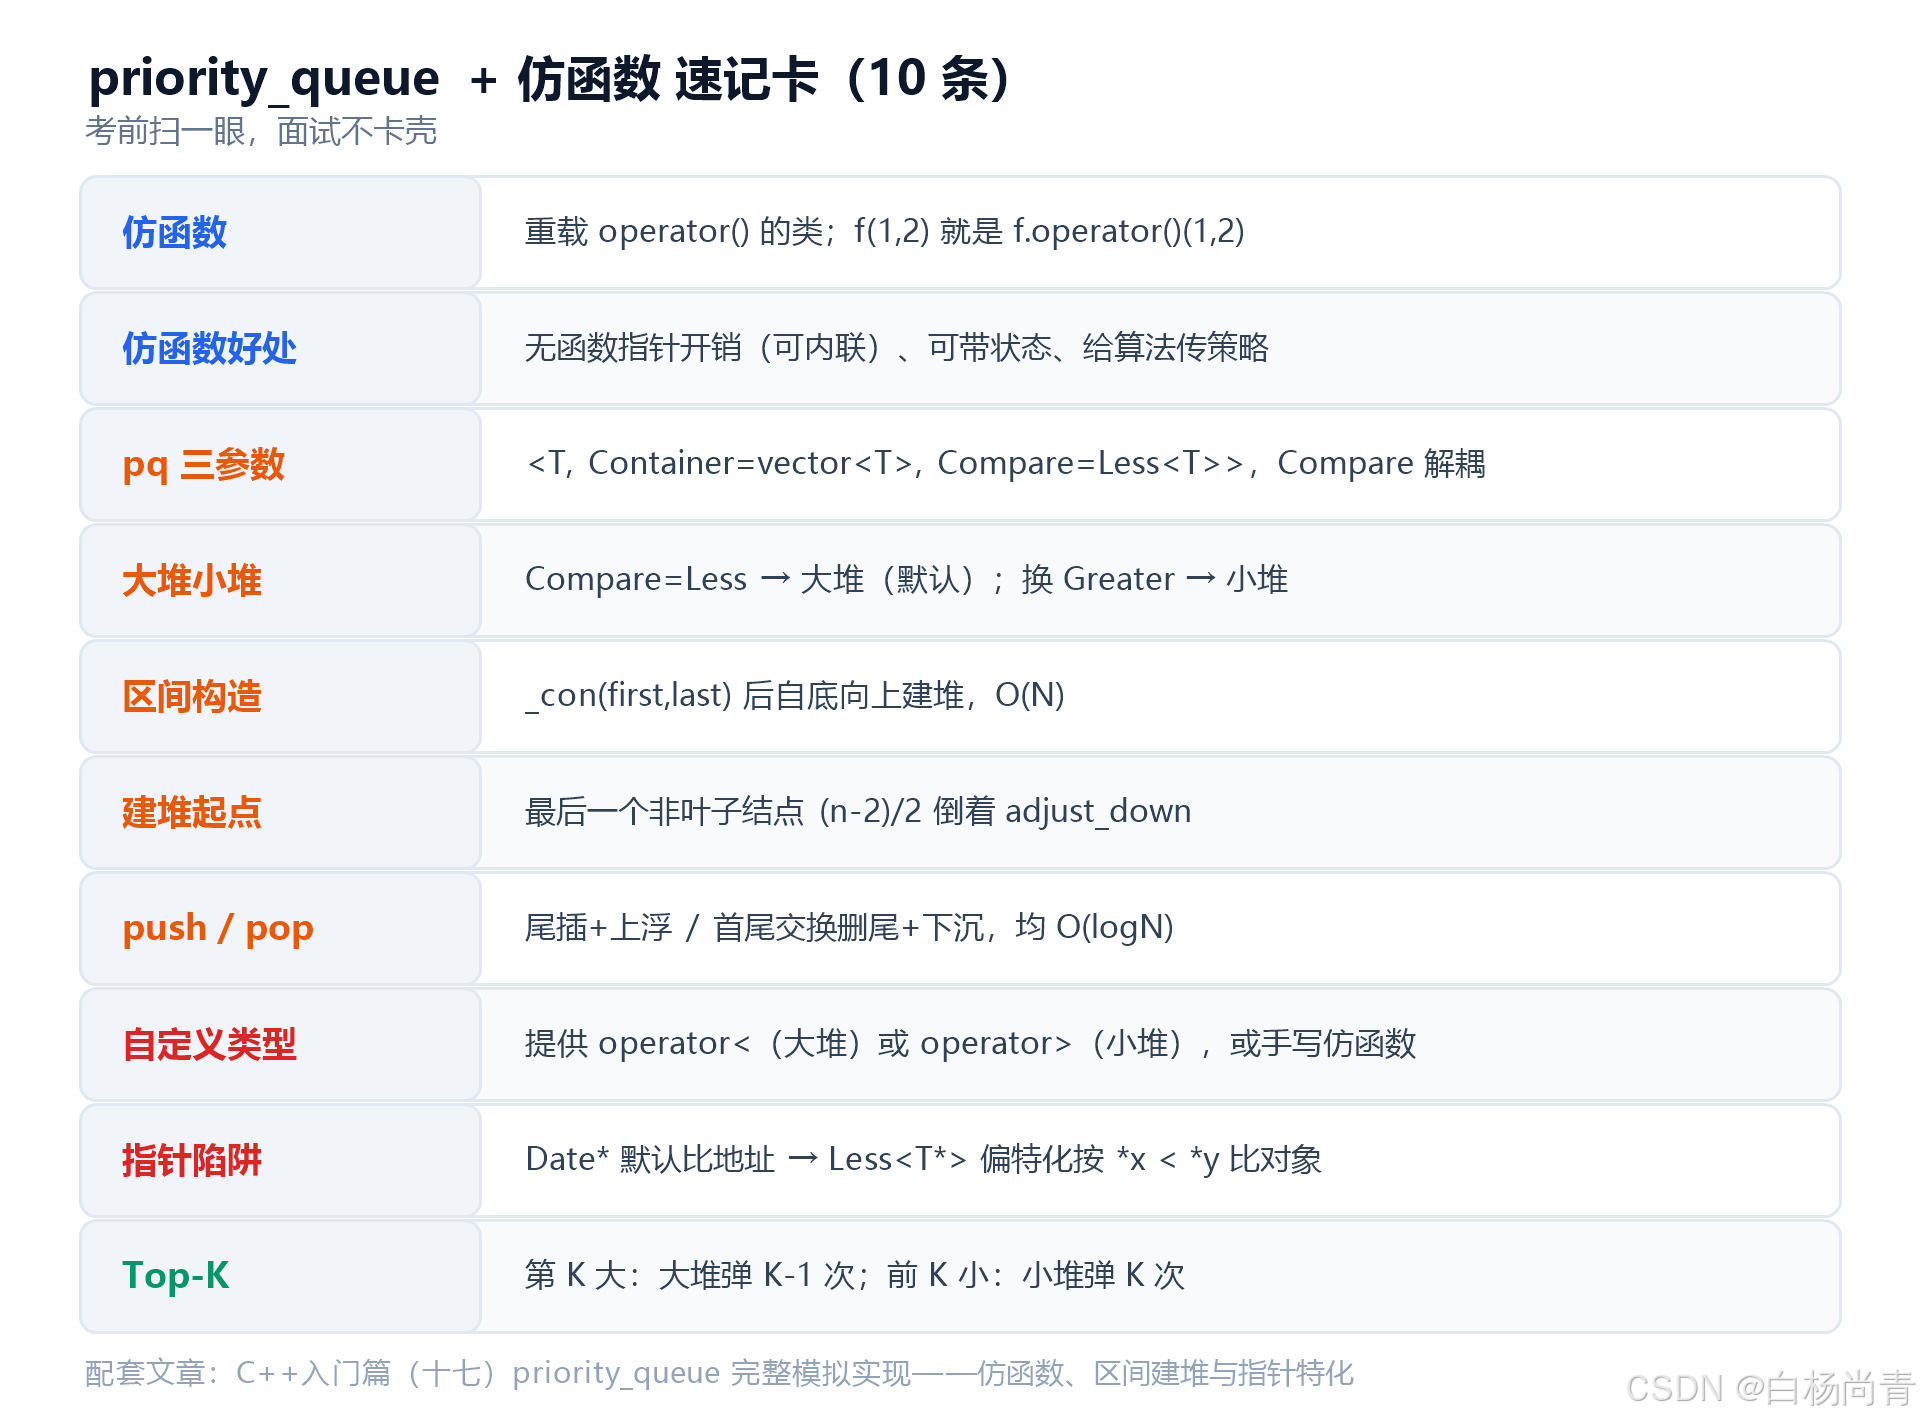
七、速记卡
考前扫一眼,面试不卡壳:
八、自测三连
先自己默答,再看答案对照:
- 仿函数是什么?
f(1, 2)的等价写法是什么?priority_queue 里它管什么?
答案
仿函数是重载了 operator() 的类;f(1, 2) 等价于 f.operator()(1, 2)。在 priority_queue 里它作为 Compare 模板参数,决定"谁排在堆顶"------Less 大堆、Greater 小堆。
- 区间构造的建堆为什么从
(n-2)/2开始?为什么它和"逐个 push"结果一样?
答案
(n-2)/2 是最后一个结点的双亲,也就是最后一个非叶子结点;它的后面全是叶子,叶子天然是合法的堆,不用调整。从它开始倒着做向下调整,每个子树都被修正成堆,自底向上完成建堆。和逐个 push 只是"建堆路径不同",最终得到的是同一个堆,但建堆整体是 O(N),更快。
priority_queue<Date*>直接塞指针会怎样?为什么?怎么修?
答案
默认 Less<Date*> 比较的是指针地址 ,和日期大小无关,堆顶会拿错(实测拿到了 10-29 而不是 10-30)。修复:给比较器加指针偏特化 Less<T*>,用 *x < *y 按指向的对象比较;或者传入一个针对该类型的自定义仿函数。
附录 A:完整代码仓库
完整工程(单文件版,全部实验一次跑完)在 Gitee:
gitee.com/BaiYang_SQ/priority-queue-sim
| 仓库文件 | 说明 |
|---|---|
priority_queue_sim.cpp |
单文件:全部实验 + 完整模拟实现;章节 ↔ 函数名对照见仓库 README 导览表 |
output.txt |
全部实验的真实运行输出(不想装编译器,直接看这个) |
build.bat |
Windows 一键编译 + 运行 + 刷新 output.txt |
README.md |
一分钟上手 + 代码导览 |
面试前手写练手,照这个"默写版"骨架抄(比完整版少了 top/empty/size 等边角):
cpp
// priority_queue 面试默写版(完整版见正文第三节 / 仓库)
#include <iostream>
#include <vector>
using namespace std;

template <class T, class Container = vector<T>, class Compare = less<T>>
class priority_queue
{
public:
    priority_queue() {}

    template <class InputIterator>
    priority_queue(InputIterator first, InputIterator last)
        : _con(first, last)
    {
        for (int i = ((int)_con.size() - 2) / 2; i >= 0; --i)
            adjust_down((size_t)i);
    }

    void push(const T& x) { _con.push_back(x); adjust_up(_con.size() - 1); }

    void pop()
    {
        swap(_con[0], _con[_con.size() - 1]);
        _con.pop_back();
        adjust_down(0);
    }

    const T& top() const { return _con[0]; }

private:
    void adjust_up(size_t child)
    {
        size_t parent = (child - 1) / 2;
        while (child > 0)
        {
            Compare compare;
            if (compare(_con[parent], _con[child]))
            {
                swap(_con[child], _con[parent]);
                child = parent;
                parent = (child - 1) / 2;
            }
            else break;
        }
    }

    void adjust_down(size_t parent)
    {
        size_t child = parent * 2 + 1;
        Compare compare;
        while (child < _con.size())
        {
            if (child + 1 < _con.size() && compare(_con[child], _con[child + 1]))
                ++child;
            if (compare(_con[parent], _con[child]))
            {
                swap(_con[child], _con[parent]);
                parent = child;
                child = parent * 2 + 1;
            }
            else break;
        }
    }

    Container _con;
};

int main()
{
    priority_queue<int> q;
    for (int e : {5, 1, 9, 3, 7}) q.push(e);
    cout << q.top() << endl;   // 9
    q.pop();
    cout << q.top() << endl;   // 7
    return 0;
}
好了,priority_queue 这一篇到此完结!下一篇回到主线------入门篇的收官之战:模板进阶 (预告:非类型模板参数、模板全特化与偏特化、分离编译------对,就是本篇指针陷阱埋下的那个伏笔继续往下挖)。如果对你有帮助,不要忘记点赞三连一波哦,我是白杨,我们下期见。