| 项 | 内容 |
|---|---|
| 标题 | Fast Approximate Similarity Join in Vector Databases |
| 作者 / 单位 | Jiadong Xie(香港中文大学)、Jeffrey Xu Yu(香港中文大学)、Yingfan Liu(西安电子科技大学) |
| 发表出处 | Proc. ACM Manag. Data, Vol. 3, No. 3 (SIGMOD), Article 158 (June 2025), pp. 1--26 |
| DOI | 10.1145/3725403 |
| 本地材料 | paper.pdf(26 页全文)、paper.md(MinerU VLM 转写)、paper.report.md(已有批判性分析)、images/(图件) |
证据纪律 :文中所有 blockquote 均逐条对照
paper.pdf文本层核验;标注(§n, p.m)中p.m为 PDF 页码(与文章页码一致,共 26 页)。MinerU 转写中 ε、X、Y、k 等符号存在乱码,引用时已按 PDF 原文恢复。对论文未直接陈述、属于本精读的推理判断,一律标注"分析判断"。
一、研究动机与价值
核心研究目标 :为向量数据库设计一个新的近似相似性连接算法(Approximate Similarity Join) ------本文命名为 SimJoin------利用已处理数据点的结果来 "预测" 或 "滑动" 到后续数据点的连接窗口,从而大幅减少重复计算,实现比现有方法快一个数量级以上的性能提升。
第一步:先搞懂什么是 "相似度连接"?
用一个生活例子
假设你有 100 万本书,每本书都被编码成了一个 "数字指纹"(就是向量)。
现在你要做一个任务:
找出所有 "内容相似" 的书对------ 只要两本书的内容相似度足够高,就把它们配成一对,最后输出所有这样的配对。
这个任务就叫 相似度连接(similarity join)。
那什么是 ε?
ε 就是 "相似的门槛"。
比如你定一个规则:
"只要两本书的内容差异在 ε 以内,就算相似。"
ε 越大,算 "相似" 的书就越多;ε 越小,要求越严格。
这个任务就叫 ε- 相似度连接。
第二步:现有方法是怎么做的?为什么慢?
现有方法(传统方法)
传统方法的思路特别 "笨":
拿出第一本书,去 100 万本书里挨个扫,找出所有和它相似的; 再拿出第二本书,又去 100 万本书里挨个扫,找出所有和它相似的; ...... 拿出第 100 万本书,再去 100 万本书里挨个扫......
每处理一本书,都要从头搜一遍。
为什么这样慢?
你想想:
- 第 1 本书在书架最左边
- 第 2 本书紧挨着第 1 本书
这两本书内容应该很像对吧?那它们各自的 "相似书集合" 也应该大部分重叠对吧?
但传统方法不管这个 ------第二本书还是要从头搜一遍,哪怕第一本书的结果已经知道了。
这就像你找完张三的朋友,找李四的朋友时,明明李四和张三是邻居,你却完全不参考张三的朋友圈,又从全公司重新找一遍。
大量的计算都是重复的!
第三步:本文方法是怎么做的?为什么快?
核心思想:"滑动"
这篇论文的作者就想:
既然第 1 本书的相似书集合我已经知道了,那我能不能直接从第 1 本书的结果,"滑" 到第 2 本书的结果?
什么意思?
- 第 1 本书的 "相似书集合"(论文里叫连接窗口):{A, B, C, D, E}
- 第 2 本书紧挨着第 1 本书,它的相似书集合应该也差不多
- 我不需要重新搜,只要在 {A, B, C, D, E} 这个小集合里,微调一下就行 ------ 可能多了个 F,少了个 Z
从 100 万本书里搜,变成了从 5 本书里微调,能不快吗?
什么是 "连接窗口"?
就是上面说的 ------某本书的所有相似书组成的集合。
论文里的说法是:
连接窗口 J 就是:对于数据集 X 中的一个点 x,数据集 Y 中所有和 x 距离 ≤ ε 的点,组成的集合。
而x₁、x₂、x₃ 是 X 里的点,是我们要逐个处理的对象。它们之间的距离远近决定了滑动的效率,论文用 MST 算法来安排最优的处理顺序,让总的滑动距离最短(论文不仅说要用 MST,还自己实现了一个专门的 MST 算法。Algorithm 4: MST (G),论文第 13 页)。
第一次提到MST:Lemma 6.1(引理 6.1)
位置:论文第 12 页,Section 6.1(The Weighted Graph G_C)
Lemma 6.1: The minimum join cost of X ⋈_ε Y is equal to the total MST weight of G_ε if G_ε is connected.
如果 G_ε 是连通的,那么 X ⋈_ε Y 的最小连接代价,等于 G_ε 的最小生成树(MST)的总权重。
第四步:那 "滑动" 具体怎么滑?
这就是论文提出的核心技术。
"滑" 的本质是什么?就是在 Y 的邻接图上做一次广度优先搜索(BFS),搜索的起点是旧窗口里的所有点,搜索的终止条件是:遇到离 x₂ 太远的点就停止往下探索。 这不是 "往某个几何方向滑",而是"从旧窗口的点出发,沿着 Y 图的边,一圈一圈往外扩散,碰到离 x₂ 太远的就停"。
问题来了:怎么知道往哪个方向滑?
你总不能瞎滑吧?
论文的解决方案是:先建一张 "邻居地图"。
这张地图上,每个点都标注了 "我的邻居是谁"------ 这就是论文说的邻接点图。
有了这张地图,你就可以:
- 从第 1 本书出发,知道它的邻居是第 2 本
- 第 1 本的相似书集合已经有了
- 直接沿着邻居关系,把这个集合 "滑" 到第 2 本那里,微调一下
- 然后再滑到第 3 本,第 4 本......
一路滑下去,一路复用之前的结果,不用每次从头搜。
第五步:那 "处理顺序" 为什么也很重要?
你想想:
- 如果你按 "第 1 本 → 第 100 万本 → 第 2 本 → 第 999999 本......" 这个顺序处理
- 每次滑都要滑很远,反而更慢了
所以论文还提出了一个优化:怎么安排处理顺序,让总的滑动距离最短?
这就像你送外卖,不能瞎跑 ------ 得规划一条最短路线,挨家挨户送。论文用最小生成树(MST)算法来规划这个顺序。
整个流程串起来看:
1. 在 Y 上建邻接图 G̃(Y 内部的邻居关系)
2. 在 X 上构建加权图,用 MST 找到最优处理顺序
   → 比如顺序是:x₁ → x₂ → x₃ → x₄ → ...
3. 按这个顺序逐个处理 X 中的点:
   - 处理 x₁:完整搜索 Y,得到窗口 J₁ = {y₁, y₂, y₃}
   - 处理 x₂:从 J₁ 出发,在 Y 的邻接图上滑动,得到窗口 J₂ = {y₂, y₃, y₆}
   - 处理 x₃:从 J₂ 出发,在 Y 的邻接图上滑动,得到窗口 J₃ = {y₃, y₆, y₇}
   - ...
一句话总结整个研究目标
| 问题 | 答案 |
|---|---|
| 现有方法为什么慢? | 每本书都从头搜,重复计算太多 |
| 本文方法怎么快? | 相邻的书,直接复用之前的搜索结果,"滑" 过去就行 |
| "连接窗口" 是什么? | 就是某本书的所有相似书组成的集合 |
| "滑动" 是什么? | 从一个点的相似书集合,微调成下一个点的相似书集合 |
| 为什么能快 10 倍? | 原来每次要搜 100 万本书,现在每次只要微调 5 本书 |
------------回到正文:
解决"两个高维数据集之间,输出所有距离不超过阈值 ε 的向量对"这一运算在大规模数据上过慢的问题。论文把自己的起点直接写在摘要中:
"Existing state-of-the-art approaches for approximate similarity join are selection-based such that they treat each data point in a dataset as an individual query point to search data points by an approximate range query in another dataset. Such methods do not fully capitalize on the inherent properties of the join operation itself." (§摘要, p.1)
通俗地说:相似性连接 就像"给两摞卡片做配对"------对集合 X 中每张卡片,找出 Y 中所有"足够像"的卡片,把所有配对输出。现有方法(称为选择式方法 selection-based approaches )的做法是"把 X 里每个点都当作一条独立查询,各自在 Y 上做一次近似范围查询(approximate range query)"。这就像每一通电话都重新拨号、从通讯录第一页开始翻。论文指出,相邻查询的结果高度相关,独立处理浪费了这些相关性:
"...they do not utilize the join results from processed data points to accelerate the processing time of other data points that have not been processed, which is the focus we study in this paper." (§1, p.2)
##我有问题:怎么划分 X 和 Y,一开始是不是只有 X?
不是。相似度连接(similarity join)本质上是两个数据集之间的二元操作,和数据库里的表 JOIN 一样,天然就有左、右两个输入集合,分别叫 X 和 Y,不是从一个 X 里拆分出来的。
一、先看论文的标准定义
论文第 2 节开门见山:
Given two sets of points, X = {x₁, x₂, ..., xₙ} and Y = {y₁, y₂, ..., yₘ}, in Euclidean d-dimensional space... the ε-similarity join X ⋈_ε Y is defined as X ⋈_ε Y = {(x_i, y_j) ∈ X × Y | δ(x_i, y_j) ≤ ε}
翻译:给定两批点 X 和 Y,都在同一个 d 维欧几里得空间里,找出所有满足「x 来自 X、y 来自 Y、且两者距离 ≤ ε」的点对。
核心:X 和 Y 是两个独立的输入集合,共同构成 join 操作的两个 operand。
二、X 和 Y 怎么分工?为什么这么分?
两个集合角色不同,分工是固定的:
| 集合 | 角色 | 做什么操作 | 通常特点 |
|---|---|---|---|
| Y | 被查询方 / 索引方 | 建邻接图,供搜索滑动 | 更大、更固定(存量数据) |
| X | 查询方 / 处理方 | 逐个点处理,滑动窗口 | 更小、更动态(增量 / 查询数据) |
为什么这么分?
-
Y 建索引,一次建好反复用 邻接图是建在 Y 上的,建图成本较高,所以适合把量大、不怎么变的存量数据放 Y 里,索引建一次可以服务很多次 join。
-
X 做遍历,越小越高效 我们要在 X 上做 MST 最优排序、逐个点滑动处理,X 越小,排序成本越低,滑动总距离也越短。 论文第 6 章开头明确说了这个假设:
Here we assume the set of X is smaller than that of Y in size.
举个实际例子:auto-tagging 场景
- Y:100 万篇已标注文档(数据库存量,固定不变)→ 建好邻接图索引
- X:10 万篇新来的未标注文档(动态增量)→ 逐个去 Y 里找相似的已标注文档,自动打标签
三、特殊情况:自连接(self-join)
有时候我们就是要在同一个数据集内部 找所有相似点对(比如文档去重、相似样本聚类)。这时候 X = Y,就是同一个数据集。
但算法逻辑里仍然分两个角色:
- Y 角色:用整个数据集建邻接图
- X 角色:还是逐个点遍历,从第一个点开始滑动窗口
论文里的实验也专门对比了「self-join(自连接)」和「join(两个不同数据集连接)」两种场景。
一句话总结划分原则
谁做索引谁当 Y,谁被遍历谁当 X;量大固定当 Y,量小动态当 X。
------------回到正文:
学术定义上,论文研究的是ε-相似性连接(ε-similarity join):
"the ε-similarity join X ⋈ε Y is defined as X ⋈ε Y = {(x_k, y_l) ∈ X × Y | δ(x_k, y_l) ≤ ε}, where δ(x_k, y_l) is L2 norm (i.e., Euclidean distance) between x_k ∈ X and y_l ∈ Y and ε is a user-given threshold where ε > 0." (§2, p.3)
科学瓶颈 :论文点明,由于维度灾难(curse of dimensionality) ,精确 ε-join 计算代价极高,而 k-NN 搜索 / k-ANN 搜索已被大量研究、近似 ε-join 却"未被充分研究";且既有近似 join 方法全部是选择式的(文中指 VBase、XJoin 等)。它还指出现代负载的维度远超传统"高维"定义:
"Most of these works 8, 25, 39, 48 consider dimensions around 40 as high, whereas current vector databases often feature significantly more dimensions, e.g., the number of dimensions in GIST is 960." (§9, p.24)
论文的实验规模佐证了这一现实:SIFT 1000 万点(128 维)、Higgs 1100 万点、GIST 100 万点(960 维)等(Table 2)。
产业意义:
-
向量数据库把 join 从"学术操作"推向"核心算子":自动打标(auto-tagging)------"an unlabeled document can be labeled by the label of another labeled document, if the corresponding two document embeddings (vectors) are sufficiently similar"(§1, p.1)------等价于一次 ε-join;同类还有去重、数据清洗、近重复样本消理。
-
论文把 join 与**邻近图索引维护(proximity graph index maintenance)**挂钩:平台持续涌入新向量("over 500 hours of content are uploaded to YouTube every minute",§7.2, p.17),全局重建成本极高------"global rebuilding of an index for Higgs dataset peaked at 22.4 GB memory and required 2,962 seconds when it is executed using 32 threads, despite the original size of Higgs is 3.8 GB"(§7.2, p.17)。用 k-join 替代全局重建,把这次 4.8 GB/744 s(单线程,Table 4)------一个算法同时服务于 ANN 检索、join 与索引维护,工程价值显著。
学术意义 :本文第一次把"复用已处理查询的结果窗口"与"批处理顺序优化"形式化为 join 执行层面的两个核心问题(join window sliding 与 join window order selection),并给出了成本模型、若干引理/定理和离线---在线拆分的高效实现,为"批式近似检索"提供了一个可分析、可复用的执行框架。
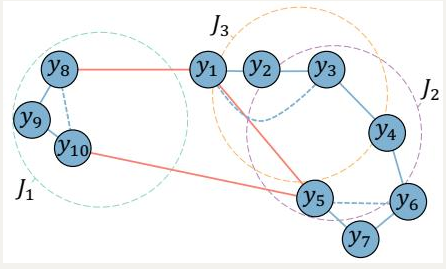
图 1(原文 Fig. 1):k-NN/k-ANN 图上,独立入口的 range search 无法同时覆盖落在不同连通分量里的结果点,这是选择式方法的召回瓶颈(§3, Example 3.1)。
二、核心方法与创新
论文把执行过程拆成两个关键问题(§2, p.3):
"Join window sliding refers to the process of sliding the join window J_i to the join window J_j to be processed next for x_j. And join window order selection is how to select such x_j among the points in X that have not yet been processed, in order to minimize the join processing cost."
其中连接窗口(join window) 是 J_i = {y_l ∈ Y | δ(x_i, y_l) ≤ ε},即"以 x_i 为球心、ε 为半径的球内所有 Y 点"。
注: X 和 Y 都在同一个 d 维欧几里得空间里。X 和 Y 只是人为分出来的两批点,本质上都是这个空间里的点。那为什么不合并成一个数据集?
有时候确实会合并 ------ 论文里叫 self-join(自连接),就是 X = Y,自己和自己找相似点对。
但更多时候 X 和 Y 是不同用途的两批点:
- 比如 X 是 "查询点",Y 是 "数据库点"
- 比如 X 是 "小数据集",Y 是 "大数据集"
分开只是为了方便描述,本质上都在同一个空间里。
总执行成本被形式化为(Eq. (1), p.3):
C(X ⋈ε Y) = Σ_{x_i∈X} { c_ε(x_i)          if (∅, x_i) ∈ ℵ
                        { c_κ(κ_i, x_i)    otherwise
即每个新窗口要么选择"独立 range search"(成本 cε),要么选择"从某个已处理窗口 κi 滑过去"(成本 c_κ)。
创新 1:连接窗口滑动(Join Window Sliding)。通俗解释:如果两个查询点很近,它们的结果窗口往往重叠------就像把聚光灯从旧区域拖到新区域,沿路能"顺带看清"新区域,而不必重新从图入口出发全局搜索。学术上它依赖三个概念:
-
邻接点(adjacent points) :
"two points y and y′ in Y are adjacent if there exists a d-ball such that y and y′ are two points on the boundary of d-ball and there is no any point y″ in Y inside d-ball."(Definition 4.1, p.5)白话:一对点能共处一个"空球"边界上,球里不许有别人,就视为可一步滑动的邻居。 -
连续窗口(continuous window) 与连续滑动(continuous sliding) (Definitions 4.2/4.3)。论文的关键洞察是:相邻数据点的连接窗口是连续的,可以从一个窗口滑动到下一个窗口,复用已有的搜索结果。
-
邻接图(adjacent graph) G = (V, E),把邻接点对连边(Definition 4.4)。几何上等价于维诺图(Voronoi diagram)的对偶------德劳内三角剖分(Delaunay triangulation, DT):论文明确"we construct G for Y by constructing DT over Y"(§4.1, p.7)。
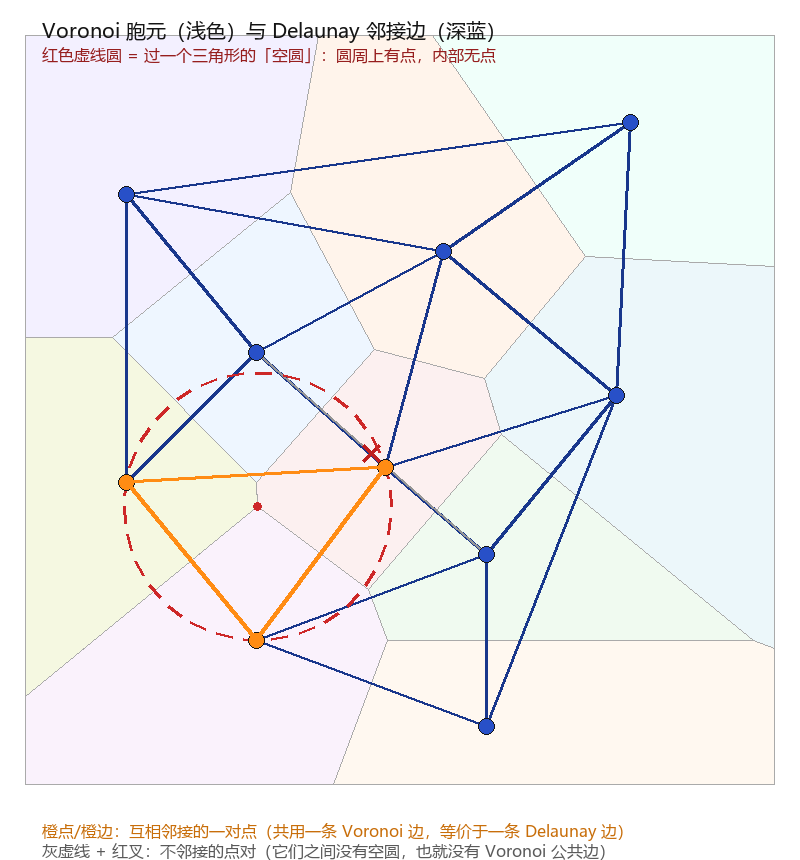
补充:
Voronoi 图(维诺图)
给定平面上一堆离散点(称为站点 /site):
- 把每个点想象成一片土地的"中心"。平面上每个位置都归离它最近的那个站点管。离站点 \(y_1\) 最近的地方就是 \(y_1\) 的地盘,离 \(y_2\) 最近的地方就是 \(y_2\) 的地盘......所有地盘像瓷砖一样铺满整个平面,这就是 Voronoi 图(Voronoi diagram) ,每块瓷砖是一个 Voronoi 胞元;
- 所有胞元拼在一起,整张分割图就是 Voronoi 图。
- Voronoi 顶点的性质:一个 Voronoi 顶点,到周围 3 个站点距离相等(也就是这 3 个点的外接圆圆心)。
通俗解释:拿地面,按照离哪个钉子最近切成一块一块的地盘:
- 每一块地盘,里面所有位置,离这块地盘的钉子最近;
- 地盘之间的分界线,到两边两个钉子距离一模一样;
- 好几块地盘交汇的那个交点,到周围3 颗钉子距离完全相等。
👉 Voronoi 干的事:给钉子划分地盘 。 你看到的图形主体是一块一块的区域。
Delaunay 三角剖分(德劳内三角)
还是同一组站点,把这些站点直接连起来,拼成一堆三角形,覆盖整个凸包。 Delaunay 最重要判定准则(空圆准则):
任意一个 Delaunay 三角形的外接圆内部,不能包含其他任何站点。
通俗解释:还是这堆钉子。不画地盘了,直接把钉子互相连线,拼成一堆三角形 ,铺满所有钉子围成的区域。 有一条硬性规则:随便挑一个三角形,画它的外接圆,圆里面不能出现别的钉子(空圆准则)。
👉 Delaunay 干的事:直接连接钉子,拼三角形网格 。 你看到的图形主体是点和三角形。
重点:什么叫「两者互为对偶」
对偶 = 两套图,是同一个信息的两种表达方式,可以互相转化,但是画出来样子完全不一样。
操作(纸上跟着脑补):
- 先画 Voronoi 图(钉子的地盘)
- 只要两块地盘挨在一起,就把这两块地盘对应的两颗钉子,拉一条直线连起来
- 全部连完,得到的一堆三角形 = Delaunay 三角剖分
反过来:
- 先画 Delaunay 三角形(钉子连成三角网)
- 找到每一个三角形外接圆圆心
- 相邻三角形的圆心之间连线 → 得到 Voronoi 地盘分割线
二者不是长得一样! Voronoi 画的是地盘多边形;Delaunay 画的是钉子连出来的三角。 对偶是信息等价,知道一个,就能算出另一个,不是图形外观相同。
论文证明了 windows 在 DT 上的关键性质 :Lemma 4.1 (任意点的 k-NN 与其前 k−1 个 NN 中至少一个相邻,说穿了就是:每个新加入的近邻都不会是"孤儿",它身上总有一根边连回一个更近的点。 )和 Corollary 4.1(join window 在 G 中构成连通子图,允许"找到一个点就能涨满整个窗口"),二者在page6,并据此保证:
"It is important to note that the continous sliding ensures that we do not miss any points in Y for X ⋈ε Y." (§4.1, p.5)
论文特别区分了"相似性 ≠ 邻接性(Similarity vs Adjacency)":k-NN 相似的点未必是邻接点、邻接点未必相似(以 Fig. 2 中 y1 的 1-NN(第2近)/2-NN(第2近)/3-NN (第3近)为例),这正是为什么选择式方法在 k-ANN 图上滑动会漏结果、而 DT 邻接图不会。
- 最相似的点,中间可能隔着别人,所以不是邻接
- 最邻接的点,可能在全局排名里排很靠后,所以不相似
| 概念 | 本质 | 判断标准 |
|---|---|---|
| 相似性 | 谁离我最近 | 全局排名(第几近) |
| 邻接性 | 中间塞不下第三个点 | 局部几何(能不能画空心球) |
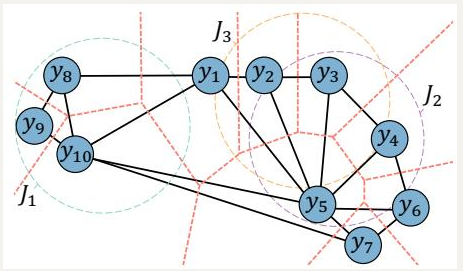
图 2(原文 Fig. 2):Voronoi 划分(红线)与其对偶 DT 邻接图(黑线);沿邻接边滑动窗口可保证不遗漏。
创新 2:用邻近图充当近似邻接图。DT 在高维不可用:
| 位置 | 原话要点 |
|---|---|
| §4.1, PDF p.7 | 论文是先规定"邻接图 G 用 DT 来构造":> "In this work, we construct G for Y by constructing DT over Y." |
| §5, PDF p.9 | 然后说高维下 G 变成完全图 、无法用于窗口滑动,所以要换成近似邻接图(approximate adjacent graph) |
即:G 的实现方式就是 DT → G 在高维退化为完全图 → 所以 DT 这条路在高维不可行。论文没有单独写一句"DT is unusable in high dimensions",但这两句合起来就是这个意思。
它标志着 SimJoin 从"精确邻接图(Lemma 4.1 / Corollary 4.1 能保证窗口连通、不漏点)"退让到"近似邻接图(只剩概率/经验保证)"。这也是后来召回损失、OOD 场景不鲁棒的根源------后续工作(如本仓库收录的 arXiv:2603.16360)正是冲着这个缺口来的。
"in a high dimensional space, G becomes a complete graph 19, 26, 38, which implies that all points can possibly be adjacent in a d-dimensional space when d becomes larger (e.g., d > 100). Thus, it becomes impractical for G to be used to slide over the join windows." (§5, p.9)
而且系统维护两张大图不现实:"it is impractical in a system to maintain two large graph indices. One is based on k-ANN for k-ANN search or approximate ε-range query, and the other one is based on adjacency for ε-similarity join. We explore if we can use one graph to serve all the purposes."(§5, p.9)。
两张大图指的是------两套建在同一个 Y 上的图:关键点在于两张图的顶点集完全相同(都是 Y),只是边不同 。普通向量库为了做检索,本来就必须维护图 A,向量库是持续更新的(论文举了"over 500 hours of content are uploaded to YouTube every minute",§7.2, p.17),插入、删除、定期重建都要做;而 SimJoin 的滑动又需要图 B。如果老老实实各建一张,就等于给同一批点维护两套邻接关系------内存、构建时间、尤其是维护成本都要翻倍,这在系统里不可接受。
| 图 A:k-ANN 邻近图 | 图 B:join邻接图 G | |
|---|---|---|
| 建在哪个数据集 | Y | Y(和 A 完全同一批点) |
| 边代表什么 | "相似":每个点连向它的 k 个近似最近邻(NSG / HNSW / Vamana 这类) | "邻接":每个点连向它的相邻点(理想是 DT 的对偶,实际是近似邻接图) |
| 用来干什么 | 常规的 k-ANN 搜索 / 近似 ε-range query | join window sliding(窗口沿边滑动) |
| 谁提供 | 向量数据库本来就有(存量基础设施) | SimJoin 需要新造 |
论文的对策:一张图两用。
依据是Theorem 5.1 (短边更可能成为邻接边的概率论证,p.9--10), 在均匀分布假设下证明:若 y_u 是 x_q 的最近邻,则与 y_u 距离更近的点更可能成为 x_q 的下一个近邻------即"短边"在概率意义上近似 Delaunay 邻接。从而支撑"一张 k-NN/proximity 图同时服务 ANN 查询与 join 滑动 "的设计。滑动算法 JoinSlide(Algorithm 3) 处理两种情况:窗口相交时直接从交集点做 ε 内邻居扩展(窗口连通性保证闭合);窗口不相交时用优先队列沿"离 x_j 更近"的方向贪心下滑,并设波束宽度(beam width)参数 w 限制队列大小(时间---召回折中),失败时回退到图入口 y0。论文还用 Msong 数据验证了该成本模型:滑动代价(以距离计算次数 NDC计)随两查询点距离近似线性增长(Fig. 5, p.11)------这是"用查询间距离作为滑动代价代理"成立的实证基石。
更正我上一条里的一句不严谨表述:我说"失败时回退到图入口 \(y_0\)"------更准确的说法是,"从 \(y_0\) 独立搜索"是在顺序选择阶段就被选定的另一条执行路径(即该查询的父节点被定为 \(y_0\)),而不是搜索跑崩了以后临时补救。
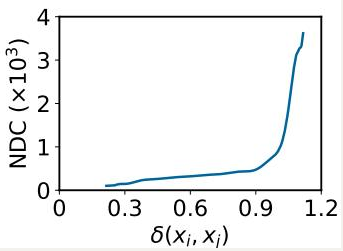
图 5(原文 Fig. 5):NDC 随 δ(x_i, x_j) 增大而增大,"it is almost linear when the distance is under 0.9"(§5, p.11)。
以上这段话其实把三件事揉在一段里了。我拆成三块讲,每块配一个生活化类比。
第一块:Theorem 5.1 在说什么,为什么它能支撑"一张图两用"
翻译成人话:"离冠军最近的人,更可能当亚军。"
- 设 x_q 是我们要去找邻居的查询点;y_u 是它找到的最近邻(冠军)。
- 现在看另外两个点 y_v、y_w:其中 y_v离冠军 y_u 更近。
- 定理说:y_v 比 y_w更可能成为 x_q 的第二近邻。
这跟邻接有什么关系?
论文前面已经证明:"邻接"等价于"存在一个空球,球面只压住这两个点"。如果 \(y_u\) 和 \(y_v\) 能同时充当某个 \(x_q\) 的 1-NN 和 2-NN,那这个 \(x_q\) 附近就存在这样一个空球------所以它们邻接 。定理说的正是:"距离自己近的点"(即 k-NN 图里的短边)更可能成为这种邻接伙伴。
于是结论呼之欲出:k-NN 图里的短边,和 Delaunay 邻接边高度重合。既然向量数据库本来就有 k-NN 图,就不必再单独造一张邻接图了------这就是"一张图同时服务 ANN 搜索与 join 滑动"的依据。
⚠️ 两个必须记住的限定(否则会误解成保证):这是概率 结论("更可能",不是"一定"),且建立在均匀分布、无限维空间的假设上。
所以它是"可以近似顶替"的启发式依据,不是定理级保证------这也正是后文召回会掉的根源。
第二块:JoinSlide 的两种情况(Algorithm 3)
要"滑动窗口",就是问:站在旧窗口 J_i 上,怎么走到新窗口 J_j? 算法分两种情形:
-
情况 (ii):窗户有重叠 ------已经站在新窗口里了。
像洪水漫岛 :已知新窗口里有一个落脚点,就从这个点出发,沿着"距离 x_j < ε"的邻接边一层层往外爬,直到爬不动为止。之所以敢这么做、而且不会漏,靠的是 Corollary 4.1(窗口在图上连成一片)------岛屿是连着的,水漫过去自然全淹。
-
情况 (i):完全没有重叠 ------一个落脚点都没有。
没法漫,只能朝着目标方向下山 :把旧窗口的点放进一个优先队列(按"到 x_j 的距离"排序),每次挑离 x_j最近的点,跳到它"更靠近 x_j"的邻居上,一步一步挪进 ε 范围,找到第一个落脚点后再切回情况 (ii)。
论文同时给了第二条路:干脆别滑,从固定入口 y_0 做一次普通的近似 ε-range 搜索 。两条路谁便宜走谁------判定标准就是 min {delta(x_i,x_j),delta(y_0,x_j)}(这是在顺序选择阶段就算好的)。
-
w(beam width 波束宽度)是什么:上面那个"下山"过程里,队列最多只保留 \(w\) 个候选(超出就丢掉离 \(x_j\) 最远的)。w 大 → 找得全但算得慢;w 小 → 跑得快但可能半路断掉、漏结果。这就是所谓的时间---召回折中。
第三块:Fig. 5 与"代价代理"
顺序选择要算"按什么顺序处理查询最省",就得知道"从窗口 A 滑到窗口 B 要花多少"。但真实的滑动成本,不跑一遍是不知道的。
论文的做法:先用一个便宜的指标当替身 ------NDC(number of distance computations,距离计算次数),也就是"滑这一趟要算多少次两点距离"。然后在 Msong 数据上做实验:随机取 1000 对查询 \((x_i, x_j)\),真的从 \(J_i\) 滑到 \(J_j\),记录 NDC。
结果(Fig. 5, p.11):两个查询点离得越远,滑动要算的距离次数越多,而且在距离小于 0.9 时几乎成正比。
这就好比:打车费基本跟两地距离成正比 。于是规划路线时,不必真跑一趟去问价钱,直接用两点距离 \(\delta(x_i,x_j)\) 当作"滑动代价"的估计就够了。有了边权,MST(最小生成树)才有得算------这就是我那句话说的"实证基石"。
把整段串起来(三块各自的作用)
| 问题 | 答案 | 出处 |
|---|---|---|
| 能不能只维护一张图? | 能------因为短边≈邻接边 | Theorem 5.1 (p.9--10) + Exp.7/Fig.11 |
| 有了图怎么滑? | 重叠就"洪水漫岛",不重叠就"朝目标下山",用 \(w\) 控预算 | Algorithm 3 (p.10--11) |
| 按什么顺序滑最省? | 用"查询间距离"当滑动代价的替身,建 MST 排顺序 | Fig. 5 (p.11) + §6 |
顺带澄清一个容易混淆的点 :论文里其实还有第三张图------建在 X ∪ {y₀} 上的 εNG (用于求 MST、决定窗口处理顺序)。但它不属于这里说的"两张大图":论文在 §6 开头明确假设 |X| < |Y|("Here we assume the set of X is smaller than that of Y in size", §6, p.12),且 εNG 是离线构建、体量小得多(Table 1 显示其平均度仅 11--51)。
创新 3:连接窗口顺序选择(Join Window Order Selection) 。通俗解释:既然复用旧窗口能省事,就该先规划"按什么顺序处理查询、每个查询认谁当父窗口",使总滑动路程最短------这是图上的最小生成树(Minimum Spanning Tree, MST) 问题。学术上:对 X ∪ {y0} 建带权完全图 G_C(边权 = 查询间距离),但其构建要 O(dn²)(§6.1, p.12)。论文改用ε-邻域图(εNG, ε-neighbor graph):只保留距离 ≤ ε' 的边(ε' 取保证连通的最小值),并证明最优性保持:
"Lemma 6.1: The minimum join cost of X ⋈ε Y is equal to the total MST weight of Gε if Gε is connected." (p.12)
随之给出其核心工程贡献------离线/在线两阶段 MST 算法(Algorithms 4 + 5):第一阶段离线算好 X 的近似 εNG 的 MST(朴素 Kruskal 需 O(m|X|log(m|X|)),m 为度上限;Algorithm 4 借助"邻居按距离升序"的 Borůvka 型合并进一步加速);第二阶段在线用 Kruskal 风格把 y0 的 |X| 条边插入,复杂度约 O(|X|),再用 DFS 得到窗口处理顺序:
"Theorem 6.2: Given the entry point y0 of the proximity graph of Y, Algorithm 5 returns the optimal window order list with the minimum join cost when the given proximity graph G of X is a connected εNG." (p.15)
注意"最优"是条件最优:以"查询间距离"为滑动代价代理、且 G 为连通 εNG 成立。主算法 **SimJoin(Algorithm 2)**按序逐点调用 JoinSlide / 独立搜索,输出全部近似 join 对;顺序树还天然支持并行------"all the child nodes of the same parent can be processed in parallel... layer-wise fashion"(§4.3, p.9)。
创新 4:k-similarity join 与索引维护的复用 。仅替换滑动函数 kJoinSlide(Algorithm 6) (改判停条件为"队列无未探索邻居")就支持 k-相似性连接(k-similarity join) X ⋈_k Y = {(x_i,y_j) | y_j ∈ TopK(x_i)}(§7.1, p.16);并把 k-join 反过来用作邻近图索引的增量维护:插入时以 k-join 结果作为跨新旧集合的候选出边;删除时对受影响 in-neighbor 用 kJoinSlide 补边(§7.2, pp.16--17)。
与既有方法的原理差异(整理自 §3、§8、§9):
| 维度 | VBASE / XJOIN(选择式) | FGF-HILBERT(精确) | SIMJOIN |
|---|---|---|---|
| 执行模型 | 每点独立 range query(VBASE 用索引扫描 + range filter;XJoin 用学习型基数过滤 learned filter预测结果数并跳过低产出查询) | Epsilon Grid Order 排序 + 过滤-精化两步,缓存无关 | 批量窗口滑动 + MST 顺序,复用已处理结果 |
| 复用查询间相关性 | 否 | 否 | 是(窗口滑动与顺序选择两级复用) |
| 图索引用途 | 仅支撑单查询 | 不用图 | 一张图三用:ANN、join 滑动、索引维护 |
| 结果保证 | 近似 | 精确 | 全部候选经精确距离验证(precision = 1 由构造保证) |
| 顺序优化 | 无 | 无 | 理论上条件最优(Lemma 6.1 / Theorem 6.2) |
三、实验设计与验证
实验配置 (§8, p.18):6 个真实 + 2 个合成数据集(图像 SIFT 10M/128 维、GIST 1M/960 维;音频 Msong 1M/420 维;文本 GloVe 1.18M/100 维、Crawl 1.99M/300 维;物理 Higgs 11M/29 维;均匀 Rand 与高斯 Gauss 各 10 万/64 维);数据集均分两半,一半做 self-join、两半做二集 join。基线为 VBase (图 + 阻塞式 range filter)、XJoin (学习预测结果数 + LSH join)与精确方法 FGF-Hilbert 。指标为**平均召回率(average recall)**与平均精确率;环境为 Xeon Silver 4215(128 GB)、C++11、g++ 11.4.1 -O3、单线程、5 次平均。索引时间策略明确:
"we exclude the index construction time for VBase, XJoin and our approach as the index constructed is independent of the ε value selected... We include the index construction time for FGF-Hilbert, because FGF-Hilbert requires preprocessing and cannot reuse the same index constructed for different ε values." (§8, p.18)
十个实验覆盖:参数影响(Exp. 1)、总体性能(Exp. 2)、ε 变化(Exp. 3)、NDC(Exp. 4)、base/query join(Exp. 5)、规模扩展(Exp. 6)、不同图索引(Exp. 7)、顺序算法对比(Exp. 8)、k-join(Exp. 9)、索引维护(Exp. 10)。
主结果(Exp. 2, ε=0.4;源自 Table 3)------self-join 运行时间 / 平均召回率(精确 FGF-Hilbert 召回恒为 1):
| 数据集 | XJOIN S(RECALL) | VBASE S(RECALL) | FGF-HILBERT S | SIMJOIN S(RECALL) | SIMJOIN 对 VBASE 加速 |
|---|---|---|---|---|---|
| Rand | 19.37(0.957) | 16.34(0.992) | 48.99 | 1.86(1.000) | 8.8× |
| Gauss | 15.79(0.958) | 13.27(0.996) | 18.23 | 1.13(1.000) | 11.7× |
| Msong | 765.8(0.976) | 528.6(0.991) | 4904 | 135.9(0.994) | 3.9× |
| GIST | 2097(0.973) | 1828(0.988) | 10911 | 120.6(0.991) | 15.2× |
| GloVe | 280.7(0.966) | 225.1(0.993) | 882.3 | 18.2(1.000) | 12.4× |
| Crawl | 1063(0.973) | 838.9(0.988) | 6072 | 47.1(0.9999) | 17.8× |
| SIFT | 14819(0.981) | 7679(0.993) | 166050 | 5233(0.996) | 1.5× |
| Higgs | 8258(0.987) | 4553(0.990) | 38724 | 2045(0.990) | 2.2× |
论文原文给出的加速比清单(对 VBASE):
"SimJoin achieves speedups of 8.8x, 11.7x, 3.9x, 15.2x, 12.4x, 17.8x, 1.5x, 2.2x in self-similarity join, and 2.6x, 13.1x, 3.0x, 5.0x, 14.7x, 4.2x, 1.7x, 3.1x in similarity join on the Rand, Gauss, Msong, GIST, GloVe, Crawl, SIFT, Higgs datasets respectively." (§8 Exp.2, p.20)
对精确方法的声势表述为:"up to speedups of over 2 orders of magnitude in runtime while maintaining an average loss of less than 1% in join results"(p.20)。按 Table 3 实算:Crawl self-join 6072.2/47.1 ≈ 129× 、GIST ≈ 90×、GloVe ≈ 49×、Msong ≈ 36×------"两个数量级"是 Crawl 上的上界情形。表中还报告了顺序选择的pre-ratio(顺序选择耗时占 join 总耗时比例,0.00023%--0.0387%),论文称:
"the order selection phase constitutes a negligible portion of the total time of our SimJoin." (§8 Exp.2, p.20)
其他关键佐证:
- Exp. 1 / Fig. 6:time-recall 曲线上 SimJoin 曲线整体位于左下方(更少时间、更高召回),且"初始点显著靠右"------低参数下就能拿到绝大部分结果,参数依赖更弱。
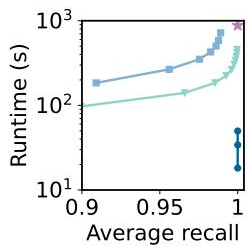
图 6(e)(原文 Fig. 6 面板):GloVe self-join 上四种方法的 Runtime--Recall 曲线,SimJoin 曲线整体更左下(ε=0.4)。
-
Exp. 3 / Fig. 7 :定义 nSelectivity = |X|·|X ⋈ Y|/|X×Y|(平均每查询结果数),"the runtime of our algorithms increases linearly with the value of nSelectivity, demonstrating good scalability as the number of join results increases"(p.20)。注意 XJoin 被排除在 Fig. 7 之外------"it cannot achieve 0.99 recall in either the Crawl or Higgs datasets"。
-
Exp. 7 / Fig. 11:不同邻近图作滑动基座时,"HNSW does not perform well due to higher edge distances... because it is built via incremental insertion, which means candidate neighbors are only selected among previously inserted nodes. Vamana and NSG exhibit similar performance"(p.22)------与 Theorem 5.1 的短边理论一致。
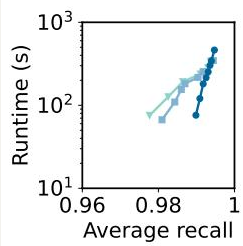
图 11(b)(原文 Fig. 11 面板):GIST self-join 下 HNSW/NSG/Vamana 作为 G 的效果,HNSW 因长边较多明显更差。
-
Exp. 8 / Fig. 12 :朴素 Kruskal 顺序选择太贵------GloVe 上 4.4 s、占 join 总时间 20% 以上 ;两阶段方案(离线 MST + 在线插边)比基线快一个数量级,Sort/ε-range 两个变体分别快 2 个和 3 个数量级,且顺序代价差异 "less than 0.01% across all datasets"(p.22)------证明离线化没有牺牲顺序质量。
-
Exp. 9 / Fig. 13:k=10 的 k-join 对 VBASE(借其 k-NN 搜索拼出 join)"significantly lower"耗时且召回持平或更好。
-
Exp. 10 / Table 4 :索引维护(删 10% 再插回等量点)。Higgs 行:全局重建 22.394 GB / 2961.66 s(多线程) vs FreshDiskANN 4.7927 GB / 769.70 s vs 本文 k-join 方案 4.7922 GB / 744.14 s(单线程) ;Crawl:7.3334 GB/1963.67 s vs 2.4671 GB/674.07 s vs 2.4202 GB/585.06 s。且 Fig. 14 显示维护后的 NSG 做 ANNS 的 QPS 甚至优于全局重建("attributed to the higher quality of the k-nearest neighbors of each data point in our algorithms compared to NN-descent",p.23)。
四、未来方向与潜在价值
论文自述的下一步是分布式:
"Our future work will focus on developing a distributed algorithm based on our current approach to offer a more scalable approximate similarity join method." (§10, p.25)
(以下为结合当前进展的分析判断,非论文结论。)该方向值得继续探索的问题:
-
滑动失败的鲁棒性 :JoinSlide 在窗口不相交、贪心下滑中途队列耗尽时直接返回空窗口("if Q is empty then return J_j = ∅",Algorithm 3)而无回退重试;对分布外(OOD)查询批次,需要安全的 fallback / 多入口策略(本仓库收录的后续工作 Fast Approximate Vector Joins via Offline-Online Co-Design(arXiv:2603.16360)即把"硬复用"扩展为"软复用",可视为对该断点的直接回应------依据本地 catalog 目录说明)。
-
学习式代价模型:把 MST 边权从"查询间距离"换成可学习的真实滑动成本(含 w、图结构影响),以及学习式跳过低产出/高成本查询(与 XJoin/Xling 路线融合)。
-
并行与异构:MST 顺序树天然可层间并行;叠加上 GPU(如精确 GPU self-join 工作的思想)与 SSD 外存(本目录 DiskJoin, arXiv:2508.18494 的路线)可覆盖超大规模。
-
评价体系 :目前只有 per-query 平均 recall;应补全局 pair recall、尾部查询分布、方差/显著性,以及过滤谓词(多属性过滤)下的 join 语义。
-
产业机会:批式嵌入刷新(embedding 全量重算后与旧库 join 增量更新索引)、训练数据去重、RLHF 数据治理、"检索增强"图构建中的批量链接预测,都可能直接受益于一个可复用窗口的批处理原语。
五、批判性审视
方法严谨性:
-
"最优"是条件最优:Lemma 6.1/Theorem 6.2 仅在"G 为连通 εNG、以查询距离为成本代理"下成立(§6.1--6.2, pp.12--15);实际执行用的是近似 εNG,且滑动成本代理 δ(x_i,x_j) 只是真实 NDC 的线性近似(Fig. 5 支持了这一点,但该线性性只在 Msong 数据集上展示)。
-
"continuous sliding ... do not miss any points"这一保证建立在精确 DT 邻接(Corollary 4.1)之上;实际用 proximity graph 替代后,窗口在图上可能不连通或漏点,论文对此没有量化失效概率(Theorem 5.1 仅给出均匀分布下的概率论证,现实数据不满足均匀假设)。
-
JoinSlide 的两个隐蔽风险点(Algorithm 3, p.10):① 下滑失败即返回空窗口,无回退到入口点 y0 的二次尝试;② 波束 w 的裁剪可能把通向目标窗口的前沿节点剪掉。论文未报告这两类失效的实际发生率。
-
双图空间代价未建模:SimJoin 在 X 上建 εNG/MST、在 Y 上建邻近图,全文没有给出统一的额外内存公式;对 10M 级数据集这是实用化的关键成本。
实验完备性:
-
Table 3 中 Higgs self-join 的 SimJoin 召回 0.99014 低于 VBASE 的 0.99031,与"superior quality"的笼统表述并不完全一致;SIFT/Higgs 上加速只有 1.5×/2.2×,说明高密度、低维、局部性弱的批负载上复用收益有限。
-
单线程评测、5 次运行只报均值不报方差;无显著性检验;无 join 过程的内存报告(只有维护实验报内存);无"一次冷启动总成本"(图构建 + εNG/MST 构建 + join)对照------离线 MST 虽被论证可摊销,但其耗时未进入 Table 3。
-
指标只报 per-query 平均 recall;小窗口查询的召回波动被平均掩盖,且没有离群查询的分布分析。precision = 1 是"全部候选精确验证"的构造性结果,作为优势被隐式消费而非实验检验。
-
Exp. 10 中全局重建用 32 线程、本文方法与 FreshDiskANN 用单线程------设置为"对自己不利"的保守方向,结论可信,但并非同资源强度对比;维护效果未在长期连续插入/删除流中验证。
-
合成数据集仅 64 维、10 万点;缺少现代语义 embedding(MIPS/内积、大模型向量)、带过滤谓词的 join 和更新流场景;XJoin 在 Exp. 3 被整体排除(达不到 0.99 recall),Table 3 里其召回也明显偏低(0.957--0.987),与"学习跳过"路线的公平对比不足。
结论普适性争议:
-
"up to one order of magnitude" / "over 2 orders of magnitude" 是跨数据集上界描述,实际加速比跨数据集差异极大(1.5×--17.8× 对 VBASE),结论需按工作负载条件化。
-
"average loss of less than 1%" 与 Table 3 中 Msong/Higgs 单库 recall ≈ 0.990--0.994 之间约有 0.6%--1.0% 的灰区,该主张需要逐数据集陈述而非全局打包。
-
窗口复用的收益前提(查询批次局部聚簇、稀疏输出、图连通)未作为先决条件显式检验------这恰是后续 2603.16360 等工作把 OOD 断连作为研究动机的原因(分析判断,依据本地 catalog 说明)。
六、可迁移启发
最值得精读的部分(按价值排序):
-
§4.1 + Fig. 2:如何从"独立 range query"抽象出窗口/邻接/连通性,再论证"不漏点"的边界条件------问题建模范式可迁移到任何批式检索。
-
§5 + Fig. 5:用 NDC 实证"复用成本 ≈ 查询间距离"的线性性------代价代理 + 微型实证的组合是低成本建立成本模型的好模板。
-
§6 + Algorithms 4/5 + Exp. 8:离线(MST/排序归并)/在线(插边 + DFS)两阶段拆分,把"看似必须在线完成"的图算法摊销掉 2--3 个数量级;pre-ratio 的工程测量方式(重复 100 次取均值)。
-
§7.2 + Table 4:一个算法(k-join)反向复用于索引维护------"算法复用"优于"新造维护组件"。
-
Exp. 7 / Fig. 11:图索引的构造方式(增量插入 vs 全局多样性精剪)直接决定其上滑动的质量------索引副作用评估。
方法层面启发:
-
批处理即资源:把"查询间相关性"升级为一等公民的执行资源,而不是每查询独立优化的累加。
-
双级复用:数值级复用(结果窗口)与结构级复用(顺序树)分开设计、可独立开关。
-
one-graph-for-all:让一个索引同时服务检索、批处理和维护,降低系统工程复杂度。
-
验证式精度:所有候选走精确距离验证,把"精度=1"免费拿到手,把风险集中在召回端------近似系统的常见正确姿势。
-
面向并行执行计划:MST 顺序树直接给出层式并行纹理(BFS 式滑动并行),未来 GPU/分布式实现的天然骨架。
对你研究课题(多属性过滤的高维向量检索)的可能迁移点(分析判断):过滤谓词会切断窗口连通性(类别属性把数据集切成碎片),恰好落在本文"近似图断连导致漏招"的失效域;可借鉴"窗口连通性 + 结构再造"的思路,为同过滤组内的批式查询建代价图求 MST 顺序;WindowOrder 的离线/在线拆分也可对应"过滤选择率的预计算与在线拼装"。
建议的前置文献与背景知识:
-
图索引 ANN(算法基座):NSG(原文 14)、HNSW(34)、Vamana/DiskANN(47)、FreshDiskANN(40)------理解近似邻接图与度约束。
-
相似连接谱系 :精确方法 Epsilon Grid Order(7)与 FGF-Hilbert(36);k-NN join(8,48);本仓库理论篇 On the Complexity of Inner Product Similarity Join (arXiv:1510.02824)、Similarity Join Size Estimation using LSH(arXiv:1104.3212)、流式 size estimation(arXiv:1806.03313)、GPU self-join(arXiv:1809.09930)。
-
选择式近似 join:VBase(51)、XJoin(46)/与本地 catalog 中 Xling(arXiv:2402.13397)同属学习型过滤路线。
-
几何与算法基础:Voronoi 图 / Delaunay 三角剖分(12,13,26)、MST 与 Kruskal/Borůvka、复杂度下界与维度灾难(21)。
-
直接后续 :Fast Approximate Vector Joins via Offline-Online Co-Design (arXiv:2603.16360)、DiskJoin(arXiv:2508.18494),均在本仓库收录,可沿"硬复用 → 软复用""内存 → 外存"两条轴线继续延伸理解。
(本报告 2026-10-10 成稿;引文页号以 PDF 页码为准;图件为论文原图裁剪,完整版见图表清单。)