1.http 2个预备知识
平时我们俗称的 "网址" 其实就是说的 URL
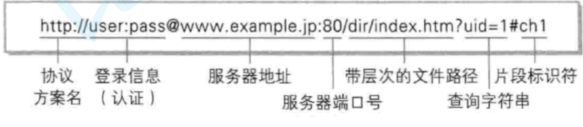
网络通信本质就是进程间通信,服务器和客户端通信本质就是进程间通信。我们的上网行为也就是获取资源和上传资源,对用进程间通信之间的IO。
- 登录信息 URL 标准仍然允许这种写法,但在现代 Web 里基本不再使用,尤其不推荐把密码放进 URL。 现在更多是历史遗留、命令行工具或某些内部系统还在用。
- 服务器地址是通过DNS域名解析为 ip 地址进行访问的,浏览器会自动帮我们完成,我们现在使用的云服务器没有绑定域名所以不能使用域名。
- 服务器端口号一般会省略,使用 http 服务器使用的端口号是 80。
- Linux 服务器上的路径,第一个 / 准确来讲叫 web 根目录
- ?后表示要传入参数,uid 叫参数的名字,1 是参数的内容,多组参数使用&连起来。片段标识符在客户端定位资源内部的某个位置,现在少见了。
https 是加密的 http, 使用的端口号是443。面对客户的不能随便改,就像 110 与警察的关系。所以重要的常用的协议,端口号必须是众说周知的,不可随意修改的。
urlencode和urldecode:
百度搜索你好,可以发现参数里面有这个关键字。

搜索特殊字符
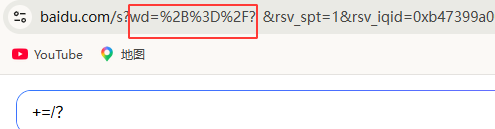
像 / ? 等这样的字符, 已经被url当做特殊意义理解了。因此这些字符不能随意出现。比如,某个参数中需要带有这些特殊字符,就必须先对特殊字符进行转义。转义的规则如下 :将需要转码的字符转为16进制(一个字节char类型),URL 里只允许安全 ASCII 字符;其他字符先按 UTF-8 变成字节,再把每个字节写成 %HH,HH 是两位十六进制数。
2.用http 写一个样例
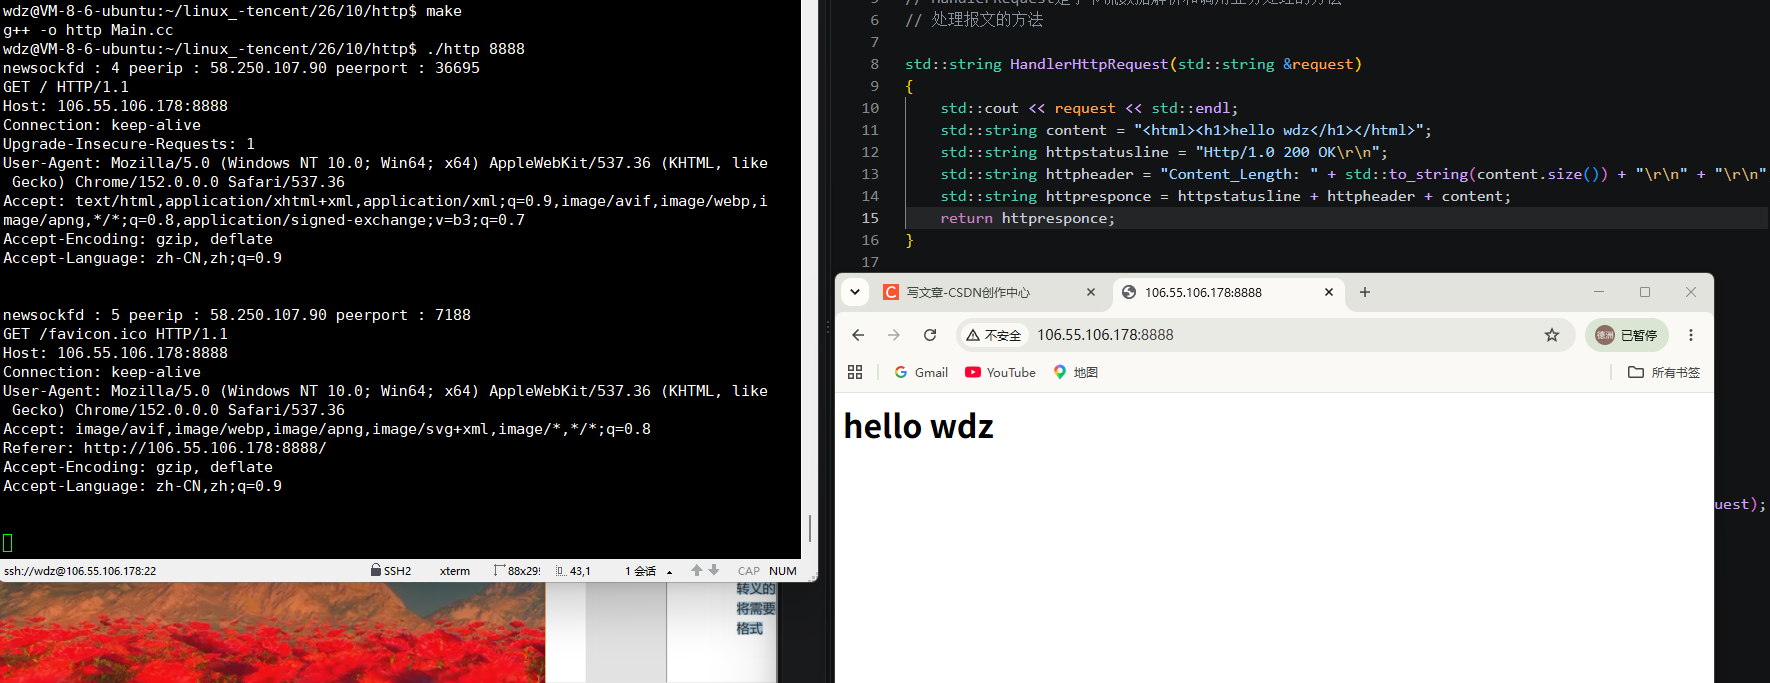
浏览器本身就是客户端,可以直接访问我们的云服务器http,浏览器发送的请求被我们Linux服务器客户端接收。
cpp
#pragma once
#include <iostream>
#include "Socket.hpp"
#include <functional>
#include <string>
#include <unistd.h>

// http底层采用的tcp协议
using func_t = std::function<std::string(std::string& request)>;

class HttpServer;

class ThreadData
{
public:
    ThreadData(HttpServer *http_this, Net_Work::Socket *sockp)
        : _this(http_this), _sockp(sockp) {}

    HttpServer *_this;
    Net_Work::Socket *_sockp;
};

class HttpServer
{
public:
    HttpServer(int port, func_t hander_request)
        : _port(port), _listensocket(new Net_Work::TcpSocket()), _handler_request(hander_request)
    {
        _listensocket->BuildListenSocketMethod(_port, Net_Work::backlog);
    }

    static void *ThreadRun(void *args)
    {
        pthread_detach(pthread_self()); // 线程分离
        ThreadData *td = static_cast<ThreadData *>(args);

        // 1.读取数据,不关心数据是什么,只读取
        std::string http_request;

        if (td->_sockp->Recv(&http_request, 4096))//不一定会读完
        { // 2.报文处理。数据不仅仅是回调回去,还会回来。由上层HandlerRequest关心
            std::string http_response = td->_this->_handler_request(http_request);

            if(!http_response.empty())
                td->_sockp->Send(http_response);
        }

        td->_sockp->CloseSockFd();
        delete td->_sockp; // Loop也可以使用智能指针指向_sockp,这里不用显示释放
        delete td;
        return nullptr;
    }

    void Loop()
    {
        while (true)
        {
            std::string peerip;
            uint16_t peerport;
            Net_Work::Socket *newsockfd = _listensocket->AcceptConnection(&peerip, &peerport);
            if (!newsockfd)
            {
                break;
            }
            std::cout << "newsockfd : " << newsockfd->GetSockFd() << " peerip : " << peerip << " peerport : " << peerport << std::endl;

            // 创建线程处理链接
            pthread_t tid;
            ThreadData *td = new ThreadData(this, newsockfd);
            pthread_create(&tid, nullptr, ThreadRun, td);
        }
    }
    ~HttpServer()
    {
        delete _listensocket;
    }

private:
    int _port;
    Net_Work::Socket *_listensocket;

public:
    func_t _handler_request;
};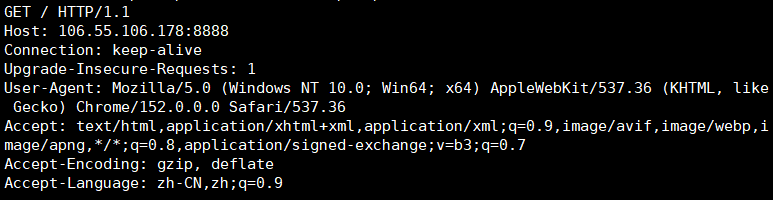
无论 http 请求打印了多少行,在 TCP 当中都叫字节流,都是只有一行字符串,是通过 \r\n 区分开的,也是序列化与反序列化。
http 为什么不采用json 方案,而自己做出一套方案,因为 http 是一个基础的协议,该协议不想依赖任何一款第三方库,自己做了字符串处理,但与我们序列化反序列化思想相同,只是复杂了些。
3.http报文交换格式
http 请求报文格式:
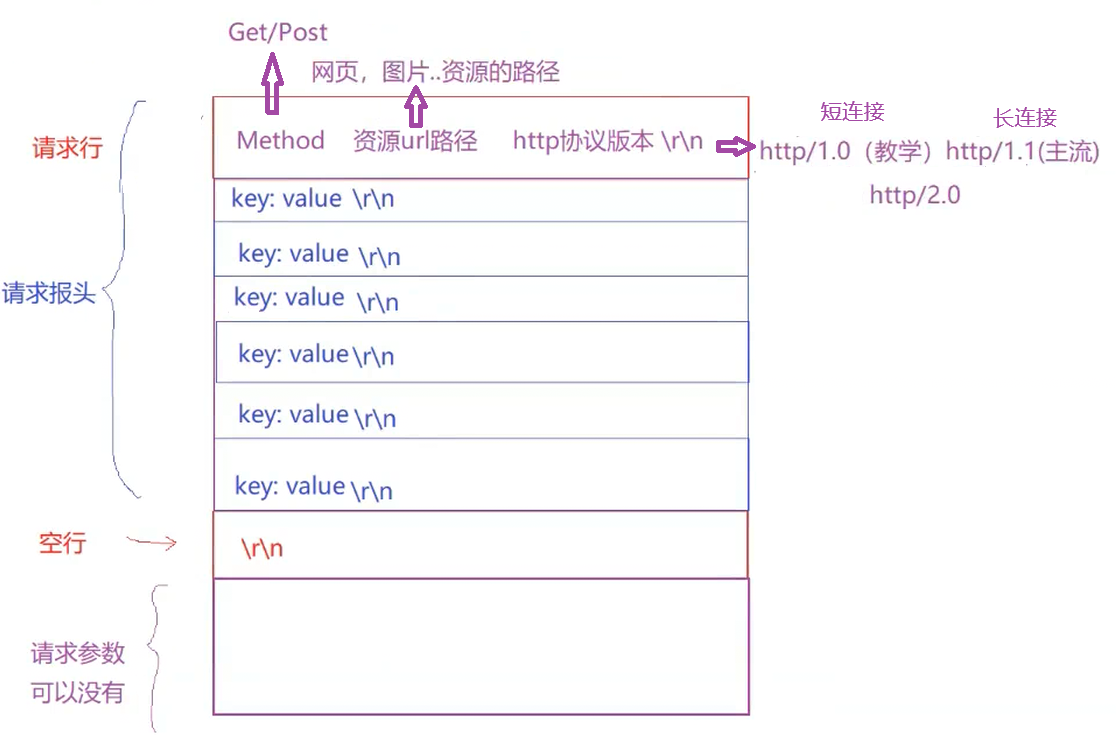
总体可分为三部分
- 首行:方法 + url + 版本。最常见的方法就是GET 和 POST。
- Header:请求的属性,冒号分割的键值对;每组属性之间使用\n分隔;遇到空行表示Header部分结束。
- Body:空行后面的内容都是Body,Body允许为空字符串,如果Body存在,则在Header中会有一个Content-Length属性来标识Body的长度。
HTTP 方法:
GET(获取资源):最常用的方法。用于请求服务器发送某个资源(比如打开网页、看图片)。它只获取数据,不应改变服务器状态(幂等且安全)。
POST(传输实体主体):通常用于向服务器提交数据(比如表单提交、上传文件、发表评论)。它会改变服务器状态(非幂等)。
PUT(传输文件):用于向服务器上传/替换资源。如果资源不存在就创建,存在就覆盖(幂等)。
HEAD(获得报文首部) :和GET几乎一样,但服务器只返回响应头,不返回响应体。常用于检查资源是否存在、检查文件大小或最后修改时间。
DELETE(删除文件):请求服务器删除指定的资源(幂等)。
OPTIONS(询问支持的方法) :询问服务器对特定资源支持哪些HTTP方法。跨域请求(CORS)中的预检请求(Preflight)用的就是这个。
TRACE(追踪路径) :回显服务器收到的请求,主要用于测试或诊断。由于容易引发XSS安全漏洞,现代服务器通常默认禁用。
CONNECT(要求用隧道协议连接代理):要求在与代理服务器通信时建立隧道,常用于HTTPS加密连接的代理(比如翻墙软件、抓包工具的原理)。
LINK(建立和资源之间的联系) ,UNLINK(断开连接关系) 这两个方法在早期的HTTP/1.0草案中被提出,目的是在HTML文档中建立或断开与其他资源的链接。但后来HTML标准采用了
<link>标签,这两个方法就从未被广泛实现,并在后续的HTTP/1.1标准中被正式废弃(Removed)
对于http请求,如何做到读到完整报文,如何http进行反序列化:
http 协议中请求参数 称为有效载荷,且不能保证把 http 读完,但能保证把请求行和请求报文读完,分两步,1.一直读,直到读到空行,2.如果有请求正文,请求报头中会存在一种属性 Content-Length:长度---表明正文部分长度 。报头和有效载荷就是通过空行分离的。报头根据 \r\n 进行反序列化即可,分成字符串。
3.1 有效载荷如何交付
http 相应报文格式:
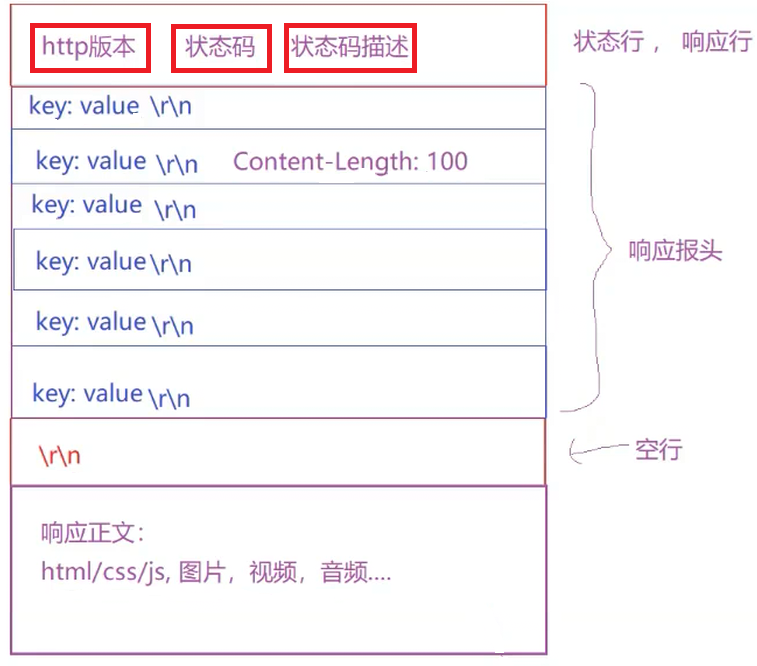
http 的版本,请求时是浏览器的版本,相应时服务器支持的版本,在交换版本信息。
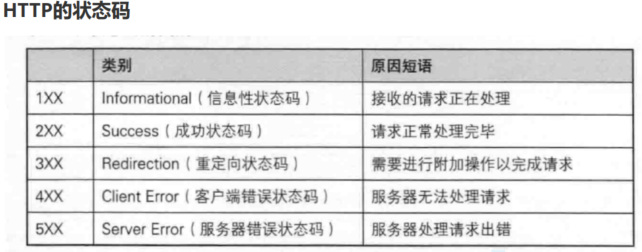
最常见的状态码, 比如 200(OK), 404(Not Found), 403(Forbidden), 302(Redirect, 重定向), 504(Bad Gateway)。命令行输入 telnet www.baidu.com 80,可以我数请求只简单粗暴地输入GET / HTTP/1.1,然后得到 http 相应,空行后是内容。
我们可以使用 telnet 127.0.0.1 端口,访问自己服务器,查看返回的服务器 response 相应的信息。
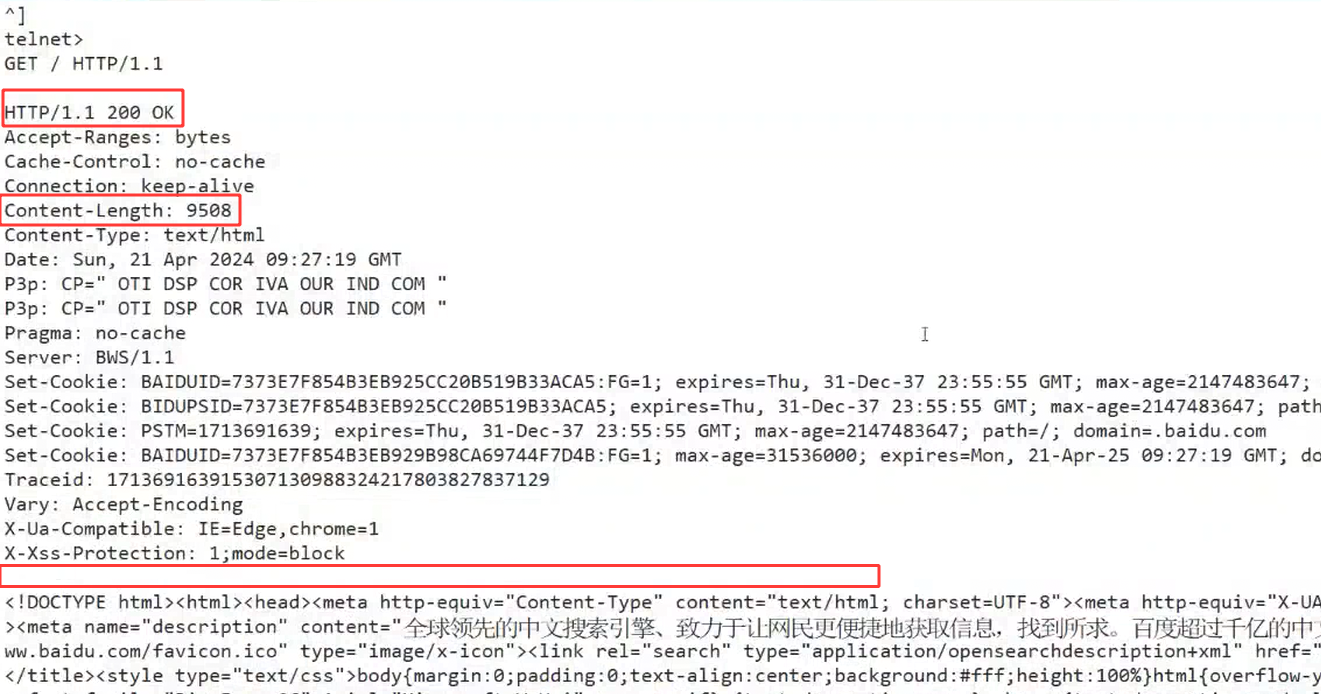
4.http的报头中的关键字段
4.1 请求报文中资源路径 url(web根目录)
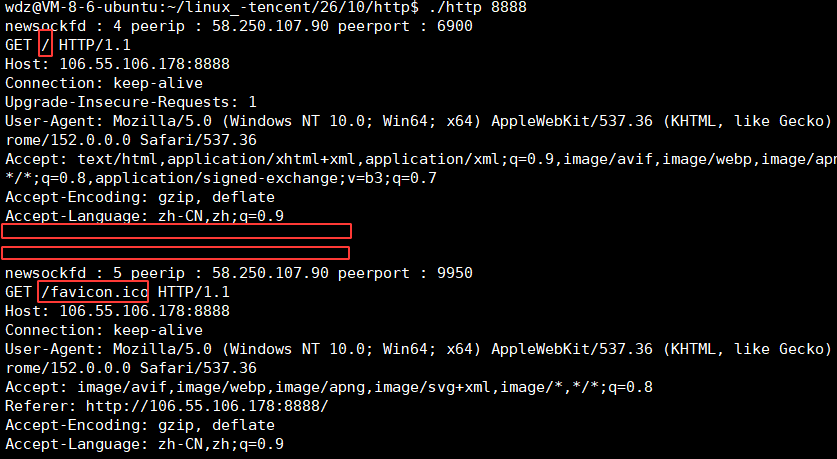
我们使用浏览器输入我们的云服务器网址和端口号,然后访问。也默认访问web根目录,规定 / 表示我们默认访问该网站的首页 ,即 index.html或index或html 网页文件。如果用浏览器访问,还会得到 favicon.ico 的 ico 图标文件,即百度的熊掌,腾讯的企鹅图标。下图为直接访问我云服务器且正文为空的效果。
自己对浏览器客户端发来的请求进行反序列化:
cpp
    bool GetLine(std::string &str, std::string *line)
    {
        auto pos = str.find(HttpSep);//"\r\n"
        if (pos == std::string::npos)
        {
            return false;
        }
        else
        {
            *line = str.substr(0, pos); // 如果line是\r\n,substr(0,0)是空串
            str.erase(0, pos + HttpSep.size());
            return true;
        }
    }
    bool Deserilize(std::string &request)
    {
        std::string line;
        bool ok = GetLine(request, &line);
        if (!ok)
            return false;
        _req_line = line; // 第一行

        while (true)
        {
            ok = GetLine(request, &line);
            if (ok && line.empty()) // 读到空串,包头处理完了。
            {
                _req_content = request; // 前面被删完了 "\r\n"方便看
                break;
            }
            else if (ok && !line.empty())
            {
                _req_header.push_back(line);
            }
            else
            {
                return false;
            }
        }
        return true;
    }
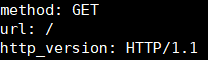
输入网址时在根目录后带上即可,然后 ?后跟自己想要传入的参数。什么是 web 根目录,如果请求 url = / ,我们请求的是默认首页
cpp
    void ParseReqLine()
    {
        std::stringstream ss(_req_line);
        ss >> _method >> _url >> _http_version;
    }
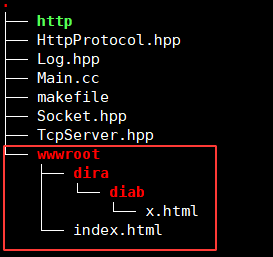
在 http 服务中需要 mkdir 一个 wwwroot(可改名字)目录,里面需要存在一个 index.html (可改名字)主页文件,这个目录称为 http 的根目录,这些资源都在这里
cpp
    void ParseReqLine()
    {
        std::stringstream ss(_req_line);
        ss >> _method >> _url >> _http_version;

        if (_url == "/") // 这只分析两种
        {
            _path += _url;
            _path += homepage;
        }
        else // 后面带文件   /x.html
        {
            _path += _url;
        }
    }
所以web 根目录就是服务器指定的已经目录,未来所有的 http 资源 在该路径下 --- linux 的一个指定的目录。如果请求 url = /,我们请求的就是 http 服务器给自动拼接的首页。html 是一个可以被浏览器直接访问的文件,可以提取其中的正文,进行解释,浏览器会把它渲染成我们看到的样子。
w3cschool网址中有各种语法教程。我们看到网页里的要素需要显示的每个都需要单独请求,如果网页里有一张图片,就需要三次请求,一次访问主页,一次访问图片,一次访问 ico 文件。
html
<!DOCTYPE html>
<html lang="en">

<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>我的网站</title>
</head>

<body>
    <p>This is my first paragraph.</p>
    <!-- <a href="https:www.qq.com/">点我</a> -->
    <a href="http://106.55.106.178:8888/dira/dirb/x.html">点我跳转</a>
    <h1>登录页面</h1>
    <img src="/image/1.jpg" alt="八重神子">


</body>

</html>请求报文报头属性 中还包括一项 Content-Type:表示正文的类型。
- 我要请求的所有资源都有后缀,Linux 不以后缀区分,但用户需要通过后缀决定了文件的类型。
- http respone 给浏览器相应的时候,正文部分是什么类型,可以通过文件资源的后缀来判定。
- 我们可以建立文件后缀 和 Content-Type 的映射表然后进行反序列化。所以 http 超文本传输协议,可以支持任意内容的发送,根据请求资源的后缀,判定 Content-Type 是什么,
4.2 Get vs Post
上网行为:
- 获取资源。
- 向服务器进行传参,我们要把我们的数据上传到服务器,登录注册,搜索等等。GET/POST 结合 html 使用,即 html 表单
html
<form action="/action_page.php">
  <label for="fname">First name:</label><br>
  <input type="text" id="fname" name="fname" value="Bill"><br>
  <label for="lname">Last name:</label><br>
  <input type="text" id="lname" name="lname" value="Gates"><br><br>
  <input type="submit" value="提交">
</form>- GET 通常用来获取资源,也可以用来传递参数
- POST 上传数据
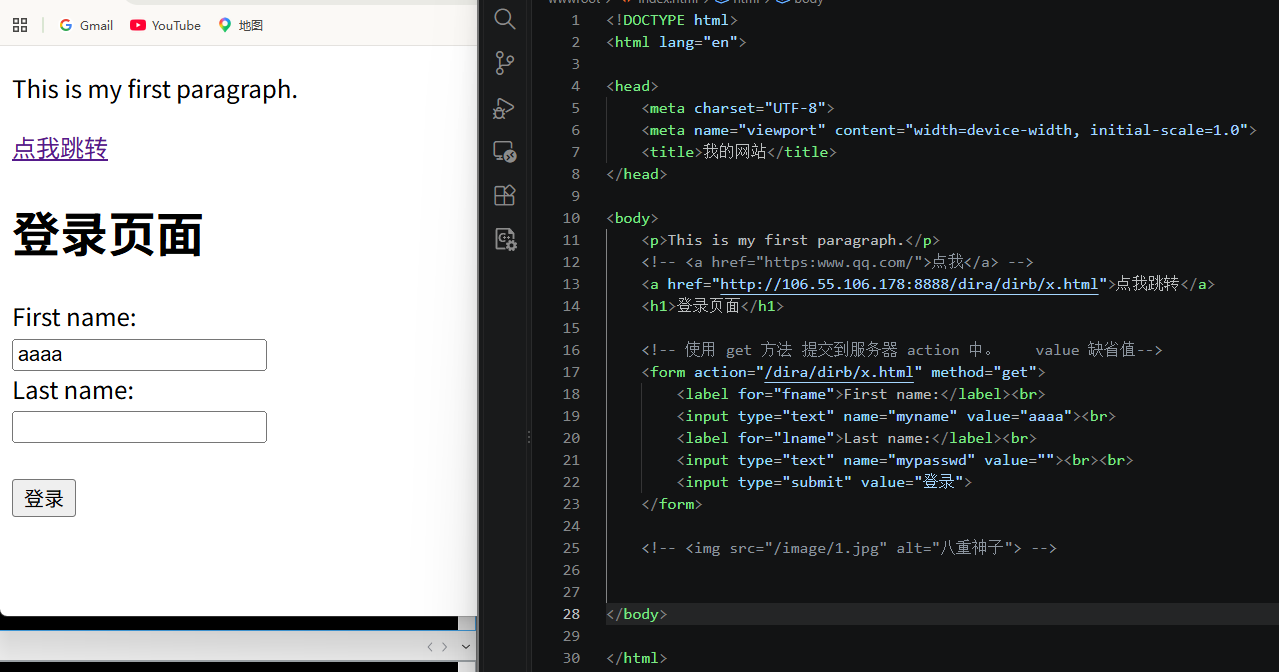
输入First name hello,Last name为123456登陆时,网址变为 http://106.55.106.178:8888/dira/dirb/x.html?**myname=hello\&mypasswd=123456**。
然后我们服务器就可以获取,所以GET方法可以通过 form 表单提交参数,是通过 url 方式提交的。
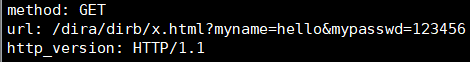
FORM 表单不写,默认是方法就是GET
使用POST方法:网址后没有跟参数,发现参数放在了正文部分
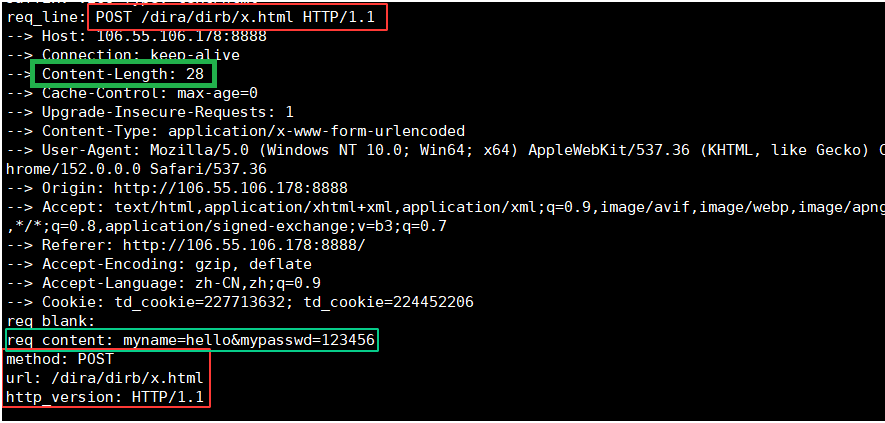
- GET 通过 url 传递参数, POST请求正文传参。
- url传参,字节个数有限制(跟浏览器版本服务器有关),POST方法,参数个数没有限制
- GET私密性差一点,会在url中回显,POST方法能好一些。但都不安全,明文传送,可以抓到。
4.3 状态码
1开头的状态码表示正在处理,当你不断访问时,就会返回这种信息性状态码,比如银行转账需要处理。 2开头最常用的有200,表示成功 OK。3开头表示重定向,后面讲。403表示访问不属于你客户权限访问内的东西,一般像公司内网;404请求的资源不存在。5开头例如你请求时服务器采用多进程线程创建失败。因为状态码标准只是建议,所以5比较少见,因为服务端可能会否认自己的错误。
307 临时重定向 ,要结合 Location 报头选项,指定一个新的地址, 访问时服务器返回新的地址,然后客户端发起二次请求。例如引导用户跳转到目标网页,例如烦人摇一摇跳转。linux下跳转就是fork然后exec程序替换。
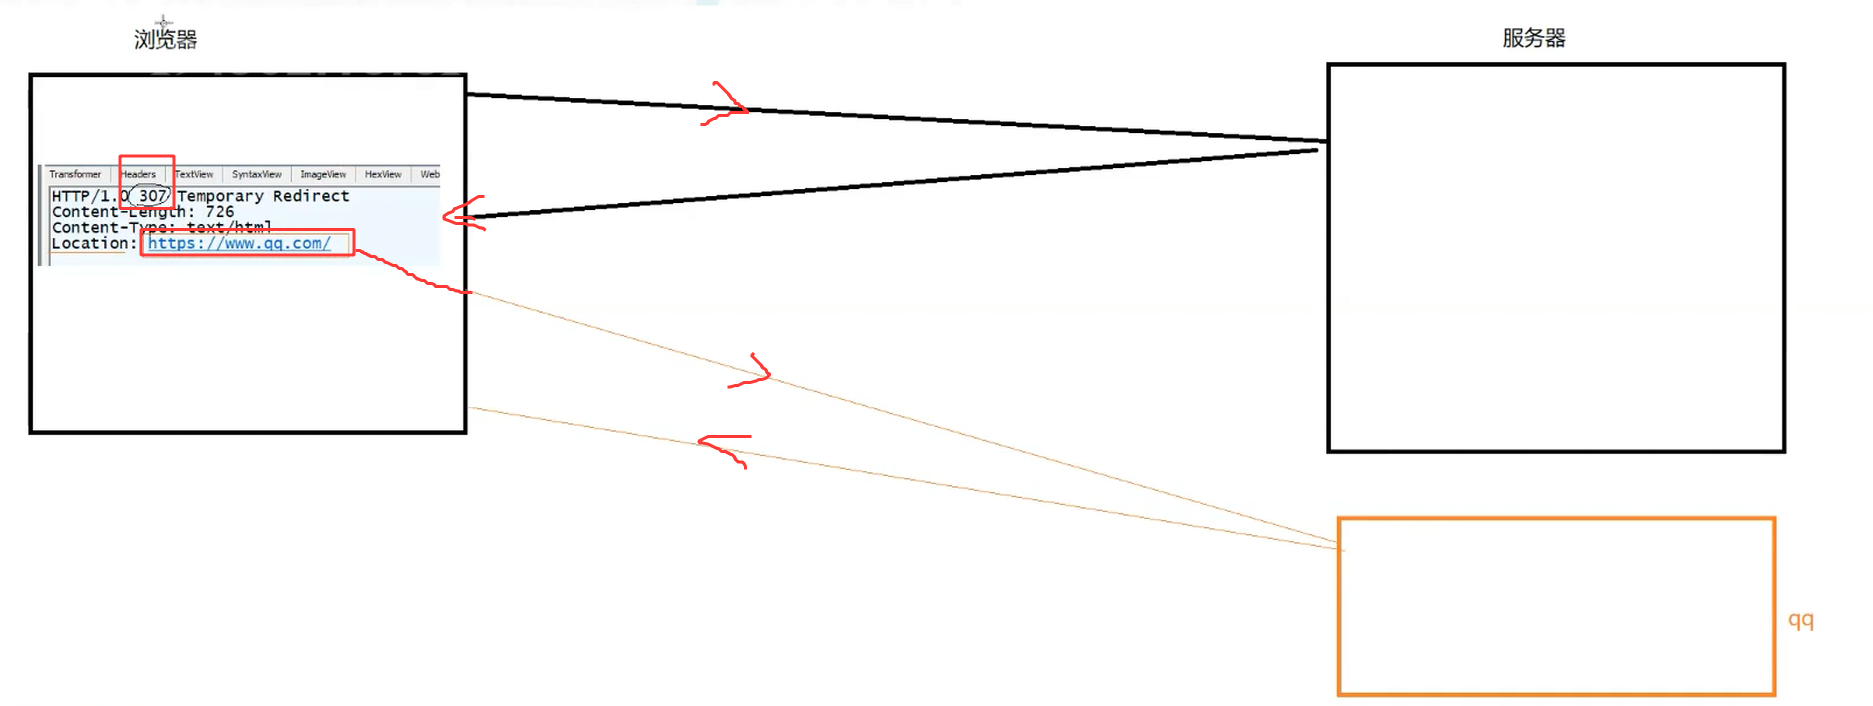
**301永久重定向:**我们使用搜索引擎,获取页面是使用的 url 关键字,关键字会与无数个网站对应,但如果这些网站过期了,想要更新域名,我们服务器就需要给浏览器返回 301 Location 来更新浏览器的书签链接对应关系。
4.4 cookie 和 session
HTTP/1.0 默认短连接,被称作无连接;HTTP/1.1 之后默认持久连接,但 HTTP 仍然是无状态协议。
**无状态:**第二次访问同一张网页,不记得之前访问过(不考虑浏览器缓存了一些信息)。为什么登录B站之后再打开还认识我。 其实每一次访问每一个资源都需要认证,例如是不是vip,根据身份,要区分权限。但它是无状态的,是如何一直认识我的?
版本1: 登录成功后,服务器会返回带有 cookie 的报头,然后客户端浏览器收到后会保存起来,然后再访问服务器时会把保存的 cookie 带上发送。
cookie 分两种,文件级和内存级,文件级就是直接写到浏览器安装 cookie中;内存级就是浏览器 malloc 一段空间保存,浏览器关闭就不认识了。cookie 也可以设置超时时间,多久有效。
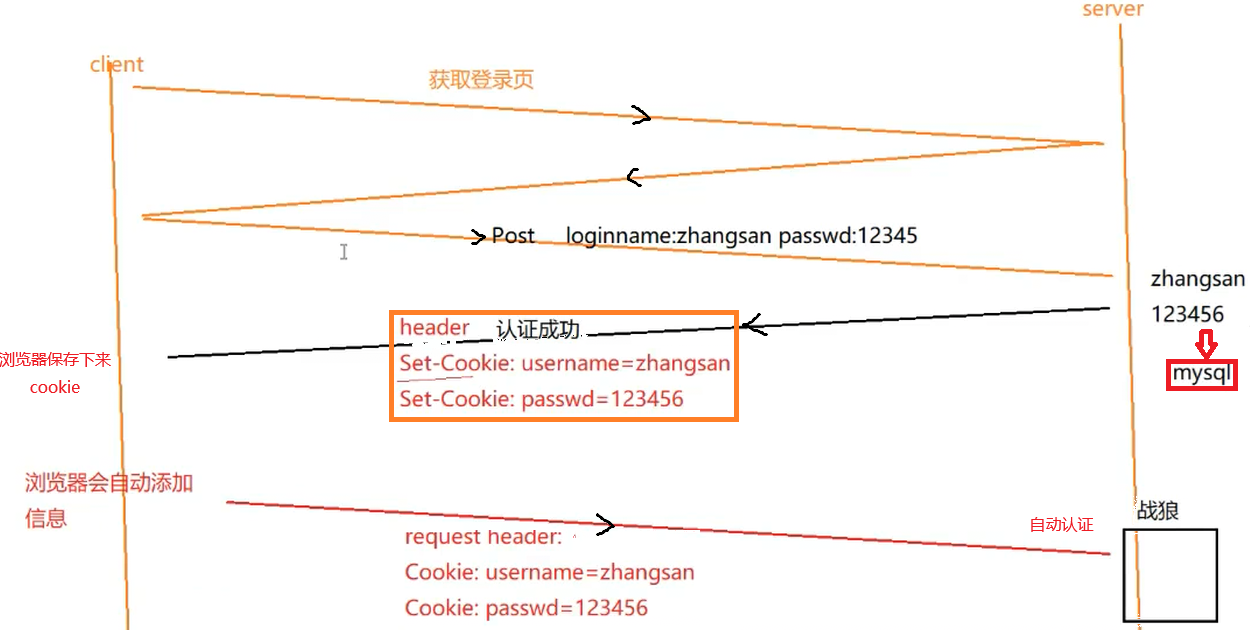
服务器设置 Cookie:
cpp
    std::string namecookie = "Set-Cookie: username=zhangsan\r\n";
    resp.AddHeader(namecookie);
    std::string passcookie = "Set-Cookie: password=123456\r\n";
    resp.AddHeader(passcookie);
    std::string stauscookie = "Set-Cookie: status=logined\r\n";
    resp.AddHeader(stauscookie);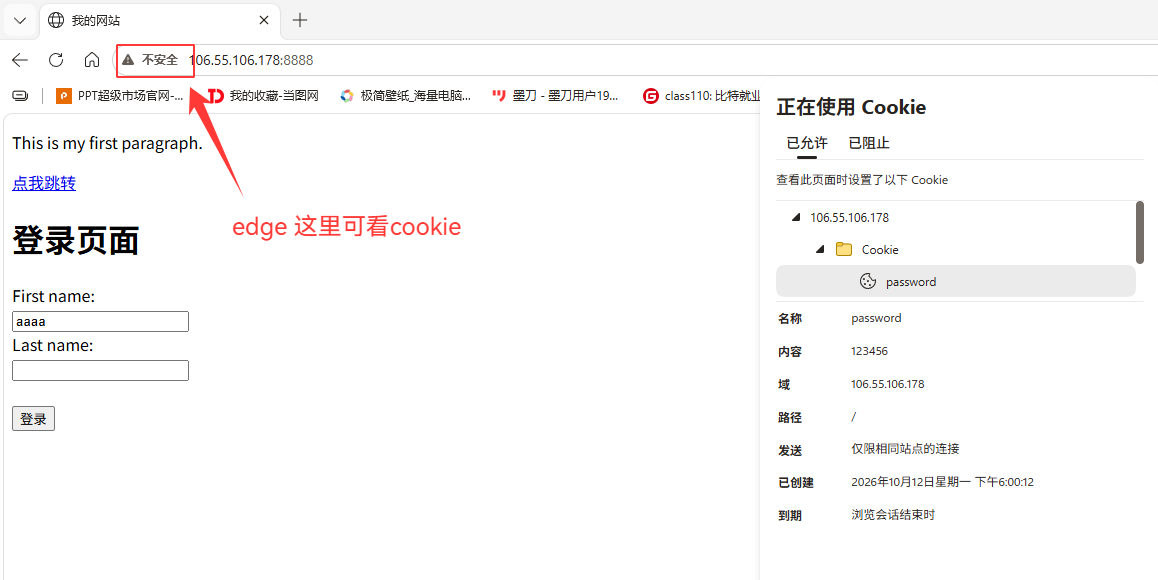
Cookie 以后就能发给该域名及其子域名。但是 Cookie 这样使用容易被盗。
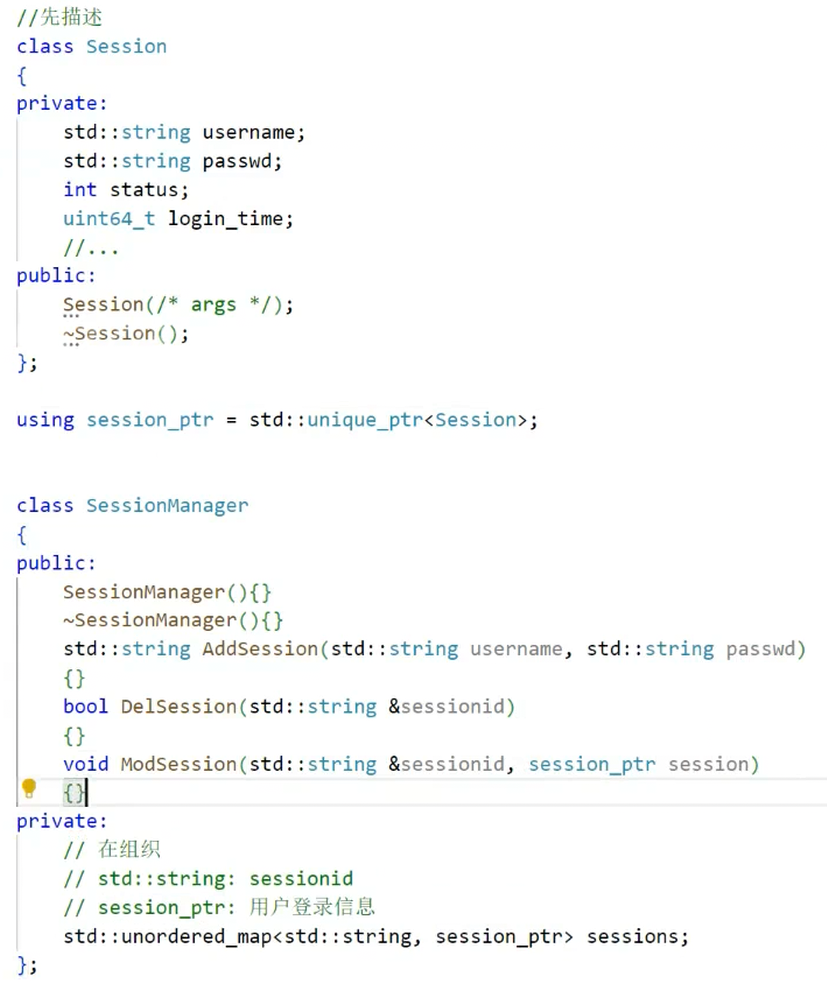
版本2:构建一个 session,保存用户名,密码和登录状态,服务器后端会形成一个具有唯一性的 sessionid ,然后返回用户 Set-Cookie:sessionid=XXXXXX ;服务器 Coolie 文件保存sessionid,再访问服务器时使用 sessionid。登录名和登录密码保存在服务端 session 文件。这样可以解决用户名和密码的私密性,但依旧可以盗走 sessionid ,但 session 文件维护在服务端(敏感操作校验来源、验证码、二次密码)可以随时让 session 失效过期,达到保护客户端的目的。
一个服务器上,存在大量用户,要通过 session(sessionid)的方式管理:也是先描述,再组织,例如:
4.5 http 中的其他报头
- **Content-Type:**数据类型(text/html等)
- **Content-Length:**Body的长度
- Host: 客户端告知服务器, 所请求的资源是在哪个主机的哪个端口上,一般目标服务器ip地址,很少用;
- User-Agent: 声明用户的操作系统和浏览器版本信息;
- referer: 当前页面是从哪个页面跳转过来的,通常用来禁止从该网站跳转过来;
- **location:**搭配3xx状态码使用, 告诉客户端接下来要去哪里访问;
- Cookie: 用于在客户端存储少量信息. 通常用于实现会话(session)的功能;
本篇结束!
岁受谢,燕辞归。去白日,骛太微。吁嗟!羌斯路之焭焭兮,不可追。欸!董道兮常违。蹇!䰟兮其往,荪奚儃徊?徒离忧兮倾寤,孰将为?䰟兮其往,䰟兮其往,无悲! 何方归?燕双宿。何方逢?银釭烛。梦觉:玉钗分处、玄鸟去云悠悠;留雨铃、凭谁诉?恨芳年倏忽、朱颜难驻;却念青山永固、总凝目。但为何故? 知我相负、未负。《原神》剧情PV-「燕归来」