从一行 ip route 到容器跨主机通信
我使用 docker、k8s 已经有一些时间了,业务也几乎都使用容器部署,但对容器网络一直知之甚少,网络本身也是个较为复杂的内容。
从云计算转 Java 开发近三年,近日发现现在的实践和之前的记忆已经有些偏差了,如 Endpoint-> EndpointSlice、ingress-nginx 停止维护等等等等,于是新搭建了个 k8s 环境顺便学习下容器网络的知识。
ip rule
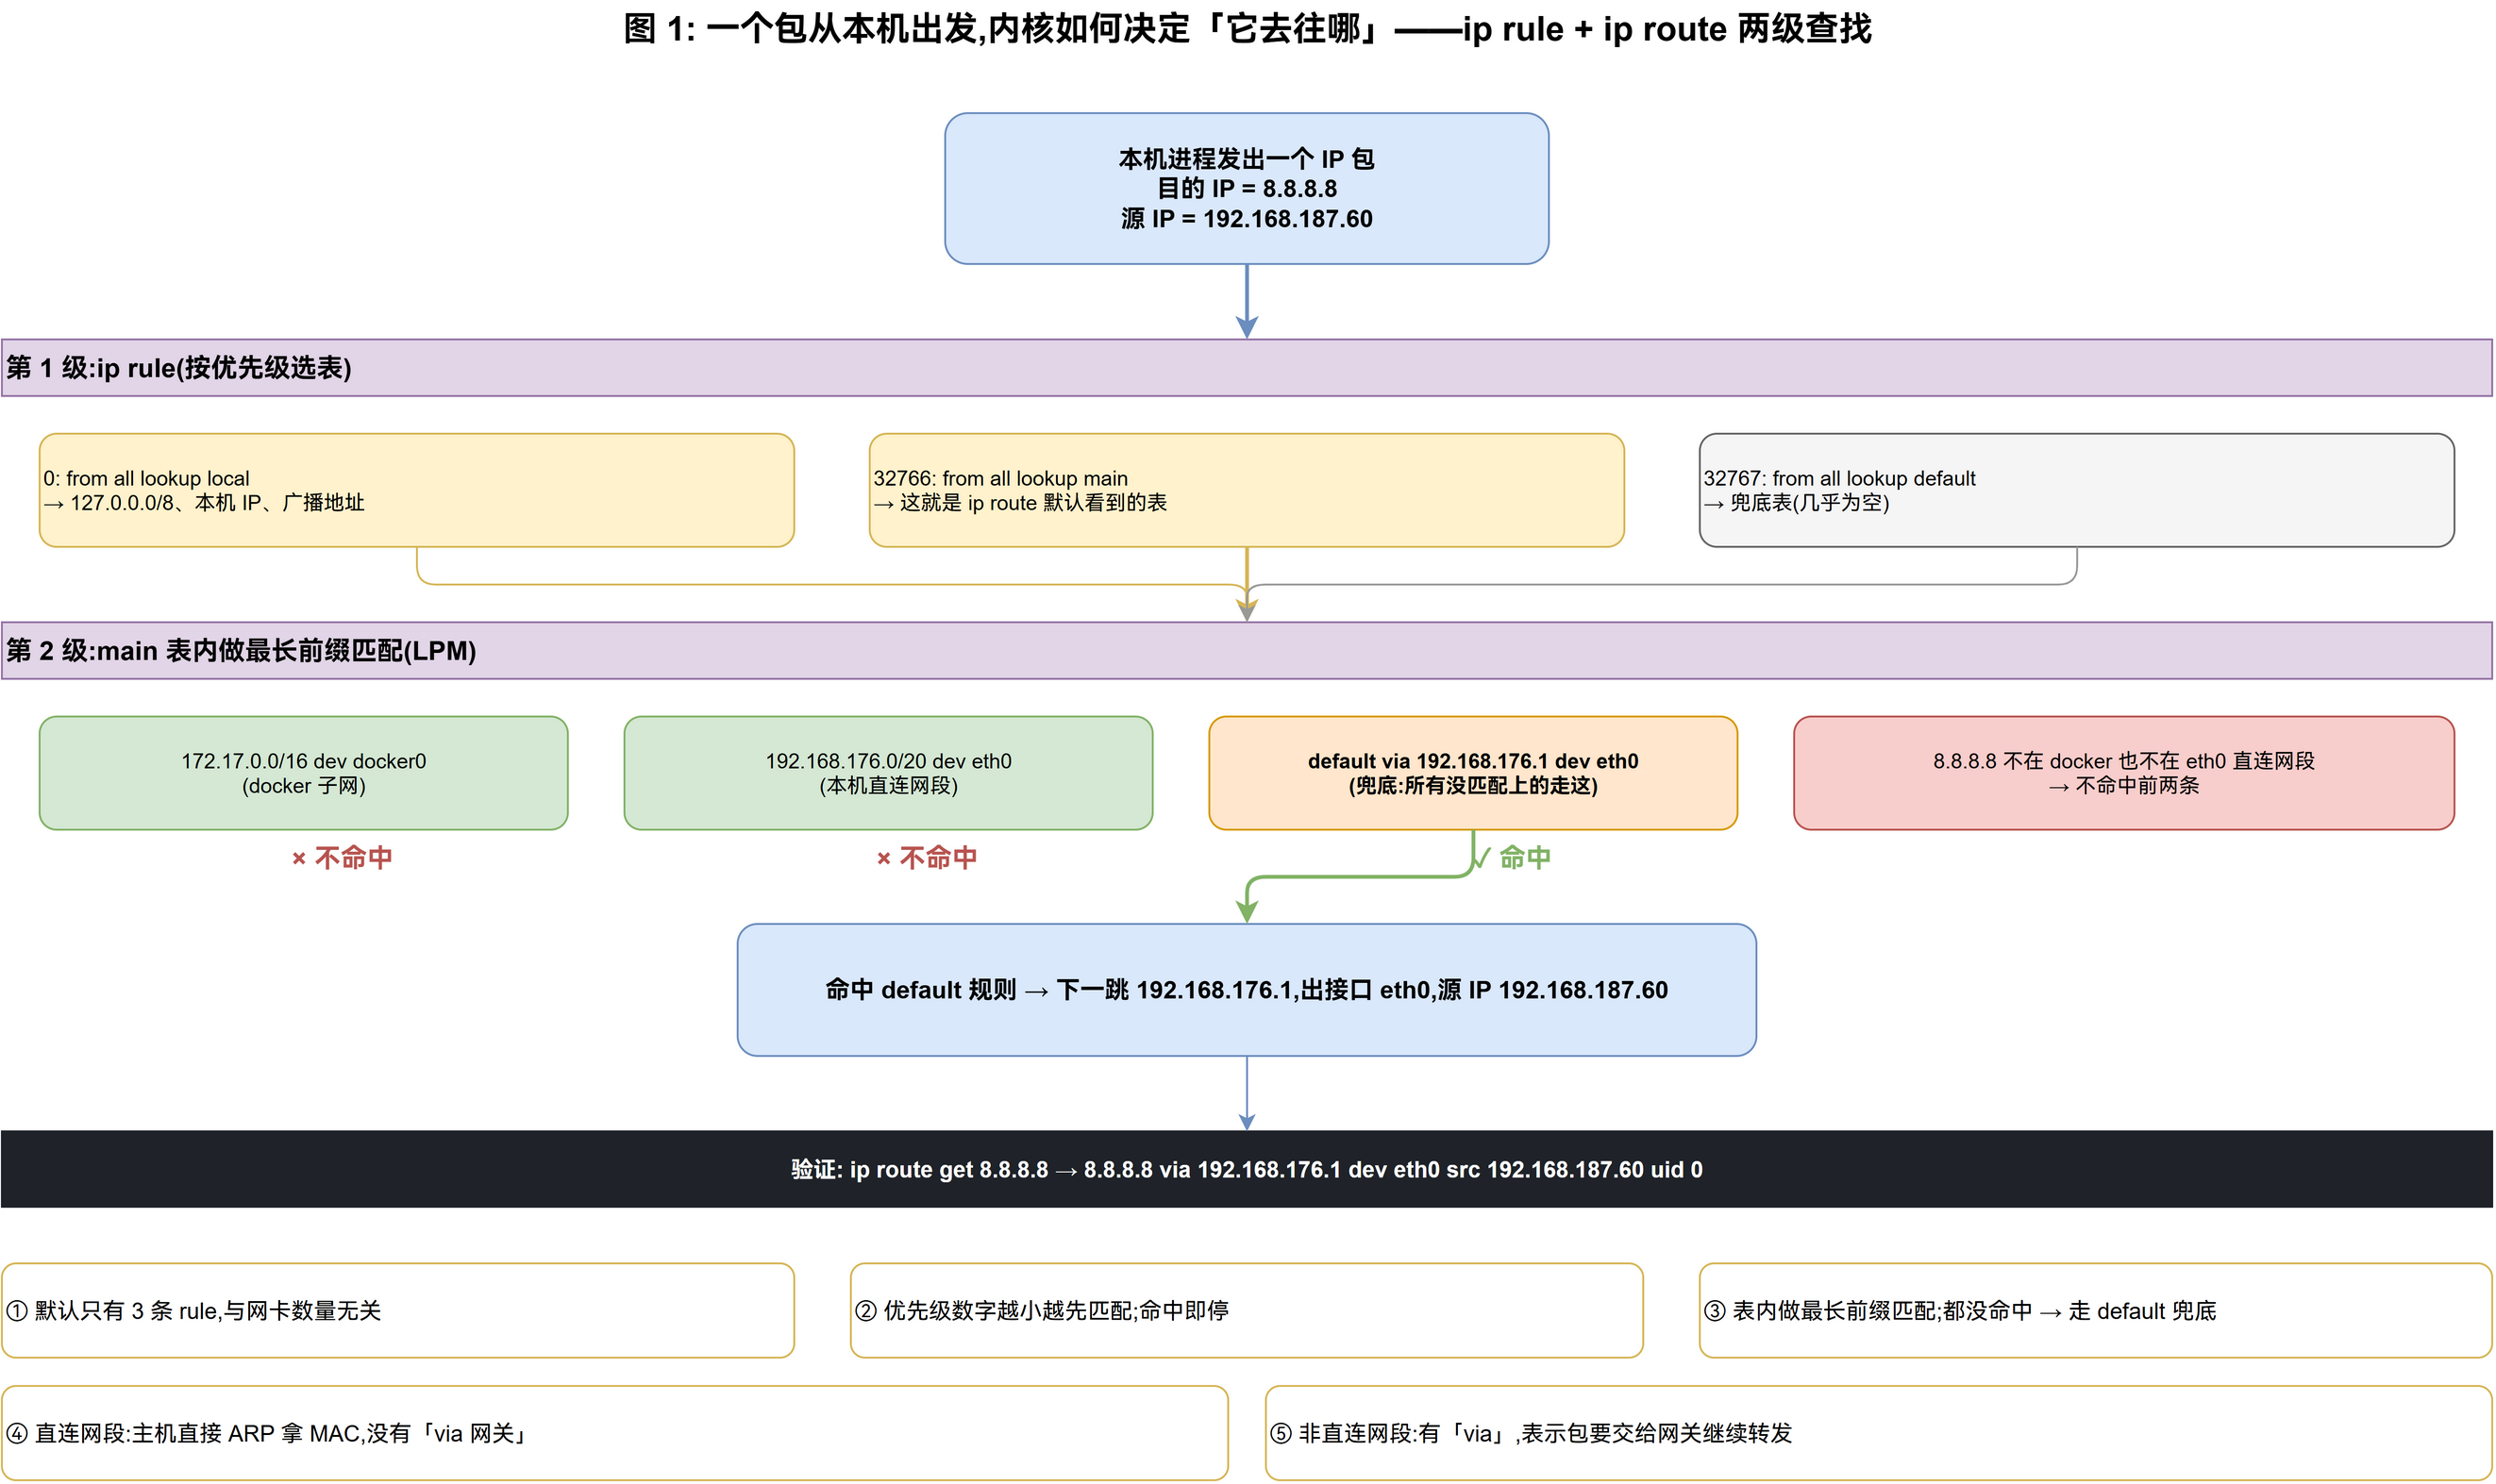
ip rule 按照优先级决定包去哪个 table 里找路由信息
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip rule
0:      from all lookup local
32766:  from all lookup main
32767: from all lookup default格式为:优先级: 匹配条件 动作
| 字段 | 含义 |
|---|---|
| 第一列数字 | 优先级,数字越小越优先(0 最先看) |
from all |
匹配条件:所有包 |
lookup local |
动作,查 local 表(本机 IP、广播地址专用) |
lookup main |
动作,查 main 表(平时 ip route 看到的就是它) |
lookup default |
动作,查 default 表(一般为空,保底用) |
操作系统决定一个包发往的下一个地址的流程大致如下:
- 按 rule 优先级从小到大遍历
ip rule。 - 对每条 rule,先看选择器是否匹配,比如
from all、from 10.0.0.0/8、fwmark 1等。 - 如果匹配,就执行动作。最常见动作是
lookup <table>。 - 去指定 table 里做路由查找:
- 先最长前缀匹配;
- 同前缀再比 metric 等。
- 如果在这张表里找到了路由 ,就用它,停止继续查后面的 rule。
- 如果在这张表里没找到路由,就继续下一条 rule。
- 如果动作是
blackhole、unreachable、prohibit,则直接返回对应结果,不再继续。 - 所有 rule 都走完还没找到,就返回网络不可达。
默认情况下 linux 上只有这 3 个规则,与有多少个网卡无关。自定义规则通常会落在 0~32766 之间,从而覆盖默认行为。
ip route
ip rule 的返回结果是按照优先级去哪个表里查, 如动作里的 lookup main 代表去查询 main 表:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip route show table main
default via 192.168.176.1 dev eth0 proto kernel
172.17.0.0/16 dev docker0 proto kernel scope link src 172.17.0.1
192.168.176.0/20 dev eth0 proto kernel scope link src 192.168.187.60
main 表是 ip route 指令默认的 table, 上述指令等价于 ip route
| 字段 | 含义 |
|---|---|
default via 192.168.176.1 |
如果没有更具体的匹配,就发给 192.168.176.1 这台设备 |
172.17.0.0/16 dev docker0 |
发往 172.17.0.0/16 这个网段的包,从 docker0 网卡出去 |
dev docker0 |
Docker 安装时创建的虚拟网卡,172.17.0.0/16 是它的网段 |
proto kernel |
这条路由是内核根据本机网卡 IP 自动生成的,也可能出现 proto dhcp 表示 DHCP 协议自动分配来的 |
scope link |
目的地跟本机是同一链路(同一网段) |
src 172.17.0.1 |
出去时用 172.17.0.1 作为源 IP |
通常我们还会执行 ip addr 看本机的 ip 信息:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip addr
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
       valid_lft forever preferred_lft forever
    inet6 ::1/128 scope host
       valid_lft forever preferred_lft forever
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP group default qlen 1000
    link/ether 00:15:5d:e0:2a:b7 brd ff:ff:ff:ff:ff:ff
    inet 192.168.187.60/20 brd 192.168.191.255 scope global eth0
       valid_lft forever preferred_lft forever
    inet6 fe80::215:5dff:fee0:2ab7/64 scope link
       valid_lft forever preferred_lft forever
3: docker0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP group default
    link/ether 46:61:fc:1c:93:8b brd ff:ff:ff:ff:ff:ff
    inet 172.17.0.1/16 brd 172.17.255.255 scope global docker0
       valid_lft forever preferred_lft forever
    inet6 fe80::4461:fcff:fe1c:938b/64 scope link
       valid_lft forever preferred_lft forever
可以看到返回值有 eth0 和 docker0,这也是上面 ip route 返回值表示的网卡名。
到这里我们就知道发往某个 ip 的包该走哪个路由了,可以用 ip route get <ip> 指令测试:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip route get 8.8.8.8
8.8.8.8 via 192.168.176.1 dev eth0 src 192.168.187.60 uid 0
    cache
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip route get 172.17.0.3
172.17.0.3 dev docker0 src 172.17.0.1 uid 0
    cache
由于 local 表一般转发一些本机(127.0...)、广播地址,所以测试的这些 IP 会走 main 表,根据路由规则:
- 8.8.8.8 不满足
docker0 172.17.0.0/16和eth0 192.168.176.0/20的规则,不在本机任何直连网段,下一跳会走 default 规则从eth0发给网关192.168.176.1,出去时用192.168.187.60作为源 IP。 - 172.17.0.3 满足
docker0 172.17.0.0/16的规则,在本机直连网络中,直接从docker0发出,172.17.0.1作为源 IP。
注意下面比上面少了 via 192.168.176.1 的部分,原因就是 172.17.0.3 在系统直连网络内,主机不经过任何路由器,直接通过 ARP 拿到目标 MAC,把帧从对应接口发出去。有 via 则是目标不在本地链路,把包交给网关,让网关继续转发。
network namespace
Linux 中有 NameSpace (命名空间)的技术,在许多的框架里也有体现:k8s、nacos、rabbitmq,ns 之间的内容相互隔离,那么 Network NameSpace 的作用也就显而易见了,在这个 ns 下的网络配置(网卡、路由表、ARP 表、iptables 规则)是独立的。
一个小实践:
bash
# 添加一个 netns
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns add test

# 查看 netns 列表(/var//run/netns)
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns
test

# 进入 test 的 netns 执行 ip addr
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test ip addr
1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00

# 进入 test 的 netns 执行 ip route
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test ip route

# 删除创建的 netns(清理)
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns del test
通过 exec test netns 的输出可知:netns 里看不到主机的网卡、路由规则。本机执行相关指令,也看不到 netns 内的网络设备,两边的世界是隔离的。那双方怎么通信呢?
veth pair
解决方案是 veth pair(虚拟以太网对),其特点如下:
- 有两个端点,数据从一端进入一定从另一端出来;
- 两端可以被各自赋 IP、参与路由;
那么主机与 netns 内进程通信的解决方案就出来了:为 netns 创建一个 veth pair,一头在 netns 里,一头在主机上,这样 netns 就可以跟外界通信了。
netns 创建时
lo设备默认是 DOWN 状态(可以回看上文的ip netns exec test ip addr输出)。如果要在 netns 内跑需要"本机回环"才能正常工作的服务(比如很多 health 检测脚本会curl 127.0.0.1),记得手动ip netns exec <ns> ip link set lo up。
veth pair 实践(实践过程中可以间断执行 ip addr 查看信息变化):
bash
# [主机] 新增一个 netns
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns add test_veth

# [主机] 新增一个 veth-test 的设备, 类型是 veth, 对端名字叫 veth-test2
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip link add veth-test type veth peer name veth-test2

# [netns] 把对端名 veth-test2 放到 test_veth 的 netns 里
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip link set veth-test2 netns test_veth

# [主机] 启动 veth-test
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip link set veth-test up

# [netns] 启动 veth-test2
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test_veth ip link set veth-test2 up

# [主机] 给 veth-test 分配 IP
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip addr add 10.11.13.3/24 dev veth-test

# [netns] 给 veth-test2 分配 IP
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test_veth ip addr add 10.11.14.4/24 dev veth-test2

# [主机] 添加路由规则
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip route add 10.11.14.0/24 dev veth-test

# [netns] 添加路由规则
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test_veth ip route add 10.11.13.0/24 dev veth-test2

# [主机] ping netns
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ping 10.11.14.4
PING 10.11.14.4 (10.11.14.4) 56(84) bytes of data.
64 bytes from 10.11.14.4: icmp_seq=1 ttl=64 time=1.68 ms
64 bytes from 10.11.14.4: icmp_seq=2 ttl=64 time=0.104 ms
64 bytes from 10.11.14.4: icmp_seq=3 ttl=64 time=0.068 ms
^C
--- 10.11.14.4 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2031ms
rtt min/avg/max/mdev = 0.068/0.615/1.675/0.749 ms

# [netns] ping 主机
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec test_veth ping 10.11.13.3
PING 10.11.13.3 (10.11.13.3) 56(84) bytes of data.
64 bytes from 10.11.13.3: icmp_seq=1 ttl=64 time=0.189 ms
64 bytes from 10.11.13.3: icmp_seq=2 ttl=64 time=0.096 ms
64 bytes from 10.11.13.3: icmp_seq=3 ttl=64 time=0.075 ms
^C
--- 10.11.13.3 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2043ms
rtt min/avg/max/mdev = 0.075/0.120/0.189/0.049 ms
可以发现,两边都能 ping 通,也就意味着打通了主机与 netns 里进程的互相通信。
bash
# 清理
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns del test_veth
网络拓扑如图:
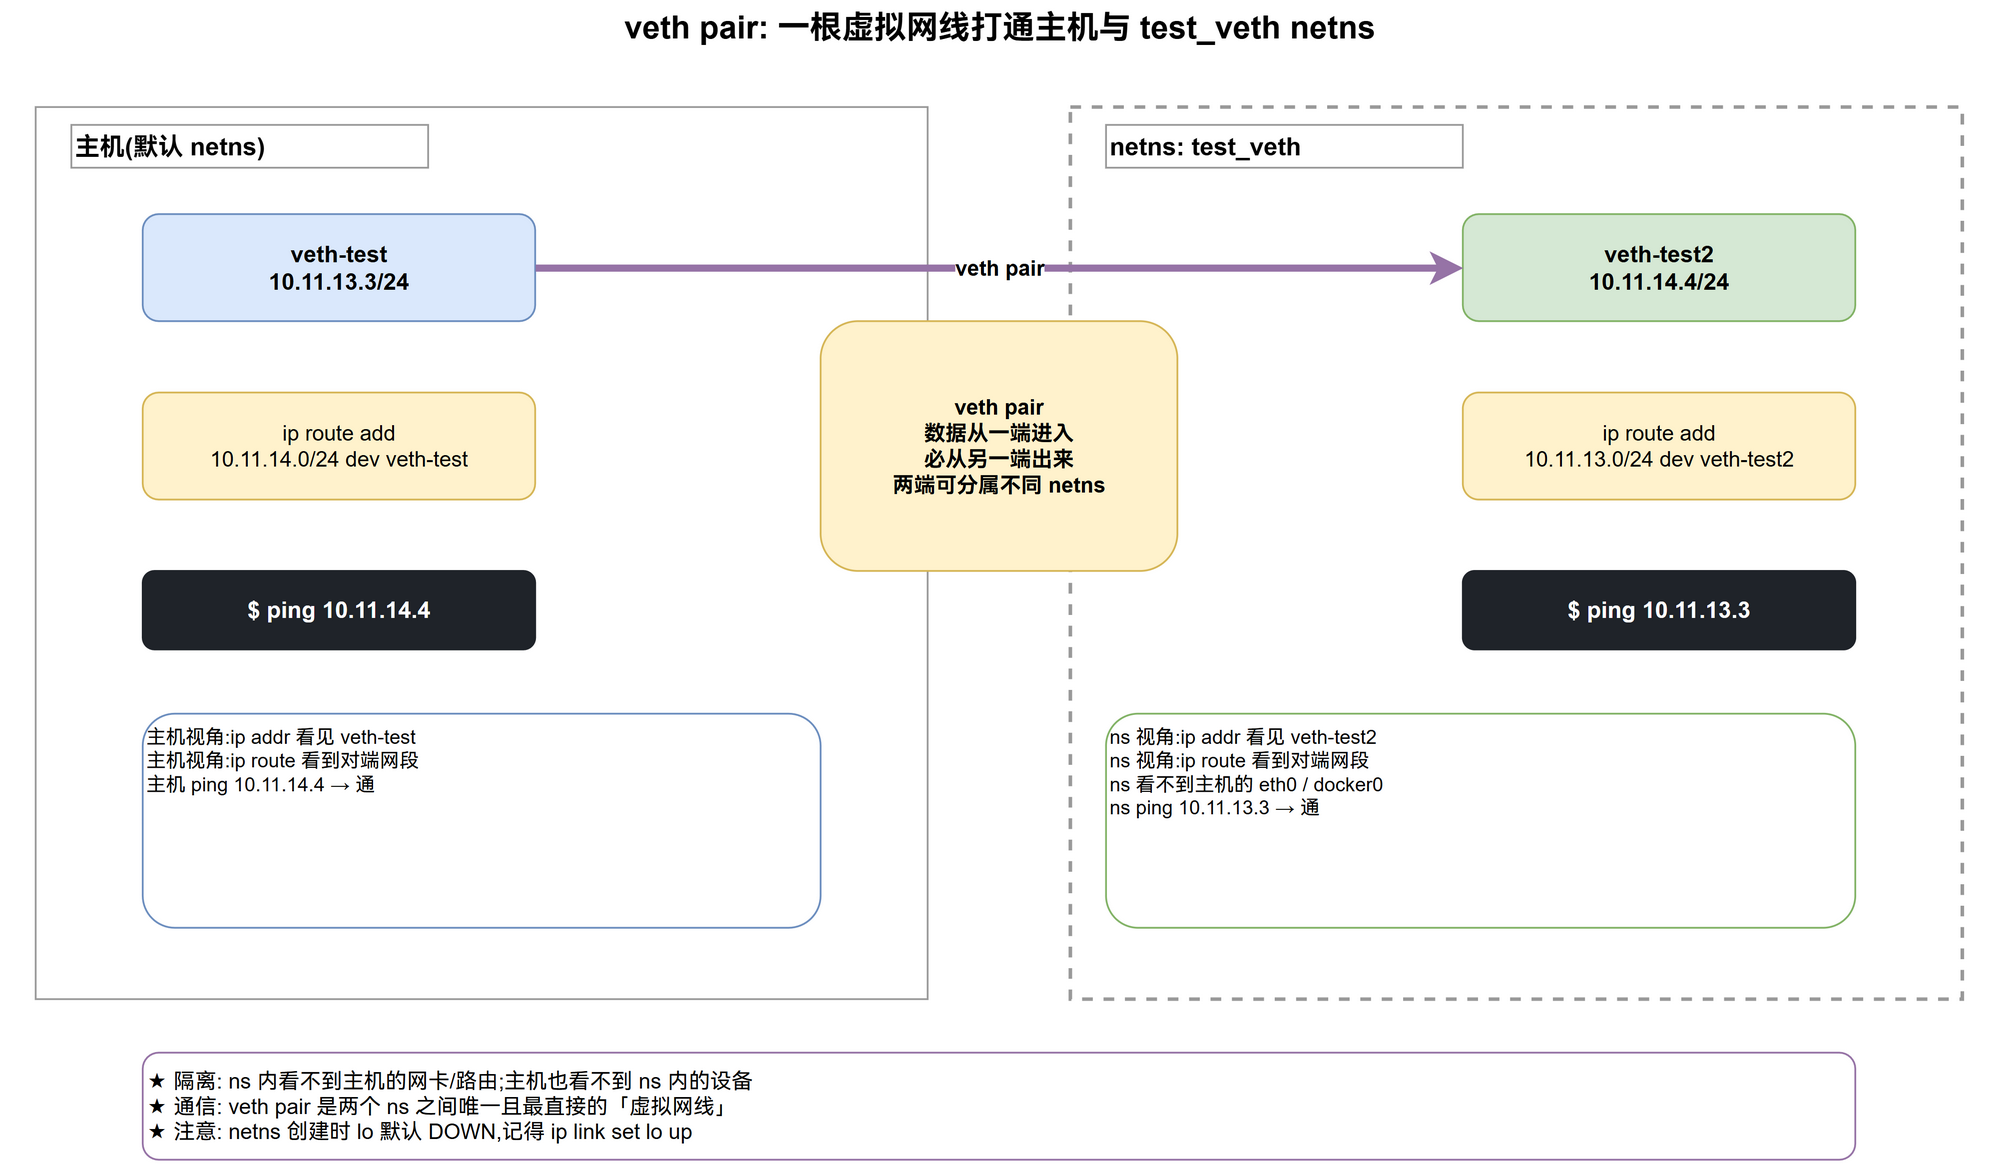
注:ip link add veth-test type veth peer name veth-test2 这个指令执行完,veth 的两端都在主机上,在后续给某一端 set veth-name netns ns 时才把 veth-name 这个端点移动到 ns 里。
container
container(容器)的本质其实是进程。
进程的定义非常多种多样,一个简单的定义是:进程是程序的动态执行。程序是代码或其产物(如二进制文件),静静的躺在磁盘上。而进程是程序被执行起来的样子:内存中的数据、寄存器里的值、堆栈和被打开的文件等这些数据和状态的总和就是进程。
容器通过约束和修改进程的动态表现,为其创造出一个"边界"。其核心原理一个是前面介绍过的 NameSpace 技术,除了 network ns,linux 还提供了 pid、mount、uts、user 多种 ns,这是 linux 创建新进程的一个可选参数;另一个核心原理则是 Cgroups,既然容器是一个进程,自然会与系统的任何其他进程一起争抢资源,Cgroups 提供了限制进程能使用的资源(cpu、mem、blkio)上限的能力。
所以一个进程运行在一个 netns 里,前面的内容实现了 netns 与主机的通信,也就是只要为每一个容器创建一个 veth 设备,容器与主机就可以通信了。
那么容器与容器之间如何通信呢?
一个简单的方案是,如果容器A需要与容器B通信,那么容器A和容器B间也添加一个 veth 设备,仔细想一下其实问题很多:如果互相通信的容器有 N个,那么需要 N(N-1)/2 个 veth 设备,根本不可行。
现实生活中,只要我们的设备连同一个路由器,互相之间就能通信,这里也是同理。
bridge
首先介绍一下交换机和路由器,交换机是二层设备,工作在数据链路层,会根据收到包的 MAC 地址转发给对应的主机;路由器是三层设备,工作在网络层,能根据收到包的 IP 地址决定从哪个网卡转发出去。
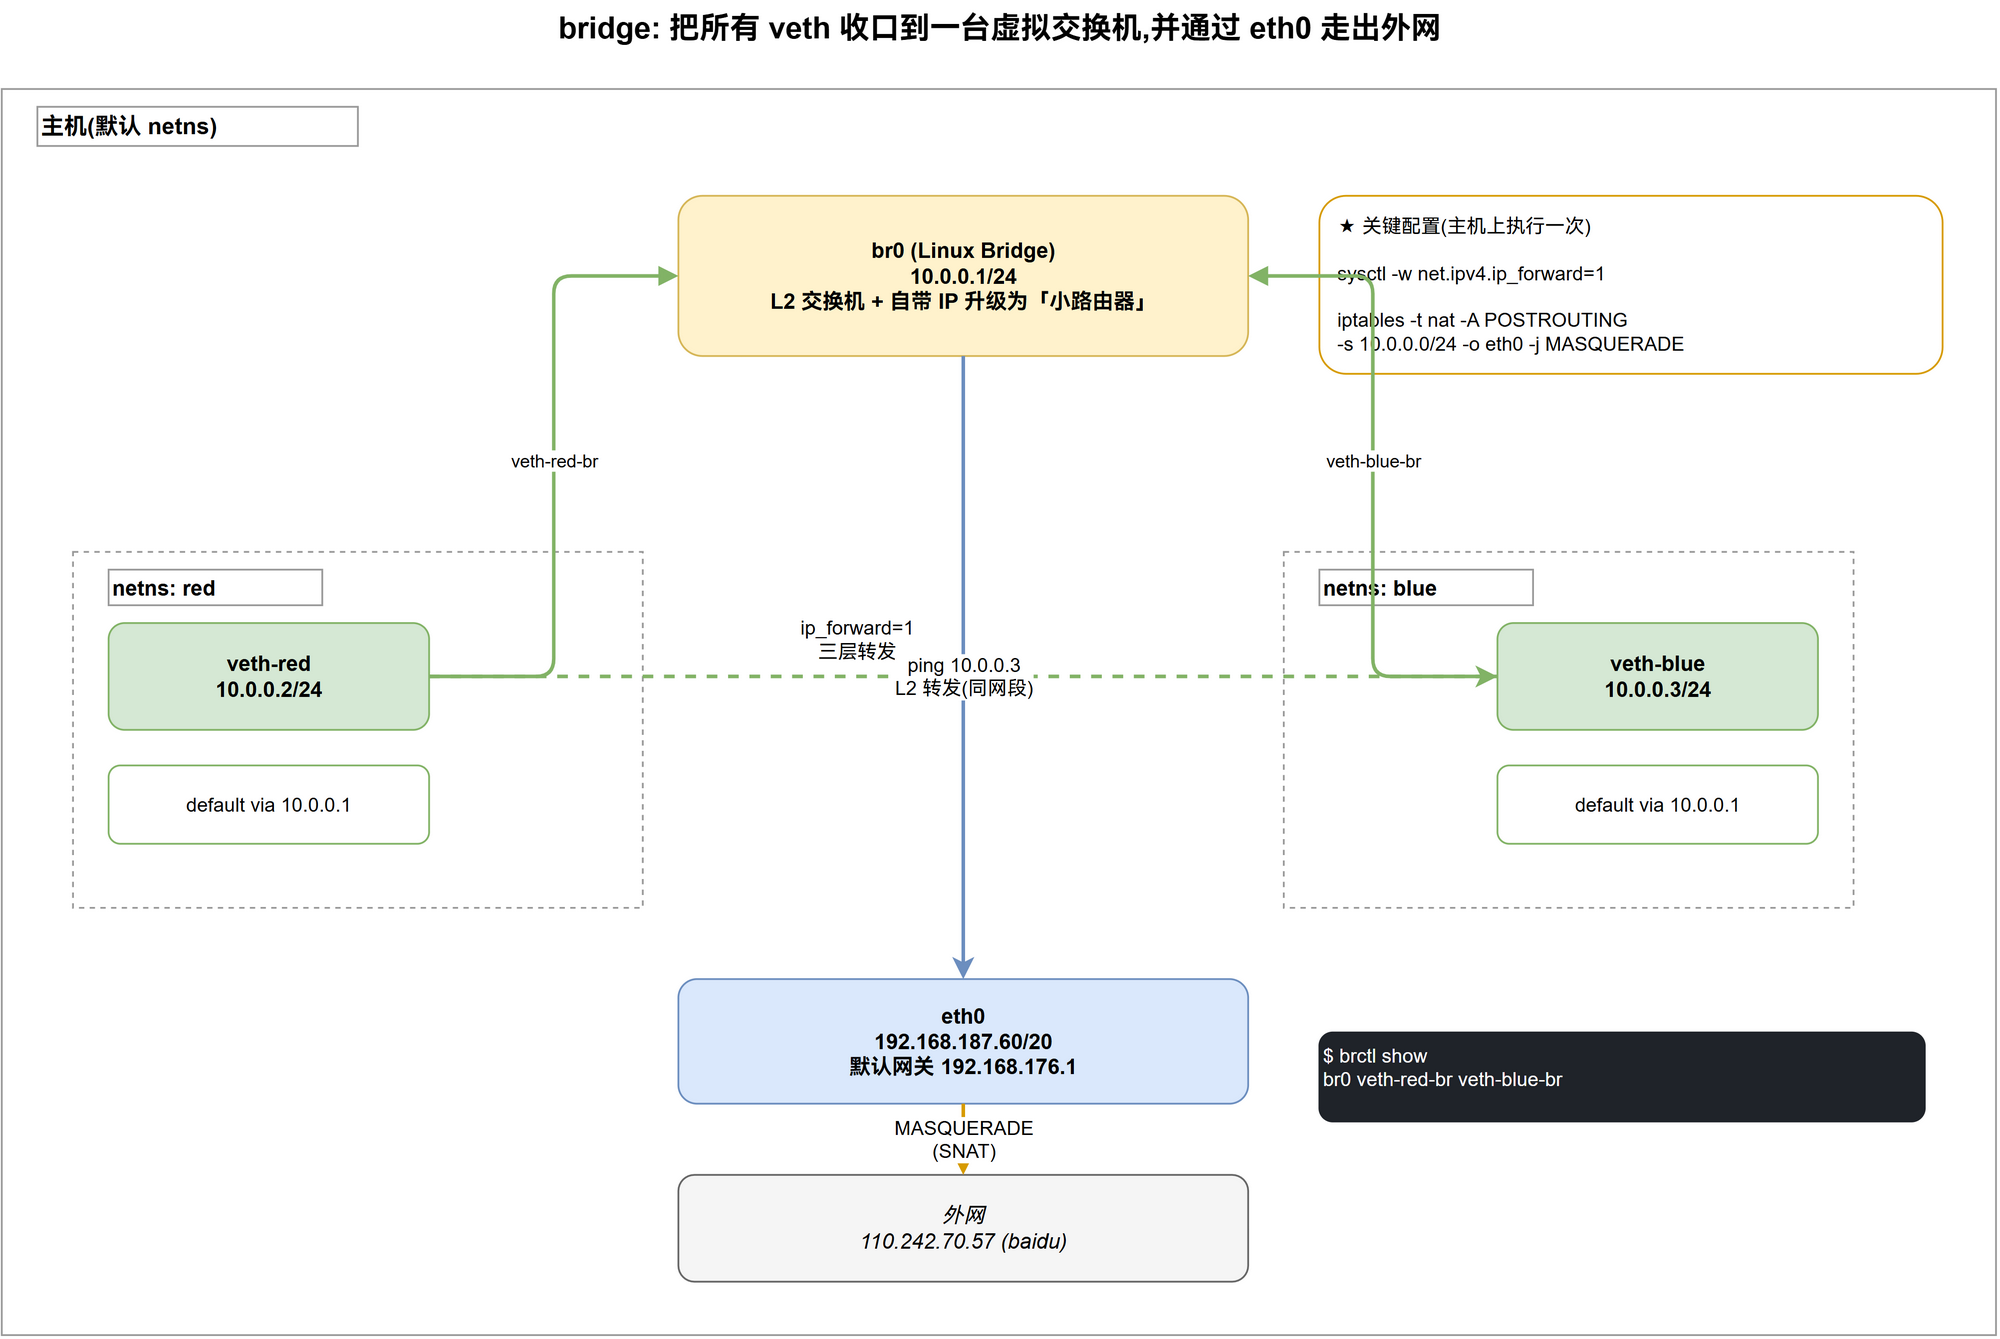
bridge 就是让所有 veth 都接到一个虚拟交换机上,这样互相之间就可以通信了,N 个容器只需要 N 个 veth。
大名鼎鼎的 docker0 就是一个 bridge。严格地说是一台二层交换机------它只会按 MAC 学习、转发同网段内的帧,并不会在不同 IP 网段之间路由包。所以光有 bridge 是不够的。
解决这个问题的方案分两步:
- 给 bridge 本身赋一个 IP,让它"接入协议栈":能查本机路由表、接收"目的 IP 是自己"的包、能从自己的视角看邻居表。
- 打开
/proc/sys/net/ipv4/ip_forward=1,允许内核把"目的 IP 不是自己"的包继续向外转发。
只有这两步都做了,bridge 才同时是一台 L2 交换机和一台 L3 路由器------容器之间同网段通信走 L2,容器对外网通信走 L3 转发。
接下来是实践,创建 red、blue 两个 netns,每个 netns 对应一个 veth,最终效果:red 和 blue 可以互相 ping 通,并能访问外网(ping www.baidu.com):
bash
# 创建两个 netns
ip netns add red
ip netns add blue

# 创建 bridge,并给它分配网关 IP
ip link add br0 type bridge
ip link set br0 up
ip addr add 10.0.0.1/24 dev br0
bash
# 为 red 创建 veth pair
ip link add veth-red type veth peer name veth-red-br
ip link set veth-red netns red
ip link set veth-red-br master br0
ip link set veth-red-br up

# 为 blue 创建 veth pair
ip link add veth-blue type veth peer name veth-blue-br
ip link set veth-blue netns blue
ip link set veth-blue-br master br0
ip link set veth-blue-br up
此时 veth-red-br 和 veth-blue-br 都插在 br0 这个虚拟交换机上。
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# brctl show
bridge name     bridge id               STP enabled     interfaces
br0             8000.9ee0a443c089       no              veth-blue-br
                                                        veth-red-br
配置 netns 内的接口和路由:
bash
# 启动 red 里的 veth,并分配 IP
ip netns exec red ip link set veth-red up
ip netns exec red ip addr add 10.0.0.2/24 dev veth-red
ip netns exec red ip route add default via 10.0.0.1

# 启动 blue 里的 veth,并分配 IP
ip netns exec blue ip link set veth-blue up
ip netns exec blue ip addr add 10.0.0.3/24 dev veth-blue
ip netns exec blue ip route add default via 10.0.0.1
查看默认出口网卡:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip route show default
default via 192.168.176.1 dev eth0 proto kernel
我这边是 eth0:
bash
# 开启 IP 转发
sysctl -w net.ipv4.ip_forward=1

# 对 10.0.0.0/24 做 MASQUERADE,从 eth0 出去
iptables -t nat -A POSTROUTING -s 10.0.0.0/24 -o eth0 -j MASQUERADE

# 如果 FORWARD 链默认是 DROP,放行转发流量
iptables -I FORWARD 1 -i br0 -o eth0 -s 10.0.0.0/24 -j ACCEPT
iptables -I FORWARD 1 -i eth0 -o br0 -d 10.0.0.0/24 -m conntrack --ctstate RELATED,ESTABLISHED -j ACCEPT
之后就可以测试了:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip netns exec red ping 10.0.0.3
PING 10.0.0.3 (10.0.0.3) 56(84) bytes of data.
64 bytes from 10.0.0.3: icmp_seq=1 ttl=64 time=0.051 ms
64 bytes from 10.0.0.3: icmp_seq=2 ttl=64 time=0.126 ms
64 bytes from 10.0.0.3: icmp_seq=3 ttl=64 time=0.117 ms
^C
--- 10.0.0.3 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2055ms
rtt min/avg/max/mdev = 0.051/0.098/0.126/0.033 ms
bash
# 110.242.70.57 是我这里解析出的 www.baidu.com 对应的 IP
root@DESKTOP-A8PBREO:/mnt/c/Users/14184/Documents# ip netns exec red ping 110.242.70.57
PING 110.242.70.57 (110.242.70.57) 56(84) bytes of data.
64 bytes from 110.242.70.57: icmp_seq=1 ttl=50 time=15.1 ms
64 bytes from 110.242.70.57: icmp_seq=2 ttl=50 time=15.0 ms
64 bytes from 110.242.70.57: icmp_seq=3 ttl=50 time=15.2 ms
^C
--- 110.242.70.57 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2003ms
rtt min/avg/max/mdev = 14.976/15.102/15.246/0.110 ms
注:如果还是不行,可以执行 iptables -I FORWARD 1 -i br0 -o br0 -j ACCEPT 试试。理论上,bridge 是二层设备,转发帧应该只看 MAC,不经过 IP 层的 netfilter。但 Linux 有一个模块叫 br_netfilter,Docker 会加载它并设置"同一个 bridge 内部端口到端口"的转发为 Drop,导致包被丢弃。
网络拓扑如图:
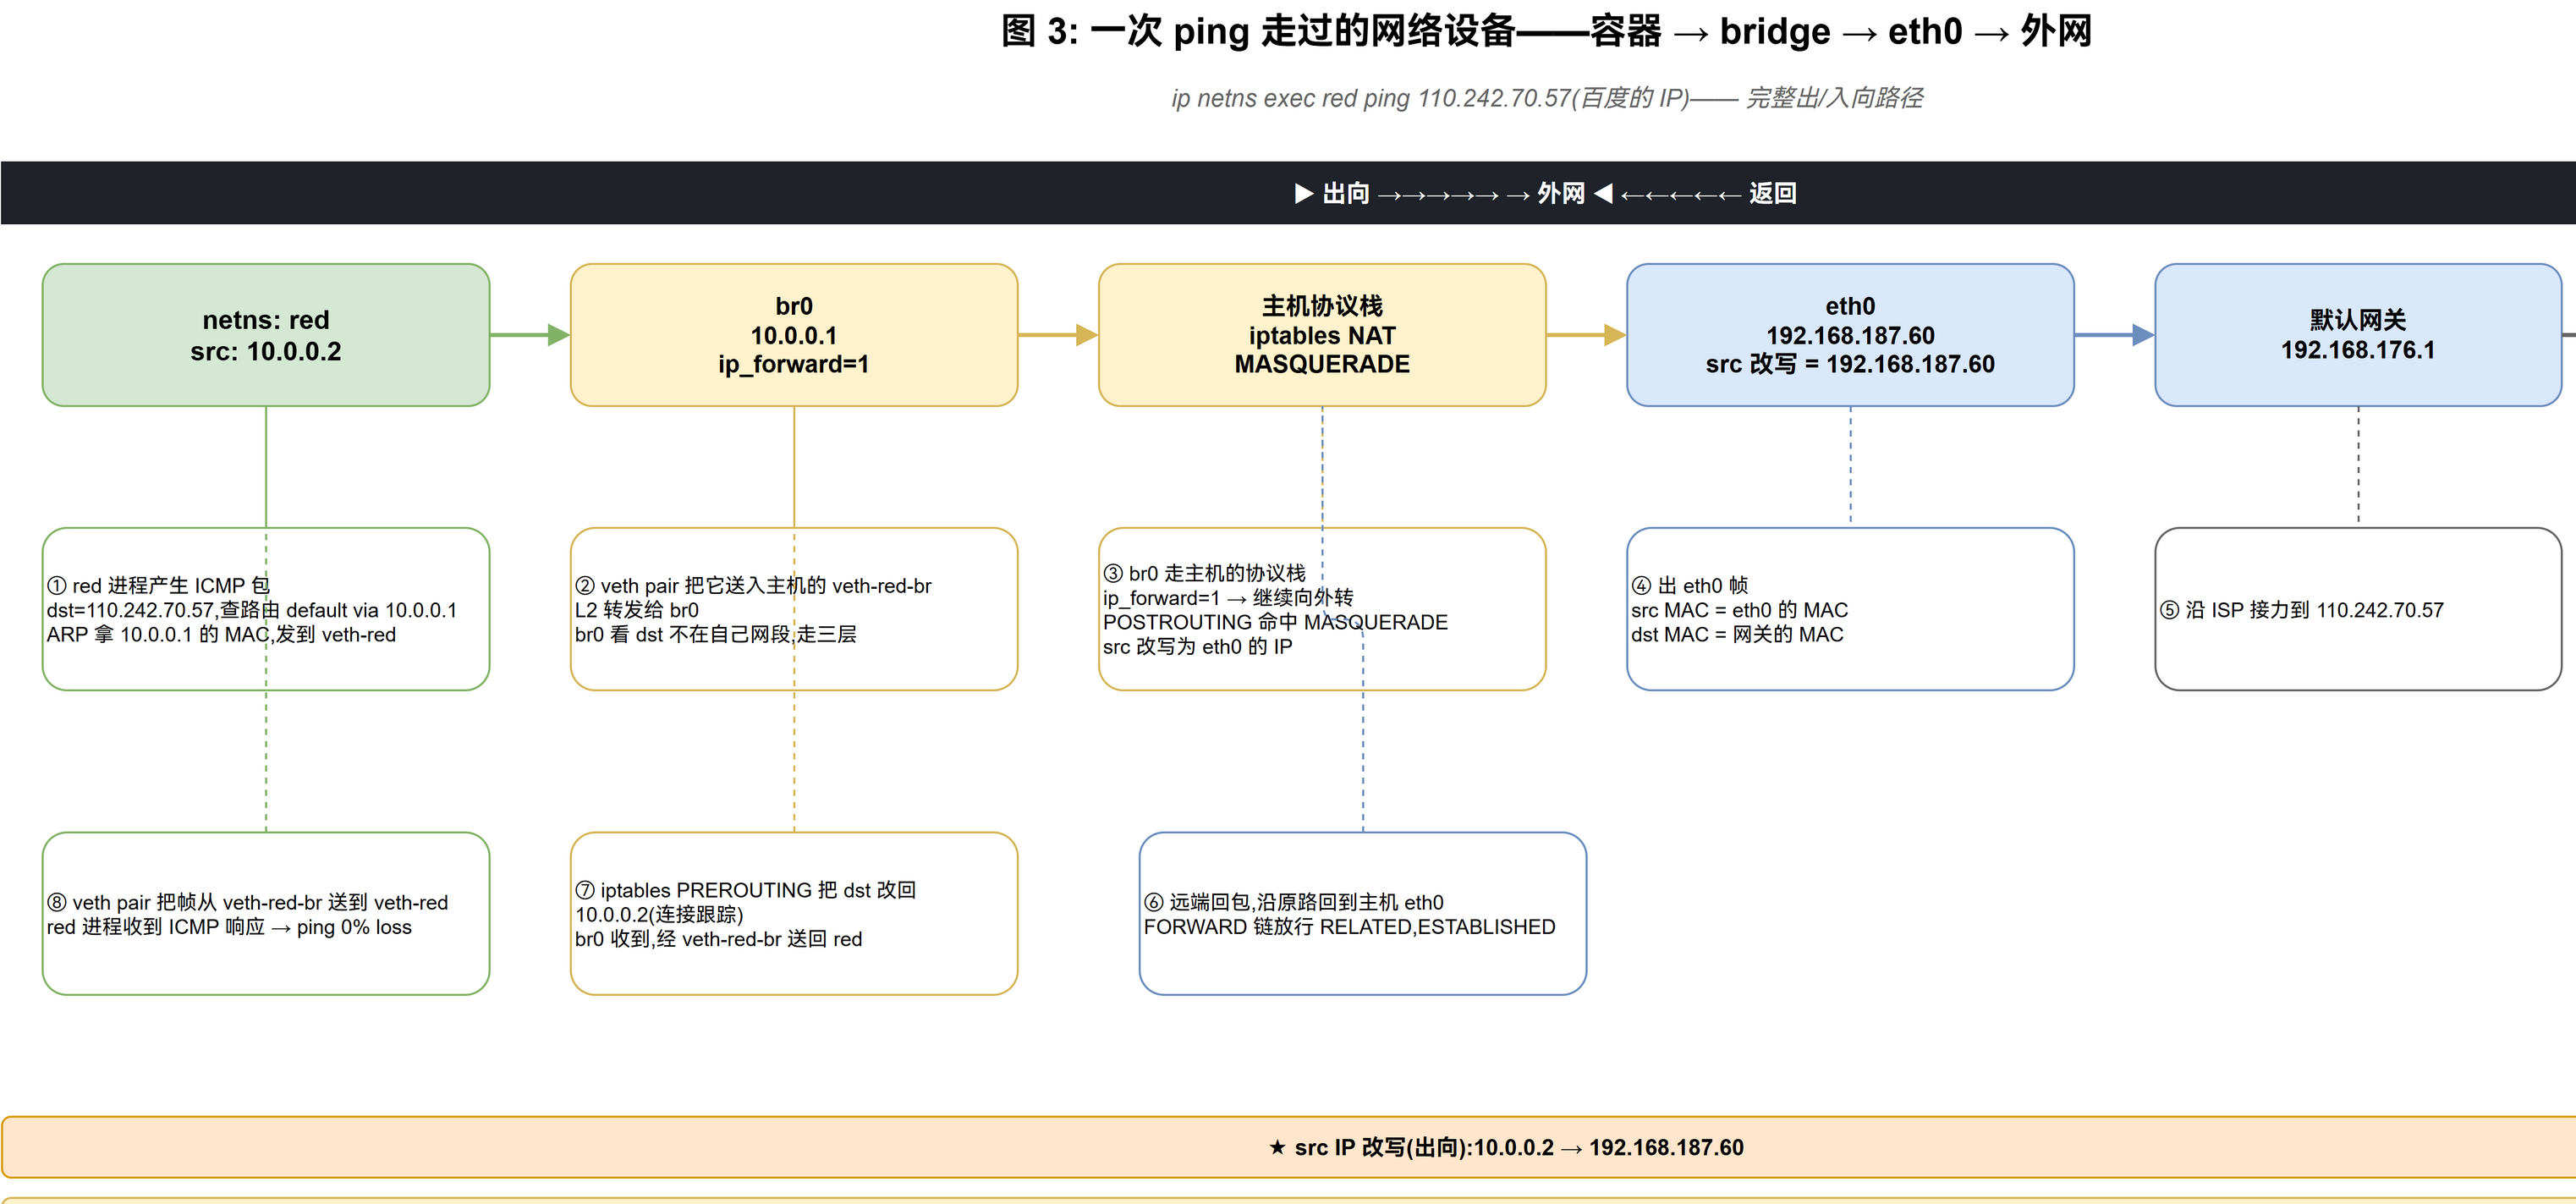
把上面所有零件拼起来,就是一次 ping 的完整路径:
docker0
理解了上面的内容,那么学习 docker 网络也比较简单了。
在装了 docker 的主机上执行 ip addr:
bash
root@DESKTOP-A8PBREO:/mnt/c/Users/27184/Documents# ip addr
3: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default
    link/ether 46:61:fc:1c:93:8b brd ff:ff:ff:ff:ff:ff
    inet 172.17.0.1/16 brd 172.17.255.255 scope global docker0
       valid_lft forever preferred_lft forever
    inet6 fe80::4461:fcff:fe1c:938b/64 scope link
       valid_lft forever preferred_lft forever
会找到这个叫 docker0 的网桥,它就是实现容器间通信、容器对外通信的核心。
启动一个容器:
bash
docker run --name mysql -e MYSQL_ROOT_PASSWORD=root -p 3306:3306 -d mysql:5.7启动完执行 ip addr 会发现多了一个设备,其实这是 veth 的一端,另一端就在容器里。
如果创建一个网络:
bash
[root@tssxserver ~]# docker network create test-veth
67b844951b1eb34589a2851afe1ee3635de6d453b3c3fabf9f69167be2279ebb

[root@tssxserver ~]# ip addr | grep 67b8449
32: br-67b844951b1e: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default
    inet 172.21.0.1/16 brd 172.21.255.255 scope global br-67b844951b1e
会发现多了一个 br 开头的设备名。
小结
容器网络并不是黑盒,整个文章其实就讲了 4 件事:
- 路由决策(ip rule + ip route):内核拿到一个 IP 包,先按优先级选路由表,再在表内做最长前缀匹配,得到"下一跳 + 出接口"。
- Network Namespace:把网卡、路由表、iptables 隔离开,让进程拥有自己独立的网络栈;veth pair 就像一根"虚拟网线", 把两个 ns 串起来。
- Linux Bridge:虚拟的 L2 交换机,把"网线"的一端统一收口在一台设备上,实现 N 个 ns 之间两两通信。
- 三层转发 + NAT:bridge 被赋 IP + ip_forward=1 就升级成"带路由功能的小交换机";iptables MASQUERADE 把容器源 IP 翻译成 eth0 的出网 IP,容器就真正"能上网"。
Kubernetes 里的 CNI、那么多的网络实现 flannel、calico 等其实也是这些事情的不同拼装。