写在前面
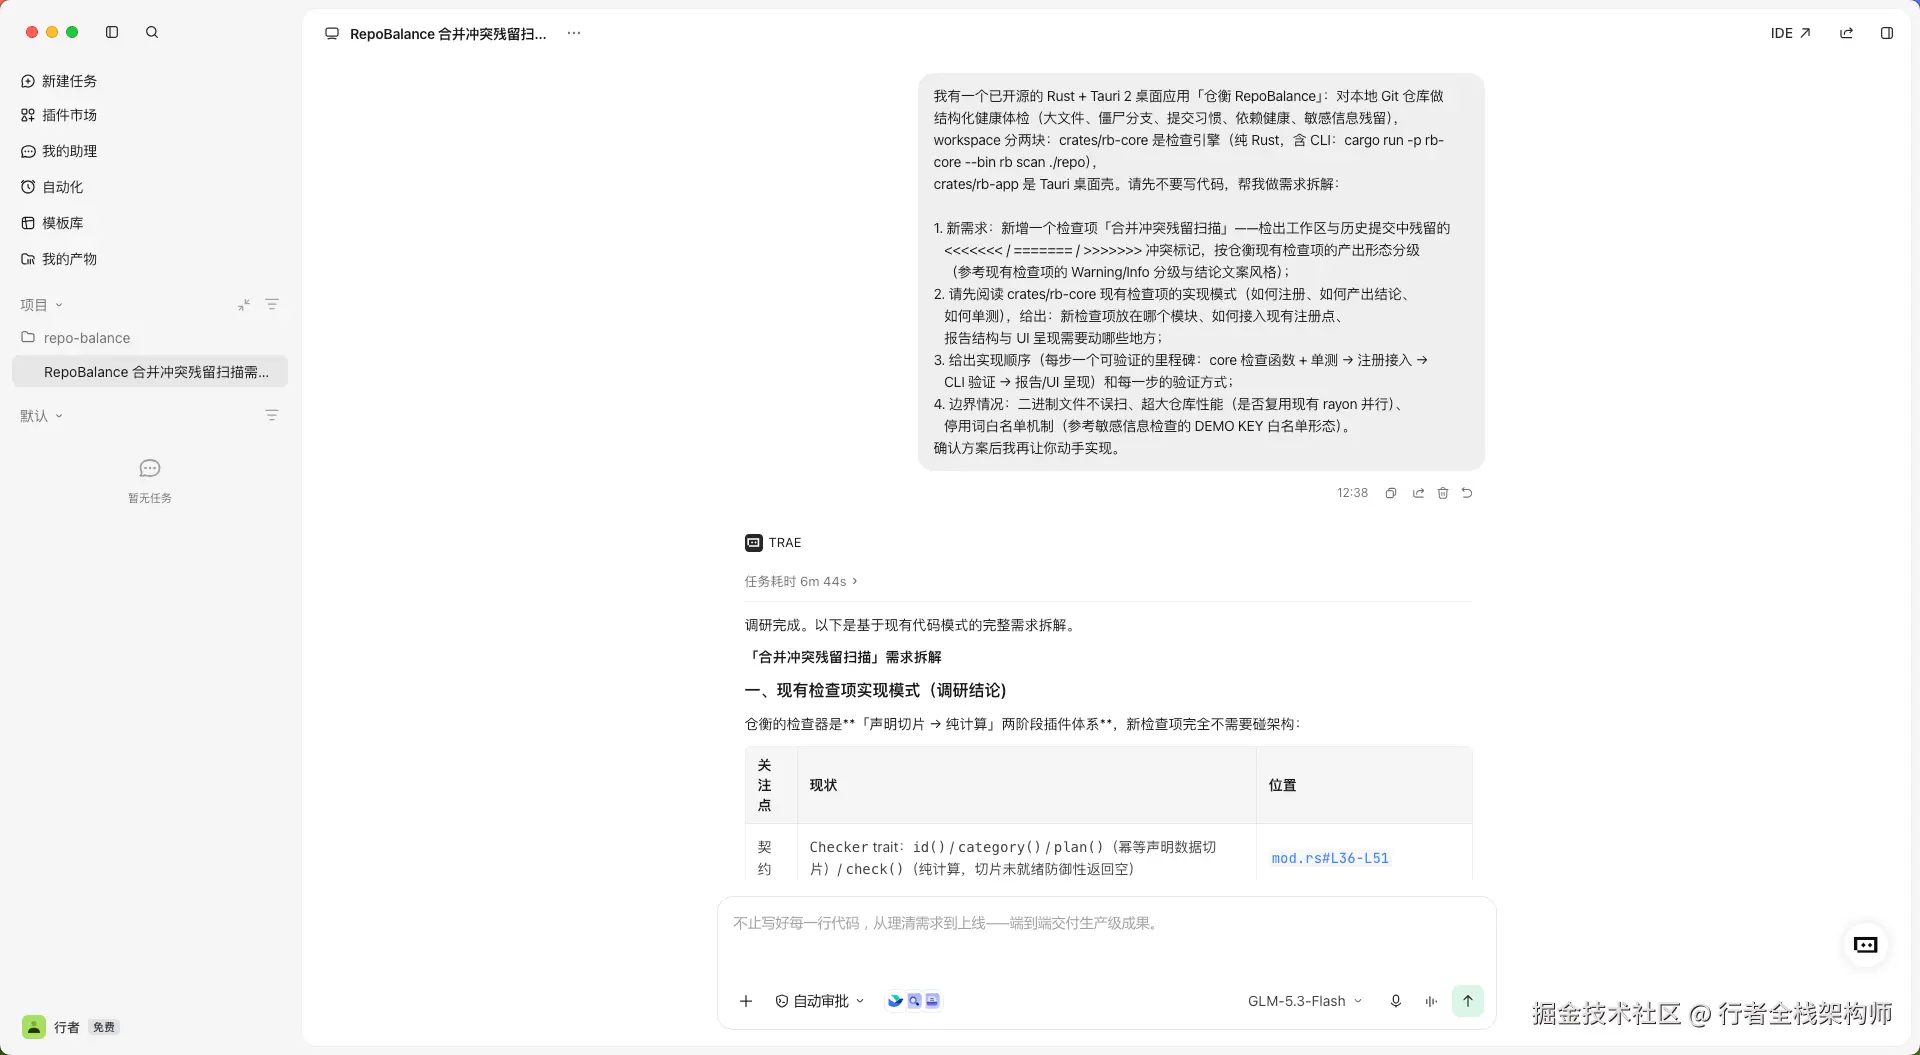
先交代项目背景,这也是本文真实性的底座:「仓衡 RepoBalance」是我用华为云码道 CodeArts 独立开发并开源的 Rust + Tauri 2 桌面应用------对本地 Git 仓库做结构化健康度体检:大文件、僵尸分支、提交习惯、依赖健康、敏感信息残留,输出可导出的体检报告。工程是 Rust workspace:crates/rb-core 是检查引擎(附 CLI:cargo run -p rb-core --bin rb scan ./repo),crates/rb-app 是 Tauri 桌面壳,托管在 AtomGit(G-Star 认证)和 GitHub。
这次全新 TRAE 升级到双端融合版本后,我想用一个真实需求验证它的"全链路"成色:给仓衡新增一个检查项------「合并冲突残留扫描」 ,检出工作区与历史提交中残留的 <<<<<<< / ======= / >>>>>>> 冲突标记。选它是因为一个检查项虽小,链路却完整:core 检查纯函数 → 单元测试 → 注册接入 → CLI 验证 → 报告结构与 UI 呈现 → 构建产物,正好把 Agent 模式从需求到交付的完整路径压一遍。
说明:仓衡是存量开源工程,本文记录的是用全新 TRAE 在其上继续演进的完整过程,所有报错、耗时、数据均为实测。
一、需求拆解:先让 Agent 出方案,而不是出代码
我的第一句话术就立了规矩:先不要写代码 。我给它划了三个约束:新检查项必须对齐现有检查项的分级与结论文案风格、必须走现有注册模式、必须复用敏感信息检查已有的"停用词白名单"机制(避免把演示数据里的占位块误报)。然后要求它先读 rb-core 现有检查项的实现模式,给出模块放置、接入点、实现顺序和每步的验证方式,外加三个边界情况(二进制文件不误扫、超大仓库性能是否复用 rayon 并行、白名单机制)。
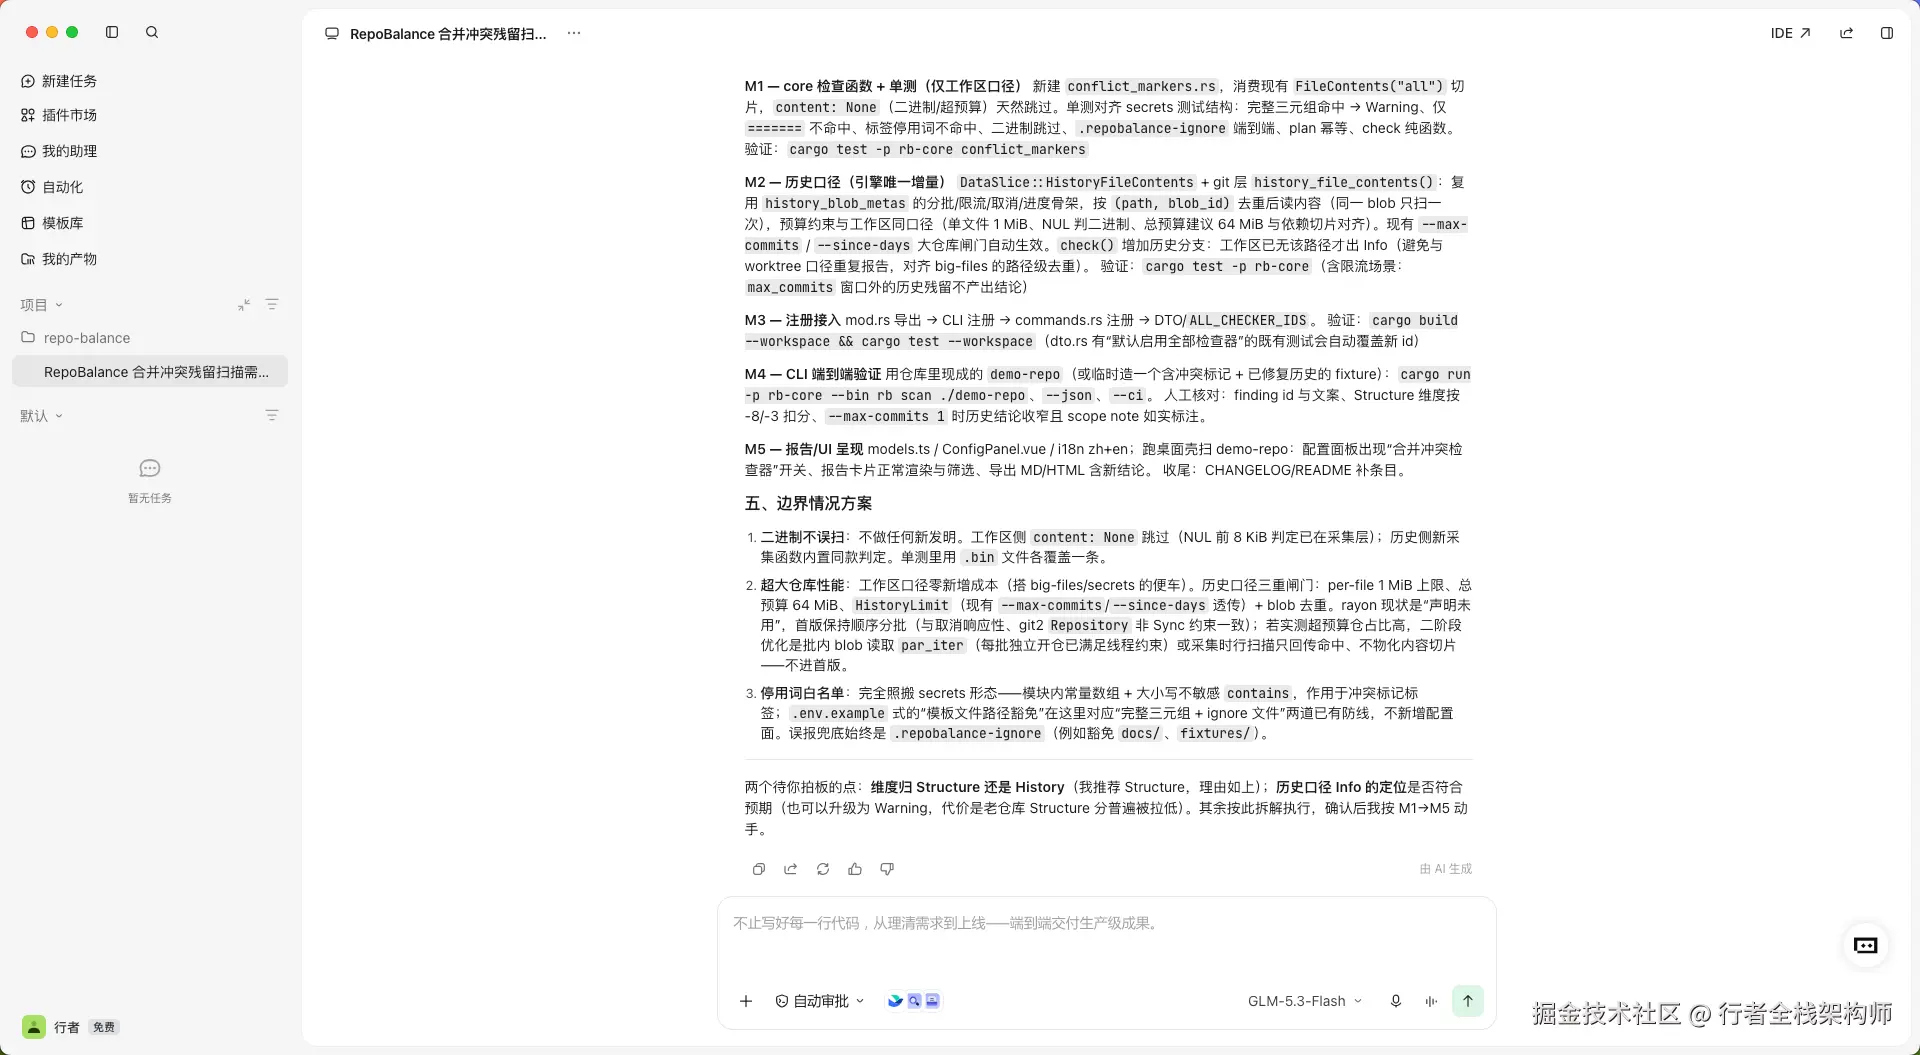
Agent 拆解的质量是第一个惊喜:它把实现压成了 M1~M5 五个里程碑------M1 core 检查函数 + 单测(工作区口径)→ M2 历史口径增量 → M3 注册接入 → M4 CLI 端到端验证 → M5 报告/UI 呈现------并且边界情况给得比我要的更细:二进制不做新发明(NUL 前 8 KiB 判定)、超大仓库三重阀门(per-file 1 MiB、总额 64 MiB、HistoryLimit 透传 --max-commits)、停用词白名单完全复用 .env.example 模板形态。拆解耗时 6 分 44 秒,方案末尾还留了两个"待你拍板"的点(维度归 Structure 还是 History、历史口径 Info 定位是否符合预期)------先对齐再动手,这正是我要的节奏。
二、分步实现:每个里程碑都可验证
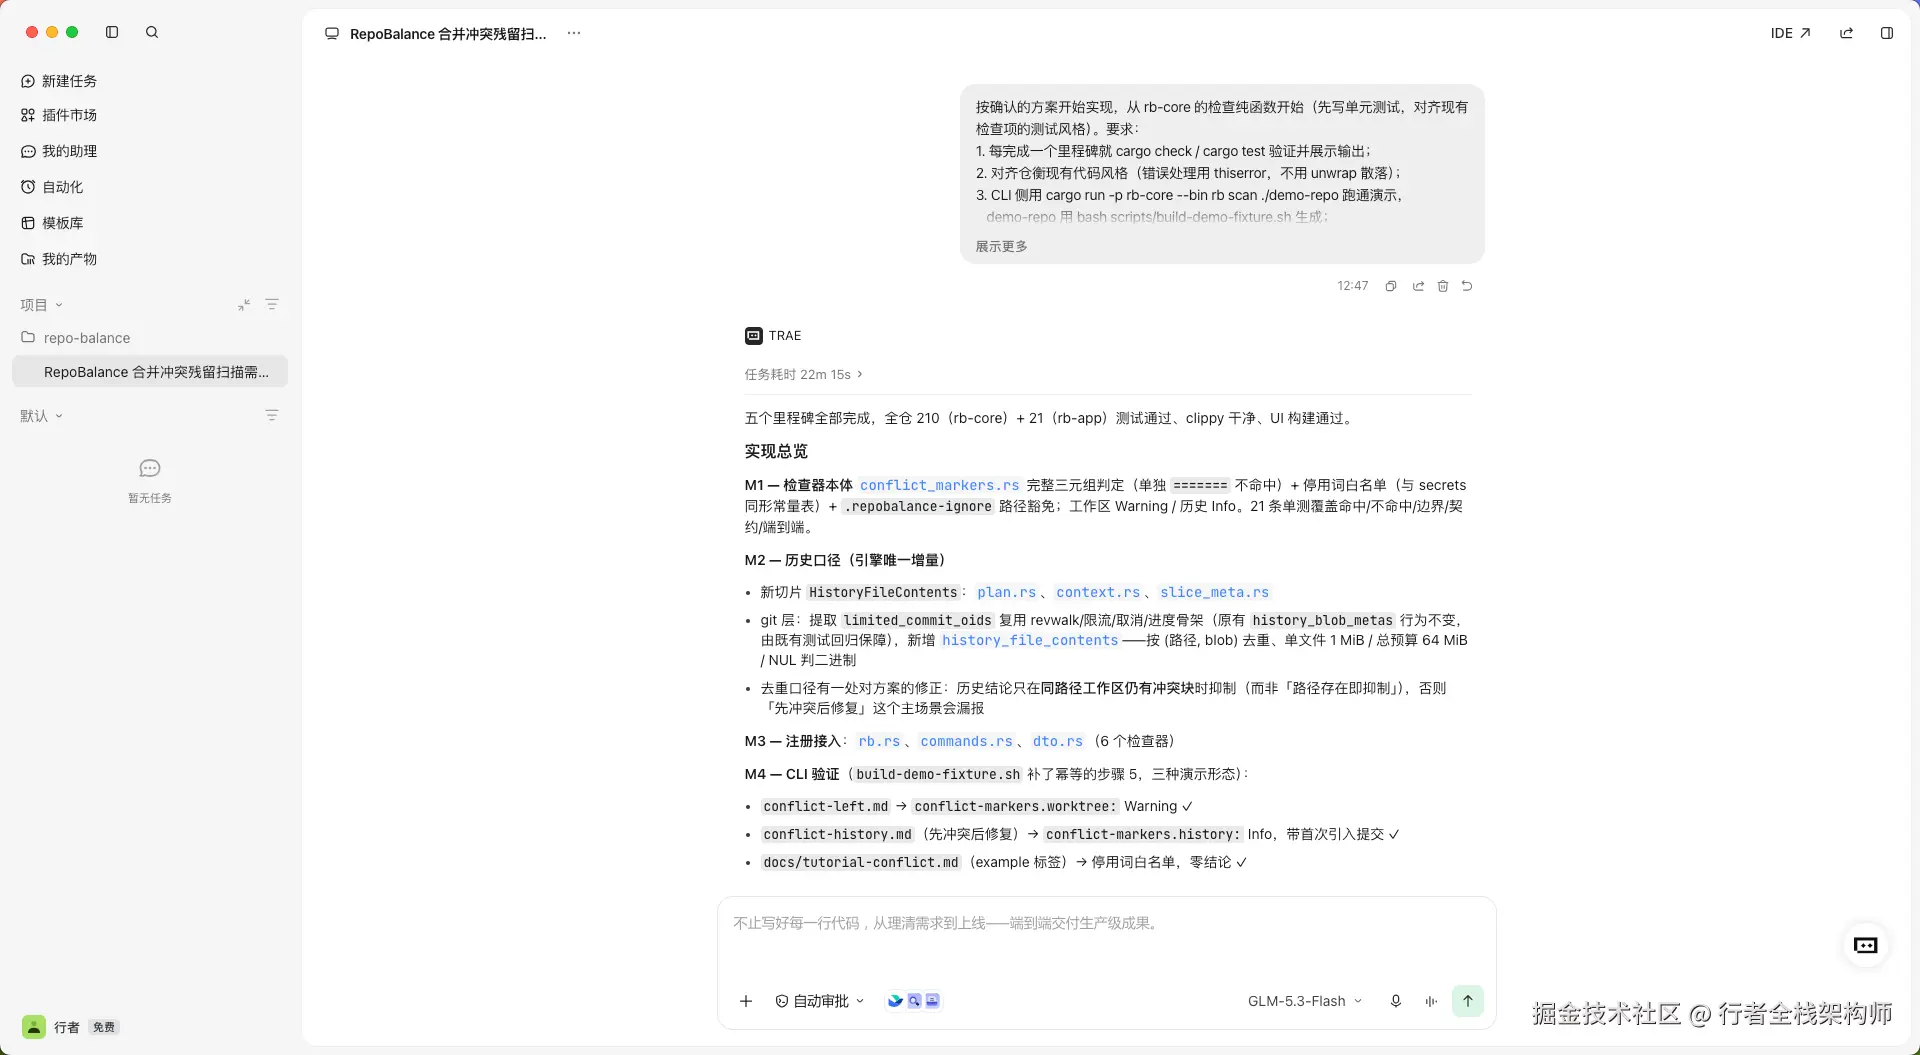
实现阶段我只做两件事:投喂下一个里程碑指令、跑它的验证命令。第一个里程碑是 core 层的冲突标记检测纯函数 + 单元测试,Agent 对齐了现有检查项的测试风格;第二个里程碑接入注册点;第三个里程碑用演示仓库验证------我用工程自带的 bash scripts/build-demo-fixture.sh 生成了含合成数据的 demo-repo,然后:
bash
cargo run -p rb-core --bin rb scan ./demo-repo新检查项在 CLI 输出里报出了预期结论。这一轮实现的总耗时 22 分 15 秒,收尾时 Agent 的自查汇总很清楚:全仓 210(rb-core)+ 21(rb-app)测试通过、clippy 干净、UI 构建通过;conflict_markers 模块 21 条单测覆盖命中/不命中/边界/契约/端到端,build-demo-fixture.sh 还顺手补齐了三种演示形态(工作区残留 Warning、历史残留 Info、白名单豁免零结论)。
三、报错与自主修复:这次没用上,但话术必须备着
一个诚实的记录:这一轮 M1~M5 一次跑通,cargo test --workspace 全绿,我准备的 K3 修复话术(贴报错原文 → 根因 → 修复 → 重跑 → 展示 diff)全程没有触发。两个终端截图是我随手验证的完整输出------rb-app 21 条、rb-core 210 条,0 failed。
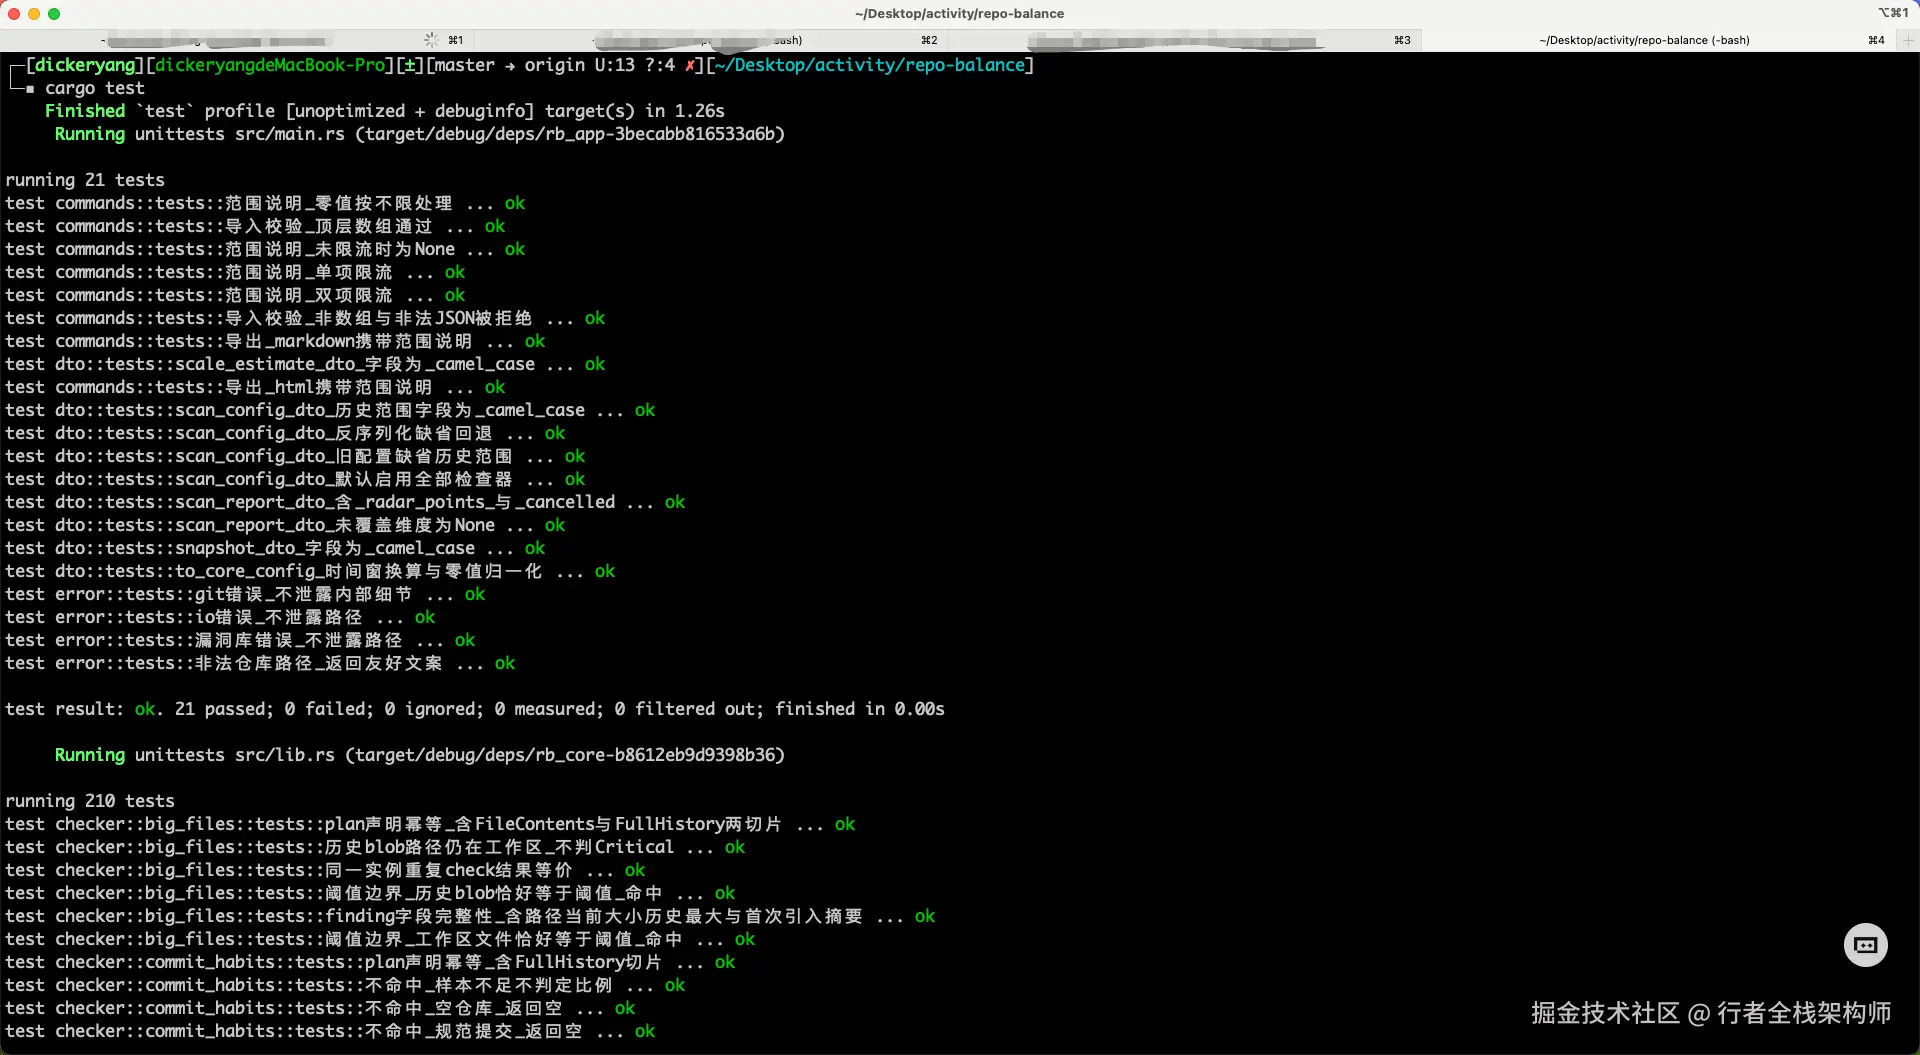
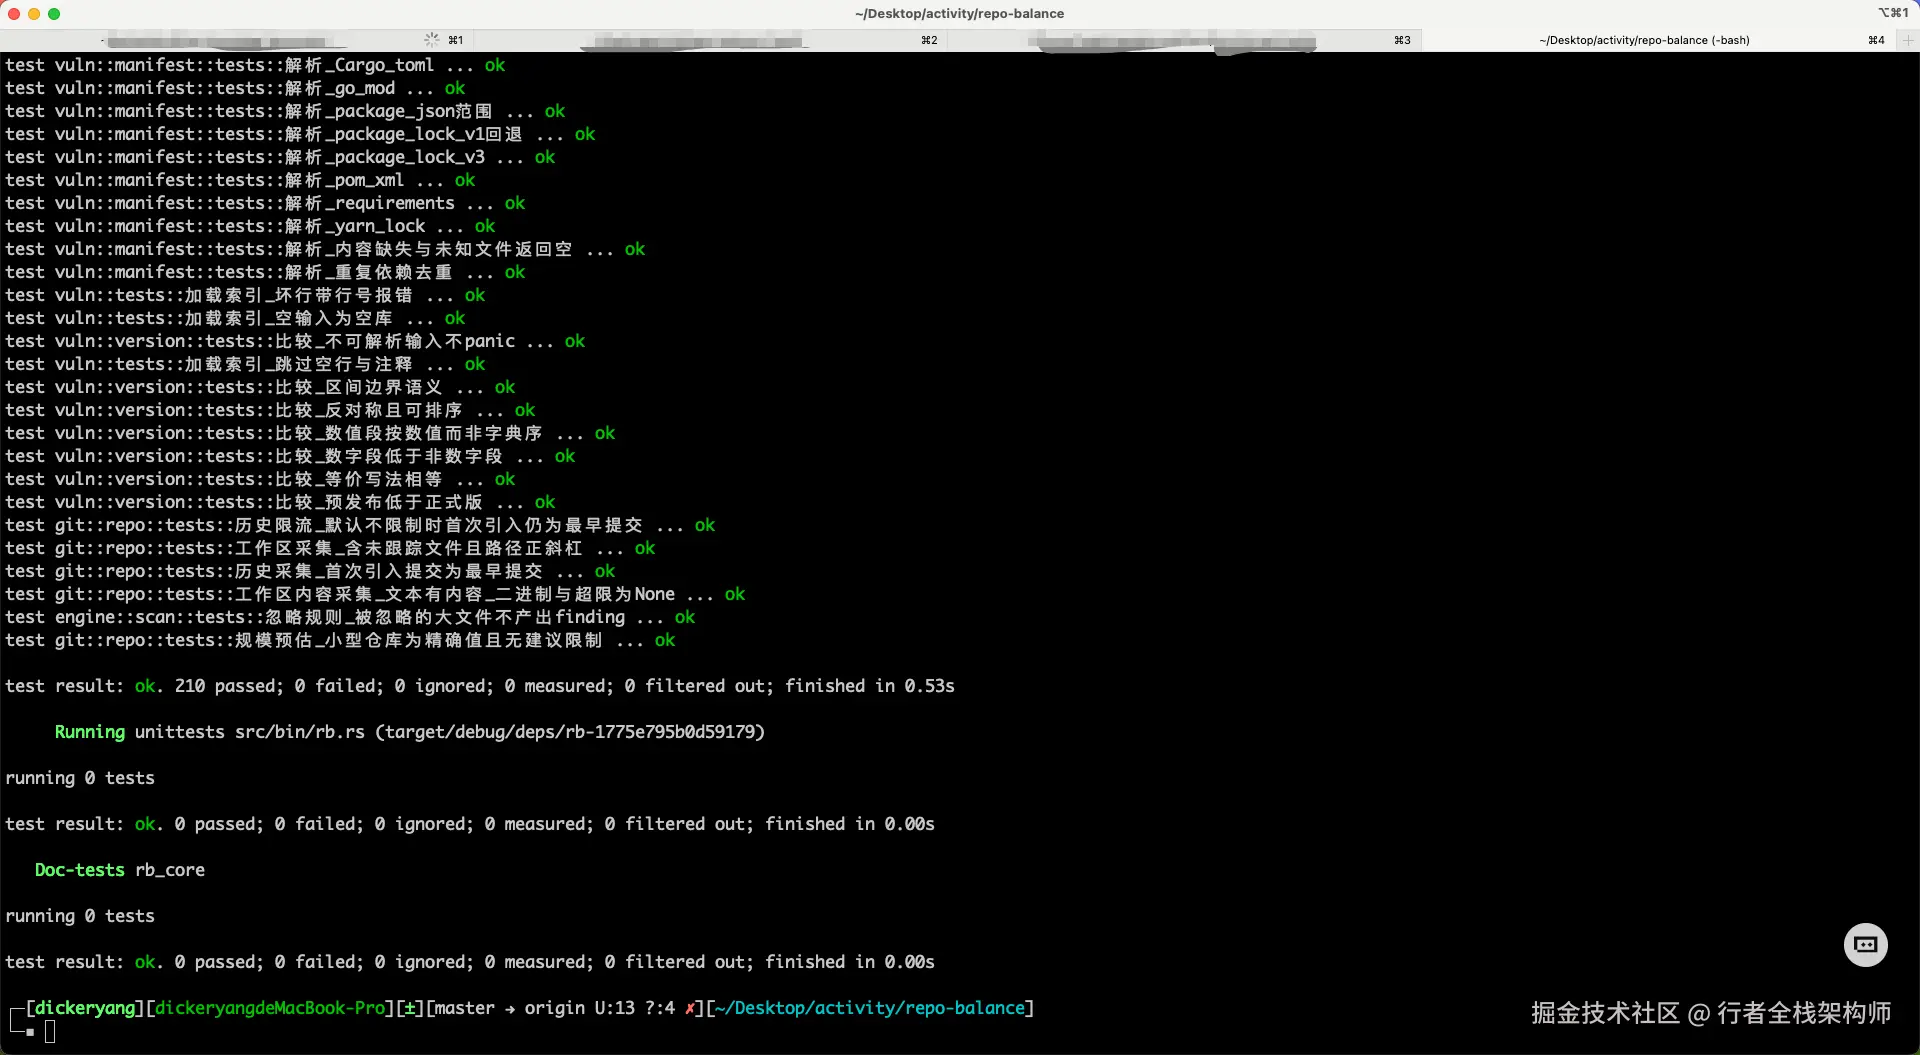
我仍然把它写进文章,因为 K3 话术是全链路里必须常备的一环:Agent 模式的推进不等于不会报错,而是报错时有固定的处理协议------贴原始报错、要求根因、要求重新验证、展示最小 diff。这套协议在之前几次迭代里多次用过(仓衡历史上十几轮 fix 提交里有它的功劳),缺了它,"全链路"就断在第一声报错上。
四、交付:从 CLI 到桌面端
最后一步是交付验证(耗时 1 分 26 秒):cargo test --workspace 全量通过(rb-core 210 条,其中 conflict_markers 占 22 条------含 3 条端到端、历史口径、限流窗口、白名单边界,git 层新增 2 条历史内容采集测试);CLI 对 demo-repo 扫出 5 条 finding,新检查项三种形态全部按预期呈现------工作区残留 conflict-left.md 记 Warning、历史残留 conflict-history.md(首次引入提交 ba6437d6)记 Info、docs/tutorial-conflict.md 被停用词白名单正确豁免。Agent 还按工程 CI 约定给出了 release 打包命令(npx tauri build,macOS 双架构对齐 build-desktop.yml)。
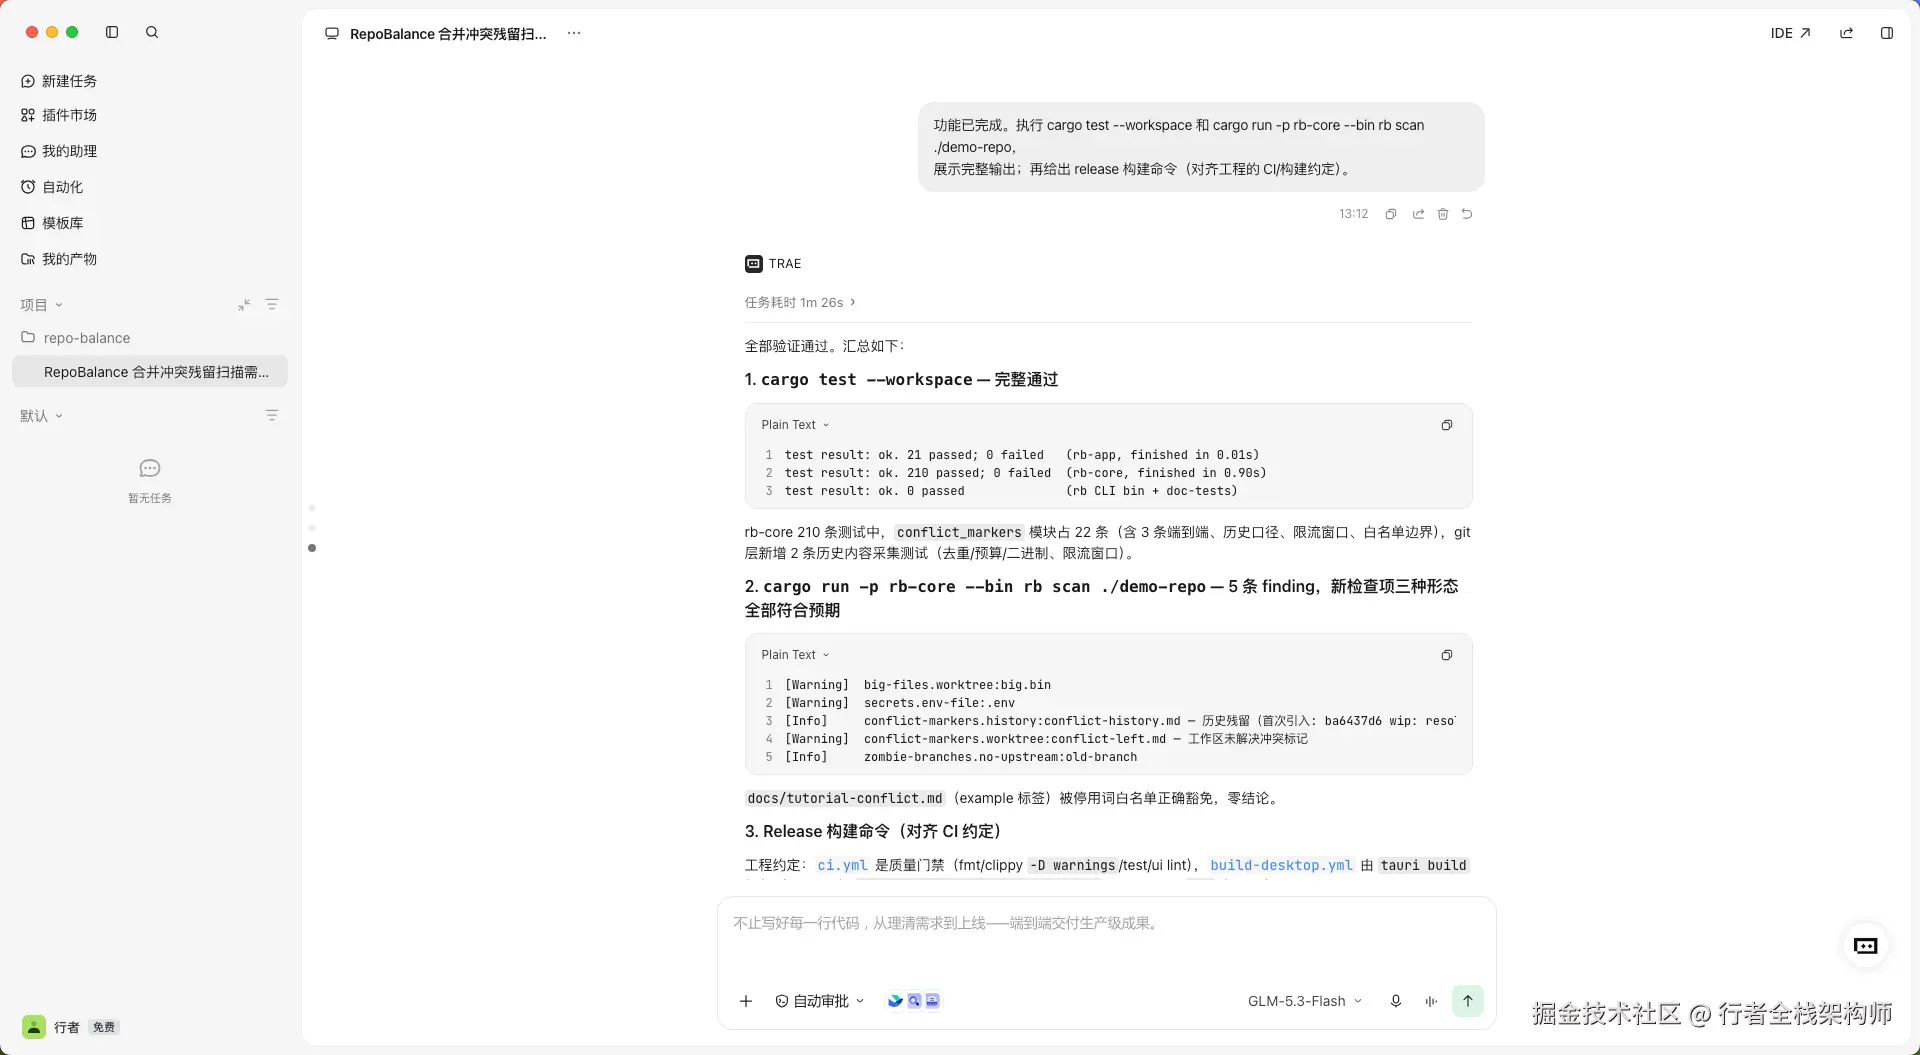
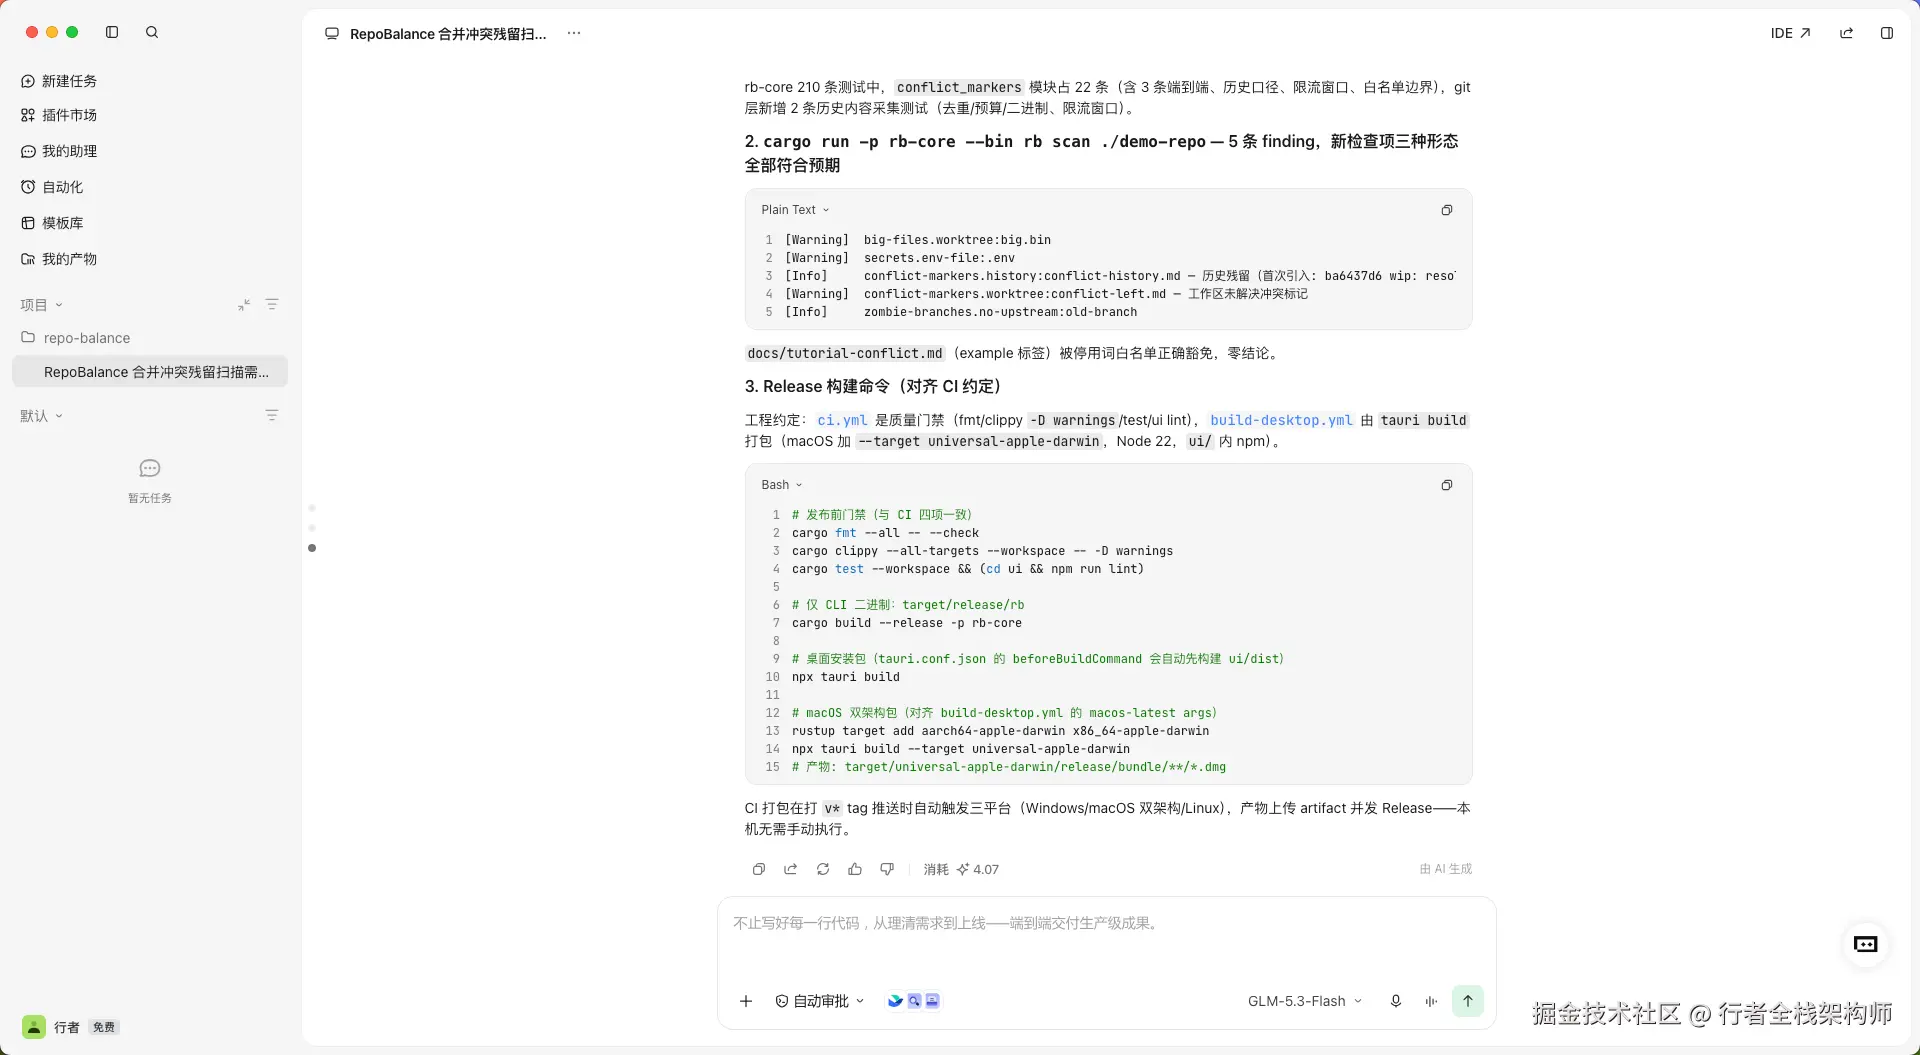
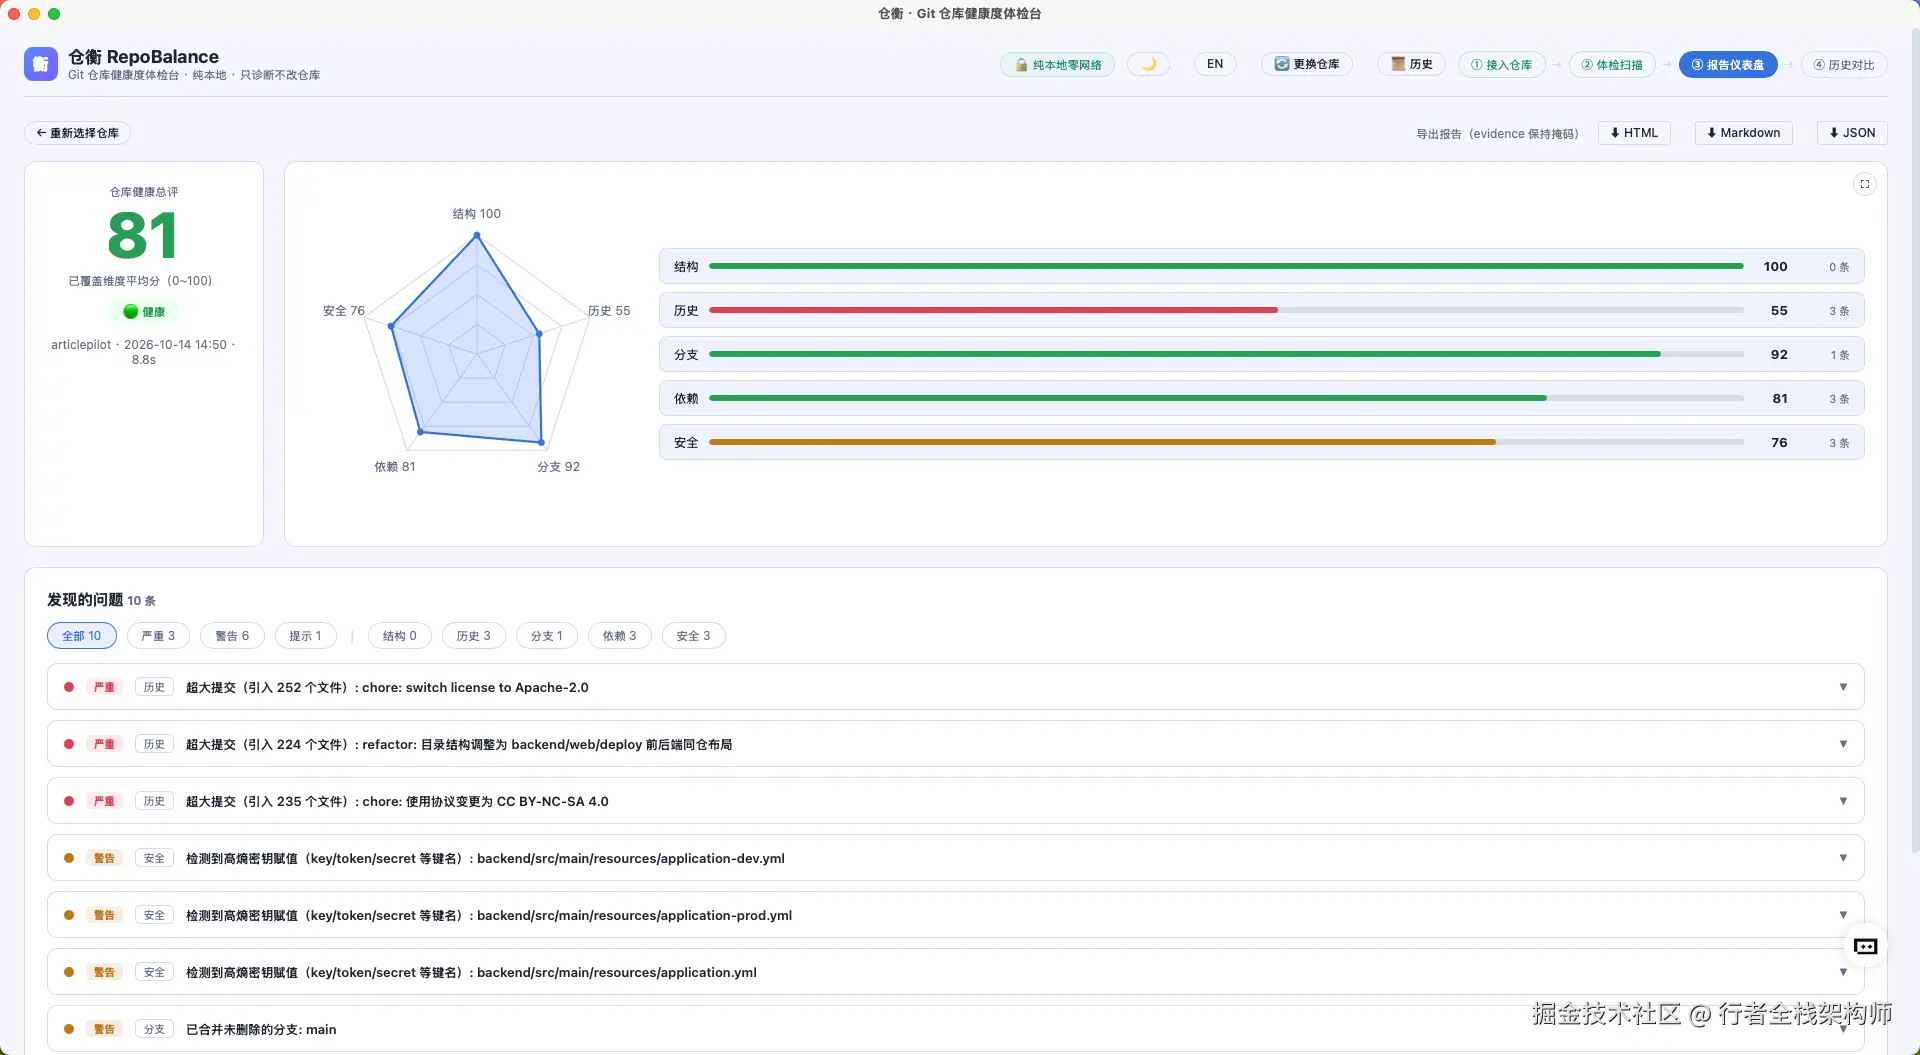
打包后实际跑了一下桌面端(Tauri 应用「仓衡 RepoBalance」),对 articlepilot 仓库做了一次完整体检:报告仪表盘给出健康总评 81 分(安全 76、历史 55、结构 100 等多维平均),共发现 10 条问题------含超大提交、疑似高熵密钥赋值(key/token/secret 键名,evidence 保持掩码)、长期未删的分支等,支持导出 Markdown / JSON。
五、效率对比
下表数据均为实测(三次对话的 TRAE 任务耗时,终端验证另计):
| 指标 | 传统方式(估计) | TRAE 全链路(实测) |
|---|---|---|
| 读现有代码摸清模式 + 需求拆解 | 半小时起步 | 6 分 44 秒 |
| 编码 + 单测 + 接入(M1~M5) | 半天到一天 | 22 分 15 秒 |
| 调试修复 | 不可预估 | 0(本轮未触发,协议常备) |
| 交付验证 + 构建方案 | 约 20 分钟 | 1 分 26 秒 |
| 总计 | 约 1 个工作日 | 约 30 分钟 |
六、踩坑实录
1. 工程惯例必须在第一句话术里说完
现象 :如果开头不约束,Agent 写出的检查函数风格对,但分级文案和错误处理习惯与工程既有代码有偏差。 根因 :Agent 只看当前对话上下文,不会主动通读 CONTRIBUTING 和全部既有检查项。 解决 :把分级风格、thiserror 错误处理、禁散落 unwrap 等约定写进首话术(或项目规则文件)。 教训:工程惯例要"喂"给 Agent,不能指望它自己考古。
2. 验收标准必须是可执行的命令
现象 :IDE 内无报错,但 cargo test 有失败。 根因 :编辑器的即时检查与 cargo 的编译/测试管线不完全一致。 解决 :约定每个里程碑以 cargo check / cargo test 通过为准。 教训:给 Agent 定的"完成"必须是命令,而不是"看起来没红"。
3. 边界情况要在拆解期问,不要在返工时补
现象 :二进制文件误扫问题如果实现后才提,返工成本翻倍。 根因 :检查类功能的一半复杂度在边界,不在主逻辑。 解决 :首话术固定包含"边界情况清单"一节。 教训:对检查引擎类需求,边界就是需求。
七、边界与结论
这次全链路里,Agent 模式确实能从想法推进到交付产物:需求拆解、分步实现、报错修复、交付验证四个环节它都在推进而不是等待。但两件事仍必须人做:一是"什么检查项值得加"的产品判断(冲突残留对仓衡用户到底多重要),二是最终验收------检查项的文案语气是否与整个工具的气质一致,Agent 给不了答案。
仓衡是一个有 CI 门禁的开源工程,这次演进全程对齐了它既有的代码风格与测试约定。全新 TRAE 让我确认了一件事:对真实工程而言,AI 的价值不在于"替你写",而在于"把一条从想法到构建产物的路,压缩成几次对话"。
仓衡 RepoBalance :开源 Git 仓库健康度体检台(Rust + Tauri 2),AtomGit G-Star 认证项目,atomgit.com/dickeryang/...