前面几篇讲了 Watermark 的原理、乱序问题处理、周期性和断点式 Watermark 生成方式,以及企业级 Watermark 案例分析。Watermark 解决了"什么时候触发窗口"的问题,但有一个场景 Watermark 本身解决不了:窗口触发后,迟到的数据怎么办?
默认情况下,窗口触发后状态立即清除,之后到达的迟到数据直接被丢弃。但生产环境中,迟到数据是常态------网络延迟、上游重试、跨地域传输都会导致数据迟到。如果直接丢弃,统计结果就会偏小,业务方不接受。
Flink 提供了 allowedLateness() 机制来解决这个问题:窗口触发后,状态不立即清除,而是再保留一段时间(allowedLateness 时长),在这段时间内到达的迟到数据会重新触发窗口计算,更新结果。这篇从本质定义、时间线可视化、三阶段对比、内部执行流程、状态生命周期、与 Watermark 的关系、完整代码实现、六个常见坑、八条最佳实践,把 AllowedLateness 一次性讲透。
一、AllowedLateness 本质定义
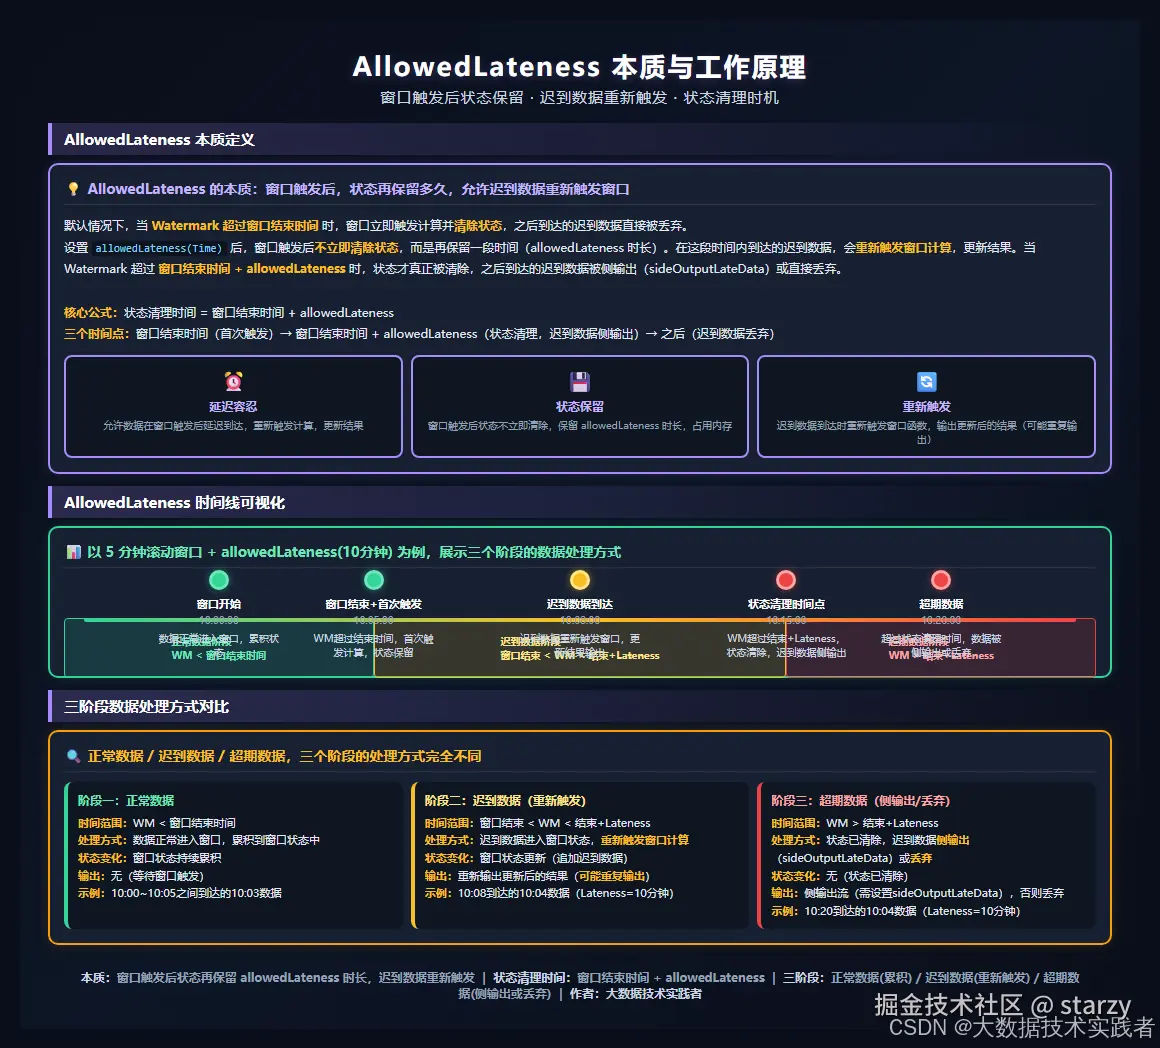
AllowedLateness 的本质一句话概括:窗口触发后,状态再保留多久,允许迟到数据重新触发窗口。
下面这张图把 AllowedLateness 的本质定义、时间线可视化、三阶段对比放在一起展示。
1.1 默认行为 vs 设置 AllowedLateness 后的行为
默认情况下(allowedLateness=0),当 Watermark 超过窗口结束时间时:
- 窗口触发计算,输出结果
- 立即清除窗口状态
- 之后到达的迟到数据直接丢弃
设置 allowedLateness(Time) 后:
- 窗口触发计算,输出结果
- 不清除状态,继续保留
- 在 allowedLateness 时长内到达的迟到数据,重新触发窗口计算,输出更新后的结果
- 当 Watermark 超过 窗口结束时间 + allowedLateness 时,状态才真正清除
- 之后到达的迟到数据,设置了 sideOutputLateData 则侧输出,否则丢弃
1.2 核心公式和三个关键时间点
核心公式: 状态清理时间 = 窗口结束时间 + allowedLateness
三个关键时间点:
- 窗口结束时间:Watermark 超过这个时间点,窗口首次触发计算
- 窗口结束时间 + allowedLateness:Watermark 超过这个时间点,状态真正清除
- 之后:迟到数据侧输出(sideOutputLateData)或直接丢弃
1.3 三大核心特点
第一,延迟容忍。 允许数据在窗口触发后延迟到达,重新触发计算,更新结果。这是 AllowedLateness 最核心的价值------处理迟到数据,保证结果准确性。
第二,状态保留。 窗口触发后状态不立即清除,保留 allowedLateness 时长。这是代价------状态保留期间持续占用内存,Lateness 越大内存占用越久。
第三,重新触发。 迟到数据到达时重新触发窗口函数,输出更新后的结果。注意是"重新输出",不是"更新之前的输出"------下游会收到多条结果,需要幂等处理或去重。
二、AllowedLateness 时间线可视化
以 5 分钟滚动窗口 + allowedLateness(10分钟) 为例,看完整的时间线:
makefile
10:00:00  窗口开始,数据正常进入窗口,累积状态
10:03:00  正常数据到达,追加到窗口状态
10:05:00  窗口结束,WM超过结束时间,首次触发计算,输出结果,状态保留(不清除)
10:08:00  迟到数据到达(事件时间10:04),追加到状态,重新触发计算,输出更新后的结果
10:12:00  又一条迟到数据到达,再次重新触发,再次输出更新结果
10:15:00  WM超过 10:05 + 10分钟 = 10:15,状态真正清除
10:20:00  超期数据到达(事件时间10:04),状态已清除,侧输出到late流或丢弃
关键观察:
- 10:05 首次触发后,状态没有清除,而是继续保留
- 10:08 和 10:12 的迟到数据都重新触发了窗口,输出了更新后的结果(下游收到 3 条结果)
- 10:15 是状态清除时间点(10:05 + 10分钟),之后到达的数据不再重新触发
- 10:20 的超期数据被侧输出或丢弃
三、三阶段数据处理方式对比
AllowedLateness 将数据处理分为三个阶段,每个阶段的处理方式完全不同:
| 阶段 | 时间范围 | 处理方式 | 状态变化 | 输出 |
|---|---|---|---|---|
| 正常数据 | WM < 窗口结束时间 | 数据正常进入窗口,累积状态 | 窗口状态持续累积 | 无(等待触发) |
| 迟到数据 | 窗口结束 < WM < 结束+Lateness | 迟到数据追加到状态,重新触发计算 | 窗口状态更新(追加迟到数据) | 重新输出更新结果(可能重复) |
| 超期数据 | WM > 结束+Lateness | 状态已清除,侧输出或丢弃 | 无(状态已清除) | 侧输出流(需设置sideOutputLateData),否则丢弃 |
重点理解第二阶段(迟到数据):
- 迟到数据到达时,窗口状态还在(因为设置了 allowedLateness)
- 迟到数据追加到窗口状态中
- 重新调用窗口函数计算,输出更新后的结果
- 每条迟到数据都可能触发一次重新计算,迟到数据多时性能开销大
- 下游会收到多条结果(首次 + 每次迟到更新),需要幂等处理
四、AllowedLateness 内部机制
理解了本质和时间线,下面深入内部机制,看 AllowedLateness 到底是怎么工作的。
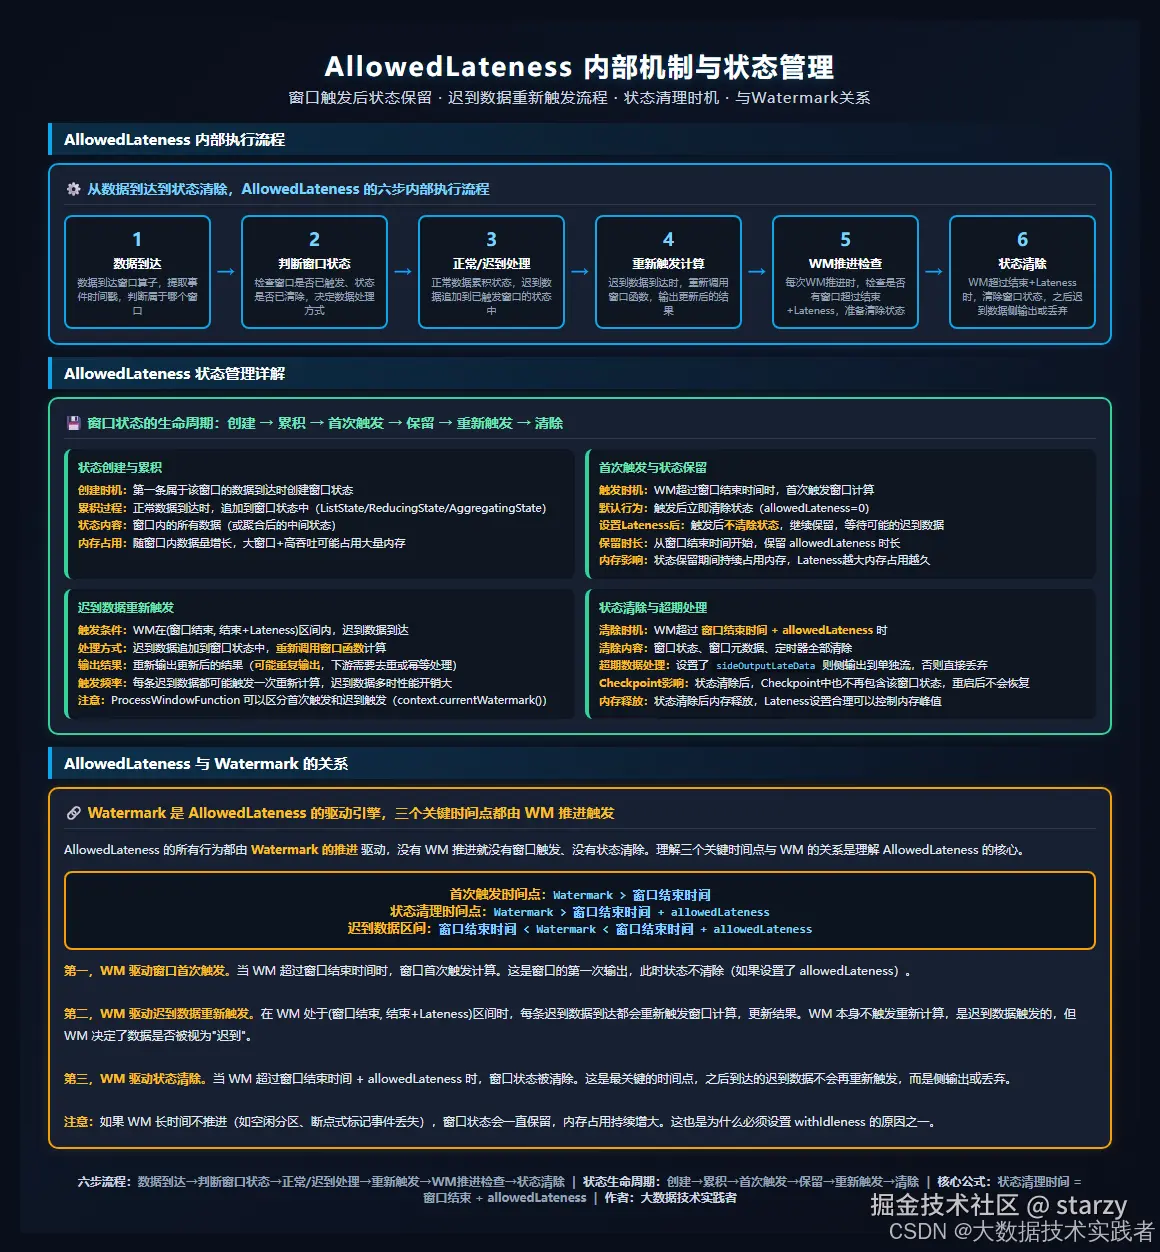
下面这张图把六步内部执行流程、状态生命周期管理、与 Watermark 的关系放在一起展示。
4.1 六步内部执行流程
从数据到达到状态清除,AllowedLateness 的完整执行流程分为六步:
第一步:数据到达。 数据到达窗口算子,提取事件时间戳,判断属于哪个窗口。如果是新窗口(第一条数据),创建窗口状态。
第二步:判断窗口状态。 检查窗口是否已触发、状态是否已清除。这一步决定了数据的处理方式:
- 窗口未触发 → 正常数据,走第三步的"正常处理"
- 窗口已触发但状态未清除(在 allowedLateness 内)→ 迟到数据,走第三步的"迟到处理"
- 窗口已触发且状态已清除(超过 allowedLateness)→ 超期数据,侧输出或丢弃
第三步:正常/迟到处理。 正常数据追加到窗口状态中累积;迟到数据也追加到窗口状态中(状态还在),但会触发第四步。
第四步:重新触发计算。 迟到数据到达时,重新调用窗口函数计算,输出更新后的结果。注意是"重新输出",不是"修改之前的输出"。
第五步:WM 推进检查。 每次 Watermark 推进时,检查是否有窗口超过了"结束时间 + allowedLateness"。如果有,准备清除这些窗口的状态。
第六步:状态清除。 Watermark 超过窗口结束时间 + allowedLateness 时,清除窗口状态、窗口元数据、定时器。之后到达的迟到数据不再重新触发,而是侧输出或丢弃。
4.2 状态生命周期管理
AllowedLateness 下,窗口状态的完整生命周期是:创建 → 累积 → 首次触发 → 保留 → 重新触发 → 清除。
状态创建与累积: 第一条属于该窗口的数据到达时创建窗口状态。正常数据到达时追加到状态中(ListState/ReducingState/AggregatingState)。状态内容是窗口内的所有数据(或聚合后的中间状态)。
首次触发与状态保留: Watermark 超过窗口结束时间时,首次触发窗口计算。默认行为是触发后立即清除状态,但设置了 allowedLateness 后,不清除状态,继续保留,等待可能的迟到数据。保留时长从窗口结束时间开始算,保留 allowedLateness 时长。
迟到数据重新触发: Watermark 在(窗口结束, 结束+Lateness)区间内,迟到数据到达时追加到窗口状态中,重新调用窗口函数计算,输出更新后的结果。每条迟到数据都可能触发一次重新计算,迟到数据多时性能开销大。ProcessWindowFunction 可以用 context.currentWatermark() > window.getEnd() 判断是否是迟到触发。
状态清除与超期处理: Watermark 超过窗口结束时间 + allowedLateness 时,窗口状态、窗口元数据、定时器全部清除。之后到达的超期数据,设置了 sideOutputLateData 则侧输出到单独流,否则直接丢弃。状态清除后,Checkpoint 中也不再包含该窗口状态,重启后不会恢复。
4.3 与 Watermark 的关系
AllowedLateness 的所有行为都由 Watermark 的推进 驱动,没有 WM 推进就没有窗口触发、没有状态清除。三个关键时间点都与 WM 相关:
- 首次触发时间点:
Watermark > 窗口结束时间 - 状态清理时间点:
Watermark > 窗口结束时间 + allowedLateness - 迟到数据区间:
窗口结束时间 < Watermark < 窗口结束时间 + allowedLateness
第一,WM 驱动窗口首次触发。 当 WM 超过窗口结束时间时,窗口首次触发计算。这是窗口的第一次输出,此时状态不清除(如果设置了 allowedLateness)。
第二,WM 决定数据是否被视为"迟到"。 WM 本身不触发重新计算,是迟到数据触发的。但 WM 决定了数据是否被视为"迟到"------如果数据的事件时间 < 当前 WM,且 WM > 窗口结束时间,这条数据就是迟到数据。
第三,WM 驱动状态清除。 当 WM 超过窗口结束时间 + allowedLateness 时,窗口状态被清除。这是最关键的时间点,之后到达的迟到数据不会再重新触发。
注意: 如果 WM 长时间不推进(如空闲分区、断点式标记事件丢失、Source 消费异常),窗口状态会一直保留,内存占用持续增大。这也是为什么必须设置 withIdleness 的原因之一。
五、AllowedLateness 完整代码实现
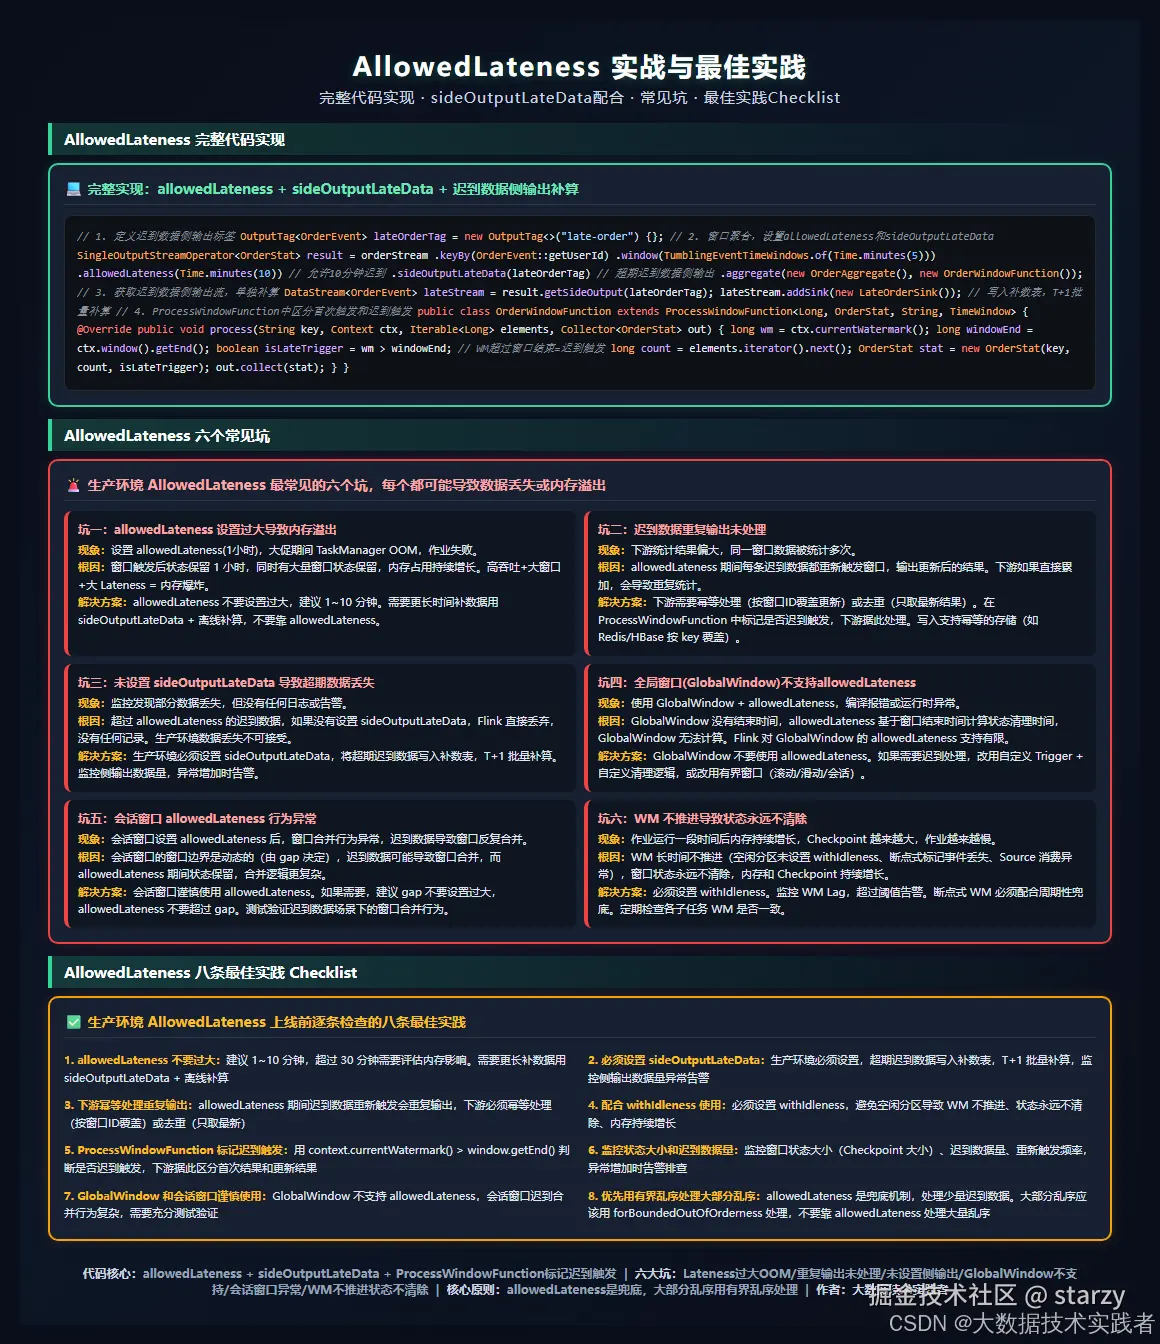
下面是一个完整的 AllowedLateness 实现,包含 allowedLateness + sideOutputLateData + 迟到数据侧输出补算 + ProcessWindowFunction 标记迟到触发。
下面这张图把完整代码实现、六个常见坑、八条最佳实践放在一起展示。
java
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.streaming.api.windowing.windows.TimeWindow;
import org.apache.flink.util.Collector;
import org.apache.flink.util.OutputTag;

import java.time.Duration;

public class AllowedLatenessExample {

    // 订单事件
    public static class OrderEvent {
        public String userId;
        public long orderId;
        public double amount;
        public long eventTime;

        public OrderEvent() {}

        public String getUserId() { return userId; }
        public long getEventTime() { return eventTime; }
    }

    // 统计结果
    public static class OrderStat {
        public String userId;
        public long count;
        public double totalAmount;
        public boolean isLateTrigger;  // 标记是否迟到触发

        public OrderStat() {}
        public OrderStat(String userId, long count, double totalAmount, boolean isLateTrigger) {
            this.userId = userId;
            this.count = count;
            this.totalAmount = totalAmount;
            this.isLateTrigger = isLateTrigger;
        }
    }

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        // 1. 定义迟到数据侧输出标签
        OutputTag<OrderEvent> lateOrderTag = new OutputTag<OrderEvent>("late-order") {};

        DataStream<OrderEvent> source = env.addSource(new OrderSource())
            .assignTimestampsAndWatermarks(
                WatermarkStrategy.<OrderEvent>forBoundedOutOfOrderness(Duration.ofSeconds(30))
                    .withIdleness(Duration.ofMinutes(1))
                    .withTimestampAssigner((event, ts) -> event.eventTime)
            );

        // 2. 窗口聚合,设置 allowedLateness 和 sideOutputLateData
        SingleOutputStreamOperator<OrderStat> result = source
            .keyBy(OrderEvent::getUserId)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))
            .allowedLateness(Time.minutes(10))  // 允许10分钟迟到
            .sideOutputLateData(lateOrderTag)    // 超期迟到数据侧输出
            .process(new OrderProcessWindowFunction());

        // 3. 获取迟到数据侧输出流,单独补算
        DataStream<OrderEvent> lateStream = result.getSideOutput(lateOrderTag);
        lateStream.addSink(new LateOrderSink());  // 写入补数表,T+1批量补算

        // 4. 主流结果输出(包含首次触发和迟到触发的结果)
        result.addSink(new OrderStatSink());

        env.execute("AllowedLateness Example");
    }

    // ProcessWindowFunction:区分首次触发和迟到触发
    public static class OrderProcessWindowFunction
        extends ProcessWindowFunction<OrderEvent, OrderStat, String, TimeWindow> {

        @Override
        public void process(String key, Context ctx, Iterable<OrderEvent> elements,
                            Collector<OrderStat> out) {
            // 判断是否迟到触发:WM超过窗口结束时间 = 迟到触发
            long currentWatermark = ctx.currentWatermark();
            long windowEnd = ctx.window().getEnd();
            boolean isLateTrigger = currentWatermark > windowEnd;

            // 统计
            long count = 0;
            double totalAmount = 0.0;
            for (OrderEvent event : elements) {
                count++;
                totalAmount += event.amount;
            }

            // 输出结果,标记是否迟到触发
            out.collect(new OrderStat(key, count, totalAmount, isLateTrigger));
        }
    }
}
代码关键点:
-
OutputTag 定义 :
new OutputTag<OrderEvent>("late-order") {},注意必须用匿名类(带{}),因为 OutputTag 是泛型类,需要类型信息。 -
allowedLateness 设置 :
.allowedLateness(Time.minutes(10)),允许 10 分钟迟到。窗口触发后状态保留 10 分钟,期间迟到数据重新触发。 -
sideOutputLateData 设置 :
.sideOutputLateData(lateOrderTag),超过 allowedLateness 的迟到数据侧输出到late-order标签流,不直接丢弃。 -
获取侧输出流 :
result.getSideOutput(lateOrderTag),获取迟到数据流,单独写入补数表,T+1 批量补算。 -
ProcessWindowFunction 标记迟到触发 :用
ctx.currentWatermark() > ctx.window().getEnd()判断是否是迟到触发。WM 超过窗口结束时间 = 迟到触发,WM 未超过 = 首次触发。下游可以根据isLateTrigger字段区分首次结果和更新结果,做幂等处理。
六、sideOutputLateData 配合使用
sideOutputLateData 是 AllowedLateness 的最佳搭档,两者配合使用形成"三层迟到数据处理方案":
第一层:有界乱序(forBoundedOutOfOrderness)。 处理大部分正常范围内的乱序数据,数据在乱序容忍时间内到达,正常进入窗口触发计算。这是主力,处理 95% 以上的数据。
第二层:allowedLateness。 处理少量迟到数据,窗口触发后状态保留一段时间,迟到数据重新触发窗口计算,更新结果。这是兜底,处理 4~5% 的迟到数据。
第三层:sideOutputLateData。 处理超过 allowedLateness 的超期数据,侧输出到单独流,写入补数表,T+1 批量补算。这是最后防线,处理 1% 以内的超期数据,保证不丢数据。
java
// 三层迟到数据处理方案完整配置
WatermarkStrategy<OrderEvent> strategy = WatermarkStrategy
    .<OrderEvent>forBoundedOutOfOrderness(Duration.ofSeconds(30))  // 第一层:30秒乱序容忍
    .withIdleness(Duration.ofMinutes(1));

SingleOutputStreamOperator<OrderStat> result = source
    .assignTimestampsAndWatermarks(strategy)
    .keyBy(OrderEvent::getUserId)
    .window(TumblingEventTimeWindows.of(Time.minutes(5)))
    .allowedLateness(Time.minutes(10))  // 第二层:10分钟迟到重新触发
    .sideOutputLateData(lateOrderTag)    // 第三层:超期数据侧输出补算
    .process(new OrderProcessWindowFunction());

// 第三层:超期数据补算
result.getSideOutput(lateOrderTag).addSink(new LateOrderSink());
生产环境建议三层都配置,这样既能保证低延迟(有界乱序正常触发),又能保证结果准确(allowedLateness 重新触发更新),还能保证不丢数据(sideOutputLateData 补算)。
七、六个常见坑
7.1 坑一:allowedLateness 设置过大导致内存溢出
现象: 设置 allowedLateness(1小时),大促期间 TaskManager OOM,作业失败。
根因: 窗口触发后状态保留 1 小时,同时有大量窗口状态保留,内存占用持续增长。高吞吐 + 大窗口 + 大 Lateness = 内存爆炸。假设 5 分钟窗口、10 万 QPS、每条数据 1KB,1 小时 Lateness 意味着同时保留 12 个窗口的状态,每个窗口 3000 万条数据,状态大小约 30GB(未压缩),OOM 是必然的。
解决方案: allowedLateness 不要设置过大,建议 1~10 分钟。需要更长时间补数据用 sideOutputLateData + 离线补算,不要靠 allowedLateness。allowedLateness 是兜底机制,处理少量迟到数据,不是主力。
7.2 坑二:迟到数据重复输出未处理
现象: 下游统计结果偏大,同一窗口数据被统计多次。
根因: allowedLateness 期间每条迟到数据都重新触发窗口,输出更新后的结果。下游如果直接累加,会导致重复统计。例如首次触发输出 count=100,迟到数据到达后重新触发输出 count=105,下游如果两条都累加,结果变成 205,而正确结果是 105。
解决方案: 下游需要幂等处理(按窗口 ID 覆盖更新)或去重(只取最新结果)。在 ProcessWindowFunction 中用 isLateTrigger 标记是否迟到触发,下游据此处理。写入支持幂等的存储(如 Redis/HBase 按 key 覆盖),不要写入只支持追加的存储(如普通文件、Kafka 直接消费累加)。
7.3 坑三:未设置 sideOutputLateData 导致超期数据丢失
现象: 监控发现部分数据丢失,但没有任何日志或告警。
根因: 超过 allowedLateness 的迟到数据,如果没有设置 sideOutputLateData,Flink 直接丢弃,没有任何记录。生产环境数据丢失不可接受,尤其是金融、计费等场景。
解决方案: 生产环境必须设置 sideOutputLateData,将超期迟到数据写入补数表,T+1 批量补算。监控侧输出数据量,异常增加时告警(可能是上游补数据或乱序容忍设置过小)。
7.4 坑四:GlobalWindow 不支持 allowedLateness
现象: 使用 GlobalWindow + allowedLateness,编译报错或运行时异常。
根因: GlobalWindow 没有结束时间(全局窗口,永远不结束,除非 Trigger 触发),allowedLateness 基于窗口结束时间计算状态清理时间,GlobalWindow 无法计算。Flink 对 GlobalWindow 的 allowedLateness 支持有限。
解决方案: GlobalWindow 不要使用 allowedLateness。如果需要迟到处理,改用自定义 Trigger + 自定义清理逻辑,或改用有界窗口(滚动/滑动/会话)。GlobalWindow 适合全局聚合(如累计 GMV),不需要事件时间窗口,用 ProcessingTime 更合适。
7.5 坑五:会话窗口 allowedLateness 行为异常
现象: 会话窗口设置 allowedLateness 后,窗口合并行为异常,迟到数据导致窗口反复合并。
根因: 会话窗口的窗口边界是动态的(由 gap 决定),迟到数据可能导致窗口合并(两个会话窗口之间的 gap 被迟到数据填充,合并为一个窗口)。而 allowedLateness 期间状态保留,合并逻辑更复杂,可能导致窗口反复合并、重复触发。
解决方案: 会话窗口谨慎使用 allowedLateness。如果需要,建议 gap 不要设置过大,allowedLateness 不要超过 gap。测试验证迟到数据场景下的窗口合并行为,确认符合预期。会话窗口本身比滚动/滑动窗口复杂,加上 allowedLateness 更复杂,能不用就不用。
7.6 坑六:WM 不推进导致状态永远不清除
现象: 作业运行一段时间后内存持续增长,Checkpoint 越来越大,作业越来越慢。
根因: WM 长时间不推进(空闲分区未设置 withIdleness、断点式标记事件丢失、Source 消费异常),窗口状态永远不清除(因为状态清除由 WM 推进驱动),内存和 Checkpoint 持续增长。这是生产环境最隐蔽的坑------作业看起来正常,但内存慢慢涨,最后 OOM。
解决方案: 必须设置 withIdleness。监控 WM Lag,超过阈值告警。断点式 WM 必须配合周期性兜底。定期检查各子任务 WM 是否一致,发现异常及时排查。
八、八条最佳实践 Checklist
上线前逐条检查:
-
allowedLateness 不要过大: 建议 1~10 分钟,超过 30 分钟需要评估内存影响。需要更长补数据用 sideOutputLateData + 离线补算,不要靠 allowedLateness。
-
必须设置 sideOutputLateData: 生产环境必须设置,超期迟到数据写入补数表,T+1 批量补算。监控侧输出数据量,异常增加时告警。
-
下游幂等处理重复输出: allowedLateness 期间迟到数据重新触发会重复输出,下游必须幂等处理(按窗口 ID 覆盖)或去重(只取最新)。写入支持幂等的存储。
-
配合 withIdleness 使用: 必须设置 withIdleness,避免空闲分区导致 WM 不推进、状态永远不清除、内存持续增长。
-
ProcessWindowFunction 标记迟到触发: 用
context.currentWatermark() > window.getEnd()判断是否迟到触发,下游据此区分首次结果和更新结果,做不同处理。 -
监控状态大小和迟到数据量: 监控窗口状态大小(Checkpoint 大小)、迟到数据量、重新触发频率,异常增加时告警排查。
-
GlobalWindow 和会话窗口谨慎使用: GlobalWindow 不支持 allowedLateness,会话窗口迟到合并行为复杂,需要充分测试验证。能用滚动/滑动窗口就不用这两个。
-
优先用有界乱序处理大部分乱序: allowedLateness 是兜底机制,处理少量迟到数据。大部分乱序应该用 forBoundedOutOfOrderness 处理,不要靠 allowedLateness 处理大量乱序。三层方案:有界乱序(主力)→ allowedLateness(兜底)→ sideOutputLateData(最后防线)。
九、总结与下一篇预告
AllowedLateness 深度剖析要点回顾:
第一,本质:窗口触发后状态再保留 allowedLateness 时长,允许迟到数据重新触发窗口计算,更新结果。核心公式:状态清理时间 = 窗口结束时间 + allowedLateness。三大特点:延迟容忍、状态保留、重新触发。
第二,时间线:以 5 分钟窗口 + 10 分钟 Lateness 为例,10:05 首次触发(状态保留)→ 10:08/10:12 迟到数据重新触发(重复输出)→ 10:15 状态清除(10:05+10分钟)→ 10:20 超期数据侧输出或丢弃。
第三,三阶段对比:正常数据(WM < 窗口结束,累积状态,无输出)→ 迟到数据(结束 < WM < 结束+Lateness,重新触发,重复输出)→ 超期数据(WM > 结束+Lateness,侧输出或丢弃)。
第四,内部六步流程:数据到达 → 判断窗口状态 → 正常/迟到处理 → 重新触发计算 → WM 推进检查 → 状态清除。
第五,状态生命周期:创建 → 累积 → 首次触发 → 保留 → 重新触发 → 清除。设置 allowedLateness 后,首次触发不清除状态,保留到 WM 超过结束+Lateness 才清除。
第六,与 WM 的关系:所有行为由 WM 推进驱动。首次触发(WM > 结束)、迟到区间(结束 < WM < 结束+Lateness)、状态清除(WM > 结束+Lateness)。WM 不推进则状态永远不清除。
第七,完整代码实现:OutputTag 定义 + allowedLateness + sideOutputLateData + getSideOutput 补算 + ProcessWindowFunction 标记迟到触发(currentWatermark() > window.getEnd())。
第八,三层迟到处理方案:有界乱序(主力,处理 95%)→ allowedLateness(兜底,处理 4~5%)→ sideOutputLateData(最后防线,处理 1%,T+1 补算)。
第九,六个常见坑:Lateness 过大 OOM、重复输出未处理、未设置侧输出丢数据、GlobalWindow 不支持、会话窗口合并异常、WM 不推进状态不清除。
第十,八条最佳实践:Lateness 不要过大、必须设置侧输出、下游幂等处理、配合 withIdleness、标记迟到触发、监控状态大小、GlobalWindow/会话窗口谨慎用、优先有界乱序处理大部分乱序。
AllowedLateness 是 Flink 迟到数据处理的核心机制,但它是兜底机制,不是主力。生产环境的正确做法是:优先用有界乱序处理大部分乱序,allowedLateness 处理少量迟到,sideOutputLateData 处理超期数据补算,三层配合,既保证低延迟,又保证结果准确,还保证不丢数据。