目录
[一、认识 ORM 与 SQLAlchemy](#一、认识 ORM 与 SQLAlchemy)
[1. 什么是 ORM](#1. 什么是 ORM)
[2. 为什么 FastAPI 不自带 ORM](#2. 为什么 FastAPI 不自带 ORM)
[3. SQLAlchemy 架构与 2.x 规范](#3. SQLAlchemy 架构与 2.x 规范)
[二、配置数据库连接与 Session](#二、配置数据库连接与 Session)
[1. 创建数据库 Engine](#1. 创建数据库 Engine)
[2. 创建 Session 工厂](#2. 创建 Session 工厂)
[3. 通过依赖注入管理 Session](#3. 通过依赖注入管理 Session)
[三、定义 SQLAlchemy ORM 模型](#三、定义 SQLAlchemy ORM 模型)
[1. 使用 SQLAlchemy 2.x 定义 Model](#1. 使用 SQLAlchemy 2.x 定义 Model)
[2. 语法拆解与声明语义](#2. 语法拆解与声明语义)
[3. 初始化数据库表](#3. 初始化数据库表)
[四、数据库操作与 Pydantic Schema](#四、数据库操作与 Pydantic Schema)
[1. 插入数据](#1. 插入数据)
[2. 为什么需要区分 ORM Model 与 Pydantic Schema](#2. 为什么需要区分 ORM Model 与 Pydantic Schema)
[3. 设计分层 Pydantic Schema](#3. 设计分层 Pydantic Schema)
[4. 完整的接口数据架构](#4. 完整的接口数据架构)
[五、使用 APIRouter 组织数据库 API](#五、使用 APIRouter 组织数据库 API)
[1. 什么是 APIRouter](#1. 什么是 APIRouter)
[2. 定义并注册 APIRouter](#2. 定义并注册 APIRouter)
[2.1 编写路由模块(app/routers/users.py)](#2.1 编写路由模块(app/routers/users.py))
[2.2 在主应用中挂载 Router(app/main.py)](#2.2 在主应用中挂载 Router(app/main.py))
[3. 推荐的项目架构目录](#3. 推荐的项目架构目录)
[六、认识 Alembic 数据库迁移](#六、认识 Alembic 数据库迁移)
[1. 为什么需要数据库迁移工具](#1. 为什么需要数据库迁移工具)
[2. 初始化 Alembic 环境](#2. 初始化 Alembic 环境)
[3. 配置 env.py 与关联 ORM Metadata](#3. 配置 env.py 与关联 ORM Metadata)
[1. 生成迁移脚本](#1. 生成迁移脚本)
[2. 迁移脚本结构](#2. 迁移脚本结构)
[3. 执行迁移](#3. 执行迁移)
[4. 底层版本记录机制](#4. 底层版本记录机制)
一、认识 ORM 与 SQLAlchemy
在现代 Web 应用程序中,后端开发离不开数据的持久化存储。编写原始 SQL 语句直接操作数据库虽然性能高效,但在复杂的业务逻辑中容易导致 SQL 注入风险、缺乏类型检查等难题
为了在面向对象编程语言与关系型数据库(如 PostgreSQL、MySQL、SQLite)之间建立桥梁,ORM(对象关系映射) 应运而生
1. 什么是 ORM
在传统的数据库交互模式中,开发者需要手写 SQL 字符串传递给数据库驱动执行,并将返回的原始元组或字典手动映射为 Python 中的数据结构:
    Python Application
            │
            ▼
      编写 SQL 字符串
            │
            ▼
         数据库引擎
            │
            ▼
        返回原始数据
ORM(Object Relational Mapping,对象关系映射) 是一种程序设计。它通过将关系型数据库中的数据表结构映射为面向对象语言中的类,使开发者能够直接使用 Python 代码来完成数据库的增删改查操作,而无需直接编写 SQL 字符串
三者的映射对应关系如下:
Python Class (类)       <───>   Database Table (数据表)

Python Instance (对象)  <───>   Database Row (数据行)

Class Attribute (属性)  <───>   Table Column (列/字段)
例如,定义一个简单的 Python 类:
python
class User:
    id: int
    username: str
    email: str
在 ORM 机制下,该类即直接对应数据库中的 users 数据表,类的每个实例(如 user = User(...))则对应表中的某一行记录
ORM 并不是让数据库不再使用 SQL
ORM 的底层依然会根据 Python 对象的逻辑状态改变,动态编译并生成对应的标准 SQL 语句,交给数据库引擎执行。它提供的是一套面向对象的 "交互接口",而非替代数据库的底层执行机制
2. 为什么 FastAPI 不自带 ORM
在部分全栈 Web 框架(如 Django)中,内置 ORM 被视作框架的一部分。然而,FastAPI 被设计为一个高度解耦、专注且轻量化的 Web API 框架
FastAPI 的核心职责聚焦于:
-
HTTP 请求处理与路由分发
-
基于 Pydantic 的数据校验与序列化
-
OpenAPI 交互式文档生成
-
基于 Depends 的依赖注入系统
把数据持久化层与 Web 框架本身剥离,使开发者可以根据业务需求自由选择最合适的数据库访问工具:
-
关系型数据库 ORM:SQLAlchemy 、SQLModel 、Tortoise-ORM
-
轻量级/原始 SQL 驱动:asyncpg 、psycopg3 、sqlite3
-
NoSQL 驱动:Motor (MongoDB)、redis-py
3. SQLAlchemy 架构与 2.x 规范
在 Python 生态中,SQLAlchemy 是最为成熟、功能最强大的 ORM 框架。SQLAlchemy 内部采用了分层设计:
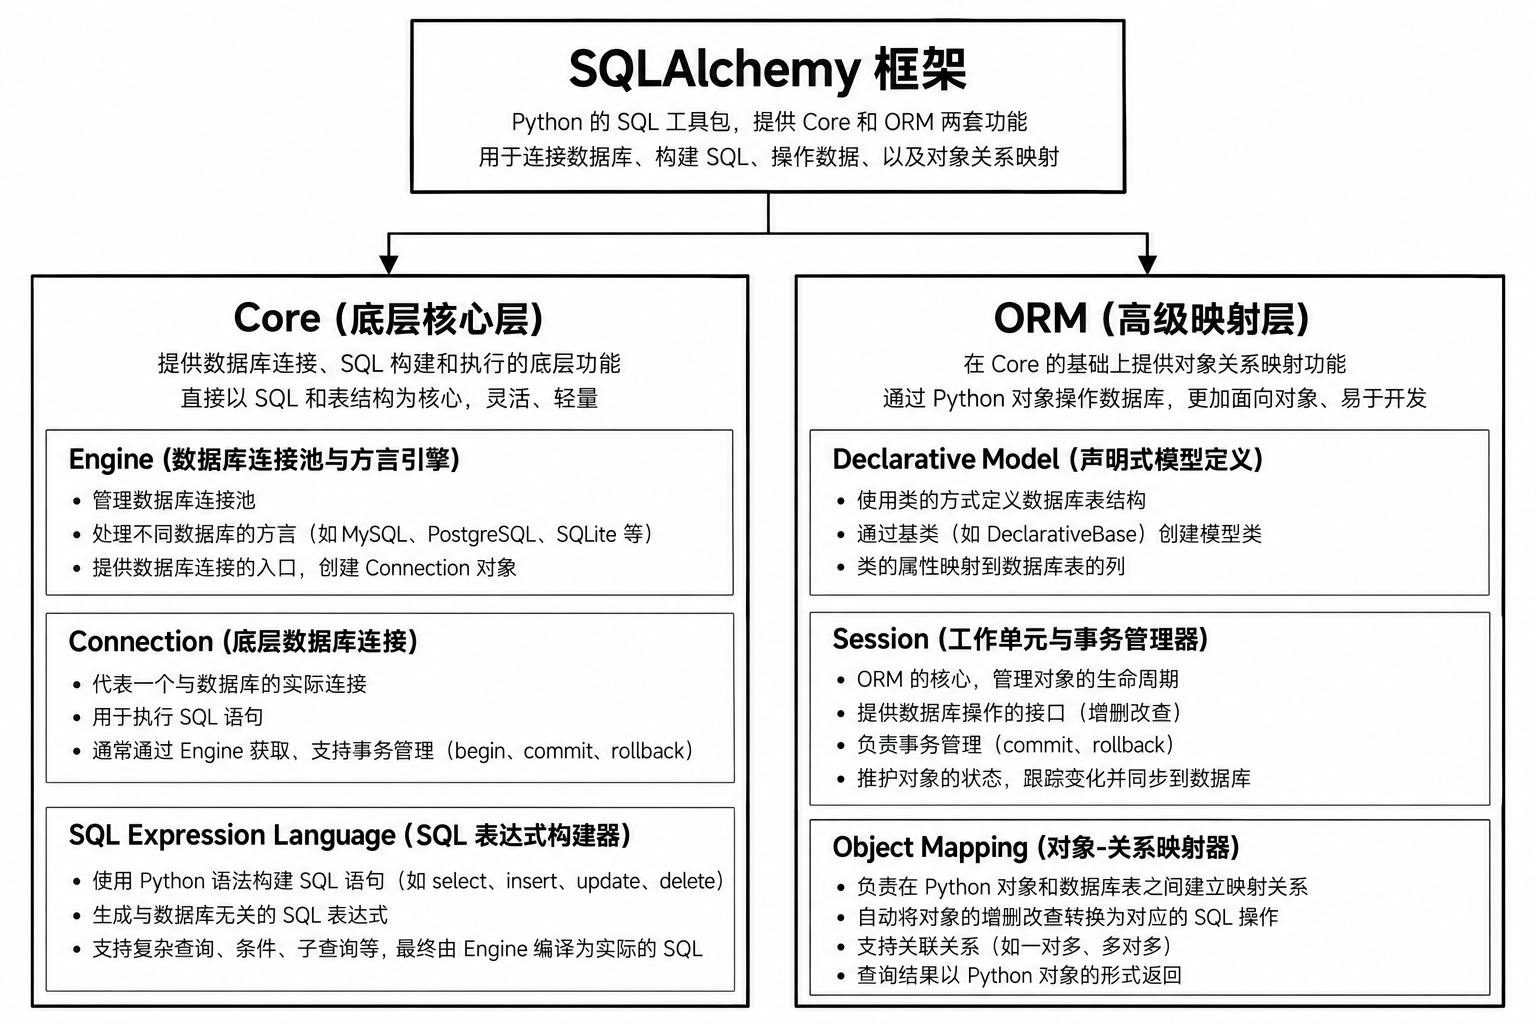
SQLAlchemy 2.0 编程规范强调
SQLAlchemy 在 2.0 版本进行了架构重构。为了避免混淆旧教程中的过时语法,本系列将全程采用 SQLAlchemy 2.x 的现代化 API 写法:
-
采用 Mapped 和 mapped_column() 进行类型安全的类型提示与字段定义,废弃旧版的 Column()
-
采用 select 与 session.execute() 进行类型明确的查询,废弃旧版的 session.query 模式
-
采用 DeclarativeBase 作为全局模型的统一基类,废弃旧版的 declarative_base() 函数
二、配置数据库连接与 Session
在基于 SQLAlchemy 的应用中,操作数据库的第一步是建立与底层数据库引擎的连接,并建立可以安全投递到单个 HTTP 请求上下文中的会话(Session)管理机制
1. 创建数据库 Engine
Engine(引擎)是 SQLAlchemy 框架与实际数据库通信的核心枢纽。它负责维护底层连接池以及处理特定数据库方言(Dialect,如 PostgreSQL、MySQL、SQLite)的 SQL 翻译
python
from sqlalchemy import create_engine

# 数据库连接 URL 示例(此处以 SQLite 本地文件为例)
SQLALCHEMY_DATABASE_URL = "sqlite:///./sql_app.db"

# 创建全局 Engine 实例
engine = create_engine(
    SQLALCHEMY_DATABASE_URL,
    connect_args={"check_same_thread": False}  # SQLite 专属参数,允许单线程外复用连接
)
DATABASE_URL 的通用组成结构
标准的数据库连接字符串按照如下格式拼接:
python
dialect+driver://username:password@host:port/database_name例如:
-
PostgreSQL: postgresql+psycopg2://user:password@localhost:5432/my_db
-
MySQL: mysql+pymysql://user:password@localhost:3306/my_db
Engine 的底层职责
-
DBAPI 驱动隔离:负责调度 Python 原生数据库驱动
-
连接池控制:避免每个 HTTP 请求都重新建立高成本的数据库 TCP握手连接,Engine 内部维护着一个复用连接池。当请求结束时,连接并不销毁,而是归还给连接池等待下一个请求复用
2. 创建 Session 工厂
在 SQLAlchemy 中,所有的数据库读写与实体状态追踪都发生在 Session 内部。为了标准化创建 Session 对象,通常需要先构造一个 sessionmaker 工厂
python
from sqlalchemy.orm import sessionmaker

# 定义 SessionLocal 工厂类
SessionLocal = sessionmaker(
    bind=engine,
    autoflush=False,
    expire_on_commit=False
)
工厂配置参数
-
bind=engine:将会话工厂绑定至刚才创建的数据库引擎
-
autoflush=False:禁用自动刷新。防止在执行查询前,SQLAlchemy 擅自将尚未准备好的待修改数据提前刷入数据库
-
expire_on_commit=False:在事务提交后,ORM 对象的属性不会被自动标记为过期。这样在 API 响应返回阶段访问 ORM 对象字段时,就不会重新触发额外的 SQL 延迟查询
| 组件概念 | 生命周期类型 | 核心职责 |
|---|---|---|
| Engine | 单例(全局共享,随应用启动) | 维护底层数据库连接池与数据库方言转换 |
| sessionmaker | 单例(全局共享) | 作为生产 Session 实例的工程制造工厂 |
| Session | 短生命周期(请求级/任务级) | 表示一次独立的工作单元,跟踪内部 ORM 对象的变更与事务 |
3. 通过依赖注入管理 Session
在 Web 接口中,每个 HTTP 请求都需要独立建立一个 Session,并在请求处理结束(无论成功或发生异常)后强制关闭该 Session
这非常适合结合第二篇的 Depends() 与 yield 上下文生命周期管理:
python
from typing import Generator
from sqlalchemy.orm import Session

# 数据库会话依赖项
def get_db() -> Generator[Session, None, None]:
    db = SessionLocal()
    try:
        yield db  # 将 Session 实体注入到路径操作函数中
    finally:
        db.close()  # HTTP 响应返回后,确保关闭会话并把连接还给连接池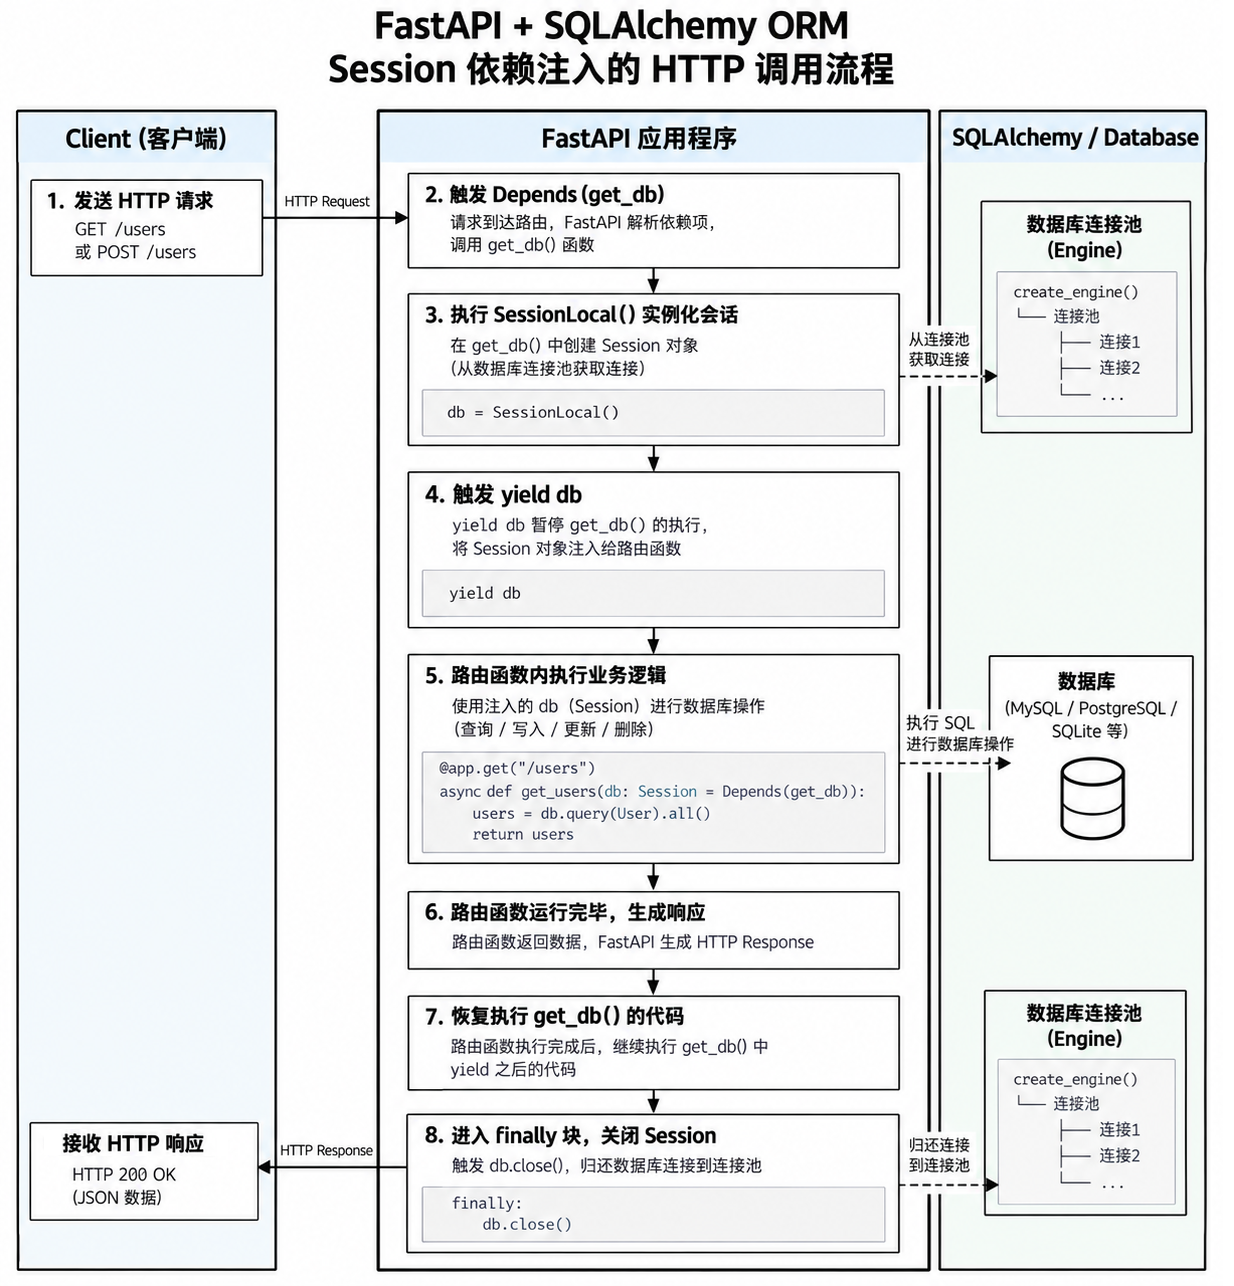
commit()、rollback() 与 close() 的分工
开发者容易将 close() 误认为会自动提交修改,需特别注意:
-
commit():显式提交事务,将当前会话中记录的所有数据新增、更新与删除真正持久化写入数据库
-
rollback():放弃并回滚当前未提交的事务,将会话恢复到最初状态(通常在捕获到业务异常时主动调用)
-
close() :仅关闭当前会话并清空内部内存缓存,同时把数据库连接放回 Engine 连接池。如果在调用 close() 时存在未 commit() 的数据修改,未提交的更改将被默认回滚
三、定义 SQLAlchemy ORM 模型
配置好数据库连接后,我们需要通过 Python 代码定义数据表的结构。在 SQLAlchemy 2.x 中,推荐使用带有类型提示的现代声明式写法定义 ORM 模型
1. 使用 SQLAlchemy 2.x 定义 Model
首先定义全局基类 Base,随后继承该基类来创建具体的数据库实体模型类:
python
from datetime import datetime
from sqlalchemy import String, func
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column


# 1. 定义全局 ORM 基类
class Base(DeclarativeBase):
    pass


# 2. 定义 User 实体模型
class User(Base):
    __tablename__ = "users"  # 映射到数据库中的表名

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, index=True, nullable=False)
    email: Mapped[str] = mapped_column(String(100), unique=True, index=True, nullable=False)
    is_active: Mapped[bool] = mapped_column(default=True)
    created_at: Mapped[datetime] = mapped_column(server_default=func.now())
2. 语法拆解与声明语义
在上述现代语法中,各个组件发挥着不同的作用:
-
DeclarativeBase:所有 ORM 模型类的公共基类。它内部维护着一个 metadata(元数据对象),用于收集并追踪所有继承自它的模型表定义
-
tablename:必填类属性。明确指定当前 Python 类所映射的真实数据库数据表名称
-
MappedT:Python 静态类型提示工具。它声明了当前属性在 Python 层面的变量类型(如 int、str),不仅让 IDE 能够提供完美的类型推断与代码补全,还显式表达了该属性是否可为空(如 Mappedstr \| None 表示该列允许为 NULL)
-
mapped_column():描述底层数据库数据列的具体约束条件与特征:
-
primary_key=True:将该列标记为主键(Primary Key)
-
unique=True / index=True:在数据库对应列上自动建立唯一约束(UNIQUE)与索引(INDEX)
-
nullable=False:限制该列在数据库层面不能为空(NOT NULL)
-
server_default / default:default 是 Python 内部生成的默认值;而 server_default=func.now() 则是在建表 DDL 中生成数据库原生的 DEFAULT CURRENT_TIMESTAMP 约束,由数据库引擎自动填充时间戳
-
3. 初始化数据库表
定义好 ORM 模型后,可以通过 Base.metadata.create_all() 强制要求 SQLAlchemy 根据模型元信息向数据库下发 DDL 语句,自动创建未存在的数据表:
python
from app.database import engine
from app.models import Base

# 检查所有继承 Base 的模型,并在数据库中创建对应的数据表
def init_db():
    Base.metadata.create_all(bind=engine)
create_all 的局限性
Base.metadata.create_all() 是开发阶段快速建表的便捷手段,但它存在一个核心局限:它只负责创建 "尚不存在" 的数据表,无法管理已有数据表的结构修改
假设数据表 users 已经在数据库中生成,后期由于业务变更,我们在 User 类中新增了一个 avatar_url 属性:
python
class User(Base):
    __tablename__ = "users"
    # ... 原有字段 ...
    avatar_url: Mapped[str | None] = mapped_column(String(255))  # 新增字段
此时重新执行 create_all(),SQLAlchemy 发现数据库中已经存在名为 users 的表,便会直接跳过处理,绝不会自动向已有的表中执行 ALTER TABLE 来增加字段
为了在不丢失已有数据的前提下安全地管理数据库结构的演进与变更,我们需要在后续引入专业的数据库迁移工具 ------ Alembic
四、数据库操作与 Pydantic Schema
在具备了数据库连接与 ORM 模型定义后,接下来需要在 FastAPI 的路由函数中实现具体的数据增删改查逻辑
而在实际开发中,一个最重要的设计原则是:必须将底层的数据库 ORM 模型(SQLAlchemy)与上层的 API 接口数据结构(Pydantic Schema)明确分离
1. 插入数据
以创建新用户为例,向数据库插入一条数据通常包含四个步骤:对象创建、加入会话、提交事务与刷新状态
python
from sqlalchemy.orm import Session
from app.models import User


def create_user_in_db(db: Session, username: str, email: str) -> User:
    # 1. 实例化 Python ORM 对象(处于 Transient 瞬时态)
    db_user = User(username=username, email=email)

    # 2. 将 ORM 对象加入到当前数据库会话中(转换为 Pending 挂起态)
    db.add(db_user)

    # 3. 提交数据库事务,真正向数据库下发 INSERT 语句(转换为 Persistent 持久态)
    db.commit()

    # 4. 从数据库重新加载刷新对象属性(如获取自增主键 id 和服务器默认生成的 created_at)
    db.refresh(db_user)

    return db_user
核心步骤解析
-
User():此时仅是在 Python 内存中构建了一个数据实体对象,尚未与数据库产生任何关联
-
db.add():将会话注册该对象。此时数据库中并没有新增记录
-
db.commit():触发真实的数据库事务提交。SQLAlchemy 会根据会话中的脏数据向数据库发送 INSERT 报文,并结束当前事务
-
db.refresh():在 commit() 执行后,数据库引擎通常会自动生成主键 ID 或默认时间戳。调用 refresh() 可以从数据库拉取最新的列值写回 Python 对象的属性中
flush() 与 commit() 的区别
-
db.flush() :将当前会话中累积的 SQL 操作刷入数据库底层的连接缓存区并执行,此时可以提前获取数据库生成的自增 ID ,但事务尚未结束。如果后续发生错误,仍可整体回滚
-
db.commit():隐式先调用 flush(),随后彻底提交事务,修改将对其他数据库连接永久可见
2. 为什么需要区分 ORM Model 与 Pydantic Schema
"既然已经定义了 SQLAlchemy 的 User ORM 模型,为什么还要定义 Pydantic 的 User Schema?"
它们的关注点和应用场景存在根本性的差异
SQLAlchemy ORM vs Pydantic Schema
| SQLAlchemy ORM Model | Pydantic Schema | |
|---|---|---|
| 职责 | 描述数据库数据表映射 | 描述 API 接口输入/输出数据契约 |
| 关注点 | 数据持久化、索引、主键、外键约束、关联关系 | 数据类型校验、字段过滤、JSON 序列化与反序列化 |
| 应用 | 在服务层与数据库层之间传递实体 | 在客户端与 FastAPI 路由层之间传输 JSON |
| 安全要求 | 包含表中所有列 | 严格屏蔽敏感列,仅暴露前端业务所需的字段 |
3. 设计分层 Pydantic Schema
为了避免在创建用户、查询用户等不同接口中重复声明相同的字段,通常采用分层的继承结构来组织 Pydantic Schema:
python
from datetime import datetime
from pydantic import BaseModel, EmailStr, ConfigDict


# 1. 基础 Schema:包含创建与响应共有的公共属性
class UserBase(BaseModel):
    username: str
    email: EmailStr


# 2. 请求 Schema:用于接收客户端 POST 提交的创建数据
class UserCreate(UserBase):
    password: str


# 3. 响应 Schema:用于 API 返回给客户端的数据(隐去密码,追加数据库生成的 id 和时间)
class UserResponse(UserBase):
    id: int
    is_active: bool
    created_at: datetime

    # Pydantic v2 配置:允许从 ORM 对象属性中提取数据完成序列化
    model_config = ConfigDict(from_attributes=True)
Pydantic v2 的 from_attributes=True
默认情况下,Pydantic 只能从 Python 字典读取数据(如 data"username")
但在 FastAPI 路由函数中,我们返回的是 SQLAlchemy 的 ORM 对象实体(通过属性访问,如 user.username)。配置 model_config = ConfigDict(from_attributes=True) 后,Pydantic 会自动适配 ORM 对象的属性读取方式,将其平滑序列化为 JSON 报文
4. 完整的接口数据架构
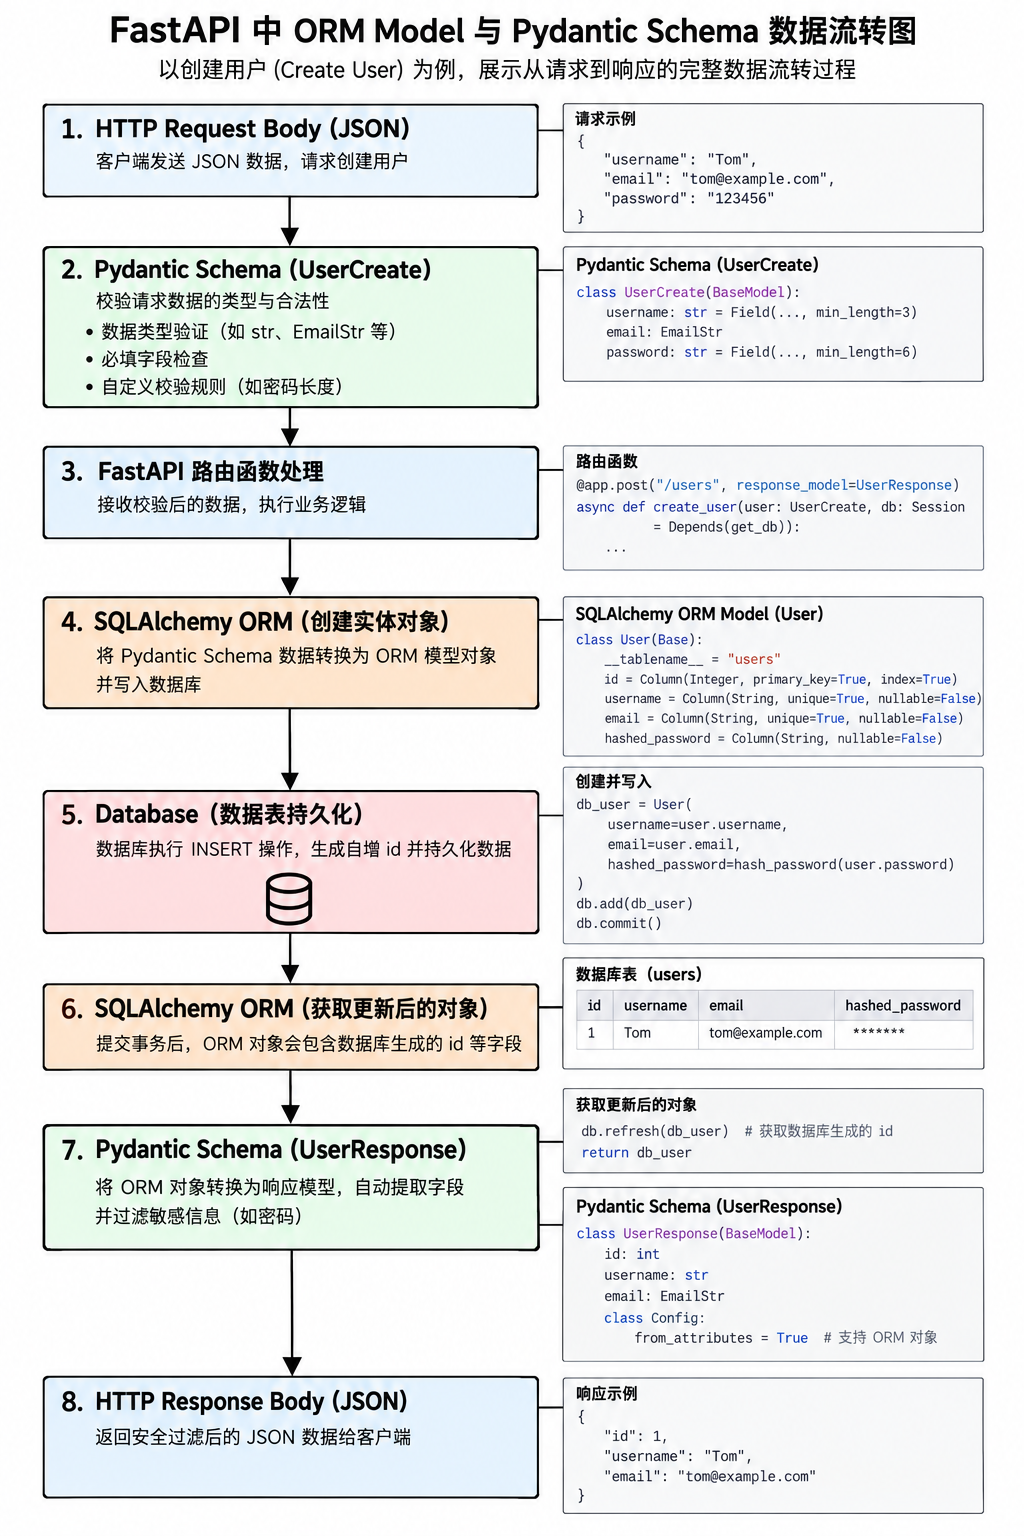
这种架构设计确保了:即使数据库存储了敏感的密码哈希等字段,也可以通过 API Response Schema 在最外层予以隔离防护,杜绝数据泄露
五、使用 APIRouter 组织数据库 API
随着系统功能的增加,如果将所有路由接口、数据库操作逻辑都挤在 main.py 中,会导致代码臃肿且极难维护。通过 APIRouter,我们可以将不同业务模块的 API 优雅地拆分到独立的文件中
1. 什么是 APIRouter
APIRouter 是 FastAPI 提供的模块化路由工具。可以将其理解为一个 "微型 FastAPI 应用"------它允许开发者在独立的子模块中声明路由、中间件和依赖项,最后再统一挂载到顶层的 FastAPI 主应用实例上
主应用与 APIRouter 的组织关系
python
                FastAPI Main Application (app)
                            │
       ┌────────────────────┼────────────────────┐
       ▼                    ▼                    ▼
Users Router         Products Router       Orders Router
(/users)             (/products)           (/orders)
  ├── POST /           ├── GET /             ├── POST /
  └── GET /{id}        └── GET /{id}         └── DELETE /{id}
2. 定义并注册 APIRouter
在独立的模块文件中(如 app/routers/users.py),使用 APIRouter 实例化路由对象,并把相关的业务接口收拢在统一的前缀下
2.1 编写路由模块(app/routers/users.py)
python
from typing import Annotated
from fastapi import APIRouter, Depends, HTTPException, status
from sqlalchemy import select
from sqlalchemy.orm import Session

from app.database import get_db
from app.models.user import User
from app.schemas.user import UserCreate, UserResponse

# 实例化 Router,统一配置路径前缀与 OpenAPI 标签
router = APIRouter(
    prefix="/users",
    tags=["Users"]
)


@router.post("/", response_model=UserResponse, status_code=status.HTTP_201_CREATED)
def create_user(
    user_in: UserCreate,
    db: Annotated[Session, Depends(get_db)]
):
    # 使用 SQLAlchemy 2.x 语法查询用户是否存在
    stmt = select(User).where(User.username == user_in.username)
    existing_user = db.execute(stmt).scalar_one_or_none()

    if existing_user:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="用户名已被注册"
        )

    # 创建 ORM 实体并写入数据库
    db_user = User(
        username=user_in.username,
        email=user_in.email
    )
    db.add(db_user)
    db.commit()
    db.refresh(db_user)
    return db_user


@router.get("/{user_id}", response_model=UserResponse)
def read_user(
    user_id: int,
    db: Annotated[Session, Depends(get_db)]
):
    stmt = select(User).where(User.id == user_id)
    user = db.execute(stmt).scalar_one_or_none()

    if not user:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="用户不存在"
        )
    return user
2.2 在主应用中挂载 Router(app/main.py)
python
from fastapi import FastAPI
from app.routers import users

app = FastAPI(title="FastAPI 与数据库应用")

# 挂载用户业务路由
app.include_router(users.router)
通过 app.include_router(users.router) 挂载后,该模块下的所有路由会自动补全前缀:
-
POST /users/ -> 创建用户
-
GET /users/{user_id} -> 查询用户
3. 推荐的项目架构目录
在包含数据库持久化的标准 FastAPI 项目中,遵循 "高内聚、低耦合" 的模块分割模式,推荐如下目录组织结构:
python
app/
├── __init__.py
├── main.py            # 应用入口:实例化 FastAPI,注册 API Router,配置全局中间件
├── database.py        # 连接配置:Engine 实例、SessionLocal 工厂以及 get_db 依赖项
├── models/            # SQLAlchemy ORM 模型实体定义 (与数据库表结构一一对应)
│   ├── __init__.py
│   └── user.py
├── schemas/           # Pydantic Schema 定义 (控制接口请求/响应契约与数据校验)
│   ├── __init__.py
│   └── user.py
└── routers/           # 路由控制层 (接收请求、调度 ORM、返回 Pydantic 视图)
    ├── __init__.py
    └── users.py
模块分工
-
database.py:隔离与底层数据库通信的所有基础设施配置
-
models/:仅存放 SQLAlchemy 的类定义,负责描述数据库内部的数据表结构
-
schemas/:仅存放 Pydantic BaseModel 派生类,负责外部 HTTP 数据交换格式控制
-
routers/:整合 HTTP 视图函数,注入数据库 Session 依赖,完成具体 API 逻辑处理
六、认识 Alembic 数据库迁移
在项目持续迭代的过程中,数据表结构并非一成不变。随着业务演进,常常需要向已有表中添加新字段、修改数据列类型或删除废弃索引
直接使用 Base.metadata.create_all() 只能创建尚未存在的新表,无法对已有的表结构进行变更。为了让数据库结构能够在不丢失现有数据的前提下跟随代码安全演进,我们需要引入 SQLAlchemy 生态中的数据库版本控制工具 ------ Alembic
1. 为什么需要数据库迁移工具
假设项目上线初期,users 表包含以下字段:
python
users
├── id
├── username
└── email
一个月后,由于新增了审计需求,需要在 users 表中追加一个记录创建时间的字段 created_at
如果仅仅在 Python ORM 模型代码中添加:
python
class User(Base):
    __tablename__ = "users"
    # ... 原有字段 ...
    created_at: Mapped[datetime] = mapped_column(server_default=func.now())
此时重新启动应用,由于数据库中已经存在 users 表,create_all() 会直接跳过,数据库中的表结构并不会更新。如果在代码中直接查询 user.created_at,就会抛出数据库异常
虽然开发者可以手动登录数据库执行 SQL 语句,但这种手工方式存在巨大隐患:
-
不可追踪:缺乏变更历史记录,无法得知数据库结构是如何演变成当前状态的
-
多环境不同步:团队其他开发人员的本地数据库、测试环境和生产环境难以保持 Schema 的严格一致
-
无法回滚:当发布的修改引发严重线上 Bug 时,无法快速撤销表结构改动
数据库迁移流程
Alembic 类似于数据库版本的 Git,它通过对比 ORM 元数据与数据库当前结构的差异,自动生成升级与降级脚本:
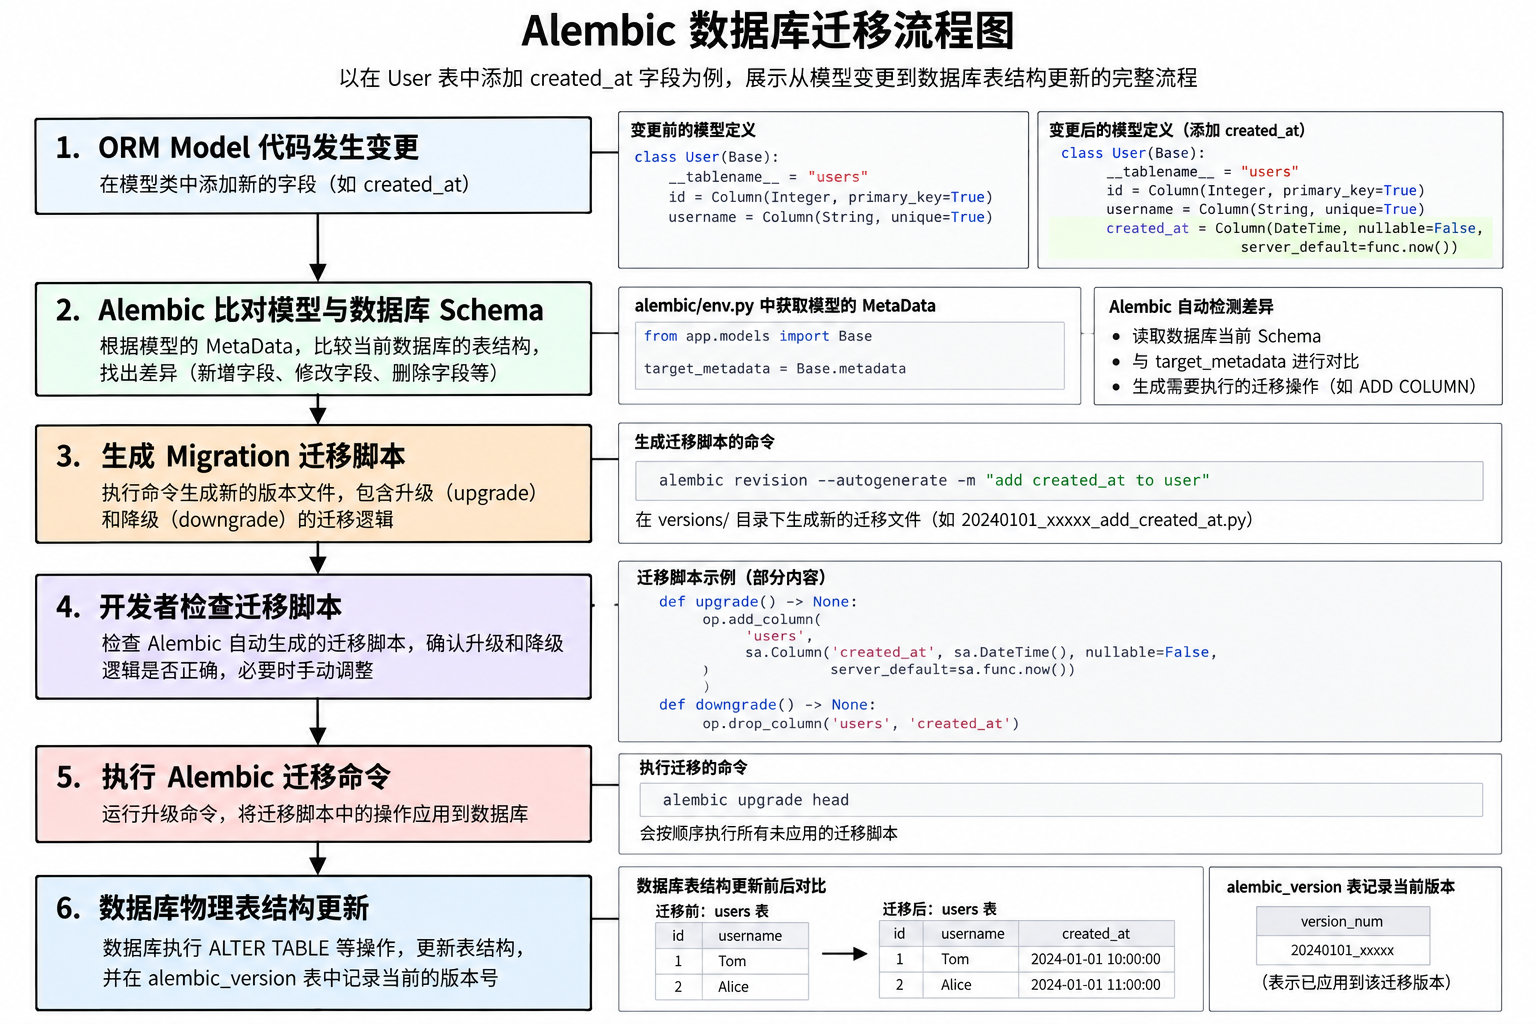
2. 初始化 Alembic 环境
在 FastAPI 项目根目录下,通过命令行运行 Alembic 初始化指令:
bash
alembic init alembic命令执行完毕后,项目根目录下会自动生成以下文件与目录结构:
bash
my_project/
├── alembic.ini          # Alembic 全局配置文件(包含数据库连接 URL、日志格式等)
└── alembic/             # 迁移脚本管理目录
    ├── env.py           # 关键脚本:迁移运行时加载的环境配置与 ORM 关联逻辑
    ├── README
    ├── script.py.mako   # 生成迁移脚本的 Mako 模板文件
    └── versions/        # 存放所有自动生成的版本变更脚本 (.py)
核心目录文件作用
-
alembic.ini:记录 Alembic 的全局参数。其中 sqlalchemy.url 项用于配置连接的目标数据库
-
alembic/env.py:Alembic 每次执行迁移命令时都会首先运行此 Python 脚本。它负责加载数据库连接配置,并读取 ORM 模型定义的 metadata
-
alembic/versions/:每一个表结构变更历史都会在这里生成一个独立的 Python 脚本文件(例如 a1b2c3d4_add_created_at.py)
3. 配置 env.py 与关联 ORM Metadata
要让 Alembic 能够自动检测 ORM 模型的变动,核心在于在 alembic/env.py 中将 SQLAlchemy 模型基类的 metadata 显式分配给 target_metadata 变量
默认生成的 alembic/env.py 中包含如下代码:
python
# target_metadata = None修改 alembic/env.py,导入项目中的 Base 基类与所有的实体模型:
python
import os
import sys
from logging.config import fileConfig

from sqlalchemy import engine_from_config, pool
from alembic import context

# 1. 将项目根目录添加到 Python 搜索路径中,确保能正确导入 app 模块
sys.path.insert(0, os.path.dirname(os.path.dirname(__file__)))

# 2. 导入声明式基类 Base 以及所有的 ORM 模型实体
from app.models.user import Base, User  # 必须确保实体模型类被导入装载

# Alembic Config 对象,用于获取 alembic.ini 中的配置
config = context.config

if config.config_file_name is not None:
    fileConfig(config.config_file_name)

# 3. 将 Base.metadata 赋予 target_metadata,使 Alembic 能够感知识别 ORM 模型定义
target_metadata = Base.metadata
在后续开发中,每当新建一个 ORM 模型文件,必须确保该模型类在 env.py 或其统一入口中被显式 import。如果模型文件未被 Python 解释器加载,Base.metadata 就无法感知该数据表的存在,Alembic 也就无法为其自动生成迁移脚本
七、生成与执行数据库迁移
在配置好 env.py 并关联 ORM 的 target_metadata 后,即可使用 Alembic 命令行工具对数据库表结构进行自动化版本追踪与更新
1. 生成迁移脚本
当修改了 SQLAlchemy ORM 模型后,可以通过带有 --autogenerate 标志的指令生成增量迁移脚本:
bash
alembic revision --autogenerate -m "add created_at to users"自动生成原理与差异比对
在执行上述指令时,Alembic 底层会同时读取两方面的信息:
-
**内存中的静态定义:**通过 env.py 中引用的 Base.metadata,读取当前 Python 代码中所有 ORM 模型的字段、类型与约束定义
-
数据库中的真实 Schema:通过数据库连接字符串,实时检查目标数据库当前的表结构
Alembic 内部的对比引擎会对两者进行差异分析,并在 migrations/versions/ 目录下自动生成一个独立的 Python 迁移脚本
人工检查的重要性
虽然 --autogenerate 极大地提升了编写迁移脚本的效率,但绝不能盲目信任自动生成的脚本
Alembic 的自动比对引擎存在一定的技术局限性,例如:
-
无法自动识别重命名:如果将 ORM 模型中的字段 username 修改为 user_name,Alembic 默认会将其识别为 "删除列 username" 和 "新增列 user_name",这会导致已有数据库中的 username 数据在执行迁移时丢失
-
部分复杂约束检测受限:对于某些特定数据库的 Enum 枚举类型、外键名称修改或表重命名,自动比对可能无法完全准确感知
生产实践原则 :自动生成的迁移脚本仅作为初稿。在提交代码或执行升级前,开发者必须人工打开生成的脚本进行二次审查与确认
2. 迁移脚本结构
每个由 Alembic 生成的迁移脚本都包含特定的 Revision ID,并由两个核心函数组成:upgrade() 与 downgrade()
python
"""add created_at to users

Revision ID: d8c7dabb1309
Revises:
Create Date: 2026-10-13 10:00:00.000000

"""
from alembic import op
import sqlalchemy as sa


# 1. 升级逻辑:将数据库 Schema 变更推向新版本
def upgrade() -> None:
    op.add_column('users', sa.Column('created_at', sa.DateTime(), server_default=sa.text('now()'), nullable=False))


# 2. 降级逻辑:将数据库 Schema 撤销回前一个版本
def downgrade() -> None:
    op.drop_column('users', 'created_at')
函数语义
-
**upgrade():**当向更高的数据库版本升迁时执行。它定义了本次版本更新具体需要施加的 DDL 操作(如新增表、追加列、创建索引)
-
**downgrade():**当需要将数据库回滚到先前版本时执行。它定义了 upgrade() 的逆向对称操作(如删除新追加的列、擦除新增的表)
3. 执行迁移
脚本生成并确认无误后,即可将修改应用到实际的物理数据库中
1. 应用最新迁移(upgrade head)
执行以下命令,将当前数据库升级至最新的版本点(head):
alembic upgrade head命令执行后,Alembic 会按照版本链的依赖关系,依次触发未执行的迁移脚本中的 upgrade() 函数,并在数据库中完成表结构的修改
2. 迁移状态与历史查询命令
Alembic 提供了丰富的指令来查看与管理当前的版本状态:
-
alembic current:查看当前物理数据库正处于哪一个迁移版本 ID(Revision ID)
-
alembic history:按时间轴顺序列出项目中所有的迁移版本历史记录。
-
alembic downgrade -1:将数据库版本回退一个版本(触发最近一次脚本中的 downgrade() 函数)。也可以指定具体的版本号进行精确回退(如 alembic downgrade base 可回退到最初始状态)
4. 底层版本记录机制
每次执行 alembic upgrade 命令时,Alembic 会自动在目标数据库中建立并维护一张名为 alembic_version的系统表
数据表结构极简:
| version_num |
|---|
| d8c7dabb1309 |
该表仅包含一行记录,用于存储当前已成功执行的最新 Revision ID。每次执行升级或降级时,Alembic 都会更新该表中的值。这就确保了无论在哪台机器或开发环境中运行,Alembic 都能准确判断当前数据库与代码中 ORM 模型版本的相对差距
总结
本章主要学习了 FastAPI 中的 SQLAlchemy ORM、Pydantic Schema、APIRouter 与 Alembic 数据库迁移
首先,我们了解了 ORM 的核心思想,并通过 SQLAlchemy 完成数据库连接、模型定义、数据表初始化及数据插入,结合 Depends() 实现了数据库 Session 的生命周期管理
随后,我们学习了 Pydantic Schema 与 ORM Model 的职责区别,并使用 APIRouter 对项目路由进行模块化管理。最后,通过 Alembic 掌握了数据库迁移的基本流程,包括环境配置、迁移脚本生成与执行
至此,FastAPI 应用开发系列正式完结。从基础路由、请求响应、数据验证,到依赖注入、中间件、安全认证、接口测试及数据库持久化,我们已经建立了一套较为完整的 FastAPI 后端开发知识体系,为后续构建实际 Web 服务与 AI Agent 应用打下了基础