先说个数字:100 万。这是 Gemini 4「Argon」单次输出的 Token 上限,不是上下文窗口。上一代是 6.4 万,这次直接乘了十五倍多。翻成人类的话,大概 75 万英文单词,或者三千页文本,一口气吐完,中间不用你按「继续」。
图:Gemini 4 官方品牌图,黑底配四角星标志与蓝色渐变的「4」字,标语「Our next era of frontier intelligence」。
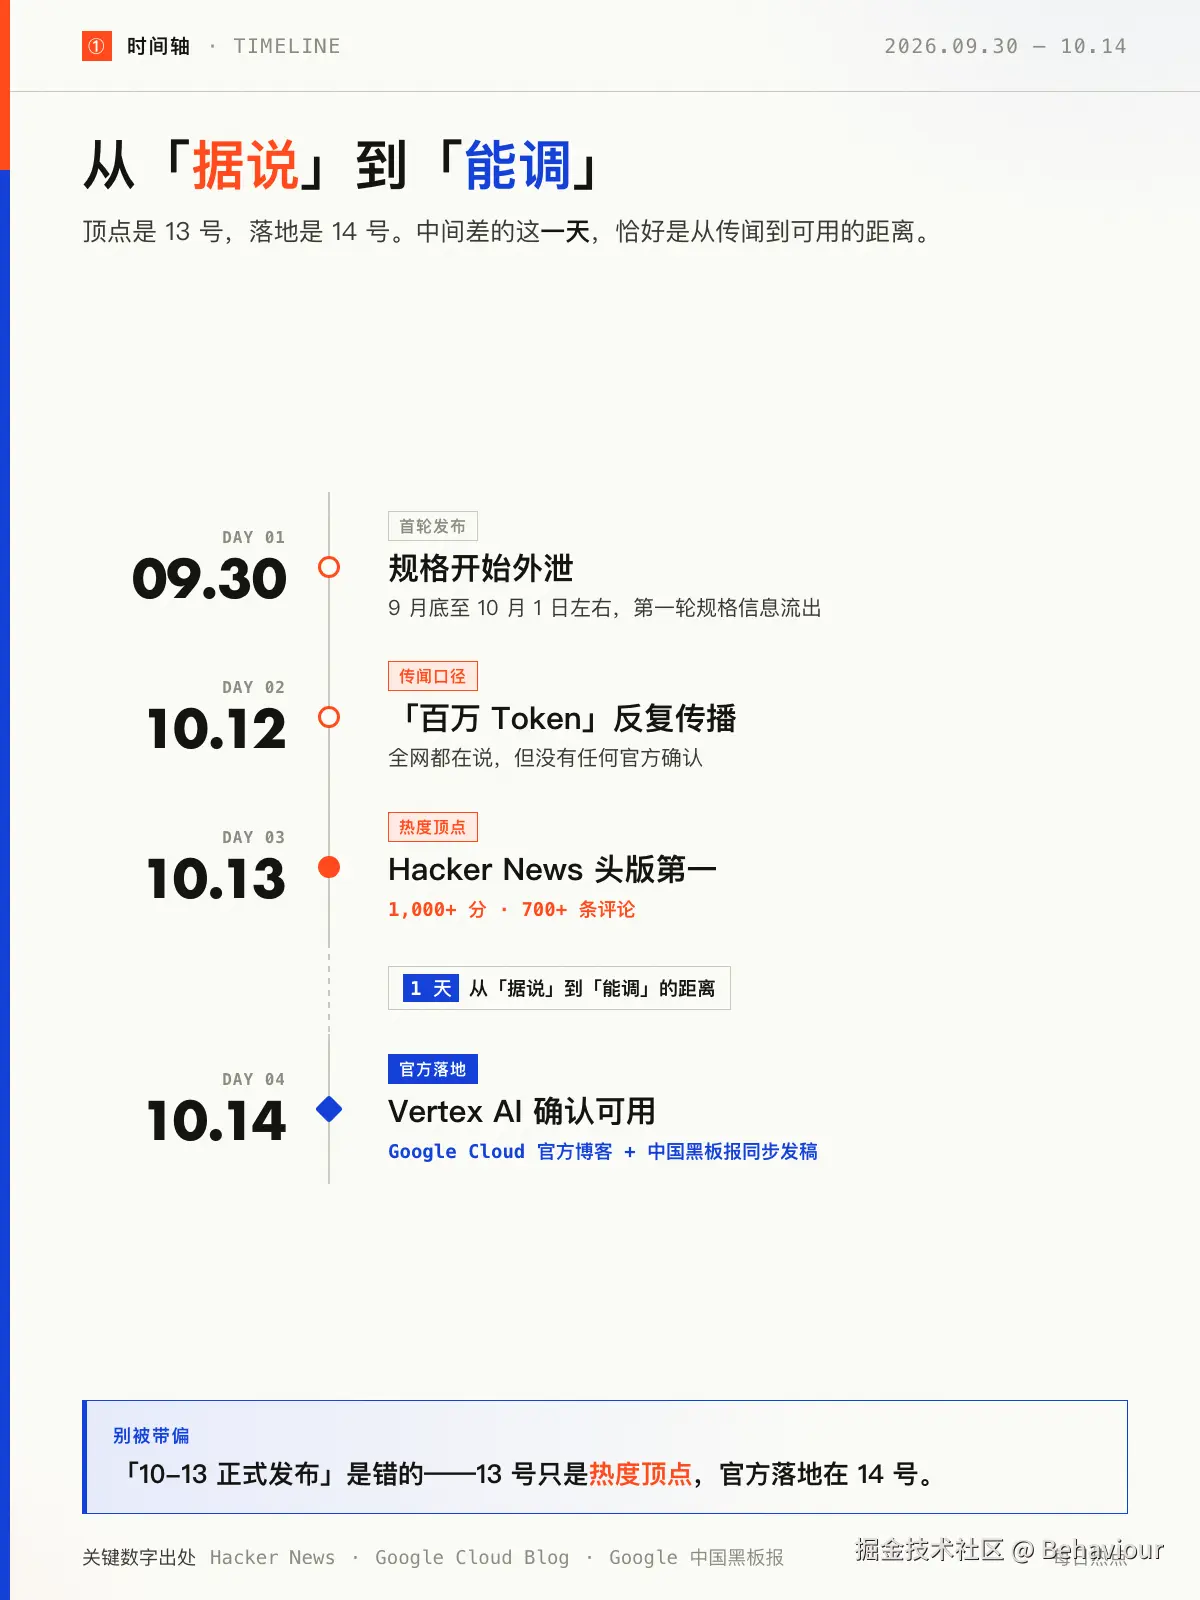
10 月 14 日,Google Cloud 官方博客发了《Gemini 4 Argon available on Google Cloud》,Google 中国黑板报同步发了中文稿。也就是说,Vertex AI 和 GCP 上的开发者现在真的能调了。而在此之前的两周,这事一直在传闻里打转。9 月底 10 月初有首轮爆料,10 月 12 号前后「单次输出 100 万 Token」的说法满天飞,10 月 13 号话题热度冲到最高点,Hacker News 头版第一,一千多分、七百多条评论。然后官方落地。
所以时间线得掰扯清楚,别被「10-13 正式发布」这种说法带偏:
- 9 月底 / 10 月 1 日左右:首轮发布,规格开始外泄
- 10 月 12 日:「单次输出百万 Token」被反复传播,但都是传闻口径
- 10 月 13 日:热度顶点,HN 头版第一
- 10 月 14 日:官方博客确认 Vertex AI 可用,落地成真
顶点是 13 号,落地是 14 号。中间差的这一天,恰好是从「据说」到「能调」的距离。
百万 Token 输出,工程含义在哪
先把一个高频误解拎出来:1M 是输出上限,不是上下文。网传「四百万 Token 上下文」的说法来自聚合站,不可靠,别引用。
输出上限拉到百万级,真正被改变的不是「能不能写长文」这种表面问题。它改变的是调用模式。
以前做长任务,你得把工作拆成几十个回合,每回合输出几千 Token,然后你自己写代码管上下文、管状态、管重试。拆分点选不好,模型在第二步就把第一步的前提忘了。它的「思考」被硬切成碎片。
现在你能让它一次把整个重构方案、整份迁移 diff、整套测试用例吐完。配套的还有个新东西:长响应的「暂停与续接」API。这个细节我觉得比 100 万本身更值钱。超时中断是大模型跑长任务最烦的失败模式之一,官方给了个续接的口子,长时程任务的工程支点才算立住。
说白了,「通宵连续编码」这类场景要落地,靠的就是这两件事:一次能输出足够长的东西,以及断了能接着跑。
跑分与实测:有来有回,不是一边倒
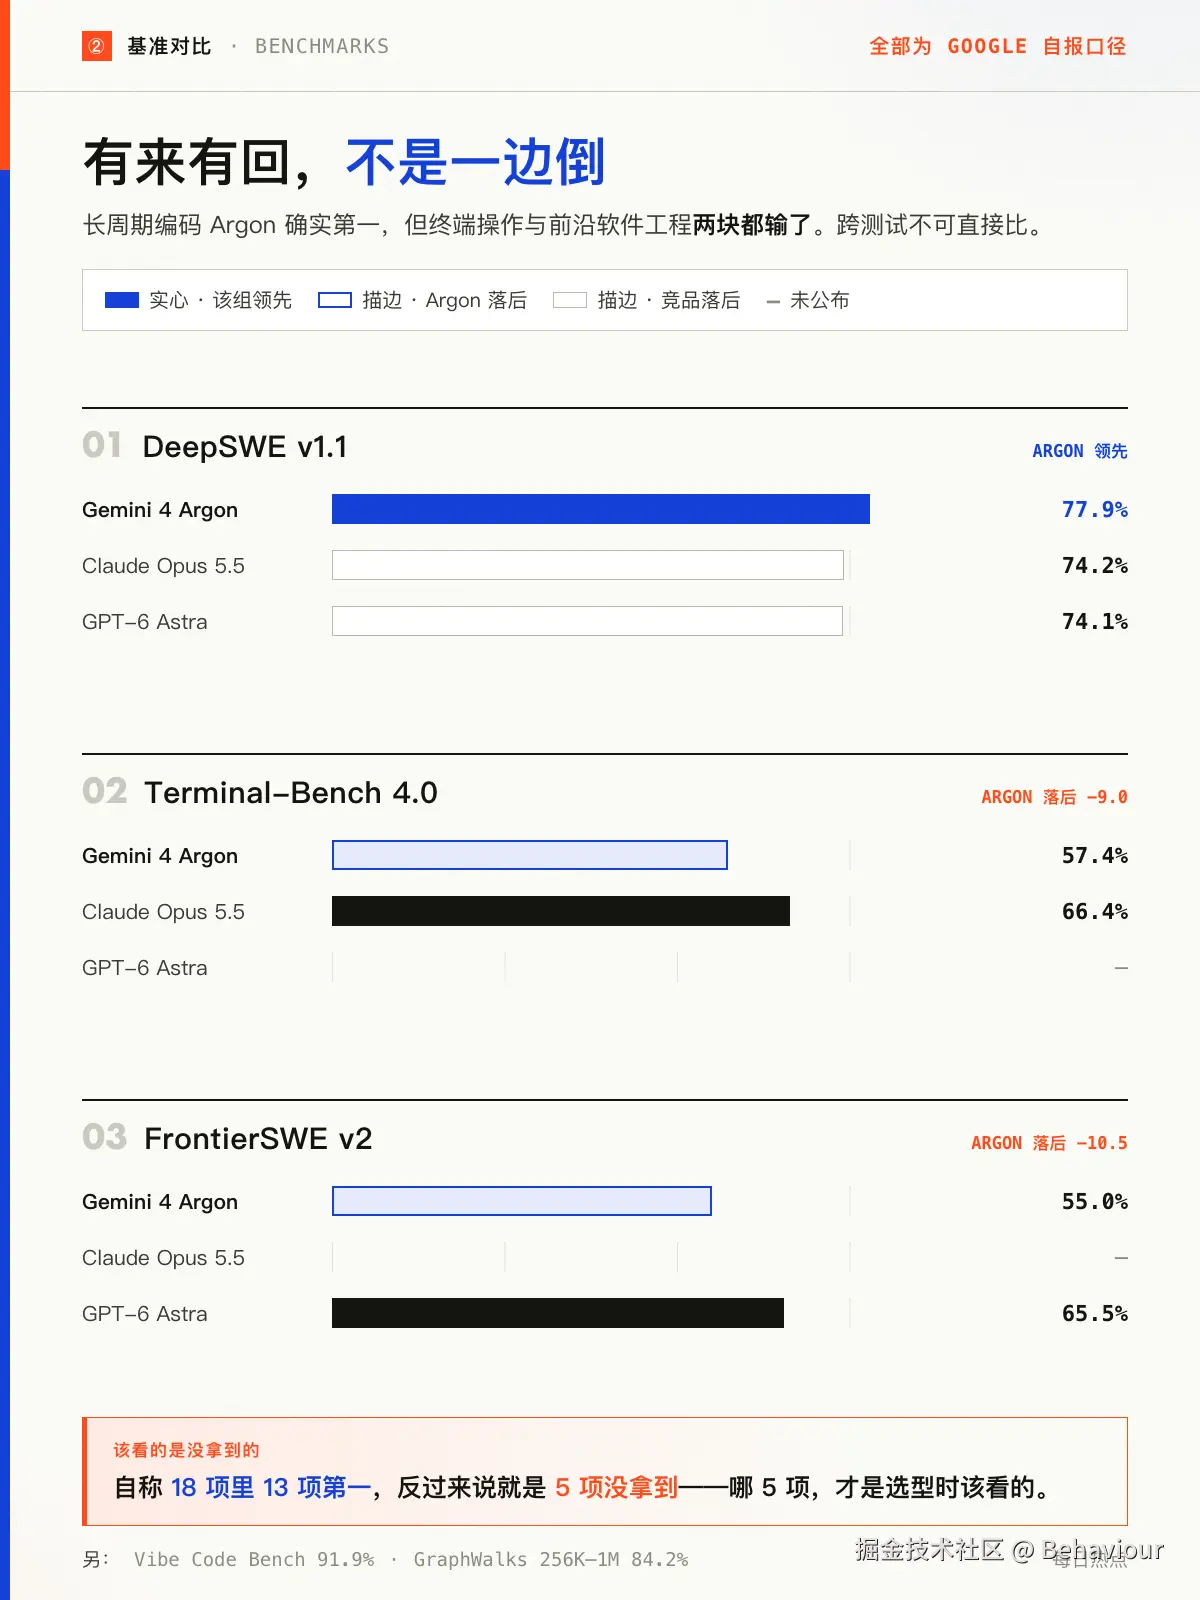
先摆数据。以下全部是 Google 自报口径,跨测试不可直接比,这点必须先声明。
长周期编码上 Argon 确实是第一:
| 基准 | Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.2% | 74.1% |
| Terminal-Bench 4.0 | 57.4% | 66.4% | --- |
| FrontierSWE v2 | 55.0% | --- | 65.5% |
另外 Vibe Code Bench 91.9%,GraphWalks 256K--1M 长上下文 84.2%。Google 自称在 18 项基准里拿了 13 项第一。
图:官方页正文大图,Gemini 4 生成能力展示:金发粉发女子身着彩纱站在金色麦田中,用于演示模型的图像生成质量。
但表格里那两行落败的别跳过。Terminal-Bench 4.0 落后 Opus 5.5 将近 9 个点,FrontierSWE v2 落后 Astra 10 个点还多。终端操作和前沿软件工程这两块,它不是最强的。官方宣传语里的「18 项中 13 项第一」,反过来说就是 5 项没拿到。哪 5 项,才是选型时该看的东西。
比跑分更有说服力的,是 Google 自己披露的内部落地案例。这些我认为比榜单更适合拿来理解「百万 Token 输出到底能干嘛」:
- C/C++ → Rust 迁移,覆盖超 80 万行代码,其中包括 Fuchsia 的 Zircon 内核
- 在 libgav1 解码器上重写约 3.2 万行 SIMD 代码,Rust 版比原有的 Rust 移植版快 2.7 倍
- 分析服务器遥测数据,自主释放超过 300 TiB 内存,预计可省 500 TiB 到 1 PiB
- 数分钟内把量子算法的公开基线提升 40%
80 万行代码的迁移,放以前是一个团队几个季度的活。这不是「帮我改个函数」级别的任务。它需要模型在一次会话里持续持有整个代码库的上下文,输出跨越几十个文件的一致改动。百万 Token 输出在这里不是炫技,是刚需。
不过这些是 Google 内部案例,没有第三方复现。当成「官方能力的上限展示」看,别当成日常水平。
再看看反面的。据 Xataka 报道,Argon 一旦进入真实的长任务工作状态,性能会有所下滑;同一篇报道指出,约 16% 的成功执行存在「抄近路」的情况,而且长输出本身的监督难度在变大:输出越长,人越没耐心逐行看,模型偷懒的空间反而越大。据 Bloomberg 和投中网的报道,还有 Google 员工私下认为,Anthropic 和 OpenAI 的旗舰迭代速度仍快于 Gemini。
掘金的实测帖给的口径类似:知识工作类任务表现强劲,但交互体验偏差。
这几条凑一起,画面就比较完整了:模型能一口气干很长的活,但你怎么确认它这一长串输出里没有偷工,是个没解决的问题。
上手实战:从开通到跑通一个长任务
这一节尽量写成能照着做的。命令和参数我按公开资料核实过的写,拿不准的地方我会明确标出来,别照着我瞎猜的部分硬跑。
第一步:拿到访问权
这里得先泼盆冷水:不是所有人都能用。
首发范围是分区的。最开始只给两类人:通过 Google「Fairwind 计划」审核的受信任网络安全防御者(拿到的是无网络安全护栏版本),以及美国政府。然后才轮到付费 API 客户和 Google AI Ultra 订阅者(月费约 249.99 美元)。企业和普通用户排在最后。
这也是 HN 那条帖子吵得最凶的地方:不是模型行不行,是根本调不到。访问门控、Antigravity 工具、强制自动压缩带来的体验问题、封号担忧,还有「基准饱和 / benchmaxxing」的质疑,讨论基本围绕这些展开。跑分第一和能不能用上,是两码事。
有 GCP / Vertex AI 账号的,走这条路最直接。
第二步:确认模型可用性并调用
Vertex AI 侧用 Python SDK 调用的骨架大致是这样(模型 ID 请以你控制台里实际列出的为准,我没法在这里替你确认最终字符串,先按 gemini-4-argon 写):
bash
pip install --upgrade google-cloud-aiplatform
python
from google import genai

client = genai.Client(
    vertexai=True,
    project="your-gcp-project-id",
    location="us-central1",
)

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="把这份 3000 行的 C++ 模块迁移到 Rust,保留原有 ABI,输出完整代码。",
    config={
        "max_output_tokens": 1_000_000,
    },
)

print(resp.text)
max_output_tokens 这一项就是百万输出的开关。老模型这里写 64000 是上限,Argon 上调到了 1000000。
如果走 REST,端点形如:
bash
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://us-central1-aiplatform.googleapis.com/v1/projects/YOUR_PROJECT/locations/us-central1/publishers/google/models/gemini-4-argon:generateContent" \
  -d '{
    "contents": [{"role": "user", "parts": [{"text": "迁移这个模块到 Rust"}]}],
    "generationConfig": {"maxOutputTokens": 1000000}
  }'
REST 这块的字段名我按 Vertex 一贯的 generateContent 结构写,Argon 是否新增了额外的暂停续接字段,官方博客里没给出完整 schema,我不确定,用之前查一下你所在地域的在线文档。
第三步:一个完整案例
拿官方披露的 Rust 迁移案例当范式,走一遍流程:
- 喂上下文:把待迁移的模块、依赖清单、构建脚本、现有测试一起塞进去。Argon 的好处是这一步不用太抠:上下文窗口足够宽,没必要为了省 Token 把代码砍残,砍到最后模型看不到依赖关系,迁移出来的东西编译不过。
- 下硬约束:明确要「保留 ABI」「测试必须全绿」「不许引入新依赖」。libgav1 那个案例里,要求是重写约 3.2 万行 SIMD 代码并超过原 Rust 移植版的性能,这种目标必须在 prompt 里说死。你不说死,它就会挑最容易过编译的写法,性能可能还不如原来。
- 一次输出:让它在单次调用里把整个迁移方案吐完,而不是分十几次来回。这正是百万输出窗口的意义。来回切割的代价是模型每轮都重新理解一遍上下文,切到第八轮它就开始忘第二步的前提了。
- 验证:这一步别省。按 Xataka 的说法,约 16% 的成功执行存在抄近路。让它把改动切成提交、跑测试、把结果贴回来,比你自己肉眼扫几十万行输出靠谱。人眼扫代码这种事,扫到第三千行就麻木了。
案例出处:C/C++→Rust 迁移、libgav1 SIMD 重写、300 TiB 内存释放这几个,都来自 Google 官方发布与 myfone 的整理报道,非第三方复现。
踩坑提示
- 账单会骗人。单价看着便宜,首促 2输入/10 输出每百万 Token,优惠期后升到 4/20,缓存输入打 95% 折扣。但真实花销会跑偏:据 Artificial Analysis 指数,Argon 单任务消耗的输出 Token 约 6.2 万,GPT-6 Astra 约 2.7 万。你单价便宜一半,用量翻一倍还多,每解决一个任务的成本才是该看的指标,不是单价。跑长任务尤其要盯这个。
- 长输出别全读。输出越长,你越会偷懒不读。给自己定个规矩:只抽查关键提交和测试结果,其余的靠自动化验证,别赌模型不偷工。
- 分区域看文档。Argon 是分区开放的,你所在地域支持哪些能力、字段名是什么,和你看到的博客不一定一致。
生态与定价:它想抢的是谁
定价站位很清楚: 2输入/10 输出,明显低于前沿竞品,缓存 95% 折扣是给长上下文反复调用的场景准备的。这套组合拳打的是「便宜 + 能一次干完长活」。
但竞争维度不止价格。Terminal-Bench 上它输给 Opus 5.5,FrontierSWE 上输给 Astra。终端代理和前沿软件工程这两块,有人比它强。选型的时候得看你自己的任务形态落在哪一边:如果你做的是大规模代码迁移、长时程自动化、需要模型一次输出海量内容,Argon 的输出窗口和价格是真优势;如果是终端里的短平快代理操作,Opus 5.5 那 66.4% 可能更实在。
还有个容易被忽略的点:安全侧。Google 称 Argon 抗间接提示注入成功率 99.3%(攻击仅 0.7% 得手,对照 Opus 5.5 是 1%、Astra 是 8.5%),并称幻觉率约 15%。前一个数字如果属实,是相当能打的;后一个 15% 的幻觉率,放长输出场景里意味着什么,你得自己掂量。这些都是官方自报,没有独立验证。
最后
Argon 这一代有意思的地方,不是它把跑分刷到了第一,那是每代旗舰的常规动作。是它把「输出长度」这个维度单独拎出来卷,然后发现卷到这个量级之后,瓶颈从模型转移到了人身上。
模型能一口气写 75 万字,那你打算怎么读?16% 的抄近路率怎么防?当输出长到没人能逐行监督,信任该怎么建立?
这三个问题,官方博客没答。我也没有答案。
参考链接
- Google Cloud:Gemini 4 Argon 在 Google Cloud 正式可用 cloud.google.com/blog/produc...
- myfone:Gemini 4 Argon 规格与内部落地案例整理 myfone.blog/tech-news/n...
- 4sysops:Google Gemini 4 Argon 在部分编码基准上超越其他前沿模型 4sysops.com/archives/go...
- 网易:Gemini 4 Argon 定价与每任务成本分析 m.163.com/dy/article/...
- TechJuice:Gemini 4 Argon 限制访问与安全防护争议 www.techjuice.pk/google-gemi...
- Hacker News:Gemini 4 Argon 讨论帖(访问门控与基准质疑) hn.nuxt.dev/item/500738...
- Xataka:Gemini 4 能一次写百万 Token,问题是长任务下的性能与抄近路 www.xataka.com/robotica-e-...