专栏:AI 全栈开发|18
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 上一篇 17《LLM 请求完整参数》仍然站在"一次请求"的视角:model、messages、temperature、输出预算都只描述这一轮。真正的聊天产品还缺一层------会话状态。Message 是一条事实,Conversation 是一个产品资源,而 Context 是每一轮根据预算临时组装出来的视图。把这三件事分开,后面才谈得上记忆、隔离和成本。 |
一、从"一次请求"走到"一段对话"
用户先说"帮我总结这份合同",下一轮只追问"那赔偿上限呢?"。第二句话离开上一轮就没有完整语义,所以产品不能只保存最后一个 prompt。每次请求都要在一个会话里读到"必要的前文",再把新回复写回去。
但这里最容易走向另一个极端:把数据库里从第一句到现在的所有历史,每一轮原样全发给模型。它前几轮能跑,几十轮后就会越来越慢、越来越贵,最后撞上上下文窗口。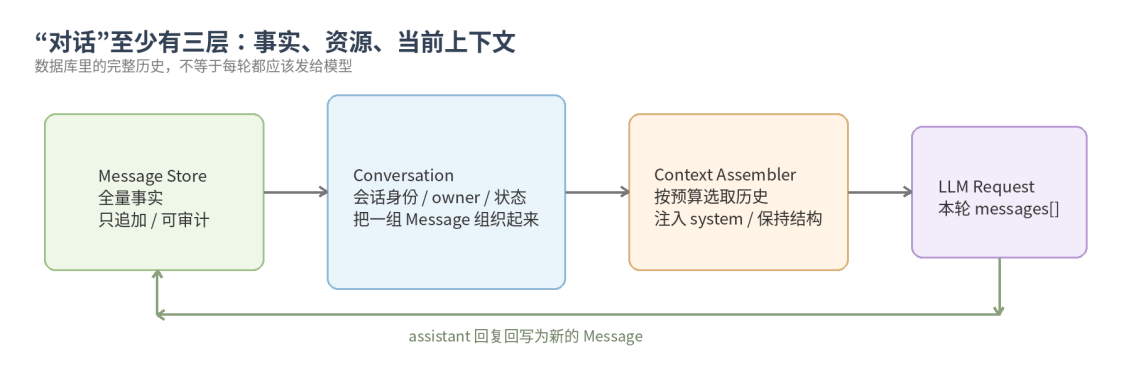
图 1 完整历史、会话资源和本轮模型上下文是三层不同的数据结构
二、先把 Message、Conversation、Context 分开
|--------------|------------------------------|------------------|
| 概念 | 它保存什么 | 生命周期 |
| Message | 一条用户 / assistant / tool 事实记录 | 写入后通常只追加,不因裁剪而消失 |
| Conversation | cid、owner、状态,以及一组有序 Message | 从创建到活跃、归档、删除 |
| Context | 这一轮真正发给模型的消息视图 | 每次请求都重新组装,可以不同 |
最重要的一条原则:存储保存"事实",Context 只表达"这一轮模型应该看到什么"。
所以"清空上下文"不等于"删除聊天记录";同样,Provider 是否替你保存了一部分会话状态,也不替代产品自己的权限、审计和历史管理。
三、Message 不应该只有 role + content
最小 Demo 里一条消息只有 role 和 content 就够了;进入产品后,至少还需要服务端顺序和与工具调用相关的元数据。顺序尤其不能依赖客户端时间戳,因为多设备和网络重试都会让到达顺序与本地时间发生冲突。
|---------------------------|--------------------------------|
| 字段 | 作用 |
| seq | 服务端分配的单调顺序;决定语义先后 |
| role | user / assistant / tool 等角色 |
| content | 文本或工具结果的可见内容 |
| tool_call_id / tool_calls | 把 assistant 的调用意图与 tool 结果关联起来 |
| created_at | 审计、排序辅助;不作为唯一顺序真相 |
四、最小实现:先做一个内存 Conversation
最小建模:Message 是事实,Conversation 是有序容器
from dataclasses import dataclass
from datetime import datetime, timezone

@dataclass(frozen=True)
class Message:
    seq: int
    role: str
    content: str
    created_at: str

class Conversation:
    def __init__(self, cid, owner):
        self.cid = cid
        self.owner = owner
        self._messages = []

    def append(self, role, content):
        msg = Message(
            seq=len(self._messages) + 1,
            role=role, content=content,
            created_at=datetime.now(timezone.utc).isoformat(),
        )
        self._messages.append(msg)
        return msg

    def history(self):
        return list(self._messages)
这里的 len+1 只用于单进程演示。生产环境要让数据库序列、事务或每会话原子计数器分配 seq;否则两个请求同时 append 时会拿到相同序号。
五、历史记录和模型上下文绝不能是同一份东西
UI 里的聊天记录要尽可能完整,因为用户要翻页、导出、审计;模型上下文却必须受预算约束。一次"组装 Context"的工作,本质上就是从完整历史里选出一个结构合法、语义尽量完整、又装得进窗口的子集。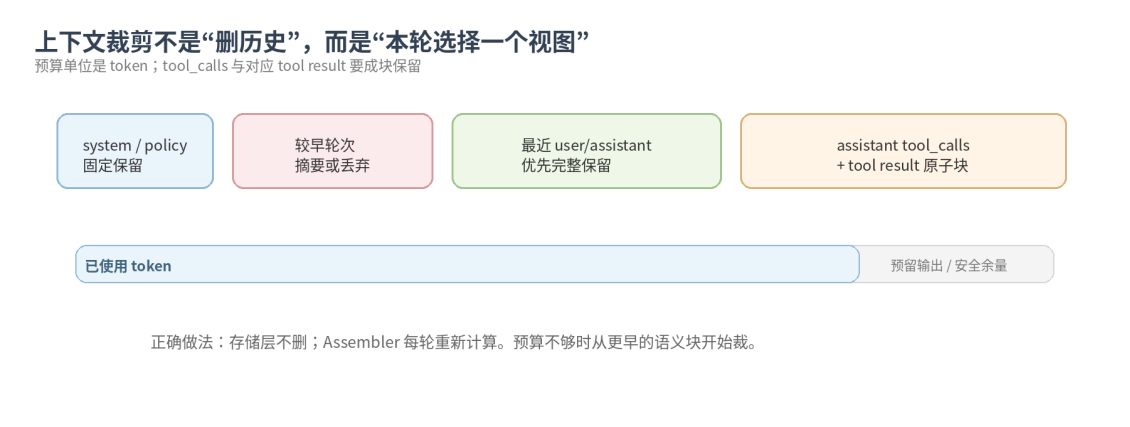
图 2 上下文裁剪只改变"本轮视图",不应该物理删除存储里的历史消息
六、裁剪按 token,不按消息条数
"只保留最近 20 条"看起来简单,但一条短回复可能只有几个 token,一段粘贴的代码可能是几千 token。真正的限制来自 token 窗口,所以预算单位也必须跟 token 对齐。
• system / policy 先预留预算,再给历史分配空间。
• 优先保留最近轮次;越早的内容越适合摘要或丢弃。
• 给模型输出预留空间,不要把整个窗口全部塞成输入。
• 示例可以用粗略计数;生产环境应使用对应模型/Provider 的 tokenizer 或可靠估算。
七、tool_calls 要成块裁剪,不能从中间切断
一旦会话里出现 Agent 工具调用,Context 就不再是"随便删几条消息"这么简单。assistant 发出的 tool_calls 与对应的 tool 结果在语义上属于同一个交互块;如果只保留一半,Provider 可能无法关联 tool_call_id,模型也会看到一段残缺历史。
因此裁剪的最小单位应该是"语义块",而不是单条数据库记录:普通 user/assistant 轮次成对处理,tool call + tool result 作为原子块一起留或一起删。
八、多会话隔离:cid 只是定位符,不是权限
一个用户可以同时有多个会话,不同用户也会访问同一套 API。cid 使用高熵值可以降低被枚举的风险,但它绝不是授权机制。每一次 history、append、archive、delete 都必须从登录态拿当前用户,再校验 Conversation.owner。
• 不要信任前端自己传的 user_id 作为授权依据。
• 不要因为 cid 是 UUID 就省略 owner 校验。
• "会话不存在"和"无权访问"的外部返回语义要按你的安全策略统一设计,避免泄露资源存在性。
九、并发写:顺序由服务端决定,但不要把数据库事务挂在 LLM 上
同一会话可能被两个浏览器标签页、手机和网页同时写。此时需要并发控制,但不建议为了"原子性"把数据库事务或全局锁一直持有到 LLM 返回------一次模型调用可能持续数秒,长事务会拖垮并发。
|---------|-----------------------------------|----------------|
| 策略 | 怎么做 | 适合场景 |
| 每会话串行队列 | 同一个 cid 的消息按队列顺序处理 | 简单、强一致,适合聊天主链路 |
| 乐观版本 | 读取 snapshot_version;回写前检查版本是否仍一致 | 允许并发,但要处理冲突/重试 |
| 事件追加 | 所有 Message append-only,按 seq 重建状态 | 审计友好,适合更复杂架构 |
十、一个小型 ContextAssembler
ContextAssembler:按 token 预算保留完整语义块
def assemble_context(system, blocks, token_budget, count_tokens):
    """
    blocks: 已经按语义分组的历史块;每块可能包含 1~N 条消息
    count_tokens(messages): 使用当前模型的计数器
    """
    fixed = [{"role": "system", "content": system}] if system else []
    kept = []

    # 从最近的语义块向前装;block 内绝不拆开
    for block in reversed(blocks):
        candidate = fixed + [m for b in reversed(kept) for m in b] + block
        if count_tokens(candidate) > token_budget:
            break
        kept.append(block)

    history = [m for block in reversed(kept) for m in block]
    return fixed + history
这里把"怎么把原始 Message 分组成 block"留给适配层:普通对话可以按一轮 user+assistant 分组;工具调用则把 assistant.tool_calls 和所有对应 tool result 放进同一个块。这样预算裁剪不会破坏结构。
十一、ConversationService 只做会话层的事 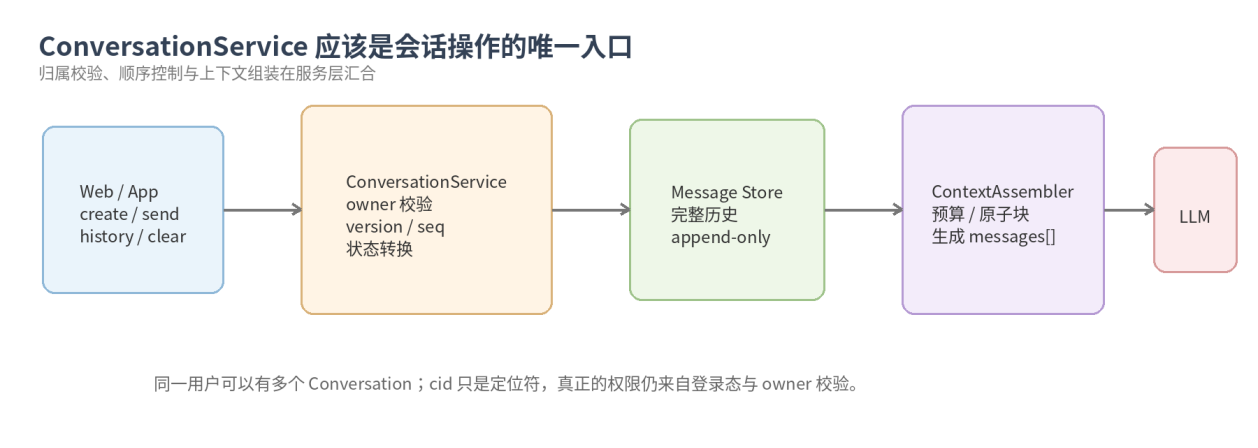
图 3 ConversationService 负责身份、顺序和状态;Store、Assembler、LLM Client 各自独立
把职责拆开后,一轮 chat 的流程会非常清楚:Service 校验 owner → 追加 user Message → 读取一个稳定 snapshot → Assembler 生成 Context → LLM Client 调模型 → 追加 assistant Message。下一篇的 Streaming 只会改变"回复如何返回",不会推翻这套会话模型。
十二、清空上下文、归档、删除是三件事
|--------|---------------------|----------------------------------|
| 操作 | 用户看到什么 | 底层应该做什么 |
| 清空上下文 | 继续保留聊天记录,但模型从新的起点开始 | 写 context boundary / 新分支标记,不必删历史 |
| 归档 | 会话不再活跃,但还能查看 | 修改状态,停止继续写入或放到历史列表 |
| 删除 | 用户要求移除会话 | 按产品与合规规则执行删除/保留审计 |
十三、几个最容易把对话做坏的地方
• 误区 1:每轮把全量历史直接发给模型。越聊越贵,最终撞上下文窗口。
• 误区 2:按消息条数裁剪。真正限制是 token,而不是"第 20 条"。
• 误区 3:裁剪时拆断 tool_calls 与 tool result。上下文结构会变成残缺状态。
• 误区 4:把数据库历史和模型 Context 当成同一个对象。清空上下文时就会误删用户记录。
• 误区 5:UUID 当权限控制。cid 只能定位资源,owner 校验才是授权。
• 误区 6:持有数据库事务等待 LLM。外部调用一慢,整个会话服务的并发都会被拖住。
• 误区 7:用客户端时间戳决定消息顺序。顺序必须由服务端 seq / 版本机制裁决。
十四、下一篇
下一篇 19《Streaming Model Output》会在这套会话模型之上打通 Model Provider → Backend → SSE → Browser 的流式链路:模型还没生成完,浏览器就开始显示;同时处理断开、取消、增量落库以及"流式输出结束后如何写回 Conversation"。