llm-serving已经有 Prometheus 指标,能看到请求量、延迟、Token 总量这些聚合数据 。接入Langfuse 是为了看到每一次请求的细节:输入的 messages、模型输出、Token 用量、耗时和错误。
文章仅做记录和参考,没有技术难度,因为可以直接让codex实现。但了解真实的实现过程一样重要。
本文实现应用层追踪:由 FastAPI 用 Langfuse Python SDK 手动记录 Trace / Span / Generation,不需要改动 llama.cpp。
目标架构
text
Client / OpenAI SDK
        │
        ▼
llm-serving · FastAPI
  Langfuse SDK · Trace · Generation · Errors
        │                          │
        ▼                          ▼
llm-serving-llama · llama.cpp     Langfuse Cloud
        │                          HTTPS · https://jp.cloud.langfuse.com/
        ▼
   Qwen2 0.5B
注意:模型返回的 Token 统计是否准确,取决于 llama.cpp 是否返回了使用量信息;不能把字符数直接当作 Token 数。
过程概览
| 步骤 | 操作 | 关键内容 |
|---|---|---|
| 1 | 在 Langfuse Cloud 创建项目和密钥 | 日本区域实例,保存 Public Key、Secret Key |
| 2 | 安装 SDK | requirements.txt 增加 langfuse>=4.0.0,<5.0.0,重建镜像 |
| 3 | 配置环境变量 | 本地 export;Kubernetes 用 Secret + Deployment env;Compose 从 shell 传入 |
| 4 | 在 FastAPI 中创建 Trace | 外层 span + 内层 generation,记录输入、输出、usage、错误 |
| 5 | 验证 Langfuse 连接 | auth_check(),再发一次真实推理请求 |
| 6 | 构建并启动 | API_HOST_PORT=8002 docker compose up --build -d api |
| 7 | 压测 | tests/load_metrics.py,180 秒,并发 2,每 2 个请求 1 个流式 |
| 8 | 对账 | Prometheus 增量对客户端统计;Langfuse 里的 Trace 数与 Token 对客户端统计 |
验证结果
- 构建与启动 :
llm-serving-llama变为Healthy,llm-serving随后Started(日志)。 - 压测 :180 秒内共发出 161 次操作,其中聊天请求 142 次(非流式 71 + 流式 71),全部返回 HTTP 200,没有错误样例(日志)。
- Prometheus 对账 :5 个指标的增量与客户端统计完全一致------请求数 142、输入 Token 7856、输出 Token 9467、耗时样本 142、首字样本 71(日志)。
- Langfuse 对账:本文给出了预期值(见第五节),实际控制台数据待补充。
环境信息
| 项目 | 值 |
|---|---|
| 宿主机 | MacBook M4,Docker Desktop,docker compose |
| Langfuse | Langfuse Cloud 日本区域 https://jp.cloud.langfuse.com |
| SDK | Langfuse Python SDK 4.x(>=4.0.0,<5.0.0),基于 OpenTelemetry |
| FastAPI 镜像 | llm-serving:local(基础镜像 python:3.12-slim),宿主机端口 8002 |
| llama.cpp 镜像 | llm-serving-llama:local,多阶段构建,模型 qwen2-0_5b-instruct-q4_k_m.gguf |
| 被测模型 | qwen2:0.5b |
一、在 Langfuse Cloud 创建项目和密钥
- 打开日本区域实例:
https://jp.cloud.langfuse.com。 - 登录后创建或选择一个项目,例如
llm-serving。 - 进入项目设置中的 API Keys,创建项目密钥。
- 保存下面三个值:
| 配置项 | 示例格式 | 用途 |
|---|---|---|
LANGFUSE_PUBLIC_KEY |
pk-lf-... |
项目标识 |
LANGFUSE_SECRET_KEY |
sk-lf-... |
服务端认证 |
LANGFUSE_BASE_URL |
https://jp.cloud.langfuse.com |
日本区域 API 地址 |
二、修改 llm-serving
2.1 安装 SDK
在 llm-serving/requirements.txt 中增加:
text
langfuse>=4.0.0,<5.0.0然后重新构建 FastAPI 镜像。SDK 4.x 使用 OpenTelemetry 追踪接口,新项目不建议继续使用旧版的 langfuse.trace()、trace.generation() 等 API。
2.2 配置环境变量
先在本地测试环境设置:
bash
export LANGFUSE_PUBLIC_KEY="pk-lf-替换为你的密钥"
export LANGFUSE_SECRET_KEY="sk-lf-替换为你的密钥"
export LANGFUSE_BASE_URL="https://jp.cloud.langfuse.com"
export LANGFUSE_TRACING_ENVIRONMENT="development"
LANGFUSE_TRACING_ENVIRONMENT 用来给 Trace 打上环境标签(这里是 development),方便在控制台里区分开发和生产数据。不要把实际密钥写进 Dockerfile,也不要提交到 .env 文件。
如果 FastAPI 运行在 Kubernetes,先创建 Secret:
bash
kubectl create secret generic langfuse-credentials \
  -n llm-serving \
  --from-literal=LANGFUSE_PUBLIC_KEY='替换为实际公钥' \
  --from-literal=LANGFUSE_SECRET_KEY='替换为实际私钥' \
  --dry-run=client -o yaml | kubectl apply -f -
再把环境变量配置到 llm-serving Deployment:
yaml
env:
  - name: LANGFUSE_PUBLIC_KEY
    valueFrom:
      secretKeyRef:
        name: langfuse-credentials
        key: LANGFUSE_PUBLIC_KEY

  - name: LANGFUSE_SECRET_KEY
    valueFrom:
      secretKeyRef:
        name: langfuse-credentials
        key: LANGFUSE_SECRET_KEY

  - name: LANGFUSE_BASE_URL
    value: "https://jp.cloud.langfuse.com"

  - name: LANGFUSE_TRACING_ENVIRONMENT
    value: "development"
2.3 在 FastAPI 中创建 Trace
llm-serving 是通过 HTTP 调用 llm-serving-llama 的,所以最直接的方案是用 Langfuse Python SDK 手动建立 Span 和 Generation:不需要改 llama.cpp,也不依赖它是否使用 OpenAI Python SDK。
先在 FastAPI 代码中初始化客户端:
python
from langfuse import get_client

langfuse = get_client()
然后在 /v1/chat/completions 的业务逻辑里,对模型调用增加追踪:
python
with langfuse.start_as_current_observation(
    as_type="span",
    name="llm-serving.chat-completions",
    input={"model": model, "messages": messages},
) as span:
    with langfuse.start_as_current_observation(
        as_type="generation",
        name="llama.cpp.inference",
        model=model,
        input={"messages": messages},
    ) as generation:
        # 保留你当前调用 llm-serving-llama 的 HTTP 请求代码
        response = await call_llama_backend(...)
        generation.update(
            output=response,
            usage={
                "input": response.get("usage", {}).get("prompt_tokens", 0),
                "output": response.get("usage", {}).get("completion_tokens", 0),
                "total": response.get("usage", {}).get("total_tokens", 0),
            },
        )
    span.update(output=response)
三、构建并启动服务
用 docker compose 构建镜像并启动 api 服务,同时用 API_HOST_PORT 指定宿主机端口为 8002:
bash
(.venv) (base) igwanglyang@MacbookProdahouzicn llm-serving % API_HOST_PORT=8002 docker compose up --build -d api
[+] Building 1.5s (24/24) FINISHED
 => [internal] load local bake definitions                                                               0.0s
 => => reading from stdin 1.06kB                                                                         0.0s
 => [llm-serving-llama internal] load build definition from Dockerfile                                   0.0s
 => => transferring dockerfile: 955B                                                                     0.0s
 => [api internal] load build definition from Dockerfile                                                 0.0s
 => => transferring dockerfile: 354B                                                                     0.0s
 => [api internal] load metadata for docker.io/library/python:3.12-slim                                  0.1s
 => [llm-serving-llama internal] load metadata for docker.io/library/alpine:3.20                         0.1s
 => [llm-serving-llama internal] load metadata for ghcr.io/ggml-org/llama.cpp:server                     1.2s
 => [auth] ggml-org/llama.cpp:pull token for ghcr.io                                                     0.0s
 => [api internal] load .dockerignore                                                                    0.0s
 => => transferring context: 2B                                                                          0.0s
 => [api 1/5] FROM docker.io/library/python:3.12-slim@sha256:a6e34c598f2467ed0e9a8d349809fcd8b5c603269512df273a0bb1784edc11b1   0.0s
 => => resolve docker.io/library/python:3.12-slim@sha256:a6e34c598f2467ed0e9a8d349809fcd8b5c603269512df273a0bb1784edc11b1       0.0s
 => [api internal] load build context                                                                    0.0s
 => => transferring context: 1.34kB                                                                      0.0s
 => CACHED [api 2/5] WORKDIR /app                                                                        0.0s
 => CACHED [api 3/5] COPY requirements.txt .                                                             0.0s
 => CACHED [api 4/5] RUN pip install --no-cache-dir -r requirements.txt                                  0.0s
 => CACHED [api 5/5] COPY app ./app                                                                      0.0s
 => [api] exporting to image                                                                             0.0s
 => => exporting layers                                                                                  0.0s
 => => writing image sha256:f7cae246f66126d95986648549d4db184525026fb5cb8c8e05791d031ac017cf             0.0s
 => => naming to docker.io/library/llm-serving:local                                                     0.0s
 => [api] resolving provenance for metadata file                                                         0.0s
 => [llm-serving-llama internal] load .dockerignore                                                      0.0s
 => => transferring context: 2B                                                                          0.0s
 => [llm-serving-llama model-downloader 1/3] FROM docker.io/library/alpine:3.20@sha256:d9e853e87e55526f6b2917df91a2115c36dd7c696a35be12163d44e6e2a4b6bc   0.0s
 => [llm-serving-llama stage-1 1/2] FROM ghcr.io/ggml-org/llama.cpp:server@sha256:052888c603894ecfa08deb6714fdc2d7084e491e174d5ab41bfb36b49ee7151c      0.0s
 => CACHED [llm-serving-llama model-downloader 2/3] RUN apk add --no-cache curl                          0.0s
 => CACHED [llm-serving-llama model-downloader 3/3] RUN mkdir -p /models && curl -fL --retry 3 "https://huggingface.co/Qwen/Qwen2-0.5B-Instruct  ...   0.0s
 => CACHED [llm-serving-llama stage-1 2/2] COPY --from=model-downloader /models/qwen2-0_5b-instruct-q4_k_m.gguf /models/qwen2-0_5b-instruct-q4_...    0.0s
 => [llm-serving-llama] exporting to image                                                               0.0s
 => => exporting layers                                                                                  0.0s
 => => writing image sha256:a6dcac02ea7f576e6c14ef765e2165b05ab45be5a5565a02e3655eef4af47c4d             0.0s
 => => naming to docker.io/library/llm-serving-llama:local                                               0.0s
 => [llm-serving-llama] resolving provenance for metadata file                                           0.0s
[+] Running 4/4
 ✔ llm-serving-llama:local      Built                                                                    0.0s
 ✔ llm-serving:local            Built                                                                    0.0s
 ✔ Container llm-serving-llama  Healthy                                                                  6.6s
 ✔ Container llm-serving        Started                                                                  6.3s
四、测试过程
4.1 运行压测
对 8002 端口的 FastAPI 压测 180 秒,并发 2,每 2 个请求里有 1 个流式:
bash
(.venv) (base) igwanglyang@MacbookProdahouzicn llm-serving % BASE_URL=http://127.0.0.1:8002 \
DURATION_SECONDS=180 \
CONCURRENCY=2 \
STREAM_EVERY=2 \
python tests/load_metrics.py
Target: http://127.0.0.1:8002
Duration: 180s; concurrency: 2; model: qwen2:0.5b; stream every 2 request(s)
Initial /health: HTTP 200 {"status":"ok","service":"llm-serving","backend":"llama.cpp"}

========== CLIENT-SIDE LOAD SUMMARY ==========
Finished at: 2026-10-13T11:15:33+08:00
Elapsed: 183.0s; issued operations: 161; throughput: 0.88 ops/s
chat_nonstream_ok: 71
chat_nonstream_requests: 71
chat_nonstream_status_200: 71
chat_response_bytes: 1365479
chat_stream_ok: 71
chat_stream_requests: 71
chat_stream_status_200: 71
chat_total_latency_ms: 357040
client_input_tokens_reported: 7856
client_output_tokens_reported: 9467
health_ok: 9
health_requests: 9
health_status_200: 9
models_ok: 10
models_requests: 10
models_status_200: 10
stream_content_chunks: 4648
stream_done: 71
http latency samples: 19
http latency P50: 0.011s
http latency P90: 0.018s
http latency P95: 0.048s
http latency P99: 0.068s
chat latency samples: 142
chat latency P50: 2.105s
chat latency P90: 4.202s
chat latency P95: 5.593s
chat latency P99: 8.643s
Streaming first-content samples: 71
Client observed first-content P50: 0.087s
Client observed first-content P90: 0.162s
Client observed first-content P95: 0.172s

========== PROMETHEUS COUNTER DELTAS ==========
llm_requests_total: +142
llm_input_tokens_total: +7856
llm_output_tokens_total: +9467
llm_request_duration_seconds_count: +142
llm_ttft_seconds_count: +71

PromQL: sum(rate(llm_requests_total[1m]))
PromQL: histogram_quantile(0.95, sum by (le) (rate(llm_ttft_seconds_bucket[5m])))
4.2 客户端结果解读
| 项目 | 结果 | 说明 |
|---|---|---|
| 压测时长 | 180s 设定,实际 183.0s | 截止后不再发新请求,等待在途请求完成 |
| 总操作数 | 161 | 聊天 142 + health 9 + models 10 |
| 吞吐 | 0.88 ops/s | 161 ÷ 183.0 |
| 聊天请求 | 142(非流式 71 + 流式 71) | 全部 HTTP 200,没有错误样例 |
| health / models | 9 / 10,全部 HTTP 200 | 与分配规则推算的次数一致 |
| 流式完成 | stream_done: 71 |
71 个流式请求都收到了 [DONE] |
| 流式内容块 | 4648 个 | 平均每个流式请求约 65 个 chunk(4648 ÷ 71) |
| 响应体总量 | 1,365,479 字节 | 非流式的响应体大小 + 流式读取到的文本行长度 |
延迟(客户端观测):
| 类别 | 样本数 | P50 | P90 | P95 | P99 |
|---|---|---|---|---|---|
/health + /v1/models |
19 | 0.011s | 0.018s | 0.048s | 0.068s |
| 聊天(完整响应) | 142 | 2.105s | 4.202s | 5.593s | 8.643s |
| 流式首字(first-content) | 71 | 0.087s | 0.162s | 0.172s | --- |
几点分析:
- 首字延迟只有约 0.09 秒,而完整响应要 2 秒多:流式的价值就在这里,用户几乎立刻就能看到第一个字,后面的内容边生成边显示。
- 聊天延迟的长尾:P99(8.6 秒)约为 P50(2.1 秒)的 4 倍,符合"输出越长耗时越长"的特点------输出长度由模型决定,每次不同。
- 并发被模型速度吃满 :聊天总耗时
chat_total_latency_ms: 357040(357 秒),而 2 个 worker 在 183 秒里一共有约 366 个 worker 秒,也就是说 worker 约 97% 的时间都在等模型。要提高吞吐,得加快单次推理或增加并发,而不是调脚本。 - 平均每个聊天请求:输入约 55 个 token(7856 ÷ 142)、输出约 67 个 token(9467 ÷ 142)、耗时约 2.5 秒(357.04 ÷ 142)。
4.3 Prometheus 对账结果
| Prometheus 指标 | 增量 | 客户端统计 | 是否一致 |
|---|---|---|---|
llm_requests_total |
+142 | 聊天请求 71 + 71 = 142 | ✅ |
llm_input_tokens_total |
+7856 | client_input_tokens_reported: 7856 |
✅ |
llm_output_tokens_total |
+9467 | client_output_tokens_reported: 9467 |
✅ |
llm_request_duration_seconds_count |
+142 | 聊天请求 142 | ✅ |
llm_ttft_seconds_count |
+71 | 流式请求 71 | ✅ |
结论:应用的 Prometheus 指标和客户端观测到的请求、Token、首字样本数完全吻合,包括流式请求(流式请求的 token 也被正确累计了)。再次强调,这是"同源"对账,验证的是应用的统计与转发,而不是后端 token 数本身是否准确。
输出末尾脚本打印了两条 PromQL,可以在 Prometheus 里直接使用:
promql
sum(rate(llm_requests_total[1m]))
histogram_quantile(0.95, sum by (le) (rate(llm_ttft_seconds_bucket[5m])))
五、在 Langfuse 里对账
5.1 时间窗口
压测结束于 2026-10-13T11:15:33+08:00,耗时 183.0 秒,所以开始时间约为 11:12:30(UTC+8)。在 Langfuse 的 Tracing 页面里,把时间范围设为这段时间(留一点余量),并按环境 development 过滤。
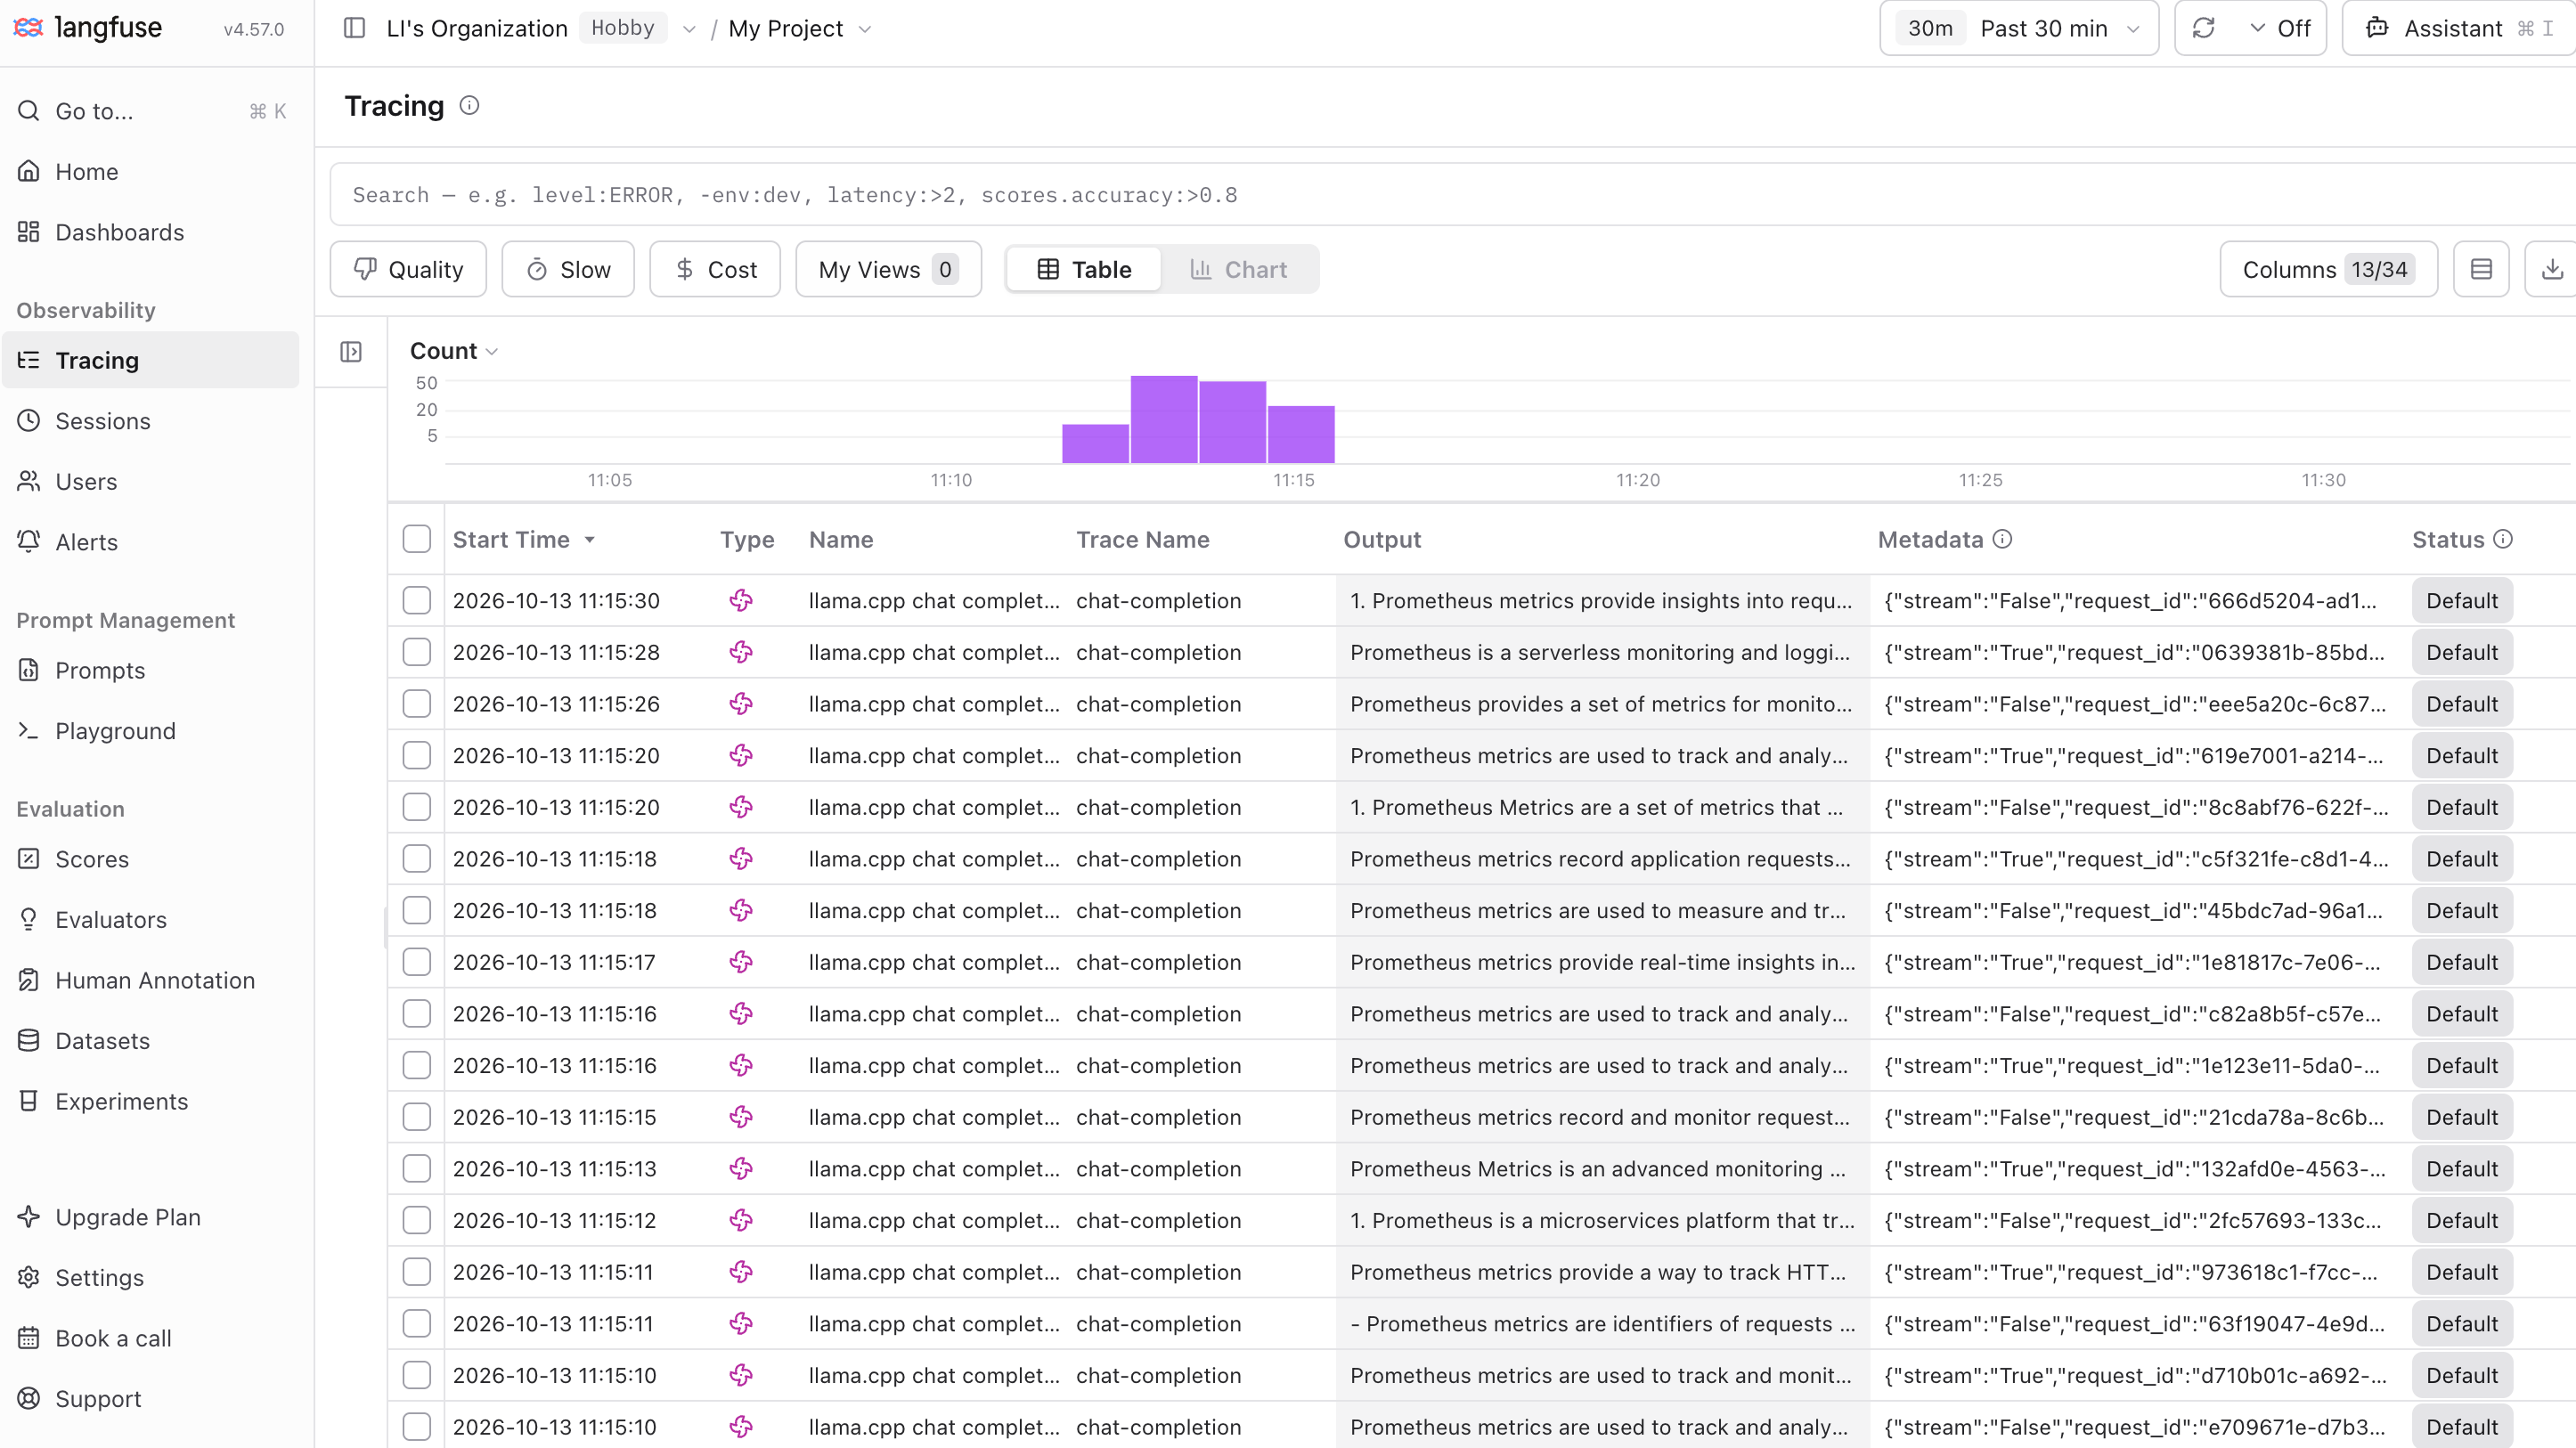
5.2 对账项与判断标准
| 对账项 | 预期 | 实际(待补充) | 不一致时的可能原因 |
|---|---|---|---|
Trace 数量(llm-serving.chat-completions) |
142 | 只追踪了非流式则为 71,说明流式分支没有埋点;或 SDK 还没来得及上传 | |
Generation 数量(llama.cpp.inference) |
142 | 同上 | |
| 其中非流式 / 流式 | 71 / 71 | 流式需要单独处理,示例代码只覆盖非流式 | |
| 输入 Token 合计 | 7856 | usage 字段名或取值方式不对;缺失时被记成 0 | |
| 输出 Token 合计 | 9467 | 同上;流式响应里没有读到 usage | |
| 错误数量 | 0 | 压测中所有请求都是 HTTP 200 | |
/health、/v1/models |
不应出现在 Trace 里 | 如果出现,说明追踪埋点放得太宽 |
这次压测里每两个聊天请求就有一个是流式的(
STREAM_EVERY=2),正好可以用来检验流式是否被追踪。2.3 里的示例只覆盖非流式,如果 Trace 数量只有 71,就说明流式分支还需要补埋点。
5.3 Token 用量的核对
Langfuse 里的 Token 用量与 Prometheus、客户端三者应该是同一组数字(7856 / 9467)。如果 Langfuse 里的数值与它们不同,优先检查:
- 应用是否把后端返回的
usage原样记录,而没有按字符数估算; - 缺失
usage时有没有被记成 0 而不是"未知"; - 流式响应是否读到了带
usage的最后一个 chunk。
测试脚本概览
| 项目 | 说明 |
|---|---|
| 作用 | 对 FastAPI + llama.cpp 执行有限时长的并发压测 ,并用压测前后 /metrics 的差值,核对 Prometheus 指标是否与客户端统计一致 |
| 运行方式 | python tests/load_metrics.py --duration 120 --concurrency 3 --stream-every 2 |
| 默认负载 | 运行 60 秒、并发 2,适合本地小模型 |
| 依赖 | Python 标准库 + httpx(异步 HTTP 客户端) |
| 并发模型 | asyncio:concurrency 个 worker 协程各自循环发请求,直到截止时间 |
| 被测接口 | GET /health、GET /v1/models、POST /v1/chat/completions(非流式 + 流式)、GET /metrics |
| 启动前检查 | 先请求一次 /health,不是 2xx 就立即退出,避免把无效请求当成压测结果 |
| 输出 | 客户端汇总、延迟分位数、流式首字延迟、Prometheus 计数器增量、错误样例、两条 PromQL 提示 |