目录
[二、核心三态:运行、阻塞 、挂起](#二、核心三态:运行、阻塞 、挂起)
[2.1 调度队列与运行状态](#2.1 调度队列与运行状态)
[2.2 阻塞状态](#2.2 阻塞状态)
[2.3 挂起状态](#2.3 挂起状态)
[Swap 分区](#Swap 分区)
[换出(Swap Out)](#换出(Swap Out))
[换入(Swap In)](#换入(Swap In))
[3.1 内核链表 vs 普通链表](#3.1 内核链表 vs 普通链表)
[3.2 list_head 的巧妙设计](#3.2 list_head 的巧妙设计)
[3.3 为什么这样设计?](#3.3 为什么这样设计?)
[四、Linux 的进程状态](#四、Linux 的进程状态)
[4.1 R 状态(运行状态)](#4.1 R 状态(运行状态))
[纯计算进程(R 状态)](#纯计算进程(R 状态))
[前台 vs 后台进程](#前台 vs 后台进程)
[4.2 S 状态(阻塞/休眠状态)](#4.2 S 状态(阻塞/休眠状态))
[4.3 T 和 t 状态(暂停状态)](#4.3 T 和 t 状态(暂停状态))
[t 状态(追踪暂停)](#t 状态(追踪暂停))
[T 状态(停止)](#T 状态(停止))
[4.4 D 状态(深度睡眠/磁盘休眠/阻塞状态)](#4.4 D 状态(深度睡眠/磁盘休眠/阻塞状态))
[S 状态的另一种叫法](#S 状态的另一种叫法)
[D 状态的引入](#D 状态的引入)
[为什么需要 D 状态?](#为什么需要 D 状态?)
[D 状态的特点](#D 状态的特点)
[什么时候出现 D 状态?](#什么时候出现 D 状态?)
[模拟 D 状态(有风险)](#模拟 D 状态(有风险))
[4.5 X 状态(死亡状态)](#4.5 X 状态(死亡状态))
[4.6 Z 状态(僵尸状态)](#4.6 Z 状态(僵尸状态))
[模拟 Z 状态](#模拟 Z 状态)
[1. 内存泄漏的本质](#1. 内存泄漏的本质)
[2. 进程结束后内存泄漏还在不在?](#2. 进程结束后内存泄漏还在不在?)
[3. 为什么常驻内存的进程内存泄漏更危险?](#3. 为什么常驻内存的进程内存泄漏更危险?)
[4. 僵尸进程多了会怎样?](#4. 僵尸进程多了会怎样?)
[5. 解决僵尸进程](#5. 解决僵尸进程)
[4.7 为什么没有挂起状态?](#4.7 为什么没有挂起状态?)
[5.1 定义](#5.1 定义)
[5.2 实验验证](#5.2 实验验证)
[5.3 1 号进程](#5.3 1 号进程)
[5.4 为什么要领养?](#5.4 为什么要领养?)
[六、内核结构申请与 Slab 机制](#六、内核结构申请与 Slab 机制)
引言:
每一个活着的人都有自己所对应的状态,可以理解为"进行时"。状态决定了你当前正在做什么事,以及系统该如何看待你------比如逃课的学生,在学校的角度就是"坏学生"。
同样,对于进程来讲,进程状态用来决定这个进程当前要被调度、要被运行,还是正在休眠,还是正在进行等待。它的状态决定了系统在系统层面应该如何处理这个进程。
进程状态的本质就是 task_struct 结构体内的一个整型变量。在操作系统内,我们可以定义宏(#define)来表示 running、sleep、stop 等各种各样的状态宏值,然后在 task_struct 里定义一个整型变量。将来进程处于什么状态,我们就改成对应状态的宏值即可。
话不多说,开始正文
一、课本上的进程状态概念
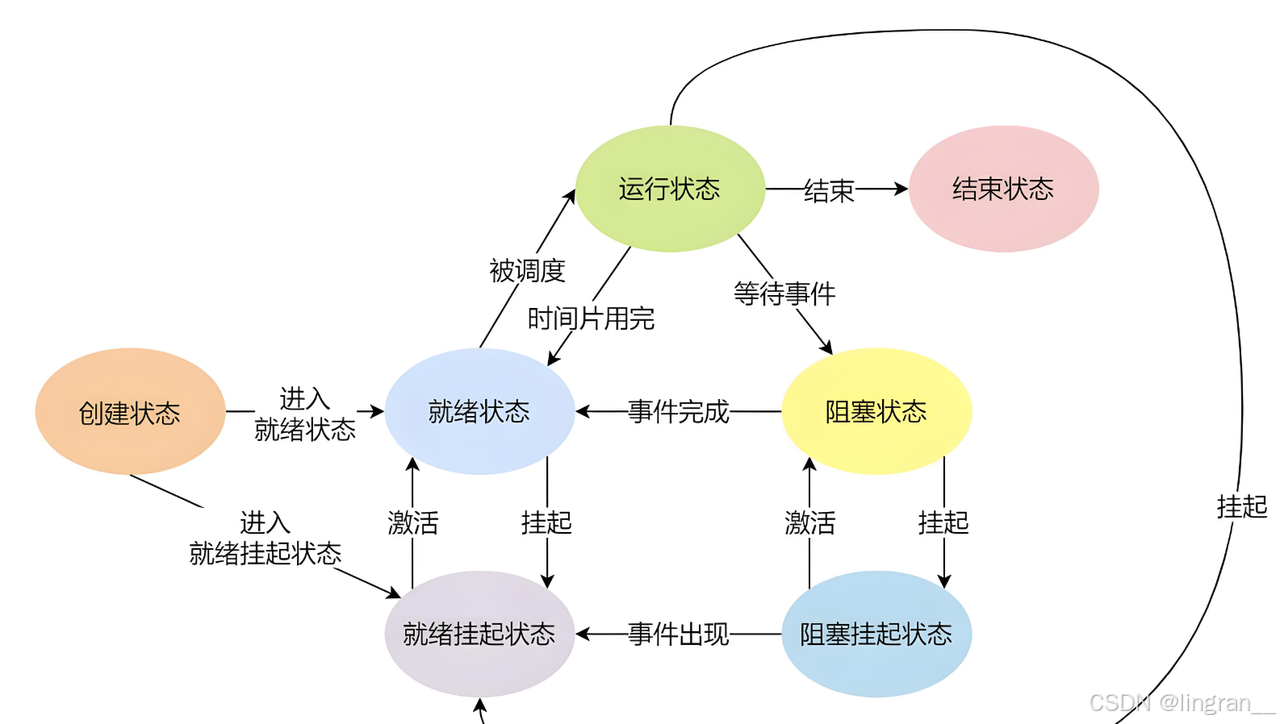
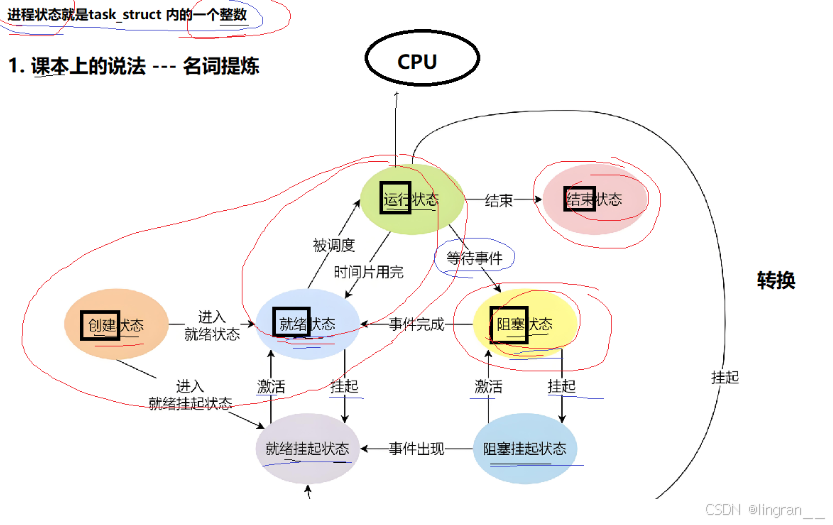
进程的状态有很多,如:创建、就绪、阻塞、运行、结束 等。其中只有运行状态是真正意义上持有 CPU 的,即进程能被 CPU 调度执行。
进程的状态可以进行互相转化。
二、核心三态:运行、阻塞 、挂起
2.1 调度队列与运行状态
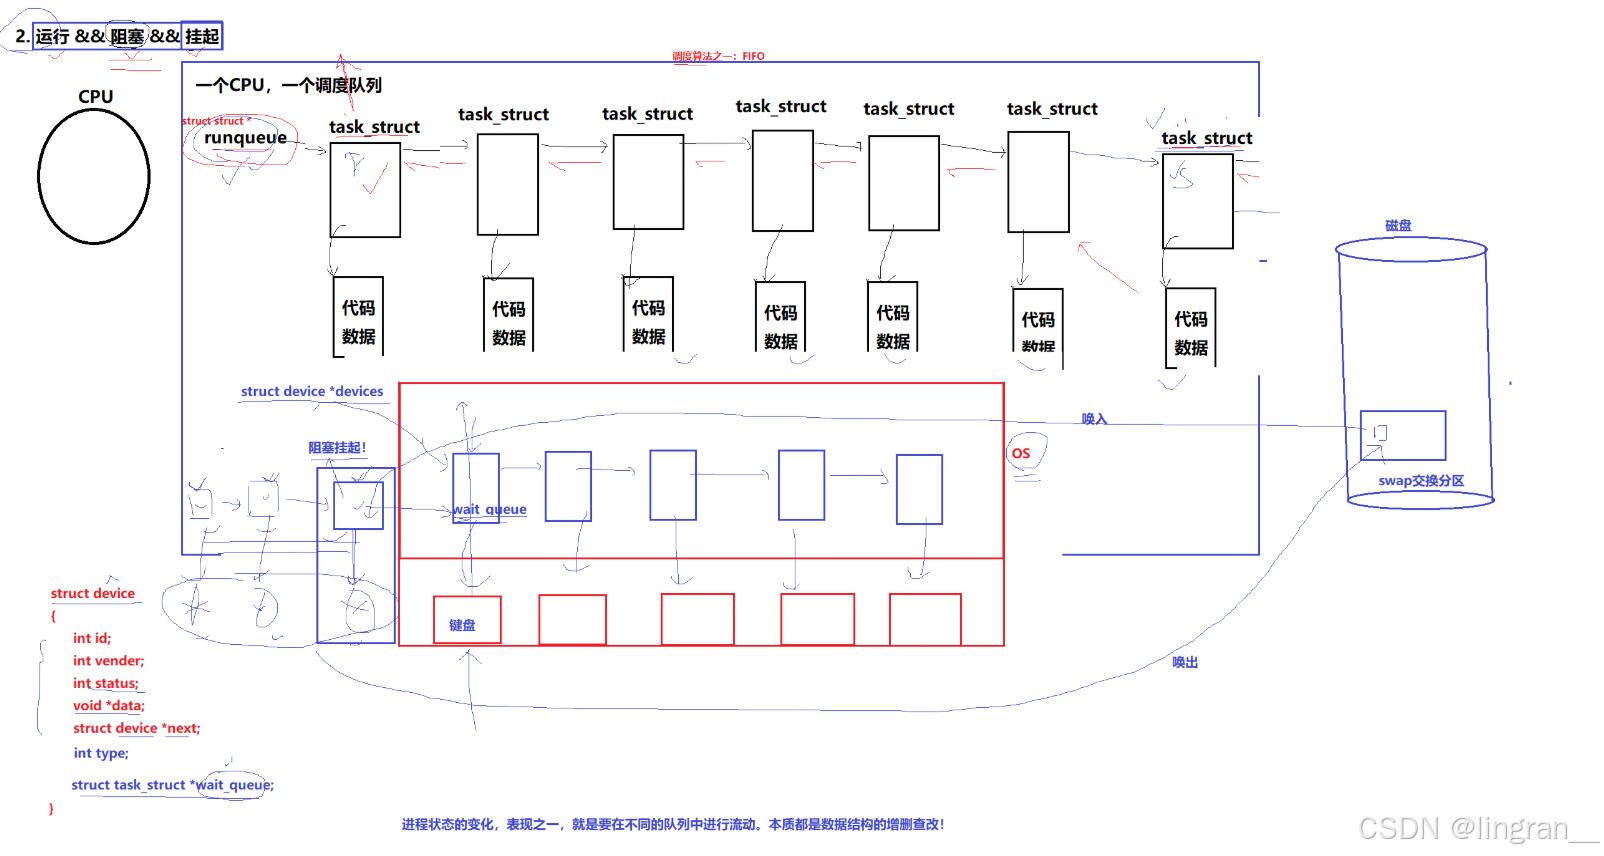
系统中存在多个进程,但只有少量的 CPU。一个进程要在 CPU 上运行,本质上每个 CPU 都要在系统内部维护一个调度队列 。CPU 选择一个进程去运行,本质并不是选择这个进程的代码数据去运行,而是选择一个进程的 PCB(Process Control Block) 来进行运行。
- 一个 CPU 对应一个调度队列
- Linux 内核中调度队列叫做 runqueue ,类型可以看作
task_struct*
注意:所有进程的 PCB 在系统中是放在一个全局双向链表 中的,但这个双向链表不是 CPU 的调度队列。
Linux 内核对于 PCB 的维护采用了一种巧妙的设计------让一个 task_struct 既可以属于全局双向链表,又可以把相关进程放在调度队列里。也就是说,一个进程 PCB 节点既可以属于 A 数据结构,又可以属于 B 数据结构。
调度队列里所谓的 task_struct 对应的队列和全局双向链表是两种不同结构 。操作系统内部专门为每个 CPU 设计了一个队列,遵循头出尾进的原则(这个调度队列其实也是双向链表)。
FIFO(先进先出)是一种调度做法:队列中越靠近头部的优先级越高,CPU 按照顺序依次选择
task_struct进行调度执行。这种调度做法并不是Linux的做法,也不是大部分操作系统的做法,我以这个调度做法来讲解
什么是运行状态?
一个进程在 CPU 上跑的时候,它就是运行状态 。但在当代计算机中,只要一个进程在调度队列里面,这个进程其实就是运行状态------要么是正在调度,要么是正在运行,要么是已经随时准备好了。
2.2 阻塞状态
从生活例子理解阻塞
C 语言中的 scanf、C++ 中的 cin,程序运行到这些函数时会停下来等待输入。严格来说,就是进程停下来了,等待我们输入,拿到数据后才继续运行。
现在重新理解:当调用 scanf、cin 时,我们并不是等待用户输入,而是等待键盘硬件就绪 (即键盘被按下)。用户没有按下键盘时,称为键盘硬件不就绪。既然键盘不就绪,scanf、cin 所在的进程就无法读取数据,就必须等待。
阻塞的意义:等待某种设备或资源就绪。
设备与等待队列
键盘、显示器、网卡、磁盘、摄像头、话筒等都是设备,但这些设备不一定都是就绪的:
scanf时键盘可能没有按下 → 进程阻塞- 往显示器打印但显示器被其他进程占用 → 进程阻塞
- 往磁盘写但磁盘 IO 压力过大 → 进程阻塞
操作系统要对软硬件资源进行管理,先描述,再组织。
除了运行(调度)队列,操作系统还要管理设备,自然也有设备队列 。如果对应设备没有就绪,进程就要开始阻塞。操作系统中,可以在存储设备信息的结构体里加上一个指向进程信息结构体的指针属性,这个存在于设备结构体中的指向进程结构体的指针,称为等待队列。
每一个设备都有自己对应的一个等待队列。
阻塞状态的转换过程
- CPU 运行进程,执行到
scanf,读取键盘 - 操作系统检查键盘状态,发现没有按键被按下
- 操作系统把这个进程从 CPU 上拿下来,从运行队列移走
- 将该进程的 PCB 链入到键盘设备的等待队列中
- 该进程不再在运行队列里,永远不会被调度 → 阻塞状态
当键盘被用户按下:
- 硬件就绪,操作系统第一时间知道
- 查看对应设备的等待队列,发现指针不为空
- 将等待队列头部进程状态设为运行状态
- 将该进程重新链回到运行队列中
- CPU 调度该进程时,继续执行
scanf,从设备读取数据
结论:进程从运行队列到阻塞状态的本质,是把 PCB 链入到不同的队列结构中。从阻塞状态再回到运行状态,本质上是找到 PCB,再把它链回运行队列。
进程状态的变化,表现之一就是要在不同的队列中进行流动,本质都是数据结构的增删查改。
2.3 挂起状态
挂起是操作系统里一个比较极端的情况。
假设计算机内存资源严重不足,操作系统需要想办法释放内存。有些数据当前不会被立即访问,但还占着内存------比如上面讲的阻塞状态的进程,这些进程的代码和数据根本就不会被执行和使用(除非设备就绪)。
Swap 分区
一般在操作系统制作时,磁盘中会存在一个特定分区,称为 swap 分区(交换分区),大小通常跟内存总大小一样,或者是内存的 1.5 倍、2 倍。
换出(Swap Out)
当内存严重不足时,操作系统只将阻塞进程的 PCB 存下来,把阻塞进程的代码和数据 直接置换到磁盘的 swap 分区上。此时这些进程的状态称为阻塞挂起。
挂起是当系统内存资源吃紧时,操作系统做一些内存页面置换算法,把不会被调度的进程的代码和数据换出到磁盘的 swap 分区上。
换入(Swap In)
硬件一旦就绪,操作系统知道后,会把对应进程曾经换入到磁盘的代码和数据重新加载到内存,重新构建指针映射让 PCB 找到,形成完整进程,然后再把这个进程放到运行队列里。
运行挂起
如果操作系统资源不是吃紧,而是相当吃紧 ,把阻塞进程全挂起到外设上还是不够,操作系统就可能打运行队列中进程的主意。CPU 不可能同时执行几十个进程,操作系统甚至可能把正在运行队列末端的进程的代码数据也交换到 swap 分区,当真正调度到时再换进来。此时这种状态称为运行挂起状态。
不管什么挂起,挂起本质是把进程的代码和数据换出到磁盘的 swap 分区。

三、理解内核链表的设计
3.1 内核链表 vs 普通链表
内核中实现的链表节点和我们在数据结构中所实现的链表节点不同:
- 普通链表:节点包含数据和 next/prev 指针
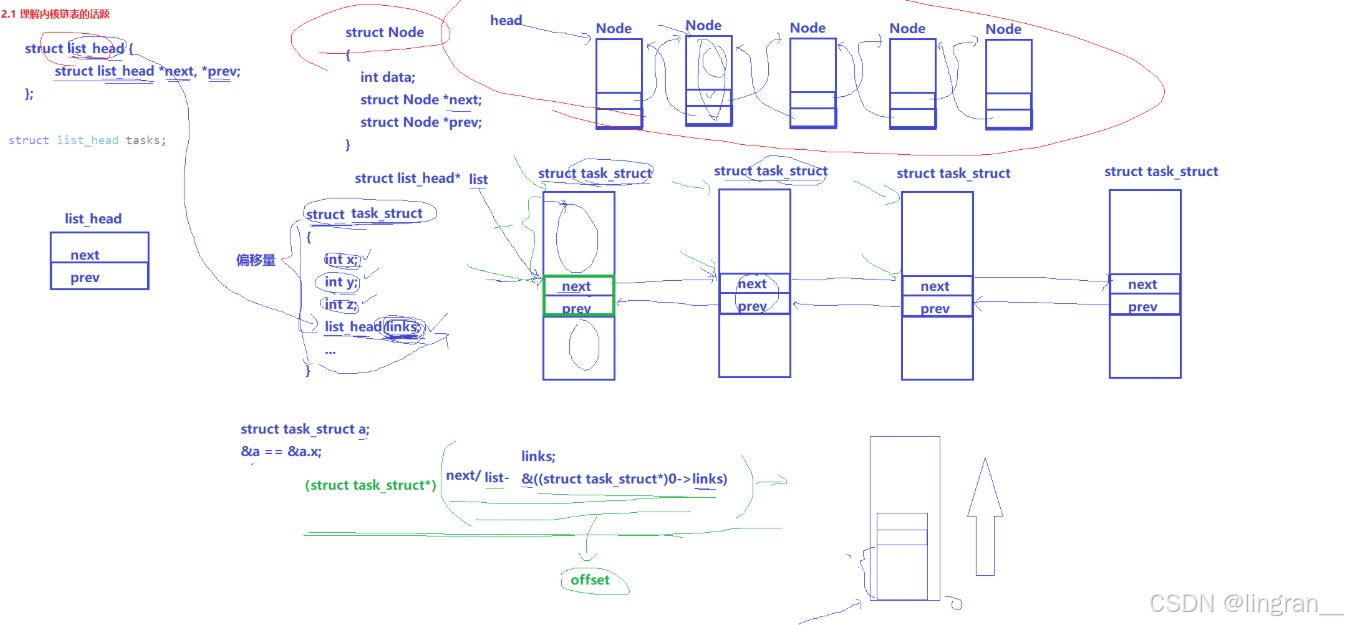
- 内核链表 :节点不包含数据 ,只把
next和prev两个指针单独封装成一个节点类型list_head
3.2 list_head 的巧妙设计
把 list_head 作为目标数据结构(如 task_struct)的成员。连接节点时:
- 不需要让
next指向下一个task_struct next指针指向的是下一个list_headprev同理
如何访问其他属性?
在一个结构体里,结构体变量本身的地址和第一个成员的地址在数字上相等。所有成员的地址依次增大,遵从内存对齐原则。
可以通过 &((struct task_struct*)0->links) 或宏 offset 来得到 list_head 属性地址离 task_struct 起始地址的偏移量。通过这个偏移量,可以得到对应 list_head 成员属性所在的 task_struct 起始地址,再强转成 task_struct*,就可以访问结构体内的所有成员属性。
3.3 为什么这样设计?
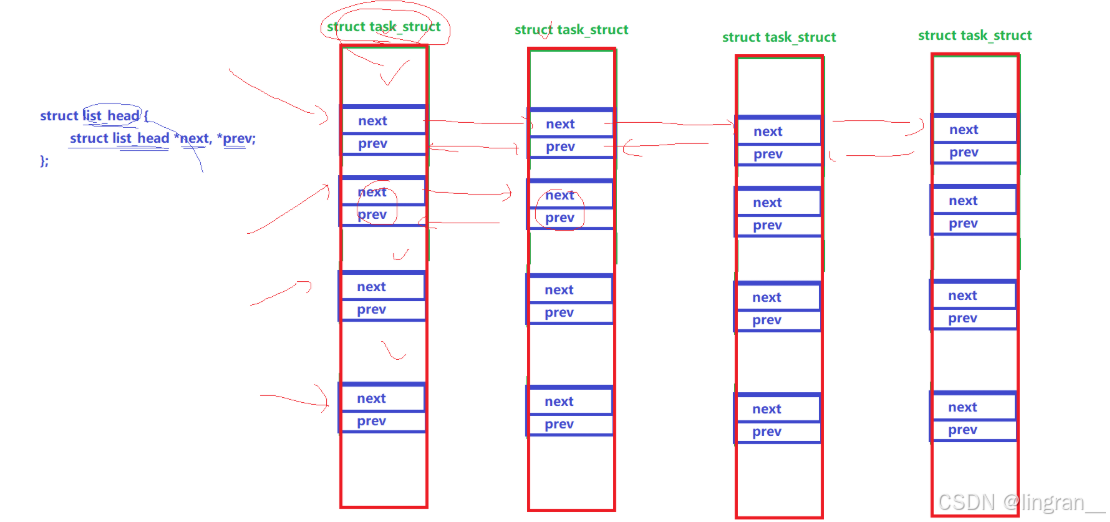
这个设计十分巧妙,一个进程能被多个不同进程状态的队列管理也是因为这个设计:
- 一个
task_struct可以存很多个list_head作为成员属性 - 每个
list_head属性代表的意义不同:- 代表运行进程的
list_head - 代表阻塞进程的
list_head - 代表全局双向链表的
list_head
- 代表运行进程的
对于不同需求,可以用对应的 list_head 属性把这些 PCB 连接起来。这样,task_struct 对象既能属于运行队列,又能属于全局链表,还能属于阻塞队列,也能放到任何数据结构里(只要这个数据结构是节点类型)。
这样 PCB 就可以随便链接了。一个 PCB 在内核中只存在一份,却能出现在不同数据结构里。
这种设计意味着 Linux 内核中很多数据结构其实是网状 的。我们只需要设计 list_head 的增删查改方法,就能让整个系统全部都能使用。
四、Linux 的进程状态
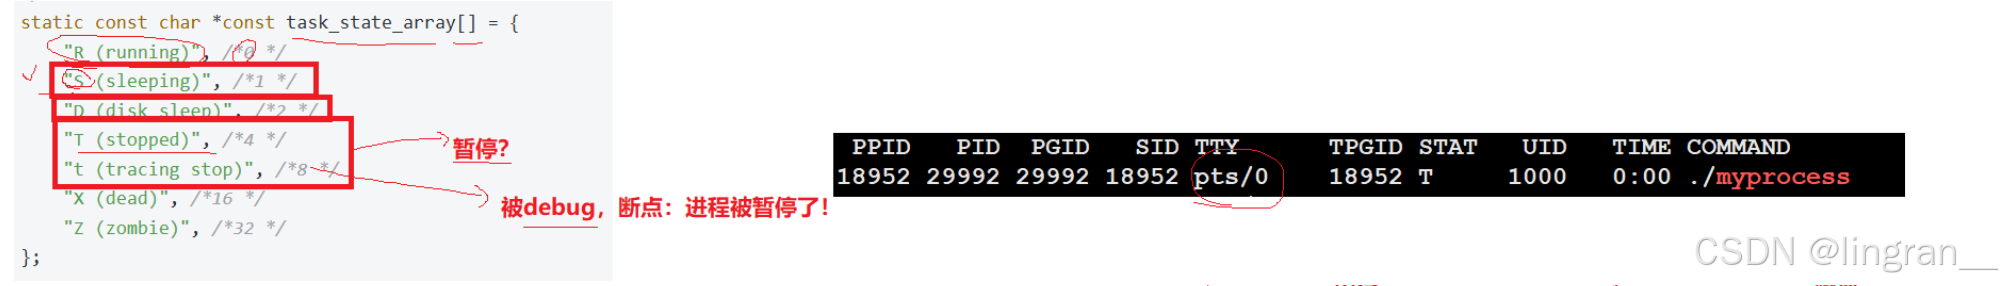
Linux 内核中定义了以下状态:
static const char *const task_state_array[] = {
    "R (running)",       /* 0 */
    "S (sleeping)",      /* 1 */
    "D (disk sleep)",    /* 2 */
    "T (stopped)",       /* 4 */
    "t (tracing stop)",  /* 8 */
    "X (dead)",          /* 16 */
    "Z (zombie)",        /* 32 */
};
状态被维护在 task_state_array 数组里,所以表示状态的属性数据类型是整型,对应状态就是数组的下标。打印时直接把整数值转化成字符串即可。
4.1 R 状态(运行状态)
R 就是上面说的运行状态。
实验验证
#include <iostream>
#include <unistd.h>
using namespace std;

int main() {
    while(1) {
        cout << "hello linux" << endl;
    }
    return 0;
}
观察命令:
while :; do ps axj | head -1 ; ps axj | grep test1 | grep -v grep; sleep 1; done结果 :进程状态大部分是 S+,R+ 只出现了一次。
bash
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:00 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:01 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 R+    1001   0:01 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:01 ./test1
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
 1320 12572 12572  1320 pts/0    12572 S+    1001   0:01 ./test1
原因 :cout 需要向外设打印数据,需要用到硬件。程序运行时大部分时间花在了 IO 上,所以进程中一大部分时间处于阻塞状态(等待硬件就绪)。进程一直在阻塞和运行状态之间切换。
纯计算进程(R 状态)
去掉 IO 操作:
int main() {
    while(1) {}  // 纯计算,无 IO
    return 0;
}
结果 :进程状态一直为 R+(运行状态)。
前台 vs 后台进程
R+中的+表示前台启动- 后台启动:
./test1 &,状态为R(没有+) - 后台进程不能用
Ctrl+C杀死,要用kill -9 pid
4.2 S 状态(阻塞/休眠状态)
S 就是上面说的阻塞状态。在 Linux 角度也称为休眠状态。
实验验证
int main() {
    cout << "进程已经在执行,进程id为:" << getpid() << endl;
    int k;
    cin >> k;  // 等待键盘输入
    return 0;
}
结果 :进程状态为 S+
原因 :程序运行到 cin 时等待键盘就绪,进程被链到等待队列,进入阻塞状态。
4.3 T 和 t 状态(暂停状态)
t 状态(追踪暂停)
用于调试场景。编译 debug 版本,用 gdb 打开:
g++ test1.cpp -o test1 -g
gdb test1
在 gdb 中打断点并运行:
(gdb) b 11
(gdb) r
结果 :test1 进程状态为 t
原因 :进程被 gdb 追踪,断点让程序暂停。t 状态主要用于 debug。
T 状态(停止)
int main() {
    cout << "进程已经在执行,进程id为:" << getpid() << endl;
    while(1) {}  // 死循环
    return 0;
}
运行后用 Ctrl+Z 暂停:
结果 :进程状态为 T
区别:
t:被 gdb 追踪暂停T:用户通过键盘操作Ctrl+Z暂停,或进程做了非法操作被操作系统暂停
暂停状态的本质
暂停和阻塞(S)不太一样:
- S 状态:进程在等待某种资源
- T/t 状态:进程因为某种条件不具备,或做了非法操作,被操作系统暂停
暂停是 Linux 特有的一种状态,用来做止损 。操作系统怀疑进程有问题,把进程暂停,让用户决定是否继续。t 由用户决定是否继续运行,T 可通过 Ctrl+Z 演示。
信号控制
kill -19 pid:暂停进程kill -18 pid:继续运行进程Ctrl+C/kill -9 pid:终止进程
4.4 D 状态(深度睡眠/磁盘休眠/阻塞状态)
S 状态的另一种叫法
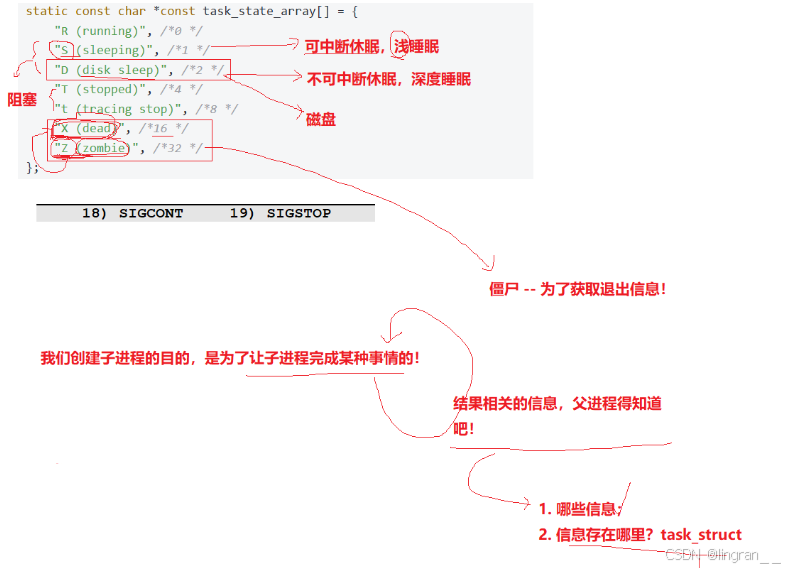
S 称为可中断休眠 ,也称为浅度睡眠。处于 S 状态的进程可以直接被杀死,会响应杀掉它的动作。
D 状态的引入
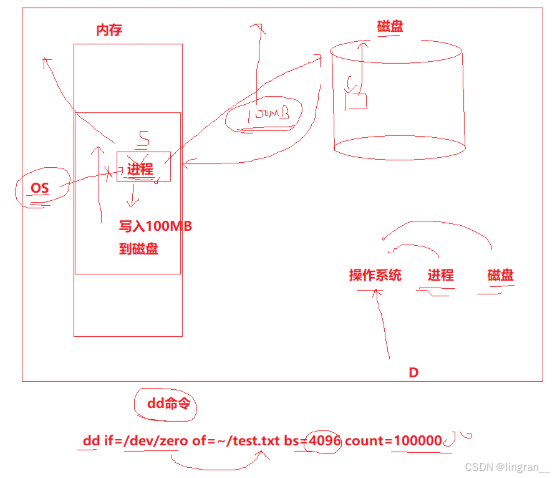
Linux 还有深度睡眠状态(不可中断休眠) ------即 D 状态,描述的是 disk sleep(磁盘休眠)。
为什么需要 D 状态?
场景举例: 一个进程要把 100MB 数据写入磁盘。进程把数据传输给磁盘后,需要等待磁盘存储完成(可能成功也可能失败,磁盘都会反馈结果)。
等待期间,进程设为 S 状态(阻塞)。此时操作系统资源严重不足,可能采取杀进程 的做法节省空间。如果操作系统把这个等待磁盘写入的进程杀掉(注:这也是一些互联网公司后端服务偶尔挂掉、手机 App 闪退的原因之一------系统资源压力过大,操作系统直接杀掉了后端进程。):
- 磁盘写入 90MB 时满了,写入失败
- 磁盘要反馈失败给进程,但进程已被杀掉
- 磁盘拿着 100MB 数据不知道该怎么办,只能丢弃
- 系统层面上丢失了这 100MB 数据
如果这 100MB 是银行一天的转账记录,损失极大。
解决方案 :给进程规定一个 D 状态 。如果进程访问磁盘,等待状态设为 D 状态,操作系统无权杀它,只能杀 S 状态的进程。
D 状态的特点
- 深度睡眠,有权不对任何杀掉动作响应
- 系统遇到 D 状态的进程不要管它
- 只能等 D 状态进程自己醒来,或整个计算机重启(有时重启都不行,只能断电)
什么时候出现 D 状态?
- 涉及对磁盘等关键数据存储设备进行访问时
- 进程进行高 IO 时
- 一般做存储和 IO 的工程师见 D 状态最多
注意:一般我们的磁盘的效率也挺快的,一般查D状态就是瞬时状态,如果系统里出现 D 状态且持续很长时间(秒级别),计算机基本快挂掉了------可能是磁盘老化、寻址出错、错误处理等。
模拟 D 状态(有风险)
dd if=/dev/zero of=~/test.txt bs=4096 count=100000从系统零号设备读数据,写到指定文件,构建块级别 IO。如果看不到 D 状态,可以加大 count。
警告:有风险,可能把磁盘打满,不建议轻易尝试。
4.5 X 状态(死亡状态)
进程死掉了,对应操作系统中的结束状态。此时释放 PCB 和对应的代码数据。
4.6 Z 状态(僵尸状态)
生活类比
一个人在马路上倒下,没有呼吸。警察来后不会直接抬走,而是封锁现场,法医采样化验,确定是自杀、谋杀还是自然死亡。在倒下到被抬走这段时间,这个人已经死亡但还在地上躺着,这个状态就是僵尸状态。
目的:获取这个人退出时的信息。
操作系统角度
创建子进程的目的是让子进程完成某种事情。子进程完成后,父进程需要知道结果。子进程退出时:
- 代码和数据可以释放(不会被调度了)
- PCB 不能释放(需要保存退出信息)
子进程退出后,在父进程获取退出信息之前,进程状态为 Z 状态(僵尸状态)。
进程的退出信息
- main 函数的返回值(退出码):
return 0表示成功,非 0 表示失败 - 不同的退出码代表不同的错误信息
- 进程也可能被信号杀掉,所以退出信息包含退出信号
退出信息保存在 task_struct 里,父进程通过系统调用waitpid获取。
模拟 Z 状态
前提:有父子进程,子进程退出,父进程不获取退出信息。
#include <iostream>
#include <unistd.h>
using namespace std;

int main() {
    pid_t id = fork();
    if (id == 0) {
        int cnt = 5;
        while (cnt) {
            cout << "我是子进程,正在执行ing..." << cnt << endl;
            sleep(1);
            cnt--;
        }
    } else {
        while (1) {
            cout << "我是父进程,正在执行ing..." << endl;
            sleep(1);
        }
    }
    return 0;
}
结果 :子进程退出后状态为 Z+,后面有 <defunct>(失效的、死的)。
僵尸进程的危害
1. 内存泄漏的本质
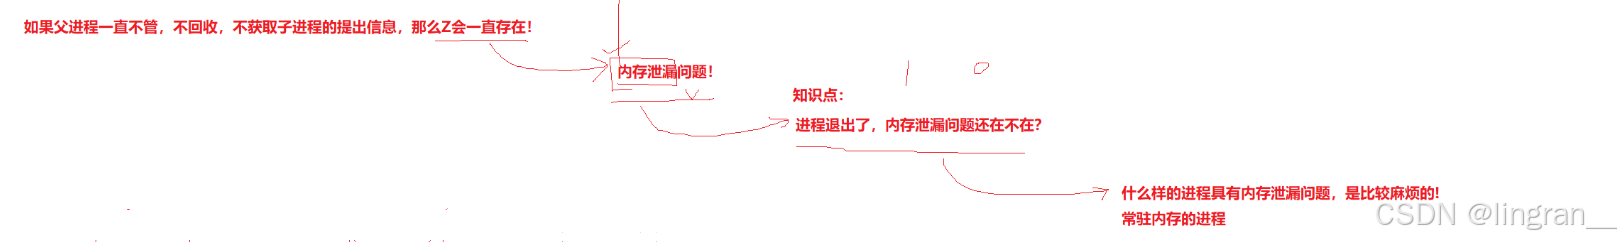
如果父进程一直不管,不回收,不获取子进程退出信息:
- Z 状态一直存在
- 导致内存泄漏(PCB 一直占有内存)
除了动态内存管理会造成内存泄漏,僵尸进程也是内存泄漏的一种。
2. 进程结束后内存泄漏还在不在?
在,而且这是个非常严重的问题。
这里要区分两个概念:
| 内存区域 | 内容 | 进程结束时是否释放 |
|---|---|---|
| 代码和数据段 | 程序的代码、全局变量、动态申请的内存等 | ✅ 释放 |
| PCB(进程控制块) | 进程状态、退出信息、调度信息等 | ❌ 不释放(僵尸状态) |
我们正常写完代码运行时,如果发生了内存泄漏(比如 malloc 后没有 free),但这些内存在代码和数据段中。进程结束时 ,不管是在僵尸状态还是结束状态,代码和数据段的内容都会被操作系统清理掉。所以这种"内存泄漏"实际上随着进程退出就解决了。
但是 PCB 不一样。
如果僵尸状态一直存在,即使进程已经"结束"了,PCB 一直没有被清理掉 。这个 PCB 会常驻在内存里,造成真正的、持久的内存泄漏。
3. 为什么常驻内存的进程内存泄漏更危险?
对于系统来说,常驻内存的进程(启动之后不会自动退出,如操作系统本身、后台服务)如果有内存泄漏问题,影响会比较大。
操作系统本身就是个常驻内存的软件,所以它内部一旦有内存泄漏问题,影响就很大了。
4. 僵尸进程多了会怎样?
僵尸进程一多:
- 内存中积累的 PCB 越来越多
- 可用的内存空间越来越少
- 系统资源逐渐耗尽
- 最终导致操作系统直接崩溃
5. 解决僵尸进程
父进程可以通过 waitpid 等待子进程,获取退出结果并回收僵尸进程:
- 释放 PCB,解决内存泄漏
- 将 Z 状态变为 X 状态
4.7 为什么没有挂起状态?
Linux 用户层没有挂起状态对应的状态符,因为:
- 挂起是内核系统内存资源不足时,操作系统把进程代码和数据换出到 swap 分区
- 换入换出、内存资源释放等工作完全隐藏,不需要用户关心
- 用户只需要知道程序运行起来还是没有运行起来
操作系统里的状态和 Linux 里的状态在概念上一致 ,但在实现上有个性化的一面。
五、孤儿进程
5.1 定义
- 僵尸进程:父进程还存在,但子进程退出且父进程没有回收获取子进程信息
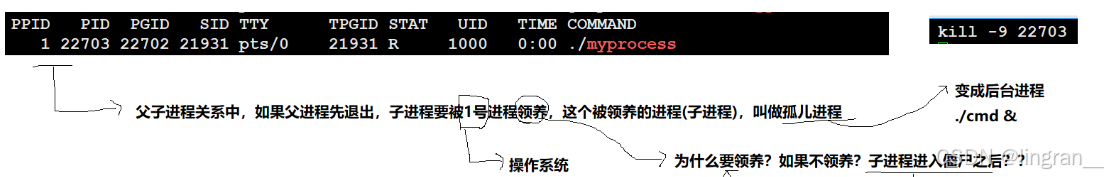
- 孤儿进程 :父进程先退出,子进程后退出 ,子进程被 1 号进程领养
5.2 实验验证
#include <iostream>
#include <unistd.h>
using namespace std;

int main() {
    pid_t id = fork();
    if (id == 0) {
        while (1) {
            cout << "我是子进程,正在执行ing..."
                 << "pid:" << getpid()
                 << " ppid:" << getppid() << endl;
            sleep(1);
        }
    } else {
        int cnt = 5;
        while (cnt) {
            cout << "我是父进程,正在执行..." << cnt
                 << " pid:" << getpid()
                 << " ppid:" << getppid() << endl;
            sleep(1);
            cnt--;
        }
    }
    return 0;
}运行效果:
- 父进程执行 5 秒后退出
- 子进程的
ppid从原父进程变为 1
进程状态 :孤儿进程放在后台运行 (Ctrl+C 不能杀,只能用 kill),状态和正常子进程一样。
5.3 1 号进程
ps axj | head -1 ; ps axj | grep systemd | grep -v grep结果:
bash
 PPID   PID  PGID   SID TTY      TPGID STAT   UID   TIME COMMAND
    0     1     1     1 ?           -1 Ss       0  22:18 /usr/lib/systemd/systemd --switched-root --system --deserialize 22
    1   387   387   387 ?           -1 Ss       0   5:24 /usr/lib/systemd/systemd-journald
    1   420   420   420 ?           -1 Ss       0   0:00 /usr/lib/systemd/systemd-udevd
    1   570   570   570 ?           -1 Ss       0   4:13 /usr/lib/systemd/systemd-logind
    1   575   575   575 ?           -1 Ss      81   8:50 /usr/bin/dbus-daemon --system --address=systemd: --nofork --nopidfile --systemd-activation
1号进程的职责
| 特性 | 说明 |
|---|---|
| 名称 | 新内核叫 systemd,老版本叫 init 或 initd |
| PID | 永远是 1 |
| 由谁创建 | 0号进程创建,然后0号进程被替换 |
| 主要职责 | 系统初始化、进程领养、服务管理、用户登录等 |
| 领养范围 | 系统中所有失去父进程的子进程 |
0号进程是什么?
- 0号进程是系统开机后最早的一个进程
- 它负责创建1号进程
- 创建完成后,0号进程就被1号进程替换掉了
- 所以用户空间中能看到的第一个进程就是1号进程
5.4 为什么要领养?
如果不领养,子进程结束变成僵尸进程后,因为父进程没了,就没有进程能处理这个僵尸进程,造成内存泄漏无法解决。
计算机里能处理子进程的只有两个:
- 子进程的父进程
- 系统(1 号进程)
领养是为了让子进程有新的父进程,新的父进程可以处理子进程的僵尸状态。
六、内核结构申请与 Slab 机制
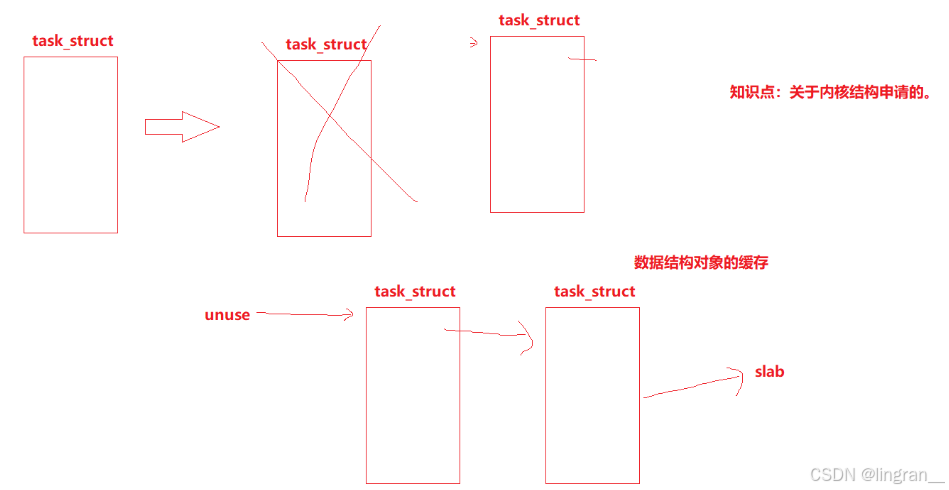
系统中频繁创建进程、释放进程。创建 PCB 一般分两步:申请空间、初始化。
Linux 用 kmalloc 申请 task_struct 结构体,填好属性。回收僵尸进程后释放 PCB。
优化 :释放的 PCB 放到 unuse 链表 中。需要新进程时,如果 unuse 链表中有 PCB,直接取来修改使用,不需要重新 kmalloc。
这种结构体变量的复用,形成了内核中数据结构对象的缓存 ,加速创建和释放进程的速度。这种技术在 Linux 内核中叫做 Slab。
结语:
进程状态是理解操作系统进程管理的核心。从课本上的抽象概念,到 Linux 内核中的具体实现(R、S、D、T、t、X、Z),再到内核链表的巧妙设计、挂起机制的内存管理、僵尸进程和孤儿进程的处理,这些内容构成了完整的进程状态知识体系。
理解这些状态的本质------PCB 在不同队列中的流动------有助于深入理解操作系统的调度机制和资源管理策略。