工业互联网、能源数字化、智能制造这几年的数据量是肉眼可见地涨------设备监测、电力采集、生产过程指标,时序数据每天都在往上垒。
这类系统真正难的地方不在当下这一刻的写入和查询,而在于跑了好几年之后,那几百万个观测点攒下来的历史数据还压不压得住、导不导得进来、管不管得动。今天一个查询慢两秒还能忍,三年后数据归档策略没定下来,就是重构。
金仓时序数据库(KES)这段时间做的优化主要就落在三件事上:存储压缩、历史数据批量插入、以及面向时序场景的数据组织。以下三组数据来自产品侧的实测环境。
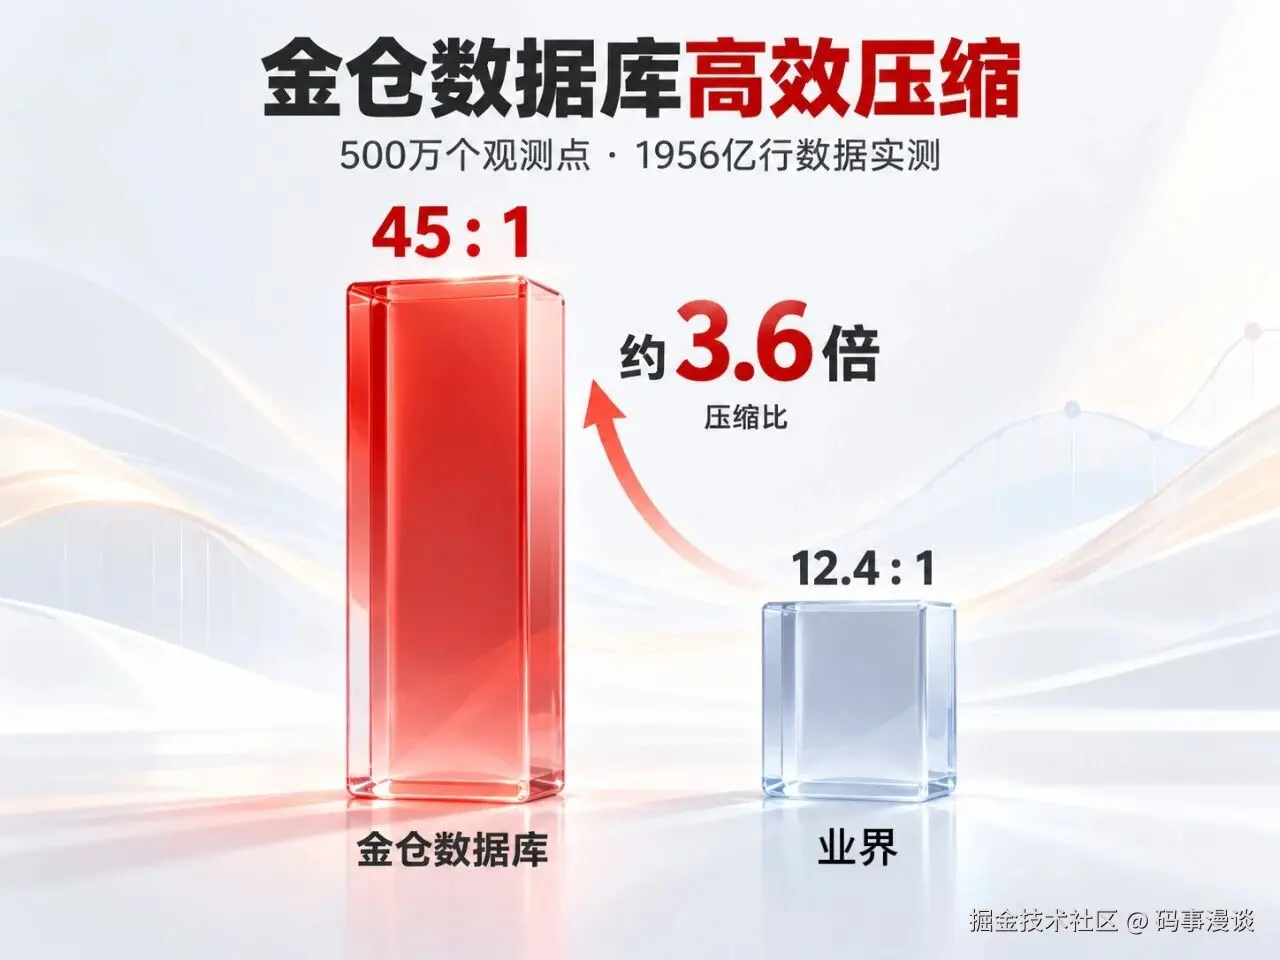
一、压缩:45:1,约业界 3.6 倍
工业时序数据有个天然规律------采集周期固定,相邻时间点之间的数值变化很小。设备温度、电流、压力、转速,绝大部分时间都在小范围内波动。用通用存储方式去存,重复信息就是实打实的浪费,而且这种浪费会随时间线性累积。
KES 的做法是让存储引擎顺着数据的规律走,用上 Delta-of-Delta 差值编码、Gorilla XOR 压缩、字典编码,再叠加列式存储优化,把冗余数据在落盘前就消掉。
实测环境:某省智能电表场景,500 万个观测点,一年 1956 亿行 。压缩比 45:1,约为业界平均水平的 3.6 倍。换算一下,这批数据原本要占的空间,现在只剩约二十二分之一。
二、写入:465 万行/秒,1956 亿行用了 701 分钟
另一种常见的卡点:系统升级、数据迁移、平台重建、智能分析应用落地,都需要把多年的历史数据一次性灌进新环境。TB 级往上的搬运用传统导入方式,写入效率受数据组织方式拖累,数据准备周期会拖得很长,业务上线跟着往后延。
KES 为历史数据单独优化了写入路径,做了面向时序场景的批量加载处理。分布式部署环境下实测:
| 指标 | 结果 |
|---|---|
| 写入数据量 | 1956 亿行 |
| 耗时 | 701 分钟 |
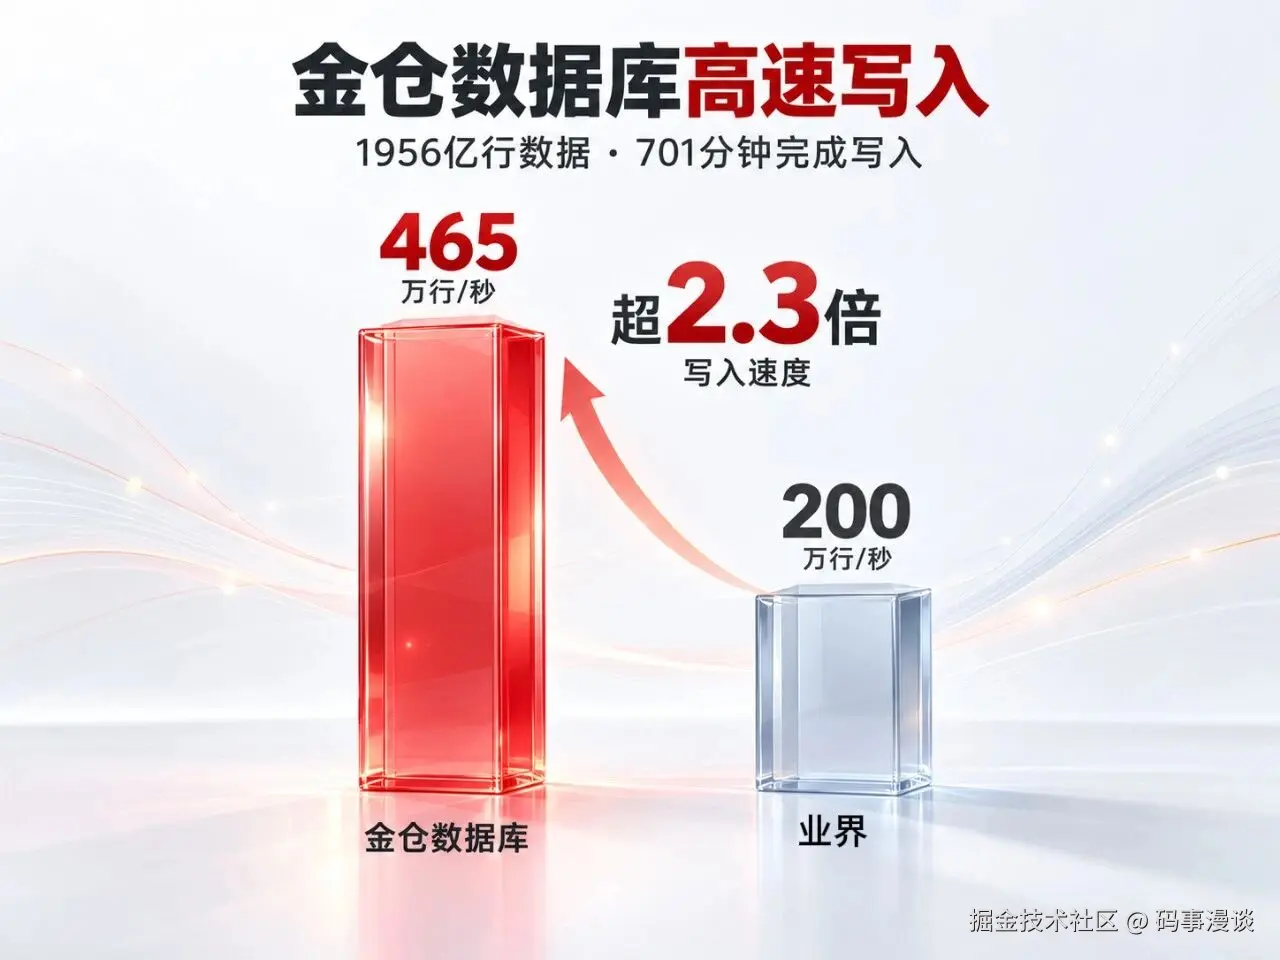
| 平均写入速度 | 465 万行/秒 |
| 对比业界 | 约 2.3 倍以上 |
三、时序超表:曲线查询快了 19.1 倍
工业时序数据的第三个特点是设备多、采样密、时间跨度长------几十万台设备同时按秒级采样,数据怎么组织,直接决定了数据库的响应效率。
KES 提供时序超表机制来承接这些特征。同样的数据规模、同样的表结构,对比普通分区表:
| 场景 | 时序超表 | 普通分区表 | 差距 |
|---|---|---|---|
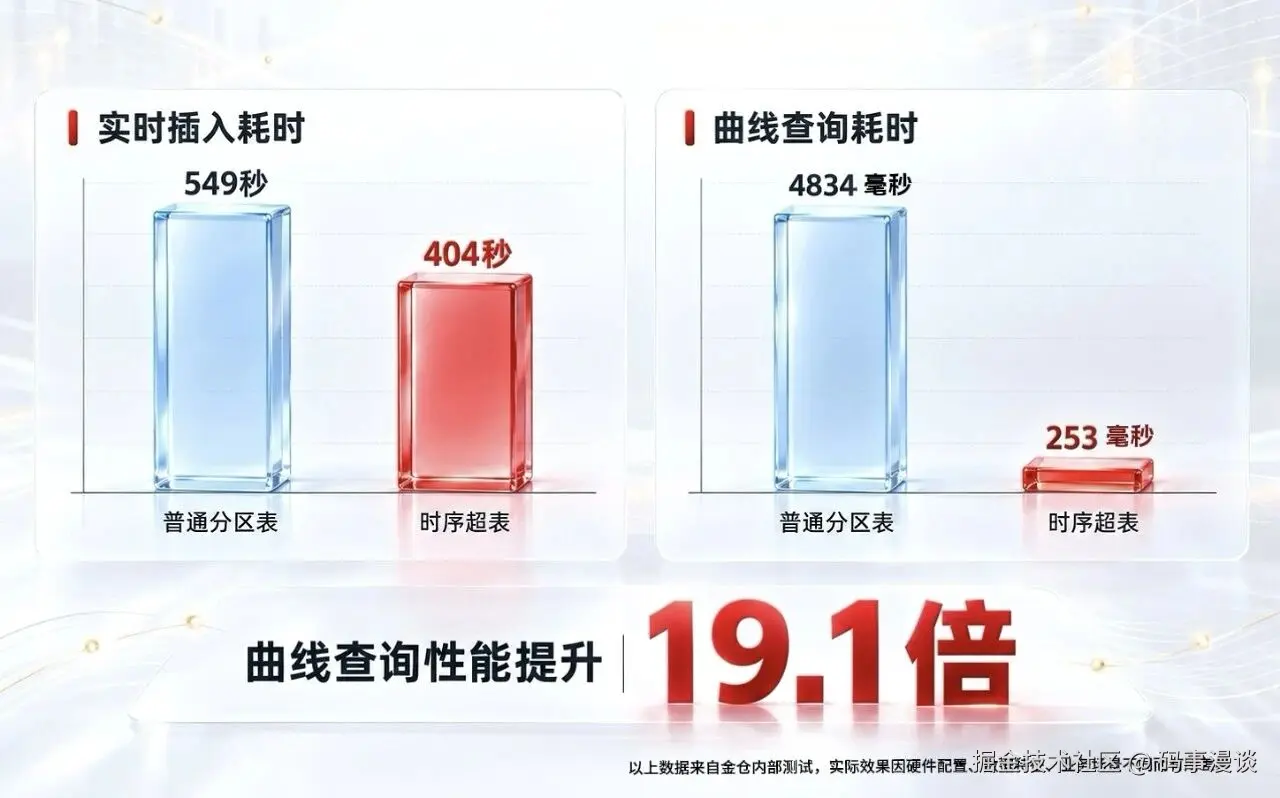
| 实时插入 | 404 秒 | 549 秒 | 快 1.36 倍 |
| 曲线查询 | 253 毫秒 | 4834 毫秒 | 19.1 倍 |
曲线查询这个差距最值得看:设备运维场景里,画一条近期的运行曲线是最高频的操作,普通分区表要等将近 5 秒,时序超表 253 毫秒就出来了。
写在最后
时序数据正在从"顺手存下来的记录"变成企业真正的数据资产------支撑业务分析、设备运维、决策判断都靠它。但规模涨到这个量级,单能写得快不够用,还得存得起、导得进、管得动。
KES 这三个方向的能力(压缩、批量加载、时序超表)本质上都是在解同一件事:让长期运行的生产系统在数据量涨到千亿行之后,依然不需要为存储成本和加载周期做妥协。