文章目录
- 前言
- 零、论文基本信息
- 一、为什么总体分数不足以指导记忆进化
-
- [1. 从静态记忆到可执行记忆程序](#1. 从静态记忆到可执行记忆程序)
- [2. 一次修改会同时产生收益与副作用](#2. 一次修改会同时产生收益与副作用)
- [3. 局部收益如何被掩盖](#3. 局部收益如何被掩盖)
- 二、问题定义与能力空间
-
- [1. 任务与程序](#1. 任务与程序)
- [2. 五段式 Memory Interface](#2. 五段式 Memory Interface)
- [3. 五类记忆能力](#3. 五类记忆能力)
- [三、PrisMem 方法总览](#三、PrisMem 方法总览)
- [四、Stage I:冷启动与证据级诊断](#四、Stage I:冷启动与证据级诊断)
-
- [1. 为什么先冷启动](#1. 为什么先冷启动)
- [2. 三个证据指标](#2. 三个证据指标)
- [五、Stage II:能力驱动的专项进化](#五、Stage II:能力驱动的专项进化)
-
- [1. 从 specialist 而非全局冠军出发](#1. 从 specialist 而非全局冠军出发)
- [2. 依赖感知的能力选择](#2. 依赖感知的能力选择)
- [3. 历史引导的失败案例](#3. 历史引导的失败案例)
- [4. 诊断上下文压缩](#4. 诊断上下文压缩)
- [5. 程序安全检查](#5. 程序安全检查)
- [六、Stage III:用执行差异整合能力专家](#六、Stage III:用执行差异整合能力专家)
-
- [1. 为什么不直接路由](#1. 为什么不直接路由)
- [2. 成对差异案例](#2. 成对差异案例)
- [3. 谱系与接受条件](#3. 谱系与接受条件)
- [4. 三组能力冲突](#4. 三组能力冲突)
-
- [完整时间关系 vs. 独立矛盾声明](#完整时间关系 vs. 独立矛盾声明)
- [时间顺序 vs. 因果证据](#时间顺序 vs. 因果证据)
- [检索多样性 vs. 相关性](#检索多样性 vs. 相关性)
- 七、效率设计
-
- [1. Revision-aware execution reuse](#1. Revision-aware execution reuse)
- [2. 预算与参数](#2. 预算与参数)
- 八、实验设置
-
- [1. 数据与长度外推](#1. 数据与长度外推)
- [2. Baseline 与模型](#2. Baseline 与模型)
- 九、主实验结果
-
- [1. BEAM-1M](#1. BEAM-1M)
- [2. LongMemEval-M](#2. LongMemEval-M)
- 十、进化成本、消融与轨迹
-
- [1. 进化 Token](#1. 进化 Token)
- [2. 消融](#2. 消融)
- [3. 轨迹分析](#3. 轨迹分析)
- 十一、迁移与路由对照
-
- [1. GPT-5.5](#1. GPT-5.5)
- [2. 跨模型与跨数据集](#2. 跨模型与跨数据集)
- [3. 路由还是统一程序](#3. 路由还是统一程序)
- [十二、与 Agent Memory 系列的横向比较](#十二、与 Agent Memory 系列的横向比较)
-
- [1. A-MEM](#1. A-MEM)
- [2. MAGMA](#2. MAGMA)
- [3. CoM](#3. CoM)
- [4. ReMemR1](#4. ReMemR1)
- [5. Mem²Evolve](#5. Mem²Evolve)
- [6. JAM](#6. JAM)
- [十三、对 Coding、Tool 与 Multi-Agent 的启发](#十三、对 Coding、Tool 与 Multi-Agent 的启发)
-
- [1. Coding Agent](#1. Coding Agent)
- [2. Tool Agent](#2. Tool Agent)
- [3. Multi-Agent](#3. Multi-Agent)
- [4. 动态能力词表](#4. 动态能力词表)
- 十四、局限性
-
- [1. 能力体系依赖人工归纳](#1. 能力体系依赖人工归纳)
- [2. 离线标注依赖参考答案与证据](#2. 离线标注依赖参考答案与证据)
- [3. 评分依赖 LLM judge](#3. 评分依赖 LLM judge)
- [4. 百万 Token 是长度泛化而非百万 Token 进化](#4. 百万 Token 是长度泛化而非百万 Token 进化)
- [5. 成本仍高](#5. 成本仍高)
- [6. Baseline 搜索空间不完全等价](#6. Baseline 搜索空间不完全等价)
- [7. 缺少多模态、工具与权限场景](#7. 缺少多模态、工具与权限场景)
- [8. 安全与审计不足](#8. 安全与审计不足)
- 十五、我的理解与启发
-
- [1. PrisMem 让优化过程自己拥有记忆](#1. PrisMem 让优化过程自己拥有记忆)
- [2. 总体分数是一种有损压缩](#2. 总体分数是一种有损压缩)
- [3. specialist 的价值是制造可比较的反事实](#3. specialist 的价值是制造可比较的反事实)
- [4. 能力依赖比单标签分类更真实](#4. 能力依赖比单标签分类更真实)
- [5. 下一步是让能力空间本身进化](#5. 下一步是让能力空间本身进化)
- 十六、总结
- 参考资料
前言
Agent 的长期记忆正在从"人工设计一个固定数据库"走向"让系统自己改写记忆程序"。
传统方法关注记忆应该长什么样:用摘要、时间线、图结构还是层次化索引。自进化记忆则把 Extraction、Indexing、Planning、Retrieval、Answer 写成可执行程序,再根据任务反馈让大模型修改代码。
但 Agent Memory 并不是单目标系统。一套程序需要同时完成事实找回、时间状态跟踪、用户偏好提取、跨会话综合,以及在证据缺失或矛盾时谨慎回答。这些能力并不总是同向变化。
例如,扩大检索范围可能提高跨会话综合,却会引入无关个人信息;把事实切得更原子化有助于发现矛盾,却可能破坏完整时间线;提高检索多样性有助于覆盖多个主题,却可能干扰状态更新判断。
现有自进化方法通常把这些反馈混在一起,用一个总体分数决定新程序是否值得保留。论文发现,在没有带来总体得分提升的修改中,仍有 80.5% 至少改善了一项记忆能力。"总分没涨"并不等于"修改没有价值"。
为此,论文提出 PrisMem,将自进化从单一总体性能维度展开到多个能力维度。
本文的唯一核心增量是:
PrisMem 把 Agent Memory 的自进化搜索单位从"总体得分更高的程序"改成"各能力维度上的优秀程序",保留被总分掩盖的局部能力增益,再通过差异执行轨迹把这些能力专家整合为统一记忆程序。
依赖感知的能力选择、历史引导的诊断和轨迹引导的整合,都服务于这条主线:前两者扩大能力空间中的探索边界,后者把分散的局部收益变成可部署的统一程序。
零、论文基本信息
- 论文名称: Capability-Driven Self-Evolution of Agent Memory
- 发表平台: arXiv
- 代码仓库: 论文当前版本未提供公开代码仓库
- 作者: Yaoqi Chen、Yuru Feng、Qianxi Zhang、Baotong Lu、Jianan Lu、Zhirui Wang、Shusen Xu、Zewen Jin、Zengzhong Li、Cheng Li、Qi Chen
一、为什么总体分数不足以指导记忆进化
1. 从静态记忆到可执行记忆程序
静态 Agent Memory 的主要机制在部署前已经确定:
- Mem0、SimpleMem 强调显著事实的提取与整合;
- Zep、Hindsight、TiMem 重视时间和状态变化;
- MemoryBank、MemoryOS、O-Mem 聚焦用户画像与偏好;
- A-MEM、GAM、MemWeaver 关注跨记忆关联和多会话综合。
自进化方法进一步把记忆表示为程序 P P P,允许修改 MemoryUnit、Query、提取提示、索引结构、查询规划、检索算法和回答规则。M★、EvolveMem、MemEvolve、MemPro 已经证明大模型能够根据失败案例改写这类程序。
问题在于,它们通常采用 holistic evolution:将不同题型的反馈汇总,再用总体分数选择候选。
2. 一次修改会同时产生收益与副作用
假设系统在综合题中只找回一个主题,于是加入 MMR 提高检索多样性:
- 多会话综合得到更多互补证据,分数上升;
- 时间题混入邻近事件,日期和状态更难对齐,分数下降。
如果一升一降,总分可能不变。传统策略会丢弃候选;更合理的做法是把它保存为多会话能力 specialist,继续优化,最后显式处理它与时间能力的冲突。
3. 局部收益如何被掩盖
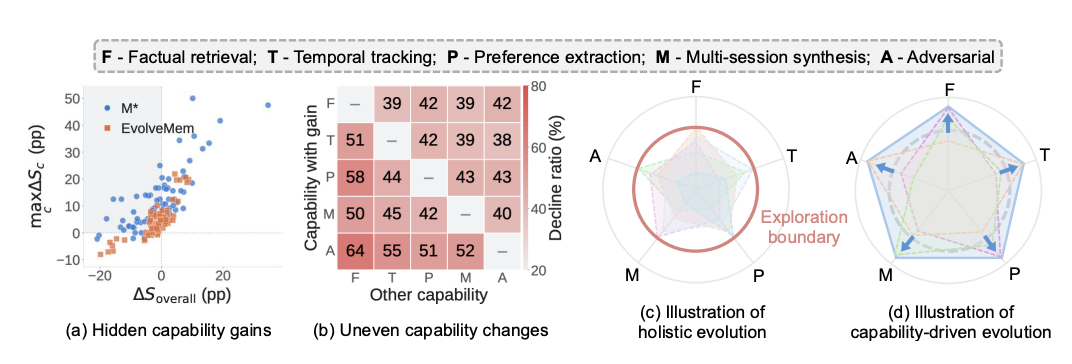
Figure 1:能力驱动进化的动机。 左侧展示总体变化与最大单项能力变化,中间统计能力间回退比例,右侧对比整体进化与能力驱动进化的探索边界。
Figure 1(a) 左上区域代表总体分数下降、但至少一项能力改善。论文统计:80.5% 没有总体增益的修改仍提高了至少一项能力。
Figure 1(b) 显示负迁移并不少见:某能力改善时,另一能力下降的比例约为 38%~64%。对抗能力改善时,事实检索下降的比例达到 64%。
所以传统方法不一定找不到好修改,而是选择机制看不见"尚未整合的好修改"。总体进化只能沿总分上升方向移动;能力驱动进化可以先沿 F、T、P、M、A 分别扩展边界,再寻找兼顾各维度的统一解。
二、问题定义与能力空间
1. 任务与程序
任务实例为:
x = ( H , q , y , E ) x=(H,q,y,E) x=(H,q,y,E)
其中 H H H 是历史会话, q q q 是问题, y y y 是参考答案, E E E 是参考证据。程序 P P P 构建记忆、检索并回答,在实例上得到:
s ( P ; x ) ∈ 0 , 1 s(P;x)\in0,1 s(P;x)∈0,1
集合平均分为:
s ( P ; S ) = 1 ∣ S ∣ ∑ x ∈ S s ( P ; x ) s(P;S)=\frac{1}{|S|}\sum_{x\in S}s(P;x) s(P;S)=∣S∣1x∈S∑s(P;x)
程序在训练集上迭代,根据验证集选择,达到预算后冻结并在测试集评估。
2. 五段式 Memory Interface
论文把程序拆成五部分:
U = P . extract ( H ) U=P.\operatorname{extract}(H) U=P.extract(H)
M = P . index ( U , H ) M=P.\operatorname{index}(U,H) M=P.index(U,H)
Q = P . plan ( q ) Q=P.\operatorname{plan}(q) Q=P.plan(q)
R = P . retrieve ( M , Q ) R=P.\operatorname{retrieve}(M,Q) R=P.retrieve(M,Q)
y ^ = P . answer ( q , R ) \hat y=P.\operatorname{answer}(q,R) y^=P.answer(q,R)
分别对应 Extraction、Indexing、Planning、Retrieval 和 Answer。细粒度接口既能定位证据在哪一步丢失,也允许局部修改复用上游计算。
3. 五类记忆能力
| 缩写 | 能力 | 记忆要求 |
|---|---|---|
| F | Factual retrieval | 保存和找回事实、数值与局部细节 |
| T | Temporal tracking | 排序事件、判断新旧、跟踪状态变化 |
| P | Preference extraction | 恢复并应用用户偏好、指令和约束 |
| M | Multi-session synthesis | 聚合多个会话或事件中的证据 |
| A | Adversarial | 证据不足时拒答,处理矛盾或误导信息 |
Table 1:五类记忆能力。 PrisMem 用这组能力词表组织进化反馈。
一个问题可同时需要多项能力。训练和验证任务被离线标注一个主要能力 ℓ ( x ) \ell(x) ℓ(x) 与最多两个次要能力 σ ( x ) \sigma(x) σ(x):
S c = { x ∈ S : ℓ ( x ) = c } S^c=\{x\in S:\ell(x)=c\} Sc={x∈S:ℓ(x)=c}
标注器会看到问题、参考答案和参考证据,因为只看问题很难判断真实记忆要求。论文在 700 个 BEAM-1M 问题上测试,GPT-5.5 只根据问题预测主要能力时,与题型映射的一致率只有 48.14%。
这些标签只用于训练阶段组织反馈,测试阶段不会提供给程序。
三、PrisMem 方法总览
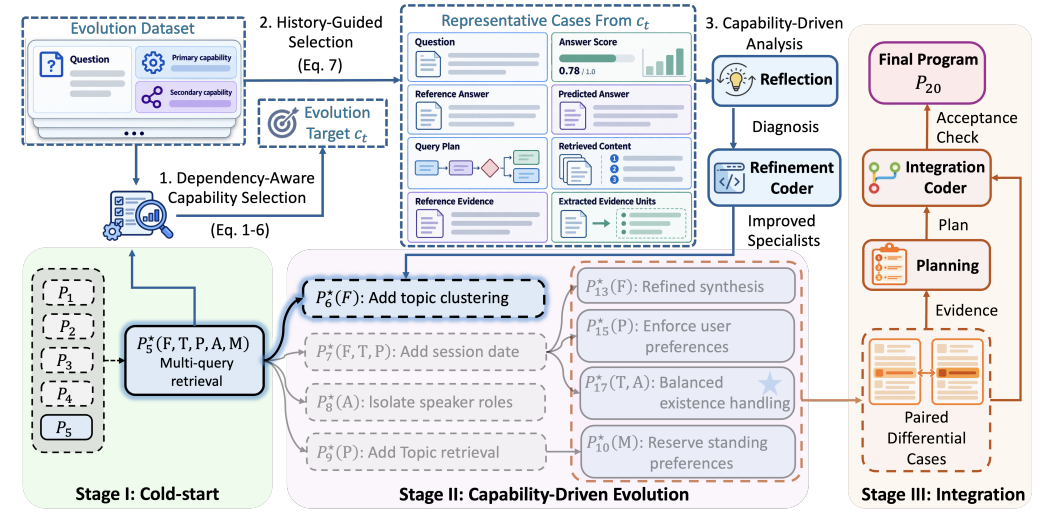
Figure 2:PrisMem 方法总览。 Stage I 建立平衡起点,Stage II 围绕代表性失败案例进化能力 specialist,Stage III 用成对差异案例指导统一整合。
三个阶段分别是:
- Cold Start: 修复种子程序的普遍缺陷;
- Capability Refinement: 保存并优化各能力 specialist;
- Trace-guided Integration: 合并不同 specialist 的互补机制。
传统方法主要维护全局最优程序。PrisMem 同时维护:
- 当前全局最优 G t G_t Gt;
- 每项能力的最优 specialist P t ⋆ ( c ) P_t^\star(c) Pt⋆(c);
- 候选程序的谱系、执行结果和历史诊断。
同一个程序可以同时成为多个能力的 specialist。
四、Stage I:冷启动与证据级诊断
1. 为什么先冷启动
种子程序故意很简单:MemoryUnit 只有一个文本字段,Query 只有一个查询字段,索引按顺序追加,检索甚至不依赖问题,只拼接记忆并截断到 16K 字符。
如果立即分五条能力路径,各分支会重复修复相同基础问题。因此前 T 1 = 5 T_1=5 T1=5 轮先建立一个平衡基座。
2. 三个证据指标
对于证据 e e e 和文本集合 Z Z Z,定义最大匹配相似度:
sim max ( e , Z ) = { max z ∈ Z ϕ ( e ) ⊤ ϕ ( z ) , Z ≠ ∅ 0 , Z = ∅ \operatorname{sim}{\max}(e,Z)= \begin{cases} \max{z\in Z}\phi(e)^\top\phi(z),&Z\neq\varnothing\\ 0,&Z=\varnothing \end{cases} simmax(e,Z)={maxz∈Zϕ(e)⊤ϕ(z),0,Z=∅Z=∅
其中 ϕ \phi ϕ 是归一化 embedding。再计算:
d ext ( x ) = 1 ∣ E x ∣ ∑ e ∈ E x sim max ( e , U e ) d_{\text{ext}}(x)=\frac{1}{|E_x|}\sum_{e\in E_x}\operatorname{sim}_{\max}(e,U_e) dext(x)=∣Ex∣1e∈Ex∑simmax(e,Ue)
d idx ( x ) = 1 ∣ E x ∣ ∑ e ∈ E x sim max ( e , R e ) d_{\text{idx}}(x)=\frac{1}{|E_x|}\sum_{e\in E_x}\operatorname{sim}_{\max}(e,R_e) didx(x)=∣Ex∣1e∈Ex∑simmax(e,Re)
d ret ( x ) = 1 ∣ E x ∣ ∑ e ∈ E x sim max ( e , R x ) d_{\text{ret}}(x)=\frac{1}{|E_x|}\sum_{e\in E_x}\operatorname{sim}_{\max}(e,R_x) dret(x)=∣Ex∣1e∈Ex∑simmax(e,Rx)
U e U_e Ue 是证据所在原文抽出的 MemoryUnit; R e R_e Re 是用证据本身作 oracle query 得到的内容; R x R_x Rx 是真实问题的检索结果。
- d ext d_{\text{ext}} dext 检查提取是否保存证据;
- d idx d_{\text{idx}} didx 检查证据能否从索引访问;
- d ret d_{\text{ret}} dret 检查真实 Query 能否找回证据。
若第一项高、第二项低,问题更可能在索引;第二项高、第三项低,则应检查 Query Planning 或 Retrieval;三项高但答案错,则要检查 Answer 对时间、来源和冲突的解释。
冷启动在附录轨迹中形成多子查询检索、预算分配与跨查询去重,为后续 specialist 搜索提供共同起点。
五、Stage II:能力驱动的专项进化
1. 从 specialist 而非全局冠军出发
对能力 c c c:
P t ⋆ ( c ) = arg max P ∈ P t s ( P ; S valid c ) P_t^\star(c)=\arg\max_{P\in\mathcal P_t}s(P;S_{\text{valid}}^c) Pt⋆(c)=argP∈Ptmaxs(P;Svalidc)
全局最优为:
G t = arg max P ∈ P t s ( P ; S valid ) G_t=\arg\max_{P\in\mathcal P_t}s(P;S_{\text{valid}}) Gt=argP∈Ptmaxs(P;Svalid)
当目标能力是 c t c_t ct 时,PrisMem 从 P t ⋆ ( c t ) P_t^\star(c_t) Pt⋆(ct) 而非总是从 G t G_t Gt 开始修改。一个总体略低、但时间能力最好的程序因此不会被淘汰。
2. 依赖感知的能力选择
对于主要能力 c p c_p cp 和次要能力 c s c_s cs,结构共现先验为:
D ( c p → c s ) = ∑ x ∈ S train c p 1 c s ∈ σ ( x ) ∣ S train c p ∣ D(c_p\rightarrow c_s)= \frac{\sum_{x\in S_{\text{train}}^{c_p}}\mathbf 1c_s\\in\\sigma(x)} {|S_{\text{train}}^{c_p}|} D(cp→cs)=∣Straincp∣∑x∈Straincp1cs∈σ(x)
定义 c s c_s cs specialist 的实例错误:
e t , c s ( x ) = 1 − s ( P t ⋆ ( c s ) ; x ) e_{t,c_s}(x)=1-s(P_t^\star(c_s);x) et,cs(x)=1−s(Pt⋆(cs);x)
以及它在主要能力为 c p c_p cp 的任务上的平均错误:
e ˉ t , c s ( c p ) = 1 ∣ S train c p ∣ ∑ x ∈ S train c p e t , c s ( x ) \bar e_{t,c_s}(c_p)= \frac{1}{|S_{\text{train}}^{c_p}|} \sum_{x\in S_{\text{train}}^{c_p}}e_{t,c_s}(x) eˉt,cs(cp)=∣Straincp∣1x∈Straincp∑et,cs(x)
错误集中于"同时需要 c s c_s cs"任务的比例是:
F t , c s ( c p → c s ) = ∑ x e t , c s ( x ) 1 c s ∈ σ ( x ) ∑ x e t , c s ( x ) F_{t,c_s}(c_p\rightarrow c_s)= \frac{\sum_x e_{t,c_s}(x)\mathbf 1c_s\\in\\sigma(x)} {\sum_x e_{t,c_s}(x)} Ft,cs(cp→cs)=∑xet,cs(x)∑xet,cs(x)1cs∈σ(x)
若 F > D F>D F>D,说明错误不成比例地集中在需要 c s c_s cs 的任务上。跨能力错误压力为:
I t ( c p → c s ) = e ˉ t , c s ( c p ) F t , c s ( c p → c s ) − D ( c p → c s ) + I_t(c_p\rightarrow c_s)= \bar e_{t,c_s}(c_p) \leftF_{t,c_s}(c_p\\rightarrow c_s)-D(c_p\\rightarrow c_s)\\right_+ It(cp→cs)=eˉt,cs(cp)Ft,cs(cp→cs)−D(cp→cs)+
能力紧迫度为:
U t ( c ) = e ˉ t , c ( c ) + max c p ∈ C ∖ { c } I t ( c p → c ) U_t(c)=\bar e_{t,c}(c)+ \max_{c_p\in C\setminus\{c\}}I_t(c_p\rightarrow c) Ut(c)=eˉt,c(c)+cp∈C∖{c}maxIt(cp→c)
论文取最大值而不是求和,避免与很多能力共现的节点天然占优。最后按已分配轮数 n t ( c ) n_t(c) nt(c) 折扣:
ρ t ( c ) = U t ( c ) 1 + n t ( c ) , c t = arg max c ρ t ( c ) \rho_t(c)=\frac{U_t(c)}{1+n_t(c)},\qquad c_t=\arg\max_c\rho_t(c) ρt(c)=1+nt(c)Ut(c),ct=argcmaxρt(c)
一项能力会因自身薄弱或成为其他任务的隐藏瓶颈而被优先选择;反复投入却停滞时,优先级会下降。
3. 历史引导的失败案例
PrisMem 先筛出目标能力中分数低于 δ = 0.8 \delta=0.8 δ=0.8 的题,再选 K = 5 K=5 K=5 个案例。权重为:
w t ( i ) = 1 + 1 ∣ P t ( c t ) ∣ ∑ P ∈ P t ( c t ) s ( P ; x i ) ( 1 + m t ( i ) ) ( 1 + m t ( σ ( x i ) ) ) w_t(i)= \frac{ 1+\frac{1}{|\mathcal P_t(c_t)|}\sum_{P\in\mathcal P_t(c_t)}s(P;x_i) }{ (1+m_t(i))(1+m_t(\sigma(x_i))) } wt(i)=(1+mt(i))(1+mt(σ(xi)))1+∣Pt(ct)∣1∑P∈Pt(ct)s(P;xi)
历史平均分越高、当前却失败的案例权重越高,因为它是 regression witness:过去版本做对过,当前 specialist 做错了。对比两者能定位最近修改的副作用。
分母压低反复出现的案例和次能力组合,避免 12 轮都围绕同一种错误。
4. 诊断上下文压缩
案例会包含能力标签、问题、参考与预测答案、Query Plan、检索内容、参考证据、原始来源和对应 MemoryUnit。
论文用语义相似度 0.75 与词项 Dice overlap 0.25 选择关键 span,同时保留时间、角色和代码块边界。BEAM 真实轨迹中,平均案例上下文从 16,776 tokens 降至 9,428 tokens ,减少 43.8%。
5. 程序安全检查
生成候选在昂贵评估前要通过:
- Python 源码和必需模块检查;
- MemoryUnit、Query schema 与函数签名检查;
- 本地 stub backend 的构建、空索引和检索测试;
- 约 2K 合成单元、100 批次、4096 维 embedding 的复杂度检查。
通过检查且目标能力训练分上升后,候选才进入完整能力评估。
六、Stage III:用执行差异整合能力专家
1. 为什么不直接路由
只凭问题很难识别真实能力,一个任务也常需要多个能力。PrisMem 最终不部署五个 specialist,而是整合为一个程序。
2. 成对差异案例
对每个 specialist,寻找它与 base 分差最大的训练案例:
x ^ c = arg max x ∈ S train c s ( P ⋆ ( c ) ; x ) − s ( G ; x ) \hat x_c=\arg\max_{x\in S_{\text{train}}^c} \lefts(P\^\\star(c);x)-s(G;x)\\right x^c=argx∈Straincmaxs(P⋆(c);x)−s(G;x)
规划模型同时看到 base 和 specialist 在该案例上的 MemoryUnit、Query、检索内容、答案与分数。它可以判断 specialist 究竟因为保存 session date、区分 speaker、拆分查询还是改变排序而成功。
3. 谱系与接受条件
规划模型根据 lineage topology 决定整合顺序:靠近 base、依赖少的改动先处理,较远 specialist 后处理。编码模型最多尝试 T 3 = 3 T_3=3 T3=3 轮。
候选必须同时满足:
- 总体分高于原 base;
- 任一能力相对下降不超过 θ = 0.1 \theta=0.1 θ=0.1。
失败实现及其在同一差异案例上的 trace 会回传继续修正。
4. 三组能力冲突
完整时间关系 vs. 独立矛盾声明
时间能力希望完整计划和进度保持在同一 MemoryUnit;对抗能力希望矛盾声明独立可见。整合策略是:完整过程保持成组,矛盾声明单独保存。时间提高 0.87 pp,对抗提高 2.73 pp。
时间顺序 vs. 因果证据
时间题可按日期恢复顺序,但因果题不能把"先发生"误判成"导致"。整合后的回答规则要求时间题按事件顺序组织,因果题必须找到明确连接。时间提高 2.71 pp,对抗提高 8.59 pp。
检索多样性 vs. 相关性
多会话综合偏好多样结果,时间题需要聚焦同一事件。统一策略按问题类型调节 MMR:综合题偏多样性,时间题偏相关性。多会话提高 3.92 pp,时间提高 3.70 pp。
整合并非机械拼代码,而是把冲突机制变成"在什么条件下启用什么行为"。
七、效率设计
1. Revision-aware execution reuse
| 修改内容 | 重新执行起点 | 可复用内容 |
|---|---|---|
| MemoryUnit schema 或 Extraction | Extraction | 会话分段 |
| Constructor、Index 或 helper | Indexing | 分段和已抽取单元 |
| Query schema、Planning 或 Retrieval | Query Planning | 分段、抽取和索引 |
| 仅 AnswerInstruction | Answer | 已建记忆、Query 和检索结果 |
Table 6:候选程序的重执行边界。 越靠后的局部修改,可复用的上游工作越多。
2. 预算与参数
| 阶段 | 轮数 |
|---|---|
| Cold Start | 5 |
| Capability Refinement | 12 |
| Integration | 3 |
Table 8:20 轮进化预算分配。 所有自进化方法使用相同总轮数。
其他参数为 δ = 0.8 \delta=0.8 δ=0.8、 K = 5 K=5 K=5、 θ = 0.1 \theta=0.1 θ=0.1,整合时每项能力取一个差异案例。
八、实验设置
1. 数据与长度外推
程序在 BEAM-100K 和 LongMemEval-S 上进化,冻结后测试 BEAM-1M 和 LongMemEval-M。
| 数据集 | 划分 | F | T | P | M | A | 总数 | 平均 Token |
|---|---|---|---|---|---|---|---|---|
| BEAM-100K | Train | 20 | 43 | 32 | 33 | 32 | 160 | 125.11K |
| BEAM-100K | Validation | 18 | 32 | 24 | 22 | 24 | 120 | 146.83K |
| BEAM-1M | Test | 70 | 210 | 140 | 140 | 140 | 700 | 1,089.57K |
| LongMemEval-S | Train | 19 | 17 | 11 | 9 | 4 | 60 | 109.40K |
| LongMemEval-S | Validation | 20 | 17 | 8 | 8 | 7 | 60 | 109.40K |
| LongMemEval-M | Test | 64 | 64 | 30 | 32 | 10 | 200 | 1,079.04K |
Table 7:数据划分与能力构成。 程序在约 100K token 历史上进化,在约 1.08M token 历史上评测。
LongMemEval-M 使用分层抽样的 200 题子集,并非完整测试集。
2. Baseline 与模型
静态方法包括 Mem0、A-MEM、HippoRAG2、SimpleMem、LightMem;自进化方法为 M★ 与 EvolveMem。
主实验的任务、反思、编码和裁判模型均为 Qwen3.8-27B,embedding 为 Qwen3-Embedding-8B,运行环境是 A100、vLLM 0.20.0 和 Python 3.12。附录还测试 GPT-5.5。
分数由 benchmark 的 LLM judge 给出。每个实验运行三次,报告均值和标准差。
九、主实验结果
1. BEAM-1M
| 方法 | F | T | P | M | A | Overall | 平均 Token |
|---|---|---|---|---|---|---|---|
| Mem0 | 54.74 | 46.51 | 60.48 | 38.02 | 49.11 | 48.95 | 190.28K |
| A-MEM | 56.21 | 46.22 | 65.39 | 53.87 | 41.13 | 51.56 | 428.95K |
| HippoRAG2 | 65.24 | 47.06 | 66.43 | 44.83 | 44.82 | 51.86 | 207.70K |
| SimpleMem | 48.55 | 36.82 | 48.85 | 21.87 | 50.68 | 40.18 | 95.72K |
| LightMem | 46.66 | 33.40 | 36.64 | 16.70 | 55.45 | 36.44 | 86.20K |
| M★ | 61.29 | 48.98 | 71.91 | 42.19 | 46.02 | 52.85 | 89.47K |
| EvolveMem | 41.80 | 39.74 | 52.21 | 21.67 | 45.67 | 40.01 | 98.40K |
| PrisMem | 74.17 | 57.26 | 75.58 | 54.12 | 64.32 | 63.39 | 100.59K |
Table 2:BEAM-1M 主结果。 PrisMem 在五项能力和总体分上均为最佳。
PrisMem 的 63.39 比最佳静态方法 HippoRAG2 高 11.53 pp,比最佳自进化方法 M★ 高 10.54 pp。
提升并非由单项拉动。尤其是对抗能力达到 64.32,而 A-MEM 和 HippoRAG2 分别只有 41.13 与 44.82。这表明统一程序没有简单以召回率换取准确率。
PrisMem 每题平均 100.59K token,略高于 M★ 的 89.47K,却远低于 A-MEM 的 428.95K。结论应是"成本与其他进化方法相近、准确率明显更高",而不是"最省 token"。
2. LongMemEval-M
| 方法 | F | T | P | M | A | Overall | 平均 Token |
|---|---|---|---|---|---|---|---|
| Mem0 | 69.79 | 63.54 | 43.33 | 63.54 | 63.33 | 62.50 | 5772.67K |
| A-MEM | 87.50 | 59.90 | 44.44 | 54.17 | 96.67 | 67.33 | 8873.92K |
| HippoRAG2 | 89.58 | 47.92 | 24.44 | 40.63 | 90.00 | 58.67 | 6185.48K |
| SimpleMem | 82.81 | 74.48 | 11.11 | 67.71 | 73.33 | 66.50 | 2624.68K |
| LightMem | 47.92 | 74.48 | 24.44 | 58.33 | 96.67 | 57.00 | 1888.30K |
| M★ | 76.04 | 47.40 | 12.22 | 67.71 | 93.33 | 56.83 | 1528.94K |
| EvolveMem | 78.13 | 69.79 | 42.22 | 65.63 | 70.00 | 67.67 | 2749.94K |
| PrisMem | 82.29 | 75.00 | 47.78 | 82.29 | 96.67 | 75.50 | 2232.65K |
Table 2(续):LongMemEval-M 主结果。 PrisMem 总体最佳,但事实检索并非单项第一。
PrisMem 比最佳静态方法高 8.17 pp,比最佳自进化方法 EvolveMem 高 7.83 pp。
需要注意反例:事实检索 82.29 低于 HippoRAG2 的 89.58 和 A-MEM 的 87.50;对抗能力与 A-MEM、LightMem 并列。论文支持的是总体平衡能力更强,不是所有单项绝对第一。
主要增益在时间、偏好和多会话综合,其中多会话 82.29 比 M★ 与 SimpleMem 的 67.71 高 14.58 pp。
十、进化成本、消融与轨迹
1. 进化 Token
| 方法 | BEAM | LongMemEval |
|---|---|---|
| M★ | 76.5 ± 7.1 76.5\pm7.1 76.5±7.1 M | 202.3 ± 10.3 202.3\pm10.3 202.3±10.3 M |
| EvolveMem | 69.2 ± 7.3 69.2\pm7.3 69.2±7.3 M | 102.7 ± 8.4 102.7\pm8.4 102.7±8.4 M |
| PrisMem | 73.7 ± 6.4 73.7\pm6.4 73.7±6.4 M | 143.3 ± 9.6 143.3\pm9.6 143.3±9.6 M |
Table 3:20 轮进化 Token。 EvolveMem 最省,但只进化部分配置;PrisMem 与 M★ 修改完整程序。
PrisMem 比 M★ 低约 4%~30%,但仍高于 EvolveMem。压缩诊断上下文与执行复用有效,却没有消除完整程序进化的高成本。
2. 消融
| 变体 | Overall | 变化 |
|---|---|---|
| 完整 PrisMem | 63.39 ± 1.02 63.39\pm1.02 63.39±1.02 | - |
| 无 capability evolution | 53.24 ± 2.38 53.24\pm2.38 53.24±2.38 | -10.15 pp |
| 无 trace-guided integration | 60.23 ± 1.86 60.23\pm1.86 60.23±1.86 | -3.16 pp |
| Round-robin 选能力 | 60.84 ± 1.13 60.84\pm1.13 60.84±1.13 | -2.55 pp |
| 随机选案例 | 58.13 ± 1.25 58.13\pm1.25 58.13±1.25 | -5.26 pp |
Table 4:BEAM-1M 消融。 能力驱动搜索是最大增益来源,案例选择和最终整合也有独立贡献。
去掉能力驱动进化下降 10.15 pp,直接验证核心增量。去掉整合仍有 60.23,说明 specialist 探索本身已经有效;整合再贡献 3.16 pp。
随机案例下降 5.26 pp,说明"看哪些失败"对程序进化影响很大。固定轮询下降 2.55 pp,则支持依赖感知调度。
3. 轨迹分析
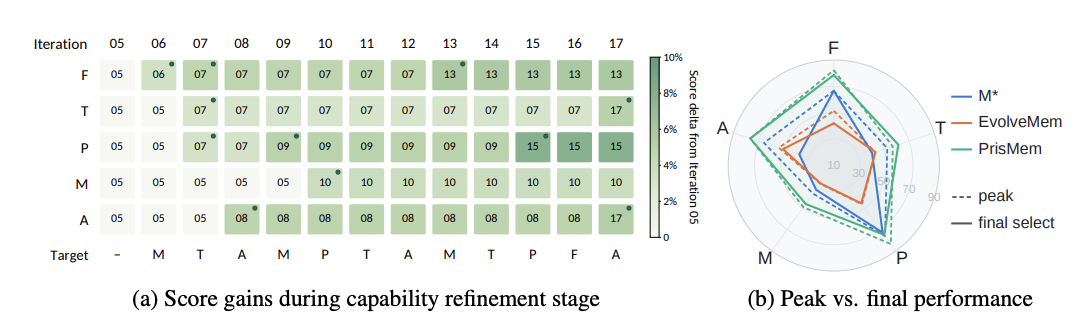
Figure 3:进化轨迹分析。 左侧展示 Stage II 各轮 specialist 更新,右侧对比历史能力峰值与最终程序。
能力分数并非平滑上升:第 7 轮时间专项同时更新 F、T、P,第 17 轮又同时更新 T、A。这说明能力间存在依赖,也说明改进是间歇出现的。
右侧 PrisMem 的能力峰值边界整体超过 M★ 与 EvolveMem,最终程序实线又接近各能力历史峰值虚线,是"扩大探索边界,再整合局部收益"的直接证据。
十一、迁移与路由对照
1. GPT-5.5
| 方法 | Overall | 平均 Token |
|---|---|---|
| Mem0 | 57.77 | 180.21K |
| A-MEM | 60.92 | 352.11K |
| HippoRAG2 | 57.73 | 193.52K |
| SimpleMem | 52.36 | 121.39K |
| LightMem | 46.68 | 94.05K |
| M★ | 60.75 | 97.47K |
| EvolveMem | 46.77 | 94.39K |
| PrisMem | 67.09 | 99.36K |
Table 9:GPT-5.5 上的 BEAM 结果。 更换底层模型后,PrisMem 仍领先最佳 baseline 6.17 pp。
2. 跨模型与跨数据集
| 设置 | 迁移程序 | 目标环境直接进化 |
|---|---|---|
| Qwen 进化,GPT-5.5 测试 | 67.25 ± 1.35 67.25\pm1.35 67.25±1.35 | 67.09 ± 1.79 67.09\pm1.79 67.09±1.79 |
| BEAM 进化,LongMemEval 测试 | 76.50 ± 1.67 76.50\pm1.67 76.50±1.67 | 75.50 ± 1.80 75.50\pm1.80 75.50±1.80 |
Table 10/11:模型与数据集迁移。 冻结程序迁移后没有明显退化。
这说明 session date、speaker provenance、多查询分解和主题聚合等机制具有一定通用性。但只测试两个模型和两个数据集,不能推断任意环境都能迁移。
3. 路由还是统一程序
| 策略 | Overall |
|---|---|
| Question-only router | 57.74 ± 1.21 57.74\pm1.21 57.74±1.21 |
| Oracle-label router | 62.27 ± 1.14 62.27\pm1.14 62.27±1.14 |
| PrisMem 统一程序 | 63.39 ± 1.02 63.39\pm1.02 63.39±1.02 |
Table 12:路由与整合。 即使用 oracle 能力标签路由 specialist,也不如统一程序。
Question-only router 受 48% 标签一致率限制。Oracle router 仍低 1.12 pp,说明复合问题往往需要多项能力,单个 specialist 覆盖不均衡。
十二、与 Agent Memory 系列的横向比较
1. A-MEM
A-MEM 优化记忆内容及其关联结构;PrisMem 优化生成和使用这些结构的程序。A-MEM 风格的关联机制可以成为 PrisMem 的初始实现或某个候选改动。
2. MAGMA
MAGMA 扩展记忆表示空间,用多视图承载不同关系;PrisMem 扩展程序搜索空间,在某种结构提高一项能力、伤害另一项时保留局部突破并处理冲突。
3. CoM
CoM 类方法组合记忆模块或内容;PrisMem 整合的是不同进化路径中已被执行验证的程序机制,并用差异案例解释为何有效。
4. ReMemR1
ReMemR1 在在线记忆更新时回调历史,避免内容层面的不可逆损失;PrisMem 在离线程序搜索时保留能力分支,避免优化路径的不可逆淘汰。
5. Mem²Evolve
两者都关注进化,但 PrisMem 明确增加能力坐标、specialist archive、依赖调度与轨迹整合,解决总体反馈压扁搜索空间的问题。
6. JAM
JAM 在回答时动态研究原始历史,解决 request-agnostic 压缩;PrisMem 在部署前改写程序,测试时运行冻结实现。二者可形成双层结构:PrisMem 离线优化 Researcher 与索引,JAM 在线按请求研究。
十三、对 Coding、Tool 与 Multi-Agent 的启发
以下是工程推演,不是论文直接实验。
1. Coding Agent
代码 Agent 同时需要定位、修改、测试、兼容、性能与安全。只用总体 pass rate 会掩盖"修复增强但测试回退"的策略。可为各能力维护 specialist,再用同一 issue 的 execution trace 整合互补行为。
2. Tool Agent
工具选择、参数构造、多步规划、结果校验、失败恢复之间存在依赖。跨能力错误压力可以发现"参数构造"是否成为多步规划任务的隐藏瓶颈,比固定轮询模块更有效。
3. Multi-Agent
可在同一任务上比较 planner、retriever、critic 的成功与失败轨迹,不只判断谁分数高,而是提取各角色的关键行为,写入共享协调策略。
4. 动态能力词表
真实系统还需要隐私、权限、来源可信度、成本与时延。工程上不应写死五类能力,而应从失败聚类中发现新能力,允许层次化、多标签和能力合并。
十四、局限性
1. 能力体系依赖人工归纳
五项能力覆盖当前 benchmark,但不是唯一分解。"对抗"同时包含拒答、矛盾与误导处理。论文未比较不同能力粒度,也未自动发现能力。
2. 离线标注依赖参考答案与证据
标签不会传给测试程序,因此不是测试泄漏;但真实日志常没有 golden evidence。如何只靠稀疏反馈构造可靠 primary/secondary 标签仍未解决。
3. 评分依赖 LLM judge
尽管温度为 0、运行三次,judge 噪声仍会影响单题分数,而能力调度、regression witness 和 specialist 选择都依赖这些分数。
4. 百万 Token 是长度泛化而非百万 Token 进化
程序在约 100K 历史上进化,再迁移到约 1M 测试。它不能证明在百万 Token 训练历史上持续进化的成本可接受,也不能覆盖千万 Token 或在线分布漂移。
5. 成本仍高
LongMemEval 的 20 轮进化消耗约 143.3M token。论文未报告完整墙钟时间、GPU 小时、美元成本、阶段成本拆分和程序验证失败率。当前更适合高复用服务,不适合每位用户独立进化。
6. Baseline 搜索空间不完全等价
EvolveMem 主要优化检索和回答配置,PrisMem 与 M★ 修改完整程序。因此性能差异同时受搜索策略和搜索空间影响,成本不能被理解成完全同构算法的纯效率比较。
7. 缺少多模态、工具与权限场景
实验只覆盖文本对话,没有图像、音频、工具执行记录、代码状态、多 Agent 共享记忆或企业权限边界。
8. 安全与审计不足
源码检查和复杂度测试不能解决越权检索、敏感信息持久化、Memory prompt injection、删除权、版本回滚和演化代码审计。功能正确不等于生产安全。
十五、我的理解与启发
1. PrisMem 让优化过程自己拥有记忆
它保存历史程序、每项能力冠军、程序谱系、案例差异和已诊断组合。传统总体进化只记住当前冠军;PrisMem 记住每个维度的局部冠军以及它为何成功。这本质上是搜索过程的结构化元记忆。
2. 总体分数是一种有损压缩
把 F、T、P、M、A 压成 Overall,会让"五项都中等"和"一项突破、另一项回退"的程序得到类似分数,但后者对后续搜索更有价值。
因此:
最终指标适合选择部署版本,却未必适合指导每一步探索。
搜索阶段需要保存更丰富的中间坐标。
3. specialist 的价值是制造可比较的反事实
specialist 最后不必被直接部署。它提供同一问题上"base 为什么失败、specialist 改了什么行为、收益与副作用是什么"的反事实。把代码差异与行为差异对齐,比只做自然语言 reflection 更容易形成可靠整合。
4. 能力依赖比单标签分类更真实
复杂任务不是简单"属于哪类",而是由一个主要能力决定,同时依赖若干辅助能力。PrisMem 能发现一个看似不弱的能力是否正在卡住其他任务,这比只优化最低分更接近系统瓶颈分析。
5. 下一步是让能力空间本身进化
未来可以:
- 从失败 trace 聚类自动提出能力;
- 根据行为差异拆分或合并能力;
- 使用层次能力图;
- 同时优化准确率、成本、时延和安全;
- 让能力词表随数据分布变化。
十六、总结
PrisMem 不是再设计一种记忆数据库,而是改变搜索和改进记忆程序的方式。
整体进化把多能力反馈压成总分,会模糊修改方向,也会淘汰"局部提升、总体暂时回退"的有效分支。PrisMem 为每项能力保存 specialist,根据直接缺陷和跨能力压力选择目标,用历史高分但当前失败的案例诊断,再通过 paired differential cases 把互补机制整合为统一程序。
在 Qwen3.8-27B 上:
- BEAM-1M 达到 63.39,比最佳自进化 baseline 高 10.54 pp;
- LongMemEval-M 达到 75.50,比最佳自进化 baseline 高 7.83 pp。
去掉能力驱动进化下降 10.15 pp,直接验证了核心判断;迁移和 oracle router 实验又表明,结果不是简单题型路由,而是可迁移、覆盖复合能力的统一程序。
一句话总结:
PrisMem 让记忆程序不再只追逐单一总分,而是先保留各能力方向上的真实突破,再用执行轨迹把局部突破整合成更强的统一系统。
参考资料
- Chen, Y. et al. Capability-Driven Self-Evolution of Agent Memory. arXiv:2610.06361, 2026.
- Pan, et al. M★: Memory Self-Evolution for Large Language Model Agents. 2026.
- Liu, et al. EvolveMem. 2026.
- Xu, et al. A-MEM: Agentic Memory for LLM Agents. 2025.
- Wu, et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. 2025.
- Tavakoli, et al. BEAM. 2026.