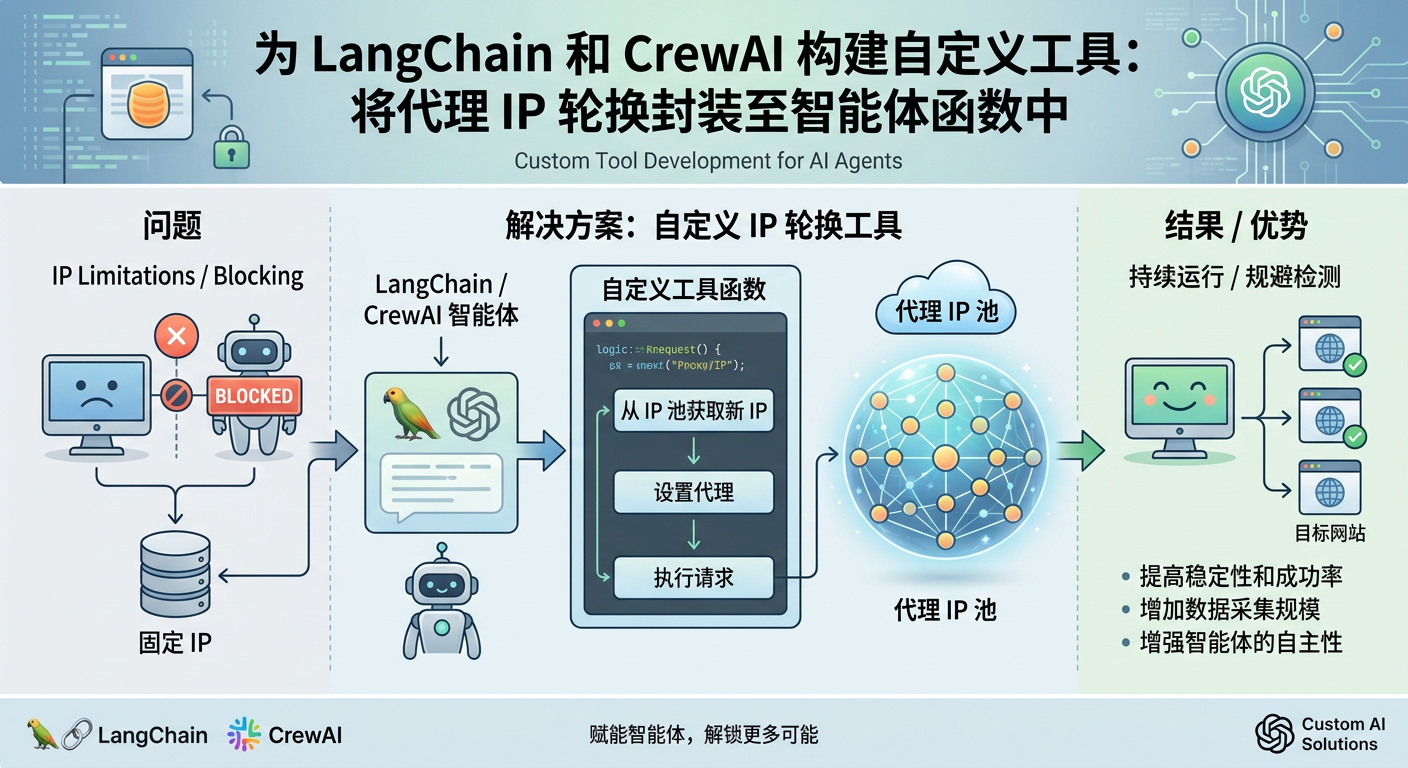
当您将 AI 智能体(Agents)从本地测试转向大规模生产数据检索时,初期的"蜜月期"通常会戛然而止。您可能已经构建了一个复杂的 CrewAI 研究团队或 LangChain RAG 流水线,但现实世界很快就会给予回击:您的智能体开始返回空字符串、403 Forbidden 错误,或者更糟糕的是------因为被服务器识别为机器人并投喂了"验证码"内容而产生幻觉。
在自主智能体(Autonomous Agents)的世界里,"工具(Tool)"不仅是一个函数,它是智能体与现实世界交互的唯一接口。如果这个接口被限流或封禁,智能体的推理循环就会崩溃。为了构建具有韧性的智能体,我们必须超越简单的 API 封装,将专业级的代理(Proxy)轮换逻辑直接植入智能体所使用的工具中。
为什么自主智能体在大规模运行时会失败?
大多数开发者将 LLM 工具视为静态实用程序:提供 URL,工具获取 HTML,LLM 进行处理。然而,智能体本质上是"话痨"属性的。一个高层级的目标可能会在几秒钟内触发二十次递归搜索或抓取尝试。
从 Web 服务器的角度来看,这种行为与 DDoS 攻击无异。传统的硬编码 Header 和单一 IP 请求是让您的智能体基础设施被列入黑名单的最快方式。如果您希望智能体具备资深数据工程师般的可靠性,就需要将网络韧性的复杂性抽象到工具内部。
韧性自定义工具的架构
为了弥补 LangChain/CrewAI 与开放网络之间的鸿沟,我们需要一种能够处理以下三个特定挑战的自定义工具架构:
- 身份管理:轮换 User-Agent 以匹配代理 IP 所感知的设备类型。
- IP 多样性:利用住宅或移动代理池绕过地理围栏和速率限制。
- 错误处理:教导智能体区分"未找到数据"错误与"网络被封锁"错误。
实现代理轮换封装器
让我们看看如何为 LangChain 和 CrewAI 构建一个强大的工具。我们将采用解耦的方法,将代理逻辑与智能体逻辑分离。
核心逻辑:ProxyManager 类
首先,我们定义一个处理程序来管理凭据和轮换逻辑。我们要确保每个请求都使用全新的会话。
python
import requests
import random

class ProxyManager:
    def __init__(self, proxy_list, user_agents):
        self.proxy_list = proxy_list
        self.user_agents = user_agents

    def get_headers(self):
        return {
            "User-Agent": random.choice(self.user_agents),
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
            "DNT": "1",
        }

    def fetch(self, url):
        proxy = random.choice(self.proxy_list)
        proxies = {
            "http": proxy,
            "https": proxy
        }
        try:
            response = requests.get(
                url,
                headers=self.get_headers(),
                proxies=proxies,
                timeout=10
            )
            response.raise_for_status()
            return response.text
        except requests.exceptions.RequestException as e:
            return f"错误:请求因 {str(e)} 失败。请尝试不同的方法或 URL。"
为 LangChain 封装:@tool 装饰器
LangChain 要求工具具有清晰的文档字符串(docstrings),因为 LLM 会根据这些描述来决定何时调用该函数。
python
from langchain.tools import tool

@tool
def resilient_web_scraper(url: str) -> str:
    """
    当标准抓取失败时,用于获取网页内容。
    使用轮换代理网络绕过访问限制。
    输入应为完整的 URL。
    """
    # 配置通常从环境变量加载
    PROXIES = ["http://user:pass@proxy.example.com:8080", "http://user:pass@proxy.example.com:8081"]
    USER_AGENTS = ["Mozilla/5.0...", "AppleWebKit/537.36..."]

    manager = ProxyManager(PROXIES, USER_AGENTS)
    return manager.fetch(url)
与 CrewAI 集成:增强智能体能力
CrewAI 智能体对工具的输出特别敏感。如果工具返回一个通用的错误,智能体可能会陷入"观察/思考"的无限死循环。通过将代理轮换封装在 BaseTool 中,我们为智能体提供了一个能够静默处理互联网噪音的"超级工具"。
python
from crewai_tools import BaseTool

class ProxyScraperTool(BaseTool):
    name: str = "韧性抓取工具"
    description: str = "使用住宅代理获取网站数据的工具,可有效避免被识别为机器人。"

    def _run(self, url: str) -> str:
        # 实现 ProxyManager 的抓取逻辑
        return manager.fetch(url)
如何为您的智能体选择正确的代理策略?
并非所有代理都是平等的。在为 AI 智能体构建工具时,您必须将代理类型与智能体的"预算"以及目标的复杂程度相匹配。
| 代理类型 | 成本 | 可靠性 | 最佳用例 |
|---|---|---|---|
| 数据中心代理 | 低 | 中 | 高速抓取无防护网站。 |
| 住宅代理 | 高 | 极高 | 电商、社交媒体及带有重度反爬的网站。 |
| 移动代理 (4G/5G) | 极高 | 最高 | 绕过最复杂的指纹识别系统。 |
"静默失败"陷阱:资深专家的视角
智能体开发中最常见的错误之一是未能将失败的真实原因传回给 LLM。
如果您的代理工具返回 "403 Forbidden",智能体可能会将其解释为"该网站没有相关信息"。这是一个伪命题(假阴性)。相反,您的工具应该向智能体返回明确的指令:
"请求被服务器封锁。请等待 5 秒,然后尝试不同的 URL 或搜索查询。"
通过提供这种反馈,您可以让智能体的"推理"模块调整策略,而不是直接放弃。
构建自定义智能体工具清单
- 严格类型化:确保工具输入具有严格的类型定义。智能体很难处理模糊的 JSON 结构。
- 遥测监控:记录哪些代理 IP 失败了。如果某个代理供应商被标记,工具应自动切换 IP 池。
- 内部速率限制 :即使使用了代理,也不要让智能体失控狂奔。在工具内部实现
time.sleep(random.uniform(1, 3))来模拟人类的阅读模式。 - 内容提取 :不要只返回原始 HTML。在工具内部使用
BeautifulSoup或Markdownify剥离噪音。LLM 不需要看到<script>标签;它们需要的是干净的文本。
总结
我们正在迈向一个"智能体"数量将超过"人类用户"的网络世界。随着网站防御性变得越来越强,智能体的质量将由其工具的质量决定。
将代理轮换封装到您的 LangChain 和 CrewAI 工具中不仅是一项技术优化,更是构建能够真正生存于开放互联网的自主系统的核心要求。目标是让基础设施变得透明,从而让智能体专注于它最擅长的事情:推理、计划和执行。
下次当您的智能体无法检索数据时,不要检查提示词(Prompt),请检查工具。您是给智能体提供了一个笨拙的钝器,还是一个专业级的世界信息接口?