一、JVM 运行时数据区
JVM 在执行 Java 程序时,会把内存划分为多个不同用途的区域,部分区域随线程创建销毁,部分全局共享。
线程私有(随线程而生、随线程而灭)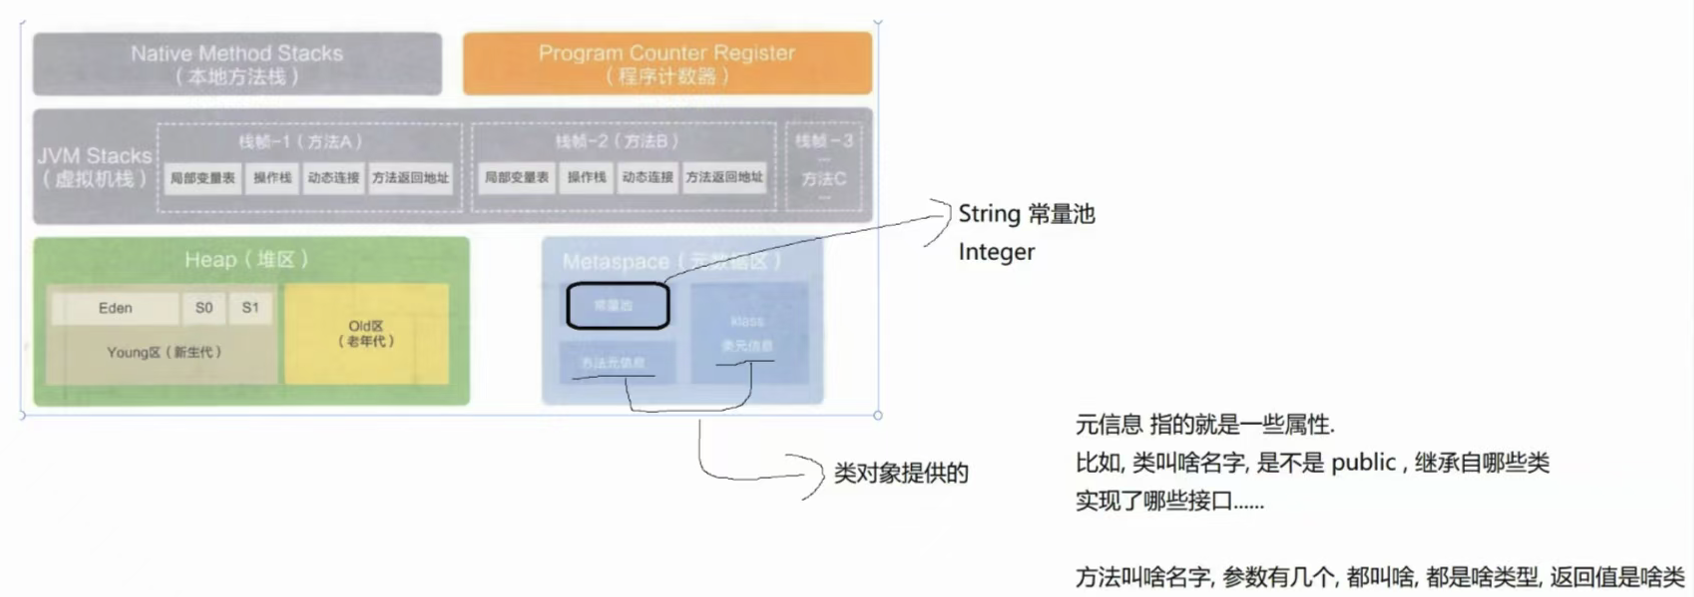
- 程序计数器(PC 寄存器) 唯一一个不会发生 OOM 的内存区域。用来记录当前线程正在执行的字节码行号,线程切换后恢复执行位置。
- 虚拟机栈(Java 栈) 存储栈帧,每调用一个方法就创建一个栈帧。栈帧包含局部变量表、操作数栈、动态链接、方法返回地址。 方法递归过深会抛出
StackOverflowError;栈动态扩展内存不足会 OOM。 - 本地方法栈 作用和虚拟机栈类似,专门为 Native 本地方法服务。
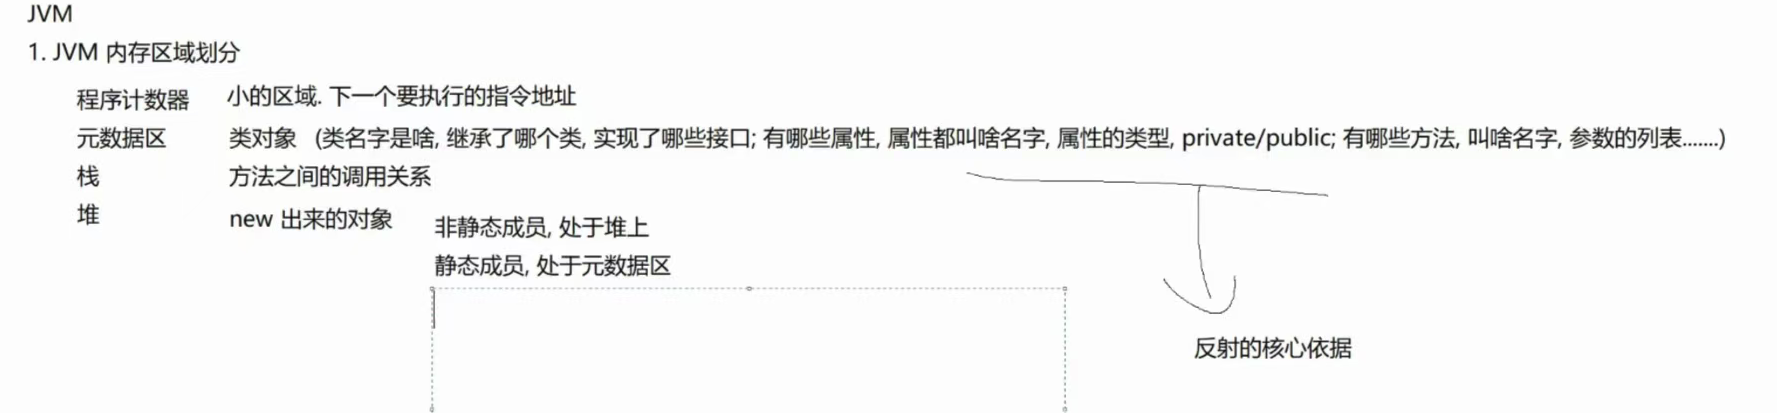
线程共享(全局,GC 主要作用区域)
- 堆 Heap Java 堆是 GC 的主战场,几乎所有对象实例、数组都在堆中分配。 堆分为新生代与老年代:
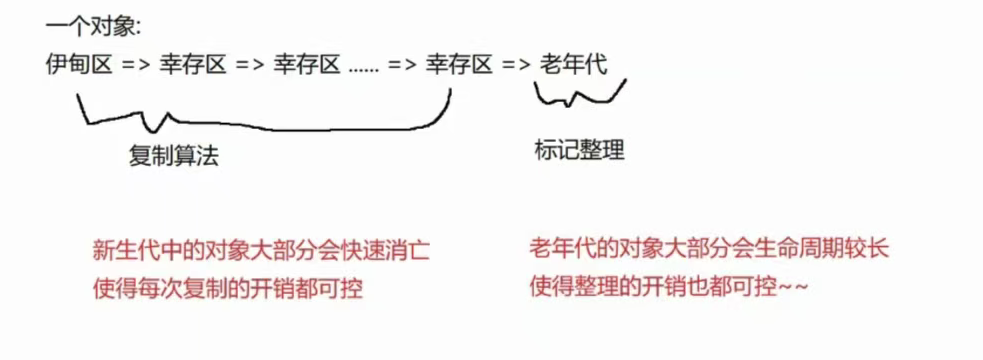
- 新生代:Eden 伊甸区 + 两个 Survivor 幸存区(S0、S1),比例默认 8:1:1
- 老年代:存放长期存活的对象
- 元空间 Metaspace(元数据区) JDK8 之后取代永久代,使用操作系统本地内存,不再占用堆空间。存储类元信息、常量、静态变量等。
记忆口诀:私有 PC、两栈;共享堆、元空间。
二、类加载的五个阶段
Class 文件从磁盘加载到 JVM 内存,最终生成 Class 对象,一共 5 个阶段:加载 → 验证 → 准备 → 解析 → 初始化
1. 加载阶段 & 三大类加载器
依据全限定类名,找.class文件,读取文件内容;
双亲委派模型发生在加载阶段。JVM 内置 3 个类加载器:
BootstrapClassLoader(启动类加载器) 由 C++ 编写,没有对应的 Java 对象实例。负责加载JAVA_HOME/lib下核心 rt.jar 等 Java 基础核心类(java.lang.*等)。
ExtensionClassLoader(扩展类加载器) Java 实现,父加载器是启动类加载器。加载JAVA_HOME/lib/ext目录下扩展 jar 包。
ApplicationClassLoader(应用程序类加载器,系统类加载器) Java 实现,父加载器是扩展类加载器。加载我们项目 classpath 下自己写的代码和第三方依赖包,也是我们代码默认的类加载器。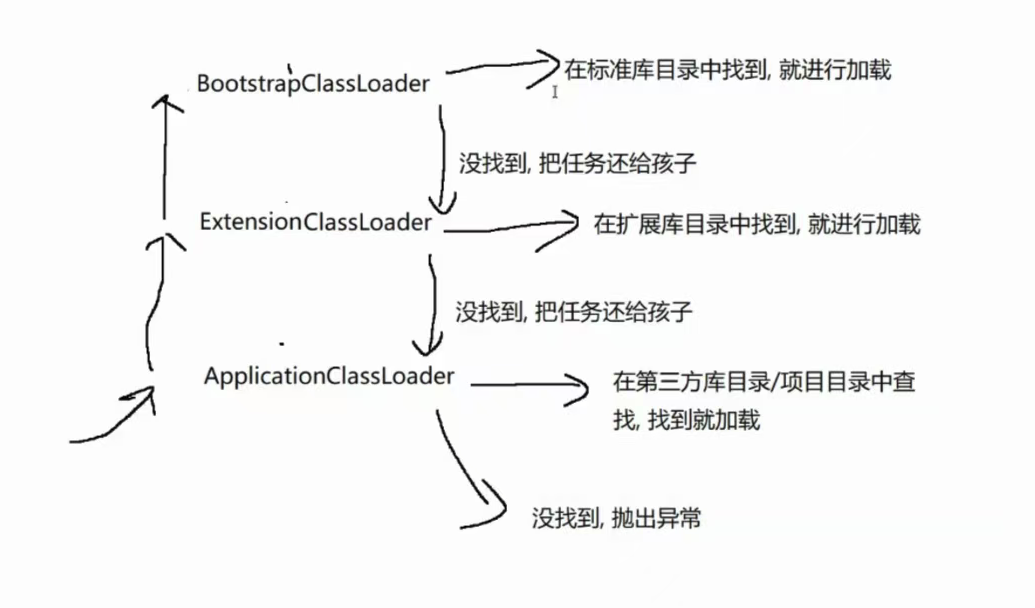
双亲委派模型:收到类加载请求,优先向上委托父加载器尝试加载,父加载器无法加载时,当前加载器才自己加载。 作用:避免类重复加载;保障核心类库安全,防止自定义恶意
java.lang.String覆盖原生类。
2.验证 校验字节码文件格式、语义合法性,防止恶意 / 损坏的 Class 文件破坏 JVM。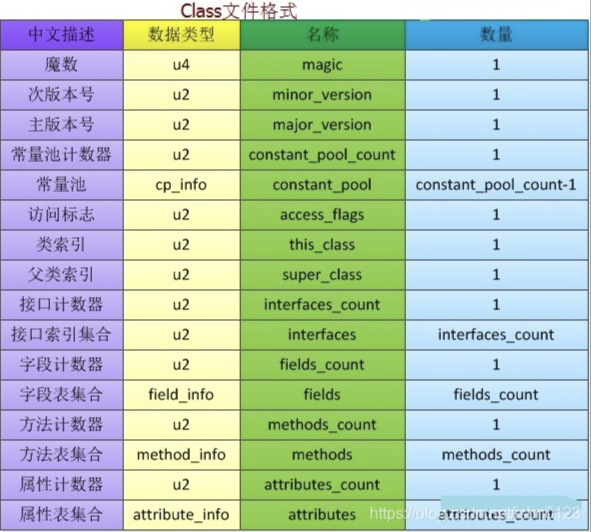
3.准备 为静态变量分配内存 ,赋予默认初始值 ,不是代码中设置的值。 例:static int num = 10,准备阶段 num = 0,等到初始化阶段才赋值 10。
4.解析: 针对字符串常量 将常量池中的符号引用 替换为直接引用。
5.初始化 真正执行静态代码块、静态变量自定义赋值,执行类的静态逻辑。针对类对象进行填充,也会触发父类的加载(父类没加载过)
三、GC 垃圾回收机制
GC 核心思想:分代回收,根据对象存活周期采用不同回收算法,age在对象头里。
1. 新生代:复制算法
新生代对象大多朝生夕灭,存活率低,适合复制算法。 Eden 区占 80%,S0、S1 各占 10%,同一时刻只有一块幸存区可用。
- Eden 区满时,触发 Minor GC,Eden 存活对象复制到空闲 Survivor,清空 Eden;
- 下次 GC,Eden + 当前 Survivor 存活对象复制到另一块空 Survivor,两块 Survivor 来回交换;
- 对象熬过多次 GC,年龄达标后晋升到老年代。
2. 老年代:标记 - 整理算法
老年代对象存活时间长、存活率高,不适合复制算法。 标记存活对象,之后将存活对象向内存一端移动,清理边界以外垃圾。优点:没有内存碎片。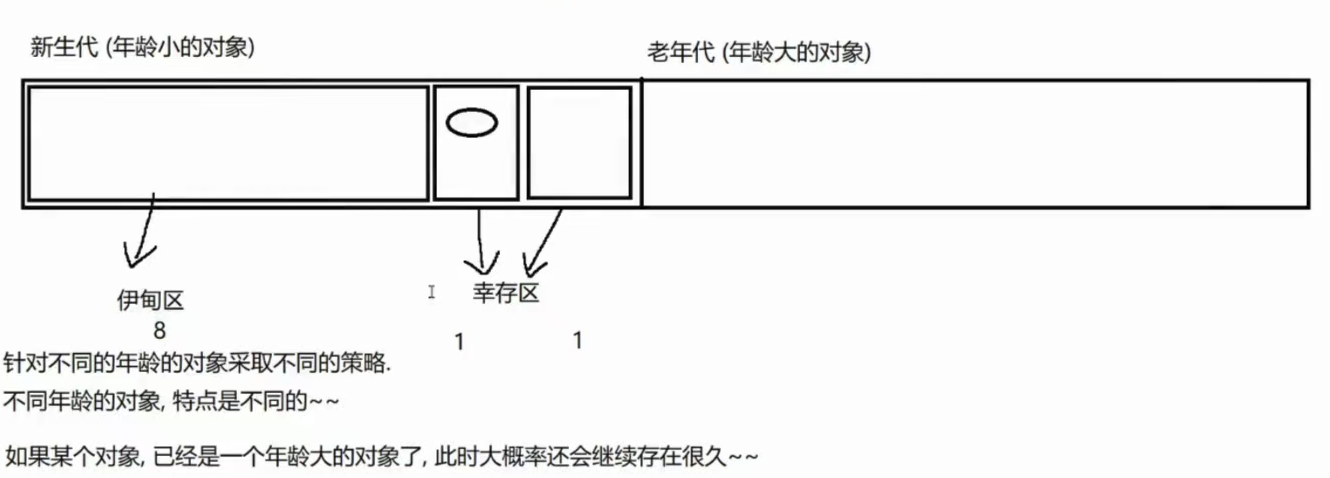
补充对比:标记 - 清除算法,标记垃圾然后直接清除,实现简单,但会产生大量内存碎片。
3. 常见垃圾收集器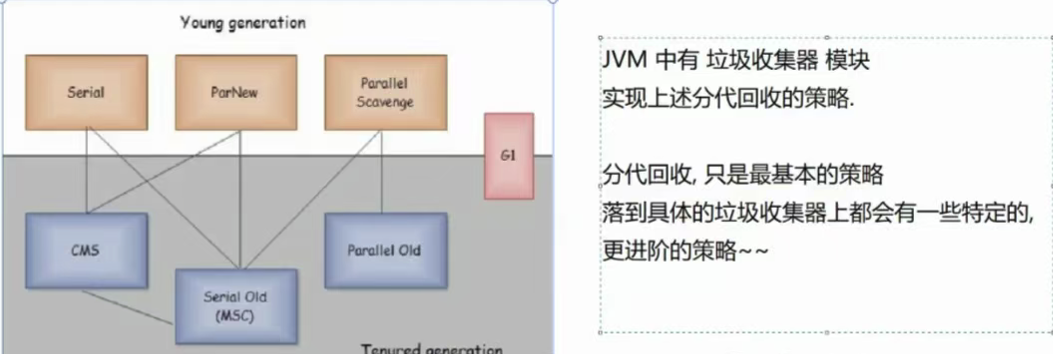
- Serial:单线程收集器,全程 STW,简单高效,客户端使用。
- Parallel Scavenge + Parallel Old:多线程收集器,优先追求吞吐量。
- CMS:老年代并发收集器,标记清除,追求低停顿,存在内存碎片。
- G1:Region 分块,兼顾新生代、老年代,支持可预测停顿。
- ZGC / Shenandoah:超低延迟收集器,几乎无 STW,适合超大堆场景。
四、GC 判定存活算法对比:可达性分析 vs 引用计数
Java GC 判断对象是否存活,底层是可达性分析 ;Python、Rust 早期、PHP 等语言使用引用计数。
1. 引用计数(Reference Counting)
原理:每个对象头维护一个引用计数器。
- 新增引用:计数器 + 1
- 引用失效:计数器 - 1
- 计数器为 0:对象立即回收
✅ 优点
- 回收即时,引用消失立刻释放内存;
- 没有全局扫描,不需要 STW;
- 局部化操作,逻辑简单。
❌ 致命缺点
- 循环引用无法回收:A 引用 B,B 引用 A,两者计数器都不为 0,内存泄漏。
- 频繁增减计数器,并发场景下需要原子操作,性能损耗大。
- 额外占用内存保存计数值。
典型语言:Python,Python 用标记清除 + 分代回收作为补充,专门解决循环引用问题。
2. 可达性分析(Reachability Analysis,Java 采用)
原理:以GC Roots作为起始根节点,向下遍历引用链;能遍历到的对象标记为存活,不可到达的判定为垃圾。 GC Roots 包含:虚拟机栈局部变量、静态变量、本地方法栈 JNI 引用等。
✅ 优点
- 不存在循环引用问题,循环引用只要不在 GC Roots 链上,直接被回收;
- 不需要频繁维护计数器,减少并发开销。
❌ 缺点
- 需要扫描整个堆,会产生 STW(Stop The World),暂停用户线程;
- 堆越大,扫描耗时越高(ZGC 等收集器大幅优化降低 STW)。
3. Java 分代回收的本质
Java 不是独立的算法,是可达性分析 + 分代思想 + 不同回收算法组合。 利用 "大部分对象朝生夕灭" 的弱分代假说,对新生代、老年代使用不同回收策略,减少每次 GC 扫描范围,降低 STW 开销。
| 对比项 | 引用计数 | 可达性分析(Java) |
|---|---|---|
| 判断方式 | 对象自带计数器 | GC Roots 扫描引用链 |
| 循环引用 | ❌ 无法处理,内存泄漏 | ✅ 可以正常回收 |
| 回收时机 | 引用断开立刻回收 | 需要 GC 触发扫描,不是即时 |
| STW | 一般不需要 | 需要(现代收集器大幅优化) |
| 性能开销 | 每次赋值都要原子增减 | 扫描堆时开销大 |
| 代表语言 | Python | Java、Go |
总结
JVM 内存区区分线程私有和共享区域;类加载 5 个阶段,双亲委派在加载阶段;GC 采用分代思想,新生代复制、老年代标记整理;不同垃圾收集器分别侧重吞吐量或低延迟。