01. 为什么还需要一套"逆向 Skill"?
把一份 ELF 可执行文件交给 AI,说"帮我分析这个校验函数",它可能直接写一堆 objdump 命令;换成 Android APK,又可能随意推荐 Frida;碰到前端 JavaScript,它可能在缺少网络观察的情况下开始推测签名算法。
问题不一定出在模型的语言理解能力,而在于缺乏跨项目、可执行、可检查的方法论:什么时候先做静态分析?什么时候需要动态观察?本机到底有没有 Ghidra、jadx?什么操作需要授权?分析结论如何追溯?
zhaoxuya520/reverse-skill 给出的解决思路,是把这些决策从零散提示词中抽出来,放进规则配置、场景 Skill、工具索引、案件工作流和证据契约里。
先澄清它的边界:reverse-skill 不是一个新的反编译引擎,也不是内置所有逆向工具的万能执行程序。 它更准确的定位,是为 AI 编程助手提供安全任务的路由与作业规范。是否能够执行真实反编译、调试或抓取,仍取决于本地工具、MCP 连接、系统权限和目标格式。
项目 README 在核对时列出了 44 条路由、175 条回归用例和 45 个受跟踪技能模块,以及 Windows、Ubuntu 的持续集成。它们是仓库公开声明的工程覆盖数据,并不等于对逆向成功率的承诺。
02. 从源码看架构:六个模块组成一条分析链
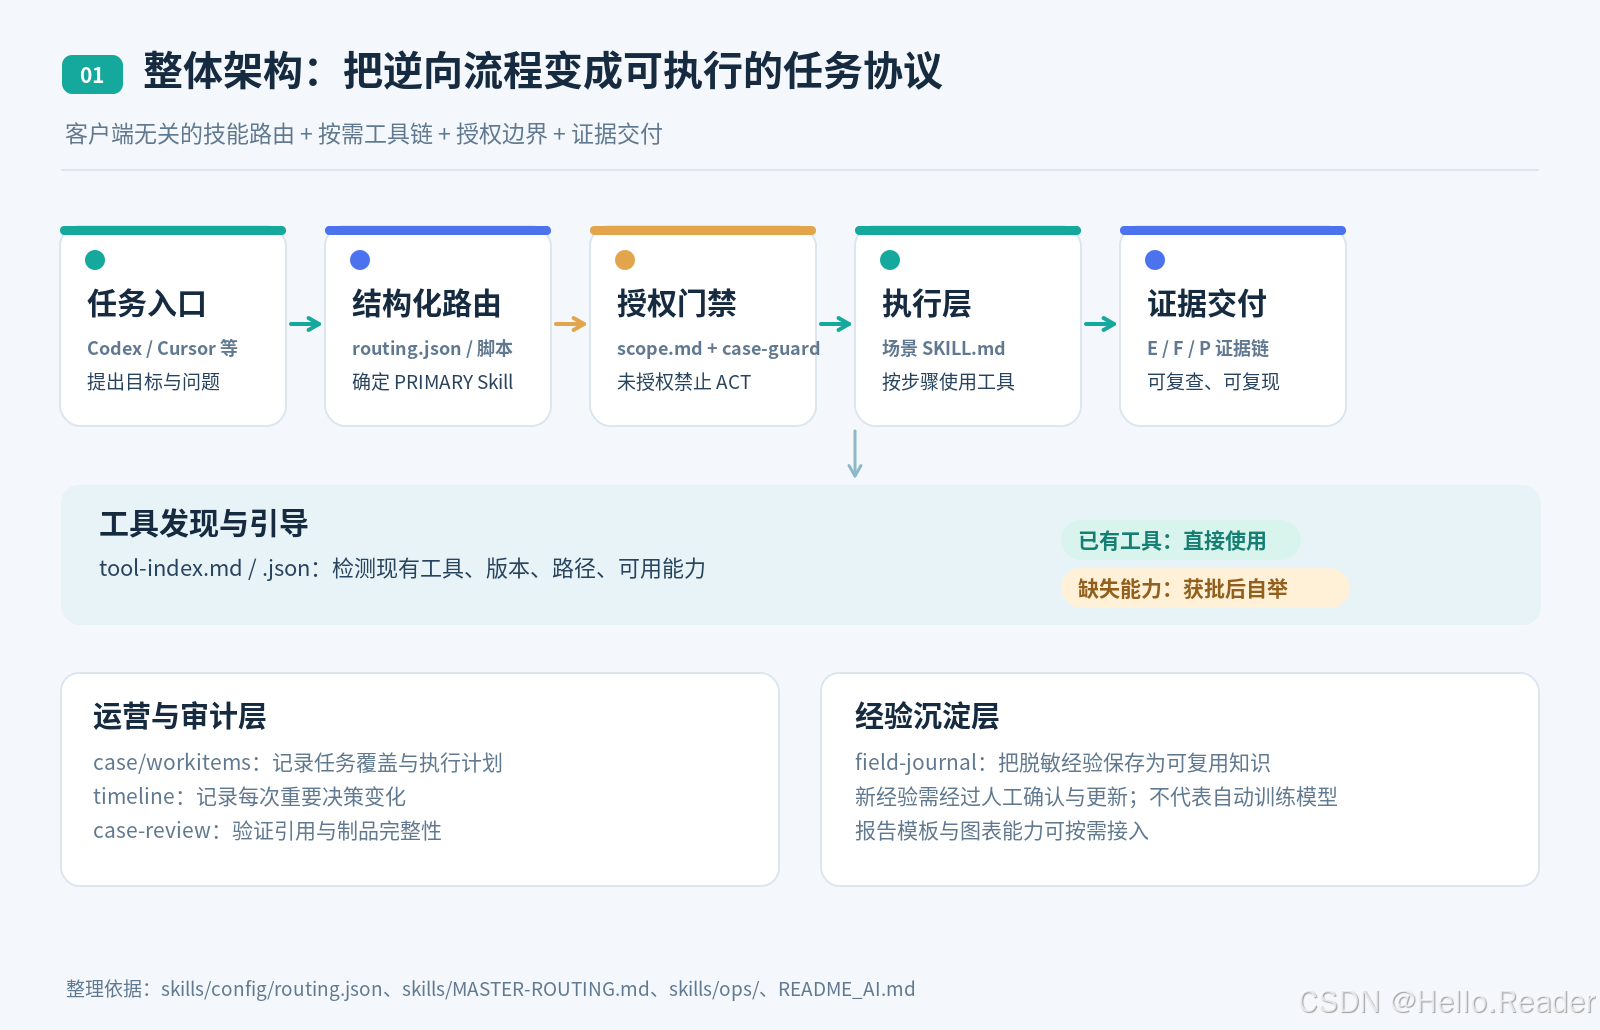
可以把这套架构划分为六层:
| 层次 | 核心文件或目录 | 解决的问题 |
|---|---|---|
| 入口与规则 | RULES.md、AGENTS.md、skills/SKILL.md |
告诉 Agent 何时激活流程、如何守住授权边界 |
| 结构化路由 | skills/config/routing.json、master-route.ps1/.sh |
根据任务描述确定 PRIMARY Skill |
| 专业技能 | skills/apk-reverse/、js-reverse/、ghidra-reverse/ 等 |
给不同分析场景提供专门的步骤和工具选择 |
| 工具环境 | refresh-tool-index.*、bootstrap-reverse.* |
发现已有工具,缺少能力时执行经批准的安装计划 |
| 工作与审计 | case-init.*、case-guard.*、skills/ops/ |
记录 Scope、WorkItem、Timeline、Evidence、Finding、Path |
| 复用与质量 | skills/field-journal/、测试脚本、CI |
沉淀脱敏经验、校验路由配置并减少重复踩坑 |
整个项目最值得学习的,是它没有让每个 Skill 自己处理所有事情:路由统一、授权统一、工具状态统一、证据字段统一,具体分析方法下沉到专属 Skill。 这与后台架构中"网关负责路由、工作流负责状态、领域服务负责业务逻辑"的分层思想相通。
2.1 为什么使用 Skill,而不只写一份总提示词?
总提示词的常见问题是越写越长,模块之间互相干扰。APK、ELF、JavaScript、.NET、固件的分析入口各不相同。将其拆为多个 SKILL.md,能够让 Agent 按当前任务读取所需方法,而不是把一大堆工具命令一次性塞进上下文。
以三个常用方向为例:
apk-reverse:围绕 APK、Manifest、Smali、jadx、apktool 等 Android 产物展开。go-rust-reverse:关注 Go/Rust 二进制的语言特征、符号恢复与编译器行为。js-reverse:强调观察、证据采集、局部复现与运行时分析的先后顺序。
注意:Skill 是工作规范,不保证工具已经安装。 例如某个 Skill 提到了 Frida,不代表此时 Agent 真的具备可调用的 Frida 服务。
03. 原理一:PRIMARY 路由是确定性的结构化规则
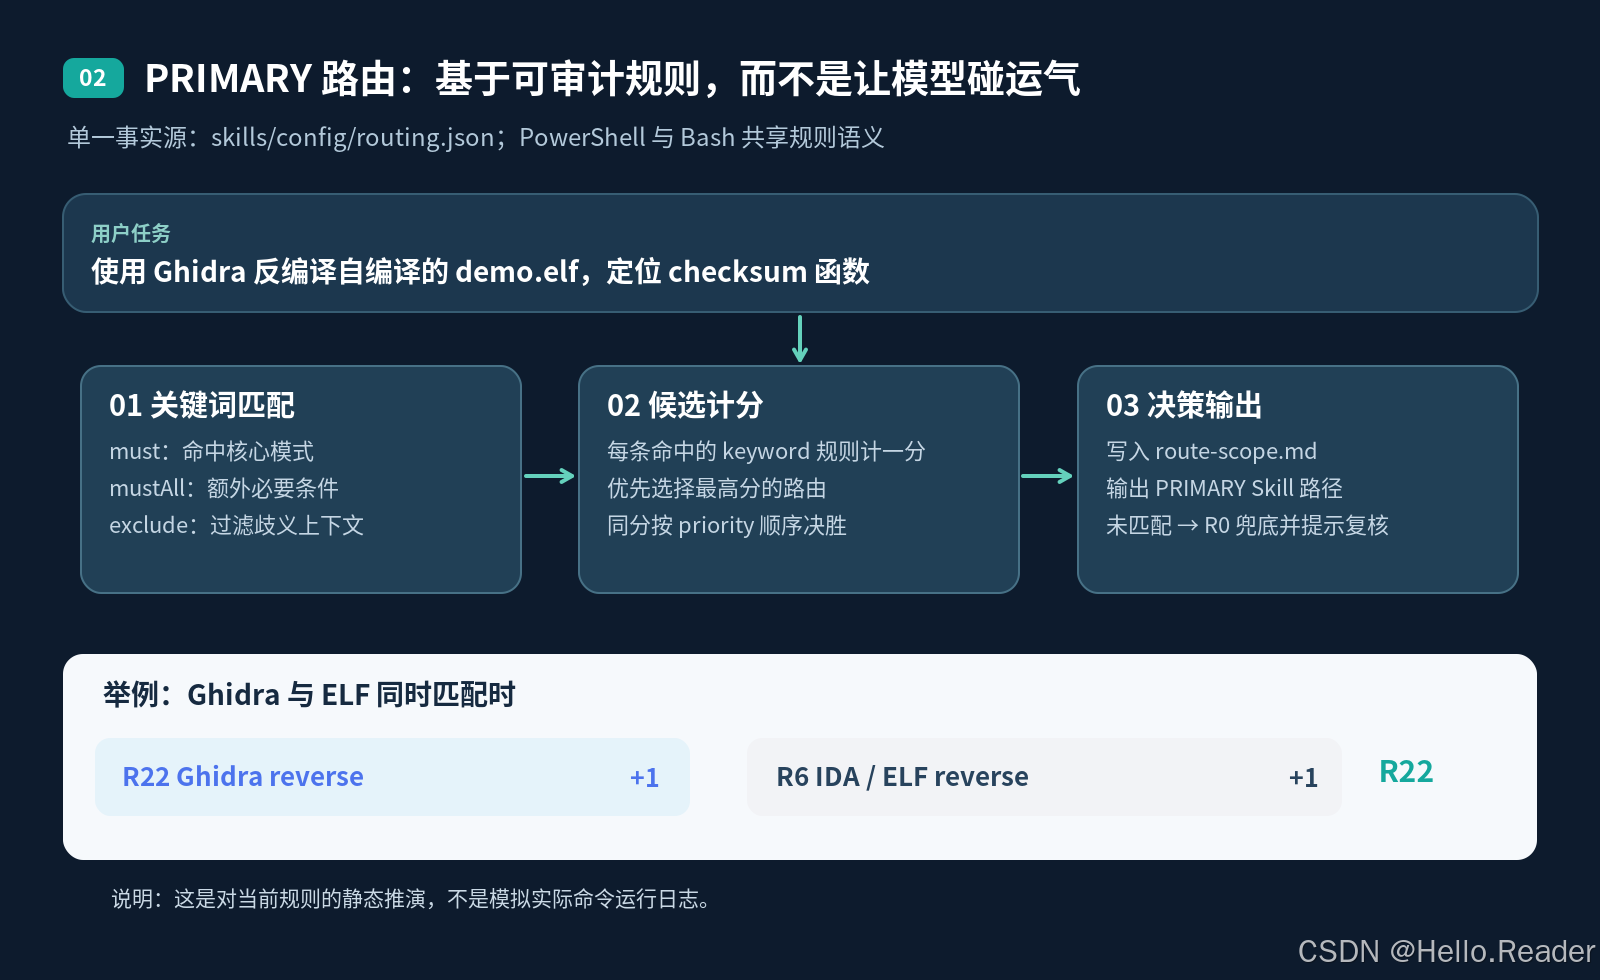
源码里最关键的配置是 skills/config/routing.json。它保存 routes、priority、fallbackId 等内容。master-route.ps1 和 master-route.sh 分别提供 Windows 与 Linux/macOS 的调用入口。
其主要逻辑可以概括为:
- 遍历各条路由的
keywords规则,使用正则表达式检查用户任务描述。 - 一条规则的
must命中后,继续检查mustAll;如果命中exclude,则排除此规则。 - 对同一路由,将命中的规则数累加成分数。
- 选择分数最高的路由;分数相同,按
priority数组中的先后顺序决胜。 - 没有候选时使用配置中的兜底路由(当前是
R0),并提示人工检查。
下面是便于理解的简化伪代码,不是可直接替换仓库脚本的实现:
python
scores = {}
for route_id, route in routes.items():
    for rule in route['keywords']:
        if match(rule['must'], task_text) \
           and all(match(x, task_text) for x in rule.get('mustAll', [])) \
           and not match(rule.get('exclude'), task_text):
            scores[route_id] = scores.get(route_id, 0) + 1

primary = pick_highest_score_then_priority(scores, priority)
primary = primary or fallback_id
例如任务写成"使用 Ghidra 反编译自己编译的 demo.elf,定位校验函数":按照核对到的规则,Ghidra 会命中 R22,.elf 或"反编译"会命中 R6,两条路由各有一条规则计分。在分数相同的条件下,R22 在优先级表中排得更早,因此选择 Ghidra 的 Skill。
这一细节很重要:路由中的优先级不是固定覆盖分数的强制顺序,而是同分时才用来决胜。 如果后续修改配置,应重新运行路由回归测试,避免新增关键词影响原有任务。
04. 原理二:工具链发现和安装是两回事
很多"AI 一键逆向"类介绍把工具选择和工具安装混在一起,容易产生两个问题:模型幻想本地存在一个程序,或者不经检查就下载执行脚本。
reverse-skill 在设计上把两者分开:
refresh-tool-index.sh/.ps1:检测当前机器的工具路径、版本或能力信息,并生成skills/tool-index.md、skills/tool-index.json。检测脚本不是通用自动安装器。bootstrap-reverse.sh/.ps1:根据明确的能力需求按需准备依赖;涉及安装、下载、启动服务和 MCP 注册时,应先阅读执行计划并取得用户批准。bootstrap-manifest.json:定义可以自举的能力,不能任由 Agent 猜测任意下载来源或安装命令。
这里还有一个容易忽视的安全细节:读取 README 或 Skill 文本不等于同意执行仓库中的脚本。 作者在 README_AI.md 和 RULES.md 中对首次副作用、全局配置变更和第三方工具安装专门设置了同意要求。真实团队使用时,最好把这条要求落实到代码助手的操作确认机制和受限执行环境中。
05. 原理三:Scope Gate 是正式分析之前的门槛
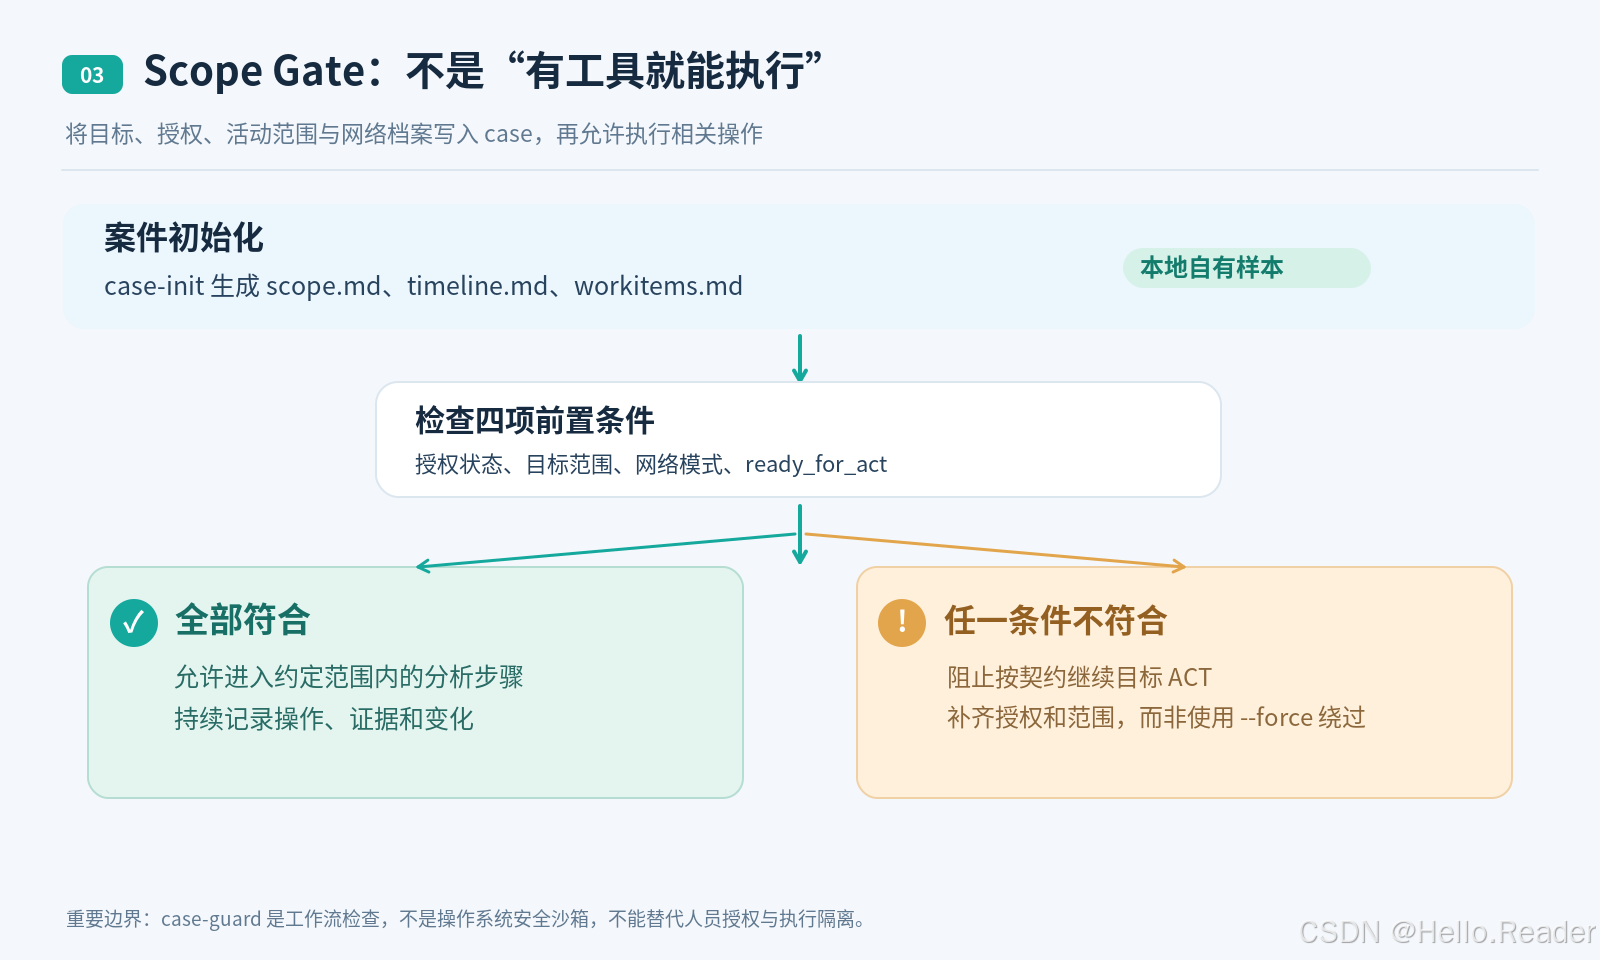
即使路由正确、工具齐全,也不意味着任何目标都可以开始扫描、Hook 或修改。
case-init 会为当前任务建立案件目录。scope.md 需要记录授权、目标范围、允许的活动、网络档案和交付约束。case-guard 负责检查关键字段;当前脚本中未就绪会以非零状态退出,--force 不会绕过硬门槛。
针对自有的本地可执行文件,仓库提供了 offline-sample 预设。它能将活动限定在显式指定的离线样本上。
这是一层工作流约束,而不是内核级沙箱。 它不会自动阻止某个完全绕开流程的进程访问网络。企业落地时还应配合:最小系统权限、网络隔离、独立容器/虚拟机、操作审计和可复核的目标授权。
06. 原理四:Evidence、Finding、Path 让 AI 的结论可复查
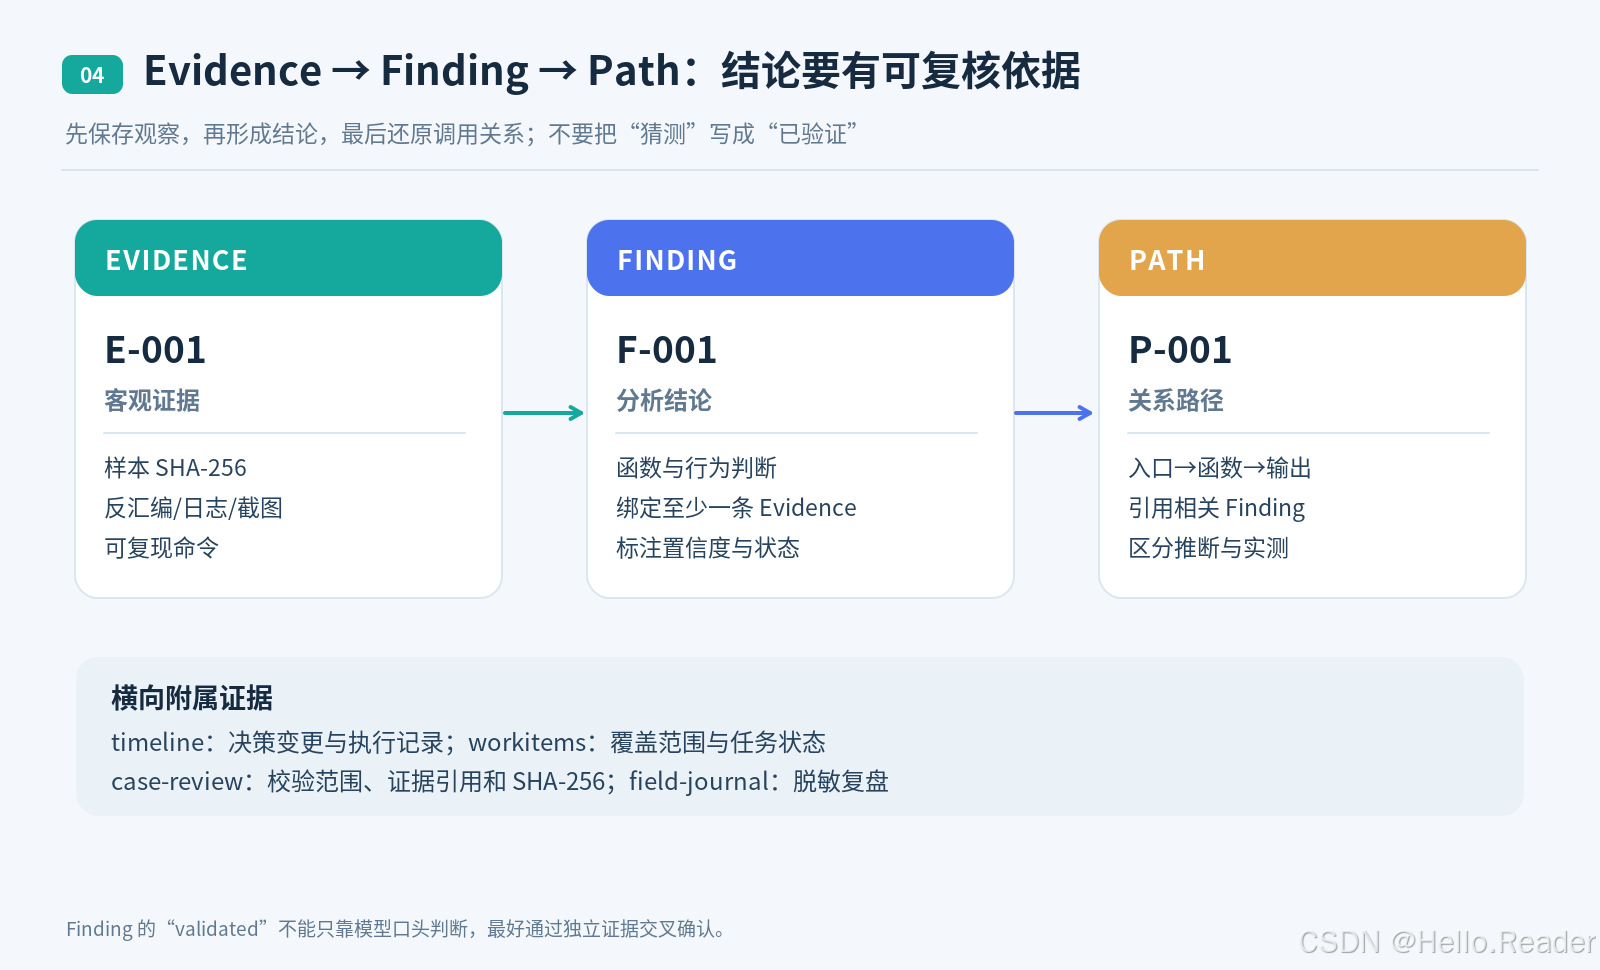
很多 AI 分析报告有一个共同缺陷:写出很完整的结论,却无法解释结论如何得出。
reverse-skill 使用三类明确区分的记录:
| 记录 | 含义 | 典型字段 |
|---|---|---|
| Evidence | 原始观察与可重复的操作记录 | E-001、时间、来源、路径、SHA-256、重现命令 |
| Finding | 对证据作出的判断 | F-001、关联证据、状态、置信度、影响与建议 |
| Path | 模块调用路径、行为路径或其他关系链 | P-001、相关 Finding、前后关系 |
在一次自有程序分析中,E-001 可以记录 sha256sum demo.elf 的结果,E-002 可以记录函数的反汇编片段或截图,F-001 再描述"函数执行 FNV-1a 风格的 32 位计算",并附上源码和独立测试来交叉验证。
这个设计没有要求 AI 每次必须"发现漏洞"。如果只是功能理解,Finding 可以是行为结论,Path 可以是一个正常的调用路径。case-review 可以只读检查 Scope、证据引用、工作项和可选的文件 Hash 完整性。
07. 从零实战:自己编译 ELF,让路由、授权和分析串起来
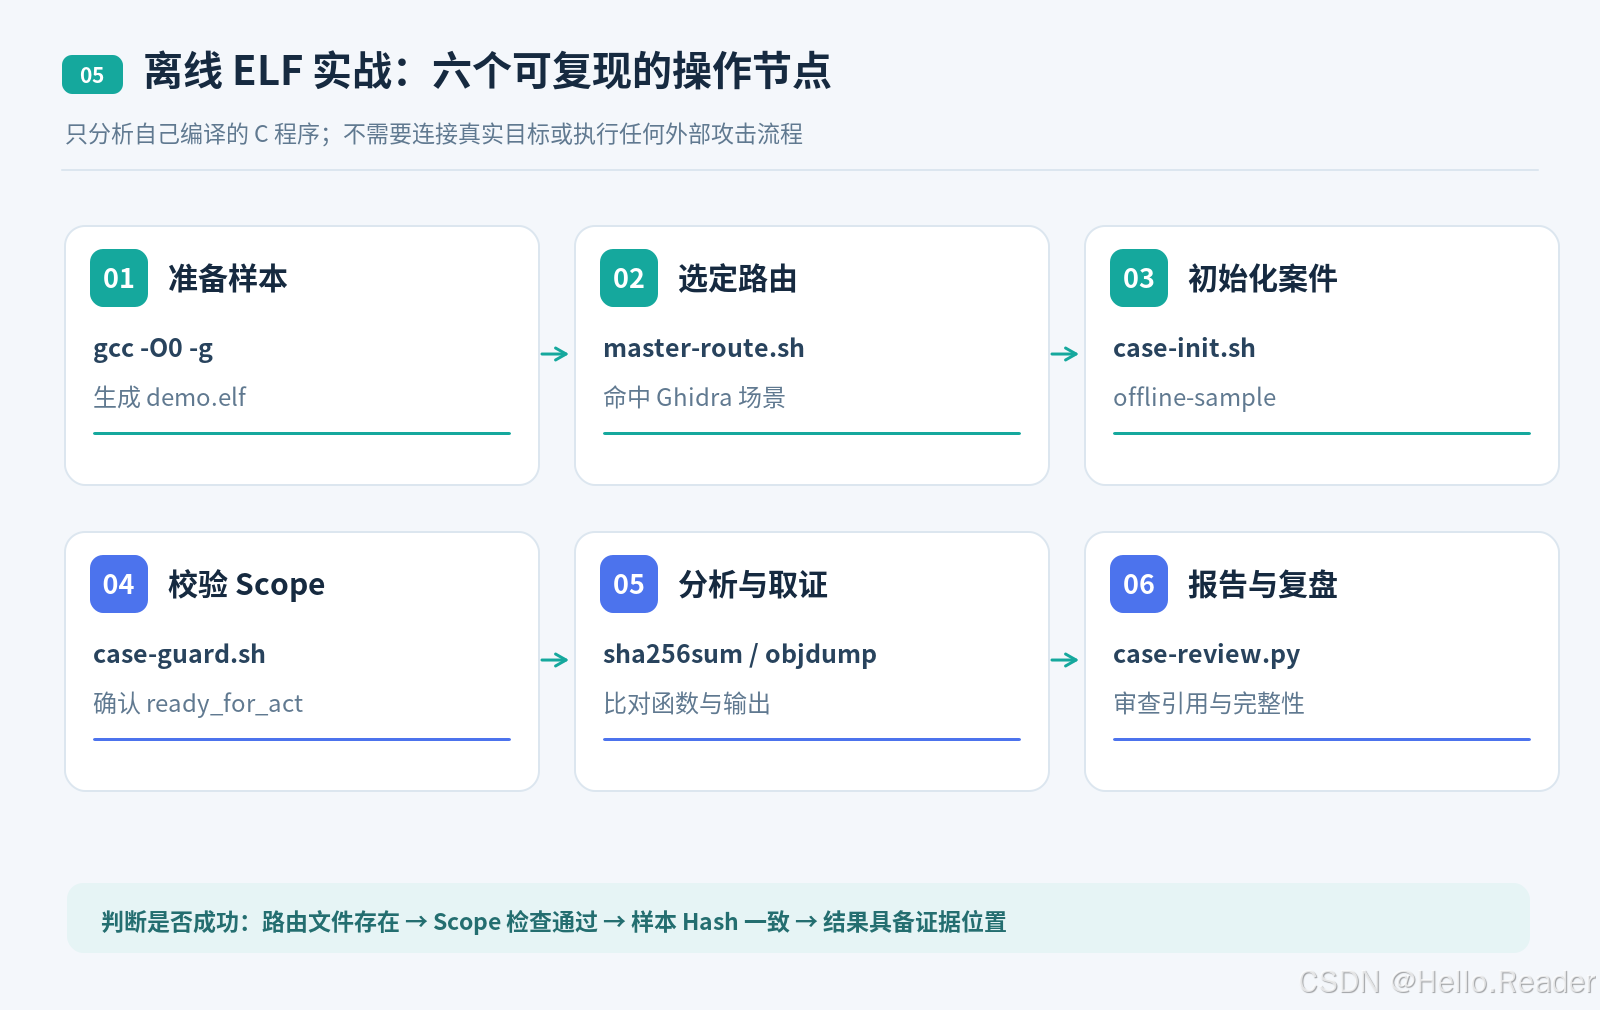
这个实验只使用一个自己编写的 C 程序,不涉及远程网络目标。Linux、Ubuntu 或 WSL 都可以跟着操作。Windows 原生 PowerShell 的对应入口放在后文。
步骤 1:获取仓库并检查源码
bash
git clone https://github.com/zhaoxuya520/reverse-skill.git
cd reverse-skill

git rev-parse HEAD
sed -n '1,150p' README_AI.md
sed -n '1,150p' skills/MASTER-ROUTING.md
先审核脚本计划,再自行决定是否执行。本实验后续写入的文件均放入明确指定的本地 lab/ 项目目录中。
步骤 2:编译一个可控的教学样本
创建 lab/demo.c:
c
#include <stdint.h>
#include <stddef.h>
#include <stdio.h>

__attribute__((noinline))
uint32_t fnv1a(const unsigned char *data, size_t length) {
    uint32_t hash = UINT32_C(2166136261);
    for (size_t i = 0; i < length; ++i) {
        hash ^= data[i];
        hash *= UINT32_C(16777619);
    }
    return hash;
}

int main(int argc, char **argv) {
    if (argc != 2) {
        fprintf(stderr, "Usage: %s <text>\n", argv[0]);
        return 2;
    }
    const unsigned char *input = (const unsigned char *)argv[1];
    size_t length = 0;
    while (input[length] != 0) ++length;
    printf("%08x\n", fnv1a(input, length));
    return 0;
}
编译两个版本,然后比较执行输出:
bash
mkdir -p lab
# 将上面的代码保存为 lab/demo.c
gcc -std=c11 -Wall -Wextra -O0 -g lab/demo.c -o lab/demo.elf
gcc -std=c11 -Wall -Wextra -O2 lab/demo.c -o lab/demo-optimized.elf

./lab/demo.elf hello
./lab/demo-optimized.elf hello

file lab/demo.elf
sha256sum lab/demo.elf
在本次独立编译检查中,两个版本对 hello 都输出 4f9f2cab,符合 FNV-1a 32 位计算。这个结果验证的是自制样本,不代表已经运行 reverse-skill 的路由或 Ghidra 分析。
步骤 3:刷新本机工具索引
在明确了解写入位置并批准本地运行后,执行:
bash
bash skills/scripts/refresh-tool-index.sh随后查看 skills/tool-index.md。它反映本机检测到的工具,不等于所有技能依赖均已就绪。如果没有 Ghidra,可以先只完成路由和 ELF 只读检查;不要因为 Skill 提到了工具就假定它已安装。
步骤 4:执行 PRIMARY 路由
bash
bash skills/scripts/master-route.sh \
  --hint "使用 Ghidra 反编译自编译的 demo.elf,定位校验函数" \
  --project-root "$PWD/lab"
根据当前 routing.json 的匹配规则,预计 PRIMARY 为 skills/ghidra-reverse/SKILL.md。命令会在指定项目的 work/master-route-.../ 目录中写出 route-scope.md。这个文件是路由决策记录,还不是授权完成的 scope.md。
步骤 5:初始化只允许离线分析的 Case
bash
bash skills/scripts/case-init.sh \
  --hint "使用 Ghidra 分析自编译的 demo.elf" \
  --case-name fnv-local \
  --preset offline-sample \
  --sample "$PWD/lab/demo.elf" \
  --project-root "$PWD/lab"
检查生成的 Scope 内容是否准确记录了自有样本、离线模式、权限依据,随后执行:
bash
bash skills/scripts/case-guard.sh \
  --case-root "$PWD/lab/work/fnv-local"
只有在 CASE-GUARD OK 时,才进入后续约定范围内的分析。若提示 Not Ready,应修正 Scope,不要把 --force 当作绕过授权的办法。
步骤 6:分析文件与验证函数
先使用本地通用只读命令:
bash
nm lab/demo.elf | grep fnv1a
objdump -d -M intel lab/demo.elf | less
sha256sum lab/demo.elf
如果本机已有可用的 Ghidra,并且已经在 Tool Index 里确认了安装情况,再按 skills/ghidra-reverse/SKILL.md 的步骤导入这个自有文件 ,定位 fnv1a,检查乘法常量 16777619、初始状态 2166136261 和逐字节异或的循环。
一个有意义的核验任务是:对照 -O0 与 -O2 版本,观察反汇编的指令和控制流如何变化,而输出结果为何保持一致。
这里没有虚构"AI 已定位某地址""Ghidra 已生成某伪代码"之类的结果。具体地址、基本块和指令以读者自己编译出的二进制和工具实际输出为准。
步骤 7:整理 Evidence 并进行案件审查
可以保存 sha256sum、nm、必要的反汇编截图和对照测试日志,写入 work/fnv-local/evidence/,按 skills/ops/evidence-finding-path.md 建立 E-xxx、F-xxx 引用,补齐 timeline.md 和 workitems.md。
完成有效记录后,再执行只读审查:
bash
python3 skills/case-review/scripts/review_case.py \
  "$PWD/lab/work/fnv-local" --verify-hashes --strict
审查失败通常意味着 Scope、引用或 Hash 信息不完整;不应该被解读为"逆向过程本身失败"。
08. Windows、Codex、Cursor:怎么接才实用?
Windows 原生脚本入口是 PowerShell 版本。仓库 README 给出的基础检测命令为:
powershell
powershell -NoProfile -ExecutionPolicy Bypass -File skills/scripts/refresh-tool-index.ps1路由和 Case 初始化也有对应入口:
powershell
powershell -File skills/scripts/master-route.ps1 -Hint "使用 Ghidra 分析自有 ELF 示例"
powershell -File skills/scripts/case-init.ps1 -Hint "离线本地样本分析" -CaseName "local-review"上面第二行没有提供授权信息,只用于初始化待检查的 Scope,不代表可以立即对目标 ACT 。本地样本的完整 PowerShell 参数和批准流程请以 skills/MASTER-ROUTING.md 为准。
对于 Codex、Cursor、Antigravity 等 Agent,最通用的接法是:在项目工作区 明确引用这个仓库的根目录和 skills/SKILL.md,让 AI 按 routing.json 选择分析路径,并以单独批准的步骤运行本地命令。
仓库的 plugins/reverse-skill/ 提供了可选的 Codex 适配入口;它不会仅因为存在而自动注册 Ghidra、Frida 等外部 MCP 服务。Antigravity 的实际接入应以当前客户端支持的 Skills/工作区规则机制为准,不应臆造"一键官方插件"。
一个可直接复制的 Agent 指令模板:
请仅针对我拥有或已明确授权的样本工作。先只读检查 reverse-skill 的规则与当前机器工具状态,告诉我本次任务的 PRIMARY Skill、必要依赖、准备执行的命令以及预期文件写入。没有我的确认不要运行仓库脚本、下载依赖、启动服务、修改全局配置或接触外部目标。获得批准后,按 Scope、Timeline、Evidence、Finding、Path 记录结果,区分观察、推断和未知项,并输出可复现的测试与报告。
09. field-journal:所谓"自动进化",具体进化的是什么?
项目通过 skills/field-journal/ 保存复盘记录,内容包括某类样本的处理步骤、工具兼容性问题、错误修正和可复用模式。_index.md 用来帮助后续任务更快查找先例。
它的价值不是"AI 自动训练了一个更强的新模型",而是把经验以文档形式积累到下一次任务可以读取的知识库中。如果写回仓库或贡献到公共 GitHub,还应先脱敏并经过用户同意。
建议在团队使用时额外加入三项约束:所有 Journal 都记录来源和验证状态;任何含有 Token、客户信息、真实 IP/域名的内容必须脱敏;历史经验只能作为参考,不能代替当前证据和授权范围。
10. 它与 REA 是竞争关系,还是互补关系?
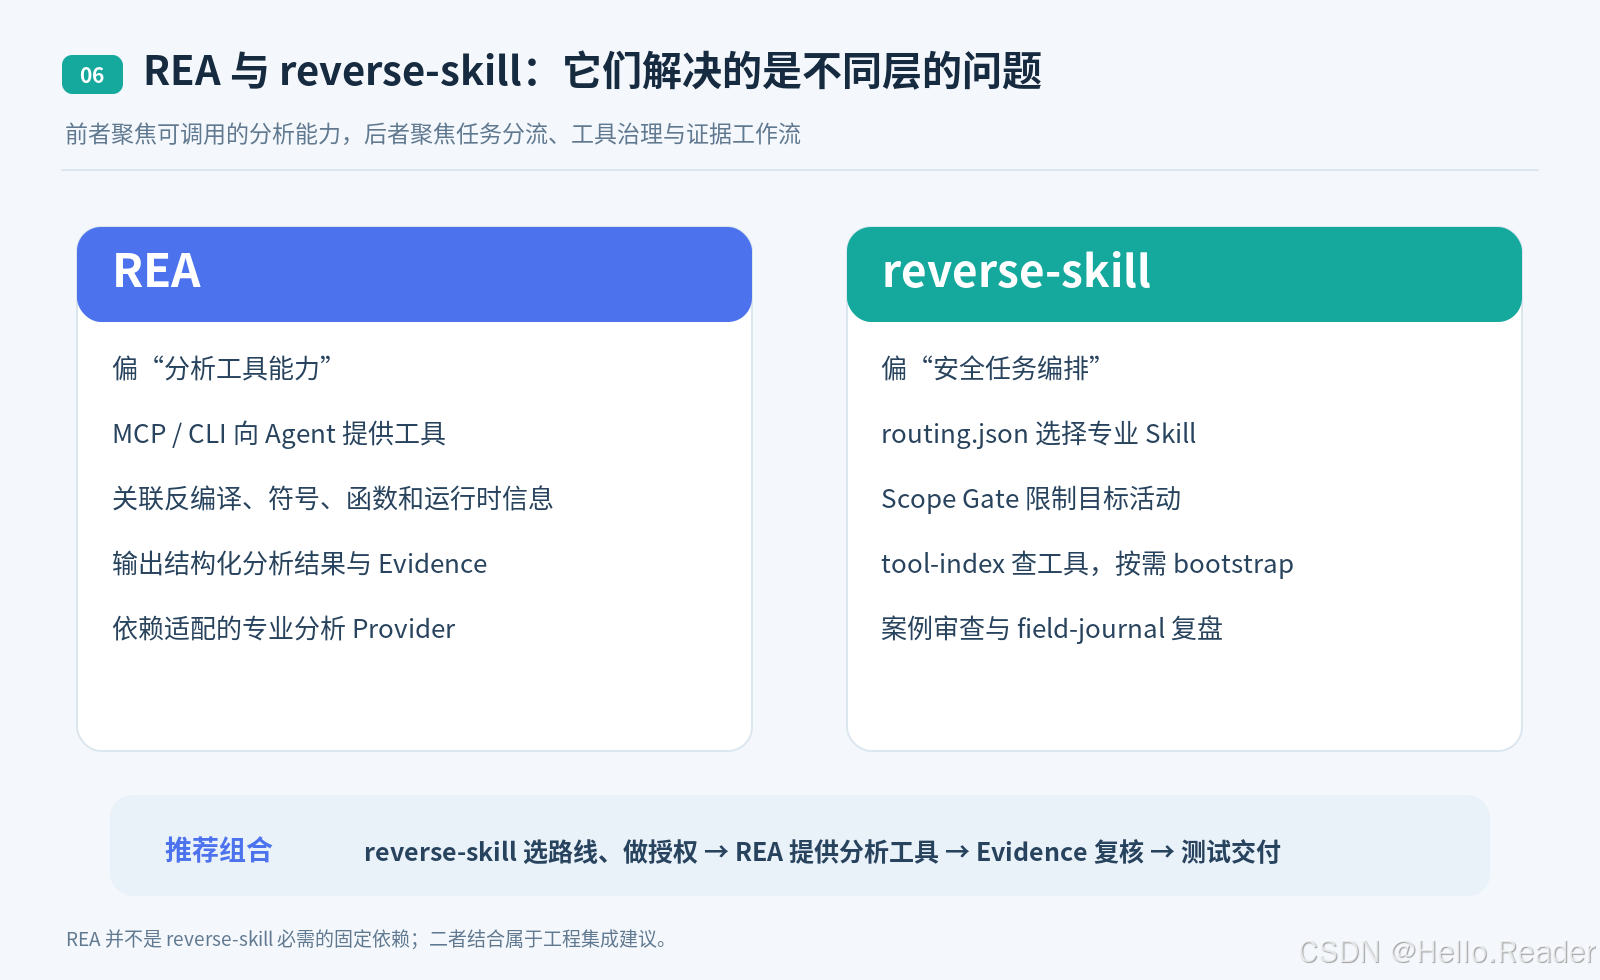
| 对比维度 | REA(morluto/rea) | reverse-skill(zhaoxuya520/reverse-skill) |
|---|---|---|
| 核心定位 | 分析能力接口,提供 CLI 与 MCP | 路由与作业规范,组织 Skill 和外部工具 |
| 主要输出 | 结构化分析事实、关系与 Evidence | PRIMARY、Scope、执行记录、Evidence/报告 |
| 是否自带反编译引擎 | 不自研代替所有引擎,依赖 Ghidra/Hopper/IDA 等 | 不自带万能反编译引擎,调用现有工具或服务 |
| 适合解决的问题 | 如何提取并关联程序中的分析事实 | 应当先做什么、使用哪个方法、如何管理风险与交付 |
| 一起使用 | 可作为某种分析工具能力来源 | 可作为上层分析工作流管理方式 |
我的建议是把二者看成可组合的两层,而不是简单二选一:reverse-skill 负责安排正确的方法与 Scope,REA 在适用目标上提供标准化分析能力,最终再由测试和 Evidence 判断结论能否成立。但这只是集成架构建议,并不是 reverse-skill 已经原生集成 REA 的声明。
11. 工程落地时还需要注意什么?
第一,Skill 不等于权限。 给 Agent 一个任务路由规范,并不代表它拥有执行危险操作的授权。必须结合用户批准、最小权限和系统隔离。
第二,工具自举存在供应链风险。 任何下载或自动安装都应核对软件来源、版本、校验信息、依赖许可证以及预期变更,尤其不要把未知脚本直接放进生产主机执行。
第三,路由是基于当前关键词规则的。 它不是深度语义理解器。含糊的任务可能进入兜底或产生交叉命中,复杂任务仍然需要人工复核 PRIMARY。
第四,证据链需要真实数据。 仅有 Markdown 模板不意味着结论已经被验证;需要具体的源文件、日志、哈希值、反编译结果或独立复现。
第五,维护成本不可忽略。 Skill 数量多了以后,版本、路径、测试基准和文档都会发生漂移。仓库自带的路由回归和一致性检查,是把 Skill 项目从"提示词合集"提高到工程化水准的重要基础。
12. 结语
reverse-skill 最值得借鉴的,不是哪一条破解命令,而是它给出了一个思路:让 AI 的逆向调查有入口、有规则、有授权、有工具状态、有证据,也有可复用的复盘。
对于个人开发者,可以先从一份离线 ELF 或自己的 Android APK 开始;对于团队,更适合进一步把 Scope Gate、案例审查和工具版本管理纳入统一开发流程。
归根结底,AI 负责辅助推理,工具负责真实观察,证据负责约束结论,最终测试负责验收。
参考资料
- reverse-skill 仓库:https://github.com/zhaoxuya520/reverse-skill
- 项目中文说明:https://github.com/zhaoxuya520/reverse-skill/blob/main/README_zh.md
- Agent 配置与同意门:https://github.com/zhaoxuya520/reverse-skill/blob/main/README_AI.md
- 路由主文档:https://github.com/zhaoxuya520/reverse-skill/blob/main/skills/MASTER-ROUTING.md
- 结构化路由规则:https://github.com/zhaoxuya520/reverse-skill/blob/main/skills/config/routing.json
- 授权 Scope 契约:https://github.com/zhaoxuya520/reverse-skill/blob/main/skills/ops/scope-contract.md
- Evidence 证据契约:https://github.com/zhaoxuya520/reverse-skill/blob/main/skills/ops/evidence-finding-path.md
- REA 对比项目:https://github.com/morluto/rea
许可提醒:reverse-skill 主仓库采用 MIT 许可,但部分子模块与第三方工具可能有独立许可证。本文只讨论合法授权的软件分析、教学实验与防御研究。