> 系列:VeapAI 自然语言操作实战(全体系架构专题)
> 本文要点:声明式资产 · 写入三表台账 · 就绪检查 · 固定顺序的过滤链
条目写完,为什么还搜不到
知识库里明明有一条"第三十条",问答却召回不到。这类"搜不到"的问题,排查下来通常有三层原因:没向量化、索引没就绪、被过滤链挡掉。
这就是向量层的全部工作量。它不是"接一个 Milvus 就完事",而是一段有状态、有台账、有边界的工程链路。本文按两段来看:先看写入,再看召回。
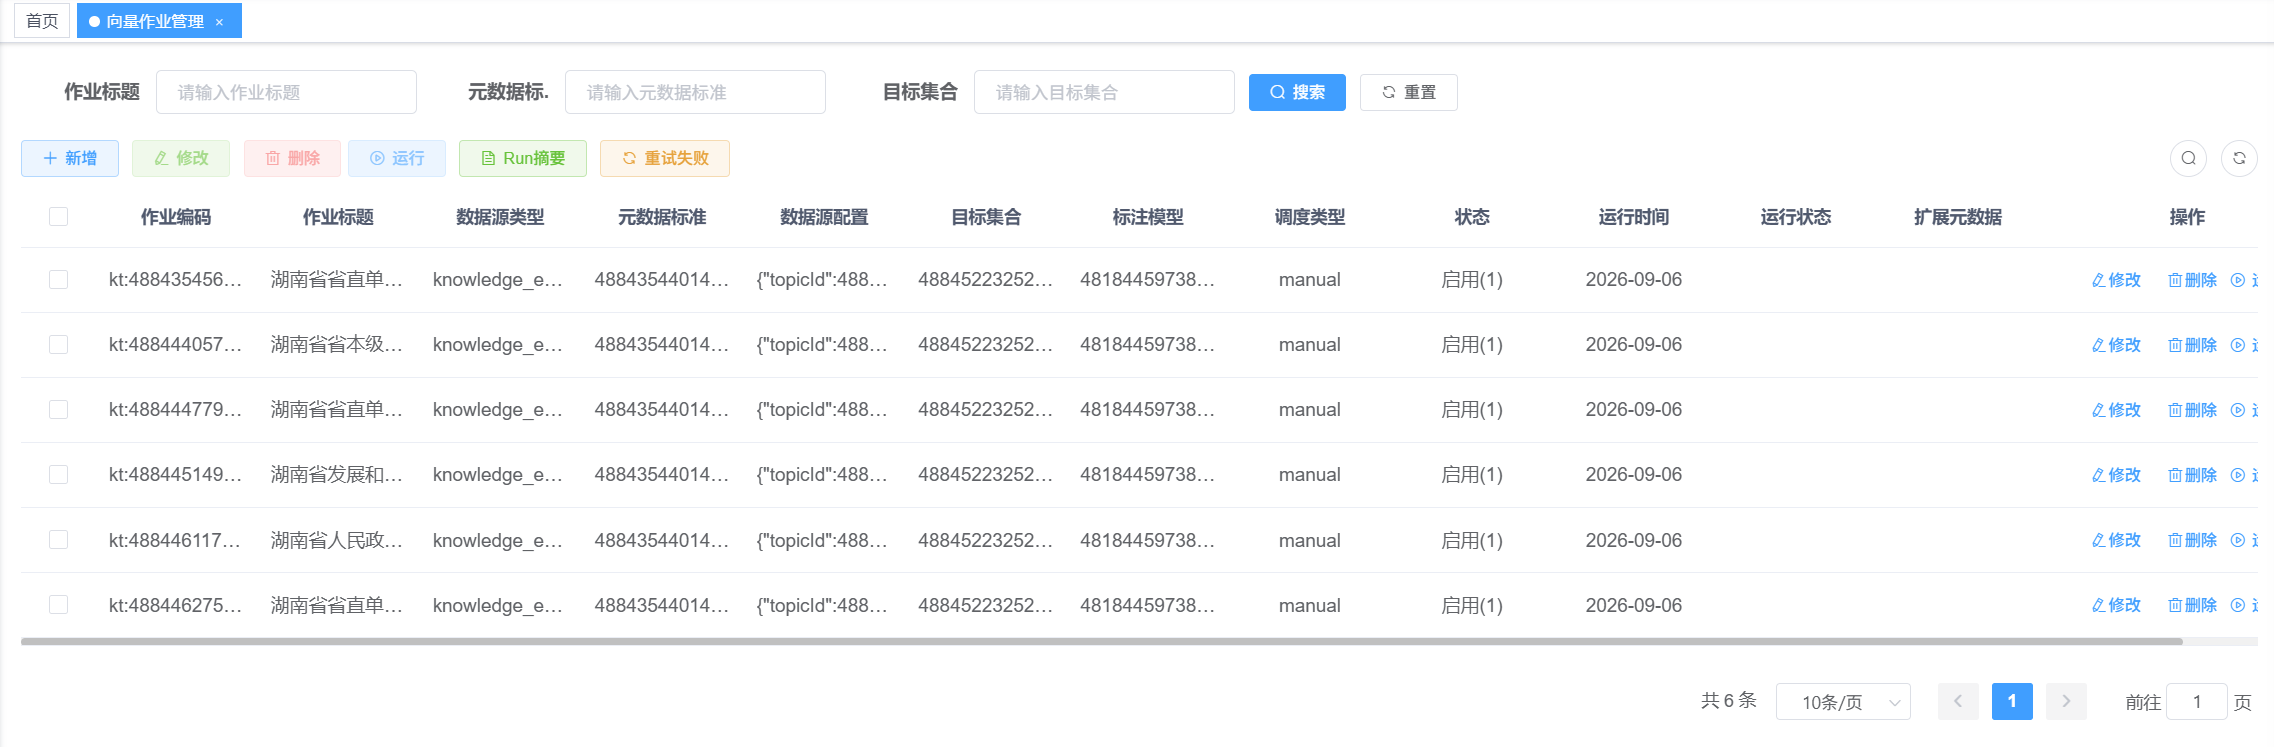
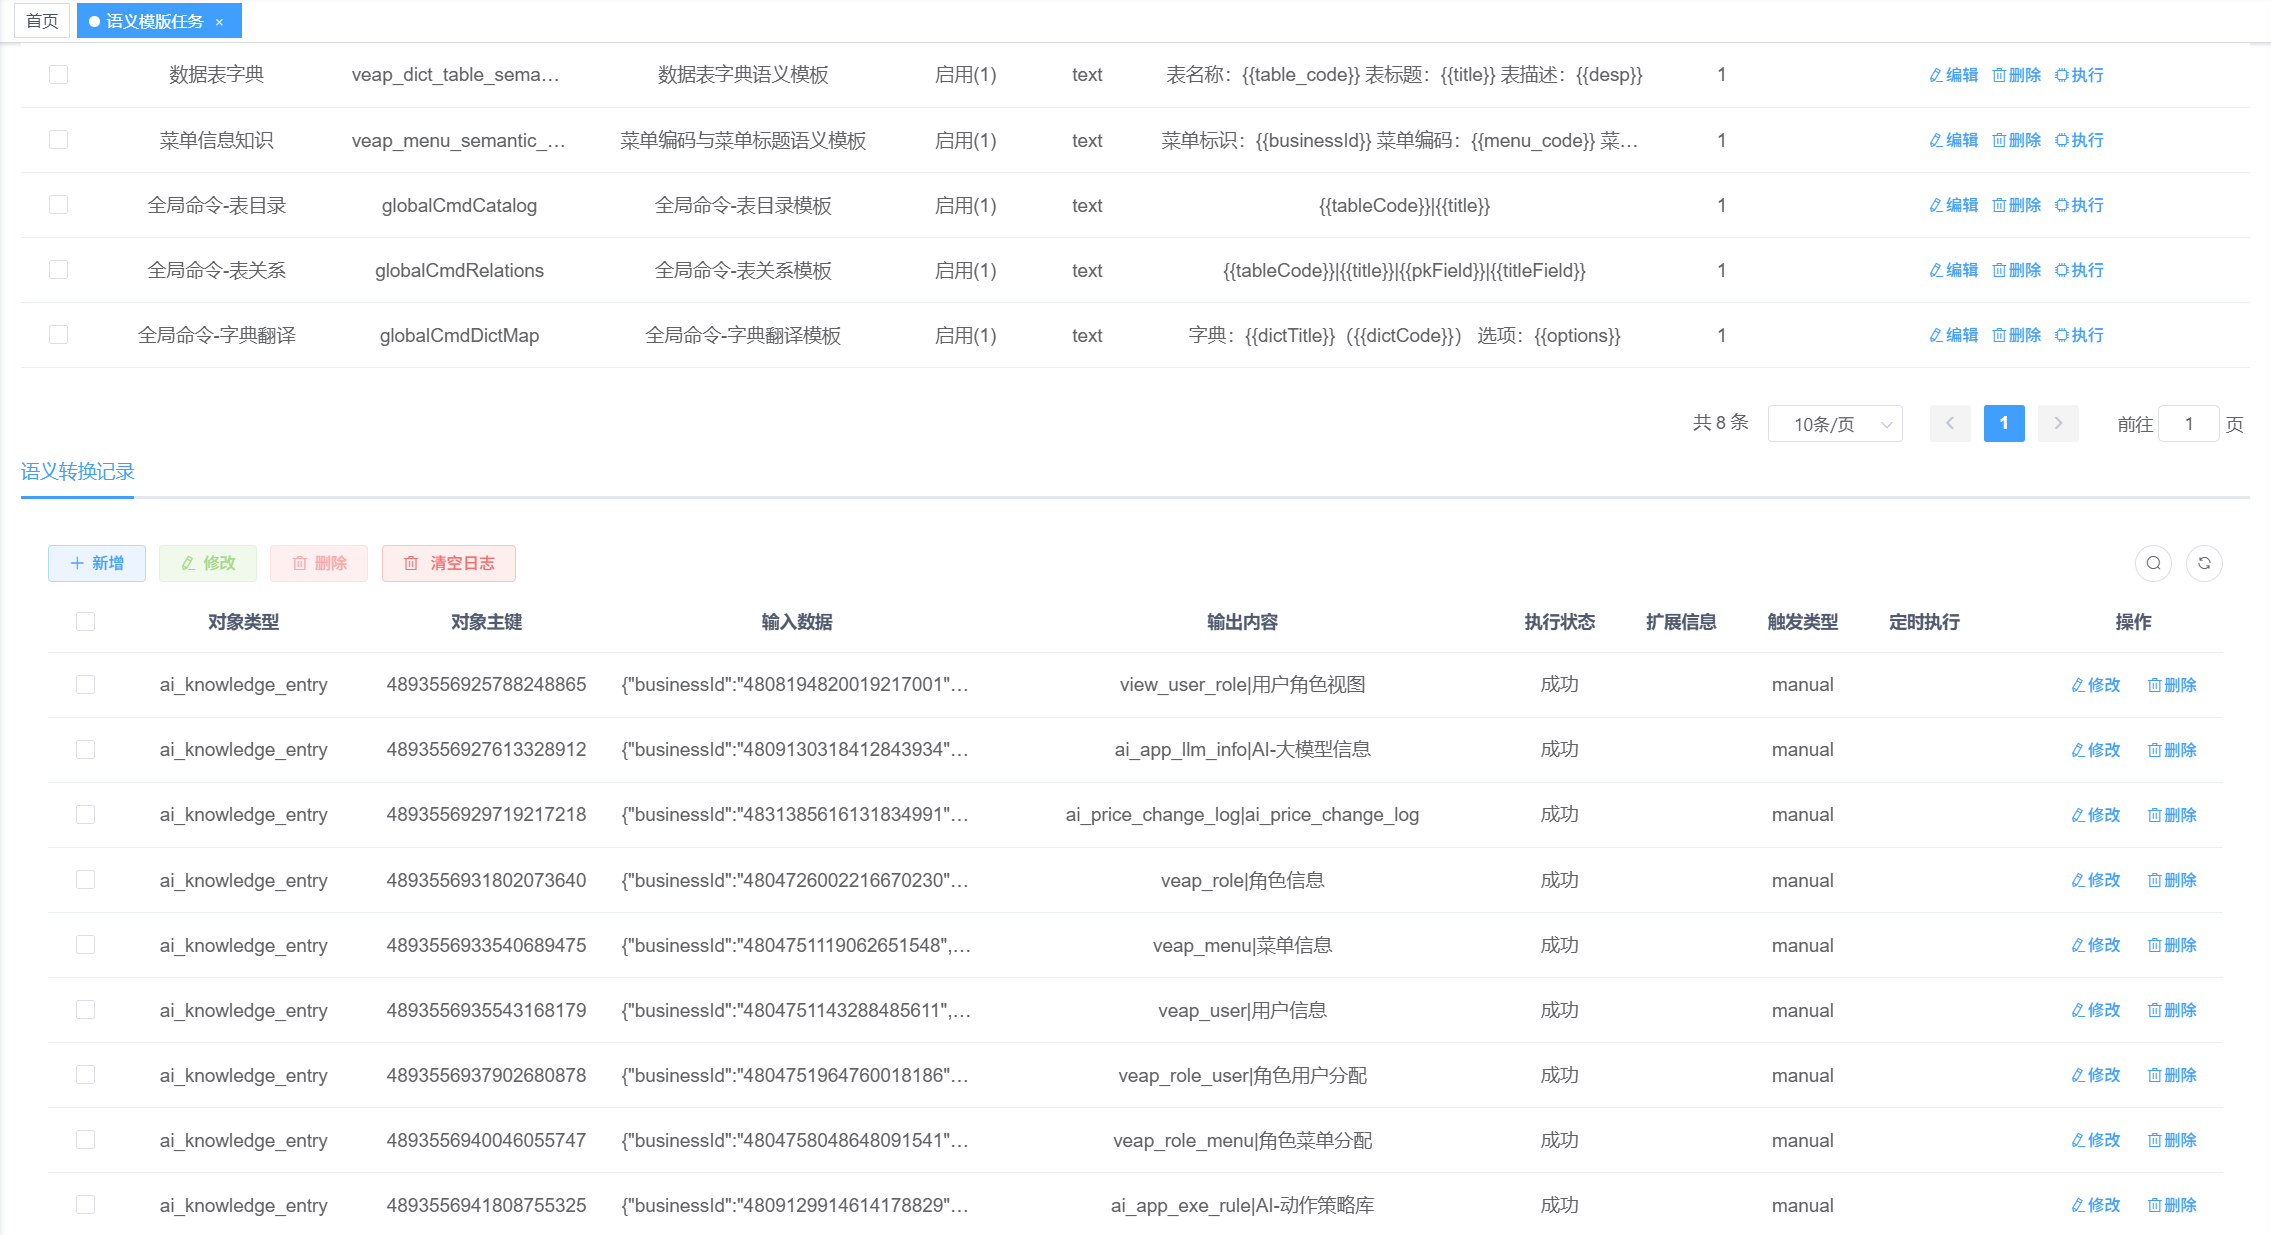
!向量化作业与运行记录:写入链的每一批都有统计与明细
资产先声明,再同步
!向量资产生命周期:声明式资产(实例 → 集合 → 字段 → 索引)与写入链(作业 → 批次 → 逐条 → 台账)
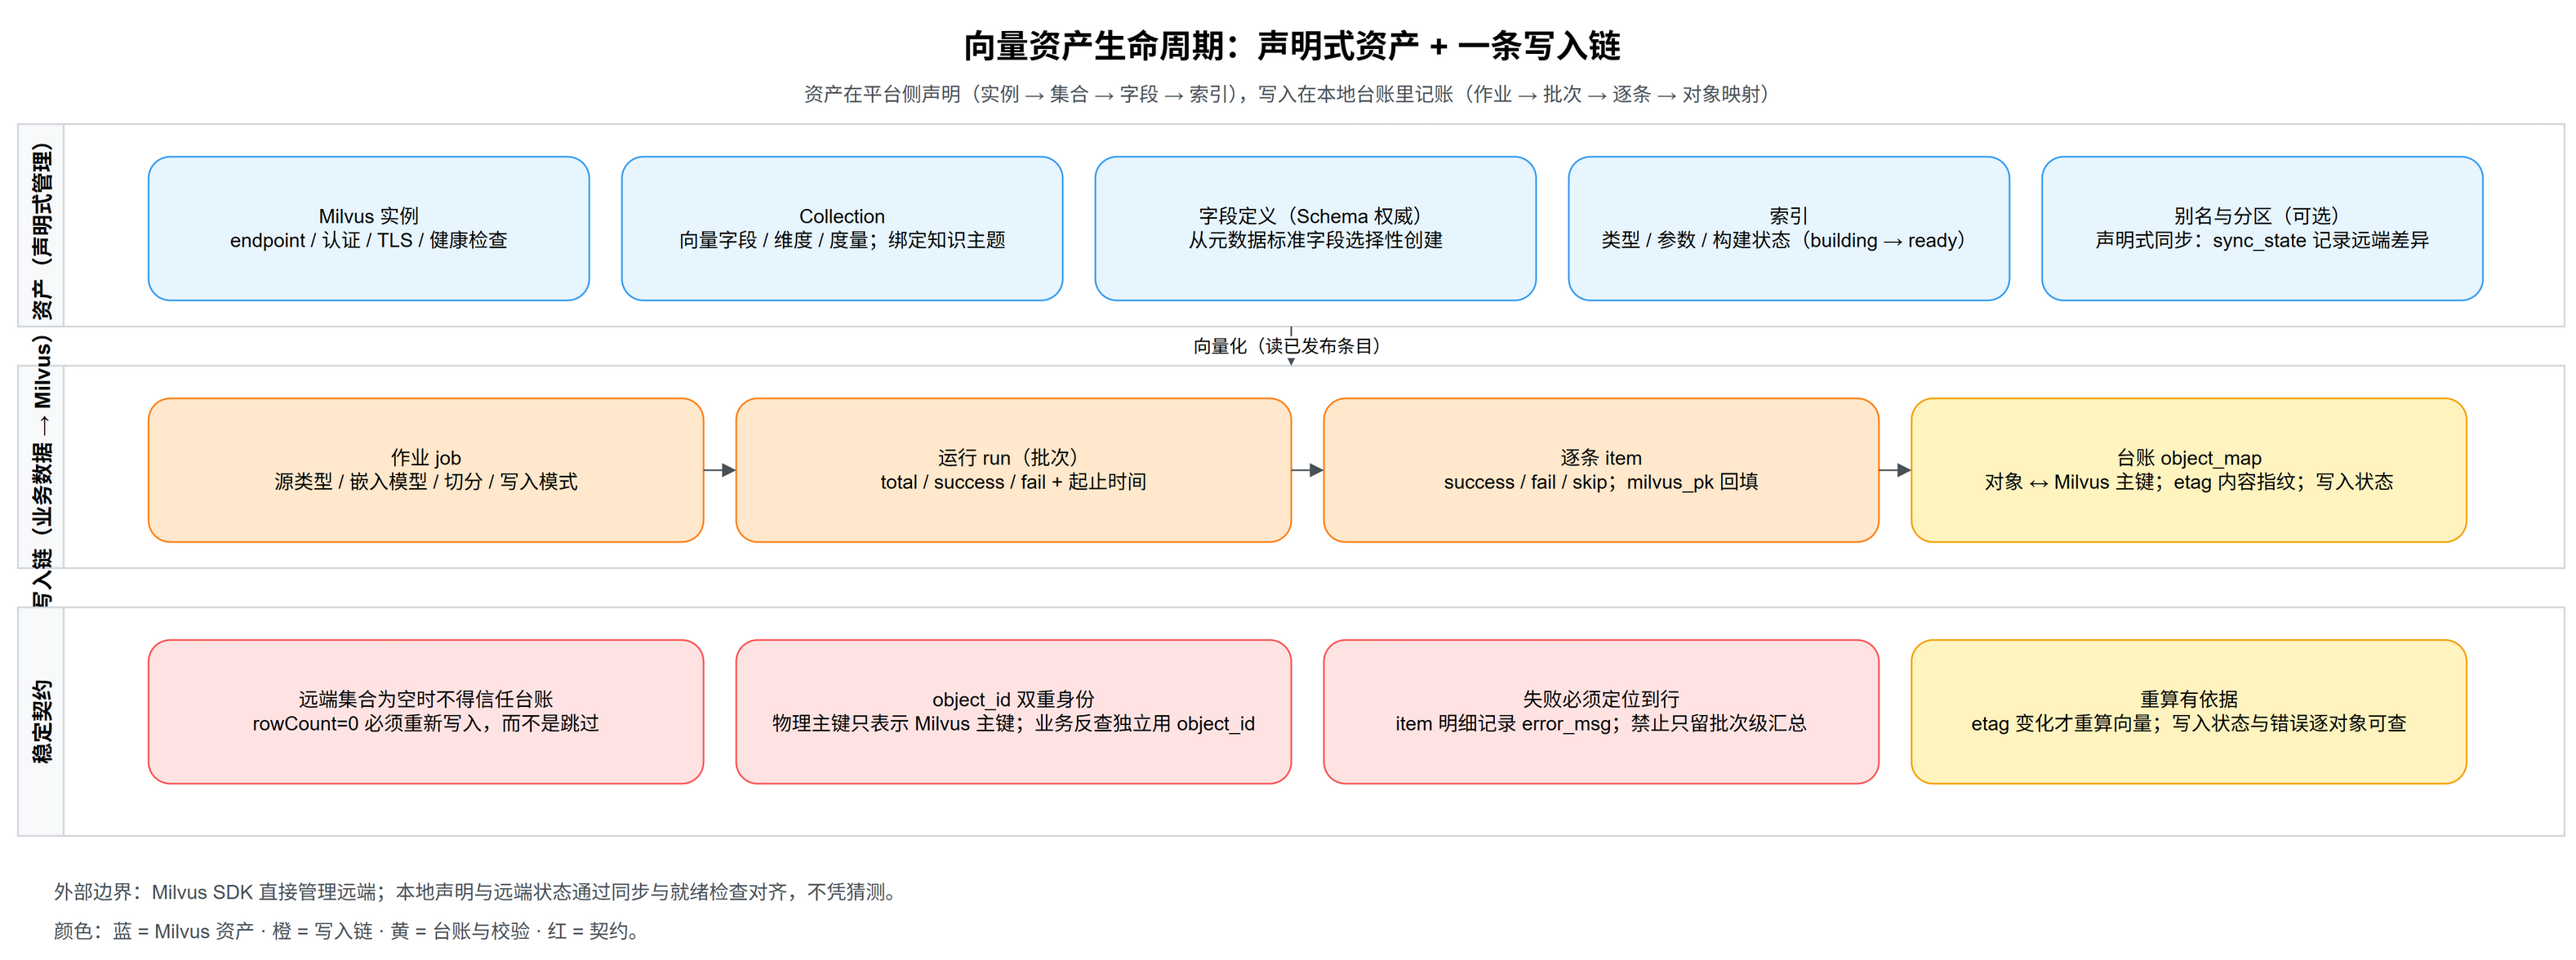
平台对 Milvus 资产采用声明式管理:先在平台侧把资产定义清楚,再同步到远端。资产有五层:
-
实例:`endpoint`、认证(token / 用户密码,密钥加密存储)、TLS 与健康检查;
-
集合:`primary_field`(主键字段名)、`vector_field`、`vector_dim`、`metric_type`(L2 / IP / COSINE)四个字段必须显式声明;集合绑定知识主题;
-
字段定义:Schema 权威在平台侧,每个字段可以从元数据标准的字段里选择性创建;
-
索引:类型(HNSW / IVF_FLAT / AUTOINDEX 等)与构建状态(`build_state`);
-
别名与分区:可选,用于平滑切换与数据组织。
声明与远端之间可能出现差异,所以集合上有一列 `sync_state`:unknown、in_sync、out_of_sync、pending、error。改完声明后同步一次,状态归位;出问题时有据可查。
写入:三张表记账,外加一本台账
一次向量化写入,本地会留下四份记录,各管一段:
| 表 | 角色 | 关键字段(注释原文节选) |
| --- | --- | --- |
| `ai_vector_ingest_job` | 作业定义(业务数据向量化 → Milvus) | `source_type`:knowledge_entry 等;`embed_model_id`:Embedding模型ID;`upsert_mode`:insert_only / upsert / replace |
| `ai_vector_ingest_run` | 运行批次 | `run_status`:running / success / fail / canceled;total / success / fail 计数 |
| `ai_vector_ingest_item` | 运行明细(失败定位) | `item_status`:success / fail / skip;`milvus_pk`:写入成功后回填 |
| `ai_vector_object_map` | 向量对象映射(业务对象 ↔ Milvus主键) | `milvus_pk`:字符串化,兼容 Int64 / UUID;`etag`:内容hash(判断是否需重算向量) |
四份记录的分工很清楚:job 说"要做什么",run 说"这一批做得怎么样",item 说"哪一条出错了",object_map 说"这个对象现在对应哪个向量"。
台账里的 `etag` 是个细节亮点:它是内容的指纹。内容没变,向量就不用重算;内容变了,etag 变化触发重写。没有这列,每次执行都得全量重算。
就绪检查与两条数据契约
检索之前有一道硬门禁,叫就绪检查。规则只有两条:集合里有数据时,必须存在且仅存在一个启用的向量字段索引,且 `build_state=ready`,才允许加载集合并检索;集合没有数据时,直接返回空结果,不做任何尝试。
这个检查防的是最常见的"搜不到":索引还在构建中,检索请求打过去,表面没有报错,结果却是空的。与其让用户猜,不如把门禁前置。
另外两条数据契约,是踩过坑之后写死的:
-
`primary_field` 只表示 Milvus 的物理主键;业务侧反查知识条目,必须用独立的 `object_id` 字段。两者不是一回事,混用会在某些主键模式下直接查错;
-
召回返回 `object_id` 后,如果回查知识条目为空,必须显式报"知识召回数据不一致",禁止静默输出空列表。查不到就是有问题,问题要报出来。
召回:固定顺序的过滤链
!召回过滤链:检索、融合、发布态、权限、ACL、重排、加权,每一步顺序固定
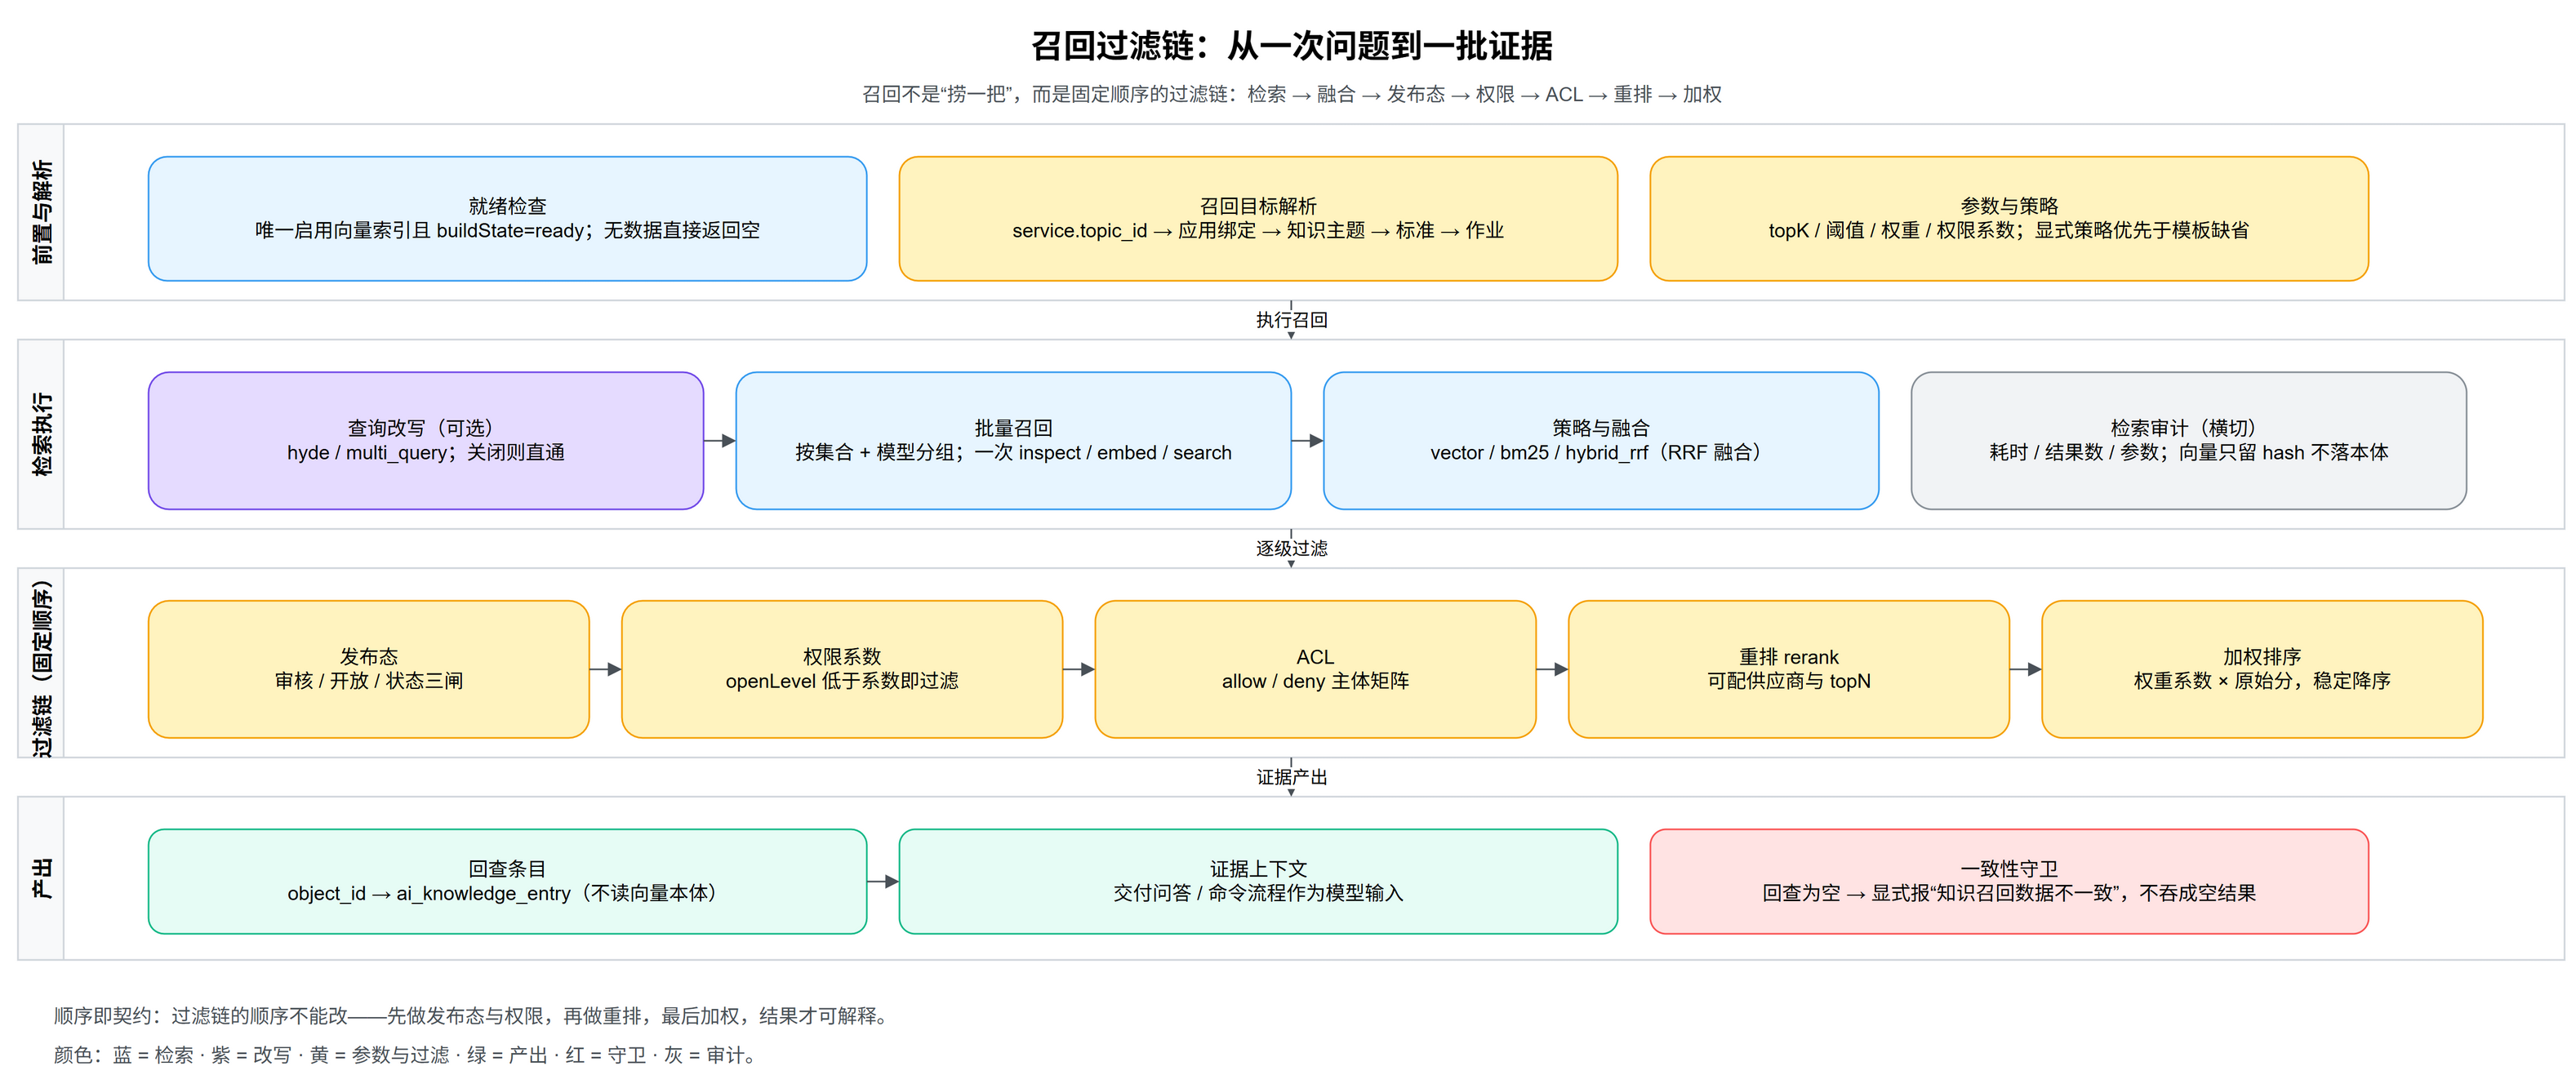
召回的执行从"解析"开始:先定召回目标,再定参数。目标是链路解析出来的------从应用服务的 `topic_id` 出发,经过应用绑定、知识主题、标准,最终落到向量化作业。
检索行为的配置收在检索模板 `ai_vector_search_template` 里,四组要素:
-
`strategy_type`:vector(缺省)、bm25(全文)、hybrid_rrf(向量 + 全文 RRF 融合);
-
`query_rewrite_config`:查询改写(hyde / multi_query),可关闭;
-
`rerank_config`:重排配置(供应商与 topN);
-
`top_k`、`score_threshold`、`filter_expr`、`output_fields`:常规检索参数。
多主题召回是批量执行的。按"集合 + 嵌入模型"分组,每组一次 inspect / embed / search,过滤表达式形如 `topic_id in ...`。多个知识主题因此不会退化成多次往返。
检索拿到候选之后,还有一条固定顺序的过滤链,一步都不能省:
-
发布态:审核、开放、状态三个闸门都过的条目才可召回;
-
权限系数:条目公开级别低于配置系数的直接过滤;
-
ACL:按 allow / deny 矩阵判定主体可见性;
-
重排:按配置的供应商对候选重新打分;
-
加权排序:按知识配置的权重系数与原始分加权,稳定降序。
顺序即契约。先做发布态与权限、再做重排、最后加权,任何一步换顺序,结果的解释都会变。
过程全程留痕:`ai_vector_search_audit` 记录查询文本、`top_k`、过滤表达式、结果数量、耗时与状态。向量本身只留 hash,不落库。
!检索调试台:dense / sparse / 融合三路结果并排,便于对比策略效果
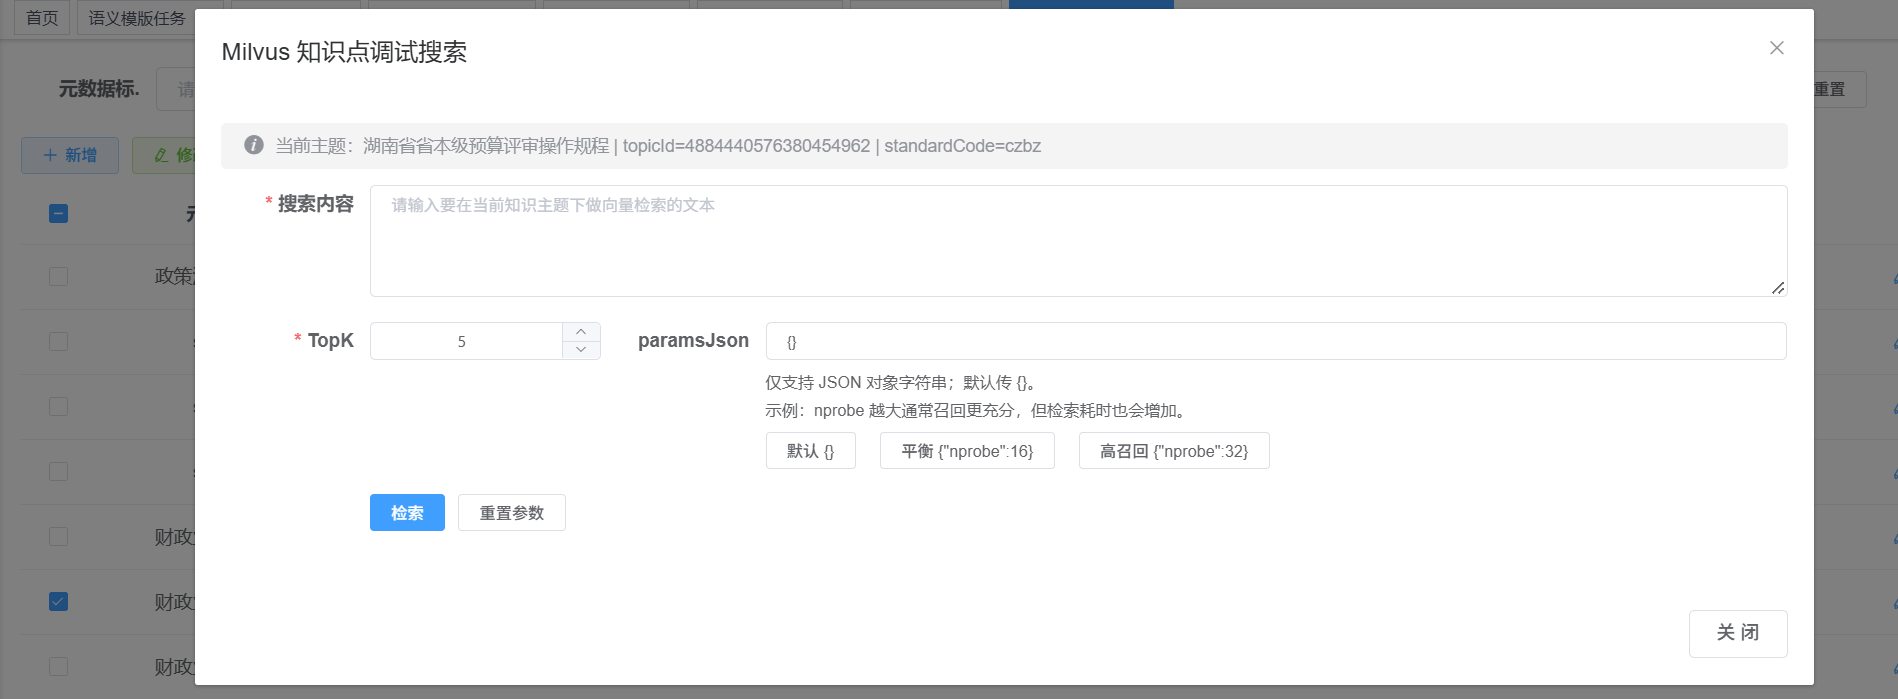
!检索模板:策略、改写与重排配置的可视化维护入口
源码走读
-
资产与写入:`veap-cloud/veap-modules/veap-milvus`------`AiMilvusCollectionController`、`AiVectorIngestJobController` 与写入执行器;
-
召回执行:`AiKnowledgeEntryVectorQueryAppService`(单主题与批量两条路径);内网入口 `InnerMilvusVectorQueryController`(`/milvus/inner/knowledgeEntry/vectorQueryHitsBatch`);
-
嵌入调用:`EmbeddingFacade`------兼容 openai_compat 协议(`/api/embed`)与既有直连两种模式;
-
检索模板:`ai_vector_search_template` 的 `strategy_type`、`rerank_config`、`query_rewrite_config` 三列,由可视化页面维护;
-
SDK:Milvus SDK(2.6.x),客户端按连接键复用。
较真:两次"信任"引发的返工
向量层最贵的教训,都与"信任"有关。
第一次是信任本地台账。旧的跳过逻辑是:台账里有记录、本轮就跳过写入。上线后遇到一次远端集合被清空的情况,台账还在,数据已经没了,于是所有条目都被跳过,知识全丢但没有任何报错。修复后的契约很简单:远端集合 `rowCount=0` 时不得信任台账,必须重新写入;并且只有本轮发生了实际写入,才允许刷新台账。
第二次是信任"已经写好的方法"。批量召回上线后,结果恒为空。排查到根因:单主题与批量两条路径的 `output_fields` 传参不同。批量路径仍然只传 `object_id` 一个字段,而结果分发逻辑要按 `topic_id` 分组。字段缺失导致每条记录都被判定为无效并丢弃。解法其实早就在代码里------一个定义好但没被用上的批量字段集。
教训写在规范里:**新增一个执行参数,必须把全部调用点的语义差异重新核对一遍。**单主题路径的方案,不能默认搬进批量路径。
复现与验证
-
看写入链:`SELECT run_status, total_count, success_count, fail_count FROM ai_vector_ingest_run WHERE job_id = <作业id> ORDER BY id DESC LIMIT 5;`
-
看台账:`SELECT object_type, object_id, milvus_pk, last_upsert_status FROM ai_vector_object_map WHERE collection_id = <集合id> LIMIT 20;`
-
看审计:`SELECT result_count, latency_ms, status FROM ai_vector_search_audit ORDER BY id DESC LIMIT 10;`
这一层的边界:它只负责"条目进、证据出",不负责改写业务口径,也不承担知识质量。条目本身准不准,是前两层的事------向量层只保证"查得到"。
到这里,知识侧的链路已经完整:附件与系统数据进来,加工成条目,向量化后可以被召回。接下来换个视角,看这些能力是怎么被装配进同一个前端运行时的。