这不是一份可以挂很多年的模型榜,结果更新于2026 年 10 月。
2026 年 10 月,我们又广泛测试过 Qwen 3.7 max、Qwen 3.8 max、Doubao 2.1 Lite、豆包 2.1 Pro、Gemini 3.7 Flash、Gemini 3.8 Flash、 GLM 5.3、DeepSeek 4.1 flash、 GPT-6 Sol、GPT-6.1 Sol 和 GPT-6 Luna 之后,效果最好的已经是 GPT-6.1 Sol,性价比最高的是 GPT-6 Luna。
8 月那轮的分数仍然有效,但只代表 8 月。 当时 GPT-5.6 Sol 配合鬼手翻译 Agent,中译英综合分 9.75 / 10 ,匿名同组胜率 85.6% ,语义错译率 2.43%。第二梯队最低错译率是 4.46%,这一项大约低了 46%。
让我们回顾一下 8 月份短剧翻译的大模型和 agent 评测:8 月样本是 200 部真实短剧,每部前 10 集 ,覆盖 AI 剧、漫剧和真人剧;目标语 15 种 。14 个模型先小样测试,7 个进入大规模匿名对照。评测时固定 Agent 的其他流程,只换底层翻译模型。
短剧翻译的难点:一句很顺,剧还是会翻砸
短剧单集不长,人物关系、身份和世界观却是整部剧的。句子语法对、读着也顺,仍然可能把人指错、把事实改掉,或者长到放不进那个镜头。
我们看翻译,主要盯五件事:
- 剧情事实:人物、否定、数量、因果、关键动作不能改。
- 像人话:符合当地口语,同时保留原意。
- 像这个人:身份、亲疏、威胁和情绪强度,决定称谓和力度。
- 整部剧一致:人名、组织、族群跨集不能各翻各的。
- 说得进镜头:太长会逼配音加速,太短会空一拍。
下面五句都来自评测里的真实台词,画面是对应剧照。对照看的是"其他翻译"和鬼手翻译 Agent 的差别。
翻译案例 1:金额没了,委屈也就轻了
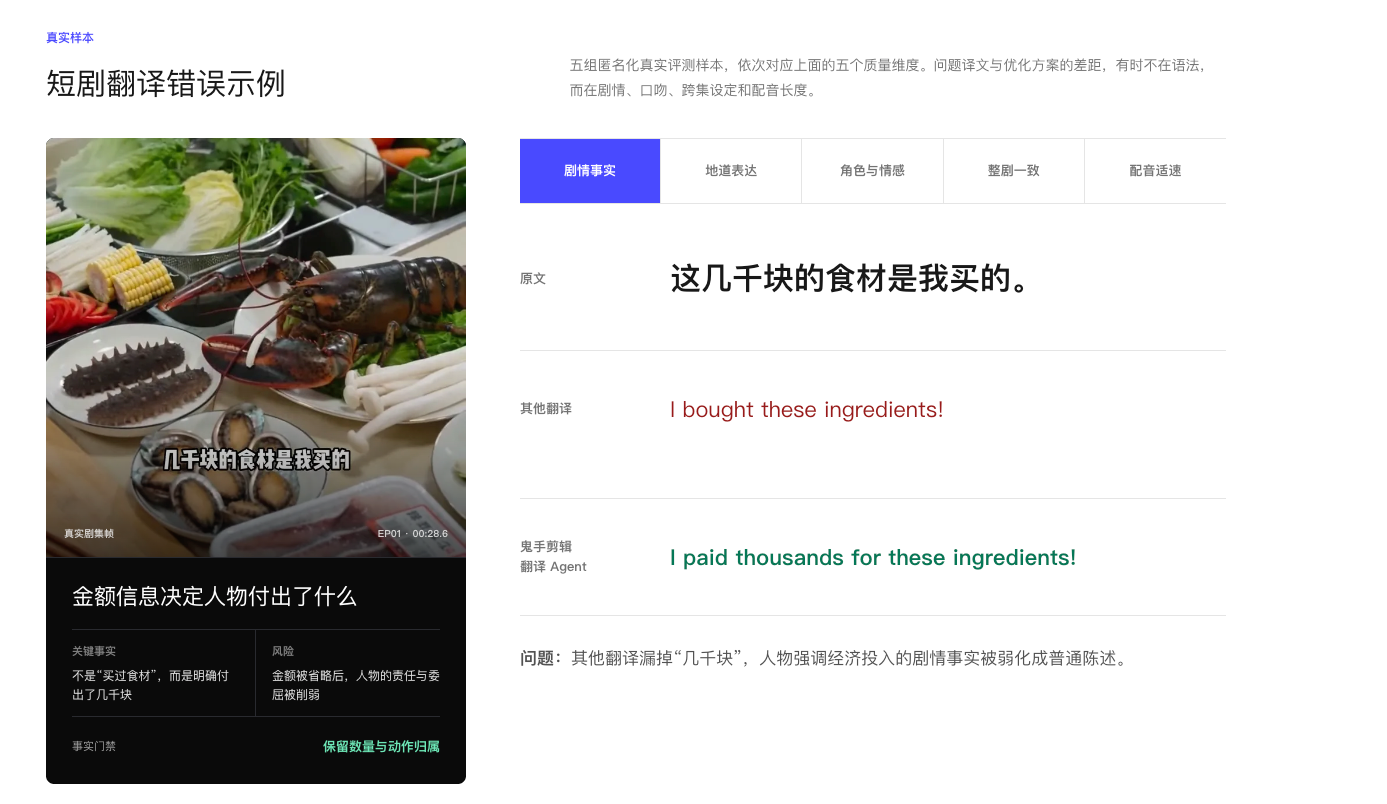
这几千块的食材是我买的。
其他翻译: I bought these ingredients!
**鬼手翻译 Agent:**I paid thousands for these ingredients!
「买过食材」语法没问题。原文要说的是付出了几千块。金额一删,这句从委屈变成报菜名。
翻译案例 2:「娘家」不是一座房子
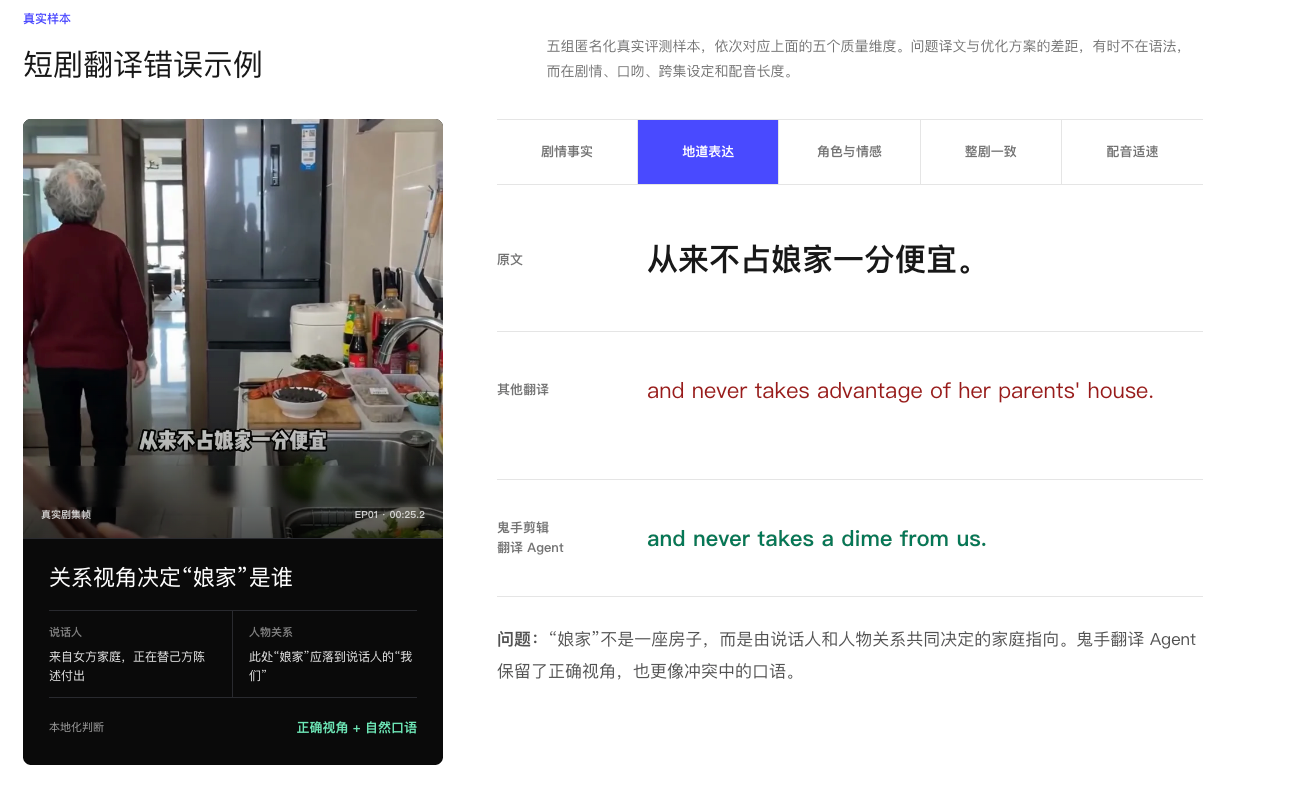
从来不占娘家一分便宜。
其他翻译: and never takes advantage of her parents' house.
**鬼手翻译 Agent:**and never takes a dime from us.
这句是女方家里的人在替自己这边说话。「娘家」指的是说话人的「我们」一方,不是对方父母的房子。术语表可以记住「娘家」有个标准译法,但谁在说、对谁说、现在站在哪一边,表本身不知道。
翻译案例 3:动词一换,骂的就不是同一件事
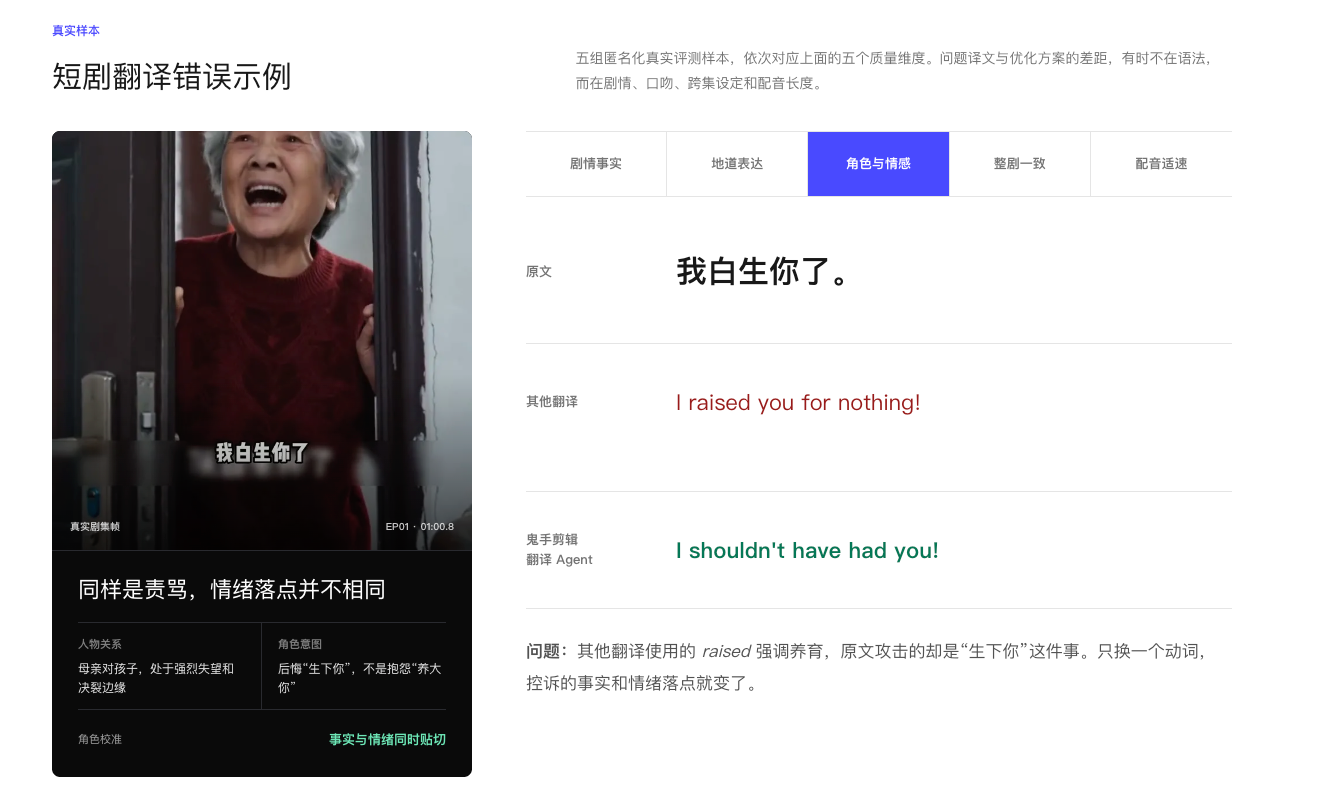
原文:我白生你了。
其他翻译:I raised you for nothing!
鬼手剪辑翻译 Agent:I shouldn't have had you!
问题: 其他翻译使用的 raised 强调养育,原文攻击的却是"生下你"这件事。只换一个动词,控诉的事实和情绪落点就变了。
翻译案例 4:组织和族群不能译成普通名词
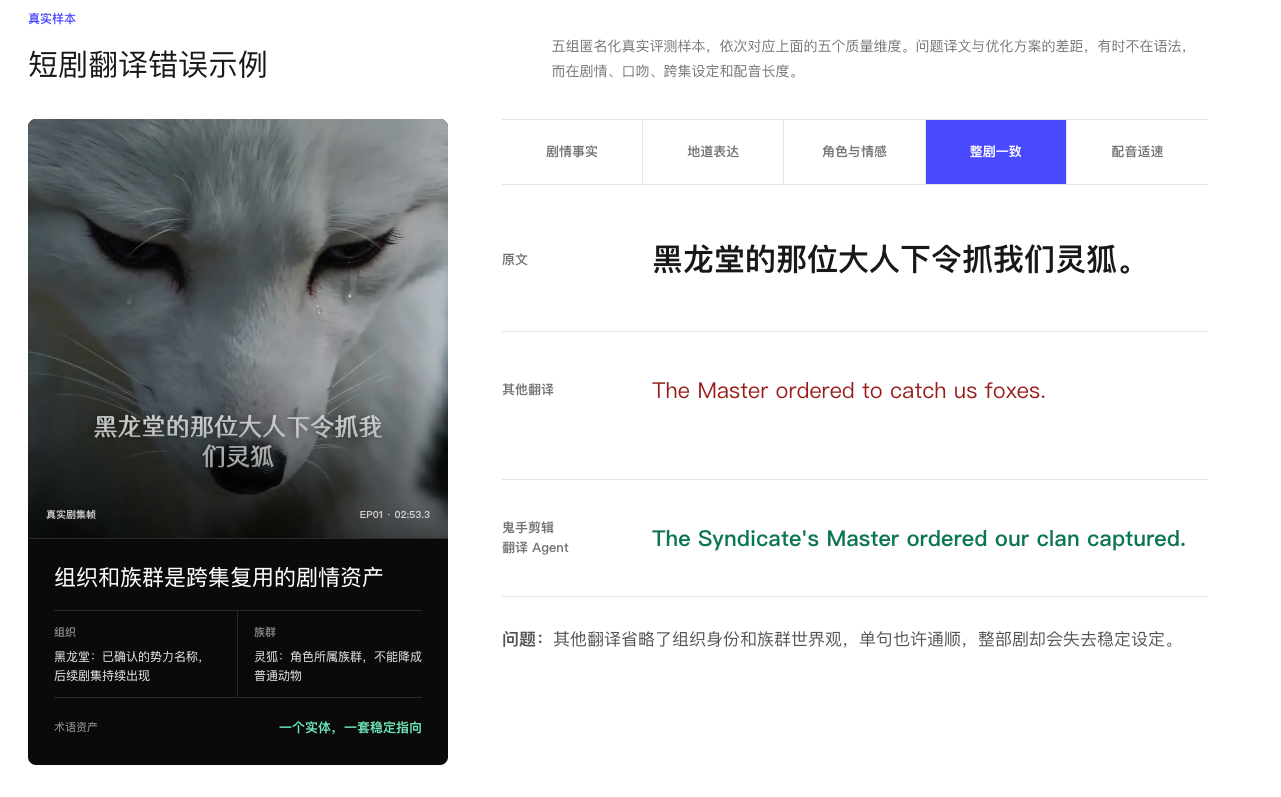
原文:黑龙堂的那位大人下令抓我们灵狐。
**其他翻译:**The Master ordered to catch us foxes.
**鬼手剪辑翻译 Agent:**The Syndicate's Master ordered our clan captured.
黑龙堂是后面还要出现的势力,灵狐是族群,不是森林里的狐狸。这一句单看也许通顺,整部剧的设定会从这里开始散架。
翻译案例 5:短促台词要保住意义,也要说进镜头
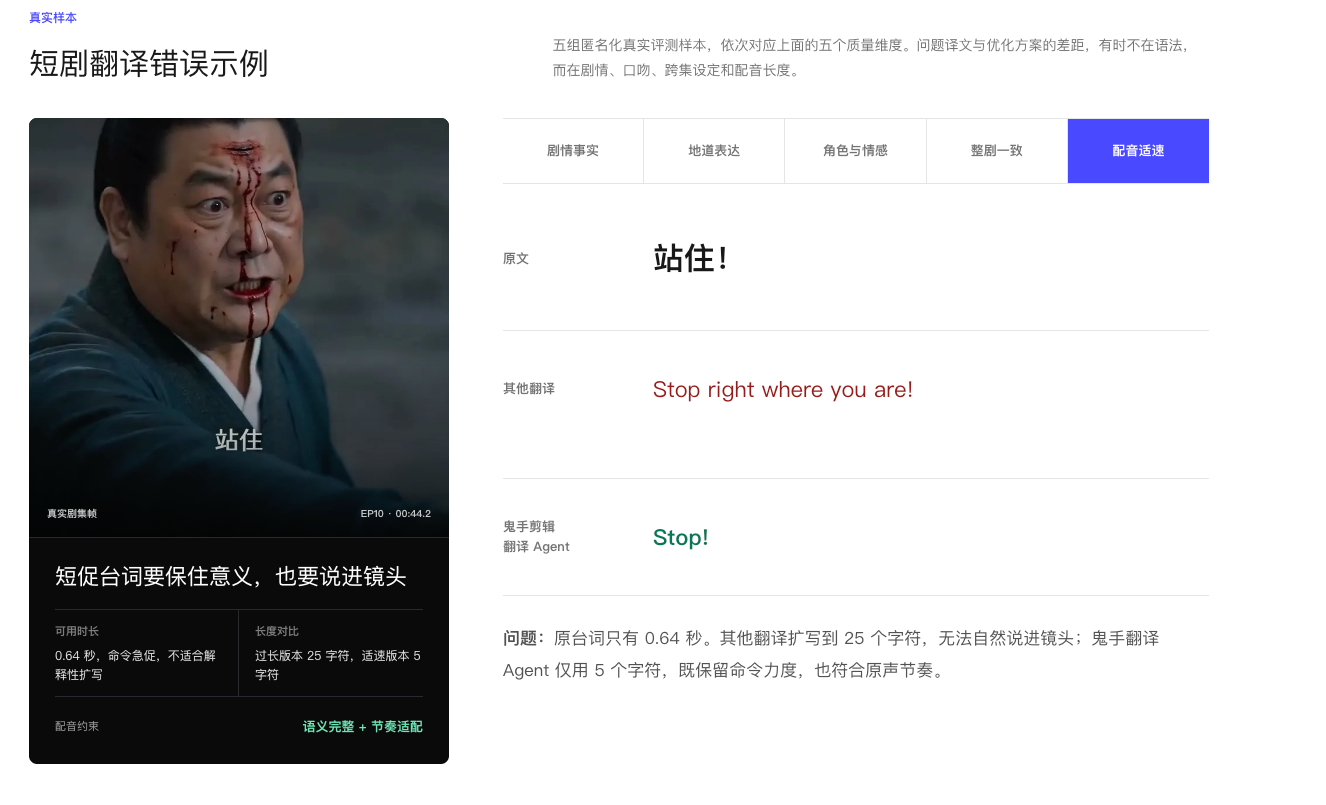
原文:站住!
其他翻译: Stop right where you are!
鬼手翻译 Agent: Stop!
这句只有 0.64 秒。扩写版大约 25 个字符,说不进镜头;收成 Stop,5 个字符,命令还在。长度按中英语速估算配音时长,1.00 大约等长。它不是最终配音实测,但能提前看出这句会不会顶破画面。
上面几句里,有的错在模型没抓住事实,有的错在没有理清整部剧的人物关系。两件事要分开。
模型决定这一句能写到多好。 翻译不只是模型的功劳,需要有超长上下文的约束来流转,来保证翻译的准确、一致。
翻译不只需要好模型,还需要Agent 约束整部剧的语境
Agent维护的是跨集还在用的东西:人物、关系、真名和化名、组织、剧情阶段、术语。润色、事实核对、语言检查和台词长短,需反复查看,不是生成一次就交付。术语表仍然有用,适合固定人名、组织、功法和世界观。称谓和立场不能机械替换。「刘哥」可能是亲近、江湖的称谓,也可能只是客气,要看此刻的人物关系。译文还要能用后面的配音:字幕行、角色、顺序和时间别打乱。过长就收紧,过短就补上自然的停连,保留人物和关键动作。
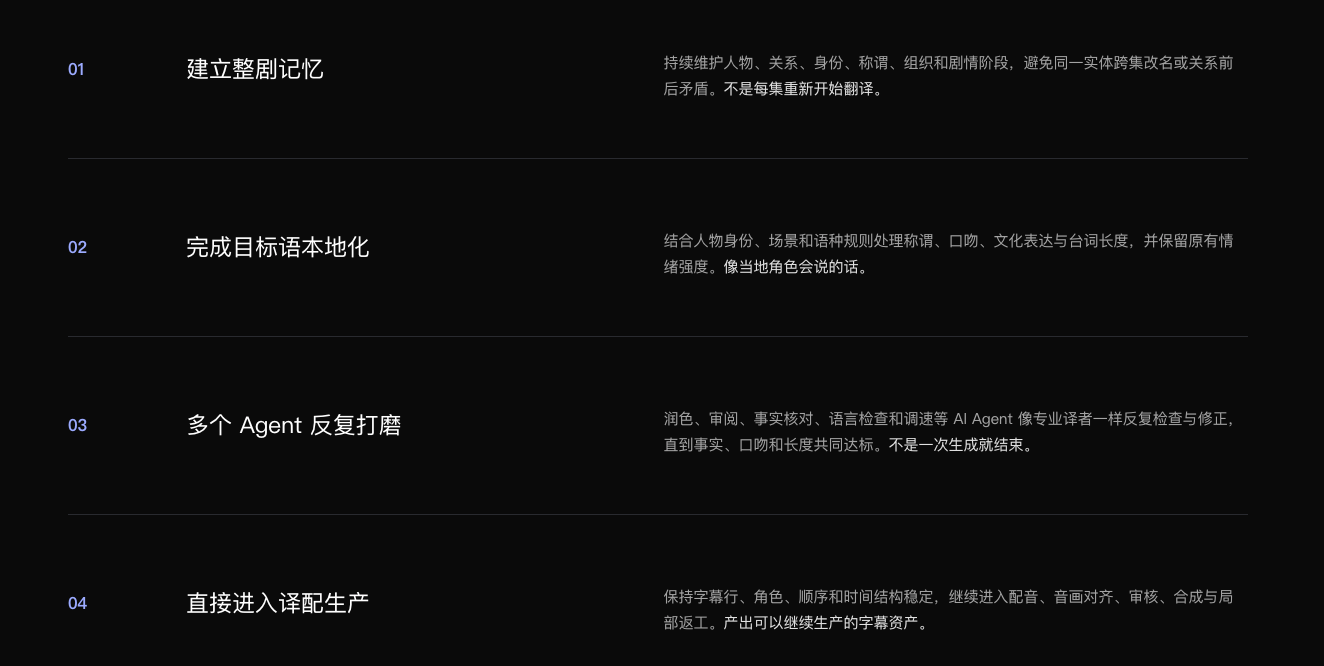
在一套完整的评测逻辑和数据集中,寻找最佳短剧翻译模型:
**同一套 Agent,换一个底层模型,剧情理解、口语自然度和语义错误率仍会明显变化。**所以我们在 2026 年 8 月份,先广泛测试 14 个大模型,从中筛选优秀模型进入大批量深度评测,直到选出配合鬼手翻译 Agent 表现最佳的那一个。
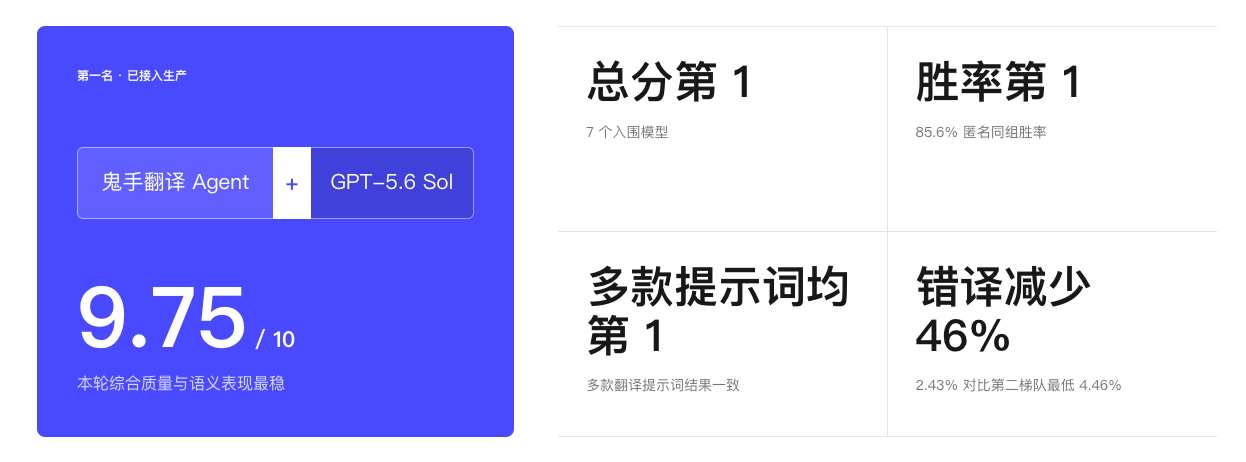
14 个模型里进了 7 个,中译英第一是 GPT-5.6-Sol(2026 年 8 月)
观察池14个,小样看可用性、结构稳不稳、翻译像不像短剧台词。7个进入完整横评。中译英这一项做了数千次模型测试,同一部剧的译文打乱模型名,用当时推理能力最强的模型做匿名盲测。
GPT-5.6 Sol 在多套翻译提示词下都是第一,现已接进鬼手翻译 Agent。Gemini 3.1 Pro 和 Kimi K3 在公开领先组里。其余入围模型按页面口径匿名,不在这里猜名讳。
| 排名 | 候选 | 质量 / 10 | 语义错译率 | 长度比 |
|---|---|---|---|---|
| 1 | GPT-5.6 Sol | 9.75 | 2.43% | 1.13 |
| 参考 | 人工翻译 A | 9.53 | 未单独统计 | 1.16 |
| 2 | Gemini 3.1 Pro | 9.51 | 4.46% | 1.13 |
| 3 | 模型 A | 9.51 | 4.73% | 1.22 |
| 4 | Kimi K3 | 9.46 | 4.46% | 1.09 |
| 5 | 模型 B | 9.44 | 6.62% | 1.09 |
| 6 | 模型 C | 9.43 | 5.54% | 1.11 |
| 参考 | 人工翻译 B | 9.30 | 未单独统计 | 1.22 |
| 7 | 模型 D | 9.27 | 6.35% | 1.15 |
人工翻译 A、B 和模型译文放在一起盲测,只做质量参照,不参与这 7 个模型的排名。它们的样本没有单独算语义错译率。
质量分看四项:准确完整、口语自然、角色口吻、一组台词里前后连贯。语义错译率按台词组算,统计的是篡改人物、否定、因果、数量、动作或其他原意的比例。
每一轮、每个语向内部,候选使用相同源字幕、术语资产和输出结构,并使用该轮次冻结的模型配置。单集盲评与多集一致性复核分层随机交由 Gemini 3.1 Pro 和 GPT-5.6 Solo 两款模型,各评一半;4 个 Gemini 评审任务因供应商安全拒绝从有效分母中剔除,未转交另一评审模型。自动化评估不能替代母语审校,也不能完全消除评审模型的家族偏好。
英语之外,14个语种里13个领先(2026年8月)
同一套样本库,还测了日语、韩语、泰语、越南语、印尼语、拉美西班牙语、巴西葡萄牙语、法语、德语、阿拉伯语、土耳其语、俄语、印地语、意大利语。
盲测由两款评估模型随机打分。折合成 10 分制后,鬼手翻译 Agent + GPT-5.6 Sol 的整体质量分平均高出 4% ,单个语种的 PK 胜率最高 84.6% 。14 个非英语语种里,13 个综合均分领先,巴西葡萄牙语持平。
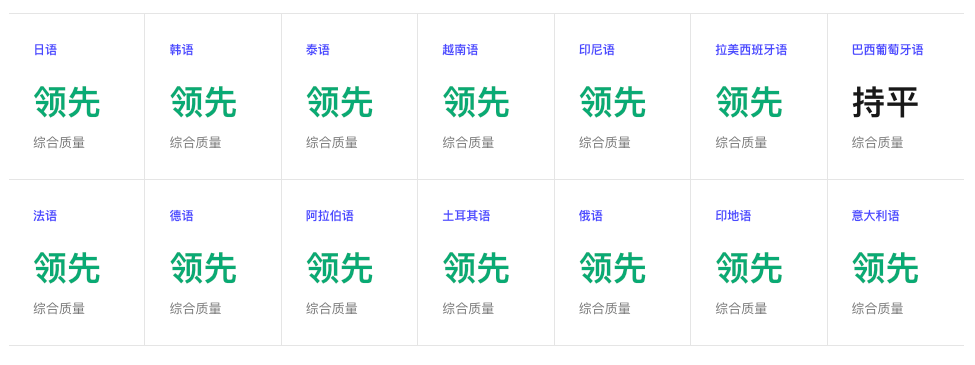
| 语种 | 这轮结果 |
|---|---|
| 日语、韩语、泰语、越南语、印尼语 | 领先 |
| 拉美西班牙语、法语、德语、阿拉伯语 | 领先 |
| 土耳其语、俄语、印地语、意大利语 | 领先 |
| 巴西葡萄牙语 | 持平 |
引用这组数之前,先看边界
评测冻结在 2026 年 8 月 的模型配置。候选用同一套源字幕、术语和输出结构。单集盲评和多集一致性复核,分层随机交给 Gemini 3.1 Pro 和 GPT-5.6 Sol,各评一半。有 4 个 Gemini 评审任务被供应商以安全原因拒绝,从有效分母中剔除,没有改交另一个模型。
自动化评估替代不了母语审校,也消不掉评审模型和参赛模型同族时的偏好。高风险内容仍建议人工看一遍。AI这轮分数高,不等于可以免审。
14 个进入前期候选的模型是:DeepSeek V3.2、DeepSeek V4 Flash 0731、Doubao Seed 2.0 Lite、Gemini 3.0 Flash、Gemini 3.1 Flash Lite、Gemini 3.1 Pro、Gemini 3.5 Flash、Gemini 3.6 Flash、GLM-5.2、GPT-5.6 Luna、GPT-5.6 Sol、GPT-5.6 Terra、Grok 4.5、Kimi K3。其中 7 个进入大规模评测,名单以 2026 年 8 月 6 日为准。
不适合直接拿去用的情况:把这一次榜单当成以后永远的采购标准;拿去解释和短剧字幕无关的通用翻译赛事。