ndexTTS-2和 CosyVoice 之 TTS(Text-to-Speech) 使用python示例
本文介绍了TTS(文本转语音)技术及其在语音克隆、情感表达等方向的应用,重点展示了哔哩哔哩ndexTTS-2与阿里云CosyVoice的Python实现示例。
TTS 技术概述
TTS(Text-to-Speech,文本转语音)是将文本内容自动转换为语音的技术。
语音克隆属于 TTS 的一个技术方向,二者区别:
普通 TTS 直接使用模型内置的已有音色朗读文本,不需要额外提供人声样本。
语音克隆 TTS 需要提供目标说话人的音频样本,让模型学习复刻其声线音色,并用该音色朗读任意文本。
TTS 技术已经从早期单纯 "把文字读出来",演进到可以根据文本信息预测停顿、重音、语调,实现带有情感风格的朗读。现代 TTS 的核心竞争力不只在于音频音质,还包括韵律控制、情感表现力、推理实时性、音色定制能力以及文本前端处理能力。
TTS 拥有丰富落地用途:用于智能助手、车载导航等人机交互场景;支撑智能客服、自动外呼业务;快速生成有声书、短视频、数字人配音等音频内容;作为无障碍工具,帮助视障、阅读障碍人群获取文字信息;同时广泛用于语言教育、公共信息播报、游戏交互等领域。
现代 TTS 有众多代表性模型与产品。开源模型方面,Tacotron2、FastSpeech 奠定端到端神经语音合成基础;VITS 是当前本地部署、少样本克隆最热门的框架;Bark 擅长生成带有情绪、语气的口语语音。商用产品包括阿里云 CosyVoice、微软 Azure TTS、百度智能云、科大讯飞 TTS,以及面向创作者的 ElevenLabs、Suno 等。其中 CosyVoice、ElevenLabs 等支持语音克隆,仅需少量音频样本即可复刻目标人声。
Azure TTS(Azure AI Speech 神经文本转语音,官方商用服务) 是微软云 Azure AI 语音服务中的正式商用 TTS 服务,面向企业与开发者的官方产品,底层为 Neural 神经语音模型,现在新增 DragonHD 高清语音。
edge-tts (Python 开源库,调用 Edge 浏览器内置 TTS 接口,非微软官方 SDK)是社区开源 Python 库,**不是微软官方产品**。它调用的是 Microsoft Edge 浏览器网页端内置的免费神经 TTS 接口,**语音模型和 Azure 预训练神经音色是同一套**,所以听感高度接近。
关于edge-tts 使用可见
https://blog.csdn.net/cnds123/article/details/167258747
https://blog.csdn.net/cnds123/article/details/165126064
哔哩哔哩(Bilibili)的ndexTTS-2
ndexTTS-2 是由哔哩哔哩(Bilibili)Index 团队开源的第二代零样本语音合成系统,其核心突破在于**首次在自回归零样本 TTS 模型中实现精确的时长控制**,同时保持了高自然度与情感表现力,并实现音色与情感解耦,可独立调控音色和情绪。IndexTTS‑2 支持本地 GPU 部署,可自行下载权重与代码在本地显卡上运行;同时有 HuggingFace 官方 Demo 以及第三方封装的在线云端网页,无需本地显卡即可快速试用。
Demo 展示地址:https://index-tts.github.io/index-tts2.github.io
官方GitHub 仓库:https://github.com/index-tts/index-tts
B站官宣视频:https://www.bilibili.com/video/BV136a9zqEk5
IndexTTS-2 的使用方式与费用:
试听效果:如 ModelScope 在线 Demo 。 免费。
本地部署:有硬件门槛如需要NVIDIA GPU,一次性硬件投入 + 电费。模型本身完全免费,无调用次数限制,长期成本主要是电费和硬件折旧。
云端 API 调用:无需硬件, 按量付费,如:
· 优云智算 支持 IndexTTS-2,参数完整 充值门槛 50 元。
· 模力方舟 支持 IndexTTS-2,10 元门槛 只开放了部分参数,sample_rate、gain 不认。
在线体验
不用部署也不用写代码,可以直接使用在线体验站。例如 ModelScope 的 IndexTTS-2 Demo:
https://modelscope.cn/studios/IndexTeam/IndexTTS-2-Demo
注册(如用手机号短信验证)后即可在浏览器中上传参考音频、输入文本、选择情感,直接生成语音。
如果追求开箱即用,WebUI 和云平台 API 最省事。
下面是一个完整的 Tkinter GUI 示例,通过云平台的 OpenAI 兼容接口调用 IndexTTS-2。
模力方舟(Moark)是开源中国旗下的AI大模型服务平台,可以理解为国内版的Hugging Face。它依托Gitee的开发者生态,提供从模型体验到部署的一站式服务,并且对IndexTTS-2有很好的支持。语音和语音合成部分还包括CosyVoice2等。
模力方舟首页:https://ai.gitee.com
注册登录
在IndexTTS-2 模型页,
获取访问令牌 (API Key)
下面给出python实现的完整示例。
示例运行截图:
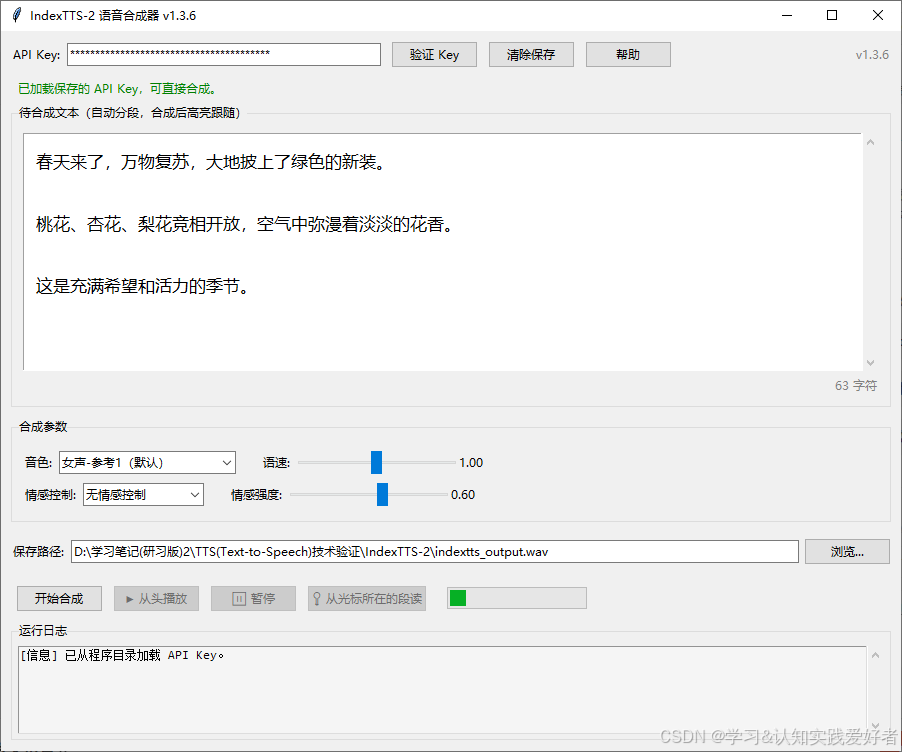
安装依赖
pip install openai
示例源码如下:
python
"""
IndexTTS-2 语音合成器 v1.3.6
------------------------------------------------
- 平台:模力方舟(Moark)
- 接口:POST /v1/audio/speech
- 特点:预置音色、并发合成、情感控制
------------------------------------------------
"""
import os
import re
import json
import shutil
import tempfile
import threading
import time
import bisect
import tkinter as tk
import wave
from concurrent.futures import ThreadPoolExecutor, as_completed
from tkinter import ttk, messagebox, filedialog
import requests
VERSION = "v1.3.6"
BASE_URL = "https://ai.gitee.com/v1"
MODEL_NAME = "IndexTTS-2"
# ==================== 预置音色 ====================
# - 全部为 Replicate 托管:https://replicate.com/lucataco/indextts-2/examples#2
VOICE_PRESETS = {
# ---- 中性参考(来自官方示例的 speaker_audio)----
"女声-参考1(默认)": (
"https://replicate.delivery/pbxt/"
"NigP1cGgZmFEu5z8A0u9uEWyE487nGgBQ7AZP2uQ4tYUe7S3/"
"reference1.wav"
),
"女声-参考2": (
"https://replicate.delivery/pbxt/"
"NigTVEMY9cJI8dIfL1aMnn6qxLMhstylWmb1V3lTGJ3vXWqu/"
"reference2.wav"
),
# ---- 带情感(来自 emotional 参考的合成输出)----
"女声-情感(激情型)": (
"https://replicate.delivery/xezq/"
"41QMD7WzK76oFJDOhDKmFO2NozL0sXrQSDxkG3ap0YbYhcVF/output.wav"
),
# ---- 带情感(来自预测输出,男声)----
"男声-情感": (
"https://replicate.delivery/pbxt/"
"NitO1NzB1daQBpaUDMK7oQuo27jGI2WoDXz4ue2asQ43awBW/"
"replicate-prediction-3hz4g2hrx1rma0csab285ha2r8-3.wav"
),
## "男声-情感(备选)": (
## "https://replicate.delivery/xezq/"
## "5gmCsU4WeQUYQqhuxetn8NafqD7JEbY9E4iCWrfFv7vugHXVB/output.wav"
## ),
}
EMO_METHODS = {
"无情感控制": 0,
"情感音频参考": 1,
"情感向量": 2,
"情感文本描述": 3,
}
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
DEFAULT_OUTPUT = os.path.join(SCRIPT_DIR, "indextts_output.wav")
CONFIG_PATH = os.path.join(SCRIPT_DIR, ".indextts_config.json")
CLIP_PATH = os.path.join(tempfile.gettempdir(), "indextts_clip.wav")
MAX_SEG_LEN = 150
POLL_MS = 50
MAX_RETRIES = 3
RETRY_BASE_DELAY = 1.0
MAX_CONCURRENT = 5
PLAY_START_GRACE_MS = 500
END_CONFIRM_COUNT = 3
# ==================== 文本切分 ====================
def _split_recursive(s, start, max_len):
if not s:
return []
if len(s) <= max_len:
return [(s, start, start + len(s))]
parts = re.split(r'(?<=[。!?!?])', s)
if len(parts) > 1:
result, offset = [], start
for p in parts:
if p:
result.extend(_split_recursive(p, offset, max_len))
offset += len(p)
return result
parts = re.split(r'(?<=[,,;;、])', s)
if len(parts) > 1:
result, offset = [], start
for p in parts:
if p:
result.extend(_split_recursive(p, offset, max_len))
offset += len(p)
return result
return [(s[i:i + max_len], start + i, start + i + min(max_len, len(s) - i))
for i in range(0, len(s), max_len)]
def split_text_smart(text, max_len=MAX_SEG_LEN):
segments = []
pos = 0
for part in re.split(r'(\n\s*\n)', text):
if not part:
continue
if re.fullmatch(r'\n\s*\n', part):
pos += len(part)
continue
segments.extend(_split_recursive(part, pos, max_len))
pos += len(part)
return segments
def concat_wavs(input_paths, output_path):
durations = []
with wave.open(output_path, "wb") as out:
with wave.open(input_paths[0], "rb") as first:
p = first.getparams()
out.setparams(p)
framerate, sampwidth, nchannels = p.framerate, p.sampwidth, p.nchannels
data = first.readframes(first.getnframes())
out.writeframes(data)
durations.append(len(data) / sampwidth / nchannels / framerate)
for path in input_paths[1:]:
with wave.open(path, "rb") as w:
wp = w.getparams()
if (wp.sampwidth != sampwidth or
wp.nchannels != nchannels or
wp.framerate != framerate):
raise RuntimeError(f"WAV 参数不匹配: {os.path.basename(path)}")
data = w.readframes(w.getnframes())
out.writeframes(data)
durations.append(len(data) / sampwidth / nchannels / framerate)
return durations
# ==================== 主程序 ====================
class IndexTTSApp:
def __init__(self, root):
self.root = root
self.root.title(f"IndexTTS-2 语音合成器 {VERSION}")
screen_w = self.root.winfo_screenwidth()
screen_h = self.root.winfo_screenheight()
win_w = min(900, screen_w - 80)
win_h = min(720, screen_h - 120)
win_x = max(0, (screen_w - win_w) // 2)
win_y = max(0, (screen_h - win_h) // 2 - 20)
self.root.geometry(f"{win_w}x{win_h}+{win_x}+{win_y}")
self.root.minsize(740, 560)
self.is_playing = False
self.is_paused = False
self.play_offset_ms = 0
self.timeline = []
self.timeline_starts = []
self.highlight_idx = -1
self.current_audio_path = None
self._playing_clip_path = None
self._play_started_at = 0.0
self._not_busy_count = 0
self._play_available = False
try:
import pygame
pygame.mixer.init()
self.pygame = pygame
self._play_available = True
except Exception:
self.pygame = None
self.build_ui()
self.load_config()
def build_ui(self):
# 顶部:API Key
api_frame = ttk.Frame(self.root, padding=10)
api_frame.pack(side=tk.TOP, fill=tk.X)
ttk.Label(api_frame, text="API Key:").pack(side=tk.LEFT)
self.api_key_var = tk.StringVar()
ttk.Entry(api_frame, textvariable=self.api_key_var, width=44, show="*").pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="验证 Key", command=self.check_api_key).pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="清除保存", command=self.clear_saved_key).pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="帮助", command=self.show_help).pack(side=tk.LEFT, padx=5)
ttk.Label(api_frame, text=VERSION, foreground="gray").pack(side=tk.RIGHT)
self.status_label = ttk.Label(self.root, text="请填写 API Key 并点击[验证 Key]", foreground="gray")
self.status_label.pack(side=tk.TOP, fill=tk.X, padx=15)
# 底部:日志
log_frame = ttk.LabelFrame(self.root, text="运行日志", padding=5)
log_frame.pack(side=tk.BOTTOM, fill=tk.X, padx=10, pady=(0, 10))
log_frame.rowconfigure(0, weight=1)
log_frame.columnconfigure(0, weight=1)
self.log_text = tk.Text(log_frame, height=6, font=("Consolas", 9), state=tk.DISABLED, bg="#f5f5f5")
self.log_text.grid(row=0, column=0, sticky="nsew")
log_scroll = ttk.Scrollbar(log_frame, orient=tk.VERTICAL, command=self.log_text.yview)
log_scroll.grid(row=0, column=1, sticky="ns")
self.log_text.config(yscrollcommand=log_scroll.set)
# 底部:按钮区
btn_frame = ttk.Frame(self.root, padding=10)
btn_frame.pack(side=tk.BOTTOM, fill=tk.X)
self.generate_btn = ttk.Button(btn_frame, text="开始合成", command=self.on_generate)
self.generate_btn.pack(side=tk.LEFT, padx=5)
self.play_btn = ttk.Button(btn_frame, text="▶ 从头播放", command=self.on_play, state=tk.DISABLED)
self.play_btn.pack(side=tk.LEFT, padx=5)
self.pause_btn = ttk.Button(btn_frame, text="⏸ 暂停", command=self.on_pause_resume, state=tk.DISABLED)
self.pause_btn.pack(side=tk.LEFT, padx=5)
self.cursor_btn = ttk.Button(btn_frame, text="📍 从光标所在的段读",
command=self.on_play_from_cursor, state=tk.DISABLED)
self.cursor_btn.pack(side=tk.LEFT, padx=5)
self.progress = ttk.Progressbar(btn_frame, mode="indeterminate", length=140)
self.progress.pack(side=tk.LEFT, padx=15)
# 底部:输出路径
out_frame = ttk.Frame(self.root, padding=10)
out_frame.pack(side=tk.BOTTOM, fill=tk.X)
ttk.Label(out_frame, text="保存路径:").pack(side=tk.LEFT)
self.out_path_var = tk.StringVar(value=DEFAULT_OUTPUT)
ttk.Entry(out_frame, textvariable=self.out_path_var, width=55).pack(
side=tk.LEFT, padx=5, fill=tk.X, expand=True)
ttk.Button(out_frame, text="浏览...", command=self.browse_output).pack(side=tk.LEFT)
# 底部:参数区
param_frame = ttk.LabelFrame(self.root, text="合成参数", padding=10)
param_frame.pack(side=tk.BOTTOM, fill=tk.X, padx=10, pady=5)
# 音色 + 语速
row1 = ttk.Frame(param_frame); row1.pack(fill=tk.X, pady=3)
ttk.Label(row1, text="音色:").pack(side=tk.LEFT)
voice_names = list(VOICE_PRESETS.keys())
self.voice_var = tk.StringVar(value=voice_names[0])
self.voice_combo = ttk.Combobox(row1, textvariable=self.voice_var, values=voice_names,
state="readonly", width=22)
self.voice_combo.pack(side=tk.LEFT, padx=5)
ttk.Label(row1, text="语速:").pack(side=tk.LEFT, padx=(20, 5))
self.speed_var = tk.DoubleVar(value=1.0)
ttk.Scale(row1, from_=0.5, to=1.5, variable=self.speed_var, orient=tk.HORIZONTAL, length=160,
command=lambda v: self.speed_label.config(text=f"{float(v):.2f}")).pack(side=tk.LEFT)
self.speed_label = ttk.Label(row1, text="1.00", width=5)
self.speed_label.pack(side=tk.LEFT)
# 情感控制
row2 = ttk.Frame(param_frame); row2.pack(fill=tk.X, pady=3)
ttk.Label(row2, text="情感控制:").pack(side=tk.LEFT)
self.emo_method_var = tk.StringVar(value="无情感控制")
emo_combo = ttk.Combobox(row2, textvariable=self.emo_method_var,
values=list(EMO_METHODS.keys()), state="readonly", width=14)
emo_combo.pack(side=tk.LEFT, padx=5)
emo_combo.bind("<<ComboboxSelected>>", self.on_emo_method_change)
ttk.Label(row2, text="情感强度:").pack(side=tk.LEFT, padx=(20, 5))
self.emo_weight_var = tk.DoubleVar(value=0.6)
ttk.Scale(row2, from_=0.0, to=1.0, variable=self.emo_weight_var, orient=tk.HORIZONTAL, length=160,
command=lambda v: self.emo_w_label.config(text=f"{float(v):.2f}")).pack(side=tk.LEFT)
self.emo_w_label = ttk.Label(row2, text="0.60", width=5)
self.emo_w_label.pack(side=tk.LEFT)
# 情感描述(默认隐藏)
self.emo_text_frame = ttk.Frame(param_frame)
ttk.Label(self.emo_text_frame, text="情感描述:").pack(side=tk.LEFT)
self.emo_text_var = tk.StringVar(value="愉快")
ttk.Entry(self.emo_text_frame, textvariable=self.emo_text_var, width=30).pack(side=tk.LEFT, padx=5)
ttk.Label(self.emo_text_frame, text="如:愉快、悲伤、激动、温柔",
foreground="gray").pack(side=tk.LEFT)
# 中间:文本区
text_frame = ttk.LabelFrame(self.root, text="待合成文本(自动分段,合成后高亮跟随)", padding=10)
text_frame.pack(side=tk.TOP, fill=tk.BOTH, expand=True, padx=10, pady=5)
text_frame.rowconfigure(0, weight=1)
text_frame.columnconfigure(0, weight=1)
text_frame.columnconfigure(1, weight=0)
self.text_input = tk.Text(text_frame, wrap=tk.WORD, font=("Microsoft YaHei", 13), height=10,
padx=12, pady=12, spacing1=4, spacing3=4)
self.text_input.grid(row=0, column=0, sticky="nsew")
text_scroll = ttk.Scrollbar(text_frame, orient=tk.VERTICAL, command=self.text_input.yview)
text_scroll.grid(row=0, column=1, sticky="ns")
self.text_input.config(yscrollcommand=text_scroll.set)
self.text_input.tag_config("highlight", background="#FFE066", foreground="#D9480F")
self.char_count = ttk.Label(text_frame, text="0 字符", foreground="gray")
self.char_count.grid(row=1, column=0, columnspan=2, sticky="e", pady=(4, 0))
self.text_input.bind("<KeyRelease>", self.update_char_count)
default_text = ("春天来了,万物复苏,大地披上了绿色的新装。\n\n"
"桃花、杏花、梨花竞相开放,空气中弥漫着淡淡的花香。\n\n"
"这是充满希望和活力的季节。")
self.text_input.insert("1.0", default_text)
self.update_char_count()
# ---------------- 事件与配置 ----------------
def update_char_count(self, event=None):
n = len(self.text_input.get("1.0", "end-1c"))
self.char_count.config(text=f"{n} 字符")
def on_emo_method_change(self, event=None):
if EMO_METHODS[self.emo_method_var.get()] == 3:
self.emo_text_frame.pack(fill=tk.X, pady=3)
else:
self.emo_text_frame.pack_forget()
def browse_output(self):
path = filedialog.asksaveasfilename(defaultextension=".wav",
filetypes=[("WAV 音频", "*.wav"), ("所有文件", "*.*")],
initialfile="indextts_output.wav")
if path:
self.out_path_var.set(path)
def log(self, msg):
try:
self.root.after(0, lambda m=msg: self._log_ui(m))
except (RuntimeError, tk.TclError):
pass
def _log_ui(self, msg):
self.log_text.config(state=tk.NORMAL)
self.log_text.insert(tk.END, msg + "\n")
self.log_text.see(tk.END)
self.log_text.config(state=tk.DISABLED)
def load_config(self):
try:
if os.path.exists(CONFIG_PATH):
with open(CONFIG_PATH, "r", encoding="utf-8") as f:
cfg = json.load(f)
key = cfg.get("api_key", "").strip()
if key:
self.api_key_var.set(key)
self.status_label.config(text="已加载保存的 API Key,可直接合成。", foreground="green")
self.log("[信息] 已从程序目录加载 API Key。")
except Exception as e:
self.log(f"[警告] 读取配置失败: {e}")
def save_config(self, key=None):
try:
cfg = {}
if os.path.exists(CONFIG_PATH):
with open(CONFIG_PATH, "r", encoding="utf-8") as f:
cfg = json.load(f)
if key is not None:
cfg["api_key"] = key
with open(CONFIG_PATH, "w", encoding="utf-8") as f:
json.dump(cfg, f, ensure_ascii=False, indent=2)
except Exception as e:
self.log(f"[警告] 保存配置失败: {e}")
def clear_saved_key(self):
if os.path.exists(CONFIG_PATH):
try:
os.remove(CONFIG_PATH)
self.log("[信息] 已清除保存的配置。")
except Exception as e:
self.log(f"[警告] 清除配置失败: {e}")
self.api_key_var.set("")
self.status_label.config(text="已清除保存的 Key,请重新输入。", foreground="gray")
# ---------------- 验证 ----------------
def check_api_key(self):
key = self.api_key_var.get().strip()
if not key:
self.status_label.config(text="请先输入 API Key", foreground="red")
return
test_audio = list(VOICE_PRESETS.values())[0]
self.status_label.config(text="正在验证 API Key...", foreground="blue")
self.log("[验证] 正在向服务器发送测试请求...")
def verify():
try:
payload = {"model": MODEL_NAME, "input": "好",
"prompt_audio_url": test_audio, "response_format": "wav"}
resp = requests.post(f"{BASE_URL}/audio/speech", json=payload,
headers={"Authorization": f"Bearer {key}",
"Content-Type": "application/json"},
timeout=30)
if resp.status_code == 200 and len(resp.content) > 0:
self.root.after(0, lambda: self._on_key_valid(key))
elif resp.status_code == 401:
self.root.after(0, lambda: self._on_key_invalid("API Key 无效或已过期"))
else:
snippet = resp.text[:200].replace("\n", " ")
self.root.after(0, lambda s=snippet, c=resp.status_code:
self._on_key_invalid(f"HTTP {c}: {s}"))
except Exception as e:
err = str(e)
self.root.after(0, lambda e=err: self._on_key_invalid(e))
threading.Thread(target=verify, daemon=True).start()
def _on_key_valid(self, key):
self.save_config(key)
self.status_label.config(text="API Key 验证通过,已保存。", foreground="green")
self.log("[成功] API Key 验证通过并已保存。")
def _on_key_invalid(self, reason):
self.status_label.config(text=f"验证失败: {reason}", foreground="red")
self.log(f"[失败] API Key 验证失败: {reason}")
# ---------------- 帮助 ----------------
def show_help(self):
help_text = """IndexTTS-2 语音合成器 - 使用说明
【第一步:获取 API Key】
1. 访问模力方舟 ai.gitee.com
2. 工作台 -> 访问令牌
3. 创建令牌,复制 sk- 开头的字符串
4. 填入本程序顶部,点 [验证 Key]
5. 验证通过后会自动保存,下次打开无需重复输入
【第二步:选择音色】
- 下拉框已预置示例音色,直接选即可
- 不需要上传任何文件
【第三步:情感控制(可选)】
- 无情感控制:默认语气
- 情感文本描述:如"愉快、激动",会拼接到每段
【第四步:输入文本】
- 支持长文本,自动按段落/句号/逗号切分
- 每段不超过 150 字,多段并发合成(最多同时 5 段)
【第五步:合成与播放】
- 点 [开始合成],等待完成
- [▶ 从头播放]:从音频开头播放
- [⏸ 暂停]:暂停 / 继续
- [📍 从光标所在的段读]:
把光标放在文本框任意位置,
程序会找出光标所在的那一段,
然后从该段的起点开始播放。
例如:光标放在第 2 段的任意位置,
就从第 2 段的开头开始读。
【为什么从段首而不是从光标精确位置开始?】
- IndexTTS-2 接口只返回音频,不返回词级时间戳
- 时间轴是段级的,只能精确到段
- 从段首开始,保证你一定能听到想要的那一段
【常见问题】
- 报错 401:API Key 无效
- 报错 402:账户余额不足
- 报错 400 "prompt_audio_url ... is not valid":
音色 URL 失效。这类链接有时效性,需要更换。
如果频繁出现,建议将音频托管到国内平台
(如 Gitee 仓库的 raw 链接),再更新到音色列表。
- 高亮是整段而不是逐字:API 不返回词级时间戳
"""
win = tk.Toplevel(self.root)
win.title(f"使用说明 - {VERSION}")
win.geometry("700x640")
win.transient(self.root)
frm = ttk.Frame(win); frm.pack(fill=tk.BOTH, expand=True, padx=10, pady=10)
frm.rowconfigure(0, weight=1); frm.columnconfigure(0, weight=1)
text = tk.Text(frm, wrap=tk.WORD, font=("Microsoft YaHei", 11),
padx=15, pady=15, spacing1=3, spacing3=3)
text.grid(row=0, column=0, sticky="nsew")
scroll = ttk.Scrollbar(frm, orient=tk.VERTICAL, command=text.yview)
scroll.grid(row=0, column=1, sticky="ns")
text.config(yscrollcommand=scroll.set)
text.insert("1.0", help_text)
text.config(state=tk.DISABLED)
ttk.Button(win, text="关闭", command=win.destroy).pack(pady=10)
win.bind("<Escape>", lambda e: win.destroy())
# ---------------- 合成 ----------------
def _post_with_retry(self, url, payload, headers, timeout=180):
delay = RETRY_BASE_DELAY
last_err = None
for attempt in range(MAX_RETRIES):
try:
resp = requests.post(url, json=payload, headers=headers, timeout=timeout)
if resp.status_code == 200:
return resp
if resp.status_code == 429 or resp.status_code >= 500:
last_err = f"HTTP {resp.status_code}: {resp.text[:150]}"
self.log(f"[重试] 第 {attempt + 1} 次失败,{delay:.1f}s 后重试")
time.sleep(delay); delay *= 2; continue
return resp
except requests.RequestException as e:
last_err = str(e)
self.log(f"[重试] {attempt + 1}/{MAX_RETRIES} 异常,{delay:.1f}s 后重试")
time.sleep(delay); delay *= 2
raise RuntimeError(f"请求失败(已重试 {MAX_RETRIES} 次): {last_err}")
def on_generate(self):
api_key = self.api_key_var.get().strip()
if not api_key:
messagebox.showerror("错误", "请先输入 API Key!")
return
text = self.text_input.get("1.0", "end-1c").strip()
if not text:
messagebox.showwarning("提示", "请输入需要合成的文本。")
return
voice_name = self.voice_var.get()
prompt_audio = VOICE_PRESETS.get(voice_name)
if not prompt_audio:
messagebox.showerror("错误", f"音色 '{voice_name}' 没有对应的音频。")
return
self.save_config()
self.is_playing = False
self.is_paused = False
self.highlight_idx = -1
self.generate_btn.config(state=tk.DISABLED)
self.play_btn.config(state=tk.DISABLED)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.DISABLED)
self.progress.start(10)
self.log(f"[开始] 文本长度: {len(text)} 字符,音色: {voice_name}")
self.status_label.config(text="正在合成...", foreground="blue")
threading.Thread(target=self.synthesize,
args=(text, api_key, prompt_audio), daemon=True).start()
def synthesize(self, text, api_key, prompt_audio):
temp_dir = None
try:
out_path = self.out_path_var.get()
emo_method = EMO_METHODS[self.emo_method_var.get()]
emo_weight = round(self.emo_weight_var.get(), 2)
emo_text = self.emo_text_var.get().strip() if emo_method == 3 else ""
speed = round(self.speed_var.get(), 2)
segments = split_text_smart(text, MAX_SEG_LEN)
self.log(f"[切分] 共 {len(text)} 字符,切分为 {len(segments)} 段")
temp_dir = tempfile.mkdtemp(prefix="indextts_")
headers = {"Authorization": f"Bearer {api_key}",
"Content-Type": "application/json"}
def synth_one(i, seg):
payload = {"model": MODEL_NAME, "input": seg,
"prompt_audio_url": prompt_audio,
"response_format": "wav", "speed": speed}
if emo_method > 0:
payload["emo_control_method"] = emo_method
payload["emo_weight"] = emo_weight
if emo_method == 3:
payload["emo_text"] = emo_text
resp = self._post_with_retry(f"{BASE_URL}/audio/speech", payload, headers)
if resp.status_code != 200:
raise RuntimeError(f"第 {i + 1} 段失败: HTTP {resp.status_code} {resp.text[:200]}")
seg_path = os.path.join(temp_dir, f"seg_{i:04d}.wav")
with open(seg_path, "wb") as f:
f.write(resp.content)
return i, seg_path
temp_wavs = [None] * len(segments)
max_workers = min(MAX_CONCURRENT, len(segments))
self.log(f"[并发] 同时请求 {max_workers} 段...")
with ThreadPoolExecutor(max_workers=max_workers) as executor:
futures = {executor.submit(synth_one, i, seg): i
for i, (seg, a, b) in enumerate(segments)}
completed = 0
for fut in as_completed(futures):
try:
i, seg_path = fut.result()
temp_wavs[i] = seg_path
completed += 1
self.log(f"[进度] {completed}/{len(segments)} 段已完成")
except Exception as e:
raise RuntimeError(f"合成中断: {e}")
self.log("[拼接] 正在拼接音频...")
combined_wav = os.path.join(temp_dir, "combined.wav")
durations = concat_wavs(temp_wavs, combined_wav)
self.timeline = []
self.timeline_starts = []
t_cursor = 0.0
for (seg, a, b), dur in zip(segments, durations):
self.timeline.append((t_cursor * 1000, (t_cursor + dur) * 1000, a, b))
self.timeline_starts.append(t_cursor * 1000)
t_cursor += dur
self.log(f"[时间轴] 共 {len(self.timeline)} 段,总时长 {t_cursor:.2f} 秒")
shutil.copy(combined_wav, out_path)
self.current_audio_path = out_path
self.root.after(0, lambda p=out_path: self.on_synth_success(p))
except Exception as e:
err = str(e)
self.root.after(0, lambda e=err: self.on_error(e))
finally:
if temp_dir and os.path.exists(temp_dir):
shutil.rmtree(temp_dir, ignore_errors=True)
def on_synth_success(self, path):
self.progress.stop()
self.generate_btn.config(state=tk.NORMAL)
self.play_btn.config(state=tk.NORMAL if self._play_available else tk.DISABLED)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.NORMAL if self._play_available else tk.DISABLED)
self.is_playing = False; self.is_paused = False; self.highlight_idx = -1
self.status_label.config(text="合成完成,可播放并高亮", foreground="green")
self.log(f"[完成] 音频已保存: {path}")
def on_error(self, err):
self.progress.stop()
self.generate_btn.config(state=tk.NORMAL)
self.status_label.config(text="合成失败", foreground="red")
self.log(f"[错误] {err}")
messagebox.showerror("合成失败", err)
# ---------------- 播放 ----------------
def _unload_audio(self):
if not self.pygame: return
try: self.pygame.mixer.music.stop()
except Exception: pass
try: self.pygame.mixer.music.unload()
except Exception: pass
def _extract_wav_from(self, src_path, dst_path, start_ms):
"""把 src_path 从 start_ms 毫秒处截到结尾,存为 dst_path。"""
with wave.open(src_path, "rb") as src:
params = src.getparams()
framerate = params.framerate
start_frame = int(start_ms * framerate / 1000)
if start_frame >= params.nframes:
start_frame = max(0, params.nframes - 1)
src.setpos(start_frame)
frames = src.readframes(params.nframes - start_frame)
with wave.open(dst_path, "wb") as dst:
dst.setparams(params)
dst.writeframes(frames)
def on_play(self):
if not self.current_audio_path or not os.path.exists(self.current_audio_path):
messagebox.showwarning("提示", "请先合成音频。"); return
if not self._play_available:
messagebox.showerror("错误", "未安装 pygame。"); return
self._start_playback(0)
def on_play_from_cursor(self):
"""从光标所在的段读:找出光标所在的段,从该段起点开始播放。"""
if not self.current_audio_path or not os.path.exists(self.current_audio_path):
messagebox.showwarning("提示", "请先合成音频。"); return
if not self.timeline:
messagebox.showwarning("提示", "时间轴为空。"); return
try:
cursor_index = self.text_input.index(tk.INSERT)
cursor_char = len(self.text_input.get("1.0", cursor_index))
except Exception:
cursor_char = 0
idx = len(self.timeline) - 1
for i, (t0, t1, a, b) in enumerate(self.timeline):
if cursor_char < b:
idx = i
break
# 就近原则:如果离下一段起点比离当前段末尾更近,跳到下一段
if idx + 1 < len(self.timeline):
_, _, cur_a, cur_b = self.timeline[idx]
next_a = self.timeline[idx + 1][2]
dist_cur = cur_b - cursor_char
dist_next = next_a - cursor_char
if dist_next < dist_cur:
self.log(f"[定位] 光标字符 {cursor_char} 距段 {idx+1} 末尾 {dist_cur},"
f"距段 {idx+2} 起点 {dist_next},跳到段 {idx+2}")
idx += 1
else:
self.log(f"[定位] 光标字符 {cursor_char} 落在段 {idx+1}"
f"(字符 {cur_a}-{cur_b}),从段首开始读")
else:
self.log(f"[定位] 光标字符 {cursor_char} 落在段 {idx+1},从段首开始读")
start_ms = self.timeline[idx][0]
self._start_playback(start_ms)
def _start_playback(self, start_ms):
"""从 start_ms 毫秒处开始播放。"""
self.is_playing = False
self.is_paused = False
try: self.pygame.mixer.music.stop()
except Exception: pass
try: self.pygame.mixer.music.unload()
except Exception: pass
if self._playing_clip_path and os.path.exists(self._playing_clip_path):
try: os.remove(self._playing_clip_path)
except Exception: pass
self._playing_clip_path = None
try:
if start_ms > 0:
self.log(f"[播放] 从 {start_ms:.0f} ms 处截取音频片段...")
self._extract_wav_from(self.current_audio_path, CLIP_PATH, start_ms)
self.pygame.mixer.music.load(CLIP_PATH)
self.pygame.mixer.music.play()
self._playing_clip_path = CLIP_PATH
self.play_offset_ms = start_ms
else:
self.pygame.mixer.music.load(self.current_audio_path)
self.pygame.mixer.music.play()
self._playing_clip_path = None
self.play_offset_ms = 0
except Exception as e:
messagebox.showerror("播放错误", str(e))
return
self.is_playing = True
self.is_paused = False
self.highlight_idx = -1
self._play_started_at = time.monotonic()
self._not_busy_count = 0
self.play_btn.config(state=tk.DISABLED); self.cursor_btn.config(state=tk.DISABLED)
self.pause_btn.config(state=tk.NORMAL, text="⏸ 暂停")
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.status_label.config(text="播放中...", foreground="green")
self.sync_loop()
def on_pause_resume(self):
if not self.pygame: return
if self.is_paused:
try: self.pygame.mixer.music.unpause()
except Exception as e: messagebox.showerror("错误", str(e)); return
self.is_paused = False; self.is_playing = True
self.pause_btn.config(text="⏸ 暂停")
self.status_label.config(text="播放中...", foreground="green")
self.sync_loop()
elif self.is_playing:
try: self.pygame.mixer.music.pause()
except Exception as e: messagebox.showerror("错误", str(e)); return
self.is_paused = True; self.is_playing = False
self.pause_btn.config(text="▶ 继续")
self.status_label.config(text="已暂停", foreground="gray")
def sync_loop(self):
if not self.is_playing:
return
busy = self.pygame.mixer.music.get_busy()
if busy:
self._not_busy_count = 0
pos = max(self.pygame.mixer.music.get_pos(), 0)
self.update_highlight(pos + self.play_offset_ms)
self.root.after(POLL_MS, self.sync_loop)
else:
elapsed_ms = (time.monotonic() - self._play_started_at) * 1000
if elapsed_ms < PLAY_START_GRACE_MS:
self.root.after(POLL_MS, self.sync_loop)
return
self._not_busy_count += 1
if self._not_busy_count >= END_CONFIRM_COUNT:
self.on_playback_finished()
else:
self.root.after(POLL_MS, self.sync_loop)
def update_highlight(self, ms):
if not self.timeline_starts: return
idx = bisect.bisect_right(self.timeline_starts, ms) - 1
if idx < 0 or idx >= len(self.timeline): return
t0, t1, a, b = self.timeline[idx]
if not (t0 <= ms < t1): return
if idx == self.highlight_idx: return
if b <= a: return
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.text_input.tag_add("highlight", f"1.0+{a}c", f"1.0+{b}c")
self.text_input.see(f"1.0+{a}c")
self.highlight_idx = idx
def on_playback_finished(self):
self.is_playing = False; self.is_paused = False; self.play_offset_ms = 0
self._unload_audio()
if self._playing_clip_path and os.path.exists(self._playing_clip_path):
try: os.remove(self._playing_clip_path)
except Exception: pass
self._playing_clip_path = None
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.play_btn.config(state=tk.NORMAL if self.current_audio_path else tk.DISABLED)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.NORMAL if self.current_audio_path else tk.DISABLED)
self.status_label.config(text="播放结束", foreground="gray")
self.log("[播放] 已结束")
if __name__ == "__main__":
root = tk.Tk()
app = IndexTTSApp(root)
root.mainloop()阿里云 CosyVoice
CosyVoice2 是由阿里巴巴通义实验室(SpeechLab@Tongyi)的语音团队开发并推出的。
它是该团队在2024年7月开源的 CosyVoice 模型的全面升级版本,于2024年12月正式发布。**内置少样本语音克隆**,情感丰富,可控韵律。广泛用于数字人、短视频配音、智能客服。CosyVoice2 在低延迟、高准确度和音色克隆稳定性上都有显著提升。
官方资源
你可以在以下官方渠道找到 CosyVoice2 的代码、模型和演示:
· GitHub 仓库:https://github.com/FunAudioLLM/CosyVoice
· 在线体验 Demo:https://www.modelscope.cn/studios/iic/CosyVoice2-0.5B
· 开源模型:https://www.modelscope.cn/models/iic/CosyVoice2-0.5B
下面给出python实现的完整示例。
使用硅基流动 cloud.siliconflow.cn的
CosyVoice2 的API 密钥
示例运行截图:
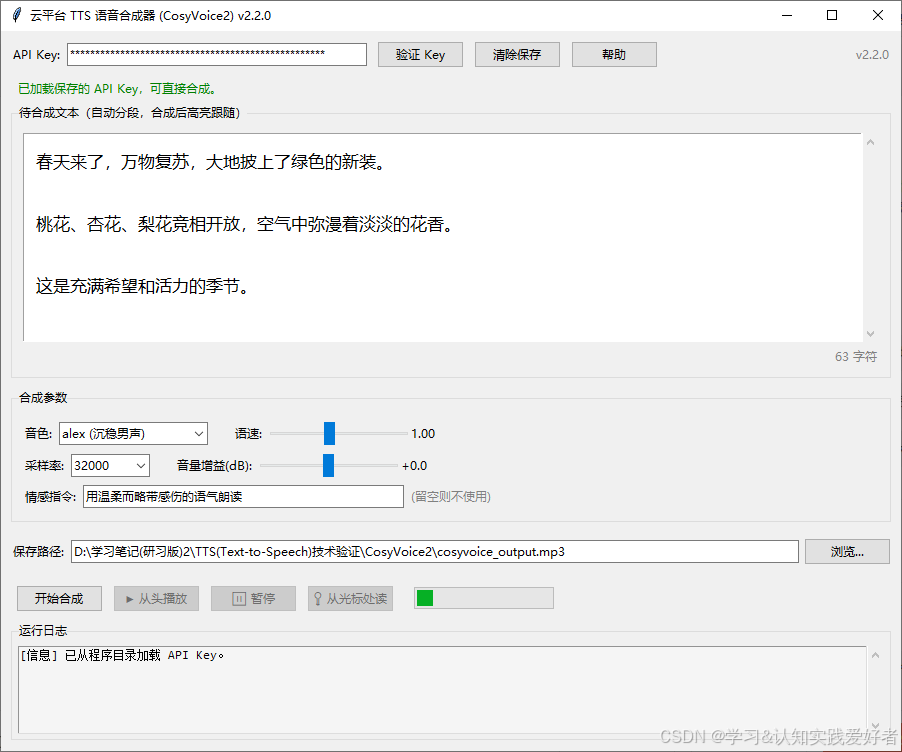
安装依赖
pip install openai pygame
示例源码如下:
python
"""
云平台 TTS 语音合成器 (GUI) v2.2.0
------------------------------------------------
- 默认模型:CosyVoice2 (硅基流动)
- 输出:程序同级目录下的 cosyvoice_output.mp3
- 配置:程序同级目录下的 .tts_gui_config.json
- 高亮:按段落跟随(因 API 不返回词级时间戳)
------------------------------------------------
"""
import os
import re
import json
import shutil
import subprocess
import tempfile
import threading
import time
import bisect
import tkinter as tk
import wave
from tkinter import ttk, messagebox, filedialog
import requests
try:
import pygame
except ImportError:
pygame = None
# ==================== 配置 ====================
VERSION = "v2.2.0"
BASE_URL = "https://api.siliconflow.cn/v1"
MODEL_NAME = "FunAudioLLM/CosyVoice2-0.5B"
VOICE_DISPLAY_NAMES = [
"alex (沉稳男声)", "benjamin (低沉男声)", "charles (磁性男声)", "david (欢快男声)",
"anna (沉稳女声)", "bella (激情女声)", "claire (温柔女声)", "diana (欢快女声)"
]
VOICE_API_NAMES = {
"alex (沉稳男声)": "FunAudioLLM/CosyVoice2-0.5B:alex",
"benjamin (低沉男声)": "FunAudioLLM/CosyVoice2-0.5B:benjamin",
"charles (磁性男声)": "FunAudioLLM/CosyVoice2-0.5B:charles",
"david (欢快男声)": "FunAudioLLM/CosyVoice2-0.5B:david",
"anna (沉稳女声)": "FunAudioLLM/CosyVoice2-0.5B:anna",
"bella (激情女声)": "FunAudioLLM/CosyVoice2-0.5B:bella",
"claire (温柔女声)": "FunAudioLLM/CosyVoice2-0.5B:claire",
"diana (欢快女声)": "FunAudioLLM/CosyVoice2-0.5B:diana",
}
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
DEFAULT_OUTPUT = os.path.join(SCRIPT_DIR, "cosyvoice_output.mp3")
CONFIG_PATH = os.path.join(SCRIPT_DIR, ".tts_gui_config.json")
MAX_SEG_LEN = 150
POLL_MS = 50
MAX_RETRIES = 3
RETRY_BASE_DELAY = 1.0
# ==================== 帮助内容 ====================
HELP_QUICKSTART = """# 快速开始
## 1. 获取 API Key
- 登录硅基流动 cloud.siliconflow.cn
- 进入「API 密钥」页面创建密钥
- 复制以 sk- 开头的字符串
## 2. 填入并验证
- 把 API Key 粘贴到顶部输入框
- 点击 [验证 Key],程序会向服务器发一次真实请求
- 验证通过后 Key 自动保存到程序目录下的
.tts_gui_config.json
- 下次打开程序会自动加载,无需重复输入
- 如需清除,点击 [清除保存]
## 3. 输入文本
- 在文本框中粘贴或输入要朗读的内容
- 长度不限:程序会自动按段落、句号、逗号
逐级切分,每段不超过 150 字,逐段合成后拼接
## 4. 设置情感指令(可选)
- 例如「用温柔而略带感伤的语气朗读」
- 留空则使用模型默认语气
- 指令会自动拼接 <|endofprompt|> 分隔符
## 5. 开始合成
- 点击 [开始合成]
- 状态栏显示「正在合成」,日志区打印每段进度
- 合成完成后,播放和定位按钮会自动启用
## 6. 播放与高亮
- [▶ 从头播放]:从开头播放,同时高亮对应段落
- [⏸ 暂停]:暂停,按钮变为 [▶ 继续]
- [📍 从光标处读]:从光标所在段落起点播放
"""
HELP_PARAMS = """# 参数说明
## 音色
- 共 8 种预置音色,4 男 4 女
- 男声:alex(沉稳)、benjamin(低沉)、
charles(磁性)、david(欢快)
- 女声:anna(沉稳)、bella(激情)、
claire(温柔)、diana(欢快)
- 朗读诗歌散文推荐 claire(温柔)
或 bella(激情)
## 语速
- 范围 0.25 ~ 2.0,1.0 为正常
- 诗歌建议 0.85 ~ 1.0,节奏更舒缓
- 散文建议 0.9 ~ 1.1
## 采样率
- MP3 输出只支持 32000 和 44100 Hz
- 32000 更省流量,44100 兼容性更好
- 推荐保持 32000
## 音量增益(dB)
- 范围 -10.0 ~ +10.0 分贝
- 0.0 表示不改变原始音量
- 负值降低音量,正值提高音量
- 单位是分贝,不是倍率
## 情感指令
- 用自然语言描述想要的语气
- 会自动拼接在每段文本前面
- 例如:
- 用温柔而略带感伤的语气朗读
- 用充满激情和力量的声音朗读
- 用像是在耳边低语的声音朗读
- 留空则不加任何指令
## 保存路径
- 默认保存在程序所在目录
文件名 cosyvoice_output.mp3
- 点 [浏览...] 可修改为其他位置
- 如果文件名后缀是 .wav,则直接保存 WAV
## 关于重复计费
- 情感指令会拼接到每一段
- 因此按字节计费时会略有上浮
- 例如 13 字指令分 20 段,约多 8.7% 开销
"""
HELP_OPERATIONS = """# 操作说明
## 合成流程
点 [开始合成] 后,程序会依次:
1. 把文本按段落、句号、逗号逐级切分
每段不超过 150 字
2. 逐段向服务器请求 WAV 音频
3. 把所有片段拼接为一个 WAV 文件
4. 用 ffmpeg 转换为 MP3
如果没装 ffmpeg,则保留 WAV
## 播放控制
- [▶ 从头播放]:从音频开头播放
- [⏸ 暂停]:暂停,按钮文字变 [▶ 继续]
- [▶ 继续]:从暂停位置恢复
- [📍 从光标处读]:光标放在文本框任意位置,
点击后从光标所在段落的起点开始播放
## 高亮规则
- 高亮按「段」进行,整段以黄色背景显示
- 原因:CosyVoice2 API 只返回音频,
不返回词级时间戳,无法精确到字
- 文本框会自动滚动到当前段落
## 键盘快捷键
- Ctrl+A 全选文本
- Ctrl+C / V 复制 / 粘贴
- Ctrl+Z 撤销
- Esc 关闭帮助窗口
## 关闭程序
- 直接关闭窗口即可
- 会自动停止播放、释放音频句柄
- 合成中的临时文件也会自动清理
"""
HELP_FAQ = """# 常见问题
## Q: 为什么合成到一半就停了?
- 原因:单段文本超过模型长度限制
- 本程序已自动切分,每段不超过 150 字
- 如果仍失败,查看日志区的具体错误
- v2.0.0 起自动重试 429 和 5xx 错误 3 次
## Q: 为什么高亮是整段而不是逐字?
- CosyVoice2 的 API 只返回音频,不返回词级
时间戳(不像 edge-tts 会返回 WordBoundary)
- 没有时间戳只能按段时长估算
- 逐字高亮会因标点停顿导致明显偏差
- 因此选择按段高亮,视觉上最稳定
## Q: API Key 验证失败怎么办?
- 检查是否复制完整:sk- 开头,无多余空格
- 检查账户余额是否充足
- 检查网络是否正常
- 错误信息 401:Key 无效或已过期
- 错误信息 402:账户余额不足
## Q: MP3 转换失败?
- 需要安装 ffmpeg 并添加到 PATH
- Windows 用户可从 ffmpeg.org 下载
- 下载后把 bin 目录加入系统环境变量 PATH
- 如果不想装 ffmpeg,程序会自动保留 WAV 文件
## Q: 黑窗口一闪是什么?
- 是 ffmpeg 子进程的控制台窗口
- v2.1.0 起已使用隐藏窗口模式,不再闪现
- 如果还有闪现,说明你在使用旧版本
## Q: 播放中合成会报错?
- v2.0.0 起已修复此问题
- 程序会在合成前自动释放文件句柄
- 如果仍遇到 PermissionError
先点 [⏸ 暂停] 再点 [开始合成]
## Q: 如何清除保存的 API Key?
- 点击顶部的 [清除保存] 按钮
- 或手动删除程序目录下的
.tts_gui_config.json 文件
## Q: 合成的音频能商用吗?
- CosyVoice2 模型本身是 Apache 2.0 协议
- 但通过 API 生成的内容请参考
硅基流动平台的服务条款
## Q: 为什么不返回词级时间戳?
- 这是 CosyVoice2 模型本身的限制
- 如果需要词级对齐,可以:
1. 换用 edge-tts(免费,有 WordBoundary)
2. 用 Whisper 等强制对齐工具后处理
3. 换用支持时间戳的云平台(如 Azure)
"""
# ==================== 文本切分 ====================
def _split_recursive(s, start, max_len):
if not s:
return []
if len(s) <= max_len:
return [(s, start, start + len(s))]
parts = re.split(r'(?<=[。!?!?])', s)
if len(parts) > 1:
result, offset = [], start
for p in parts:
if p:
result.extend(_split_recursive(p, offset, max_len))
offset += len(p)
return result
parts = re.split(r'(?<=[,,;;、])', s)
if len(parts) > 1:
result, offset = [], start
for p in parts:
if p:
result.extend(_split_recursive(p, offset, max_len))
offset += len(p)
return result
return [(s[i:i + max_len], start + i, start + i + min(max_len, len(s) - i))
for i in range(0, len(s), max_len)]
def split_text_smart(text, max_len=MAX_SEG_LEN):
segments = []
pos = 0
for part in re.split(r'(\n\s*\n)', text):
if not part:
continue
if re.fullmatch(r'\n\s*\n', part):
pos += len(part)
continue
segments.extend(_split_recursive(part, pos, max_len))
pos += len(part)
return segments
# ==================== WAV 拼接 ====================
def concat_wavs(input_paths, output_path):
durations = []
with wave.open(output_path, "wb") as out:
with wave.open(input_paths[0], "rb") as first:
p = first.getparams()
out.setparams(p)
framerate, sampwidth, nchannels = p.framerate, p.sampwidth, p.nchannels
data = first.readframes(first.getnframes())
out.writeframes(data)
durations.append(len(data) / sampwidth / nchannels / framerate)
for path in input_paths[1:]:
with wave.open(path, "rb") as w:
wp = w.getparams()
if (wp.sampwidth != sampwidth or
wp.nchannels != nchannels or
wp.framerate != framerate):
raise RuntimeError(f"WAV 参数不匹配: {os.path.basename(path)}")
data = w.readframes(w.getnframes())
out.writeframes(data)
durations.append(len(data) / sampwidth / nchannels / framerate)
return durations
# ==================== ffmpeg 转换(隐藏黑窗口) ====================
def convert_wav_to_mp3(wav_path, mp3_path):
ffmpeg = shutil.which("ffmpeg")
if not ffmpeg:
raise FileNotFoundError("未找到 ffmpeg,请安装并加入 PATH")
cmd = [ffmpeg, "-y", "-loglevel", "error", "-i", wav_path,
"-codec:a", "libmp3lame", "-qscale:a", "4", mp3_path]
kwargs = {"capture_output": True}
if os.name == "nt":
si = subprocess.STARTUPINFO()
si.dwFlags |= subprocess.STARTF_USESHOWWINDOW
si.wShowWindow = subprocess.SW_HIDE
kwargs["startupinfo"] = si
if hasattr(subprocess, "CREATE_NO_WINDOW"):
kwargs["creationflags"] = subprocess.CREATE_NO_WINDOW
try:
proc = subprocess.run(cmd, **kwargs)
except Exception as e:
raise RuntimeError(f"ffmpeg 调用失败: {e}")
if proc.returncode != 0:
err = (proc.stderr or b"").decode("utf-8", errors="replace")[:300]
raise RuntimeError(f"ffmpeg 转换失败: {err}")
# ==================== 主程序 ====================
class TTSApp:
def __init__(self, root):
self.root = root
self.root.title(f"云平台 TTS 语音合成器 (CosyVoice2) {VERSION}")
# 自适应窗口大小并居中
screen_w = self.root.winfo_screenwidth()
screen_h = self.root.winfo_screenheight()
win_w = min(900, screen_w - 80)
win_h = min(720, screen_h - 120)
win_x = max(0, (screen_w - win_w) // 2)
win_y = max(0, (screen_h - win_h) // 2 - 20)
self.root.geometry(f"{win_w}x{win_h}+{win_x}+{win_y}")
self.root.minsize(720, 560)
# 播放状态
self.is_playing = False
self.is_paused = False
self.play_offset_ms = 0
self.timeline = []
self.timeline_starts = []
self.highlight_idx = -1
self.current_audio_path = None
self._help_window = None
if pygame:
try:
pygame.mixer.init()
except Exception as e:
print(f"pygame 初始化失败: {e}")
self.build_ui()
self.load_api_key()
# ---------------- 布局 ----------------
def build_ui(self):
# ========== 顶部固定区 ==========
api_frame = ttk.Frame(self.root, padding=10)
api_frame.pack(side=tk.TOP, fill=tk.X)
ttk.Label(api_frame, text="API Key:").pack(side=tk.LEFT)
self.api_key_entry = ttk.Entry(api_frame, width=42, show="*")
self.api_key_entry.pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="验证 Key", command=self.check_api_key).pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="清除保存", command=self.clear_saved_key).pack(side=tk.LEFT, padx=5)
ttk.Button(api_frame, text="帮助", command=self.show_help).pack(side=tk.LEFT, padx=5)
ttk.Label(api_frame, text=VERSION, foreground="gray").pack(side=tk.RIGHT)
self.status_label = ttk.Label(self.root, text="请粘贴 API Key 并点击[验证 Key]", foreground="gray")
self.status_label.pack(side=tk.TOP, fill=tk.X, padx=15)
# ========== 底部固定区:从下往上 pack ==========
# 日志区(最底)
log_frame = ttk.LabelFrame(self.root, text="运行日志", padding=5)
log_frame.pack(side=tk.BOTTOM, fill=tk.X, padx=10, pady=(0, 10))
log_frame.rowconfigure(0, weight=1)
log_frame.columnconfigure(0, weight=1)
self.log_text = tk.Text(log_frame, height=6, font=("Consolas", 9),
state=tk.DISABLED, bg="#f5f5f5")
self.log_text.grid(row=0, column=0, sticky="nsew")
log_scroll = ttk.Scrollbar(log_frame, orient=tk.VERTICAL, command=self.log_text.yview)
log_scroll.grid(row=0, column=1, sticky="ns")
self.log_text.config(yscrollcommand=log_scroll.set)
# 按钮区
btn_frame = ttk.Frame(self.root, padding=10)
btn_frame.pack(side=tk.BOTTOM, fill=tk.X)
self.generate_btn = ttk.Button(btn_frame, text="开始合成", command=self.on_generate)
self.generate_btn.pack(side=tk.LEFT, padx=5)
self.play_btn = ttk.Button(btn_frame, text="▶ 从头播放",
command=self.on_play, state=tk.DISABLED)
self.play_btn.pack(side=tk.LEFT, padx=5)
self.pause_btn = ttk.Button(btn_frame, text="⏸ 暂停",
command=self.on_pause_resume, state=tk.DISABLED)
self.pause_btn.pack(side=tk.LEFT, padx=5)
self.cursor_btn = ttk.Button(btn_frame, text="📍 从光标处读",
command=self.on_play_from_cursor, state=tk.DISABLED)
self.cursor_btn.pack(side=tk.LEFT, padx=5)
self.progress = ttk.Progressbar(btn_frame, mode="indeterminate", length=140)
self.progress.pack(side=tk.LEFT, padx=15)
# 输出路径区
out_frame = ttk.Frame(self.root, padding=10)
out_frame.pack(side=tk.BOTTOM, fill=tk.X)
ttk.Label(out_frame, text="保存路径:").pack(side=tk.LEFT)
self.out_path_var = tk.StringVar(value=DEFAULT_OUTPUT)
ttk.Entry(out_frame, textvariable=self.out_path_var, width=55).pack(
side=tk.LEFT, padx=5, fill=tk.X, expand=True)
ttk.Button(out_frame, text="浏览...", command=self.browse_output).pack(side=tk.LEFT)
# 参数区
param_frame = ttk.LabelFrame(self.root, text="合成参数", padding=10)
param_frame.pack(side=tk.BOTTOM, fill=tk.X, padx=10, pady=5)
row1 = ttk.Frame(param_frame); row1.pack(fill=tk.X, pady=3)
ttk.Label(row1, text="音色:").pack(side=tk.LEFT)
self.voice_var = tk.StringVar(value=VOICE_DISPLAY_NAMES[0])
ttk.Combobox(row1, textvariable=self.voice_var, values=VOICE_DISPLAY_NAMES,
state="readonly", width=18).pack(side=tk.LEFT, padx=5)
ttk.Label(row1, text="语速:").pack(side=tk.LEFT, padx=(20, 5))
self.speed_var = tk.DoubleVar(value=1.0)
ttk.Scale(row1, from_=0.25, to=2.0, variable=self.speed_var, orient=tk.HORIZONTAL, length=140,
command=lambda v: self.speed_label.config(text=f"{float(v):.2f}")).pack(side=tk.LEFT)
self.speed_label = ttk.Label(row1, text="1.00", width=5)
self.speed_label.pack(side=tk.LEFT)
row2 = ttk.Frame(param_frame); row2.pack(fill=tk.X, pady=3)
ttk.Label(row2, text="采样率:").pack(side=tk.LEFT)
self.sr_var = tk.StringVar(value="32000")
ttk.Combobox(row2, textvariable=self.sr_var, values=["32000", "44100"],
state="readonly", width=8).pack(side=tk.LEFT, padx=5)
ttk.Label(row2, text="音量增益(dB):").pack(side=tk.LEFT, padx=(20, 5))
self.gain_var = tk.DoubleVar(value=0.0)
ttk.Scale(row2, from_=-10.0, to=10.0, variable=self.gain_var, orient=tk.HORIZONTAL, length=140,
command=lambda v: self.gain_label.config(text=f"{float(v):+.1f}")).pack(side=tk.LEFT)
self.gain_label = ttk.Label(row2, text="+0.0", width=6)
self.gain_label.pack(side=tk.LEFT)
row3 = ttk.Frame(param_frame); row3.pack(fill=tk.X, pady=3)
ttk.Label(row3, text="情感指令:").pack(side=tk.LEFT)
self.emo_text_var = tk.StringVar(value="用温柔而略带感伤的语气朗读")
ttk.Entry(row3, textvariable=self.emo_text_var, width=45).pack(side=tk.LEFT, padx=5)
ttk.Label(row3, text="(留空则不使用)", foreground="gray").pack(side=tk.LEFT)
# ========== 中间弹性区:最后 pack ==========
text_frame = ttk.LabelFrame(self.root, text="待合成文本(自动分段,合成后高亮跟随)", padding=10)
text_frame.pack(side=tk.TOP, fill=tk.BOTH, expand=True, padx=10, pady=5)
text_frame.rowconfigure(0, weight=1)
text_frame.columnconfigure(0, weight=1)
text_frame.columnconfigure(1, weight=0)
self.text_input = tk.Text(
text_frame, wrap=tk.WORD, font=("Microsoft YaHei", 13),
height=10, padx=12, pady=12, spacing1=4, spacing3=4
)
self.text_input.grid(row=0, column=0, sticky="nsew")
text_scroll = ttk.Scrollbar(text_frame, orient=tk.VERTICAL, command=self.text_input.yview)
text_scroll.grid(row=0, column=1, sticky="ns")
self.text_input.config(yscrollcommand=text_scroll.set)
self.text_input.tag_config("highlight", background="#FFE066", foreground="#D9480F")
self.char_count = ttk.Label(text_frame, text="0 字符", foreground="gray")
self.char_count.grid(row=1, column=0, columnspan=2, sticky="e", pady=(4, 0))
self.text_input.bind("<KeyRelease>", self.update_char_count)
default_text = (
"春天来了,万物复苏,大地披上了绿色的新装。\n\n"
"桃花、杏花、梨花竞相开放,空气中弥漫着淡淡的花香。\n\n"
"这是充满希望和活力的季节。"
)
self.text_input.insert("1.0", default_text)
self.update_char_count()
# ---------------- 帮助 ----------------
def show_help(self):
# 已打开则前置
if self._help_window is not None and self._help_window.winfo_exists():
self._help_window.lift()
self._help_window.focus_force()
return
win = tk.Toplevel(self.root)
self._help_window = win
win.title(f"使用说明 - {VERSION}")
win.geometry("780x600")
win.minsize(620, 460)
win.transient(self.root)
# 居中于主窗口
self.root.update_idletasks()
px, py = self.root.winfo_x(), self.root.winfo_y()
pw, ph = self.root.winfo_width(), self.root.winfo_height()
w, h = 780, 600
win.geometry(f"{w}x{h}+{px + (pw - w) // 2}+{py + (ph - h) // 2}")
notebook = ttk.Notebook(win)
notebook.pack(fill=tk.BOTH, expand=True, padx=10, pady=(10, 0))
self._add_help_tab(notebook, "快速开始", HELP_QUICKSTART)
self._add_help_tab(notebook, "参数说明", HELP_PARAMS)
self._add_help_tab(notebook, "操作说明", HELP_OPERATIONS)
self._add_help_tab(notebook, "常见问题", HELP_FAQ)
btn_frame = ttk.Frame(win, padding=10)
btn_frame.pack(fill=tk.X)
ttk.Button(btn_frame, text="关闭", command=win.destroy).pack(side=tk.RIGHT)
win.bind("<Escape>", lambda e: win.destroy())
def _add_help_tab(self, notebook, title, content):
frame = ttk.Frame(notebook, padding=10)
notebook.add(frame, text=title)
frame.rowconfigure(0, weight=1)
frame.columnconfigure(0, weight=1)
text = tk.Text(
frame, wrap=tk.WORD, font=("Microsoft YaHei", 11),
padx=14, pady=14, spacing1=3, spacing3=3,
bg="#fafafa", relief=tk.FLAT, borderwidth=0,
)
text.grid(row=0, column=0, sticky="nsew")
scrollbar = ttk.Scrollbar(frame, orient=tk.VERTICAL, command=text.yview)
scrollbar.grid(row=0, column=1, sticky="ns")
text.config(yscrollcommand=scrollbar.set)
# 简单标记渲染
text.tag_config("h1", font=("Microsoft YaHei", 15, "bold"),
foreground="#1a5490", spacing1=6, spacing3=10)
text.tag_config("h2", font=("Microsoft YaHei", 12, "bold"),
foreground="#2c3e50", spacing1=12, spacing3=4)
text.tag_config("bullet", font=("Microsoft YaHei", 11),
lmargin1=20, lmargin2=36)
text.tag_config("plain", font=("Microsoft YaHei", 11))
for line in content.split("\n"):
if line.startswith("# "):
text.insert(tk.END, line[2:] + "\n", "h1")
elif line.startswith("## "):
text.insert(tk.END, line[3:] + "\n", "h2")
elif line.startswith("- "):
text.insert(tk.END, " • " + line[2:] + "\n", "bullet")
else:
text.insert(tk.END, line + "\n", "plain")
text.config(state=tk.DISABLED)
text.yview_moveto(0)
# ---------------- 配置读写 ----------------
def load_api_key(self):
try:
if os.path.exists(CONFIG_PATH):
with open(CONFIG_PATH, "r", encoding="utf-8") as f:
cfg = json.load(f)
key = cfg.get("api_key", "").strip()
if key:
self.api_key_entry.delete(0, tk.END)
self.api_key_entry.insert(0, key)
self.status_label.config(text="已加载保存的 API Key,可直接合成。", foreground="green")
self.log("[信息] 已从程序目录加载 API Key。")
except Exception as e:
self.log(f"[警告] 读取配置失败: {e}")
def save_api_key(self, key):
try:
cfg = {}
if os.path.exists(CONFIG_PATH):
with open(CONFIG_PATH, "r", encoding="utf-8") as f:
cfg = json.load(f)
cfg["api_key"] = key
with open(CONFIG_PATH, "w", encoding="utf-8") as f:
json.dump(cfg, f, ensure_ascii=False, indent=2)
self.log(f"[信息] API Key 已保存到: {CONFIG_PATH}")
except Exception as e:
self.log(f"[警告] 保存配置失败: {e}")
def clear_saved_key(self):
if os.path.exists(CONFIG_PATH):
try:
os.remove(CONFIG_PATH)
self.log("[信息] 已清除保存的 API Key。")
except Exception as e:
self.log(f"[警告] 清除配置失败: {e}")
self.api_key_entry.delete(0, tk.END)
self.status_label.config(text="已清除保存的 Key,请重新输入。", foreground="gray")
# ---------------- 主线程日志 ----------------
def log(self, msg):
try:
self.root.after(0, lambda m=msg: self._log_ui(m))
except (RuntimeError, tk.TclError):
pass
def _log_ui(self, msg):
self.log_text.config(state=tk.NORMAL)
self.log_text.insert(tk.END, msg + "\n")
self.log_text.see(tk.END)
self.log_text.config(state=tk.DISABLED)
# ---------------- 事件 ----------------
def update_char_count(self, event=None):
n = len(self.text_input.get("1.0", "end-1c"))
self.char_count.config(text=f"{n} 字符")
def browse_output(self):
path = filedialog.asksaveasfilename(
defaultextension=".mp3",
filetypes=[("MP3 音频", "*.mp3"), ("WAV 音频", "*.wav"), ("所有文件", "*.*")],
initialfile="cosyvoice_output.mp3"
)
if path:
self.out_path_var.set(path)
# ---------------- 网络验证 ----------------
def check_api_key(self):
key = self.api_key_entry.get().strip()
if not key:
self.status_label.config(text="请先输入 API Key", foreground="red")
return
self.status_label.config(text="正在验证 API Key...", foreground="blue")
self.log("[验证] 正在向服务器发送测试请求...")
def verify():
try:
payload = {
"model": MODEL_NAME,
"input": "好",
"voice": "FunAudioLLM/CosyVoice2-0.5B:alex",
"response_format": "mp3",
}
resp = requests.post(
f"{BASE_URL}/audio/speech",
json=payload,
headers={"Authorization": f"Bearer {key}",
"Content-Type": "application/json"},
timeout=15,
)
if resp.status_code == 200 and len(resp.content) > 0:
self.root.after(0, lambda: self._on_key_valid(key))
elif resp.status_code == 401:
self.root.after(0, lambda: self._on_key_invalid("API Key 无效或已过期"))
else:
snippet = resp.text[:150].replace("\n", " ")
self.root.after(0, lambda s=snippet, c=resp.status_code:
self._on_key_invalid(f"HTTP {c}: {s}"))
except Exception as e:
err = str(e)
self.root.after(0, lambda e=err: self._on_key_invalid(e))
threading.Thread(target=verify, daemon=True).start()
def _on_key_valid(self, key):
self.save_api_key(key)
self.status_label.config(text="API Key 验证通过,已保存。", foreground="green")
self.log("[成功] API Key 验证通过并已保存。")
def _on_key_invalid(self, reason):
self.status_label.config(text=f"验证失败: {reason}", foreground="red")
self.log(f"[失败] API Key 验证失败: {reason}")
# ---------------- 合成 ----------------
def _unload_audio(self):
if not pygame:
return
try:
pygame.mixer.music.stop()
except Exception:
pass
try:
pygame.mixer.music.unload()
except Exception:
pass
def _post_with_retry(self, url, payload, headers, timeout=120):
delay = RETRY_BASE_DELAY
last_err = None
for attempt in range(MAX_RETRIES):
try:
resp = requests.post(url, json=payload, headers=headers, timeout=timeout)
if resp.status_code == 200:
return resp
if resp.status_code == 429 or resp.status_code >= 500:
last_err = f"HTTP {resp.status_code}: {resp.text[:150]}"
self.log(f"[重试] 第 {attempt + 1} 次失败,{delay:.1f}s 后重试: {last_err}")
time.sleep(delay)
delay *= 2
continue
return resp
except requests.RequestException as e:
last_err = str(e)
self.log(f"[重试] 第 {attempt + 1} 次异常,{delay:.1f}s 后重试: {last_err}")
time.sleep(delay)
delay *= 2
raise RuntimeError(f"请求失败(已重试 {MAX_RETRIES} 次): {last_err}")
def on_generate(self):
api_key = self.api_key_entry.get().strip()
if not api_key:
messagebox.showerror("错误", "请先输入 API Key!")
return
text = self.text_input.get("1.0", "end-1c").strip()
if not text:
messagebox.showwarning("提示", "请输入需要合成的文本。")
return
self._unload_audio()
self.is_playing = False
self.is_paused = False
self.highlight_idx = -1
self.generate_btn.config(state=tk.DISABLED)
self.play_btn.config(state=tk.DISABLED)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.DISABLED)
self.progress.start(10)
self.log(f"[开始] 文本长度: {len(text)} 字符")
self.status_label.config(text="正在合成...", foreground="blue")
threading.Thread(target=self.synthesize, args=(text, api_key), daemon=True).start()
def synthesize(self, text, api_key):
temp_dir = None
try:
out_path = self.out_path_var.get()
api_voice = VOICE_API_NAMES.get(self.voice_var.get())
if not api_voice:
raise RuntimeError(f"无效的音色: {self.voice_var.get()}")
emo_prompt = self.emo_text_var.get().strip()
segments = split_text_smart(text, MAX_SEG_LEN)
self.log(f"[切分] 共 {len(text)} 字符,切分为 {len(segments)} 段")
if emo_prompt:
self.log(f"[提示] 情感指令将拼接到每一段,按 input 字节计费会略有上浮")
for i, (s, a, b) in enumerate(segments):
preview = s.replace("\n", " ")[:28]
self.log(f" 段 {i + 1}: [{a}:{b}] {preview}")
temp_dir = tempfile.mkdtemp(prefix="tts_")
temp_wavs = []
headers = {"Authorization": f"Bearer {api_key}", "Content-Type": "application/json"}
for i, (seg, a, b) in enumerate(segments):
self.log(f"[合成] {i + 1}/{len(segments)} ({len(seg)} 字符)...")
final_input = f"{emo_prompt}<|endofprompt|>{seg}" if emo_prompt else seg
payload = {
"model": MODEL_NAME,
"input": final_input,
"voice": api_voice,
"response_format": "wav",
"sample_rate": int(self.sr_var.get()),
"gain": round(self.gain_var.get(), 2),
"speed": round(self.speed_var.get(), 2),
}
resp = self._post_with_retry(f"{BASE_URL}/audio/speech", payload, headers)
if resp.status_code != 200:
raise RuntimeError(
f"第 {i + 1} 段失败: HTTP {resp.status_code} {resp.text[:200]}"
)
seg_path = os.path.join(temp_dir, f"seg_{i:04d}.wav")
with open(seg_path, "wb") as f:
f.write(resp.content)
temp_wavs.append(seg_path)
self.log("[拼接] 正在拼接音频...")
combined_wav = os.path.join(temp_dir, "combined.wav")
durations = concat_wavs(temp_wavs, combined_wav)
self.timeline = []
self.timeline_starts = []
t_cursor = 0.0
for (seg, a, b), dur in zip(segments, durations):
self.timeline.append((t_cursor * 1000, (t_cursor + dur) * 1000, a, b))
self.timeline_starts.append(t_cursor * 1000)
t_cursor += dur
self.log(f"[时间轴] 共 {len(self.timeline)} 段,总时长 {t_cursor:.2f} 秒")
if out_path.lower().endswith(".mp3"):
try:
convert_wav_to_mp3(combined_wav, out_path)
self.log(f"[转换] 已转换为 MP3: {out_path}")
except Exception as e:
fallback = os.path.splitext(out_path)[0] + ".wav"
shutil.copy(combined_wav, fallback)
self.log(f"[提示] MP3 转换失败({e}),已保存为 WAV: {fallback}")
out_path = fallback
else:
shutil.copy(combined_wav, out_path)
self.current_audio_path = out_path
self.root.after(0, lambda p=out_path: self.on_synth_success(p))
except Exception as e:
err = str(e)
self.root.after(0, lambda e=err: self.on_error(e))
finally:
if temp_dir and os.path.exists(temp_dir):
shutil.rmtree(temp_dir, ignore_errors=True)
def on_synth_success(self, path):
self.progress.stop()
self.generate_btn.config(state=tk.NORMAL)
self.play_btn.config(state=tk.NORMAL)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.NORMAL)
self.is_playing = False
self.is_paused = False
self.highlight_idx = -1
self.status_label.config(text="合成完成,可播放并高亮", foreground="green")
self.log(f"[完成] 音频已保存: {path}")
def on_error(self, err):
self.progress.stop()
self.generate_btn.config(state=tk.NORMAL)
self.status_label.config(text="合成失败", foreground="red")
self.log(f"[错误] {err}")
messagebox.showerror("合成失败", err)
# ---------------- 播放 ----------------
def on_play(self):
if not self.current_audio_path or not os.path.exists(self.current_audio_path):
messagebox.showwarning("提示", "请先合成音频。")
return
if not pygame:
messagebox.showerror("错误", "未安装 pygame,请运行: pip install pygame")
return
self._start_playback(0)
def on_play_from_cursor(self):
if not self.current_audio_path or not os.path.exists(self.current_audio_path):
messagebox.showwarning("提示", "请先合成音频。")
return
if not pygame:
messagebox.showerror("错误", "未安装 pygame。")
return
if not self.timeline:
messagebox.showwarning("提示", "时间轴为空,请重新合成。")
return
try:
cursor_index = self.text_input.index(tk.INSERT)
cursor_char = len(self.text_input.get("1.0", cursor_index))
except Exception:
cursor_char = 0
idx = 0
for i, (t0, t1, a, b) in enumerate(self.timeline):
if cursor_char < b:
idx = i
break
else:
idx = len(self.timeline) - 1
start_ms = self.timeline[idx][0]
self.log(f"[定位] 光标字符 {cursor_char} → 段 {idx + 1},从 {start_ms:.0f} ms 开始")
self._start_playback(start_ms)
def _start_playback(self, start_ms):
self.is_playing = False
self.is_paused = False
try:
pygame.mixer.music.stop()
except Exception:
pass
try:
pygame.mixer.music.unload()
except Exception:
pass
try:
pygame.mixer.music.load(self.current_audio_path)
if start_ms > 0:
pygame.mixer.music.play(start=start_ms / 1000.0)
else:
pygame.mixer.music.play()
except Exception as e:
messagebox.showerror("播放错误", str(e))
return
self.is_playing = True
self.is_paused = False
self.play_offset_ms = start_ms
self.highlight_idx = -1
self.play_btn.config(state=tk.DISABLED)
self.cursor_btn.config(state=tk.DISABLED)
self.pause_btn.config(state=tk.NORMAL, text="⏸ 暂停")
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.status_label.config(text="播放中...", foreground="green")
self.sync_loop()
def on_pause_resume(self):
if not pygame:
return
if self.is_paused:
try:
pygame.mixer.music.unpause()
except Exception as e:
messagebox.showerror("错误", str(e))
return
self.is_paused = False
self.is_playing = True
self.pause_btn.config(text="⏸ 暂停")
self.status_label.config(text="播放中...", foreground="green")
self.sync_loop()
elif self.is_playing:
try:
pygame.mixer.music.pause()
except Exception as e:
messagebox.showerror("错误", str(e))
return
self.is_paused = True
self.is_playing = False
self.pause_btn.config(text="▶ 继续")
self.status_label.config(text="已暂停", foreground="gray")
def sync_loop(self):
if not self.is_playing:
return
if pygame.mixer.music.get_busy():
pos = max(pygame.mixer.music.get_pos(), 0)
self.update_highlight(pos + self.play_offset_ms)
self.root.after(POLL_MS, self.sync_loop)
else:
self.on_playback_finished()
def update_highlight(self, ms):
if not self.timeline_starts:
return
idx = bisect.bisect_right(self.timeline_starts, ms) - 1
if idx < 0 or idx >= len(self.timeline):
return
t0, t1, a, b = self.timeline[idx]
if not (t0 <= ms < t1):
return
if idx == self.highlight_idx:
return
if b <= a:
return
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.text_input.tag_add("highlight", f"1.0+{a}c", f"1.0+{b}c")
self.text_input.see(f"1.0+{a}c")
self.highlight_idx = idx
def on_playback_finished(self):
self.is_playing = False
self.is_paused = False
self.play_offset_ms = 0
self._unload_audio()
self.text_input.tag_remove("highlight", "1.0", tk.END)
self.play_btn.config(state=tk.NORMAL if self.current_audio_path else tk.DISABLED)
self.pause_btn.config(state=tk.DISABLED, text="⏸ 暂停")
self.cursor_btn.config(state=tk.NORMAL if self.current_audio_path else tk.DISABLED)
self.status_label.config(text="播放结束", foreground="gray")
self.log("[播放] 已结束")
if __name__ == "__main__":
root = tk.Tk()
app = TTSApp(root)
root.mainloop()