这篇想回答两个问题:HyperFrames 到底能干什么,以及怎么用。中间穿插我实际跑一遍之后的体感。
1 介绍
HyperFrames 是 HeyGen 开源的「HTML → MP4」视频渲染框架(2026-04 开源,60k+ star),核心口号是 Write HTML. Render video. Built for agents.
它做的事是把网页渲染成视频:让 AI agent 用 HTML / CSS / JS 把画面写成网页,再用无头 Chrome 逐帧截图、交给 FFmpeg 编码成确定性的 MP4。同一份输入永远渲染出同一个视频------这是它能进自动化流程的前提。
它现有 21 个 skill,入口是路由器 /hyperframes,其它按需加载。核心集只有十来个,创建工作流(/faceless-explainer、/product-launch-video 这些)是用到才拉的。
1.1 相关工具
在它之前,功能类似的是 Remotion:同样把代码描述的画面渲染成视频,底层也是无头 Chrome 加 FFmpeg。Remotion 更早、生态更成熟,分布式渲染那类配套更完备。
不过要说热度,现在是反过来的:HyperFrames 今年 4 月才开源,star 数已经反超了 Remotion。现在 agent 工作流里讲 " 用代码出视频 ",提到的大多是它。
差别主要在于工作过程,Remotion 写的是 React 组件,得先有一整套前端工程和打包流程;HyperFrames 只写 HTML / CSS,一个纯文本文件就能描述整支片子的时间轴,浏览器里直接打开就能播。这一条对 agent 特别友好------生成一个 HTML 文件,比生成一个 React 工程省事得多,出错了也好改。
1.2 该选哪条工作流
我这次用的是 /faceless-explainer:给一段文本讲清一个概念,没有产品或网站要展示,画面全由 LLM 生成,只做简单测试。
如果内容更长、场景更杂,可以走 /general-video 兜底。如果是要展示某个产品或网站,推荐 /product-launch-video。
声音一般由我自己定制,本篇不涉及。
1.3 用后感
先说用后感,你再决定要不要往下看。
给一个文本、出一个视频,这个过程很快就跑通了,让 agent 自己做也没什么难度。但跑得通不等于做得好------从内容到画面,出来的是一个中等水平的视频。
技术上 html → mp4 是真有用的。确定性渲染、可寻址时间轴、能接进自动化流程,使整个流程可以稳定输出。
使用后,我的感觉是:它能出个中等效果,想一点不改,直接用它给你挣钱,几乎不可能。 博主们的演示视频里的效果很惊艳,但我自己跑下来,成片还需要不少人工调整。"应该能做出来"的理想效果,和我实际拿到手的,差距不小(疑似是手动精调的结果)。
这个功能在知识类视频里确实有用。个别动画能把抽象主题表达得更清楚,但没必要每个场景都设计动效------多数动效只是在动,不给内容加分。
所以,我觉得对于多数人来说:在自己的工作流中调用它生成动画 mp4 的 subskill,而不是完全依赖它,这可能是更合理的方案。
2 操作流程与内部处理
以我这次用的 faceless-explainer 为例,HyperFrames 处理的不是原始讲稿,而是拆好的分镜和对应画面。
-
初始化项目并检查环境:
npx hyperframes init socratic-video
cd socratic-video
npx hyperframes doctor
init 负责建项目骨架、写配置;工作流会记录在 hyperframes.json。之后生成 BRIEF.md,确定核心 message、受众、时长和画幅。原文会存入 capture/extracted/visible-text.txt,作为后续改编的信息源。
-
把讲稿改成分镜。每段要说什么、画面表达什么、持续多久,都要先确定,再写入
STORYBOARD.md。例如:scene-01 | 0--8s | 旁白:HyperFrames 把网页渲染成视频 | 画面:HTML
faceless-explainer 对分镜有固定要求,包括 scene / duration / type / persuasion / beat 和时间码镜头序列,不是只列出旁白和画面就够了。
-
根据分镜生成视觉规范和画面。
frame.md记录配色、字体、网格等设计规则;每帧生成独立 HTML,最后合成为index.html。每个 scene 对应一个class="clip"元素,时间和轨道由data-*属性定义。 -
检查、预览,再渲染:
npx hyperframes check
npx hyperframes preview
npx hyperframes render
渲染时由无头 Chrome 逐帧截图,再交给 FFmpeg 编码成 MP4。修改时要留意:分镜和帧 HTML 都记录了时长,两边的 duration 与 data-duration 必须一致;交给 agent 同步修改更稳妥。
3 背景知识
3.1 GSAP 动画
GSAP 是它调用的动画引擎,页面上每个元素 " 什么时候出现、怎么动 " 都写在它里面。
之所以要引入一个动画库,是因为 HyperFrames 的渲染方式是逐帧截图:把时间轴拖到某一帧、截一张图,再逐帧拼成视频。这就要求动画必须 " 可寻址 "------给定时间点,元素的状态是唯一确定的。GSAP 的时间轴正好能这么用,每一帧的位置都能被精确 seek。
代价是写法上有约束:动画里不能出现循环、随机数和真实时间,只能用位移、缩放、透明度这类状态明确的属性。
3.2 HTML → MP4 是怎么发生的
浏览器里那一套------CSS 布局、字体、渐变、SVG------就是它的画面层。渲染时起一个无头 Chrome,把时间轴拖到每一帧、截图,再交给 FFmpeg 编码成 MP4。
所以网页里能画出来的,都能进视频。但它只擅长 " 屏幕里的东西 ":实拍素材、真实画面要另外准备。
4 个人使用经验
4.1 哪些 Skill 值得先看
不用一口气研究全部 Skill。做动态画面时,我觉得先看这几个就够了:
-
hyperframes-core:理解时间轴、轨道和 clip 的基础规则。
-
hyperframes-animation:安排元素和文字的动画节奏。
-
hyperframes-keyframes:做局部放大、平移和裁切变化。
-
hyperframes-registry:找现成的图表、终端、卡片等组件,少从头写 HTML。
hyperframes-cli 和 hyperframes-creative 用到时再查。音频、素材和整套自动化工作流则按自己的制作流程决定要不要用。
4.2 适合交给它做的画面
我觉得它最适合补那些需要动态呈现、手工做起来又麻烦的局部画面:
-
截图或架构图的局部放大、高亮,以及架构流程的分步点亮。
-
命令行逐字输入、运行日志和代码差异展示。
-
章节标题、重点卡片等文字元素的逐步出现。
-
折线图、柱状图和关键数字的动态变化。
它适合讲抽象概念,画面上限受模型能力影响。
4.3 怎么开始,成本怎么计算
建议先做一分钟以内的小片段,成功后,再处理全部内容、TTS 和视频流程,不要预期一次生成就能直接发布。
聊天模型的 Token 和图片、语音等生成额度是两笔账;HyperFrames 以及 Agent 不提供这些模型额度,需要设置和调用外部生成工具。我这次没有生成图片,画面都由 HTML/CSS 绘制,所以图片成本为零。
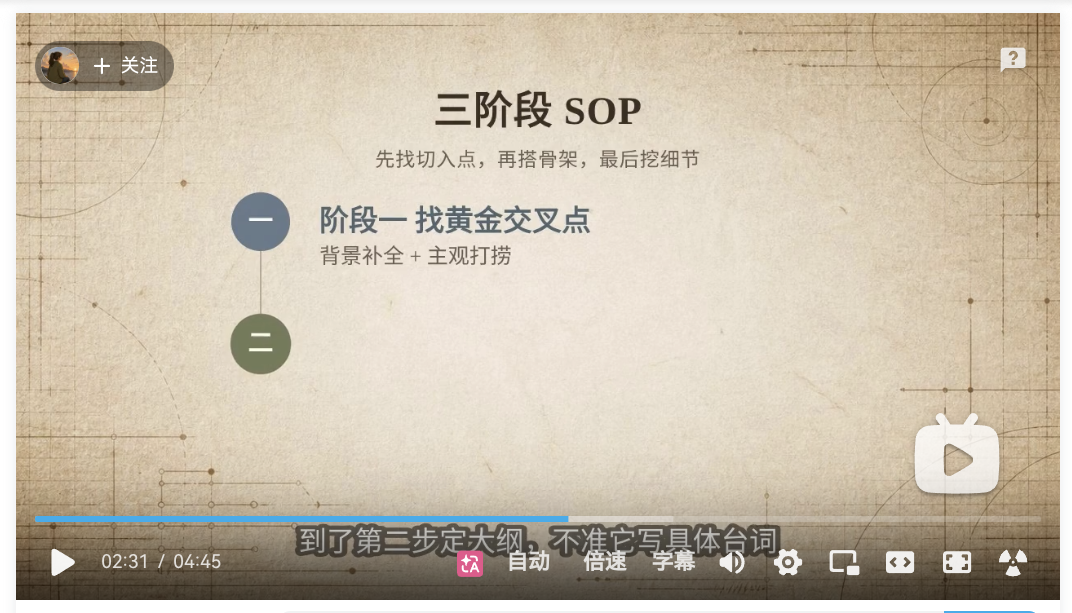
上图展示了我在视频中最常用的文字元素的逐步显示的效果,视频见:
【让 AI 写出有灵魂的内容:用苏格拉底式提问做深度创作】 https://www.bilibili.com/video/BV1JuWc6bEwQ/?share_source=copy_web\&vd_source=573b4e38139c4dc9d07806ec1e946f15