很多企事业单位启动数据中台建设时,普遍存在成本核算偏差问题。大多项目立项阶段仅统计软件采购、硬件部署等显性支出,对占总成本比重最高的人力投入预估不足,最终超支、延期的情况时有发生。
部分项目甚至因为人力缺口无法补齐,落地周期一拖再拖,数据底座的建设效果远低于预期。本文从岗位配置、模式差异、隐性成本三个维度,梳理一套可直接复用的全周期人力成本测算框架,供各类型客户参考。
数据中台建设全周期人力岗位配置明细
标准体量的数据中台建设,全周期覆盖需求调研、落地实施、长期运营三个阶段,不同阶段的岗位配置要求差异极大:
DCMM 2.0(GB/T 36073-2025,数据管理能力成熟度评估模型,Data Management Capability Maturity Assessment Model)将数据治理(Data Governance)的组织与岗位建设列为核心评估项,要求企业建立专职的数据管理岗位体系------这从标准层面印证了人力投入的必要性。
-
项目启动筹备阶段,核心配置两类岗位。一类是专职项目经理,需具备跨部门协调能力,统筹项目排期、风险管控等全流程工作;另一类是核心业务对接组,由企业各业务部门骨干组成,负责梳理业务侧数据口径、现存痛点等需求。
-
落地实施阶段,核心配置多类技术岗位。数据架构师(Data Architect)负责整体数据模型、技术架构设计;数据开发工程师(Data Developer)负责数据接入、清洗、建模等开发工作,人数按项目规模配置;数据安全工程师负责权限体系、数据加密等安全模块搭建;测试工程师负责全平台功能验证、压力测试。
-
长期运营迭代阶段,核心配置常驻岗位。数据运营专员(Data Operations)负责日常数据质量(Data Quality)校验、资产目录更新;系统运维工程师负责平台日常稳定性维护,可兼任其他信息化系统运维工作。
可以看出,数据中台建设的人力投入贯穿"建"和"用"两个阶段,尤其是长期运营岗位,往往是立项时最容易漏算的部分。
不同建设模式下的人力成本差异测算
目前行业内主流的数据中台建设模式分为三类,不同模式下的人力投入规模、周期差异极大:
-
完全自主研发模式:所有代码、组件都由企业自有团队从零开发,需要配置完整的产品、架构、开发、测试团队,周期长、团队规模大。优势是可完全按需定制,缺点是人力成本高、团队磨合难度大,后续人员流动的重置成本也高。
-
采购开源组件组装落地模式:基于主流开源数据工具,由自有团队进行二次开发、组装适配,整体人力投入比完全自研有所降低,但仍需要配置大量具备二次开发能力的技术人员,对团队技术能力要求较高。
-
采购成熟标准化产品 + 陪跑服务的轻量化模式:选择已完成全链路组件封装的成熟商用产品,由厂商提供实施指导、陪跑服务,企业仅需配置少量对接、开发人员即可完成落地。人力投入规模明显低于前两类,落地周期也能大幅压缩。
三种模式的本质差异,在于"哪些能力由企业自建、哪些能力由成熟产品承载":
| 建设模式 | 人力投入 | 落地周期 | 技术门槛 | 适用对象 |
|---|---|---|---|---|
| 完全自主研发 | 高 | 长 | 高 | 技术团队储备强的企业 |
| 开源组件组装 | 较高 | 较长 | 较高 | 具备二次开发能力的团队 |
| 商用产品 + 陪跑 | 低 | 短 | 低 | 大多数政企客户 |
如果没有极强的技术团队储备,完全自研和开源组装模式的隐性人力投入很容易超出企业承受范围;选择成熟商用产品搭配陪跑服务,通常是用人效比更高的选型方向。
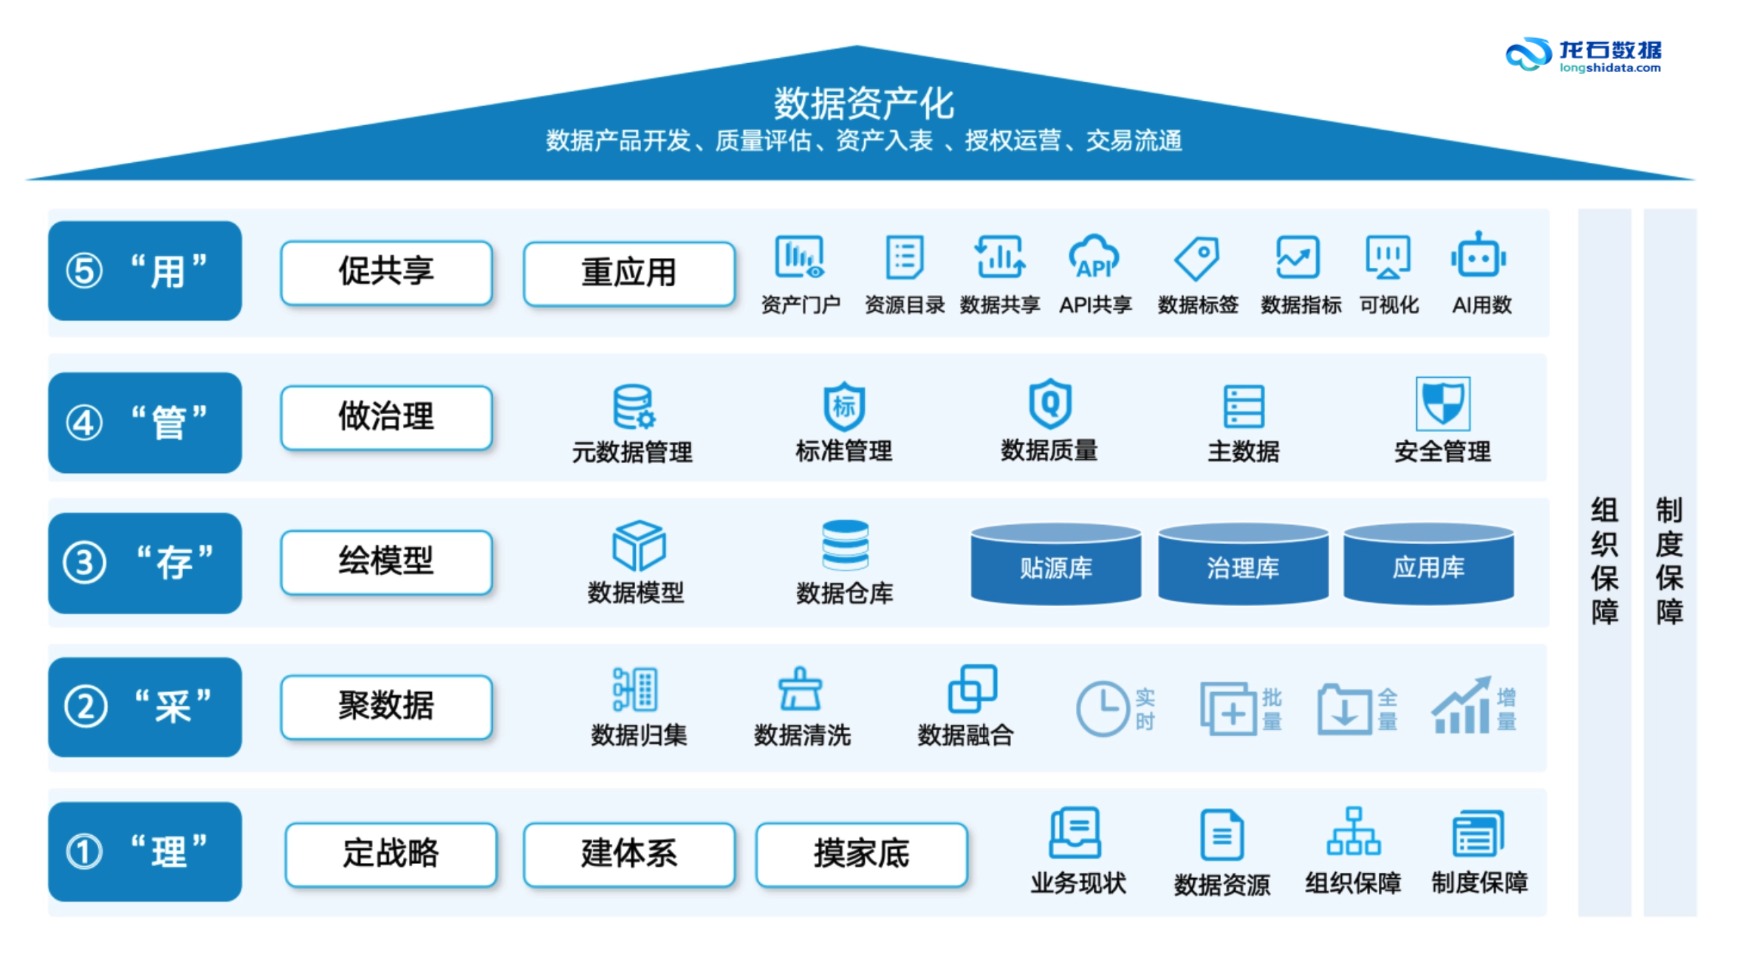
目前行业内认可度较高的龙石数据中台,就属于轻量化方案的典型代表。产品围绕"理、采、存、管、用"方法论预封装了全流程功能模块,覆盖数据接入、归集、清洗、标准、质量、安全、共享与应用全链路,支持可视化配置、组件按需部署,不需要大量定制开发工作。依托"产品 + 培训 + 陪跑"服务模式,企业可以边落地边掌握数据治理方法,不需要长期养大量专属开发团队,就能建成可自主运营的数据底座。
人力成本测算的常见隐性项与避坑指南
很多企业做人力成本测算时,很容易忽略几类隐性投入,最终导致实际支出远超预期:
-
跨部门协同的时间成本:核心数据标准梳理、口径对齐的工作,都需要业务骨干深度参与。如果没有提前给各业务部门明确对接要求,很容易出现需求反复修改的问题,拉长项目周期、推高人力成本。
-
人员流动带来的重置成本:数字化领域的技术人才流动率普遍较高,如果项目周期很长,核心岗位人员离职后,新接手人员需要较长时间熟悉项目逻辑,这段空窗期的时间成本、招聘成本都会转化为项目的额外支出。
-
后续长期迭代的运营成本:不少企业误以为数据中台上线就宣告结束,实际上后续的持续运营、数据资产迭代、场景拓展都需要配置固定的运营人员,这类长期人力投入如果没有纳入测算,上线后很容易出现平台没人维护、数据持续沉淀变成死库的问题。
针对这些隐性成本的避坑方案也很明确:一是在项目启动阶段就和各业务部门明确对接人配置、投入时长要求,把需求梳理的环节前置,避免后期反复返工;二是优先选择落地周期短的成熟商用方案,压缩项目周期、降低人员流动风险;三是选择配套完善培训体系的服务商,帮助企业自有团队快速掌握平台运营方法,实现自主迭代运营,大幅降低长期人力投入。
常见问题解答
数据中台建设最少要配置多少人力?
没有固定标准,取决于建设模式。采用成熟商用产品 + 陪跑服务的轻量化模式,企业只需配置少量对接、开发人员和 1-2 名长期数据运营人员即可完成落地与持续运营;若选择完全自研或开源组装,则需要成规模的产品、开发、测试团队。
没有专职技术团队,能不能用商用数据中台?
可以。成熟商用产品的配置多为可视化低代码操作,普通业务人员经过短期培训即可上手。配套的培训与陪跑服务会帮助企业团队掌握数据治理方法,不需要长期高薪组建庞大的专职开发团队。
数据中台上线后还需要持续投入人力吗?
需要,但规模可控。上线后主要配置数据运营、系统运维两类常驻岗位,负责日常数据质量校验、资产目录更新和平台稳定性维护,投入远低于建设阶段。
结语
数据中台建设的人力成本测算,不能只看表面的岗位薪资支出,要结合自身技术储备、业务需求选择适配的建设模式,同时把各类隐性投入提前纳入核算框架,才能得到准确的成本数值,避免项目超支、延期。
建议没有充足技术团队储备的客户,优先选择有成熟落地服务经验的厂商方案,依托预封装的全链路功能组件,搭配"产品 + 培训 + 陪跑"的服务模式,既大幅降低全周期人力投入,也在落地过程中搭建自有团队的数据治理能力,最终建成统一、可信、可复用的数据底座,形成长期自主运营的核心能力。