做 Agent 开发,第一步不是急着写提示词,而是先把"大模型接入底座"打牢。很多团队在 HarmonyOS 7 上接云端大模型时,都会在同一批坑里反复栽跟头:鉴权头写错导致 401、没设超时界面直接卡死、遇到 429 限流不重试直接失败、各家响应格式不统一解析散落一地。底座不稳,上层 Agent 再加花哨也随时崩。
本系列《HarmonyOS 7 Agent 开发实战》全部基于一个共识:整系列的 LLM 底座统一走云端大模型 API(华为云盘古 / OpenAI 兼容网关),不再依赖设备端侧模型分发通道。原因很现实------端侧模型下载入口在部分设备上尚未开放,而云端 API 只要有网就能在真机或模拟器上实测,纯逻辑还能脱离设备跑单测,符合"案例能跑通"的硬要求。
本文用一个可直接打开运行的 DevEco 工程,把云端大模型接入收敛成一套统一抽象:盘古和 OpenAI 兼容网关共用一个 LlmClient,内置超时、指数退避重试、JSON 解析,业务侧只管拿文本。所有代码基于 HarmonyOS 7(API 26)的 @ohos.net.http,并配了可脱离设备运行的 Hypium 单测。
一、整体架构:把不确定性收进一层抽象
接入云端大模型,真正要解决的不是"发一个 POST",而是把三件麻烦事管住:鉴权差异、失败重试、响应解析。如果让每个业务页面自己拼请求,代码会迅速腐化。
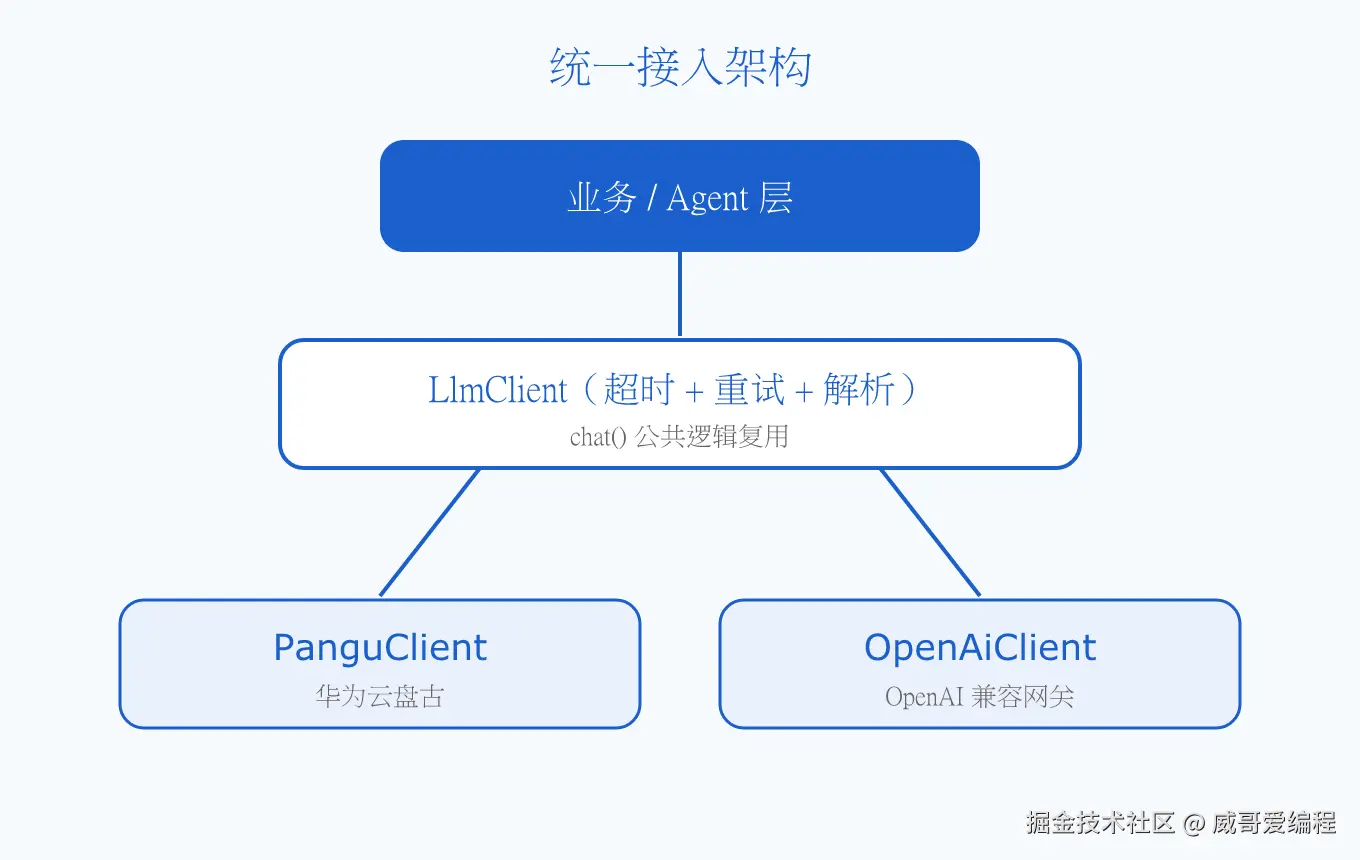
整体分三层:
- 业务 / Agent 层 :只管组织
messages、拿resp.text,不关心背后是盘古还是 OpenAI。 - 统一客户端层
LlmClient:抽象出chat(),把"超时 + 重试 + 解析"三件事收口复用。 - 具体实现层 :
PanguClient与OpenAiClient两个子类,只写它们真正不同的地方------请求地址、鉴权头、错误分类。
切换厂商只改工厂一行参数,业务代码零改动。这就是底座该有的样子:把易变的东西关进一个可替换的盒子。
二、统一消息模型:先把契约定清楚
任何客户端,第一步是把请求和响应的形状定下来,避免后面到处传 any。
ts
// feature/llmclient/ChatModels.ets
export enum Role {
  SYSTEM = 'system',
  USER = 'user',
  ASSISTANT = 'assistant'
}

export interface ChatMessage {
  role: Role;
  content: string;
}

export interface ChatRequest {
  model: string;
  messages: ChatMessage[];
  temperature?: number;
  maxTokens?: number;
}

// 实际发送到服务端的请求体(wire 格式):服务端协议用下划线命名(max_tokens)
export interface LlmPayload {
  model: string;
  messages: ChatMessage[];
  temperature?: number;
  max_tokens?: number;
}

export interface ChatResponse {
  text: string;
  raw: string;
  finishReason?: string;
  usage?: TokenUsage;
}

// Token 用量统计:服务端返回 snake_case(prompt_tokens...),归一化为驼峰命名
export interface TokenUsage {
  promptTokens: number;
  completionTokens: number;
  totalTokens: number;
}
这个模型同时被盘古和 OpenAI 复用,因为两者在消息结构上高度一致------都是 role + content 的数组。差异只在更外层的字段命名(如 max_tokens 的下划线风格),由子类在 buildPayload 里处理。
三、重试策略:纯逻辑,先写可测的部分
重试是最容易被写成"无脑 for 循环"的地方。正确的做法是把"什么错误该重试、退避多久"抽成纯函数,脱离网络就能测。
ts
// feature/llmclient/RetryPolicy.ets(节选)
export enum RetryableError {
  NETWORK = 'network',
  TIMEOUT = 'timeout',
  SERVER_5XX = 'server_5xx',
  RATE_LIMIT = 'rate_limit',
  NON_RETRYABLE = 'non_retryable'
}

export class RetryPolicy {
  readonly maxRetries: number;
  readonly baseDelayMs: number;
  readonly maxDelayMs: number;

  constructor(maxRetries = 3, baseDelayMs = 300, maxDelayMs = 5000) {
    this.maxRetries = maxRetries;
    this.baseDelayMs = baseDelayMs;
    this.maxDelayMs = maxDelayMs;
  }

  classify(statusCode: number, errMsg?: string): RetryableError {
    if (statusCode === 0 || statusCode === -1) return RetryableError.NETWORK;
    if (statusCode === 408 || (errMsg && errMsg.toLowerCase().includes('timeout')))
      return RetryableError.TIMEOUT;
    if (statusCode === 429) return RetryableError.RATE_LIMIT;
    if (statusCode >= 500 && statusCode < 600) return RetryableError.SERVER_5XX;
    return RetryableError.NON_RETRYABLE;
  }

  shouldRetry(attempt: number, error: RetryableError): boolean {
    if (error === RetryableError.NON_RETRYABLE) return false;
    return attempt < this.maxRetries;
  }

  calcBackoff(attempt: number): number {
    const exp = this.baseDelayMs * Math.pow(2, attempt);
    return Math.min(exp, this.maxDelayMs);
  }
}
注意 classify 的设计:401、400 这类客户端错误不重试(重试也没用,得改代码或参数),只有网络抖动、超时、5xx、429 才进入重试序列。退避用指数封顶,避免重试把服务端压垮。
四、响应解析:兼容两种格式再兜底
云端网关的响应不是永远规整。OpenAI 格式是 choices[0].message.content,华为云盘古兼容 OpenAI 格式,但部分网关会返回 result、text、reply 这类扁平字段。解析层先按标准格式取,取不到再走兜底。
ts
// feature/llmclient/ResponseParser.ets(节选)
static parse(raw: string): ChatResponse {
  // JSON.parse 返回 opaque 的 Object,先收窄成受控的键值容器
  const obj: Object = JSON.parse(raw);
  const anyObj: Record<string, Object> = obj as Record<string, Object>;

  const choices: Object | undefined = anyObj['choices'];
  if (choices !== undefined && Array.isArray(choices) && (choices as Array<Object>).length > 0) {
    const first: Record<string, Object> = (choices as Array<Object>)[0] as Record<string, Object>;
    const message: Record<string, Object> | undefined =
      first['message'] as Record<string, Object> | undefined;
    const text: string = message !== undefined ? (message['content'] as string) : '';
    const finish: string | undefined = first['finish_reason'] as string | undefined;
    // usage 字段走 snake_case(服务端协议),再映射成驼峰 TokenUsage
    const usageObj: Record<string, Object> | undefined = anyObj['usage'] as Record<string, Object> | undefined;
    let usage: TokenUsage | undefined = undefined;
    if (usageObj !== undefined) {
      usage = {
        promptTokens: (usageObj['prompt_tokens'] as number) ?? 0,
        completionTokens: (usageObj['completion_tokens'] as number) ?? 0,
        totalTokens: (usageObj['total_tokens'] as number) ?? 0
      };
    }
    return { text, raw, finishReason: finish, usage };
  }

  // 兜底:部分网关直接返回 result / text / reply 顶层字段
  const fallback: string =
    (anyObj['result'] as string) ?? (anyObj['text'] as string) ?? (anyObj['reply'] as string) ?? '';
  return { text: fallback, raw };
}
把解析收敛到一处,业务侧永远拿到结构化的 ChatResponse,不必在页面里写一堆 JSON.parse 加 any 强转。
五、统一客户端:差异留给子类,复用收进父类
LlmClient 是抽象类,只定义三个"因厂商而异"的抽象方法,把公共的 chat() 实现好:
ts
// feature/llmclient/LlmClient.ets(节选)
export abstract class LlmClient {
  protected config: LlmClientConfig;
  protected retryPolicy: RetryPolicy;

  abstract buildPayload(req: ChatRequest): LlmPayload;
  abstract buildHeaders(): Record<string, string>;
  abstract classifyError(err: Error): RetryableError;

  async chat(req: ChatRequest): Promise<ChatResponse> {
    let attempt = 0;
    while (true) {
      try {
        const raw = await this.sendOnce(req);
        return ResponseParser.parseOrThrow(raw);
      } catch (e) {
        const kind = this.classifyError(e as Error);
        if (!this.retryPolicy.shouldRetry(attempt, kind)) throw e;
        await this.sleep(this.retryPolicy.calcBackoff(attempt));
        attempt++;
      }
    }
  }

  protected abstract sendOnce(req: ChatRequest): Promise<string>;
}
两个子类真正不同的只有 buildHeaders 和 sendOnce 里拼的地址。盘古用 X-Auth-Token(或 Authorization: Bearer,按账号类型二选一),OpenAI 用 Authorization: Bearer;底层都是 @ohos.net.http 的 request。
ts
// 切换只改工厂一行
export class LlmClientFactory {
  static create(provider: 'pangu' | 'openai', config: LlmClientConfig): LlmClient {
    if (provider === 'pangu') return new PanguClient(config);
    if (provider === 'openai') return new OpenAiClient(config);
    throw new Error('未知 provider: ' + provider);
  }
}
六、纯逻辑单测:不联网也能绿
底座里最容易写错、又最该先测的,是重试分类与响应解析------它们不碰网络,用 Hypium 直接断言即可,在模拟器上秒过。
ts
// ohosTest/ets/test/LlmClient.test.ets(节选)
it('分类 429 为限流', 0, () => {
  expect(new RetryPolicy().classify(429)).assertEqual(RetryableError.RATE_LIMIT);
});
it('calcBackoff 指数且封顶', 0, () => {
  const p = new RetryPolicy(5, 300, 5000);
  expect(p.calcBackoff(0)).assertEqual(300);
  expect(p.calcBackoff(10)).assertEqual(5000);
});
it('解析 OpenAI 格式并取 usage', 0, () => {
  const raw = JSON.stringify({
    choices: [{ message: { content: '你好' }, finish_reason: 'stop' }],
    usage: { prompt_tokens: 10, completion_tokens: 5, total_tokens: 15 }
  });
  expect(ResponseParser.parseOrThrow(raw).usage?.totalTokens).assertEqual(15);
});
工程里共 9 条断言(重试 6 条 + 解析 3 条),全部不发起网络请求,脱离设备也能验证底座逻辑的正确性。
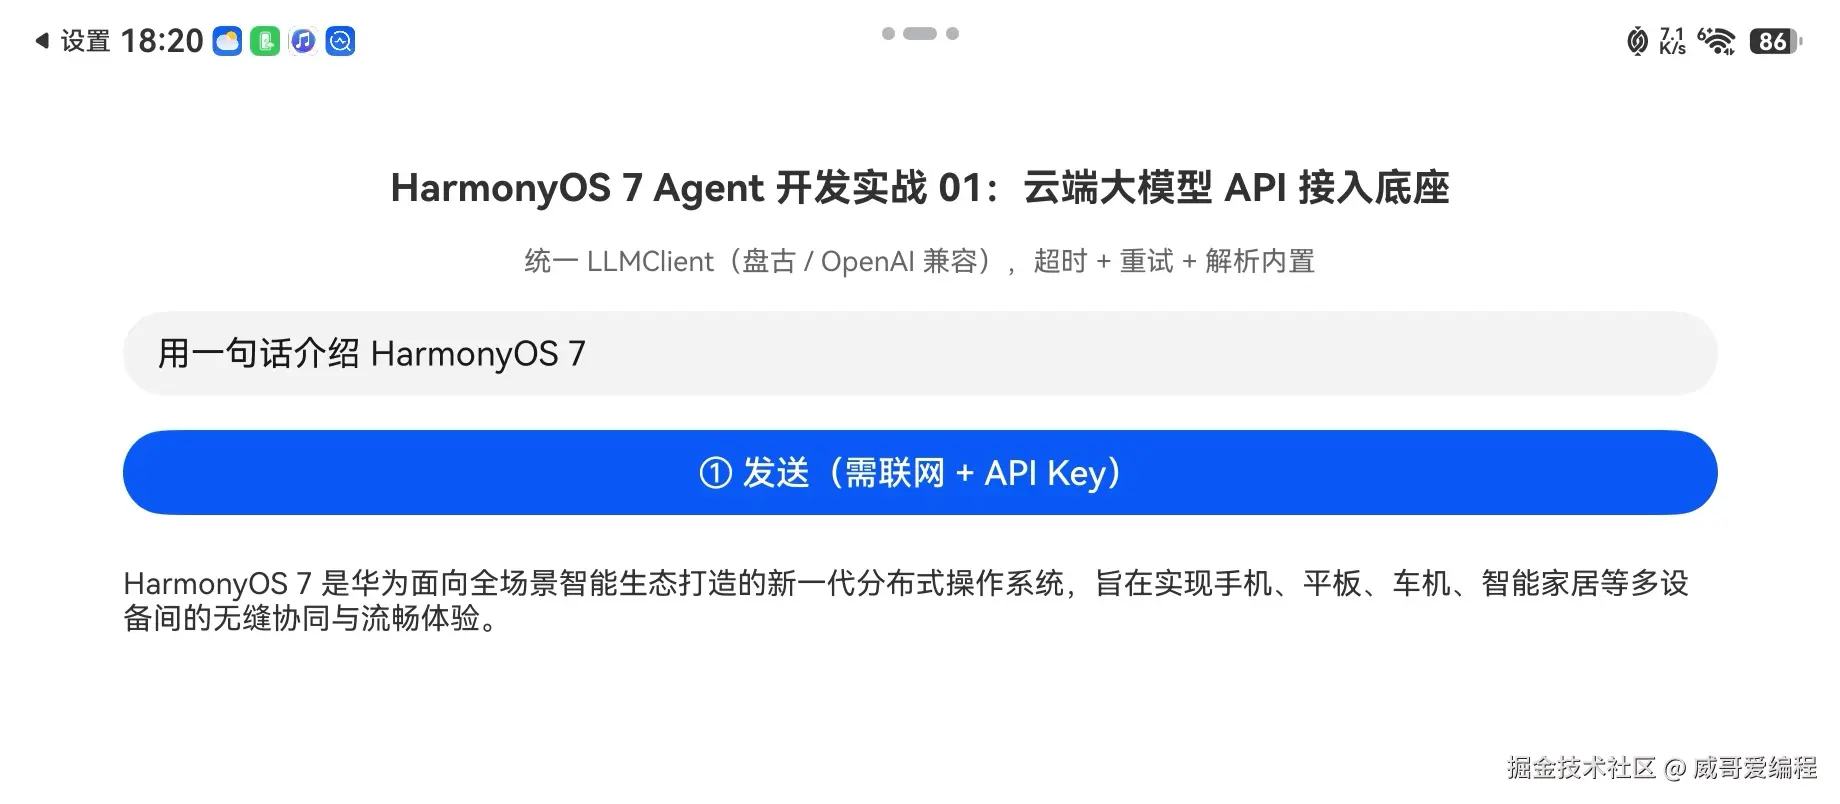
七、真机实测:填三项即可对话
演示页 pages/Index.ets 把工厂、客户端、UI 串起来。你只需把三处换成自己的配置:
baseUrl:网关地址(openai用https://.../v1/chat/completions;pangu用盘古 endpoint)apiKey:你的密钥model:模型名
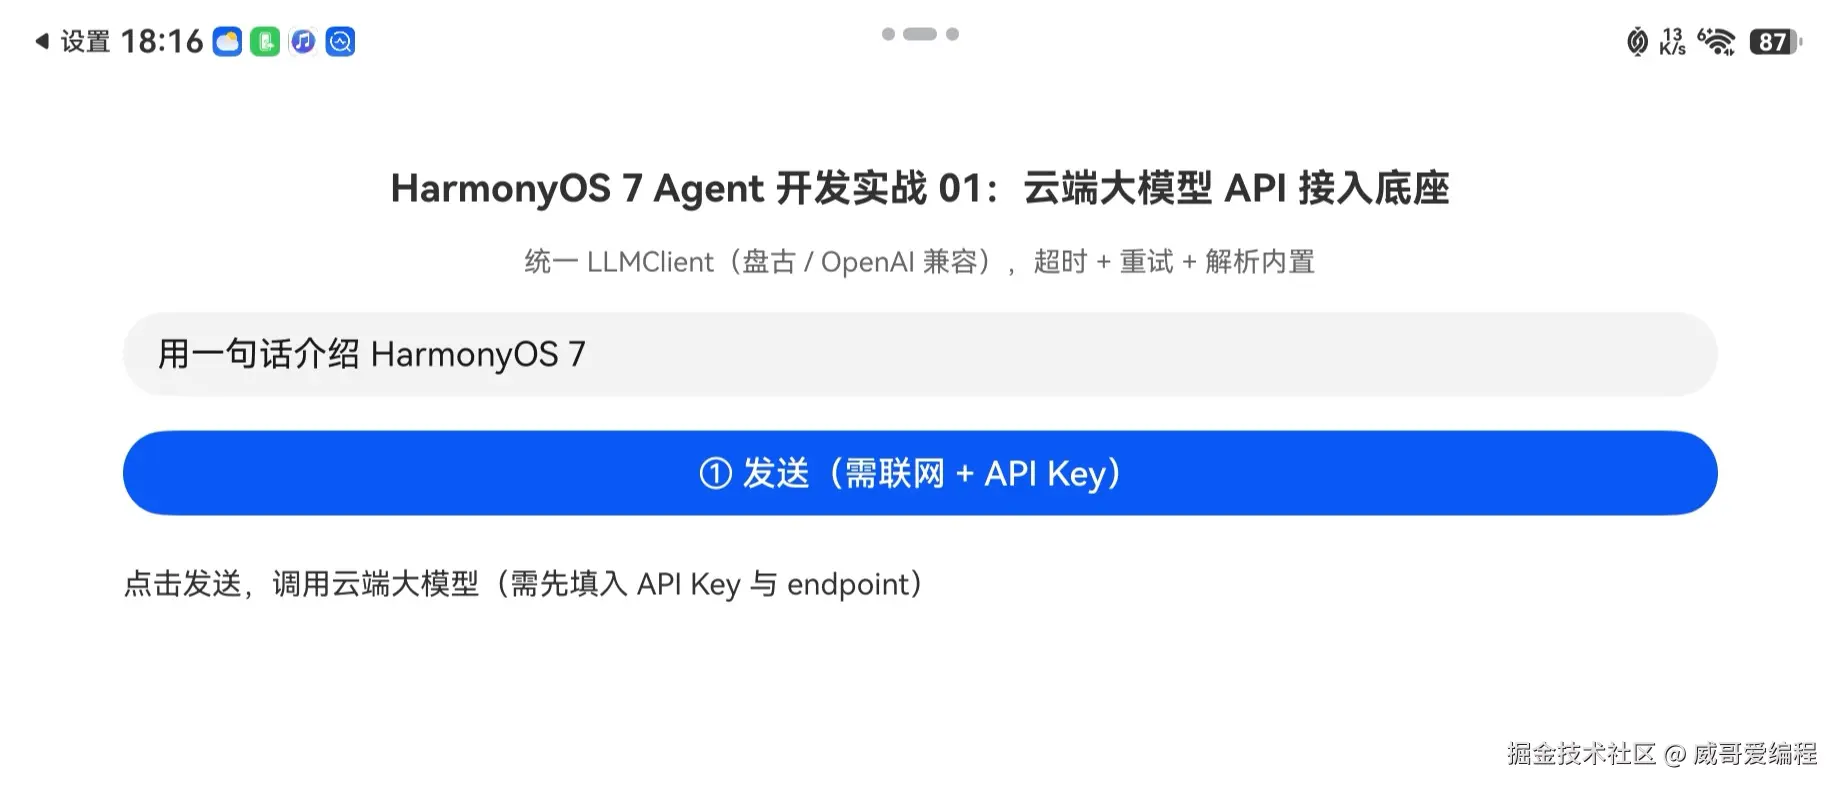
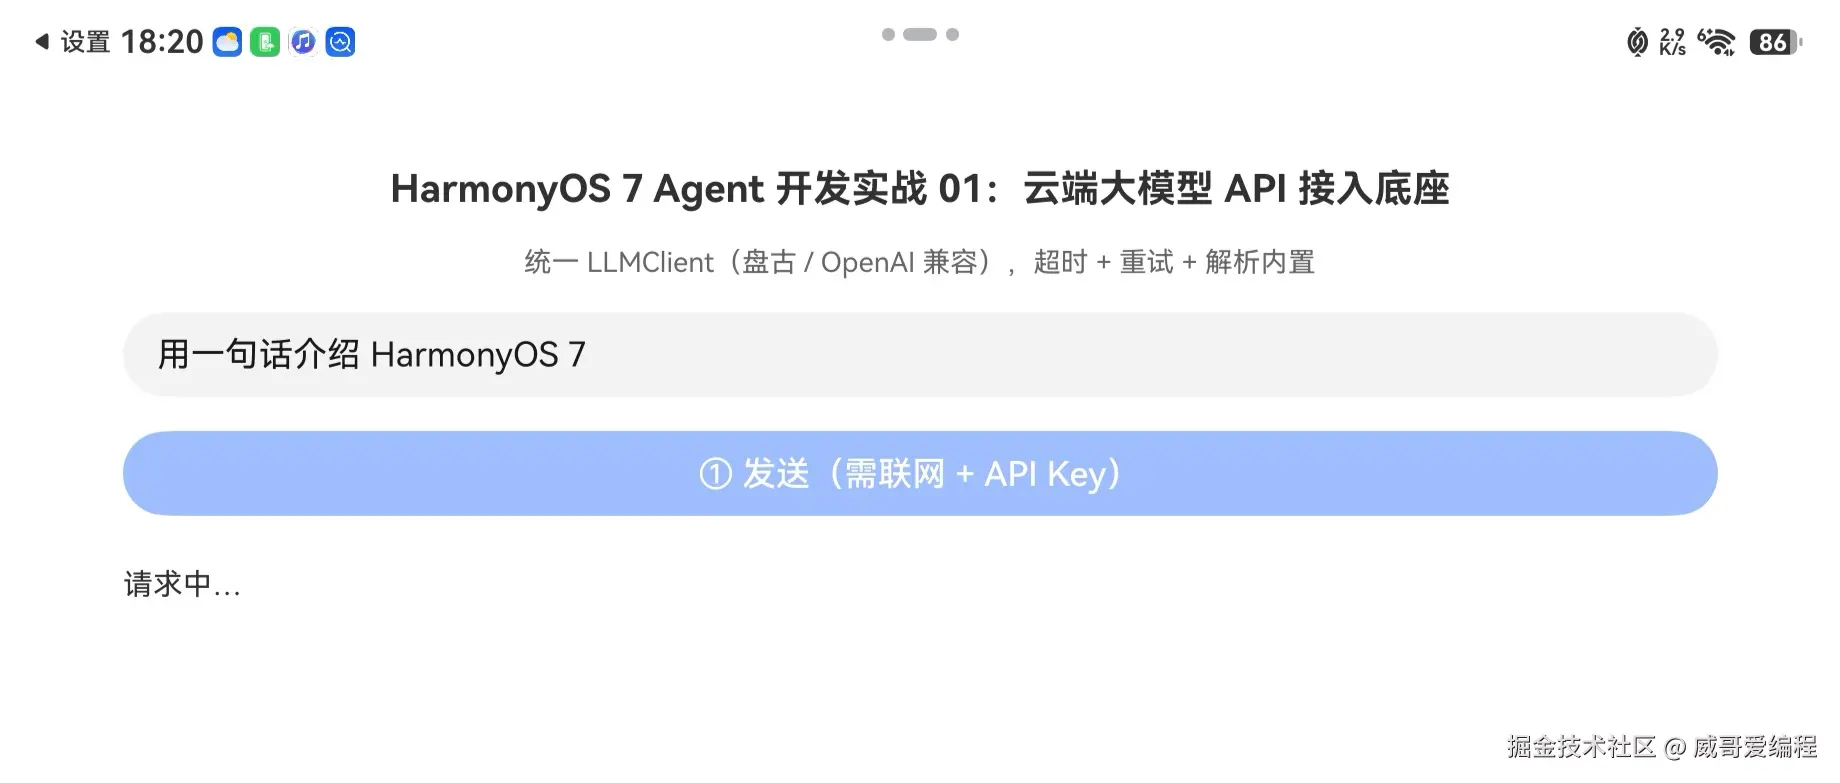
连真机或 HarmonyOS 7 模拟器,点"发送"即可看到云端大模型返回。chat() 内部已经把超时、重试、解析全管住,页面只处理 resp.text。
真机测试效果图如下:
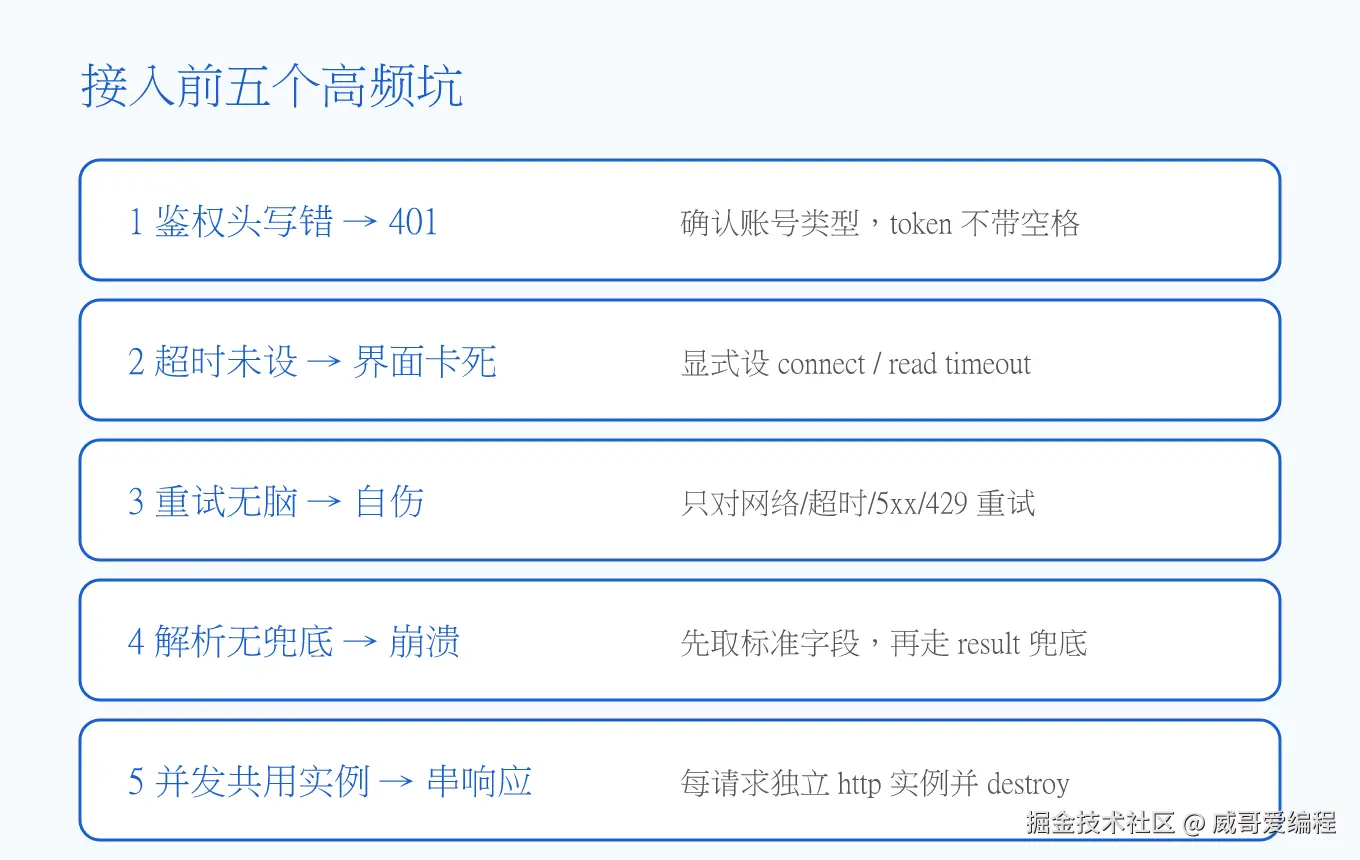
八、五个高频坑(接入前先看一遍)
- 鉴权头写错 401:盘古和 OpenAI 的鉴权头不同,确认账号类型再填;token 别带多余空格。
- 超时必设 :
@ohos.net.http不显式设connectTimeout/readTimeout,弱网下会一直挂起拖垮界面。 - 重试别无脑:401、400 这类错重试等于自伤,只对网络/超时/5xx/429 重试。
- 解析要兜底 :不要假设响应一定是 OpenAI 格式,先按标准取,取不到再走
result等扁平字段。 - 并发别共用同一把锁 :多会话并发请求时,每个请求用独立的
http.createHttp()实例并在finally里destroy(),避免串响应。
参考与出处
- 华为云盘古大模型 API 文档(对话补全 / 鉴权方式)
- OpenAI Chat Completions API(请求与响应结构)
- HarmonyOS
@ohos.net.http模块文档(API 26,request / 超时 / 错误处理)
最后一句:底座稳了,Agent 才敢往前跑;把不确定性收进一层抽象,剩下的复杂度才有地方安放。